

Nous avons l'habitude de repousser les limites du calcul, mais là, on atteint des sommets ! Après avoir atteint les 100 billions de décimales l'an dernier, nous avons décidé de passer à la vitesse supérieure et d'étendre le nombre de décimales connues de Pi à 105 billions. Cela représente 105 000 000 000 000 chiffres après le 3. Nous avons apporté quelques améliorations à la plateforme par rapport à l'année dernière, fait des découvertes surprenantes et appris de nouvelles choses, notamment la 105 billionième décimale de Pi : 6 !
En réalisant un calcul record mondial de Pi à 105 2 milliards de chiffres, le laboratoire StorageReview a souligné les incroyables capacités du matériel moderne. Cet effort, alimenté par un système AMD EPYC Bergamo 128P de pointe à 1.5 cœurs équipé de XNUMX To de DRAM et de près d'un pétaoctet de SSD Solidigm QLC, représente une réalisation historique en matière de technologie de calcul et de stockage.
La Problématique
Au cours de la course aux 100 16 milliards de données numériques, nous avons rencontré plusieurs limitations technologiques. La plate-forme serveur, par exemple, ne prenait en charge que XNUMX SSD NVMe dans les emplacements avant. Même si nous disposions de beaucoup de puissance CPU, ce calcul nécessitait un stockage massif pendant le processus et en back-end lors de la sortie du fichier TXT final.
Pour résoudre le problème de stockage la dernière fois, nous avons eu recours à des traîneaux adaptateurs PCIe NVME pour insérer trois autres SSD. Ensuite, pour la sortie, nous avions un serveur de stockage HDD en RAID0, remarquez, avec un partage iSCSI vers la boîte de calcul. Cette fois, nous voulions être un peu plus « entreprise » avec ce serveur, nous avons donc fait appel à quelques amis pour nous aider. Fait intéressant, il n’est pas aussi simple qu’il y paraît d’ajouter un tas de SSD NVMe à un serveur.
Le matériel
Au cœur de ce projet colossal se trouvait le système biprocesseur AMD EPYC 9754 Bergamo, doté de 128 cœurs chacun. Les processeurs AMD, réputés pour leurs performances exceptionnelles dans les tâches de calcul complexes (IA, HPC, analyse de données massives) , fournissaient la puissance nécessaire. À cela s'ajoutaient 1.5 To de mémoire vive (DRAM), garantissant des vitesses de traitement et de transfert de données rapides. Parallèlement, près d'un pétaoctet de stockage Solidigm QLC offrait une capacité et une fiabilité sans précédent.
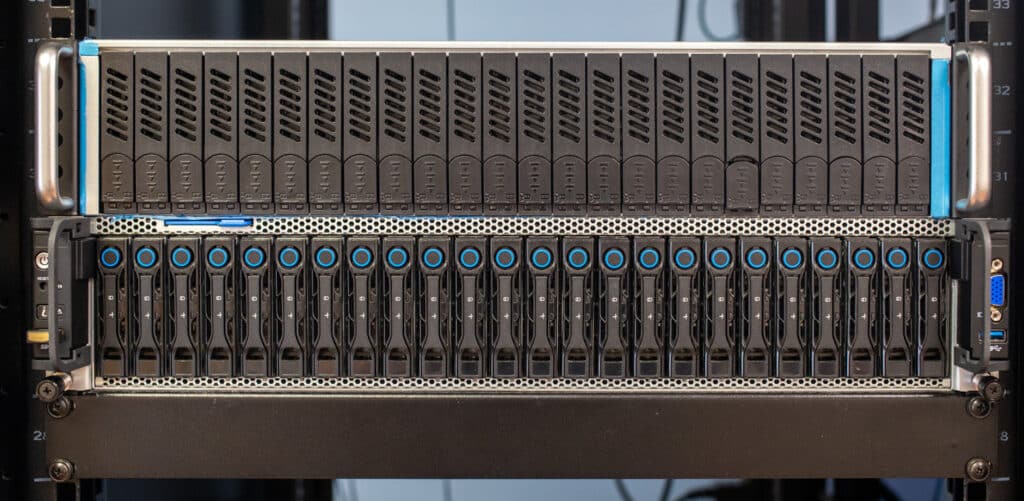
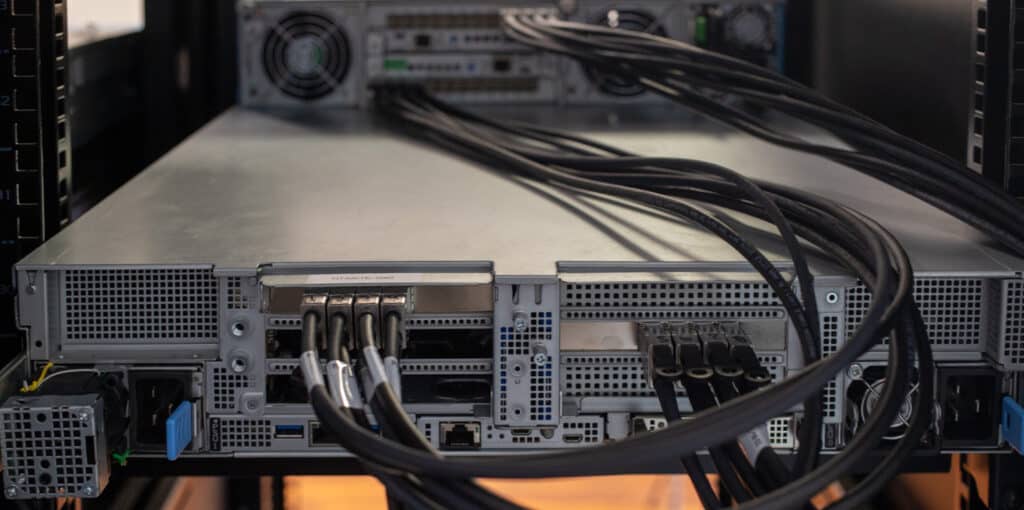
Notre plate-forme de châssis de base est restée la même que celle de l'année dernière (un boîtier QCT), mais nous avons mis à niveau les processeurs vers des puces AMD EPYC 9754 Bergamo. Nous souhaitions rechercher une amélioration de la vitesse et du nombre décimal tout en évitant d'utiliser du stockage pour le calcul, ce qui nous a obligé à faire appel à SerialCables pour fournir un JBOF. Cela a présenté certains défis en soi, que nous détaillerons ci-dessous.
| Paramètre | Valeur |
|---|---|
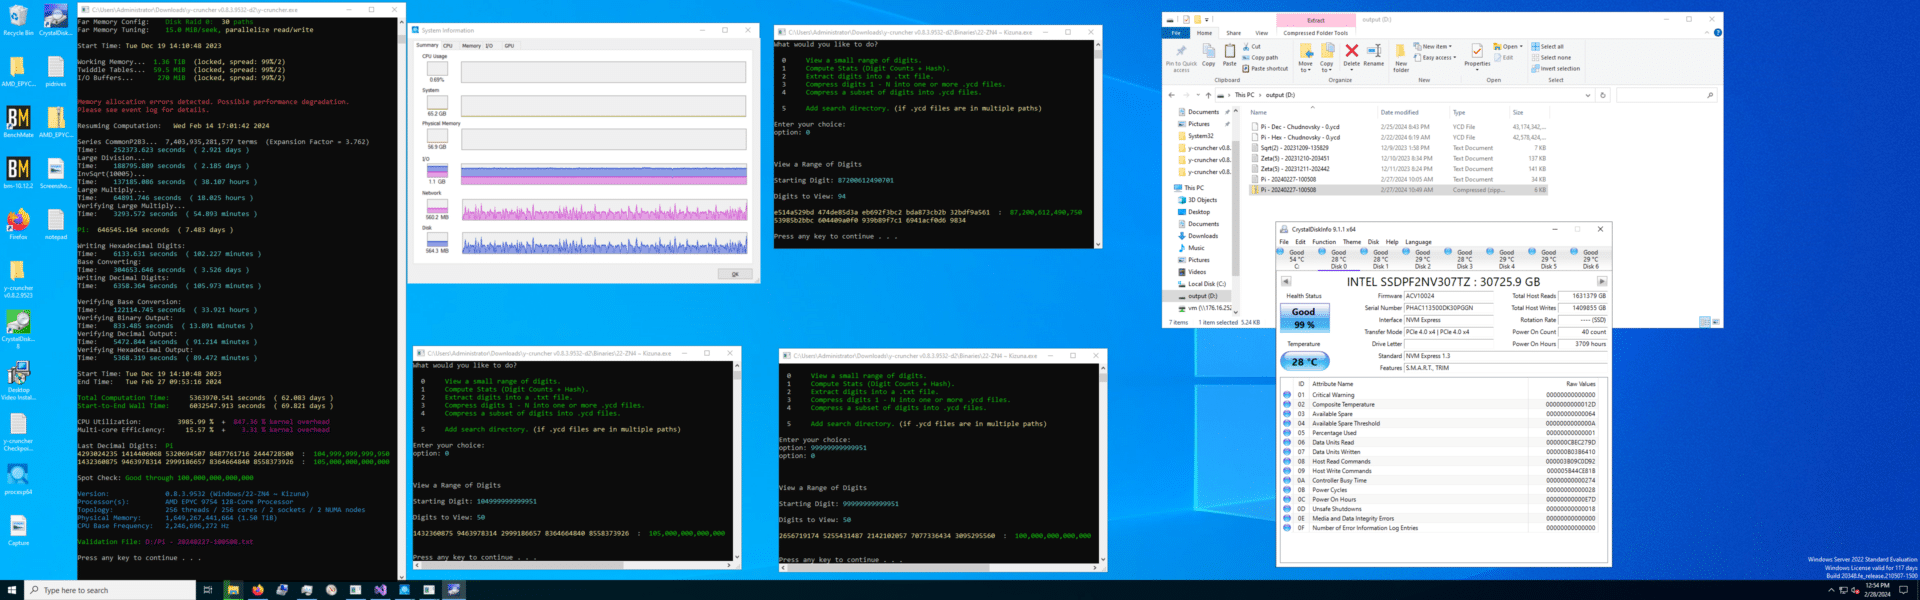
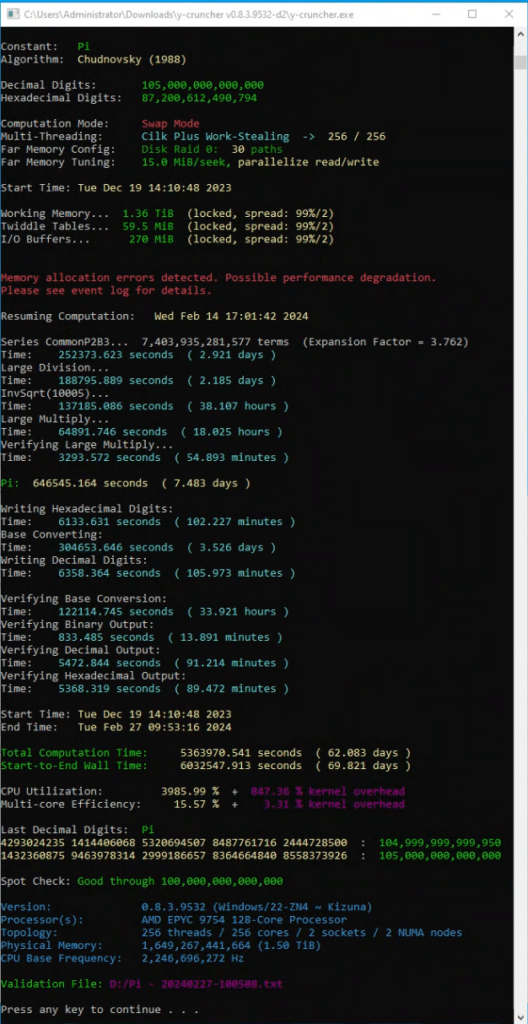
| Date de début : | mar. 19 déc. 14:10:48 2023 |
| Date de fin | mar. 27 février 09 53:16:2024 |
| Temps de calcul total | 5,363,970.541 62.08 XNUMX secondes / XNUMX jours |
| Temps de mur du début à la fin | 6,032,547.913 69.82 XNUMX secondes / XNUMX jours |
Période de calcul : du 14 décembre 2023 au 27 février 2024, soit 75 jours.
- CPU: Deux processeurs AMD Epyc 9754 Bergamo, 256 cœurs avec multithreading simultané (SMT) désactivé dans le BIOS.
- Mémoire: 1.5 To de RAM DDR5.
- Stockage: 36 disques SSD Solidigm D30.72-P5 de 5316 To.
- 24 disques SSD Solidigm D30.72-P5 de 5316 To dans un JBOF SerialCables
- 12 disques SSD Solidigm D30.72-P5 de 5316 To dans le serveur directement connecté.
- Système opérateur: Windows Serveur 2022 (21H2).
Le chemin vers 105 XNUMX milliards
| Paramètre | Valeur |
|---|---|
| Constante | Pi |
| Algorithme | Tchoudnovski (1988) |
| Chiffres décimaux | 105,000,000,000,000 |
| Chiffres hexadécimaux | 87,200,612,490,794 |
| Mode d'enfilage | Cilk Plus Vol de Travail -> 256/256 |
| Mémoire de travail | 1,492,670,259,968 1.36 XNUMX XNUMX XNUMX (XNUMX Tio) |
| Mémoire totale | 1,492,984,298,368 1.36 XNUMX XNUMX XNUMX (XNUMX Tio) |
| Le plus grand point de contrôle logique | 157,783,654,587,576 144 XNUMX XNUMX XNUMX (XNUMX Tio) |
| Utilisation logique du disque de pointe | 534,615,969,510,896 486 XNUMX XNUMX XNUMX (XNUMX Tio) |
| Octets de disque logique lus | 44,823,456,487,834,568 39.8 XNUMX XNUMX XNUMX XNUMX (XNUMX PiB) |
| Octets de disque logique écrits | 38,717,269,572,788,080 34.4 XNUMX XNUMX XNUMX XNUMX (XNUMX PiB) |
Défis rencontrés
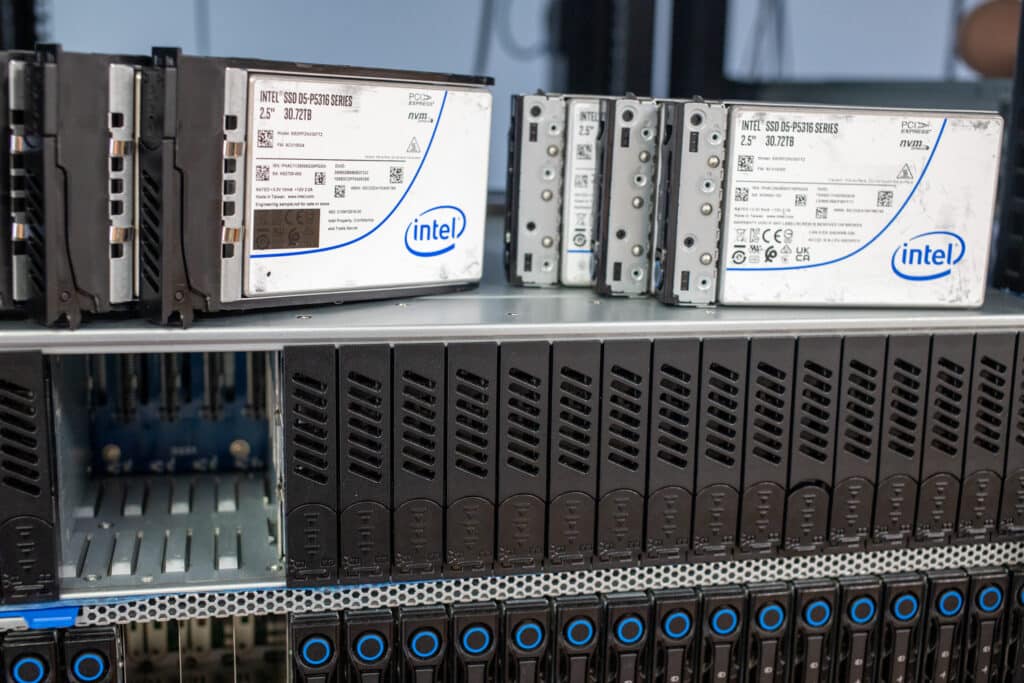
Pour étendre le stockage disponible pour les processeurs, un nouveau composant a été ajouté à cette exécution : un boîtier JBOF NVMe. Notre plateforme de test offrait 16 baies NVMe, les huit autres étant uniquement câblées en SATA. Bien que notre exécution initiale de 100 000 milliards d'itérations ait utilisé trois adaptateurs PCIe U.2 internes pour porter le nombre de disques NVMe à 19, cette configuration n'était pas optimale. Pour cette nouvelle exécution, nous avons ajouté un boîtier JBOF U.2 à 24 baies de Serial Cables , ce qui a permis d'améliorer significativement le stockage : davantage d'espace d'échange pour les calculs et un stockage interne plus important pour les fichiers de sortie. Fini les serveurs de stockage RAID 0 complexes !
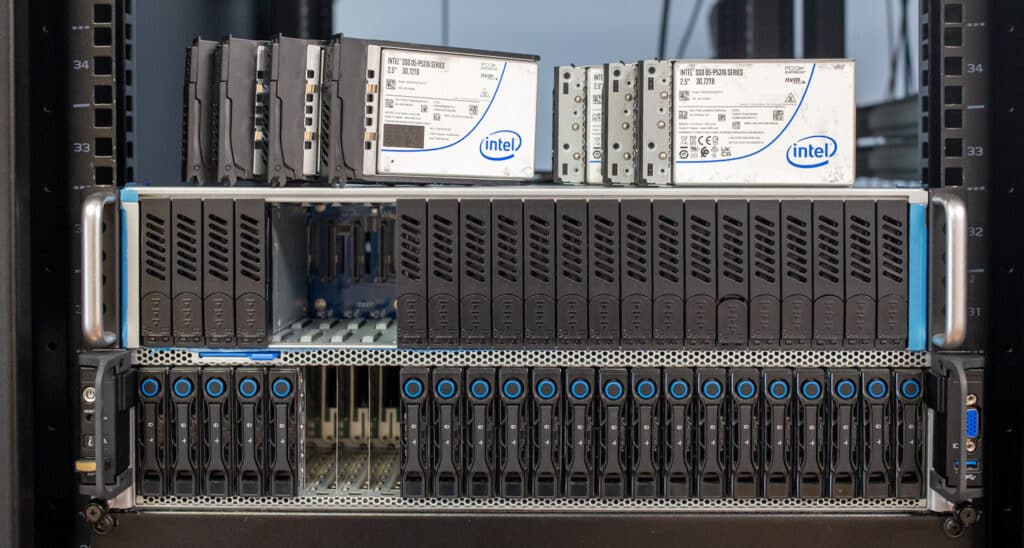
Le JBOF à 24 baies de câbles série nous a permis de presque doubler le nombre de disques par rapport à notre exécution initiale. Nous avons alloué 30 disques à l'espace de swap y-cruncher, laissant 6 SSD pour un volume de sortie Storage Spaces RAID5. Un énorme avantage de cette approche est apparu lors de la phase de sortie, où nous n'avons pas été freinés par la vitesse d'une seule connexion 10 Go, comme lors de la première itération 100T Pi. Bien que le JBOF ait résolu le problème du nombre total de disques, il a néanmoins introduit une limitation : les performances des disques individuels.
Dans un serveur doté de disques SSD U.2 à connexion directe, il existe quatre voies PCIe par disque. Si chaque disque est directement connecté à la carte mère, cela équivaut à 96 voies PCIe pour 24 SSD. La bande passante totale du JBOF est limitée par le nombre de voies PCIe qu'il peut reconnecter à l'hôte.
Dans ce cas, nous avons utilisé deux cartes hôtes de commutateur PCIe, divisant le JBOF en deux groupes de 12 SSD. Chaque groupe de 12 SSD partageait alors 16 voies PCIe. Tout en offrant des avantages considérables dans la connexion des SSD à notre hôte, nous avons eu des scénarios dans lesquels les disques d'échange exécutés via JBOF prenaient du retard sur les disques directement connectés au serveur. Ce n'est pas une faute du JBOF. Il s'agit simplement d'une limitation technique ou plutôt d'une limitation du nombre de voies PCIe avec lesquelles le serveur peut fonctionner.
Les lecteurs avisés pourraient se demander pourquoi nous nous sommes arrêtés à 36 SSD dans cette série au lieu de monter à 40. C'est une histoire amusante. L'espace PCIe adressable a ses limites sur de nombreux serveurs. Dans notre cas, au nombre de 38 disques, le dernier SSD a pris l'adresse PCIe du chipset USB et nous avons perdu le contrôle du serveur. Pour jouer la sécurité, nous l'avons sauvegardé sur 36 SSD afin de pouvoir toujours accéder au BIOS ou nous connecter au serveur. Repousser les limites conduit à des découvertes surprenantes.
Aperçu du diagnostic et résolution
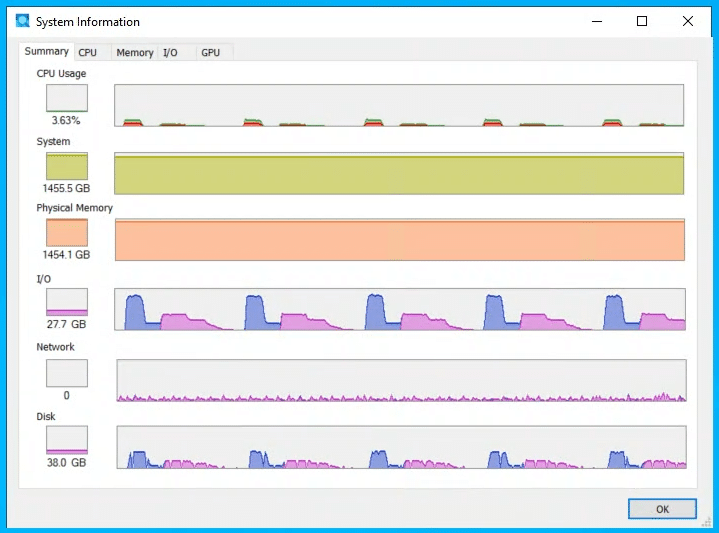
Le premier des deux principaux défis rencontrés était lié aux performances. Nous avons alors constaté l' application de la loi d'Amdahl . Un problème particulier est apparu : y-cruncher semblait se bloquer sur notre système AMD Bergamo à 256 cœurs lors d'opérations importantes en mode swap. Ce blocage, caractérisé par une absence d'activité du processeur et des E/S disque, a remis en question les comportements logiciels habituels. Cela nous a conduits à analyser en profondeur les subtilités du calcul parallèle et des interactions matérielles.
Le processus de découverte a révélé que le programme n'était pas vraiment suspendu mais fonctionnait dans une capacité très limitée, s'exécutant en monothread sur une configuration étendue de 256 cœurs. Ce comportement inhabituel a suscité des questions sur l'impact potentiel de la loi d'Amdahl, d'autant plus que les opérations impliquées n'étaient pas gourmandes en calcul et n'auraient pas dû provoquer de retards importants sur un système équipé de 1.5 To de RAM.
L'enquête a pris une tournure inattendue lorsque le problème a été reproduit sur un ordinateur de bureau grand public, soulignant les graves conséquences de la loi d'Amdahl, même sur des systèmes moins importants. Ceci a conduit à un examen plus approfondi des causes sous-jacentes, qui a révélé un risque lié au processeur, spécifique à l'architecture Zen 4, impliquant un super-alignement et ses effets sur les accès mémoire.
Le problème a été exacerbé sur les processeurs AMD par une boucle dans le code qui, en raison de sa nature simple, aurait dû s'exécuter beaucoup plus rapidement que prévu. La cause première semble être une gestion inefficace de l'alias de mémoire par l'unité de stockage de chargement d'AMD. La résolution de ce problème complexe nécessitait à la fois d'atténuer le risque de super-alignement grâce à la vectorisation de la boucle à l'aide de AVX512 et de remédier au ralentissement provoqué par la loi d'Amdahl avec un parallélisme amélioré. Cette approche globale a non seulement résolu le problème immédiat, mais a également conduit à des optimisations significatives des processus informatiques de y-cruncher, créant ainsi un précédent pour relever des défis similaires dans des environnements informatiques hautes performances.
Le problème suivant a été rencontré lors des dernières étapes du calcul, qui s’arrêtaient de manière inattendue et ne fournissaient aucune information sur la cause de l’accident. L'accès à distance a été accordé à Alexander Yee et, pour la première fois depuis plus d'une décennie, la réalisation d'un enregistrement Pi a nécessité l'intervention directe du développeur.
Nous n'avons pas participé à ce diagnostic, mais une erreur critique d'arithmétique à virgule flottante a été détectée dans le chemin d'exécution AVX512 de l'algorithme de multiplication N63. Alexander a pu effectuer un diagnostic à distance , fournir un fichier binaire corrigé et reprendre le traitement à partir d'un point de contrôle, aboutissant à un calcul réussi après la mise en œuvre de correctifs logiciels essentiels.
Réflexions et aller de l'avant
Cet effort illustre les complexités et les imprévisibilités du calcul haute performance. La résolution de ces défis a établi un nouveau record de calcul Pi et a fourni des informations précieuses sur les méthodologies de développement et de test de logiciels. La dernière version de y-cruncher, v0.8.4, intègre des correctifs pour les problèmes identifiés, promettant une stabilité améliorée pour les calculs futurs.
Calculer Pi à 105 XNUMX milliards de chiffres n’était pas une mince affaire. Cela impliquait une planification, une optimisation et une exécution méticuleuses. En tirant parti d'une combinaison de logiciels open source et propriétaires, l'équipe de StorageReview a optimisé le processus algorithmique pour exploiter pleinement les capacités du matériel, réduisant ainsi le temps de calcul et améliorant l'efficacité.
Avec des performances de lecture saturantes PCIe Gen4 et des capacités de pointe allant jusqu'à 61.44 To, les SSD Solidigm QLC offrent des résultats incroyables. « Imaginez ce que ces disques peuvent permettre dans le domaine du calcul haute performance ou des applications à forte intensité d'IA », a déclaré Greg Matson, vice-président de la planification stratégique et du marketing chez Solidigm. Nous sommes ravis que les SSD de Solidigm puissent alimenter la deuxième tentative record de Storagereview pour calculer pi. Leurs efforts prouvent les véritables capacités des disques de stockage de Solidigm, ouvrant un monde de possibilités pour les applications d'IA gourmandes en données.
Conclusion
La course jusqu’à 105 100 milliards de chiffres de Pi a été beaucoup plus complexe que prévu. Après réflexion, nous aurions dû nous attendre à rencontrer de nouveaux problèmes ; après tout, nous réalisons un calcul qui n'avait jamais été effectué auparavant. Mais avec les XNUMX XNUMX milliards de calculs complétés par une configuration beaucoup plus « ruban adhésif et grillage », nous pensions avoir réussi. En fin de compte, il a fallu un effort de collaboration pour amener cette plate-forme à franchir la ligne d'arrivée.
Alors que nous nous réjouissons avec nos partenaires de cette course record, nous devons nous demander : « Qu’est-ce que cela signifie ? Cinq milliards de chiffres supplémentaires de Pi ne feront probablement pas une énorme différence en mathématiques. Néanmoins, nous pouvons tracer quelques lignes entre les charges de travail informatiques et la nécessité d’un matériel sous-jacent moderne pour les prendre en charge. Fondamentalement, cet exercice montre que le matériel approprié fait toute la différence, qu'il s'agisse d'un cluster de centre de données d'entreprise ou d'une installation HPC de grande envergure.
Pour le calcul de Pi, nous étions entièrement limités par le stockage. Des processeurs plus rapides permettraient d'accélérer les calculs, mais le facteur limitant pour de nombreux nouveaux records du monde reste la capacité de stockage locale. Pour cette tentative, nous utilisons à nouveau les SSD Solidigm D5-P5316 de 30.72 To afin d'obtenir un peu plus de 1.1 Po de mémoire flash brute dans le système. Ces SSD sont la seule raison qui nous a permis de battre les records précédents et d'atteindre 105 billions de décimales de Pi.
Cela soulève une question intéressante. Nombre de nos abonnés savent que Solidigm propose des SSD de 61.44 To (D5-P5336) et jusqu'à 30.72 To (D5-P5430) , disponibles en plusieurs formats et capacités. Nous avons testé ces disques et publié de nombreux messages sur les réseaux sociaux mettant en avant leur densité de stockage impressionnante. Avec 32 de ces SSD atteignant près de 2 Po, on peut se demander combien de temps les 105 billions de décimales de Pi resteront le record mondial. On imagine que ce ne sera plus très longtemps.
Les plus grands chiffres décimaux connus de Pi
1432360875 9463978314 2999186657 8364664840 8558373926 : Chiffres jusqu'à 105,000,000,000,000 XNUMX XNUMX XNUMX XNUMX


 Amazon