

Note de la rédaction : Nous avons eu l’occasion de nous pencher à nouveau sur la plateforme NVIDIA Jetson avec un nouveau membre de notre équipe. Consultez notre article de l’année dernière où nous avons exécuté un modèle de vision sur une version finale de Jetson, le Lenovo SE70.
Avec la plateforme Jetson de NVIDIA, les développeurs peuvent explorer des options d'IA spécialement adaptées au développement de l'IA de pointe. Ces systèmes permettent des performances de serveur compatibles GPU dans un package que vous pouvez tenir dans une seule main. Un grand merci à NVIDIA de nous avoir offert le kit de développement Jetson AGX Orin pour essayer et voir à quel point il peut être facile d'avoir votre propre LLM local.
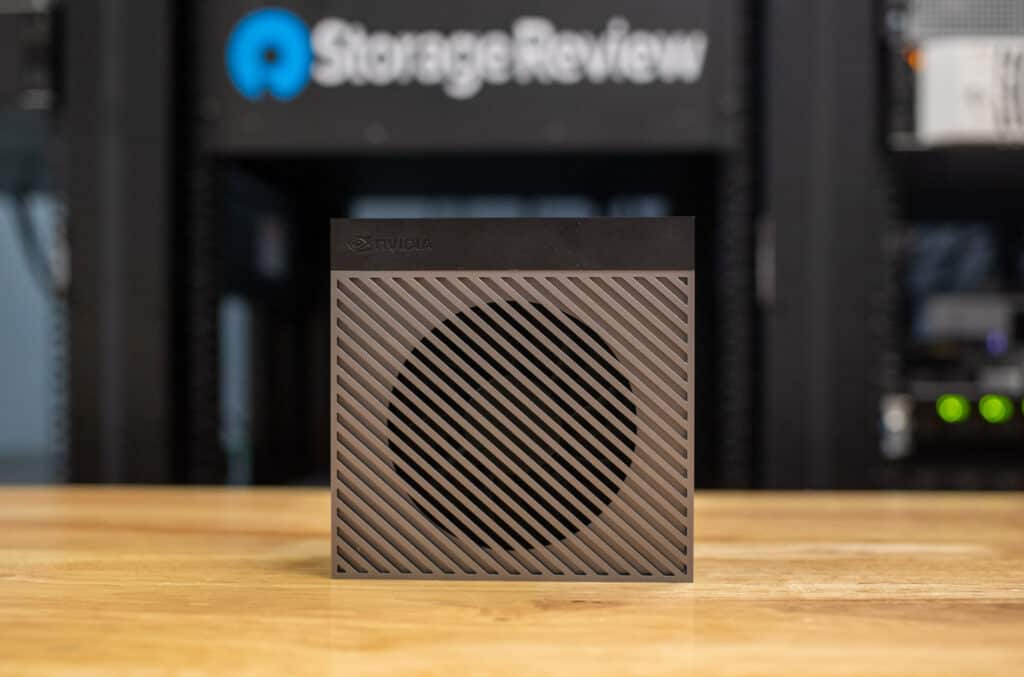 Le Jetson AGX Orin DevKit est présenté dans un format compact, mesurant seulement 11 cm ou environ 4.3 pouces de largeur et de longueur et 7.2 cm (environ 2.8 pouces) de hauteur. À l’intérieur du kit de développement Jetson AGX Orin se trouve un GPU à architecture NVIDIA Ampere à 2048 64 cœurs avec 1.3 cœurs Tensor et une fréquence maximale de 12 GHz. Il existe également un processeur Arm Cortex à 78 cœurs A8.2AE v64 3 bits avec 2 Mo de cache L6, 3 Mo de cache L2.20 et une fréquence maximale de XNUMX GHz.
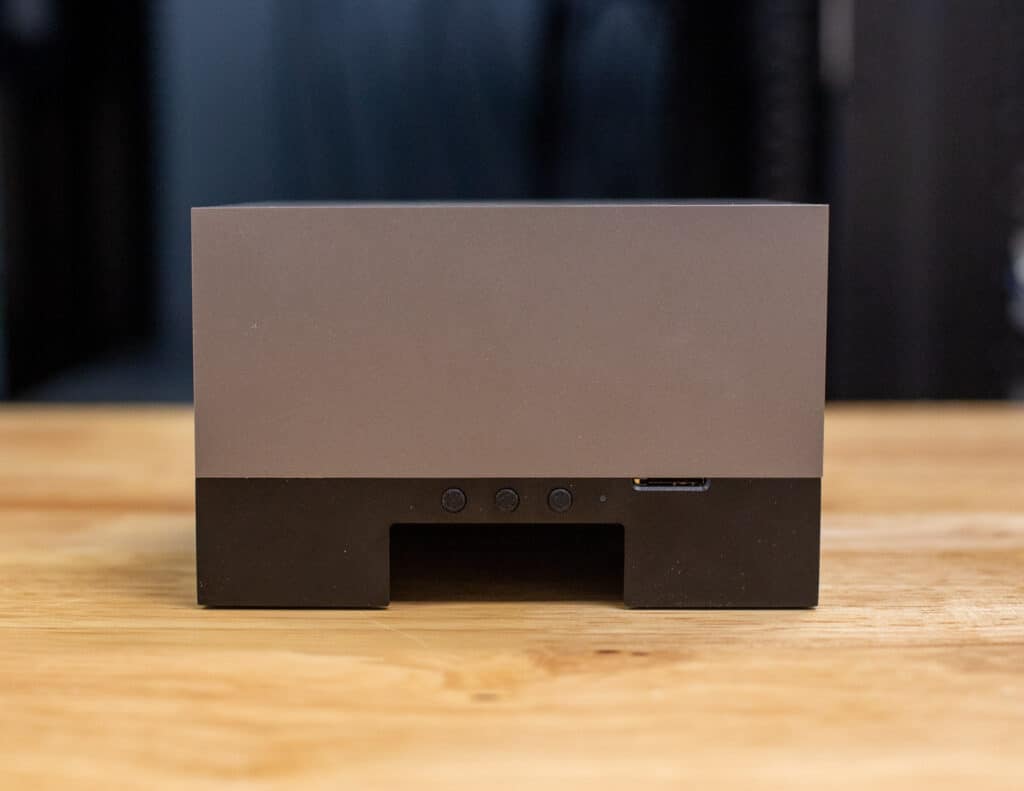
Ces deux composants de puissance, associés à 64 Go de mémoire unifiée LPDDR5 avec des vitesses de 204.8 Go/s, se combinent pour créer l'exploit le plus impressionnant de cette petite machine : 275 TOPS dans les modèles avec 64 Go du petit GPU et du DLA. C'est 8.6 fois le nombre de TOPS par rapport au prédécesseur de NVIDIA, le Jetson AGX Xavier, qui ne livrait que 32 TOPS.
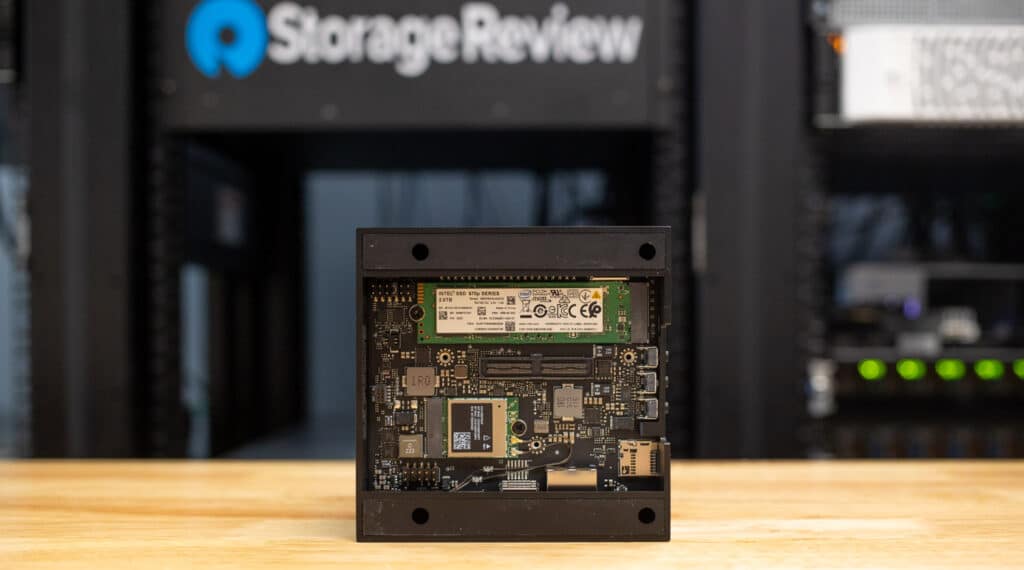
Sous le capot se trouvent également deux emplacements M.2 : un PCIe Gen 4×4 Key M pour tout stockage supplémentaire au-delà de l'eMMC de 64 Go et un Gen 4×1 Key E pour les connexions sans fil. La connectivité en ligne n'est cependant pas un problème, avec un connecteur RJ10 de 45 gigabits. De plus, il y a un en-tête à 40 broches (pour UART, SPI, I2S, I2C, CAN, PWM, DMIC et GPIO), un en-tête d'automatisation à 12 broches, un en-tête de panneau audio à 10 broches, un en-tête JTAG à 10 broches, un Connecteur de ventilateur à 4 broches, connecteur de batterie de secours RTC à 2 broches, ainsi qu'un connecteur MIPI CSI-16 à 2 voies pour les caméras CSI.
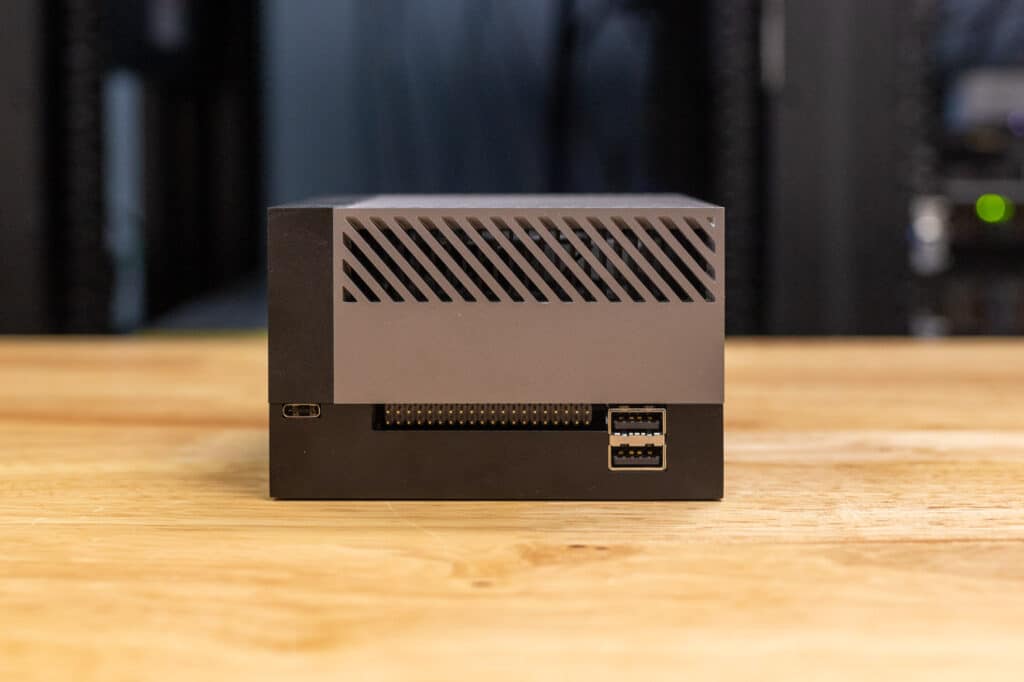 La connectivité externe ne manque pas non plus. Il existe six ports USB : deux ports USB-A 3.2 Gen 2, deux ports USB-A 3.2 Gen 1 et USB-C 3.2 Gen 2. Parmi ces deux ports USB-C, l’un peut fournir des vitesses allant jusqu’à 20 Gbit/s pour le flashage et le transfert de données, et l’autre est dédié à l’alimentation de 60 W. Si vous avez besoin de ce port USB-C supplémentaire, il existe une connexion d’alimentation supplémentaire via une prise d’alimentation CC. Le système n’est cependant envoyé qu’avec son alimentation USB-C. Il existe également un emplacement pour carte micro SD pour une option de stockage rapide et un port micro USB-B pour servir de port de débogage série.
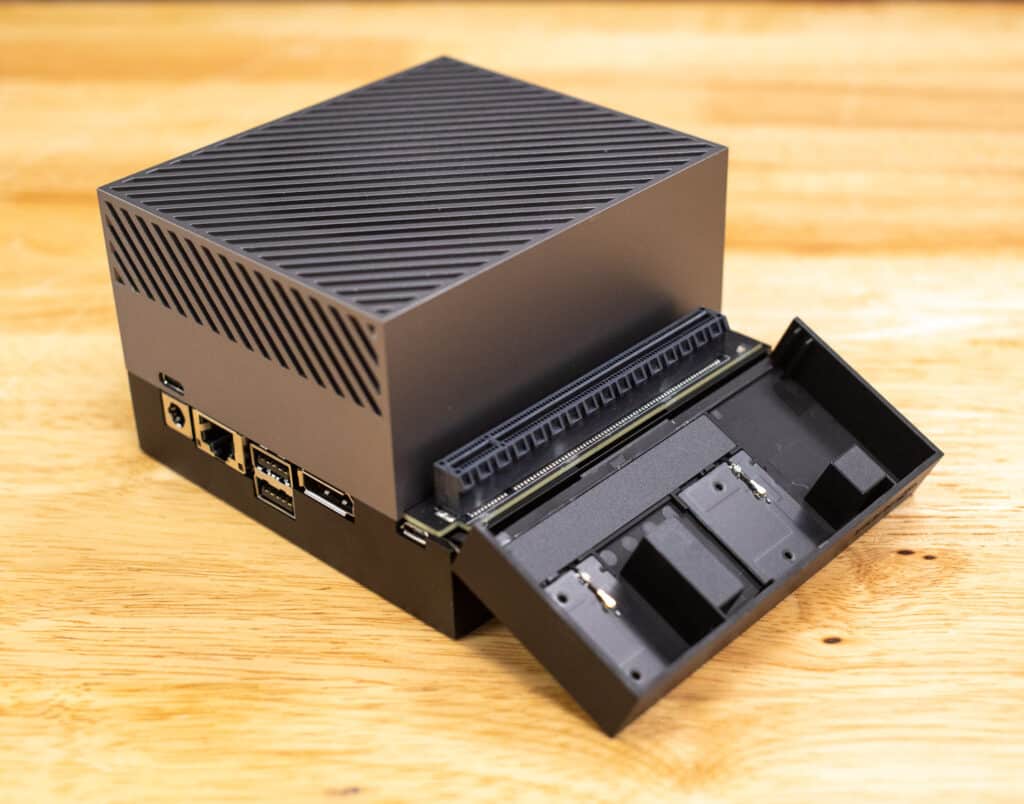
Caché sous un couvercle magnétique, se trouve l’emplacement externe PCIe Gen 4×16. De plus, l'emplacement PCIe externe prend en charge jusqu'à une connexion PCIe 4×8. Sans aucun moyen d'alimenter un GPU en interne, l'emplacement est le mieux adapté pour quelque chose comme une carte réseau haute vitesse. Pour une option d'affichage dédiée, l'Orin dispose d'un DisplayPort 1.4.
Jetson AGX Xavier contre Jetson AGX Orin
| Fonctionnalité | Jetson AGX Xavier 64 Go | Kit de développement Jetson AGX Orin 64 Go |
|---|---|---|
| Performances de l'IA | 32 TOPS | 275 TOPS |
| GPU | GPU NVIDIA Volta à 512 cœurs avec 64 cœurs Tensor | GPU NVIDIA Ampere à 2048 64 cœurs avec XNUMX cœurs Tensor |
| Fréquence maximale du GPU | Non spécifié | 1.3GHz |
| Processeur | Processeur NVIDIA Carmel Arm v8 8.2 bits à 64 cœurs, 8 Mo L2 + 4 Mo L3 | Processeur Arm Cortex-A12AE v78 8.2 bits à 64 cœurs, 3 Mo L2 + 6 Mo L3 |
| Fréquence maximale du processeur | 2.2GHz | 2.2GHz |
| Accélérateur DL | 2x NVDLA v1 | Non spécifié |
| Fréquence maximale DLA | 1.4GHz | Non spécifié |
| Accélérateur de vision | 2x PVA | 1x AVP v2 |
| Mémoire | 64 Go LPDDR4x, 136.5 Go/s | 64 Go LPDDR5, 204.8 Go/s |
| Stockage | 32 Go eMMC 5.1, 64 Go disponibles en version industrielle | Non spécifié |
| Encodage vidéo | 4x 4K60 (H.265), 8x 4K30 (H.265), 16x 1080p60 (H.265), 32x 1080p30 (H.265) | Non spécifié |
| Décodage vidéo | 2x 8K30 (H.265), 6x 4K60 (H.265), 12x 4K30 (H.265), 26x 1080p60 (H.265), 52x 1080p30 (H.265) | Non spécifié |
| Caméra CSI | Jusqu'à 6 caméras (36 via canaux virtuels), 16 voies MIPI CSI-2, 8 voies SLVS-EC, D-PHY 1.2 (jusqu'à 40 Gbit/s), C-PHY 1.1 (jusqu'à 62 Gbit/s) | Non spécifié |
| PCIe | 1 × 8, 1 × 4, 1 × 2, 2 × 1 (PCIe Gen4, port racine et point de terminaison) | Emplacement PCIe x16 prenant en charge x8 PCIe Gen4, emplacement M.2 Key M avec x4 PCIe Gen4, emplacement M.2 Key E avec x1 PCIe Gen4 |
| USB | 3x USB 3.2 Gen2 (10 Gbit/s), 4x USB 2.0 | USB-C pour l'alimentation (15-60 W), USB-C unique pour le flashage et la programmation, Micro B pour le débogage série, 2x USB 3.2 Gen2 (USB Type-C), 2x USB 3.2 Gen2 (USB Type-A), 2x USB 3.2 Gen1 (USB Type-A), USB 2.0 (USB Micro-B) |
| Networking | 1x GbE | Connecteur RJ45 jusqu'à 10 GbE |
| Écran | 3 multimodes DP 1.4/eDP 1.4/HDMI 2.0 | 1x connecteur DisplayPort 1.4a (+MST) |
| Autres E / S | 5x UART, 3x SPI, 4x I2S, 8x I2C, 2x CAN, PWM, DMIC, GPIO | Connecteur à 40 broches (UART, SPI, I2S, I2C, CAN, PWM, DMIC, GPIO), connecteur d'automatisation à 12 broches, connecteur de panneau audio à 10 broches, connecteur JTAG à 10 broches, connecteur de ventilateur à 4 broches, connecteur à 2 broches Connecteur de batterie de secours RTC, emplacement microSD, prise d'alimentation CC, boutons d'alimentation, de récupération forcée et de réinitialisation |
| Tuning Moteur | 10-30W | 15-60 W (via USB-C) |
Configuration du SDK côté IA/NVIDIA
Les Large Language Models (LLM) sont des IA, telles que ChatGPT ou Ollama, qui ont été formées sur de grandes quantités de données. Avec une empreinte aussi réduite, il est difficile de croire que vous puissiez exécuter un modèle d'IA local et privé. Actuellement, nous voyons apparaître sur le marché des ordinateurs portables « AI PC » d’Intel, AMD et Snapdragon avec des NPU dédiés. Ces appareils, similaires à la plate-forme Jetson, utilisent du silicium dédié sur la puce, doté de fonctionnalités supplémentaires d'accélération de l'IA. Conceptuellement, ces composants sont conçus pour fonctionner de manière similaire à notre cerveau (d’où le terme « neuronal » dans NPU) et permettent de traiter simultanément de grandes quantités de données. L'inclusion de NPU signifie que le CPU et le GPU sont libérés pour traiter d'autres tâches, ce qui conduit à un ordinateur beaucoup plus efficace, tant en termes de puissance que de traitement.
Cependant, les 40 TOPS produits par Lunar Lake d'Intel, ou la plate-forme 50 TOPS d'AMD, ne sont toujours pas aussi importants que la puissance combinée du GPU et du CPU des Jetson Orin Devkits, soit les 275 TOPS annoncés. Il y a plus qu'assez de puissance pour avoir une IA localement dans votre bureau, ou même dans votre maison/homelab ! Les autres composants aidant à l'IA sont les deux accélérateurs NVDLA v2 Deep Learning (DL), qui facilitent la vitesse à laquelle le système est capable d'effectuer des processus d'IA ; et un accélérateur Single Vision, qui accélère la vitesse à laquelle Computer Vision est capable de traiter les images.
La configuration du système pour exécuter l'IA est rationalisée par les nombreux guides de NVIDIA. Pour commencer, vous devez vous assurer de flasher votre Jetson avec Ubuntu, puis suivre ces 6 étapes :
Étape 1 : Installer le gestionnaire de SDK NVIDIA
Les instructions complètes et les fichiers de téléchargement seront disponibles sur le site du SDK NVIDIA . Un compte développeur gratuit est requis pour cette procédure.
Étape 2 : Ouvrez NVIDIA SDK Manager installé sur Ubuntu
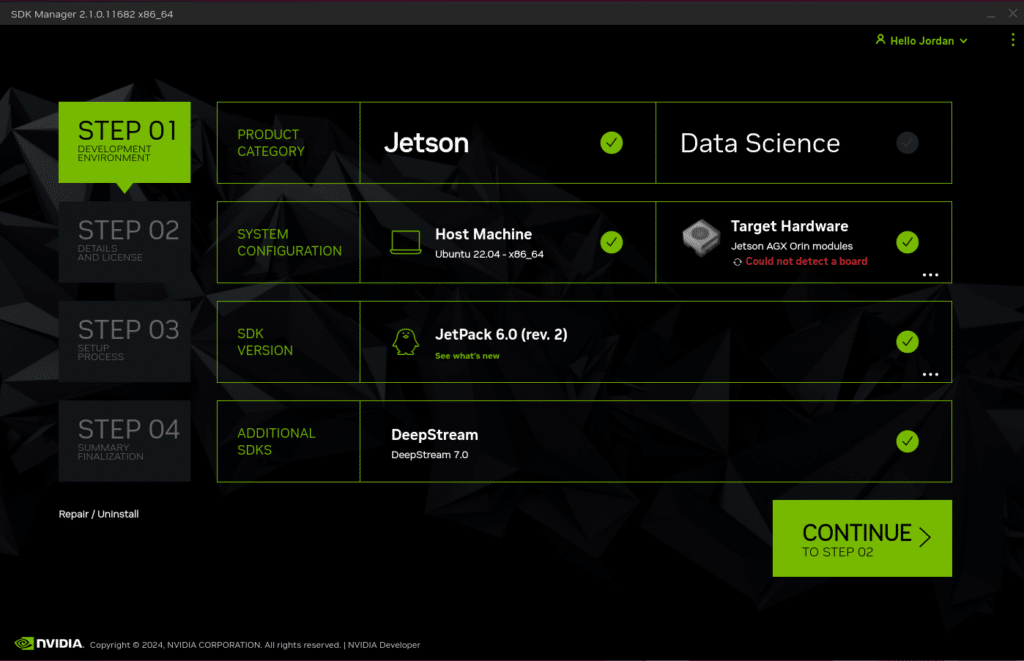
Étape 3 : Environnement de développement
Cette étape consiste à confirmer que vous avez tous vos canards alignés. Confirmez votre produit, les configurations système, la version du SDK et les SDK supplémentaires. Pour notre configuration, nous avons utilisé le kit de développement Jetson AGX Orin, Ubuntu 22.04, JetPack 6.0 et Deep Stream 7.0.
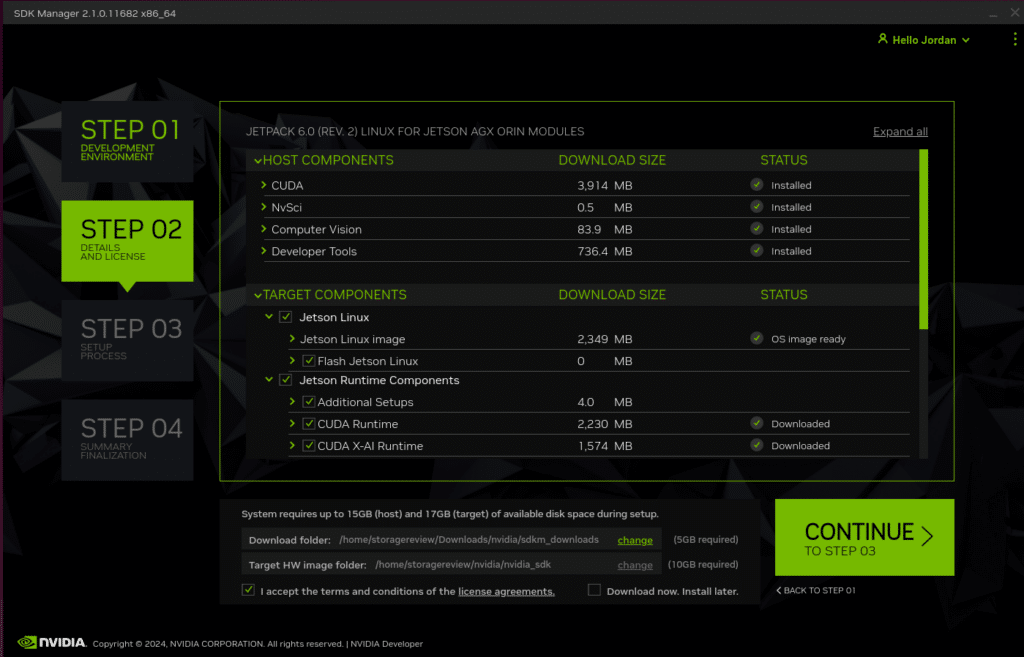
Étape 4 : Détails et licence
Cette étape sert d'écran d'installation, garantissant que tous les composants hôtes et composants cibles sont téléchargés et installés. C'est également l'endroit idéal pour sélectionner l'emplacement de téléchargement approprié. Le système hôte nécessite 15 Go de stockage et le système cible, 17 Go de stockage.
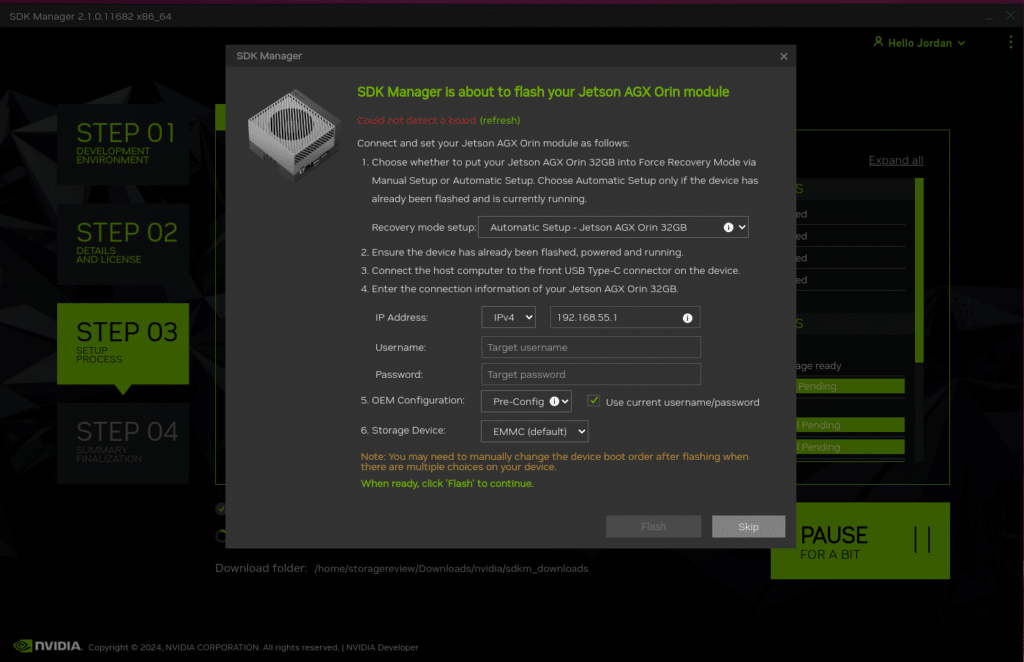
Étape 5 : Processus de configuration
Cette étape sert de fenêtre de confirmation pour terminer la configuration. Ici, vous sélectionnerez le mode de récupération, en choisissant s'il s'agira d'un mode de récupération forcée manuelle ou automatique, automatique étant donné que le système a déjà été flashé et exécuté. À partir de là, vous pouvez configurer/confirmer votre adresse IP, ajouter un nom d'utilisateur et un mot de passe, choisir votre configuration OEM et le périphérique de stockage cible. Une fois tout cela défini, vous pourrez cliquer sur l'option Flash.
Étape 6 : Finalisation du résumé
Enfin, cette étape exécutera le système. Après cela, vous pourrez exécuter le code :
jetson-containers run --name ollama $(autotag ollama)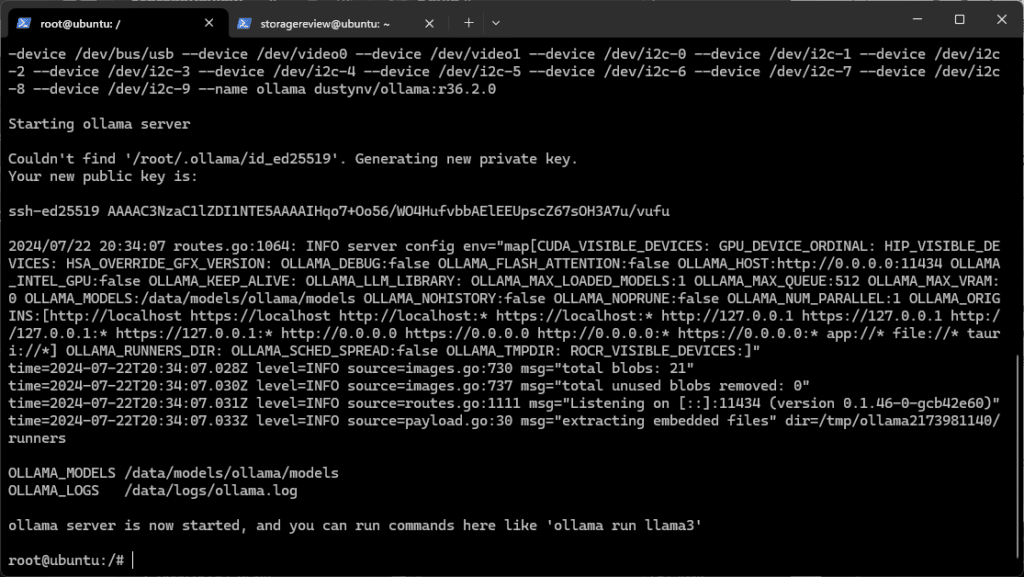
L'exécution de la première ligne de code lancera Ollama LLM. Ollama est une plateforme populaire qui simplifie la configuration et le développement locaux de modèles linéaires logiques (LLM), et peut même être installée à l'intérieur ou à l'extérieur du conteneur. Elle inclut une bibliothèque de modèles intégrée avec des poids pré-quantifiés, qui sera automatiquement téléchargée et exécutée en arrière-plan par l'intermédiaire de llama.cpp pour l'inférence. Le conteneur Ollama a été compilé avec le support CUDA, ce qui le rend parfaitement adapté à une utilisation sur Jetson AGX Orin. Ensuite, en exécutant le code :
docker run -it --rm --network=host --add-host=host.docker.internal:host-gateway ghcr.io/open-webui/open-webui:main
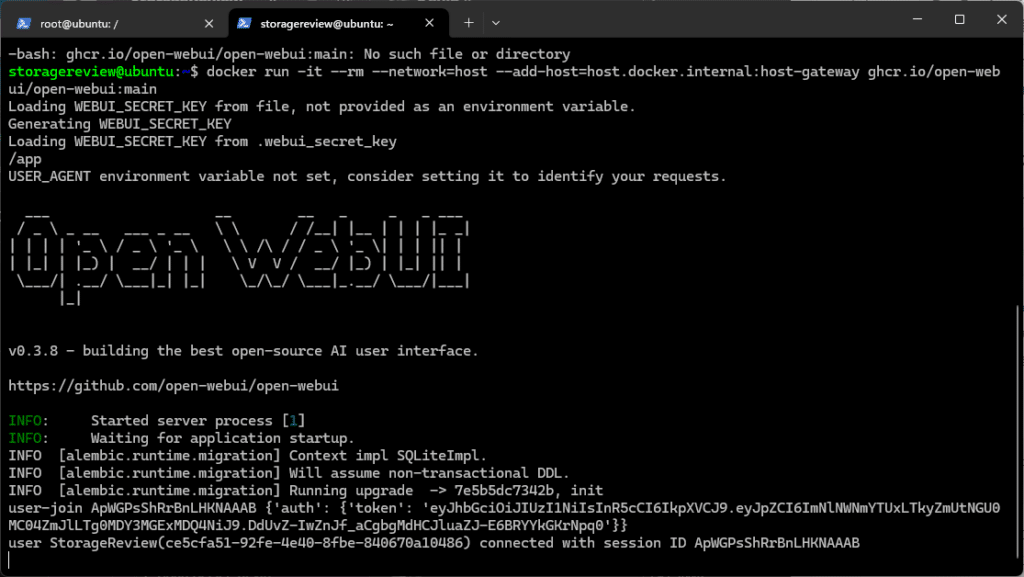
Vous pourrez alors accéder à l'Open Web User Interface (OWUI) sur l'adresse IP ou DNS de l'appareil sur le port 8080, qui fonctionnera comme un chatbot. L'OWUI sert de plug-in à l'API du serveur Ollama, mais peut également utiliser ChatGPT d'OpenAI, Llama-3 de Meta ou Phi-3 Mini de Microsoft comme plug-ins.
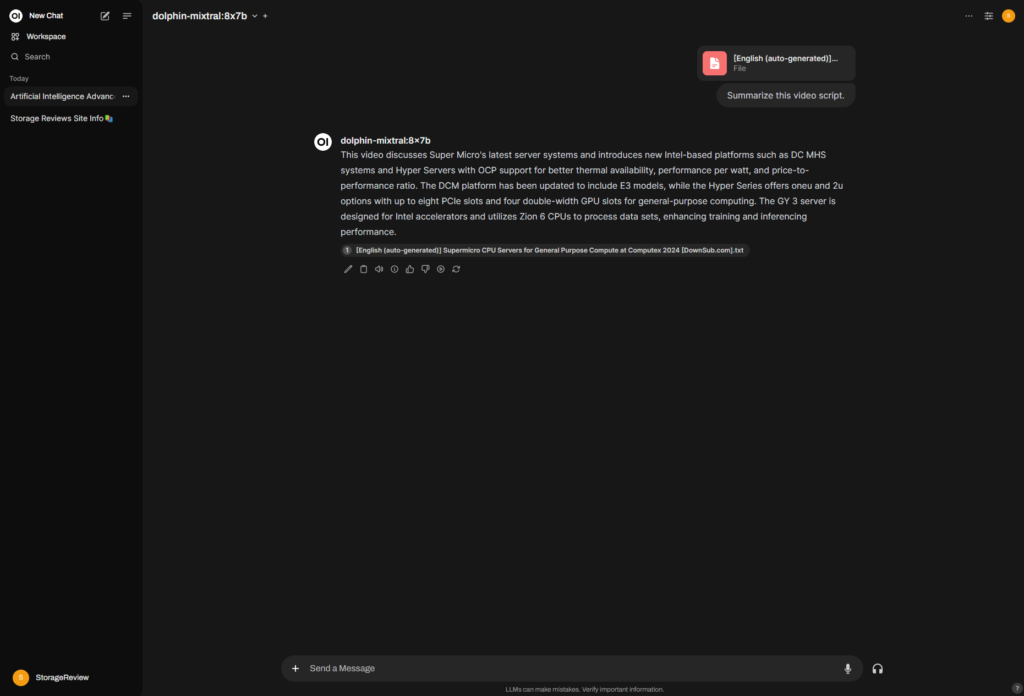
Même si, avec un budget énergétique aussi faible, le délai de création du premier token pour les modèles plus grands est particulièrement lent, la plate-forme est toujours capable de fournir des performances acceptables une fois chargée.
Conclusion
Le kit de développement Jetson AGX Orin offre des performances significatives dans un format compact. Alors que les solutions PC AI deviennent de plus en plus pertinentes, la plate-forme Jetson se démarque, en particulier si l'on considère les limitations TOPS des NPU intégrés dans les nouvelles versions de CPU. Le Jetson AGX Orin constitue un tremplin robuste pour les développeurs, en particulier ceux qui ont besoin d'applications natives ARM, facilitant la validation et le raffinement des modèles.
Bien qu'il s'agisse d'un kit de développement, sa facilité d'utilisation et sa grande puissance en font un excellent point de départ pour les entreprises qui se lancent dans l'aventure de l'IA. La plate-forme Jetson présente l'immense potentiel des solutions d'IA à petit facteur de forme : conçues avec élégance, extrêmement économes en énergie et capables de fournir 275 TOPS de performances d'IA. Cette combinaison rend la plate-forme Jetson comparable à des serveurs IA montés en rack beaucoup plus grands.
Les guides complets de NVIDIA simplifient le processus de flashage et de déploiement d'une variété de modèles d'IA, l'IA générative n'étant qu'une pièce du puzzle. Pour les entreprises prêtes à développer et à déployer l'IA, le kit de développement Jetson AGX Orin offre un mélange parfait d'efficacité énergétique, de faible encombrement et de performances d'IA exceptionnelles, ce qui en fait un choix idéal pour explorer et mettre en œuvre des technologies d'IA.


 Amazon