

Il ne se passe pas une semaine sans qu'un fournisseur informatique nous parle de l'impact de ses solutions sur les organisations impliquées dans l'intelligence artificielle, l'apprentissage en profondeur, l'apprentissage automatique ou l'intelligence de pointe. Cependant, le problème est qu'il n'y a pas d'informations matérielles sur l'impact de ces solutions sur les performances de chacune de ces tâches. Récemment, nous avons décidé de voir si nous pouvions faire quelque chose à ce sujet en nous associant à byteLAKE, un constructeur de solutions d'IA et de HPC basé en Pologne. L'objectif principal étant d'évaluer l'impact du stockage et du GPU sur les charges de travail de l'IA.
Impact du stockage sur l'IA
Au départ, nous souhaitions explorer l'hypothèse répandue selon laquelle le stockage local influence les performances des modèles d'IA. Nous avons utilisé un serveur Dell EMC PowerEdge R740xd de notre laboratoire, configuré avec deux processeurs Intel Xeon Gold 6130 et 256 Go de mémoire vive. Nous avons exécuté le test d'IA byteLAKE avec trois solutions de stockage local différentes : un SSD KIOXIA PX04S (ancien modèle), ainsi que les SSD Samsung 983 ZET et Intel Optane 900P , beaucoup plus rapides.
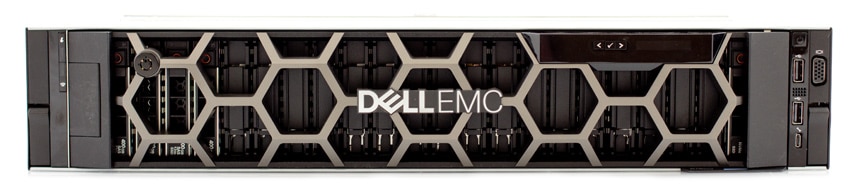
Lors de l'évaluation comparative, nous avons analysé les performances du processus d'apprentissage de l'IA. Les tests ont simulé un scénario réel, en l'occurrence l'entraînement d' EWA Guard , un produit byteLAKE . Ce dernier repose sur la dernière version de YOLO (You Only Look Once), un modèle de détection en temps réel de pointe. Il se compose d'une couche d'entrée unique, de 22 couches de convolution, de 5 couches de pooling, de 2 couches de routage, d'une couche de réorganisation et d'une couche de détection.
Comme métrique de base de la performance, nous avons utilisé le temps d'exécution de la formation pour 5000 époques. Les benchmarks ont été répétés trois fois pour chaque configuration de stockage, et les valeurs moyennes sont présentées ci-dessous.
Résultats:
- KIOXIA 98h 24m
- Samsung 98h 44
- Intel 98h 42
Comme le montrent clairement les données, le stockage local n'a eu aucun impact sur les performances. Les tests allaient d'un SSD SATA au dernier et meilleur Optane, sans aucun impact. Cela dit, le stockage peut jouer un rôle plus important en ce qui concerne l'entrée et la sortie des données, mais en termes de calcul pour l'IA, dans ce cas, il n'y a eu aucun impact.
Impact du GPU et du stockage sur l'IA
Avec les données de stockage en main, nous avons ajouté un seul NVIDIA T4 au PowerEdge pour évaluer l'impact d'un GPU sur l'IA. Pour ce test, nous avons également exécuté les trois mêmes configurations de stockage.
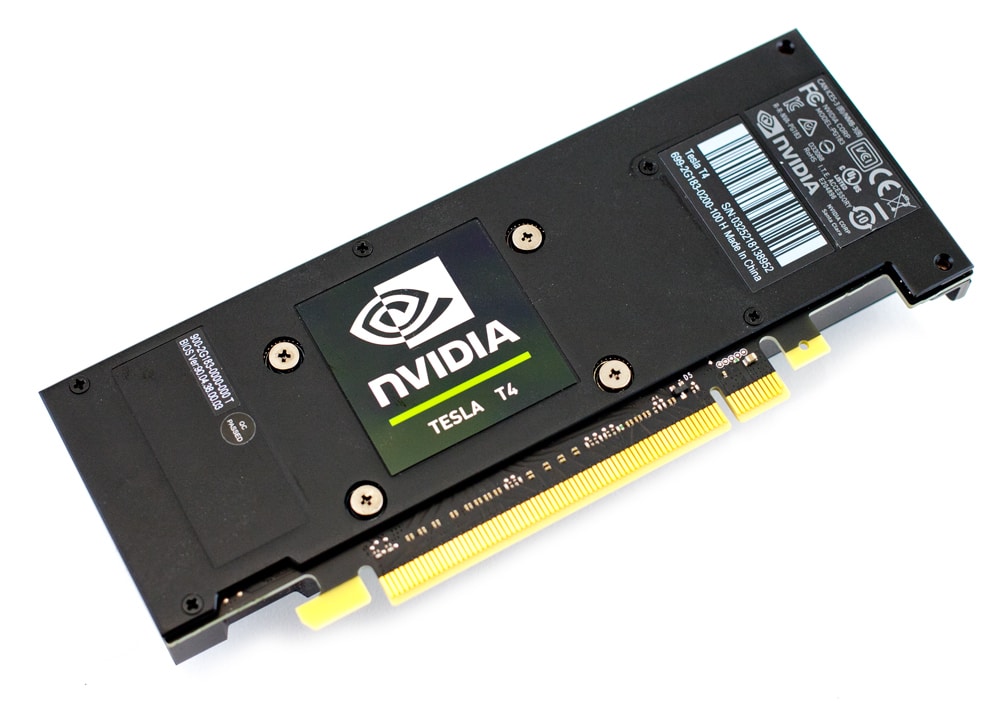
Résultats:
- KIOXIA 4h 30
- Samsung 4h 28min
- Intel 4h 27min
Comme prévu, le GPU a eu un impact, un impact exponentiel en fait, entraînant une amélioration de 22 fois. Le GPU accélérant les performances globales de l'IA, certains ont pensé que le stockage plus rapide pourrait avoir un impact. Ce n'était cependant pas le cas car le disque SATA était en ligne avec le NVMe haute vitesse.
Conclusions
Dans ce test, nous avons constaté que l'utilisation de périphériques de stockage plus rapides n'améliorait pas les performances d'apprentissage. La principale raison ici est une structure complexe du modèle d'IA. Le temps d'apprentissage est plus long que le temps de lecture des données. Autrement dit, le temps d'apprentissage à partir du lot d'images courant est plus long que le temps nécessaire à la lecture du suivant. Par conséquent, les opérations de stockage sont cachées derrière les calculs de l'IA.
Lors de l'ajout du NVIDIA T4, certains pensaient qu'un traitement plus rapide par l'IA inciterait le stockage à avoir un impact sur les performances. Ce n'était pas le cas dans ce test, car même avec le T4, le modèle d'IA avait toujours une composante d'apprentissage plus lourde et ne nécessitait pas de stockage pour être particulièrement rapide.
Bien qu'il reste du travail à faire pour tester davantage l'impact de composants et de systèmes spécifiques sur l'IA, nous pensons que ces données initiales sont utiles et constituent un bon point de départ pour la conversation. Nous avons besoin de données d'application pour pouvoir mieux comprendre où se trouvent les bons leviers d'un point de vue informatique et où les dépenses budgétaires peuvent produire les résultats les plus percutants. Bien entendu, cela dépend également en grande partie de l'endroit où cette activité a lieu, que ce soit dans le centre de données ou à la périphérie. Pour l'instant, nous saluons l'engagement de byteLAKE et d'autres à la pointe de la lance de l'IA pour aider à fournir des données utiles pour aider à répondre à ces questions pressantes.
Il s'agit de notre premier test d'IA, mais certainement pas du dernier. Mariusz Kolanko, cofondateur de byteLAKE, a indiqué qu'ils travaillaient sur un produit nommé CFD Suite (IA pour la dynamique des fluides numérique « CFD » afin d'accélérer les solveurs), dont le processus d'apprentissage profond nécessite une grande quantité de données à chaque itération d'entraînement. Ce modèle pourrait en effet engendrer une charge de stockage plus importante pour l'entraînement des modèles dans le domaine du Big Data et impacter les performances du processus d'apprentissage profond lui-même. En définitive, comme pour toute application, il est essentiel de bien comprendre ses besoins afin d'allouer les ressources appropriées du centre de données. L'IA n'est clairement pas une solution universelle.



 Amazon