

AMD ha annunciato Instinct MI350P, un acceleratore PCIe pensato per le aziende che desiderano l'inferenza AI on-premise senza dover ricostruire il proprio data center. La scheda ha un design a doppio slot, a tutta altezza e lunghezza, ed è progettata per server standard con raffreddamento ad aria. È anche la prima volta in quasi quattro anni che AMD integra un chip Instinct di ultima generazione in un fattore di forma compatibile con i server tradizionali.
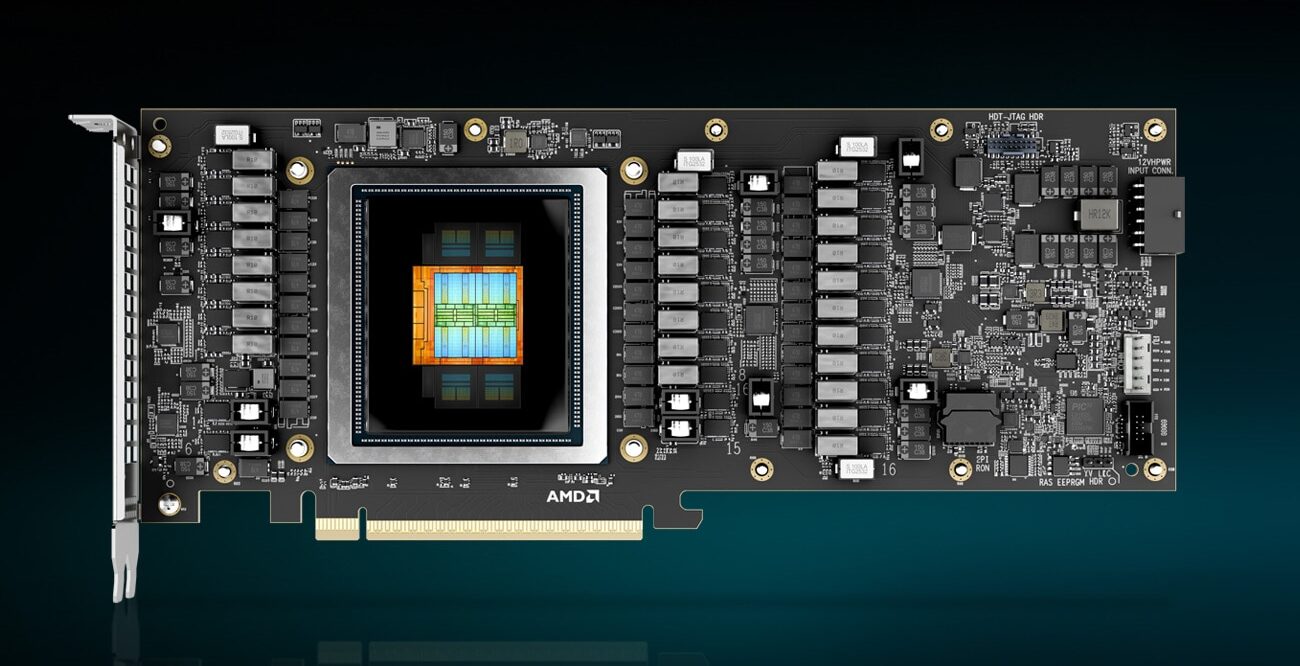
La linea PCIe Instinct era praticamente scomparsa dopo il lancio della MI210 all'inizio del 2022. Ogni generazione successiva (MI300X, MI325X e la OAM MI350X) è stata un modulo con socket OAM su una Universal Baseboard, che richiedeva uno chassis appositamente progettato con alimentazione e flusso d'aria adeguati per otto acceleratori da 1,000 W in un singolo alloggiamento. Questo funziona per i grandi operatori che acquistano GPU a rack. Non funziona per un'azienda che desidera l'inferenza on-premise ma non può o non vuole investire in un rack AI personalizzato. La MI350P colma questa lacuna e, al momento, NVIDIA non ha una scheda PCIe per server di fascia alta nella stessa categoria, quindi AMD detiene il monopolio del segmento per ora.
Hardware: MI350P vs. MI350X OAM
Il MI350P non è una versione selezionata del MI350X. AMD ha progettato un chip più piccolo appositamente per questo modello. Il MI350X ospita due die I/O, ciascuno con quattro die di complessi acceleratori (XCD), per un totale di otto XCD e 256 unità di calcolo. Il MI350P ha un singolo die I/O con quattro XCD e 128 unità di calcolo, la metà del silicio, che opera alla stessa frequenza di picco di 2.2 GHz del suo fratello maggiore. La memoria segue lo stesso schema: quattro stack HBM3E invece di otto, un bus a 4,096 bit invece di un bus a 8,192 bit e 144 GB a 4 TB/s invece di 288 GB a 8 TB/s.
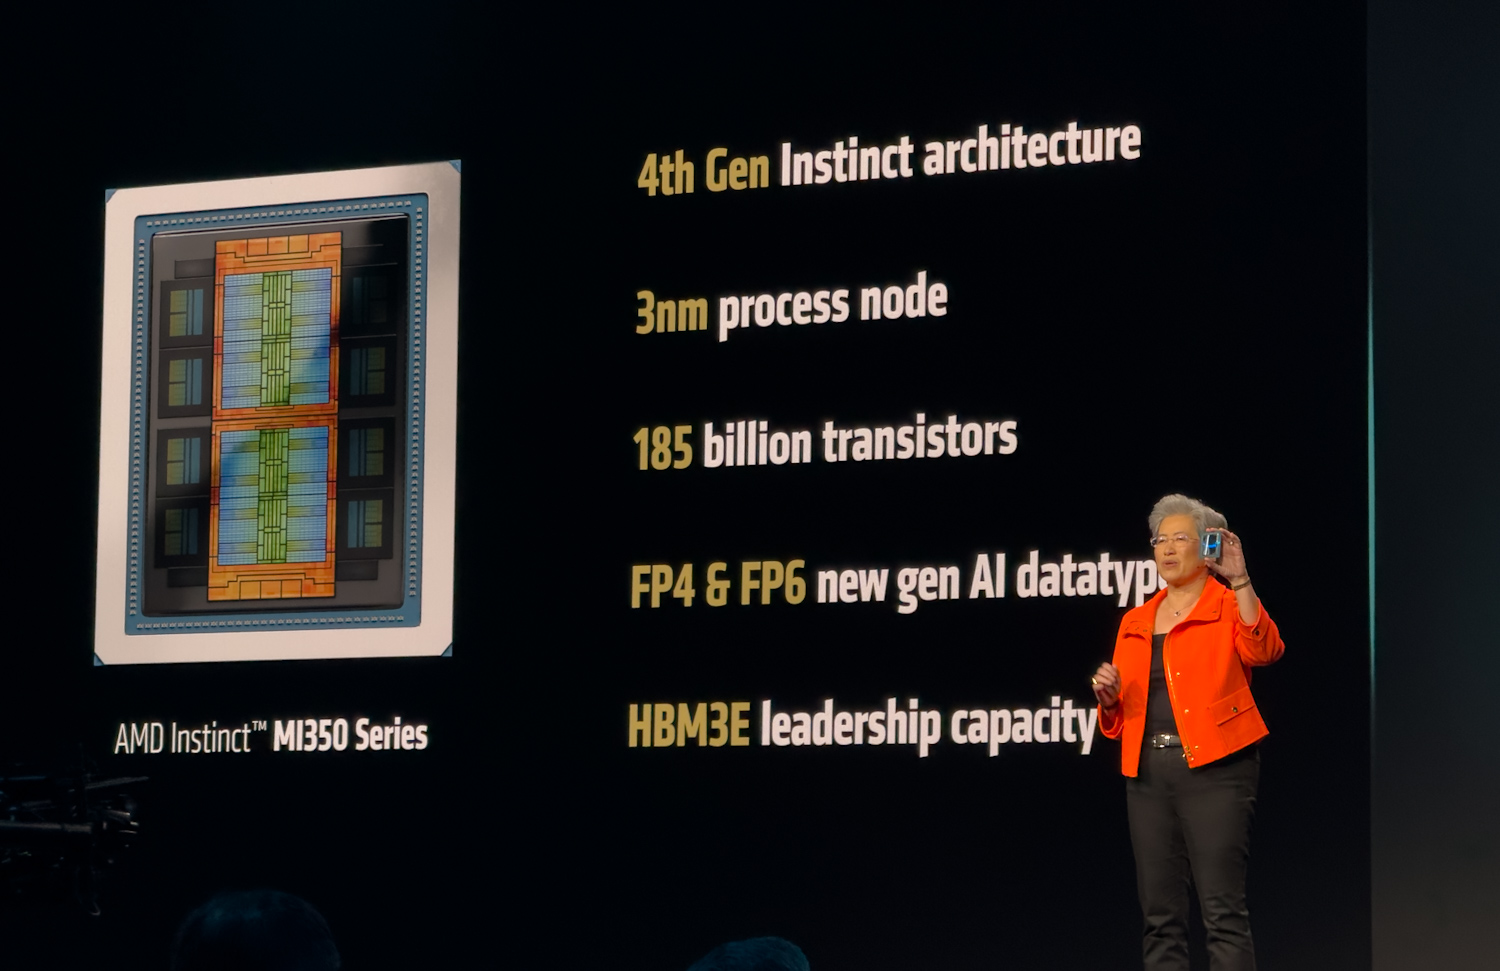
Anche la potenza di calcolo di picco si dimezza. La MI350P raggiunge un massimo di 4,600 TFLOPS in MXFP4 contro i 9.2 PFLOPS della MI350X e 2,300 TFLOPS in FP8 contro i 4.6 PFLOPS. BF16, FP16 e il resto dello stack di precisione scalano allo stesso modo. È incoraggiante vedere AMD pubblicare i valori effettivi insieme ai picchi. I valori effettivi sono 2,299 TFLOPS in MXFP4, 1,529 TFLOPS in FP8 e 713 TFLOPS in BF16. Questi numeri riflettono ciò che la scheda può effettivamente fare entro un limite di 600 W, dove i limiti elettrici e di larghezza di banda della memoria incidono sui picchi teorici.
Abbiamo avuto modo di testare la piattaforma MI350X tramite il programma Jumpstart di Supermicro e siamo rimasti davvero colpiti dalle sue prestazioni nei carichi di lavoro di inferenza. Non vediamo l'ora di testare la MI350P e vedere come si comporta la variante PCIe nel più tradizionale chassis per server per cui è stata progettata.
| Scheda PCIe AMD Instinct MI350P | ||
|---|---|---|
| Specificazione | Consegnati (FLOPS) | Picco (TFLOPS) |
| Cookie di prestazione | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| Memoria e partizionamento | ||
| Capacità di memoria | 144GB HBM3E | 144GB HBM3E |
| Memoria BW | 3.6 TB / s | 4.0 TB / s |
| Istanze GPU | Fino a 4 da 36 GB ciascuno | Fino a 4 da 36 GB ciascuno |
| Piattaforma | ||
| Decodifica video e JPEG | ||
| Interconnessione di scalabilità GPU | Non supportato | Non supportato |
| Prodotto FF | FHFL a doppio slot raffreddato ad aria | FHFL a doppio slot raffreddato ad aria |
| Potenza totale massima della scheda (TBP) | 600W (450W configurabile) |
600W (450W configurabile) |
| Host PCIe | PCIe x16 Gen 5 a 128 GB/s | PCIe x16 Gen 5 a 128 GB/s |
La potenza non si dimezza del tutto. La MI350P ha un TBP di 600 W, circa il 60% dei 1,000 W della MI350X. 600 W è il limite massimo definito dalle specifiche PCIe CEM, quindi la scheda raggiunge la temperatura massima consentita dallo slot. È disponibile una modalità a 450 W per i case che non possono fornire la potenza o il raffreddamento massimi, con una conseguente riduzione delle prestazioni. Il valore di 600 W colloca inoltre la MI350P nella stessa fascia di prezzo della NVIDIA H200 NVL e della RTX Pro 6000 Server, con cui si confronterà in questo segmento di mercato.
A differenza dell'offerta NVL4 di NVIDIA con l'H200, AMD non espone i collegamenti Infinity Fabric della GPU sul MI350P; tutte le comunicazioni collettive avvengono tramite il collegamento PCIe Gen5 x16 (128 GB/s).
La storia del raffreddamento ad aria a otto GPU
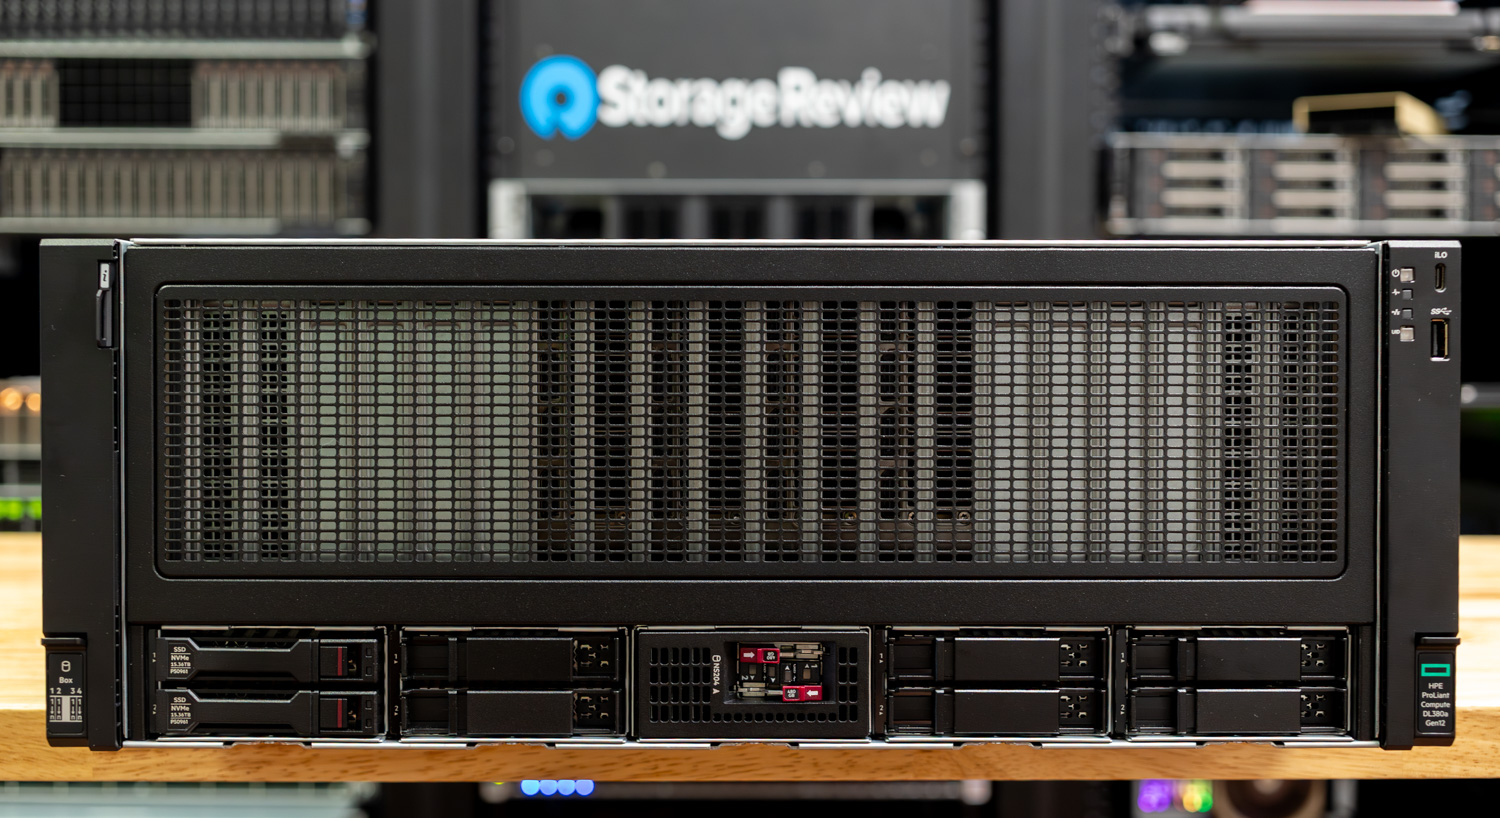
Poiché la MI350P è una scheda PCIe standard a doppio slot, a tutta altezza e a tutta lunghezza, si integra perfettamente nei server già in uso presso le aziende, comprese le piattaforme ad alta densità con otto GPU e raffreddamento ad aria, attualmente offerte dai principali OEM. I modelli Dell PowerEdge XE7740 e HPE ProLiant DL380a Gen12, entrambi già recensiti in precedenza, sono i target ideali. Ciascuno di essi è progettato specificamente per ospitare otto acceleratori FHFL a doppio slot in uno chassis con raffreddamento ad aria, con alimentazione e flusso d'aria già ottimizzati per schede da 600 W. Nessun rack personalizzato, nessun circuito di raffreddamento a liquido, nessuna scheda madre OAM.
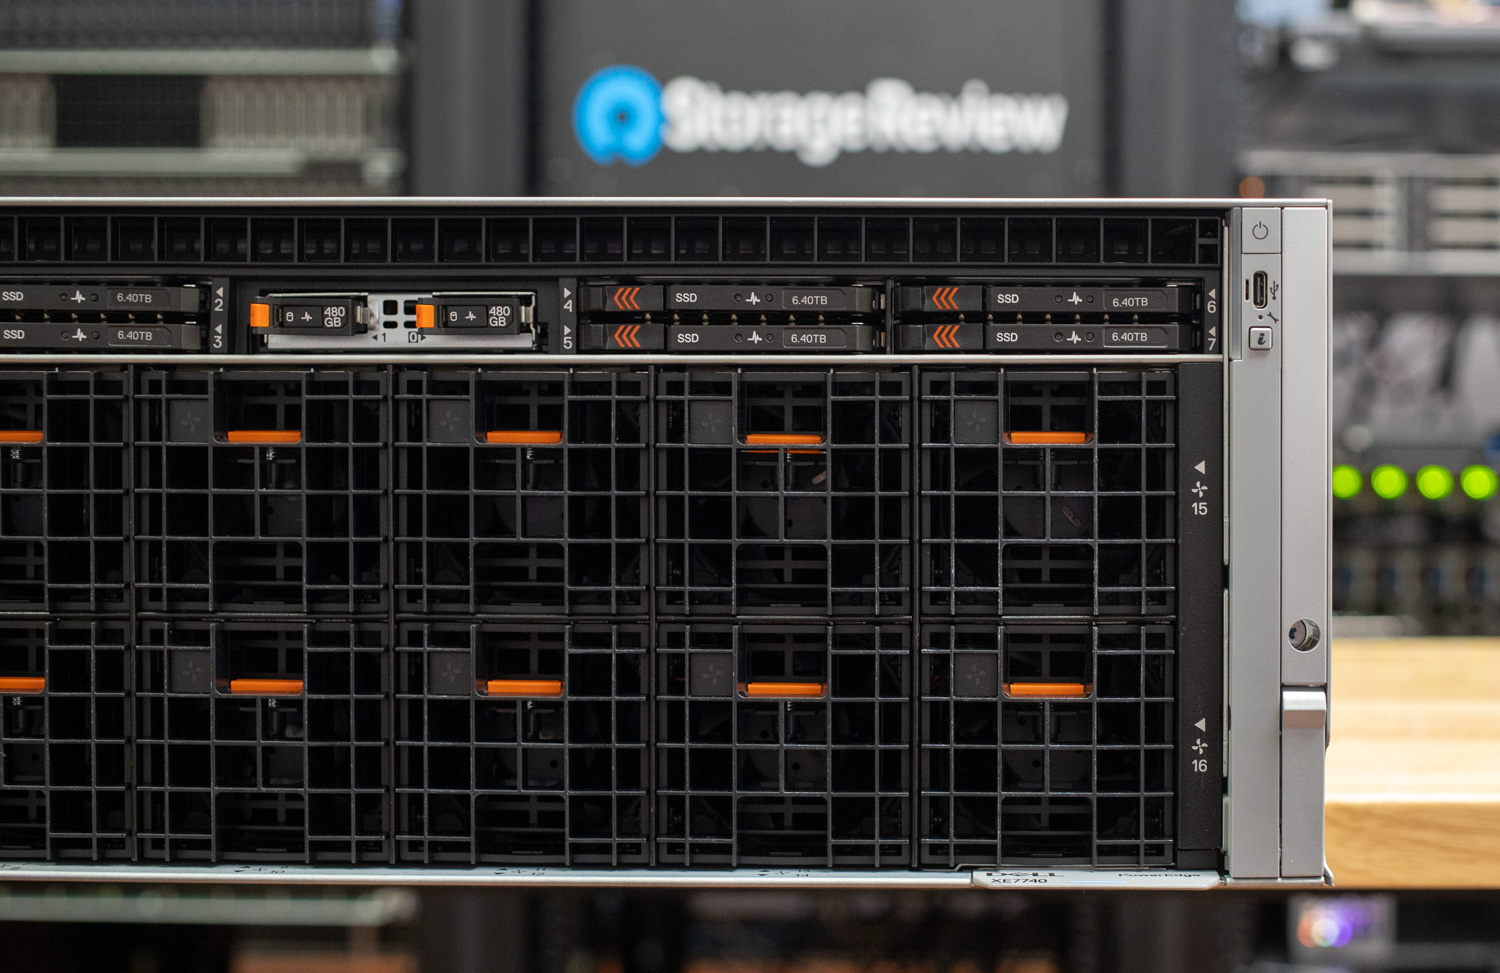
Una configurazione MI350P a otto schede in uno di questi sistemi offre 1,152 GB di HBM3E e una larghezza di banda di memoria aggregata di 32 TB/s in un singolo chassis raffreddato ad aria. Per l'inferenza su modelli open-weight di grandi dimensioni, questo è sufficiente per ospitare un modello con un trilione di parametri su MXFP4 in un singolo chassis. Tuttavia, come accennato in precedenza, il compromesso è l'assenza di un'infrastruttura di scalabilità. Sull'OAM MI350X, le GPU comunicano tramite Infinity Fabric attraverso la Universal Baseboard. Sull'MI350P, ogni comunicazione tra GPU avviene tramite PCIe Gen5 x16 a 128 GB/s, lo stesso percorso utilizzato per raggiungere l'host. Per i carichi di lavoro di inferenza, in particolare con sharding parallelo tensoriale all'interno di un nodo e parallelismo di pipeline o dati tra i nodi, questa soluzione è accettabile. Per l'addestramento strettamente accoppiato, dove la larghezza di banda all-reduce domina il tempo di esecuzione di ogni passo, la piattaforma OAM rimane la soluzione ideale.
Formati di precisione
Vale la pena parlare della precisione, anche se nessuno dei formati supportati dal MI350P è nuovo. Il MI350X offre lo stesso set. Il motivo per cui è comunque importante è che i tipi di dati con scalatura a blocchi OCP (MXFP8, MXFP6, MXFP4) sono diventati lo standard per i laboratori di modellistica all'avanguardia per addestrare e distribuire i modelli. Questi formati consentono ai laboratori di addestrare i modelli con una precisione inferiore con una perdita di qualità minima o nulla, e i vantaggi in termini di inferenza sono immediatamente evidenti.
Una precisione inferiore si traduce in maggiore velocità. MXFP4 è più del doppio più veloce di FP8 e circa quattro volte più veloce di BF16 al picco massimo. Questo incremento di velocità si manifesta nei carichi di lavoro reali. Il rilascio di gpt-oss da parte di OpenAI ha reso evidente l'aumento di throughput, e i modelli di frontiera come Kimi K2.6 vengono addestrati nativamente in INT4, tenendo conto della quantizzazione, fin dall'inizio, anziché essere quantizzati in un secondo momento. L'altro aspetto fondamentale è la memoria. I pesi INT4 e MXFP4 occupano un quarto dello spazio di BF16. Questo significa che modelli con trilioni di parametri possono essere gestiti da un singolo sistema con otto GPU. Per un'azienda che desidera ospitare un modello open-weight di grandi dimensioni in locale, la differenza è di un singolo rack rispetto a un cluster multi-nodo con tutta la rete e l'orchestrazione che ciò implica.
Conclusione
La maggior parte delle aziende che valutano soluzioni di intelligenza artificiale on-premise si ritrovano a corto di potenza, raffreddamento, densità di rack o budget prima ancora di esaurire la capacità di calcolo. Una scheda Instinct PCIe che si integra in un'infrastruttura server già esistente aggira i principali di questi vincoli. Attualmente NVIDIA non dispone di una scheda PCIe di punta per server in grado di competere con Instinct, il che lascia ad AMD un dominio incontrastato in questo segmento, almeno finché questa situazione rimarrà tale.
Ulteriori informazioni sono disponibili sulla pagina di AMD Instinct.


 Amazon