

Cerebras Systems ha presentato ufficialmente il CS-4 , la quarta generazione della sua piattaforma di supercalcolo AI su scala wafer, progettata per l'addestramento di modelli di frontiera e carichi di lavoro di inferenza ad alta concorrenza. Il sistema è basato su tre processori Wafer Scale Engine 3 (WSE-3) Turbo di nuova concezione, alloggiati in una piattaforma rack-scale Nexus completamente riprogettata. Cerebras afferma che il sistema offre prestazioni di inferenza fino a 30 volte superiori rispetto alle soluzioni basate su GPU, un dato che l'azienda basa sullo standard GPT-OSS-120B , dove cita oltre 4,400 token al secondo per utente, insieme a un aumento di 10 volte del throughput per watt rispetto alla precedente generazione CS-3.
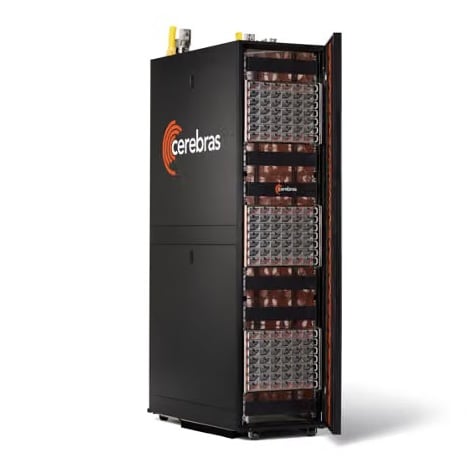
Il CS-4 è progettato per affrontare le limitazioni di scalabilità sistemiche intrinseche ai cluster GPU multi-nodo discreti, dove la comunicazione tra chip, le perdite di conversione di potenza e i limiti termici spesso riducono l'efficienza di calcolo sostenuta. Cerebras posiziona la piattaforma in modo da servire entrambi gli estremi dello spettro dei carichi di lavoro di inferenza, fornendo i tempi di risposta inferiori al millisecondo richiesti per flussi di lavoro complessi basati su agenti e ragionamento interattivo, e al contempo offrendo la capacità aggregata di cui gli hyperscaler hanno bisogno per massimizzare la densità di calcolo per gigawatt.
I miglioramenti all'infrastruttura di interconnessione sono fondamentali per le capacità di scalabilità multi-processore della piattaforma. Il CS-4 riduce la latenza di interconnessione tra wafer fino a soli 2 microsecondi, consentendo alle infrastrutture multi-wafer di operare con una coesione pressoché monolitica. Questa infrastruttura a bassissima latenza permette al CS-4 di sostenere velocità di generazione superiori a 1,000 token al secondo su modelli con oltre 10 trilioni di parametri, colmando il divario prestazionale storico in cui l'aumento del numero di parametri comprometteva seriamente la velocità di consegna dei token interattivi.

Architettura Nexus Rack e zaino su scala wafer
Una delle principali innovazioni ingegneristiche del CS-4 è la Cerebras Nexus Platform Architecture, un'implementazione modulare per rack basata su domini indipendenti per il calcolo, l'alimentazione e l'I/O. La densità di calcolo è garantita da un nuovo Wafer-Scale Backpack, montato posteriormente e collegato verticalmente all'array di alimentazione principale. Ogni Backpack è un'unità autonoma che ospita collettori di raffreddamento a liquido diretti al chip, stadi di conversione di potenza point-of-load, percorsi di rete ad alta velocità ed elettronica di controllo integrata, posizionati direttamente dietro il wafer di silicio. Isolando il livello di calcolo principale dal telaio di distribuzione dell'alimentazione, Cerebras ha ridotto del 50% il numero di componenti del sistema, aumentato del 60% l'assemblaggio automatizzato e compresso i tempi di implementazione nei data center a poche ore.

L'efficienza dell'erogazione di energia è stata migliorata riposizionando i moduli di regolazione della tensione CC-CC 100 volte più vicini al confine del silicio rispetto alle implementazioni tipiche delle schede server. Questa disposizione point-of-load riduce le perdite resistive della rete di distribuzione dell'alimentazione (PDN) e consente al telaio Nexus di fornire il doppio dell'energia a ciascun processore WSE-3 Turbo, permettendo frequenze di clock sostenute più elevate senza throttling termico.

Il sottosistema I/O è stato inoltre ampliato con un modulo I/O Wafer programmabile che raddoppia la larghezza di banda del fabric da bordo a bordo, riducendo al contempo la latenza di transito. La rete di sistema opera in due modalità: interfacce RoCE v2 standard (RDMA su Ethernet convergente) per la connessione a bassa latenza del fabric alle reti aziendali legacy e ai nodi acceleratori di terze parti, e collegamenti proprietari Direct Wafer Links che forniscono percorsi di interconnessione diretti e senza switch tra sistemi adiacenti all'interno e tra i rack.
Specifiche dei turbocompressori CS-4 e WSE-3
| SISTEMA CS-4 | |
| Architettura | Rack di alimentazione attivo con tre moduli di elaborazione modulari |
| Motori su scala wafer | 3 turbocompressori WSE-3 per sistema |
| Calcolo dell'intelligenza artificiale | 750 PFLOPS* |
| Banda di memoria | 129.6 PB/s |
| Larghezza di banda del tessuto su chip | 160.5 PB/s |
| Larghezza di banda I/O | 7.2 Tbit/s |
| Latenza I/O | 2 microsecondi |
| WSE-3 TURBO (PER WAFER) | |
| Transistor / Silicio | 4 trilioni di transistor; 46,225 mm2, TSMC 5nm |
| Core AI / SRAM su chip | 900,000 core; 44 GB di SRAM |
| Calcolo dell'intelligenza artificiale | 250 PFLOPS* |
| Banda di memoria | 43.2 PB/s |
| Larghezza di banda del tessuto su chip | 53.5 PB/s |
| Larghezza di banda I/O | 2.4 Tbit/s |
| *Calcolo AI mostrato come sparso FP16 | |
Inferenza disaggregata e disponibilità
Dal punto di vista architetturale, il CS-4 è progettato con supporto nativo per topologie di inferenza disaggregate. Negli ambienti aziendali e cloud, gli operatori possono disaccoppiare le fasi computazionali dell'inferenza utilizzando acceleratori di precaricamento esterni specializzati, come AMD Helios o AWS Trainium, per acquisire i contesti dei prompt e costruire gli stati del modello. La cache KV, vincolata al calcolo, viene quindi instradata tramite collegamenti ad alta velocità alla vasta infrastruttura SRAM del CS-4 per la generazione di token autoregressivi a bassissima latenza.
Cerebras ha confermato che le prime implementazioni e spedizioni della piattaforma CS-4 inizieranno in questo trimestre.


 Amazon