

Al Summit globale OCP del 2025, Intel ha posto l'accento sull'inferenza AI svelando due innovazioni chiave: una nuova GPU per data center chiamata "Crescent Island" e un progetto di riferimento rack-scale per Gaudi 3. Entrambi gli sviluppi sono in linea con la crescente transizione dall'addestramento dei modelli all'inferenza diffusa in tempo reale, in cui fattori quali latenza, larghezza di banda della memoria, efficienza e semplicità operativa sono ora cruciali.
Dall'addestramento statico all'inferenza pervasiva in tempo reale
Il CTO di Intel, Sachin Katti, ha riassunto la transizione osservando che, con la crescente diffusione dell'intelligenza artificiale agentiva, l'inferenza diventa continua, ricca di contesto e sempre più intensiva a livello di sistema. Per gestire i crescenti volumi di token, le complesse combinazioni di modalità e i rigorosi requisiti SLA, diventa necessaria un'infrastruttura eterogenea che combini silicio ottimale con uno stack software aperto e incentrato sugli sviluppatori. In questo ambiente, le GPU per data center con architettura Xe di Intel offrono la capacità e l'affidabilità necessarie all'aumentare della lunghezza delle sequenze e della frequenza dei token, mentre Gaudi 3 supporta un ecosistema di inferenza aperto e scalabile con un costo totale di proprietà (TCO) prevedibile.
Il punto chiave non è semplicemente "chip più veloci". Il successo dell'inferenza dipende dall'integrazione dei sistemi: memoria con riconoscimento della topologia, interconnessioni flessibili, alimentazione e raffreddamento che corrispondono ai profili di utilizzo e orchestrazione che tratta modelli, token e flussi come cittadini di prima classe. Le aziende non vogliono essere bloccate proprio nel momento in cui devono iterare tra modelli, framework e stack di servizio.
Che abbraccia PC, Edge e Data Center
Intel sostiene di essere in una posizione unica per offrire una soluzione end-to-end completa, con PC AI, edge computing industriale e rack per data center basati su CPU Xeon 6, acceleratori Gaudi 3 e GPU Intel. I temi comuni includono:
- La flessibilità PCIe nella diversità consente il riutilizzo delle impronte esistenti quando opportuno e, se necessario, consente il ridimensionamento a rack incentrati sulla struttura.
- I design rack-scale garantiscono prestazioni per watt prevedibili e includono opzioni di raffreddamento a liquido quando i requisiti termici e di elevata densità lo richiedono.
- Una piattaforma software completa e integrata volta a garantire uno sviluppo senza interruzioni su vari tipi di silicio e livelli di distribuzione.
La partnership con OCP supporta la preferenza dell'azienda per progetti aperti e referenziabili, più facili da acquisire, convalidare e scalare nelle operazioni.
Crescent Island: una GPU per data center ottimizzata per l'economia inferenziale
Crescent Island è la prossima GPU Intel per data center progettata per server aziendali raffreddati ad aria che necessitano di un elevato throughput di token senza richiedere soluzioni avanzate di alimentazione o raffreddamento. Il suo obiettivo è pratico: dare priorità all'efficienza dei costi e alle prestazioni energetiche, offrendo al contempo la capacità di memoria e la larghezza di banda essenziali per le moderne attività di inferenza.
I punti culminanti includono:
- Microarchitettura Xe3P focalizzata sulle prestazioni per watt. Questo si allinea bene con l'inferenza in stato stazionario, dove l'utilizzo è sostenuto e la sensibilità ai costi è elevata.
- Memoria LPDDR5X da 160 GB su scheda. Per il servizio LLM/RAG, la sintesi di contesti lunghi e le pipeline multimodali, la capacità di memoria e la larghezza di banda spesso influenzano i QPS e la latenza di coda più del TOPS grezzo.
- Ampio supporto per tipi di dati, progettato pensando ai provider di "token-as-a-service". La flessibilità di precisione mista/quantizzazione è fondamentale per ridurre la produttività preservando l'accuratezza per gli endpoint di produzione.
- Software pronto all'uso grazie allo stack aperto e unificato di Intel. L'ottimizzazione anticipata sulle GPU Arc Pro B-Series mira a semplificare i flussi di lavoro degli sviluppatori e a ridurre al minimo le difficoltà legate al porting.
- Cronologia: il campionamento dei clienti per Crescent Island è previsto per la seconda metà del 2026. Per gli acquirenti che pianificano cicli di aggiornamento 2026-2027, ciò offre una finestra pratica per testare fin da ora lo stack software e i modelli di servizio.
Crescent Island si basa sull'economia dell'inferenza su larga scala. È raffreddato ad aria, orientato alla capacità e focalizzato su prestazioni/W. Supponiamo che i carichi di lavoro siano dominati da un servizio basato su token con SLO di latenza rigorosi. In tal caso, i 160 GB integrati e i tipi di dati efficienti dovrebbero tradursi in un maggior numero di sessioni simultanee per watt e in un minor numero di sorprese a livello di cluster man mano che la lunghezza delle sequenze aumenta.
Gaudi 3: Rack-Scale referenziabile per modelli di grandi dimensioni e inferenza in tempo reale
Gaudi 3 si estende dalle implementazioni PCIe alle configurazioni complete su scala rack, offrendo un percorso di scalabilità senza imporre una scelta architetturale immediata. Il nuovo design di riferimento su scala rack è pensato per le aziende che standardizzano l'inferenza di modelli di grandi dimensioni e i sistemi in tempo reale critici per la latenza.
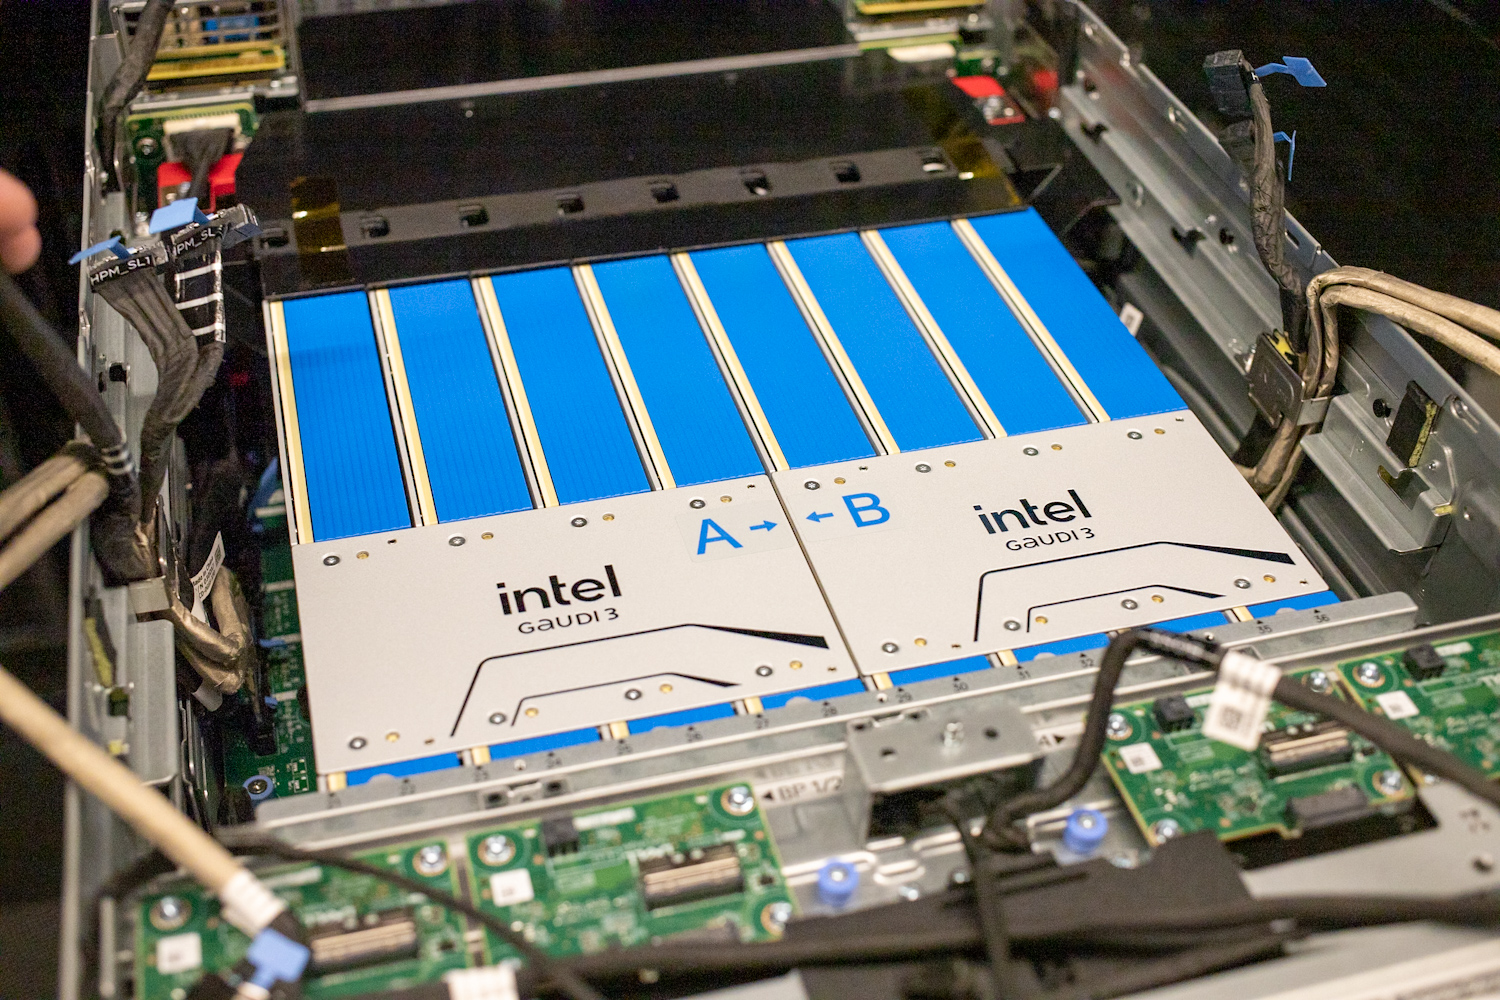
Elementi chiave:
- La sequenza PCIe-rack inizia con le schede PCIe nei server attuali e si estende ai rack, in base alle dimensioni del modello, alla concorrenza e ai profili SLA. Questo approccio, una strategia aziendale comune, contribuisce a ridurre al minimo i rischi del progetto.
- Supporta fino a 64 acceleratori per rack con 8.2 TB di memoria ad alta larghezza di banda. La funzionalità chiave, il dominio di memoria (HBD), consente più parametri e contesti di memoria più lunghi, con conseguenti minori cali di prestazioni e una latenza finale più costante.
- Le opzioni di raffreddamento a liquido sono essenziali per le densità degli acceleratori in cui il solo raffreddamento ad aria limita l'inferenza sostenuta.
- L'orchestrazione prevede uno stack software aperto, come Kubernetes, server modello standard e framework diffusi, che semplifica l'integrazione con le architetture MLOps e service-mesh esistenti.
Nell'inferenza di produzione, fattori come la topologia della memoria e la gestione termica uniforme superano le massime prestazioni teoriche. Il rack Gaudi 3, che dispone di 8.2 TB di HBM su 64 acceleratori, soddisfa esigenze pratiche come il caricamento di più varianti di grandi dimensioni, la gestione di prompt lunghi e la gestione di burst senza causare thrashing. Il raffreddamento a liquido non è solo opzionale a queste densità; è essenziale per mantenere QPS e latenza in condizioni di stress termico.
timeline
- Software : Lo stack software unificato e aperto di Intel è in fase di preparazione sulle GPU Arc Pro B-Series per offrire agli sviluppatori una finestra iniziale per l'ottimizzazione e l'integrazione CI/CD.
- Isola Mezzaluna: Campionamento dei clienti previsto per il secondo semestre del 2026. Valutazioni del piano in base alla preparazione del software, ai profili di servizio basati sulla memoria e ai vincoli dei data center raffreddati ad aria.
- Gaudi 3 rack: I progetti di riferimento specificano fino a 64 acceleratori/rack, 8.2 TB di HBM e raffreddamento a liquido, allineando le strutture e gli involucri di alimentazione/raffreddamento in anticipo con i team DC/colo.


 Amazon