

MLPerf Inference v5.1 offre benchmark rigorosi per l'inferenza AI su LLM, visione artificiale e attività multimodali. Ecco l'analisi tecnica dei risultati di Blackwell Ultra di NVIDIA e dei risultati di Instinct MI300X/MI325X/MI355X di AMD. Include dati di benchmark dettagliati, ottimizzazioni software, strategie architetturali e implicazioni per hyperscaler e aziende.
Framework di benchmarking MLPerf
I benchmark MLPerf Inference fungono da quadro di valutazione per gli acceleratori di intelligenza artificiale, fornendo un metodo standardizzato e comparabile per misurare le prestazioni nella classificazione delle immagini, nei modelli linguistici e nei sistemi di raccomandazione. Per le aziende che implementano GPU su larga scala, questi numeri spesso orientano decisioni di acquisto su larga scala.
L'inferenza MLPerf è gestita da MLCommons e definisce le regole di divisione chiusa e aperta. Gli scenari includono:
- disconnesso: Incentrato sulla produttività (esegui in batch il maggior numero possibile di query).
- server: Inferenza multi-stream conforme alla latenza.
- Interactive: TTFT (Time-to-First-Token) e TPS (token al secondo al 99° percentile) rigorosi.
La suite di carichi di lavoro v5.1 includeva:
- DeepSeek-R1: Un modello misto di esperti 671B (test di stress per l'inferenza del ragionamento).
- Llama-3.1-405B e 8B: I più recenti LLM su più modalità di inferenza.
- Sussurro: ASR sostituisce RNN-T.
- Diffusione stabile XL (SD-XL): Intelligenza artificiale generativa da testo a immagine.
- Mixtral, DLRMv2, oltre a carichi di lavoro legacy come ResNet-50.
Quando vengono mostrati i grafici del throughput (token/sec o campioni/sec), in genere evidenziano il continuo dominio di NVIDIA in termini assoluti, soprattutto per GPU. Tuttavia, i progressi di AMD in termini di efficienza relativa e fluidità di scalabilità dimostrano che l'azienda sta riducendo il divario round dopo round, in particolare negli scenari server e nelle implementazioni multi-nodo.
Risultati NVIDIA Blackwell Ultra
I sistemi Blackwell Ultra hanno raggiunto una produttività record su tutti i nuovi carichi di lavoro. Fattori chiave:
- Precisione NVFP4: float personalizzato a 4 bit, con accelerazione di DeepSeek e Llama.
- FP8 KV-cache: risparmio di memoria per i livelli di attenzione.
- Servizio disaggregato: suddivisione del contesto rispetto alle fasi di generazione su 72 GPU tramite NVLink da 1,800 GB/s.
- Software: grafici CUDA, TensorRT-LLM, ADP Balance.
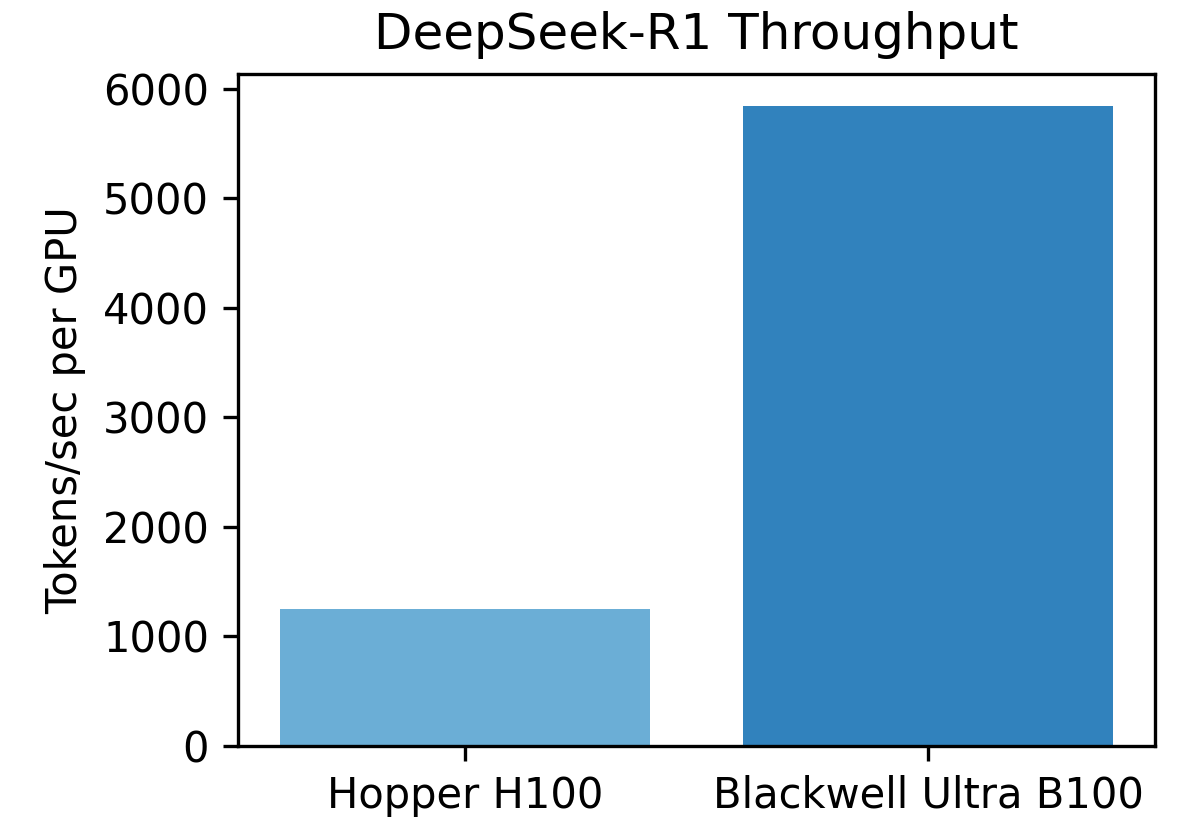
Il grafico a barre sottostante, che mette a confronto Hopper e Blackwell Ultra per GPU, mostra un aumento del throughput di quasi 5 volte su DeepSeek-R1, a conferma del fatto che i formati di dati a grana fine (NVFP4) e la larghezza di banda a livello di rack scalano linearmente per carichi di lavoro di inferenza di grandi dimensioni. Un altro grafico, incentrato sui risultati record interattivi di Llama-405B, dimostra come NVIDIA utilizzi la struttura NVLink e il servizio disaggregato per mantenere gli SLA di latenza, superando al contempo i precedenti limiti di throughput. Conclusione: NVIDIA rimane il leader del settore per quanto riguarda la velocità pura e i carichi di lavoro sensibili alla latenza.
Risultati AMD Instinct MI300X/MI325X/MI355X
AMD ha puntato su efficienza e flessibilità:
- FP4 su MI355X: offre una produttività Llama-2.7-2B 70 volte superiore rispetto a MI325X FP8.
- Potatura strutturata: Su Llama-405B, la potatura del 21-33% ha ridotto i FLOP senza influire sulla precisione, aumentando la produttività di circa l'82-90%.
- scalata: Scalabilità lineare uniforme comprovata fino a 8 nodi; il primo cluster eterogeneo (4 × MI300X + 2 × MI325X) ha raggiunto un'efficienza di scalabilità del 94%.
- Riproducibilità dell'ecosistema ROCm: I risultati presentati dai partner si collocano costantemente entro l'1-3% dei risultati di AMD.
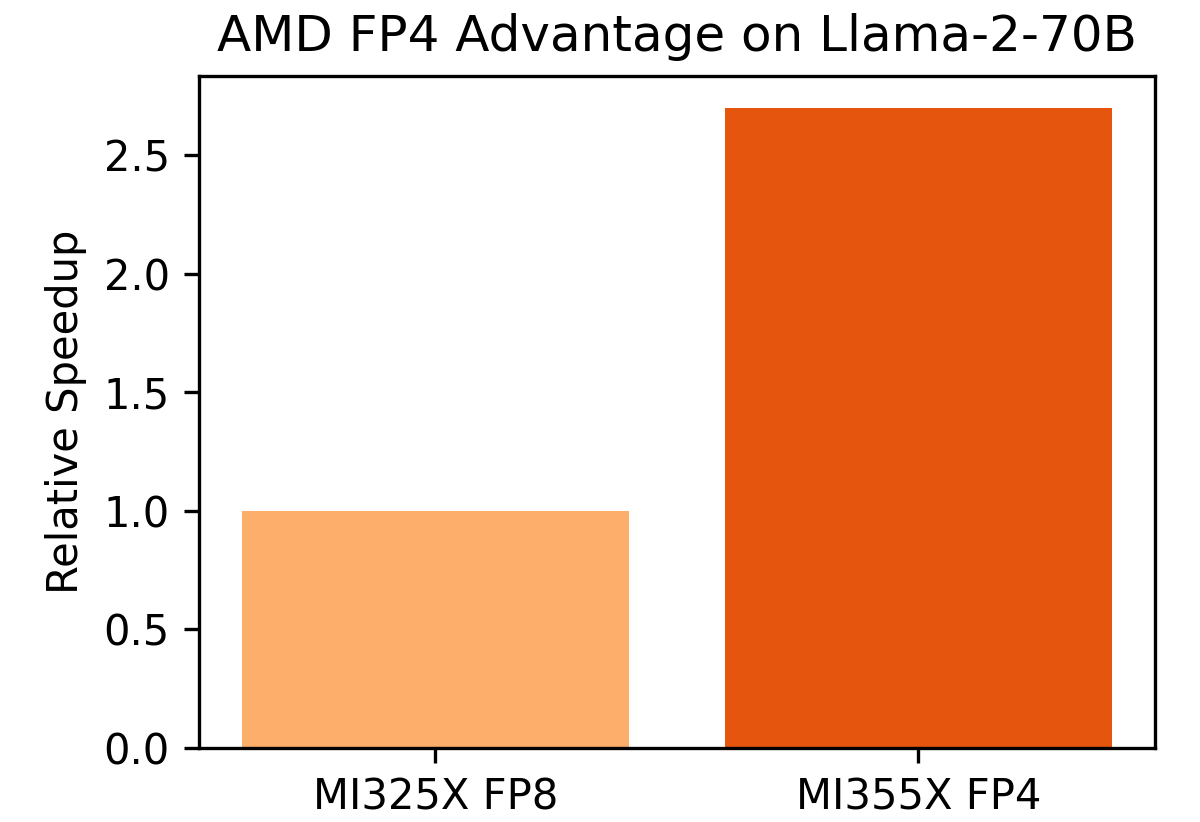
Il grafico soprastante che mostra il confronto tra MI325X FP8 e MI355X FP4 illustra i vantaggi rivoluzionari di FP4, ovvero token/sec più elevati con una perdita di precisione minima, a dimostrazione del fatto che FP4 non è sperimentale ma pronto per l'implementazione.
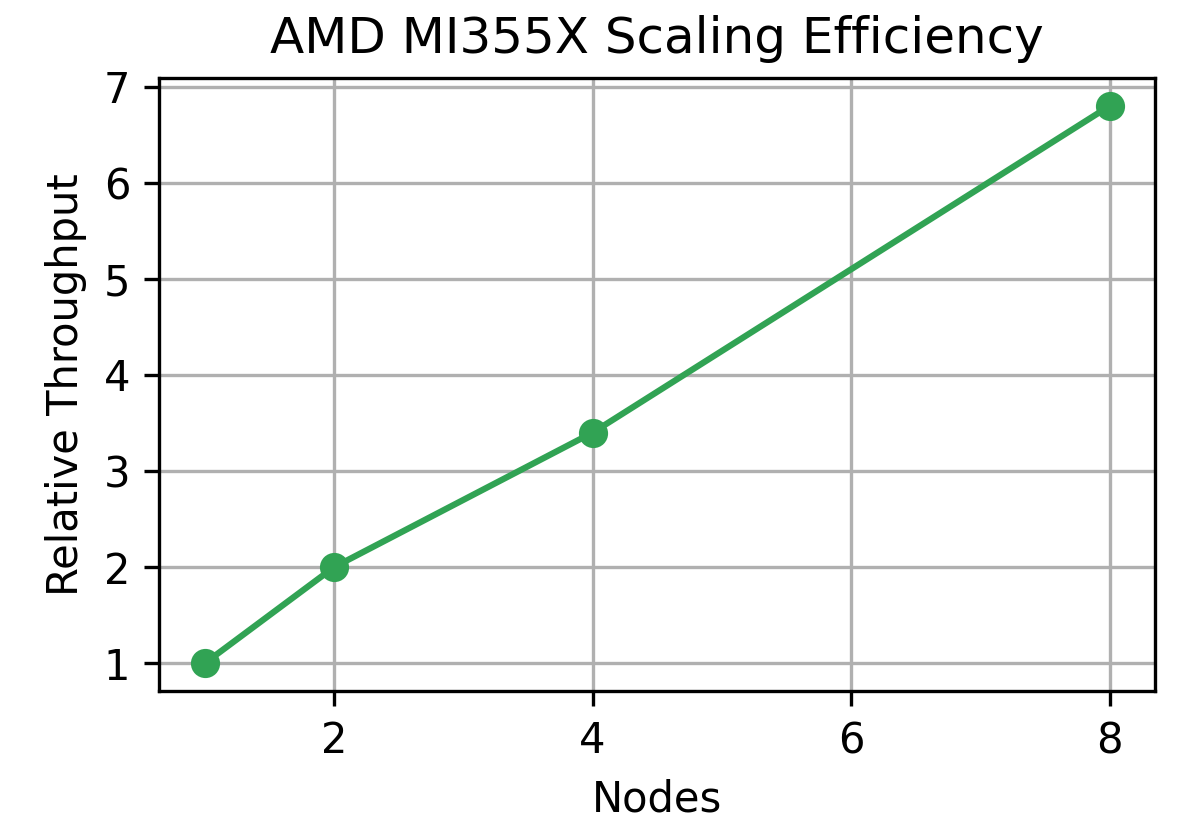
Questo grafico della curva di scalabilità (da 1 a 8 nodi) evidenzia una scalabilità quasi lineare, un aspetto molto apprezzato dai fornitori di servizi hyperscale poiché si traduce in costi di espansione prevedibili. Allo stesso tempo, lo schema di potatura strutturata mostra come l'attenzione di AMD non sia rivolta solo alla potenza bruta dell'hardware, ma anche all'efficienza algoritmica, fondamentale per i cluster di inferenza reali, limitati da potenza e spazio.
Confronto diretto tra AMD e NVIDIA
|
Metrico |
NVIDIA Blackwell Ultra |
AMD MI355X |
Note |
Vincitore |
|
Token/sec per GPU |
5842 (DeepSeek-R1) |
~2200 (FP4 ridimensionato) |
Prestazioni raw NVIDIA più elevate |
NVIDIA |
|
Memoria per GPU |
HBM192e da 3 GB |
HBM288e da 3 GB |
AMD si adatta al modello 520B con GPU singola |
AMD |
|
Supporto di precisione |
FP16, FP8, NVFP4 |
PQ16, PQ8, PQ4 |
Entrambi i cavi a 4 bit |
Tie |
|
Tessuto in scala |
72 GPU NVLink |
Scalabilità del nodo lineare a 8 |
Diverse strategie di scala |
Tie |
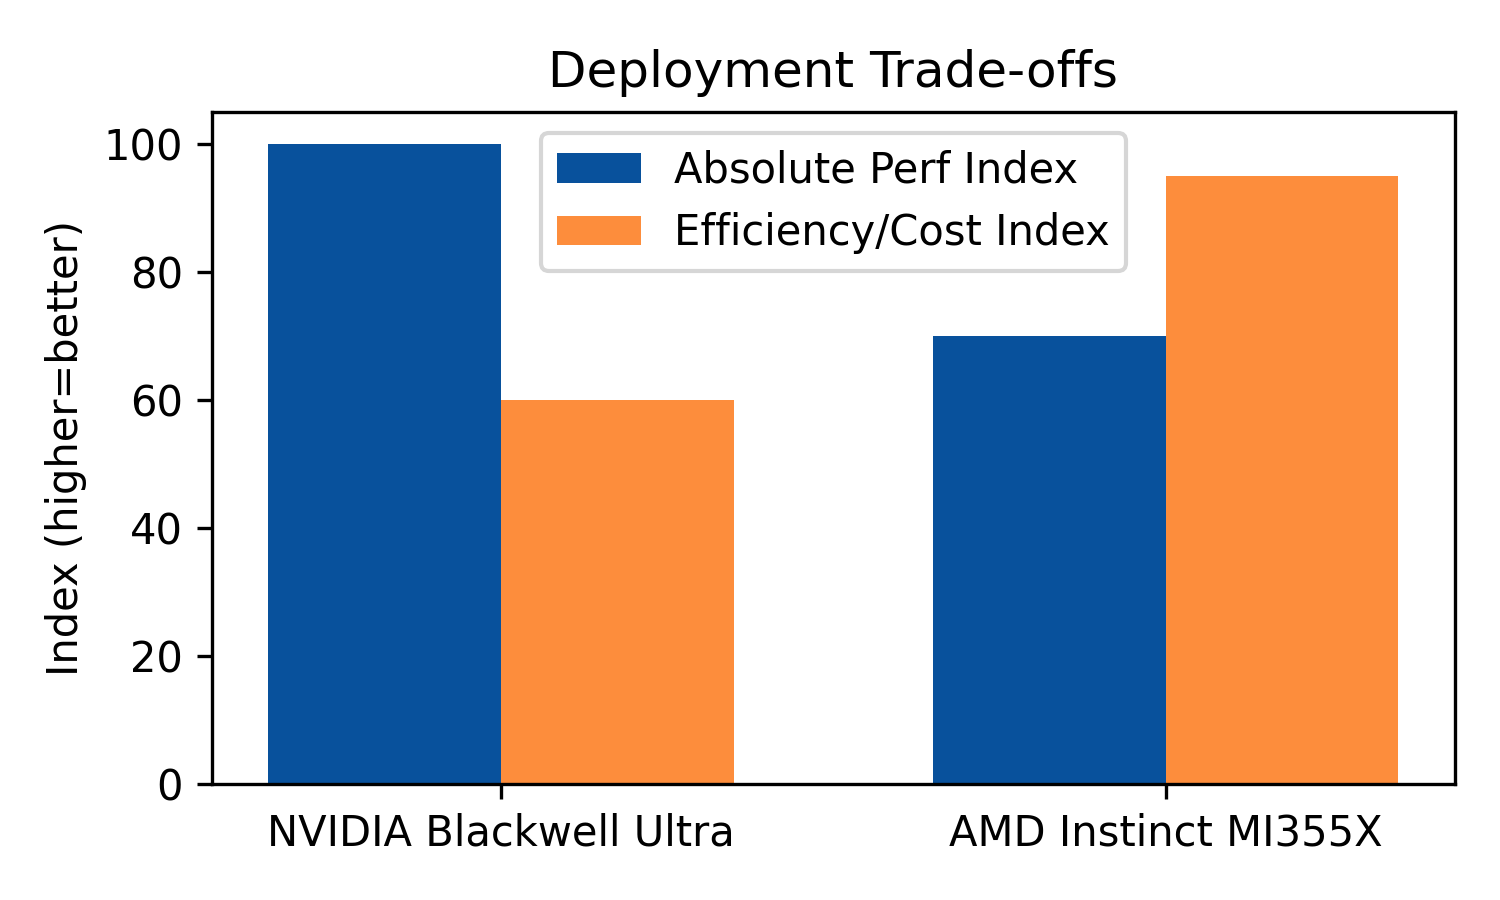
Le visualizzazioni affiancate mettono in risalto i compromessi.
- NVIDIA domina la produttività per GPU, il che la rende ideale per le fabbriche di intelligenza artificiale in cui la densità dei flop è importante.
- AMD, con una memoria più grande (288 GB) e potatura FP4, eccelle nei casi in cui il costo per token e la flessibilità di distribuzione sono fondamentali.
Implicazioni sul settore
- Hyperscaler: NVIDIA rimane lo strumento preferito dalle aziende di intelligenza artificiale che puntano a prestazioni di punta. Le crescenti innovazioni di AMD in termini di efficienza, tuttavia, consentono una scalabilità ottimizzata in termini di costi, utile per bilanciare i carichi di lavoro su più livelli.
- fornitori di cloud: Aspettatevi offerte eterogenee, livelli NVIDIA ad alte prestazioni rispetto ai pod AMD Kubernetes più convenienti.
- Aziende: Potatura strutturata, FP4 e supporto per cluster eterogenei consentono ad AMD di fornire inferenza di modelli 405B+ con un TCO inferiore. Le innovazioni NVIDIA (servizio disaggregato e Dynamo) rimangono vantaggiose per le app sensibili alla latenza (ad esempio, chatbot LLM in tempo reale).
- Prospettive future: Prevediamo l'adozione universale dell'inferenza a 4 bit come base, un uso più ampio di pool di GPU eterogenei e nuovi progetti di sistema, tra cui Rubin CPX di NVIDIA per sequenze lunghe e l'espansione ROCm di AMD per coprire più framework.
NVIDIA continua a dettare il passo in termini di throughput grezzo, con le GPU H200 leader nell'inferenza in ResNet-50 e BERT nei benchmark di divisione chiusa. Detto questo, la MI300 di AMD non è molto indietro, registrando numeri competitivi negli scenari server e offline e mostrando anche forti guadagni in termini di efficienza energetica. La vera novità non è solo che NVIDIA rimane al vertice, ma che AMD ha significativamente colmato il divario rispetto a un solo round di MLPerf fa. Per gli acquirenti, questo significa che i giorni in cui si guardava solo alle GPU green potrebbero essere finiti: il ROCm sta maturando e la MI300 è valida per le implementazioni di inferenza nel mondo reale.


 Amazon