

IBM e NASA hanno rilasciato il NASA-IBM Lunar Foundation Model come open source, uno dei primi modelli di base pubblicamente disponibili creati per lo studio scientifico della Luna. I pesi, una relazione tecnica e il dataset pronto per l'apprendimento automatico su cui è stato addestrato sono disponibili su Hugging Face nella famiglia Prithvi, che già copre l'osservazione della Terra, la meteorologia e l'eliofisica. Il punto di forza è che decenni di dati lunari multi-strumento hanno superato le capacità delle mappe vagliate manualmente e dei modelli specifici per singole attività, e un singolo modello di base pre-addestrato può essere adattato alla mappatura dei crateri, al rilevamento di formazioni vulcaniche e alla prospezione del ghiaccio senza dover ricominciare da capo ogni volta. Nei benchmark interni di IBM e NASA, il modello ha ridotto l'errore quadratico medio nell'individuazione di probabili depositi di ghiaccio fino al 22% rispetto a un modello di riferimento SwinV2-B.
Una dorsale TerraMind su 30 livelli da nove strumenti
Il modello si basa su una versione di TerraMind, il modello di osservazione della Terra sviluppato da IBM con l'Agenzia Spaziale Europea, scelto per la sua capacità di gestire diversi tipi di dati e risoluzioni e di apprendere correlazioni intermodali in grado di colmare valori mancanti o rumorosi. La messa a punto per ogni attività lunare utilizza adattatori a basso rango che mantengono il 90% dei pesi di base congelati, il che contribuisce a mantenere basso il costo di adattamento. Il corpus di addestramento è la parte che, secondo la NASA, non esisteva prima: un dataset unificato e spazialmente allineato di oltre 30 livelli provenienti da nove strumenti di quattro missioni, per un totale di circa 2 milioni di tile di immagini, con oltre 1 milione di immagini da 1 metro e quasi 964,000 immagini multispettrali a 100 metri di risoluzione. Le fonti includono immagini del Lunar Reconnaissance Orbiter della NASA, mappe del campo gravitazionale della missione GRAIL a 20 chilometri per pixel, dati del Lunar Prospector e osservazioni complementari del SELENE/Kaguya della JAXA. La collezione di riferimento, denominata SOMBench, viene fornita insieme al modello.
Ghiaccio, zone vulcaniche e crateri a due diverse scale
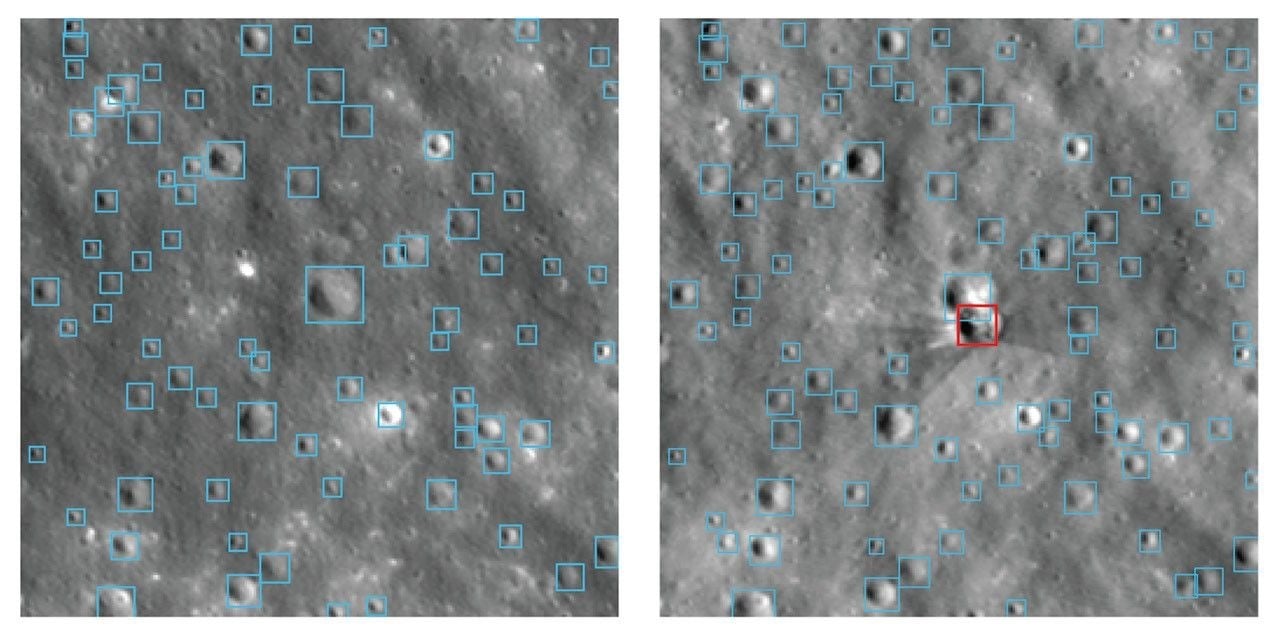
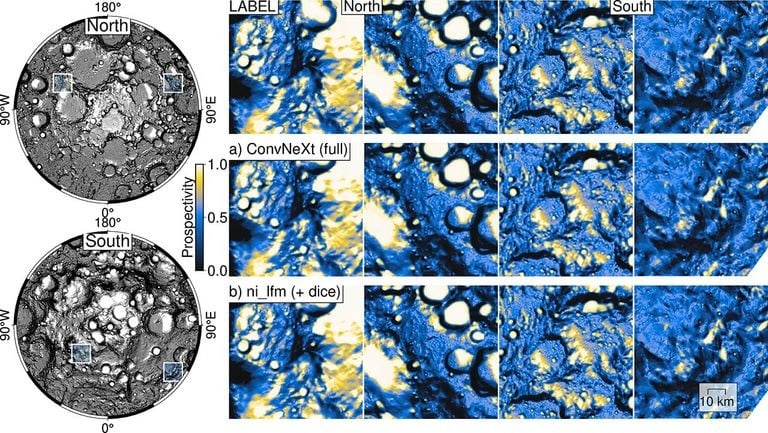
La percentuale del 22% deriva dal compito relativo al ghiaccio, in cui il modello combina osservazioni multimodali e a risoluzione multipla per prevedere dove il ghiaccio potrebbe trovarsi sotto la superficie delle regioni permanentemente in ombra, ovvero i luoghi in cui una futura base lunare estrarrebbe acqua, ossigeno e propellente per razzi. Per quanto riguarda la storia vulcanica, mappa le Irregular Mare Patches con una copertura migliore del 3% rispetto a SwinV2-B, pur essendo addestrato su etichette imperfette, il che, secondo IBM, si traduce in un'accuratezza comparabile a un costo di fine-tuning inferiore. Il rilevamento dei crateri varia in base alla scala: a una risoluzione di un metro il modello eguaglia SwinV2-B, mentre a una scala di contesto di circa 100 metri lo supera di quasi il 19% con la metà dei dati di addestramento. Michael Barker, l'esperto di topografia lunare della NASA che ha co-diretto il progetto, ha affermato che il vantaggio risiede nelle caratteristiche la cui età è ancora oggetto di dibattito: "L'età di queste caratteristiche rimane una questione di grande discussione, quindi più riusciamo a comprenderne la distribuzione e le proprietà, maggiori saranno le possibilità di risolvere questo mistero".
“La NASA ha impiegato decenni per costruire una straordinaria documentazione scientifica sulla Luna, ma la raccolta dei dati è solo una parte del lavoro. Dobbiamo anche rendere i dati più accessibili e fruibili per gli scienziati”, ha affermato Kevin Murphy, responsabile dei dati scientifici e responsabile ad interim dei dati e dell'intelligenza artificiale presso la sede centrale della NASA. Juan Bernabe-Moreno, direttore di IBM Research Europe, UK and Ireland, ha dichiarato che il modello “fornisce agli scienziati una base per esplorare la Luna su larga scala, collegando le osservazioni provenienti da diversi strumenti, rivelando schemi difficili da individuare singolarmente e offrendo una piattaforma aperta su cui la comunità scientifica globale può costruire”.
Ora tutto è disponibile con licenza open-source e il blog di ricerca di IBM illustra in dettaglio i tre casi d'uso iniziali della NASA. Si tratta dello stesso approccio open-source basato sui pesi che IBM ha già utilizzato in ambito aziendale con Granite 4.0 , applicato qui a un settore scientifico in cui la risorsa scarsa è rappresentata dai dati etichettati e dalla potenza di calcolo necessaria per ottimizzarli, e i consumatori immediati sono l'analisi dei rischi per i siti di atterraggio e la ricerca di risorse per una presenza lunare prolungata.


 Amazon