

In occasione dell'OCP Global Summit 2026 di San Jose, XCENA ha presentato due dimostrazioni di inferenza AI basate sulla sua memoria computazionale MX1 CXL: una cache KV condivisa tra server di inferenza tramite un pool di memoria CXL e una ricerca vettoriale per la generazione aumentata del recupero (RAG) eseguita all'interno del dispositivo di memoria. Anche SK hynix ha presentato presso il proprio stand un prodotto di memoria ibrida CXL basato sul chip MX1, e le due aziende stanno collaborando per ottimizzare le prestazioni della memoria condivisa basata su RDMA.
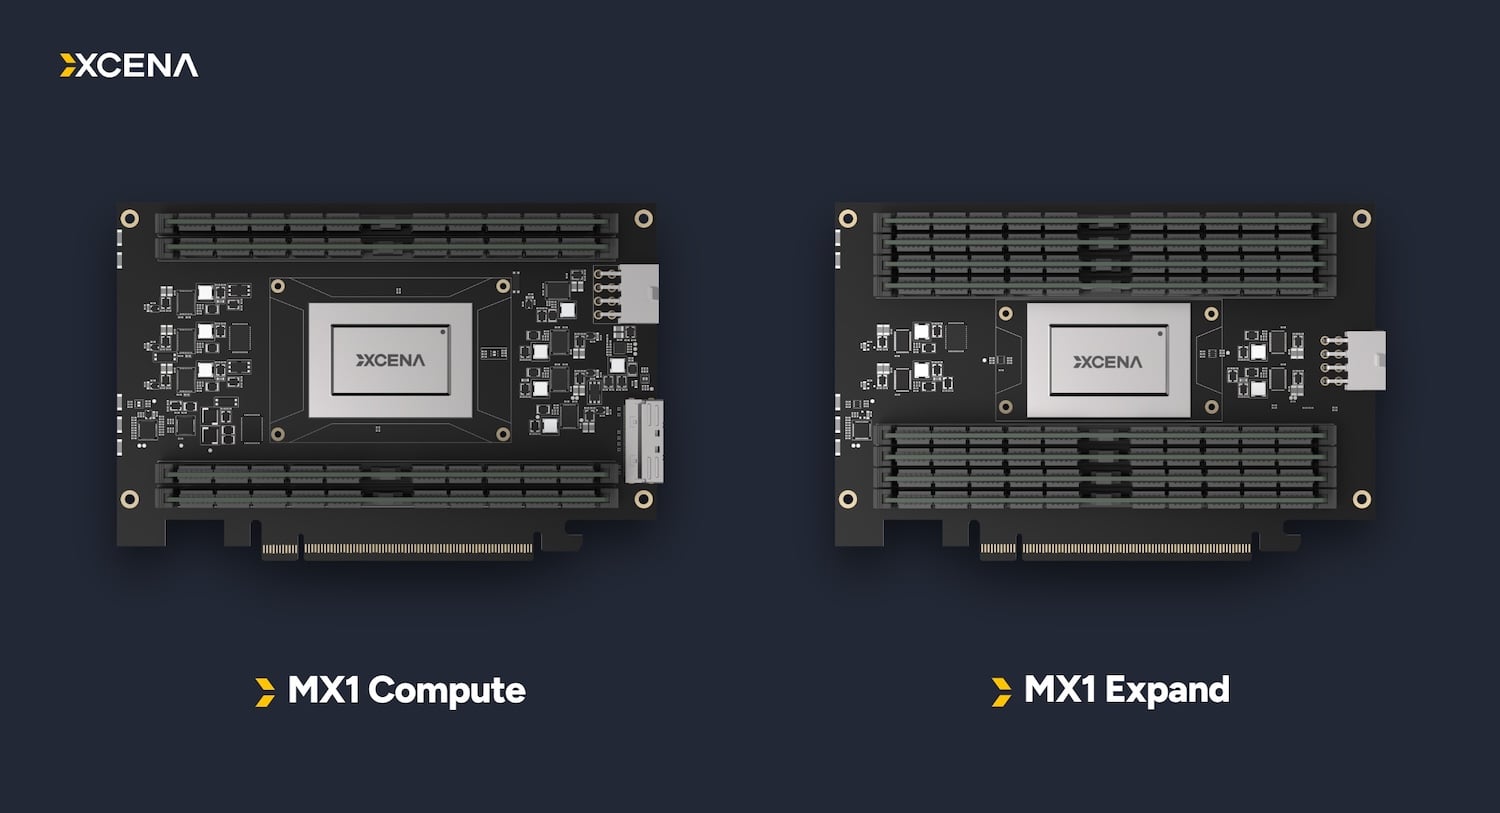
MX1 è un dispositivo di memoria CXL 3.2 di tipo 3, che XCENA definisce la prima memoria computazionale CXL 3.2, con un'interfaccia PCIe 6.0 dual x8 e supporto fino a 2 TB di DRAM utilizzando DIMM da 256 GB con due DIMM per canale. Oltre all'espansione della memoria, il controller integra migliaia di core RISC-V personalizzati con motori vettoriali FP32 e FP16 per l'elaborazione near-data, oltre a un root complex PCIe 6.0 separato che collega gli SSD per quella che XCENA chiama InfiniteMemory.
Cache KV condivisa e ricerca vettoriale in memoria
Nella prima dimostrazione, più server di inferenza condividevano una cache KV ospitata in un pool di memoria CXL. La cache KV memorizza il contesto già elaborato da un modello, consentendone il riutilizzo durante la generazione. Mantenendola in un pool condiviso, si eliminano le copie duplicate che ciascun server altrimenti conterrebbe, oltre al trasferimento di dati tra i server. Questo approccio è analogo alla demo di pooling CMM-D di Samsung con AMD presentata alla stessa fiera, e i nostri test di offload della cache KV su memoria flash riguardano il livello flash sottostante.
La seconda dimostrazione ha utilizzato l'elaborazione near-data di MX1 per accelerare la ricerca vettoriale, una fase fondamentale nelle pipeline RAG. MX1 esegue la ricerca all'interno della memoria in cui risiedono i dati vettoriali, in modo che i set di dati di grandi dimensioni non debbano essere spostati sul processore host a ogni query. XCENA non ha pubblicato i dati relativi a latenza, throughput o capacità per nessuna delle due dimostrazioni, né ha descritto la configurazione del server utilizzata.
Memoria ibrida SK hynix CXL basata su MX1
La memoria ibrida CXL di SK hynix combina la capacità DRAM con quella SSD tramite InfiniteMemory, l'espansione di memoria basata su SSD di MX1. Le due aziende affermano che l'architettura scala la capacità di memoria ben oltre i moduli DRAM CMM-D convenzionali, offrendo al contempo prestazioni superiori a quelle degli SSD, e la stanno ora validando in ambienti reali di intelligenza artificiale. Al summit, SK hynix ha mostrato la memoria ibrida in un'architettura basata su RDMA, il percorso di memoria condivisa che le due aziende stanno perfezionando insieme, a seguito del lavoro sulla memoria condivisa CXL presentato alle dimostrazioni FMS 2026.
Sessioni con Samsung, Marvell, Microsoft, Seagate e Meta
Il 14 ottobre, Harry Kim, Chief Product Officer di XCENA, ha presentato "Bringing General-Purpose Parallel Programming to Near-Data Processing" e ha partecipato a un panel con Marvell, Samsung, SK hynix e Gottbrath Technologies sul middleware aperto per infrastrutture AI eterogenee. Il 15 ottobre, ha tenuto una presentazione congiunta con Samsung Electronics sulla memoria CXL disaggregata per l'IA agentiva, trattando argomenti quali pooling dinamico, condivisione e offload di elaborazione vicino alla memoria. Lo stesso giorno, Grant Mackey, Distinguished Engineer, si è unito a relatori di Microsoft, Seagate e Meta per l'aggiornamento tecnico del sottoprogetto OCP Composable Memory Systems sulla memory wall.
"Migliorare le prestazioni e l'efficienza dell'infrastruttura AI non è più solo una sfida di calcolo. Dipende anche da quanto efficacemente viene utilizzata la memoria e da quanta movimentazione di dati si può eliminare", ha affermato Jin Kim, CEO di XCENA. L'azienda ha raccolto finora 185 milioni di dollari, inclusi 135 milioni di dollari in un round di finanziamento di Serie B, e ha sede a Seongnam, in Corea del Sud, con un ufficio negli Stati Uniti a Sunnyvale, in California.


 Amazon