

L'ASUS ExpertCenter Pro ET900N G3 è la seconda workstation GB300 DGX che abbiamo testato e la prima che abbiamo avuto modo di provare di persona in laboratorio; i test della MSI XpertStation WS300 sono stati eseguiti da remoto. Utilizza la stessa architettura NVIDIA che abbiamo testato nella MSI XpertStation WS300: un Grace Blackwell Ultra Desktop Superchip con 72 core Grace, una GPU B300, 252 GB di HBM3e, 496 GB di LPDDR5X e una ConnectX-8 SuperNIC con due porte 400GbE. ASUS racchiude questa piattaforma con core fissi in un elegante case tower progettato per l'intelligenza artificiale desktop, aggiungendo alcuni dettagli non presenti sulla WS300: due maniglie per il trasporto sulla parte superiore, una ventola dedicata rivolta verso gli alloggiamenti ottici della ConnectX-8 e un alimentatore da 1,600 W con certificazione 80 PLUS Titanium.
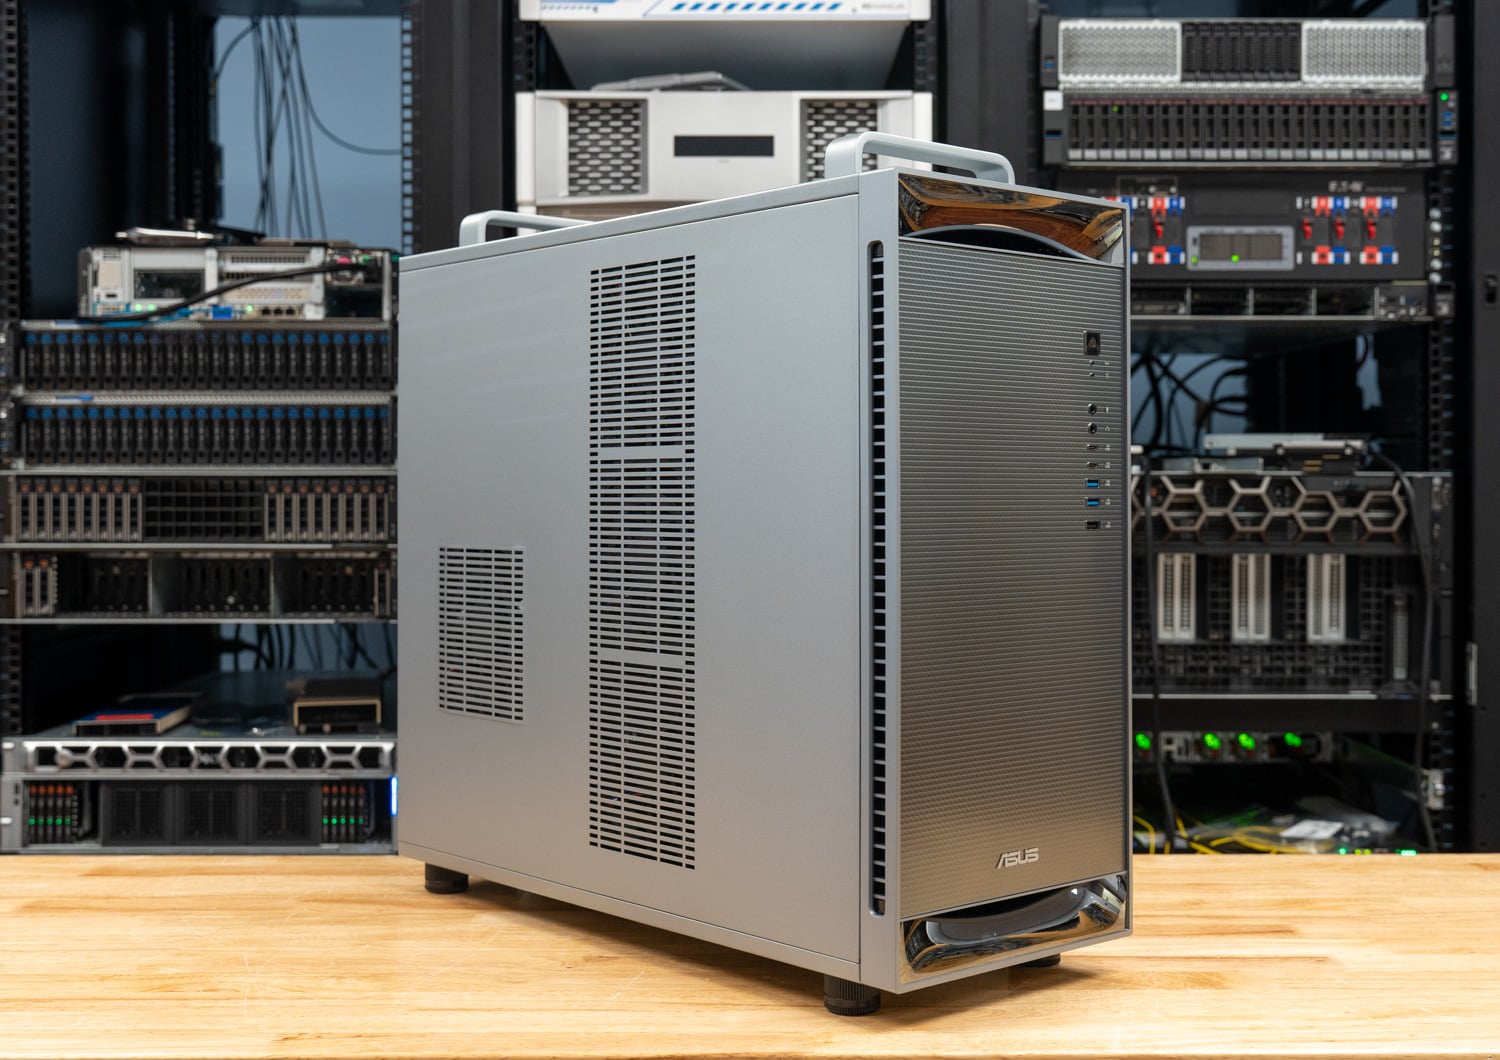
ASUS ha inviato l'ET900N G3 al laboratorio per circa una settimana di benchmark, fotografie e verifiche fisiche, con una RTX PRO 2000 installata. Per quanto riguarda la piattaforma stessa, il B300, Grace, NVLink-C2C, MIG e la funzione di una DGX Station, la recensione del WS300 copre questi aspetti. Questa recensione si concentra su ciò che ASUS ha realizzato attorno al Superchip e se le prestazioni reggono il confronto con il primo case tower GB300 che abbiamo testato.
Specifiche tecniche di ASUS ExpertCenter Pro ET900N G3
| Specificazione | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Panoramica della piattaforma | |
| Superchip | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72 core Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300), fino a 20 PFLOPS NVFP4 con sparsità |
| Interconnessione CPU-GPU | NVLink-C2C, 900 GB/s bidirezionale |
| Memorie | |
| Memoria coerente | 748GB |
| Memoria GPU | 252 GB HBM3e, 7.1 TB/s |
| Memoria della CPU | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| Archiviazione | |
| Unità di avvio | 2x M.2 2280 PCIe 5.0 x4 (Key M), con 2x NVMe da 2 TB in RAID 1 |
| Unità di espansione | 2x M.2 2280 (Key M), PCIe 6.0 x4 per ASUS, aperto di fabbrica |
| Networking | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Espansione | |
| Slot PCIe | 1x PCIe 5.0 x16 2 slot PCIe 5.0 x16 (8 segnali) |
| GPU aggiuntiva | Fino a una scheda NVIDIA RTX PRO Blackwell; l'unità di prova è stata fornita con una RTX PRO 2000 Blackwell |
| I / O | |
| Anteriore | 2 porte USB 10 Gbps di tipo C 2 porte USB 10 Gbps di tipo A 1x USB 2.0 Prese per cuffie e microfono |
| Posteriore | 4 porte USB 10 Gbps di tipo A 1x Micro-USB COM (console seriale BMC) 1x Mini DisplayPort (BMC) 3 prese audio |
| Gestione e Sicurezza | |
| BMC | ASPEED AST2600 con firmware AMI MegaRAC, IPMI e Redfish |
| Sicurezza | TPM 2.0 integrato |
| Alimentazione e raffreddamento | |
| Alimentazione di laboratorio | 1x 1,600W ATX, 80 PLUS Titanium |
| Raffreddamento | Sistema di raffreddamento a liquido AIO a circuito chiuso (secondo ASUS) con piastre di raffreddamento su GB300, SOCAM e ConnectX-8; radiatori anteriori e superiori, ventola posteriore del case, ventola dedicata sopra gli alloggiamenti QSFP112. |
| Temperatura di esercizio | 10C a 35C |
| Software e fattore di forma | |
| Sistema operativo | Ubuntu con strumenti di sviluppo AI di NVIDIA; ASUS annuncia il supporto per lo sviluppo di IA su Windows. |
| Dimensioni | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 pollici), come indicato da ASUS |
| Peso | 27 kg netti, 32 kg lordi |
Progetta e costruisci
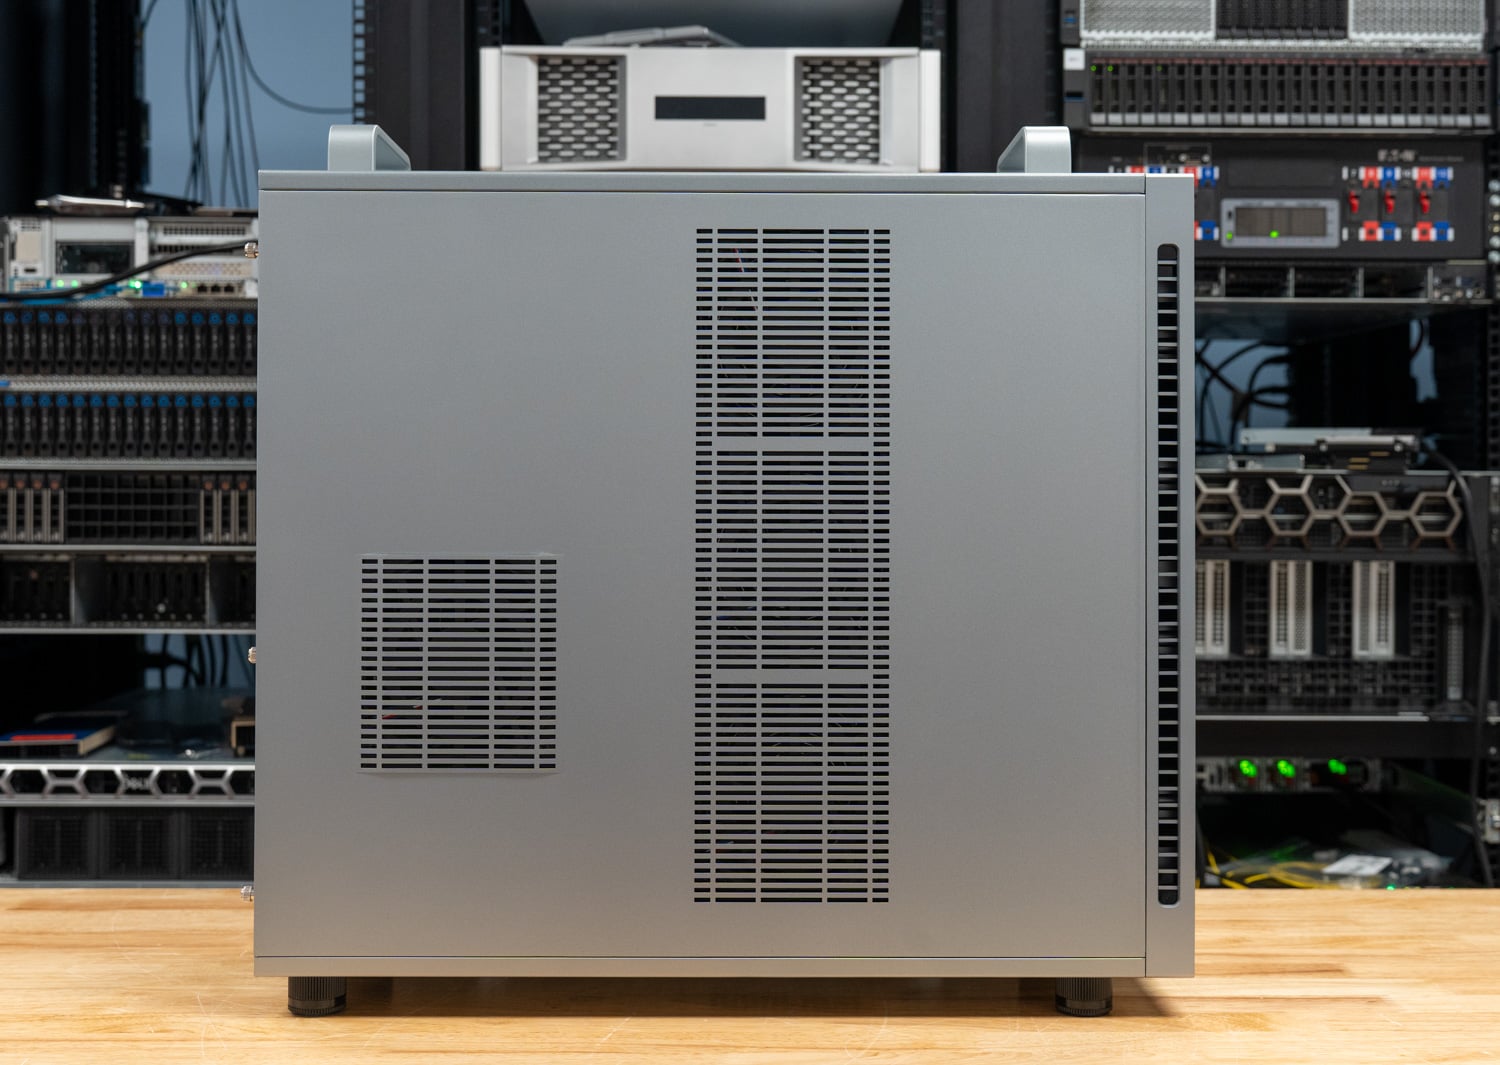
ASUS presenta l'ET900N G3 come una workstation aziendale, con uno chassis in argento spazzolato, un pannello frontale in rete scura, una base e un coperchio con finiture cromate e il logo ASUS nella parte inferiore del frontale. Le proporzioni sono dettate dalla piattaforma: 584 x 232 x 565 mm secondo le specifiche ASUS, il che lo rende leggermente più alto e un po' più stretto del WS300, che misura 529 mm di altezza, 570 mm di profondità e 246 mm di larghezza. Con un peso di 27 kg, non è un sistema che si sposta con leggerezza, ed è qui che entra in gioco la prima scelta specifica di ASUS. Due maniglie metalliche sul bordo superiore, una anteriore e una posteriore, consentono a due persone di sollevare il case e posizionarlo su una scrivania o su un carrello senza afferrare i pannelli. Possono sembrare un po' fuori luogo su un computer da ufficio, finché non ci si trova a dover trasportare un case GB300 attraverso un laboratorio.
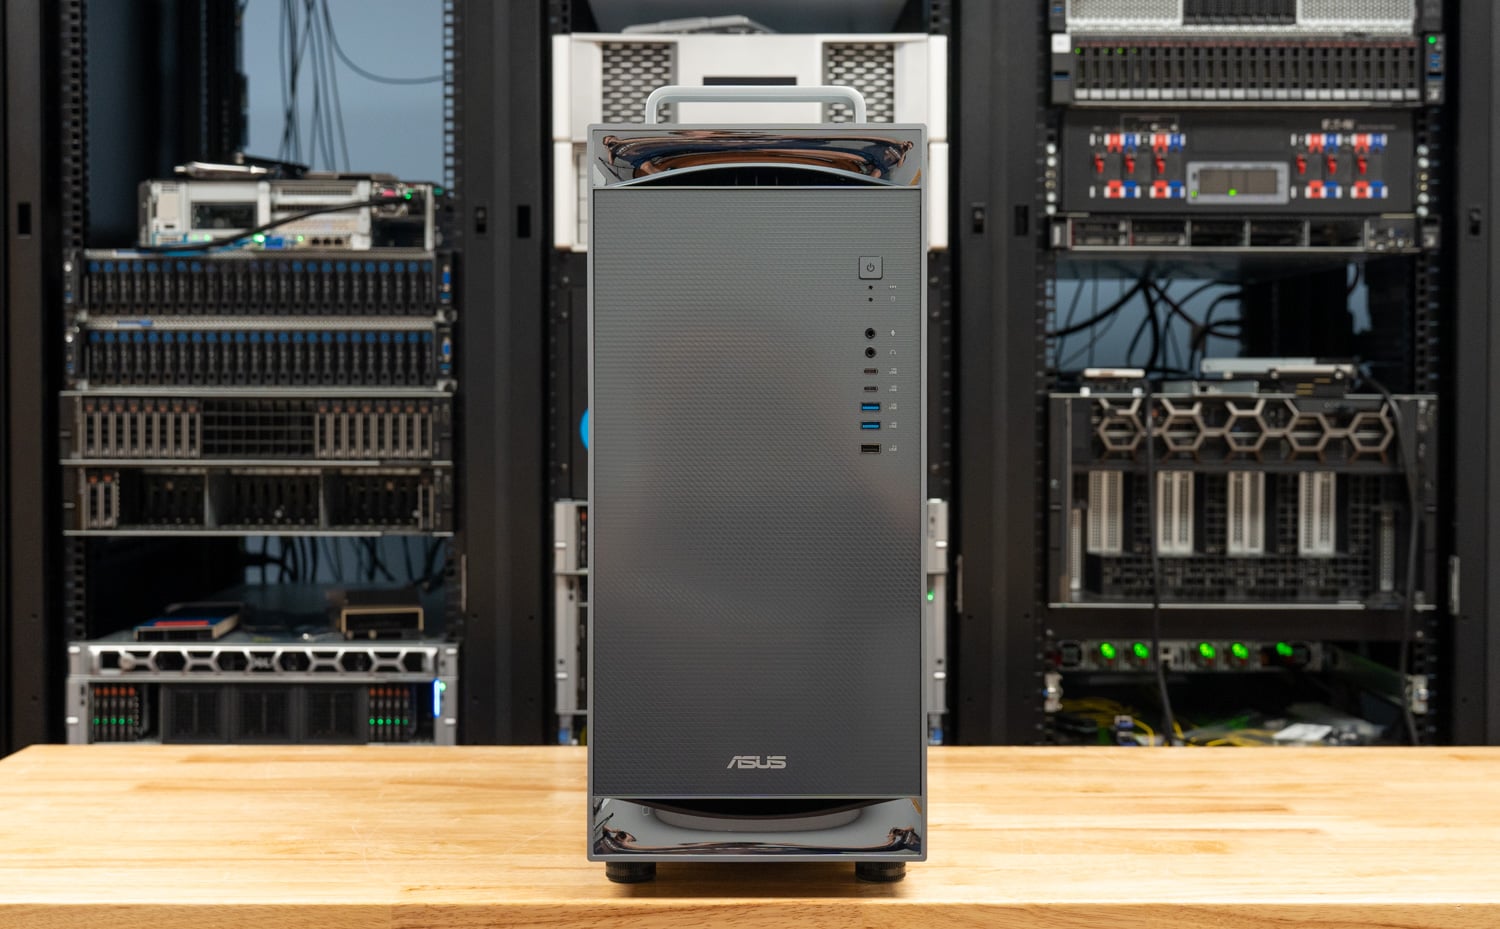
Il pannello frontale presenta il pulsante di accensione, due porte USB Type-A da 10 Gbps, due porte USB Type-C da 10 Gbps, una porta USB 2.0 e jack separati per cuffie e microfono, tutti disposti in una striscia verticale nell'angolo in alto a destra della griglia. Il pannello laterale è costituito da un'ampia lastra ventilata, con una lunga colonna perforata nella parte anteriore per l'aspirazione del radiatore e una griglia quadrata più piccola nella parte posteriore che si allinea con le ventole di sistema. Non sono presenti finestre né illuminazione, una soluzione che si adatta perfettamente al target di riferimento.
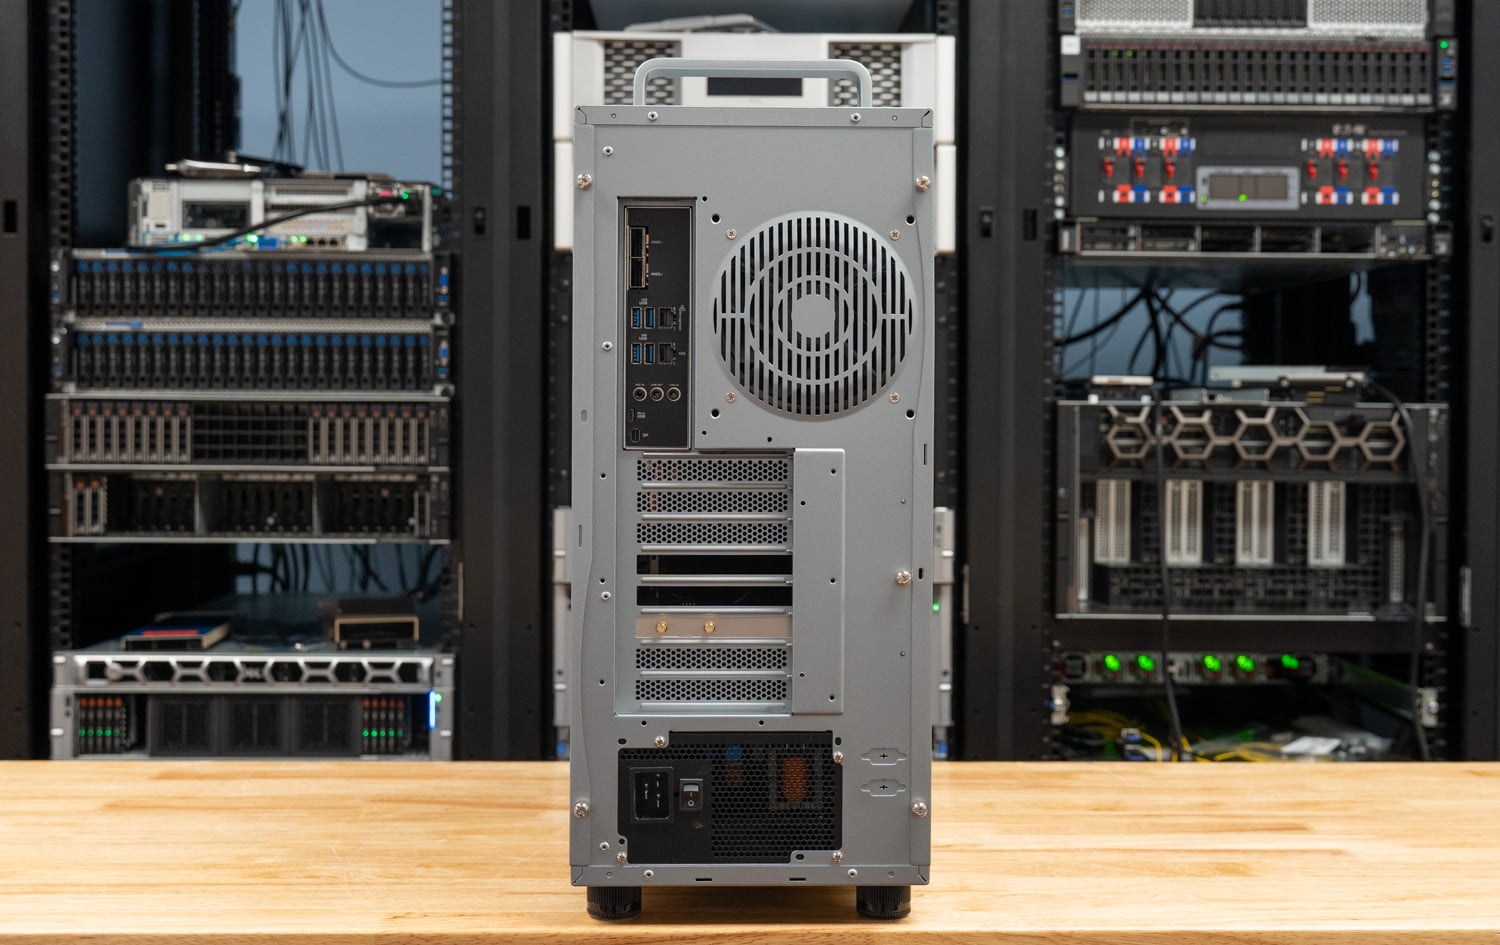
Sul retro, la disposizione separa le porte I/O della workstation dall'hardware del server sottostante. Il gruppo superiore ospita le quattro porte USB Type-A da 10 Gbps, i connettori RJ45 da 10 GbE e 1 GbE, i tre jack audio, la porta console Micro-USB del BMC e la Mini DisplayPort gestita dal BMC per la configurazione. I due alloggiamenti QSFP112 per il ConnectX-8 si trovano nella parte superiore dello scudo I/O; una ventola di scarico è posizionata accanto ad essi; i tre coperchi degli slot di espansione si estendono al centro; e l'alimentatore con il suo connettore C19 è situato nella parte inferiore. Come sul WS300, la Mini DisplayPort è un'uscita del BMC per la configurazione iniziale e la risoluzione dei problemi; chiunque desideri un desktop su questa macchina necessita di una scheda RTX PRO.
All'interno dell'ET900N G3
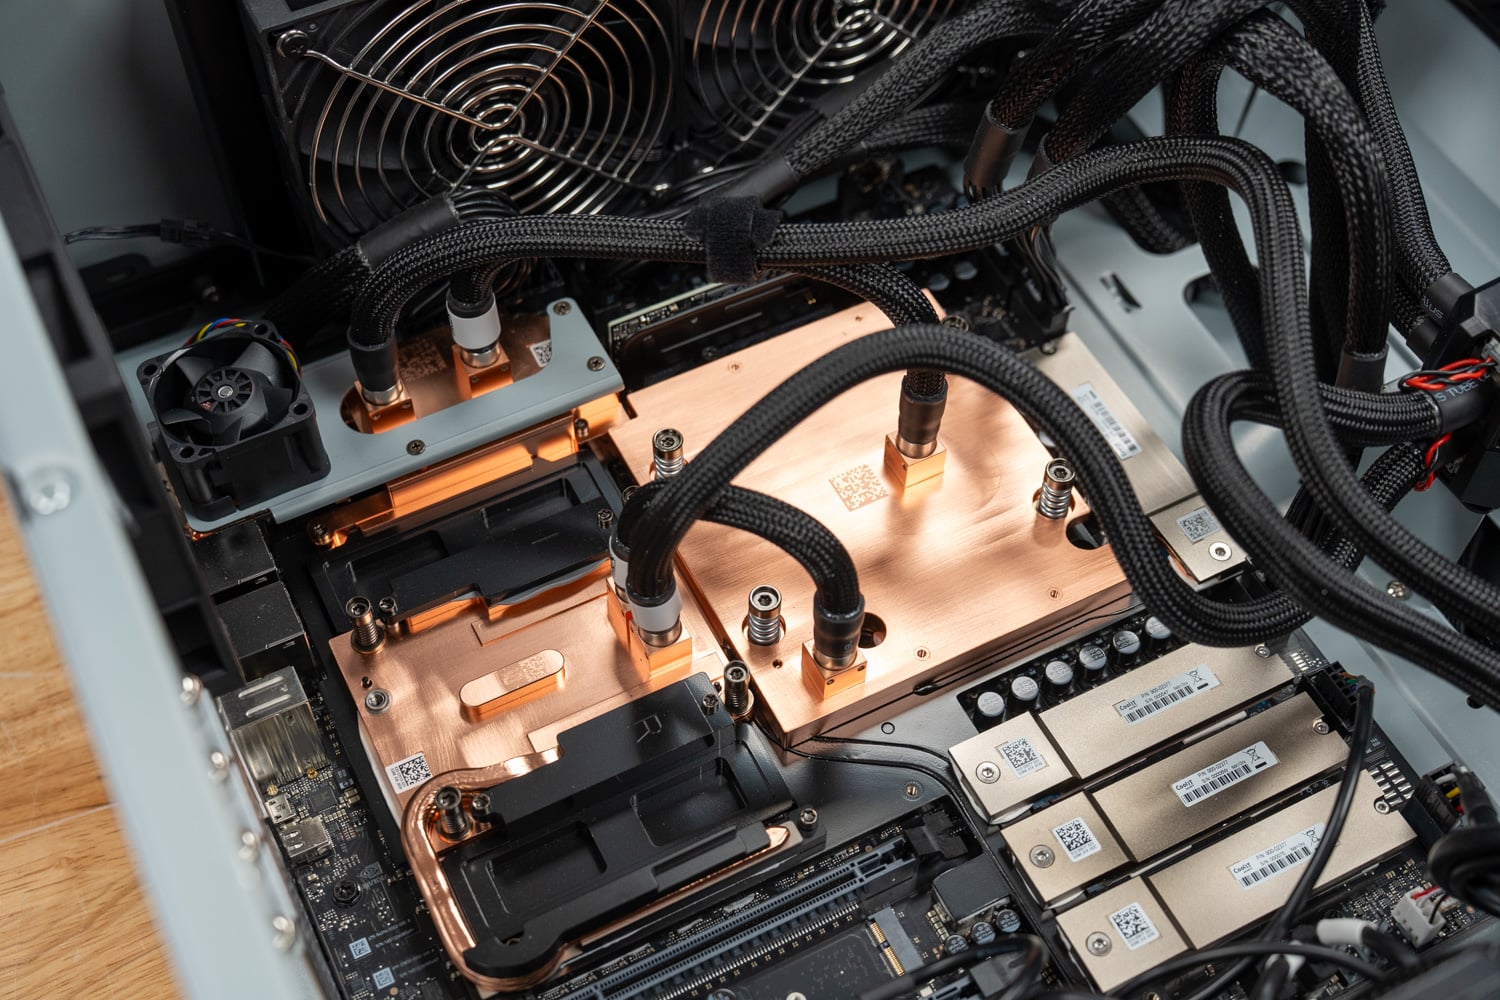
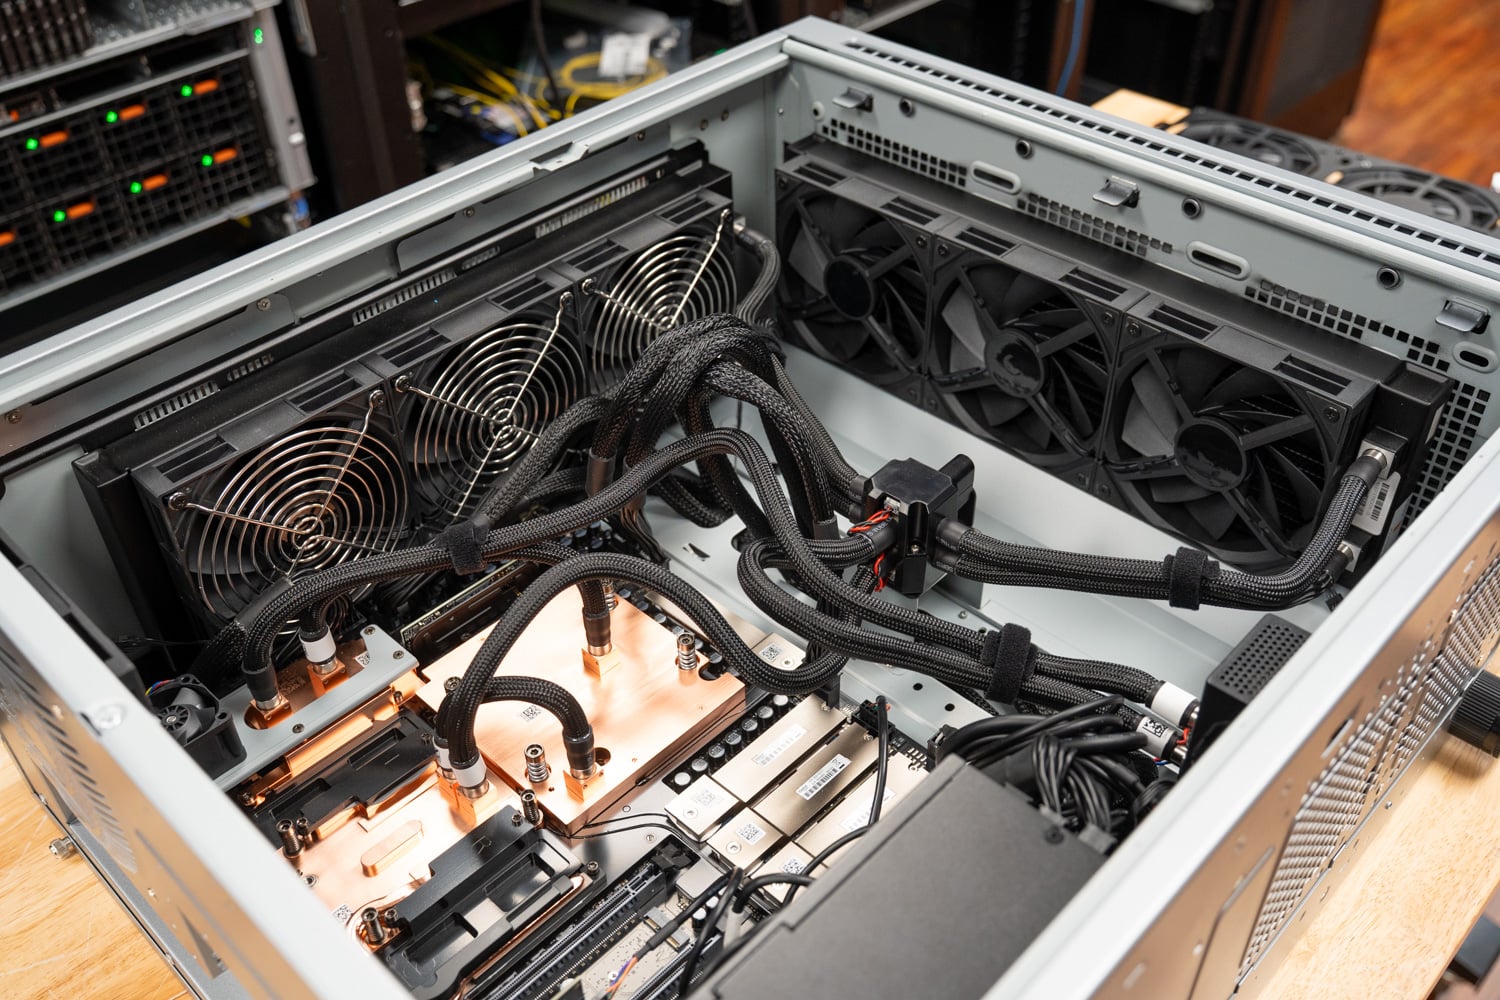
Con il pannello laterale rimosso, l'ET900N G3 appare molto simile al WS300, il che è prevedibile dato che entrambi condividono la stessa scheda madre NVIDIA. Il Superchip GB300 è posizionato sotto un gruppo di piastre di raffreddamento in rame sul lato sinistro dello chassis, con i moduli SOCAMM sotto le proprie piastre di rame accanto e il ConnectX-8 sotto un terzo blocco vicino al pannello I/O posteriore. Dei tubi flessibili collegano i blocchi a un collettore di distribuzione montato sulla traversa dello chassis e da lì ai radiatori. I tre slot PCIe a tutta lunghezza si trovano sotto il Superchip, l'alimentatore occupa l'angolo anteriore inferiore e una copertura metallica protegge il percorso dei cavi lungo il fondo.
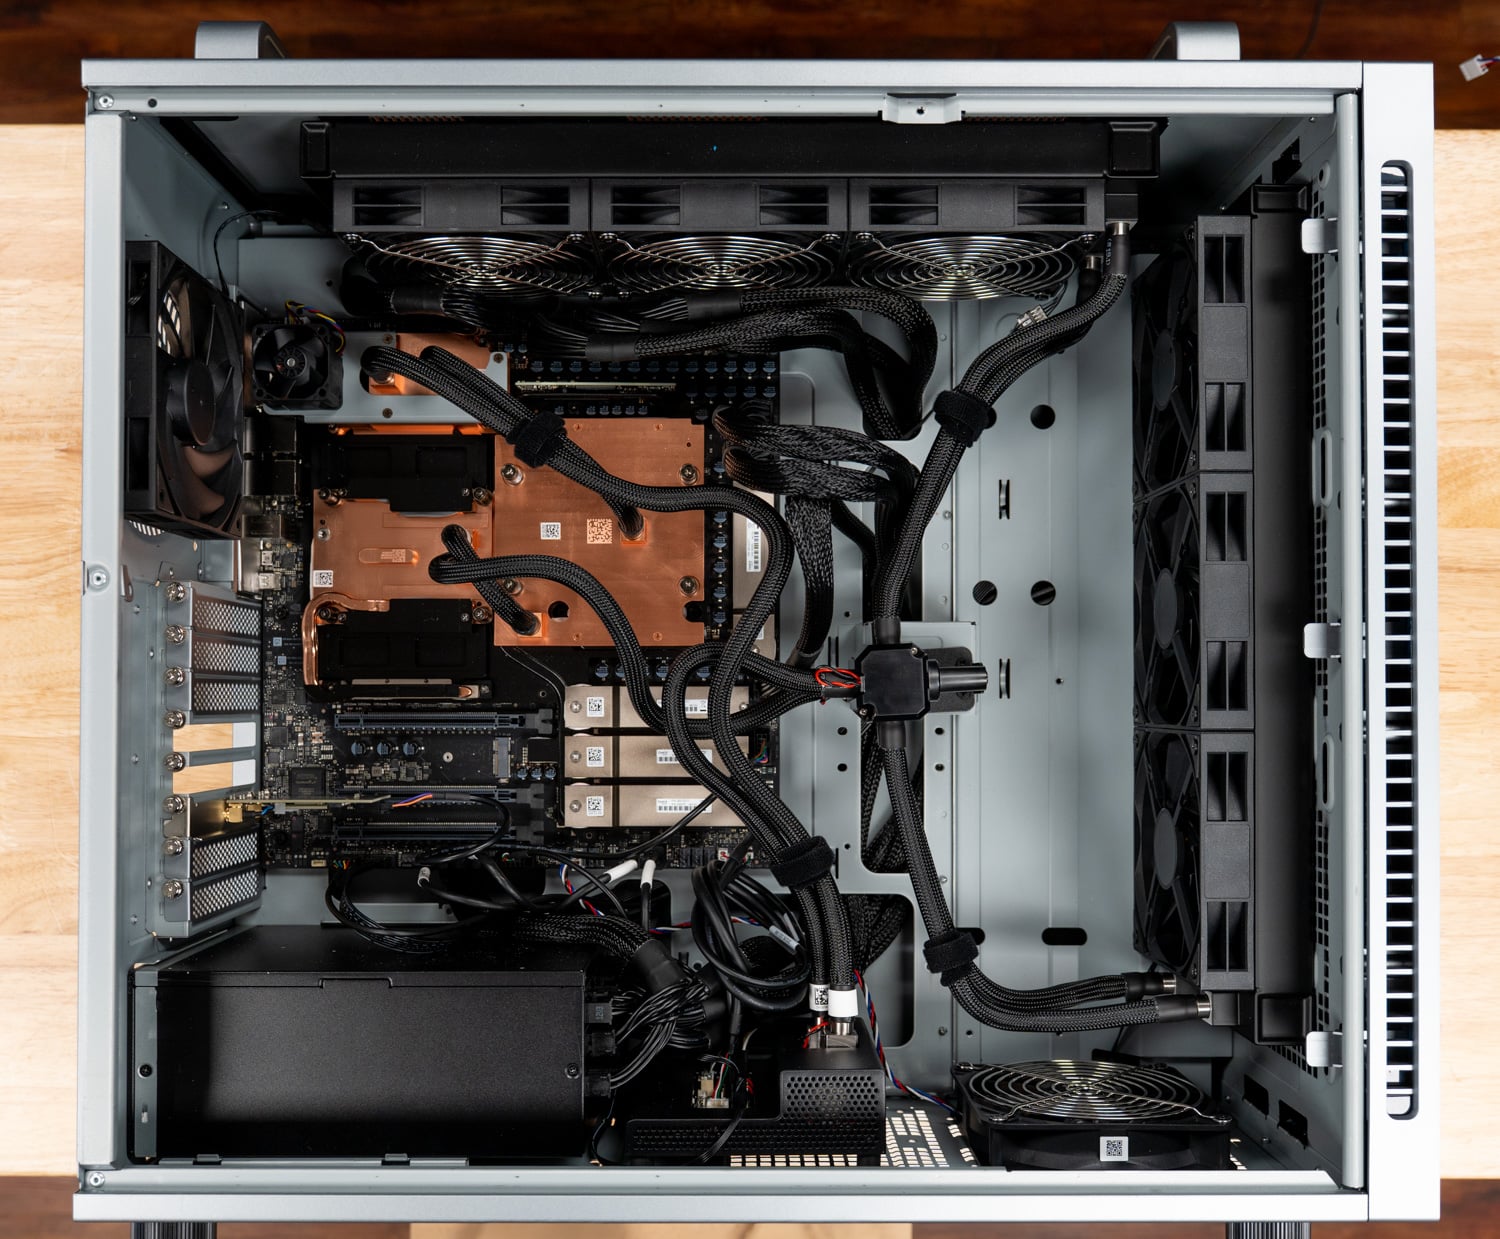
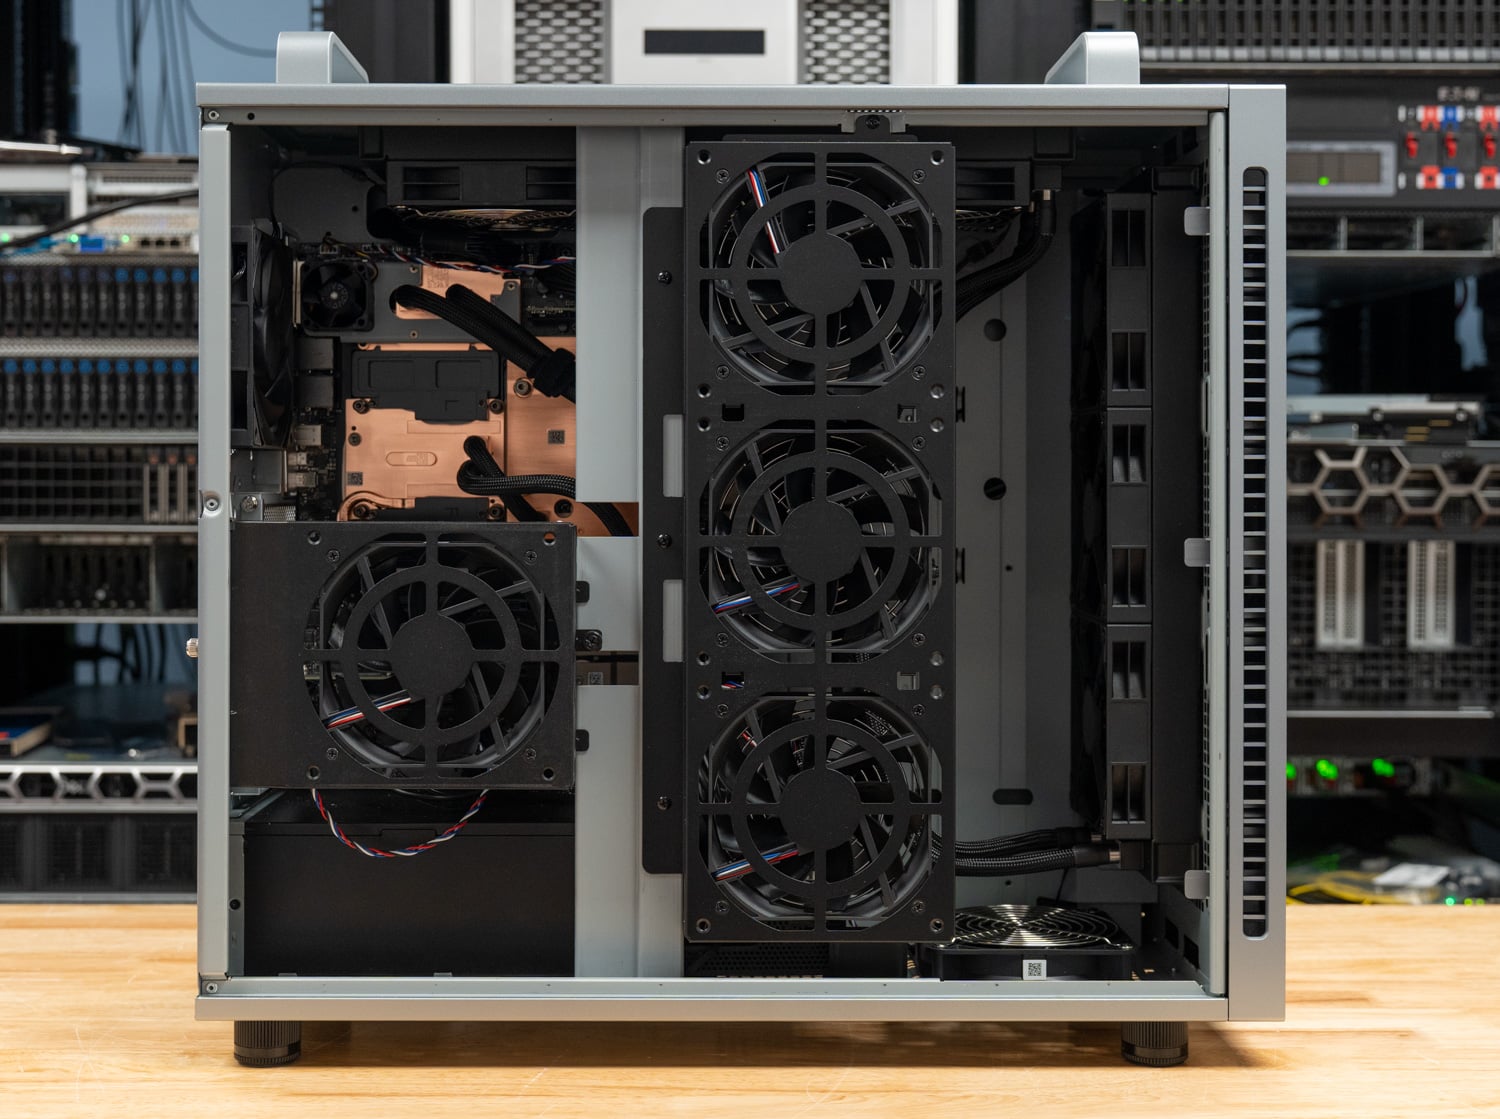
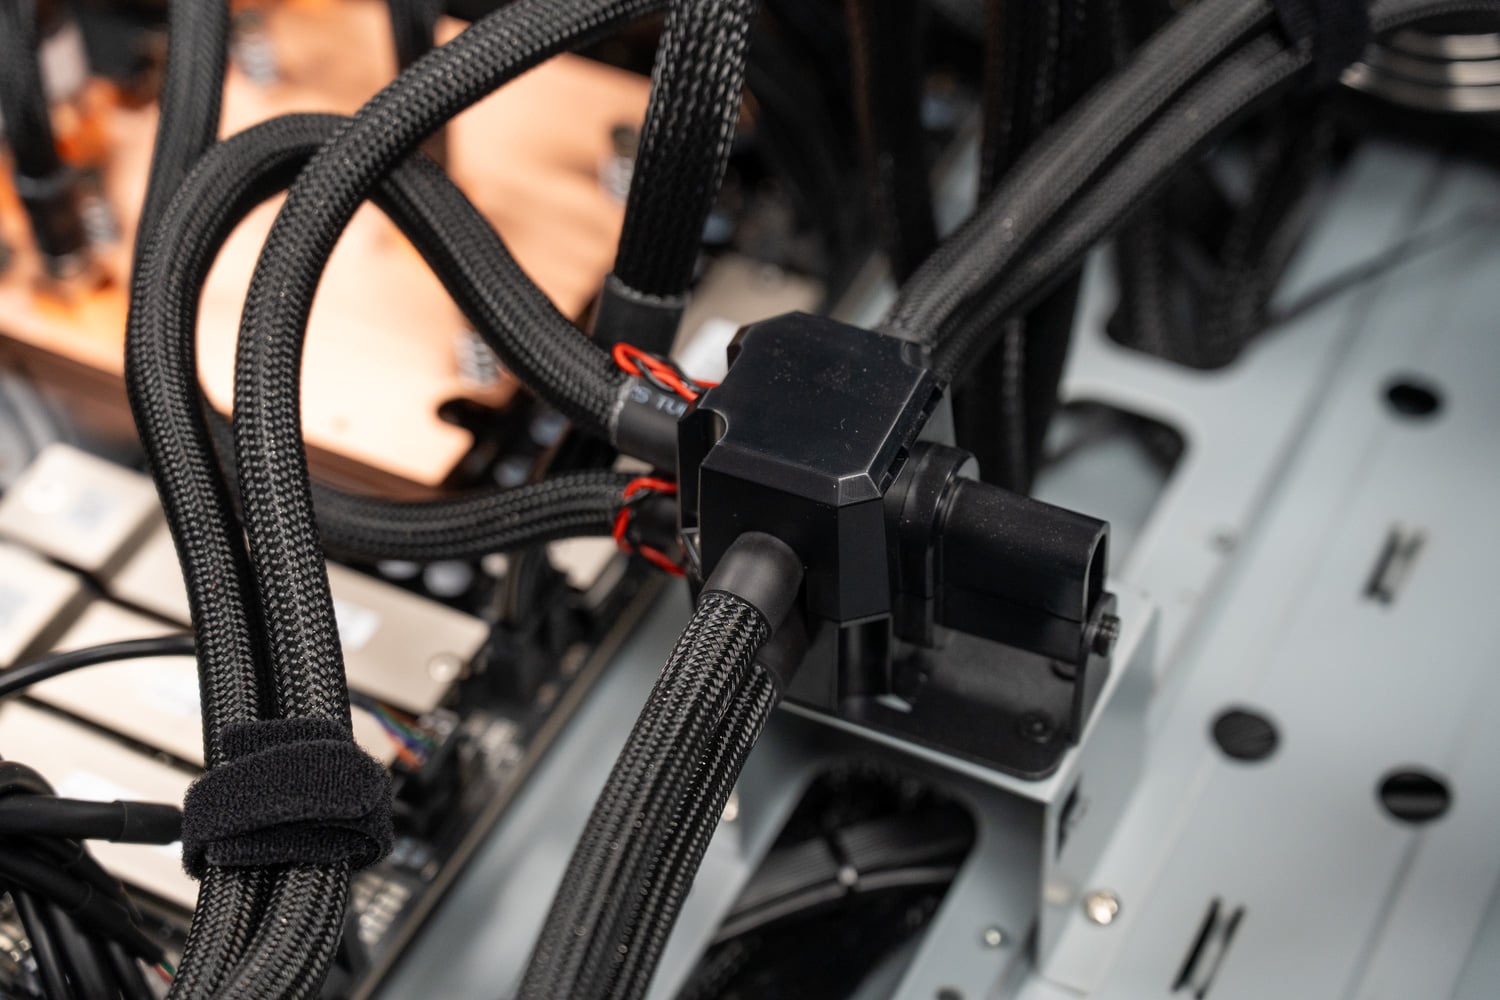
La disposizione interna segue lo stesso schema della WS300: un radiatore montato verticalmente dietro la griglia anteriore e un secondo lungo la parte superiore, ciascuno con una fila di ventole, più una ventola del telaio nella parte posteriore. I tubi del liquido di raffreddamento sono rivestiti e fissati alla traversa con fascette a strappo, e il collettore raggruppa i tubi provenienti dalle quattro piastre di raffreddamento in modo che solo due tubi raggiungano ciascun radiatore.
L'appassionato di ottica
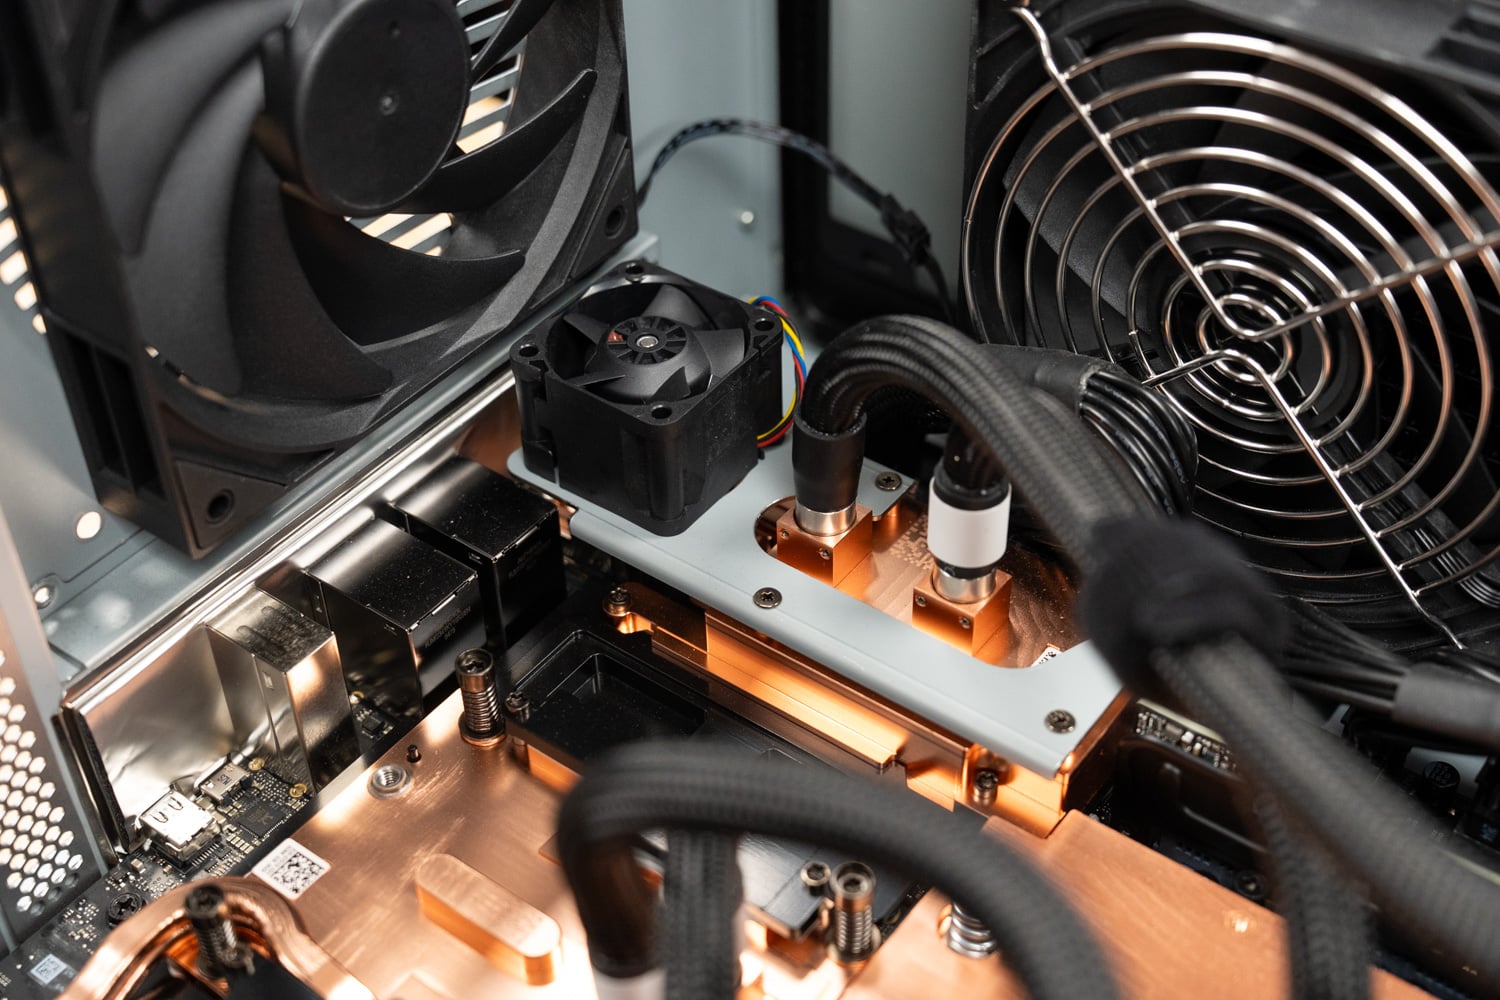
L'unico elemento di raffreddamento che non ha un equivalente nel WS300 è una piccola ventola montata su una staffa sopra la piastra di raffreddamento del ConnectX-8, orientata verso gli alloggiamenti QSFP112. Il circuito a liquido gestisce il silicio SuperNIC stesso, ma i transceiver ottici 400G generano calore e sono alloggiati in gabbie metalliche che la piastra di raffreddamento può raggiungere solo per conduzione. In altri test , abbiamo notato che il ConnectX-8 si riscalda sotto carico prolungato e che le ottiche stesse possono raggiungere temperature elevate, quindi un percorso di flusso d'aria dedicato attraverso gli alloggiamenti è un elemento di design utile per chiunque preveda di utilizzare l'ET900N G3 su fibra per ore consecutive. Con i DAC, come abbiamo fatto collegandolo a una seconda GB300 Station per un'analisi approfondita dell'inferenza clusterizzata ancora in corso, la ventola ha meno lavoro da svolgere.
Archiviazione, espansione e alimentazione
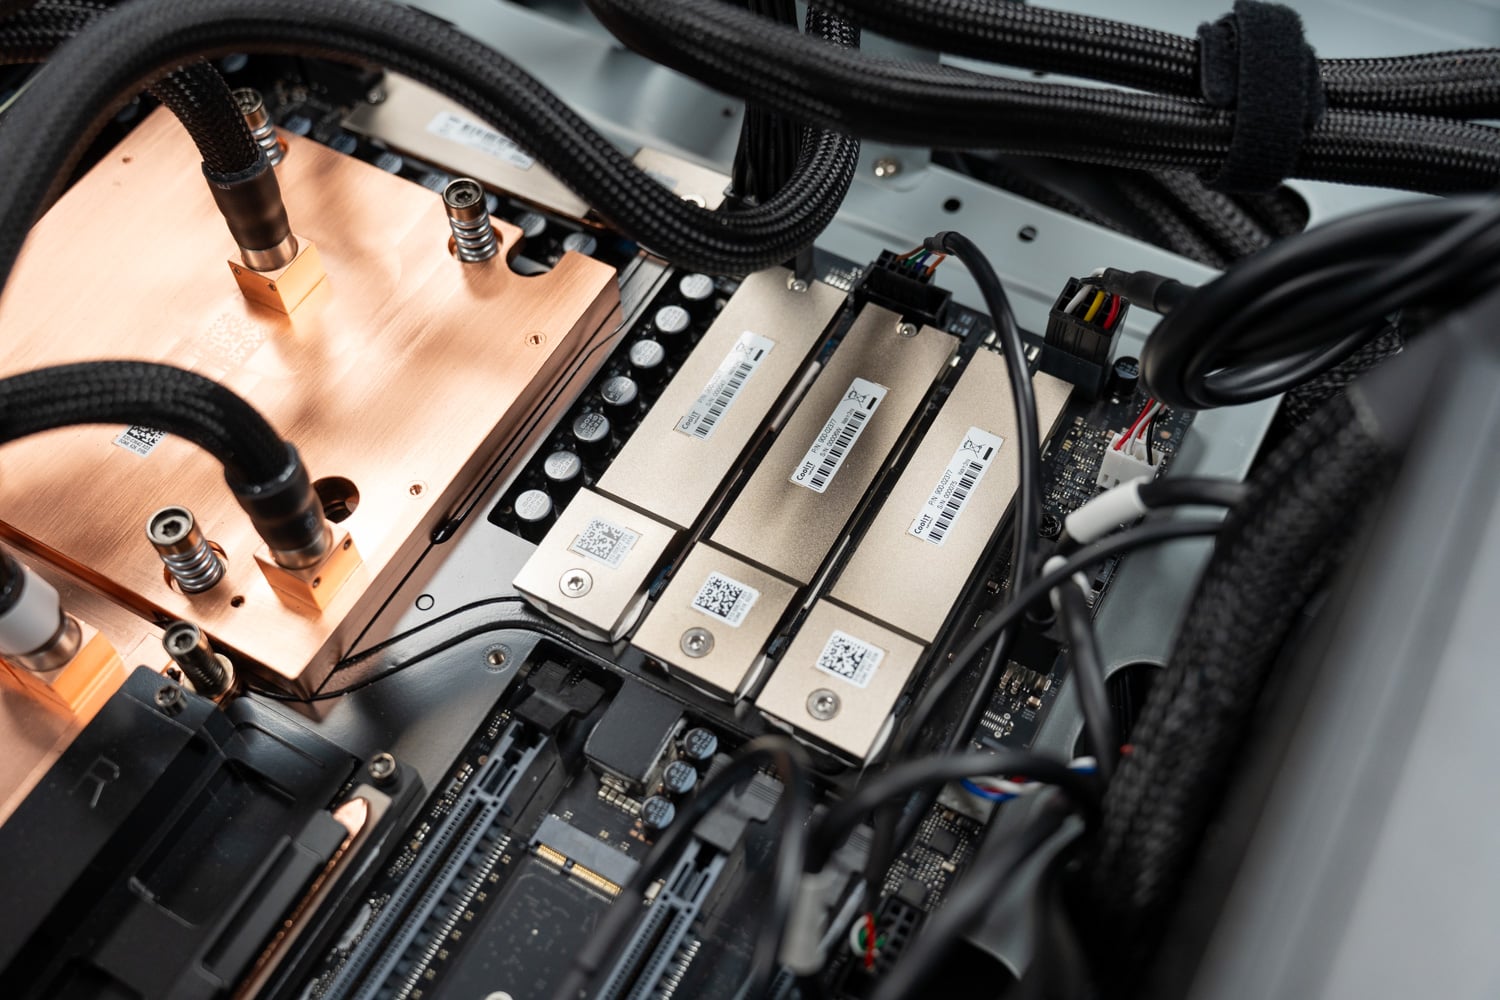
ASUS ha fornito l'ET900N G3 con un singolo SSD NVMe da 2 TB per il sistema operativo e lo stack software NVIDIA, alloggiato in una coppia di slot M.2 2280 collegati a Grace tramite PCIe 5.0 x4. La seconda coppia di slot è collegata allo switch PCIe integrato di ConnectX-8 ed è stata fornita vuota.
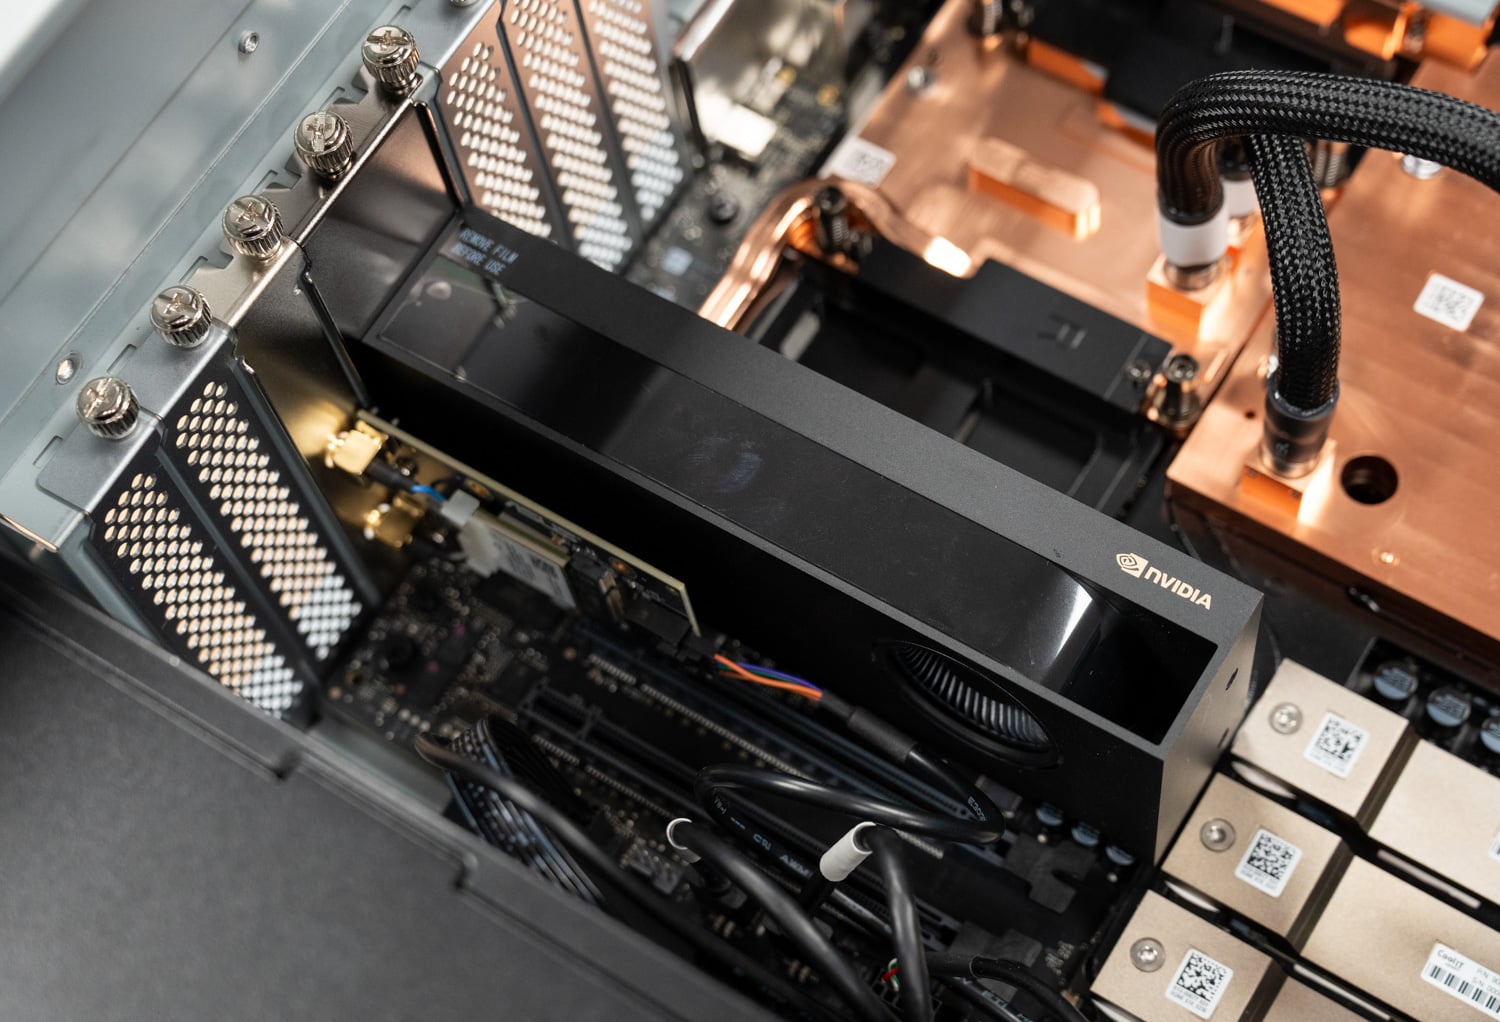
L'unità che abbiamo ricevuto per la recensione era dotata di una NVIDIA RTX PRO 2000 Blackwell nello slot PCIe 5.0 x16, una delle configurazioni elencate da ASUS. La scheda fornisce output video senza consumare molta energia dal GB300 e ASUS afferma che lo chassis può ospitare fino a una scheda RTX PRO Blackwell. Abbiamo rimosso la RTX PRO 2000 prima di eseguire i benchmark in modo che il Superchip avesse a disposizione l'intero budget di accelerazione, la stessa condizione utilizzata per il WS300, e non abbiamo testato una scheda RTX PRO ad alte prestazioni in questo chassis; questa configurazione, e il suo impatto sul budget di alimentazione condiviso, saranno trattati in una prossima recensione del GB300 Station.
L'alimentatore è un'unità ATX da 1,600 W che ASUS classifica come 80 PLUS Titanium, un gradino sopra l'unità Platinum del WS300. La certificazione Titanium richiede un'efficienza del 94% con un carico del 50% su un ingresso di 115 V rispetto al 92% del Platinum, ed è l'unico livello che impone un limite minimo al 10% di carico, quindi l'ET900N G3 dovrebbe consumare qualche decina di watt in meno alla presa di corrente con il GB300 a pieno carico. Il budget energetico è ancora condiviso: Grace, il B300, le pompe, le ventole, l'archiviazione e qualsiasi scheda RTX PRO assorbono gli stessi 1,600 W, e il servizio vsloshd di NVIDIA sposta il margine di potenza tra il Superchip e una GPU aggiuntiva in base alle variazioni del loro consumo, senza un limite fisso per nessuno dei due. La recensione del WS300 illustra questa politica, che rimane invariata anche in questo caso. Un circuito dedicato da 20 A rimane il requisito per le installazioni in Nord America.
Connettività
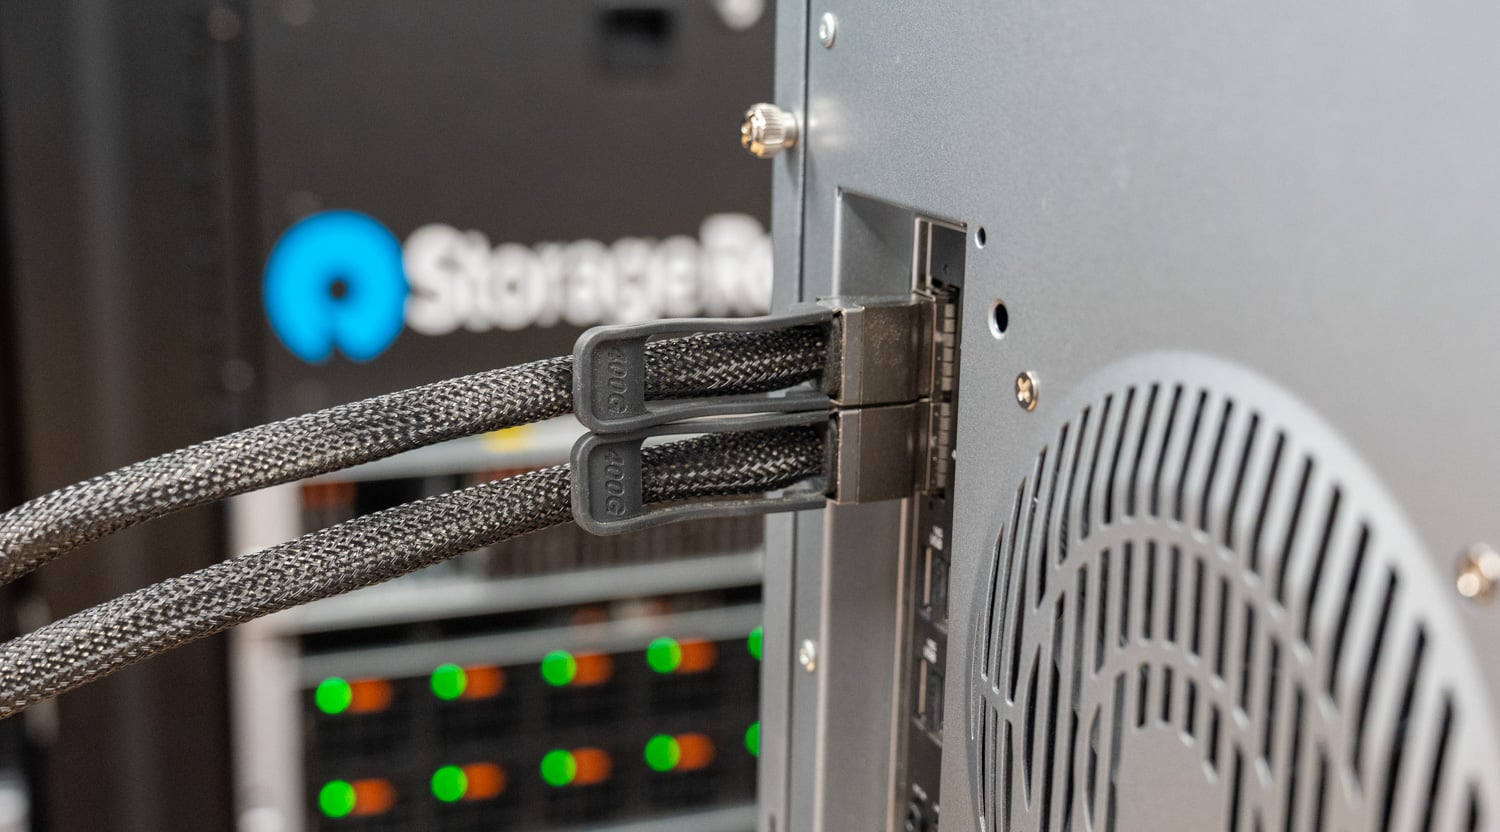
Le due porte QSFP112 del ConnectX-8 collegano l'ET900N G3 a tutto il resto: storage, una seconda DGX Station o una rete cluster. Queste porte sono già in uso in laboratorio, con l'ET900N G3 collegato a una seconda GB300 Station tramite cavi DAC da 400G per un'analisi approfondita dell'inferenza clusterizzata che pubblicheremo separatamente. La porta Marvell da 10 GbE gestisce il traffico host ordinario, mentre la porta Realtek da 1 GbE è dedicata al BMC.
Note di prova
Tutti i risultati di questa recensione provengono dall'unità che ASUS ha inviato al nostro laboratorio, nella configurazione di memoria di fabbrica con 252 GB di HBM3e e 496 GB di LPDDR5X. Il sistema è stato testato senza una scheda RTX PRO installata, quindi il chip GB300 Superchip ha avuto a disposizione l'intera potenza dell'acceleratore, replicando le condizioni dei nostri test sul WS300. Lo stack software, la configurazione vLLM, i profili di carico di lavoro e la scansione della concorrenza sono gli stessi che abbiamo utilizzato per il WS300, quindi i due computer possono essere confrontati direttamente. Questa recensione si concentra esclusivamente sulle prestazioni; non abbiamo misurato il consumo energetico o le temperature di questa unità.
I carichi di lavoro sono gli stessi due profili di inferenza live vLLM che eseguiamo su ogni sistema AI locale: un carico di lavoro uguale con 512 token di input e 512 di output e un carico di lavoro con pre-riempimento intensivo con 8,192 token di input e 1,024 di output, variando da uno a 128 flussi simultanei. Per i modelli di fascia alta, il confronto viene effettuato con un server GPU Dell PowerEdge XE7740 dotato di due o quattro schede RTX PRO 6000 , l'alternativa single-box più vicina per questi checkpoint. Per i modelli più piccoli, il confronto viene effettuato con una singola RTX PRO 6000 nello stesso XE7740, una singola H200 NVL in un Dell PowerEdge R770 e una GB10 DGX Spark rappresentata dall'Acer Veriton GN100 , la stessa Spark che abbiamo utilizzato nella recensione del WS300. I valori dell'ET900N G3 riportati di seguito sono i valori esatti dei log di esecuzione; I dati del sistema di confronto vengono letti dai nostri grafici dei risultati.
Prestazioni di inferenza
Modelli di frontiera sul pool di memoria coerente
La ragione d'essere del GB300 è quella di servire i modelli che si trovano ai lati del limite di 252 GB di HBM3e del B300, quindi partiamo da quattro punti di controllo che lo attraversano: DeepSeek V4 Flash e MiniMax M2.7 entrano in HBM con spazio a sufficienza, MiniMax M3 entra a malapena e sposta una parte dei suoi esperti sulla memoria Grace, e GLM-5.2 sposta circa la metà dei suoi pesi. Dall'altro lato di ogni grafico si trova l'alternativa più vicina in un unico box: schede RTX PRO 6000 insieme nel PowerEdge XE7740, con offload degli esperti sulla memoria host dove necessario.
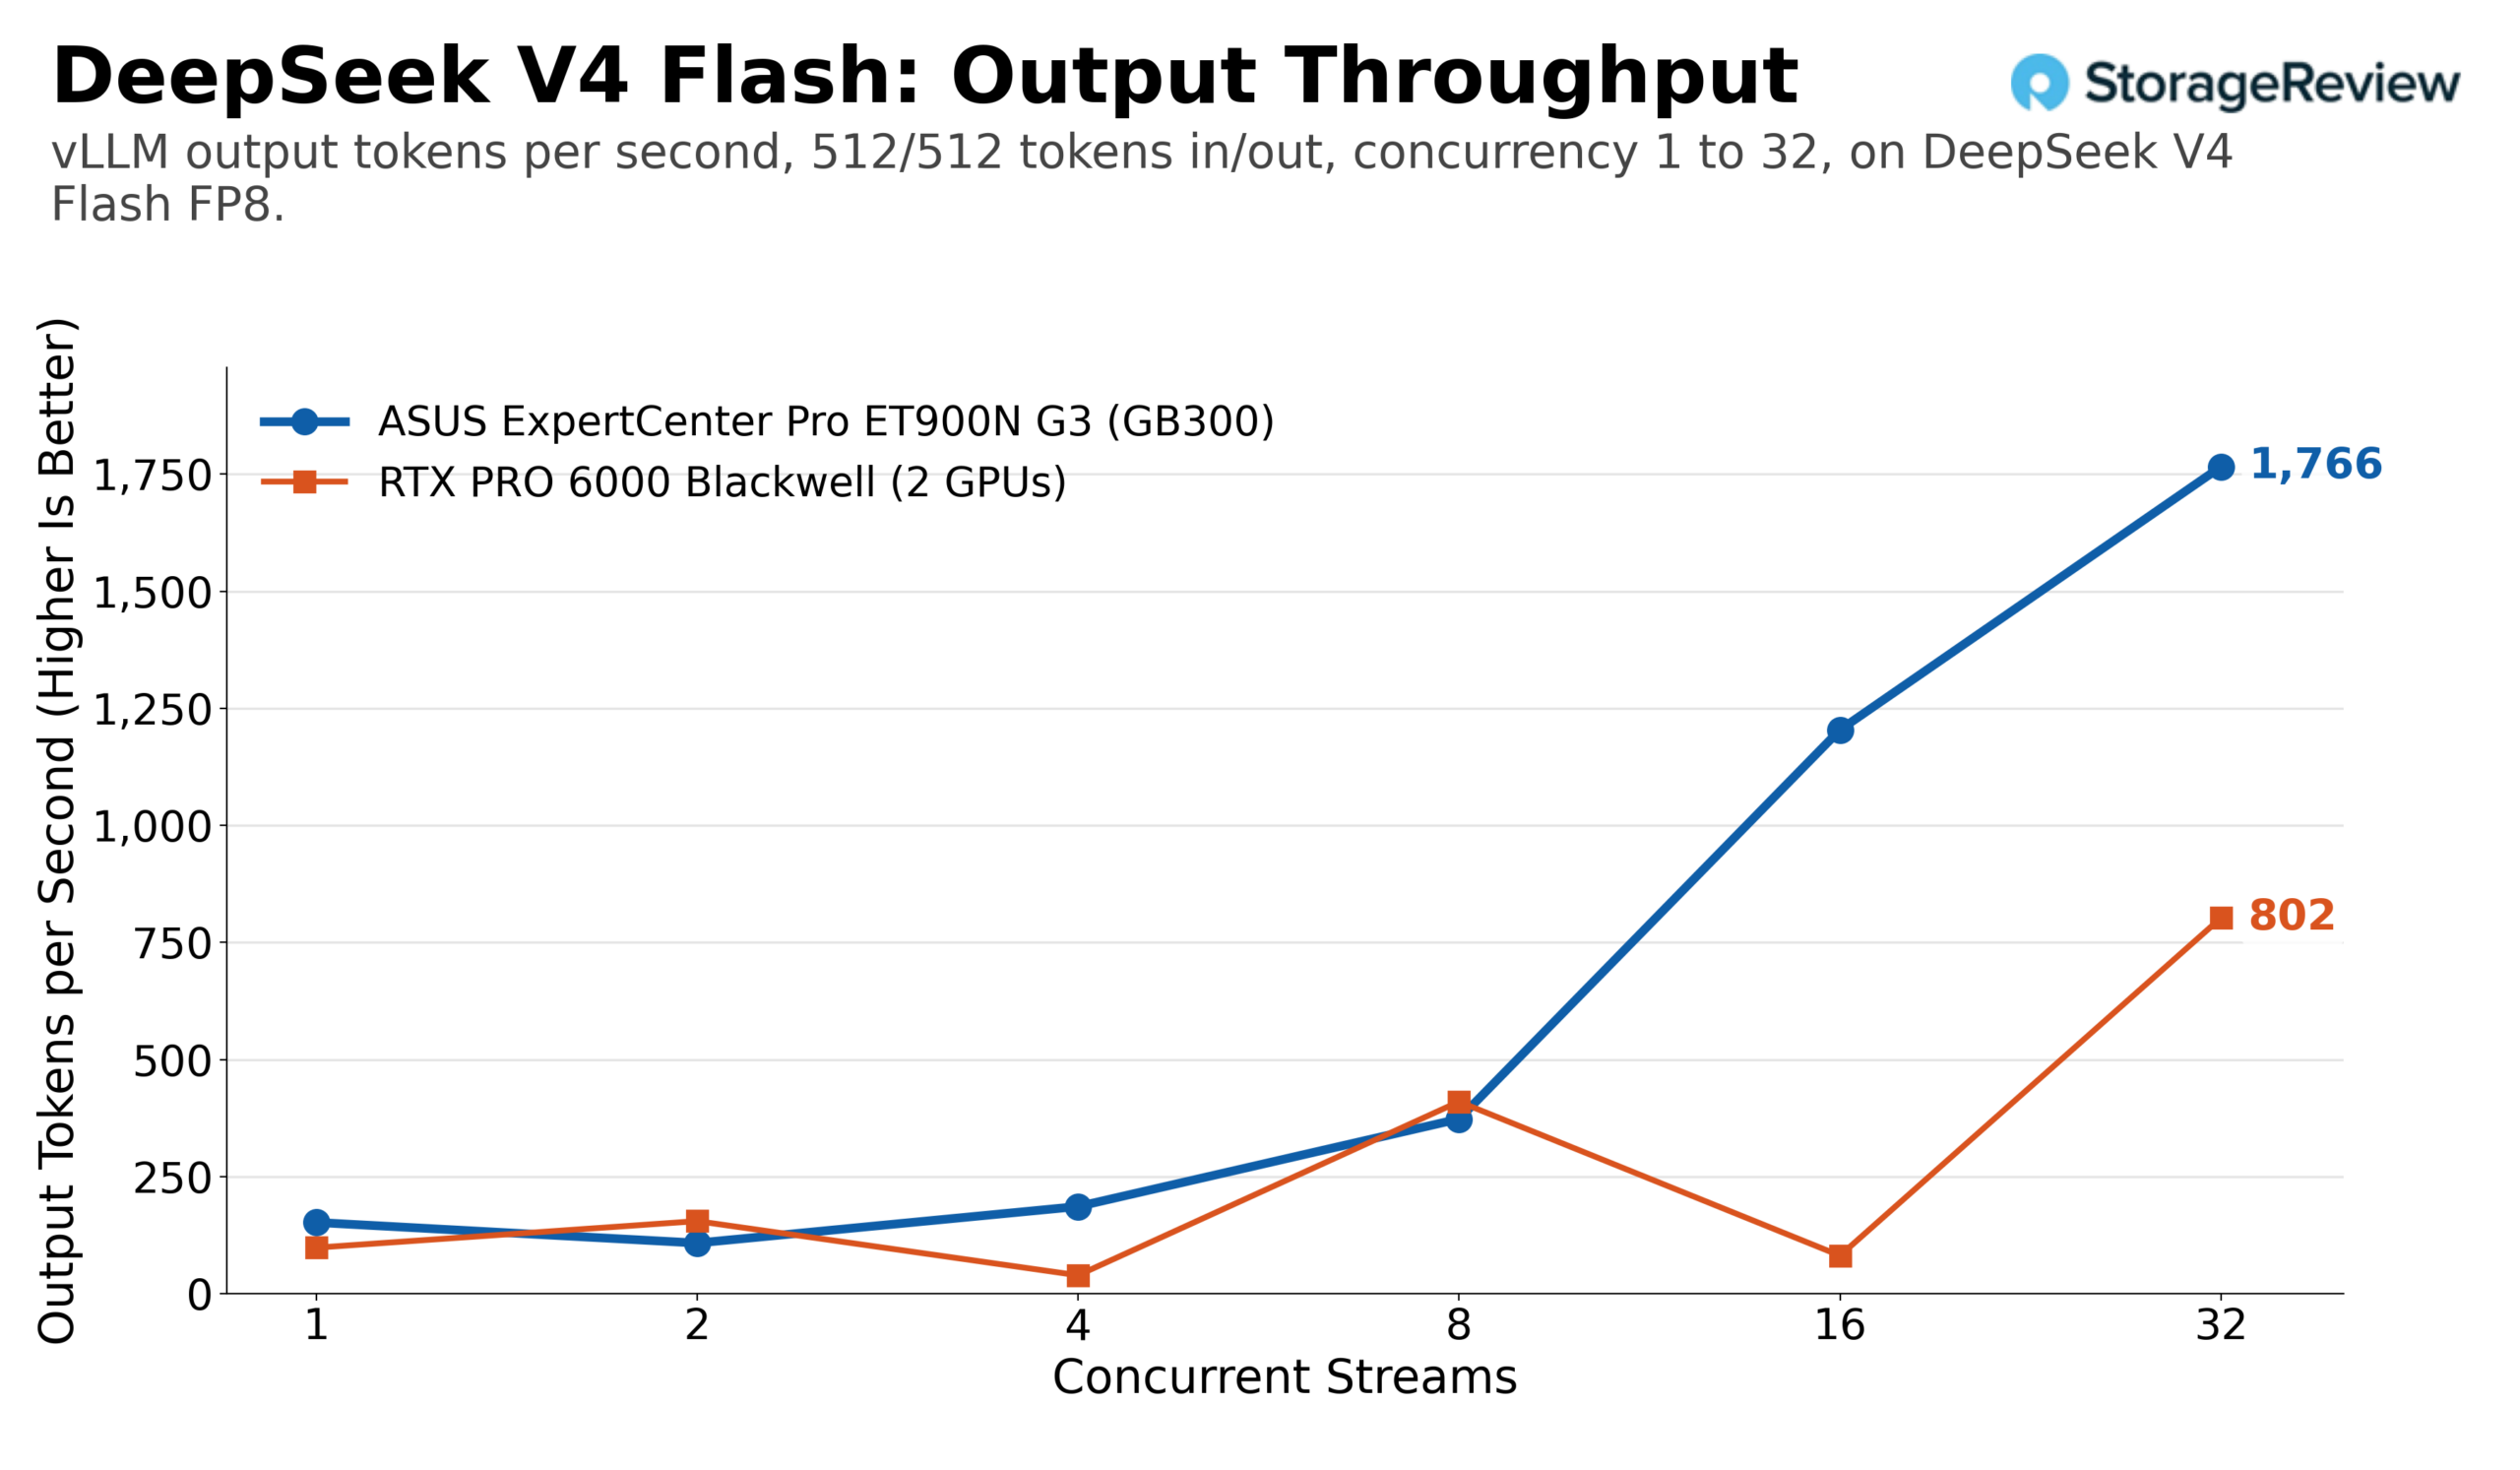
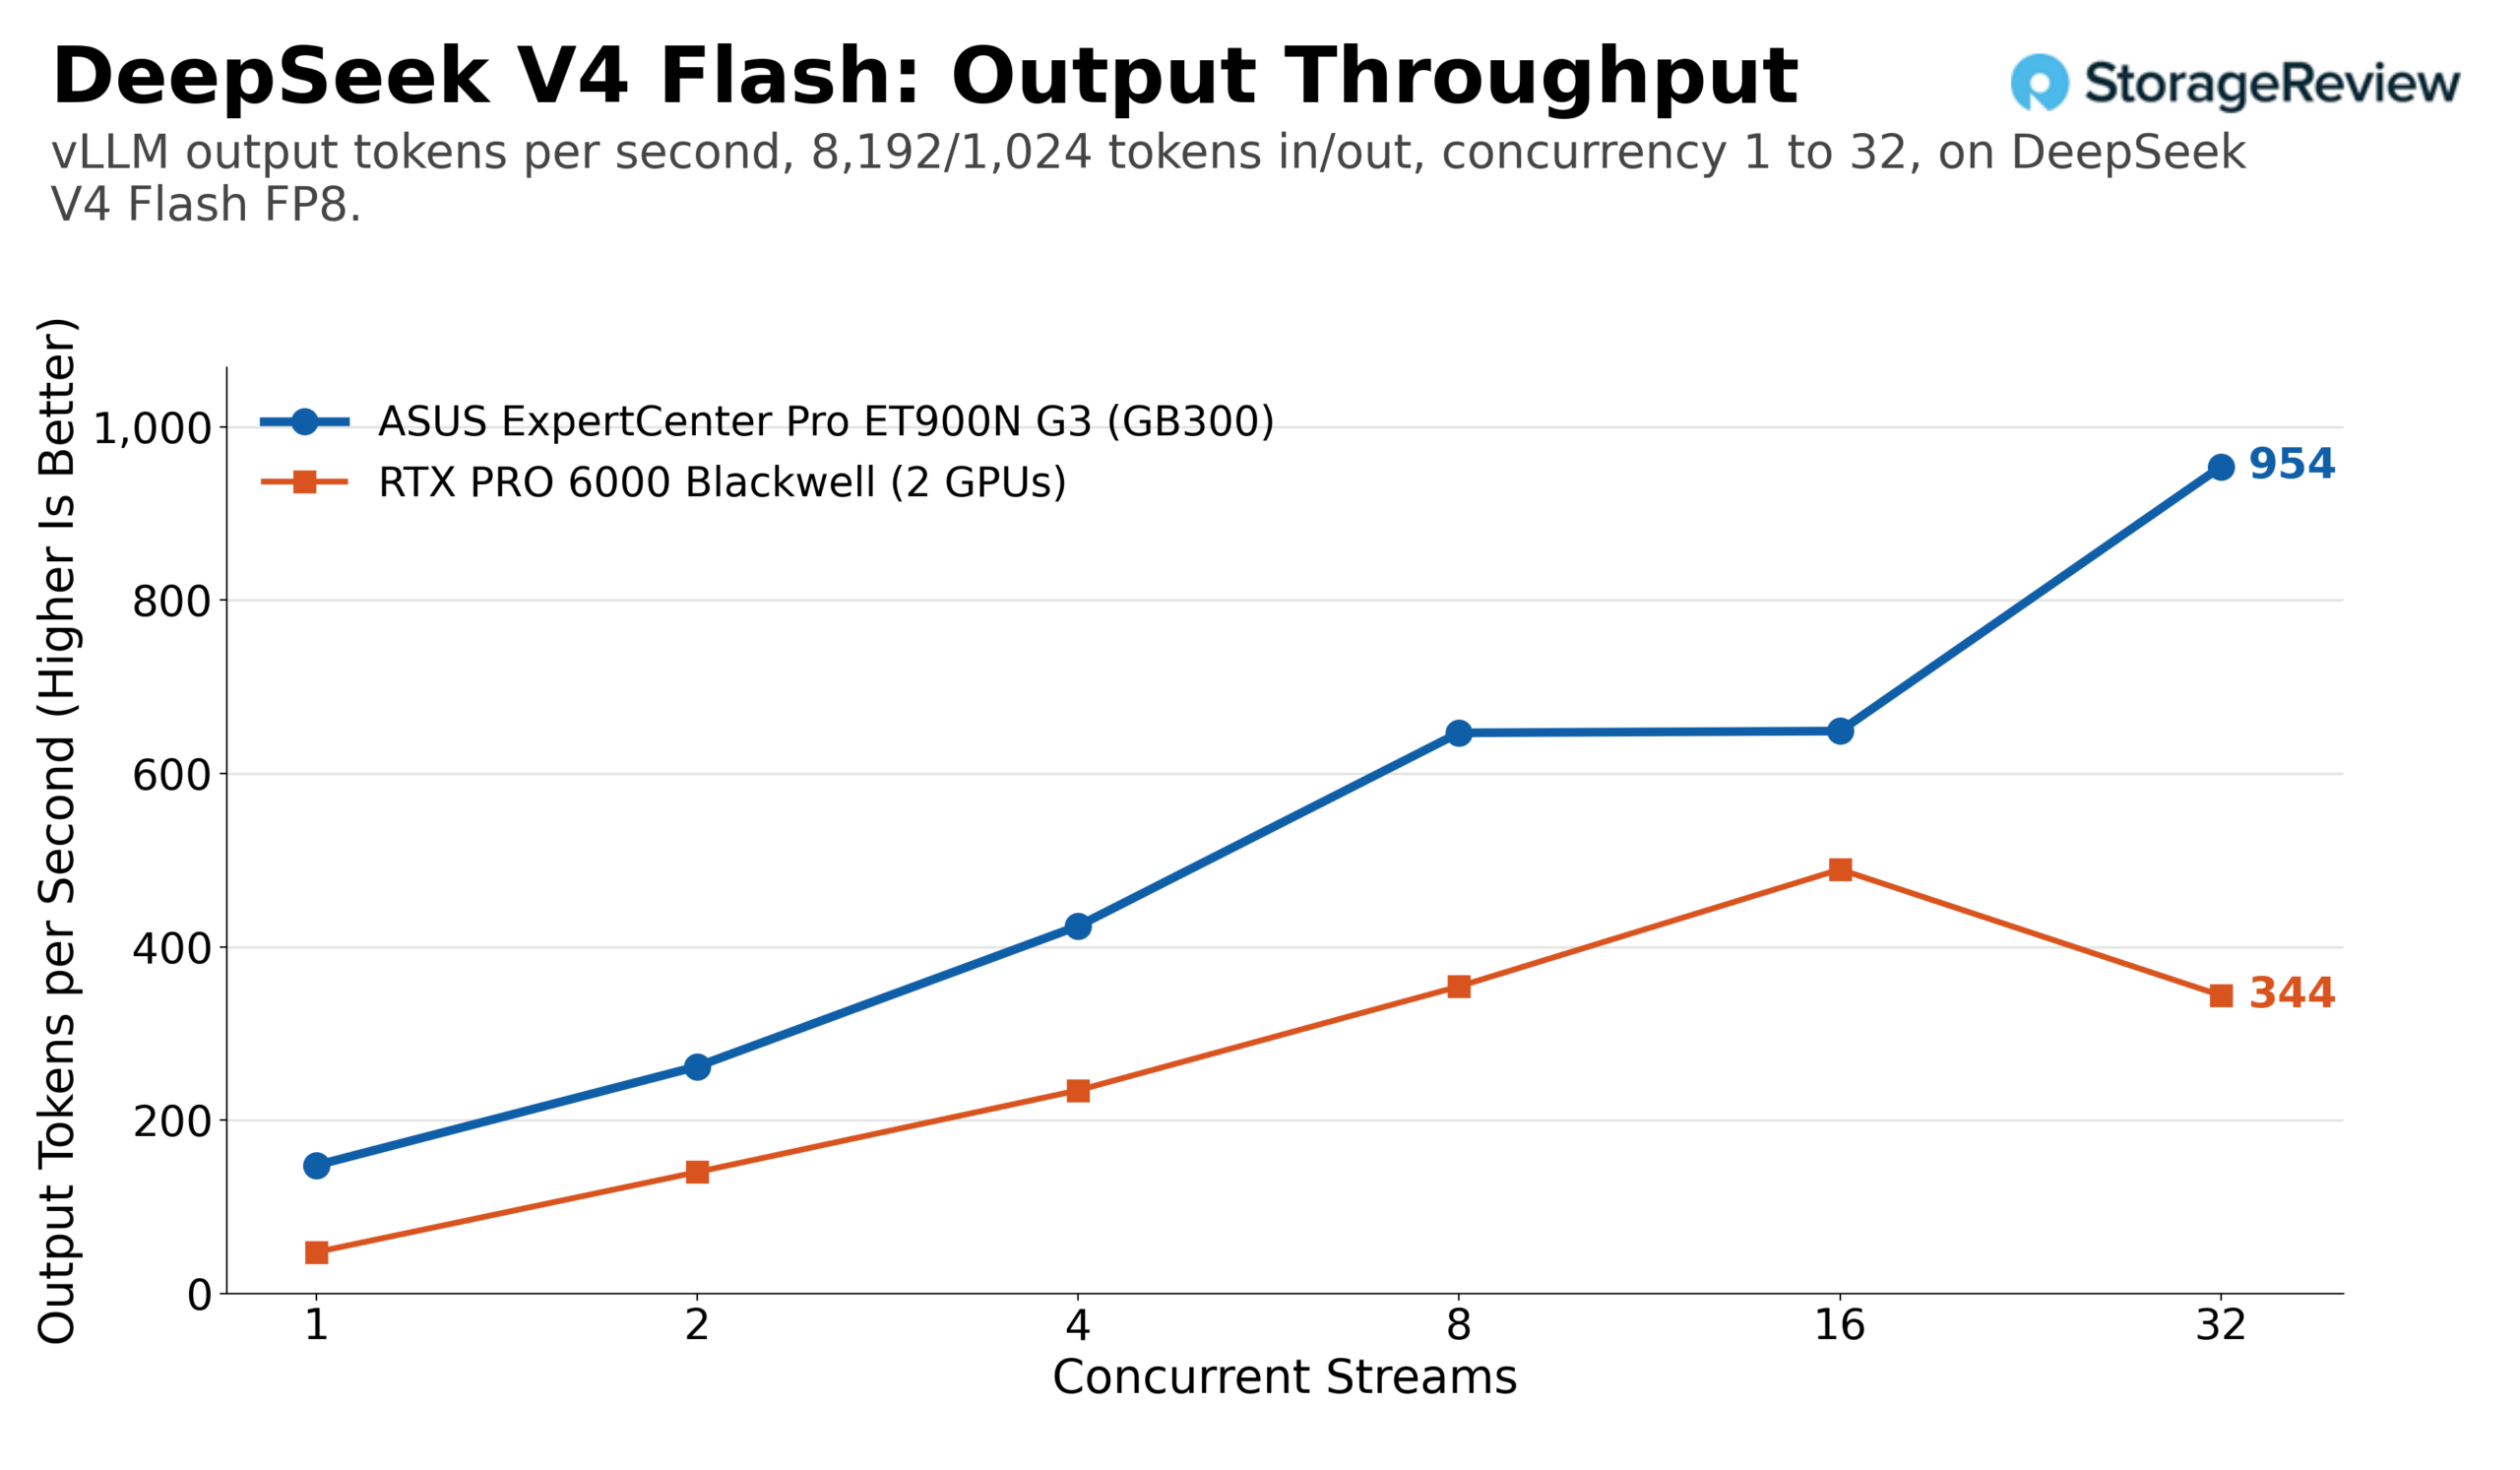
DeepSeek V4 Flash è il caso più semplice: un checkpoint nativo FP8 di circa 20 GB che il B300 gestisce senza problemi. La velocità di elaborazione in uscita con lo stesso carico di lavoro è aumentata da 152 token al secondo con 1 stream a 1,766 con 32 stream, portando la velocità di elaborazione totale a 3,532 token. Sul profilo con pre-riempimento intensivo, l'ET900N G3 è passato da 148 a 954 token di output al secondo, con un totale di 8,587 token. Una coppia di schede RTX PRO 6000 ha raggiunto un picco di quasi 800 token di output al secondo con lo stesso carico di lavoro e circa 490 con i prompt lunghi, con una curva irregolare a bassa concorrenza.
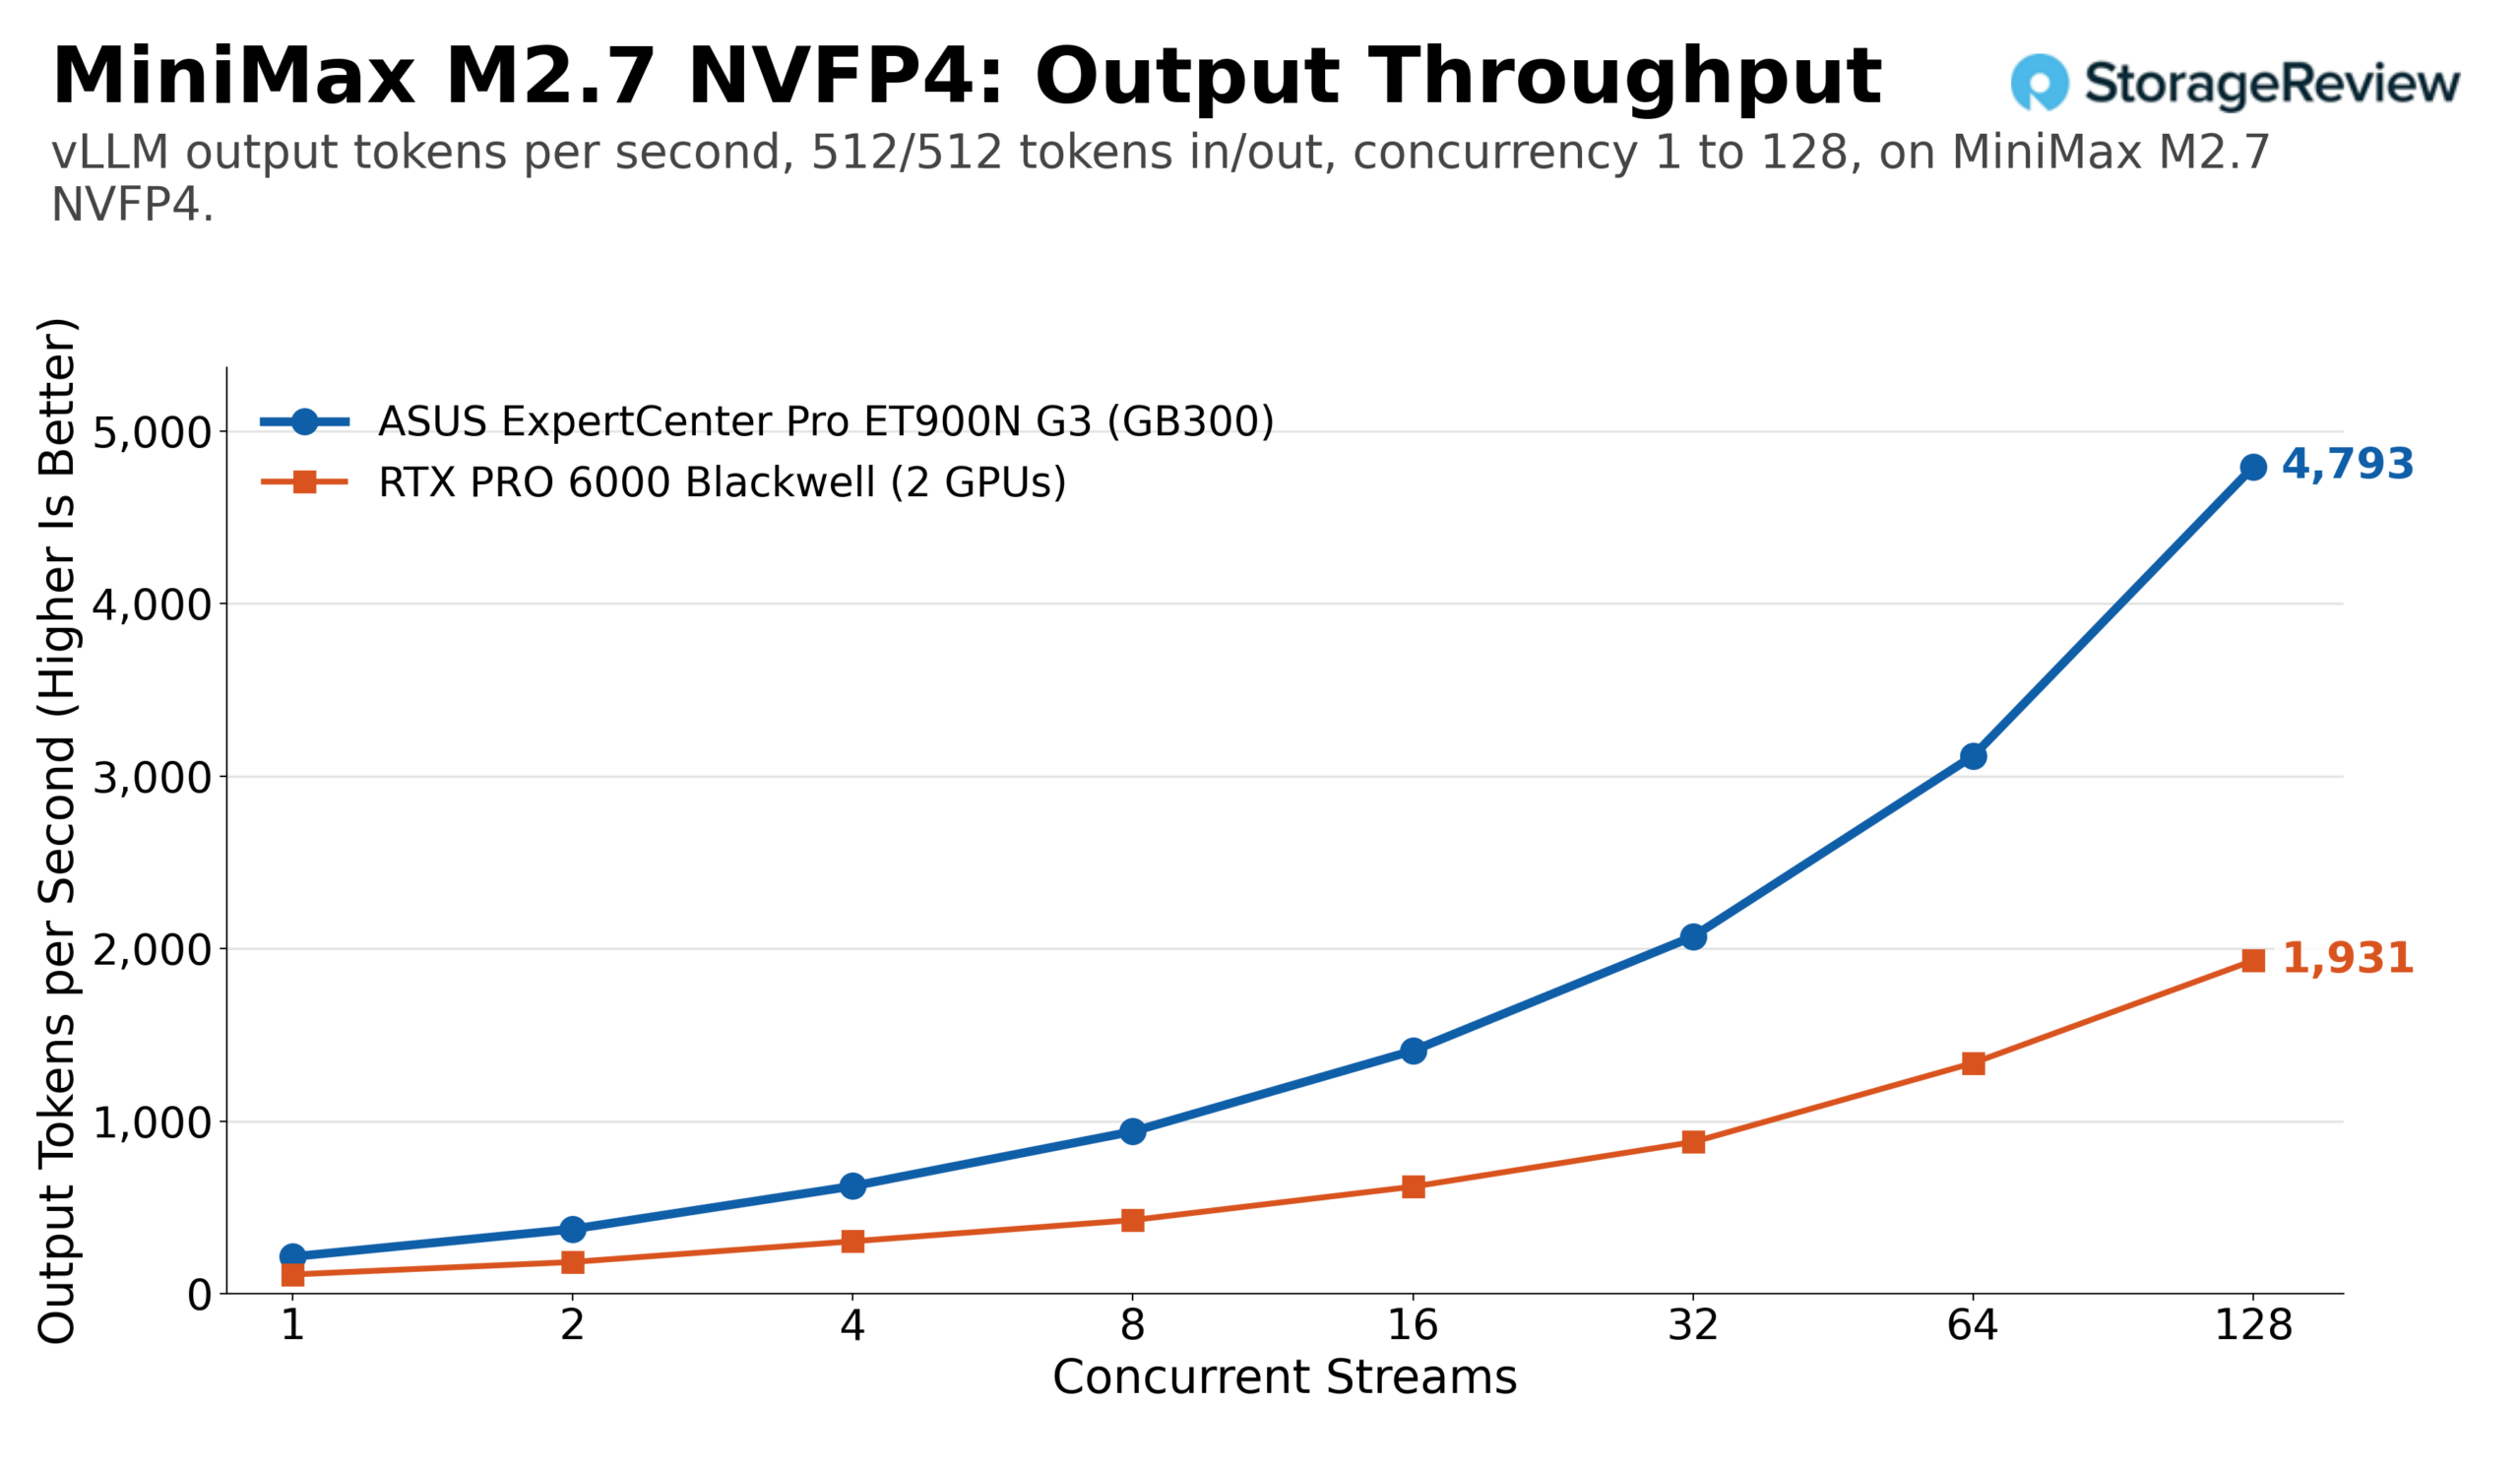
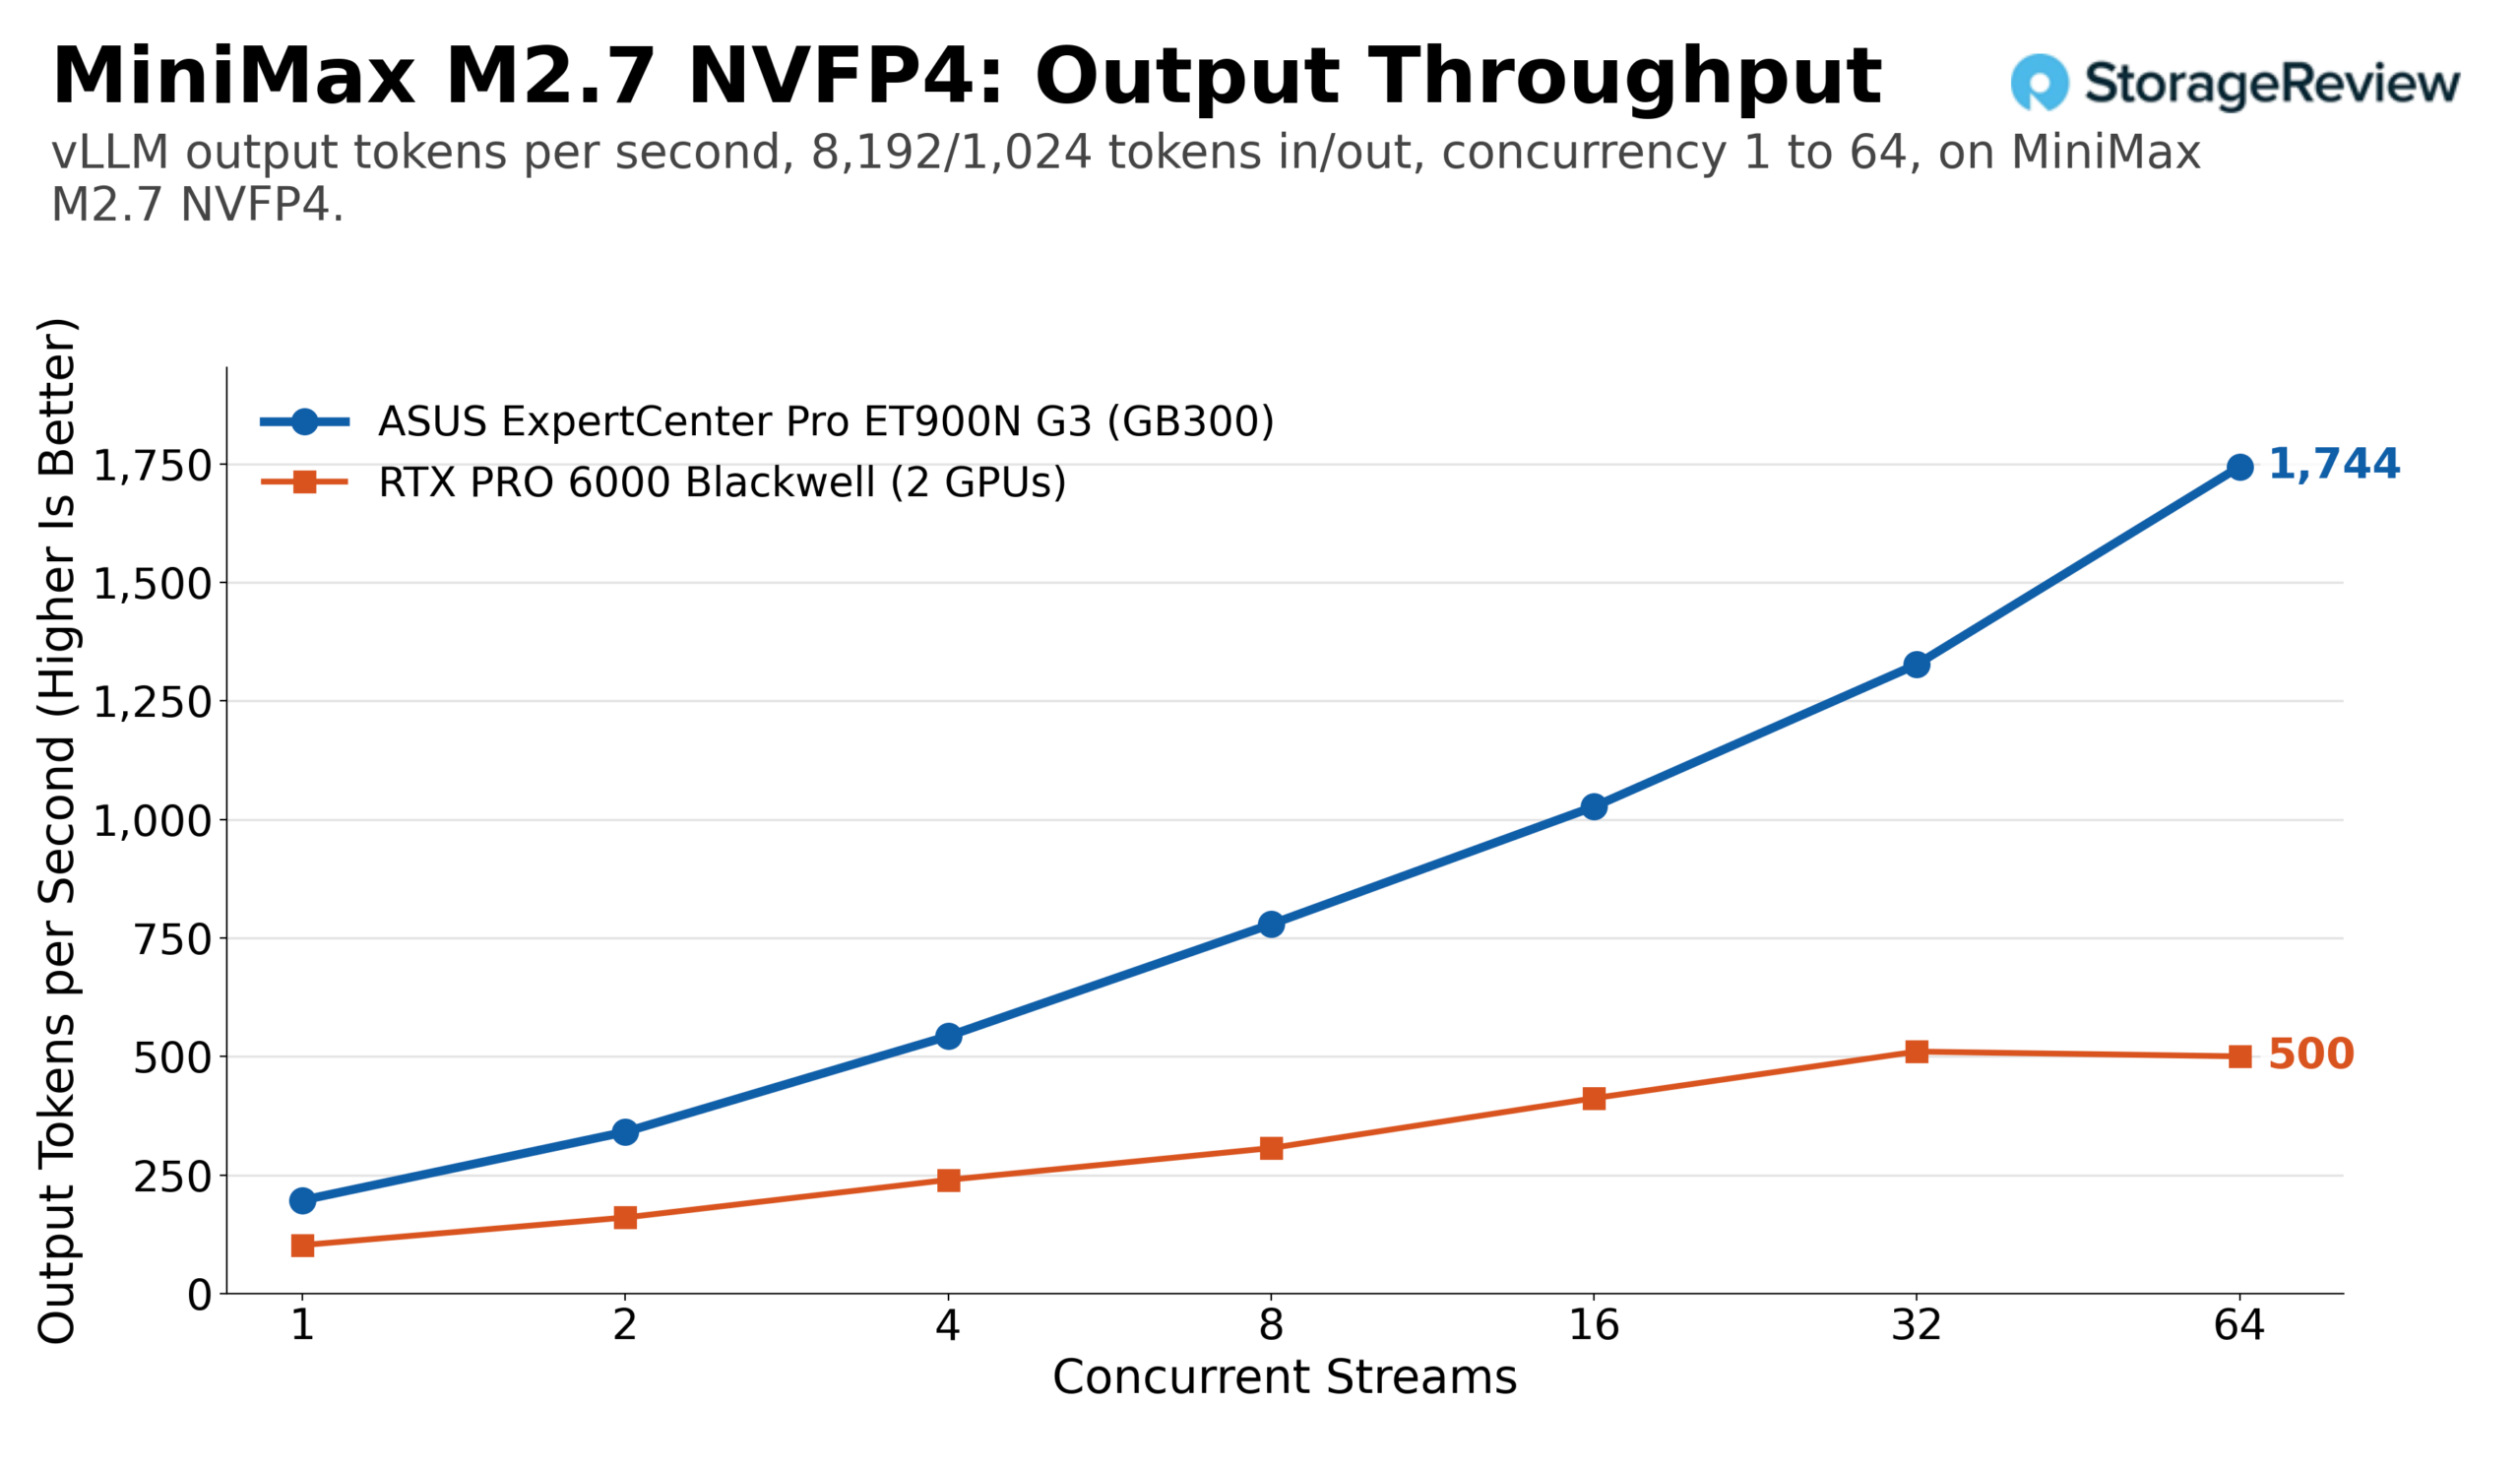
MiniMax M2.7 con quantizzazione NVFP4 di NVIDIA occupa circa 125 GB di HBM e ha raggiunto le prestazioni migliori tra i quattro. Il carico di lavoro equivalente è passato da 214 token di output al secondo su un singolo flusso a 4,793 su 128 flussi, con un throughput totale di 9,586. L'esecuzione con pre-riempimento intensivo ha raggiunto 1,744 token di output al secondo e 15,700 token totali al secondo con 64 flussi. Due schede RTX PRO 6000 hanno seguito lo stesso andamento con un'altezza inferiore alla metà, raggiungendo un massimo di circa 1,930 token di output al secondo con carico di lavoro equivalente e circa 510 con prompt lunghi.
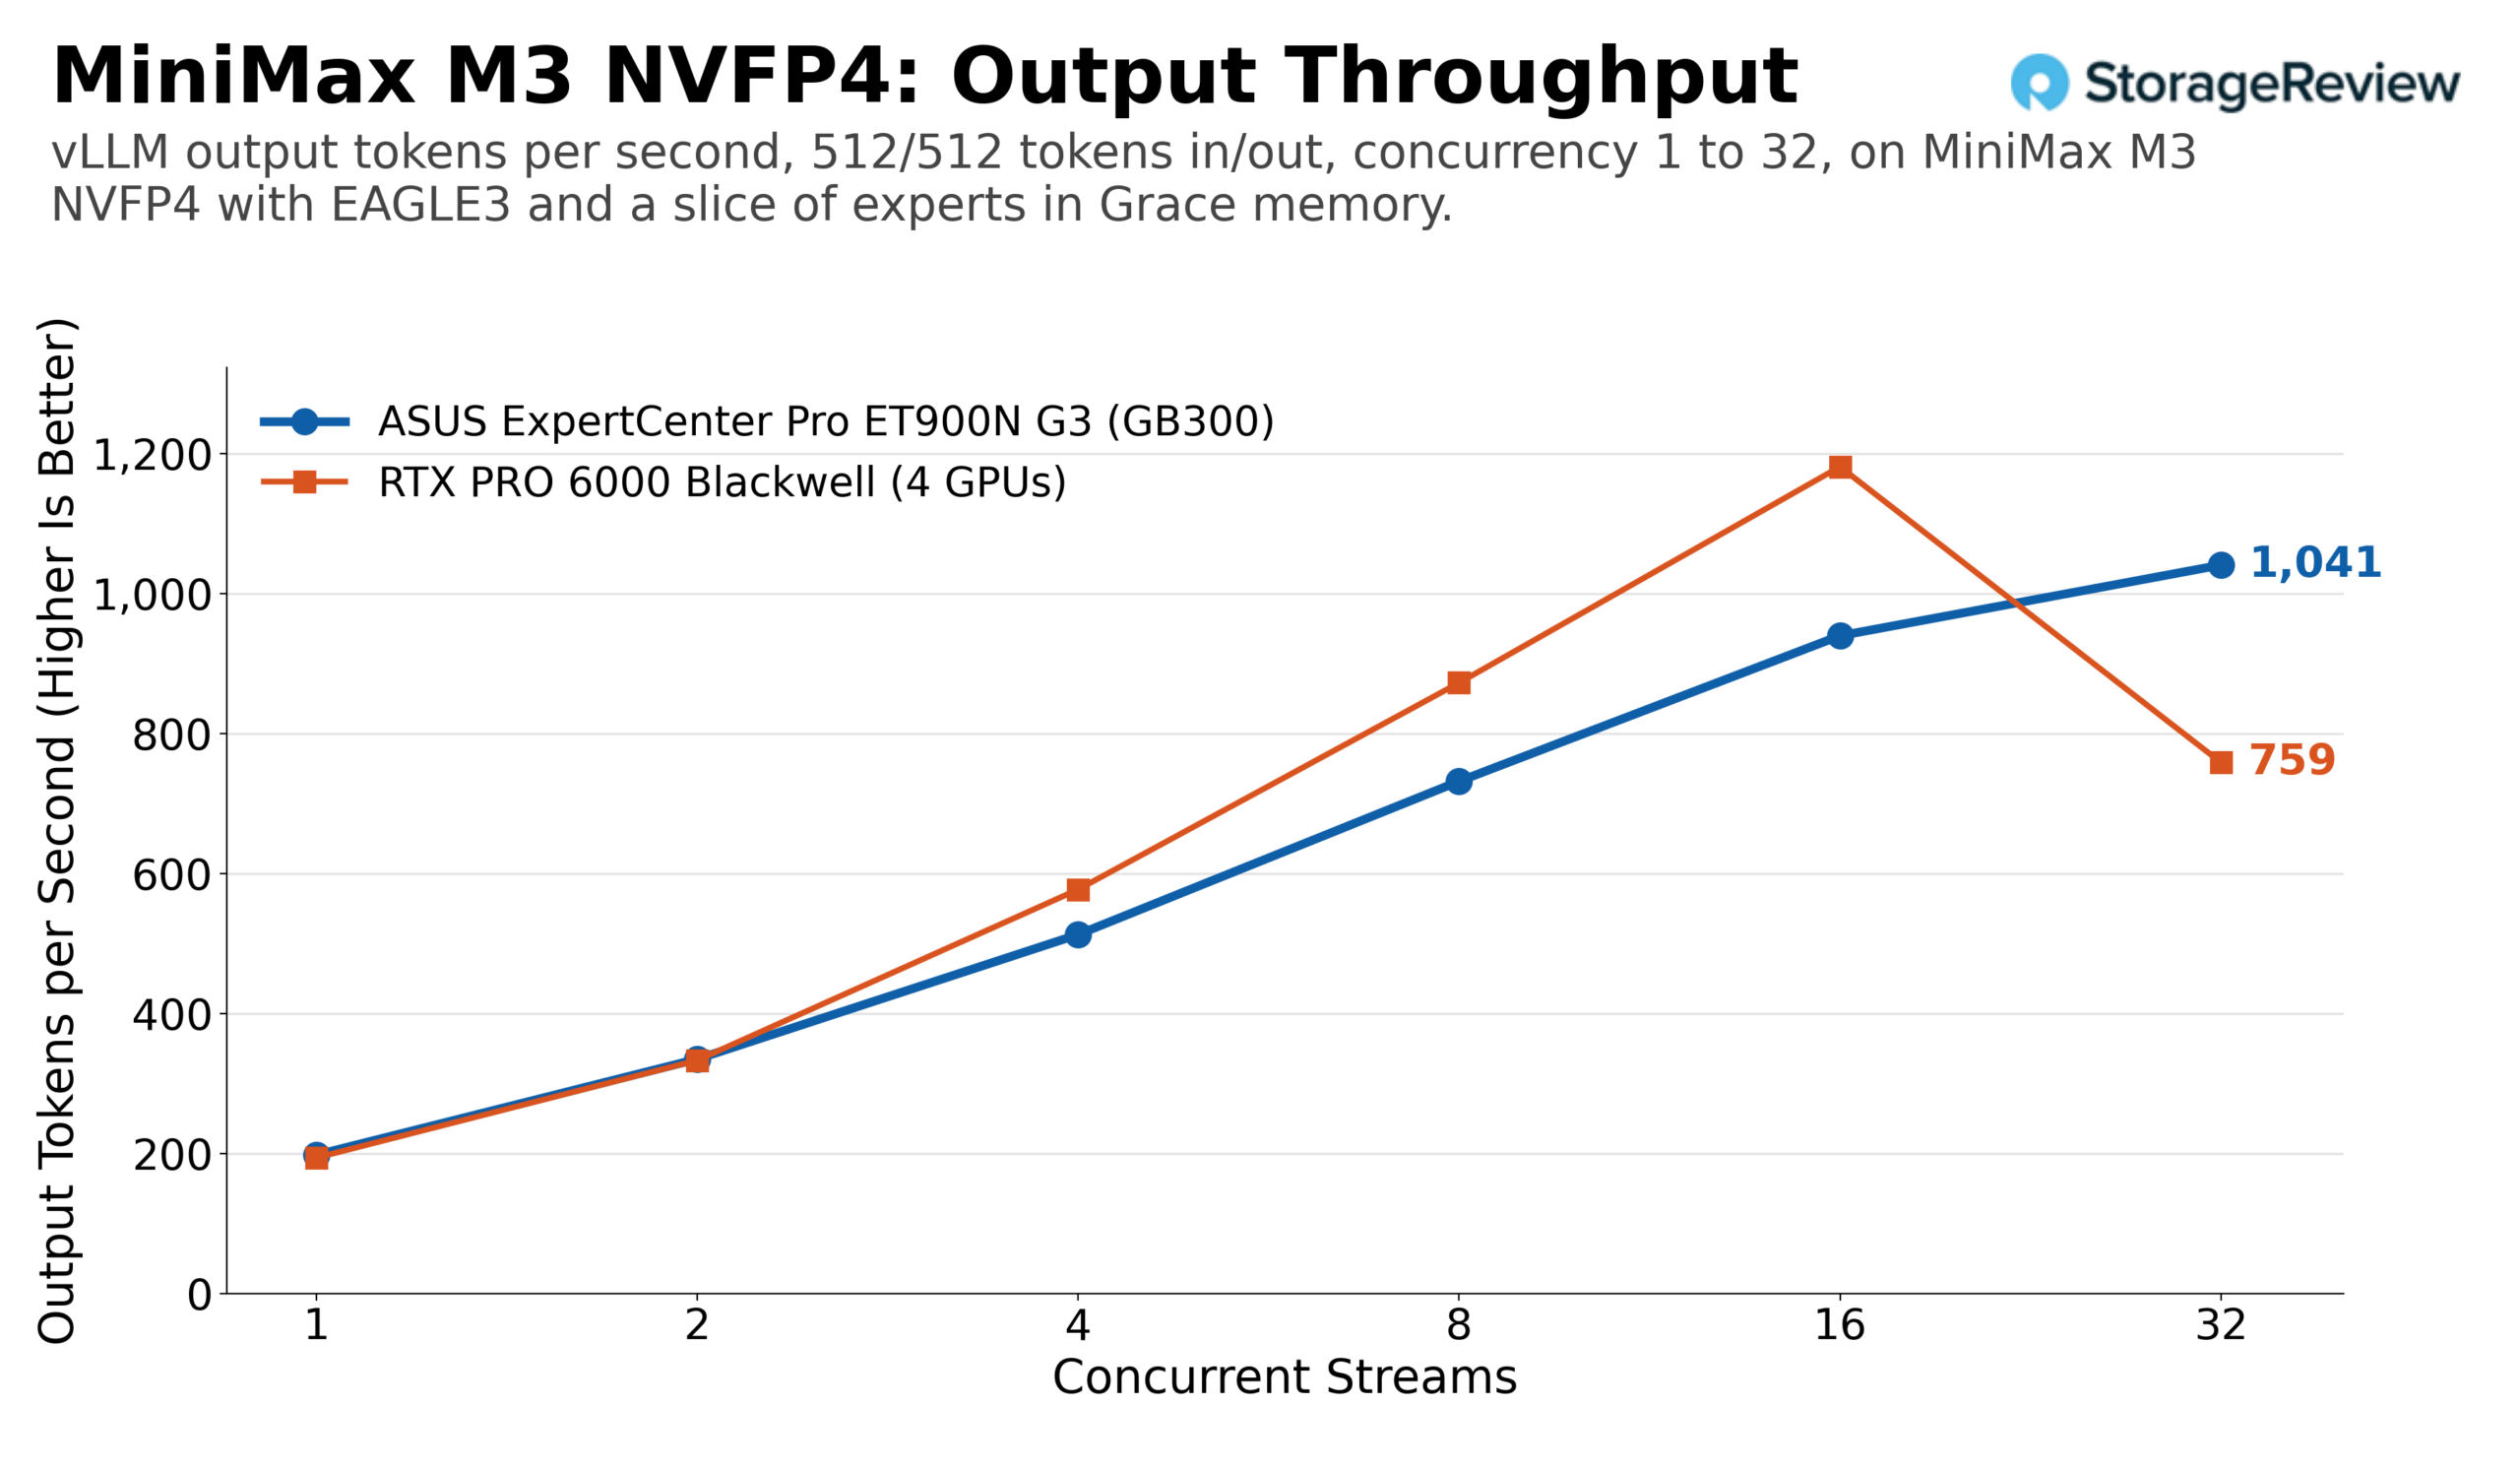
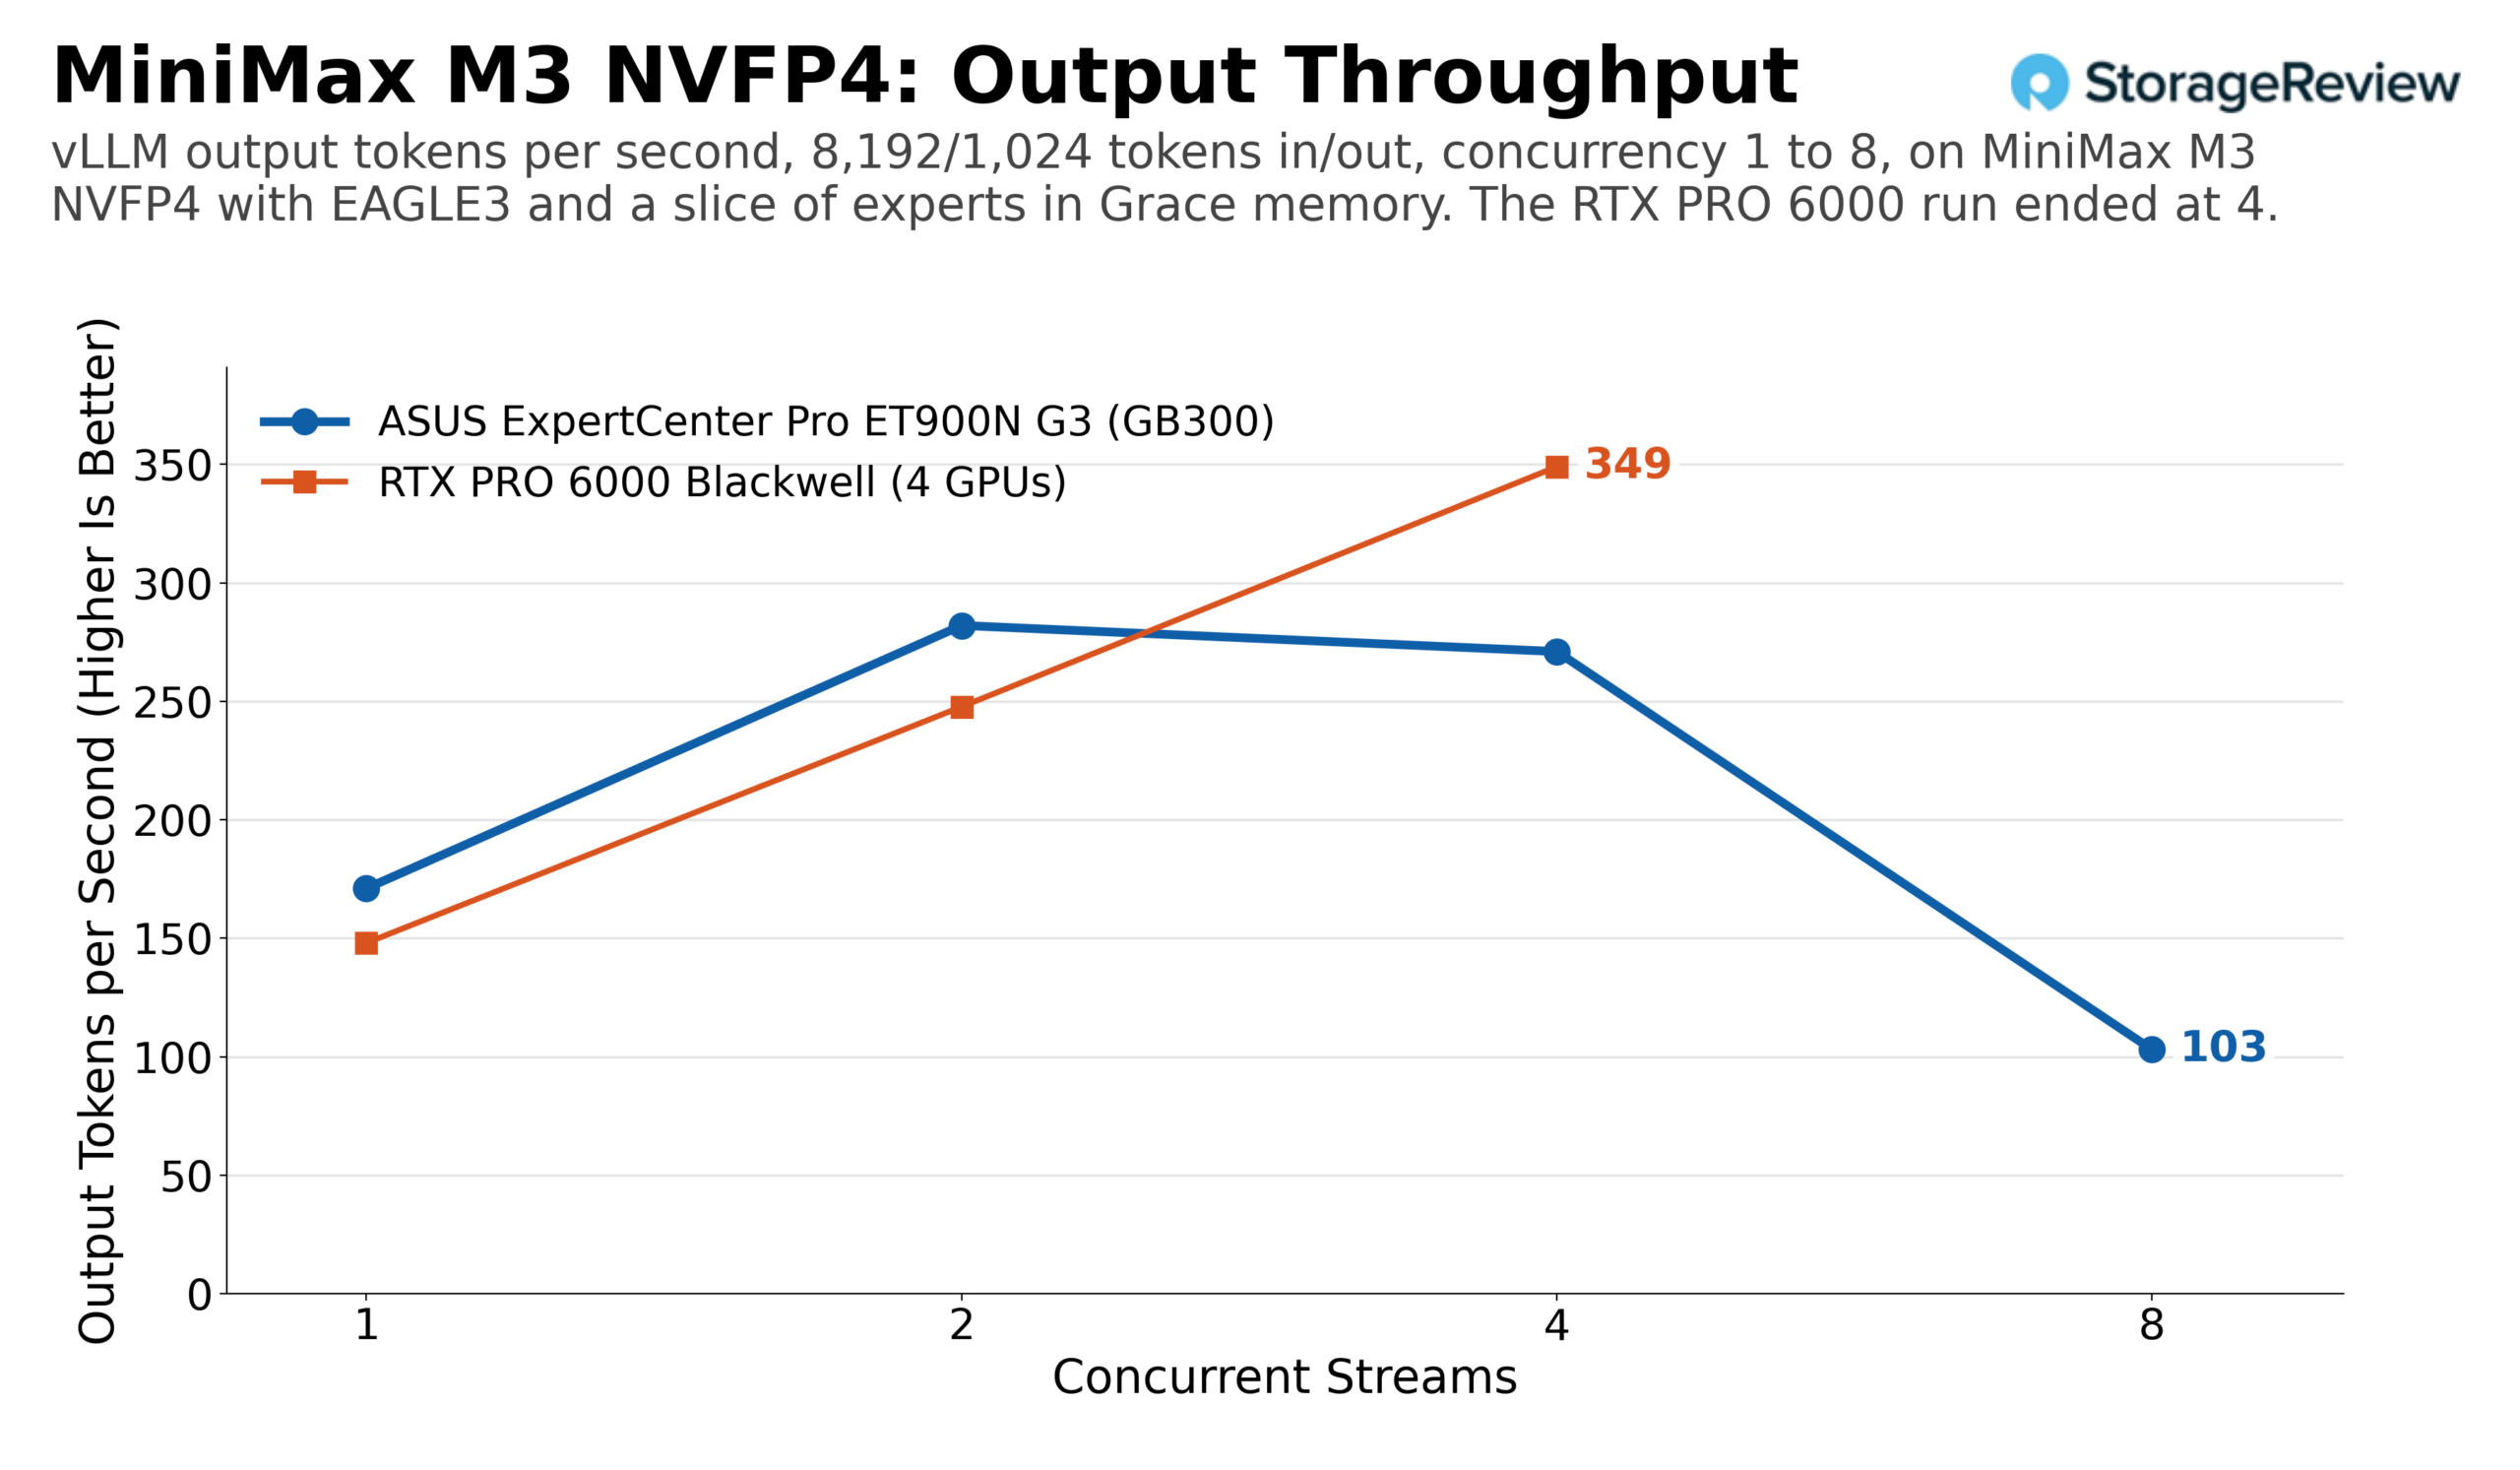
MiniMax M3 mostra cosa significa stare a malapena in memoria. Il checkpoint NVFP4 è più piccolo di 252 GB, ma anche il runtime e la cache KV necessitano di spazio, quindi una parte degli expert risiede nella memoria Grace e ogni fase di decodifica che li coinvolge attraversa NVLink-C2C. Con la decodifica speculativa EAGLE3, l'ET900N G3 ha raggiunto 1,041 token di output al secondo con 32 stream sullo stesso carico di lavoro, e il profilo con prefill intensivo ha raggiunto un picco di 282 con due stream, si è mantenuto a 271 con quattro ed è sceso a 103 con otto, poiché i prompt lunghi hanno consumato la cache rimanente. Quattro schede RTX PRO 6000 con lo stesso decoder speculativo hanno tenuto il passo con otto stream e lo hanno superato con 16 stream con circa 1,180 token di output al secondo, per poi scendere a circa 760 con 32 stream. Nel profilo con precaricamento intensivo, il box a quattro schede conteneva circa 349 token di output al secondo su quattro flussi, contro i 271 della Station. Un modello che si colloca proprio al limite della memoria HBM è l'unico in questo set in cui 384 GB di VRAM su quattro schede competono con 252 GB di HBM più offload.
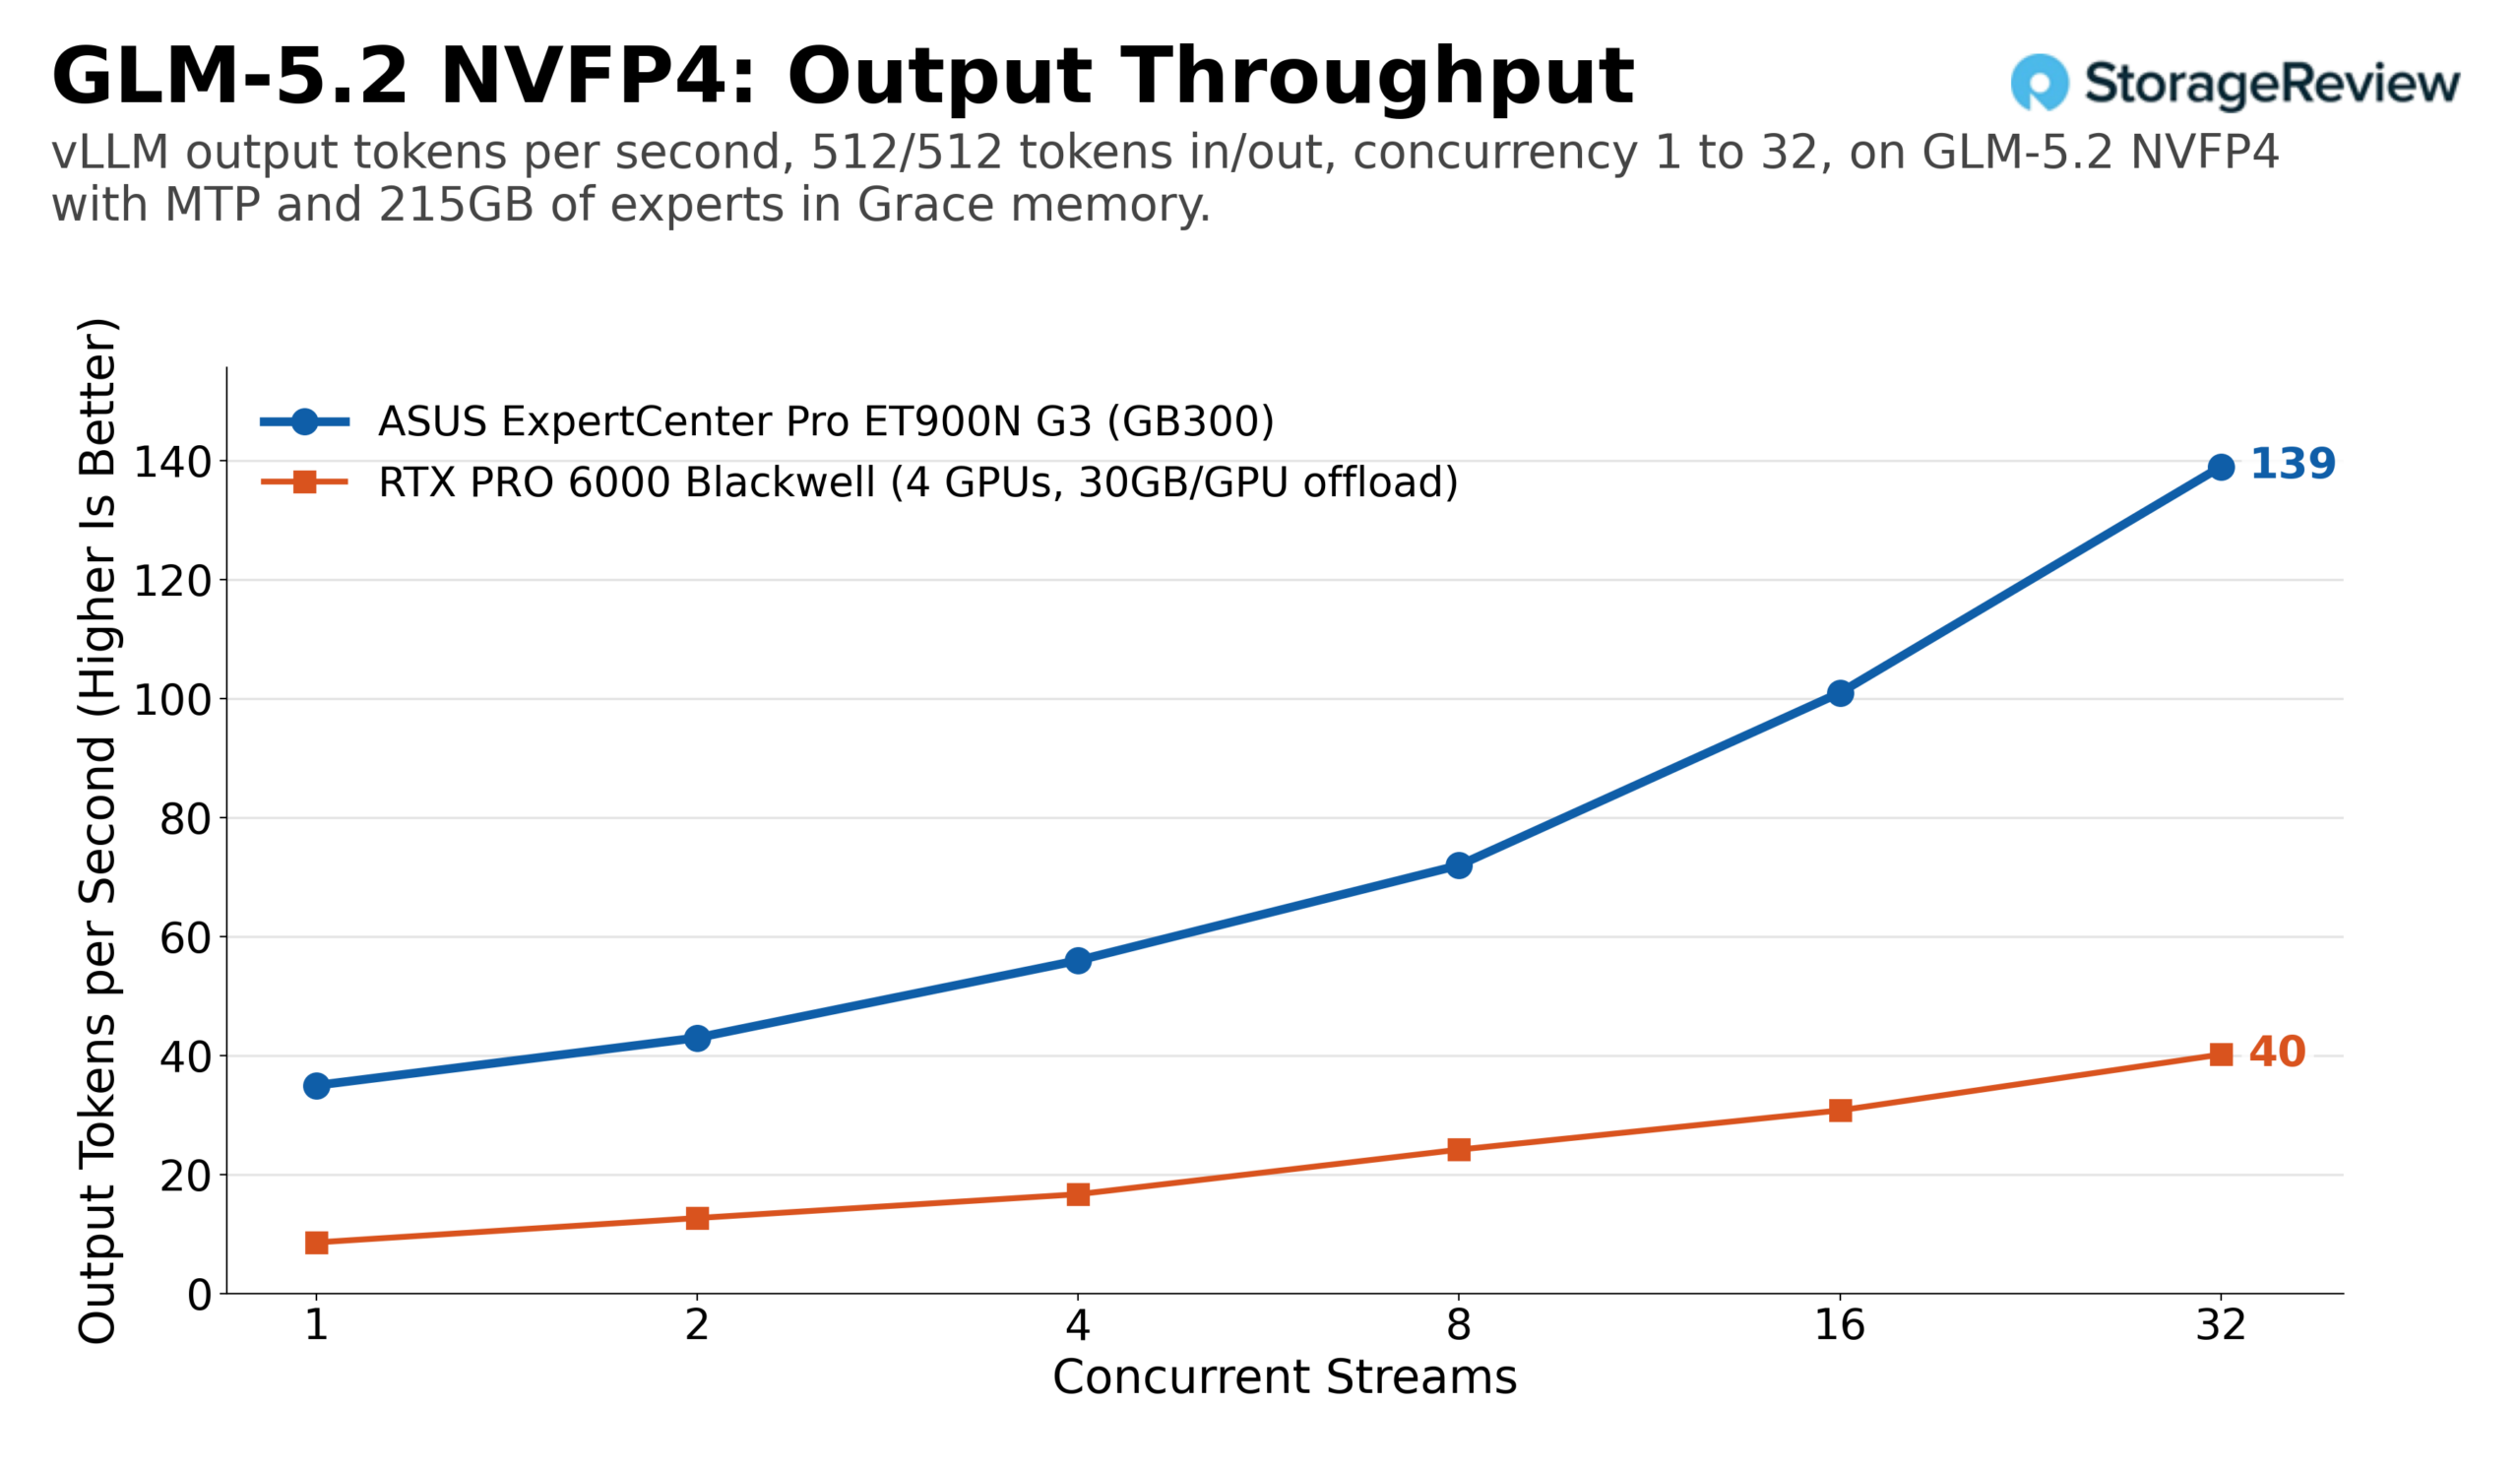
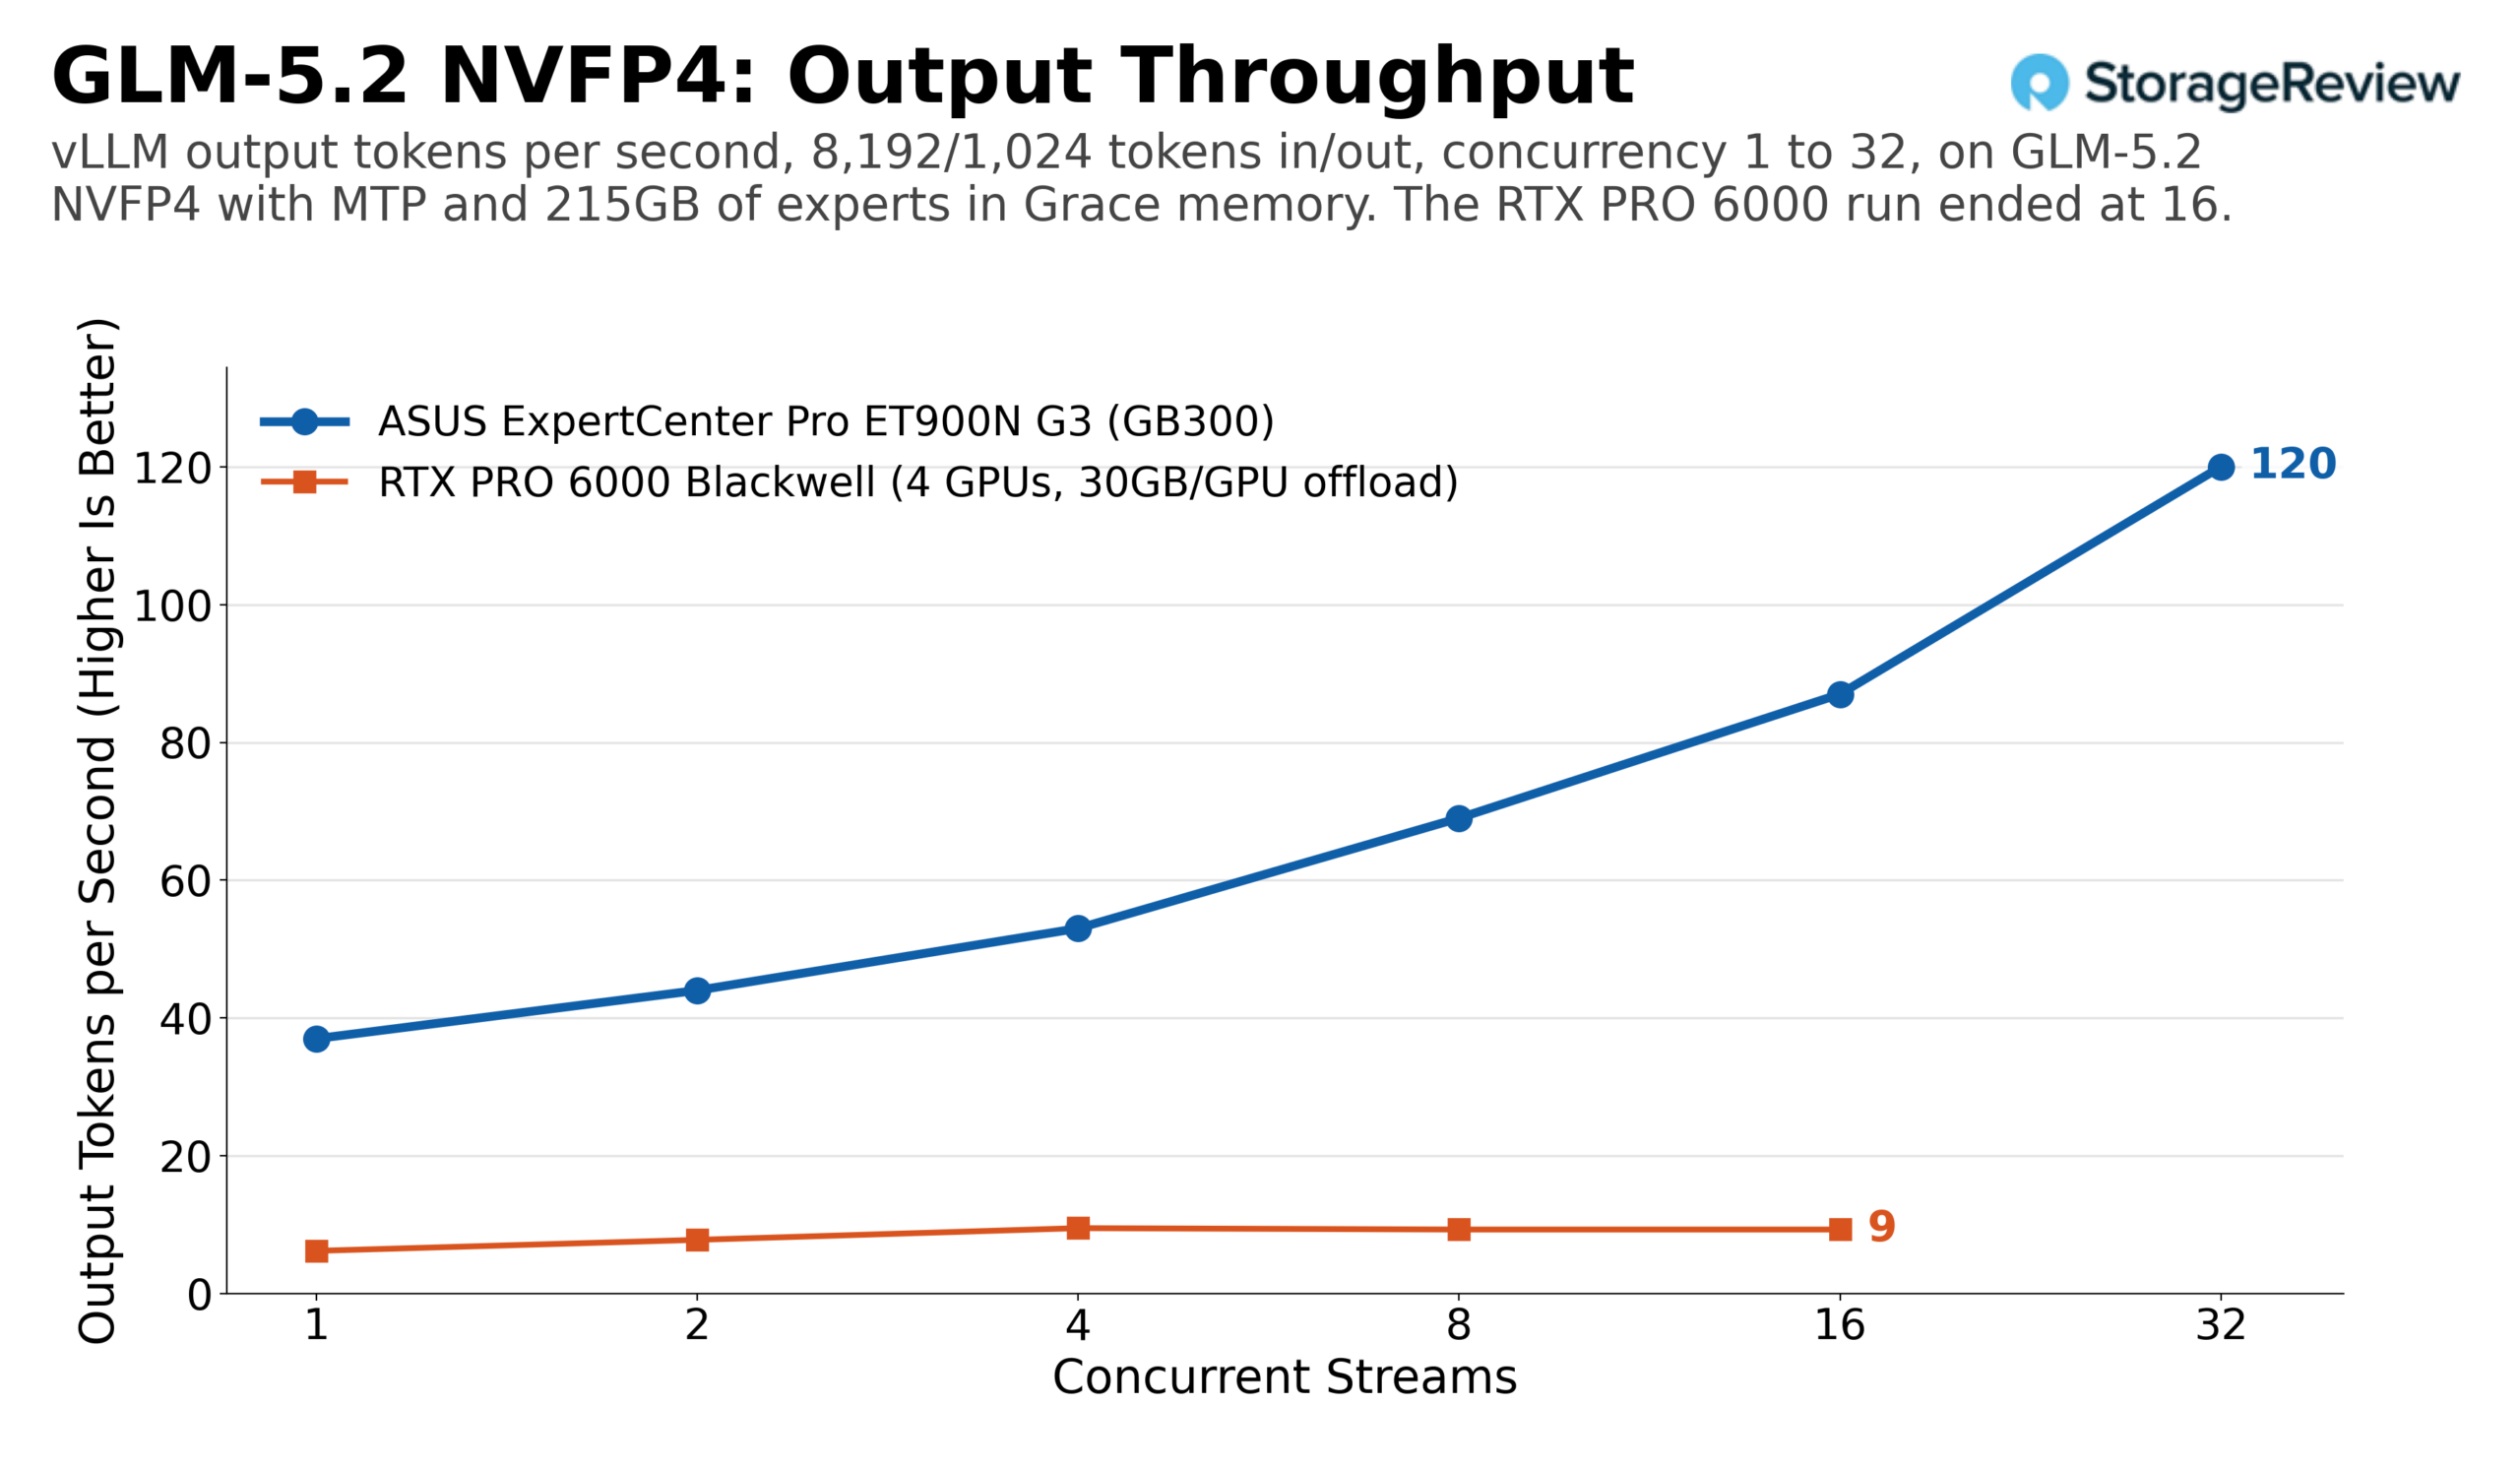
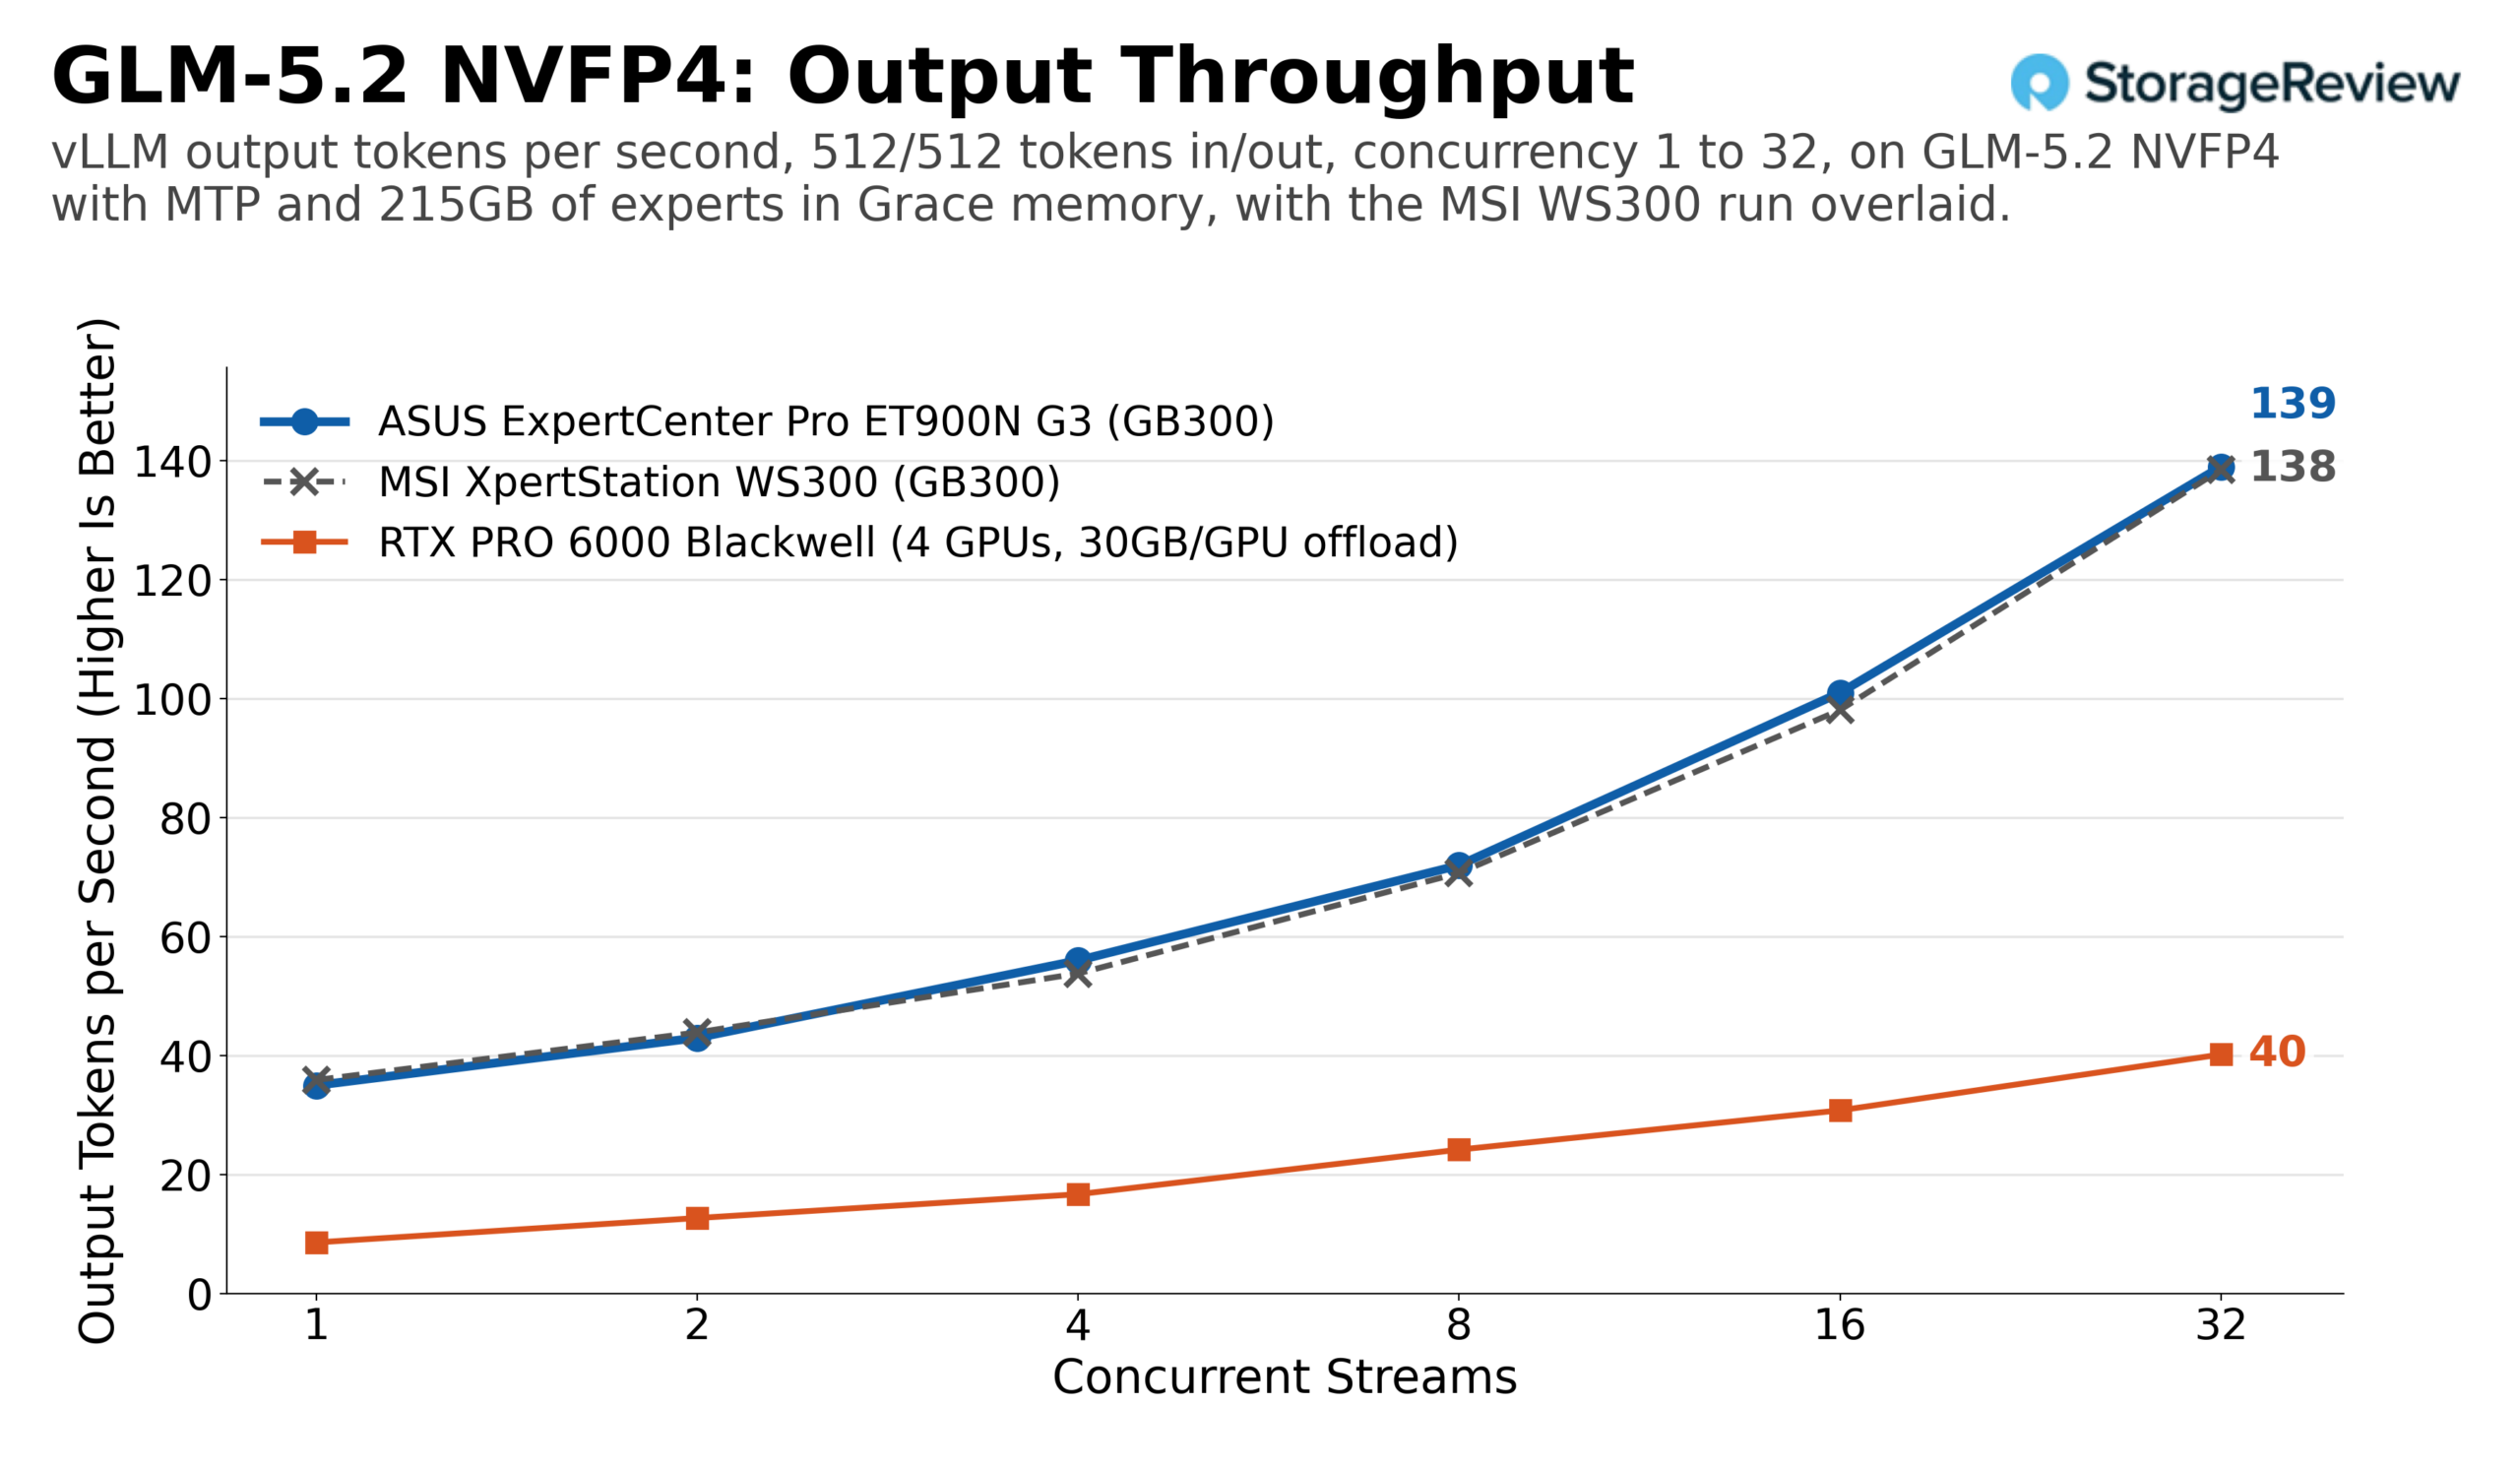
GLM-5.2 è il caso d'uso reso possibile solo dal pool coerente. Il checkpoint NVFP4 mantiene circa 215 GB di pesi esperti nella memoria Grace con decodifica speculativa MTP, e l'ET900N G3 lo ha gestito a 35 token di output al secondo per un flusso e 139 per 32 flussi con un carico di lavoro equivalente, con un throughput totale che ha raggiunto 277. Sul profilo con pre-riempimento intensivo, la scansione è stata eseguita su 32 flussi, raggiungendo 120 token di output al secondo e 1,079 token totali. Quattro schede RTX PRO 6000, ciascuna con circa 30 GB di offload alla memoria host, sono riuscite a gestire circa 40 token di output al secondo su 32 flussi, stabilizzandosi a circa 9-10 su prompt lunghi a partire da quattro flussi. Nessuno dei due sistemi fa sembrare veloce un modello da 433 GB, ma i 396 GB/s di LPDDR5X del GB300 e i 900 GB/s di NVLink-C2C, che consentono agli esperti di offload di continuare a scalare laddove la memoria host collegata tramite PCIe su quattro schede si ferma.
Rispetto all'MSI WS300, i risultati del modello di punta dell'ET900N G3 si discostano di circa l'1% in ogni punto di confronto possibile: 1,766 token di output al secondo su DeepSeek V4 Flash a 32 stream su entrambe le torri, 4,793 contro 4,801 su MiniMax M2.7 a 128, 1,041 su MiniMax M3 a 32 su entrambe e 139 su GLM-5.2 a 32 su entrambe.
Modelli condivisi con RTX PRO 6000, H200 NVL e DGX Spark
La seconda parte del benchmark utilizza modelli sufficientemente piccoli da poter essere utilizzati da qualsiasi sistema: GPT-OSS-20B e 120B in formato nativo MXFP4; Llama 3.1 8B in formato BF16 e FP8; Mistral Small 24B in formato BF16 e FP8; e Qwen3 Coder 30B in formato BF16 e FP8. Una novità rispetto alla recensione del WS300 è la presenza di una singola H200 NVL, la scheda Hopper da 141 GB di NVIDIA, che fornisce al confronto un acceleratore per data center di una generazione precedente.
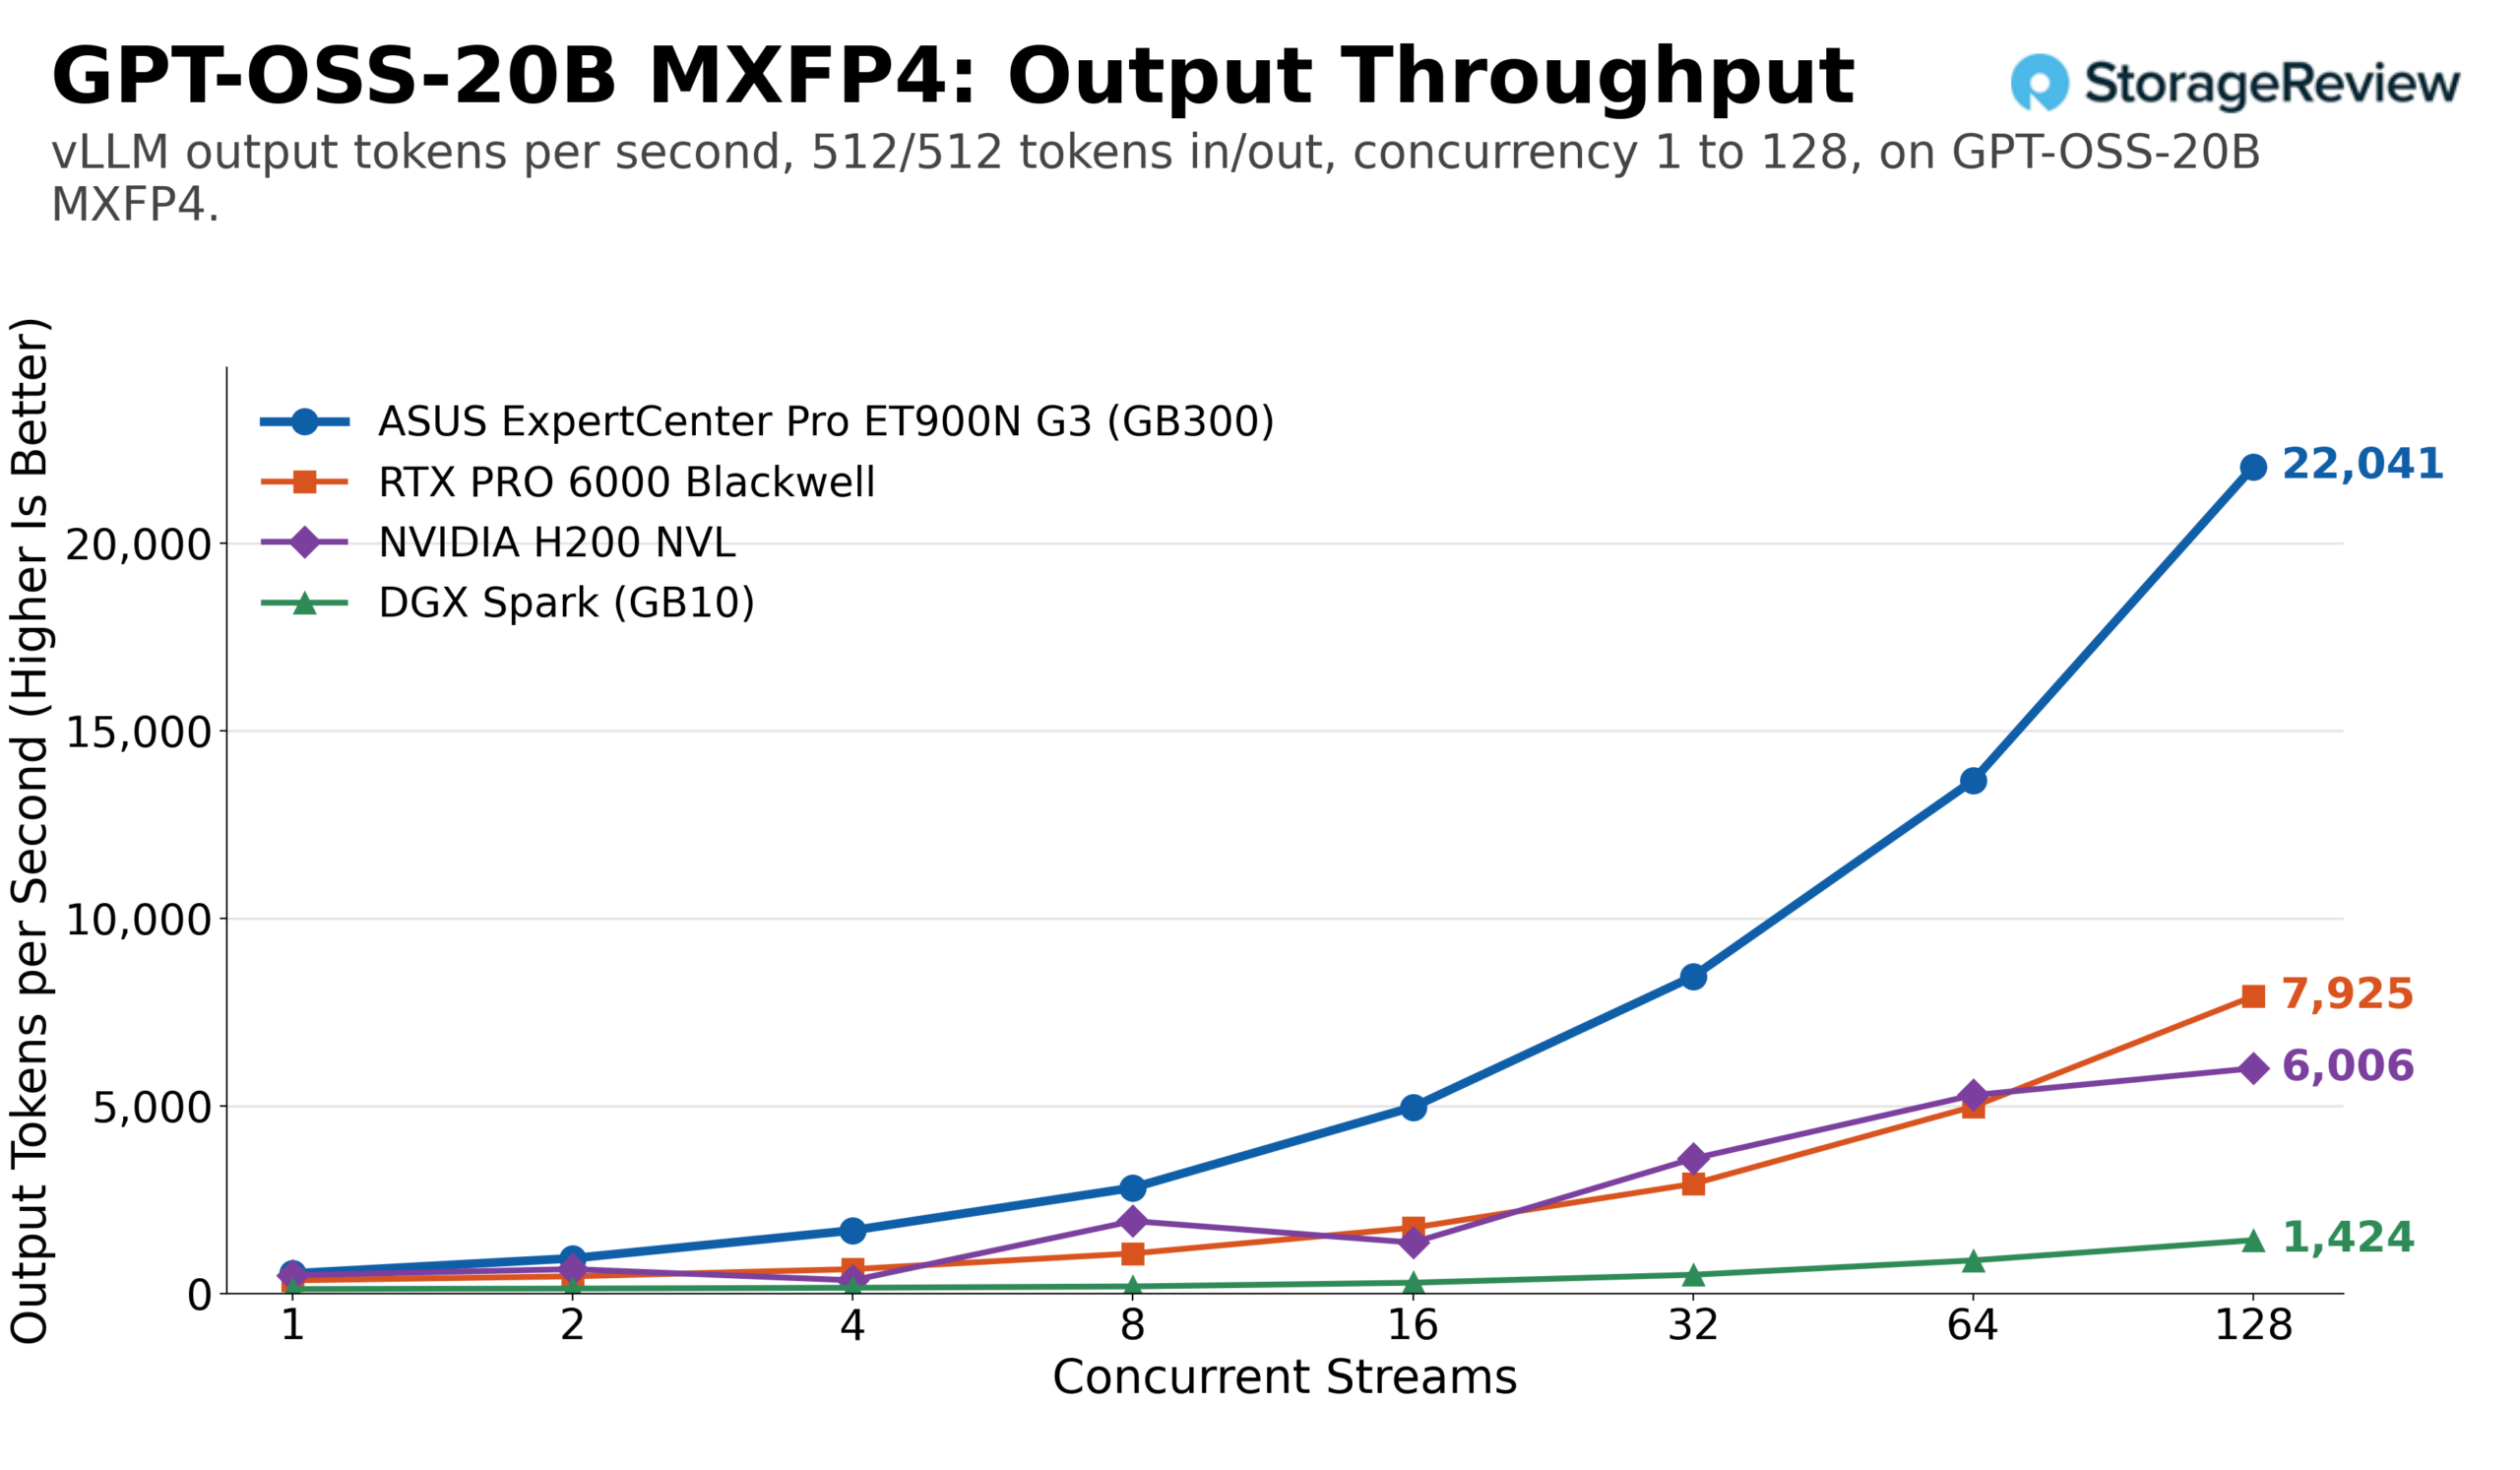
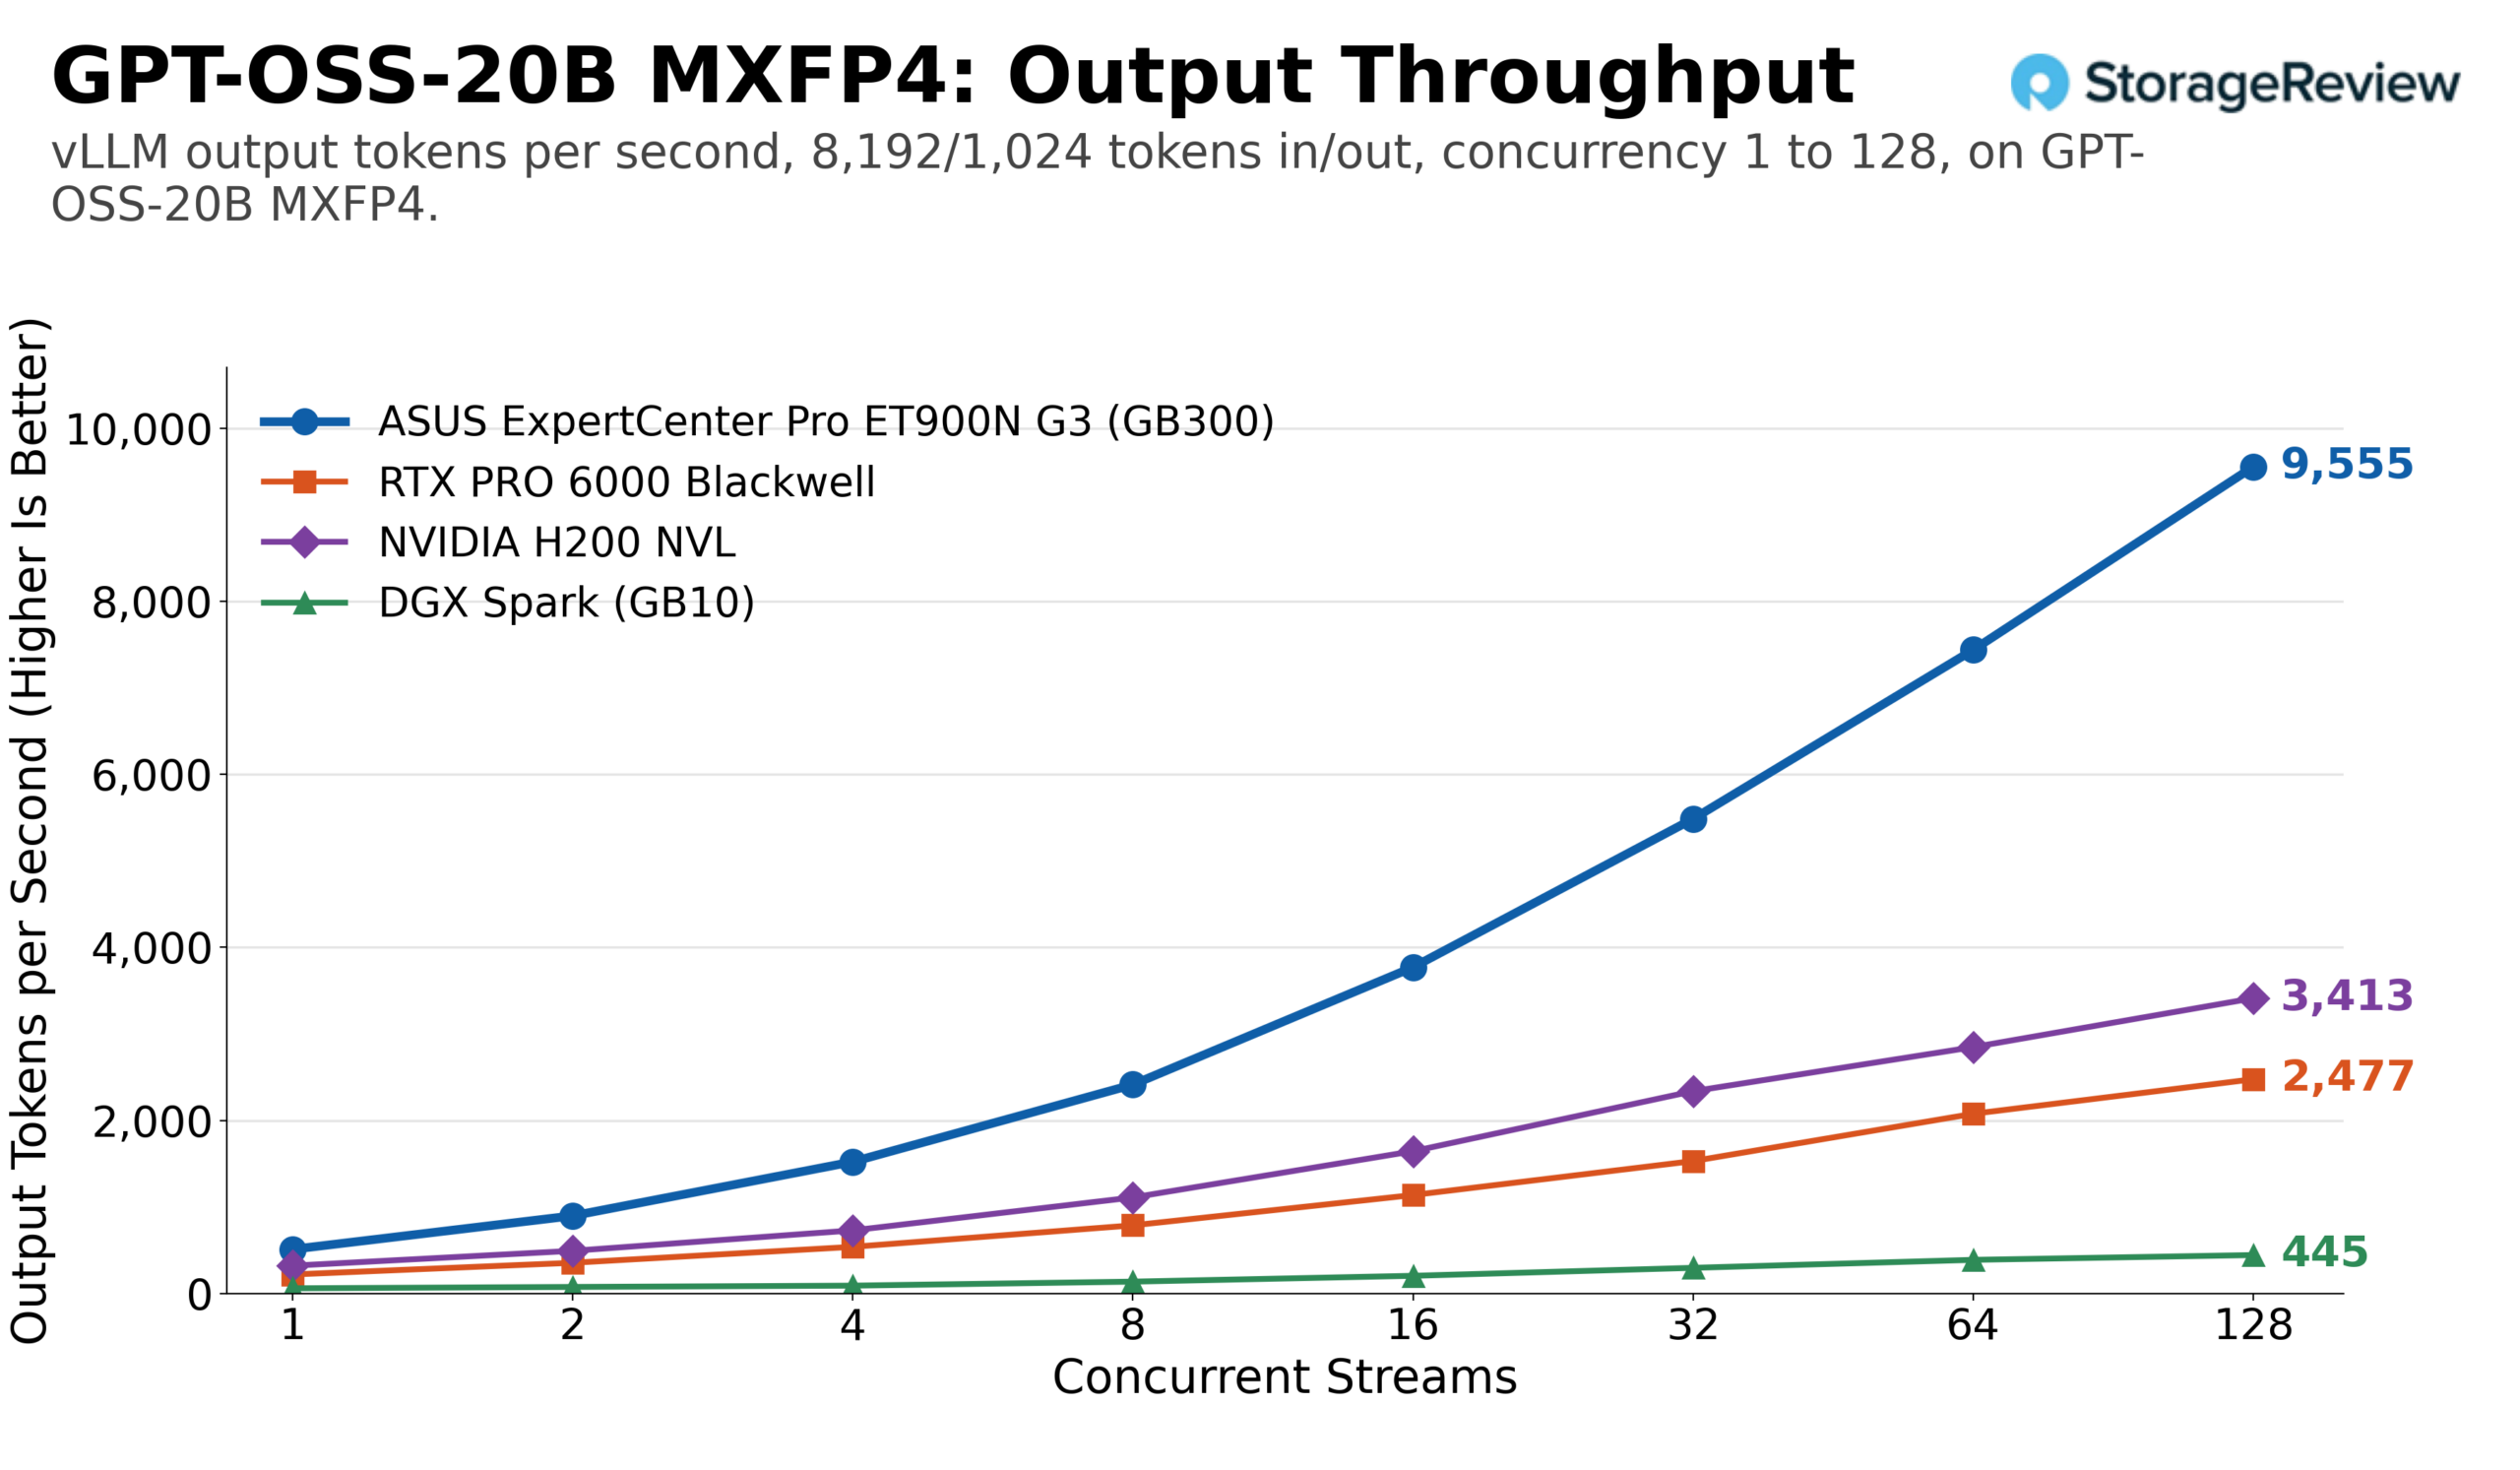
GPT-OSS-20B è il test più accessibile del set, un checkpoint che ogni sistema supera agevolmente, e con lo stesso carico di lavoro l'ET900N G3 ha raggiunto 22,041 token di output al secondo con 128 stream, ovvero 44,082 in totale, contro circa 7,920 per la RTX PRO 6000, 6,010 per la H200 NVL e 1,420 per la DGX Spark. In modalità single-stream, la Station ha prodotto 536 token di output al secondo, rispetto ai 354 della scheda, ai 489 dell'H200 e ai 120 della Spark. Il profilo con pre-riempimento intensivo ha ampliato il divario: 9,555 token di output al secondo e 85,994 totali con 128 stream per la Station, con la RTX PRO 6000 a circa 2,480, l'H200 NVL a 3,410 e la Spark a 445.
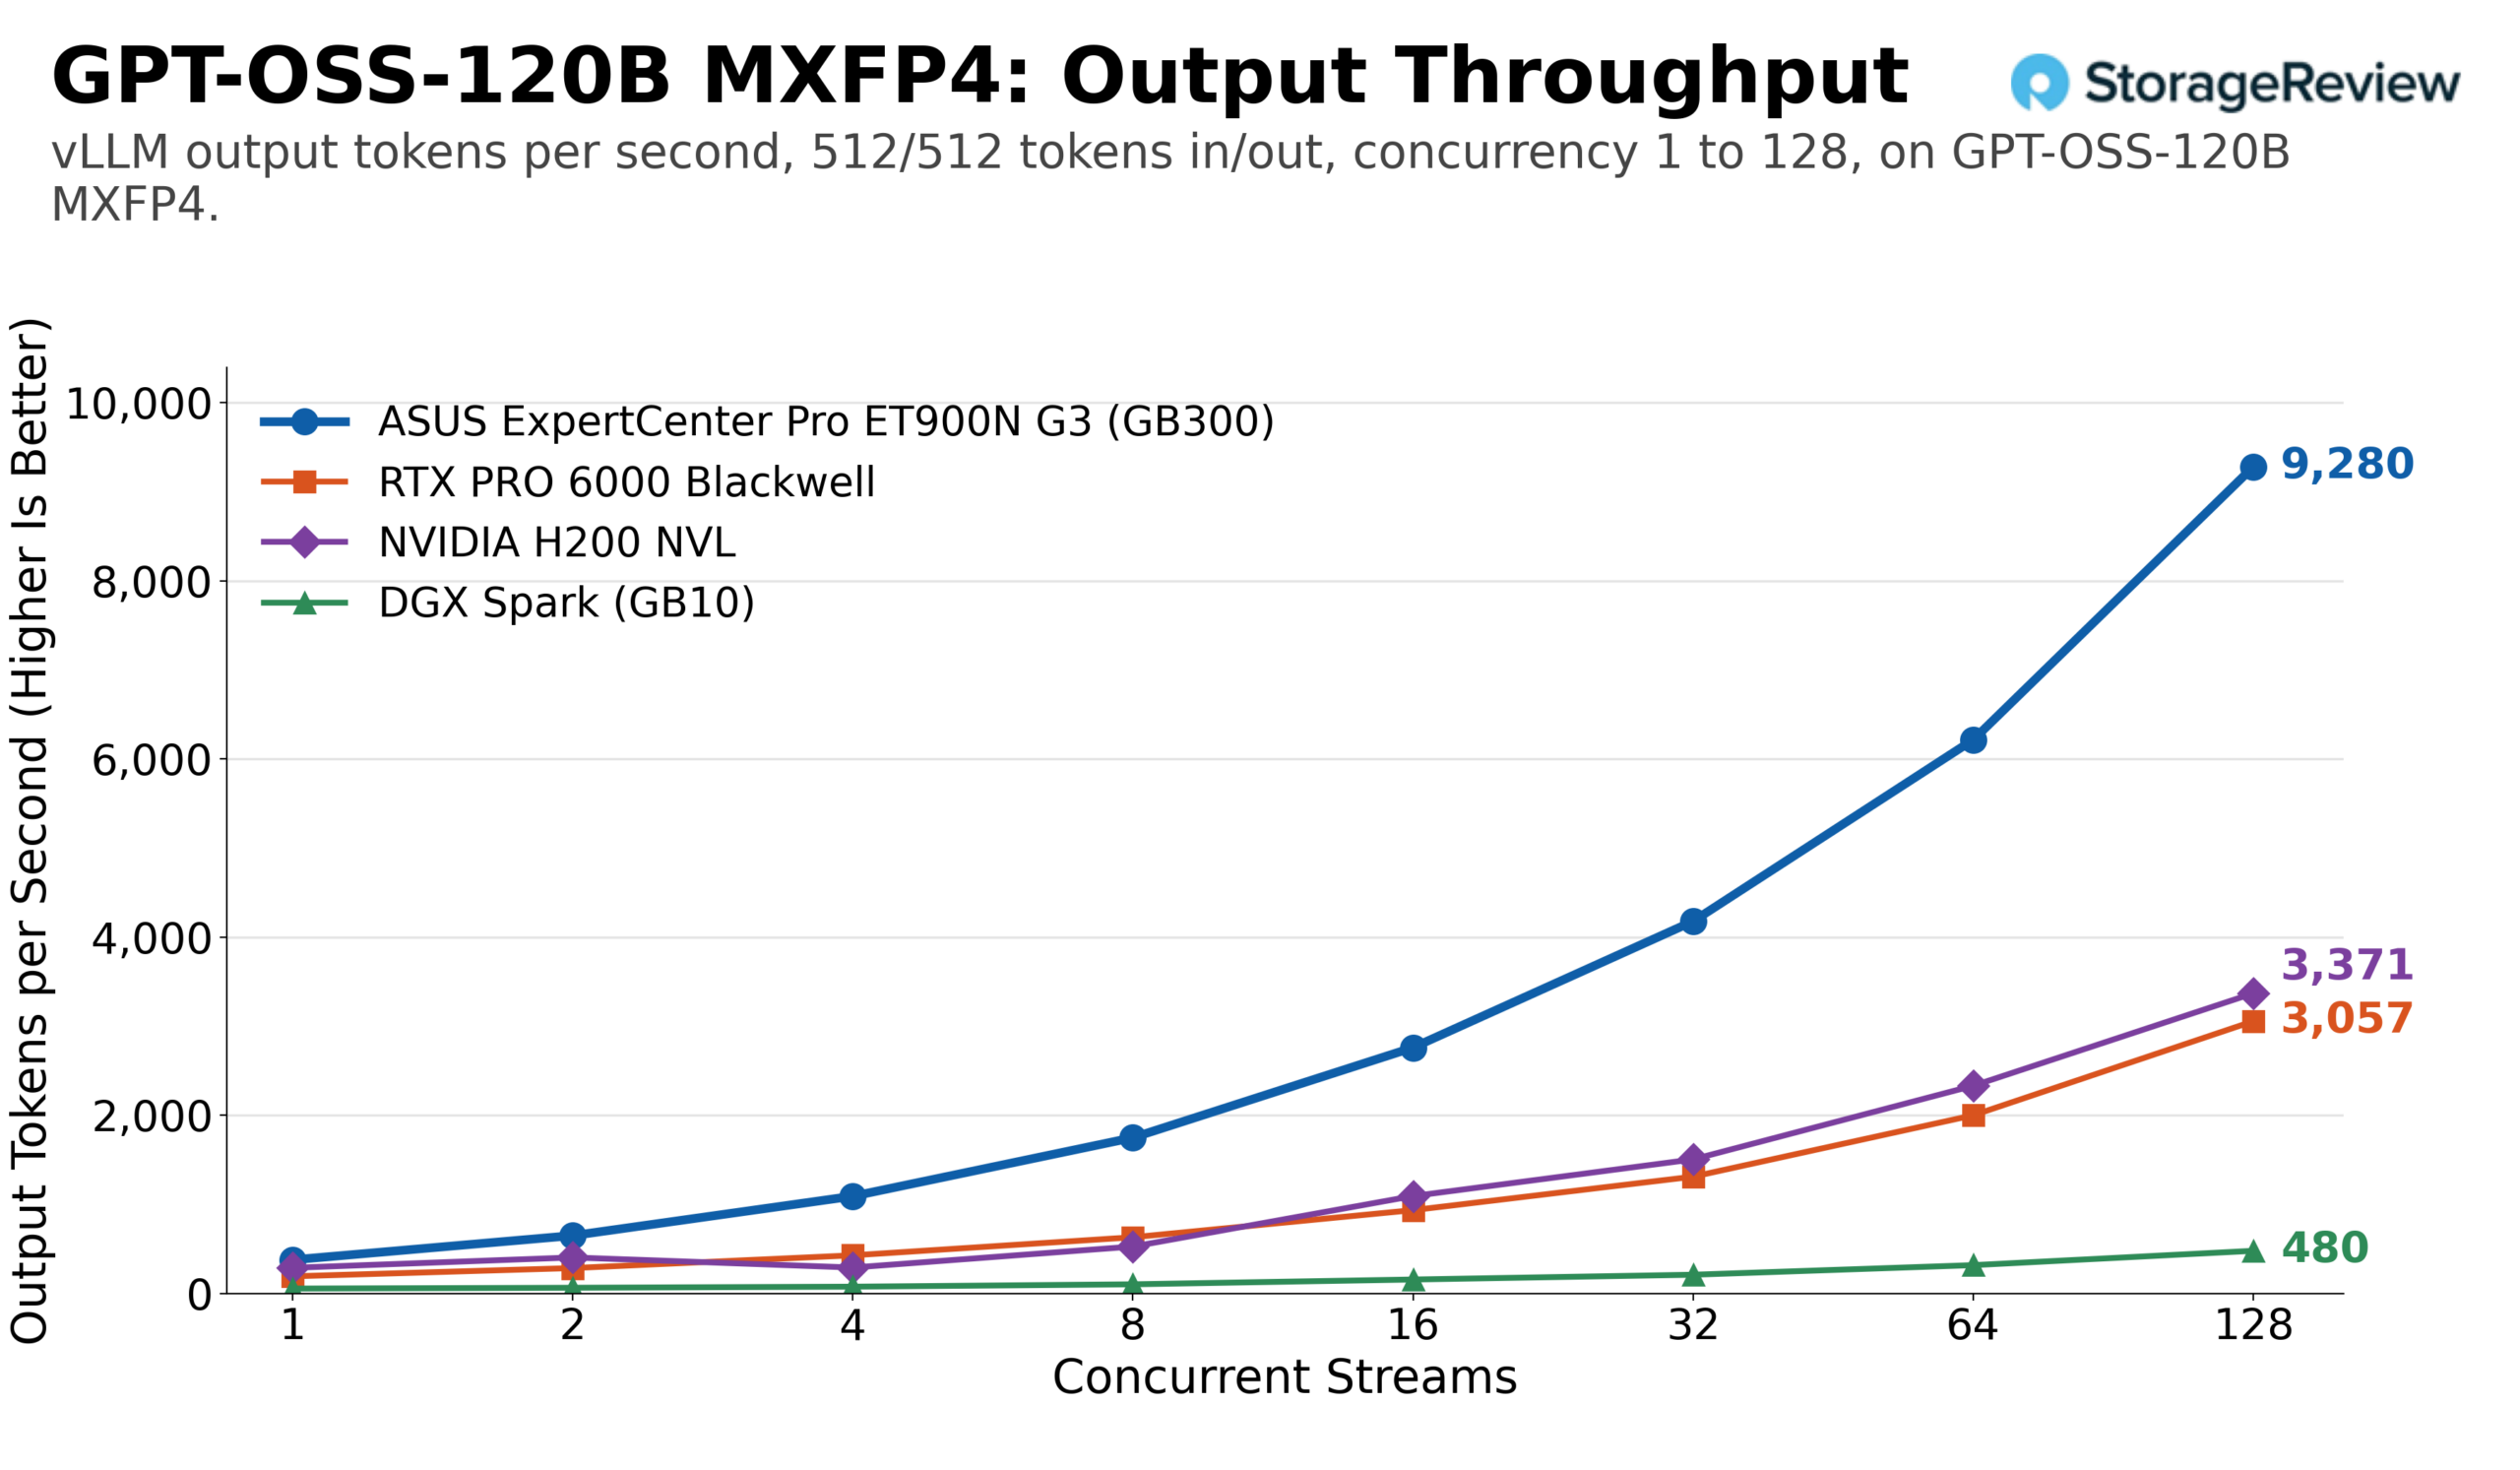
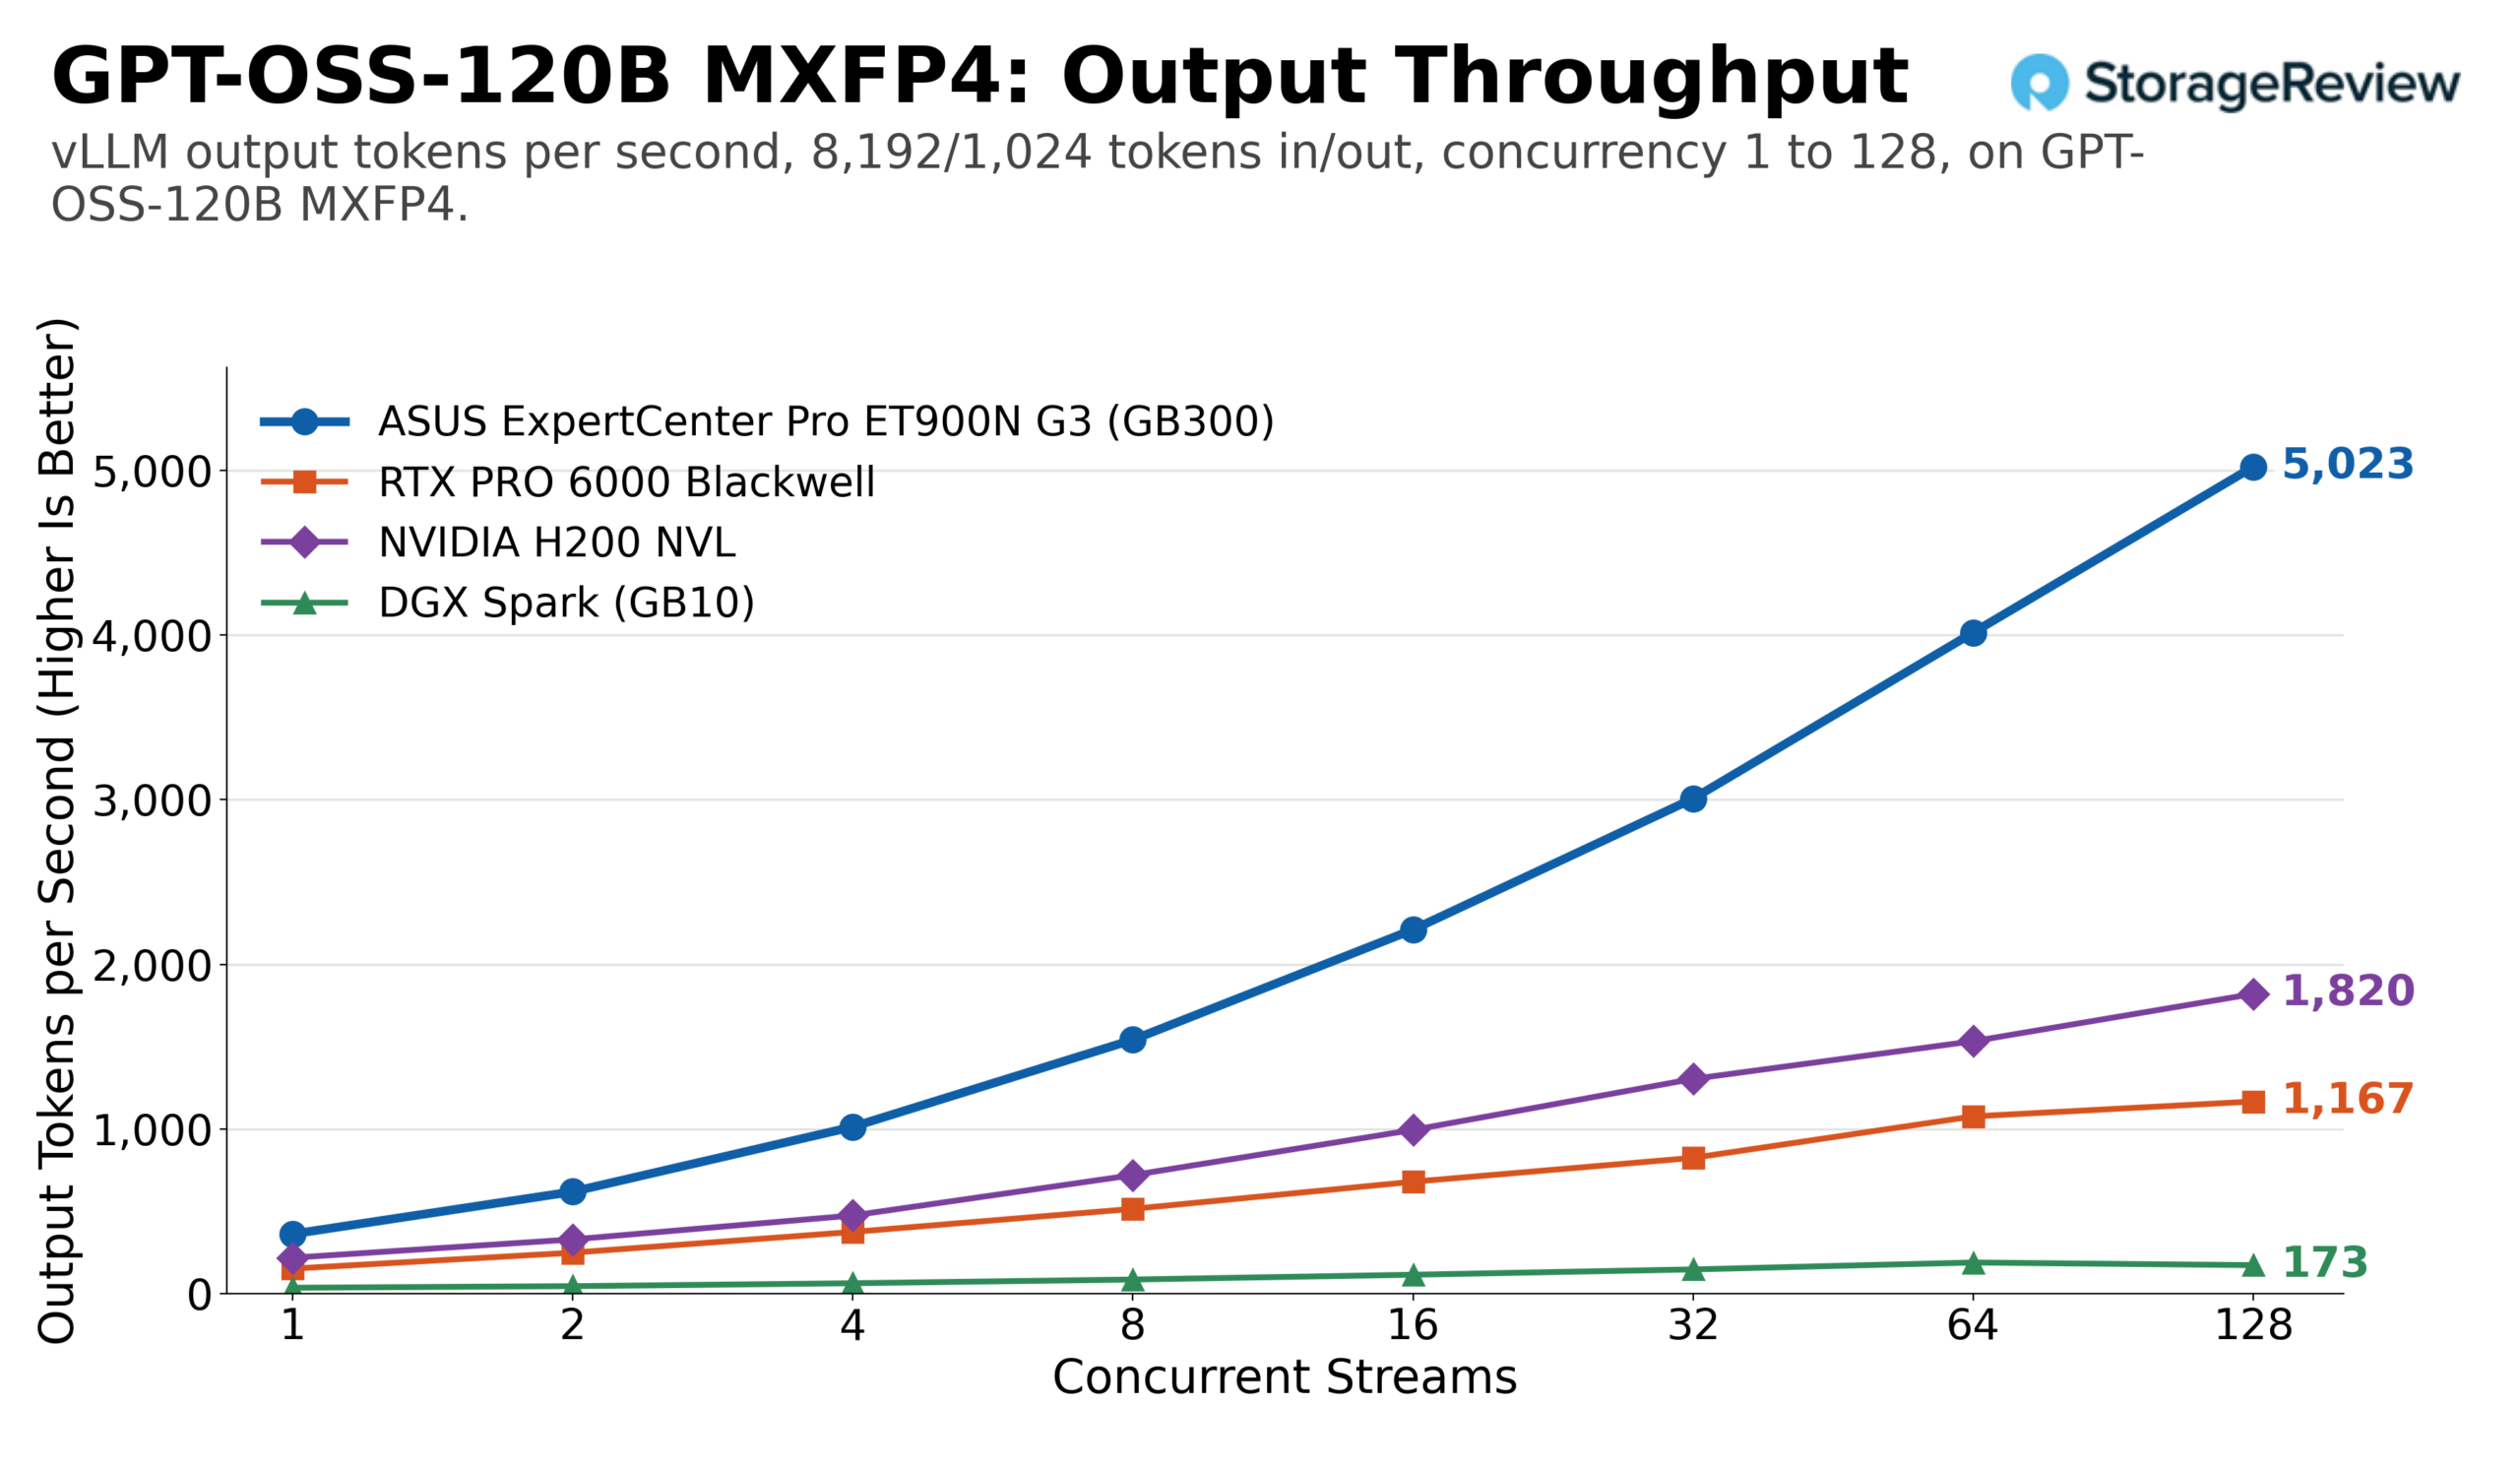
GPT-OSS-120B è il punto in cui la memoria inizia a fare la differenza. L'ET900N G3 ha raggiunto 9,280 token di output al secondo con lo stesso carico di lavoro a 128 stream, circa tre volte l'RTX PRO 6000 a 3,060, 2.8 volte l'H200 NVL a 3,370 e più di 19 volte lo Spark a 480. Con prompt lunghi, i sistemi più piccoli hanno esaurito presto la capacità della cache KV: l'RTX PRO 6000 ha raggiunto un massimo di circa 1,170 token di output al secondo e l'H200 NVL quasi 1,820, mentre la Station continuava a crescere a 128 stream e ha terminato a 5,023, con un throughput totale di 45,205 token al secondo.
Llama 3.1 8B su FP8 è il singolo numero più alto del set. L'ET900N G3 ha generato 25,602 token di output al secondo su 128 stream con lo stesso carico di lavoro, per un totale di 51,205, rispetto a circa 8,060 per la RTX PRO 6000 e 11,040 per la H200 NVL. Il passaggio da BF16 a FP8 ha aumentato le prestazioni della Station di circa il 50% (da 17,074 a 25,602), mentre la RTX PRO 6000 ha guadagnato circa il 70% e la H200 NVL circa il 37% dallo stesso cambiamento. Il profilo con pre-riempimento intensivo ha compresso tutto, con la Station a 6,164 token di output al secondo, la scheda a 1,480 e la H200 a 2,040.
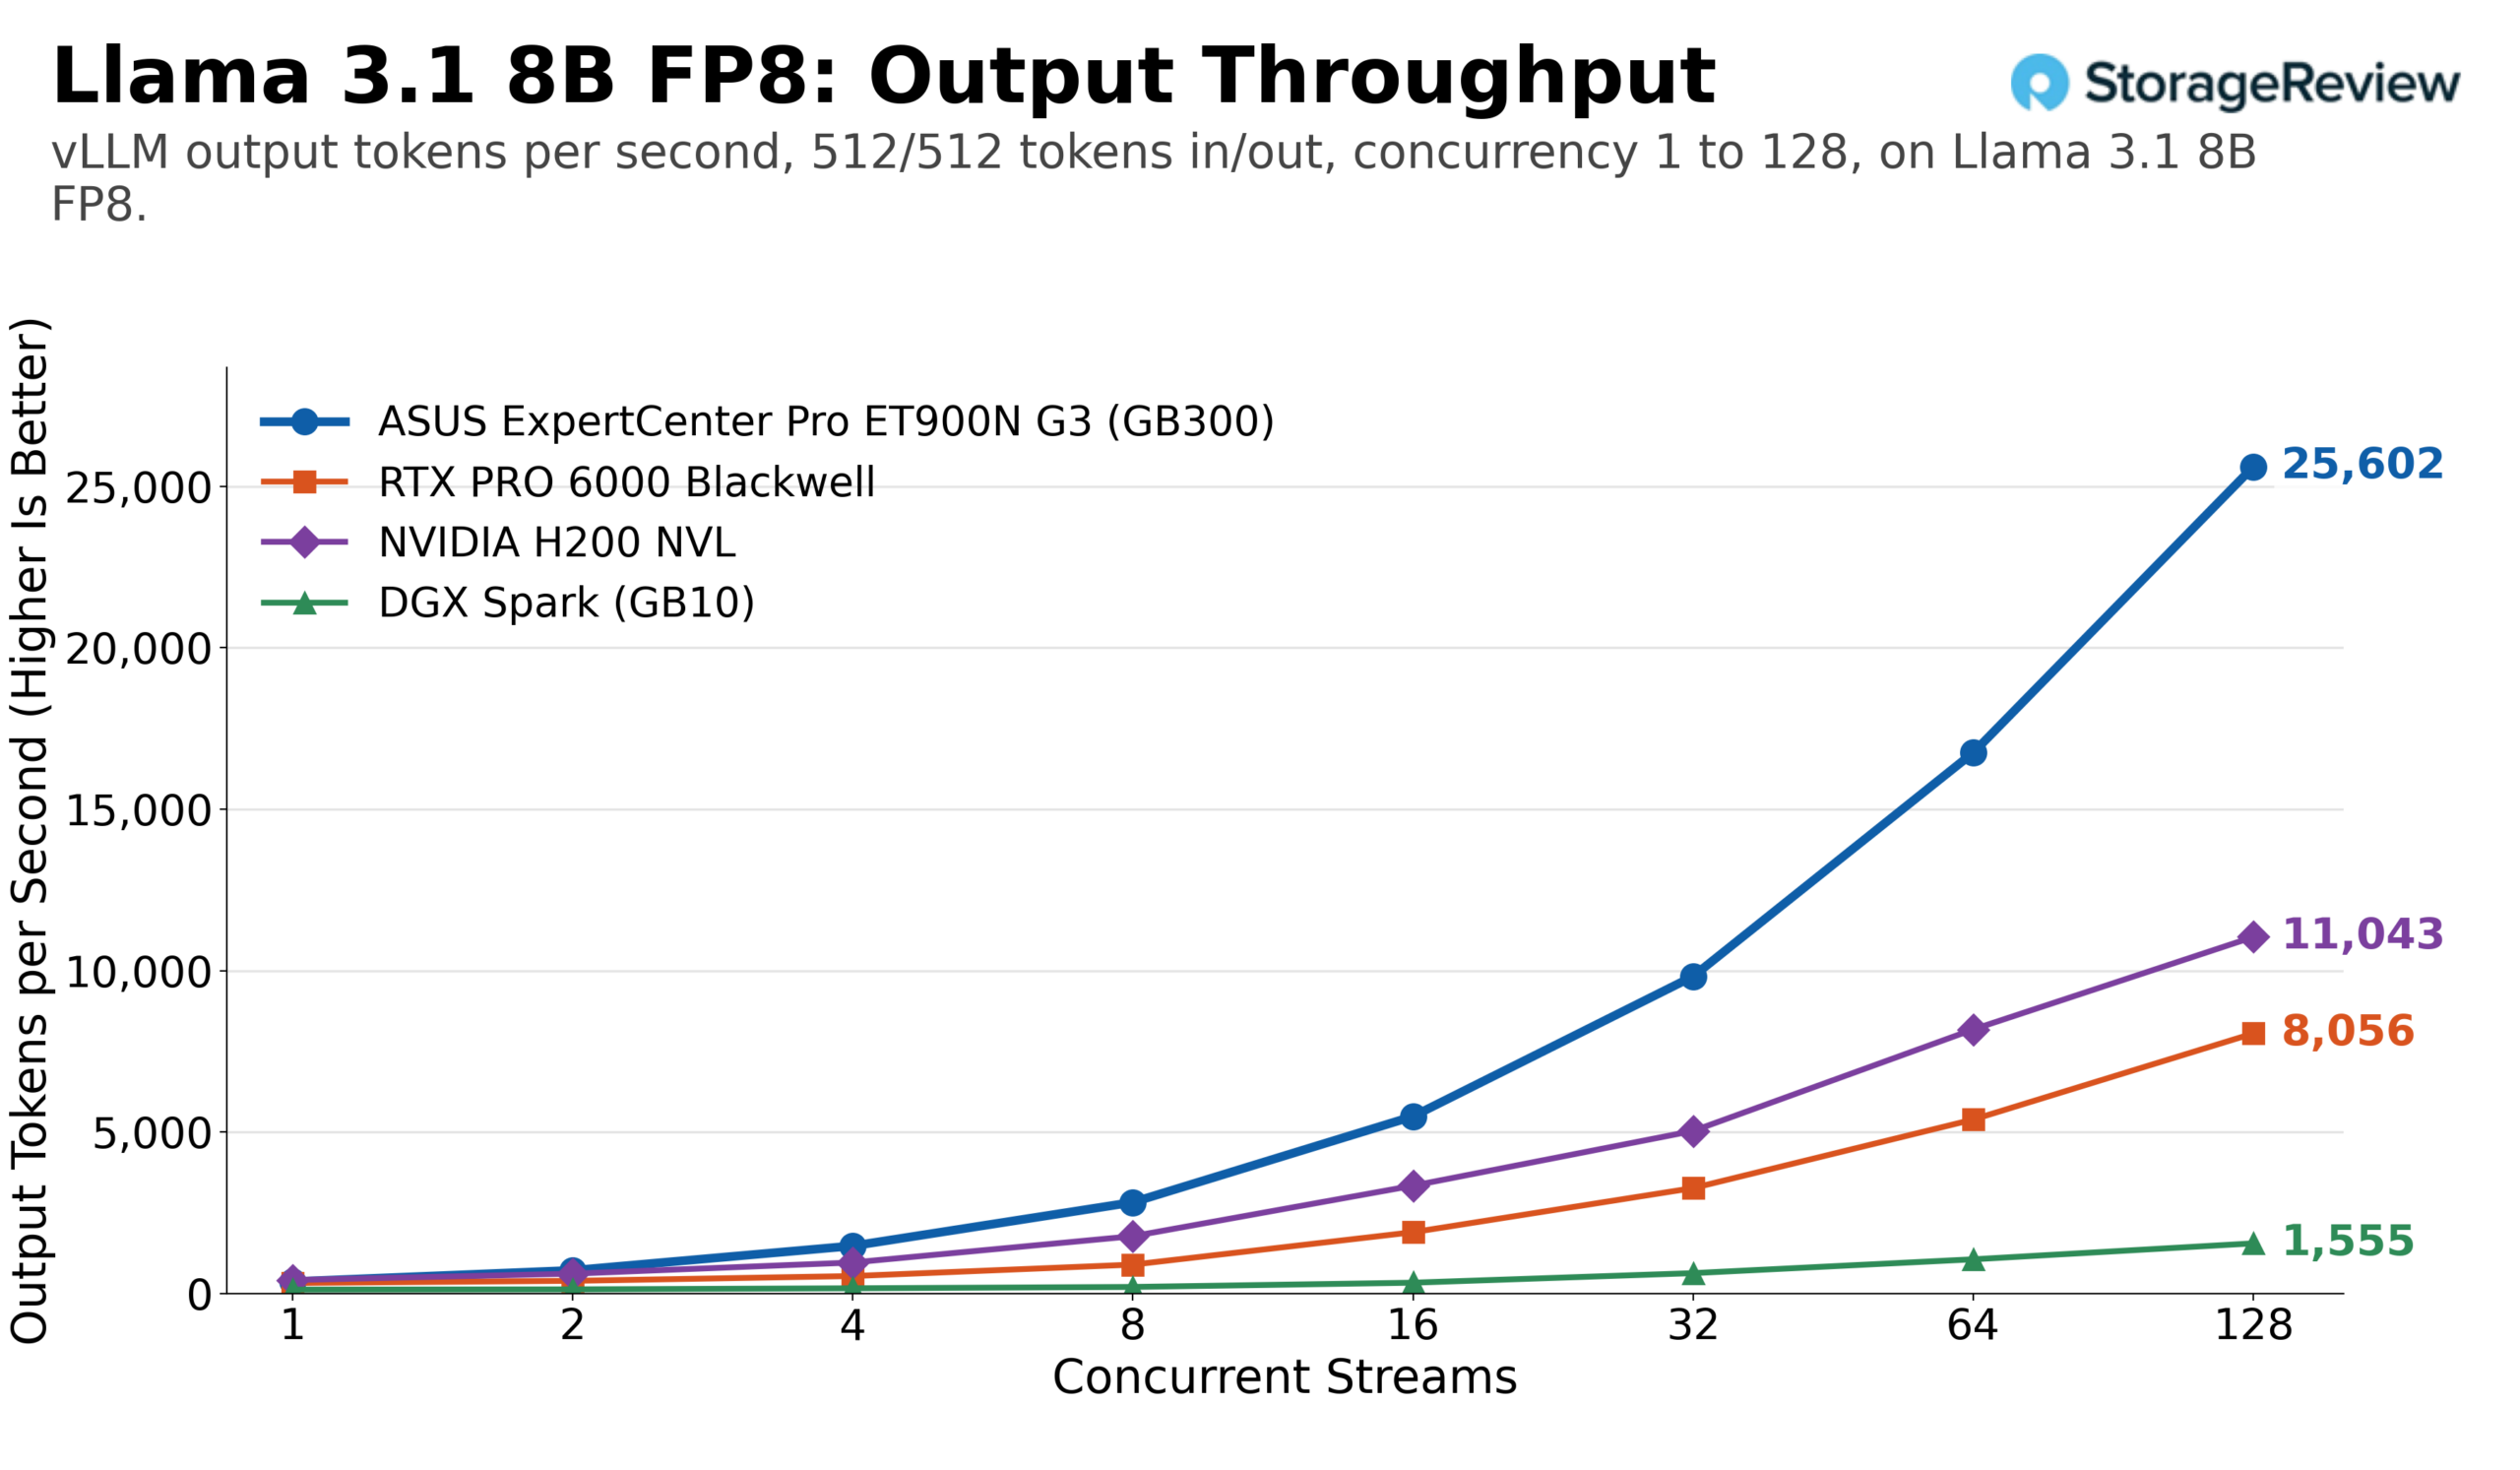
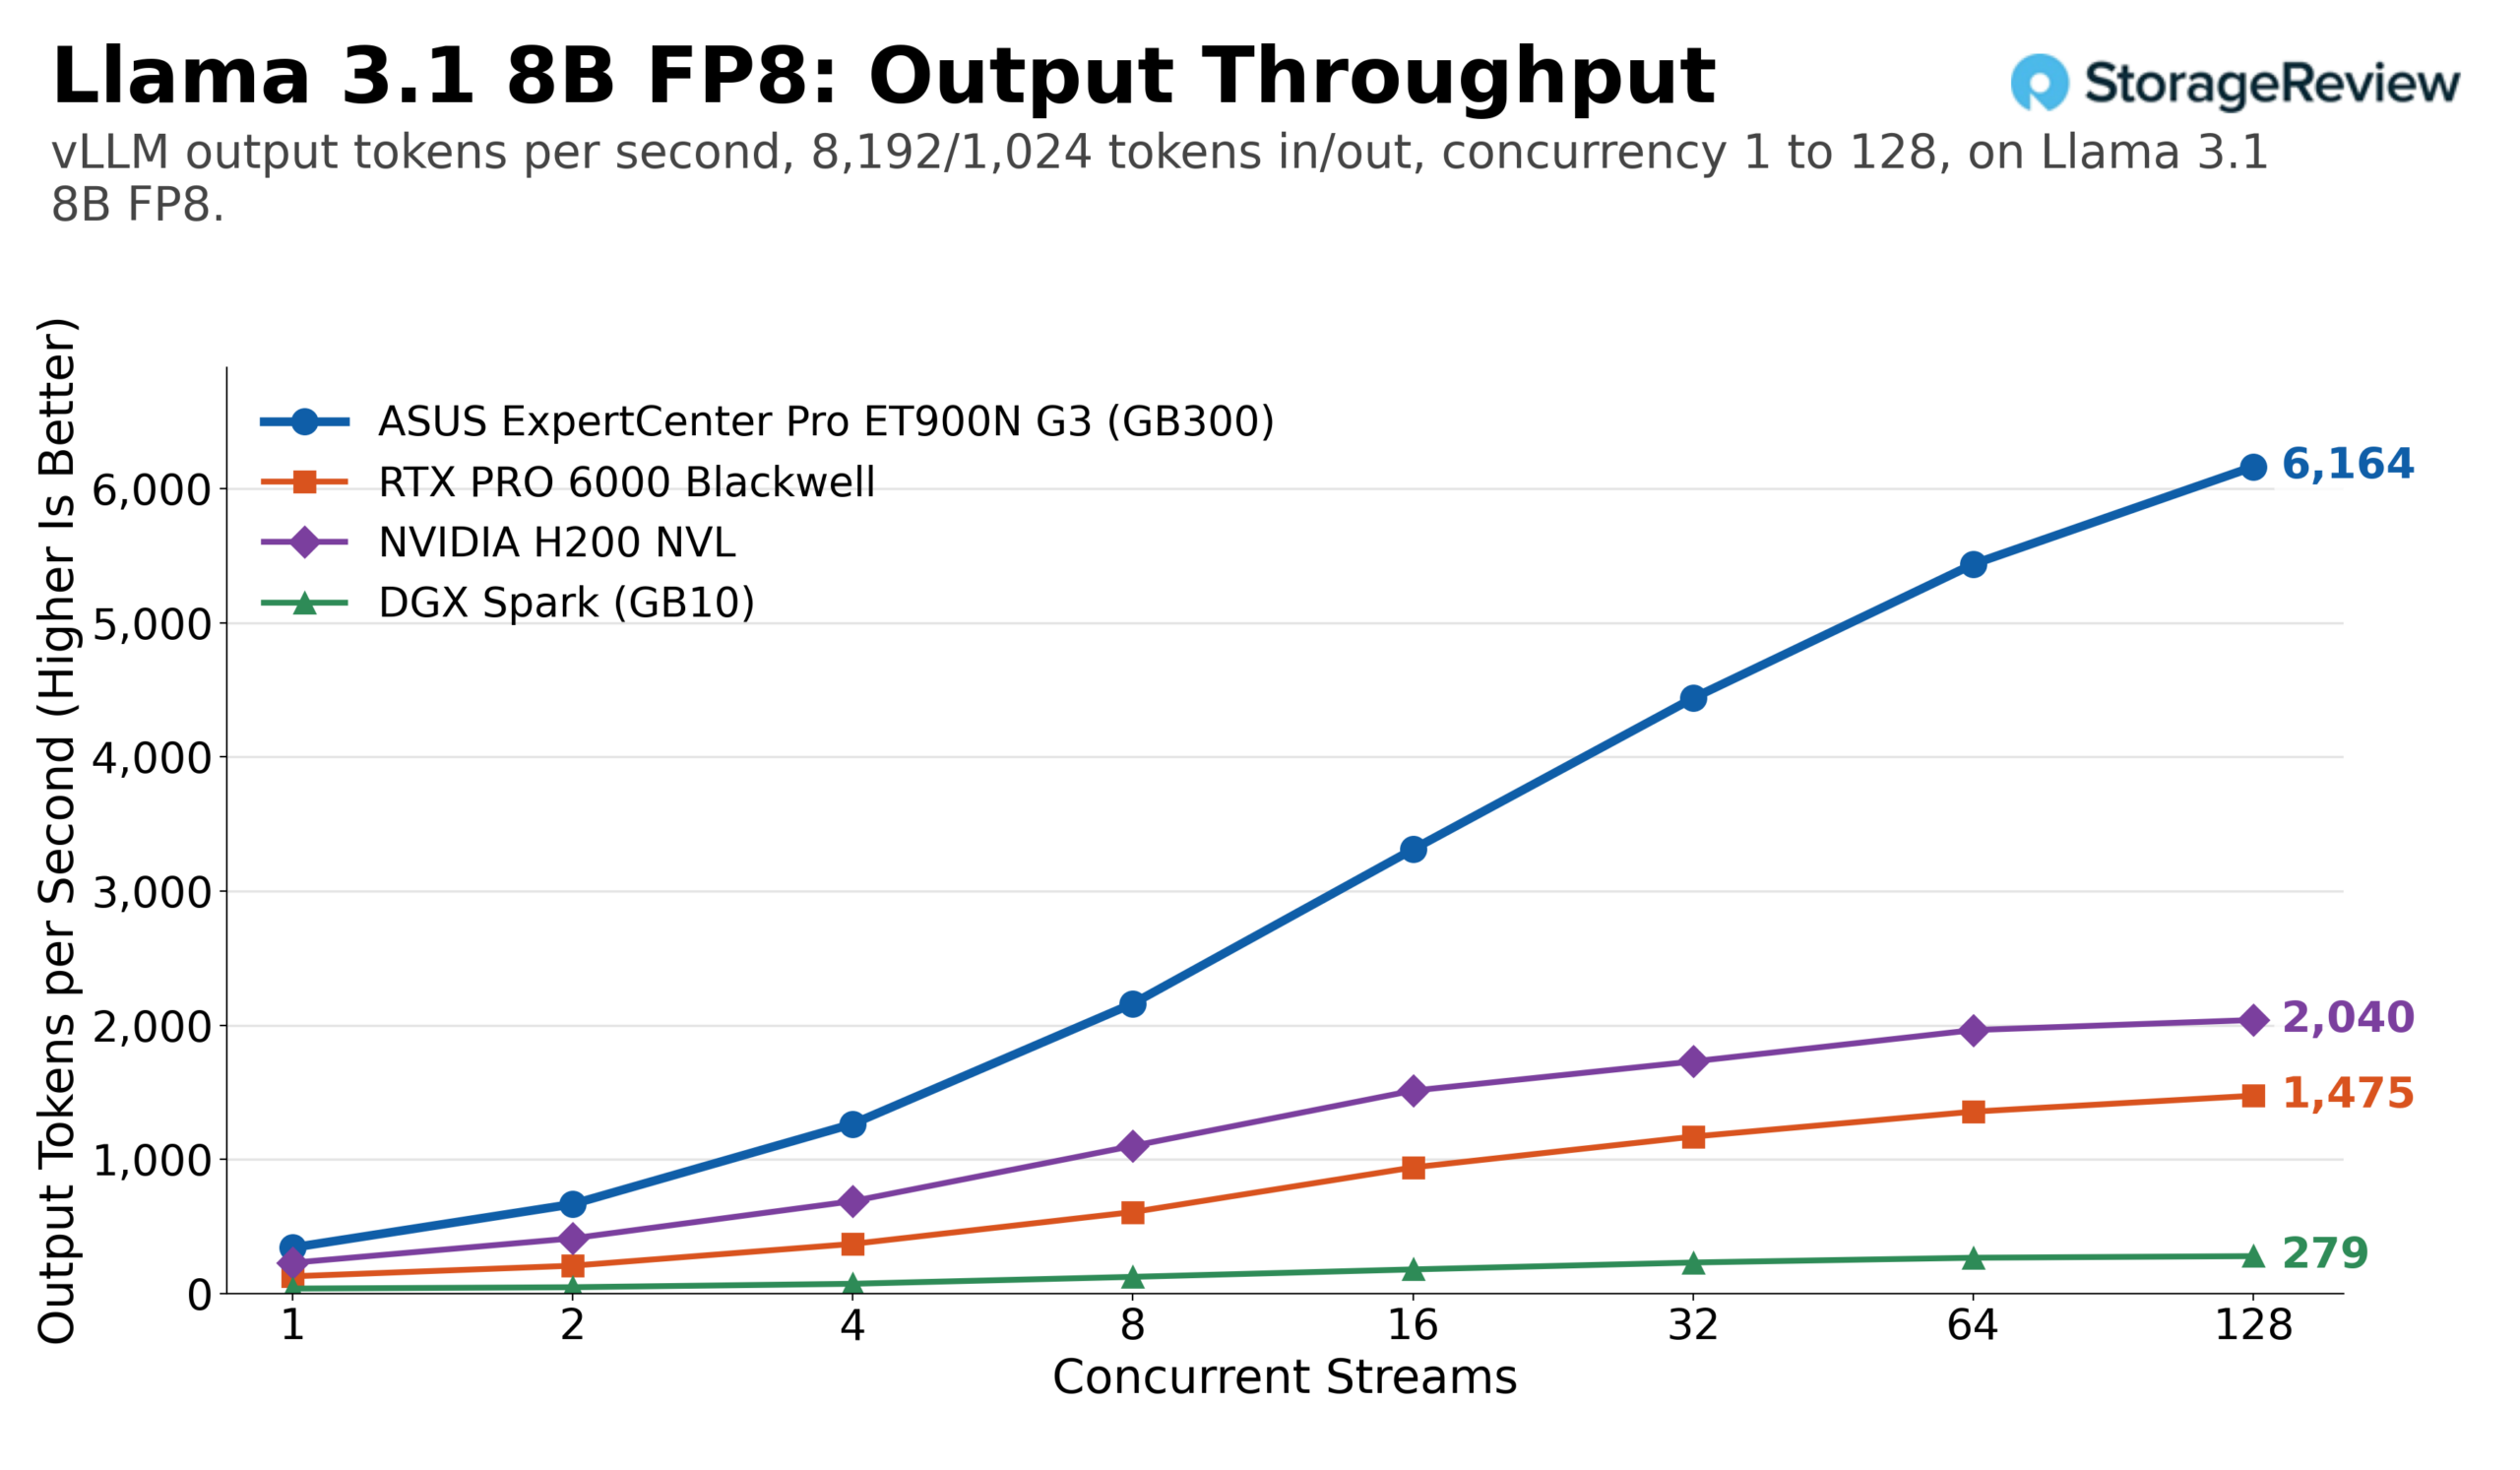
Il test Mistral Small 24B su FP8 ha prodotto i rapporti più ampi. L'ET900N G3 ha raggiunto un picco di 11,075 token di output al secondo con lo stesso carico di lavoro, 3.4 volte superiore a quello dell'RTX PRO 6000 (3,240), 2.4 volte superiore a quello dell'H200 NVL (4,610) e quasi 20 volte superiore a quello dello Spark (559). Con prompt lunghi, l'RTX PRO 6000 ha raggiunto un picco di 32 stream e circa 480 token di output al secondo prima di calare; l'H200 NVL ha raggiunto un massimo di circa 854, mentre la Station ha raggiunto 2,302 con 128 stream.


Qwen3 Coder 30B, un modello misto di esperti con un numero ridotto di parametri attivi, è dove il divario a singolo flusso si riduce. Con un singolo flusso e un carico di lavoro equivalente, la RTX PRO 6000 ha fornito circa 232 token di output al secondo contro i 319 della Station e i 308 della H200 NVL. Il batching ripristina l'ordine: con 128 flussi, la ET900N G3 ha raggiunto 12,439 token di output al secondo a FP8, 3.1 volte la scheda a 3,990 e 1.7 volte la H200 NVL a 7,450. Sul profilo con pre-riempimento intensivo, la Station ha raggiunto 3,837 token di output al secondo, mentre la RTX PRO 6000 ha raggiunto un picco di circa 880 a 64 flussi e la H200 NVL circa 1,820.


Tra i modelli condivisi, l'ET900N G3 ha ottenuto prestazioni da 2.8 a 3.4 volte superiori a quelle di una singola RTX PRO 6000 e da 1.7 a 3.7 volte superiori a quelle di un H200 NVL a piena concorrenza, con un margine su entrambi che si ampliava durante i prompt lunghi man mano che si esauriva il margine della cache KV. Rispetto al WS300, questi quattro modelli si attestano nuovamente entro l'1%: 22,041 contro 22,161 su GPT-OSS-20B, 9,280 contro 9,294 su GPT-OSS-120B, 11,075 contro 11,157 su Mistral Small FP8 e 12,439 contro 12,425 su Qwen3 Coder FP8. Il confronto completo dei 14 modelli, inclusi i tre modelli con divari maggiori, è riportato nella sezione successiva.
Due torri, una sola scheda madre: ASUS ET900N G3 vs MSI WS300
La ET900N G3 e la MSI XpertStation WS300 utilizzano la stessa scheda madre NVIDIA GB300 DGX Station in due chassis OEM diversi, ed entrambe sono state sottoposte agli stessi 14 modelli, agli stessi due carichi di lavoro e allo stesso sweep di concorrenza sulla stessa build vLLM. Il grafico seguente confronta la velocità di trasmissione di picco della ET900N G3 su tutti i modelli con quella della WS300.
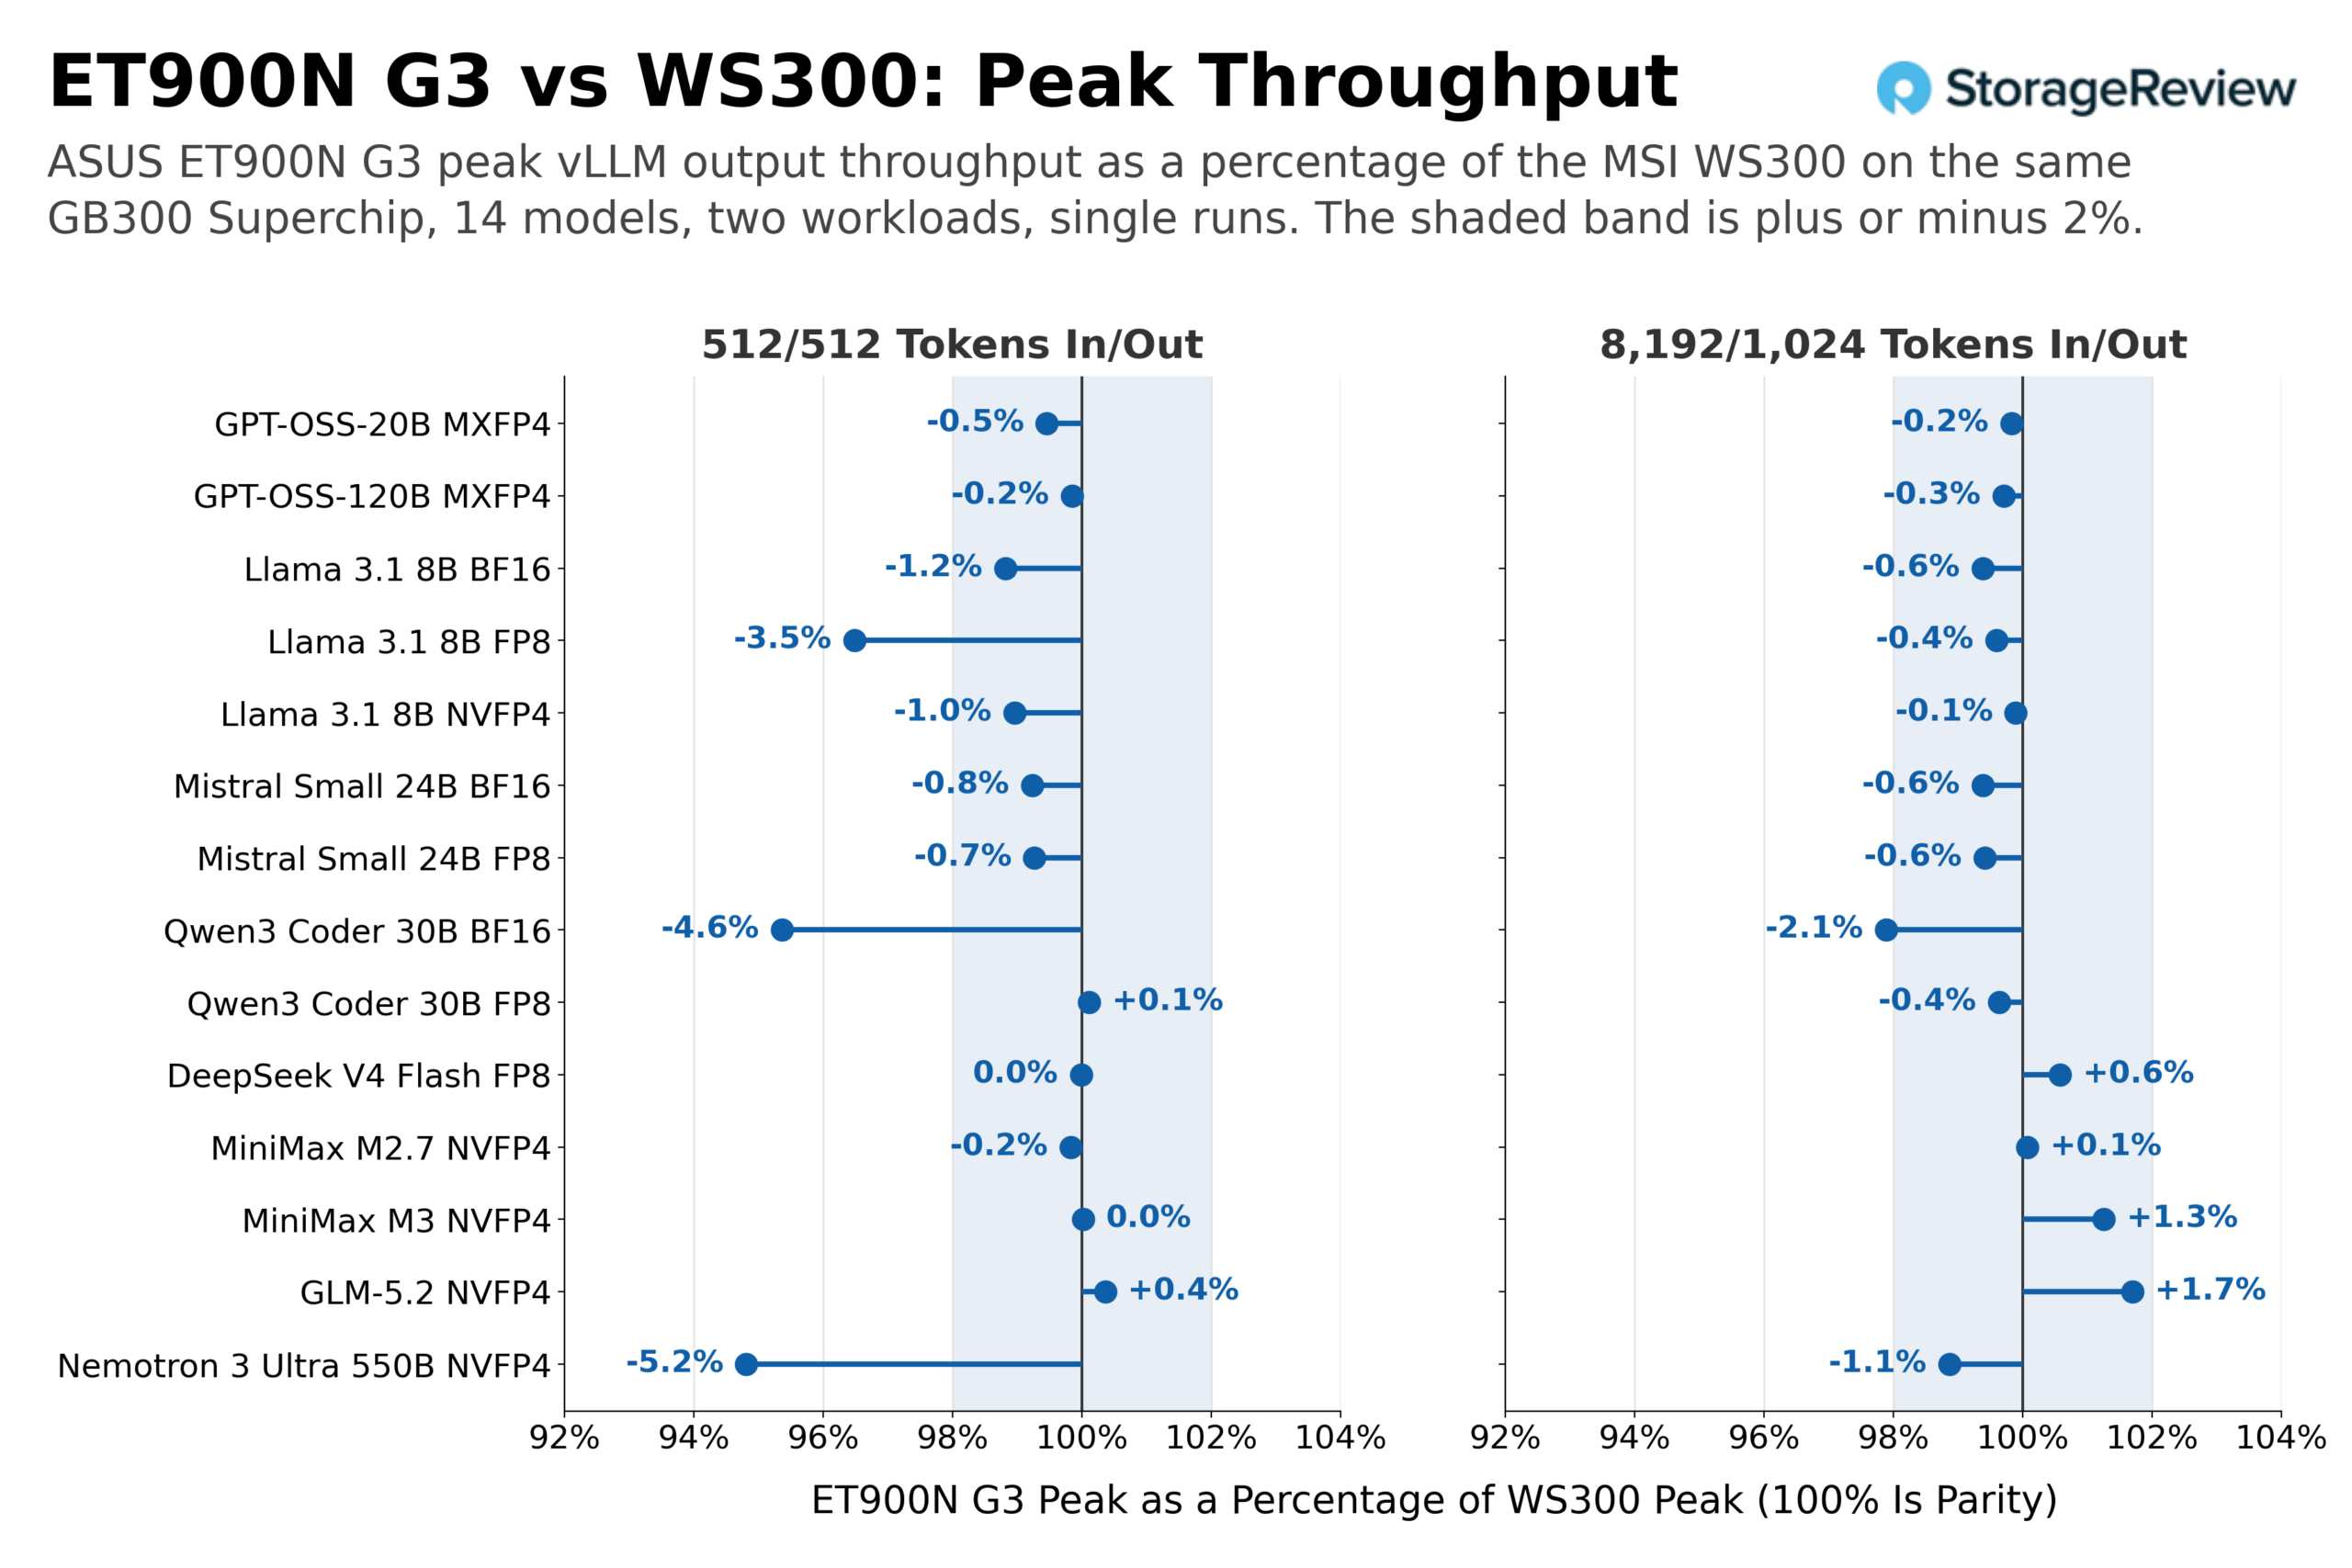
Tra le 28 coppie modello-carico di lavoro, 24 rientrano entro il 2% l'una dall'altra, e la maggior parte di queste sono una frazione di punto percentuale a favore del WS300. Quattro si trovano al di fuori di questa fascia, tre delle quali con lo stesso carico di lavoro: Llama 3.1 8B FP8 al 3.5% in meno rispetto al WS300 (25,602 contro 26,536 token di output al secondo), Qwen3 Coder 30B BF16 al 4.6% in meno (10,000 contro 10,486) e Nemotron 3 Ultra 550B al 5.2% in meno (159 contro 168), oltre a Qwen3 Coder 30B BF16 di nuovo al 2.1% in meno sui prompt lunghi. Ogni dato qui riportato si riferisce a una singola esecuzione su ciascuna torre, quindi un divario dal 2 al 5% tra tre modelli su 14 non è qualcosa che attribuiremo allo chassis; Stiamo semplicemente prendendo nota dei dati e della differenza tra i due. I modelli che si basano sul pool di memoria coerente, MiniMax M3 e GLM-5.2, raggiungono o superano la parità in entrambi i carichi di lavoro; questo è il risultato che riteniamo più importante per la piattaforma: il percorso di offload Grace offre le stesse prestazioni nello chassis ASUS come in quello MSI.
| Modello | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Lama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 Coder 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, il caso denso con la massima produttività del set, e GLM-5.2, il caso di offload, mostrano la sovrapposizione senza un rapporto: in entrambi, l'esecuzione del WS300 ricalca punto per punto quella dell'ET900N G3.
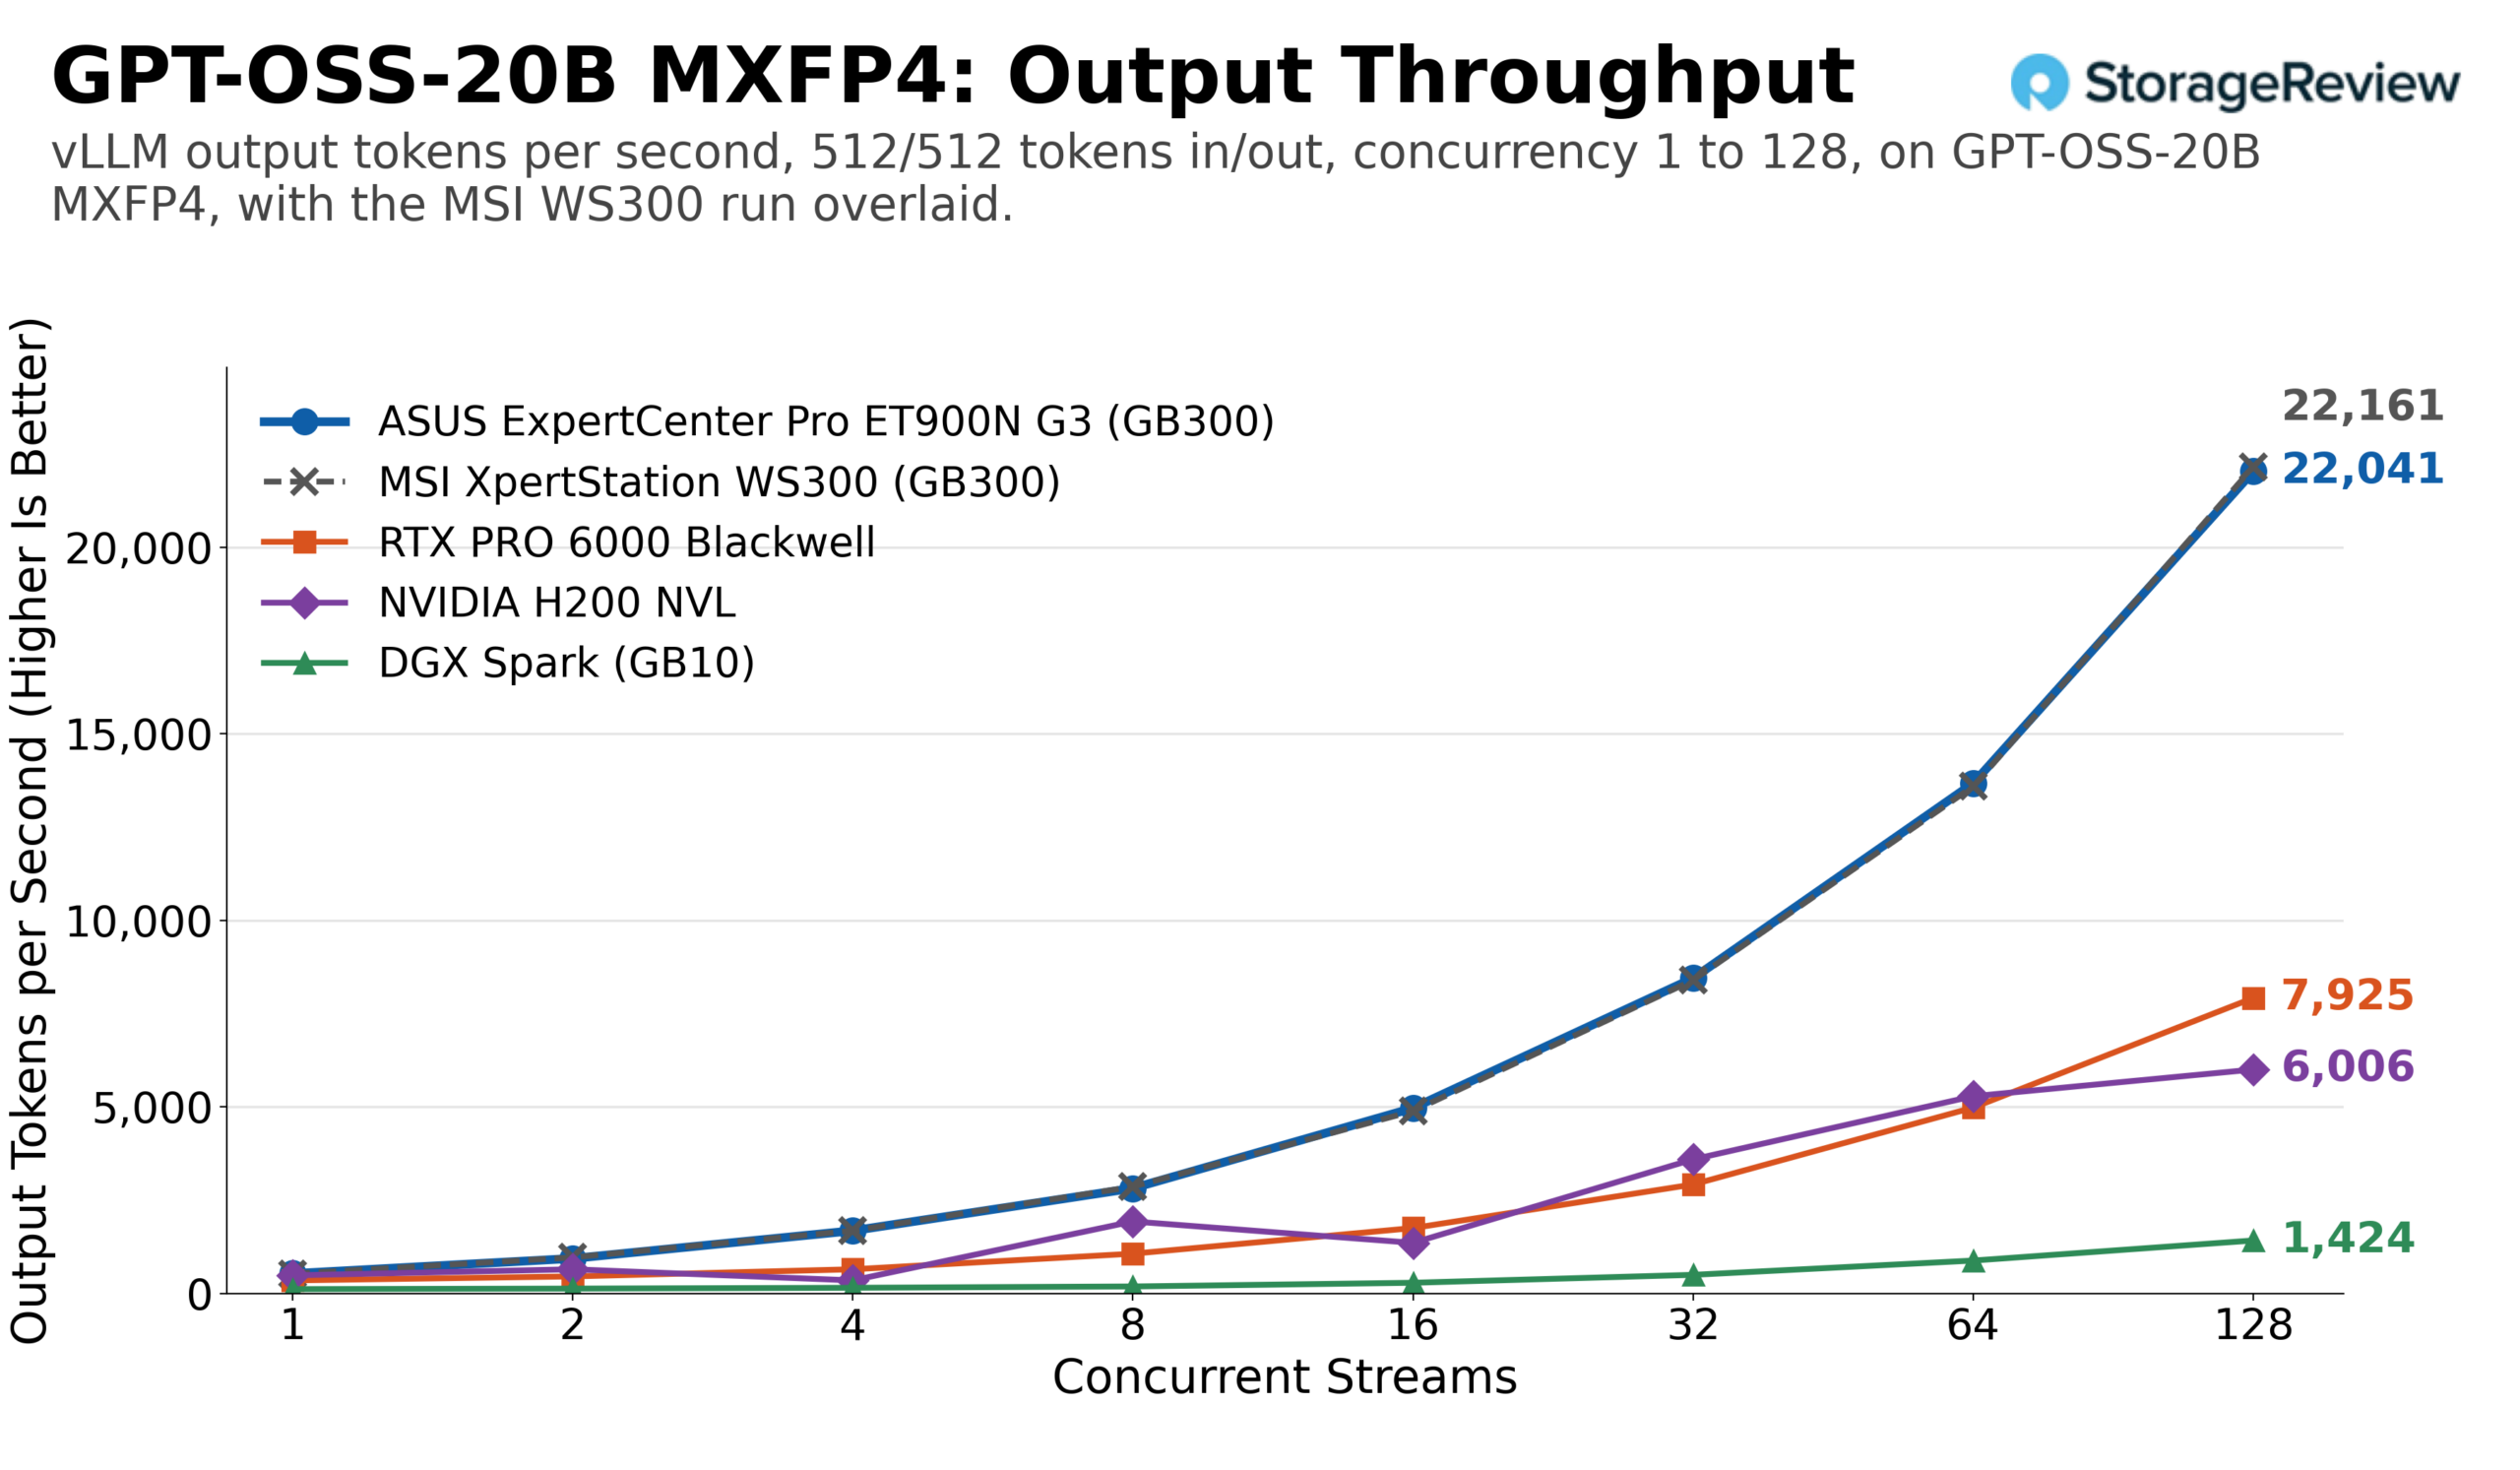
Questo è il confronto su cui ci baseremo man mano che altri computer desktop GB300 arriveranno in laboratorio. Il prossimo sarà l'HP ZGX, seguito da altri, e ognuno di essi esegue la stessa scansione, quindi eventuali differenze tra le implementazioni OEM saranno visibili qui, in un grafico per ogni computer desktop, con i grafici dei modelli che mostrano le curve grezze.
Conclusione
La ASUS ExpertCenter Pro ET900N G3 fa ciò che una seconda implementazione di una piattaforma di riferimento dovrebbe fare: conferma la prima. Su 14 modelli e due carichi di lavoro, il suo throughput vLLM di picco si è attestato entro il 2% rispetto alla MSI XpertStation WS300 in 24 dei 28 confronti, da 1,766 token di output al secondo su DeepSeek V4 Flash a 22,041 su GPT-OSS-20B, con quattro valori anomali in singole esecuzioni tra il 2 e il 5% in meno, e ha gestito GLM-5.2 con 215 GB di expert in memoria Grace a velocità che quattro schede RTX PRO 6000 non sono riuscite a raggiungere. Il Superchip GB300 definisce il limite massimo e ASUS ha fatto un ottimo lavoro nell'implementazione.
Ciò che ASUS aggiunge è pratico: le maniglie trasformano un case da 27 kg in qualcosa che due persone possono spostare senza dover afferrare i pannelli, la ventola sopra gli alloggiamenti QSFP112 risolve un potenziale problema per chiunque utilizzi moduli ottici da 400G per ore e l'alimentatore Titanium riduce di qualche watt il consumo alla presa di corrente. Il processore ARM, il circuito da 20 A, l'uscita video solo BMC e il budget condiviso di 1,600 W quando è installata una scheda video di grandi dimensioni sono caratteristiche della piattaforma che si applicano in egual misura a entrambi i case.
La workstation GB300 DGX rimane il dispositivo più performante che abbiamo mai posizionato su una scrivania, e ASUS ha realizzato la sua versione in modo da renderla un ottimo acquisto.
Sul nostro I migliori computer desktop per l'intelligenza artificiale locale leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon