

Non ci è mai capitato di spingere al limite le capacità computazionali, ma questa volta abbiamo superato ogni limite. Sulla scia del traguardo di 100 trilioni di cifre raggiunto l'anno scorso, abbiamo deciso di alzare l'asticella e portare le cifre conosciute di Pi a 105 trilioni. Ovvero 105,000,000,000,000 di cifre dopo il 3. Abbiamo apportato alcuni aggiornamenti alla piattaforma rispetto all'anno scorso, scoperto alcune cose sorprendenti lungo il percorso e imparato qualcosa di nuovo, tra cui la 105 trilionesima cifra di Pi: 6!
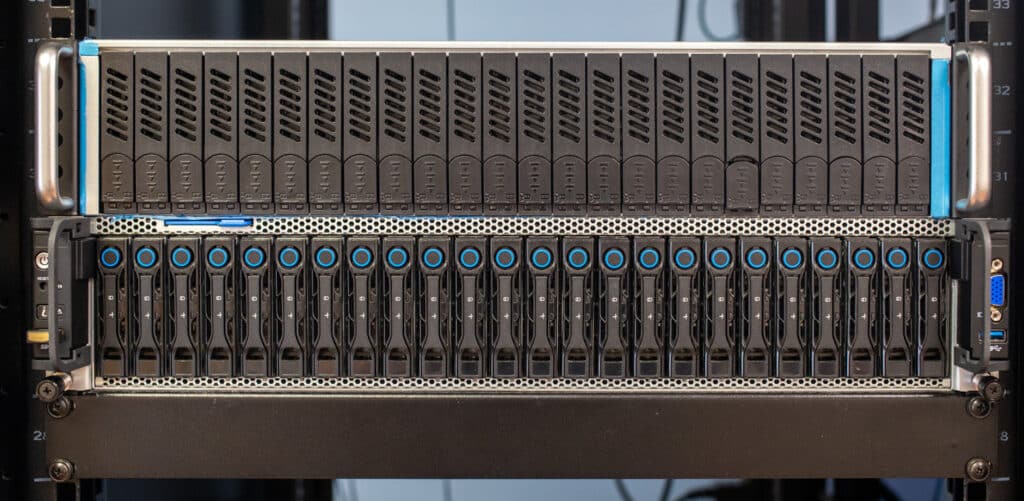
Raggiungendo un calcolo da record mondiale di Pi fino a 105 trilioni di cifre, il laboratorio StorageReview ha sottolineato le incredibili capacità dell'hardware moderno. Questa impresa, alimentata da un sistema AMD EPYC Bergamo 2P 128-core all'avanguardia dotato di 1.5 TB di DRAM e quasi un petabyte di SSD Solidigm QLC, rappresenta un risultato fondamentale nella tecnologia computazionale e di archiviazione.
La sfida
Nella corsa al digitale di 100 trilioni, abbiamo riscontrato diversi limiti tecnologici. La piattaforma server, ad esempio, supportava solo 16 SSD NVMe negli slot anteriori. Sebbene disponessimo di molta potenza della CPU, questo calcolo richiedeva uno spazio di archiviazione enorme durante il processo e nel back-end quando veniva generato il file TXT finale.
Per risolvere il problema di archiviazione l'ultima volta, abbiamo fatto ricorso agli adattatori PCIe NVME per inserire altri tre SSD. Quindi, per l'output, avevamo un server di archiviazione HDD in RAID0, sia chiaro, con una condivisione iSCSI nella casella di calcolo. Questa volta volevamo essere un po' più "enterprise" con questo server, quindi abbiamo chiesto aiuto ad alcuni amici. È interessante notare che non è così semplice come potrebbe sembrare aggiungere un gruppo di SSD NVMe a un server.
L'hardware
Il cuore di questa impresa monumentale era il sistema dual-processor AMD EPYC 9754 Bergamo, con 128 core ciascuno. I processori AMD, noti per le loro eccezionali prestazioni in attività computazionali ad alta complessità (IA, HPC, analisi di Big Data) , hanno fornito la potenza di calcolo necessaria. A completare il tutto, 1.5 TB di DRAM hanno garantito velocità di elaborazione e trasferimento dati elevate. Allo stesso tempo, quasi un petabyte di storage Solidigm QLC ha offerto capacità e affidabilità senza precedenti.
La nostra piattaforma base del telaio è rimasta la stessa dell'anno scorso (un box QCT), ma abbiamo aggiornato le CPU ai chip AMD EPYC 9754 Bergamo. Volevamo perseguire un miglioramento della velocità e dei decimali evitando di utilizzare lo spazio di archiviazione per il calcolo, il che significava che dovevamo ricorrere a SerialCables per fornire un JBOF. Ciò ha presentato alcune sfide di per sé, che descriveremo in dettaglio di seguito.
| Parametro | Valore |
|---|---|
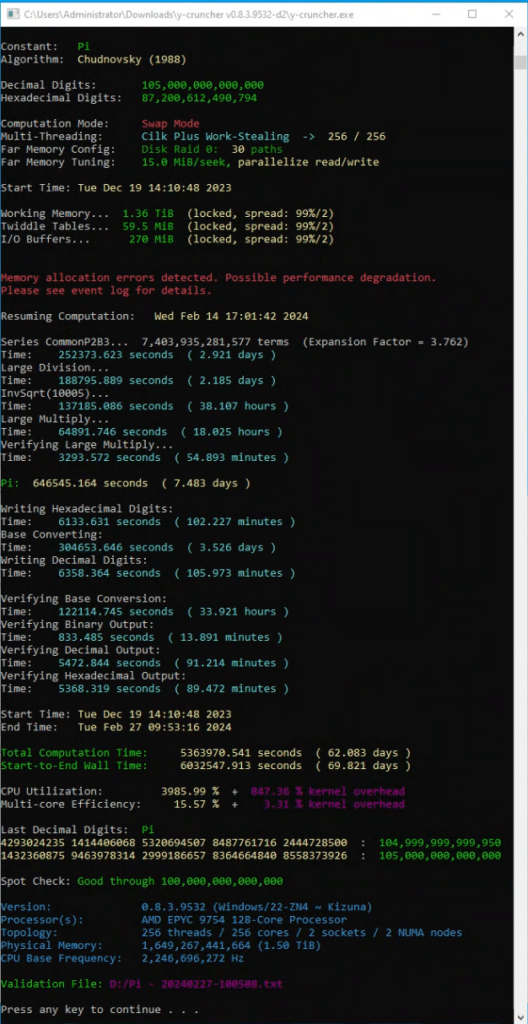
| Data d'inizio | mar dic 19 14:10:48 2023 |
| Data di fine | Mar 27 febbraio 09:53:16 2024 |
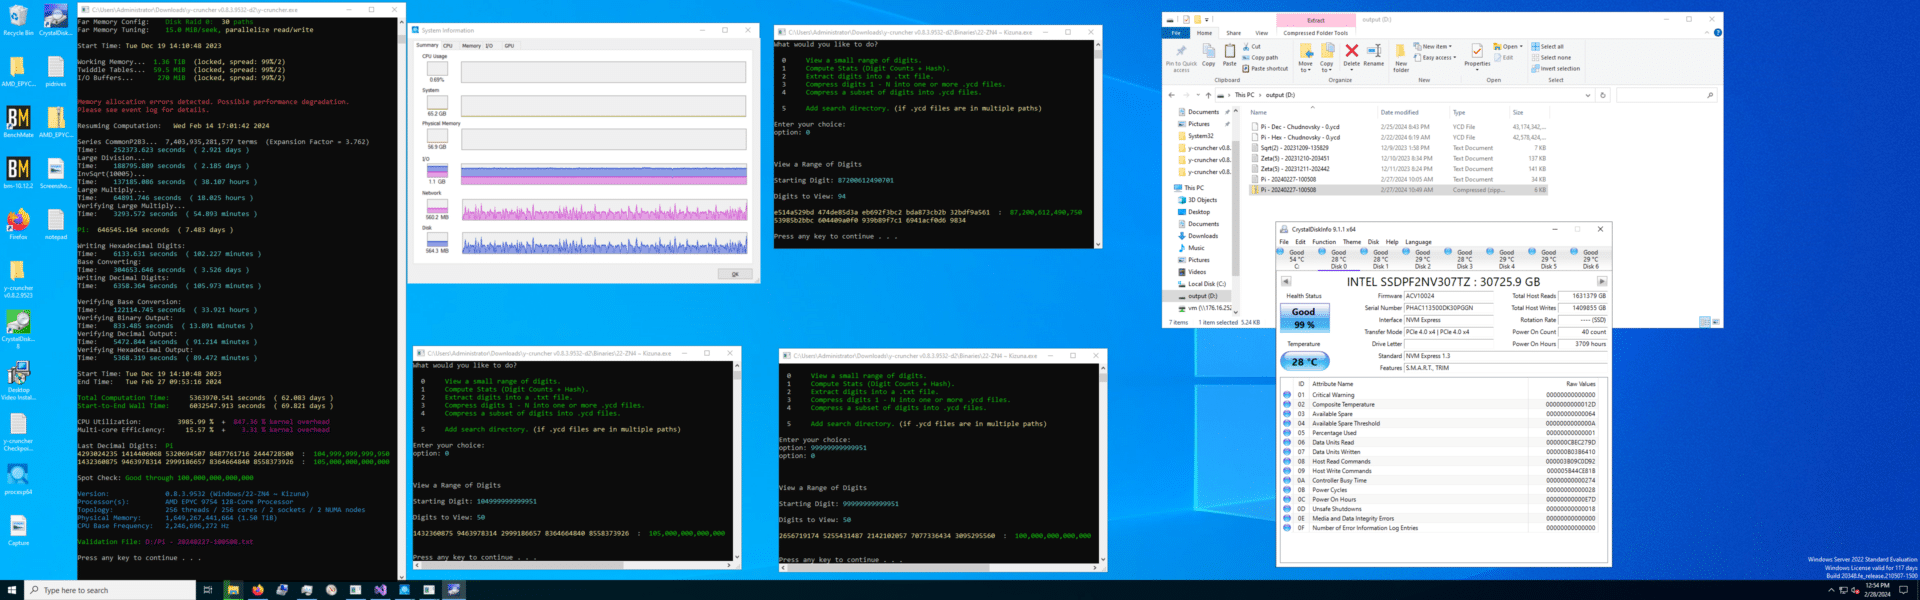
| Tempo di calcolo totale | 5,363,970.541 secondi / 62.08 giorni |
| Tempo di wall dall'inizio alla fine | 6,032,547.913 secondi / 69.82 giorni |
Periodo di calcolo: dal 14 dicembre 2023 al 27 febbraio 2024, per un totale di 75 giorni.
- CPU: Doppi processori AMD Epyc 9754 Bergamo, 256 core con multithreading simultaneo (SMT) disabilitato nel BIOS.
- Memoria: 1.5 TB di RAM DDR5.
- Memoria su disco: 36 SSD Solidigm D30.72-P5 da 5316 TB.
- 24 SSD Solidigm D30.72-P5 da 5316 TB in un JBOF con cavi seriali
- 12 SSD Solidigm D30.72-P5 da 5316 TB nel server collegato direttamente.
- Sistema operativo: Windows Server 2022 (21H2).
Il percorso verso 105 trilioni
| Parametro | Valore |
|---|---|
| costante | Pi |
| Algoritmo | Chudnovsky (1988) |
| Cifre decimali | 105,000,000,000,000 |
| Cifre esadecimali | 87,200,612,490,794 |
| Modalità di filettatura | Cilk Plus Furto di lavoro -> 256 / 256 |
| Memoria di lavoro | 1,492,670,259,968 (1.36 TiB) |
| memoria intero | 1,492,984,298,368 (1.36 TiB) |
| Punto di controllo logico più grande | 157,783,654,587,576 (144 TiB) |
| Utilizzo massimo del disco logico | 534,615,969,510,896 (486 TiB) |
| Lettura byte del disco logico | 44,823,456,487,834,568 (39.8 PiB) |
| Byte del disco logico scritti | 38,717,269,572,788,080 (34.4 PiB) |
Sfide incontrate
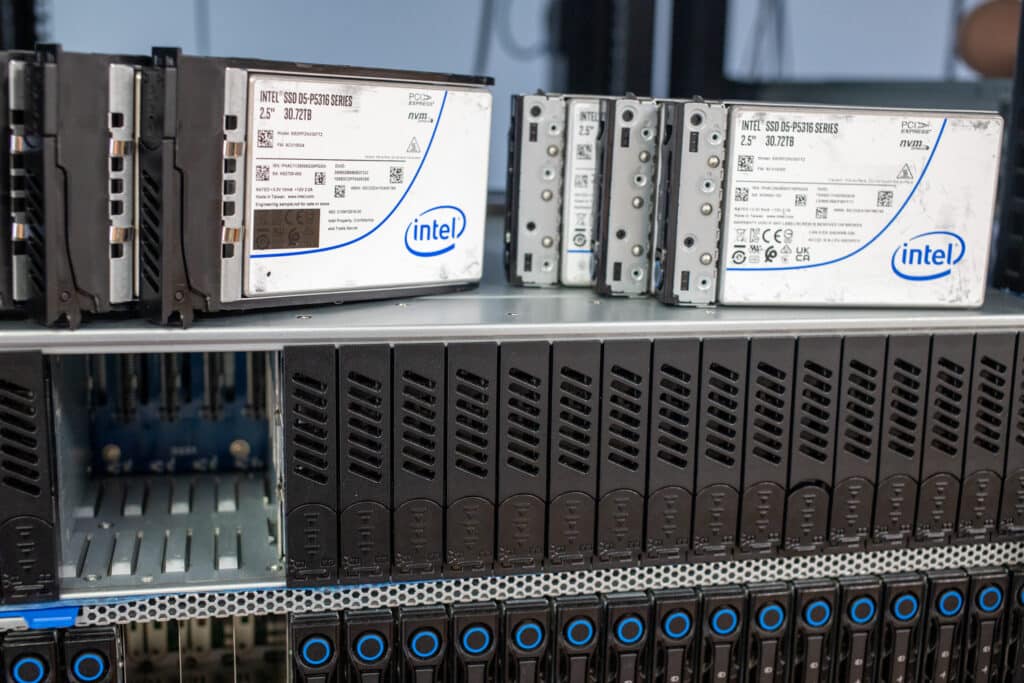
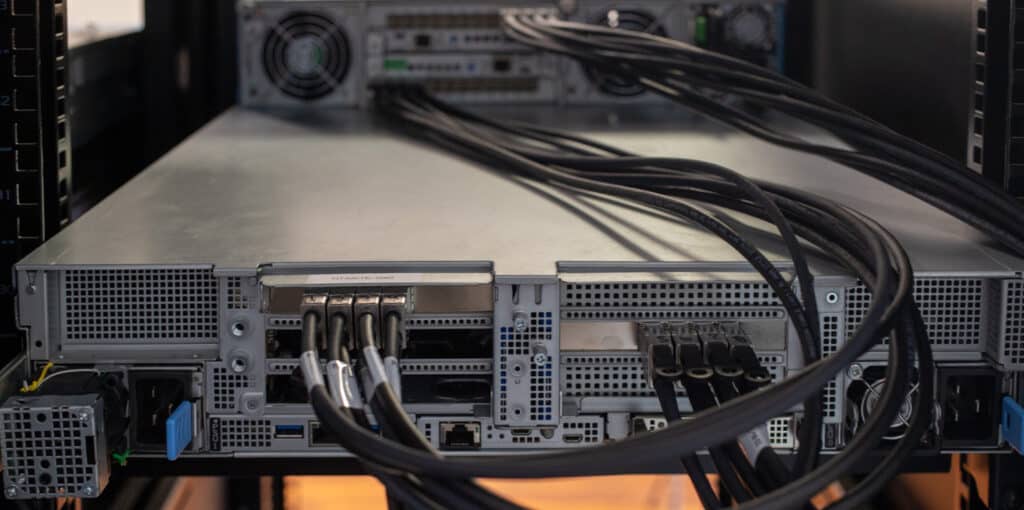
Un nuovo componente per questa sessione di test, necessario per espandere lo spazio di archiviazione disponibile per i processori, è stato l'aggiunta di un JBOF NVMe. La nostra piattaforma di test offriva 16 alloggiamenti NVMe, mentre i restanti otto erano cablati solo per SATA. Sebbene la nostra sessione da 100 trilioni avesse sfruttato tre adattatori PCIe U.2 interni per espandere il numero di unità NVMe a 19, non era ottimale. Per questa nuova sessione, abbiamo aggiunto un JBOF U.2 a 24 alloggiamenti di Serial Cables , che ha apportato due significativi vantaggi: maggiore spazio di archiviazione per lo swap di calcolo e spazio di archiviazione interno per i file di output. Niente più server di archiviazione RAID0 con HDD!
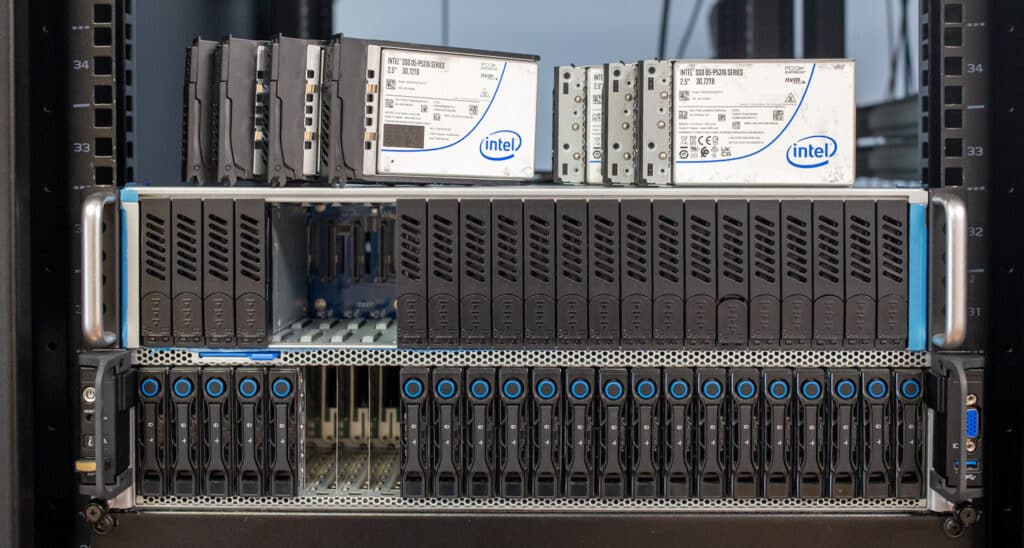
Il JBOF a 24 alloggiamenti dei cavi seriali ci ha permesso di quasi raddoppiare il numero di unità rispetto alla nostra corsa originale. Abbiamo assegnato 30 unità allo spazio di swap y-cruncher, lasciando 6 SSD per un volume di output RAID5 di Storage Spaces. Un enorme vantaggio di questo approccio è arrivato durante la fase di output, dove non siamo stati frenati dalla velocità di una singola connessione da 10 Gb, come la prima iterazione di 100T Pi. Sebbene il JBOF abbia affrontato il problema del conteggio totale delle unità, ha introdotto una limitazione: le prestazioni delle singole unità.
In un server con SSD U.2 collegati direttamente, sono presenti quattro corsie PCIe per unità. Se ciascuna unità è collegata direttamente alla scheda madre, si ottengono 96 linee PCIe per 24 SSD. La larghezza di banda totale di JBOF è limitata dal numero di corsie PCIe che può riconnettere all'host.
In questo caso abbiamo utilizzato due schede host switch PCIe, dividendo il JBOF in due gruppi di 12 SSD. Ciascun gruppo di 12 SSD condivideva quindi 16 linee PCIe. Pur offrendo notevoli vantaggi nel collegare gli SSD al nostro host, abbiamo riscontrato scenari in cui le unità di scambio che attraversavano JBOF rimanevano indietro rispetto alle unità direttamente collegate al server. Questa non è colpa della JBOF. È solo una limitazione tecnica o piuttosto una limitazione del numero di corsie PCIe con cui il server può funzionare.
I lettori più attenti potrebbero chiedersi perché ci siamo fermati a 36 SSD in questa corsa invece di salire a 40. È una storia divertente. Lo spazio PCIe indirizzabile ha i suoi limiti in molti server. Nel nostro caso, al conteggio di 38 unità, l'ultimo SSD ha preso l'indirizzo PCIe del chipset USB e abbiamo perso il controllo del server. Per andare sul sicuro, abbiamo eseguito il backup a 36 SSD in modo da poter comunque accedere al BIOS o accedere al server. Superare i confini porta ad alcune scoperte sorprendenti.
Approfondimento diagnostico e risoluzione
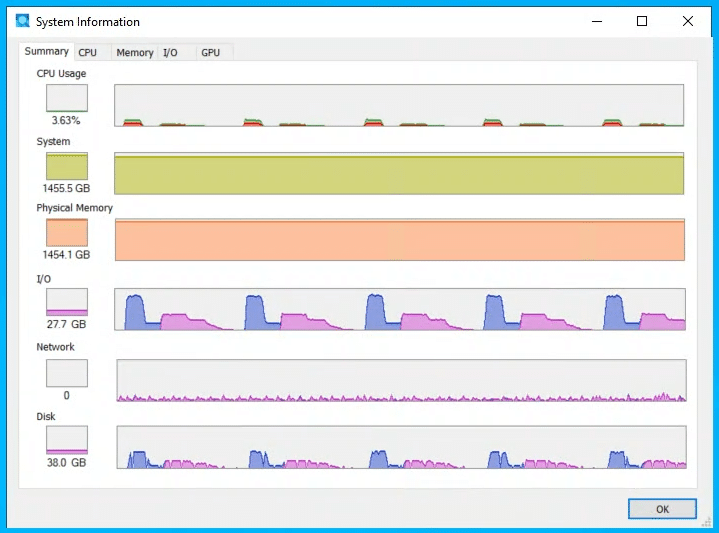
La prima delle due principali sfide che abbiamo incontrato riguardava le prestazioni. Abbiamo scoperto che si trattava della legge di Amdahl in azione. È emerso un problema particolare: y-cruncher sembrava "bloccarsi" sul nostro sistema AMD Bergamo a 256 core durante operazioni di swap di grandi dimensioni. Questo blocco, caratterizzato da una mancanza di attività di CPU e I/O del disco, ha messo in discussione le aspettative convenzionali sul comportamento del software. Ciò ci ha portato ad approfondire le complessità del calcolo parallelo e delle interazioni hardware.
Il processo di scoperta ha rivelato che il programma non era realmente bloccato ma funzionava con una capacità fortemente limitata, eseguendo un thread singolo su un'ampia configurazione da 256 core. Questo comportamento insolito ha sollevato dubbi sul potenziale impatto della Legge di Amdahl, soprattutto perché le operazioni coinvolte non erano ad alta intensità di calcolo e non avrebbero dovuto causare ritardi significativi su un sistema dotato di 1.5 TB di RAM.
L'indagine ha preso una piega inaspettata quando il problema è stato riprodotto su un computer desktop di un utente comune, evidenziando le gravi implicazioni della legge di Amdahl anche su sistemi meno complessi. Ciò ha portato a un esame più approfondito delle cause sottostanti, che ha rivelato un rischio specifico della CPU per l'architettura Zen4, relativo al super-allineamento e ai suoi effetti sui modelli di accesso alla memoria.
Il problema è stato esacerbato sui processori AMD da un loop nel codice che, data la sua natura semplice, avrebbe dovuto essere eseguito molto più velocemente di quanto osservato. La causa principale sembrava essere la gestione inefficiente dell'aliasing della memoria da parte dell'unità load-store di AMD. La risoluzione di questo problema complesso ha richiesto sia di mitigare il rischio di superallineamento attraverso la vettorizzazione del loop utilizzando AVX512, sia di affrontare il rallentamento causato dalla legge di Amdahl con un parallelismo migliorato. Questo approccio globale non solo ha risolto il problema immediato, ma ha anche portato a significative ottimizzazioni nei processi computazionali di y-cruncher, creando un precedente per affrontare sfide simili in ambienti informatici ad alte prestazioni.
Il problema successivo è stato riscontrato nelle fasi finali del calcolo, che si sarebbe interrotto inaspettatamente e non avrebbe fornito informazioni sulla causa dell'incidente. L'accesso remoto è stato concesso ad Alexander Yee e, per la prima volta in oltre un decennio, il completamento di un record Pi ha richiesto l'intervento diretto dello sviluppatore.
Non siamo stati coinvolti in questo processo diagnostico, ma c'era un errore critico di aritmetica in virgola mobile nel percorso del codice AVX512 dell'algoritmo di moltiplicazione N63. Alexander è stato in grado di diagnosticare da remoto , fornire un binario corretto e riprendere da un checkpoint, culminando in un calcolo riuscito dopo aver implementato correzioni software cruciali.
Riflessioni e andare avanti
Questo sforzo illustra le complessità e le imprevedibilità del calcolo ad alte prestazioni. La risoluzione di queste sfide ha stabilito un nuovo record nel calcolo del Pi e ha fornito preziose informazioni sullo sviluppo del software e sulle metodologie di test. L'ultima versione di y-cruncher, v0.8.4, incorpora correzioni per i problemi identificati, promettendo una maggiore stabilità per i calcoli futuri.
Calcolare il Pi greco con 105 trilioni di cifre non è stata un’impresa da poco. Ha comportato una pianificazione, ottimizzazione ed esecuzione meticolosa. Sfruttando una combinazione di software open source e proprietario, il team di StorageReview ha ottimizzato il processo algoritmico per sfruttare appieno le capacità dell'hardware, riducendo i tempi di calcolo e migliorando l'efficienza.
Con prestazioni di lettura saturanti PCIe Gen4 e capacità leader del settore fino a 61.44 TB, gli SSD Solidigm QLC offrono risultati incredibili. “Immagina cosa possono abilitare queste unità in applicazioni di calcolo ad alte prestazioni o ad alta intensità di intelligenza artificiale”, ha affermato Greg Matson, vicepresidente di pianificazione strategica e marketing di Solidigm. Siamo entusiasti che gli SSD di Solidigm possano alimentare il secondo tentativo da record di Storagereview di calcolare pi greco. I loro sforzi dimostrano le reali capacità delle unità di archiviazione Solidigm, aprendo un mondo di possibilità per le applicazioni AI ad alta intensità di dati”.
Conclusione
La corsa verso i 105mila miliardi di cifre del Pi greco è stata molto più complessa di quanto ci aspettassimo. Riflettendoci, avremmo dovuto aspettarci di incontrare nuovi problemi; dopo tutto, stiamo completando un calcolo mai eseguito prima. Ma con il calcolo di 100 trilioni completato con una configurazione molto più “nastro adesivo e rete metallica”, pensavamo di avercela fatta. Alla fine, è stato necessario uno sforzo di collaborazione per portare questo impianto a tagliare il traguardo.
Mentre ci rallegriamo con i nostri partner per questa corsa da record, dobbiamo chiederci: “Cosa significa questo?” Altri cinque trilioni di cifre del Pi probabilmente non faranno una grande differenza per la matematica. Tuttavia, possiamo tracciare alcune linee tra i carichi di lavoro computazionali e la necessità di un moderno hardware sottostante per supportarli. Fondamentalmente, questo esercizio riflette il fatto che l'hardware adeguato fa la differenza, sia che si tratti di un cluster di data center aziendali o di una grande installazione HPC.
Per il calcolo del Pi greco, eravamo completamente limitati dalla memoria di archiviazione. CPU più veloci contribuiranno ad accelerare i calcoli, ma il fattore limitante per molti nuovi record mondiali è la quantità di memoria locale disponibile. Per questa esecuzione, stiamo nuovamente sfruttando gli SSD Solidigm D5-P5316 da 30.72 TB per ottenere poco più di 1.1 PB di memoria flash grezza nel sistema. Questi SSD sono l'unica ragione per cui siamo riusciti a superare i record precedenti e raggiungere 105 trilioni di cifre del Pi greco.
Questo solleva però una questione interessante. Molti dei nostri follower sanno che Solidigm offre SSD da 61.44 TB nel modello D5-P5336 e fino a 30.72 TB nel modello D5-P5430 , disponibili in diversi formati e capacità. Abbiamo recensito queste unità e pubblicato numerosi post sui social media che mostrano la loro incredibile densità di archiviazione. Con 32 di questi SSD che si avvicinano ai 2 PB di spazio di archiviazione, ci si potrebbe chiedere per quanto tempo ancora il Pi greco, con le sue 105 trilioni di cifre, rimarrà il numero più grande al mondo. Ci piace pensare che non durerà a lungo.
Le cifre decimali più grandi conosciute del Pi greco
1432360875 9463978314 2999186657 8364664840 8558373926: cifre fino a 105,000,000,000,000


 Amazon