

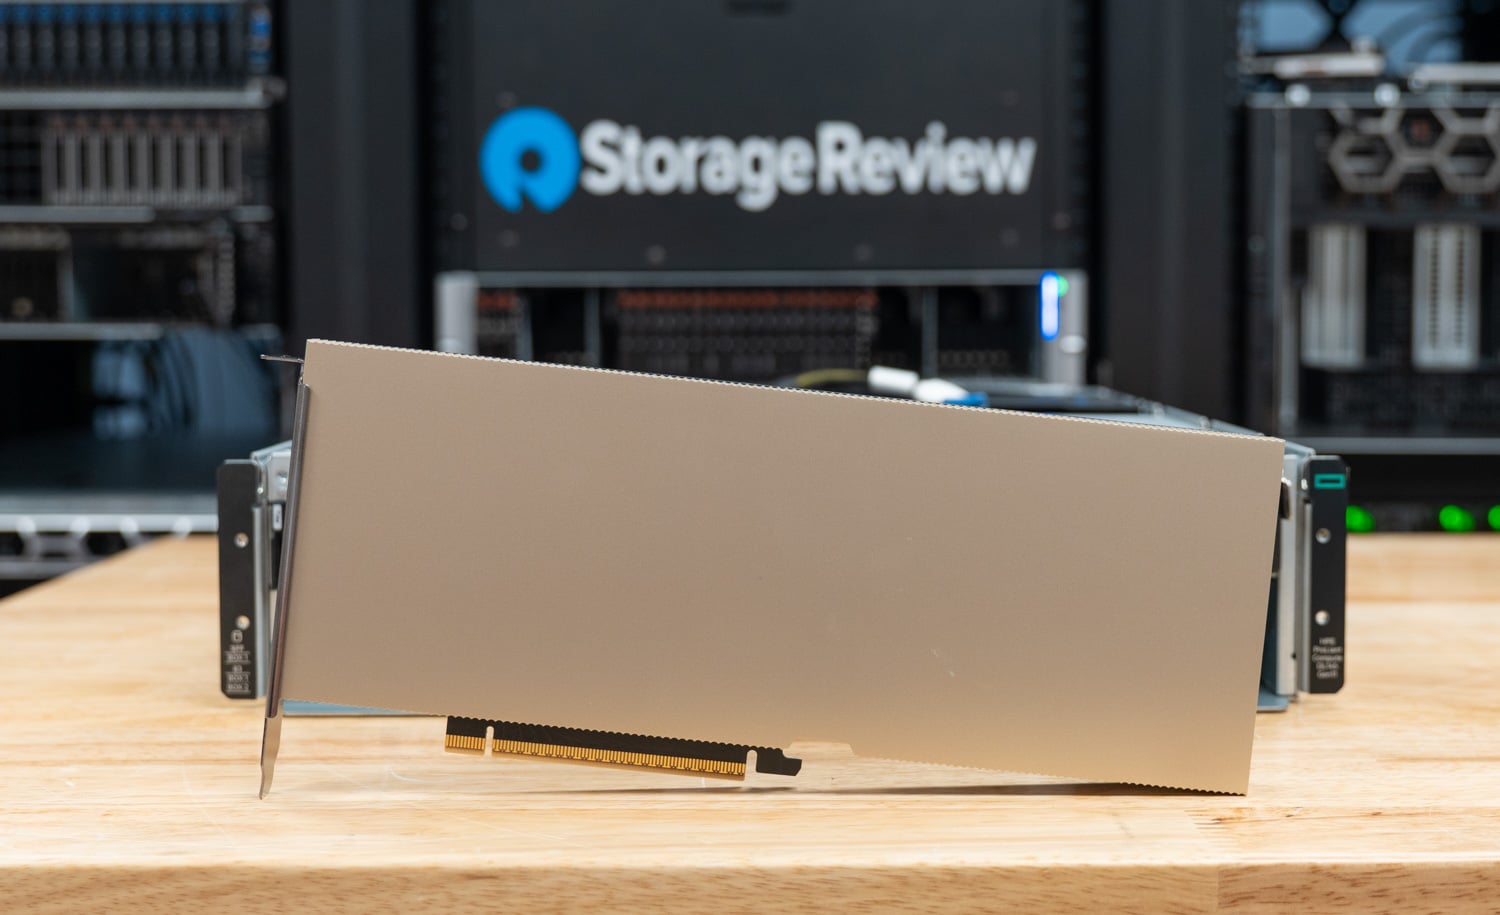
La NVIDIA RTX PRO 4500 Blackwell Server Edition è la scheda grafica progettata da NVIDIA principalmente per sostituire l'L4 nei server esterni al data center: single-slot, PCIe Gen5, raffreddamento passivo, 165 W, con 32 GB di GDDR7 e tutte le funzionalità Blackwell, inclusi i Tensor Core FP4 e la GPU multi-istanza. HPE ci ha inviato un ProLiant DL145 Gen11, il server edge a profondità ridotta che abbina a questa GPU nella sua soluzione edge Nemotron, e abbiamo eseguito lo stesso test di servizio vLLM sia sulla RTX PRO 4500 che su un L4 nello stesso chassis. Questa recensione della RTX PRO 4500 edge si concentra proprio su questo confronto: cosa ottiene un sito che già utilizza un L4 in un server edge sostituendolo con la 4500, in termini di token, latenza e consumo energetico.
Su due piccoli modelli BF16 in condizioni di concorrenza pratica, la RTX PRO 4500 offre una velocità di trasmissione 2.7 volte superiore a quella della L4, mantiene la latenza del primo token inferiore a un secondo con carichi in cui la L4 è già in coda e, per farlo, aumenta il consumo energetico complessivo del server DL145 da circa 196 W a circa 301 W. Per watt di GPU, il guadagno è da 1.3 a 1.4 volte. Per scheda, rappresenta la differenza tra gestire da 32 a 64 sessioni di chat simultanee e gestirne 256. Per box, il DL145 può ospitare fino a tre L4 e tre con 32 sessioni ciascuna si avvicinano alla velocità di una 4500, quindi il caso d'uso della 4500 a livello di box si basa su velocità per utente, latenza, un singolo pool di memoria da 32 GB e FP4.
Questo è un test su server edge che confronta una scheda con il suo predecessore, sulla piattaforma Metrum AI® Bench, con i modelli che si adattano comodamente a 24 GB e 32 GB. La RTX PRO 4500 Server Edition dovrebbe anche essere inclusa in un confronto più ampio con il resto della gamma di schede di inferenza NVIDIA, e stiamo conducendo dei test a riguardo per un articolo separato. Per questo test, la L4 è il confronto più rilevante e abbiamo aggiunto un singolo dataset della RTX PRO 6000 Blackwell solo per mostrare come si presenta NVFP4 su un modello da 26 GB quando è disponibile una scheda più grande con cui confrontarlo. La RTX PRO 6000 non è supportata nel server edge HPE.
Punti chiave
- 2.7 volte il livello 4 nello stesso server: Su 18 combinazioni di input e output su Qwen3.5-4B e Gemma 4 E4B, la RTX PRO 4500 ha fornito una media di 2.7 volte i token di output al secondo della L4 con un numero di richieste simultanee compreso tra 8 e 32, e da 3.0 a 3.2 volte con 256 richieste, con entrambe le schede installate nello stesso server HPE ProLiant DL145 Gen11.
- La latenza rappresenta il divario maggiore: Il 4500 genera token in 12-15 ms contro i 35-40 ms dell'L4 e, con 256 richieste simultanee, il suo tempo mediano per il primo token è rimasto tra 264 ms e 650 ms su richieste da 256 token, mentre quello dell'L4 è salito a 9 e 39 secondi.
- 105W in più alla presa, 2.7 volte i token: Il DL145 ha assorbito circa 196 W servendo sull'L4 e circa 301 W sul 4500 con 32 unità simultanee. I token di output per watt di sistema sono passati da 2.7 a 5.1 su Qwen3.5-4B e da 2.9 a 5.6 su Gemma 4 E4B.
- La velocità per utente si mantiene fino a 256 sessioni sui prompt in formato chat: Dividendo l'output per la concorrenza, il 4500 fornisce ancora a ogni utente da 11 a 22 token al secondo con 256 concorrenti per risposte di 256 token o più lunghe a prompt brevi e medi, dove l'L4 è sceso a 3.7-8.7. L'L4 si colloca al di sotto di una soglia di 10 token al secondo tra 32 e 256 sessioni nella maggior parte delle configurazioni e tra 8 e 16 nella configurazione 1,024/32 con pre-riempimento intensivo; il 4500 rimane al di sopra di tale soglia a 256, tranne che nelle configurazioni con risposte brevi e prompt da 1,024 token.
- 32GB e FP4 aprono una classe di modelli che L4 non può eseguire nativamente: Su una Gemma 4 26B-A4B in NVFP4 con cache KV FP8, la 4500 ha prodotto 1,613 token di output al secondo con 32 processi simultanei a 165 W, circa la metà di quanto una RTX PRO 6000 Blackwell è riuscita a fare in una workstation consumando da 266 a 471 W con 8-32 processi simultanei. Con 256 processi simultanei, il divario si amplia a circa 2.5 volte.
Per cosa è progettata la RTX PRO 4500 Server Edition?
NVIDIA ha annunciato la RTX PRO 4500 Blackwell Server Edition al GTC 2026 come modello entry-level della sua famiglia di schede grafiche RTX PRO per server e successore della L4. Condivide il nome con la scheda workstation RTX PRO 4500 Blackwell e le due schede condividono il chip e un numero di core CUDA pari a 10,496, ma sono prodotti diversi. La Server Edition non include le uscite video e la ventola, mantiene il consumo energetico della scheda a 165 W e aggiunge le funzionalità specifiche per i data center: MIG con un massimo di due istanze da 16 GB, confidential computing, un terzo NVENC e NVDEC e supporto vGPU. NVIDIA dichiara una velocità di memoria di 800 GB/s e un picco di Tensor FP4 di 1.6 PFLOPS con sparsità, e descrive la scheda come una "GPU Blackwell a basso consumo energetico per l'IA aziendale" destinata ai "server mainstream per data center e edge computing". Abbiamo trattato questo argomento nella nostra copertura dell'HPE GTC 2026.
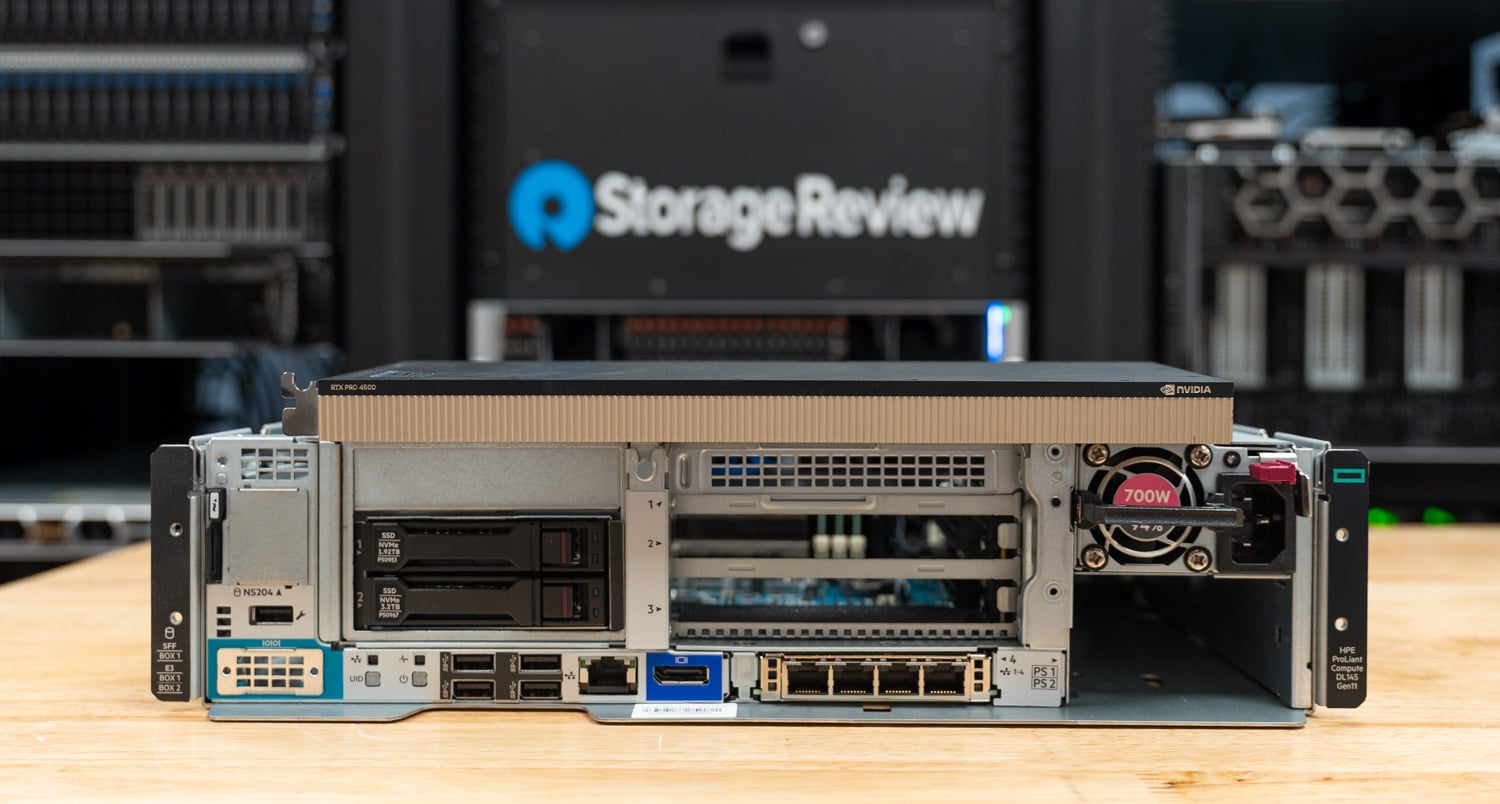
NVIDIA ha anche modificato il fattore di forma: la L4 che abbiamo recensito nel 2024 è una scheda a mezza altezza e mezza lunghezza da 72 W con 24 GB di GDDR6 a 300 GB/s, mentre la RTX PRO 4500 Server Edition è una scheda a singolo slot a tutta altezza e lunghezza da 165 W, quindi occupa ancora un solo slot ma necessita di un riser a tutta lunghezza e di un'alimentazione a 16 pin. Lo slot standard del DL145 Gen11 è a tutta altezza e mezza lunghezza, e HPE ha configurato la nostra unità con il riser e il cavo di alimentazione a tutta lunghezza. Sulla carta, la 4500 offre una larghezza di banda di memoria 2.7 volte superiore a quella della L4, il 33% di memoria in più e 1.7 volte il picco Tensor FP8 con un consumo energetico 2.3 volte superiore, oltre a un percorso FP4 per il quale la L4 non dispone di hardware.
| Specificazione | RTX PRO 4500 Blackwell Server Edition | Nvidia L4 |
|---|---|---|
| Panoramica della piattaforma | ||
| Architettura | Blackwell | Ada Lovelace |
| Nuclei CUDA | 10,496 | 7,424 |
| Memorie | GDDR32 da 7 GB con ECC | 24GB GDDR6 |
| Banda di memoria | 800GB / s | 300GB / s |
| Prestazioni (valori massimi NVIDIA, con sparsità) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| Tensore FP8 | 811 TFLOPS | 485 TFLOPS |
| Tensore FP4 | 1.6 PFLOP | Non supportato |
| Potenza e fattore di forma | ||
| Alimentazione della scheda | 165W | 72W |
| Fattore di forma | Slot singolo, altezza completa, lunghezza completa, passivo | Slot singolo, mezza altezza, mezza lunghezza, passivo |
| Connettore di alimentazione | 1x PCIe CEM5 a 16 pin | Slot alimentato |
| Interfaccia | PCIe 5.0 x16 | PCIe 4.0 x16 |
| Caratteristiche | ||
| MIG | Fino a 2 istanze da 16 GB | Nodo |
| NVENC/NVDEC | 3 / 3 | 2 / 4 |
| Informatica riservata | Capace | Nodo |
Server Edge: HPE ProLiant DL145 Gen11
HPE posiziona il DL145 Gen11 come server ideale per le sedi sprovviste di sala server. La sua descrizione della soluzione per il DL145 e NVIDIA Nemotron illustra un box quasi silenzioso, montabile a parete, con temperature di esercizio da -5°C a 55°C, adatto ad armadi con scarsa ventilazione, ambienti polverosi e climi caldi o freddi, con iLO e Compute Ops Management per l'integrazione di centinaia di sedi dotate solo di alimentazione elettrica e connessione Ethernet. HPE indica come settori target la vendita al dettaglio, la sanità, la finanza, la produzione e l'energia, e i carichi di lavoro elencati sono quelli misurati in questa recensione: modelli linguistici di piccole dimensioni, RAG e ricerca vettoriale eseguiti localmente, in modo che i dati sensibili alla latenza e regolamentati non lascino mai la sede. Abbiamo recensito il DL145 Gen11 al momento del suo lancio, quindi non ripeteremo qui la panoramica della piattaforma.
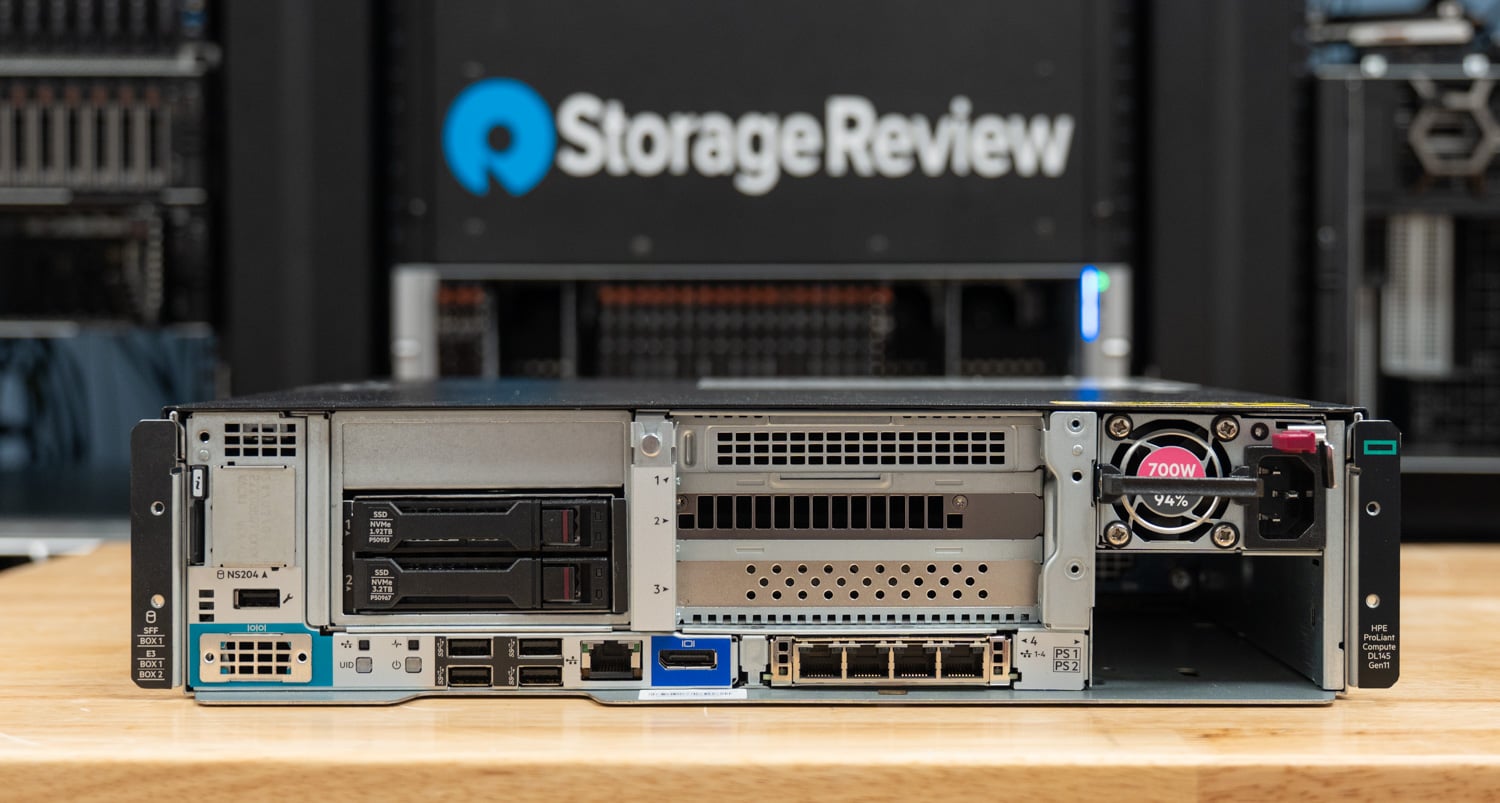
L'unità HPE inviata per questo test è configurata con un singolo AMD EPYC 8534P, un processore Siena a 64 core e 128 thread, 96 GB di DDR5-4800 in sei DIMM da 16 GB e una RTX PRO 4500 Blackwell Server Edition su un riser a tutta lunghezza. Lo chassis ha un backplane U.3 a due alloggiamenti; la nostra unità è stata fornita con cablaggio del backplane solo SATA, quindi abbiamo avviato il sistema da un SSD NVMe Solidigm D7-P5620 da 6.4 TB su un supporto PCIe, il che non ha alcuna influenza sui risultati della GPU. Il confronto con la L4 ha utilizzato la stessa identica configurazione del server. La 4500 è la scheda che HPE fornisce in questa piattaforma per la sua soluzione edge Nemotron; la L4 è quella che un possessore di un DL145 degli ultimi due anni ha molto probabilmente in quello slot oggi.
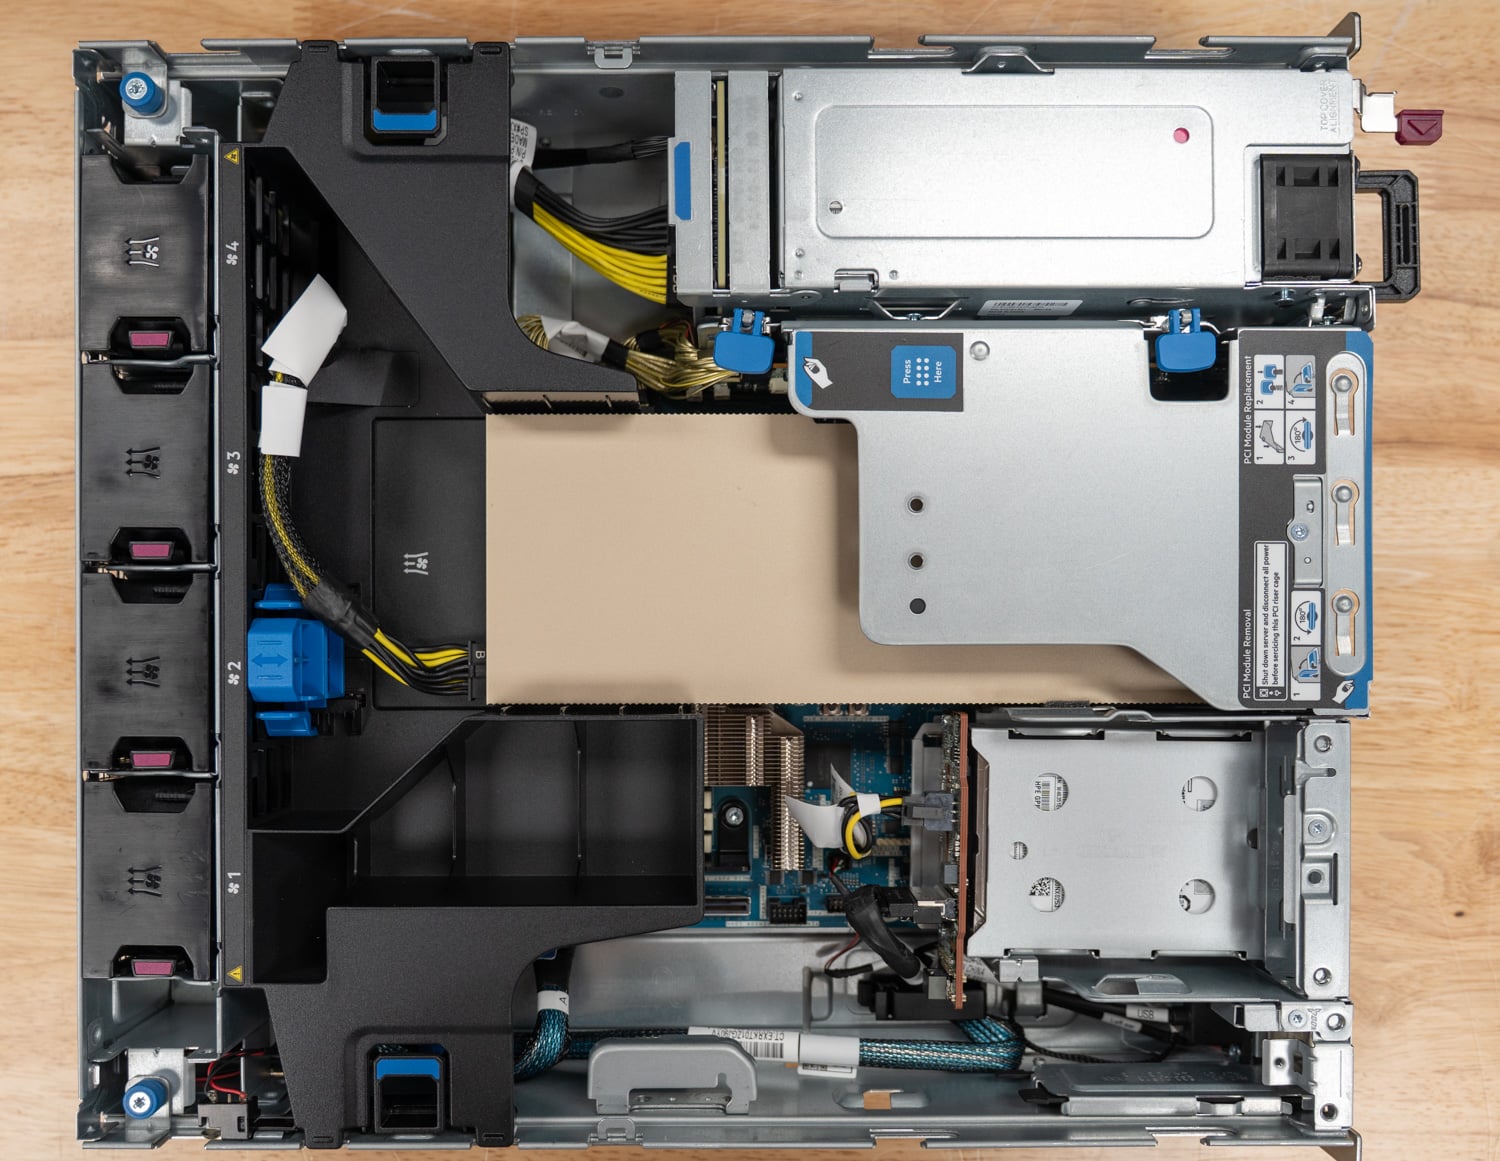
Altri due dati relativi alla piattaforma contribuiscono all'analisi seguente: il DL145 riporta il consumo energetico dell'intero server tramite iLO, e la piattaforma di test lo ha registrato insieme al consumo della scheda GPU stessa a ogni esecuzione, permettendoci di parlare di watt alla presa di corrente e watt alla scheda. Inoltre, il flusso d'aria del server ha mantenuto entrambe le schede passive entro i loro limiti: la 4500 ha raggiunto una temperatura media della GPU di 84°C durante le esecuzioni più lunghe e la L4 di 86°C, entrambe sotto carico di inferenza a piena potenza sostenuto in uno chassis 2U a profondità ridotta.
Come abbiamo testato
Tutti i dati di inferenza in questa recensione sono stati raccolti con la piattaforma Metrum AI Bench (versione 3.9.2, registrata nei file di esecuzione con il suo precedente nome, Metrum Insights), che utilizza vLLM 0.24.0 come motore di esecuzione. La piattaforma Bench esegue una griglia fissa di scenari su ciascun sistema, registra il throughput, i percentili di latenza, la telemetria della GPU e il consumo energetico dell'host per ogni scenario ed esporta i risultati come un singolo dataset per ogni job. Abbiamo già parlato della collaborazione di Metrum AI con l'Oregon State University e Dell ha utilizzato la stessa piattaforma per il suo brief tecnico sull'R770AP; questa è la prima volta che la utilizziamo per condurre il nostro confronto end-to-end tra GPU. Gli ingegneri di Metrum AI e il nostro laboratorio hanno eseguito i job insieme, con la piattaforma Bench che si è occupata della raccolta dati e il nostro team che ha impostato l'hardware, i modelli e le domande.
Metrum AI pubblica anche un software complementare open-source, Metrum AI Bench CLI , che i lettori possono utilizzare per eseguire lo stesso tipo di test sui propri sistemi. Metrum AI è un marchio registrato e Metrum AI Bench CLI e Metrum AI Bench Platform sono marchi commerciali di Metrum AI, Inc. L'utilizzo di Metrum AI Bench non implica l'approvazione da parte di Metrum AI.
La griglia è composta da nove forme di prompt: ogni combinazione di 32, 256 e 1,024 token di input con 32, 256 e 1,024 token di output massimi, ciascuna eseguita con 1, 8, 16, 32 e 256 richieste simultanee, per 45 scenari per modello per GPU. L'esecuzione di Gemma 4 su L4 includeva anche 64 e 128 richieste simultanee, che si sono rivelate utili per trovare il suo limite massimo. Ogni scenario invia 15 richieste per flusso da 1 a 32 richieste simultanee e 1,280 richieste a 256. Il job Gemma 4 E4B su 4500 è stato eseguito tre volte; la varianza scenario-scenario tra le ripetizioni era inferiore al 2% e riportiamo la mediana. I job L4 e 4500 BF16 e i due job Gemma 4 26B, uno su ciascuna scheda, corrispondono a 378 esecuzioni di scenari, e in totale si è verificata una richiesta fallita in una ripetizione di uno scenario 4500, che menzioniamo solo a scopo informativo.
Il test è stato condotto su tre modelli: Qwen3.5-4B e Gemma 4 E4B, entrambi eseguiti in BF16 con cache KV BF16, sono i due modelli utilizzati sia dall'L4 che dal 4500 e hanno le dimensioni realistiche di un modello utilizzato oggi in un'implementazione edge su una scheda da 24 GB. Gemma 4 26B-A4B, un modello misto di 26 miliardi di esperti con circa 4 miliardi di parametri attivi, è stato eseguito in NVFP4 con cache KV FP8 solo sul 4500, utilizzando come punto di riferimento una RTX PRO 6000 Blackwell Workstation Edition (600 W) in un Dell Pro Max Tower T2 . L'L4 non dispone di capacità di calcolo FP4 native e non ha spazio per questo modello in BF16, quindi non è incluso in questa parte del test.
Tre note sulla lettura dei grafici: i grafici del throughput iniziano con 8 richieste simultanee. Gli scenari a richiesta singola sono abbastanza brevi (15 richieste, di pochi secondi ciascuna) da far sì che la prima richiesta di ogni scenario Qwen a utente singolo sulla 4500, che ha raggiunto un ritardo del primo token di 37-39 secondi, falsi il valore del throughput dell'esecuzione, quindi per il caso a utente singolo riportiamo la latenza per token e il tempo di risposta, che non sono influenzati. La potenza della GPU è una media campionata, quindi calcoliamo i token per watt solo da esecuzioni abbastanza lunghe da permettere alla media di stabilizzarsi, il che in pratica significa 16 richieste simultanee e oltre. E a 256 richieste simultanee con prompt lunghi, entrambe le schede esauriscono la cache KV e le richieste delle code vLLM; questi punti rappresentano ancora valori di throughput reali, ma i valori del tempo al primo token a quel carico descrivono una coda, e consideriamo 32 richieste simultanee come l'intervallo di lavoro per l'utilizzo sensibile alla latenza.
Qwen3.5-4B
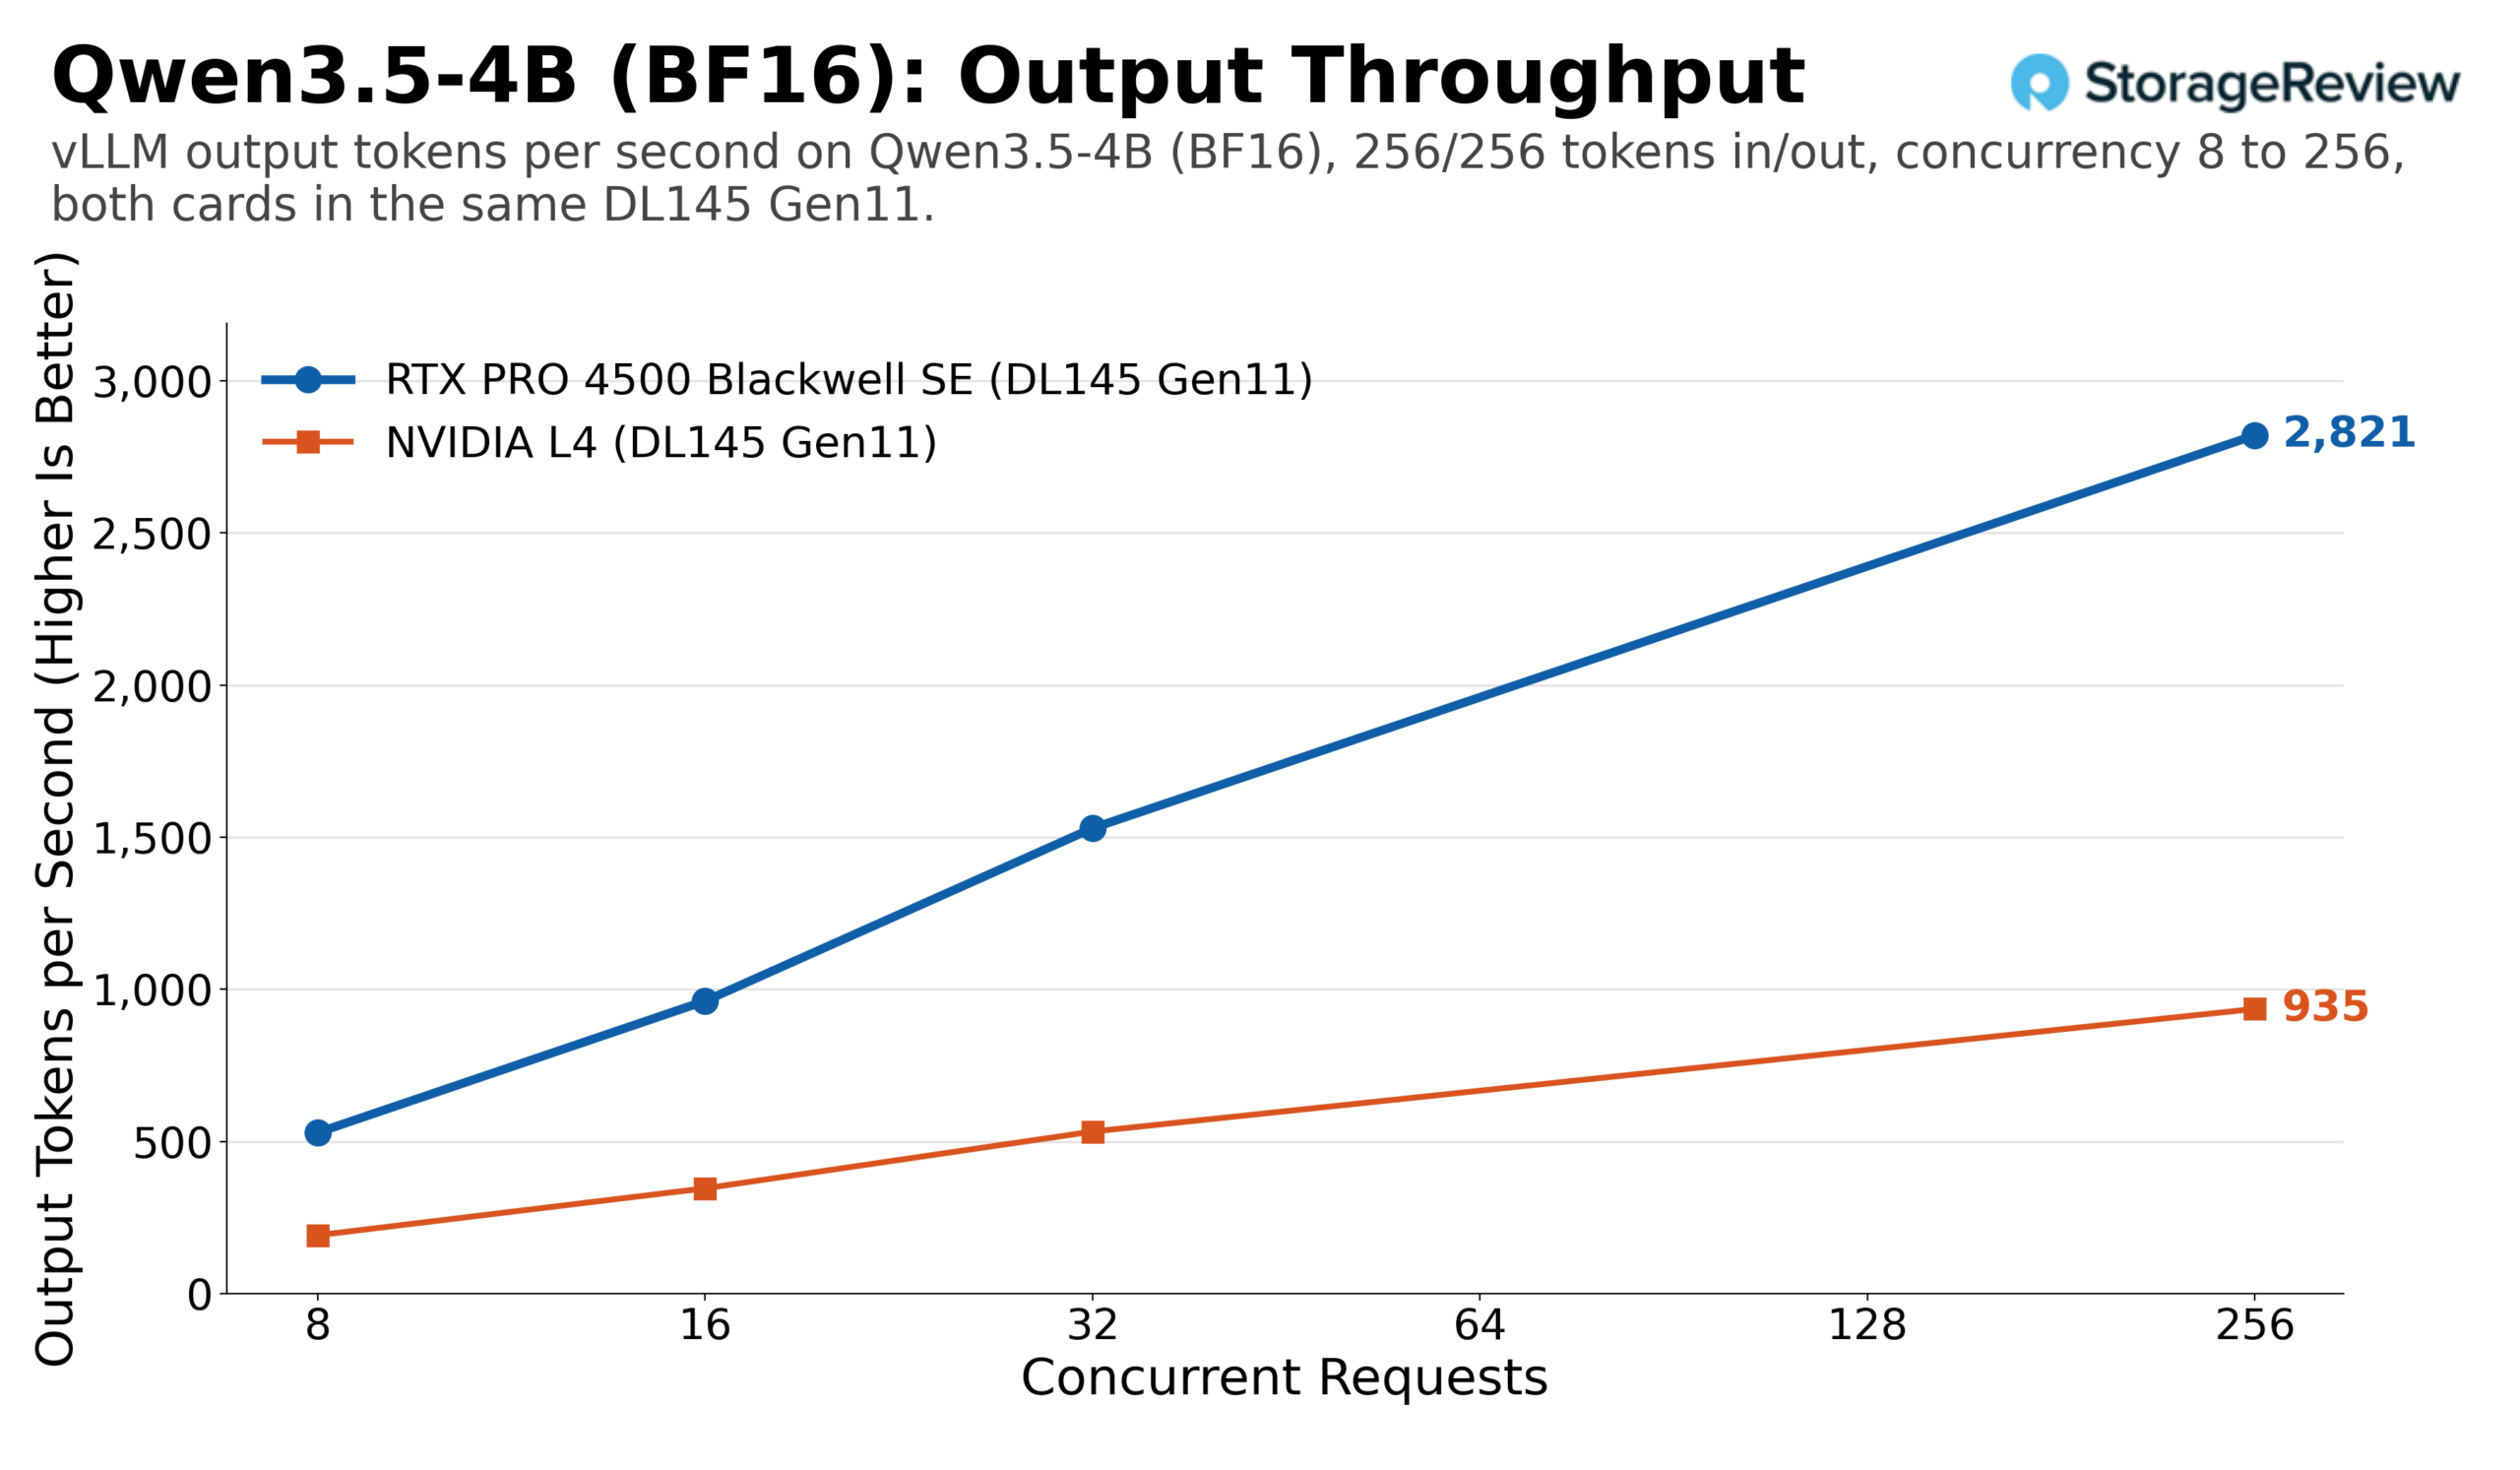
La griglia sottostante mostra in sintesi il confronto completo tra Qwen3.5 e Qwen4B: output di token al secondo su entrambe le schede per ogni configurazione di prompt, da 8 a 256 richieste simultanee. La stessa forma della curva si ripete in tutti e nove i pannelli, con la 4500 che si posiziona a circa 2.5-2.8 volte la L4 a 8 richieste simultanee, scalando leggermente più velocemente fino a 32 e stabilizzandosi a 2.4-3.2 volte a 256.
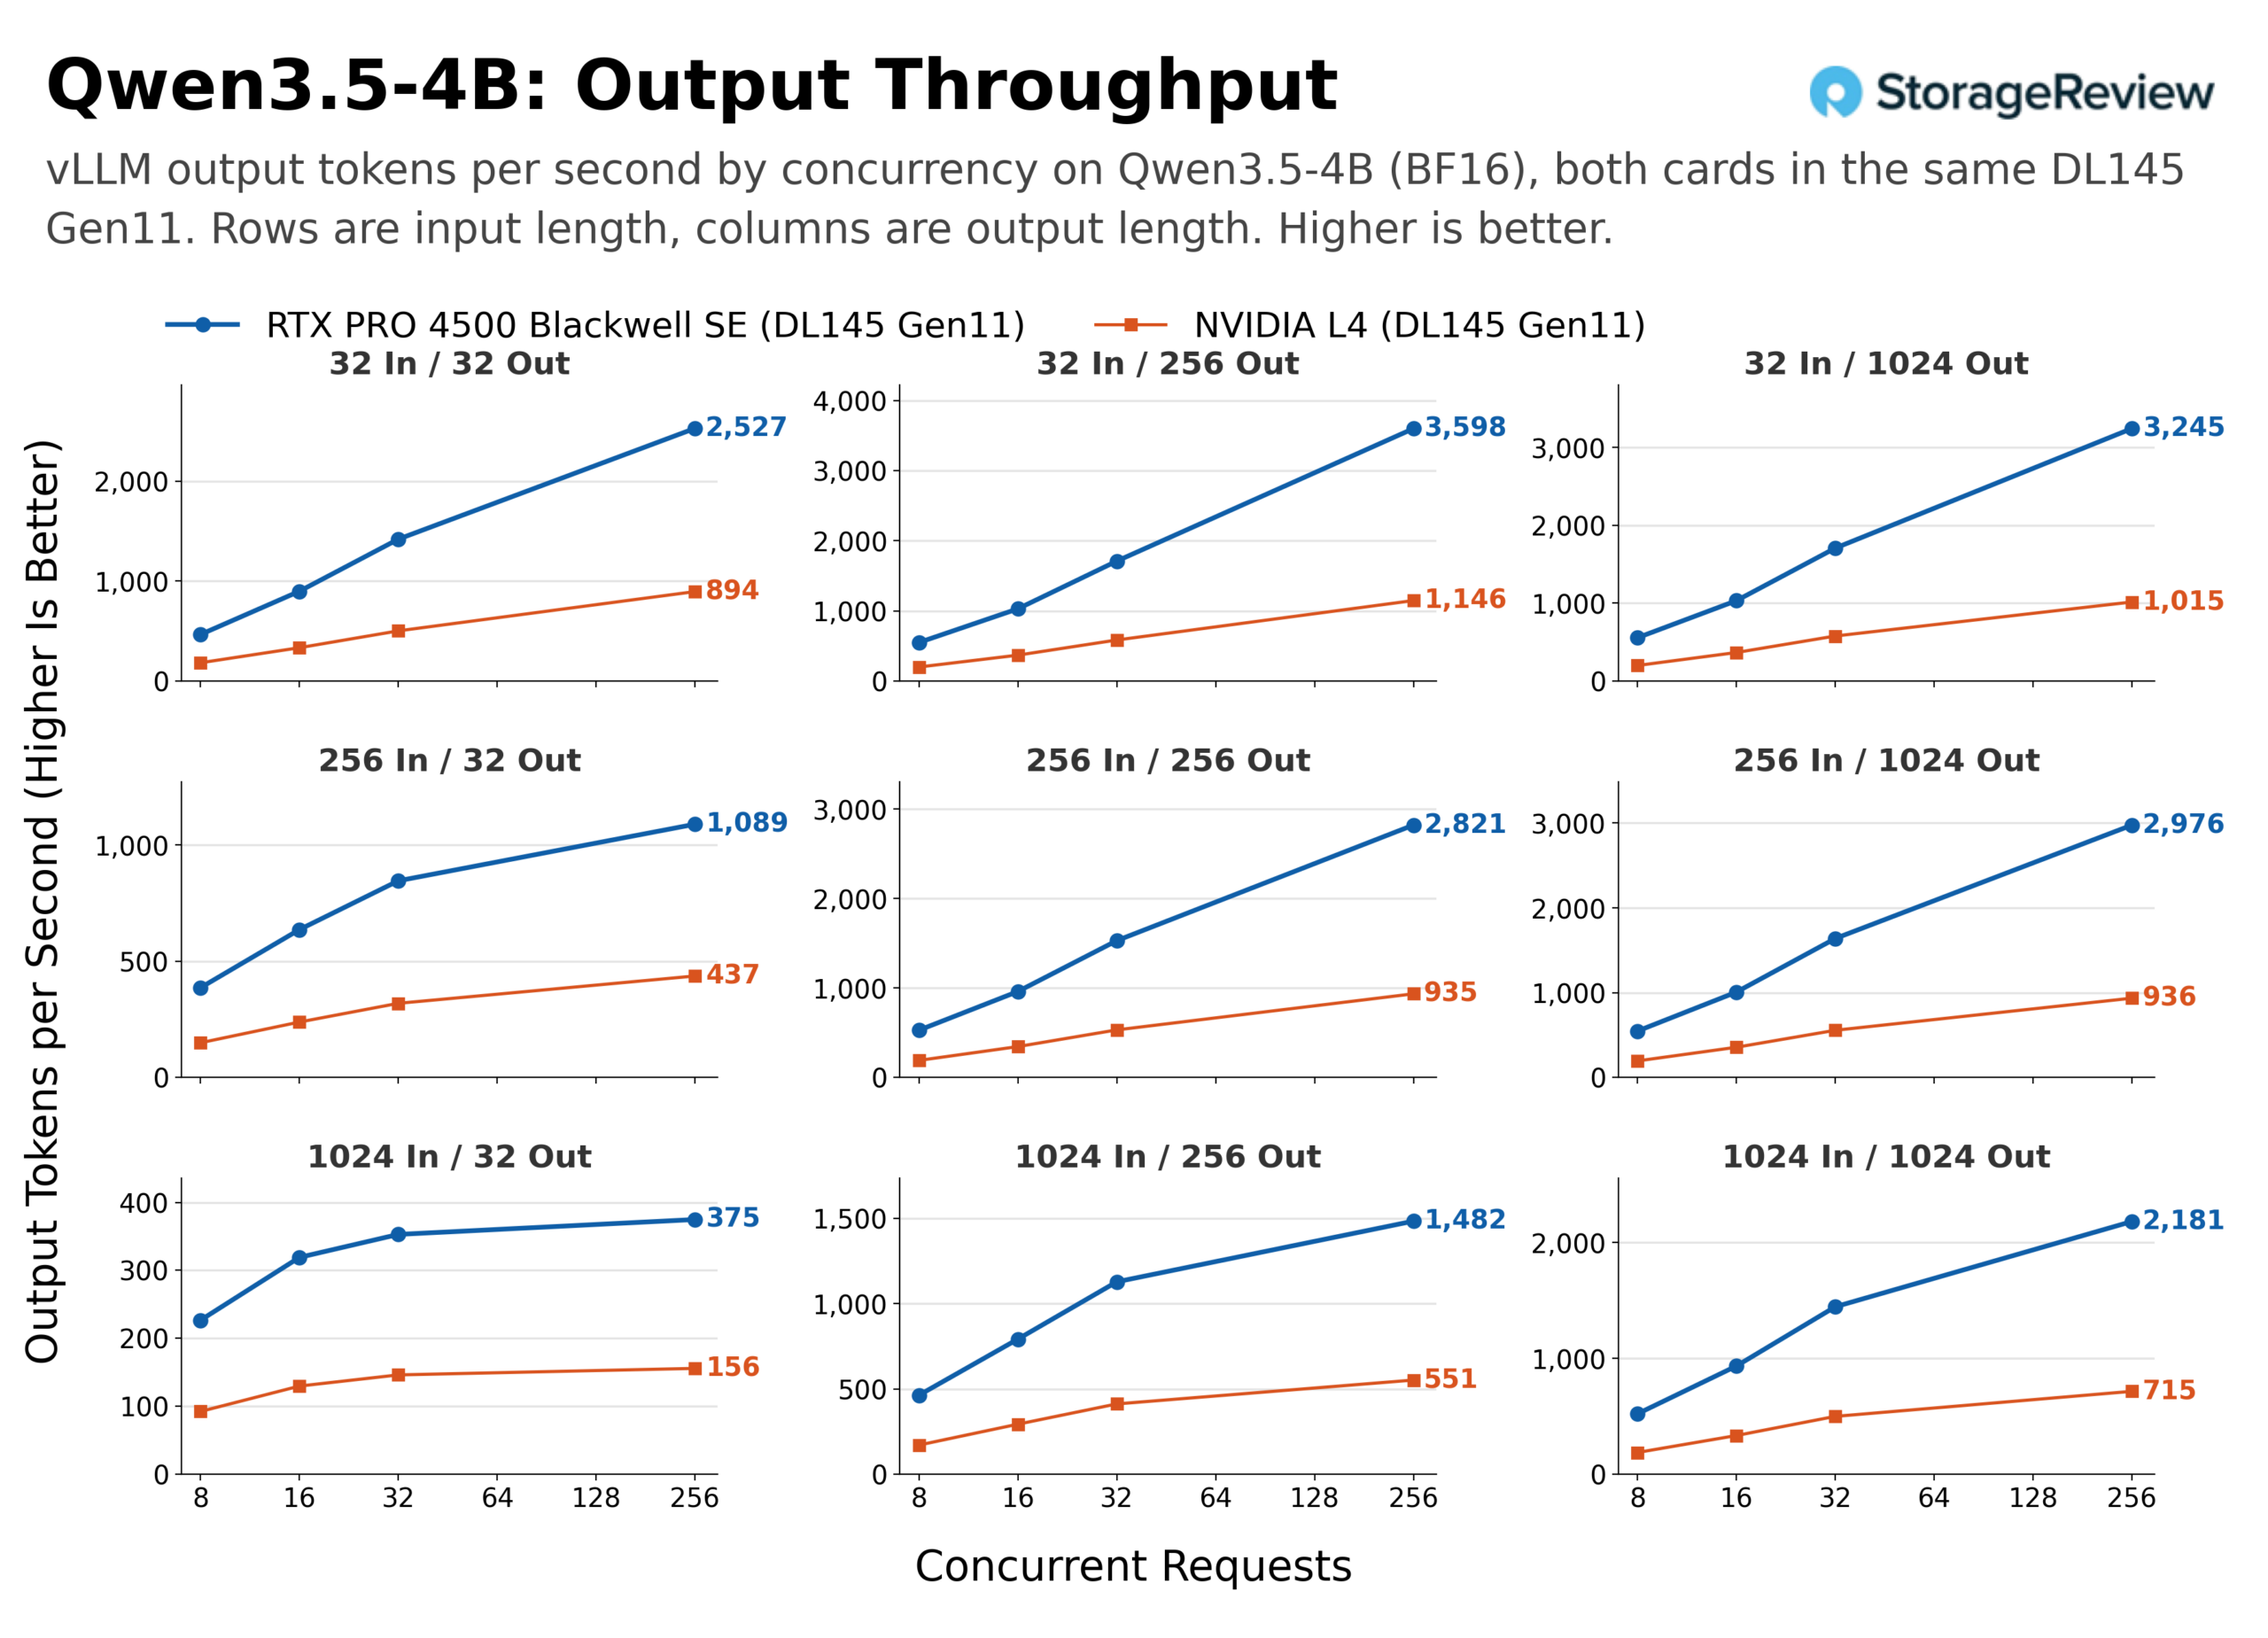
Prendendo come riferimento la configurazione 256 in, 256 out delle dimensioni di una chat: con 8 concorrenti, la L4 ha prodotto 192 token di output al secondo e la 4500 529 (2.76x); con 32 concorrenti, 532 contro 1,529 (2.87x); con 256 concorrenti, 935 contro 2,821 (3.02x). La configurazione più lunga, 1,024 token per direzione, la segue quasi esattamente: 499 contro 1,445 con 32 concorrenti e 715 contro 2,181 con 256. Il divario più piccolo nell'intera griglia è il caso con pre-riempimento intenso di 1,024 in, 32 out, dove la 4500 mantiene un vantaggio costante di 2.4x a partire da 8 concorrenti, perché quel carico di lavoro è quasi interamente costituito da elaborazione immediata ed entrambe le schede sono limitate dalla potenza di calcolo fin dall'inizio. Qwen3.5-4B sale costantemente su quella forma su entrambe le schede. L'unico calo a 16 simultanei nelle griglie BF16 è il 4500 che esegue Gemma 4 E4B su 1,024/32, che è apparso in tutte e tre le ripetizioni; non abbiamo isolato la causa.
Per un singolo utente, il rapporto di throughput sottovaluta la differenza, perché ciò che una persona vede è la velocità con cui appaiono le parole. Sulla forma 256/256, il 4500 ha generato a una mediana di 12.4 ms per token, l'L4 a 35.0 ms, quindi una risposta di 256 token ha richiesto circa 3.2 secondi sul 4500 e 9.0 secondi sull'L4. Con 1,024 token per lato, il tempo è stato di 13.1 secondi contro 36.6 secondi. La latenza del primo token per quell'unico utente è stata di 43 ms sul 4500 e 81 ms sull'L4 per il prompt più breve, 99 ms contro 219 ms per quello più lungo.
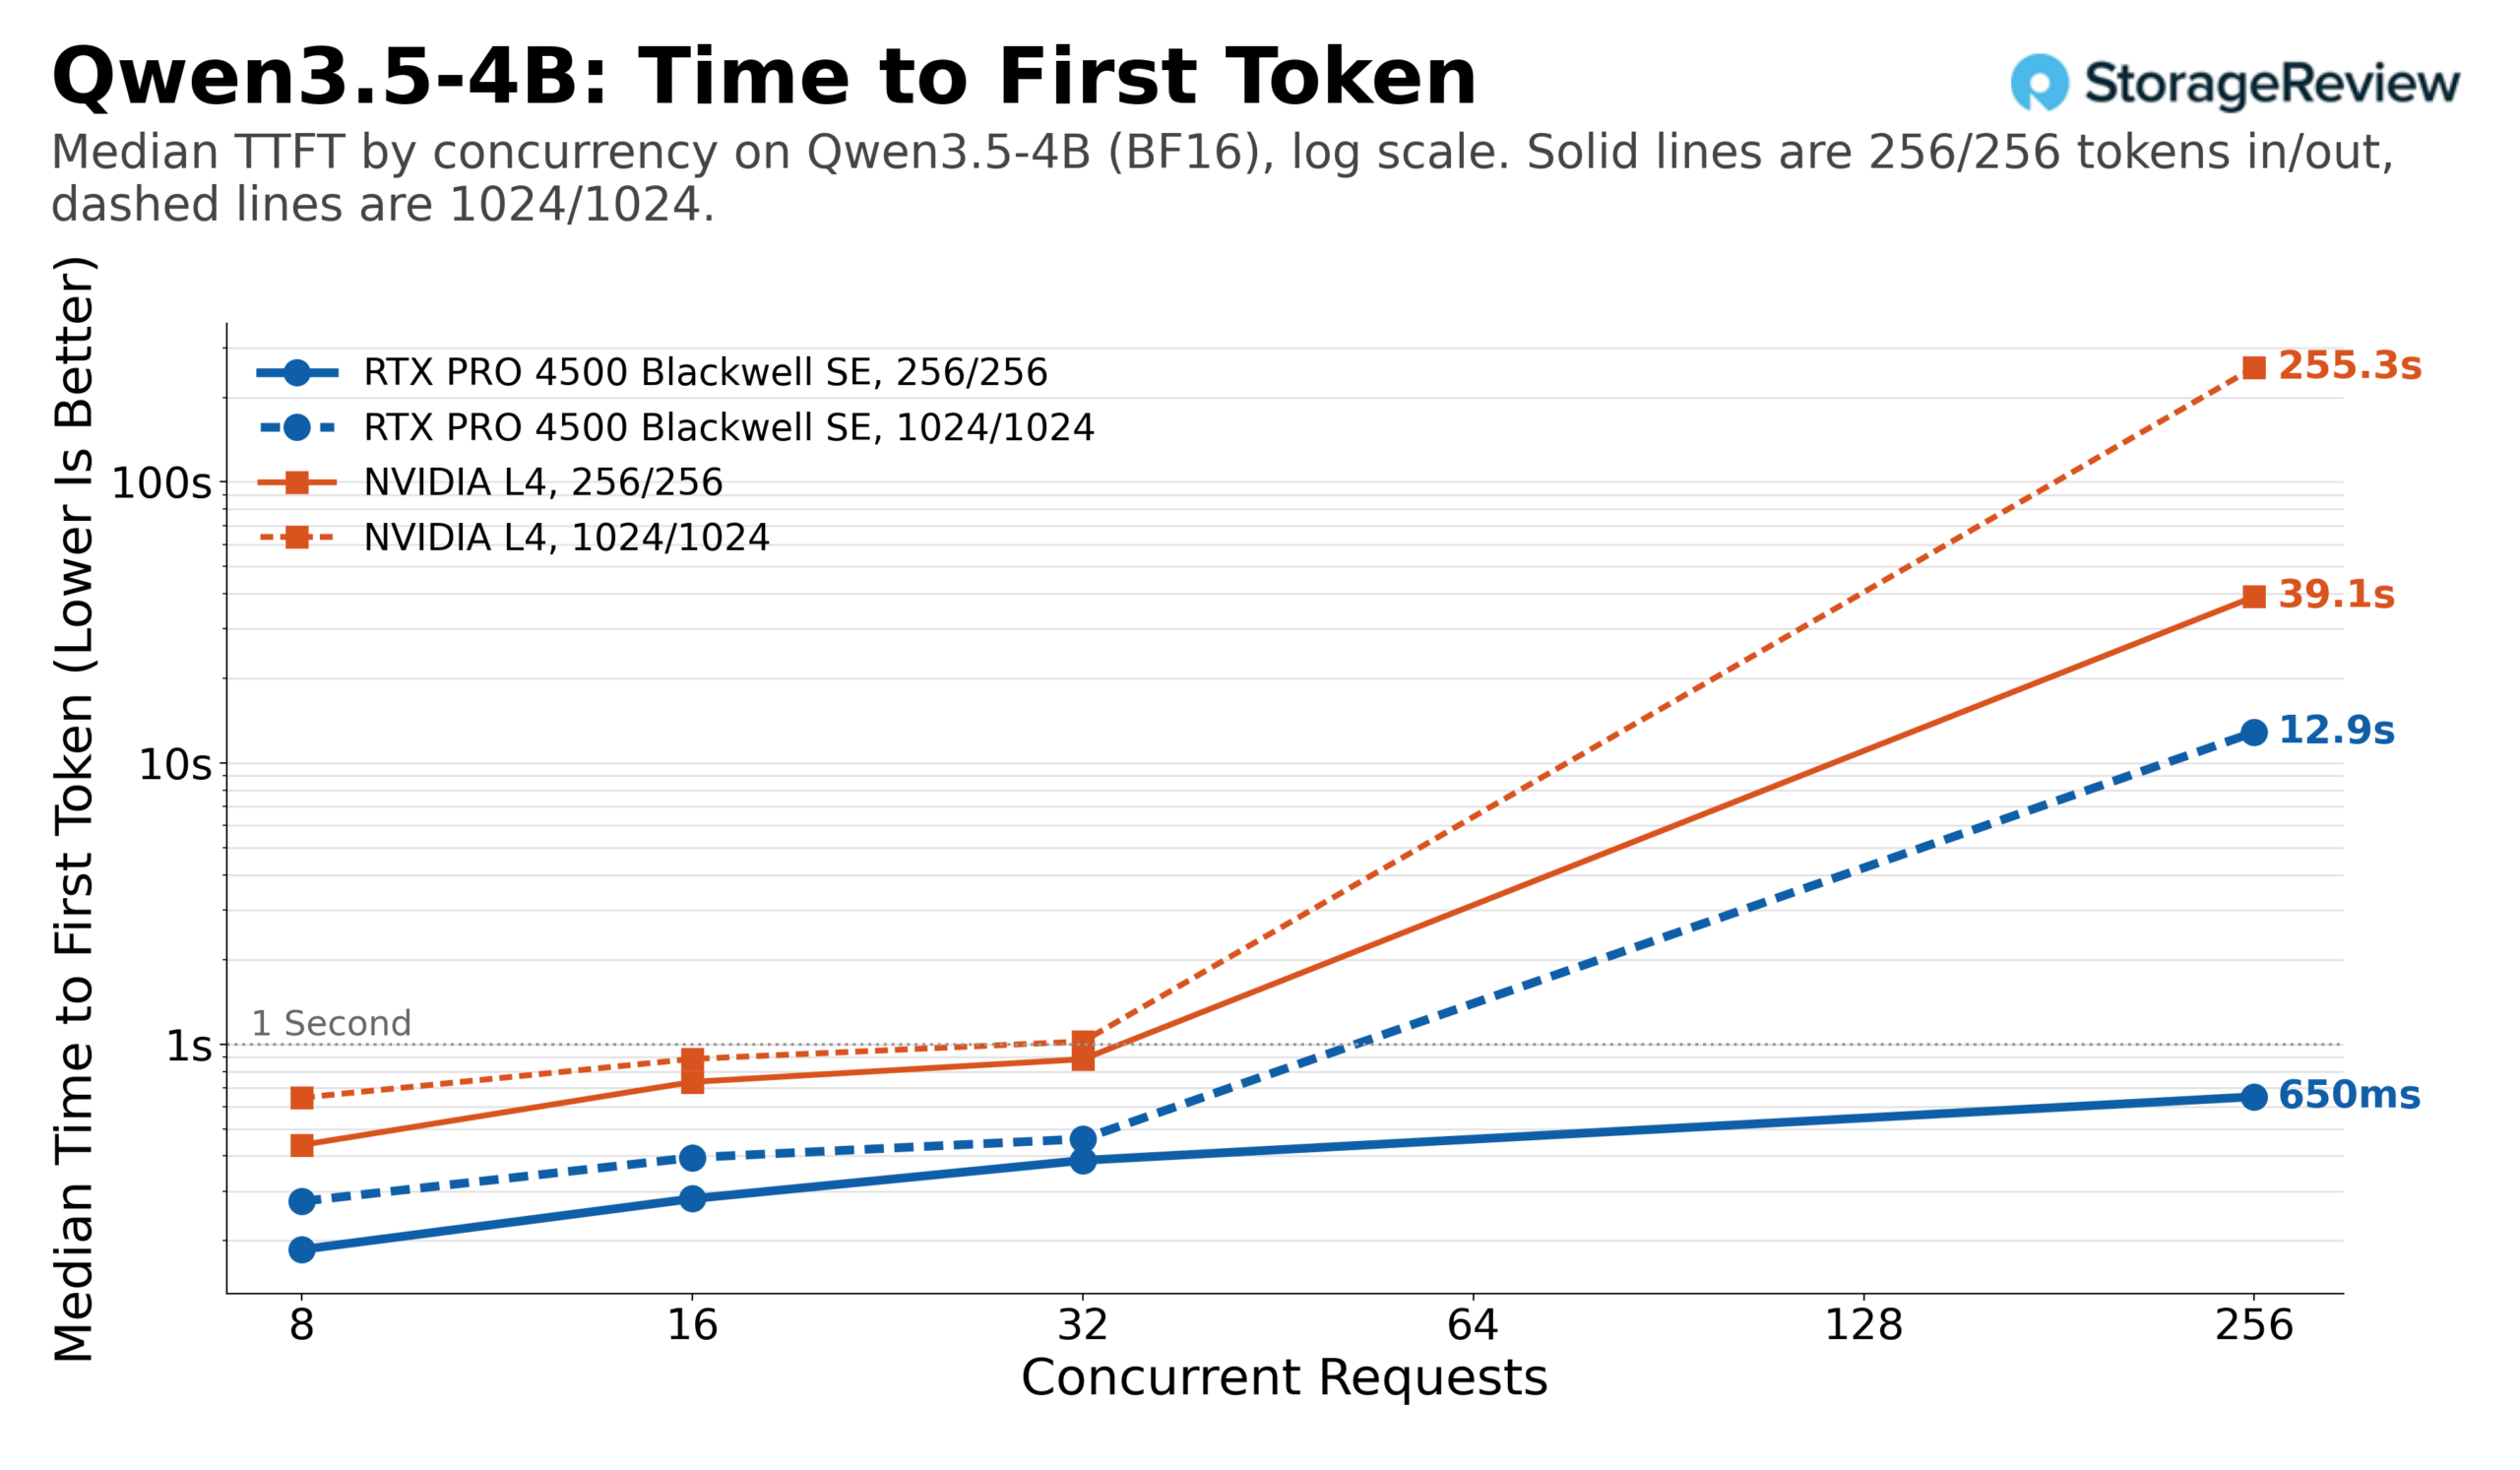
Sotto carico, il divario di latenza si allarga: con 32 concorrenti sulla configurazione 256/256, il tempo mediano per il primo token dell'L4 era di 884 ms e quello del 4500 era di 386 ms. Con 256 concorrenti, l'L4 è arrivato a 39 secondi, mentre il 4500 si è mantenuto a 650 ms. Su 1,024/1,024, l'L4 era già oltre un secondo con 32 concorrenti (1,022 ms) e ha raggiunto i 255 secondi a 256, che corrisponde a una richiesta in coda in vLLM per quattro minuti in attesa che la cache KV si liberi. Il 4500 ha superato la linea di un secondo su quella configurazione solo a 256 concorrenti, a 12.9 secondi. Nel grafico sottostante, le linee dell'L4 escono dall'area del grafico tra 32 e 256; I 4500 rimangono sotto il secondo sul tracciato più corto per tutta la durata del giro.
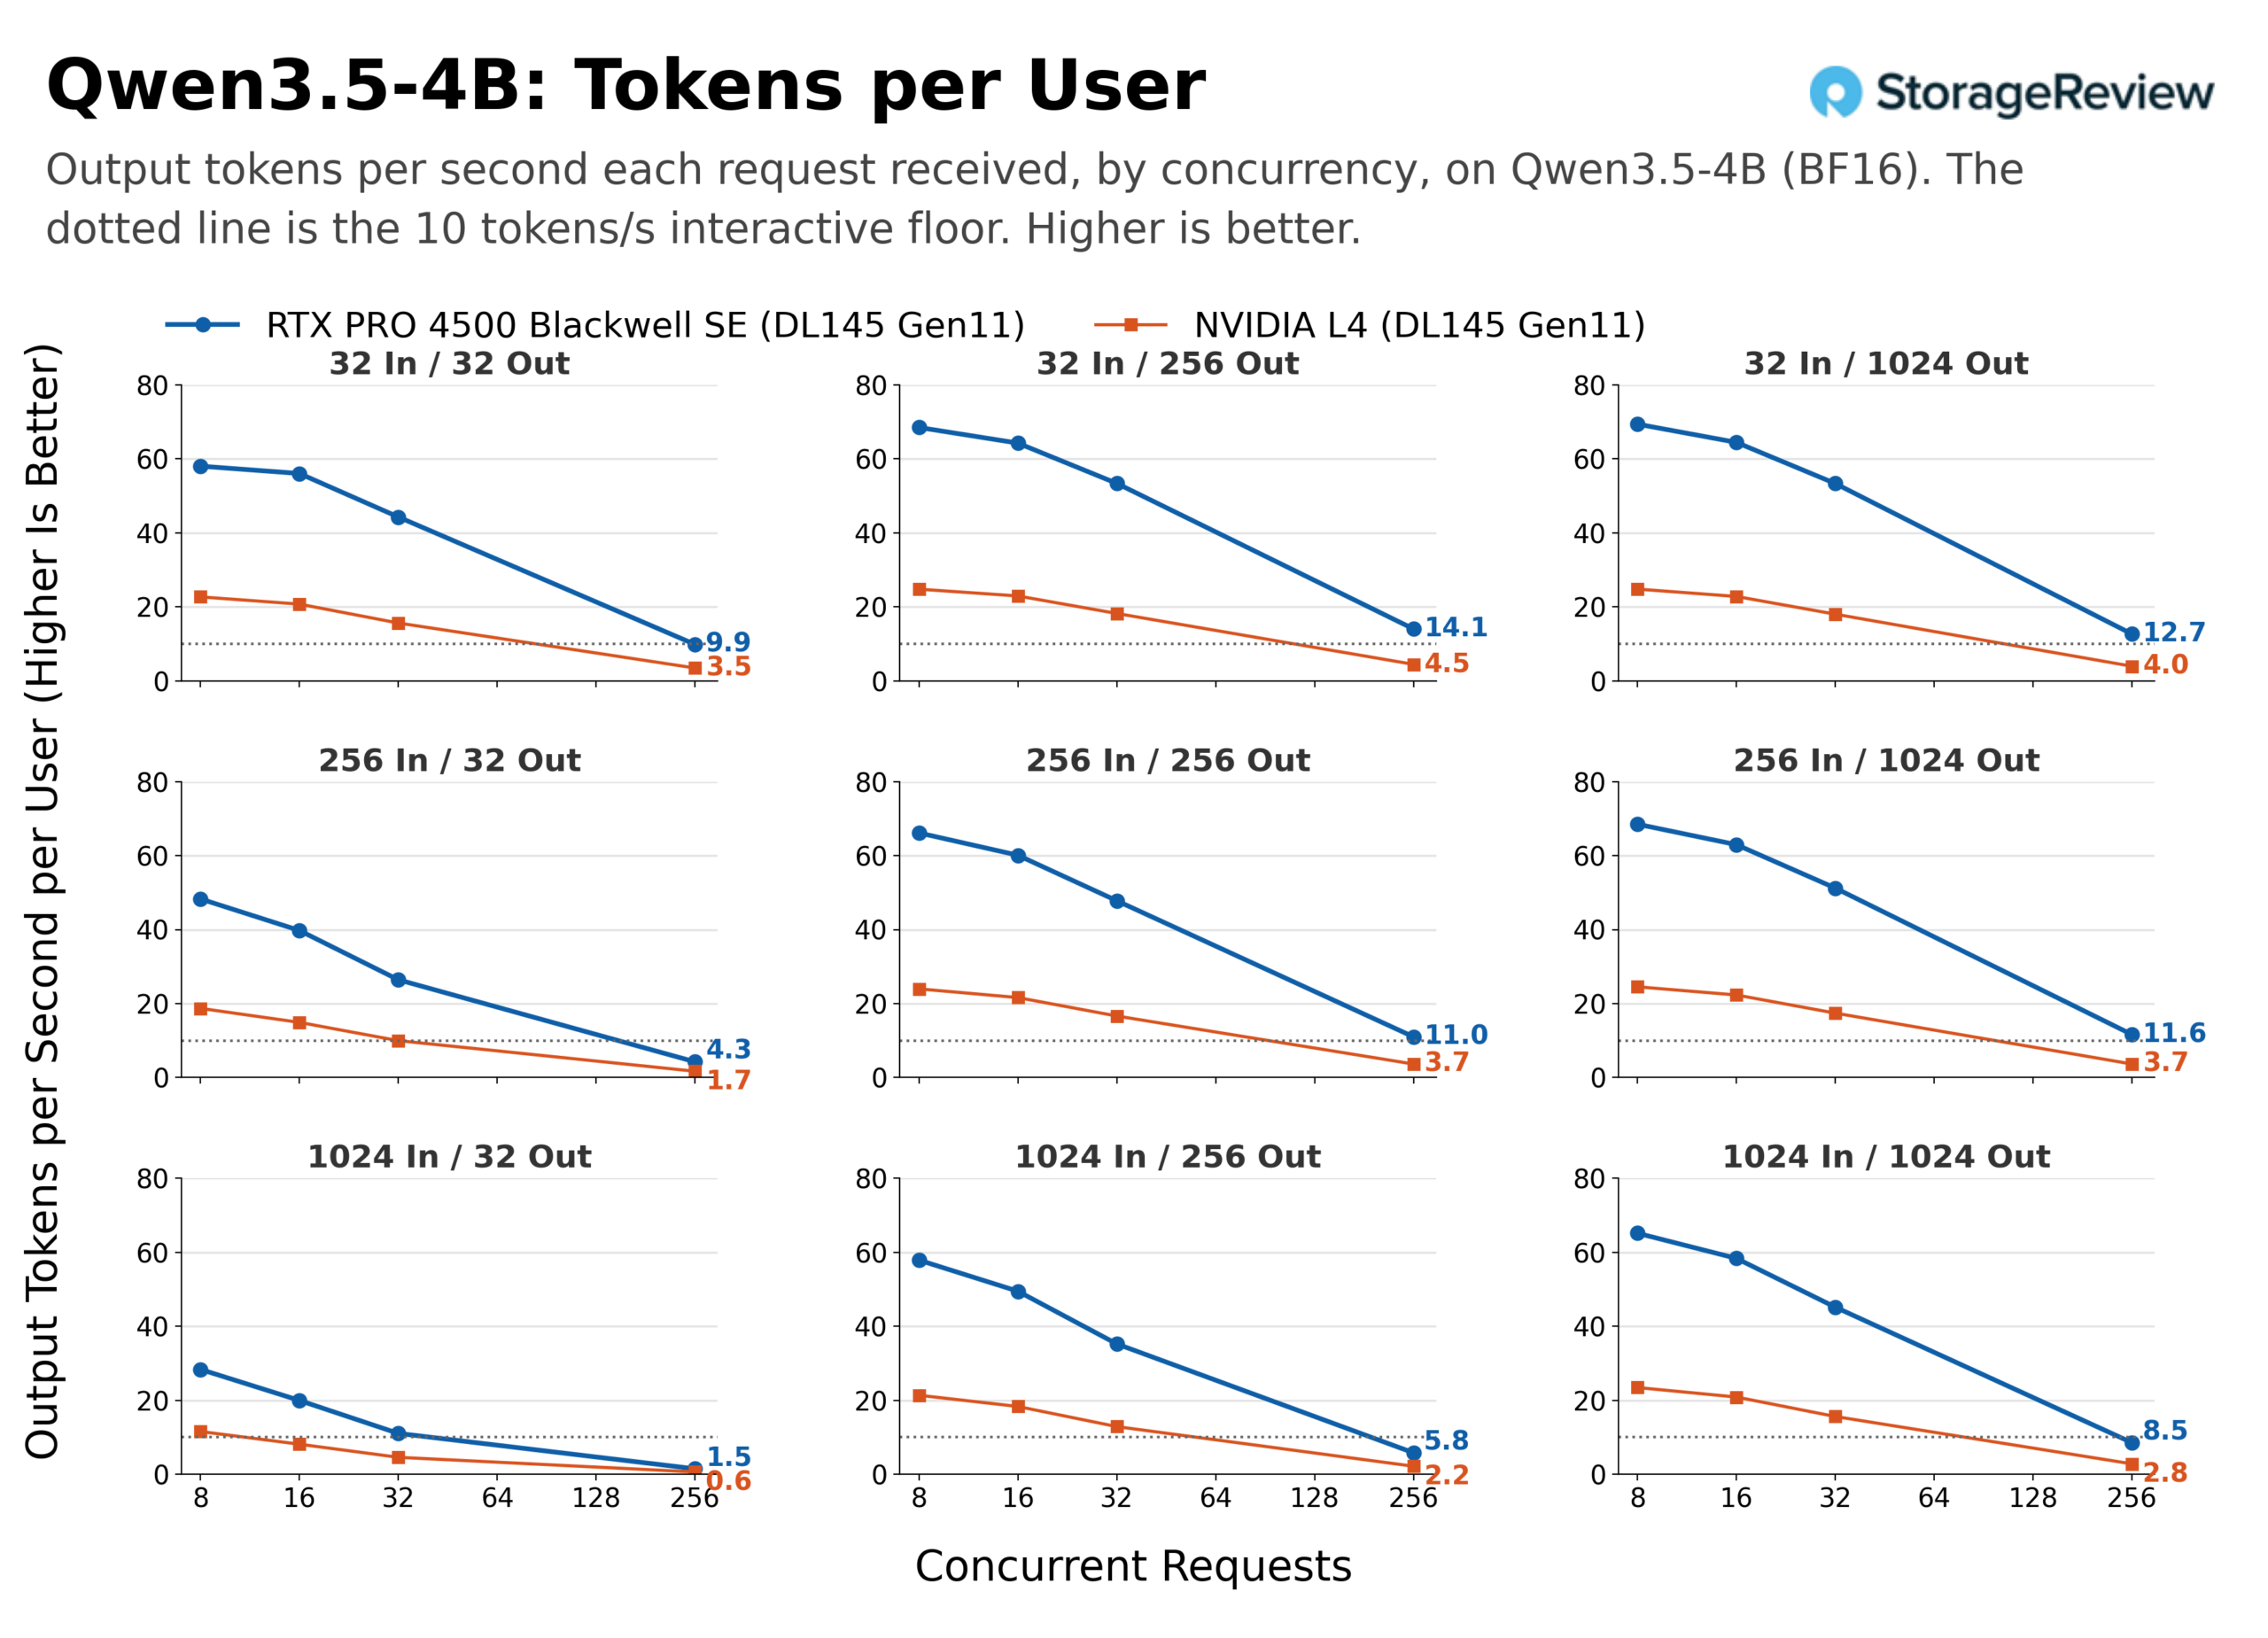
Un altro modo per leggere gli stessi dati è per utente: token di output al secondo divisi per il numero di richieste simultanee, ovvero la velocità che ogni persona in coda vede, rappresentata nella griglia sottostante per ogni configurazione rispetto a una soglia minima di 10 token al secondo che funge da soglia comune per l'uso interattivo. Con 32 richieste simultanee, il 4500 fornisce da 44 a 53 token al secondo per utente su ogni configurazione tranne 1,024 in ingresso, 32 in uscita, dove è 11, mentre l'L4 si attesta tra 10 e 18 ed è già sceso a 4.6 su quella stessa configurazione. A 256 concorrenti, il 4500 rimane sopra il pavimento nelle quattro combinazioni a forma di chat (14.1 su 32/256, 12.7 su 32/1,024, 11.0 su 256/256 e 11.6 su 256/1,024), lo raggiunge a 9.9 su 32/32 e scende al di sotto di esso nei prompt da 1,024 token e nelle forme a risposta breve, fino a 1.5 su 1,024/32 dove quasi tutto il lavoro è precompilato. L'L4 è sotto il pavimento in ogni forma a 256, tra 0.6 e 4.5. Non è stato testato nulla tra 32 e 256, quindi il punto in cui ogni linea attraversa il pavimento tratteggiato si trova da qualche parte tra queste due concorrenti; Ciò che mostra il grafico è che l'incrocio dell'L4 avviene ben prima di 256 su ogni forma, e quello del 4500 avviene a 256 o vicino ad esso sulle forme del chat.
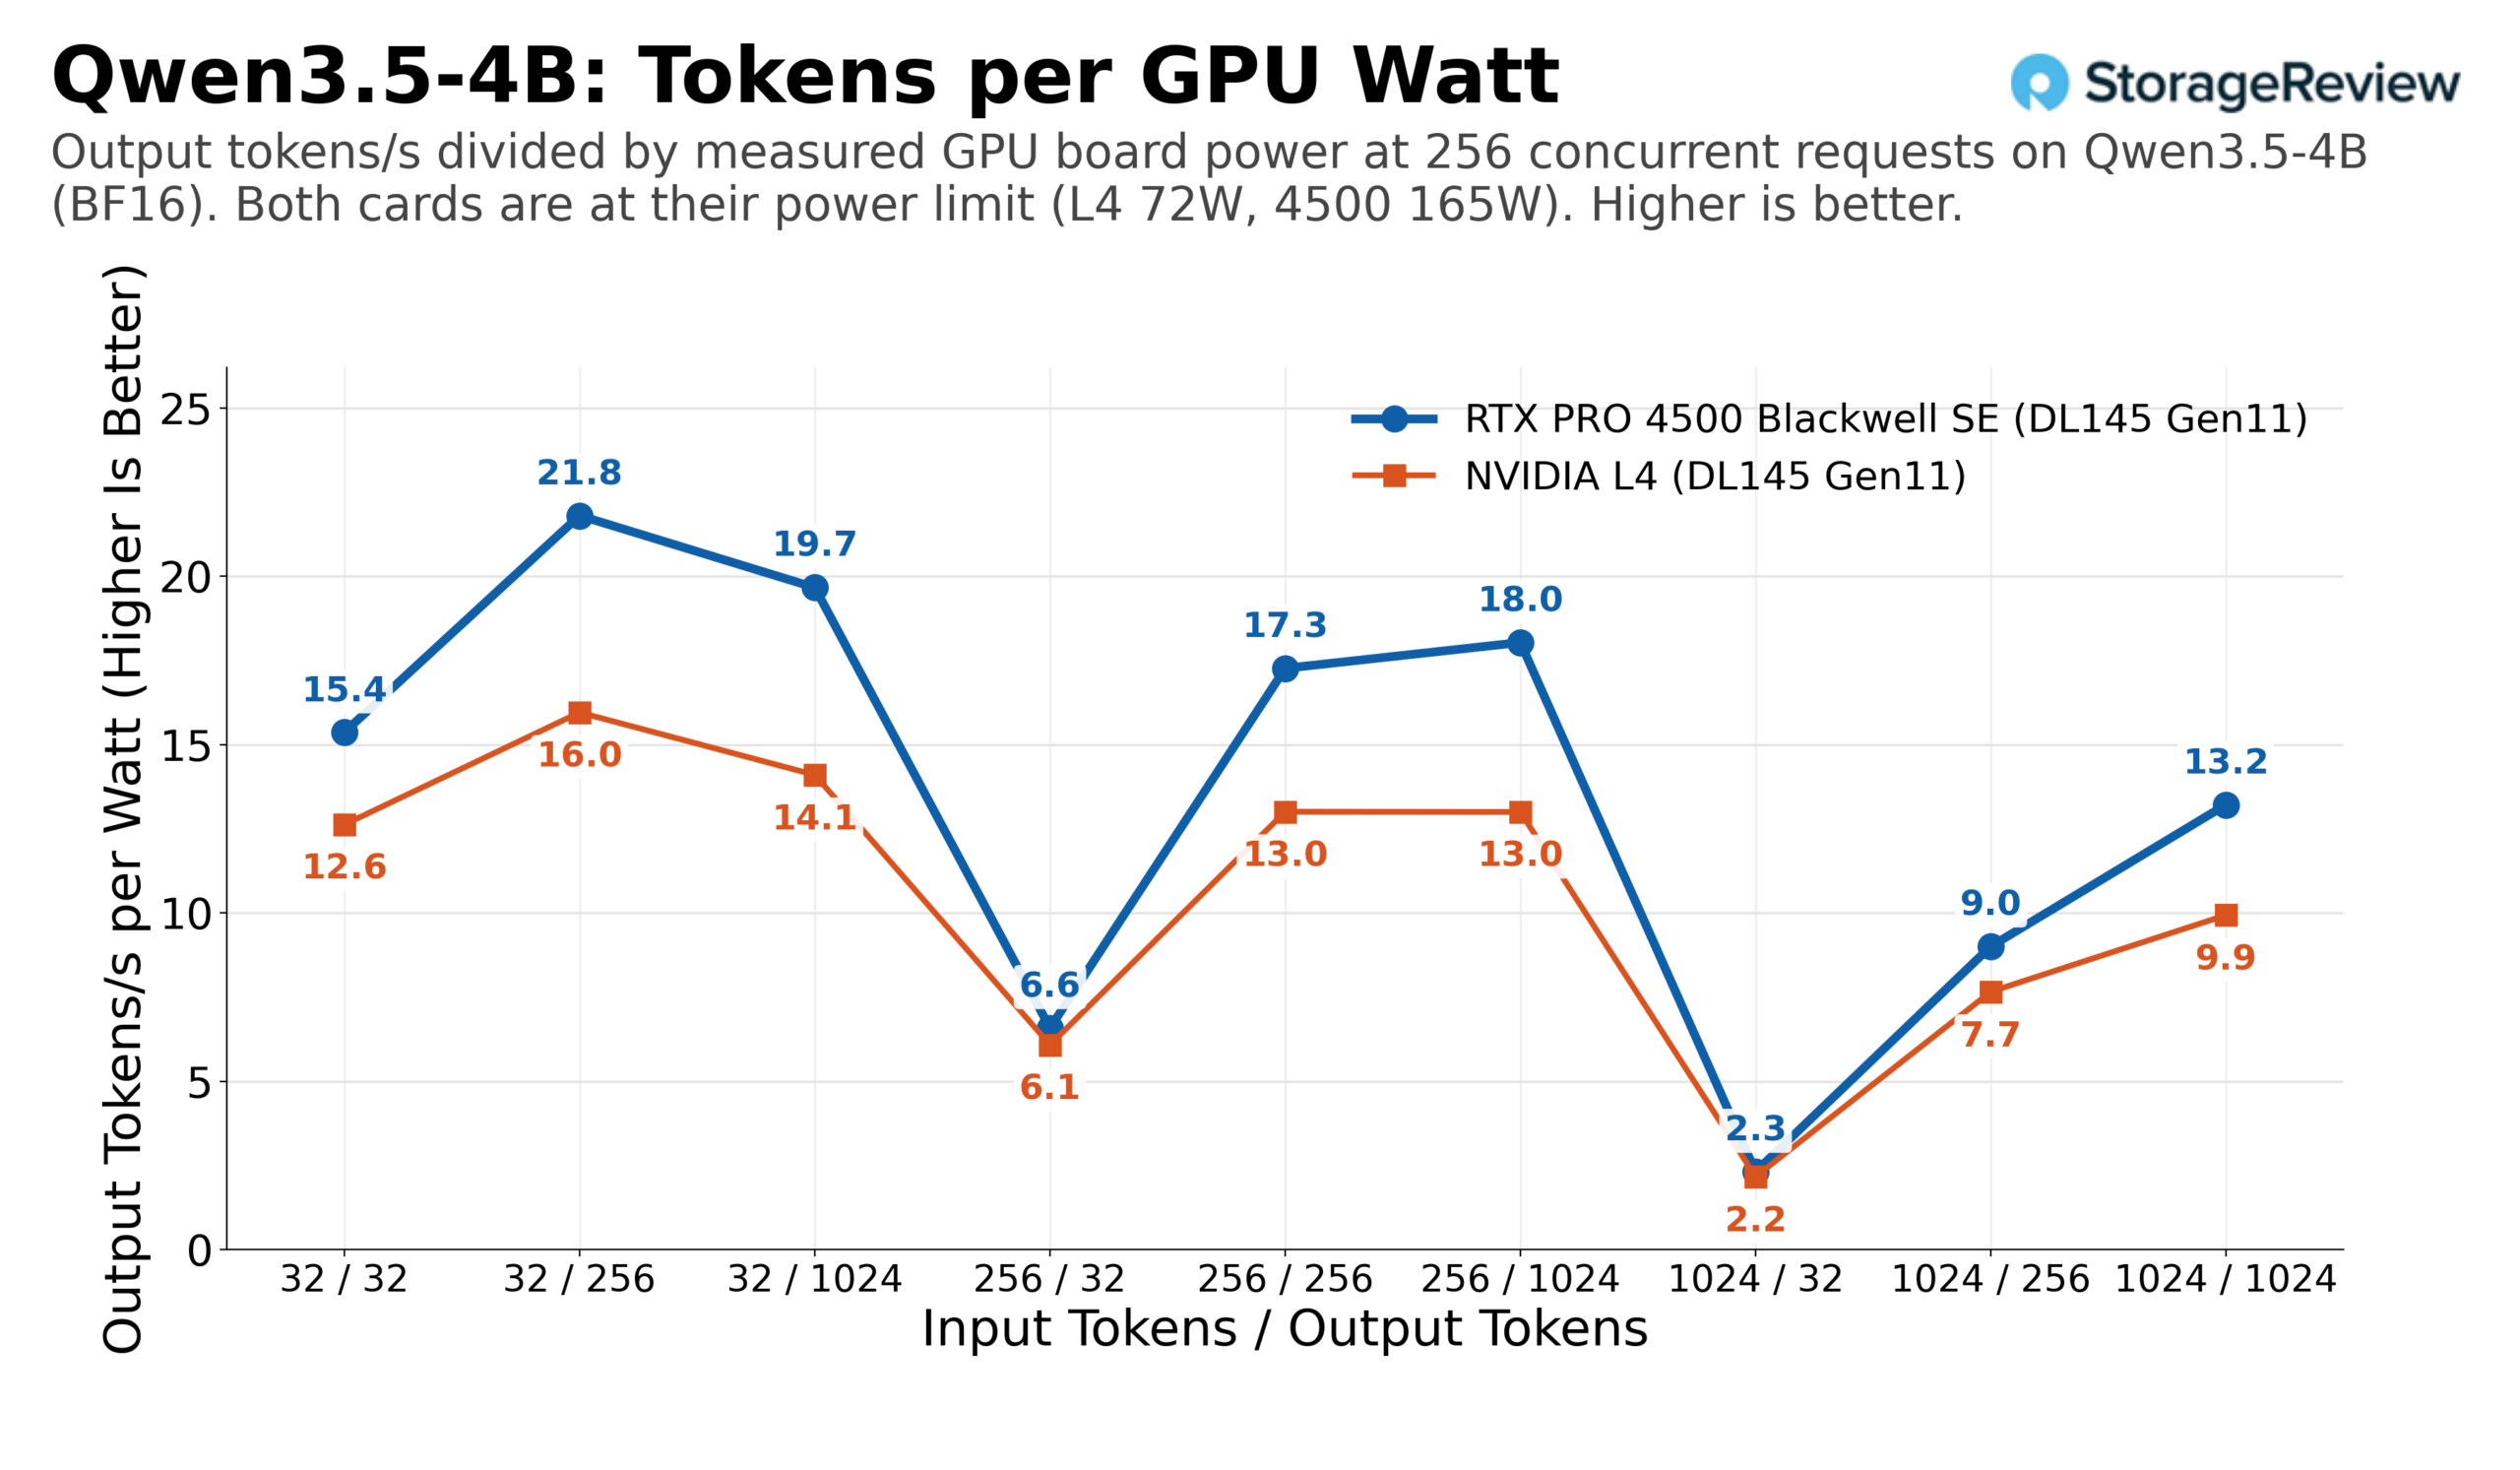
Entrambe le schede hanno funzionato al limite di potenza della scheda madre, 72 W per la L4 e 165 W per la 4500, sulla maggior parte delle configurazioni a partire da 16 concorrenti. Le configurazioni a basso output hanno funzionato a un consumo inferiore, come 125 W sulla 4500 per Qwen3.5-4B 32/32 a 32 concorrenti, quindi i token per watt della GPU seguono da vicino il throughput. A 256 concorrenti, la 4500 ha prodotto una media di 1.33 volte i token per watt della L4 nelle nove configurazioni, da 1.07x nel caso 1,024/32 con prefill-bound a 1.39x su 256/1,024. Moltiplicando questo valore per la differenza di potenza di 2.3x, si ottiene il vantaggio di throughput di 3 volte, con l'1.33x dovuto al fatto che Blackwell fa di più per watt e il 2.3x dovuto al fatto che la 4500 spende più watt.
Gemma 4 E4B
Gemma 4 E4B è il membro più piccolo della famiglia Gemma 4 di Google, dove la E sta per parametri effettivi 4B, e si comporta come Qwen3.5-4B su entrambe le schede con una scalabilità leggermente migliore nella parte alta della griglia. Il rapporto di throughput mediano da 8 a 32 simultanei è di 2.67x (intervallo da 2.31x a 3.07x), e a 256 è di 3.20x, con la configurazione 1,024/1,024 che raggiunge 3.82x perché la cache L4 è così vicina al limite della sua cache KV.
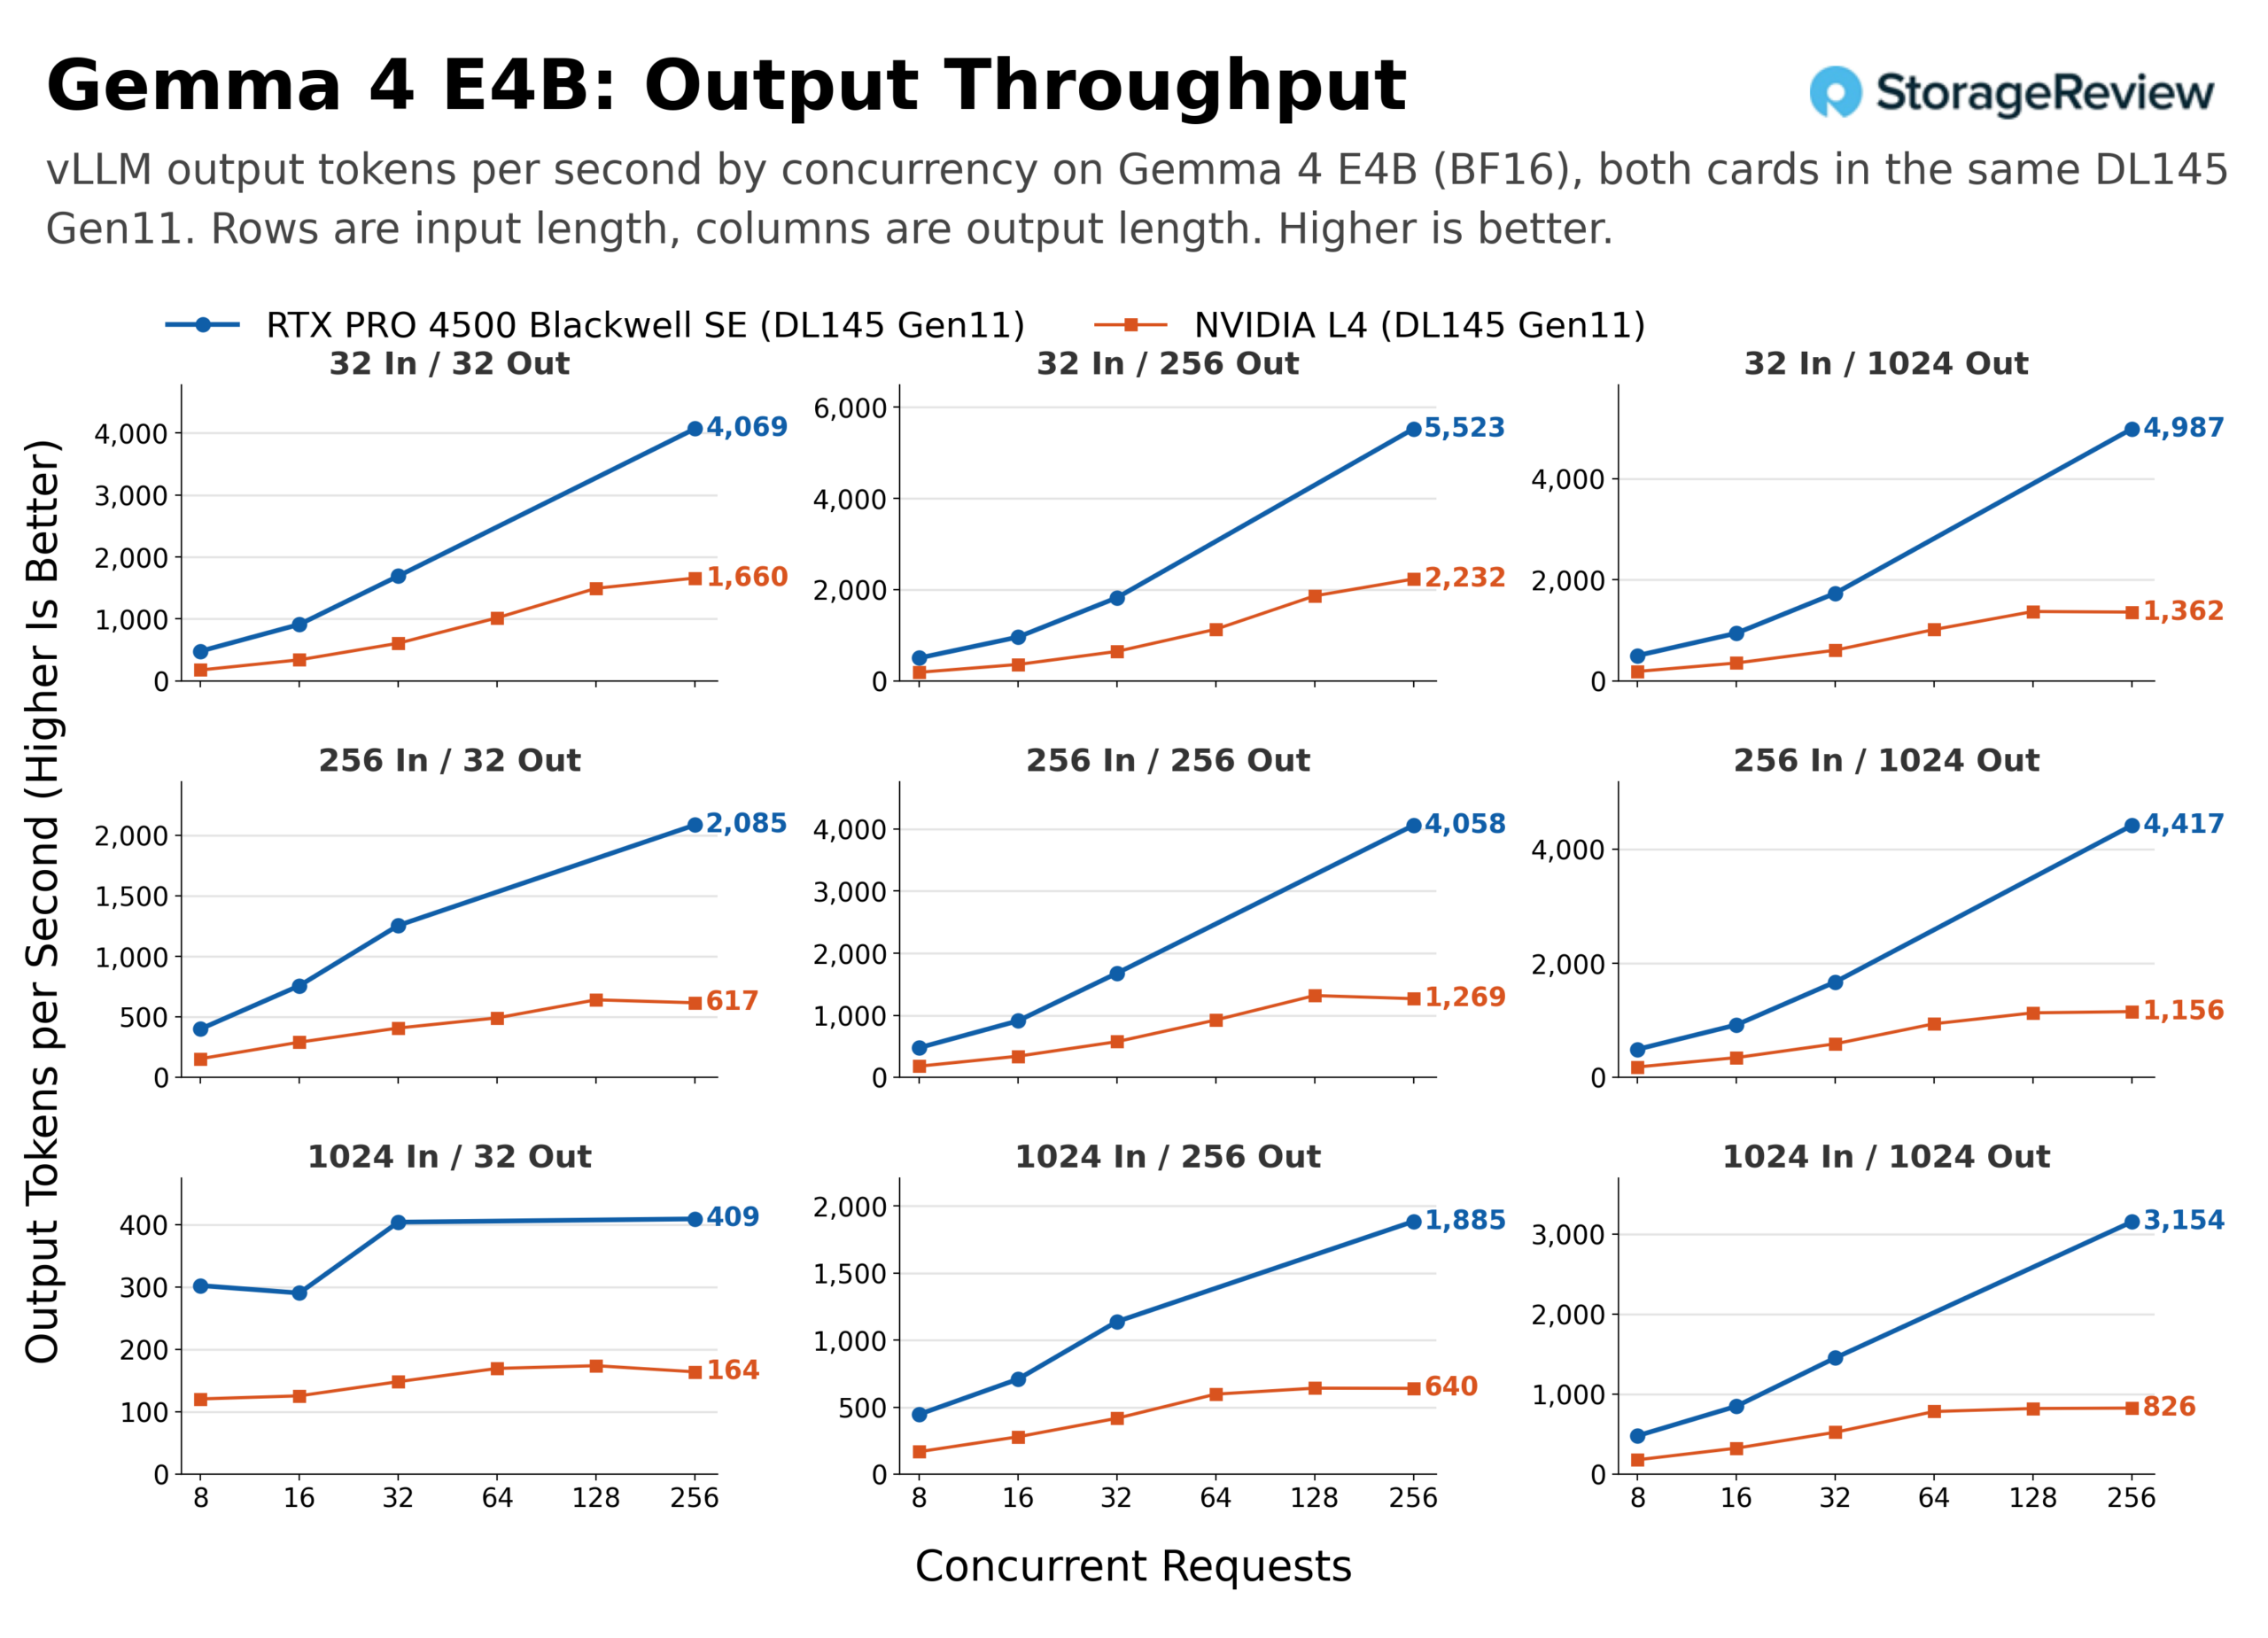
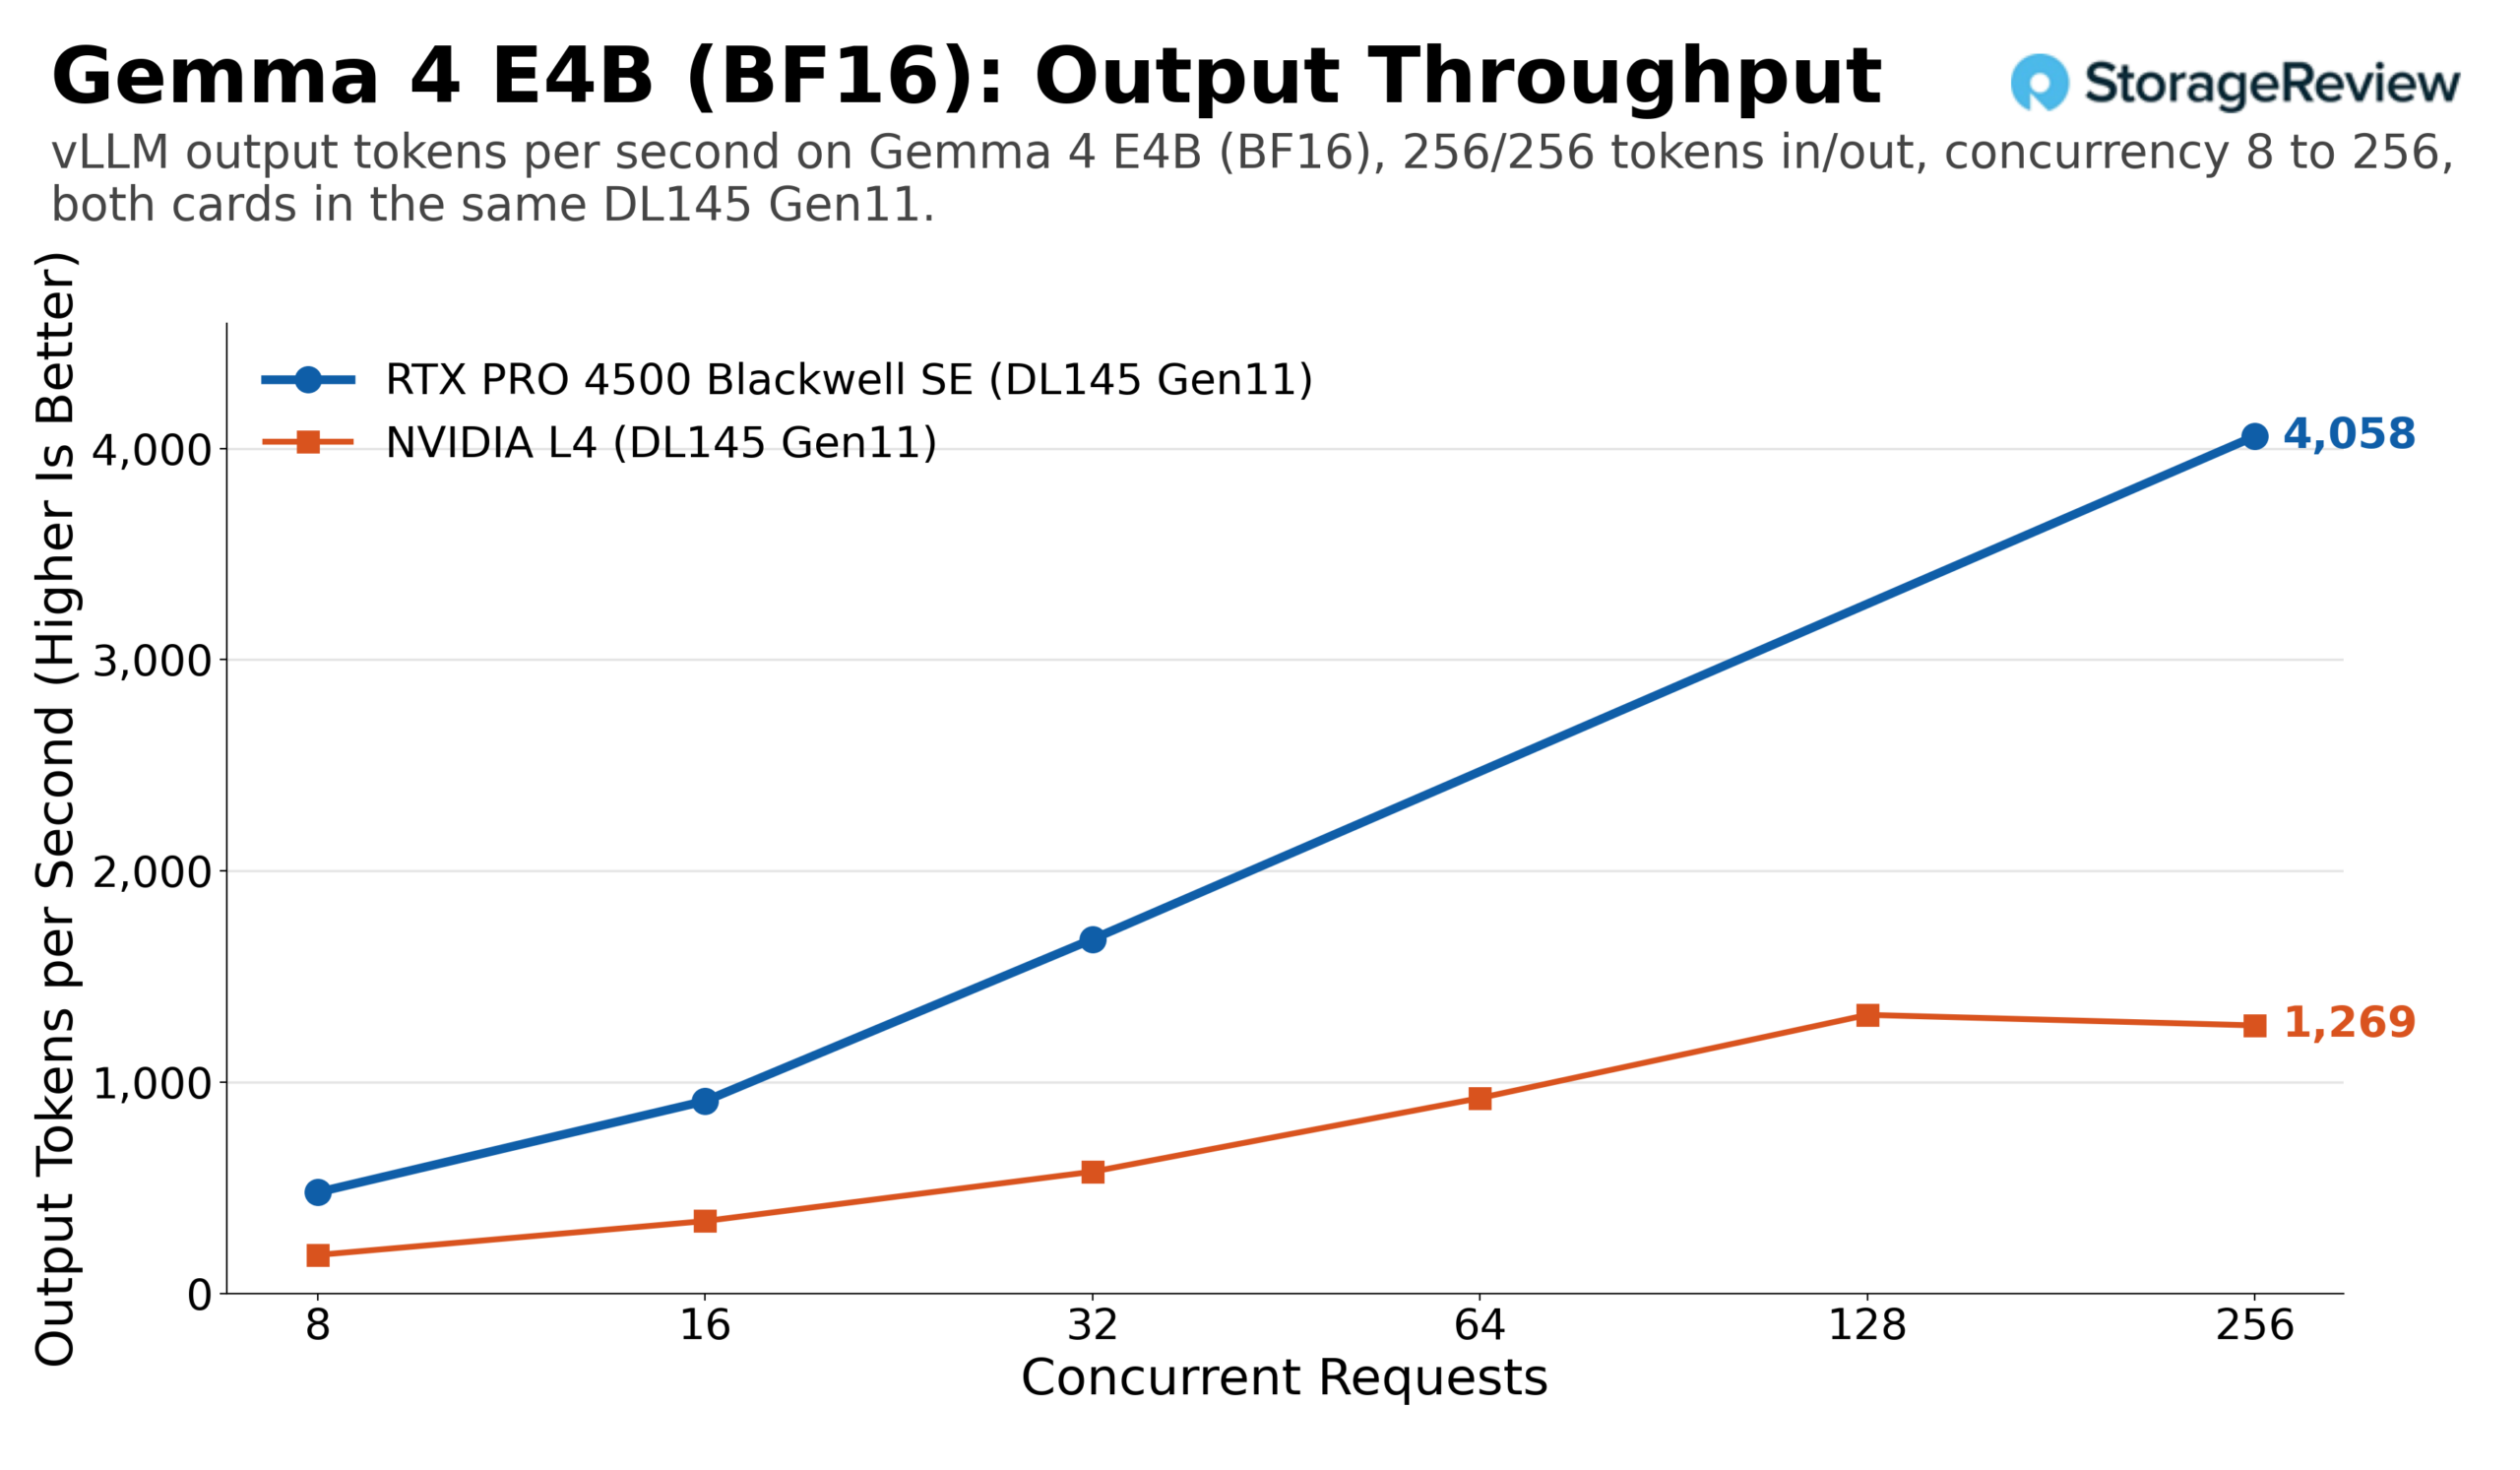
Sulla configurazione 256/256, l'L4 ha prodotto 183 token di output al secondo con 8 concorrenti, 577 con 32 e 1,269 con 256; il 4500 ne ha prodotti 479, 1,678 e 4,058. Sulla configurazione 1,024/1,024, l'L4 ha raggiunto 180, 524 e 826, mentre il 4500 ha raggiunto 480, 1,454 e 3,154. Il valore del 4500 con 256 concorrenti sulla configurazione lunga è 3.8 volte superiore a quello dell'L4, e la ragione è visibile nella curva dell'L4: ha aggiunto solo 302 token al secondo passando da 32 a 256 concorrenti, perché non aveva più memoria disponibile per aggiungere sessioni.
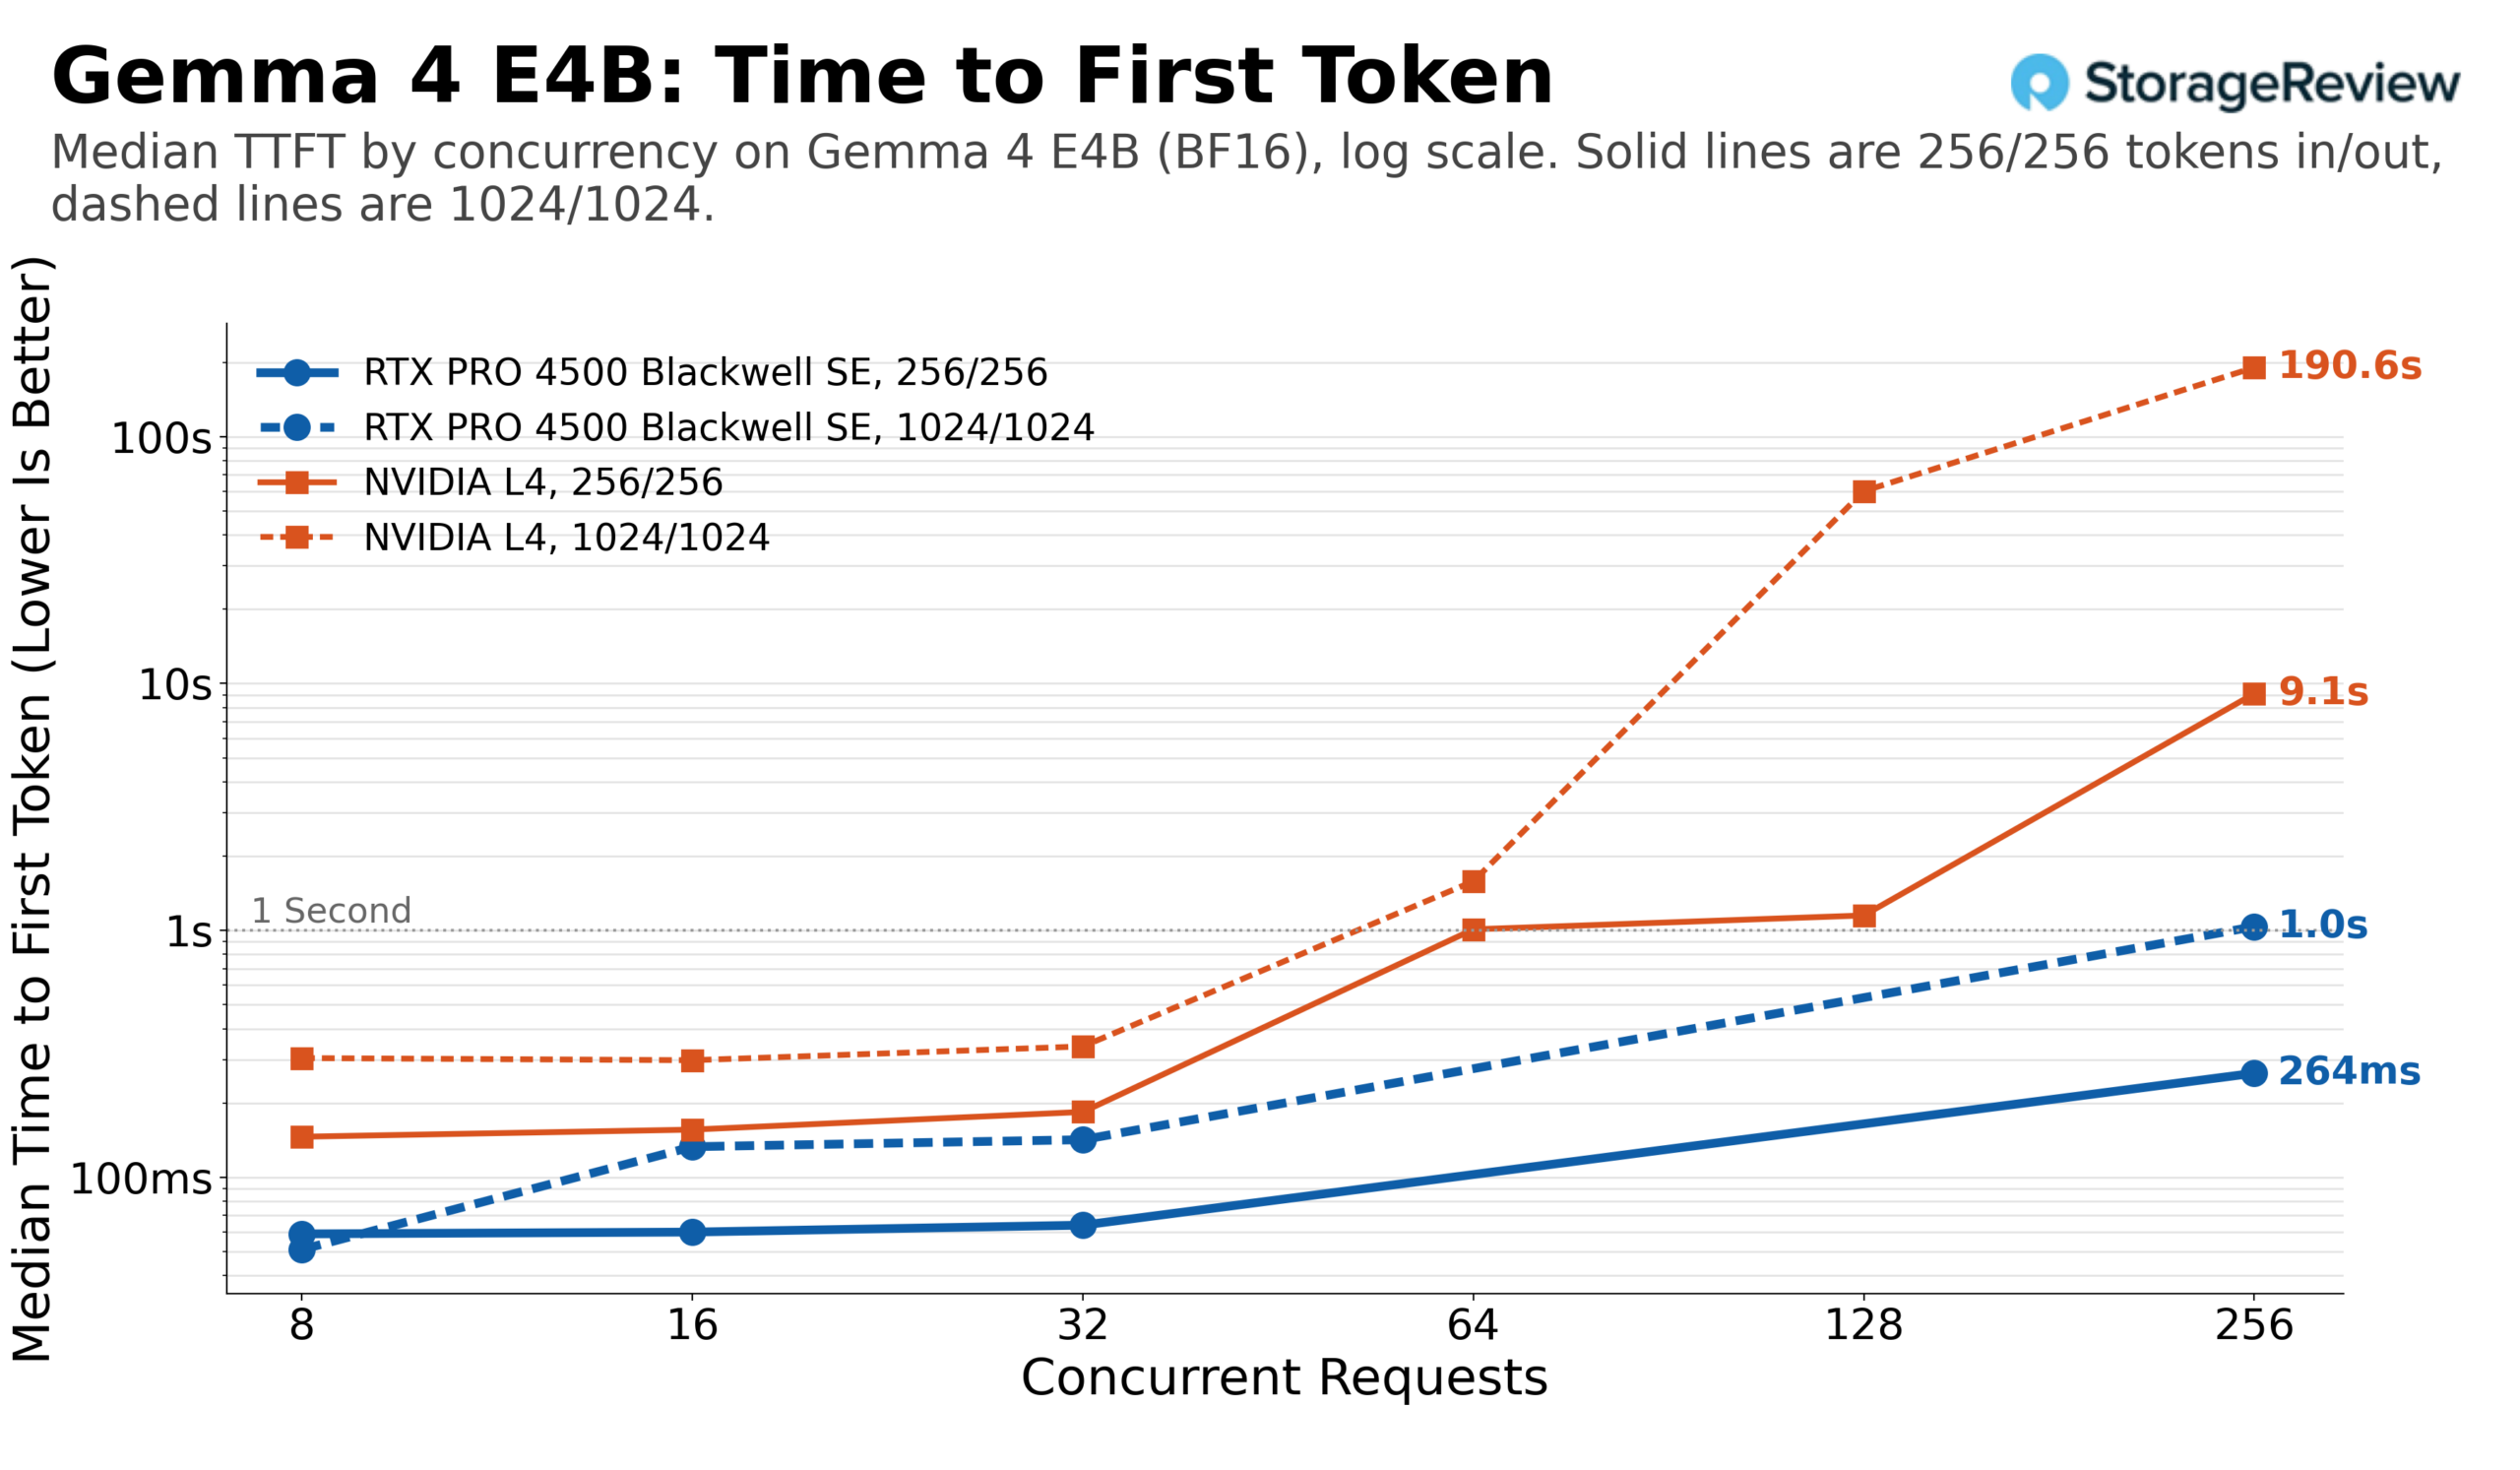
Poiché il job Gemma 4 dell'L4 includeva 64 e 128 processi simultanei, questo modello mostra esattamente dove l'L4 cede. Il suo tempo mediano al primo token sulla forma 256/256 era di 184 ms a 32 processi simultanei, poco più di un secondo a 64 e 9.1 secondi a 256. Su 1,024/1,024, era di 339 ms a 32, oltre un secondo a 64, 60 secondi a 128 e 191 secondi a 256. Il 4500 è rimasto a 64 ms a 32 processi simultanei e 264 ms a 256 sulla forma più corta, e sulla forma più lunga era di 142 ms a 32 e ha superato un secondo solo a 256, a 1,036 ms. Quindi, per Gemma 4 E4B con prompt di lunghezza chat, la L4 in questo server è una scheda da 32 a 64 sessioni e la 4500 è una scheda da 256 sessioni con latenza in abbondanza.
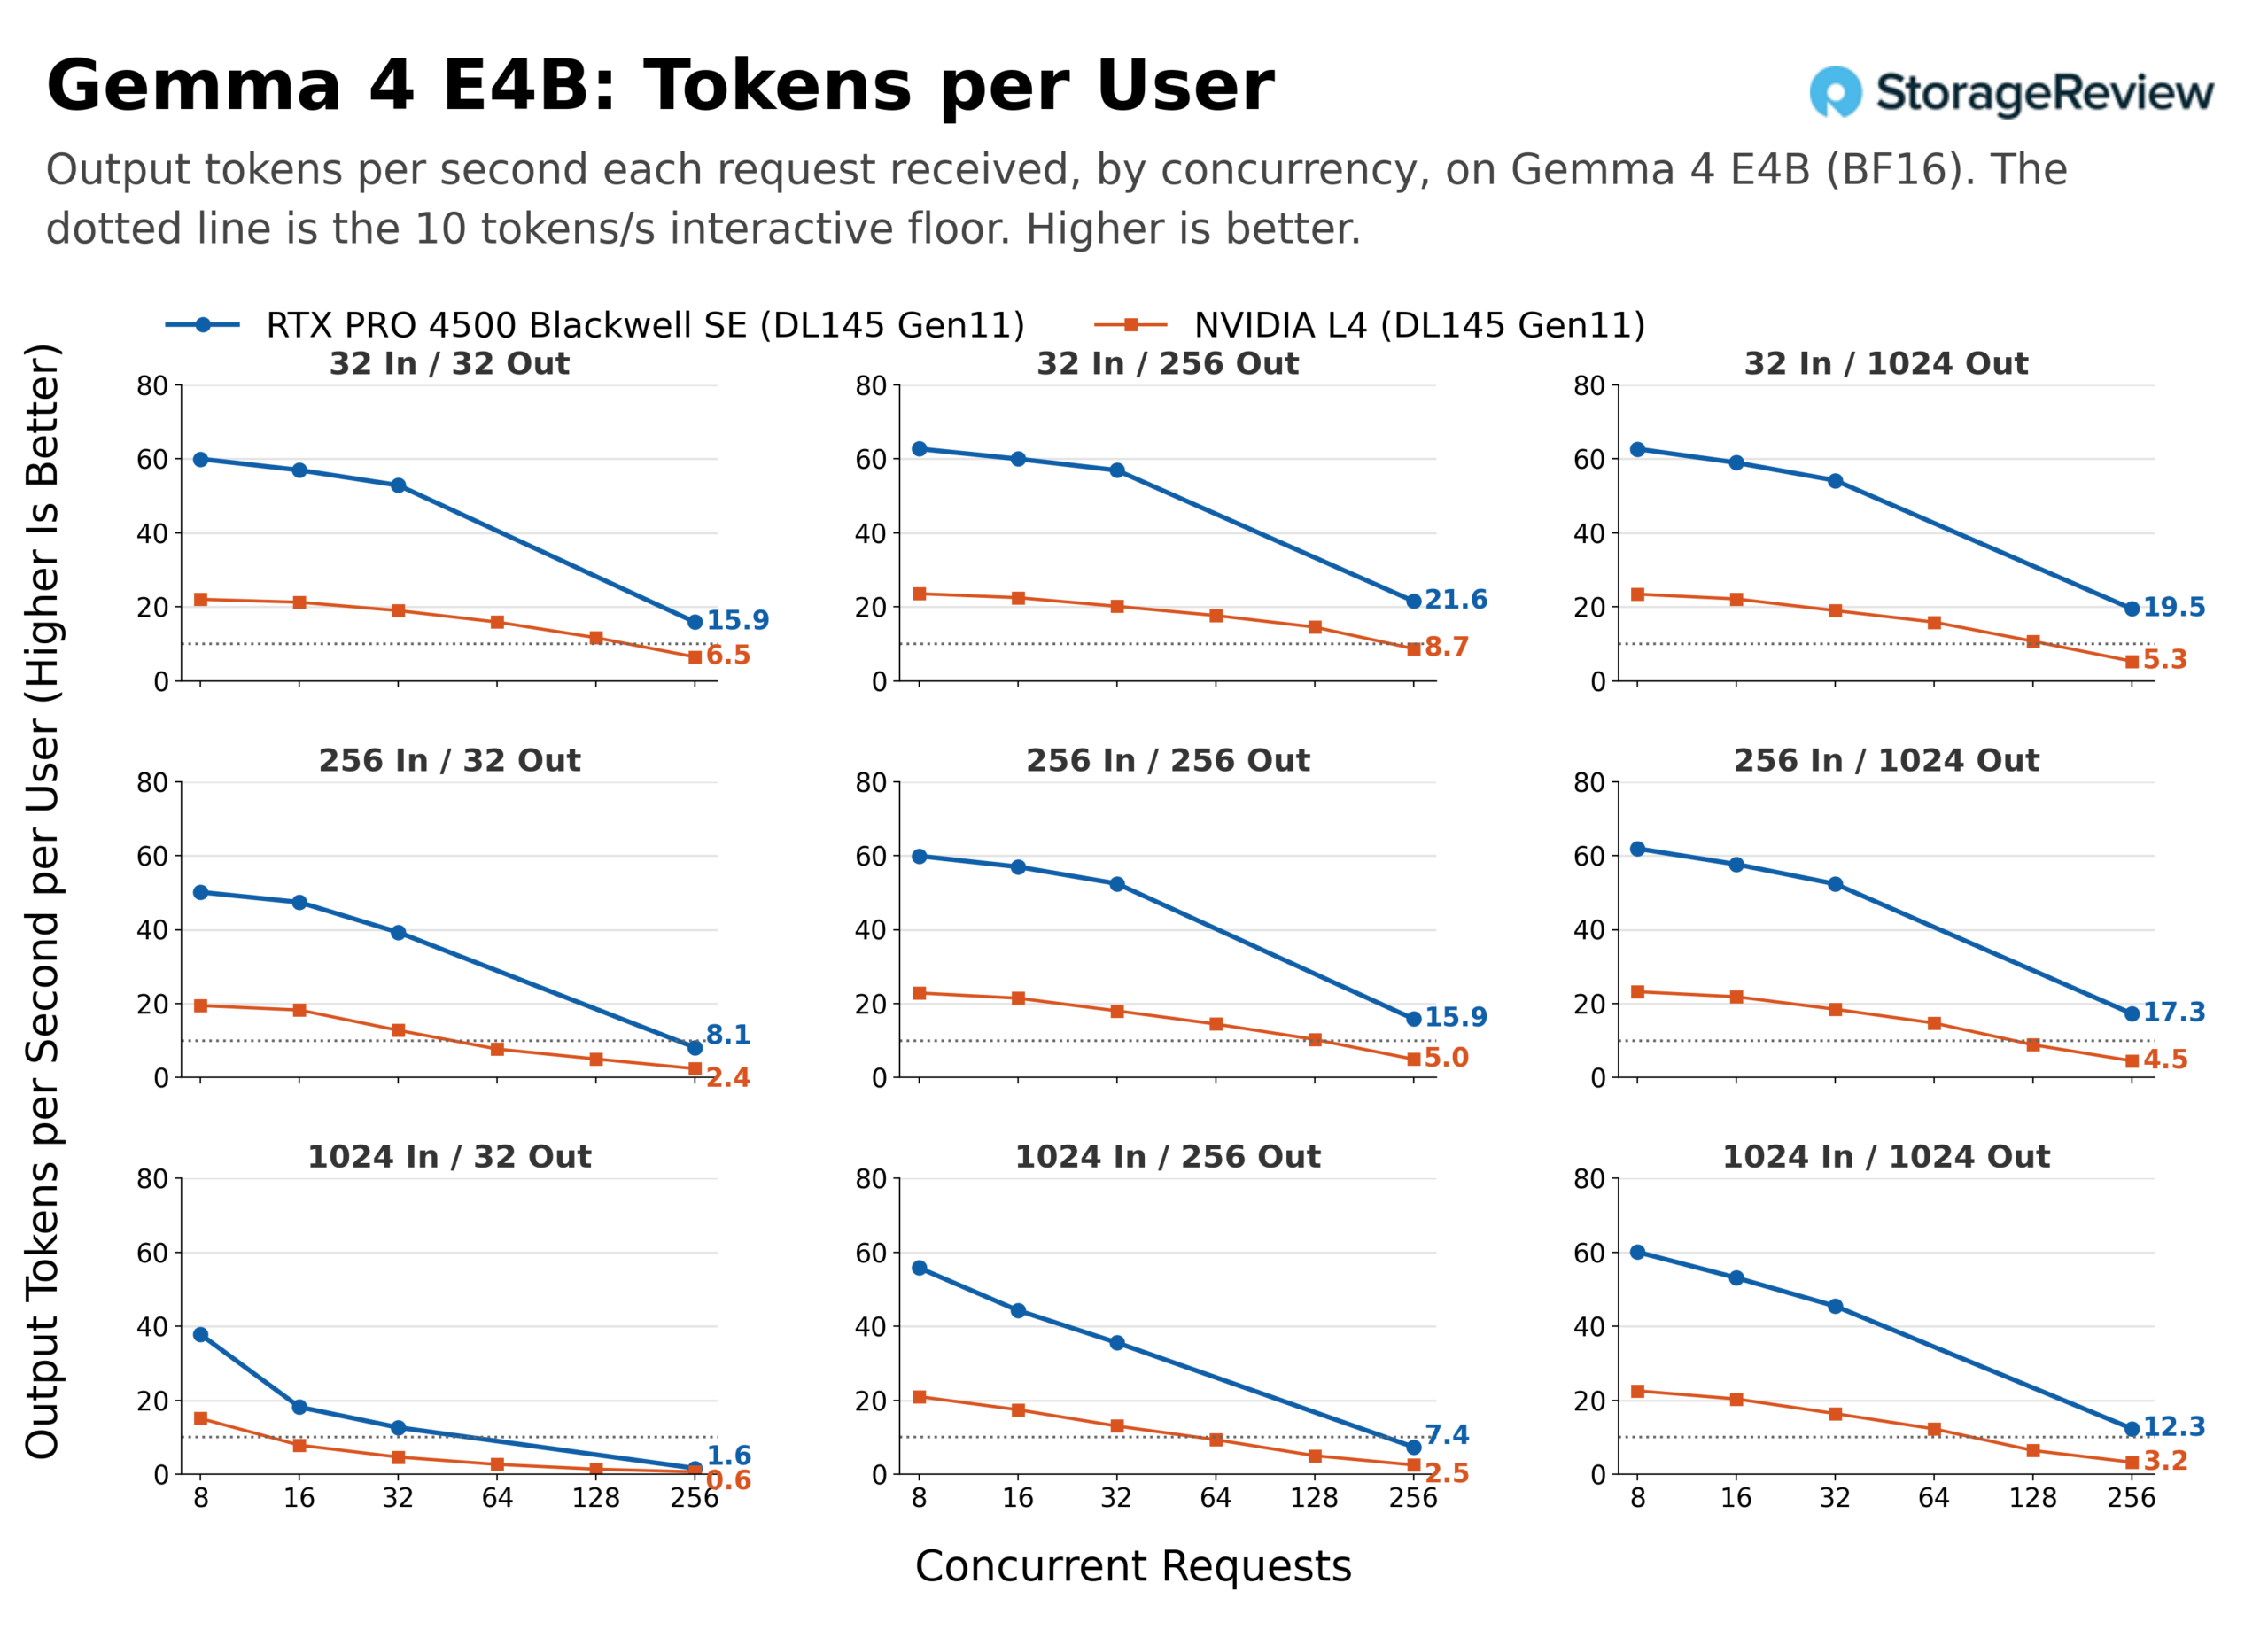
La vista per utente, con i punti 64 e 128 dell'L4 riempiti, mostra dove attraversa il pavimento. Su 256/256, l'L4 fornisce 18.0 token al secondo per utente con 32 concorrenti, 14.5 a 64, 10.3 a 128 e 5.0 a 256, quindi attraversa il pavimento di 10 token al secondo tra 128 e 256 su quella forma. Su 256/1,024 è a 8.9 a 128, e sulle forme di risposta breve e 1,024 input è sotto il pavimento a 64 (7.7 su 256/32, 9.3 su 1,024/256). Il 4500 si attesta tra 52 e 57 per utente nelle forme di chat a 32 simultanei ed è ancora al di sopra del livello minimo a 256 in sei delle nove forme (da 15.9 a 21.6 nelle forme a 32 e 256 input diverse da 256/32 e 12.3 su 1,024/1,024), scendendo al di sotto solo nelle tre forme a risposta breve e prompt lungo (8.1 su 256/32, 7.4 su 1,024/256 e 1.6 su 1,024/32).
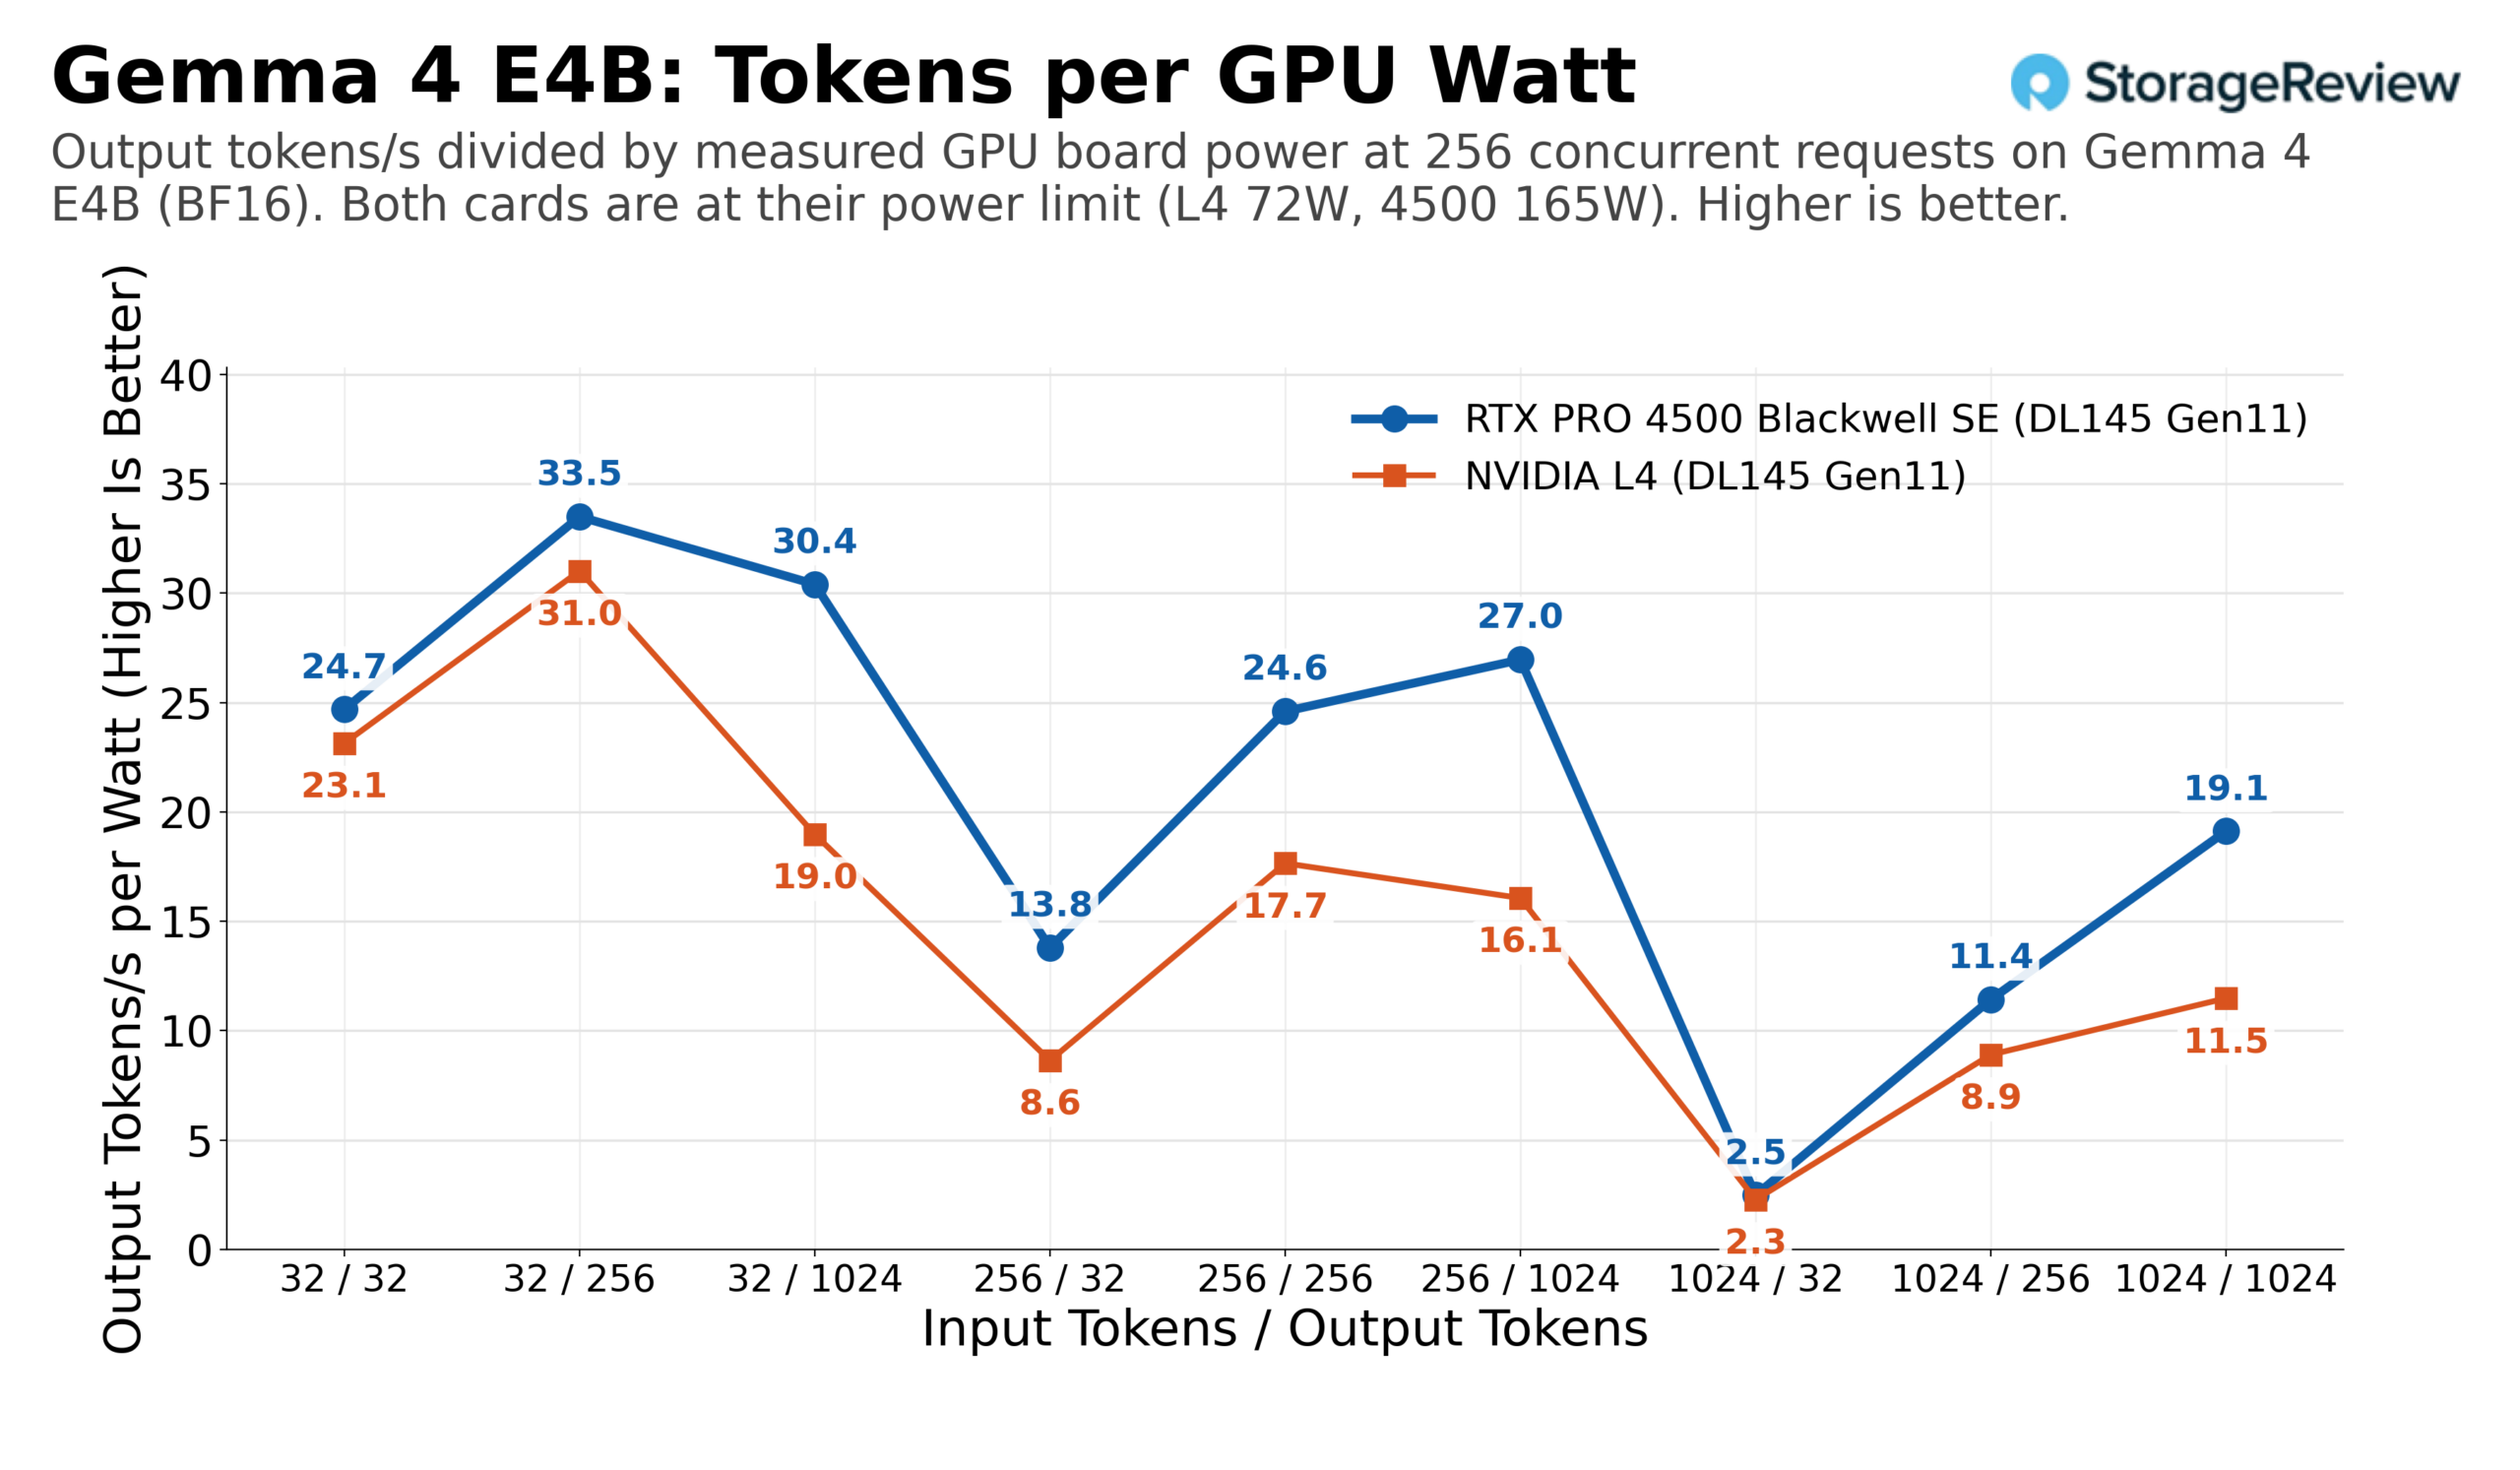
Per watt di GPU, Gemma 4 E4B offre alla 4500 una media di 1.39 volte la L4 a 256 token simultanei, con il margine più ampio, 1.68 volte, su 256/1,024 e 1.6 volte o migliore sulle altre forme di risposta lunghe in cui la L4 è a corto di cache KV, e il più ristretto, 1.07 volte, su 32/32 dove il carico di lavoro è troppo breve perché entrambe le schede possano sfruttarlo appieno. Su 256/256 si ottengono 24.6 token di output al secondo per watt contro 17.7.
La latenza per token per un singolo utente corrisponde a quella di Qwen: 14.1 ms per token sul 4500 contro 39.1 ms sull'L4 a 256/256, e 14.6 ms contro 39.8 ms a 1,024/1,024, quindi una risposta a 1,024 token richiede circa 15 secondi sul 4500 e 41 secondi sull'L4.
Potere al muro
I siti edge spesso hanno poca potenza a disposizione, quindi abbiamo monitorato il consumo totale del server tramite l'iLO del DL145 in ogni esecuzione. Con un carico leggero, in test con un singolo utente e la GPU che consumava da 43 a 65 W, il server si attestava intorno ai 160 W con entrambe le schede installate. Con 32 utenti simultanei sulla configurazione 256/256, il consumo medio era di 196 W con la L4 e di 301 W con la RTX PRO 4500, e questi valori medi si sono mantenuti costanti su entrambi i modelli BF16; il massimo registrato è stato di 209 W con la L4 e di 308 W con la 4500. Pertanto, l'aggiornamento comporta un costo di circa 105 W alla presa di corrente sotto carico, che è vicino alla differenza di 93 W nei valori nominali di potenza delle schede, più una piccola perdita di conversione e un maggiore sovraccarico dovuto alle ventole.
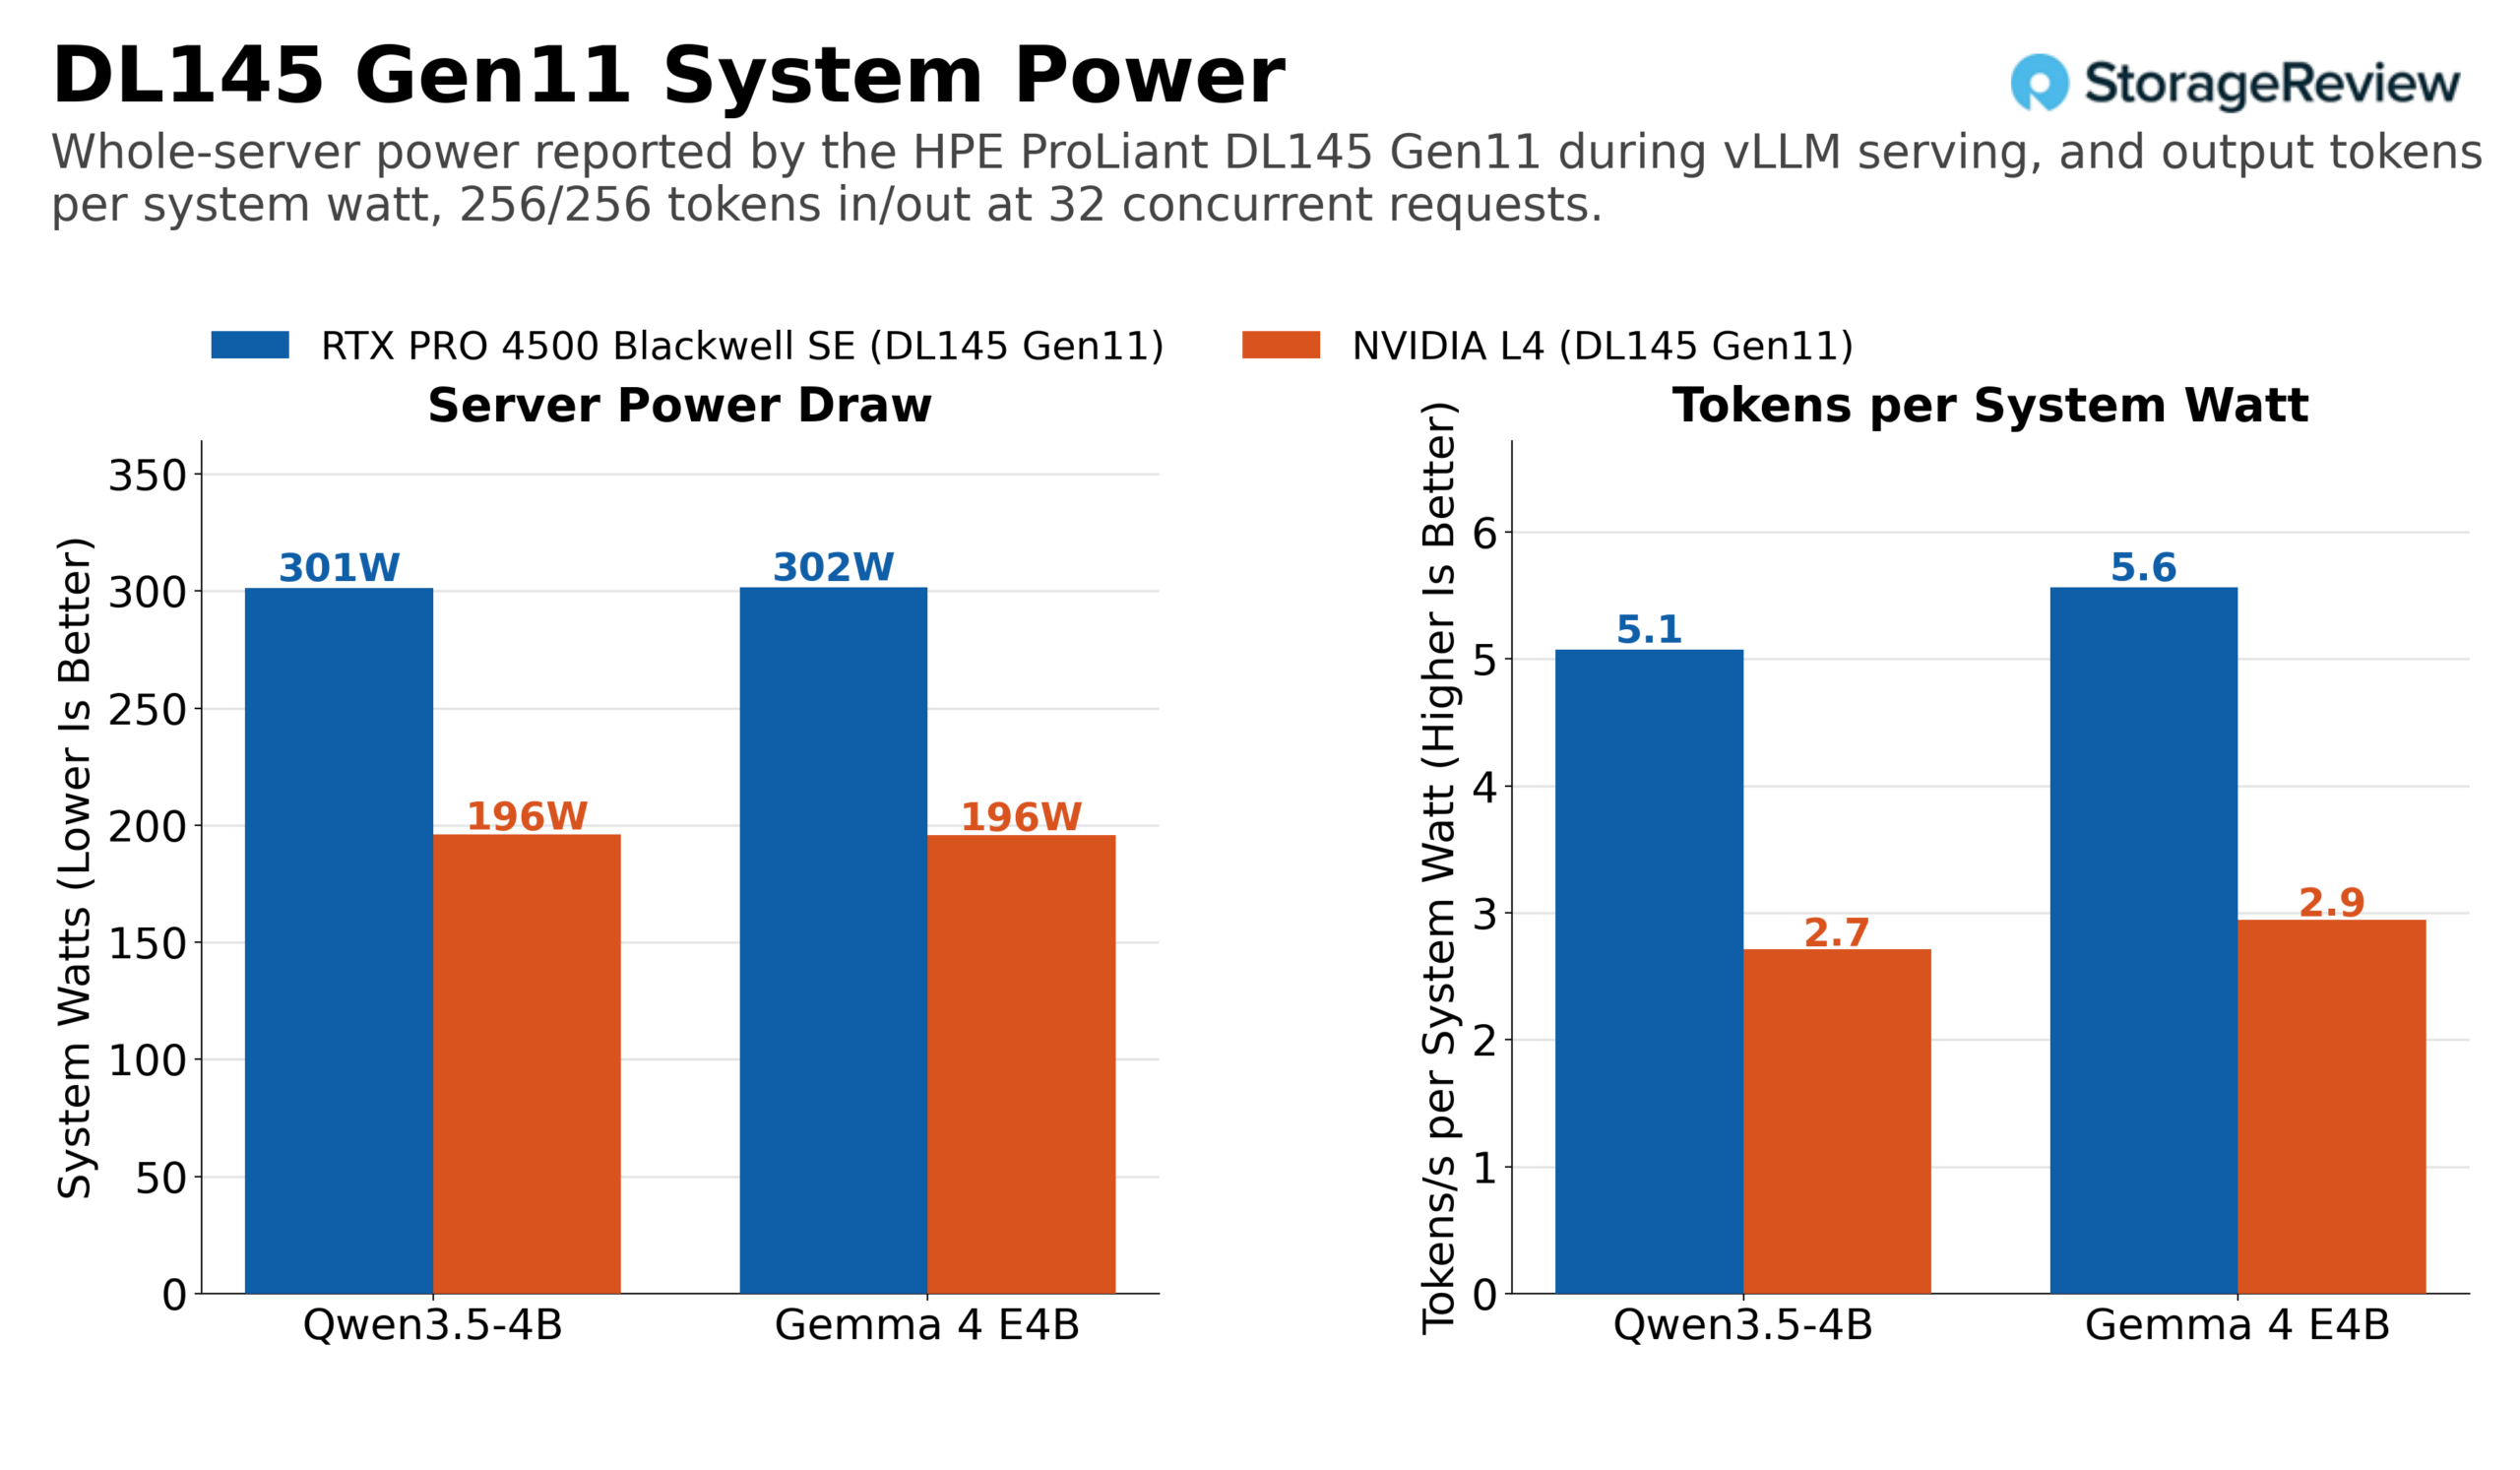
Con 32 istanze simultanee su 256/256, il server ha prodotto 2.7 token di output al secondo per watt di sistema su Qwen3.5-4B con la L4 e 5.1 con la 4500; su Gemma 4 E4B, 2.9 e 5.6. Il guadagno in termini di efficienza a livello di sistema è maggiore di quello a livello di scheda perché gran parte del consumo della DL145 è un costo fisso: CPU, memoria, ventole e storage consumano circa la stessa quantità di energia sia che la GPU produca 532 token al secondo o 1,529. Un sito che paga per il server ottiene già 1.9 volte i token per watt alla presa di corrente grazie alla sostituzione, contro 1.3 volte a livello di scheda. Per una flotta dimensionata in base a un budget energetico per sito, questo è il dato su cui basarsi per la pianificazione.
Cosa aggiungono 32 GB e NVFP4
Tutto quanto descritto sopra è un'operazione che l'L4 può eseguire, seppur più lentamente. L'altro argomento a favore del 4500 riguarda una classe di modelli che l'L4 non può gestire nativamente: Gemma 4 26B-A4B in NVFP4, un modello a miscela di esperti a 26 bit con circa 4 miliardi di parametri attivi per token, servito con una cache KV FP8. Al BF16, i soli pesi di questo modello superano i 24 GB; in NVFP4, invece, rientrano nei 32 GB del 4500, con spazio sufficiente per una cache KV funzionante, e i Tensor Core FP4 di Blackwell supportano nativamente il formato. vLLM può caricare i pesi NVFP4 sull'architettura Ada dell'L4 tramite un kernel dedicato ai soli pesi, e i pesi a 4 bit, pari a circa 14 GB, rientrerebbero nei 24 GB, ma l'L4 non dispone di capacità di calcolo FP4 native, quindi non l'abbiamo eseguito su di esso. Per confronto, abbiamo eseguito lo stesso test su una RTX PRO 6000 Blackwell Workstation Edition, una scheda da 96 GB e 600 W, installata in un Dell Pro Max Tower T2. Si tratta di un host e di una scheda di classe diversa, e l'abbiamo inclusa solo per fornire un punto di riferimento ai risultati della 4500.
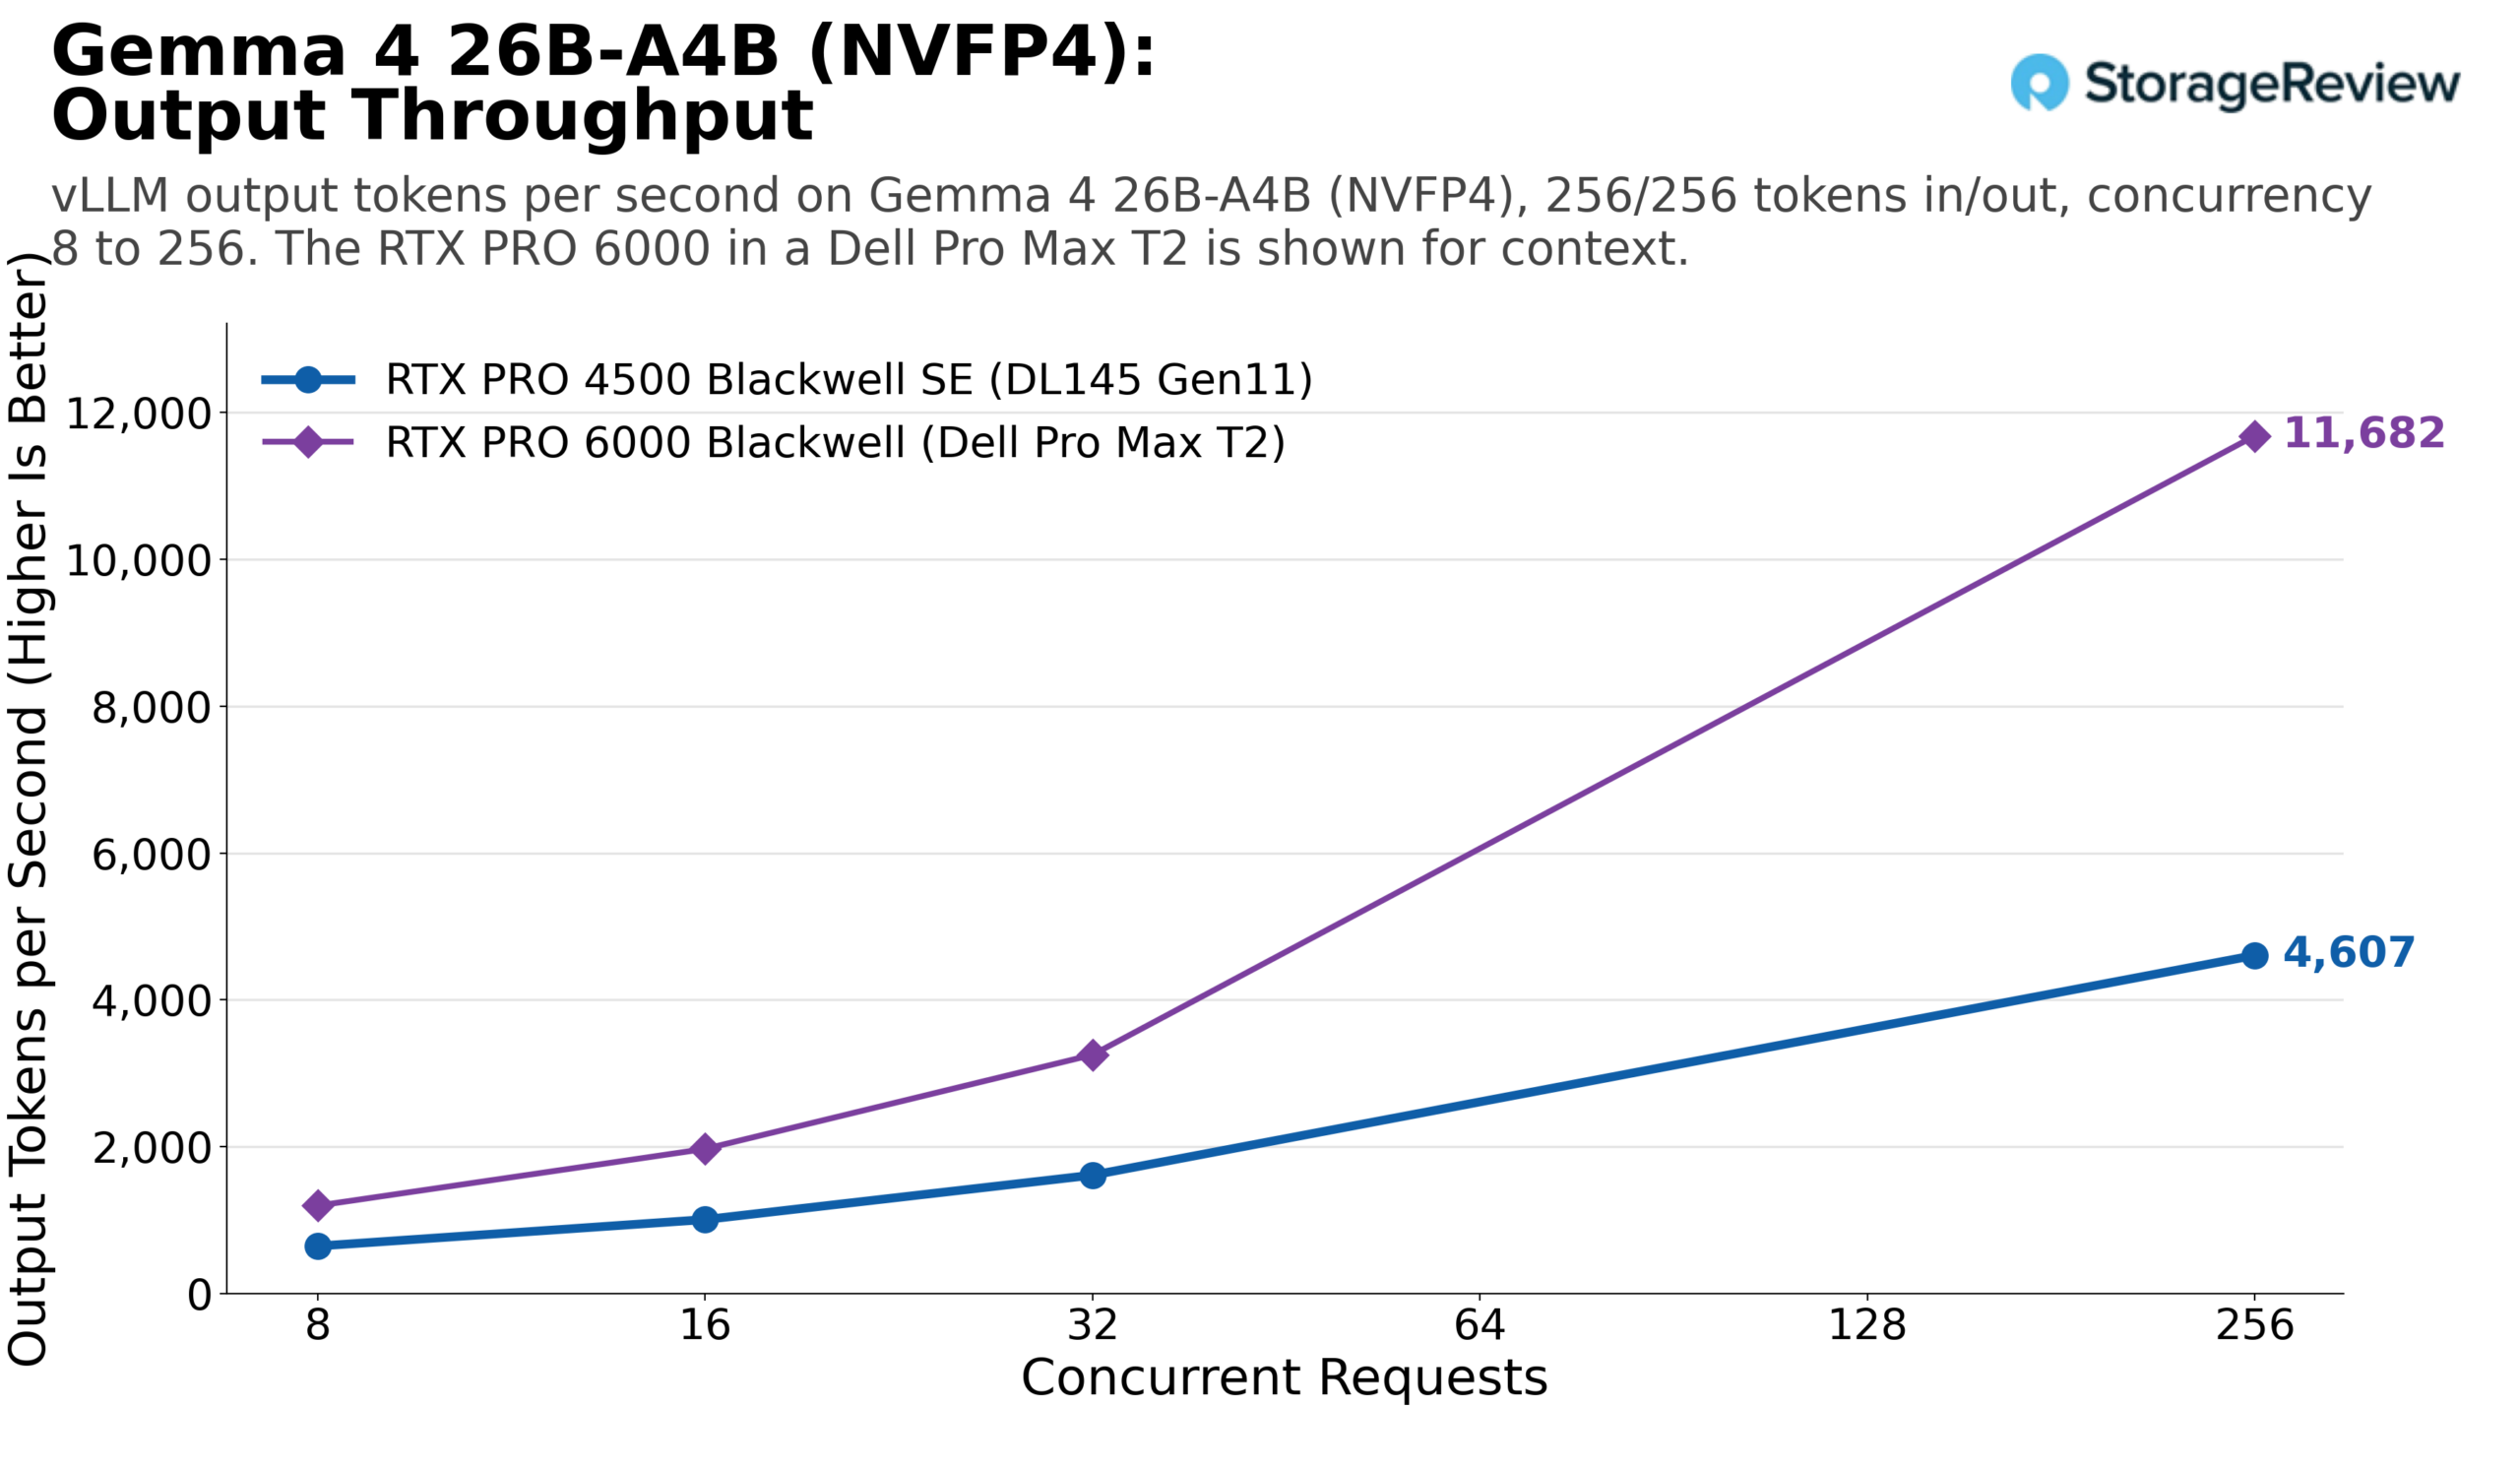
Su 256/256, la 4500 ha prodotto 647 token di output al secondo con 8 concorrenti, 1,613 con 32 e 4,607 con 256; la RTX PRO 6000 ne ha prodotti 1,198, 3,252 e 11,682. Da 8 a 32 concorrenti, la 4500 si attesta tra il 48% e il 55% della 6000 su ogni forma, eccetto il caso 1,024/32 con pre-riempimento limitato, dove scende al 29% con 32 concorrenti, e lo fa con 165 W contro i 266 W - 471 W misurati sulla 6000 per le forme rappresentate nel grafico. A 256 concorrenti, scende al 23% - 42% man mano che i suoi 32 GB si riempiono.
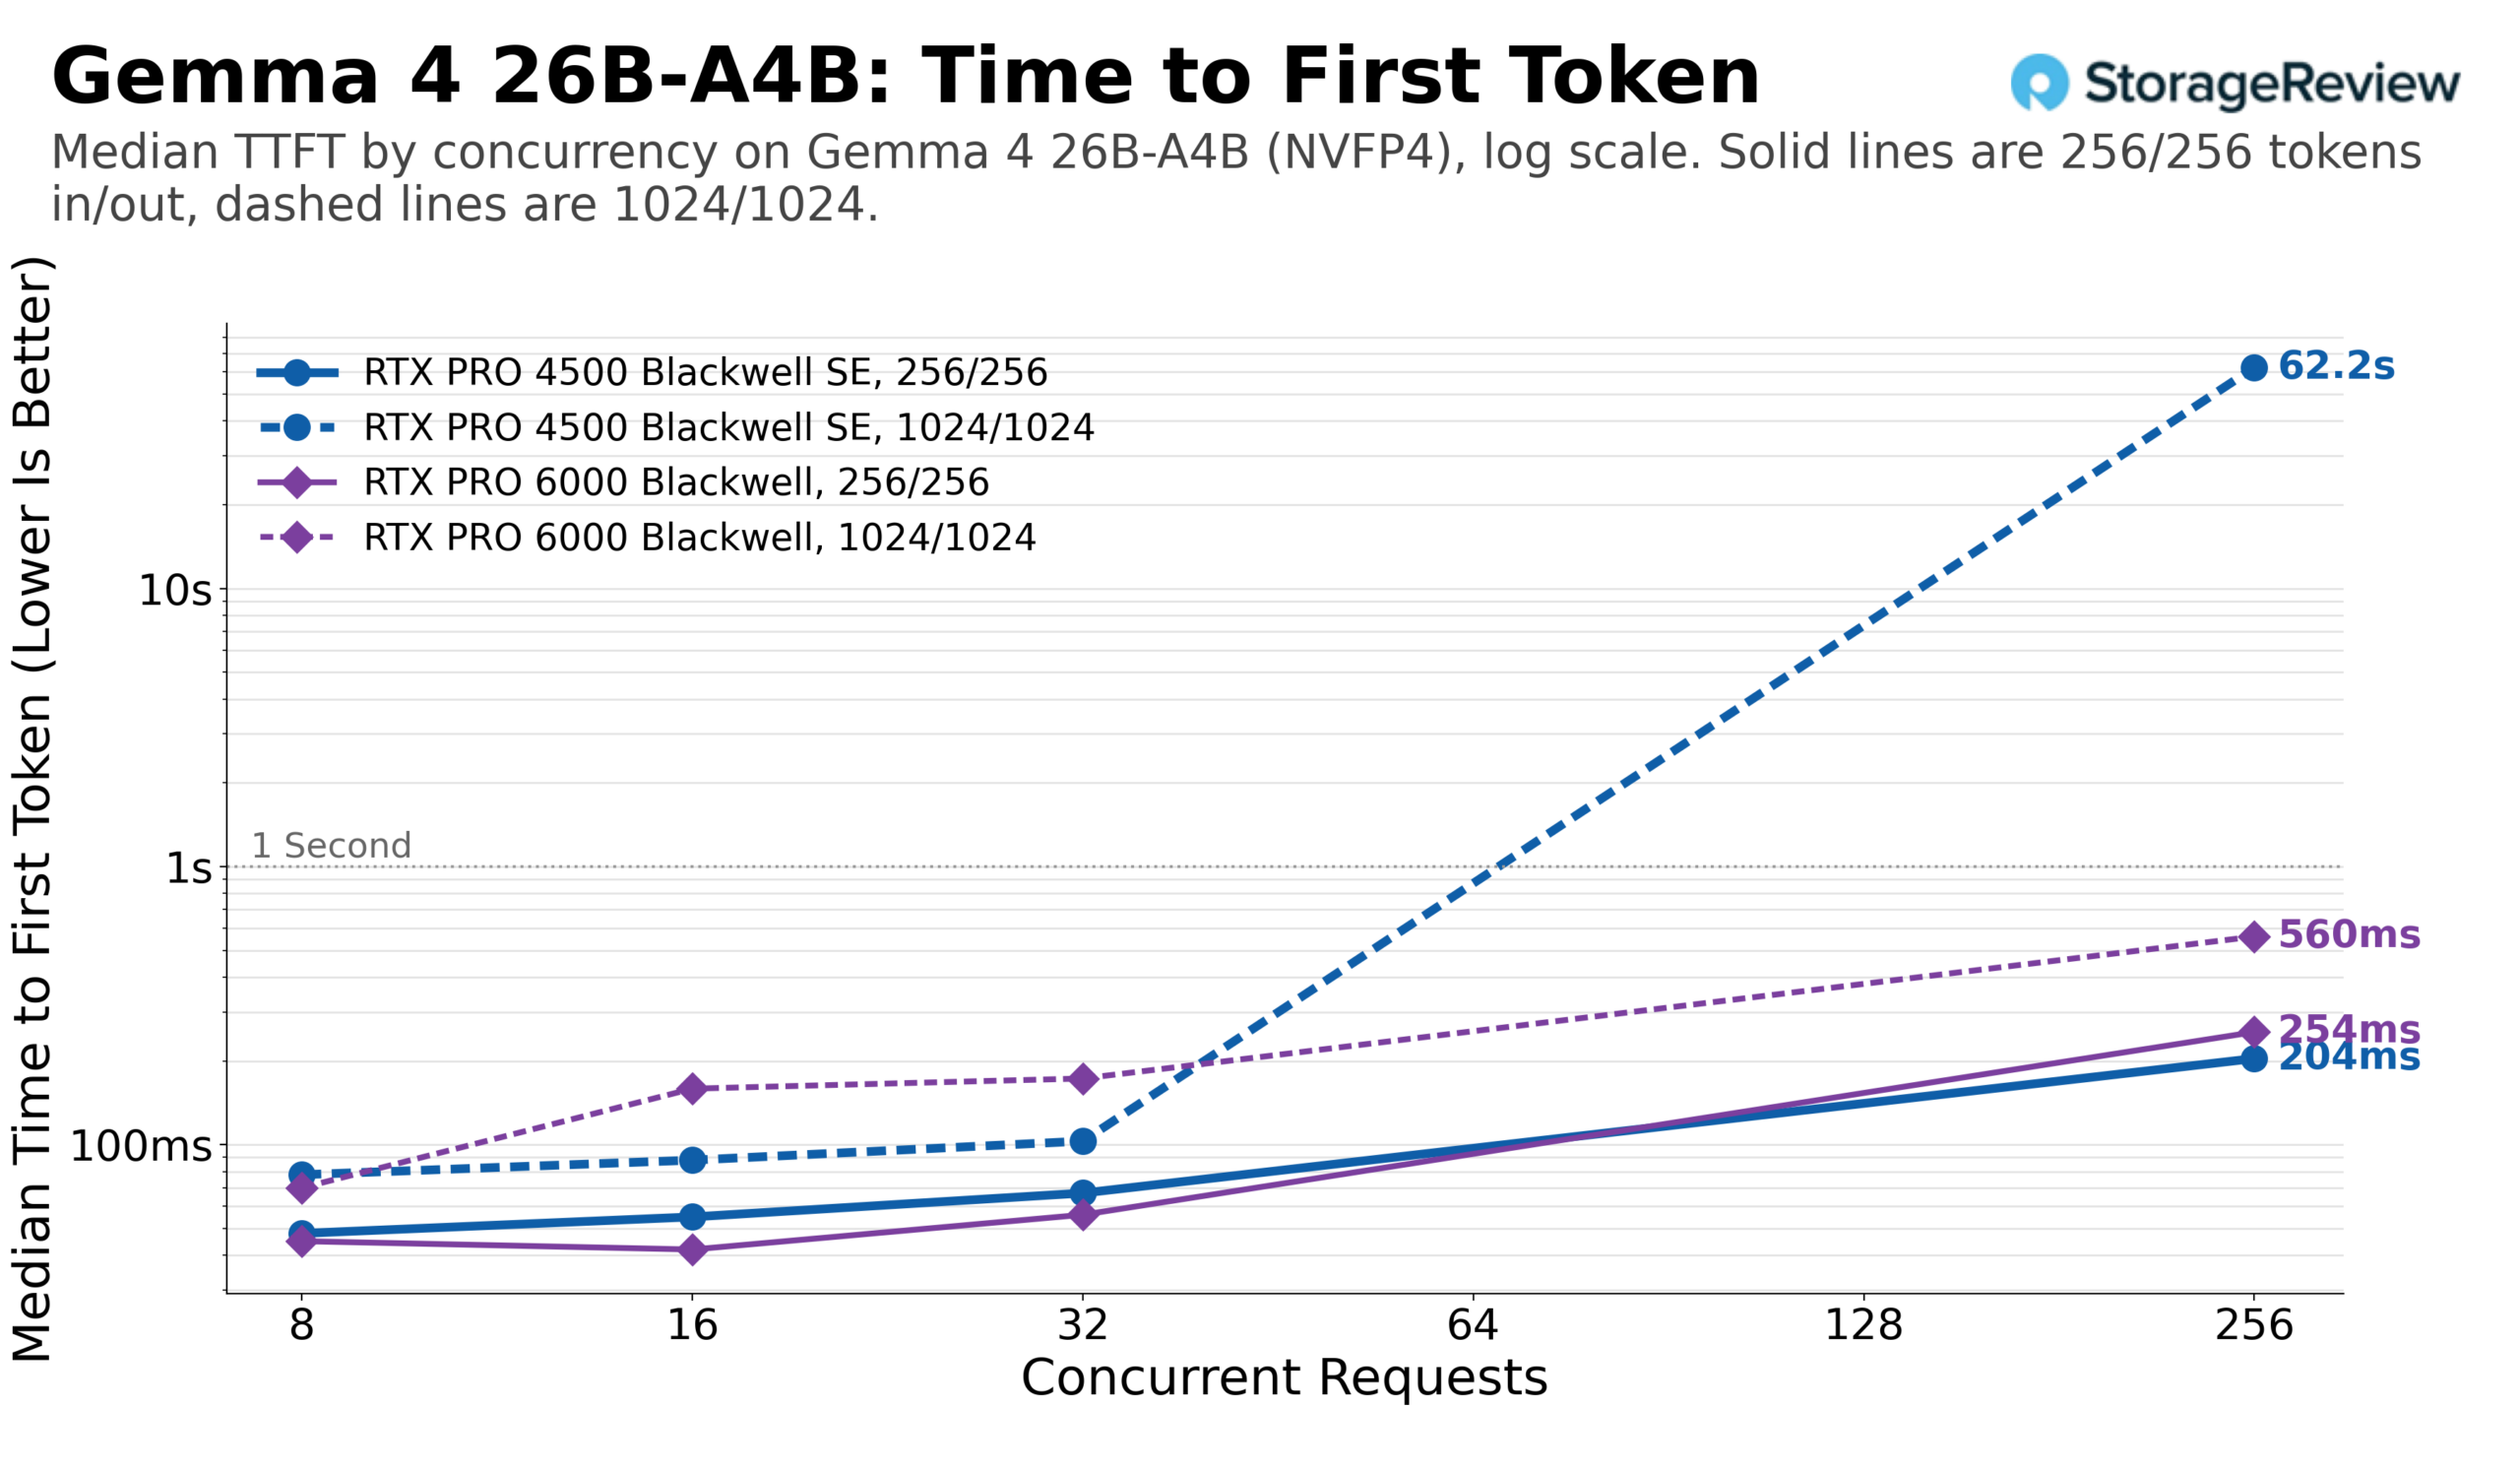
La latenza del primo token conferma quanto osservato nei modelli BF16: con 32 sessioni simultanee, la mediana del 4500 era di 67 ms su 256/256 e di 103 ms su 1,024/1,024, entro poche decine di millisecondi dal 6000 in entrambi i casi, e si manteneva a 204 ms con 256 sessioni simultanee sulla forma breve. Su 1,024/1,024 con 256 sessioni simultanee, il 4500 impiegava 62 secondi per la coda, mentre il 6000, con il triplo della memoria, si manteneva a 560 ms. Per un MoE a 26 bit, il 4500 è una scheda a 32 sessioni con contesto lungo e una scheda a 256 sessioni con lunghezza chat, ed esegue il modello su hardware FP4 che l'L4 non possiede.
La DL145 ha assorbito un massimo di 306 W alimentando il modello 26B sull'Audi 4500, contro un picco di 308 W sui modelli 4B, poiché la scheda consuma comunque 165 W. Un modello di classe 26B in un box esterno con un consumo di 300 W rappresenta l'aggiornamento in termini di prestazioni, e non comporta un consumo energetico maggiore rispetto ai modelli più piccoli.
Conclusione
NVIDIA valuta la RTX PRO 4500 Blackwell Server Edition con prestazioni superiori di oltre 5 volte rispetto alla L4, un dato basato su FP4 e NIM. In un confronto diretto con BF16 sullo stesso DL145 Gen11, la 4500 ha fornito una velocità di elaborazione media 2.7 volte superiore a quella della L4 su due piccoli modelli in condizioni di concorrenza operativa e da 3.0 a 3.2 volte superiore in condizioni di saturazione, generando token 2.8 volte più velocemente per un singolo utente e mantenendo la latenza del primo token inferiore a un secondo con carichi di lavoro in cui la L4 era rimasta in coda per decine di secondi. La L4 mantiene ogni utente con oltre 10 token di output al secondo per un numero di sessioni compreso tra 32 e 256 nella maggior parte delle configurazioni, e solo fino a 8 nella configurazione 1,024/32, caratterizzata da un elevato utilizzo di pre-riempimento, mentre la 4500 lo fa con 256 sessioni per i prompt di lunghezza chat. Il modello 4500 è stato utilizzato anche per la Gemma 4 26B-A4B in NVFP4, un modello che l'L4 non è in grado di gestire nativamente.
Il consumo è di 105 W alla presa di corrente, da circa 196 W a circa 301 W per l'intero server sotto carico, e 2.3 volte la potenza della scheda a livello della GPU. Misurata a livello della GPU, la 4500 è da 1.3 a 1.4 volte più efficiente della L4 per token di output; misurata alla presa di corrente, dove viene consumato il resto del consumo del sistema, è circa 1.9 volte. I siti di queste dimensioni con un budget di potenza per unità troveranno nella 4500 un utilizzo migliore dei watt che già spendono, e i siti di queste dimensioni in base agli slot troveranno in una singola 4500 la stessa velocità di elaborazione di tre L4 con 32 sessioni ciascuna, con una generazione 2.8 volte più veloce per utente e un singolo pool da 32 GB.
La precisazione iniziale sulla portata del test rimane valida, poiché si tratta di un confronto tra una scheda e la sua predecessora in un server edge su tre modelli di piccole dimensioni, e la posizione della RTX PRO 4500 Server Edition rispetto all'L40S, alla RTX PRO 6000 Server Edition e al resto dell'attuale gamma di schede di inferenza è una questione a parte che stiamo affrontando in un articolo più ampio. Per quanto riguarda la domanda posta da un possessore di un DL145 con un L4, la risposta è che la 4500 è l'aggiornamento per cui la piattaforma è stata progettata, a condizione che lo chassis disponga del riser a lunghezza intera e dell'alimentazione a 16 pin necessari, e che l'abbinamento di questa scheda con questo server per Nemotron in ambiente edge da parte di HPE sia ben bilanciato rispetto alle prestazioni dell'hardware.
Il DL145 Gen11 stesso appare nella sezione periferica del nostro I migliori server classifica, dove questo risultato ora costituisce il punto di riferimento per la narrazione dell'inferenza dei bordi.
Classifica: La RTX PRO 4500 Blackwell Server Edition detiene il titolo di Migliore GPU a singolo slot nella nostra Le migliori GPU aziendali leaderboard, and the L4 holds Best Slot-Powered Card for 1U and Edge.


 Amazon