

Cerebras Systemsは、最先端のトレーニングと高並列推論ワークロード向けに設計された、ウェハスケールAIスーパーコンピューティングプラットフォームの第4世代となるCS-4を正式に発表しました。このシステムは、新たに開発された3つのWafer Scale Engine 3(WSE-3)Turboプロセッサを中心に構築されており、Nexusラックスケールプラットフォームと呼ばれるゼロからの再設計で搭載されています。Cerebrasは、このシステムがGPUベースのソリューションの最大30倍の推論性能を実現すると主張しており、その根拠としてGPT-OSS-120Bを挙げています。GPT-OSS-120Bでは、ユーザー1人あたり毎秒4,400トークン以上、さらに前世代のCS-3と比較してワットあたりのスループットが10倍向上しています。
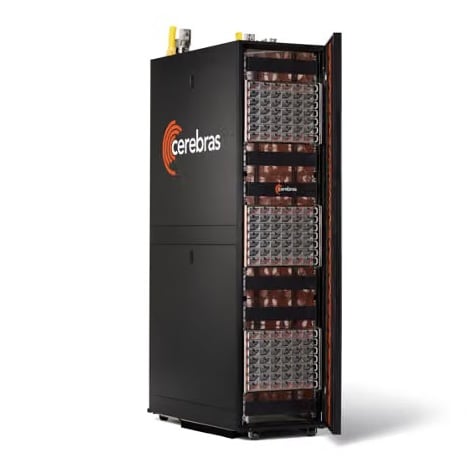
CS-4は、個別のマルチノードGPUクラスタに内在するシステム的なスケーリング制限に対処するために設計されています。この制限では、チップ間の通信、電力変換損失、および熱制限によって、持続的な計算効率が頻繁に低下します。Cerebrasは、このプラットフォームを推論ワークロードの両極端に対応できるように位置付けており、複雑なエージェントワークフローや対話型推論に必要なミリ秒以下の応答時間を実現すると同時に、ハイパースケーラーがギガワットあたりの計算密度を最大化するために必要な総容量を提供します。
相互接続ファブリックの改良は、プラットフォームのマルチプロセッサスケーリング機能の中核を成すものです。CS-4は、ウェハ間相互接続のレイテンシをわずか2マイクロ秒にまで低減し、マルチウェハファブリックをほぼモノリシックなレベルで動作させます。この超低レイテンシファブリックにより、CS-4は10兆個以上のパラメータを持つモデルでも毎秒1,000トークンを超える生成速度を維持でき、パラメータ数を増やすとインタラクティブなトークン配信速度が著しく低下するという従来の性能ギャップを解消します。

Nexusラックアーキテクチャとウェハースケールバックパック
CS-4における主要なエンジニアリング上の転換点は、独立したコンピューティング、電源、およびI/Oドメインを中心に構築されたモジュール式ラック実装であるCerebras Nexusプラットフォームアーキテクチャです。コンピューティング密度は、プライマリ電源アレイに垂直に接続される新設計の背面マウント型ウェハスケールバックパックによって支えられています。各バックパックは自己完結型のユニットで、シリコンウェハの真後ろに配置されたチップ直結型液冷マニホールド、ポイントオブロード電力変換ステージ、高速ネットワークパス、およびオンボード制御エレクトロニクスを内蔵しています。コアコンピューティング層をバルク電源分配フレームから分離することで、Cerebrasはシステムコンポーネント数を50%削減し、自動組み立てを60%向上させ、データセンターの展開期間をわずか数時間に短縮しました。

電力供給効率は、DC-DC電圧レギュレーションモジュールを、一般的なサーバーボードの実装よりもシリコン境界に100倍近づけることで向上しました。この負荷点配置により、抵抗性電力分配ネットワーク(PDN)損失が低減され、Nexusフレームは各WSE-3 Turboプロセッサに2倍の電力を供給できるため、熱スロットリングを起こすことなく、より高いクロック周波数を持続的に実現できます。

I/Oサブシステムは、プログラマブルなウェハI/Oモジュールによって拡張され、ファブリックのエッジ間帯域幅を2倍にしながら、伝送遅延を低減します。システムネットワークは2つのモードで動作します。1つは、従来のエンタープライズネットワークやサードパーティ製アクセラレータノードへの低遅延ファブリック接続を実現する標準のRoCE v2(RDMA over Converged Ethernet)インターフェイス、もう1つは、ラック内およびラック間の隣接システム間でスイッチ不要の直接相互接続パスを提供する独自のダイレクトウェハリンクです。
CS-4およびWSE-3ターボの仕様
| CS-4システム | |
| アーキテクチャ | 3つのモジュール式コンピューティングバックパックを備えたアクティブ電源ラック |
| ウェハースケールエンジン | システムあたり3基のWSE-3ターボ |
| AIコンピューティング | 750 PFLOPS* |
| メモリ帯域幅 | 129.6 PB/秒 |
| オンチップファブリック帯域幅 | 160.5 PB/秒 |
| 入出力帯域幅 | 7.2 テラビット/秒 |
| I/Oレイテンシ | 2のマイクロ秒 |
| WSE-3 ターボ(ウェハーあたり) | |
| トランジスタ/シリコン | トランジスタ数4兆個、面積46,225 mm2、TSMC 5nmプロセス |
| AIコア/オンチップSRAM | 900,000万コア、44GB SRAM |
| AIコンピューティング | 250 PFLOPS* |
| メモリ帯域幅 | 43.2 PB/秒 |
| オンチップファブリック帯域幅 | 53.5 PB/秒 |
| 入出力帯域幅 | 2.4 テラビット/秒 |
| *AI演算はスパースFP16として表示されます | |
分解された推論と可用性
アーキテクチャ上、CS-4は分離型推論トポロジーをネイティブにサポートするように設計されています。エンタープライズ環境やクラウド環境では、オペレーターはAMD HeliosやAWS Trainiumなどの専用の外部プリフィルアクセラレータを使用してプロンプトコンテキストを取り込み、モデル状態を構築することで、推論の計算フェーズを分離できます。計算処理に特化したKVキャッシュは、高速リンクを介してCS-4の大容量SRAMファブリックにルーティングされ、超低遅延の自己回帰型トークン生成を実現します。
Cerebras社は、CS-4プラットフォームの初期生産展開と出荷が今四半期中に開始される予定であることを確認した。


 Amazon