

IBMは、応答性、セキュリティ、そして稼働時間が必須となる生成型AIおよびエージェント型AI向けに設計された低レイテンシー推論エンジン、IBM Spyre Acceleratorを発表しました。Spyreは、既存の記録システム(SOR)にAIを統合したい企業向けに設計されており、パフォーマンスを損なうことなく機密データをプラットフォーム上に保持できます。
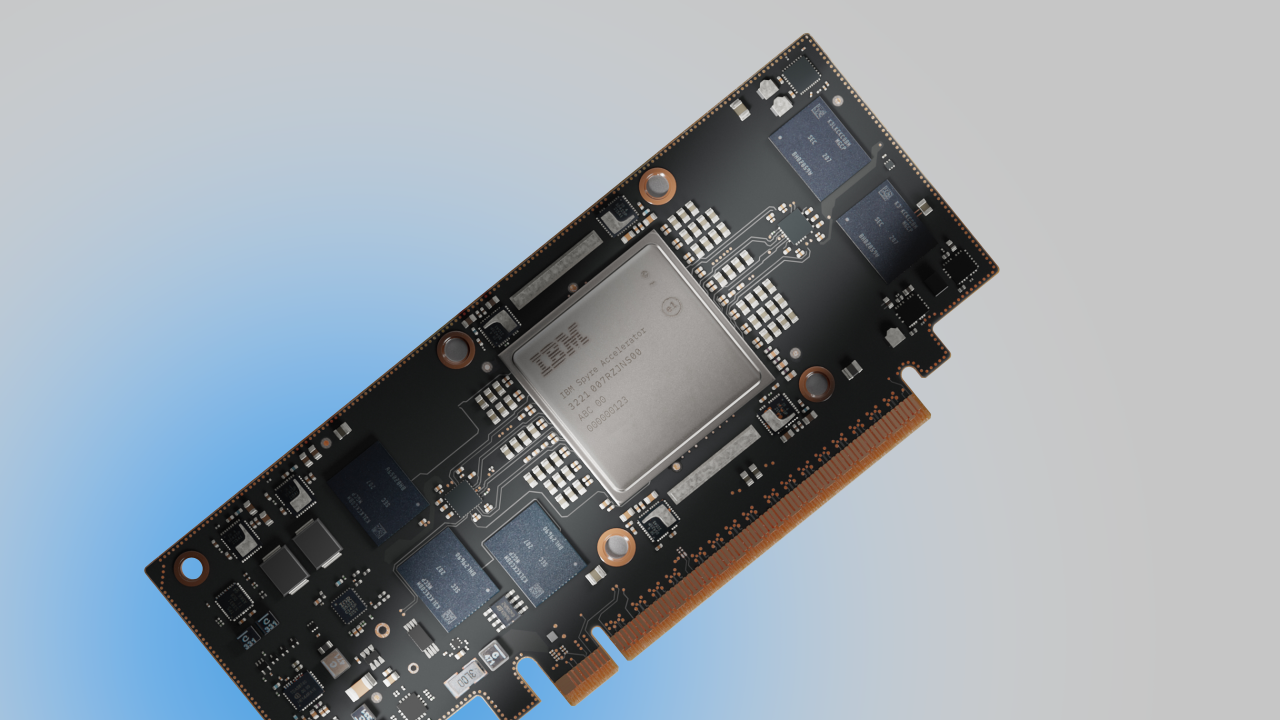
IBM z17およびLinuxONE 5向けは10月28日より一般提供が開始され、Power11は12月上旬に発売されます。このアクセラレーターは、75ワットのPCIeカードにパッケージ化された5nm、32コアのSoCです。IBMは、IBM ZまたはLinuxONEシステムごとに最大48枚、IBM Powerシステムごとに最大16枚のカードで構成されるクラスターをサポートし、不正検出、小売自動化、リスクスコアリングなどのトランザクション・ワークロードに隣接するマルチモデル推論のスケールアウトを可能にします。Spyreは、IBMのAIハードウェア・センターの研究成果を製品化したもので、データの局所性、セキュリティー、エネルギー効率が基本要件となるオンプレミス展開向けに調整されています。
ロジックパイプラインからエージェントAIへ
企業のワークフローは、決定論的なロジックチェーンから、コンテキストを認識し、リアルタイムで計画・実行するエージェントAIへと移行しつつあります。こうしたエージェントシステムでは、コアシステムが大量のトランザクション処理を維持する中でも、低レイテンシーの推論と予測可能なサービス品質が求められます。IBMのアプローチは、重要なデータが既に存在するプラットフォームに専用の推論ハードウェアを直接配置することです。データをIBM Z、LinuxONE、Power Systems上に保存することで、不要なデータ出力や外部処理を回避し、リスクとコンプライアンスのオーバーヘッドを削減します。生成推論とエージェント推論をデータの近くで実行することで、テールレイテンシーが発生することが多いバックホールやネットワークに起因する変動性も最小限に抑えられます。最終的な目標は、スループット、変更時間枠、サービスレベルを損なうことなく、既存のOLTP、バッチ、メッセージングフローにAI主導の意思決定を追加することです。
スパイアアーキテクチャ
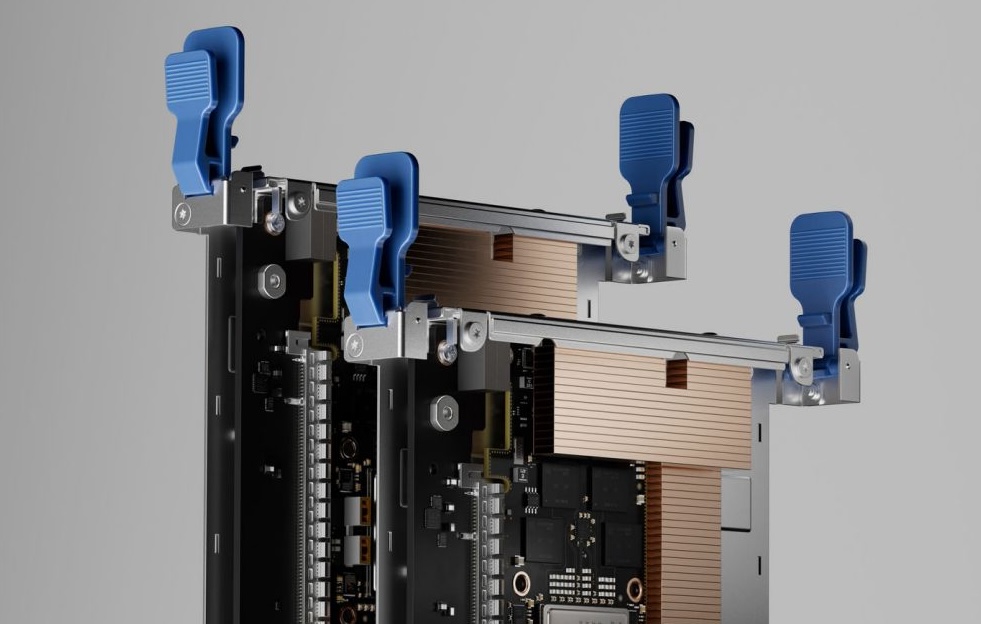
Spyreは、IBMリサーチが作成したプロトタイプから開発された商用システムオンチップ(SoC)です。5nmプロセスで構築され、25.6億個のトランジスタと32個のアクセラレータコアを搭載し、モデル学習ではなく、同時実行型で低レイテンシの推論に最適化されています。このデバイスは75ワットのPCIeアドインカードとして提供され、インフラチームに使い慣れた導入・サービスモデルを提供します。
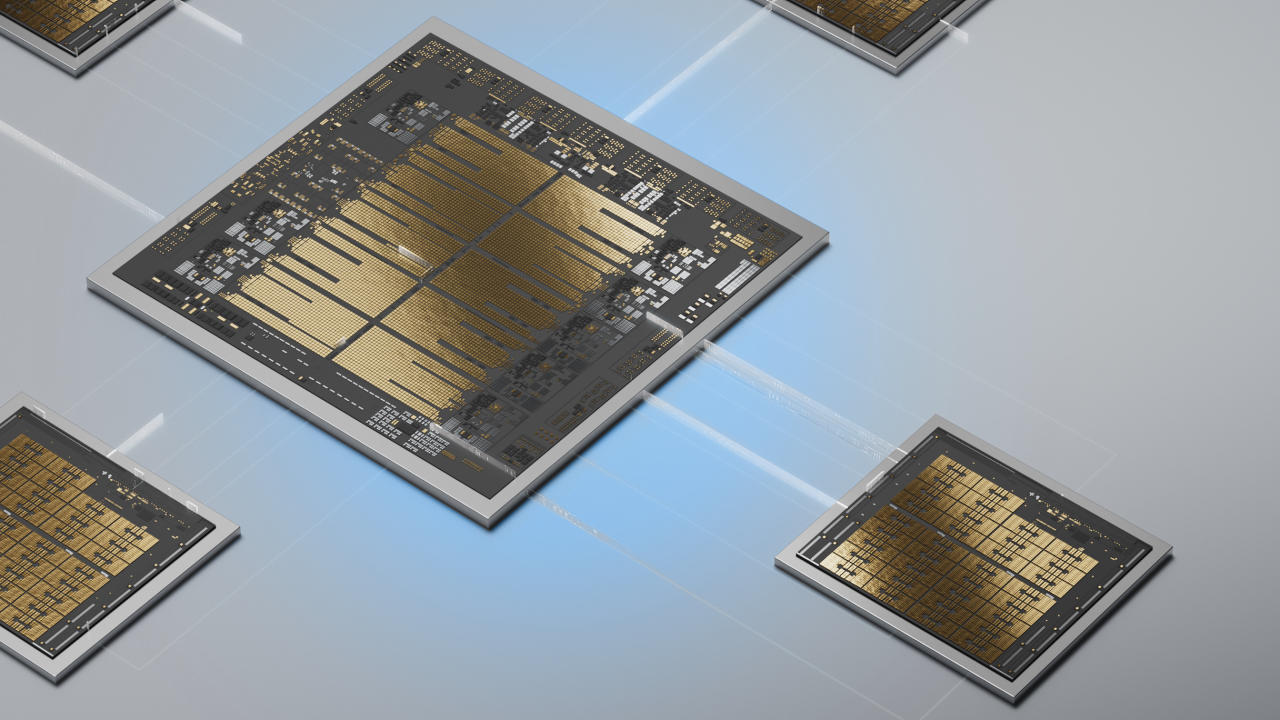
IBMは、IBM ZまたはLinuxONE 5システムでは最大48枚、IBM Power11システムでは最大16枚のカードを搭載可能なスケールアウト構成を開発しました。これにより、単一プラットフォーム内でマルチモデルサービングとテナント分離が可能になります。ソフトウェア面では、SpyreはIBMのエンタープライズ・スタックと統合し、モデルサービング、セキュリティ、可観測性を実現します。また、Powerはワンクリック・カタログ機能を追加することで、迅速なサービス展開を実現します。この組み合わせにより、既存の運用およびコンプライアンスの境界内でAIサービスを維持しながら、価値実現までの時間を短縮できます。
プラットフォーム統合
IBM Z と LinuxONE: Telum II との共存
z17およびLinuxONE 5では、SpyreはTelum IIプロセッサー・コンプレックスと連携して動作し、推論をトランザクション・データおよびイベント・ストリームと共存させます。この構成により、規制環境において不可欠な既存のセキュリティー・ドメインと監査証跡が維持されます。推論をローカルで実行することで、組織は外部アクセラレーターへの接続を最小限に抑え、追加の遅延がトランザクションSLAに影響を与えるのを防ぎます。このシステムは最大48枚のカードまで拡張可能で、複数のモデルとワークロードを同時にサポートします。また、論理的な分離を提供し、様々な事業部門や規制要件に対応します。これは、1ミリ秒単位の精度が重要で、コンプライアンス境界の拡大が望ましくない決済フロー、不正防止、請求処理、サプライチェーン・イベントにおいて特に重要です。
IBM Power11: カタログ駆動型 AI サービスと MMA の相乗効果
Power11サーバー上で、Spyreは既存のPower環境への迅速な導入を目的に設計されたAIサービスカタログと統合されています。管理者は、Powerのお客様がミドルウェア、アナリティクス、基幹業務アプリケーションを従来通り運用する方法に沿って、ワンクリックでサービスを展開できます。SpyreとPowerのオンチップMMAアクセラレータを組み合わせることで、生成型AIパイプラインと複雑なプロセス統合において重要な段階であるデータ変換と前処理のスループットが向上します。
IBMは、プロンプトサイズが128の場合、システムが約1時間で800万件以上のドキュメントをナレッジベース統合のために処理できるというスループットの例を挙げています。RAGシステムを開発したり、大規模なエンタープライズサーチを実施したりする企業にとって、推論ステップだけでなく、データの準備と取り込みの高速化に重点が置かれます。全体的な適合性は、製造、小売、医療、ERPを多用する導入など、予測可能なスループットと保守性が鍵となる混合環境を対象としています。
IBM AIハードウェアセンターから現場への導入まで
Spyreは、IBMがいかに研究成果を実用的な製品へと変貌させるかを示すものです。この技術は、IBMリサーチによって開発されたプロトタイプとして始まり、ヨークタウン・ハイツ・キャンパスでの反復的なクラスター導入や、アルバニー大学の新興人工知能システムセンターとの連携を通じて成熟しました。その後、IBMインフラストラクチャーは、IBM Z、LinuxONE、Power向けにこの設計を製品化し、セキュリティ、信頼性、ライフサイクル管理、保守性といった企業の要件を満たすシリコンを実現しました。IBMの幹部はSpyreをマルチモデルAIのためのインフラストラクチャーと位置付け、コアデータとトランザクションで既に信頼されているプラットフォーム上で、生成型およびエージェント型のワークロードを安全かつ回復力のある方法で拡張できることを重視しています。
Spyreの価値は、IBMの運用体制と切り離せないものです。データが生成され、管理される場所で推論を実行することで、組織はデータの流出を制限し、コンプライアンスの複雑さを軽減できます。IBM ZとLinuxONEは、多くのお客様の規制フレームワークに既に不可欠な暗号化、分離、ロギング、監査機能を提供します。Powerは、混合分析とトランザクション資産に適した堅牢なセキュリティおよび管理スタックを提供します。クラスタリングのサポート、論理パーティショニング、そしてファーストパーティーの可観測性ツールは、メインフレームとPowerの運用基準に準拠しており、AIサービスを他のTier 1ワークロードと同様に導入、監視、そしてサービス提供することを可能にします。金融、医療、そして公共部門の多くのバイヤーにとって、これらの運用保証は、生のTOPSや合成ベンチマークよりも優先されます。
パフォーマンスとスケーラビリティに関する考慮事項
IBMは各モデルの包括的なパフォーマンス詳細を公開していませんが、アーキテクチャ上の指標は明らかです。Spyreは、エージェントループやイベントドリブンパイプライン向けに最適化された低レイテンシ推論パスをターゲットとしており、ピークスループットだけでなく、同時実行性とテールレイテンシ制御も重要です。PCIeカードクラスターによるスケールアウトにより、プラットフォームの再設計を必要とせずに、マルチモデルサービス、テナント分離、そして将来の成長に合わせてデプロイメントのサイズを調整できます。
Powerでは、MMAとSpyreの組み合わせにより、RAGやエンタープライズ検索のエンドツーエンドの時間を左右するデータ準備と変換を高速化できます。企業は、モデルのサイズとトークンウィンドウ、リクエストの同時実行性、トランザクション負荷との相互作用、競合時のテールレイテンシのテレメトリなど、本番環境を反映する概念実証を構築する必要があります。
IBMインフラストラクチャー担当COO兼IBMシステムズ担当GMのバリー・ベイカー氏は、同社が新興AIワークロード向けインフラストラクチャーの開発に注力していることを強調しました。ベイカー氏は、生成型AIやエージェント型AIを含むマルチモデルAIをサポートするシステム強化におけるSpyre Acceleratorの役割を強調しました。さらに、このイノベーションは、お客様がミッションクリティカルなAIワークロードを安全、レジリエンス、そして効率的に拡張し、企業データの価値を最大化することを目指していると付け加えました。
IBMセミコンダクターズ部門ゼネラルマネージャーのムケシュ・カレ氏は、IBMがAIのコンピューティング需要の増大に対応するため、近年のAIブーム以前から2019年にAIハードウェアセンターを立ち上げたと述べています。カレ氏は、IBMのメインフレームおよびサーバークライアントのパフォーマンスを向上させるために設計された、センター初のチップの商用化を喜んでいます。
適用例
金融サービスチームは、Spyreを活用してリアルタイムの不正検出を行うことができます。Spyreはプラットフォーム上のデータセットに対して直接動作するため、監査範囲を拡大することなく、モデルの更新やポリシーの更新が可能です。小売・物流業界では、エージェントアシスタントが推論を運用システム内でローカルに保つことで、在庫管理やフルフィルメントの意思決定を一貫した応答時間で調整できます。医療・政府機関は、厳格なプライバシーと居住地の制約内で生成サマリーと意思決定支援を展開できるため、追加のコンプライアンス作業につながるデータ移動を回避できます。産業・ERPを多用する環境では、SpyreはPowerで稼働するSAP、Oracle、プラントテレメトリシステムの近くでプロセス自動化と異常検出を実現し、確定的な動作と保守性を確保します。
IBMインフラストラクチャー部門のリーダーシップは、SpyreをAIシフトの基盤となるインフラストラクチャーとして提示します。Spyreは、強力なセキュリティとレジリエンシーの保証を備え、エンタープライズ規模のマルチモデル生成およびエージェント型ワークロードをサポートするように設計されています。IBMセミコンダクター部門のリーダーシップは、SpyreをAIハードウェアセンターからの最初の商用化マイルストーンと位置付け、IBMのメインフレームおよびサーバー顧客向けのハードウェアイノベーションの継続的な進展を期待しています。
ボトムライン
Spyreは、セキュリティ、信頼性、データの局所性を犠牲にできない環境において、低レイテンシー推論を実現するIBMのオンプレミスソリューションです。ハードウェアのスケール、プラットフォームネイティブな統合、そして運用モデルは、コアトランザクションと同じ影響範囲でエージェントAIを求めるIBM Z、LinuxONE、Power環境と整合しています。購入者にとっての次のステップは、実証、つまり実際のワークロードにおけるレイテンシー、同時実行性、ガバナンスの優位性を検証する概念実証です。現場でのパフォーマンスが要件に合致すれば、Spyreは、生成型AIとエージェント型AIをミッションクリティカルなシステムに直接組み込むための実用的な道筋を提供します。
利用状況
Spyreは、10月28日よりIBM z17およびLinuxONE 5向けに一般提供を開始します。IBM Power11システムには12月上旬にSpyreが提供されます。この段階的なリリースにより、メインフレームおよびLinuxONEのお客様はプラットフォーム内推論を最も早くご利用いただけるようになり、その後すぐにPowerシステムにも提供されます。


 Amazon