

NVIDIA の新しい L675S GPU を搭載した Lenovo ThinkSystem SR3 V40 サーバーがロサンゼルスの SIGGRAPH に登壇し、世界的な AI 展開を推進し、インテリジェントなチャットボット、検索、要約ツールなどの生成型 AI アプリケーションを導入するという NVIDIA の計画の中心となりました。さまざまな業界のユーザー。
新しい ThinkSystem は NVIDIA OVX サーバーとして展示されており、最近発表された NVIDIA L40S GPU がまもなく統合される予定です。このコラボレーションは、AI 実装に革命をもたらし、次世代 AI、没入型メタバース シミュレーション、および大規模な認知的意思決定を可能にするのに役立つと期待されています。
NVIDIA L40S GPU
新たに発表された NVIDIA L40S GPU は、強力なユニバーサル データセンター プロセッサーとして機能し、AI トレーニングと推論、3D 設計と視覚化、ビデオ処理、NVIDIA Omniverse プラットフォームによる産業デジタル化などのコンピューティング集約型アプリケーションの高速化を目的として設計されています。大規模言語モデル (LLM) 推論と再トレーニング、グラフィックス、およびビデオ アプリケーションに対する画期的なマルチワークロード アクセラレーションを誇ります。
L40S GPU は、次世代の AI 対応オーディオ、音声、2D、ビデオ、および 3D アプリケーションを強化し、高忠実度で正確なデジタル ツインを提供する、次期 NVIDIA Omniverse OVX 3.0 プラットフォームにとって重要なコンポーネントです。
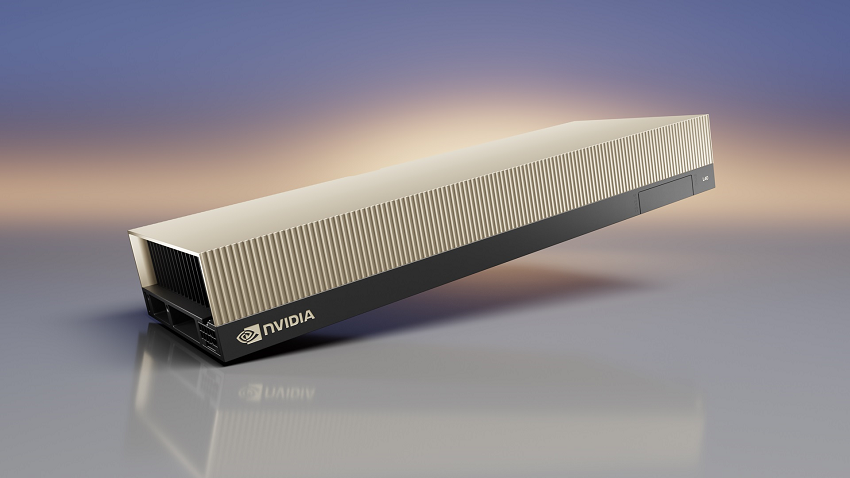
NVIDIA L40S GPU は、NVIDIA OVX システムの重要な資産となります。 NVIDIA Ada Lovelace GPU アーキテクチャと豊富な 48GB メモリを搭載しており、各サーバーには最大 40 つの L8S GPU を搭載できます。また、第 1.45 世代 Tensor コアと FPXNUMX Transformer Engine も備えており、XNUMX ペタフロップスという驚異的な Tensor 処理能力を実現します。
前世代の NVIDIA A100 Tensor コア GPU と比較して、L40S は、数十億のパラメーターと複数のデータ モダリティを含む複雑な AI ワークロードを処理するために、最大 1.2 倍の生成 AI 推論パフォーマンスと最大 1.7 倍高速なトレーニング パフォーマンスを実証します。
L40S GPU は、幅広いプロフェッショナルなワークフローに対応できるように設計されています。 142 個の第 212 世代 RT コアが搭載されており、3 テラフロップスのレイ トレーシング パフォーマンスを実現し、リアルタイム レンダリング、製品設計、XNUMXD コンテンツ作成などの高忠実度のプロフェッショナルなビジュアライゼーション ワークフローに最適です。
さらに、L40S の 18,176 個の CUDA コアは、NVIDIA A5 GPU のほぼ 32 倍の単精度浮動小数点 (FP100) パフォーマンスを提供し、エンジニアリングおよび科学シミュレーションの計算需要を確実に加速した効率で満たします。
ThinkSystem SR675 V3 構成
Lenovo は、新しい GPU に最適化されたサーバーの新しいラインナップで L40S をサポートする戦略的な立場にあります。 Lenovo は、完全にシミュレートされたデジタル ツインと生成 AI を組み合わせることで、ビジネス プロセスと設計成果の向上を目指しています。 NVIDIA OVX システムにおける Lenovo と NVIDIA の連携により、仮想世界の構築と運用が容易になり、システムの機能が生成 AI に拡張され、AI ワークロードを備えたデータセンターに電力パフォーマンスが提供されます。
ThinkSystem SR675 V3 は、NVLink および Lenovo Neptune ハイブリッド水冷を備えた NVIDIA HGX A100 4-GPU システムのサポートを含む 4 つのサーバー構成を 8 台で提供します。さらに、40U の設置面積に NVIDIA L100S、NVIDIA H80 100GB、または NVIDIA H3 NVL サーバーを搭載した XNUMX または XNUMX GPU 構成と互換性があります。
Lenovo は、これらの開発が AI の展開を簡素化し、あらゆる規模の組織が AI にアクセスできるようにし、あらゆる業界にわたって変革的なインテリジェンスを推進する上での大きな進歩であると考えています。
ThinkSystem SR675 V3 構成: Base、Dense、および HGX モジュール
AI/HPC サーバー構成の領域では、さまざまな構成のトレードオフと利点を理解することが、最適化と特定のワークロード要件にとって重要です。 Lenovo ThinkSystem SR675 V3 は、それぞれ特定のニーズに合わせて設計された、Base、Dense、および HGX モジュール構成による柔軟性を提供します。
ベースモジュール
基本モジュール構成は、GPU サポートとストレージ機能のバランスの取れた組み合わせを求める組織に対応します。ダブル幅、フルハイト、フルレングスを最大 4 つまで収納できます。 FHFL GPU、PCIe Gen5 x16 接続を利用。これにより、AI および深層学習のワークロードに適切な並列処理機能が提供されます。
ストレージに関しては、ベース モジュールは最大 8 台の 2.5 インチ ホット スワップ SAS/SATA/NVMe ドライブをサポートし、ストレージのボリュームと速度のバランスを提供します。
高密度モジュール
並列 GPU 処理を優先する組織の場合、Dense モジュールは最大 8 つのダブル幅、フルハイト、フルレングスの GPU をサポートできます。各 GPU は PCIe スイッチ上で PCIe Gen5 x16 を使用するため、単一サーバー上の GPU の数が最大化され、並列処理が強化されます。
ストレージに関しては、Dense Module は多用途です。最大 6 台の EDSFF E1.S NVMe SSD または最大 4 台の EDSFF E3.S 1T NVMe HS SSD をサポートします。この構成は、ストレージの柔軟性を犠牲にして、より多くの GPU を必要とする集中的なデータ処理タスクのシナリオに最適です。
HGXモジュール
HGX モジュール構成は特殊化されており、特定の GPU 要件を持つ高性能ニーズをターゲットとしています。 NVLink 接続された SXM100 GPU を 4 つ備えた NVIDIA HGX H5 を活用します。これらの SXM5 GPU は、シャーシに搭載できる全体の数を制限する可能性がありますが、優れたチップ パフォーマンスを提供するため、要求の厳しい AI およびディープ ラーニング タスクに最適です。
ストレージに関しては、HGX モジュールは速度を重視して最適化されています。最大 4 台の 2.5 インチ ホット スワップ NVMe SSD または最大 4 台の EDSFF E3.S 1T NVMe HS SSD を収容できます。
閉じた思考
ThinkSystem SR675 V3 の各モジュール構成には、独自の強みがあります。 HGX モジュールの SXM5 GPU は比類のないパフォーマンスを提供しますが、より多くの並列処理を必要とする組織は、より多くの PCIe GPU に適合する Dense モジュールを選択できます。ただし、これには TDP 損失と潜在的なパフォーマンス低下という代償が伴います。基本モジュールは中間点を提供し、GPU サポートとストレージ オプションのバランスを提供します。いつものように、最良の選択は、当面のタスクの特定の要件と制約によって決まります。私たちは、これらの構成をラボから追い出すことは決してありません。


 Amazon