

マーベルはFMS 2026において、ハイパースケーラーやクラウドプロバイダーがコンピューティングとは独立してメモリを拡張できるよう支援することを目的とした、新しいメモリインフラストラクチャ技術を発表した。このポートフォリオには、サーバーレベルのAIストレージ、ラック規模のCXLメモリ拡張およびプーリング、ポッドレベルの光共有メモリが含まれる。
今回のリリースは、エージェント型AI推論に伴うメモリ需要の増大に対応するものです。モデルの大型化、コンテキストウィンドウの長期化、キーバリューキャッシュの拡大に伴い、メモリ容量、帯域幅、接続性に対する要求が高まっています。従来のサーバー接続型アーキテクチャでは、こうした要求によってプロセッサの停止やデータ転送の非効率化が発生する可能性があります。

メモリの分離により、メモリをコンピューティングリソースとは独立して拡張、プール化、共有することが可能になります。マーベル社は、このアプローチはメモリへのアクセス性を向上させ、レイテンシとデータ移動を削減し、プロセッサの利用率を高めることを目的としていると述べています。目標は、既存のデータセンターの電力とスペースの制約内で、より多くのトークンを生成することです。
マーベルのカスタムクラウドソリューション担当エグゼクティブバイスプレジデント兼ゼネラルマネージャーであるウィル・チュー氏は、AIインフラストラクチャは、独立したサーバーから、コンピューティング、メモリ、接続性を組み合わせた統合システムへと移行しつつあると述べた。さらに、AI導入におけるリソース利用率の向上とコストおよび電力要件の管理には、より独立したメモリスケーリングが必要だと付け加えた。
サーバーレベルのAIストレージ
Marvell Bravera SC6 PCIe 6.0 SSDコントローラは、高帯域幅メモリとSSDストレージ間でKVキャッシュデータを頻繁に移動させる必要があるAI推論ワークロードをサポートするように設計されています。Marvellによると、このコントローラは前世代のBravera SC5 PCIe 5.0の2倍の速度を実現しています。
SC6はキャッシュ転送性能を向上させることで、AI、クラウド、エンタープライズワークロードにおけるストレージ効率を高めることを目的としています。また、書き込み増幅率の低減とNANDフラッシュメモリの長寿命化も目指しています。複数のサプライヤーのNANDフラッシュメモリに対応しているため、ハイパースケーラーはSSDの調達と導入においてより高い柔軟性を得ることができます。
Bravera SC6は、2026年第4四半期にサンプル出荷を開始する予定です。
ラック規模のメモリ拡張とプーリング
マーベルのStructera Xメモリ拡張ソリューションは、同社の既存のStructera CXLプラットフォームを基盤としており、ハイパースケーラーがより大規模で柔軟なメモリプールを通じて、メモリ集約型のAIワークロードに対応できるよう設計されています。ハイパースケーラーパートナーと共同開発されたこのプラットフォームは、サーバー間でのメモリ拡張とリソース共有をサポートします。
Structera Xは、既存のメモリ投資の利用効率を向上させると同時に、より大規模なモデル、より長いコンテキストウィンドウ、および増加するKVキャッシュ要件に対応することを目的としています。メモリ容量を個々のサーバー構成から分離することで、このプラットフォームは、より適応性の高いCXLベースの拡張およびプーリングアーキテクチャをサポートできます。
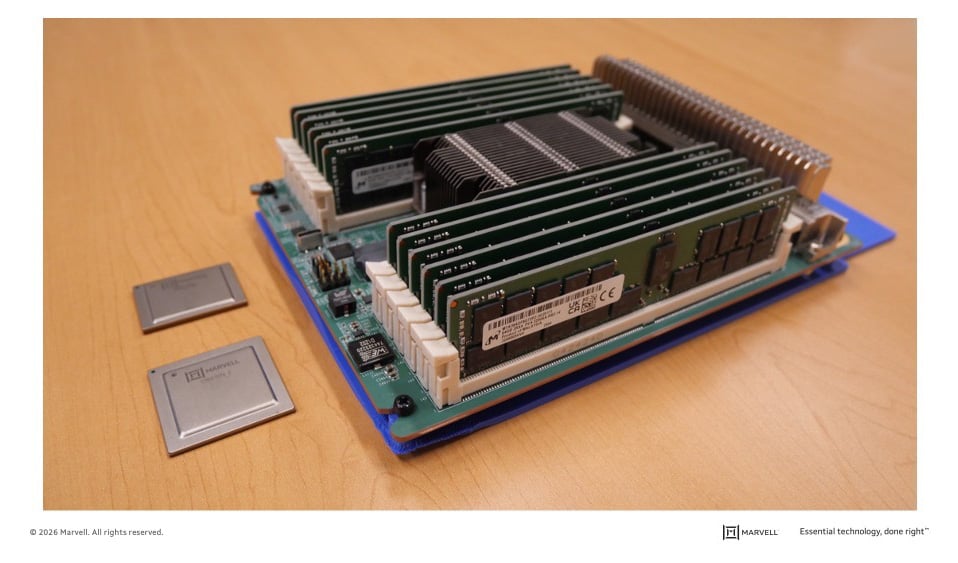
マーベル社によると、このアプローチはインフラ利用率と運用効率を向上させつつ、総所有コストを削減することを目的としている。また、将来のCXLメモリプーリングおよび共有システムの基盤を築くものでもある。
ポッドレベル光共有メモリ
マーベルのフォトニックファブリックの構成要素には、光メモリモジュール、ネットワークインターフェースコントローラ、および複数のラックにまたがる共有メモリアーキテクチャ用のチップレットが含まれます。このシステムは、最大50メートルの距離でXPUとラックを接続するように設計されています。
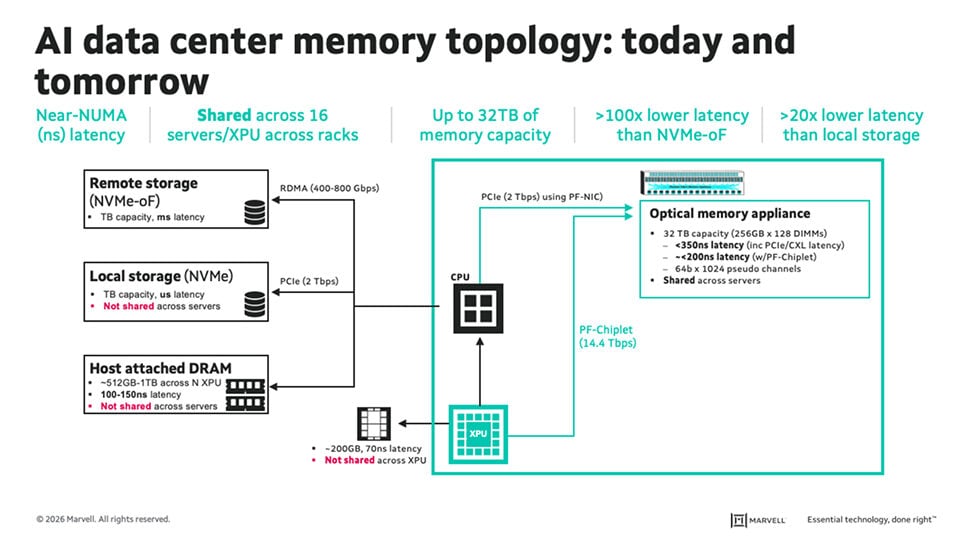
このアーキテクチャは、最大32TBのウォームKVキャッシュオフロードを高帯域幅かつ低遅延でサポートします。AIシステムは、ストレージからKVキャッシュデータを取得する代わりに、共有光メモリ層からデータにアクセスできます。マーベル社によると、これにより推論スループットの向上、より大規模なモデルとより長いコンテキストウィンドウのサポート、トークン効率の向上が可能になるとのことです。
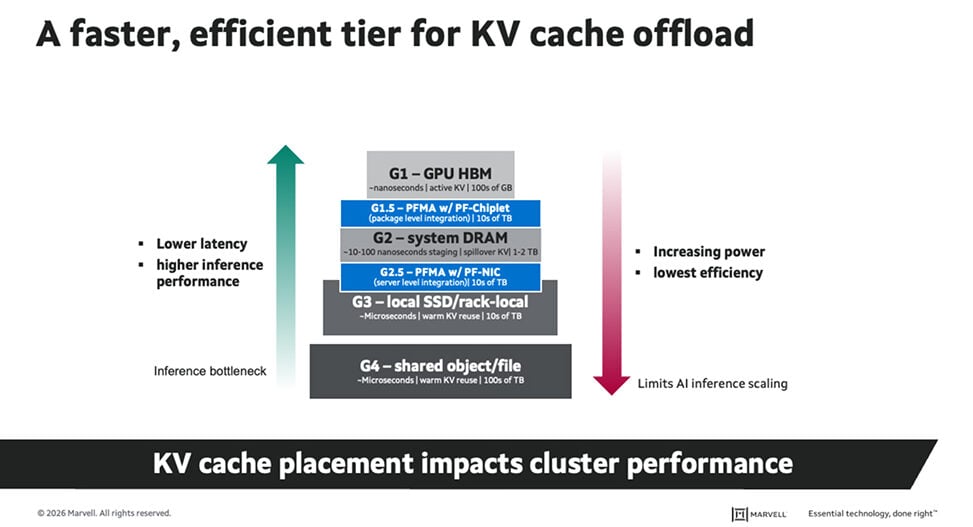
同社は、既存のデータセンターのスペースと電力制約内で、トークン処理能力を最大2~3倍向上させることを予測している。実際のパフォーマンスは、システム構成、ワークロード特性、および周辺のAIインフラストラクチャの実装状況によって左右される。
マーベルは、FMS 2026のブース番号805で製品ポートフォリオを展示している。この発表は、推論メモリ関連のニュースが中心となった週に行われ、NVIDIAのStorage-NextおよびSCADA推進と合致している。マーベルは、このアーキテクチャには100億IOPSを支えるPCIe Gen7 SSDが必要であり、Bravera SC6のようなコントローラは、GPU駆動の小ブロックアクセス向けに設計されたドライブへの足がかりとなると指摘している。


 Amazon