

MinIOは、大規模AI推論環境におけるボトルネックの増大に対処するために設計されたコンテキストメモリストア「 MemKV 」を発表しました。AIStorに次ぐ同社のポートフォリオにおける2番目のコアコンポーネントとして位置づけられるMemKVは、MinIOのデータインフラストラクチャをメモリ層に拡張し、GPUクラスタ全体で動作するエージェント型AIワークロード向けに、永続的で共有可能なコンテキストを提供することを目指しています。
AIシステムが単一応答型の対話から複数ステップの推論とタスク実行へと進化するにつれ、推論サイクル全体にわたってコンテキストを維持することが極めて重要になってきています。現在のアーキテクチャでは、HBMやDRAMといったGPU近傍のメモリ層の容量が限られているため、コンテキストが頻繁に失われます。これにより、GPUは以前に生成されたコンテキストを再計算せざるを得なくなり、レイテンシ、計算リソースの利用率、およびエネルギー消費が増加します。MinIOはこの現象を、特にハイパースケール環境やクラウド環境において、規模が大きくなるにつれて累積する再計算コストと捉えています。
MemKVは、ペタバイト規模でマイクロ秒単位のデータ取得が可能な共有型永続メモリ層を提供することで、この問題を軽減するように設計されています。推論処理全体にわたってコンテキストを維持することで、プラットフォームは冗長な計算を削減し、システム全体の効率を向上させます。MinIOは、社内ベンチマークにおいて、本番環境の並列処理レベルで最初のトークン取得までの時間が改善されたと報告しています。128個のGPUと128Kトークンのコンテキストウィンドウを使用した代表的なデプロイメントでは、GPU利用率が約50%から90%以上に向上し、年間計算コストの大幅な削減につながりました。
MinIOの経営陣は、再計算のオーバーヘッドはこれまで小規模な導入では目立たなかったものの、大規模になると構造的な非効率性になると指摘した。GPUクラスタが拡大するにつれ、コンテキストを繰り返し生成するコストは消費電力とインフラ要件の両面で増加し、持続可能なAI運用には専用のメモリシステムが必要となる。
メモリ規模のトレードオフへの対処
従来のAIインフラストラクチャでは、速度と拡張性のトレードオフが生じます。HBMやDRAMといった高性能メモリ層はマイクロ秒単位の低遅延を実現しますが、容量に制約があり高価です。一方、ストレージシステムは拡張性に優れていますが、ミリ秒単位の低遅延が発生するため、リアルタイム推論や長期コンテキスト推論には適していません。
MemKVは、低遅延アクセスと大容量を兼ね備えた共有メモリ層を導入することで、このギャップを埋めるように設計されています。NVIDIA BlueField-4 STX上で動作するように構築され、NVIDIA DynamoおよびNIXLと統合されたこのプラットフォームは、GPUクラスタ全体が推論要件に合わせた速度で共通のコンテキストデータプールにアクセスできるようにします。このアプローチにより、異なるメモリ層とストレージ層間でコンテキストを転送する必要がなくなり、遅延が削減され、スループットが向上します。
推論ワークロードに最適化されたアーキテクチャ
MemKVは推論データパス専用に設計されており、GPUメモリ階層におけるMinIOのG3.5レイヤーの説明に準拠しています。NVMeベースのインフラストラクチャ上でペタバイト規模の容量を実現しながら、マイクロ秒レベルのアクセス特性を維持し、メモリ規模とGPUコンピューティングリソースを効果的に分離します。
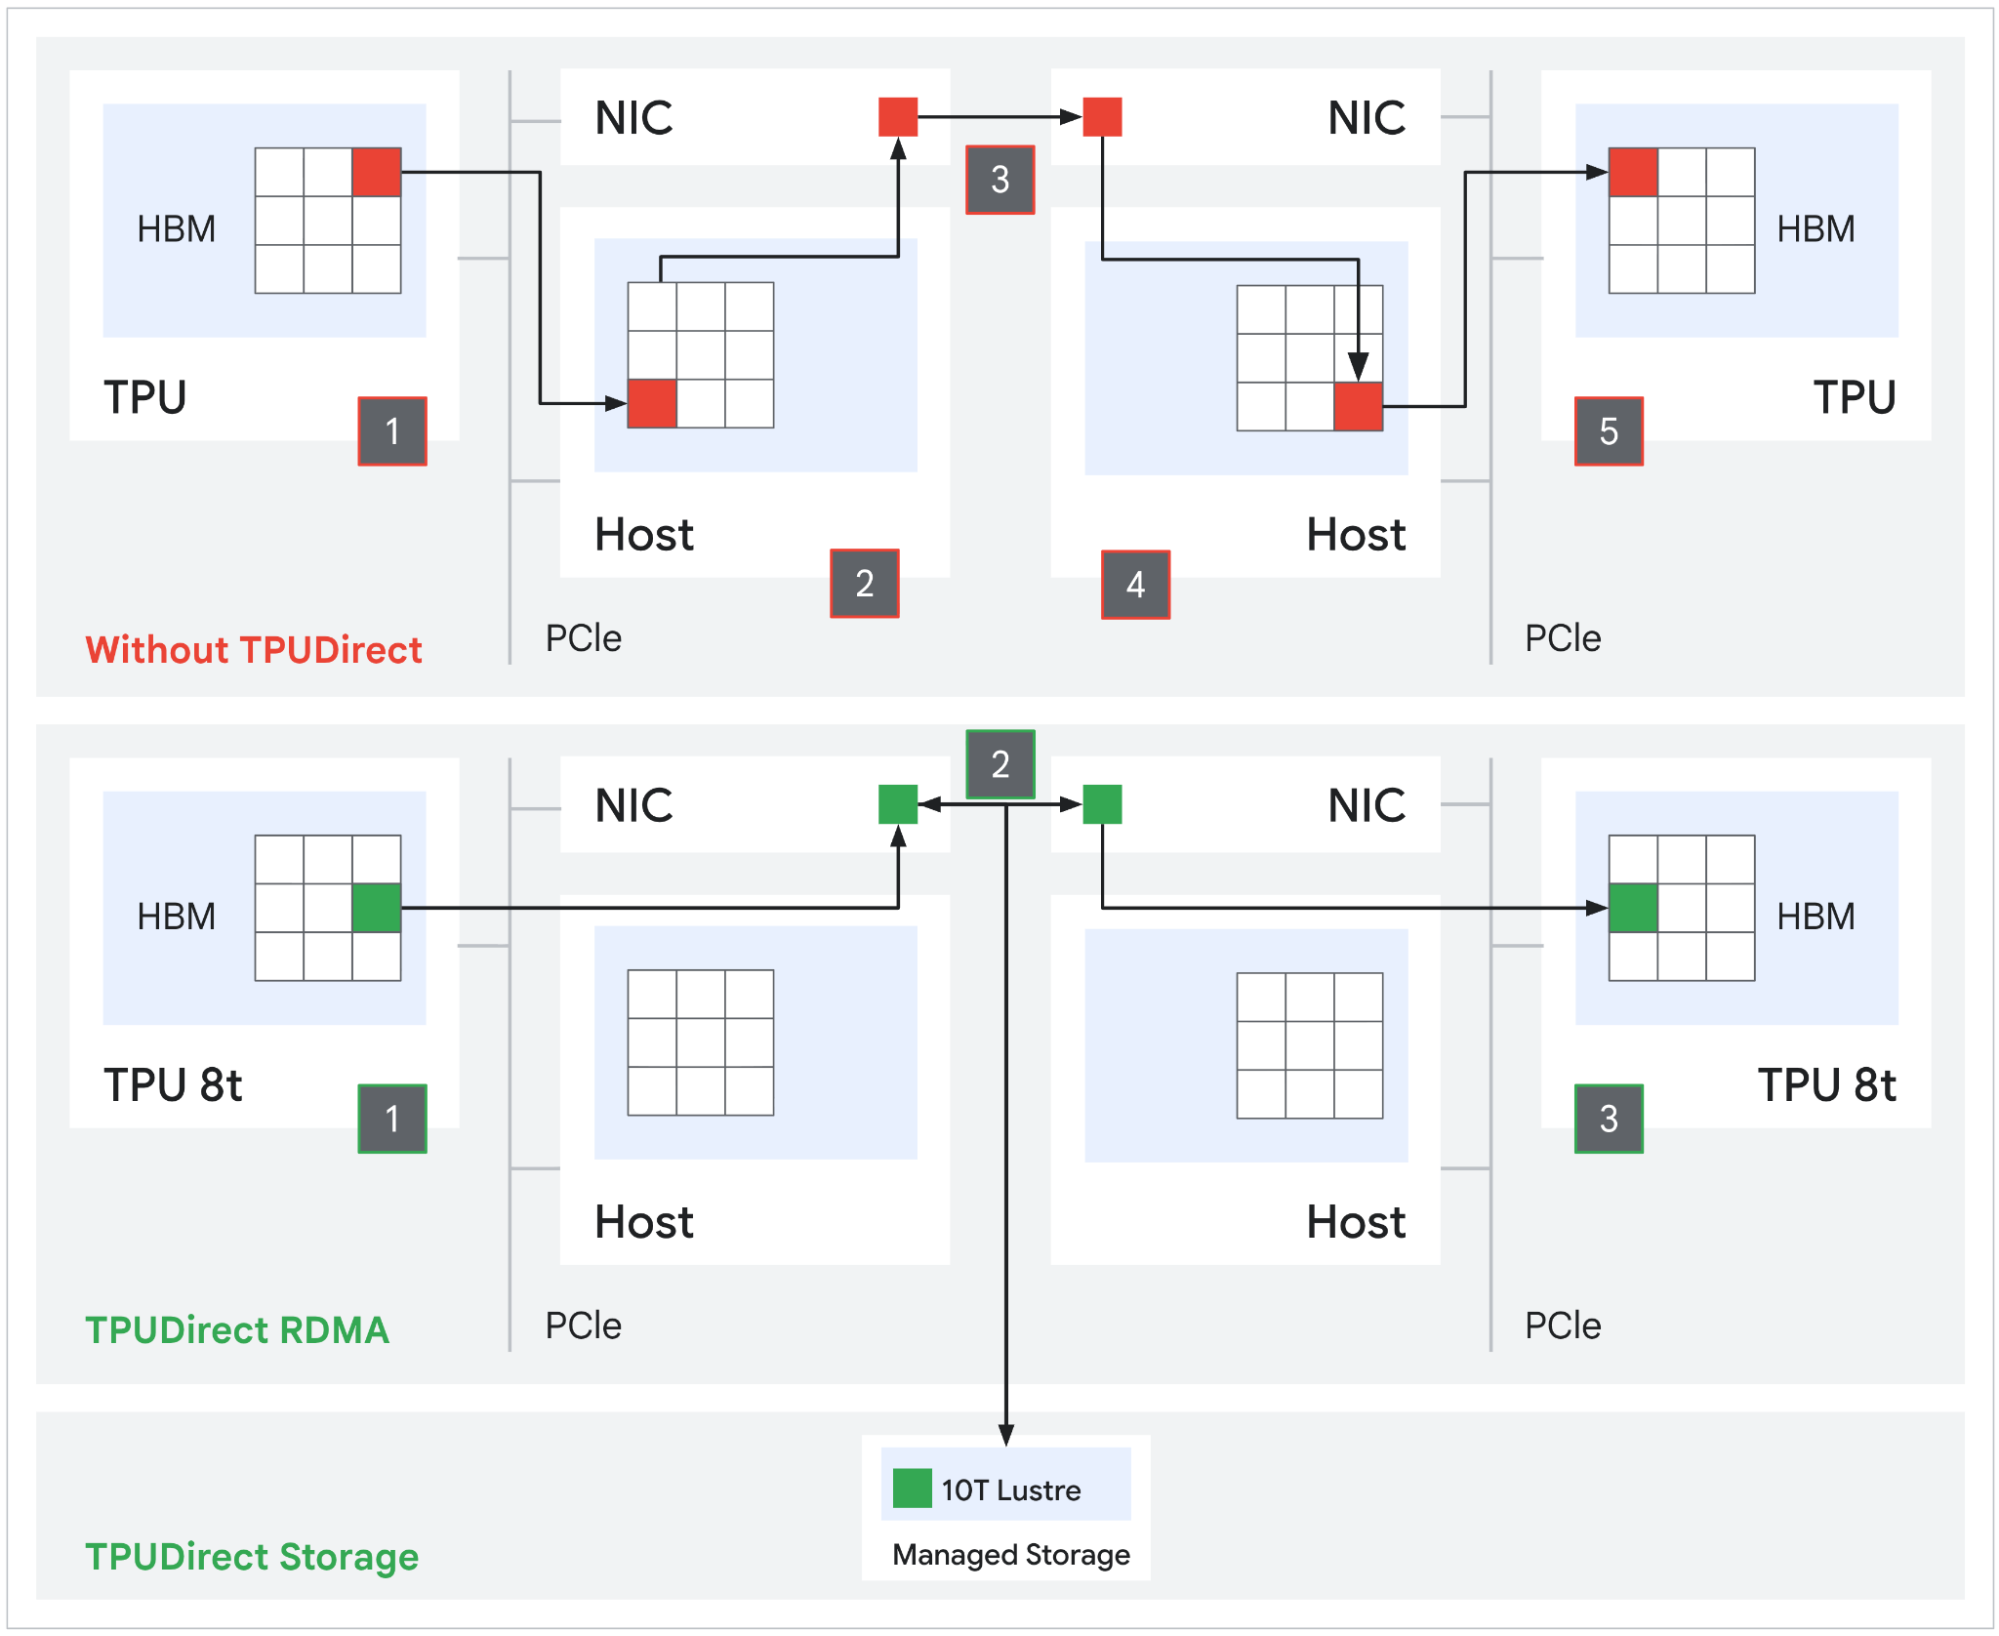
このシステムは、エンドツーエンドのRDMAトランスポートを介してNVMeからAIデータパスへデータを直接転送することで、従来のストレージ抽象化を回避します。これにより、オブジェクトベースおよびファイルベースのアーキテクチャで一般的なHTTPプロトコル、ファイルシステム変換、中間ストレージサーバーによるオーバーヘッドが排除されます。
出典:グーグル
主要なアーキテクチャ要素としては、ストレージ層に組み込まれたARM64バイナリとしてNVIDIA BlueField-4 STX上でネイティブ実行することで、外部のx86ストレージノードへの依存度を低減しています。データ転送は、従来のストレージスタックを介さずに、GPUメモリからNVMeへRDMAで行われます。また、MemKVは、従来の4KBストレージブロックではなく、GPUスループットパターンに最適化された2MBから16MBまでのより大きなブロックサイズを使用しています。ネットワーク性能は、NVIDIA Spectrum-X EthernetやPCIe Gen6などの最新の高速ファブリックに対応しており、クラスタ全体でほぼワイヤースピードのデータ転送を実現します。
利用状況
MinIO MemKVはすぐに利用可能です。


 Amazon