

MLCommons は MLPerf Inference v6.1 を公開しました。今回のテストでは、30 の提出組織と 486 のデータセンターおよびエッジの結果が集まり、参加記録を更新しました。新たに 2 つのテストが追加されました。データセンター向けの End-to-End RAG パイプラインと、シングル ユーザー デバイス向けの Edge Agentic Inference ベンチマークです。また、NVIDIA の Vera Rubin NVL72、AMD の Instinct MI350P、Intel の Arc Pro B70、AMD の Ryzen AI Max+ 395 のピア レビュー済み数値が初めて掲載されました。改善ペースについて、MLCommons は、サーバー シナリオにおけるアクセラレータごとの DeepSeek-R1 のベスト 結果は、1 年前の v5.1 と比べて 5.7 倍向上し、VLM のベスト 結果は v6.0 から 6 か月で 2.99 倍向上したと述べています。
2つの新しいテスト:エンドツーエンドRAGとエッジエージェント推論
エンドツーエンドのRAGベンチマークは、複数のモデルとベクトルデータベースが連携して動作する完全な質問応答パイプラインを測定します。リファレンス実装では、4つのモデルが連携して実行されます。gpt-oss-120Bはクエリの分解、十分性チェック、および回答生成を処理します。gpt-oss-20Bは取得したドキュメントを評価します。e5-base-v2は埋め込みを生成します。ColBERTv2はパッセージを再ランクします。コーパスは、2,515個のHTMLファイルからチャンク化された107,484のパッセージで構成されています。質問は、GoogleのFRAMESデータセットからの824個のマルチホップタスクです。各タスクは、パイプラインが十分な証拠があると判断するまで、最大5回の検索ラウンドをループできます。2つの指標が出力されます。FAISS HNSWベクトルデータベースを構築するための1秒あたりのドキュメント数と、それに対して質問に答えるための1秒あたりのタスク数です。Llama 3.1-8Bジャッジが、97%の精度目標に対して最終的な回答を採点し、ジャッジに時間はかかりません。
Edge Agentic Inference ベンチマークは、ワークステーションやデスクトップ AI ボックスに移行したコーディング アシスタント パターンを対象としています。モデルは、思考をオフにした Qwen3.6-27B で、リファレンスの llama.cpp の下で Q4_K_M GGUF として実行され、1 ターンあたり 32K のコンテキスト ウィンドウが提供されます。パフォーマンス ワークロードは、SWE-bench Verified から抽出された 20 個のエージェント コーディング ジェクトリの記録されたリプレイで、合計 1,007 ターン、ラップトップ上の開発者がエージェントを実行する方法と同様に、1 つのリクエストが進行中の単一ストリームで駆動されます。報告されるメトリックは、1 ターンあたりの平均レイテンシで、最初のトークンまでの時間と出力トークンあたりの時間の分布が併記され、精度は、リファレンス スコアの 97% で BFCL v4 によって個別にゲートされます。MLCommons は、近日公開予定の MLPerf Agentic データセンター ベンチマークからフレームワークを適応させました。
「クエリ応答は、コーパスで学習させたLLMの域を超えて進化していることは明らかです。関係者は、現在構築されているような、複数のステップと複数のコンポーネントからなるパイプラインの実際のパフォーマンスを理解する必要があります」と、MLPerf推論ワーキンググループの共同議長であるミロ・ホダック氏は述べています。「同様に、エージェント特性を持つ複雑な推論システムがエッジコンピューティングデバイス上でホストされることが増え、お客様が現在直面している新たなパフォーマンス上の課題が生じているため、エッジエージェント推論テストを追加しました。」
今回のラウンドでは、これまでDeepSeek-R1に限定されていた投機的デコードのサポートを、インタラクティブシナリオにおけるGPT-OSSベンチマークにも拡張し、応答時間を約1.5秒とするVLMテスト用の新しいインタラクティブシナリオを定義しました。
デスクトップからラックまで、新しいシリコン
NVIDIAのVera Rubin NVL72が、NVIDIAとNebiusがVR200 NVL72で提出したプレビューカテゴリでMLPerfに初登場しました。NVIDIAは、TensorRT-LLMを使用したオフライン、サーバー、インタラクティブシナリオ全体で、DeepSeek-R1においてGB300 NVL72よりも最大2.5倍高いトークンスループットを実現し、NVIDIA Dynamoを使用したvLLMによるQwen3ビジョン言語モデルでは最大3.7倍のスループットを実現したと報告しています。これらはNVIDIAが自社の前世代と比較した数値であり、プレビュー指定は、このプラットフォームが次回のラウンドまでに商用利用可能になる見込みであることを意味します。
AMDは、MLPerf Inference 6.1への提出対象を、言語、推論、テキストからビデオへの変換、および推薦タスクにわたる6つのモデルファミリーに拡大し、Instinct MI355X、MI350X、および新しいMI350P PCIeカードを展開しました。MI355X上に構築された512個のGPUで構成されるCrusoeクラスタについては、AMDによる今回のラウンドの詳細な分析とともに、以下で説明します。
IntelのArc Pro B70は、IntelがLlama 3.1-8B、Llama 2-70B、gpt-oss-120B、Whisper、および新しいE2E-RAGテストに使用した、合計128GBのVRAMを備えた4つのGPUノードに登場します。Intelは、同じハードウェア上で、gpt-oss-120Bがv6.0と比較してサーバーで36%、オフラインで27%向上したと報告しています。CPU側では、Intelは、Xeon 6980P Llama 3.1-8Bサーバーのスループットが、同じシリコン上でv6.0から2.4倍に上昇したと述べています。これはソフトウェアのみによる向上です。
Ryzen AI Max+ 395 は、今回初めて提出した Atlas Inference によって公開されました。Atlas Inference は、同じエンジンと量子化レシピを使用して、NVIDIA DGX Spark と AMD Strix Halo デスクトップの両方で新しい Edge Agentic ワークロードを実行しました。Atlas は、DGX Spark で毎秒 20.1 トークン、64 分未満で 1,007 ターンすべてを完了し、Strix Halo では毎秒 19.63 トークンと報告しています。これは、Ryzen AI HaloとDGX Spark のレビューで市販のランタイムを使用して 2 つのプラットフォーム間で測定した差よりも小さく、新しいベンチマークが明らかにするように設計されている種類の結果です。
より大きく、より多様で、より分散化されている
マルチノードの提出数は、v4.0 のゼロから今回のラウンドで記録を更新し、3 つの提出が際立っています。 初めて提出した Crusoe は、AMD を使用して MLPerf 推論の歴史上最大のシステムを実行しました。標準 RoCE Ethernet ファブリック上の 64 ノードにわたる 512 個の Instinct MI355X GPU が gpt-oss-120b と DeepSeek-R1 に提出されました。 AMD は、このクラスターから gpt-oss-120b でオフライン シナリオで毎秒 5.75 万トークン、サーバーで毎秒 5.39 万トークン、DeepSeek-R1 でオフラインで毎秒 2.90 万トークン、サーバーで毎秒 2.41 万トークンを報告しており、AMD はこれを MLPerf の歴史上最高の集計トークン スループットと呼び、スループットは 1 ノードから 64 ノードまでほぼ線形にスケーリングします。 gpt-oss-120b の実行では、ネイティブ MXFP4 で 512 個の独立したシングル GPU レプリカとしてモデルが使用されました。 DeepSeek-R1は、ノードごとに8つのGPUレプリカを1つ使用したSGLangを採用しました。AMDは、72個のGPUを使用したGPT-OSS-120Bの提出について、スケーリング効率95%、毎秒100万トークンという結果を別途報告しており、これはv6.0でMI355Xで達成したのと同じ見出しです。
Cisco は、ベンチマークで初めてベンダーをまたがる異種システムを提出しました。これは、8 基の NVIDIA H200 GPU と 8 基の AMD Instinct MI350X GPU を Cisco Silicon One G200 ファブリック上の単一の推論プールにプールしたもので、同社のSecure AI Factoryで販売している混合アクセラレータ方式と同じです。地理的に分散したエントリーは、MangoBoost と Dell によるもので、太平洋をまたぐ 2 大陸の 4 つのサイトが MangoBoost、Dell、TensorWave、および Microsoft Azure によってホストされ、MangoBoost が 97% のスケーリング効率と報告する単一のエンドポイントとして動作しています。MangoBoost はまた、AMD Instinct GPU で初めてプリフィル/デコード分離結果を達成したと主張しています。
その他の結果では、CoreWeave は GB300 NVL72 で合計 1.16 万トークン/秒を達成し、GPU ごとのオフライン スループットは v6.0 以降 17% 向上したと報告しています。HPE は、Blackwell Ultra を搭載した 2 台の Compute XD690 サーバーで DeepSeek-R1 の GPU あたり 8,500 トークン/秒を達成したと述べています。Google は、業界が大規模な専門家混合モデルに移行していることを挙げ、DeepSeek-R1 に焦点を当てて提出しました。gpt-oss-120b には 112 件の提出があり、これはどの MLPerf ワークロードよりも多い数です。
AMDの2つのCDNA 4フォームファクター:OAMとデュアルスロットPCIe
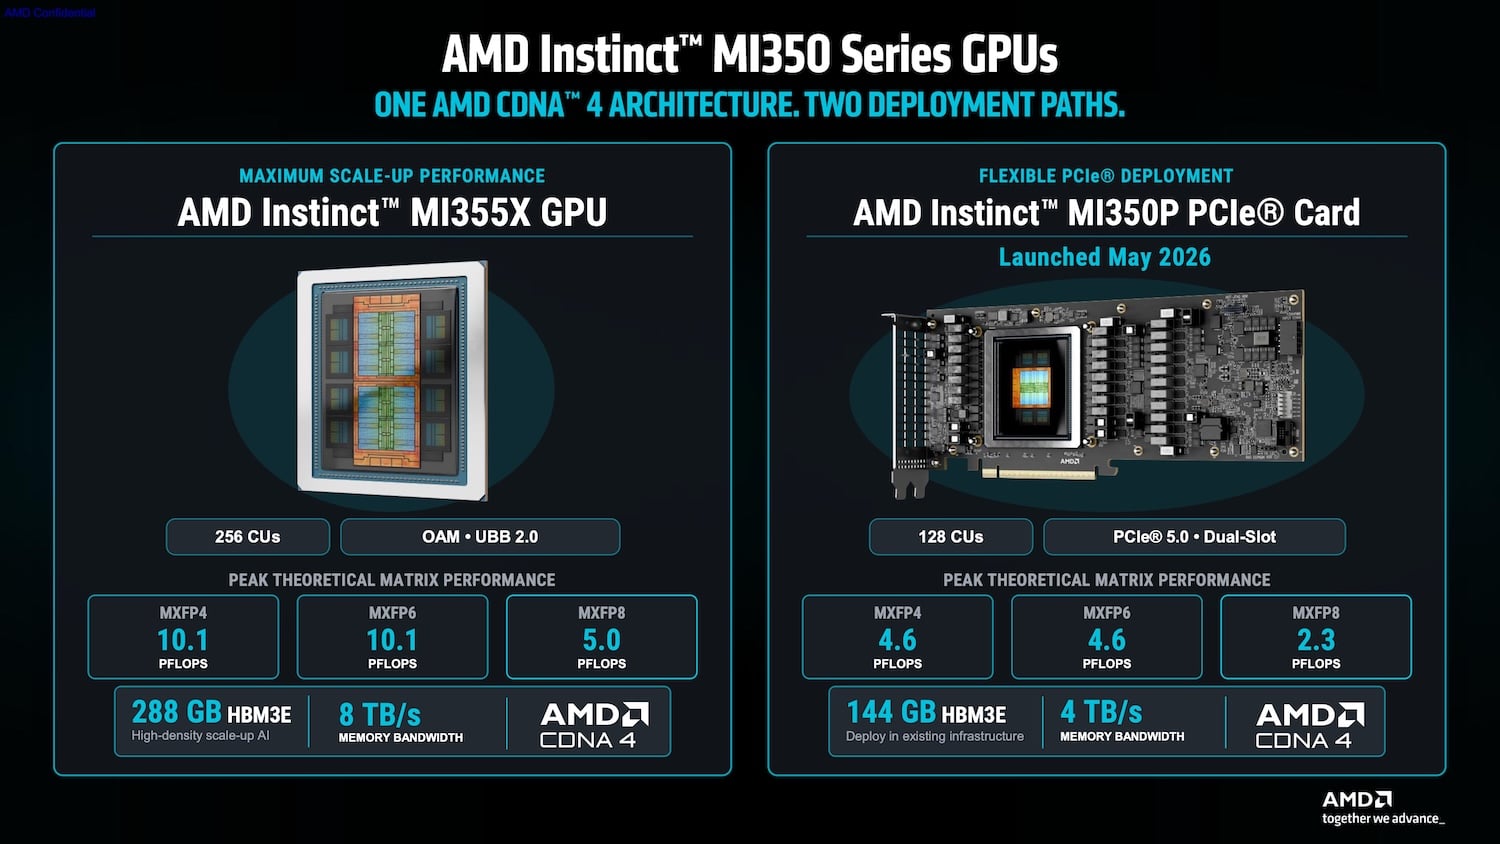
AMDのCDNA 4アーキテクチャは、データセンターの電力と冷却に関する特定の制約を満たすために、2つの物理的なフォームファクタで提供されています。フラッグシップのInstinct MI355Xは、OCPユニバーサルベースボード(UBB 2.0)プラットフォーム上のOAMフォームファクタを使用して高密度コンピューティングノードをターゲットとしており、256個の演算ユニット、288 GBのHBM3Eメモリ、および合計8 TB/sのメモリ帯域幅を提供します。理論上のピークMXFP4およびMXFP6マトリックス演算で最大10.1 PFLOPSを実現します。新しく導入されたInstinct MI350Pは、同じCDNA 4シリコンを標準的なエンタープライズシャーシ用のデュアルスロットPCIe 5.0アドインカードに採用しており、128個の演算ユニット、144 GBのHBM3Eメモリ、4 TB/sの帯域幅を備え、理論上のピークMXFP4およびMXFP6マトリックス性能で最大4.6 PFLOPSを実現します。
同一シリコン上でのソフトウェア主導による世代間性能向上
AMD ROCm v7 のソフトウェア最適化により、単一の MLPerf サイクル中に同一の MI355X ハードウェアで測定可能なスループット向上を実現しました。8 つの GPU を搭載した MI355X ノードでのテストでは、オフライン シナリオで GPT-OSS-120B スループットが 28%、サーバー シナリオで 38% 上昇し、Wan-2.2 SingleStream パフォーマンスが 70% 向上しました。クラスタ規模では、MLPerf 6.1 の 72 台の MI355X アクセラレータが、ラウンド 6.0 で報告された 94 台の GPU 構成よりも高い合計 GPT-OSS-120B スループットを達成しました。AMD が公開した競合比較では、8 台の GPU を搭載した MI355X が GPT-OSS-120B で NVIDIA B200 および B300 に対して提出結果をリードし、72 台の GPU を搭載したクラスタが NVIDIA の GB200 提出結果をリードしました。
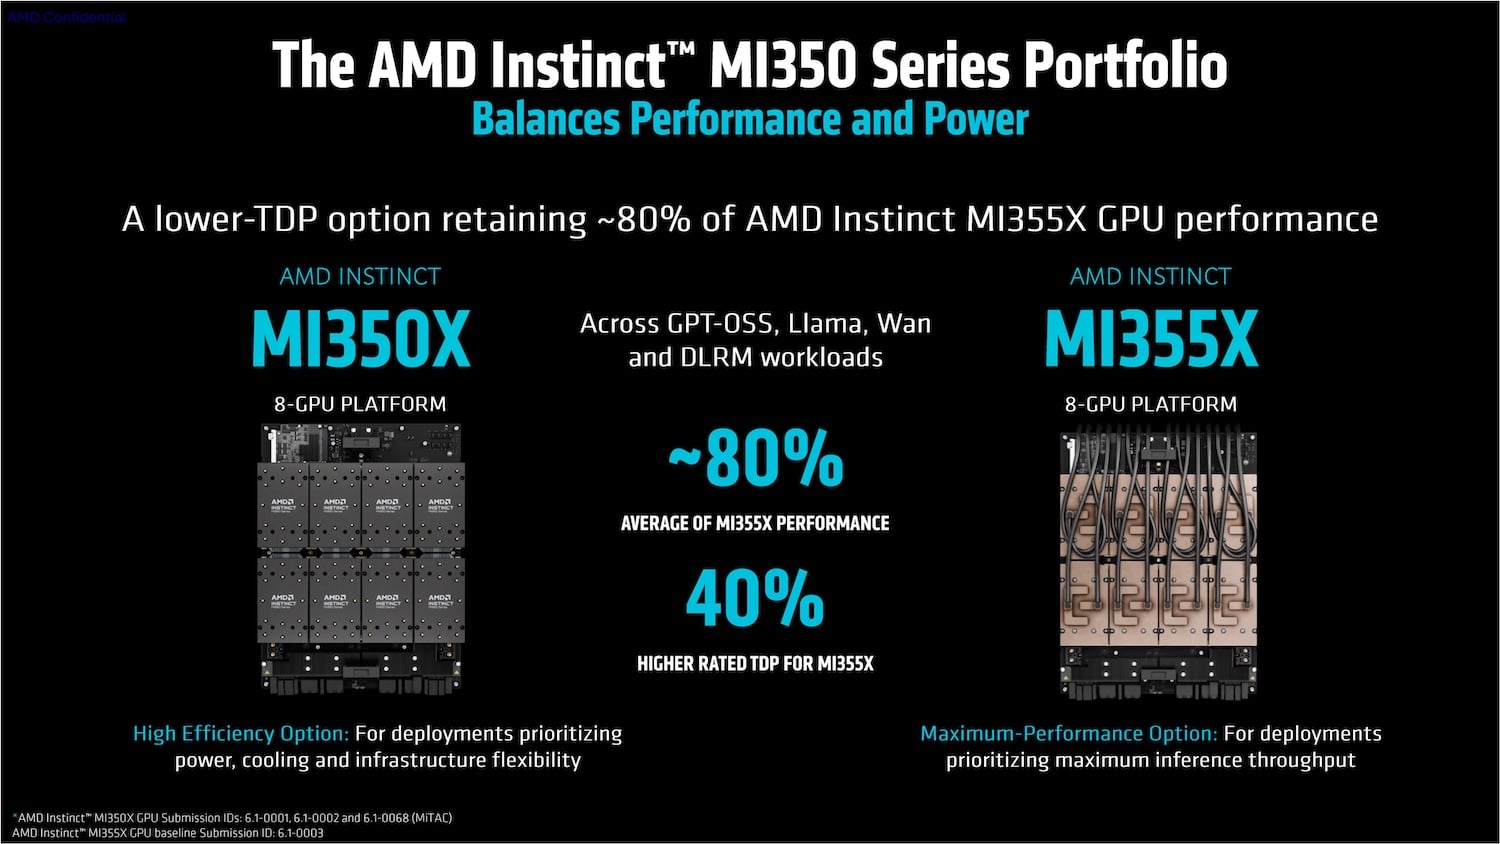
最初の MLPerf ラウンドで、デュアル スロットの MI350P は 5 つのクローズド ワークロードで提出し、NVIDIA RTX PRO 6000 Server Edition および H200 NVL の選択された提出に対して優れた結果を記録しました。電力と冷却予算に敏感な展開の場合、8 つの GPU を搭載した MI350X システムは、GPT-OSS、Llama、Wan、および DLRM ワークロード全体で MI355X プラットフォームのベンチマーク パフォーマンスの約 80% を維持しましたが、MI355X は定格 TDP が 40% 高くなっています。Signal65 が委託した調査では、これらのスループットの数値は、固定レイテンシ制限内でドキュメントあたりの運用コストの削減とドルあたりのトークン出力の増加につながると報告されています。
AMDパートナーの業績と韓国・米国間の事業展開
AMDによると、デル・テクノロジーズ、オラクル、ヒューレット・パッカード・エンタープライズ、スーパーマイクロ、マンゴーブースト、クルーソー、MiTACの7社のパートナー企業から提出されたMI355Xの同等のテスト結果は、平均してAMDのリファレンスシステムの結果の4%以内の誤差に収まり、一部のテスト結果はリファレンスシステムの結果と同等か、わずかに上回ったという。
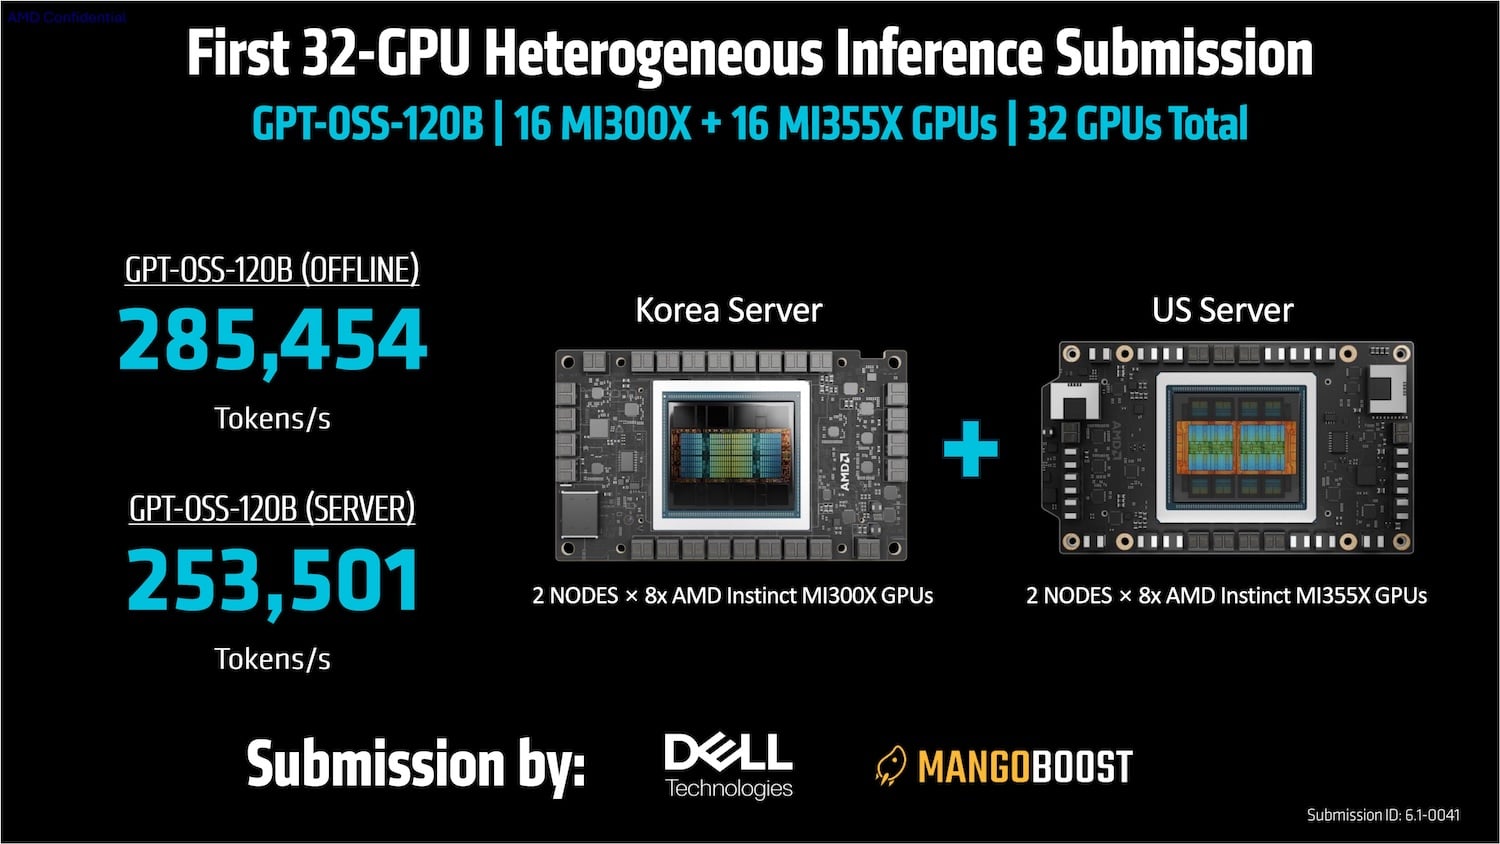
上記のMangoBoostとDellのエントリーは、ベンチマーク初の異種32GPUサービング構成であり、韓国の16個の旧世代Instinct MI300X GPUと米国の16個のInstinct MI355X GPUを統合して、統一されたGPT-OSS-120Bエンドポイントを構築しています。このスプリットクラスタ構成では、オフライントークンが毎秒285,454個、サーバートークンが毎秒253,501個生成されました。提出されたデータはROCm 7で実行されました。AMDは、HBM4ベースのMI400シリーズとそれに続くMI500世代の先駆けとして、vLLM、SGLang、ROCm.AIプロファイリングツールを備えたROCm 10リリースを挙げています。
データセンターにおけるMLPerf推論を置き換えるハーネス
今回のラウンドでは、30の提出者のうち16人がMLPerfのAPI中心のハーネスを使用しました。これは、v6.0のオープン部門提出者が1人だったのと比べて大幅な増加です。このハーネスは、ホストされたエンドポイントに対して標準APIを介して真のクライアント/サーバー構成を実行します。これは、データセンター推論が展開される方法です。また、既に新しいEdge Agenticテスト、VLM-Interactive、gpt-oss、DeepSeek-R1、Llama 3.1-8B、およびtext-to-videoに対応しています。これはMLPerf Endpointsの基盤であり、2026年1.0月にオンデマンドのローリング提出を開始し、2027年にはデータセンターベンチマークとしてMLPerf Inferenceに取って代わります。Endpoints v1.0では、正規化された結果と拡張されたエージェントワークロードが計画されています。
「今後、MLPerf Endpointsは、データセンター向けベンチマークファミリーにおいてInferenceに取って代わることになります。API中心のハーネスが急速に普及することで、この移行がスムーズに進むでしょう」と、MLPerf責任者のDavid Kanter氏は述べています。今回のラウンドで初めて提出したのは、Atlas Inference、Crusoe、Orrick Industries、ScitiX、VibeHPC、そしてハーバード大学ケンプナー研究所の個人貢献者であるNaeem Khoshnevis氏の6名で、Khoshnevis氏はH200を1台使用したLlama 3.1-8Bの結果を個別に提出しました。
推論ラウンドは、2週間前に公開されたMLPerf Storage v3.0の結果に続くもので、データセンターとエッジの完全な表、および提出者による補足資料は、MLCommonsの結果ページで入手できます。


 Amazon