

Supermicroは本日、IBMおよびNVIDIAと共同で、長コンテキスト推論の背後にあるキーバリュー状態をGPUから共有オールフラッシュ層に移すKVキャッシュストレージソリューションを発表しました。このパッケージは、AMD EPYC 9005プロセッサを搭載したSupermicro Petascaleストレージサーバー、IBM Storage Scale、NVIDIA Dynamo、およびNVIDIA Spectrum-X Ethernetを組み合わせたもので、IBMがRedbookとして公開した検証済みのリファレンスアーキテクチャによって裏付けられています。注目すべき数値は、コンテキストを最初から再計算するGPUに対して13万トークンのプロンプトで最初のトークンを取得するまでの時間が56分の1に短縮されるというものです。
KVキャッシュにストレージ層が必要な理由
推論は2つのフェーズで実行されます。まず、プリフィルフェーズではプロンプトをトークンに変換し、それらをモデルに通して中間的なキーバリュー状態を生成します。次に、デコードフェーズでは、これらの状態に対してトークンを1つずつ生成して応答を生成します。キーバリュー状態を永続キャッシュに保持することで、システムはそれを次のターン、次のエージェントステップ、または同じコンテキストを共有する次のリクエストで再利用し、再計算をスキップできます。
エージェントワークフロー、コーディングアシスタント、ロングコンテキストRAG、およびマルチターンアプリケーションは、GPUとCPUメモリをすぐにオーバーフローさせるのに十分な量のこの状態を生成するため、Supermicro、IBM、およびNVIDIAはネットワークストレージ層を開発している。
この設計では、NVIDIA Dynamoがキャッシュ階層を管理し、NIXLを介してブロックを移動します。IBM Storage Scale Erasure Code Editionは共有ファイル層を提供し、ペタスケールサーバーはフラッシュメモリとその背後にあるPCIe Gen5レーンを提供します。Supermicroは、3社がクラスタレベルで高同時実行性とノイズの多い近隣ネットワークトラフィックの下でスタックをテストしたと述べており、その結果を工場でのラック統合とオンサイトでの展開によるターンキー構築として売り込んでおり、展開時間を数週間から数日に短縮できるとしています。
テスト済み構成
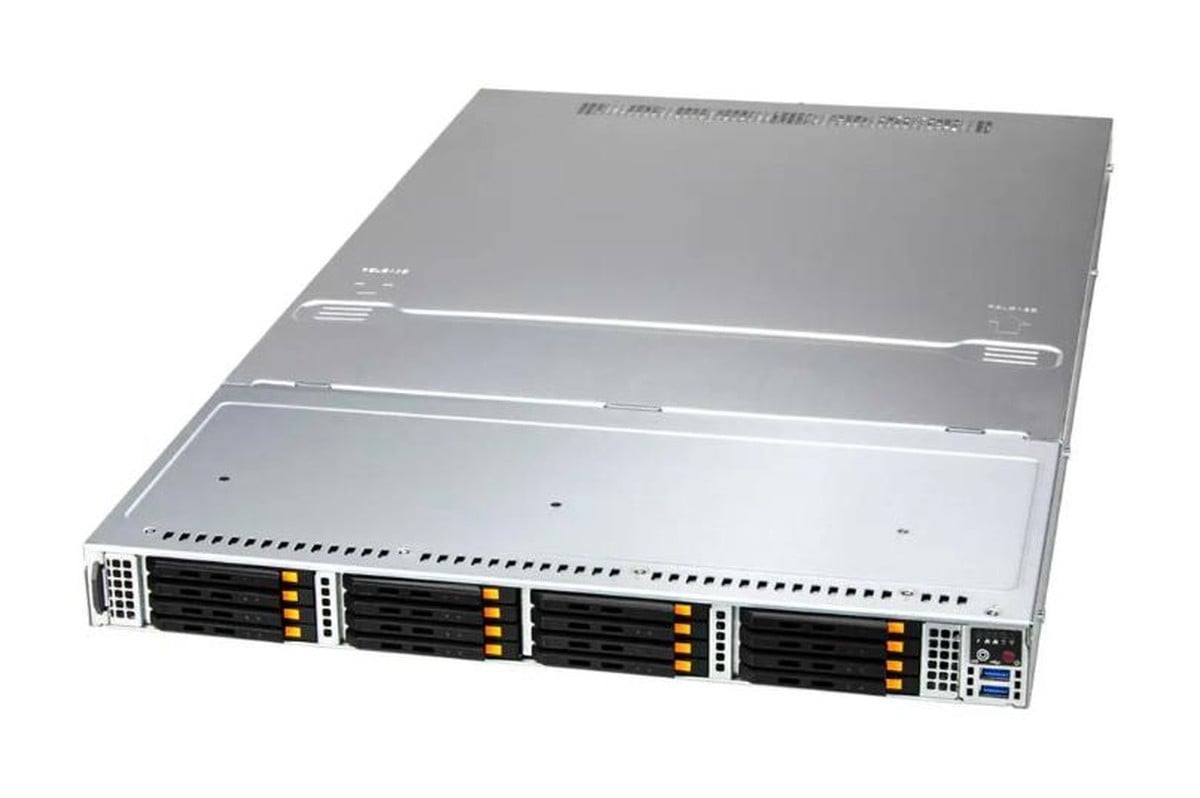
リファレンスアーキテクチャでは、Supermicro ASG-1115S-NE316R ペタスケールノードを8台使用しています。各ノードは1Uシステムで、AMD EPYC 9535プロセッサ1基とMicron 7.68TB E3.S NVMeドライブ16台を搭載しており、各ノードに122.88TB、8台合計で約983TBのフラッシュメモリが搭載されています。各ノードは、クライアント側にデュアルポート200Gb NVIDIA BlueField-3 B3220、ストレージバックエンドに400Gb ConnectX-7を搭載し、3台のSpectrum-X SN5600スイッチをスパイン&リーフ構成で配置し、800Gb/sのアップリンクを備えています。
ストレージノードはRHEL 9.6とIBM Storage Scale ECE 6.0.0.1を8+2Pイレイジャーコード構成で実行しており、IBMは以前のテスト結果に基づき、この8ノード構成の読み取りスループットを315GB/秒としている。
| 成分 | KVキャッシュ参照アーキテクチャ(テスト済み) |
|---|---|
| ストレージ層 | |
| ストレージノード | Supermicro ASG-1115S-NE316R (1U、シングルソケット) 8台 |
| ノードあたりのCPU数 | AMD EPYC 9535、PCIe Gen5 128レーン(NVMe用64レーン、ネットワーク用64レーン) |
| ノードごとのフラッシュ | Micron製 7.68TB E3.S NVMe SSD 16台 (実容量122.88TB) |
| ノードごとのネットワーク | NVIDIA BlueField-3 B3220、デュアルポート200Gb(クライアント側) NVIDIA ConnectX-7 400GB(ストレージバックエンド) |
| 切り替え | NVIDIA Spectrum-X SN5600 3基、スパイン&リーフ構成、800Gb/sアップリンク |
| ストレージソフトウェア | IBM Storage Scale Erasure Code Edition 6.0.0.1、8+2P RHEL 9.6 |
| 推論クライアント | |
| システム | Supermicro SYS-212GB-FNR (NVIDIA MGX)、Ubuntu 24.04 |
| ベンチマークに使用したGPU | NVIDIA RTX PRO 6000 Blackwell 1基、重み付けとCUDAグラフ処理後、KVキャッシュ用に19.6GiBの空き容量あり |
| 顧客ネットワーク構築 | NVIDIA BlueField-3 B3140H 400Gb/s 2基、最大80GB/sのクライアント向け帯域幅 |
| モデルとソフトウェア | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 (NIXL対応) NVIDIA AIPerfベンチマーククライアント |
| キャッシュの階層化 | ホスト層とローカル層はゼロに設定されています。キャッシュされた1.4万個のトークンはすべてストレージスケール層から提供されます。 |
ベンチマークのクライアントは、Supermicro SYS-212GB-FNR MGX システム 1 台で、そのシステムに搭載された NVIDIA RTX PRO 6000 Blackwell GPU 1 台が、vLLM 0.14.1 および Dynamo 0.9.0 環境下で MXFP4 の openai/gpt-oss-120b モデルを実行した結果です。
重みとCUDAグラフの処理後、KVキャッシュ用に19.6GiBのGPUメモリが残され、GPU自体に約1.14万トークンを格納するのに十分な容量となりました。テストでは、ホストメモリとローカルティアをゼロに設定し、キャッシュされたブロックはすべてStorage Scaleから返されるようにしました。そのため、結果は混合階層の助けを借りずに、ストレージパス自体を測定しています。
最初のトークン取得までの時間で56倍、スループットで22倍
キャッシュがない場合、120B モデルの最初のトークンまでの時間は、入力トークンが 10,000 の場合の 0.572 秒から、GPU がコンテキスト全体を再計算した 130,000 の場合の 32.14 秒に増加しました。ストレージ スケールの KV キャッシュを使用すると、TTFT は同じ範囲で 0.193 秒から 0.57 秒の間に留まり、これは 130,000 トークンの時点で 56 倍の数値であり、Supermicro が発表で引用している 0.377 秒の差です。これらのテストは IBM、Supermicro、および NVIDIA が実行したものであり、弊社は実行も結果の監査も行っていません。
スループット テストでは、28 の同時接続で 200 件のリクエストを送信しました。これは、合計 24 万トークンと 825GB の KV キャッシュ データを含む 100 個の固有のプロンプトから抽出されたもので、キャッシュは空の状態から開始しました。再計算ベースラインは 1,048 秒で毎秒 0.19 件のリクエストで終了しました。ストレージ スケール ティアは 46.94 秒で毎秒 4.26 件のリクエストで終了し、キャッシュを埋めるためのコールド スタート コストを含めて 22 倍の性能向上となりました。
3回目のテストでは、同じファブリック上で200GB/sの無関係なネットワークトラフィックを送信するクライアントを4台追加しました。キャッシュ構成では、1秒あたり3.6件のリクエストが保持され、200件のリクエストの処理時間は55.56秒でした。これはクリーンな状態でのテストより約9秒遅く、ベースラインの18倍の速度です。IBMはこのわずかなパフォーマンス低下は、Spectrum-Xファブリックがキャッシュトラフィックをバックグラウンド負荷から分離しているためだと考えています。
「エージェント型AIやロングコンテキストアプリケーションは、多くのステップにわたってコンテキストを効率的に再利用することに依存しており、NVIDIA Dynamoは分散推論のオーケストレーションを支援することで、企業が各GPUからより多くの実用的なスループットを得られるようにします」と、NVIDIA AI推論製品リーダーのシュルティ・コパルカー氏は述べています。「NVIDIA DynamoとSpectrum-X EthernetをSupermicro PetascaleストレージサーバーおよびIBM Storage Scaleと組み合わせることで、このKVキャッシュソリューションは、冗長な計算を削減し、最初のトークン取得までの時間を改善し、顧客が回復力のあるAI推論サービスを拡張できるように支援する高性能な共有ストレージ層を構築します。」
サイズ選びと数字には表れないもの
IBM のサイジング ガイドでは、4 ノード構成は 4+2P で、7B ~ 34B モデルおよび最大 64 個の GPU に対して使用可能容量が 67% であり、テスト済みの 8 ノード構成は 8+2P で、70B ~ 120B モデルおよび 100 ~ 256 個の GPU に対して使用可能容量が 80% であり、読み取り帯域幅が 100 ~ 300GB/s 以上必要な場合、16 ノード以上は 16+3P で使用可能容量が 84% であり、より大規模なモデルおよび 300 個以上の GPU に対して 300GB/s 以上で拡張可能です。ストレージ スケール ECE 自体は、3 台のストレージ サーバーから 256 台まで拡張可能です。
主な注意点は、シングルGPUテスト構成であることだ。リファレンスアーキテクチャは数百個のGPUに対応するように設計されているが、論文中のすべての結果は、IBMが315GB/sと評価する8ノード、983TBのフラッシュストレージ層に対して1基のRTX PRO 6000を使用した結果である。そのため、ストレージ側は飽和状態には程遠く、フルGPUクラスタが同時にキャッシュをプルする場合のTTFTの性能はテストでは示されていない。
Supermicroは、このパッケージソリューションの価格や発売時期を公表しておらず、発表内容にもGPU利用率に関する数値は含まれていない。このアプローチは、DDNのAI400X3Mに搭載されたDynamo統合型KVキャッシュアクセラレーションと同じ領域に位置するが、違いは、このスタックが汎用SupermicroサーバーとIBMのファイルシステム上のイーサネット上で動作する点にある。
「AIワークロードがトレーニングから推論へと拡大するにつれ、エージェント型AIや長コンテキストかつマルチターン生成型AIに特徴的な高スループット推論ワークロードを展開する企業やネオクラウドは、GPU効率を向上させるためにボトルネックを解消する必要があります」と、Supermicroの社長兼CEOであるチャールズ・リャン氏は述べています。「IBMおよびNVIDIAとの共同開発による当社のソリューションは、こうしたパフォーマンス上のメリットを明確に示しています。」



 Amazon