

ASUS ExpertCenter Pro ET900N G3 は、テストした 2 台目の GB300 DGX ステーションであり、ラボで実際に操作した最初の製品です。MSI XpertStation WS300 のテストはリモートで行いました。MSI XpertStation WS300 でテストしたのと同じ NVIDIA シリコンを使用しています。Grace Blackwell Ultra Desktop Superchip、72 個の Grace コア、B300 GPU、252GB の HBM3e、496GB の LPDDR5X、および 2 つの 400GbE ポートを備えた ConnectX-8 SuperNIC です。ASUS はこの固定コア プラットフォームを、デスクサイド AI 用に設計されたすっきりとしたタワーにパッケージ化し、WS300 にはないいくつかの工夫を加えています。上部に 2 つの持ち運び用ハンドル、ConnectX-8 光学ケージに向けられた専用ファン、および 80 PLUS Titanium 定格の 1,600W 電源です。
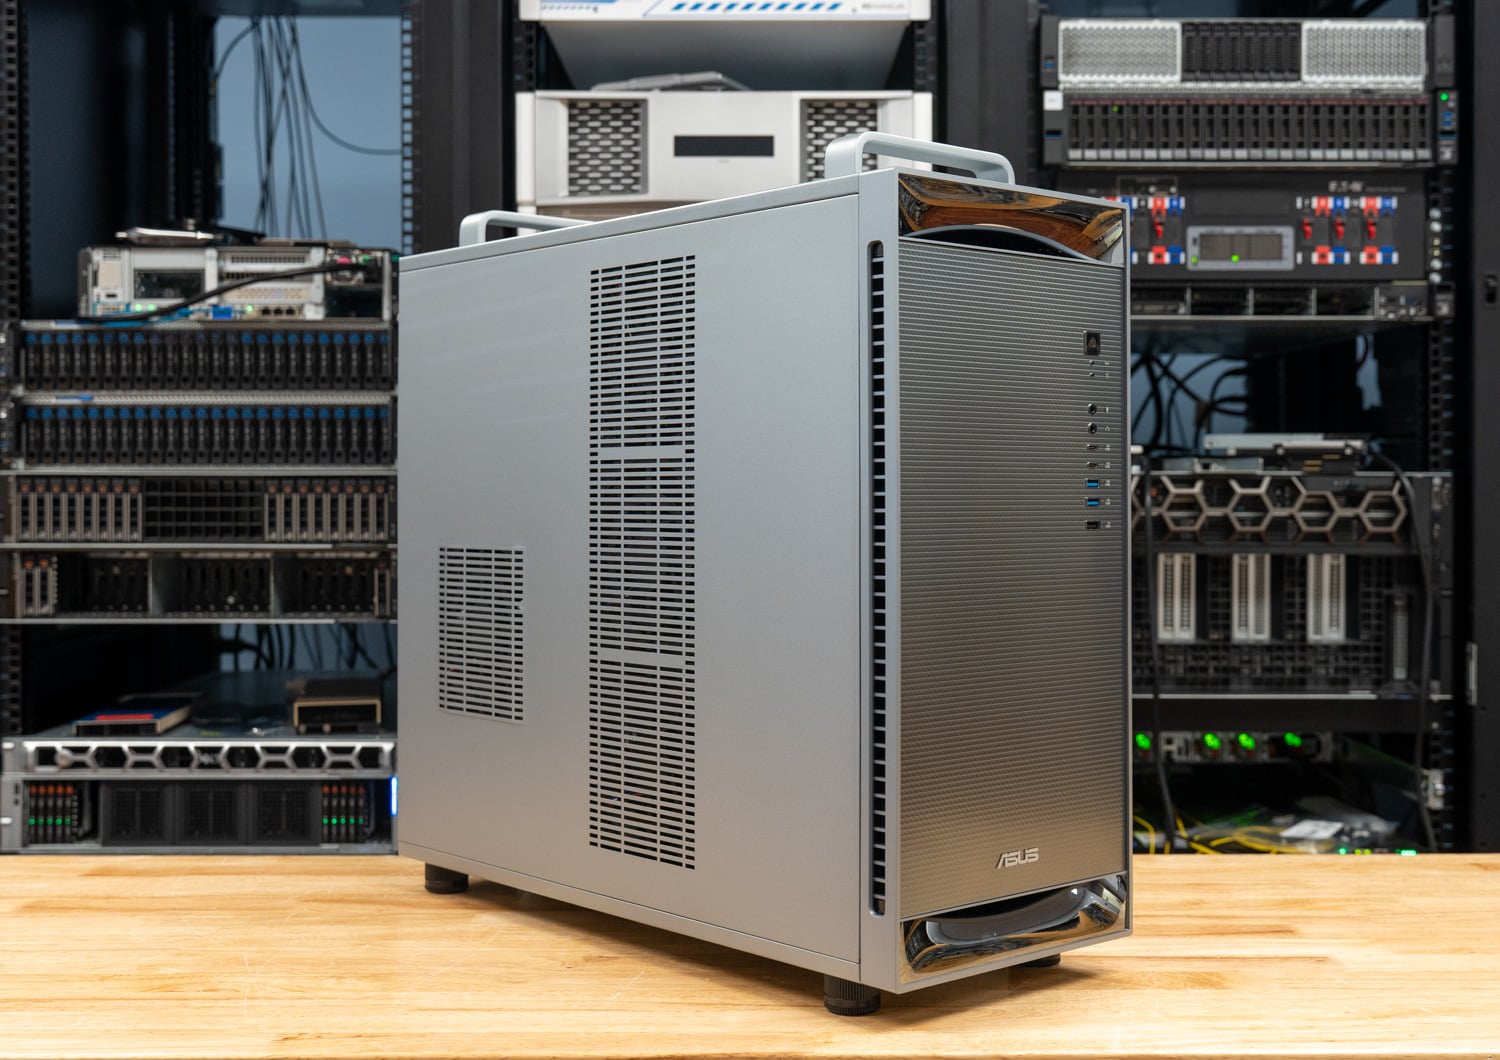
ASUSは、RTX PRO 2000を搭載したET900N G3を約1週間、ベンチマーク、写真撮影、および物理的なチェックのためにラボに送りました。プラットフォーム自体、B300、Grace、NVLink-C2C、MIG、およびDGX Stationの用途については、WS300のレビューで説明されています。このレビューは、ASUSがSuperchipを中心に構築したものと、その数値が最初にテストしたGB300タワーと比較して妥当かどうかについてです。
ASUS ExpertCenter Pro ET900N G3の仕様
| 製品仕様 | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| プラットフォームの概要 | |
| スーパーチップ | NVIDIA GB300 Grace Blackwell Ultra デスクトップ スーパーチップ |
| CPU | NVIDIA Grace、72 Arm Neoverse V2 コア |
| GPU | NVIDIA Blackwell Ultra (B300)、スパース性を用いた最大20 PFLOPSのNVFP4 |
| CPU-GPU インターコネクト | NVLink-C2C、双方向900GB/s |
| メモリ | |
| コヒーレントメモリ | 748GB |
| GPUメモリ | 252GB HBM3e、7.1TB/s |
| CPUメモリ | 496GB LPDDR5X、396GB/s、4x SOCAMM |
| Storage | |
| ブートドライブ | M.2 2280 PCIe 5.0 x4 (Key M) スロット×2、2TB NVMe SSD 2台をRAID 1構成で搭載 |
| 拡張ドライブ | ASUS製、M.2 2280(Key M)スロット×2、PCIe 6.0 x4、工場出荷時からオープン |
| Networking | |
| スーパーNIC | NVIDIA ConnectX-8、2x QSFP112 400GbE |
| イーサネット | Marvell 10GbE 1基 Realtek 1GbE (BMC) x 1 |
| 拡大 | |
| PCIeスロット | 1x PCIe 5.0 x16 PCIe 5.0 x16スロット×2(x8信号) |
| アドインGPU | NVIDIA RTX PRO Blackwellカードは最大1枚まで搭載可能。レビュー用ユニットにはRTX PRO 2000 Blackwellが搭載されていました。 |
| I / O | |
| フロント | USB 10Gbps Type-Cポート×2 USB 10Gbps Type-Aポート×2 1x USB 2.0 ヘッドホンジャックとマイクジャック |
| リア | USB 10Gbps Type-Aポート×4 Micro-USB COMポート(BMCシリアルコンソール)×1 Mini DisplayPort (BMC) x 1 オーディオジャック×3 |
| 管理とセキュリティ | |
| BMC | AMI MegaRACファームウェア、IPMI、およびRedfishを搭載したASPEED AST2600 |
| セキュリティ | オンボードTPM 2.0 |
| 電源と冷却 | |
| 電源 | 1x 1,600W ATX、80 PLUS Titanium |
| 冷却 | GB300、SOCAMM、ConnectX-8にコールドプレートを備えた密閉型AIO水冷システム(ASUS調べ)。前面および上面ラジエーター、背面シャーシファン、QSFP112ケージ上の専用ファンを搭載。 |
| 使用温度 | 10Cから35C |
| ソフトウェアとフォームファクター | |
| オペレーティングシステム | NVIDIA AI開発ツールを搭載したUbuntu。ASUSはWindowsベースのAI開発サポートを計画中としている。 |
| 寸法 | ASUSの記載によると、584 x 232 x 565mm (23.0 x 9.1 x 22.3インチ) です。 |
| 重量 | 正味重量27kg、総重量32kg |
設計と構築
ASUSはET900N G3をビジネスワークステーションとしてデザインしており、つや消しシルバーのシャーシ、ダークメッシュのフロントパネル、クロームトリムのキャップとフット、そしてフロント下部にASUSのバッジがあしらわれています。サイズはプラットフォームの仕様通りで、ASUSの表記では584 x 232 x 565mmとなっています。これは、高さ529mm、奥行き570mm、幅246mmのWS300よりも少し背が高く、少し幅が狭くなっています。重量は27kgで、気軽に持ち運べるシステムではありません。そこで、ASUS独自の設計が活きてきます。上部の縁に金属製のハンドルが2つ(前面と背面に1つずつ)付いており、2人でパネルをつかまずにタワーを机やカートに持ち上げることができます。オフィスマシンとしては少し場違いに見えますが、GB300タワーをラボで運んだ経験があれば納得できるでしょう。
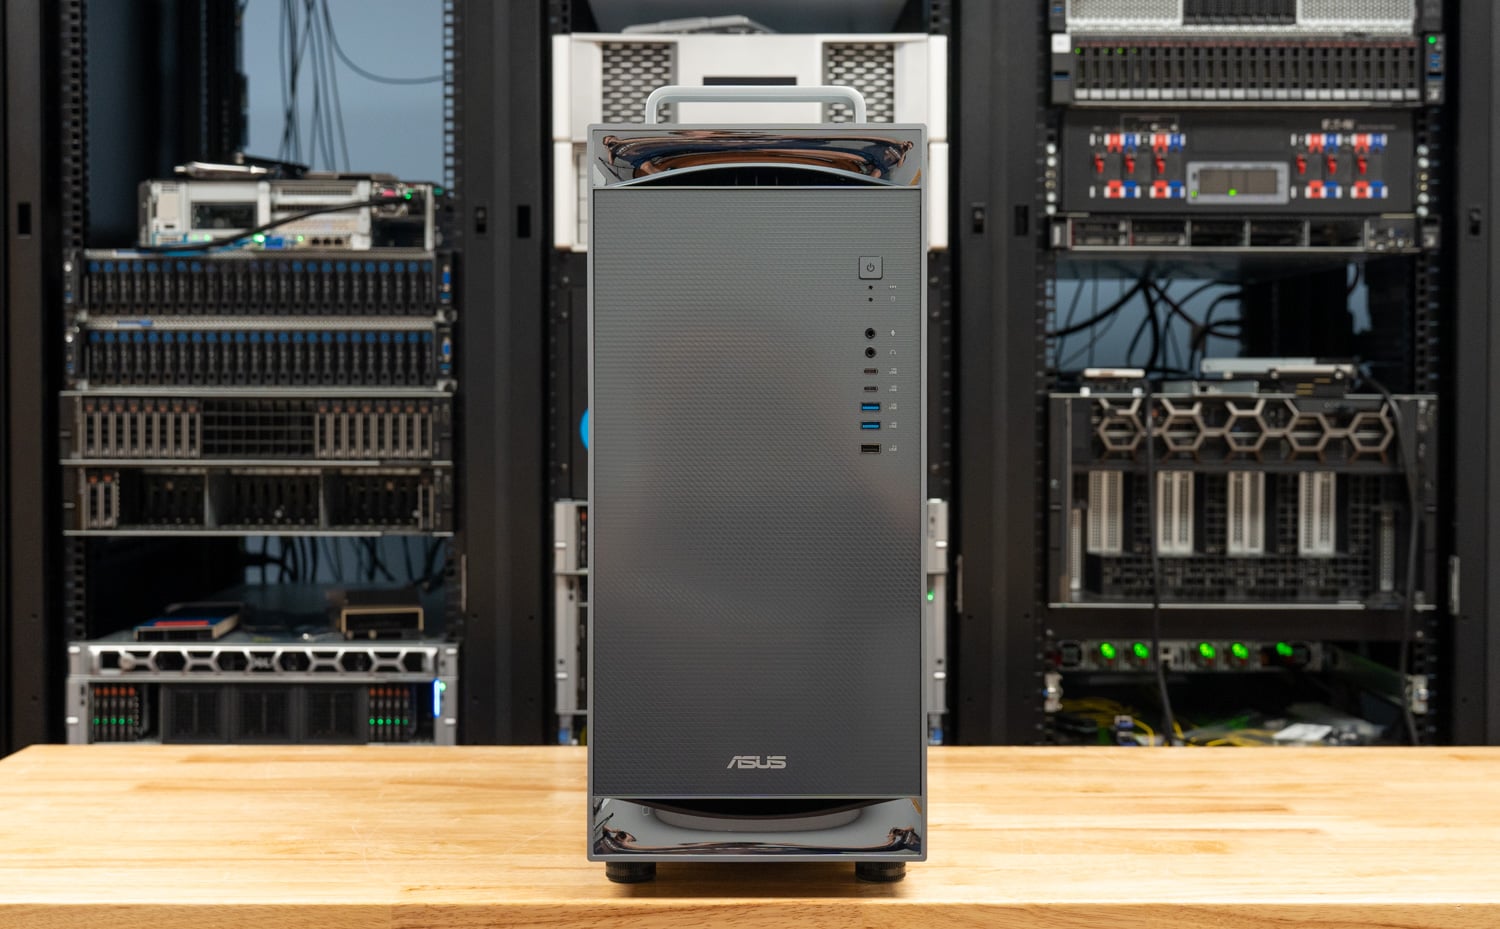
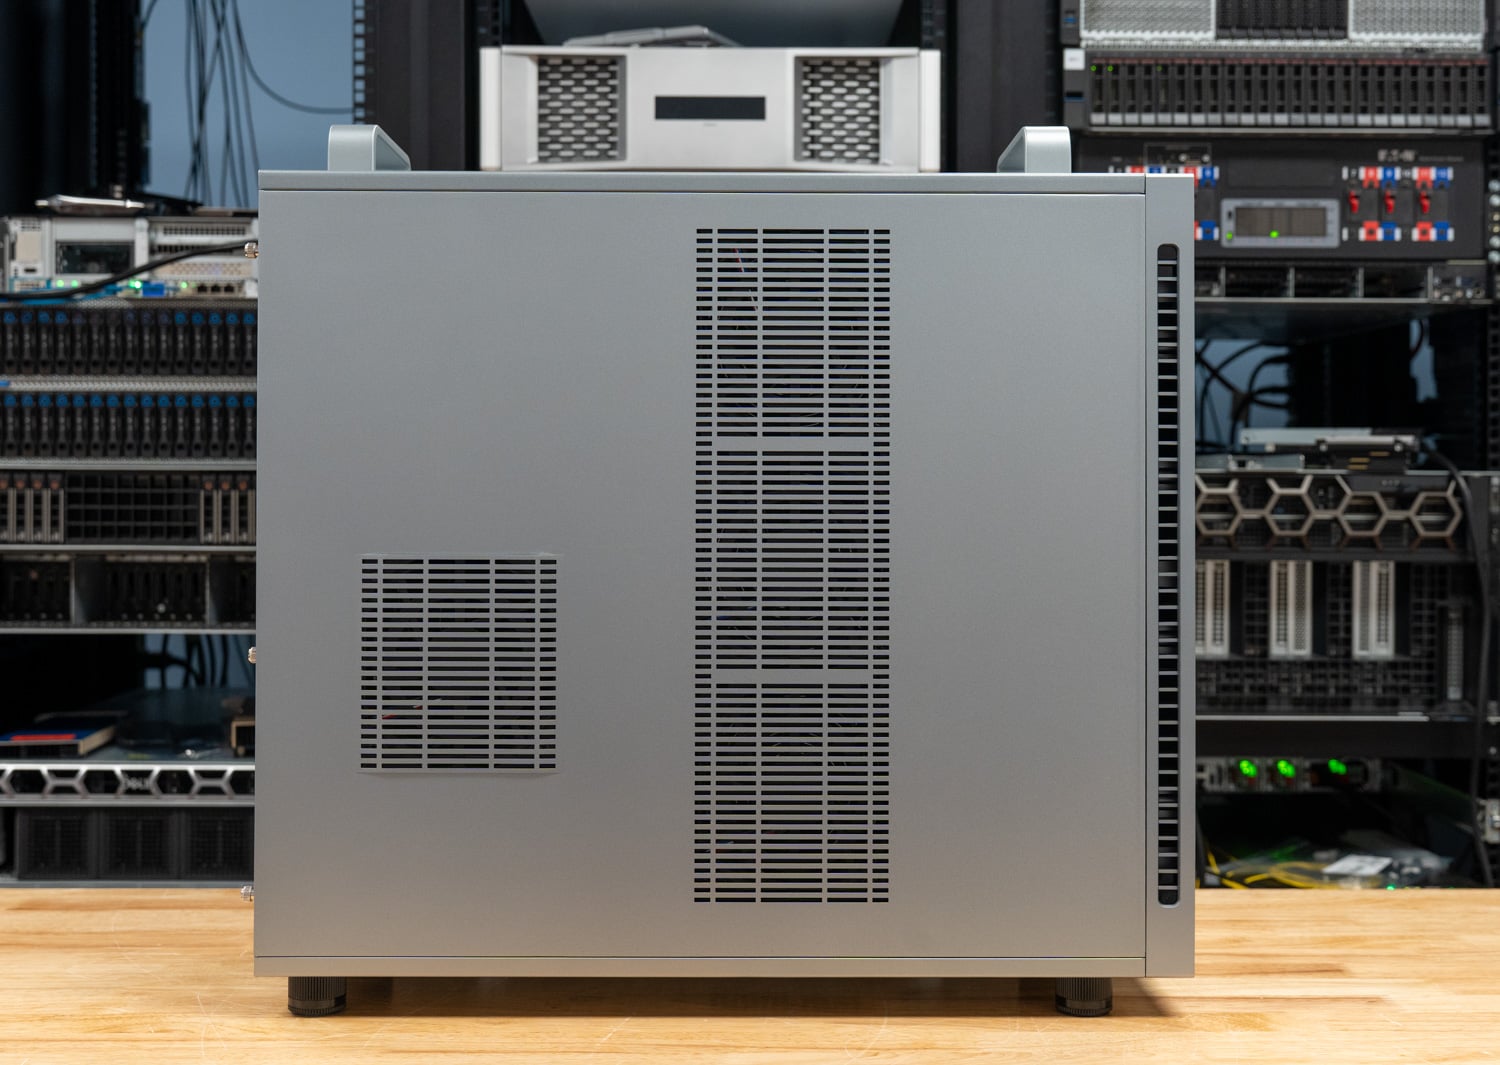
フロントパネルには、電源ボタン、10Gbps USB Type-Aポート×2、10Gbps USB Type-Cポート×2、USB 2.0ポート、ヘッドホンジャックとマイクジャックがそれぞれ独立して配置されており、メッシュの右上部に縦一列に並んでいます。サイドパネルは通気孔のある大きな板状で、前面にはラジエーター吸気用の長い穴あきコラムがあり、背面にはシステムファンと一直線に並ぶ小さな四角いグリルがあります。ウィンドウも照明もありませんが、これはターゲットとする購入者層に適しています。
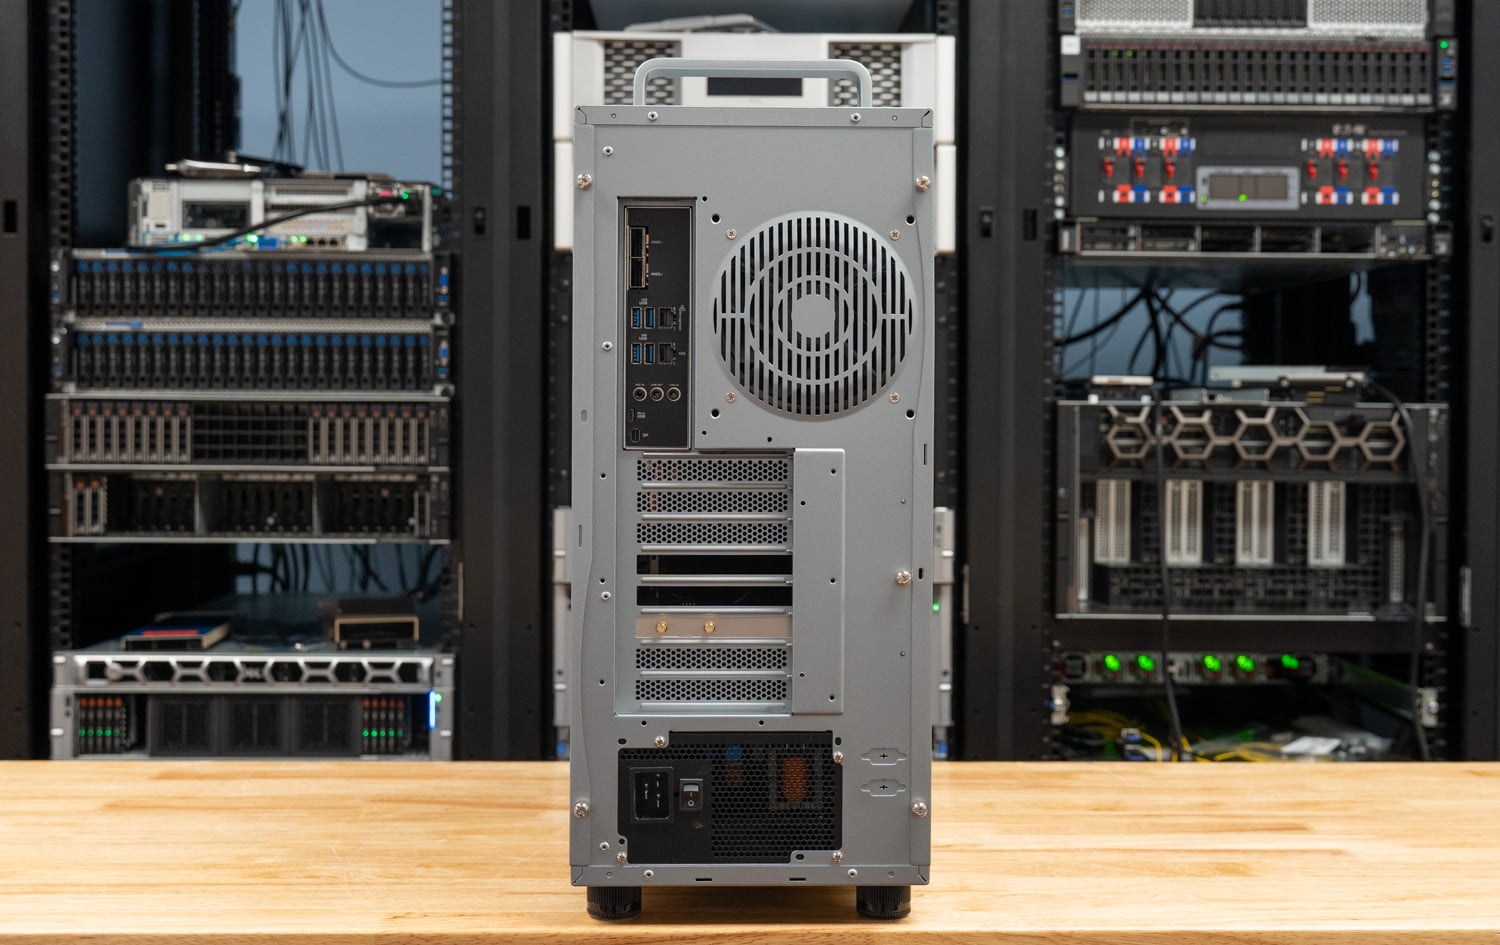
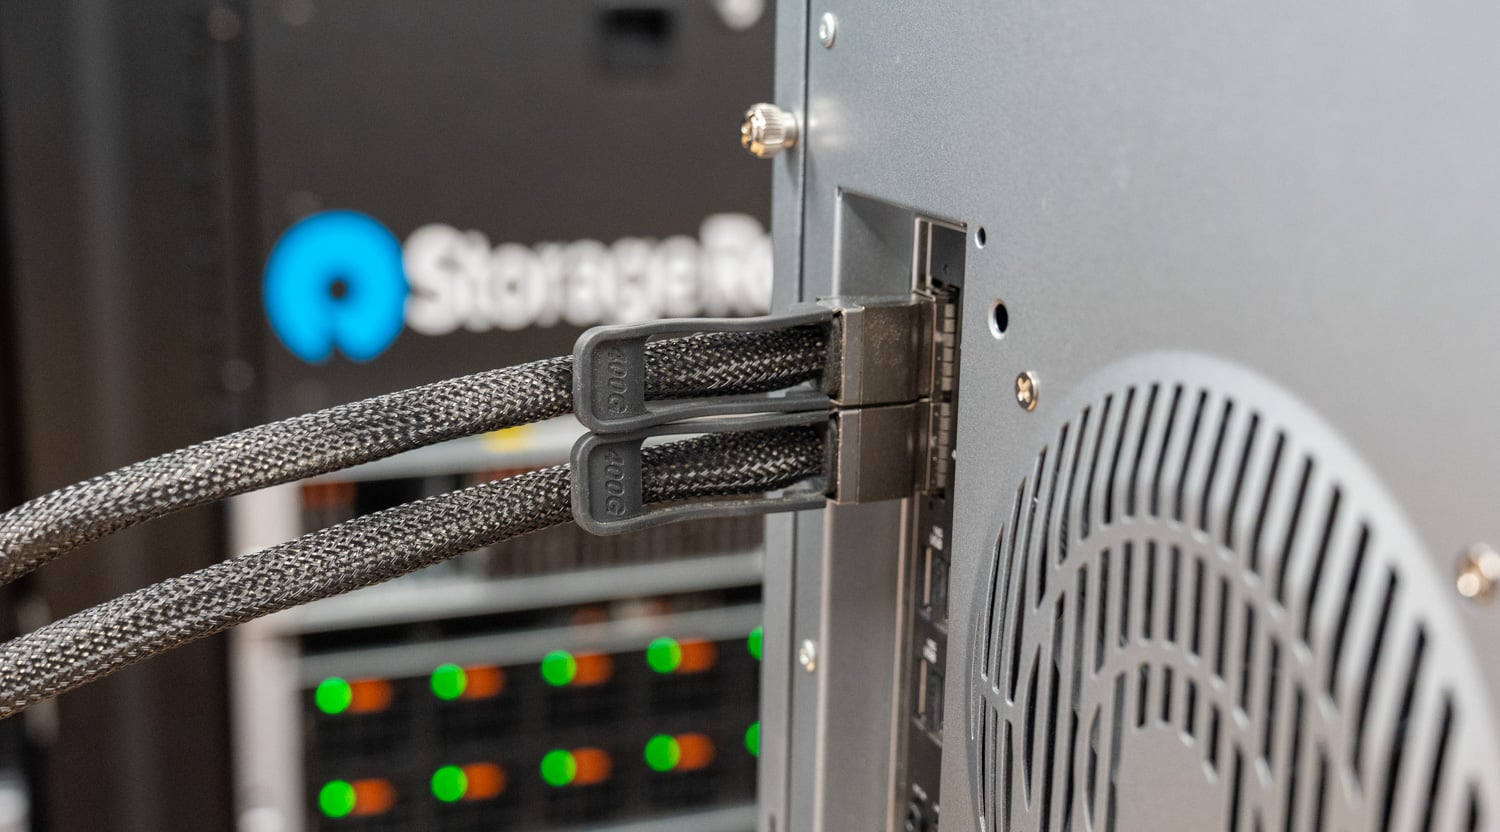
背面を見ると、ワークステーションのI/Oと下部のサーバーハードウェアがレイアウトで分離されています。上部のクラスターには、4つの10Gbps USB Type-Aポート、10GbEおよび1GbE RJ45ジャック、3つのオーディオジャック、BMCのMicro-USBコンソールポート、およびセットアップ時にBMCが駆動するMini DisplayPortが配置されています。ConnectX-8用の2つのQSFP112ケージはI/Oシールドの上部にあり、その横に排気ファンが配置されています。3つの拡張スロットカバーは中央に配置され、C19インレットを備えた電源ユニットは下部にあります。WS300と同様に、Mini DisplayPortは初期設定とトラブルシューティングのためのBMC出力です。このマシンでデスクトップを使用したい場合は、RTX PROカードが必要です。
ET900N G3の内部
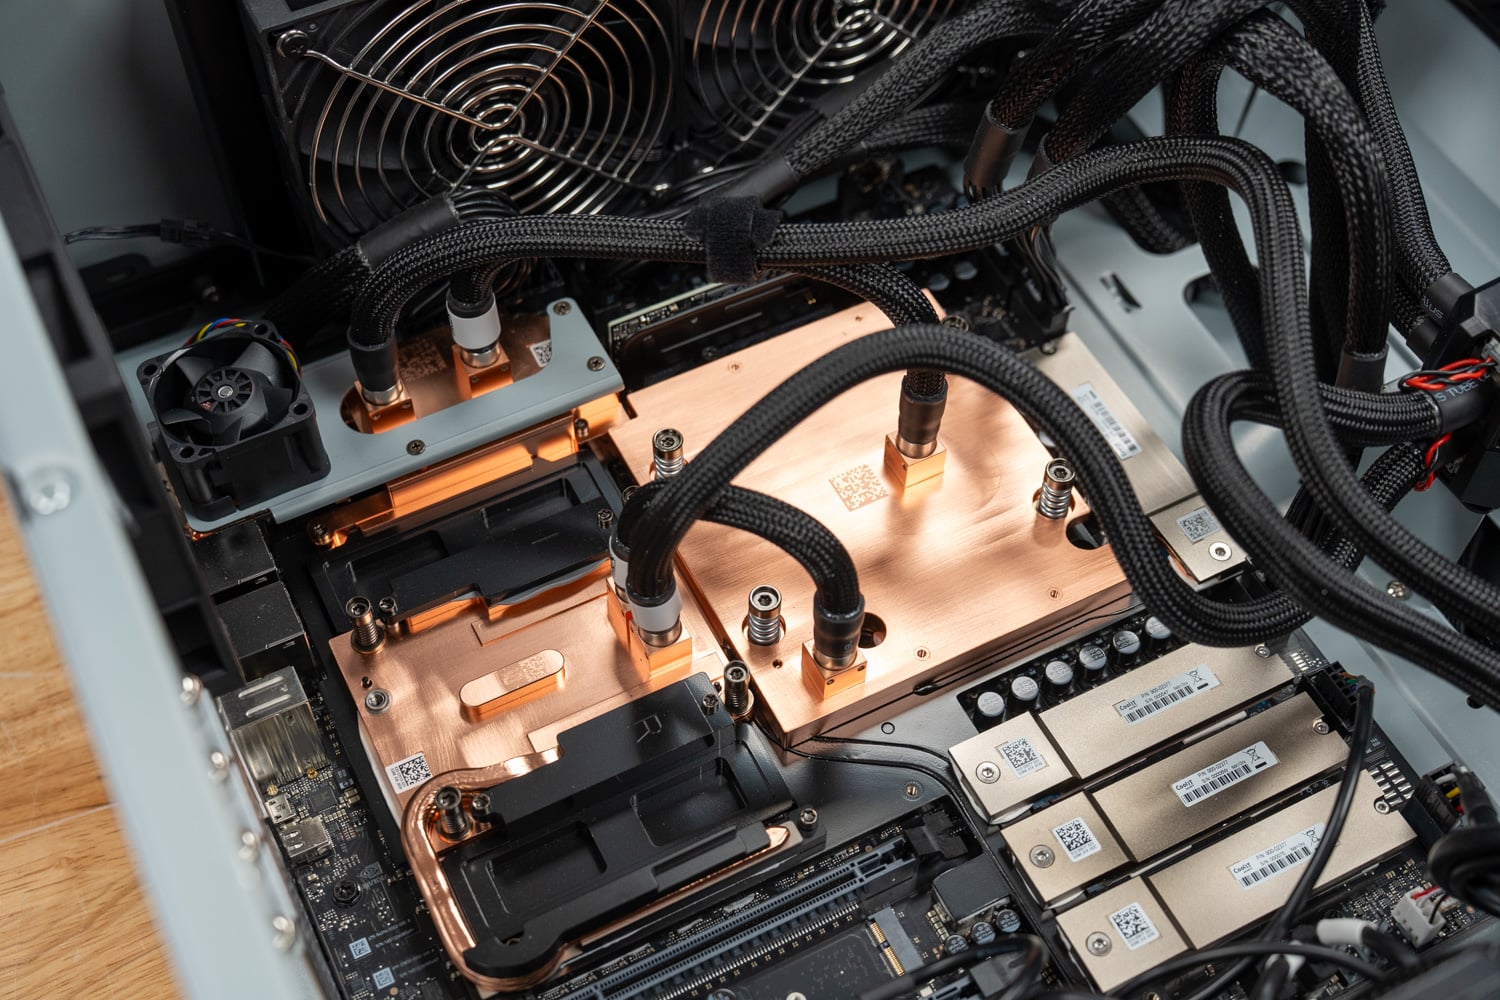
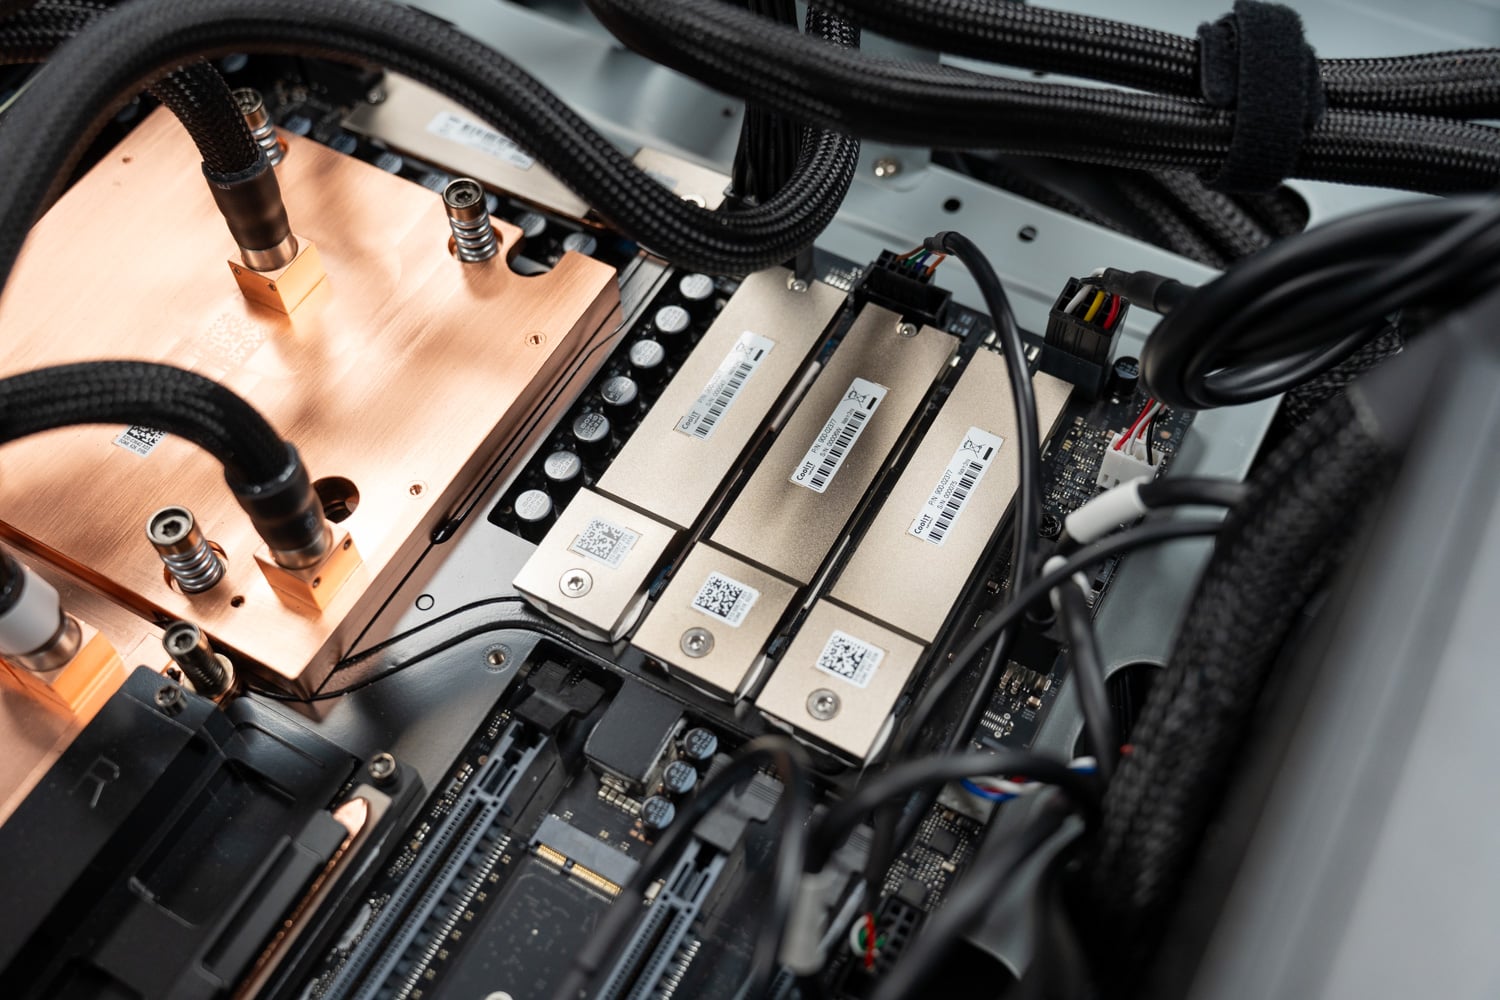
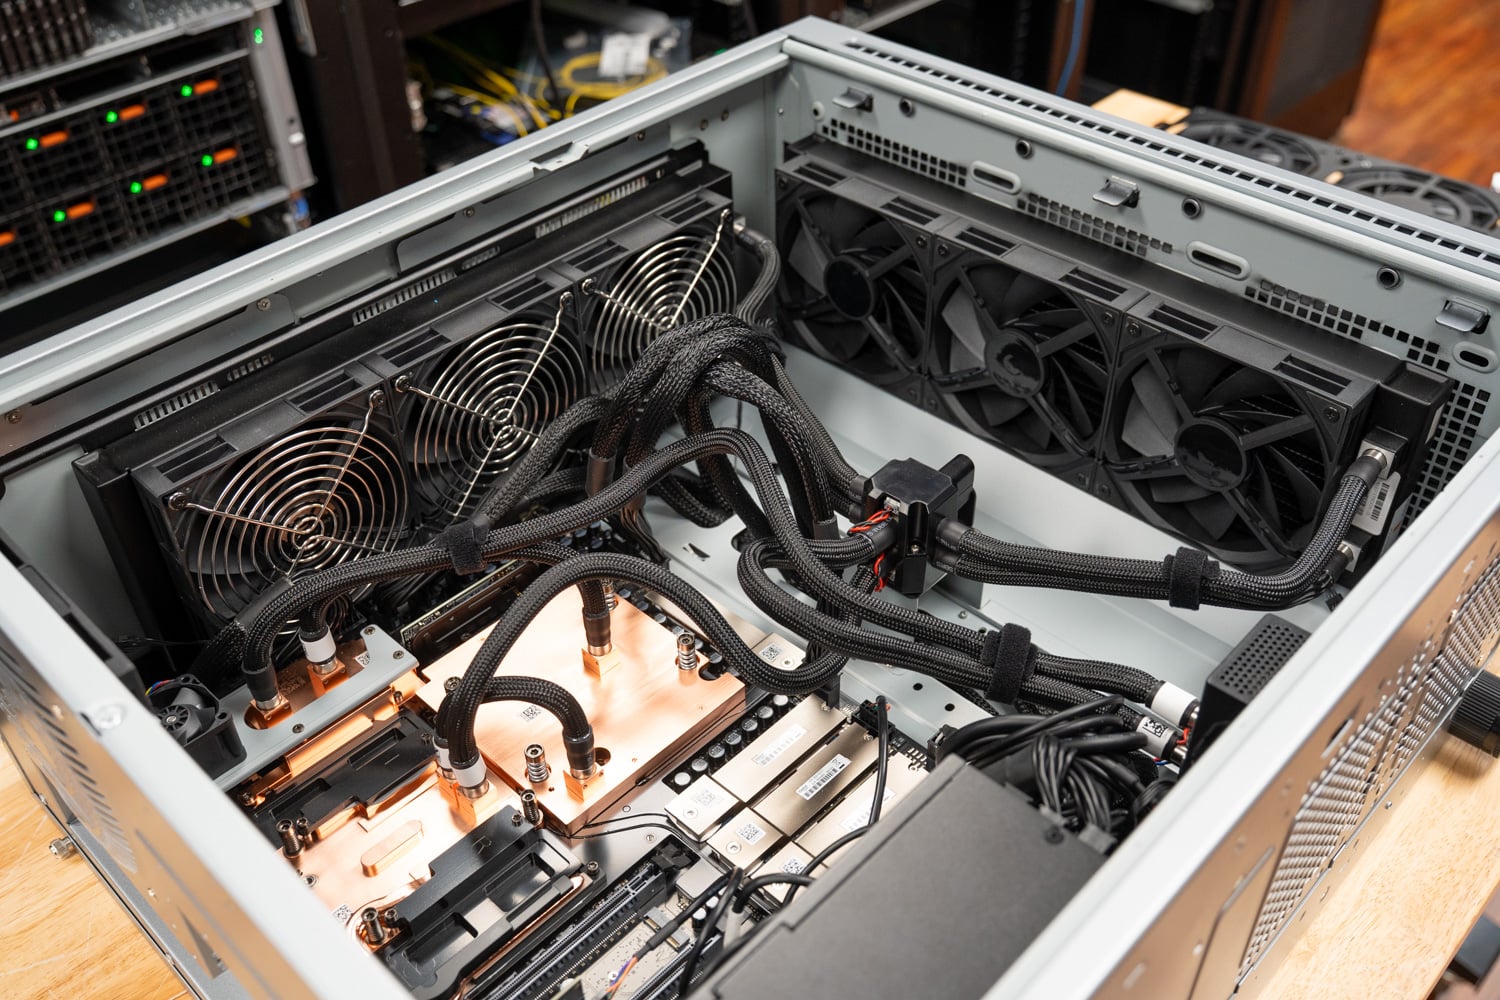
サイドパネルを取り外すと、ET900N G3はWS300とよく似ているように見える。両モデルとも同じNVIDIAベースボードを採用していることを考えると、これは当然のことだ。GB300 Superchipはシャーシ左側の銅製コールドプレートアセンブリの下にあり、SOCAMMモジュールはその横にある独自の銅製プレートの下に、ConnectX-8は背面I/O付近の3つ目のブロックの下に配置されている。編組チューブはブロックからシャーシクロスメンバーに取り付けられた分配マニホールドまで伸び、そこからラジエーターへと繋がっている。3つのフルレングスのPCIeスロットはSuperchipの下にあり、電源ユニットは前面下部の隅に配置され、金属製のシュラウドが底面のケーブル経路を覆っている。
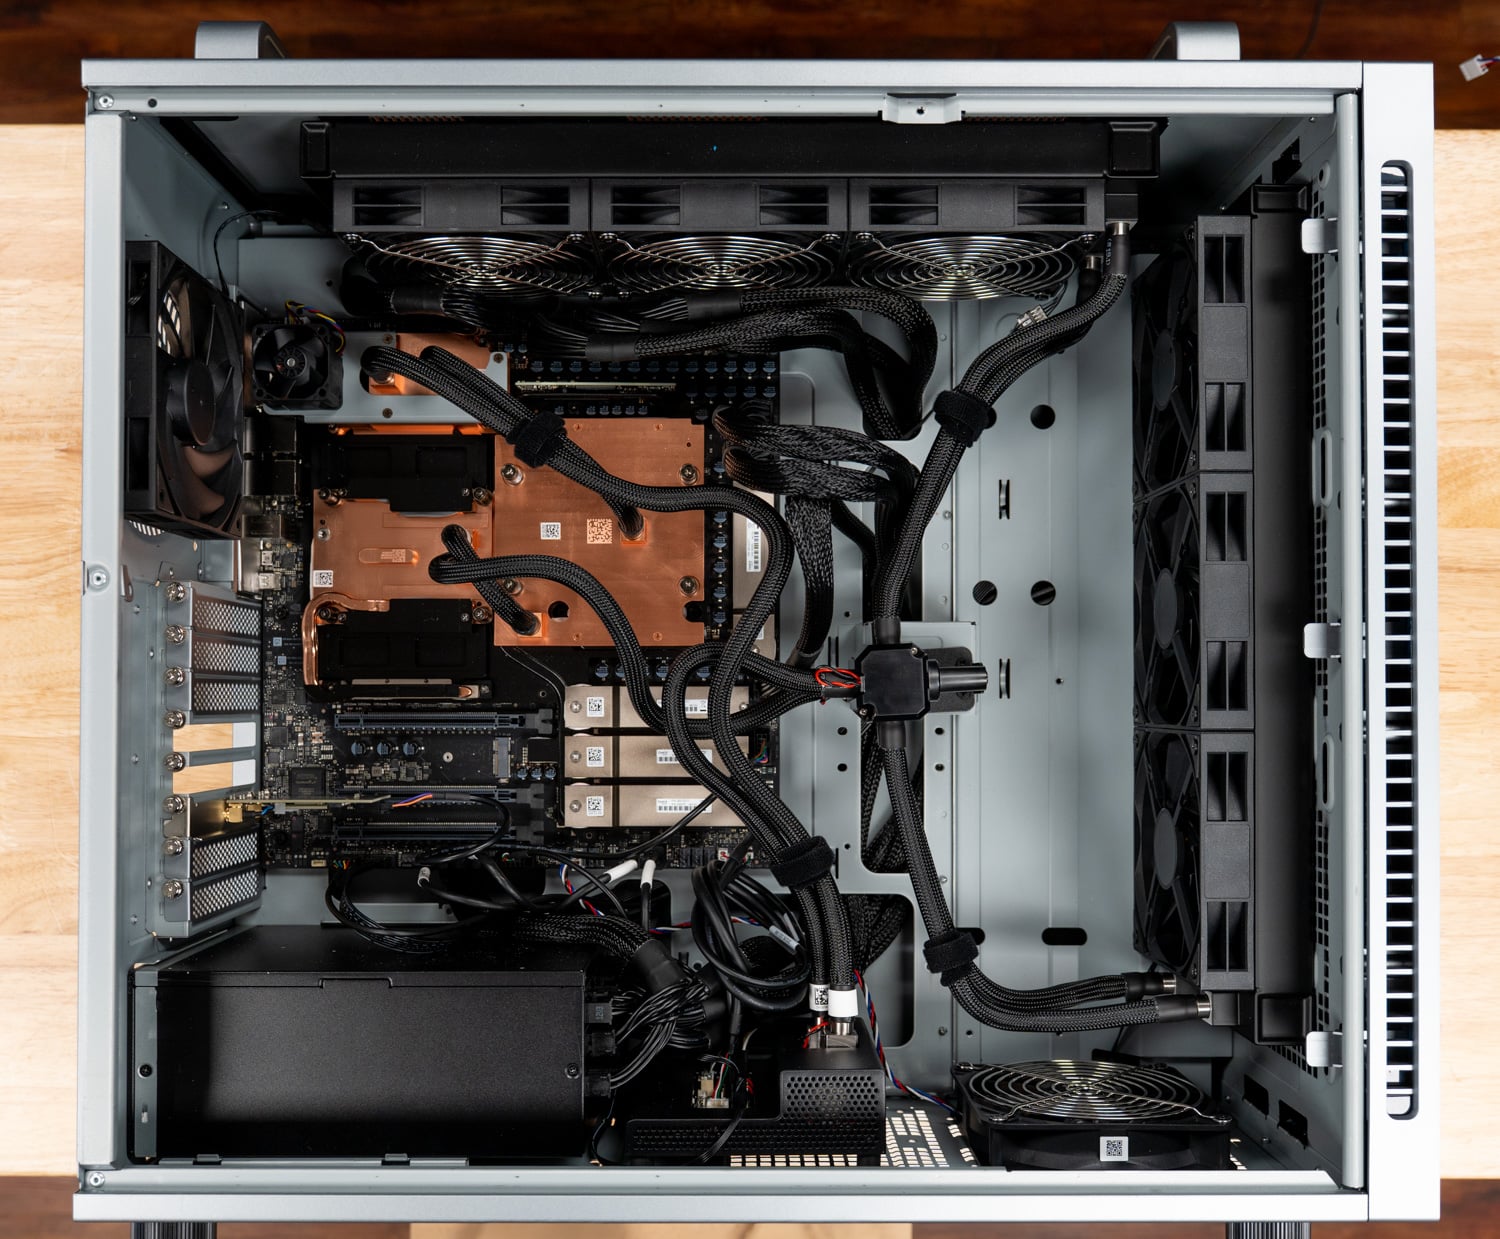
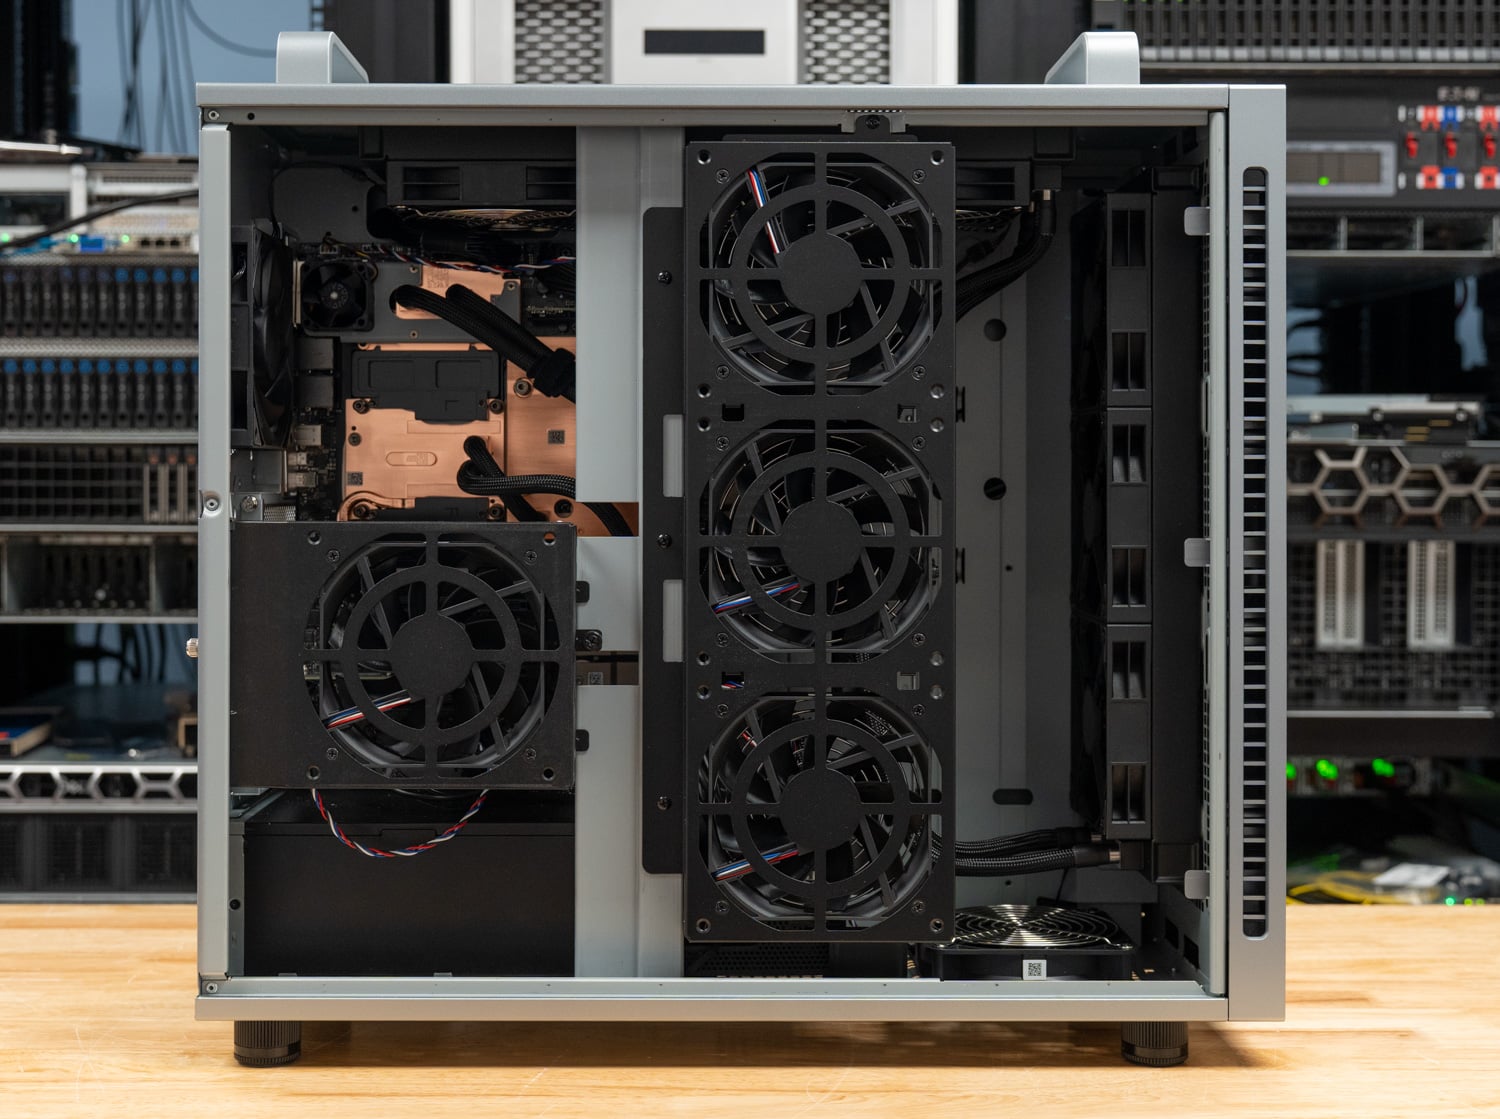
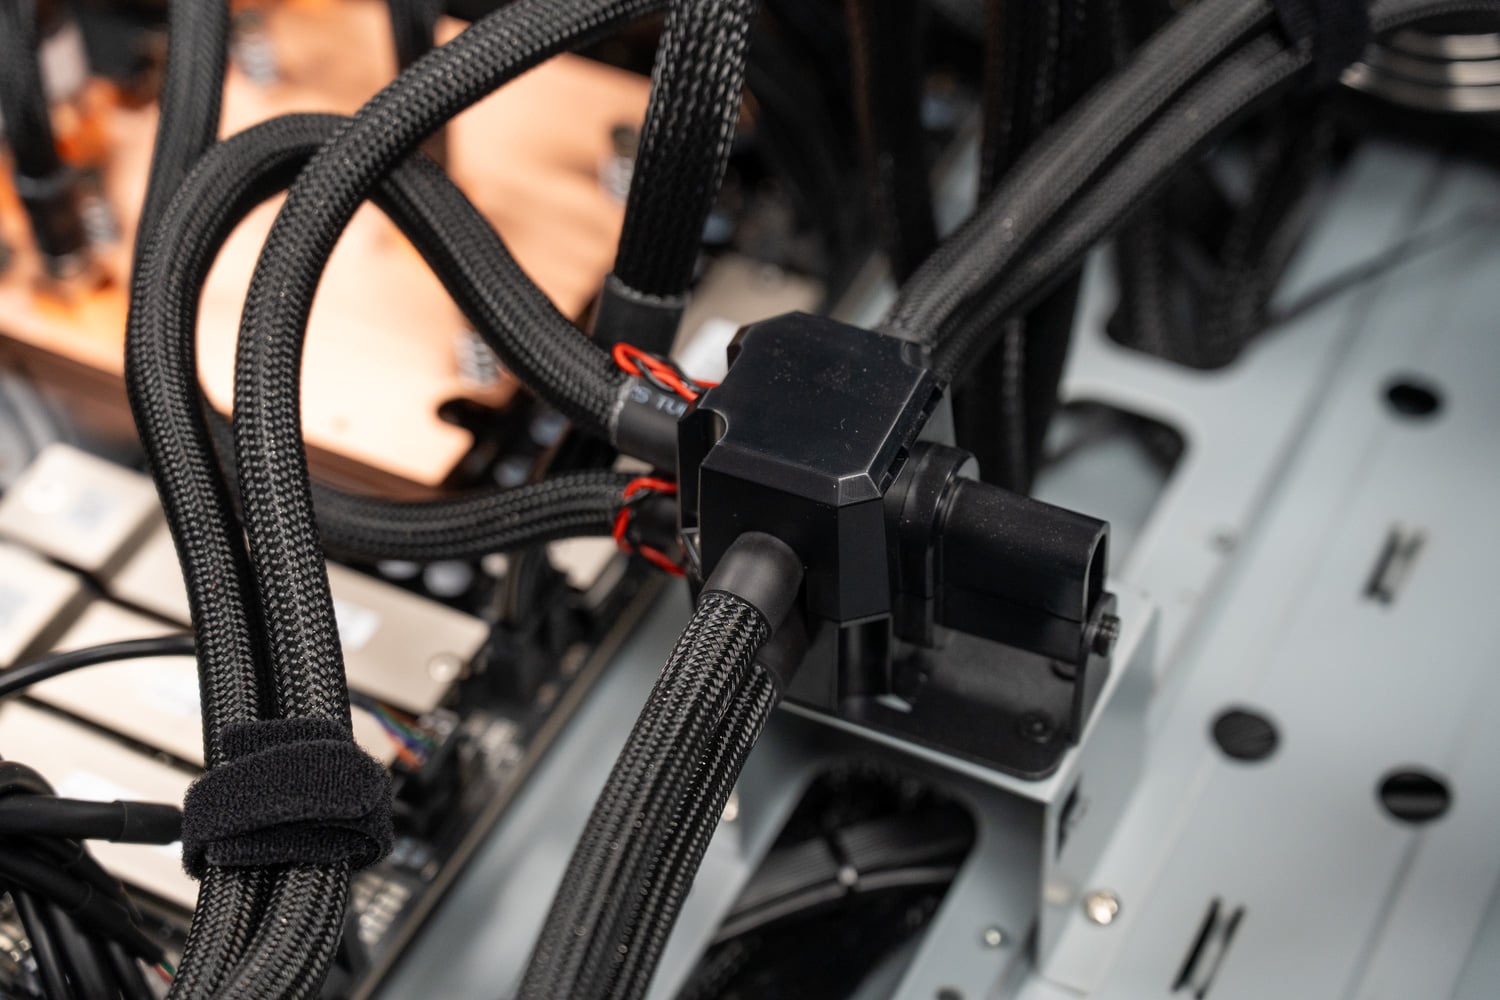
内部の配置はWS300と同じパターンで、フロントメッシュの後ろに垂直に取り付けられたラジエーターが1つと、上部に取り付けられたもう1つのラジエーターがあり、それぞれにファンが1列ずつ配置されている。さらに、後部にはシャーシファンが1つある。冷却液ラインはスリーブで覆われ、面ファスナー式のストラップでクロスメンバーに固定されている。マニホールドは4枚のコールドプレートからの配管をまとめ、各ラジエーターに届く配管は2本だけとなるように設計されている。
光学ファン
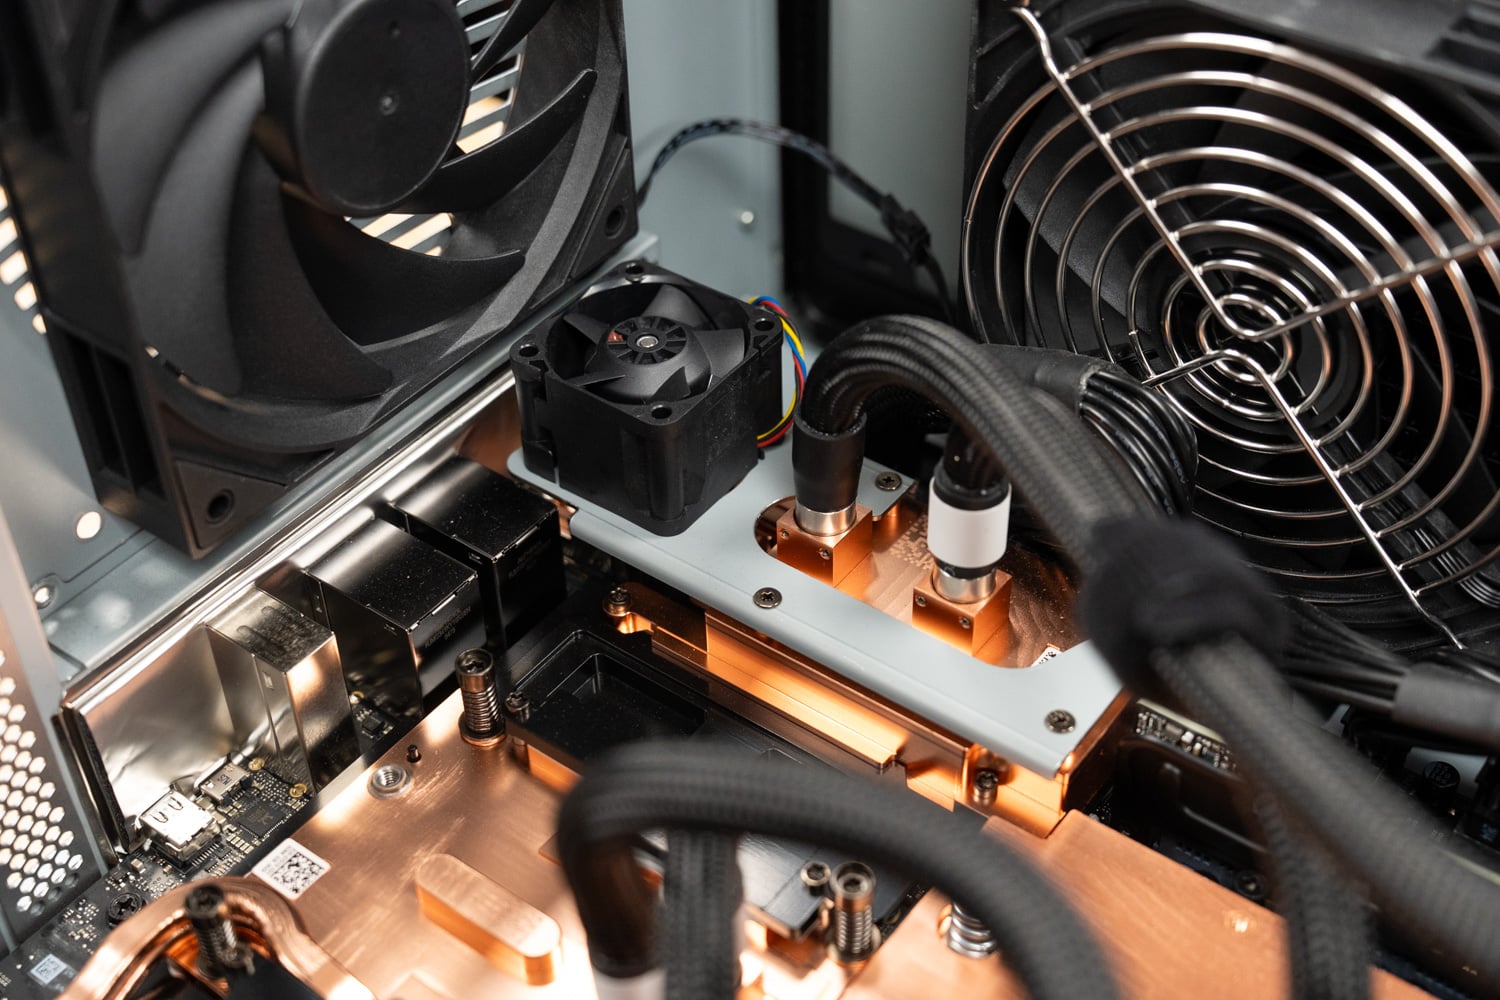
WS300 には同等の冷却要素がない唯一の冷却要素は、ConnectX-8 コールドプレートの上にあるブラケットに取り付けられた小型ファンで、QSFP112 ケージに向けています。液体ループは SuperNIC シリコン自体を冷却しますが、400G 光トランシーバーは独自の熱を発生し、コールドプレートが伝導によってしか届かない金属製のケージに入っています。他のテストでは、ConnectX-8 は持続的な負荷の下で熱くなり、光モジュール自体も熱くなることがわかっています。そのため、ET900N G3 を光ファイバーで数時間連続して動作させる予定の人にとって、ケージを横切る専用のエアフロー経路は優れた設計要素です。DAC を使用する場合、つまり、クラスタ推論の詳細調査のために別の GB300 ステーションにケーブル接続した場合(これはまだ進行中です)、ファンの出番は少なくなります。
ストレージ、拡張性、および電力
ASUSはET900N G3に、オペレーティングシステムとNVIDIAソフトウェアスタック用の2TB NVMeドライブを1台搭載し、PCIe 5.0 x4経由でGraceに接続された2つのM.2 2280スロットに挿入して出荷した。もう1組のスロットはConnectX-8の内蔵PCIeスイッチに接続されており、空の状態だった。
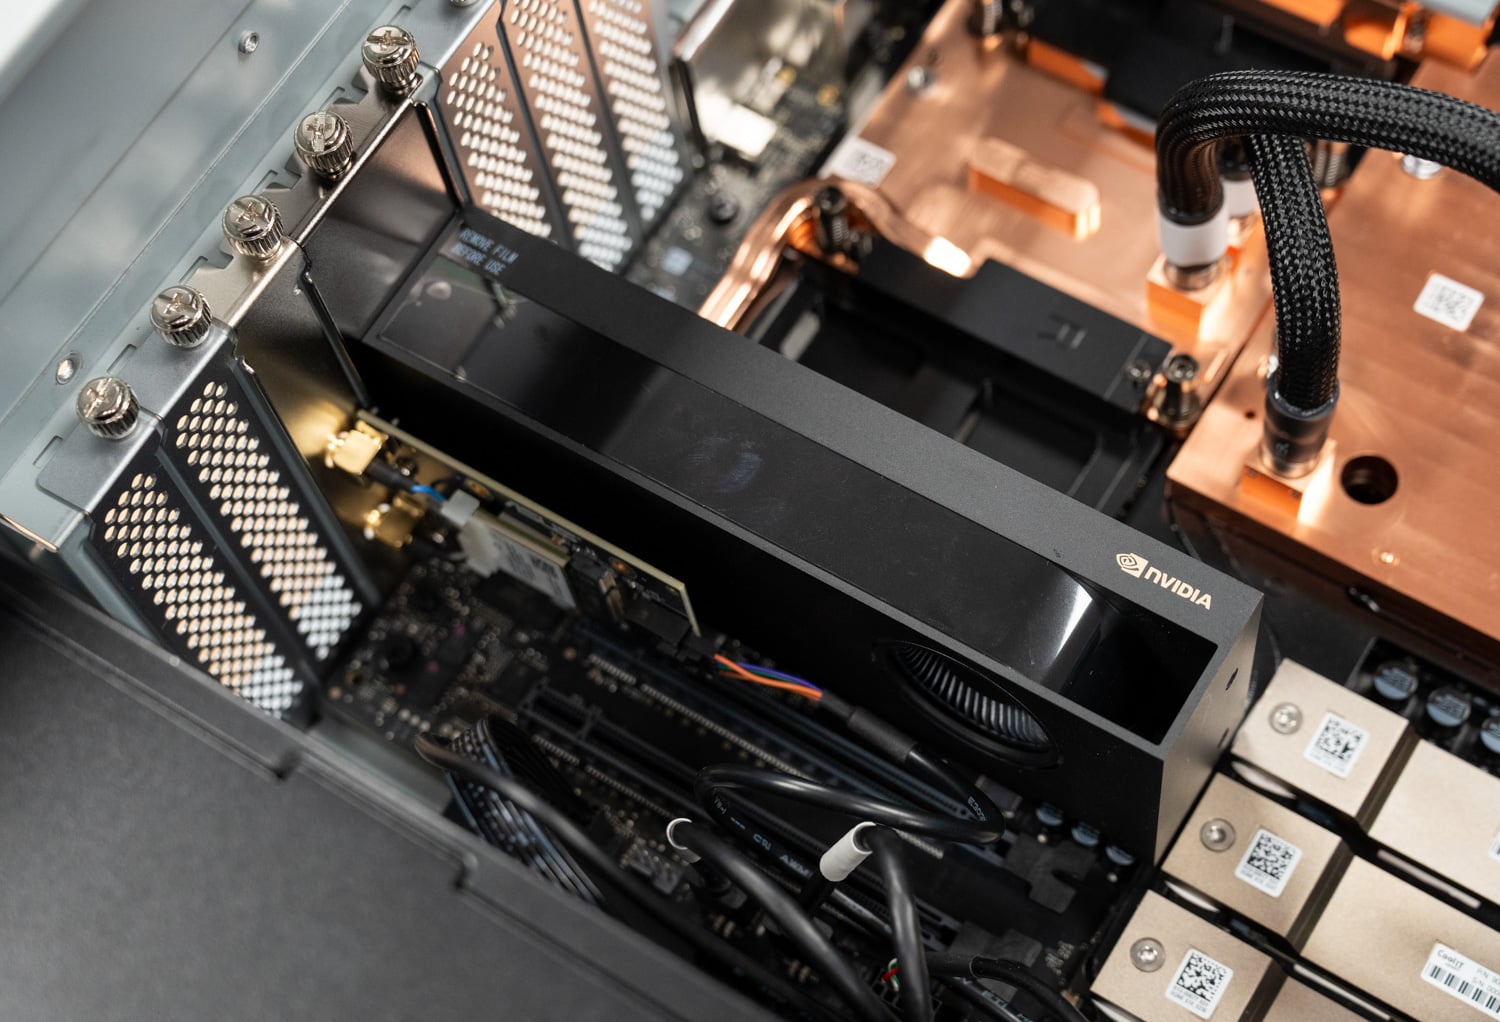
レビュー用のユニットには、ASUSがリストアップしている構成の1つである、PCIe 5.0 x16スロットにNVIDIA RTX PRO 2000 Blackwellが搭載されていました。このカードは、GB300の電力バジェットを大幅に消費することなくディスプレイ出力を提供し、ASUSはシャーシに最大1枚のRTX PRO Blackwellカードを搭載できると述べています。ベンチマークの前にRTX PRO 2000を取り外し、Superchipがアクセラレータのバジェットをフルに利用できるようにしました。これはWS300で使用したのと同じ条件です。また、このシャーシでは高出力のRTX PROカードのテストは行いませんでした。その方法と、それが共有電力バジェットにどのような影響を与えるかについては、今後のGB300 Stationレビューで取り上げます。
電源は 1,600W ATX ユニットで、ASUS は 80 PLUS Titanium と評価しており、WS300 の Platinum ユニットよりも一段上のレベルです。Titanium は 115V 入力で 50% 負荷時に 94% の効率を必要とし、Platinum の 92% と比較すると、10% 負荷で最低値を設定する唯一のティアであるため、ET900N G3 は GB300 がフル負荷のときに壁コンセントで数十ワット少なく消費するはずです。予算は依然として共有されています。Grace、B300、ポンプ、ファン、ストレージ、および RTX PRO カードはすべて同じ 1,600W から消費し、NVIDIA の vsloshd サービスは、Superchip とアドイン GPU の消費量が変化すると、両者の間でヘッドルームを移動し、どちらにも固定の上限はありません。WS300 のレビューではそのポリシーについて説明されており、ここでも変更はありません。北米でのインストールには、専用の 20A 回路が引き続き必要です。
接続性
ConnectX-8の2つのQSFP112ポートは、ET900N G3とストレージ、2台目のDGXステーション、クラスタファブリックなど、他のすべての機器との接続に使用されます。これらのポートは既にラボで使用されており、ET900N G3は400G DACを介して2台目のGB300ステーションに接続され、クラスタ推論の詳細分析を別途公開する予定です。10GbEのMarvellポートは通常のホストトラフィックを処理し、Realtekの1GbEポートはBMC専用です。
テストノート
本レビューのすべての結果は、ASUSがラボに出荷したユニット(出荷時のメモリ構成、HBM3e 252GB、LPDDR5X 496GB)から得られたものです。システムはRTX PROカードを搭載せずに動作させたため、GB300 Superchipはアクセラレータの電力バジェットをフルに活用でき、WS300のテスト条件と一致しています。ソフトウェアスタック、vLLM構成、ワークロードプロファイル、同時実行スイープはWS300で使用したものと同じなので、2つのタワーを直接比較できます。本レビューはパフォーマンスのみを対象としており、このユニットの消費電力や温度は計測していません。
ワークロードは、ローカル AI システムで実行する 2 つの vLLM ライブ推論プロファイルと同じです。入力トークン 512 個と出力トークン 512 個の均等なワークロードと、入力トークン 8,192 個と出力トークン 1,024 個のプリフィルが多めのワークロードで、同時ストリーム数は 1 から 128 に変化します。 最先端規模のモデルについては、これらのチェックポイントに最も近いシングル ボックスの代替品である、2 枚または 4 枚のRTX PRO 6000カードを搭載したDell PowerEdge XE7740 GPUサーバーと比較します。 小規模モデルについては、同じ XE7740 の 1 枚の RTX PRO 6000、Dell PowerEdge R770 の 1 枚の H200 NVL 、および WS300 レビューで使用したのと同じ Spark であるAcer Veriton GN100で表されるGB10 DGX Sparkと比較します。比較システムの数値は、当社の結果チャートから読み取られます。
推論パフォーマンス
コヒーレントメモリプールに関する最先端モデル
GB300 の存在意義は、B300 の 252GB HBM3e の境界の両側のモデルに対応することにあるため、まず、その境界をまたぐ 4 つのチェックポイントから始めます。DeepSeek V4 Flash と MiniMax M2.7 は HBM に余裕を持って収まり、MiniMax M3 はギリギリ収まり、エキスパートの一部を Grace メモリにプッシュし、GLM-5.2 はそのウェイトの約半分をオフロードします。各チャートの反対側には、最も近いシングル ボックスの代替品があります。PowerEdge XE7740 に RTX PRO 6000 カードが統合され、必要に応じてエキスパートをホスト メモリにオフロードします。
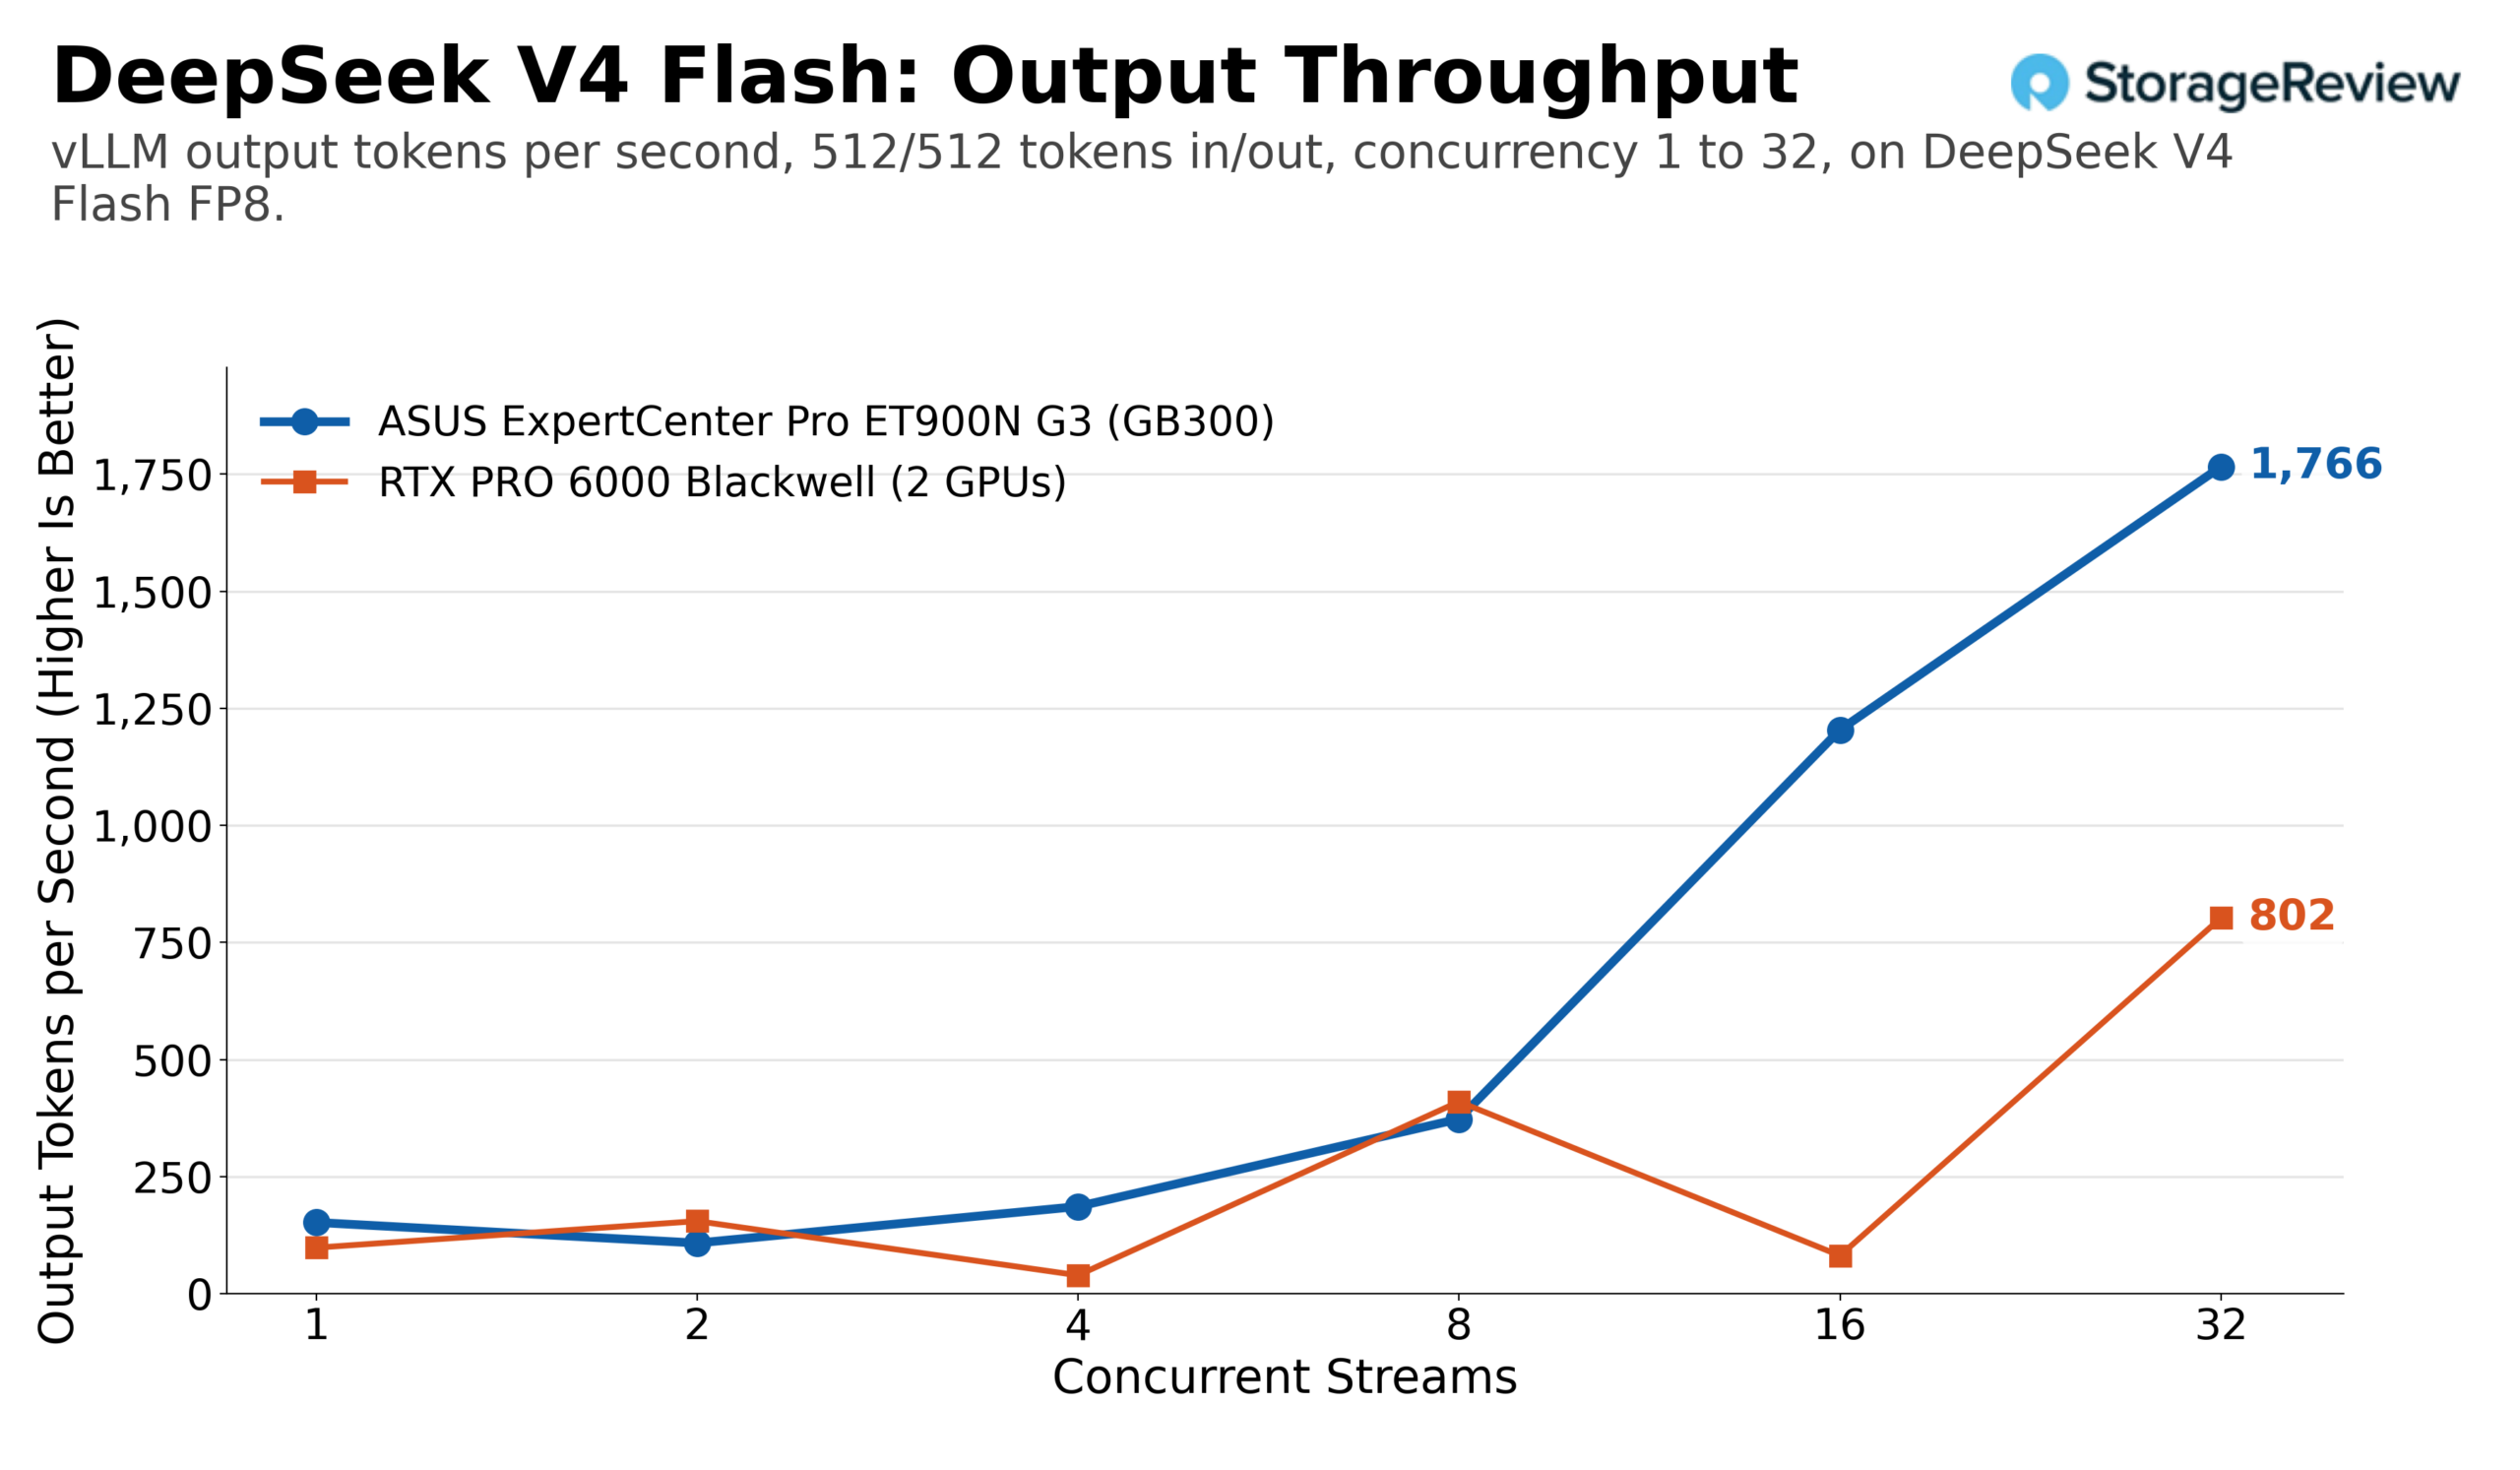
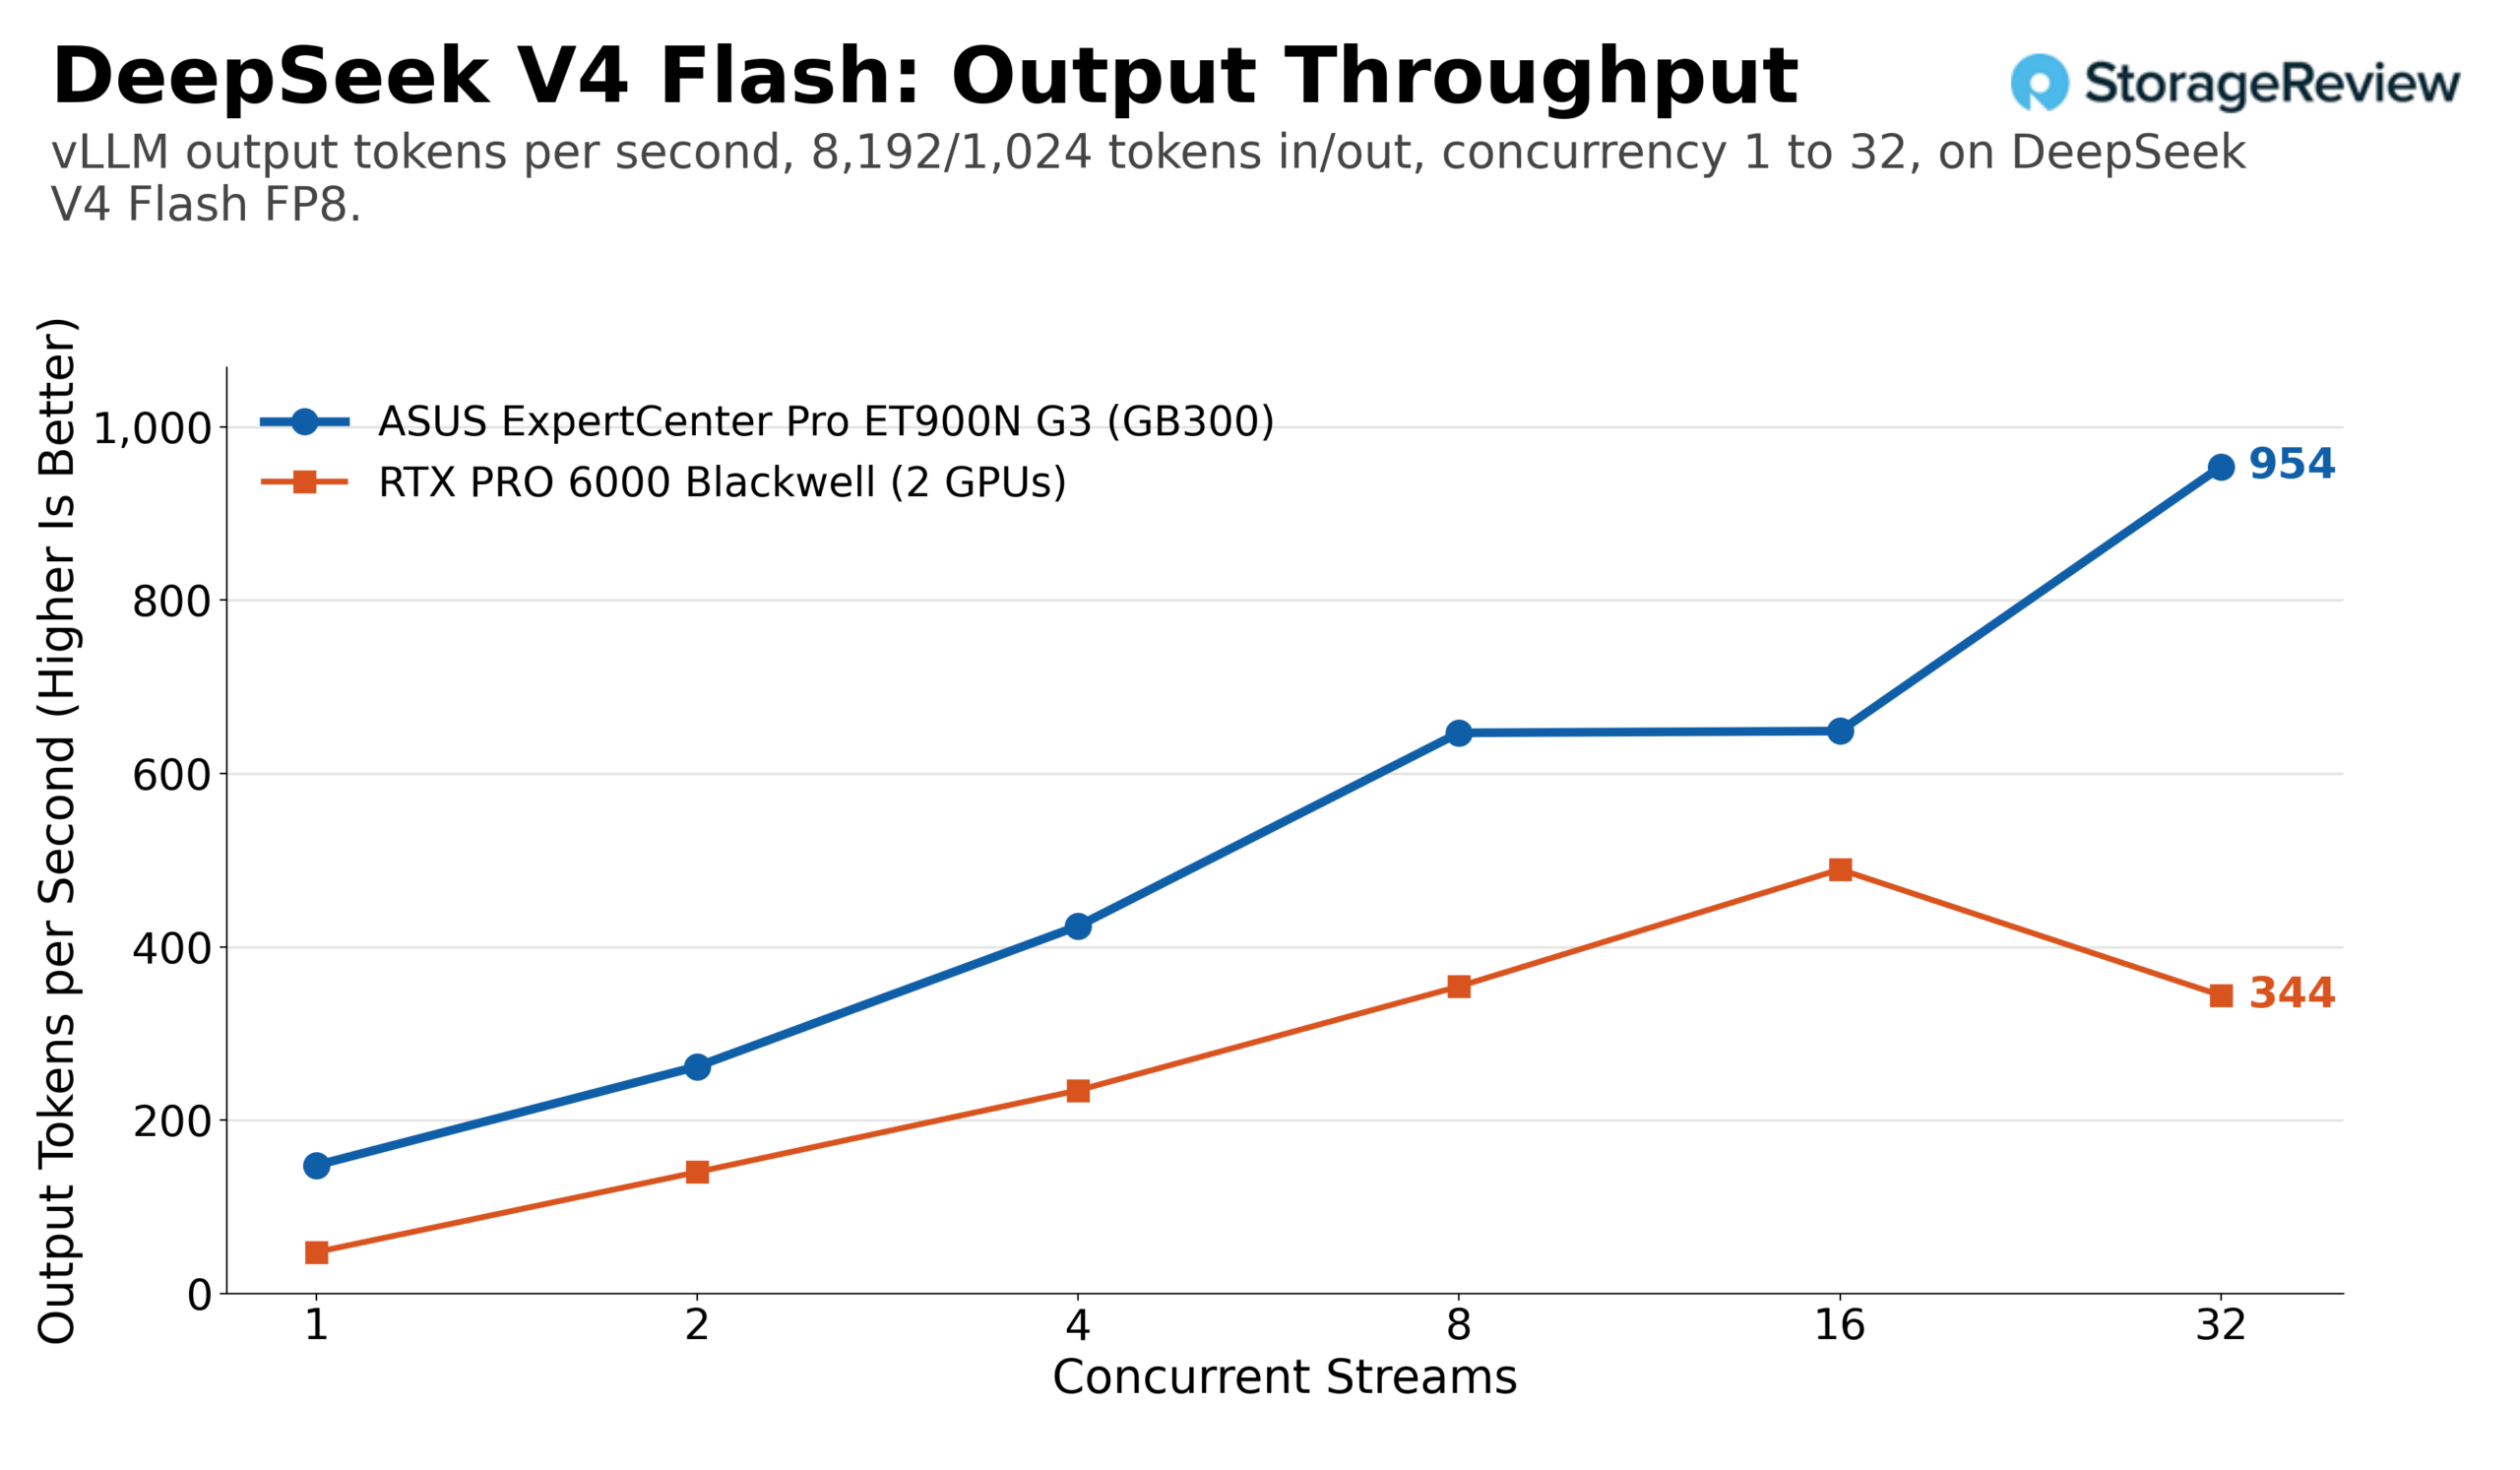
DeepSeek V4 Flash は簡単なケースです。ネイティブ FP8 のチェックポイントは約 20GB で、B300 は問題なく処理します。同じワークロードでの出力スループットは、1 ストリームで毎秒 152 トークンから 32 ストリームで毎秒 1,766 トークンに上昇し、合計トークン スループットは 3,532 になりました。プリフィルが多いプロファイルでは、ET900N G3 の出力トークンは毎秒 148 から 954 に増加し、合計 8,587 トークンになりました。RTX PRO 6000 カード 2 枚は、同じワークロードで毎秒 800 近い出力トークンに達し、長いプロンプトでは毎秒 490 程度に達しましたが、同時実行数が少ない場合は曲線が不均一でした。
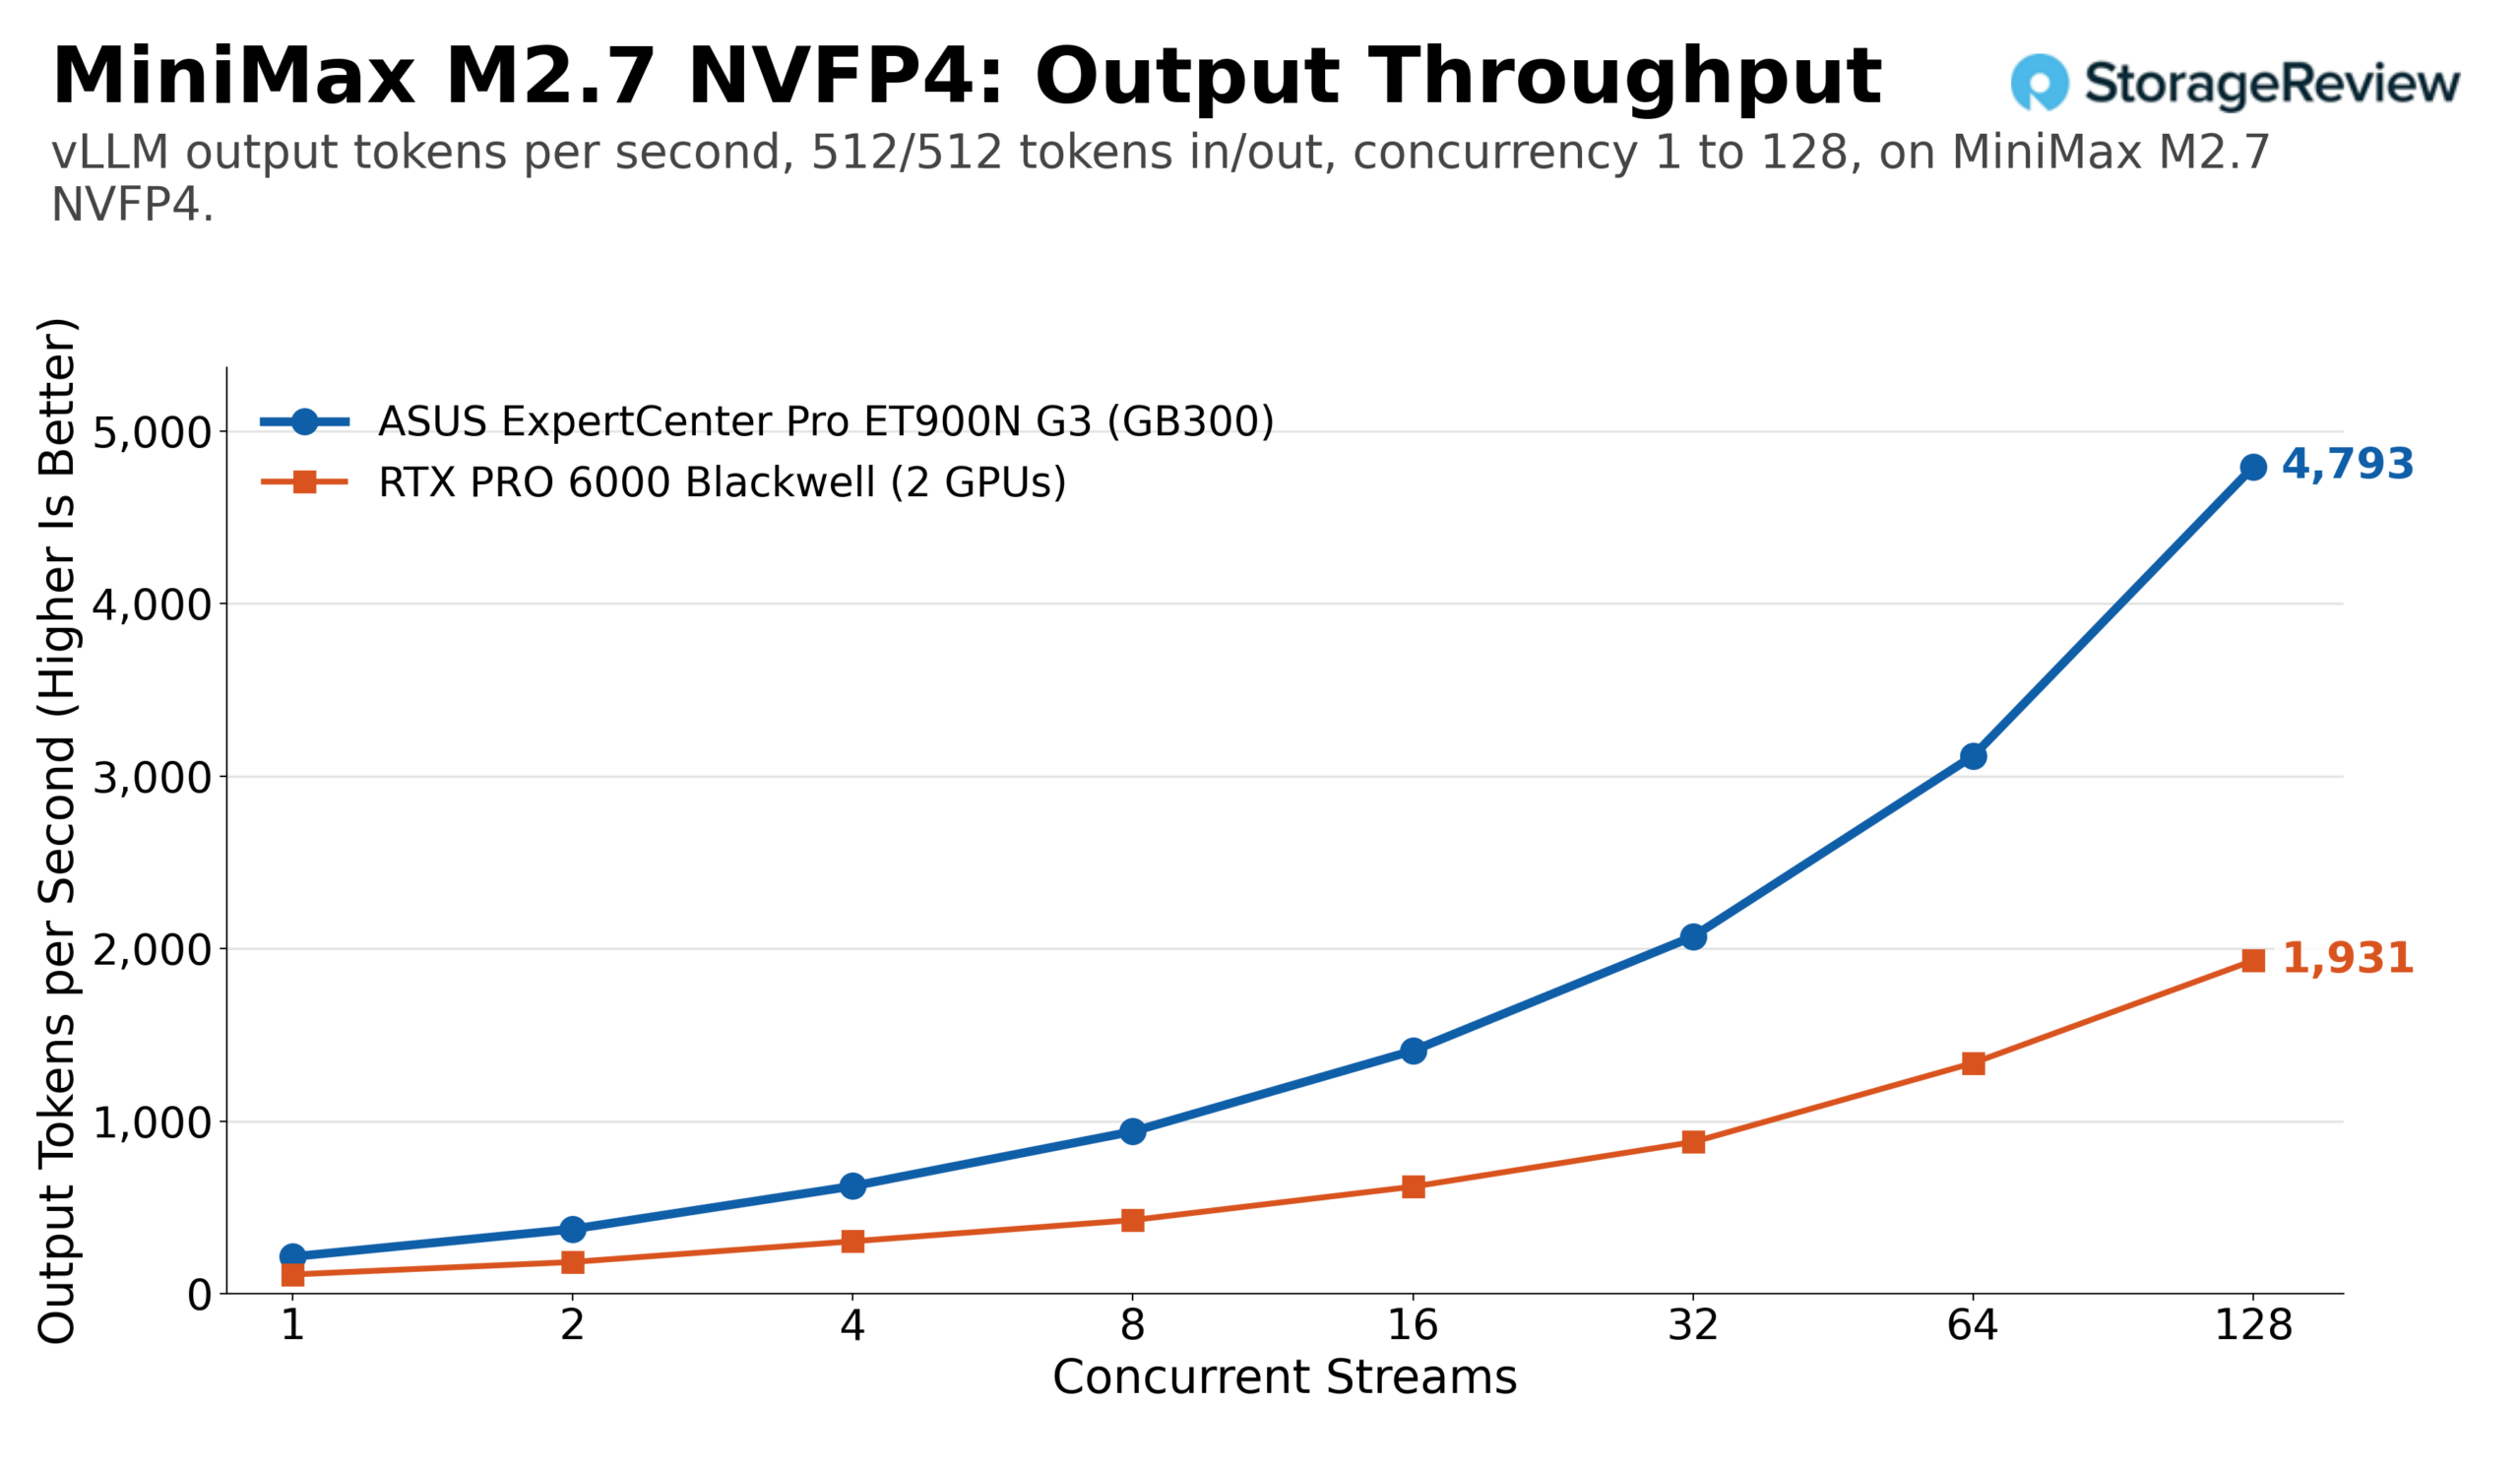
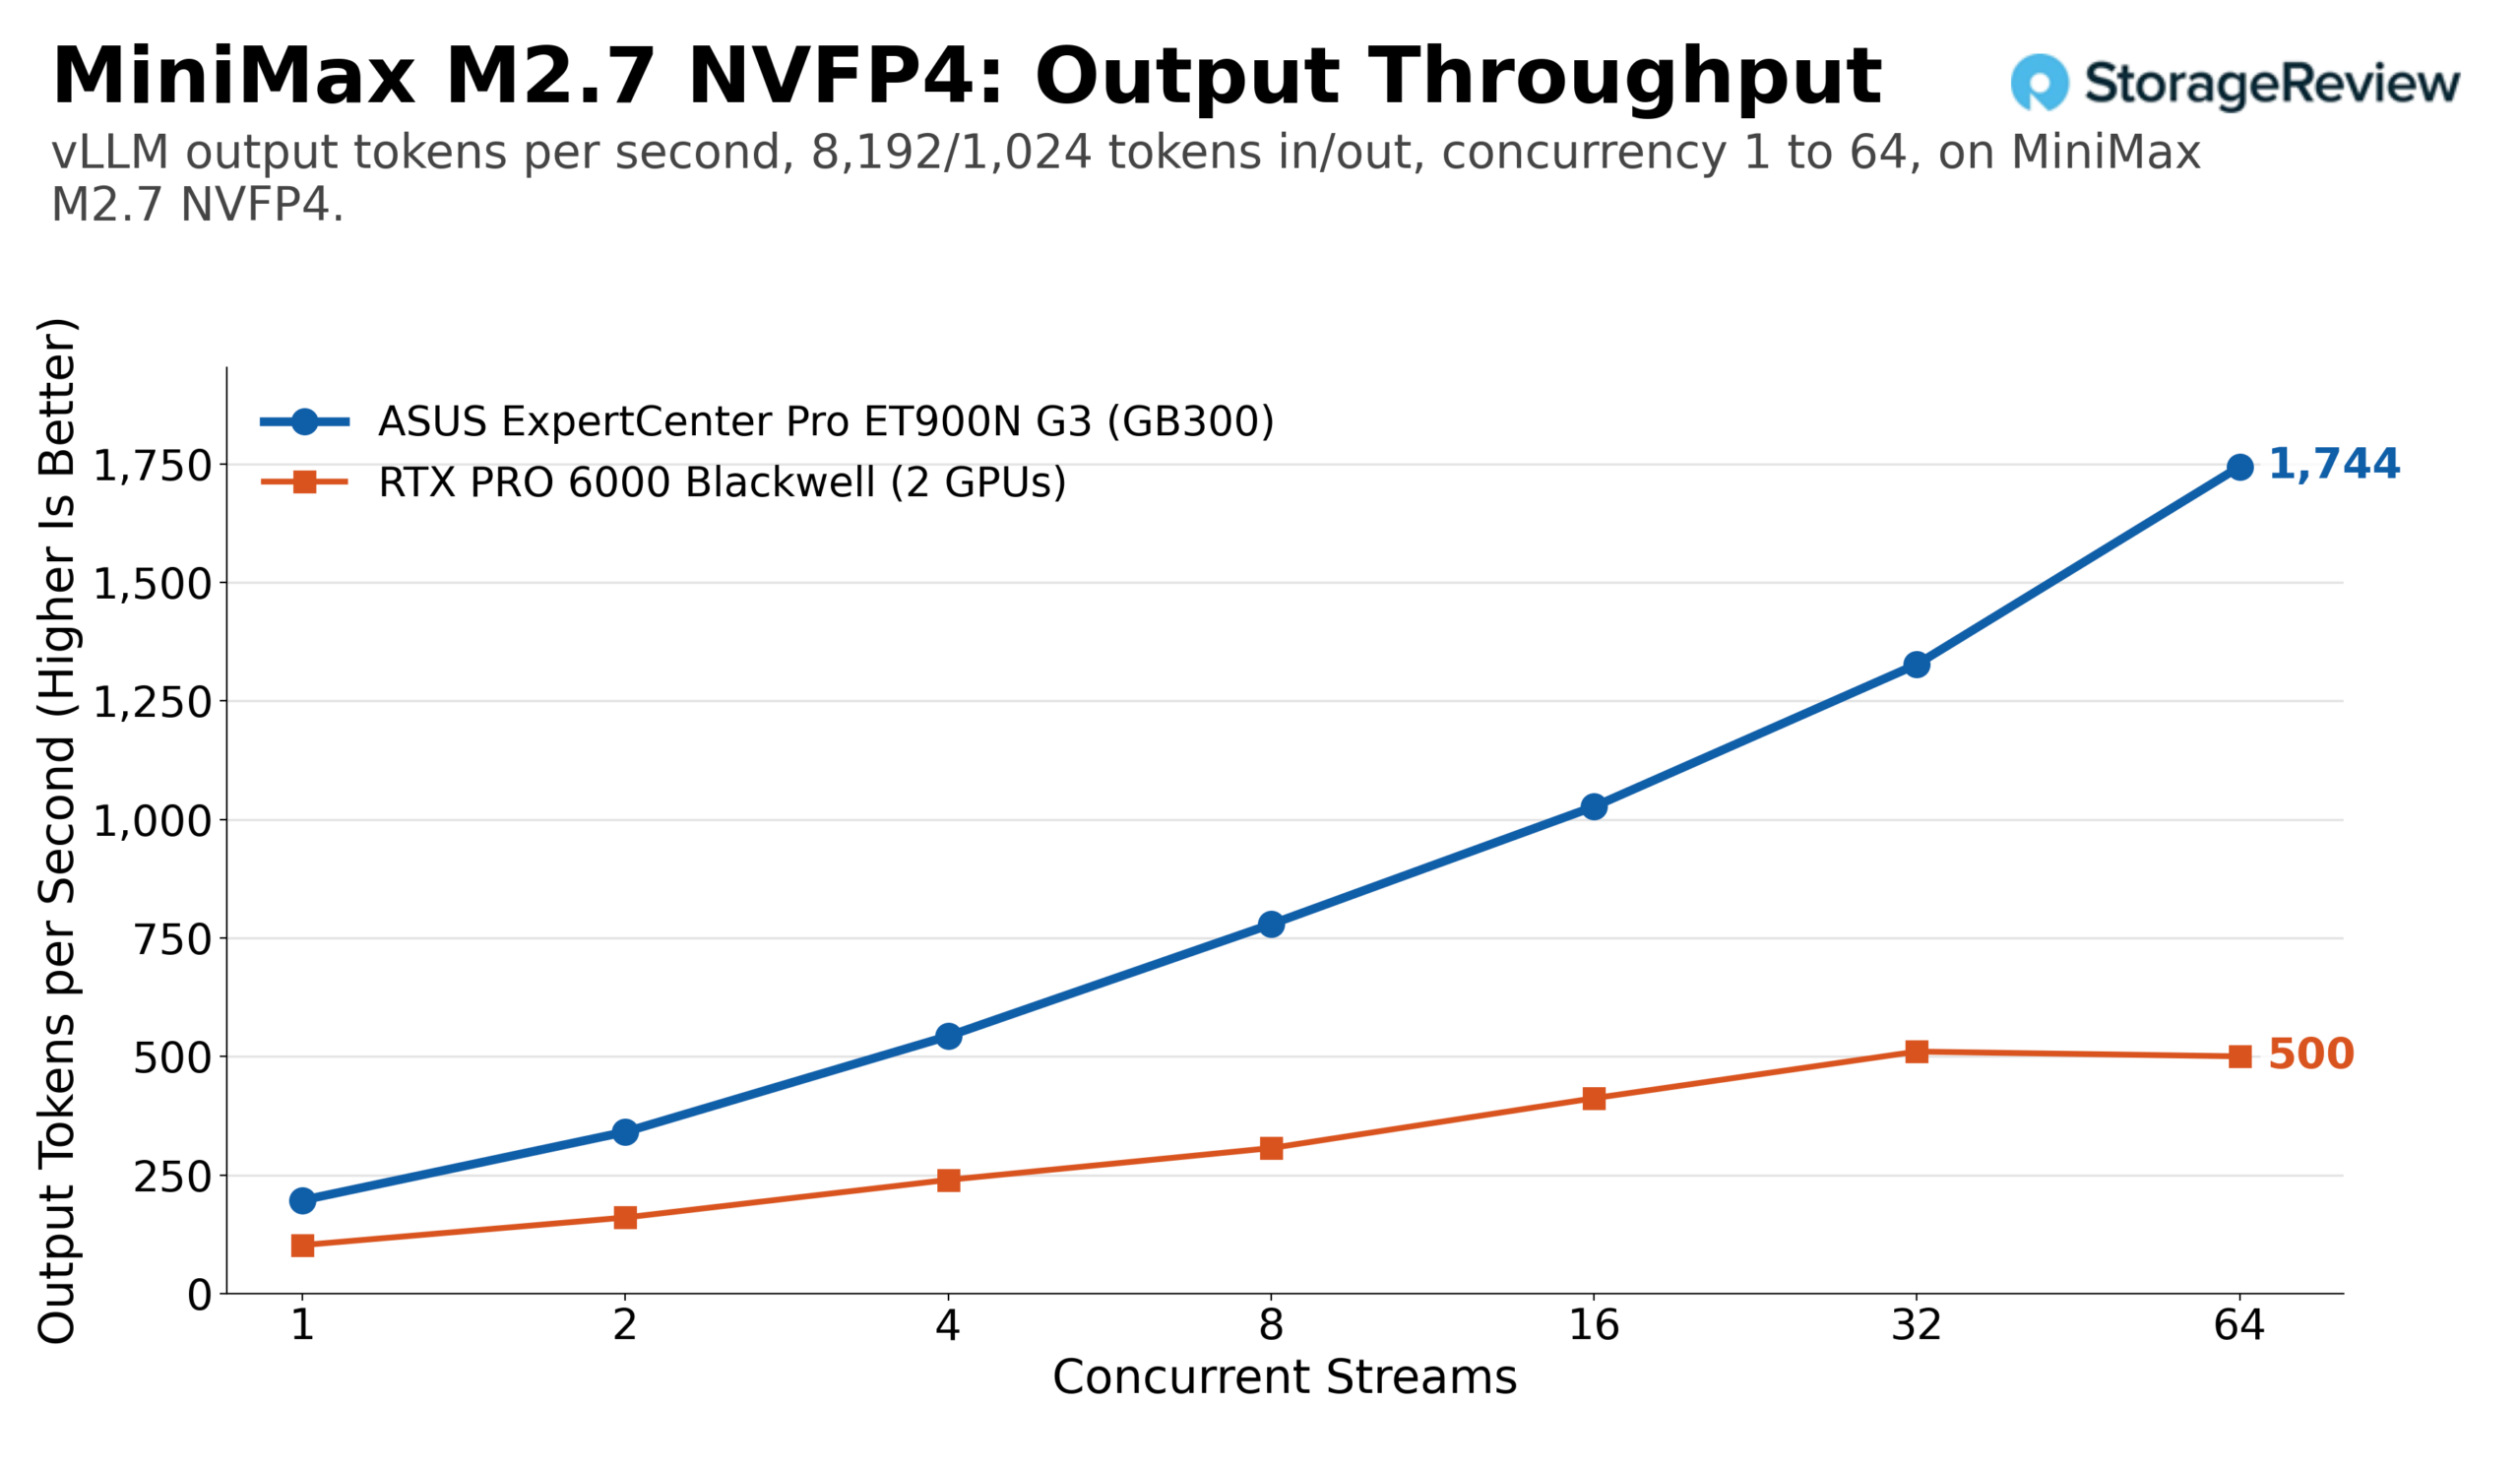
NVIDIAのNVFP4量子化におけるMiniMax M2.7は、約125GBのHBMを占有し、4つの中で最も大きくスケールアップしました。均等ワークロードでは、1つのストリームで毎秒214出力トークンから128ストリームで毎秒4,793に増加し、総スループットは9,586に達しました。プリフィルを多用した実行では、64ストリームで毎秒1,744出力トークン、毎秒15,700トークンにスケールアップしました。2枚のRTX PRO 6000カードは、半分以下の高さで同様の形状を示し、均等ワークロードで毎秒約1,930出力トークン、長いプロンプトで約510の出力トークンでピークに達しました。
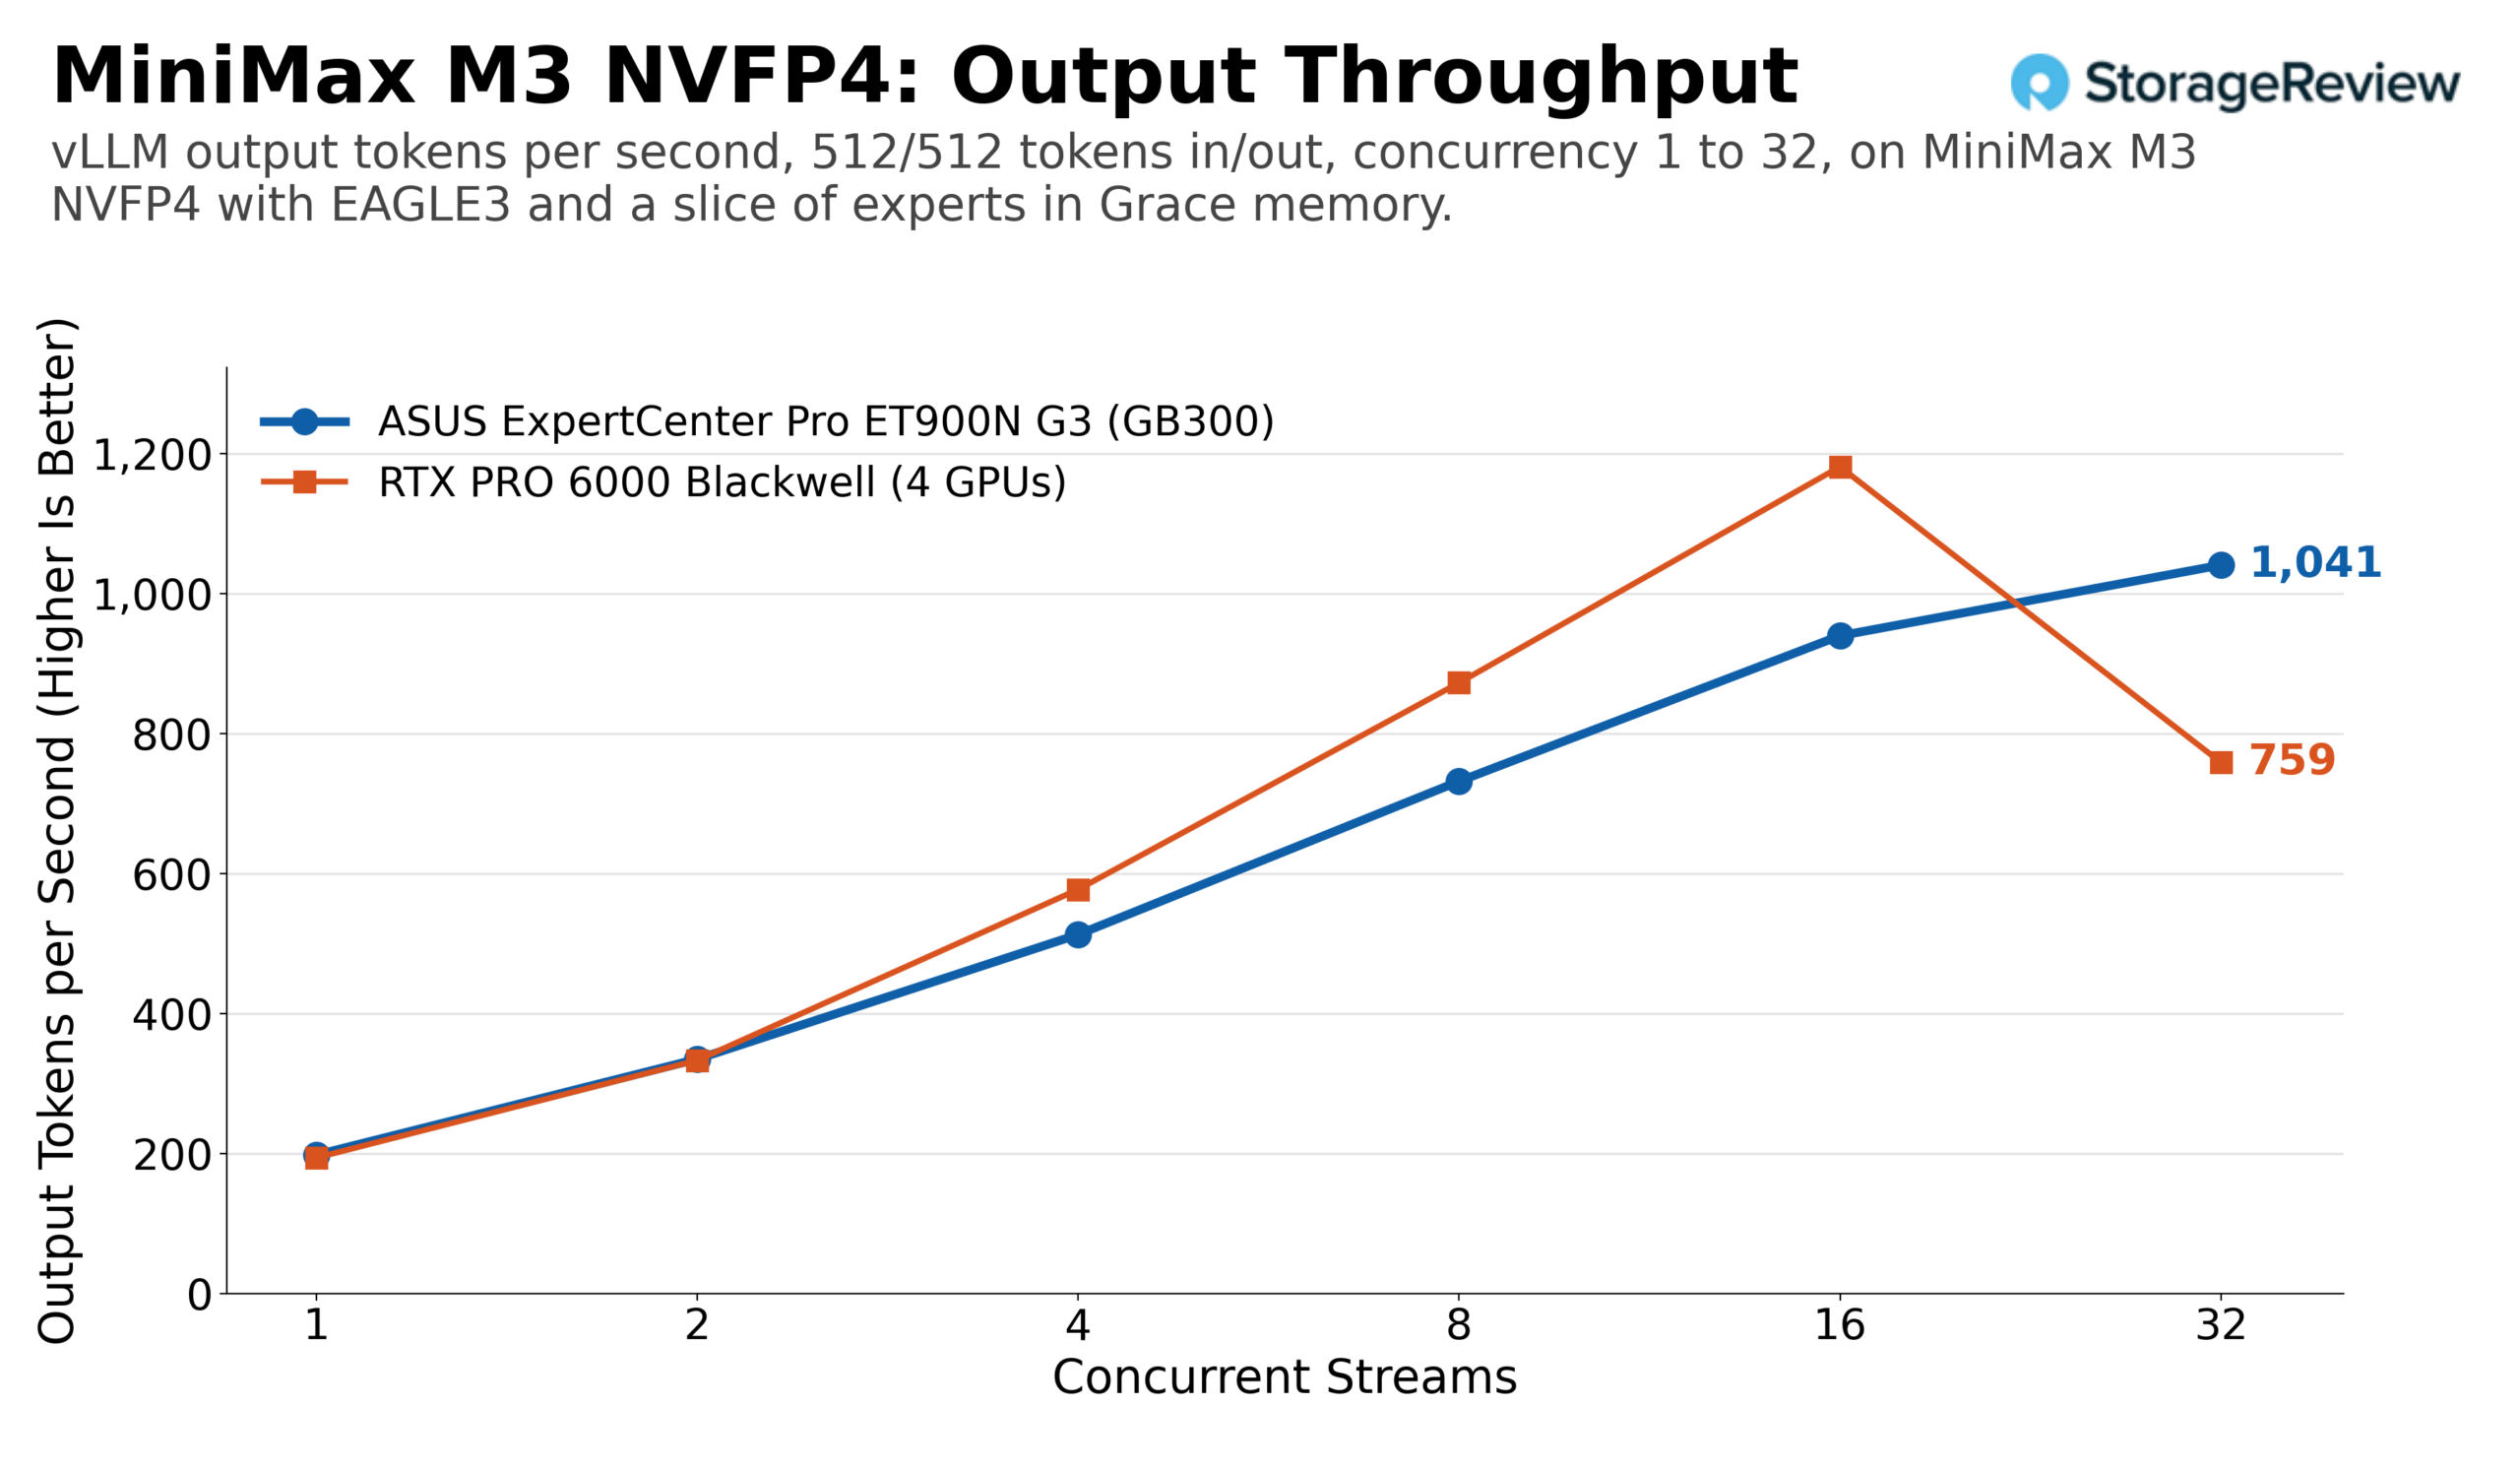
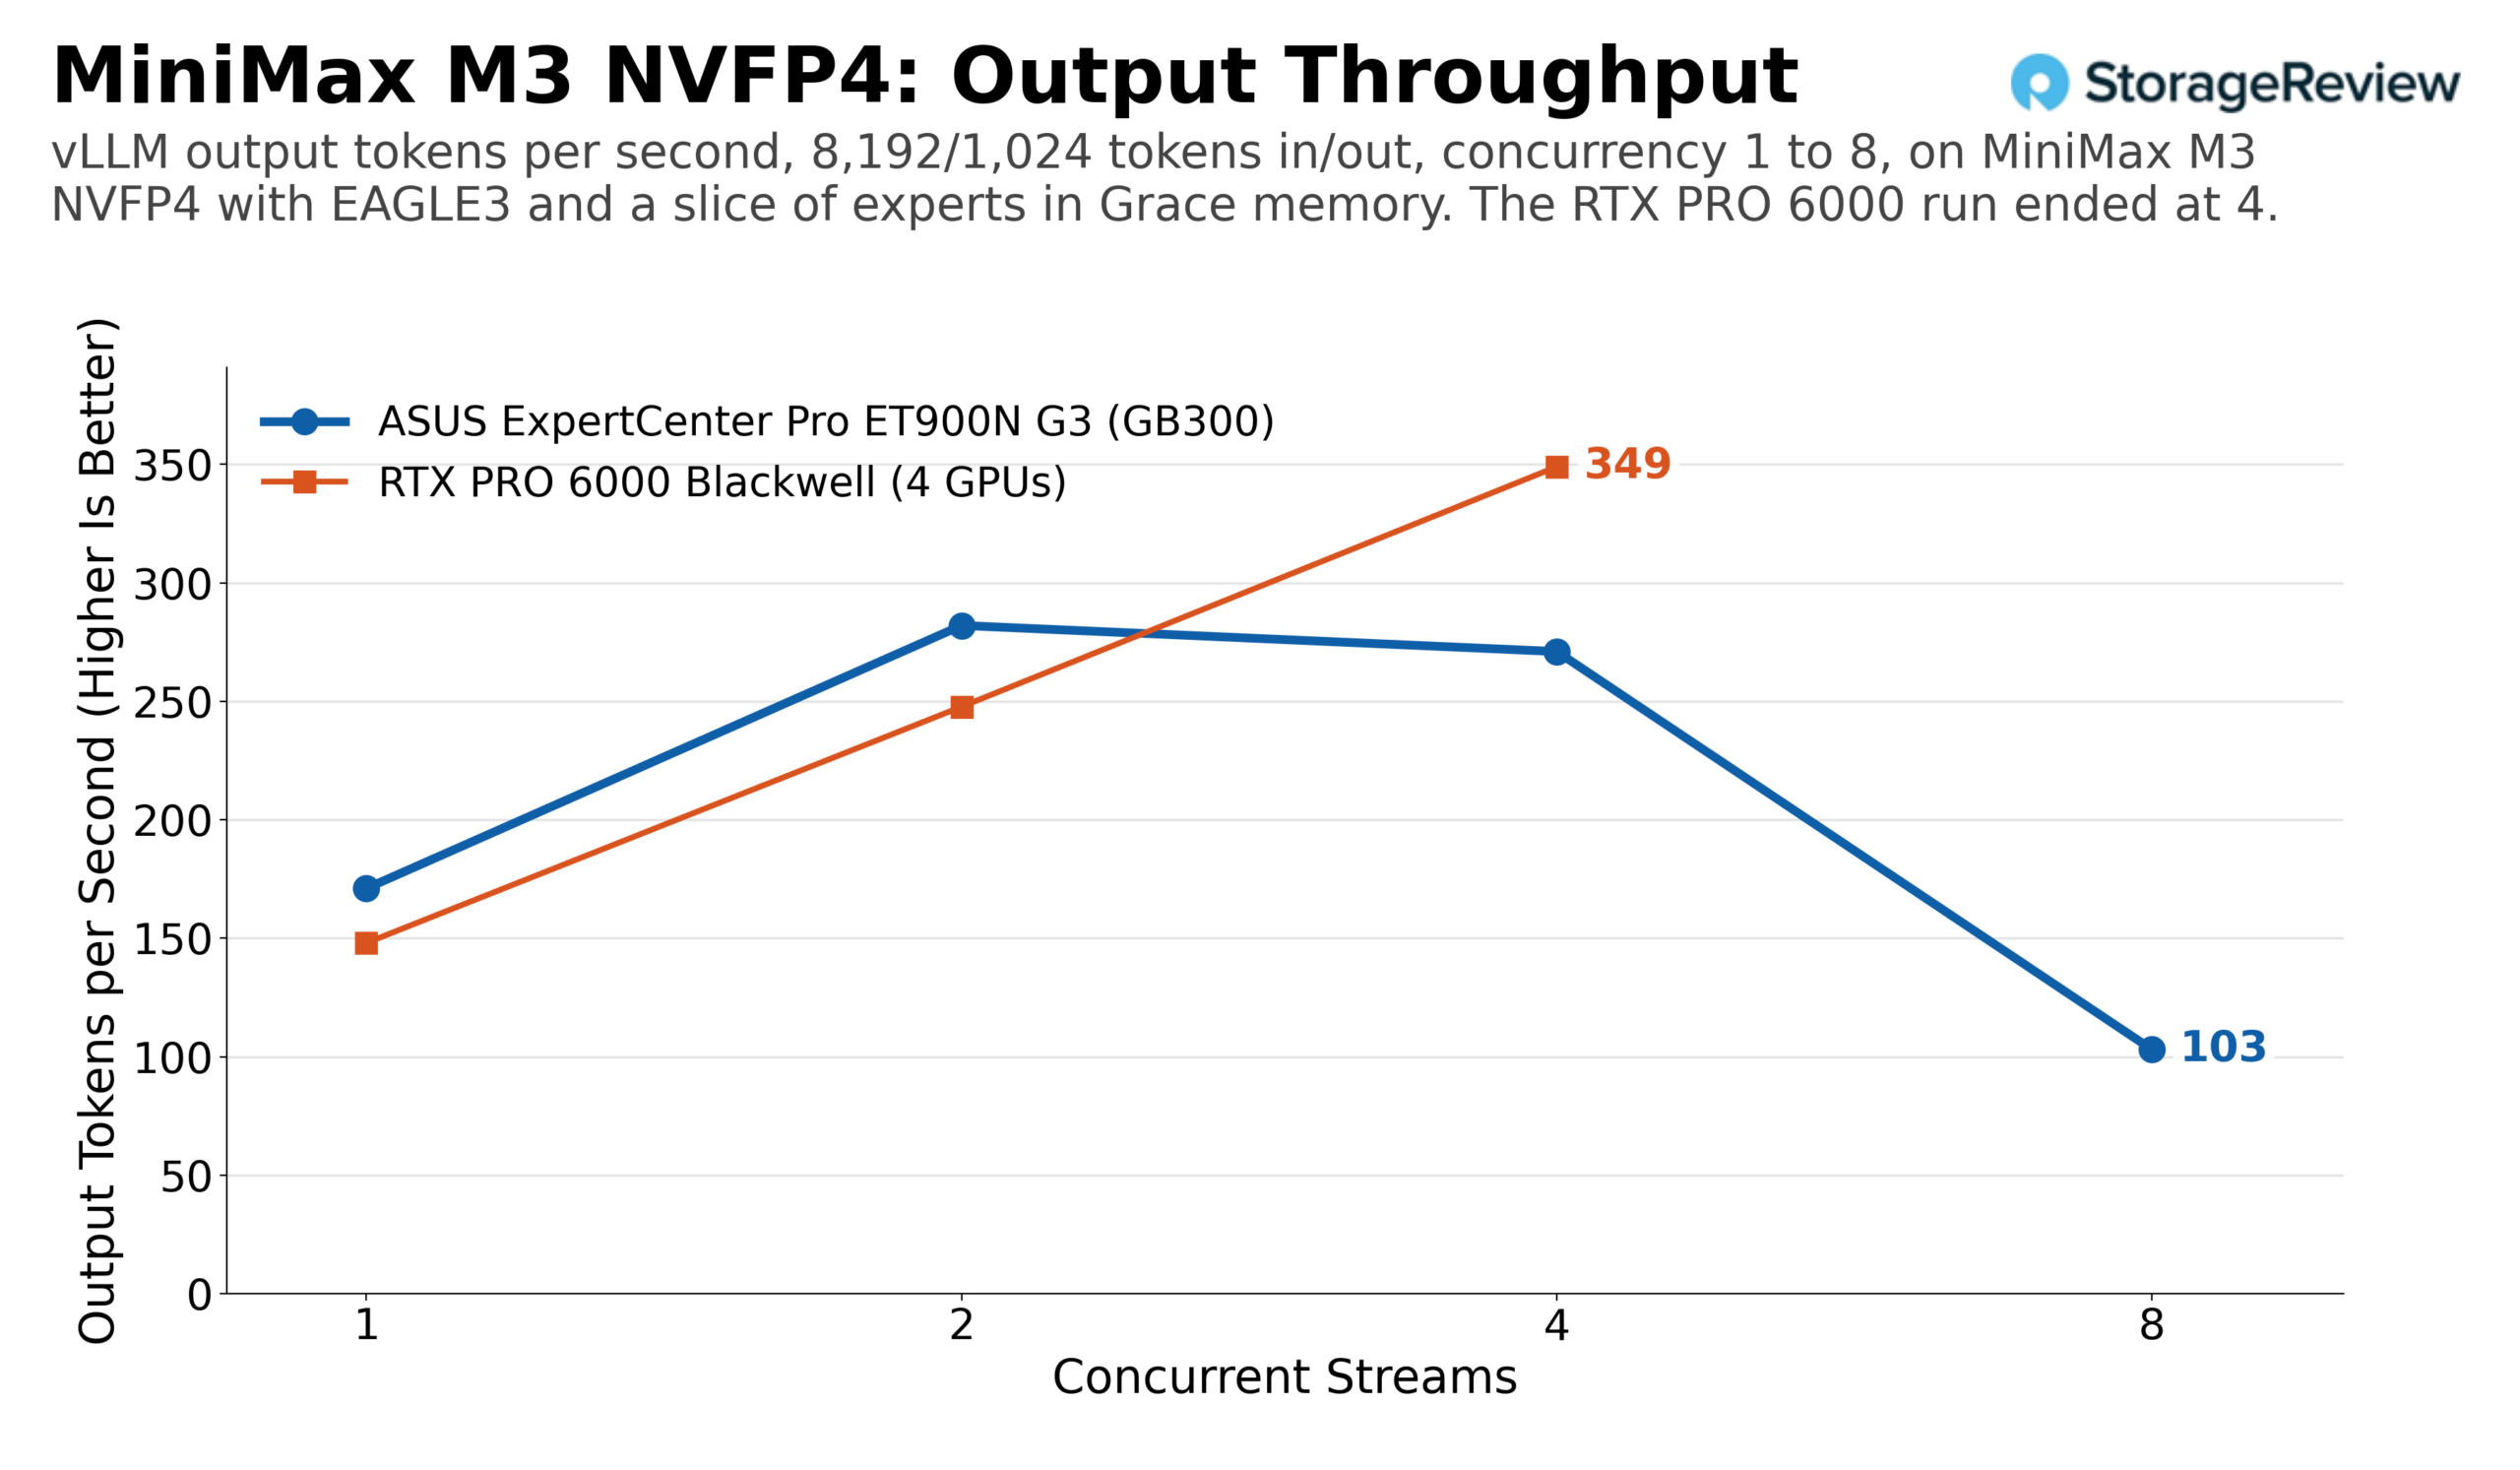
MiniMax M3 は、メモリにギリギリ収まる様子を示しています。NVFP4 チェックポイントは 252GB より小さいですが、ランタイムと KV キャッシュにもスペースが必要なため、エキスパートの一部は Grace メモリに存在し、エキスパートに触れるすべてのデコード ステップは NVLink-C2C を経由します。EAGLE3 の投機的デコードでは、ET900N G3 は同等のワークロードで 32 ストリームで毎秒 1,041 個の出力トークンに達し、プリフィルが多いプロファイルは 2 ストリームで 282 のピークに達し、4 ストリームで 271 を維持し、長いプロンプトが残りのキャッシュを消費したため 8 ストリームで 103 に低下しました。同じ投機的デコーダを備えた 4 枚の RTX PRO 6000 カードは、8 ストリームまで同調し、16 ストリームで毎秒約 1,180 個の出力トークンでリードしましたが、32 ストリームで約 760 に低下しました。プリフィルを多用したプロファイルでは、4枚のカードボックスは、Stationの271に対し、4つのストリームで毎秒約349個の出力トークンを保持しました。HBMの境界ぎりぎりに位置するモデルは、このセットの中で、4枚のカードにわたる384GBのVRAMが、オフロードを加えた252GBのHBMと競合する唯一の場所です。
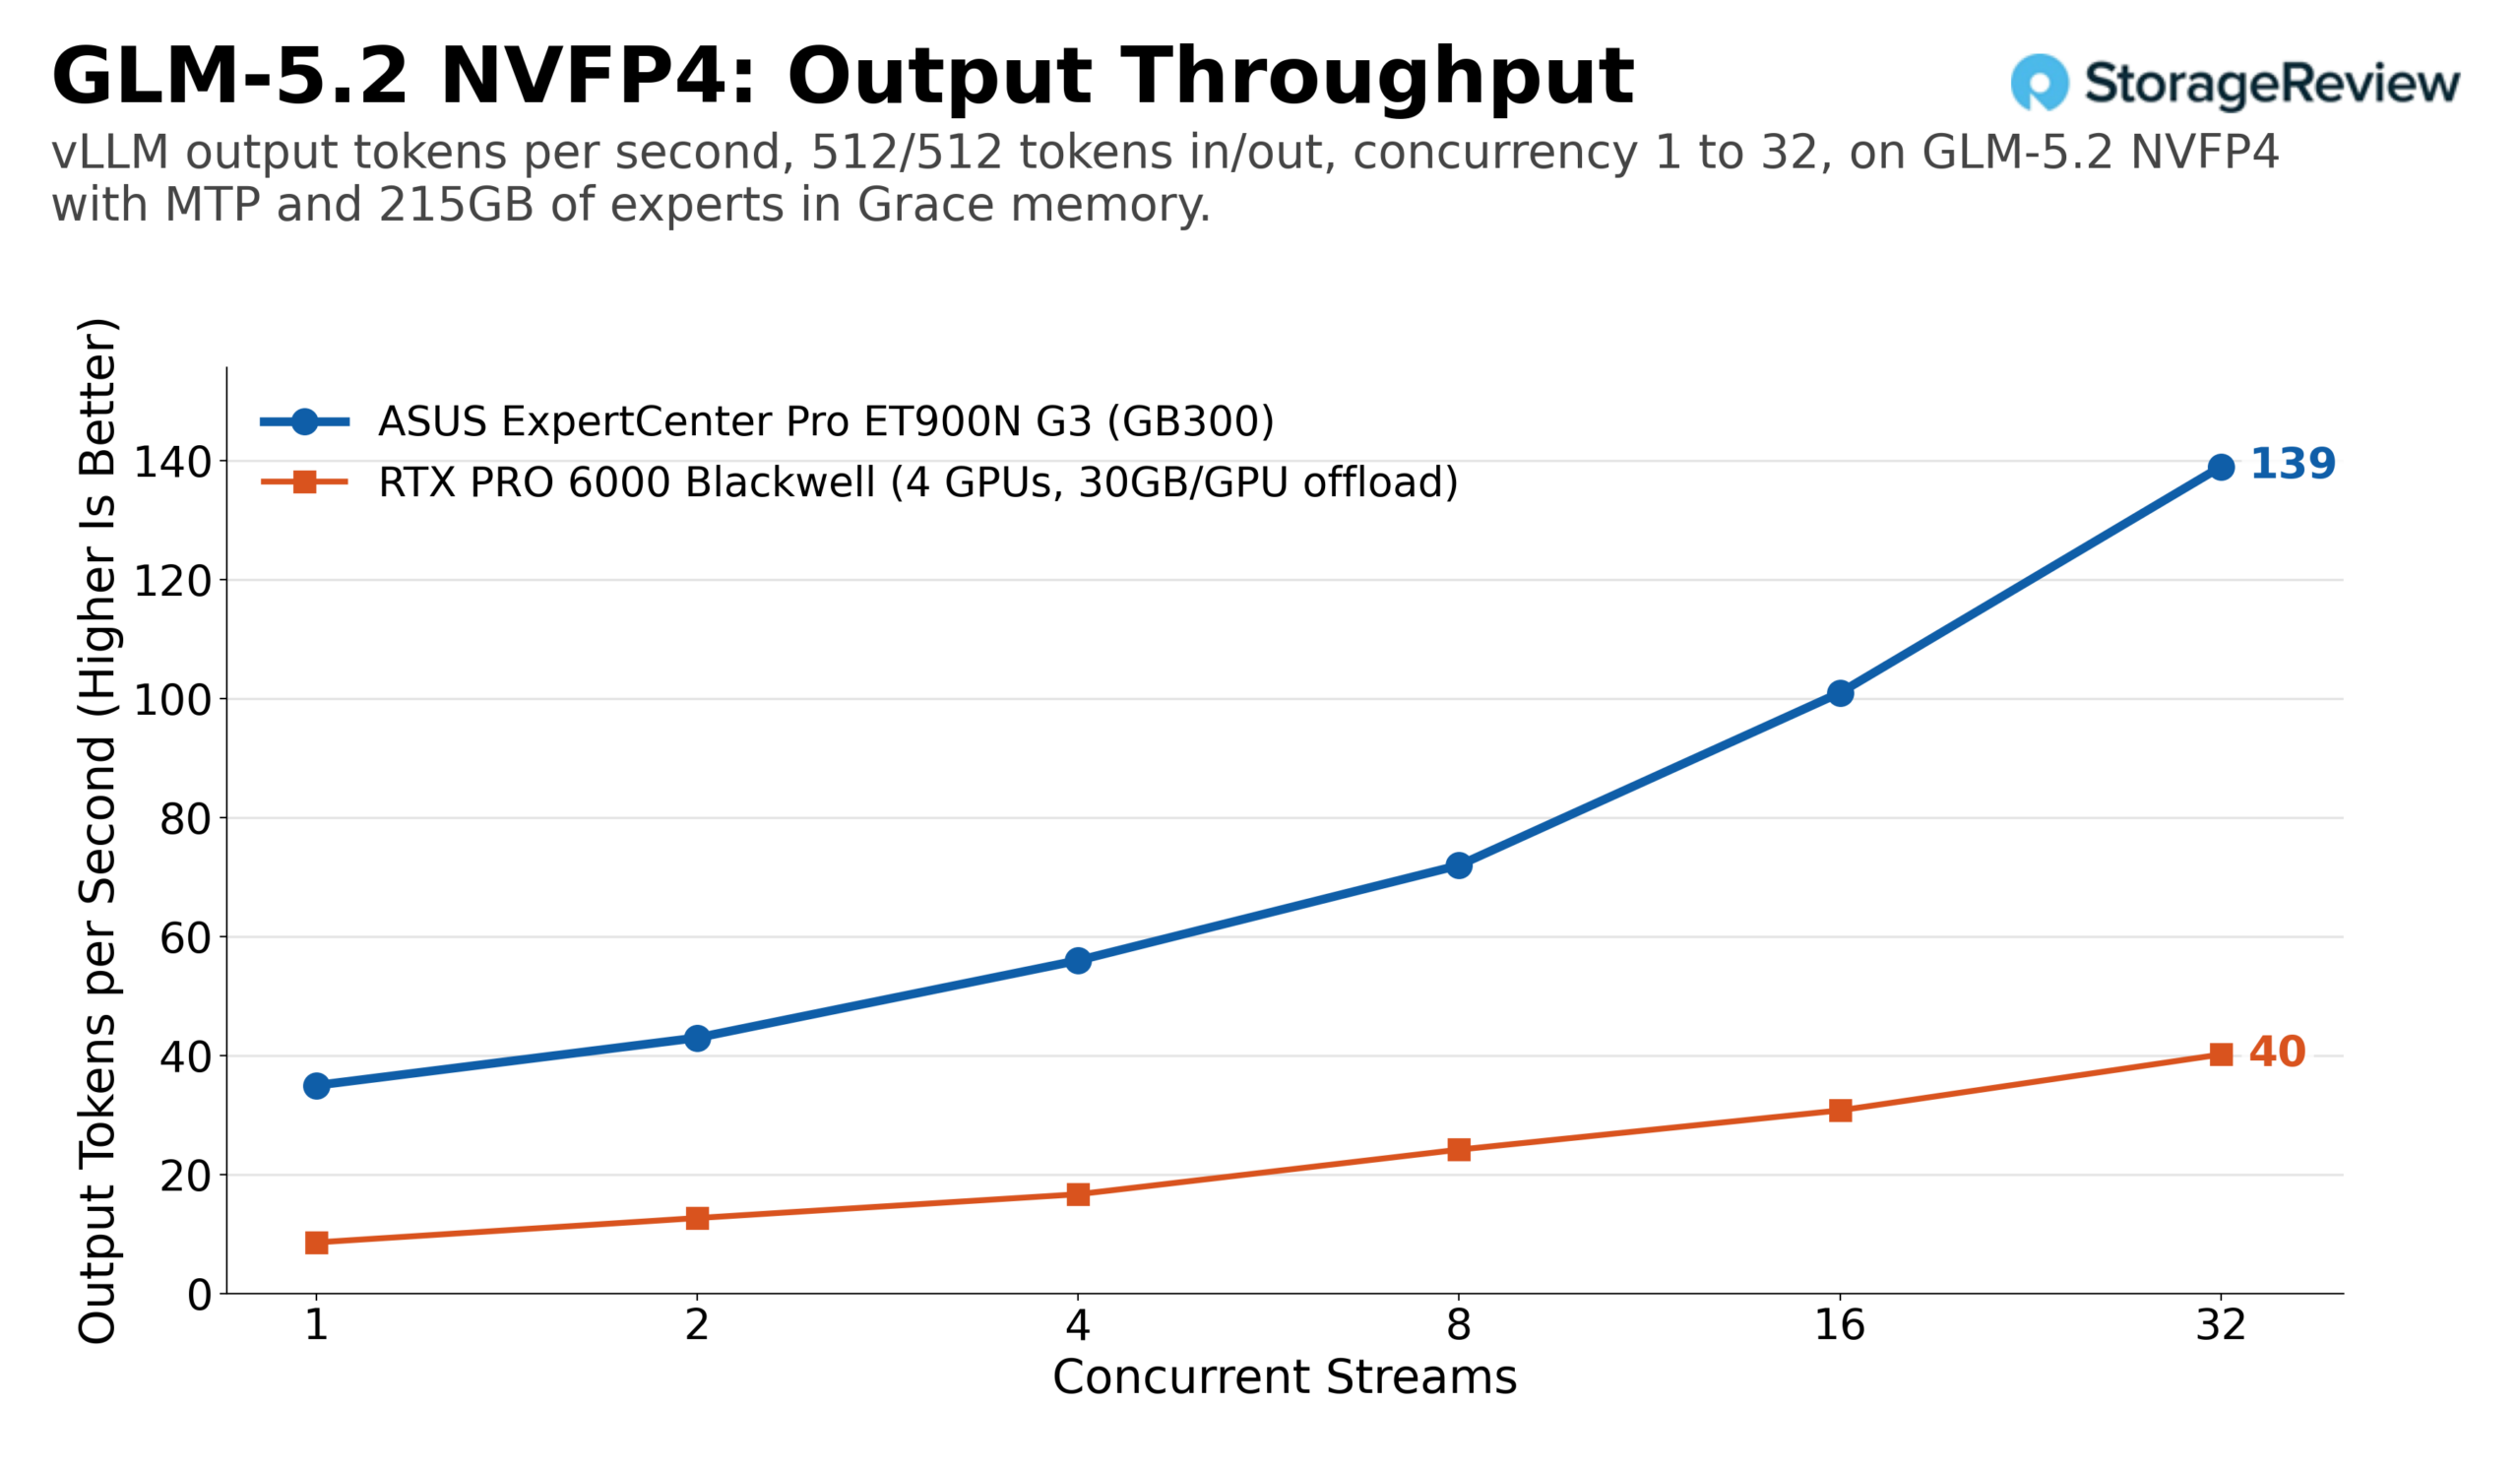
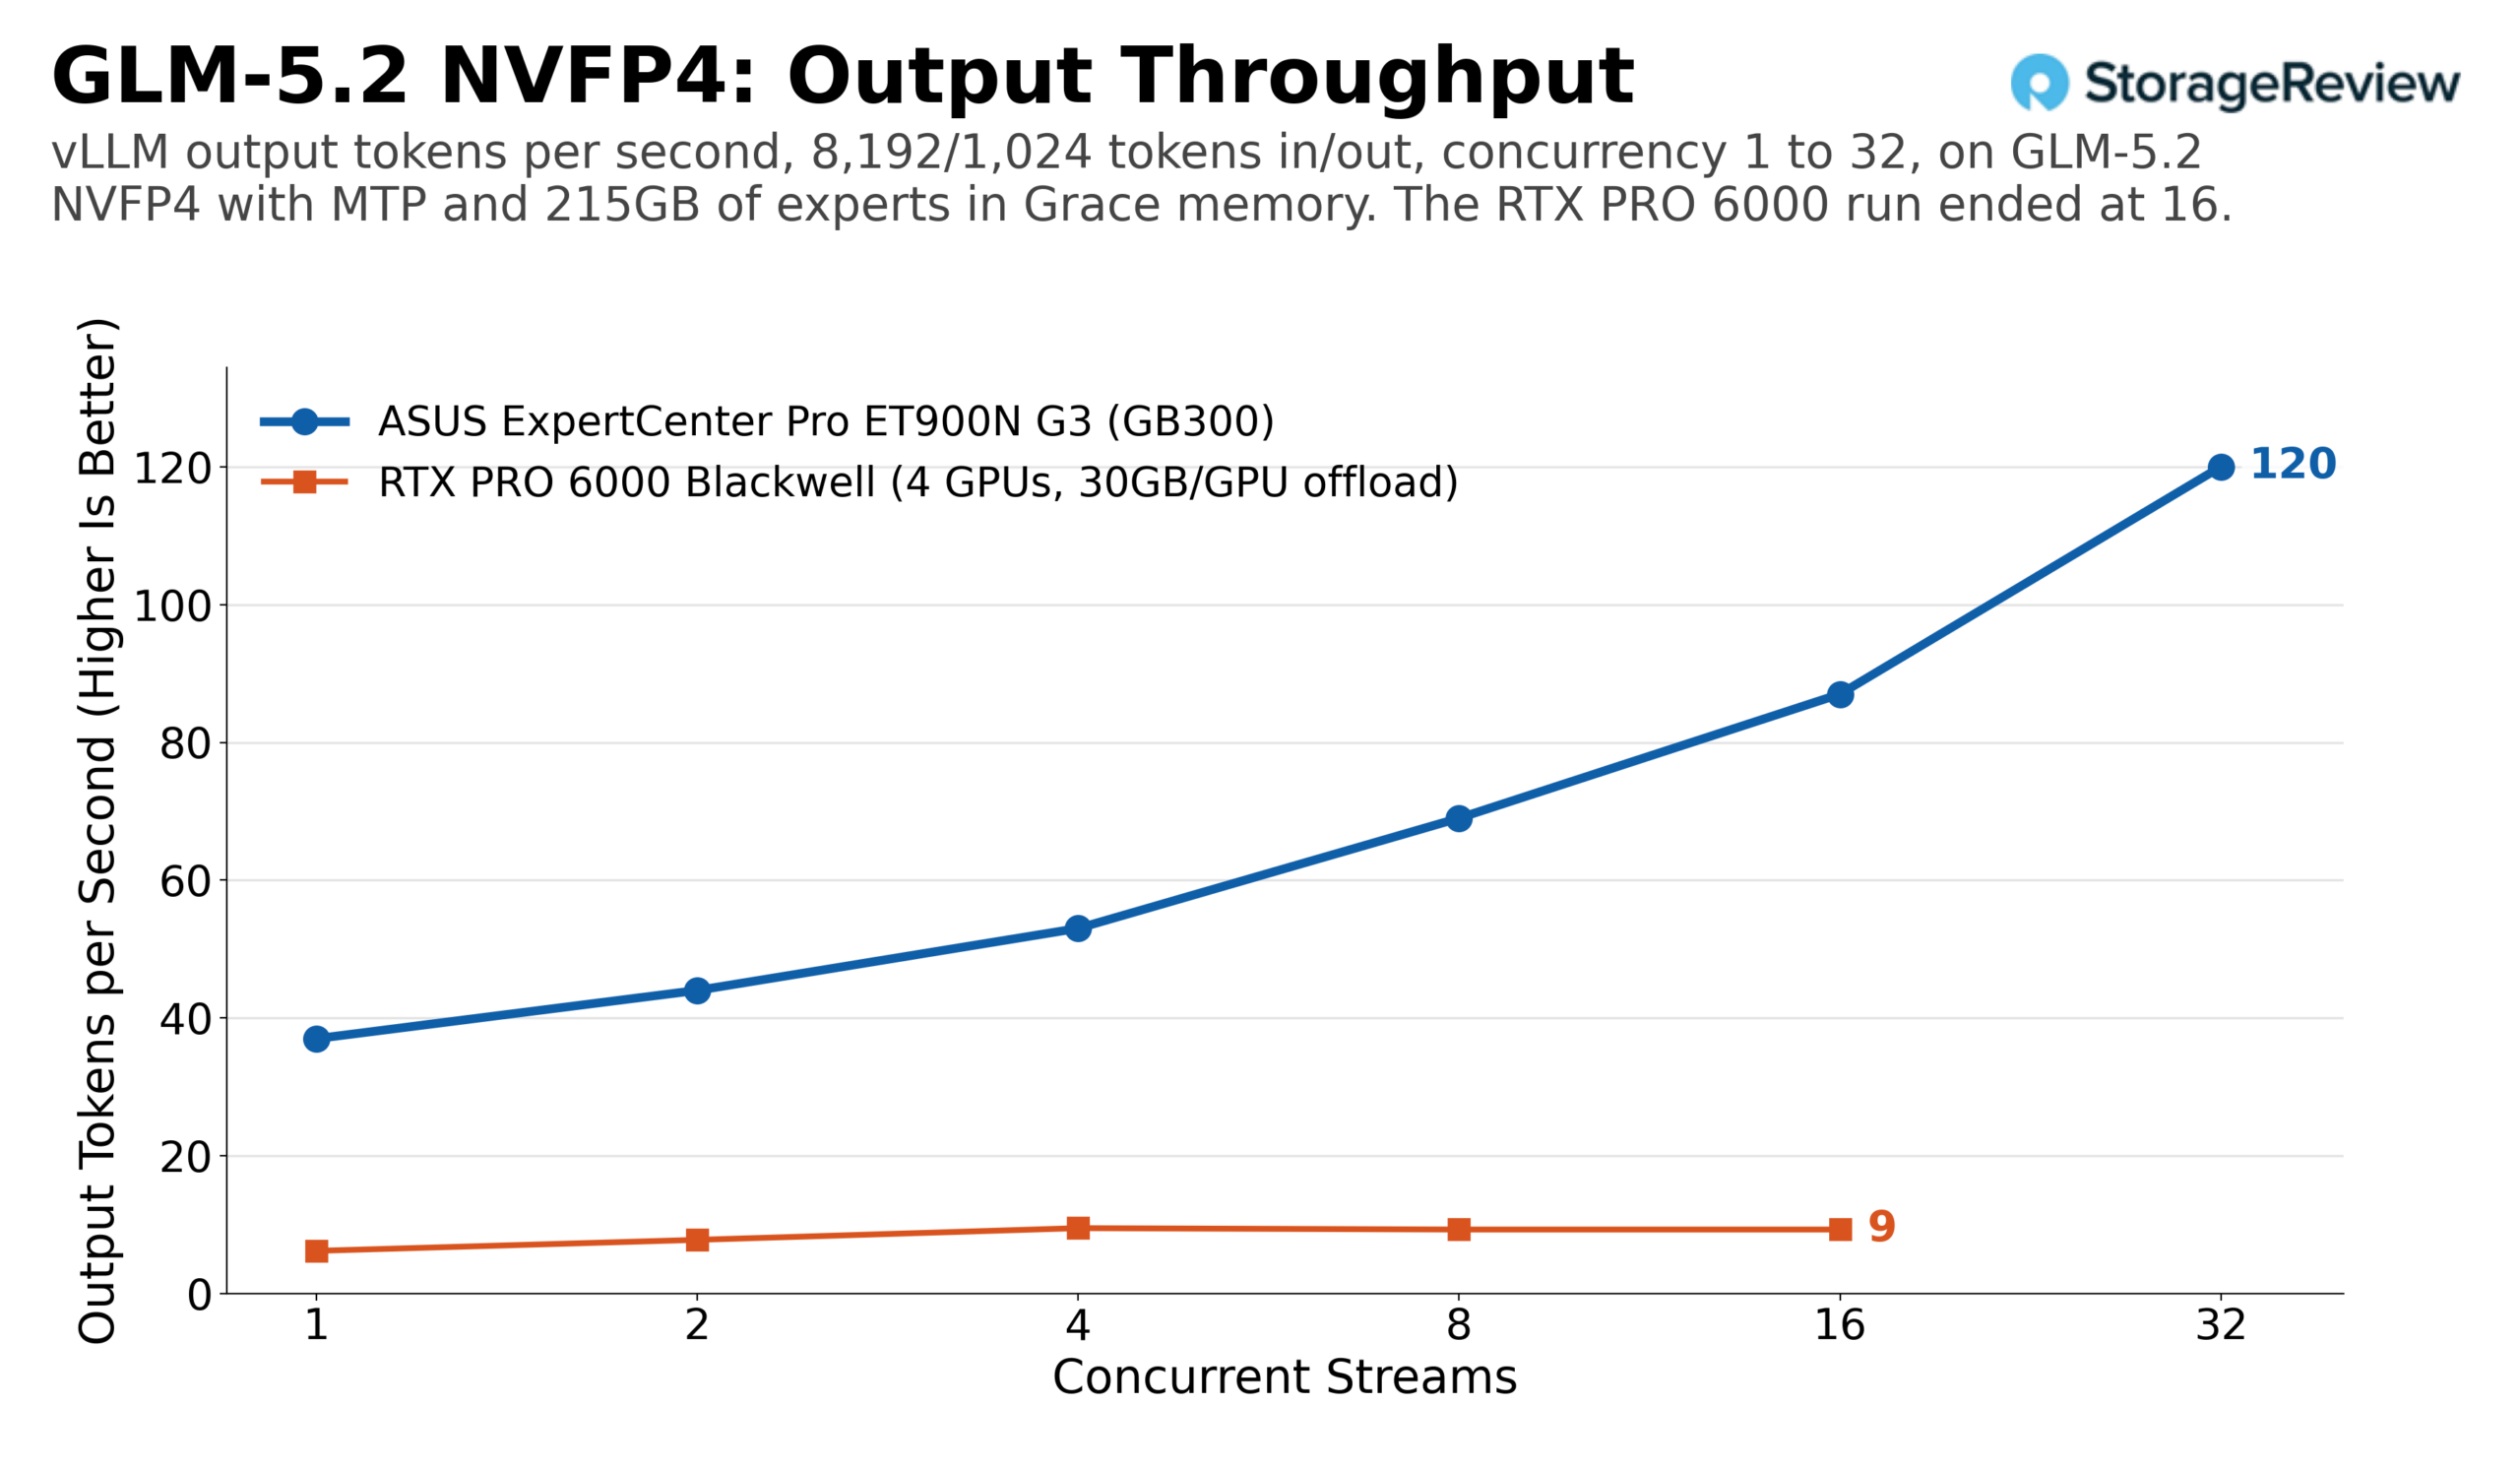
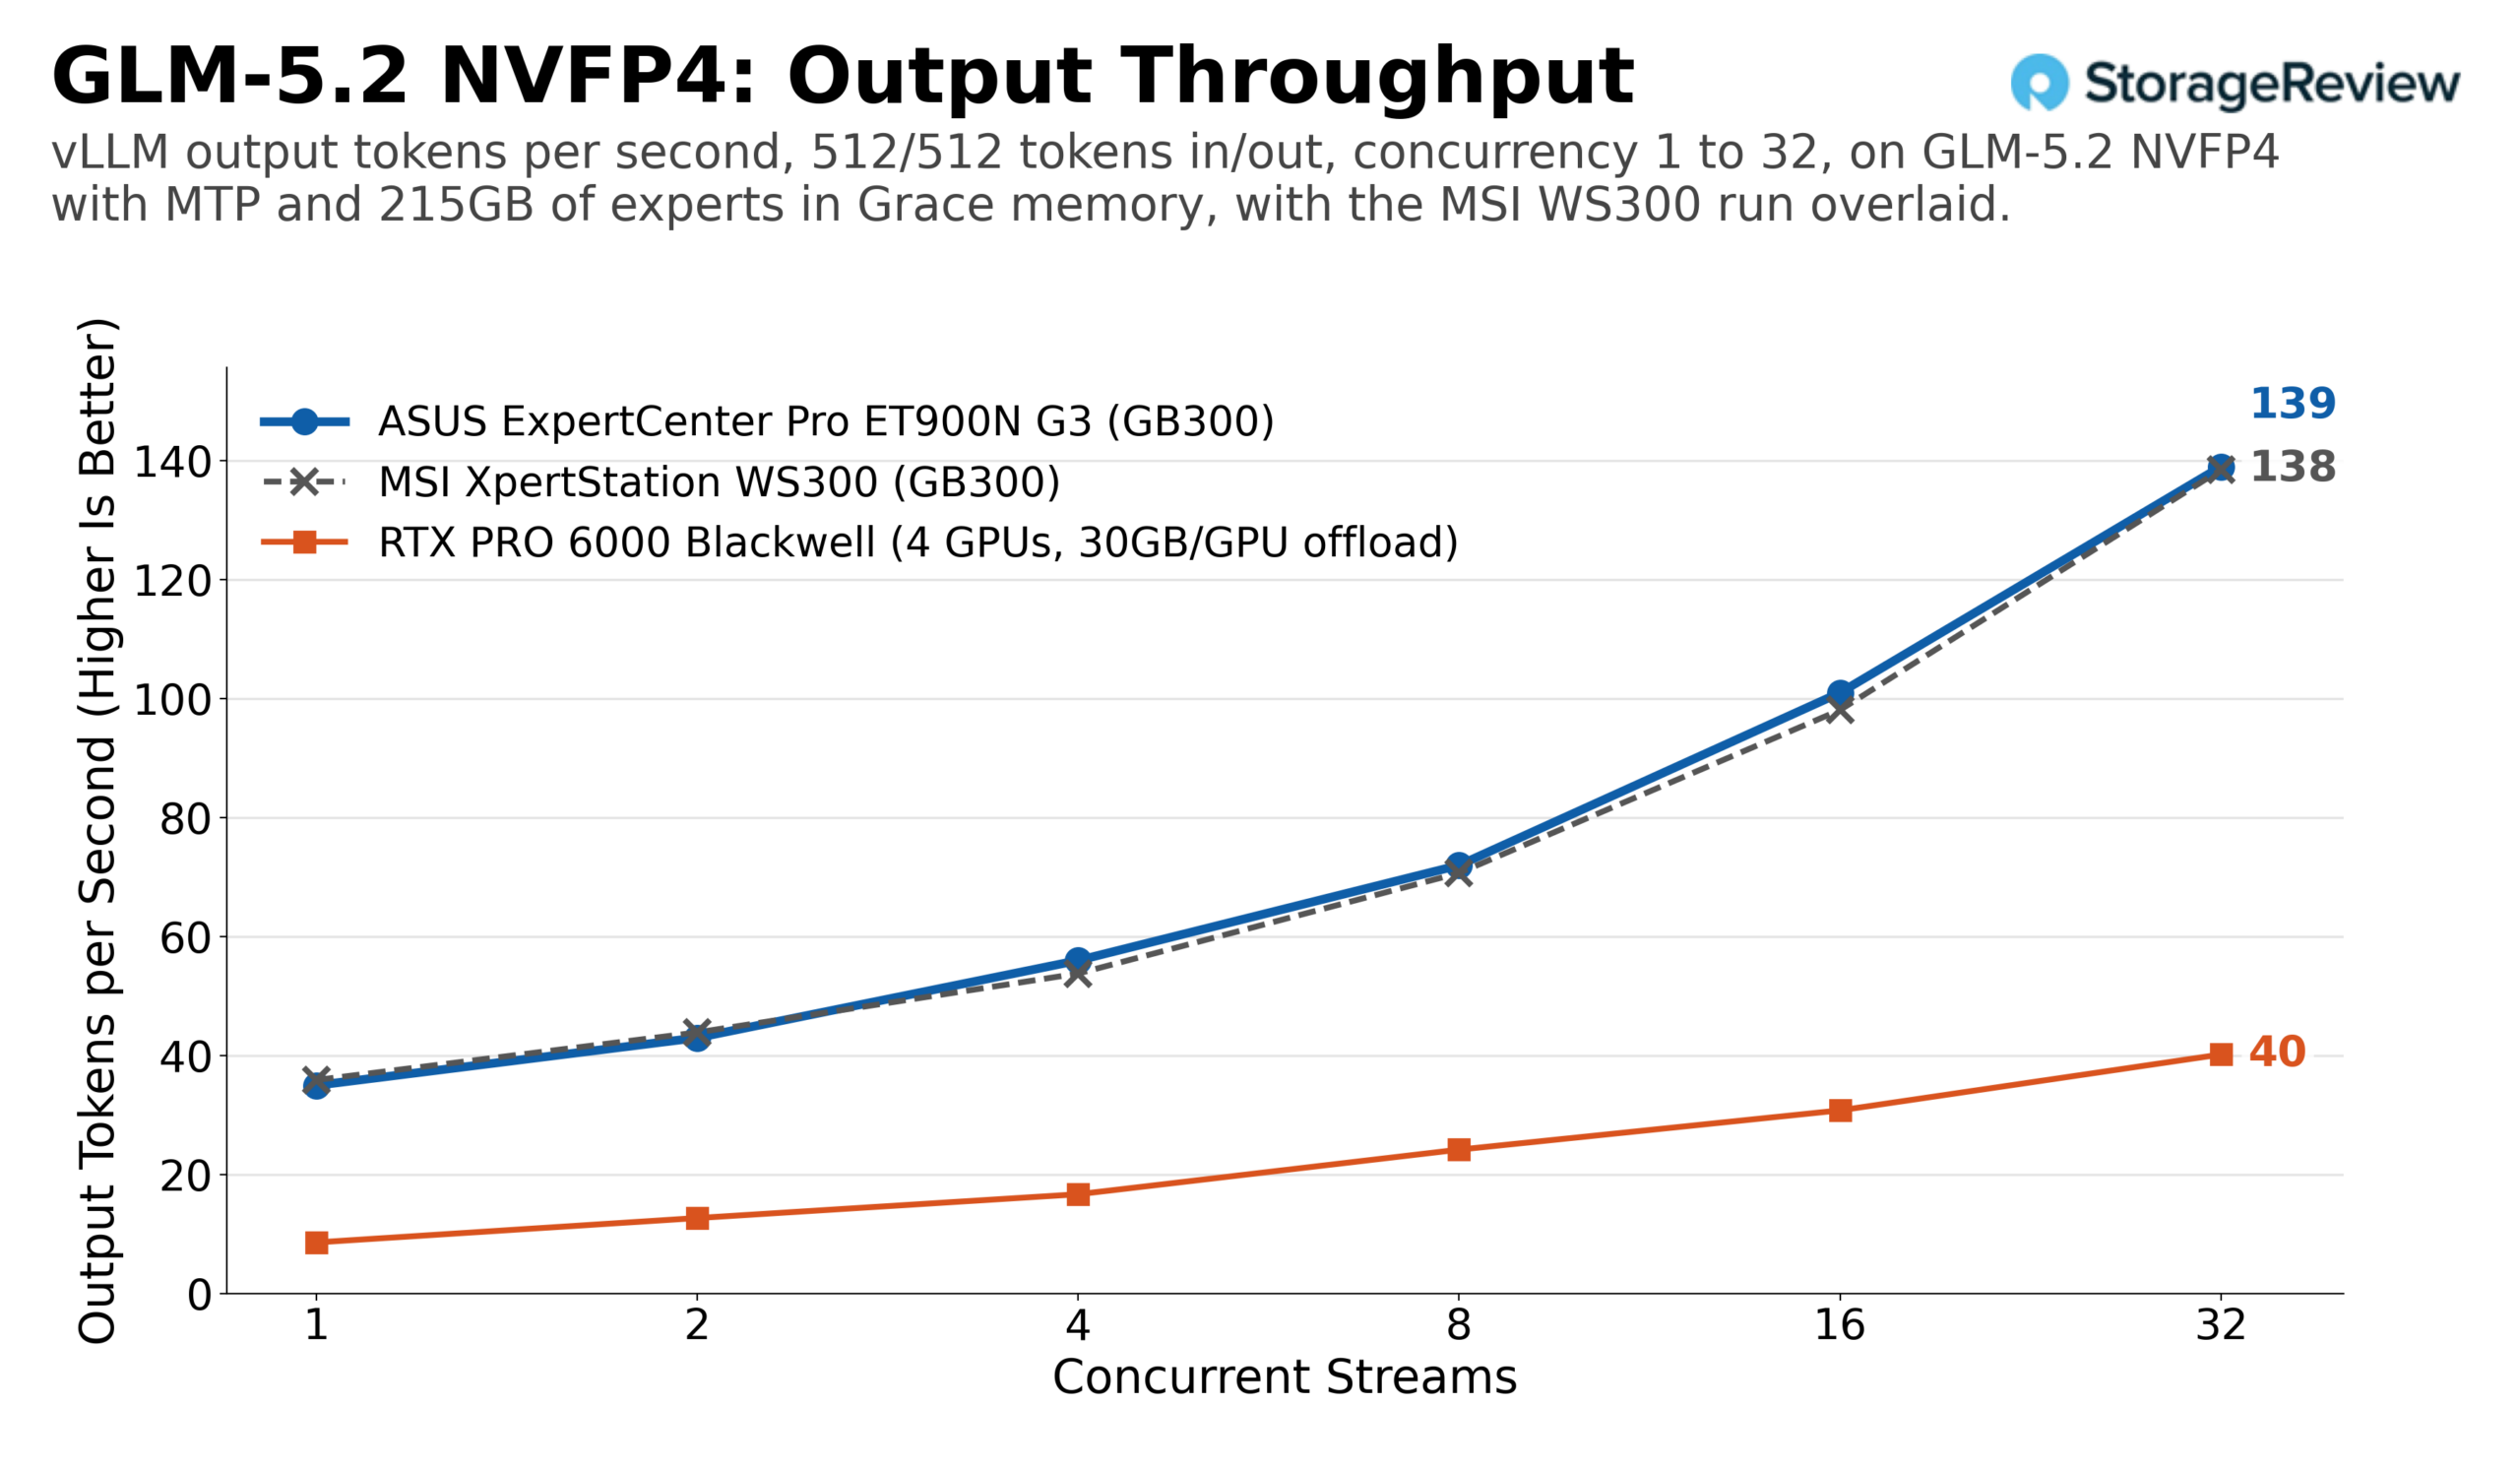
GLM-5.2 は、コヒーレント プールによってのみ可能となるユース ケースです。NVFP4 チェックポイントは、MTP 投機的デコードを使用して、約 215GB のエキスパート重みを Grace メモリに保持し、ET900N G3 は、同じワークロードで 1 ストリームで毎秒 35 出力トークン、32 ストリームで毎秒 139 出力トークンでそれを処理しました。総スループットは 277 に達しました。プリフィルが多めのプロファイルでは、スイープは 32 ストリームまで実行され、毎秒 120 出力トークン、合計 1,079 トークンに達しました。4 枚の RTX PRO 6000 カードは、それぞれ約 30GB をホスト メモリにオフロードし、32 ストリームで毎秒約 40 出力トークンを管理し、4 ストリーム以降は長いプロンプトで毎秒約 9 ~ 10 に平坦化しました。どちらのシステムも433GBモデルを高速に感じさせるものではありませんが、GB300の396GB/s LPDDR5Xと900GB/s NVLink-C2Cパスは、4枚のカードにまたがるPCIe接続のホストメモリでは限界に達するところから、オフロードされたエキスパートへのスケーリングを継続します。
MSI WS300と比較すると、ET900N G3の最先端モデルの結果は、比較可能なすべてのポイントで約1%以内に収まっています。DeepSeek V4 Flashでは、両方のタワーで32ストリームで毎秒1,766出力トークン、MiniMax M2.7では128で4,793対4,801、MiniMax M3では両方のタワーで32で1,041、GLM-5.2では両方のタワーで32で139です。
RTX PRO 6000、H200 NVL、およびDGX Sparkとの共通モデル
ベンチマークの後半では、すべてのシステムで処理できるほど小さなモデルを使用します。具体的には、ネイティブMXFP4のGPT-OSS-20Bと120B、BF16とFP8のLlama 3.1 8B、BF16とFP8のMistral Small 24B、BF16とFP8のQwen3 Coder 30Bです。WS300のレビュー以降に新たに加わったのは、NVIDIAの141GB HopperカードであるH200 NVLで、これにより比較対象に1世代前のデータセンターアクセラレータが追加されました。
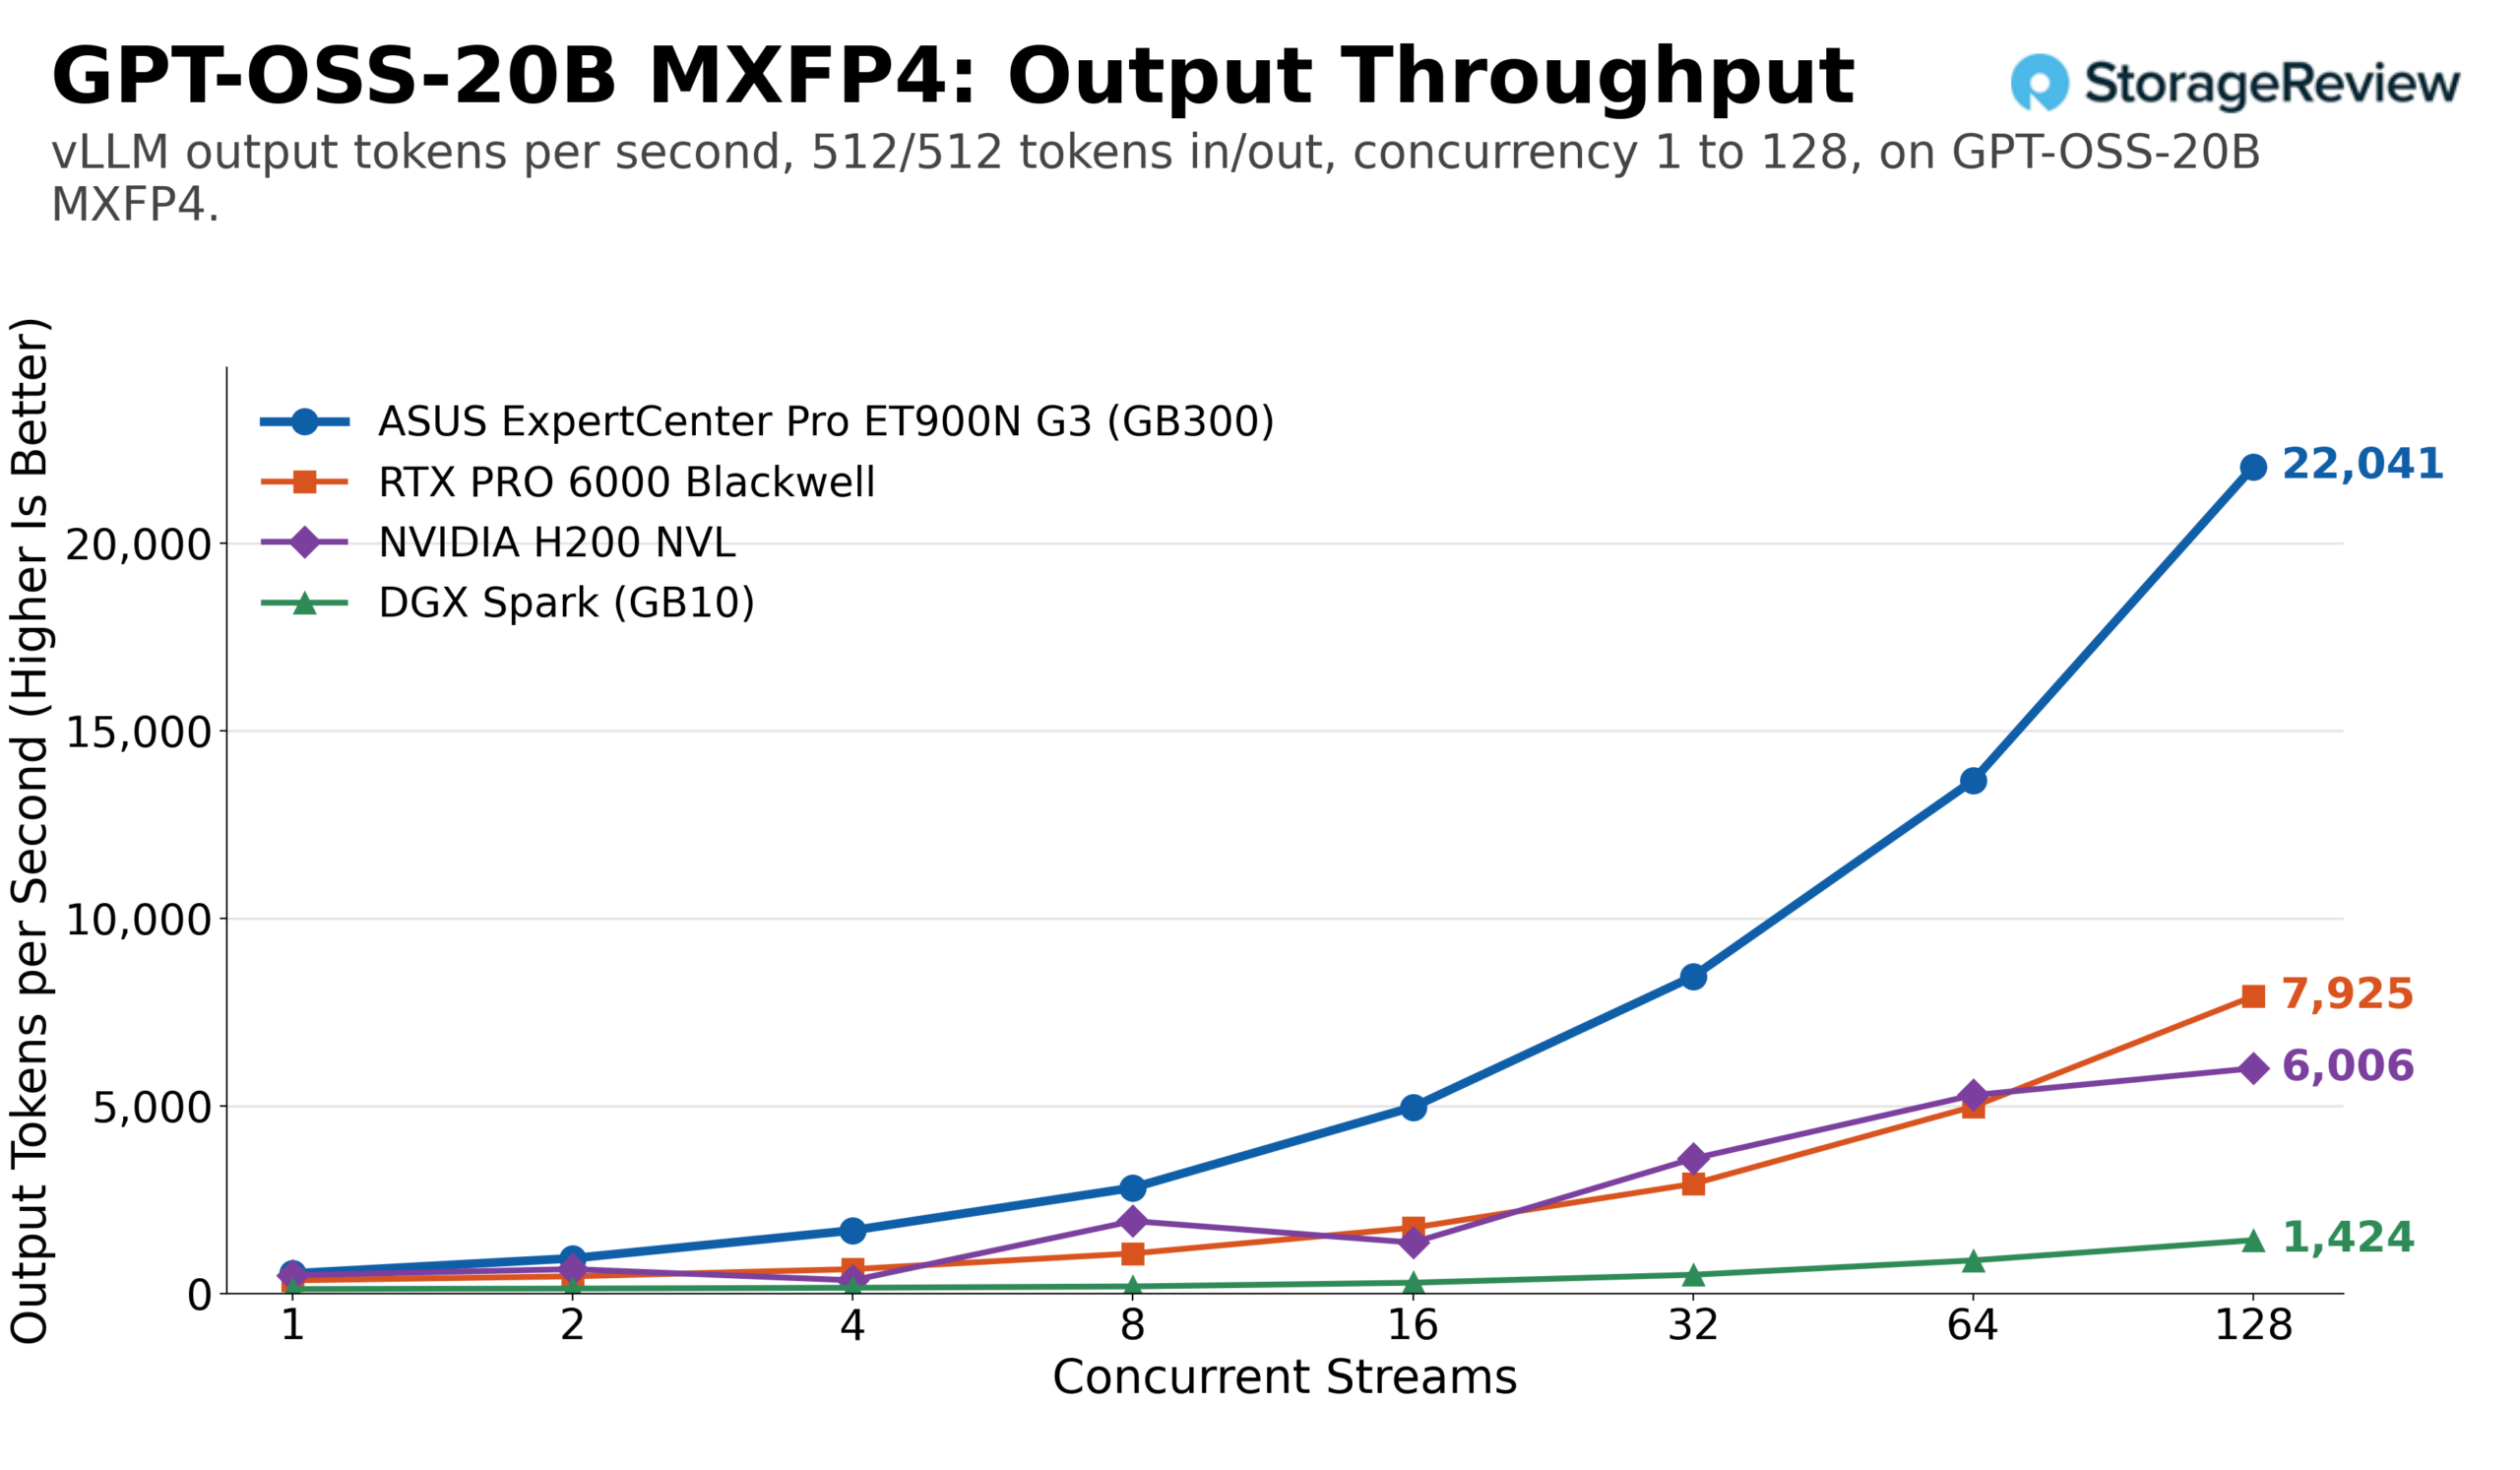
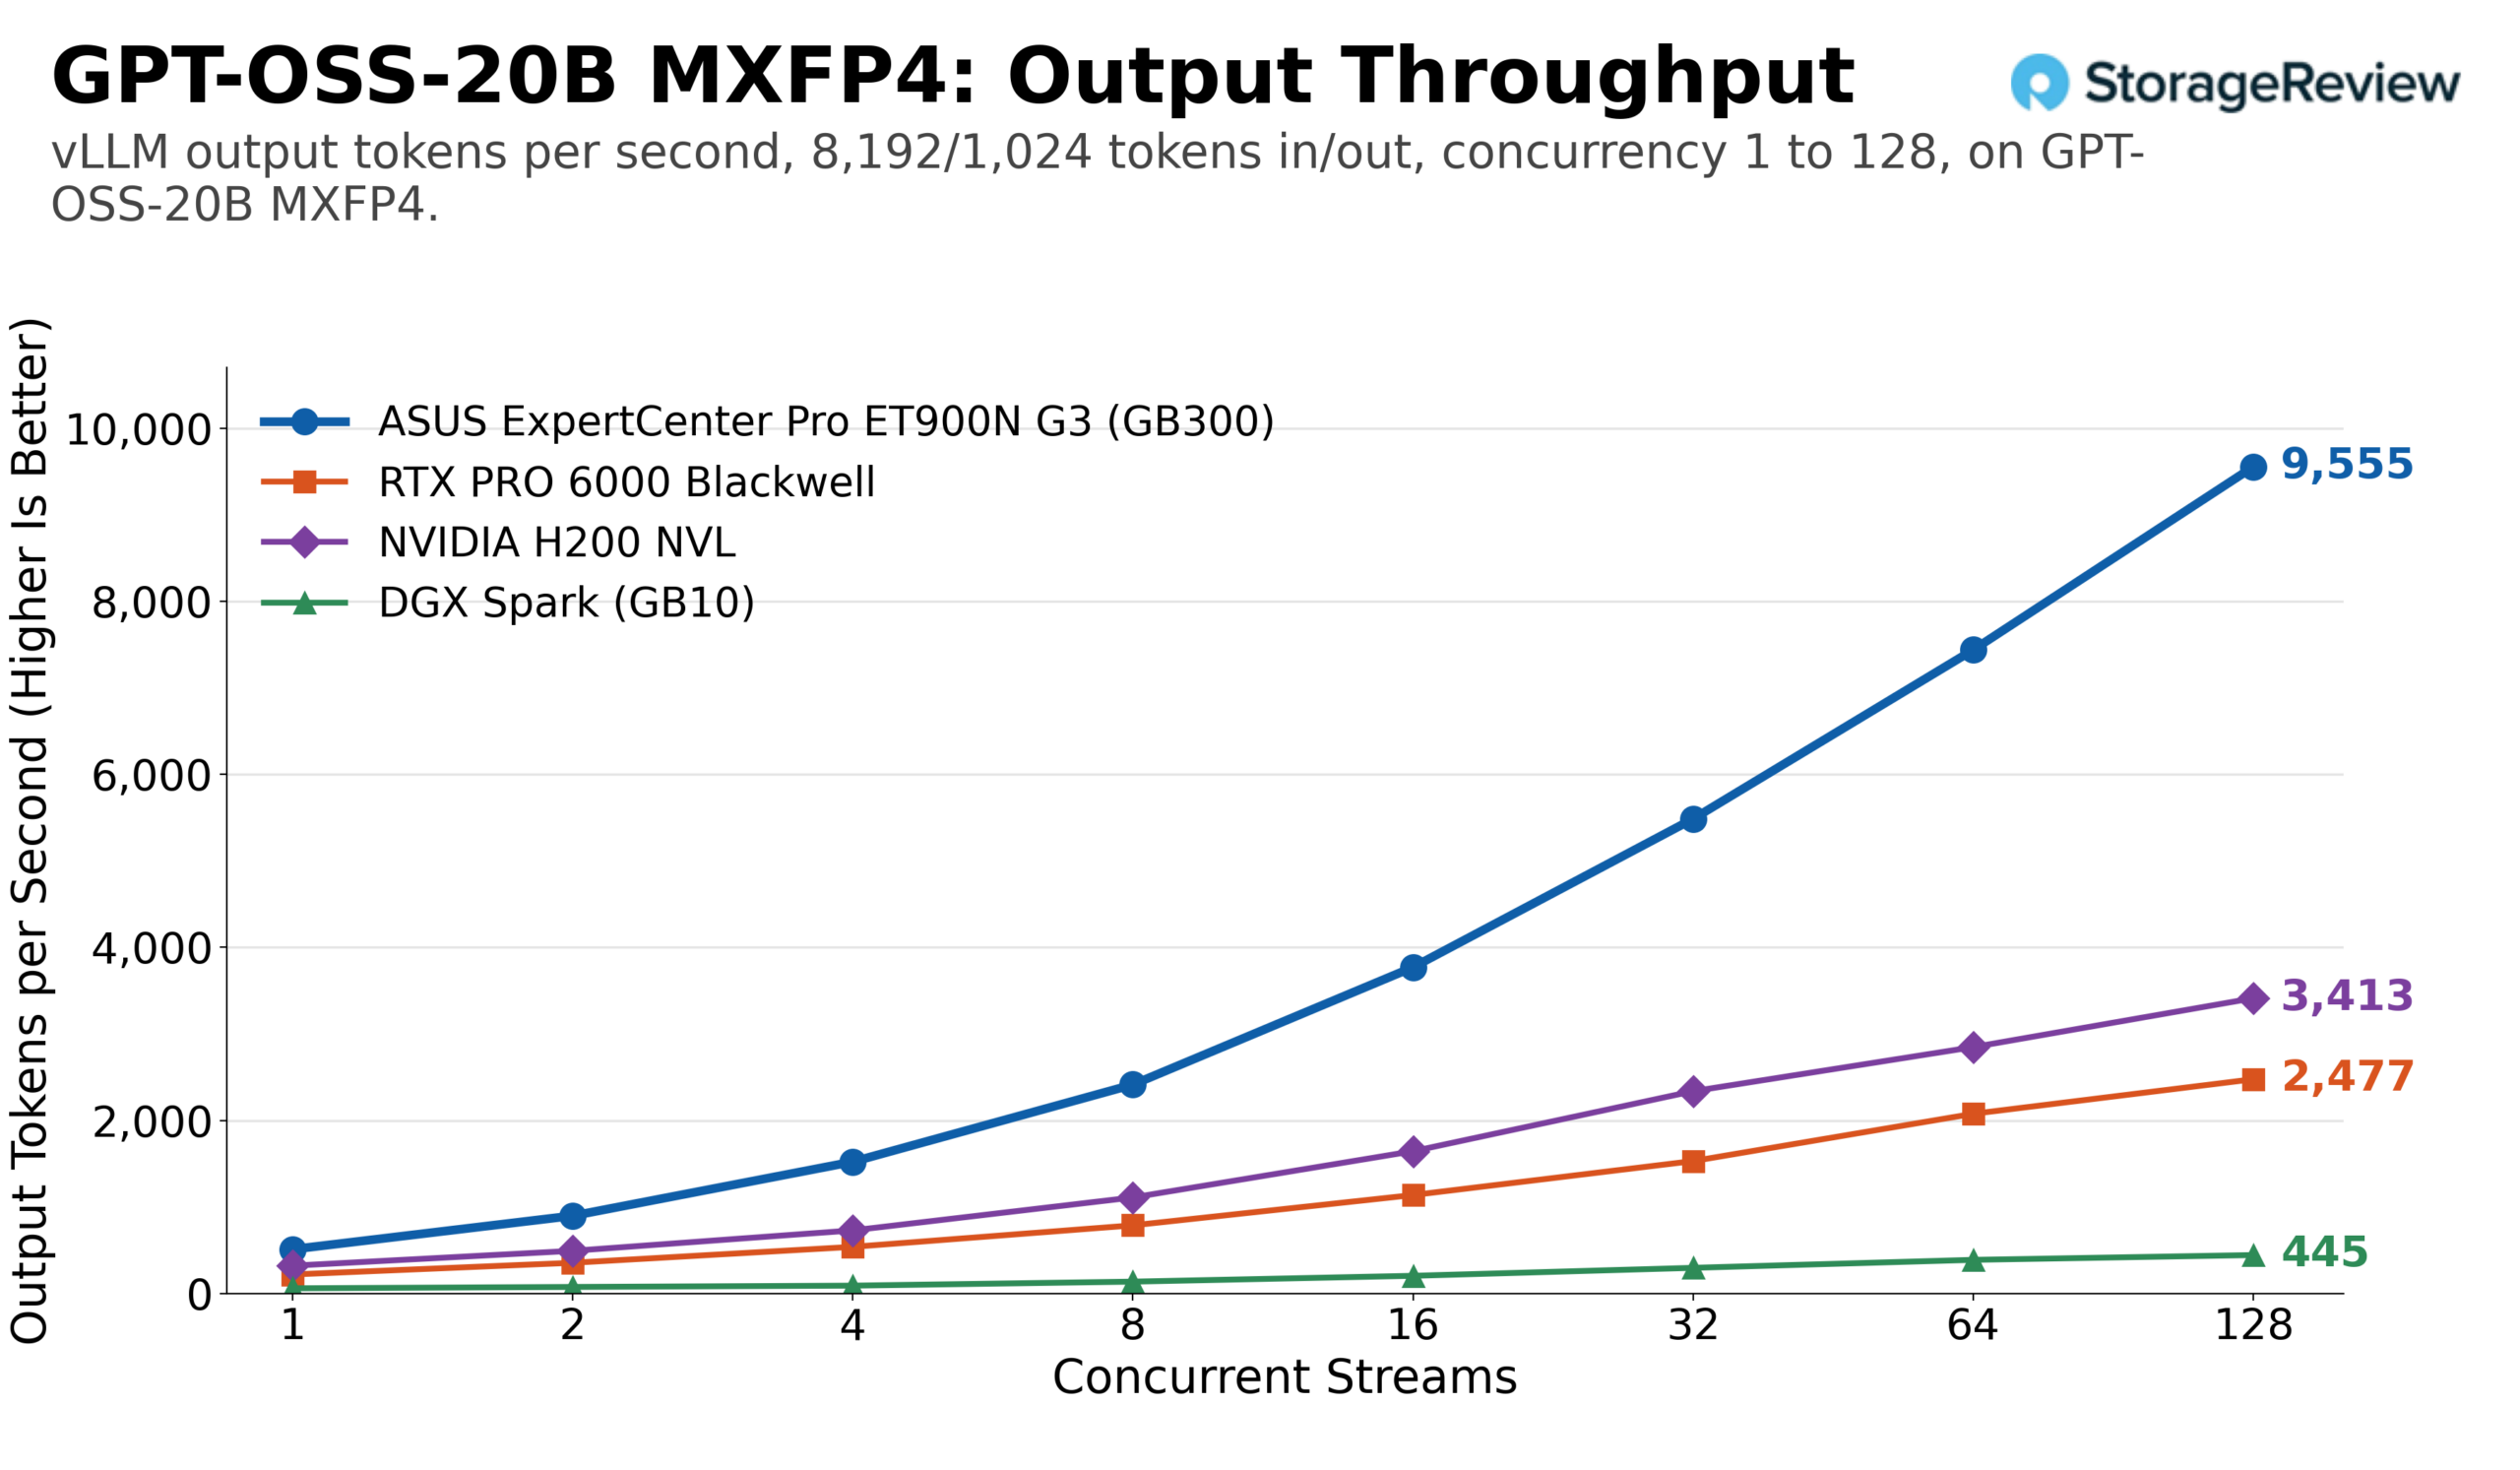
GPT-OSS-20Bは、このテストセットの中で最も扱いやすいテストであり、どのシステムでも問題なくクリアできるチェックポイントです。同じワークロードで、ET900N G3は128ストリームで毎秒22,041出力トークン、合計44,082トークンにスケールアップしました。これは、RTX PRO 6000の約7,920、H200 NVLの6,010、DGX Sparkの1,420と比較して高い数値です。シングルストリームモードでは、Stationは毎秒536個の出力トークンを生成し、カードの354個、H200の489個、Sparkの120個と比較しました。プリフィルを多用したプロファイルではその差がさらに広がり、Stationは毎秒9,555個の出力トークンと128ストリームで合計85,994個を生成し、RTX PRO 6000は約2,480個、H200 NVLは3,410個、Sparkは445個でした。
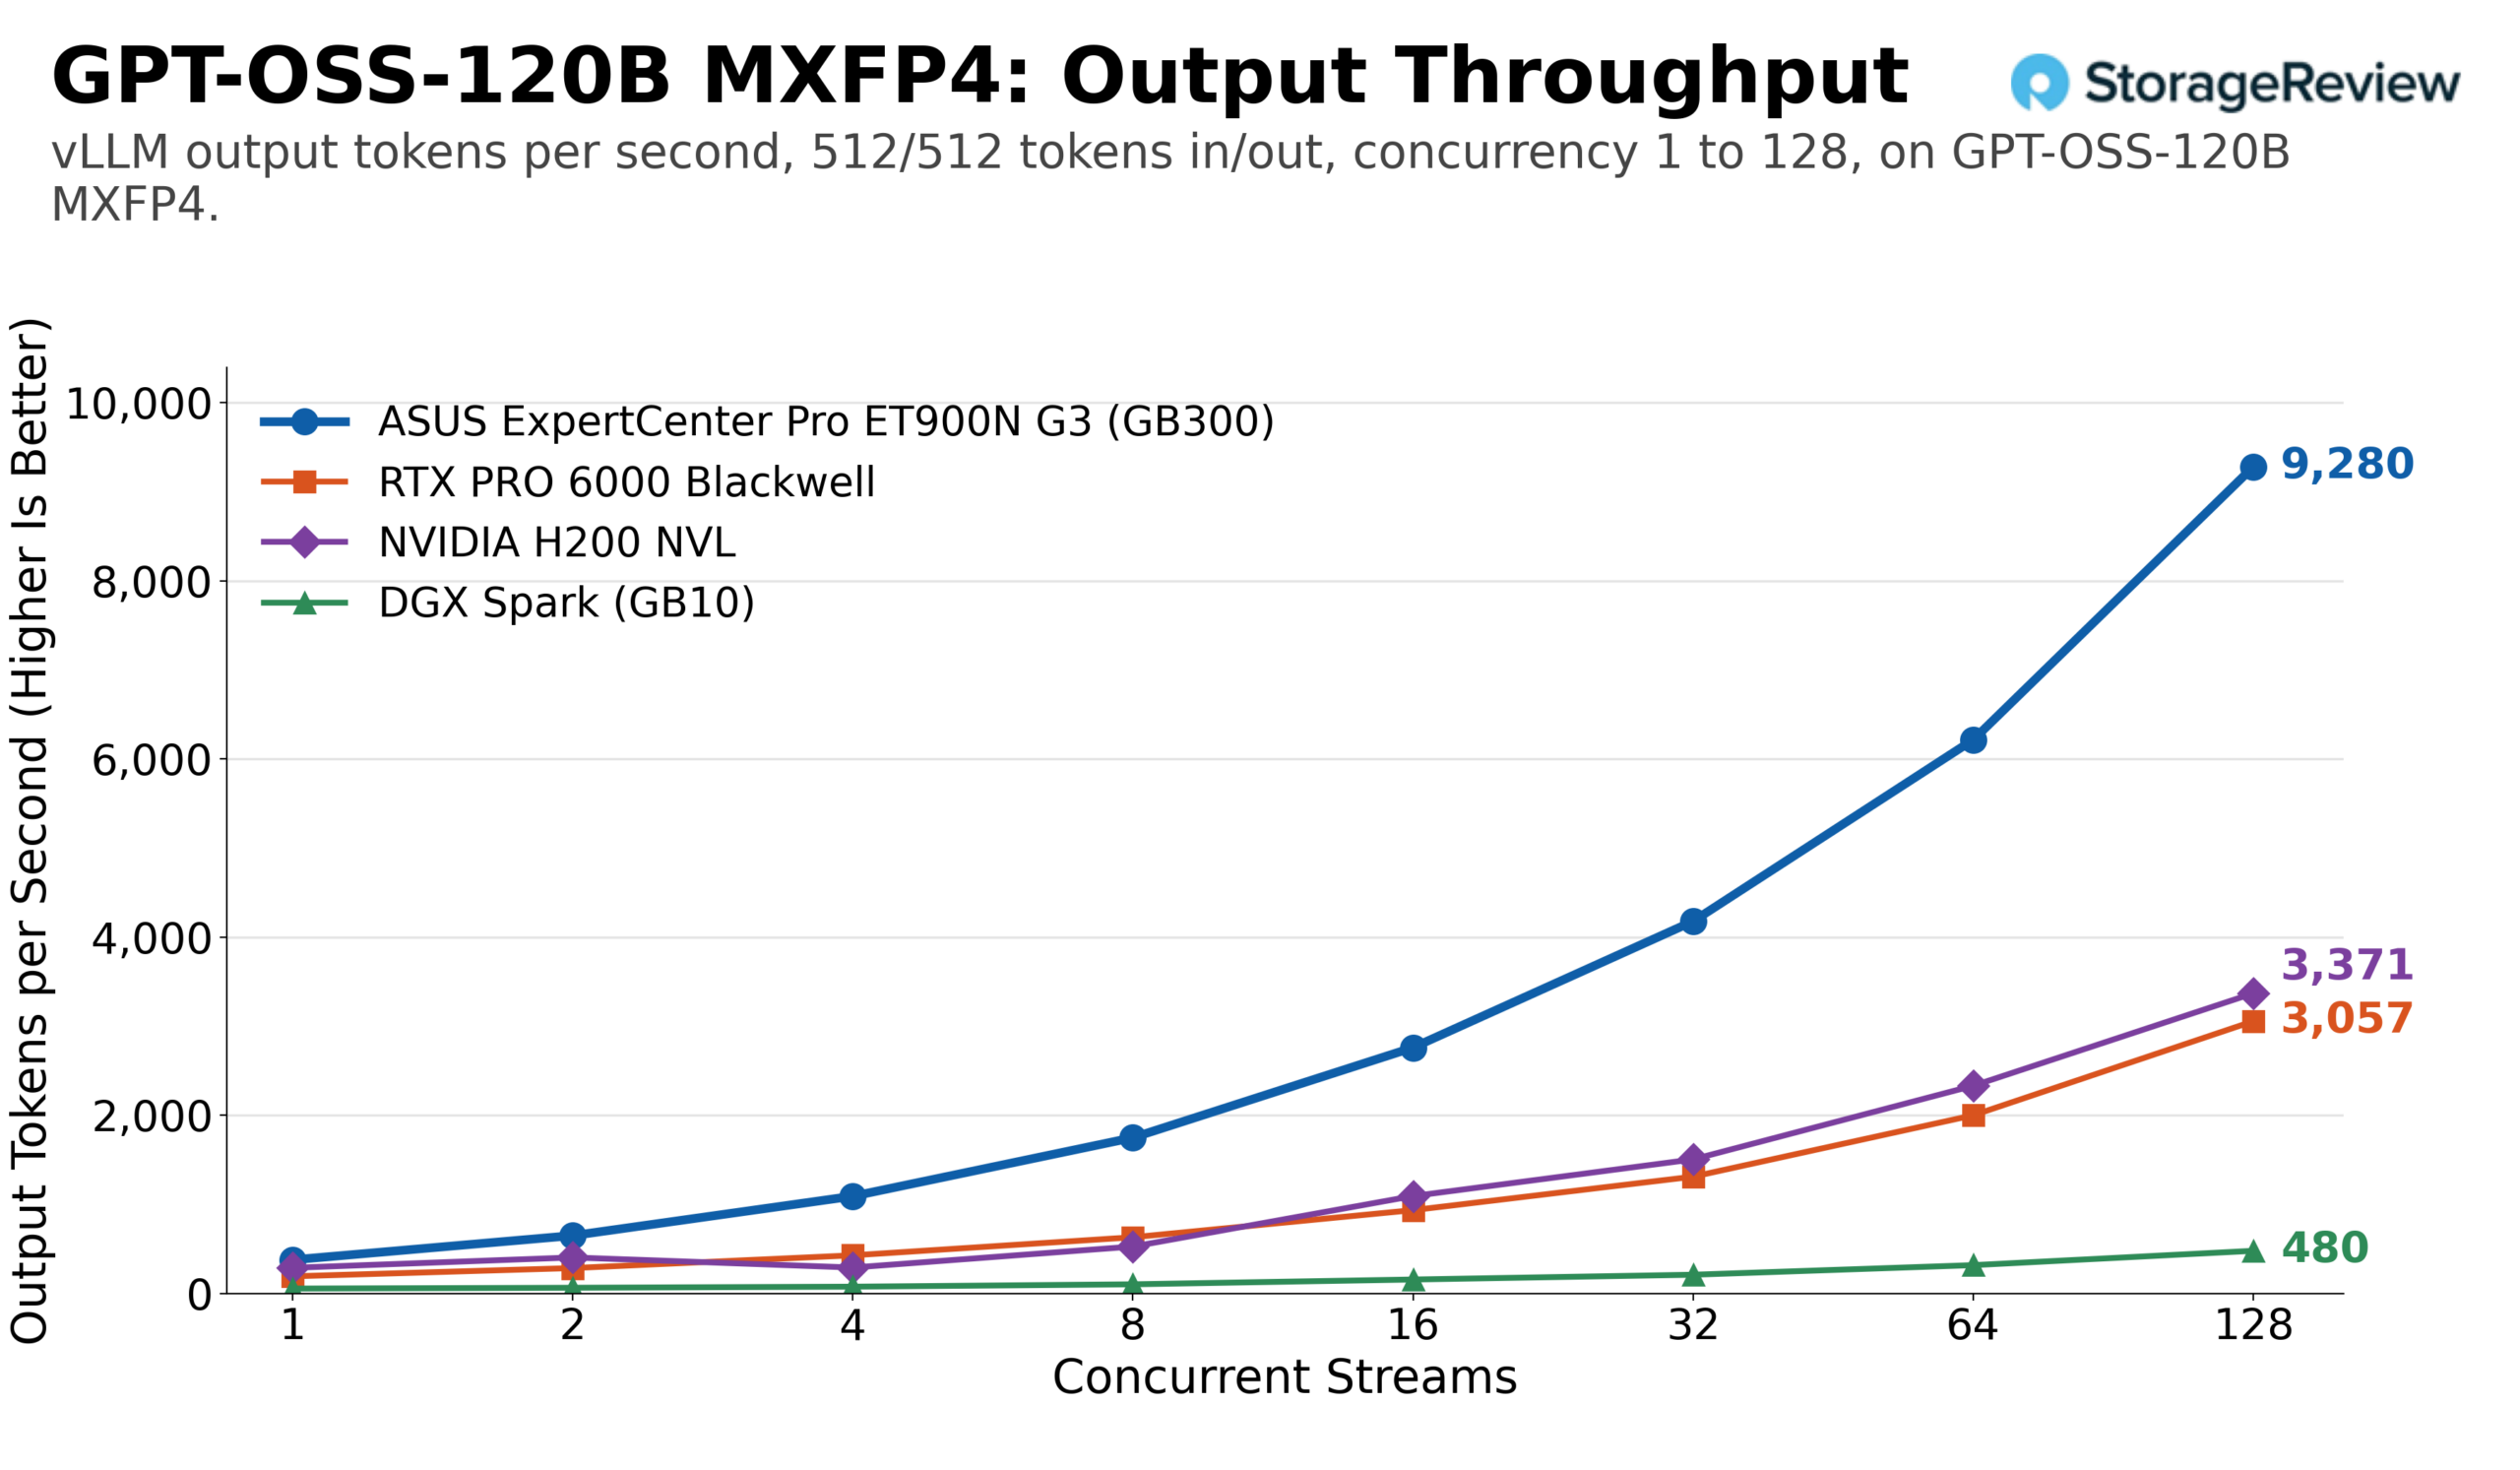
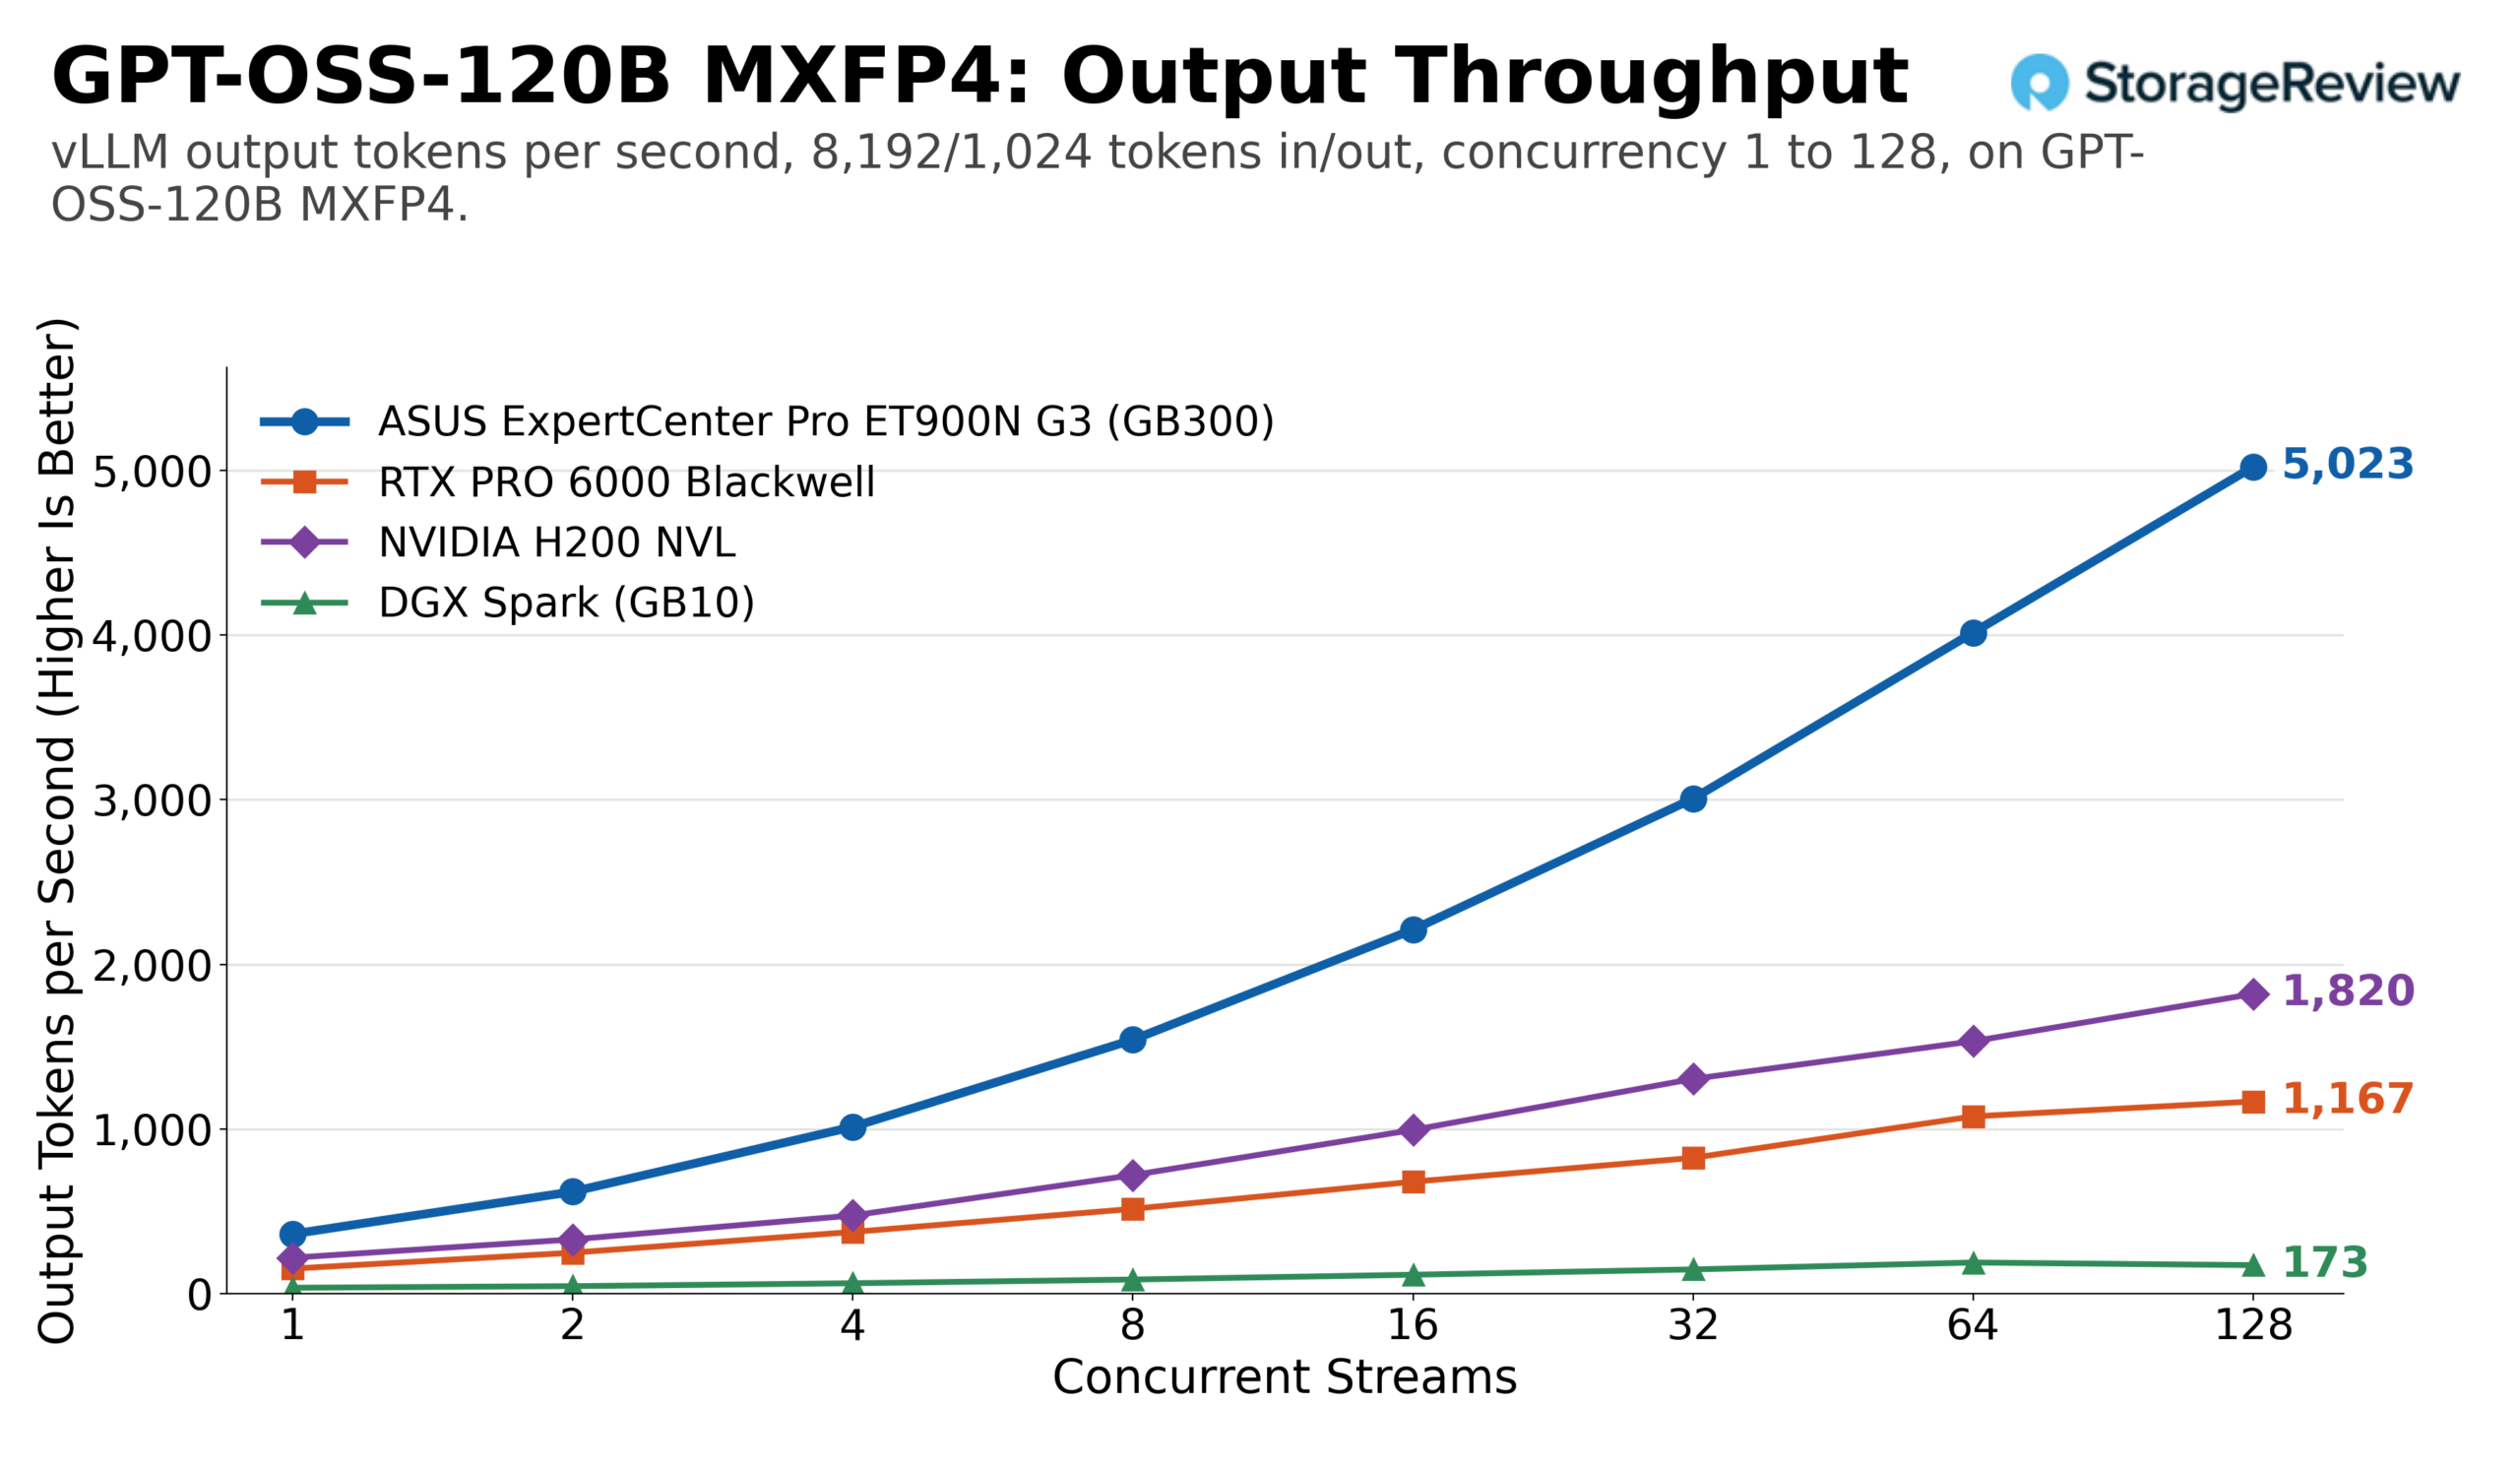
GPT-OSS-120B は、メモリがフィールドのソートを開始する場所です。ET900N G3 は、128 ストリームで同等のワークロードで毎秒 9,280 出力トークンに達し、3,060 の RTX PRO 6000 の約 3 倍、3,370 の H200 NVL の 2.8 倍、480 の Spark の 19 倍以上となりました。長いプロンプトの下では、小型システムは KV キャッシュの余裕が早くも不足しました。RTX PRO 6000 は毎秒約 1,170 出力トークンで頭打ちになり、H200 NVL は毎秒約 1,820 で頭打ちになりましたが、Station は 128 ストリームでまだ上昇しており、最終的に 5,023 に達し、合計スループットは毎秒 45,205 トークンとなりました。
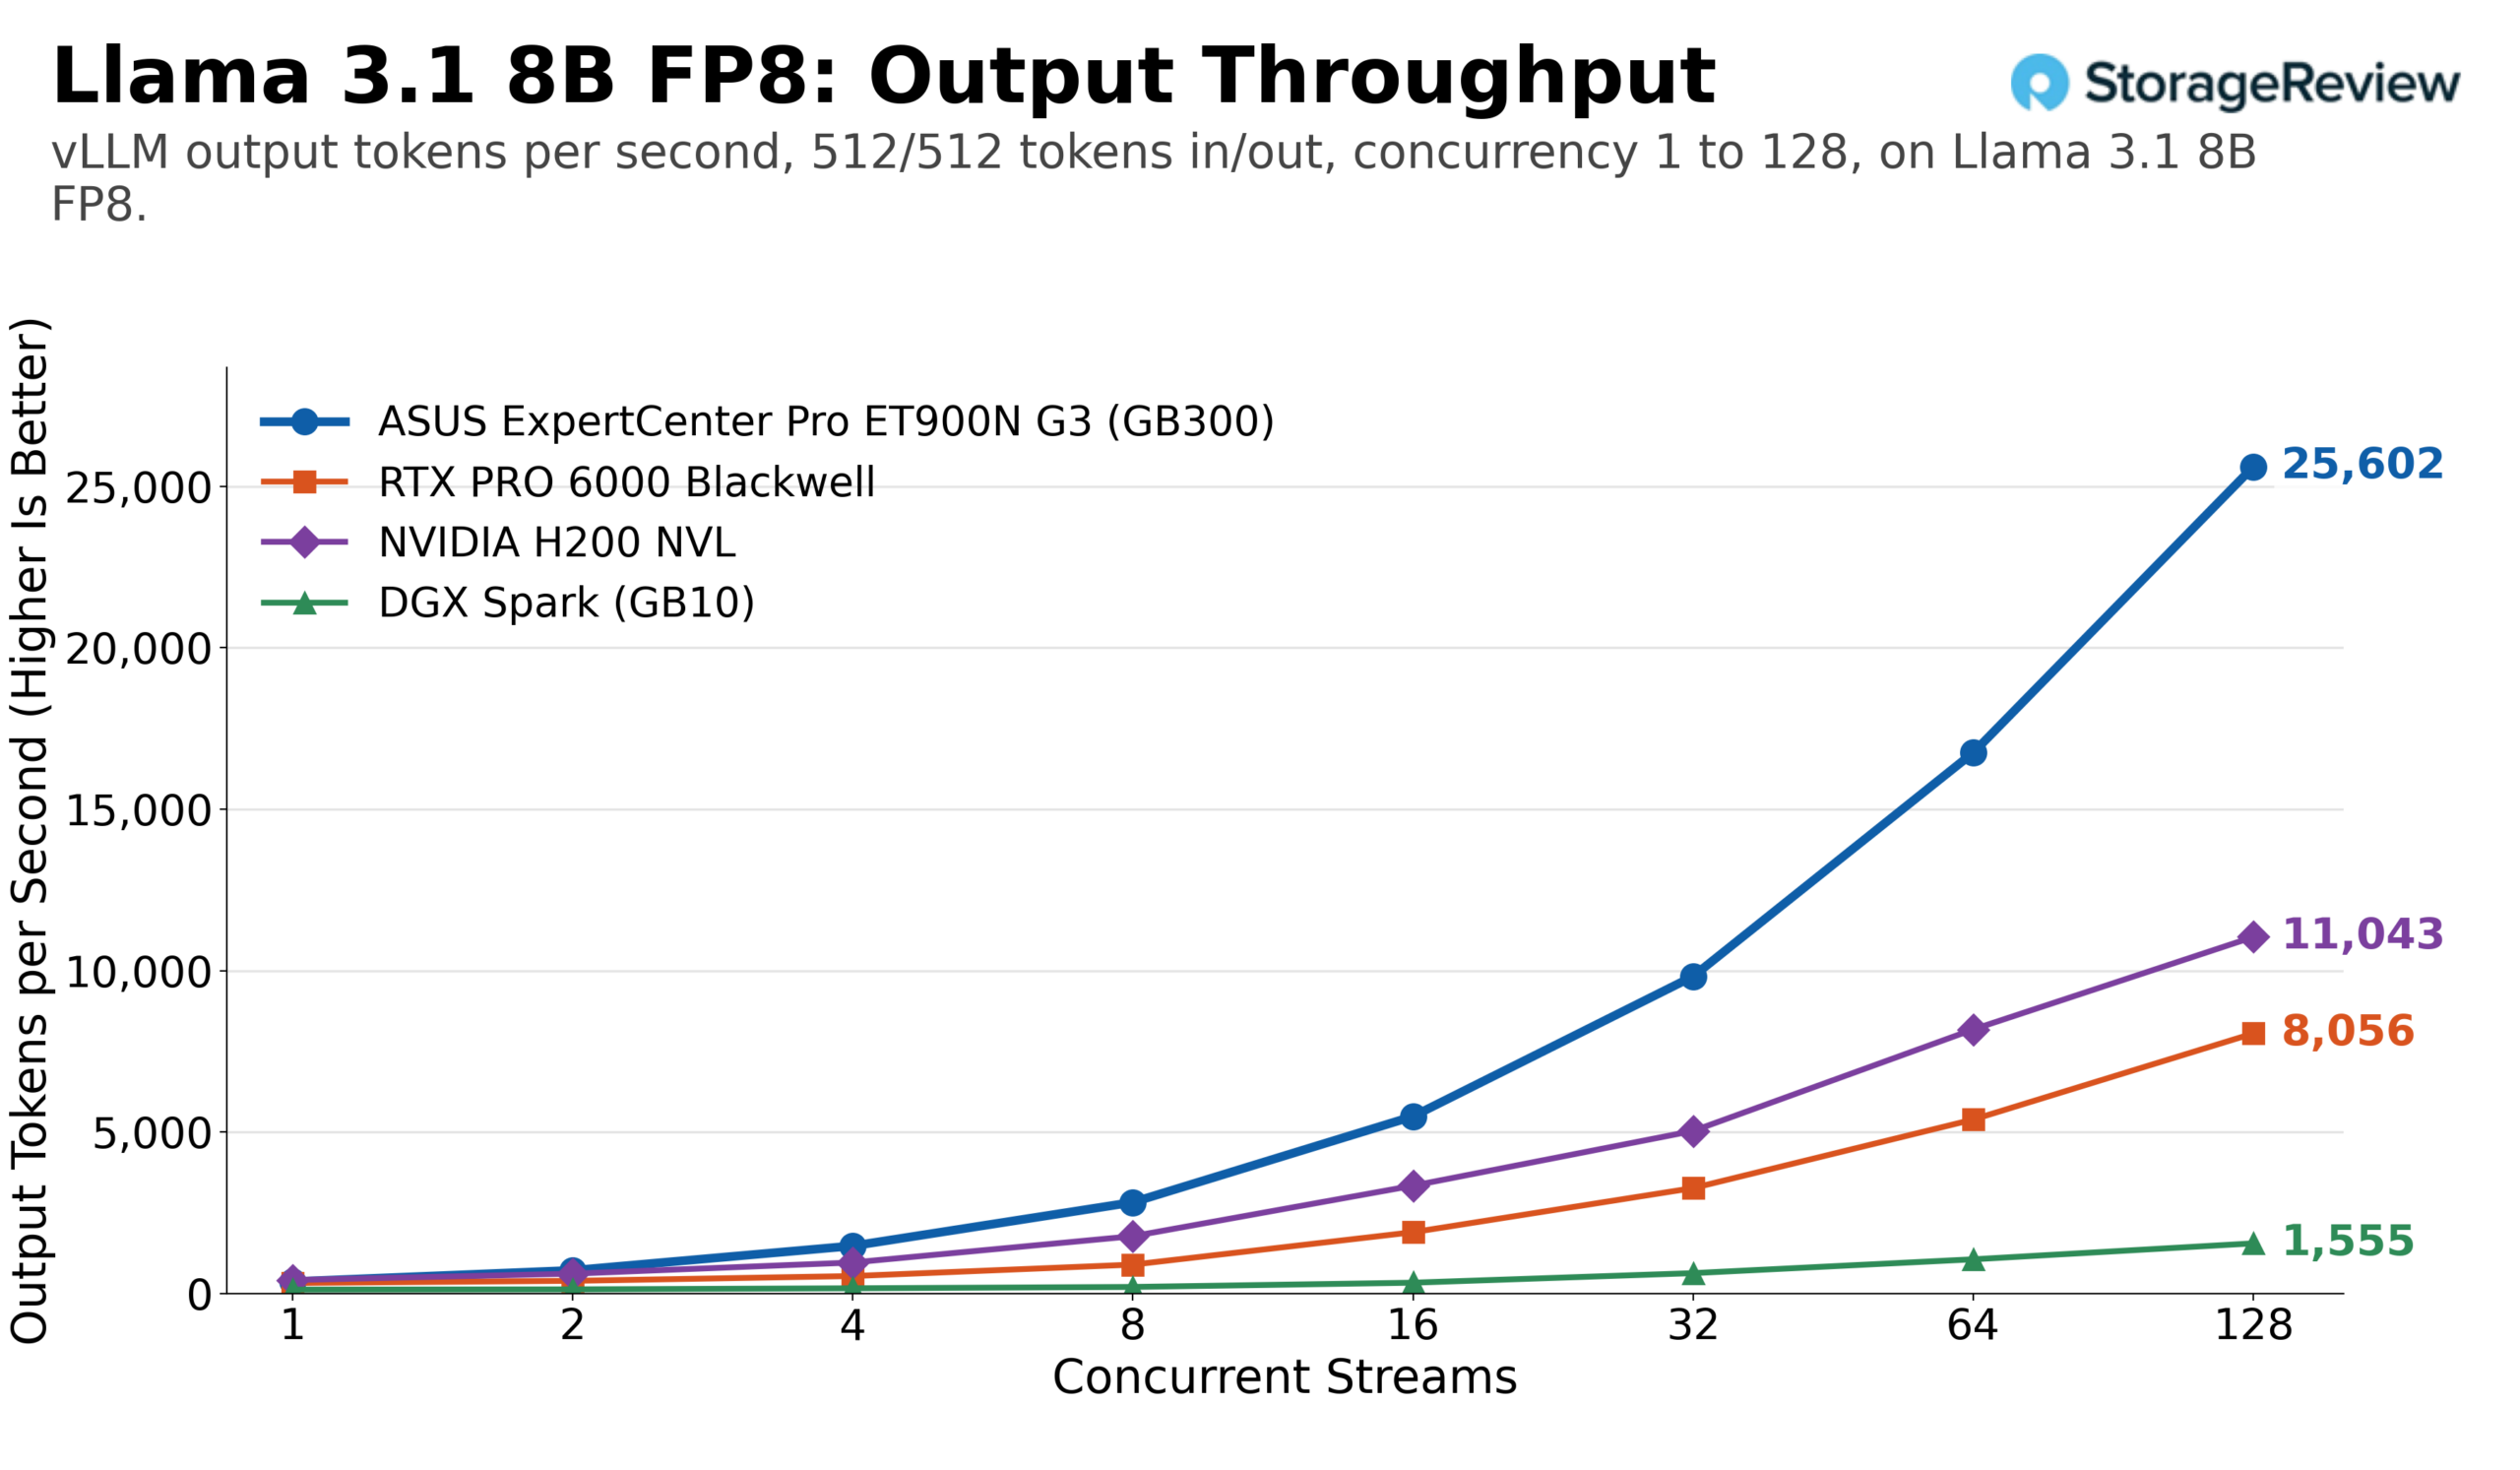
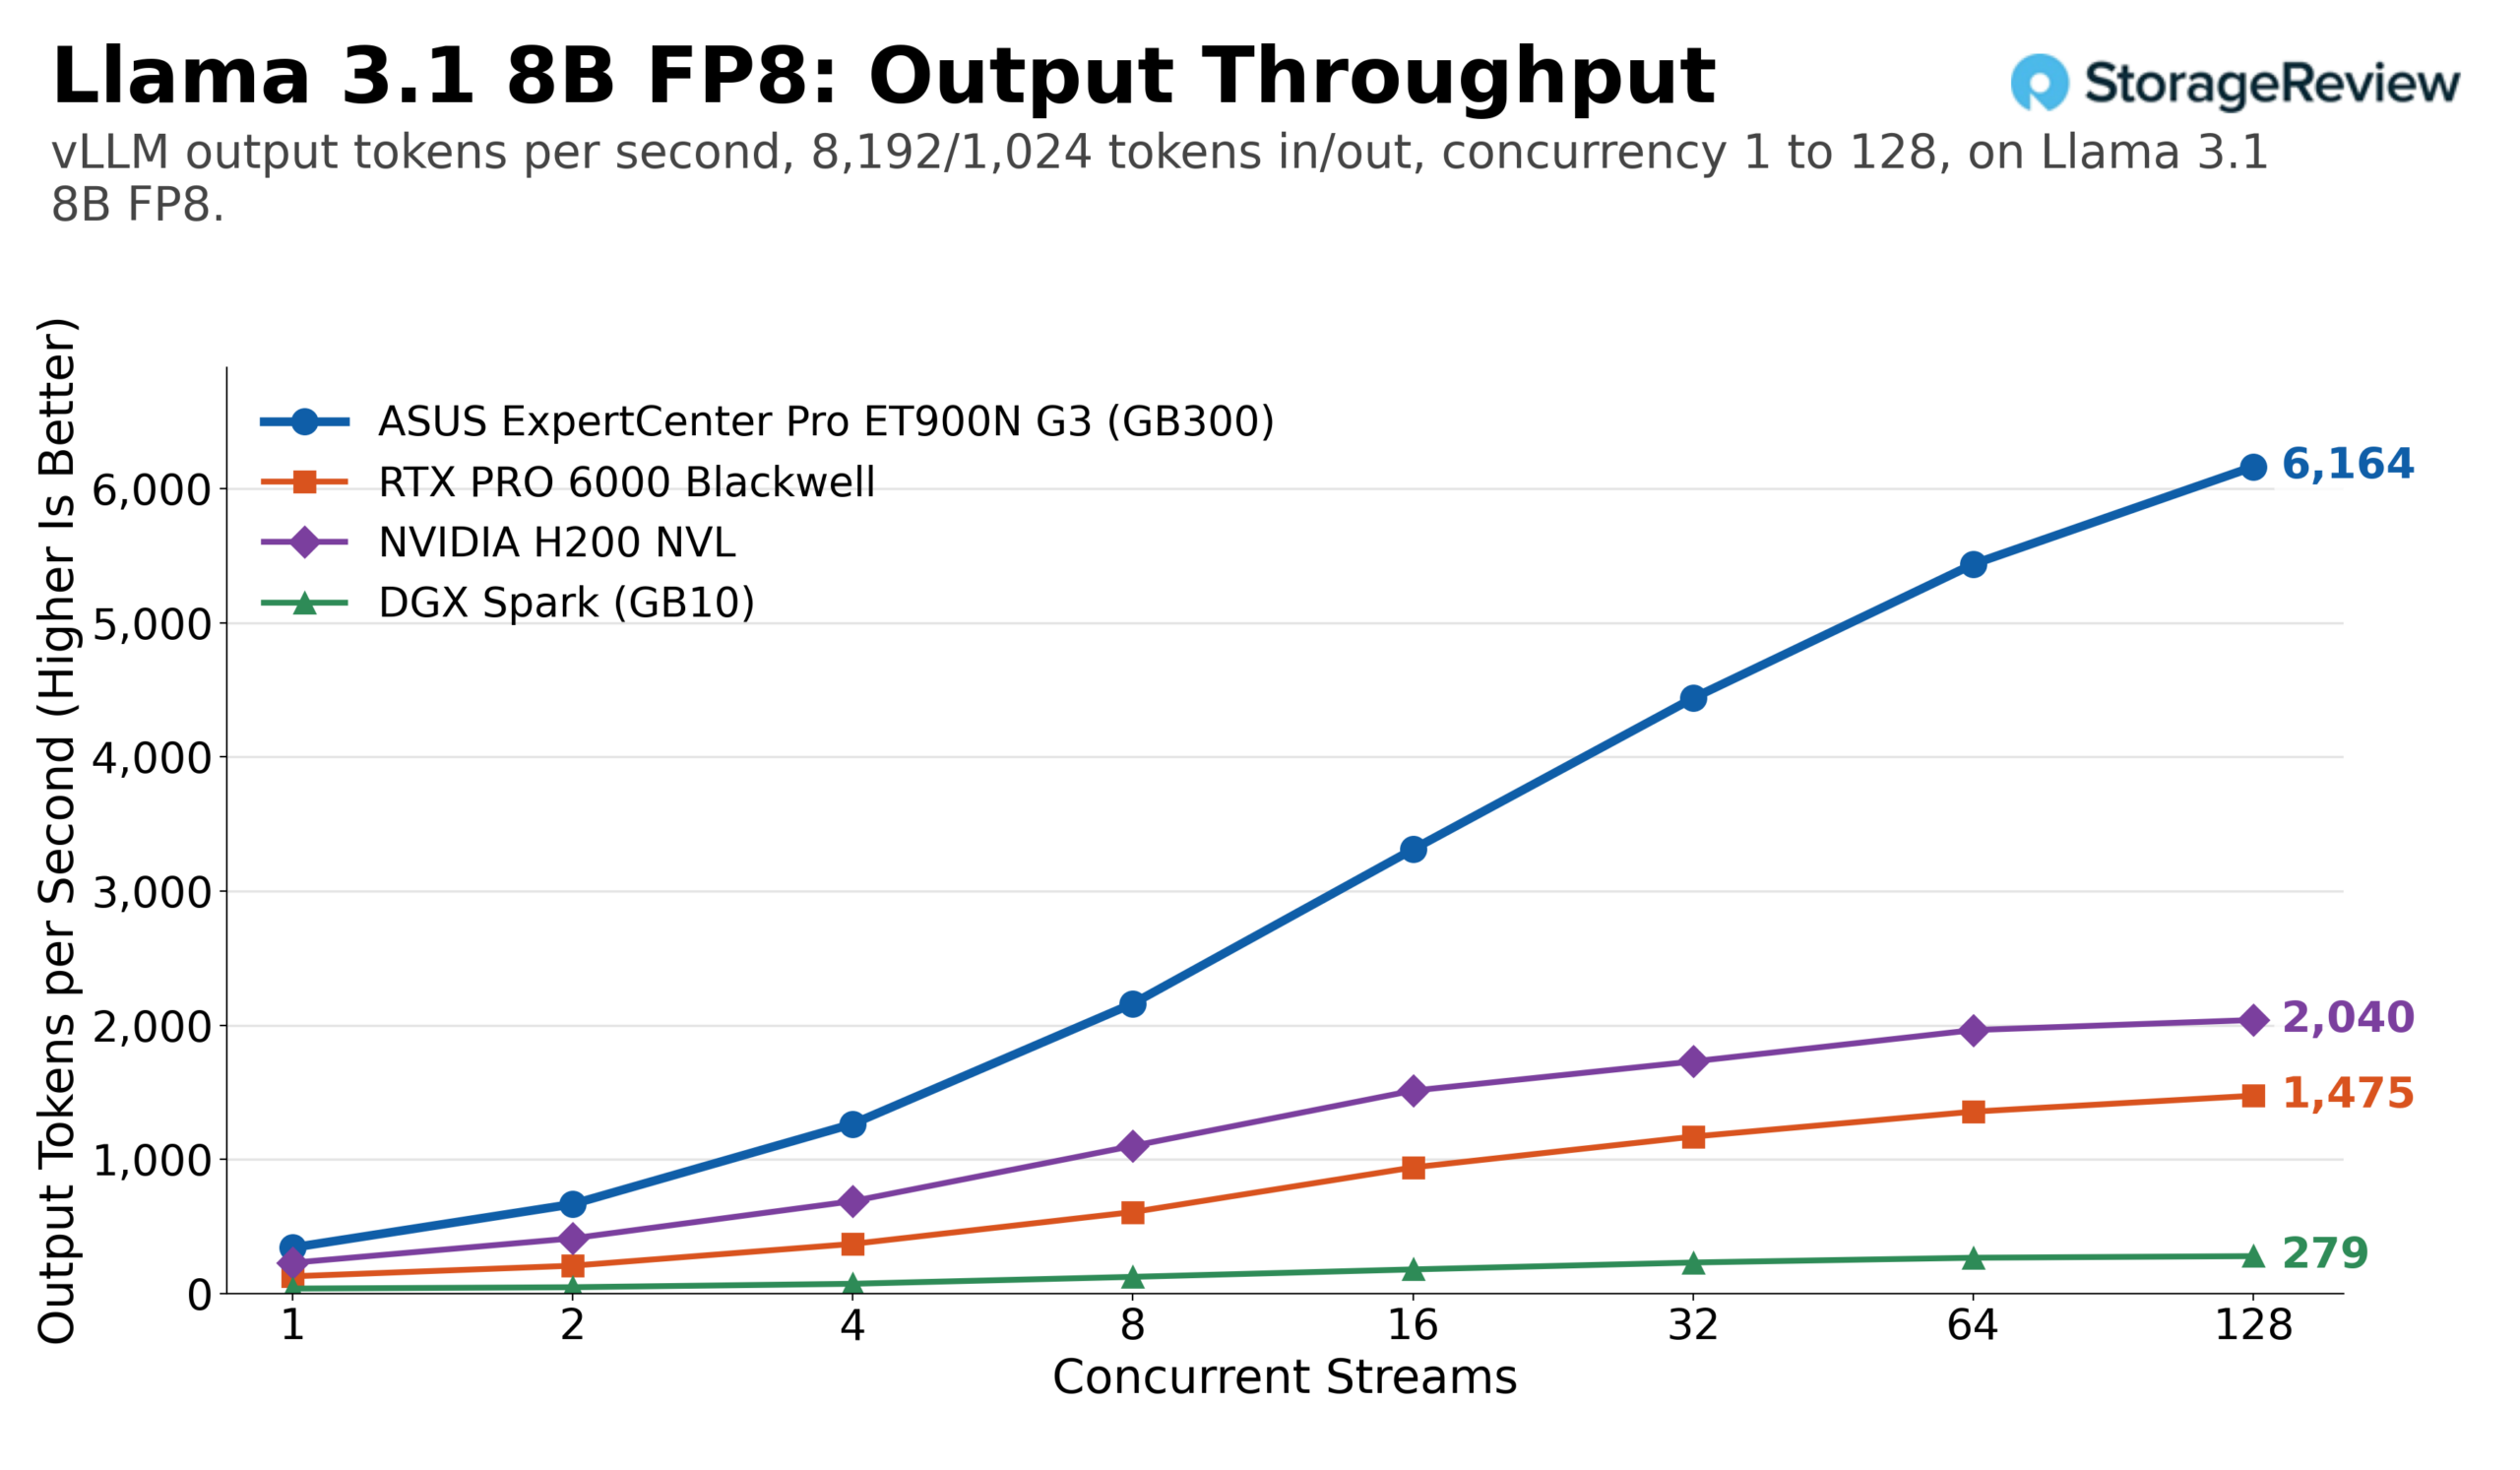
Llama 3.1 8B at FP8 は、このセットの中で最も高い単一の数値です。ET900N G3 は、同じワークロードで 128 ストリームにわたって毎秒 25,602 の出力トークンをプッシュし、合計 51,205 でした。これは、RTX PRO 6000 の約 8,060 と H200 NVL の 11,040 と比較したものです。BF16 から FP8 に下げると、Station は約 50% 上昇し (17,074 から 25,602 へ)、同じ変更により RTX PRO 6000 は約 70%、H200 NVL は約 37% 上昇しました。プリフィルが多めのプロファイルではすべてが圧縮され、Station は毎秒 6,164 の出力トークン、カードは 1,480、H200 は 2,040 となりました。
Mistral Small 24B の FP8 では、最も広い比率が得られました。ET900N G3 は、同じワークロードで毎秒 11,075 個の出力トークンをピークに達成し、RTX PRO 6000 の 3,240 の 3.4 倍、H200 NVL の 4,610 の 2.4 倍、Spark の 559 の 20 倍近くに達しました。長いプロンプトの下では、RTX PRO 6000 は 32 ストリームで毎秒約 480 個の出力トークンをピークに達成した後、低下しました。H200 NVL は約 854 でピークに達し、Station は 128 ストリームで 2,302 に達しました。


アクティブ パラメータ数が少ない混合エキスパート モデルである Qwen3 Coder 30B では、シングル ストリームの差が縮まります。同じワークロードで 1 つのストリームの場合、RTX PRO 6000 は毎秒約 232 個の出力トークンを供給し、Station は 319、H200 NVL は 308 個でした。バッチ処理では、この順序が回復します。128 ストリームの場合、ET900N G3 は FP8 で毎秒 12,439 個の出力トークンに達し、3,990 のカードの 3.1 倍、7,450 の H200 NVL の 1.7 倍でした。プリフィルが多いプロファイルでは、Station は毎秒 3,837 個の出力トークンに達しましたが、RTX PRO 6000 は 64 ストリームで約 880 個、H200 NVL は約 1,820 個でピークに達しました。


共有モデル全体では、ET900N G3 は、完全な同時実行で単一の RTX PRO 6000 の 2.8 ~ 3.4 倍、H200 NVL の 1.7 ~ 3.7 倍の性能を発揮し、長いプロンプトでは KV キャッシュの余裕がなくなるため、両者との差が拡大しました。WS300 と比較すると、これら 4 つの性能は 1% 以内の差に収まっています。GPT-OSS-20B では 22,041 対 22,161、GPT-OSS-120B では 9,280 対 9,294、Mistral Small FP8 では 11,075 対 11,157、Qwen3 Coder FP8 では 12,439 対 12,425 です。差が大きい 3 つのモデルを含む、全 14 モデルの比較は次のセクションにあります。
2つのタワー型ケース、1つのベースボード:ASUS ET900N G3 vs MSI WS300
ET900N G3とMSI XpertStation WS300は、同じNVIDIA GB300 DGX Stationベースボードを2つのOEMシャーシに搭載したもので、どちらも同じ14種類のモデル、同じ2種類のワークロード、そして同じvLLMビルド上で同じ同時実行性スイープを実行しました。下のグラフは、ET900N G3の全モデルにおけるピーク出力スループットとWS300のピーク出力スループットを比較したものです。
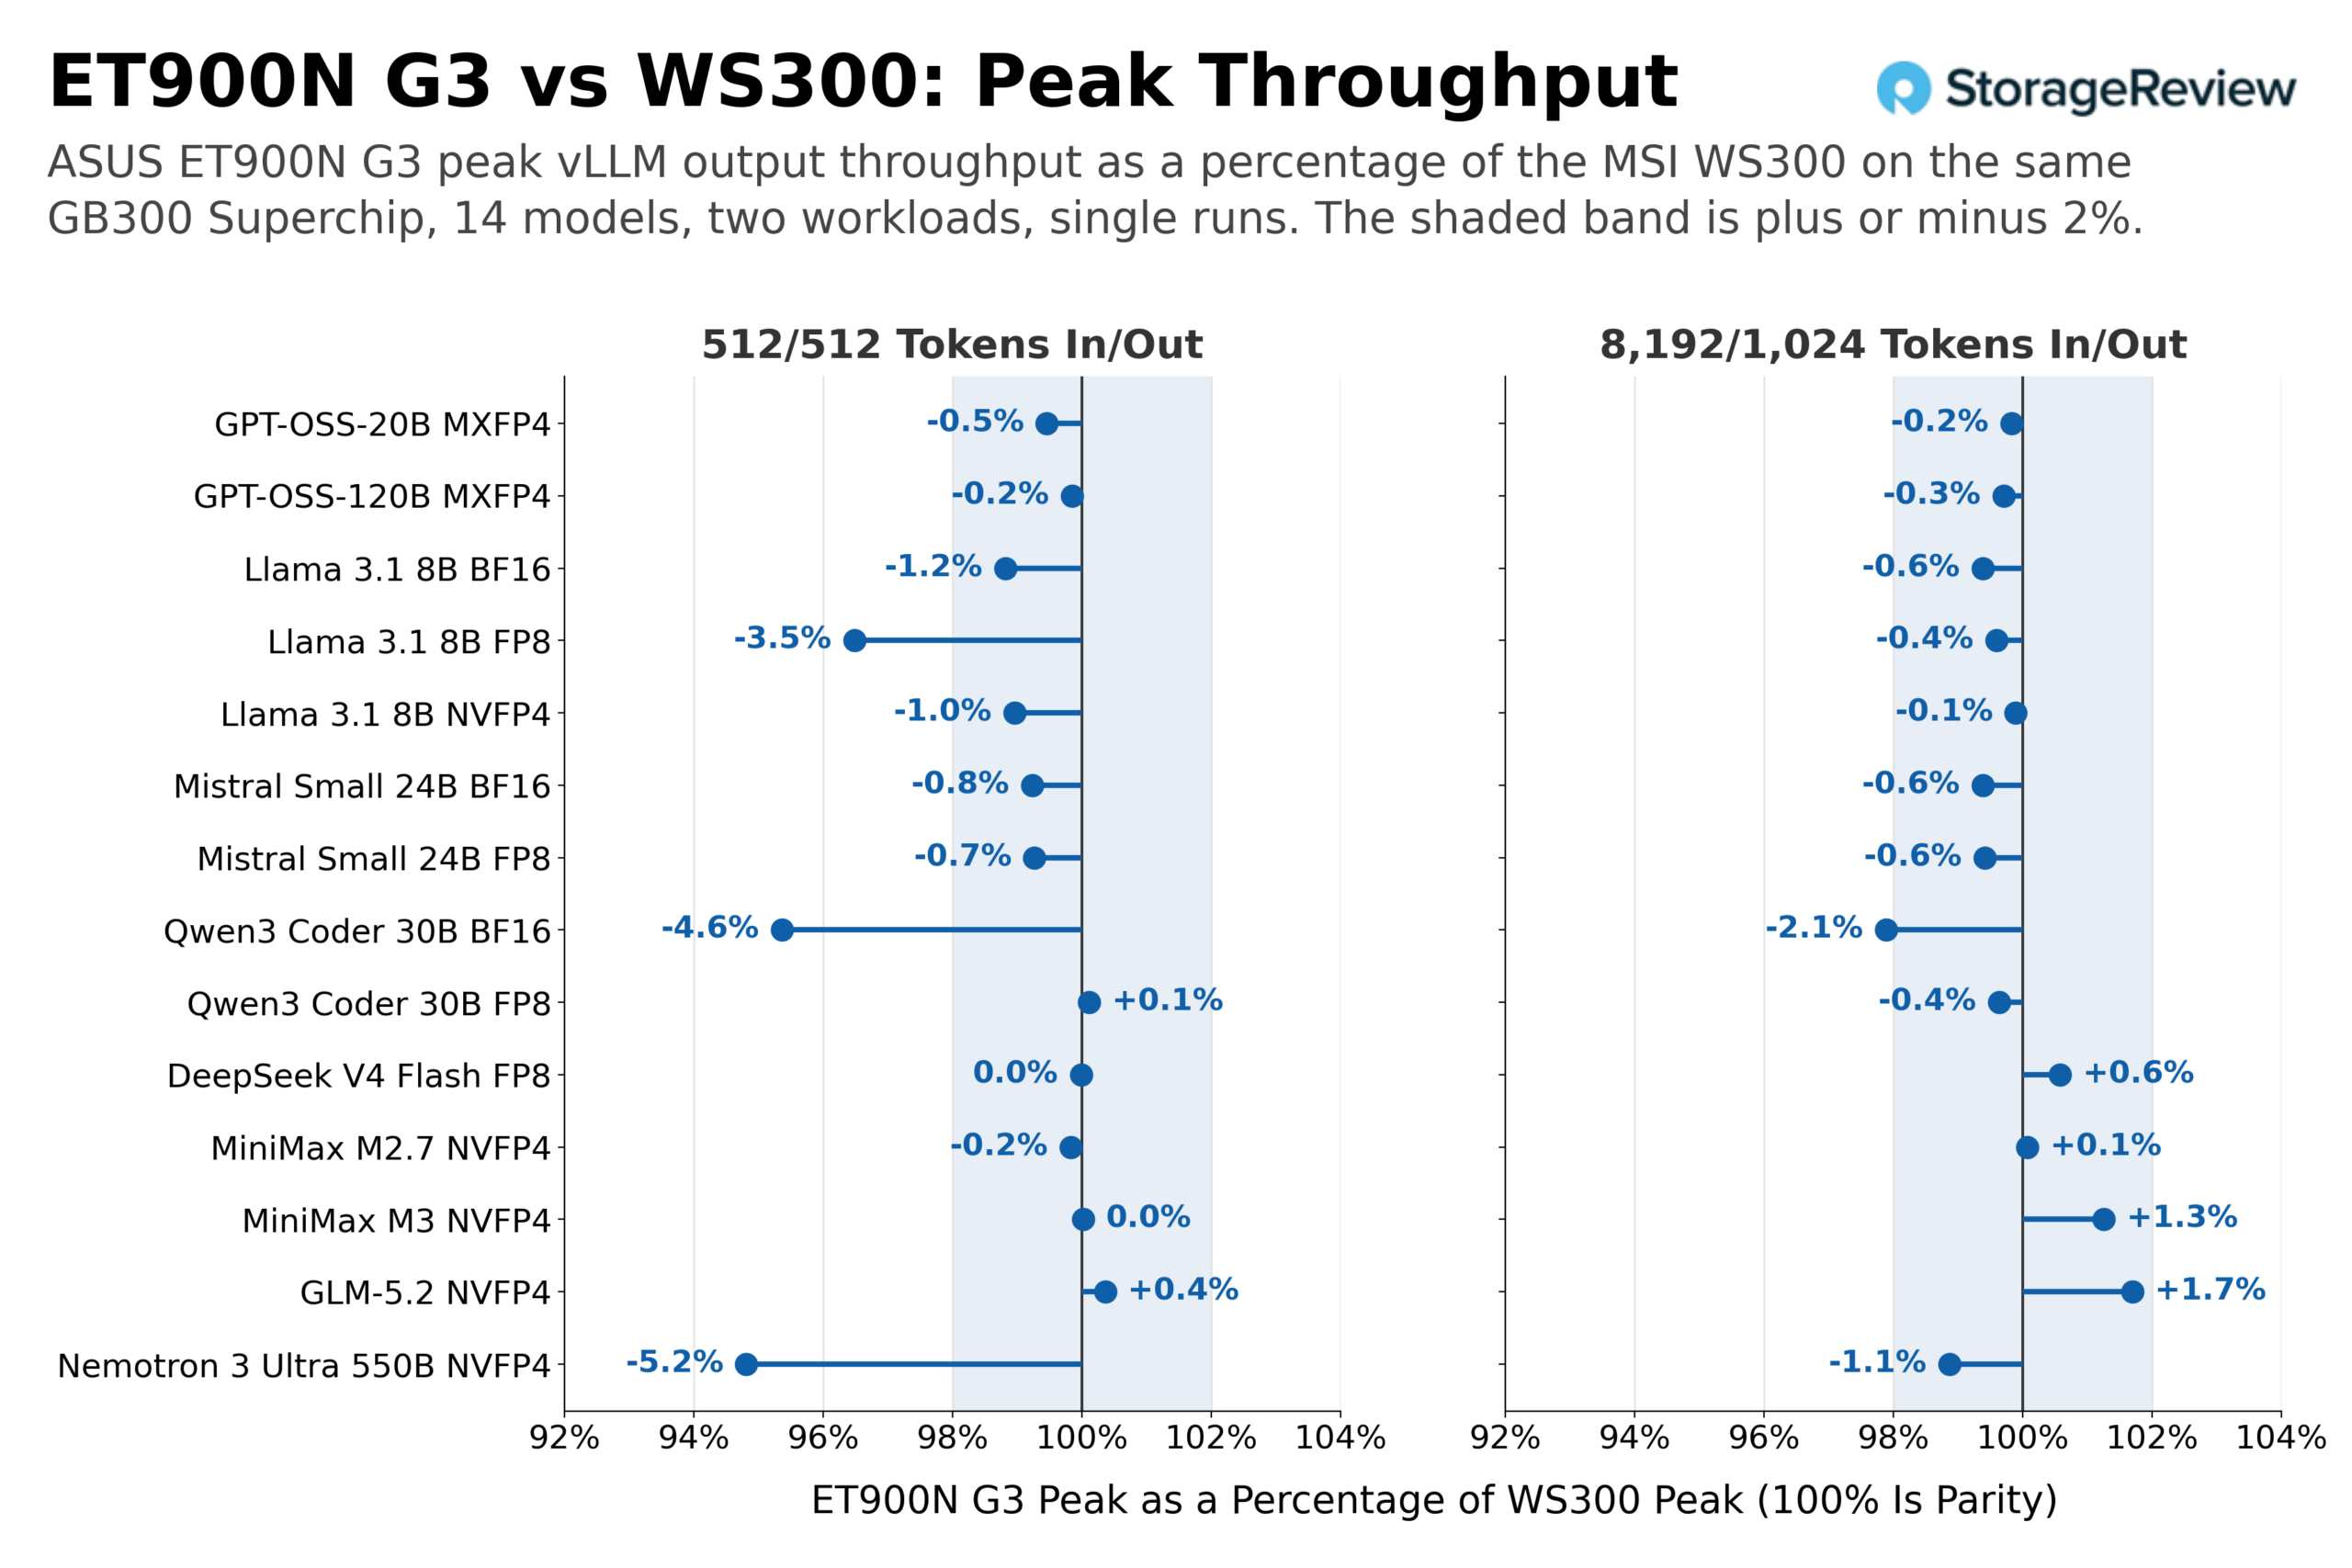
28 組のモデルとワークロードの組み合わせのうち、24 組は 2% 以内の差に収まり、そのほとんどは WS300 の方がわずかに優れています。4 組はその範囲外にあり、そのうち 3 組は同じワークロードです。Llama 3.1 8B FP8 は WS300 より 3.5% 低く (1 秒あたり 25,602 対 26,536 出力トークン)、Qwen3 Coder 30B BF16 は 4.6% 低く (10,000 対 10,486)、Nemotron 3 Ultra 550B は 5.2% 低く (159 対 168)、さらに Qwen3 Coder 30B BF16 は長いプロンプトでも 2.1% 低くなっています。ここに示す数値はすべて各タワーでの 1 回の実行結果なので、14 組のうち 3 組で 2 ~ 5% の差があるのはシャーシのせいではありません。ここでは、データと両者の差分のみを記録しています。コヒーレントメモリプールに依存するモデルであるMiniMax M3とGLM-5.2は、どちらのワークロードでも同等以上の性能を発揮します。プラットフォームにとって最も重要なのは、この結果だと考えています。つまり、Graceオフロードパスは、ASUSのシャーシでもMSIのシャーシでも同じ性能を発揮するということです。
| モデル | WS300 512/512 | ET900N G3 512/512 | デルタ | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | デルタ |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| ラマ 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| ラマ 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| ラマ 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| ミストラル スモール 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| ミストラル・スモール24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 コーダー 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 コーダー 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| ネモトロン3ウルトラ550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
セットの中で最もスループットの高い高密度ケースであるGPT-OSS-20Bと、オフロードケースであるGLM-5.2は、比率を示さずに重複を示しています。どちらの場合も、WS300の実行結果はET900N G3の実行結果と完全に一致しています。
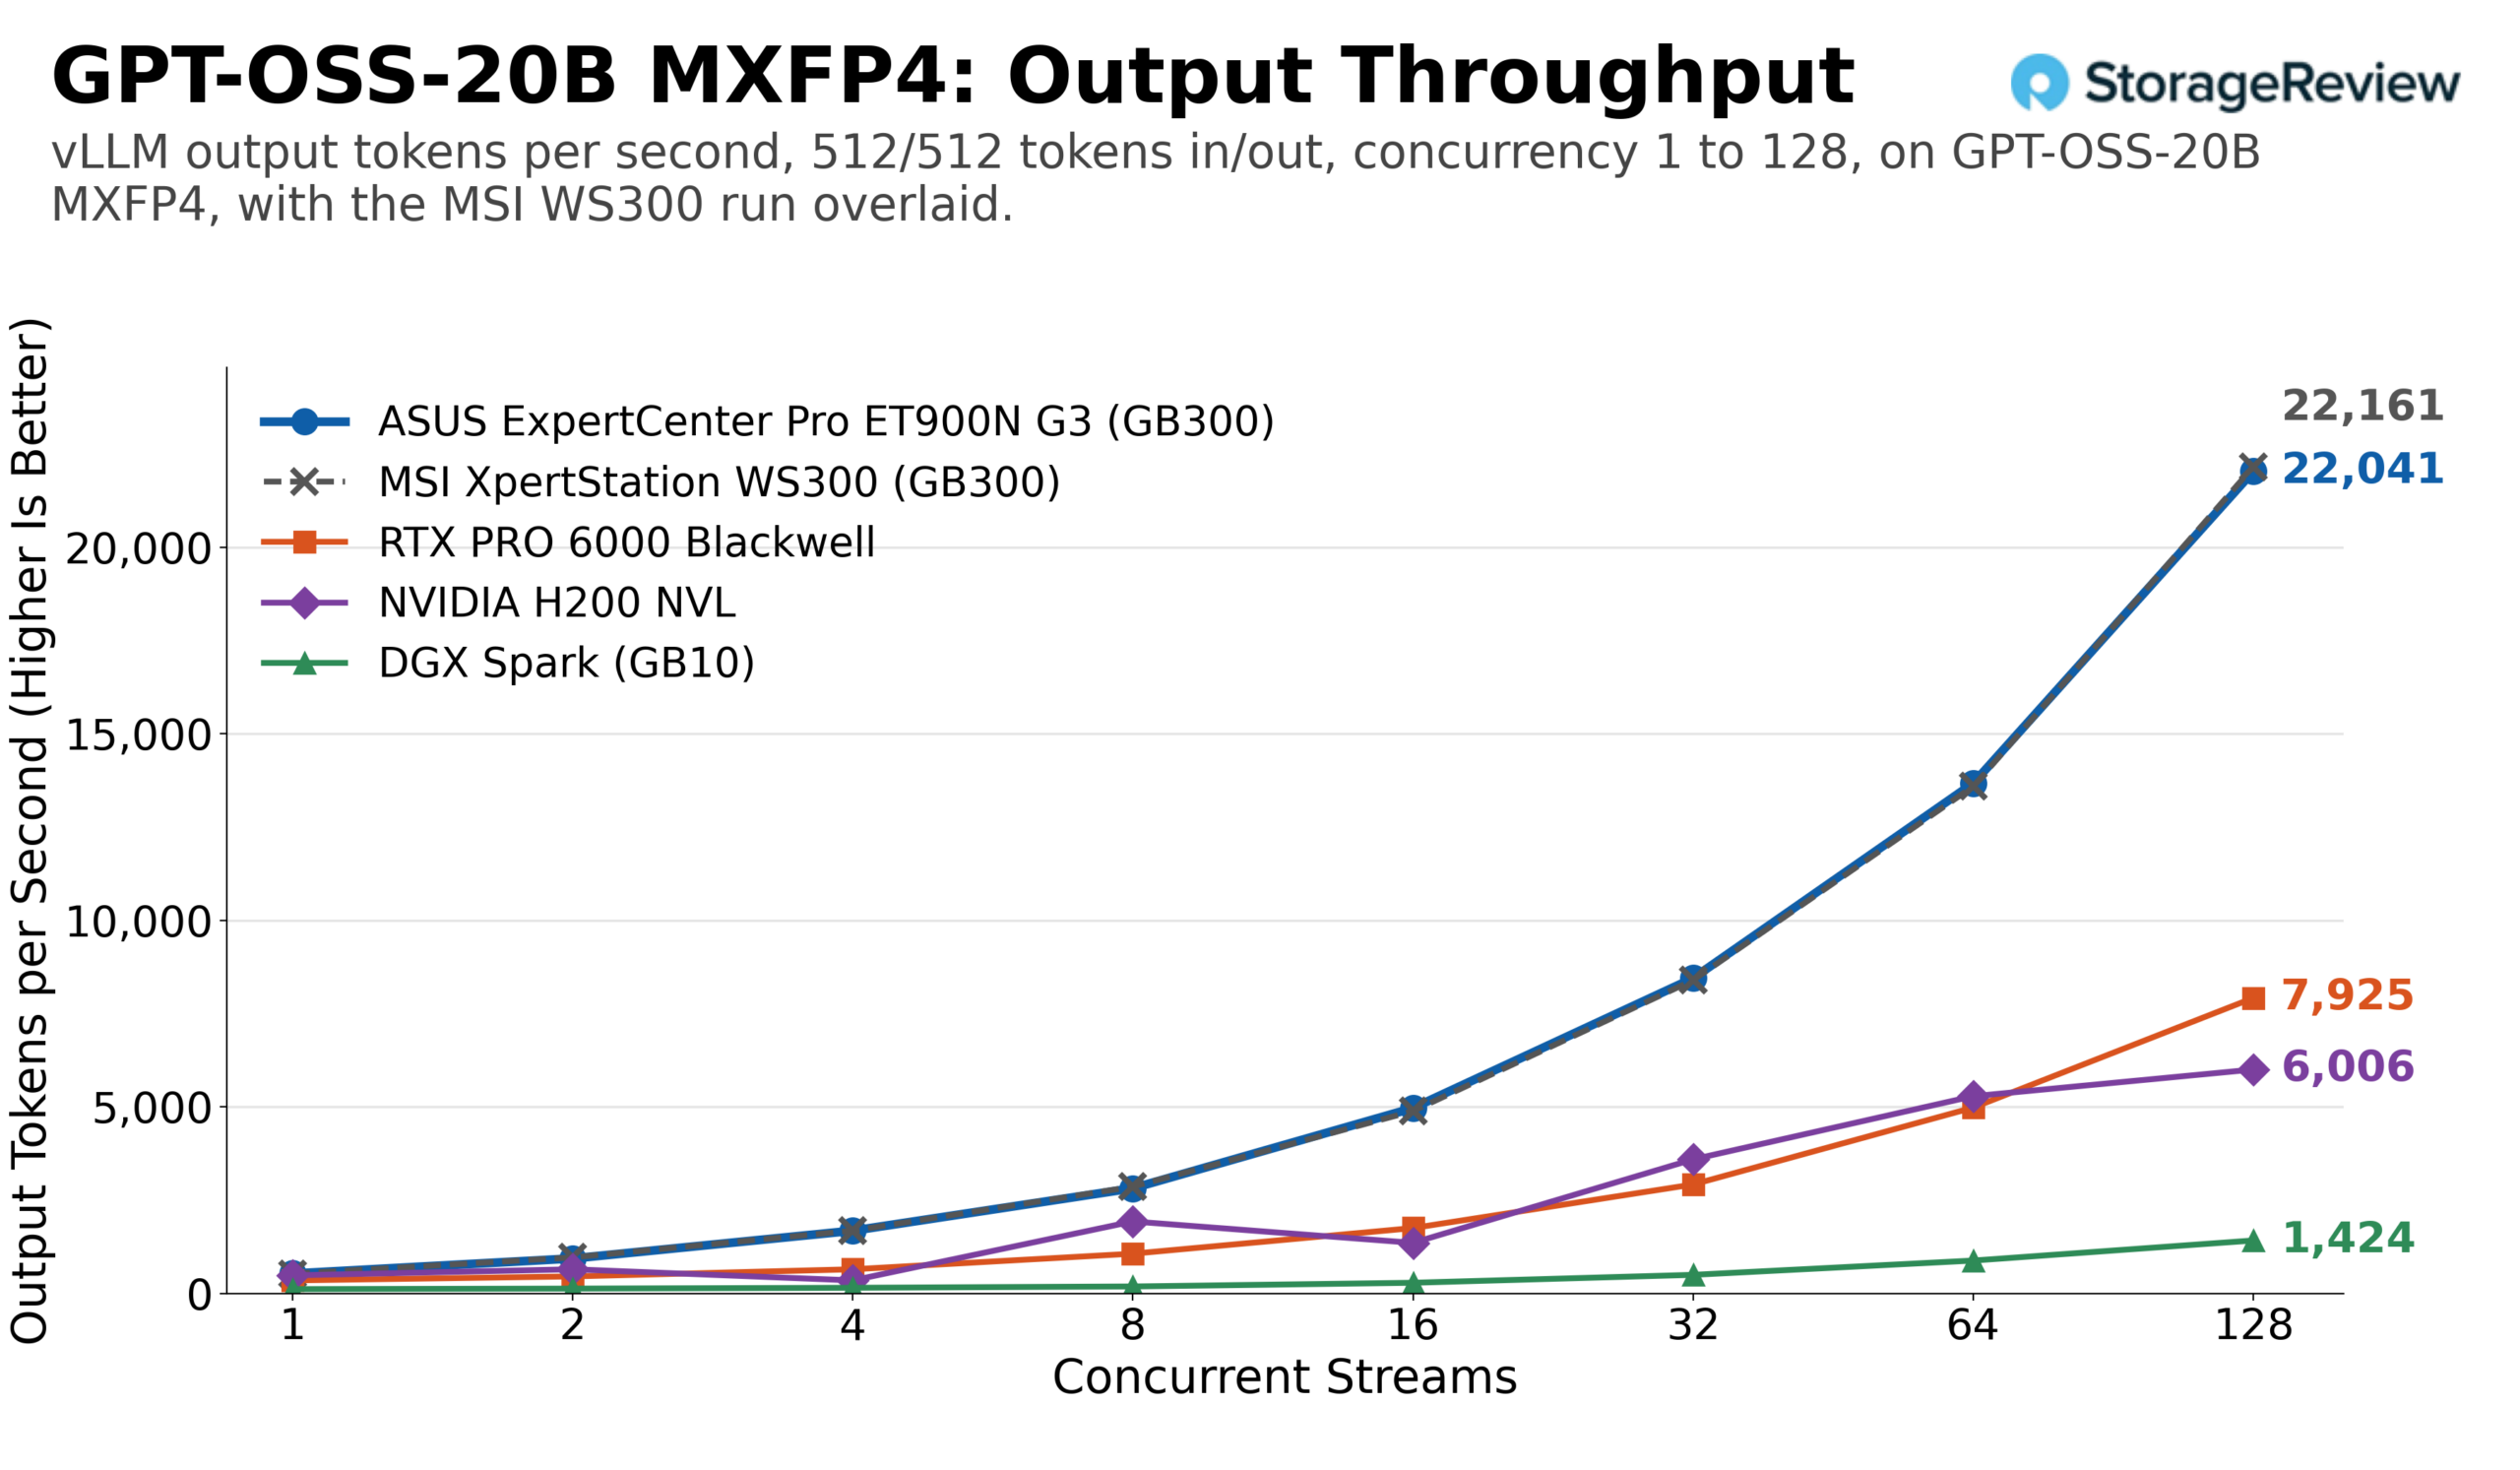
これは、今後さらに多くのGB300タワーがラボに届くにつれて、私たちが比較していくものです。次はHPのZGXで、その後も続々と届きます。各タワーは同じスキャンを実行するため、OEMの実装の違いは、タワーごとに1つのグラフに表示され、モデルグラフには生の曲線が表示されます。
結論
ASUS ExpertCenter Pro ET900N G3は、リファレンスプラットフォームの2番目の実装としてあるべきことを実現しています。つまり、最初の実装を裏付けています。14のモデルと2つのワークロードにわたって、ピークvLLMスループットは、DeepSeek V4 Flashでの毎秒1,766出力トークンからGPT-OSS-20Bでの毎秒22,041まで、28の比較のうち24でMSI XpertStation WS300の2%以内に収まり、4つのシングルランの外れ値は2~5%低いものでした。また、Graceメモリに215GBのエキスパートを搭載したGLM-5.2を、4枚のRTX PRO 6000カードでも到達できない速度で処理しました。GB300 Superchipが上限を設定しており、ASUSはそれをうまく実現しました。
ASUSが追加したのは実用的な機能です。ハンドルのおかげで、27kgのタワー型PCをパネルをつかまずに2人で移動させることができ、QSFP112ケージ上のファンは、400G光モジュールを長時間使用するユーザーにとって潜在的な問題を解決し、チタン製電源は壁コンセントでの消費電力を数ワット削減します。Armホスト、20A回路、BMC専用のディスプレイ出力、大型カード搭載時の1,600Wの共有電力予算は、どちらのタワー型PCにも等しく適用されるプラットフォーム上の制約です。
GB300 DGX Stationは、私たちがこれまでデスクに置いた中で最も高性能な製品であり、ASUSは自社製のGB300 DGX Stationを魅力的な選択肢として提供している。
私たちの上に ローカルAIに最適なデスクトップ leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon