

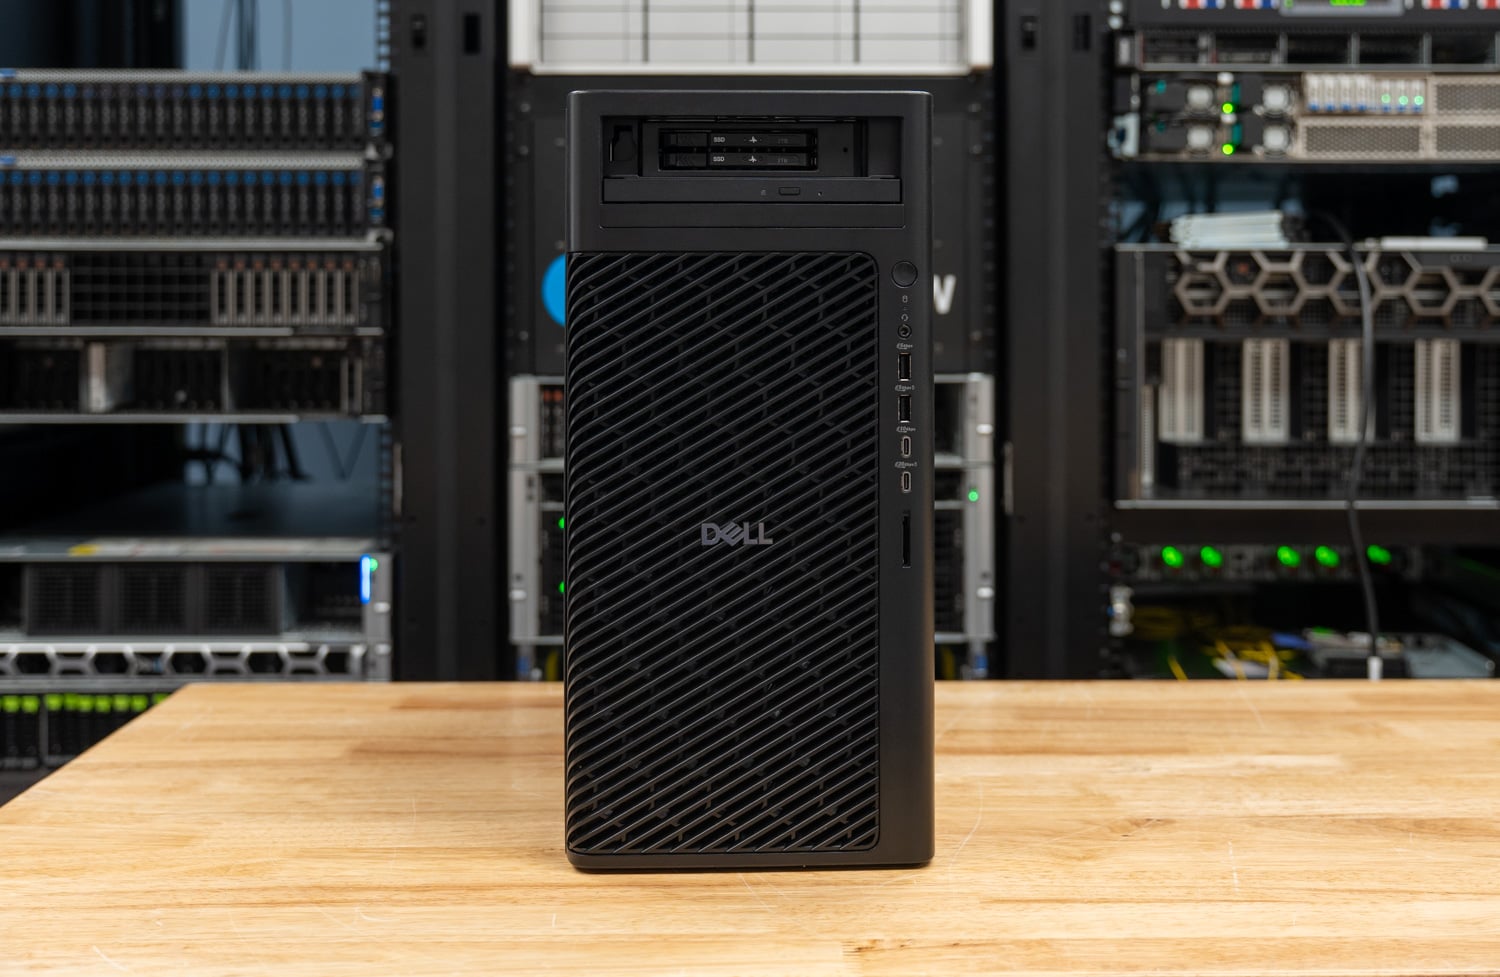
Dell Pro Precision 9 T2は、1年前にレビューしたシングルGPUタワー「Dell Pro Max Tower T2」のXeonバージョンで、2つの変更点があります。1つは、DellがワークステーションをPrecisionブランドに戻したため、新しい名前になったこと、もう1つは、同じ32リットルのシャーシ内でCore Ultra 9 285KがIntelのXeon 6に置き換えられた新しいプラットフォームになったことです。私たちが試用したユニットには、24コアのXeon 658X、128GBのDDR5-6400 RDIMM ECC、300WのRTX PRO 6000 Blackwell Max-Q、およびフロントFlexBayにストライピングされた2台の2TB E3.S Gen5ドライブが搭載されていました。Dell.comで同じ構成で販売されている価格は約28,300ドルです。
マトリックス形式でテストしました。Pro Precision 9 T2 では、付属の Max-Q カードと、Pro Max Tower T2 から取り出した 600W RTX PRO 6000 Blackwell の両方を使用して、テストスイート全体を実行しました。Core ベースの T2 でも両方のカードを実行したため、以下の結果はすべて 4 つの列で構成され、各ペアは 1 つの変数、つまり CPU プラットフォームまたは GPU の電力制限を分離しています。テストスイートは、先週のRTX Spark ノートブックで実行したものと同じで、今回初登場の項目がいくつか追加されています。
Xeon はスループットを買ってレイテンシを犠牲にしています。Pro Precision 9 T2 は、Cinebench 2026 マルチコアで 12,322 を記録し、Core T2 の 8,856 を上回りました。LLVM の構築時間は 140.2 秒で、Core T2 の 182.5 を上回りました。STREAM Triad の読み取り速度は 122,233MB/s で、Core T2 の 33,003 を上回りました。一方、シングルコア Cinebench スコアは 454.1 で、Core T2 の 564.4 を下回り、Speedometer スコアは 36.8 で、Core T2 の 46.3 を下回りました。600W カードは、どちらのタワーでも LLM デコードで 7 ~ 20 パーセント、プロンプト処理と拡散で 20 ~ 39 パーセント向上し、Xeon タワーでは、全コア作業で CPU のコストが 4 ~ 5 パーセント低下します。
主要なポイント(要点)
- Xeon 6は、シングルソケットタワー型の高スループットプラットフォームです。 Cinebench 2026マルチコアで12,322、同じシャーシのCore Ultra 9 285Kより39%高いスコア、7-Zipで289.6 GIPS(174.8 GIPS)、DGEMMで1,638 GFLOPS(768 GFLOPS)、DDR5-6400の4チャネルによりメモリ帯域幅が3.7倍。
- 285Kは依然としてスレッドあたりの速度でトップを走っている。 XeonはCinebenchシングルコアで20%、Speedometerで21%、シングルスレッドPythonで20~31%劣り、コア間レイテンシは56.2nsに対し38.1nsとなっている。
- AIの結果を決定づけるのはGPUであり、600Wのカードはその電力を以下のプロンプトに基づいて獲得する。 MLPerf Llama 3.1 8B は Max-Q では毎秒 230.9 トークン、600W カードでは毎秒 252.8 トークンを生成し、最初のトークンまでの時間は 0.082 秒から 0.059 秒に短縮され、Qwen-Image 20B は 1024×1024 の画像を 26.1 秒から 19.7 秒でレンダリングします。
- 600Wのグラフィックカードは、XeonのCPUの負荷を4~5パーセント増加させる。 Cinebenchのマルチコアスコアは12,322から11,705に、30分間の連続ループスコアは12,328から11,764に低下し、定常状態のクロック周波数は4,274MHzから4,178MHzに低下しました。同じ構成変更をCore T2で行っても変化はありませんでした。
- FlexBayに搭載されたE3.S、Graid社製VROCストライプ塗装済み: フロントベイには、タワー型ワークステーションとしては初めてとなる2台のE3.S Gen5ドライブが搭載されており、DellのRAID0ブートオプションにより、Graid TechnologyのVROCを搭載した4,097GBのボリュームが構築されます。ストライプのシーケンシャル読み取り速度は9,332MB/sで、4Kランダム読み取り時のピークIOPSは840.1Kです。これは、Core T2に搭載されている単一のGen5 M.2の1.78M IOPSと比較すると高い数値です。
プロマックスからプロプレシジョンへ
Dellは2025年初頭にPrecisionという名称を廃止し、すべてのワークステーションをDell Pro Maxに置き換えましたが、今回復活させました。10月7日、DellはGB10とGB300デスクトップサイドの名称をDell Pro MaxからDell Pro Precisionに変更し、Dell.comではPro Precision 9 T2が新しいT4およびT6タワーとともに同じブランドで掲載されています。Pro MaxはCoreベースのマシンに残っており、昨年レビューしたCore Ultraタワーは引き続きDell Pro Max Tower T2として販売され、今回レビューしたXeonタワーはDell Pro Precision 9 T2(モデルPW9T2260)です。
T4とT6は名称変更に伴いXeon 6に移行し、Dellは3つのタワーを拡張性で位置付けています。Pro Precision 9 T4(PW9T4260)は、最大86コアのXeon 698Xまで同じプロセッサリストを採用し、8つのメモリチャネルすべてで最大4TBのDDR5-6400に対応する16個のDIMMスロットを追加、1500W電源で600WのRTX PRO 6000を1枚またはMax-Qカードを2枚搭載可能で、2400Wシャーシはオプションです。
Pro Precision 9 T6(PW9T6260)は、6つのスロット、2400Wの電源、そして600WのRTX PRO 6000カードを2枚、Max-Qカードを3枚、またはRTX PRO 5000を最大5枚搭載できるスペースを備えた最上位モデルです。T2は、シングルGPU、4チャンネル構成のエントリーモデルです。
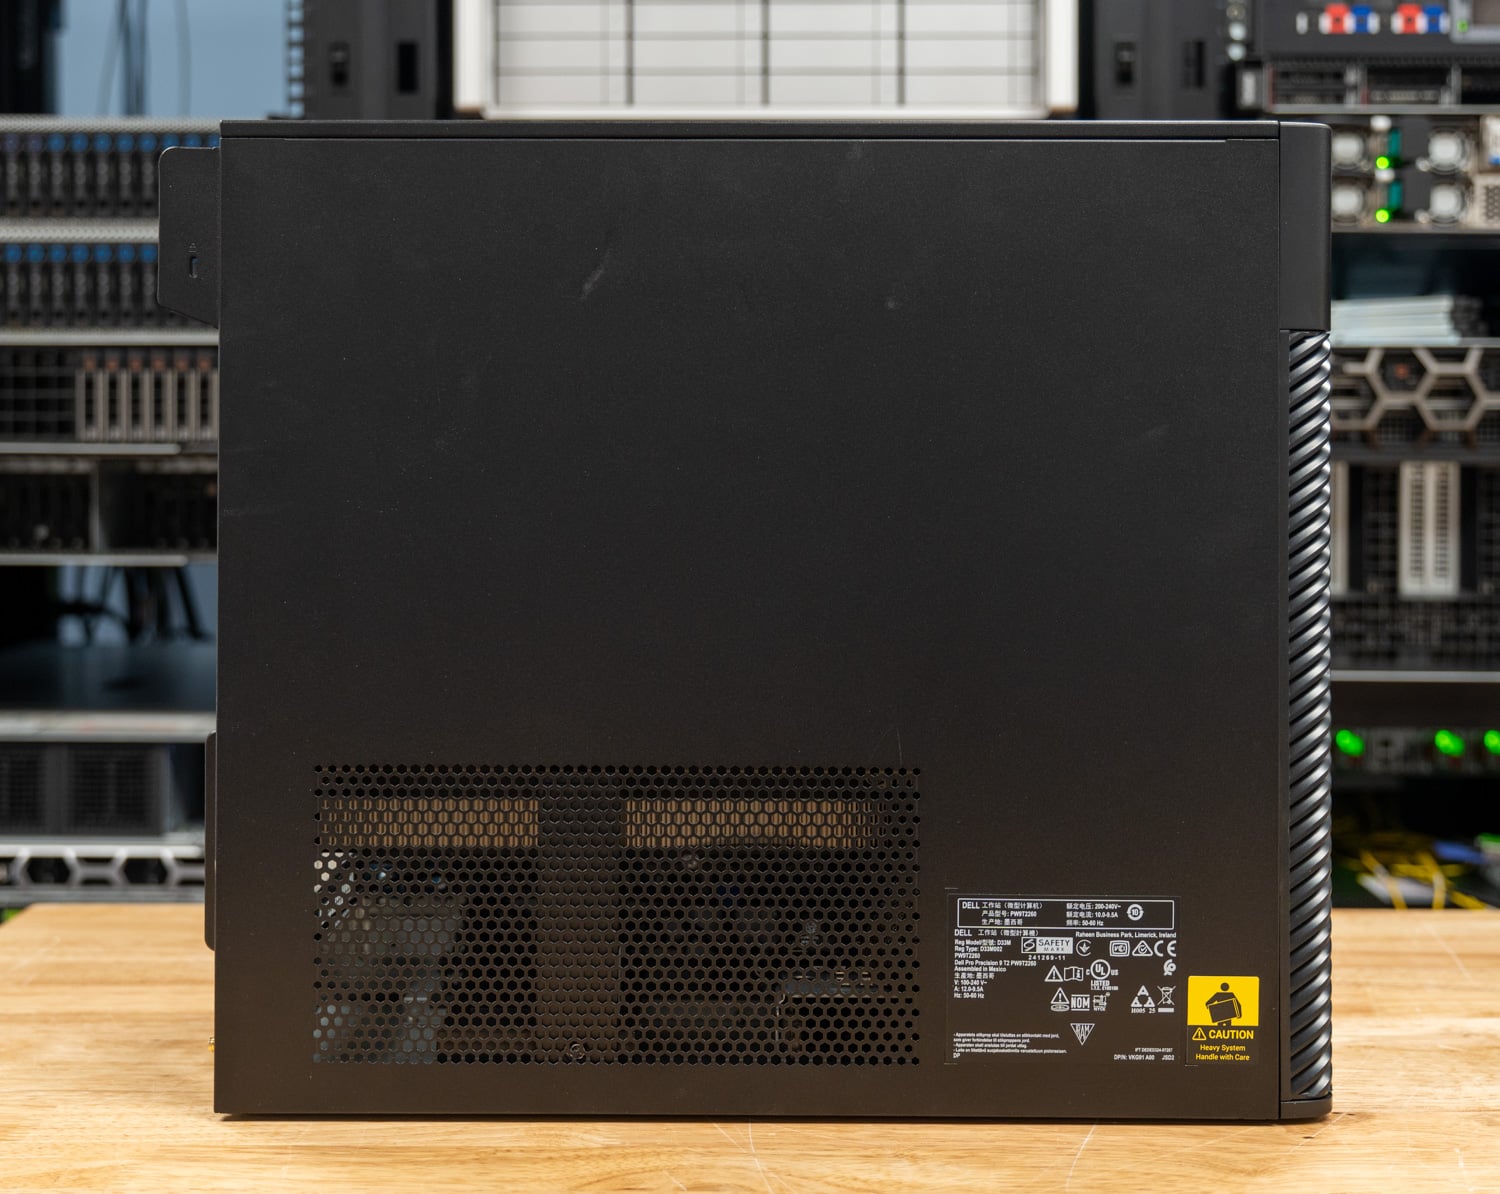
命名の正確さが重要なのは、2 つのタワーは外観が同一で、387 x 187.7 x 438mm の同じ 32 リットルシャーシ、同じベゼルとフロント FlexBay、および Dell のコンフィギュレーターで同じ RTX PRO 6000 Blackwell オプションを共有しているため、違いはボードにあるからです。Pro Max Tower T2 は 24 コアの Core Ultra 9 285K と 4 つの非バッファード DDR5 DIMM スロットを組み合わせていますが、Pro Precision 9 T2 は、ワークステーション向けの Intel Xeon 6、6月にベアボードでレビューしたGranite Rapids-WSプラットフォーム、レジスタード ECC メモリ、より多くの PCIe レーン、および最上位構成で 250W プロセッサを採用しています。

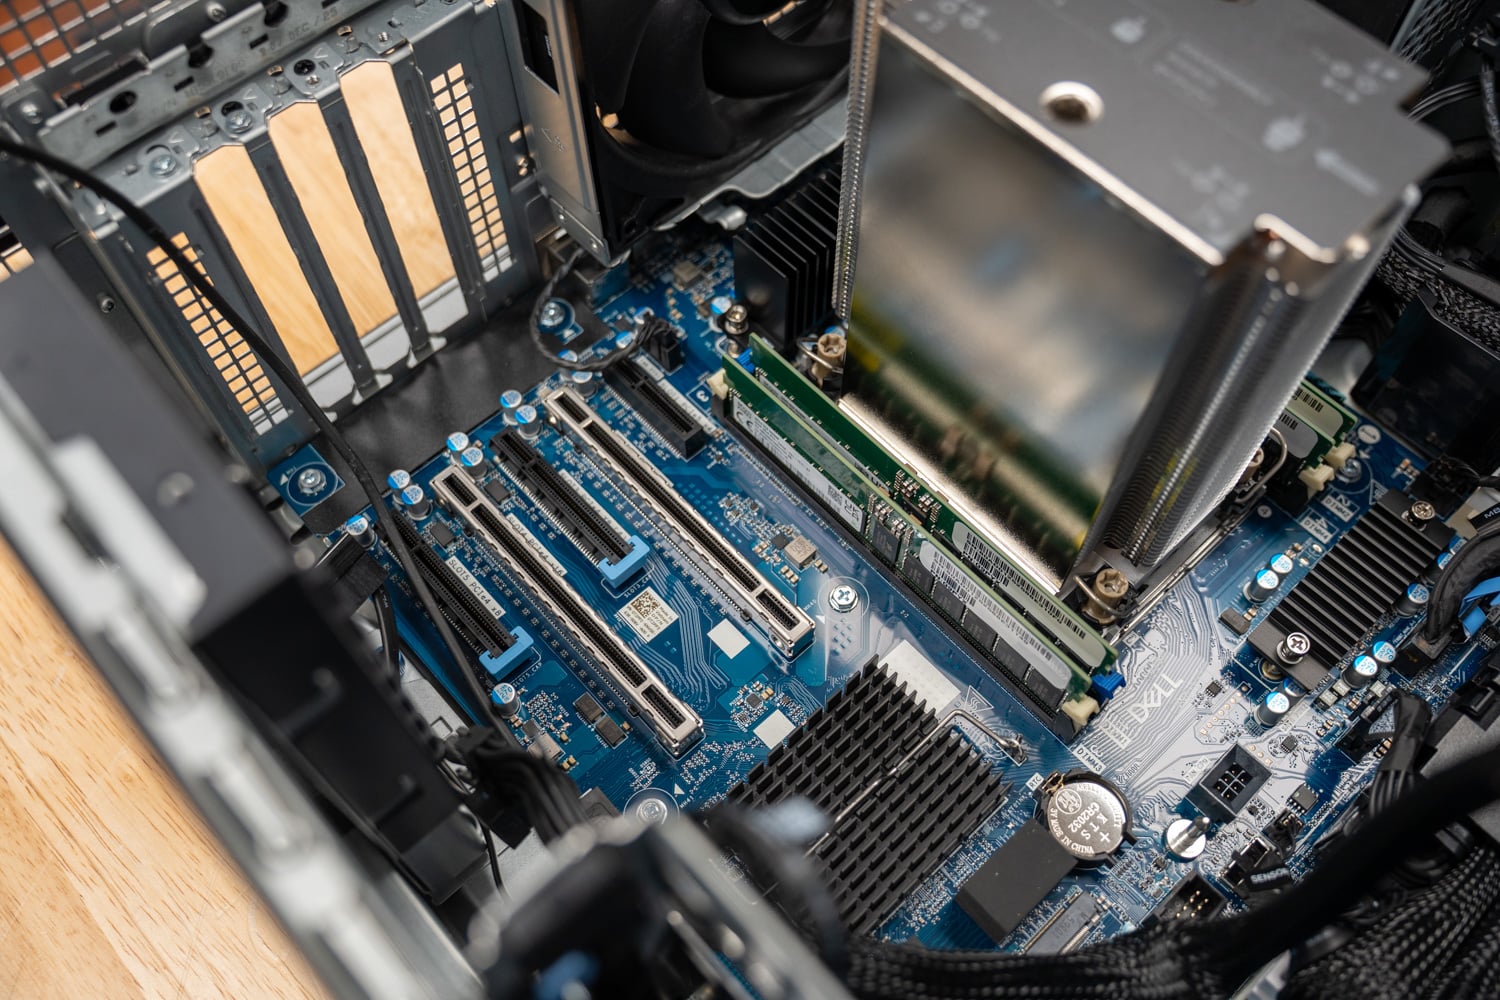
DellはPro Precision 9 T2に6種類のXeon 6プロセッサを提供しており、150Wの12コアXeon 634から、今回レビューしたユニットの250Wの24コア658Xまで用意されています。634から658Xへのアップグレードは1,560ドルのオプションです。658Xは24コア48スレッドで、ベースクロック3.0GHz、ターボクロック4.9GHz、L3キャッシュ144MB(285Kの36MBの3倍)を搭載し、285KにはないAVX-512とAMXをサポートしています。このチップは8つのDDR5-6400チャネルと128のGen5レーンを備えています。T2には4つのDIMMスロットと5つの拡張スロットがあり、より大型のT4とT6では残りのスロットが露出します。
| Platform | Dell Pro Precision 9 T2(テスト済み) | Dell Pro Max Tower T2(テスト済み) |
|---|---|---|
| プロセッサ | Intel Xeon 658X、24コア/48スレッド、3.0~4.9GHz、144MB L3キャッシュ、250W | Intel Core Ultra 9 285K、24コア/24スレッド(8P + 16E)、最大5.7GHz、36MB L3、125W |
| 命令セット | AVX-512、AMX | AVX2 (AVX-512 なし)、インテル AI ブースト NPU |
| メモリ | 32GB DDR5-6400 RDIMM ECC 4枚(4チャンネル、最大1TB) | 32GB DDR5-4400 ECC UDIMM x 4 |
| 拡大 | Gen5 x16、Gen5 x4、Gen4 x16、Gen4 x8 2台(うち1台は電気系統でx4) | Gen5 x16、Gen4 x4 x1、Gen3 x4 x2 |
| テスト済みのブートストレージ | 前面FlexBayに2TB E3.S Gen5 NVMe SSD×2台、RAID0構成(Graid Technology社製VROC)、4,097GB | 2TB SK hynix PCB01 M.2 Gen5(シングルドライブ) |
| 内部M.2 | M.2 2280 Gen5 x 3 | Gen5 M.2 1基とGen4 M.2 2基 |
| 電源 | 標準出力750W、オプションで500Wまたは1500W(テスト対象は1500W) | 360W、500W、または1500W(80 Plus Platinum認証) |
| テストされたグラフィック | RTX PRO 6000 Blackwell Max-Q (300W) 出荷時仕様。600W版カードもテスト済み。 | RTX PRO 6000 Blackwell (600W) 出荷時仕様。Max-Qカードもテスト済み。 |
| シャーシ | 387 x 187.7 x 438mm、11.6~21.8kg | 387 x 187.7 x 438mm、8.17~23kg |
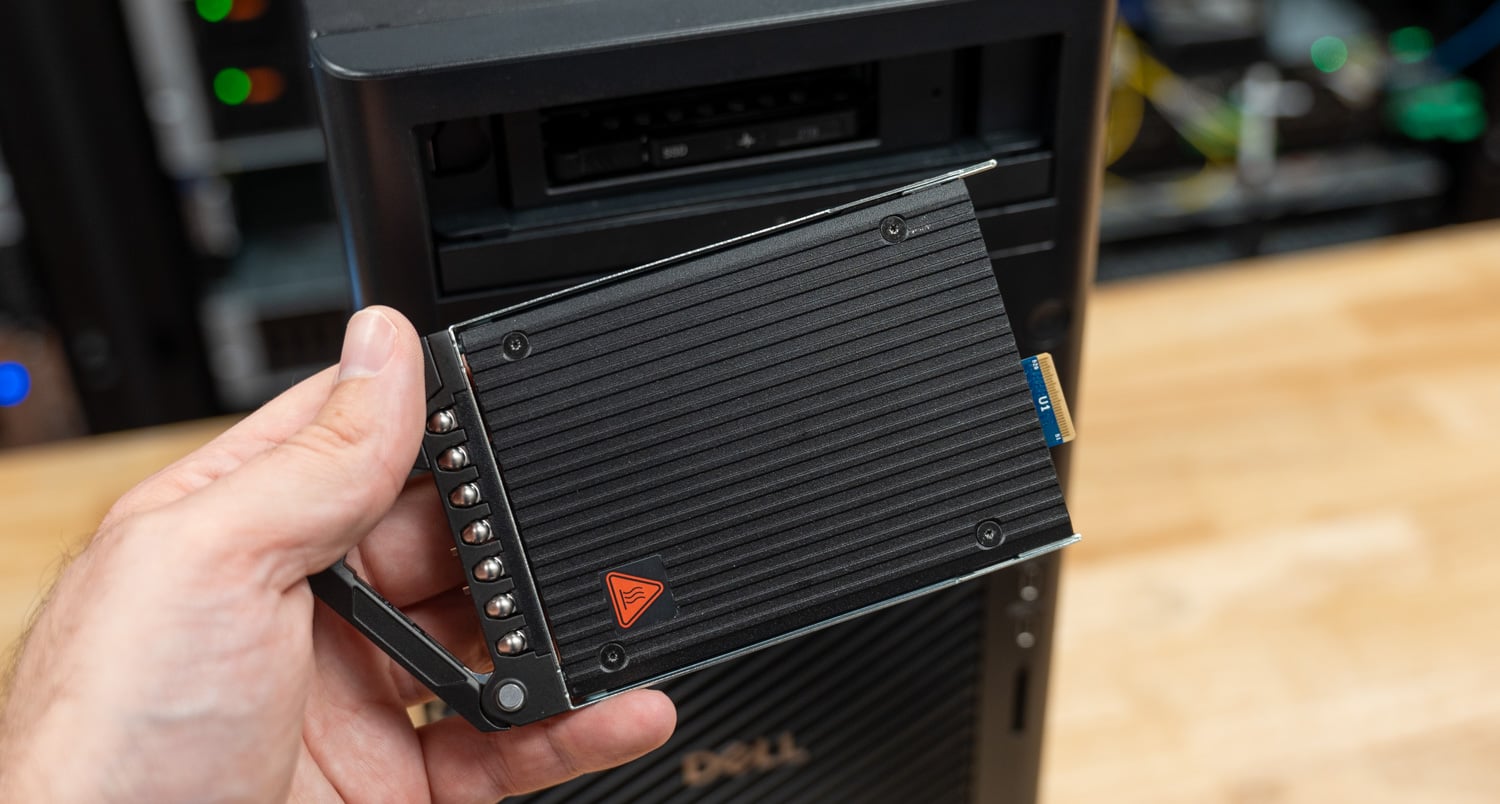
Core T2 は単一の M.2 ドライブから起動しますが、Pro Precision 9 T2 には Dell の FlexBay NVMe ブート構成が搭載されています。これは、フロント ベゼルの裏側にホットプラグ対応の E3.S Gen5 ドライブ 2 台が搭載され、RAID0 ブート オプションによって 4,097GB のボリュームにストライピングされています。E3.S は、容量の上限を M.2 をはるかに超え、シャーシを開けずにドライブを前面から取り出せるため、タワー ベンダーに要望してきたエンタープライズ フォーム ファクターです。RAID レイヤーはGraid Technology の VROC で、これは昨年 Graid が引き継いで Computex で再発表した Intel VROC コードであり、このワークステーションは、当ラボで出荷された最初の製品です。

600Wカードには少し余裕が必要ですが、Max-Qカードには必要ありません。弊社のユニットにはGPUの隣のスロットにIntel E810-XXVデュアルポート25GbEアダプタが装着されていましたが、600W RTX PRO 6000を取り付けるには、このアダプタを取り外す必要がありました。カードのクーラーが隣接するスロットのスペースと電源を占有するためです。フルパワーカードと高速NICを希望する購入者は、注文前にスロットのレイアウトを計画しておく必要があります。また、1500W電源が唯一妥当な組み合わせです。弊社のユニットには1500Wオプションが搭載されており、標準の750W電源から40ドルのアップグレードとなっています。
ビルドとデザイン
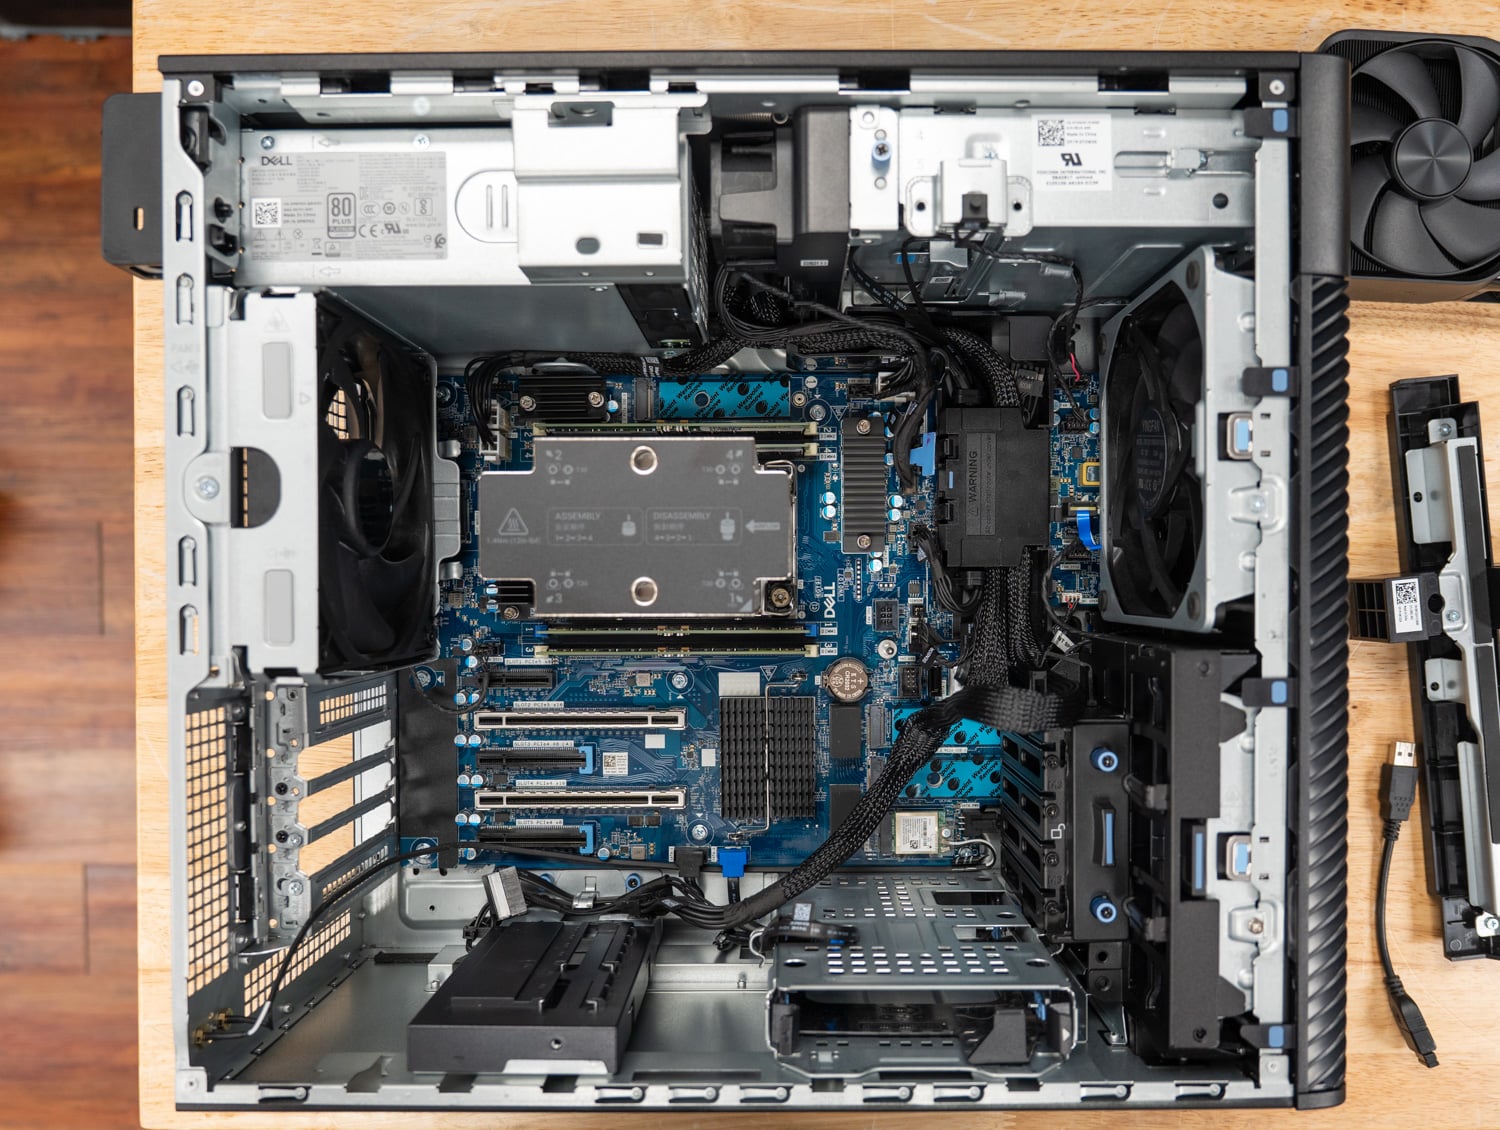
Pro Precision 9 T2は、Pro Maxバージョンと同じツールレスタワーを採用しており、吸気用のフルハイトメッシュフロントグリル、サイドパネル用のサイドラッチと固定式つまみネジ、下部ベゼルの裏側にFlexBayとオプションのスリム光学ドライブを備えています。Dellはシャーシの重量を空の状態が11.6kg、構成時が最大21.8kgとしていますが、今回テストした1500W電源、658Xのクーラー、2スロットGPUを搭載した構成は、その範囲の上限に近い重量となっています。

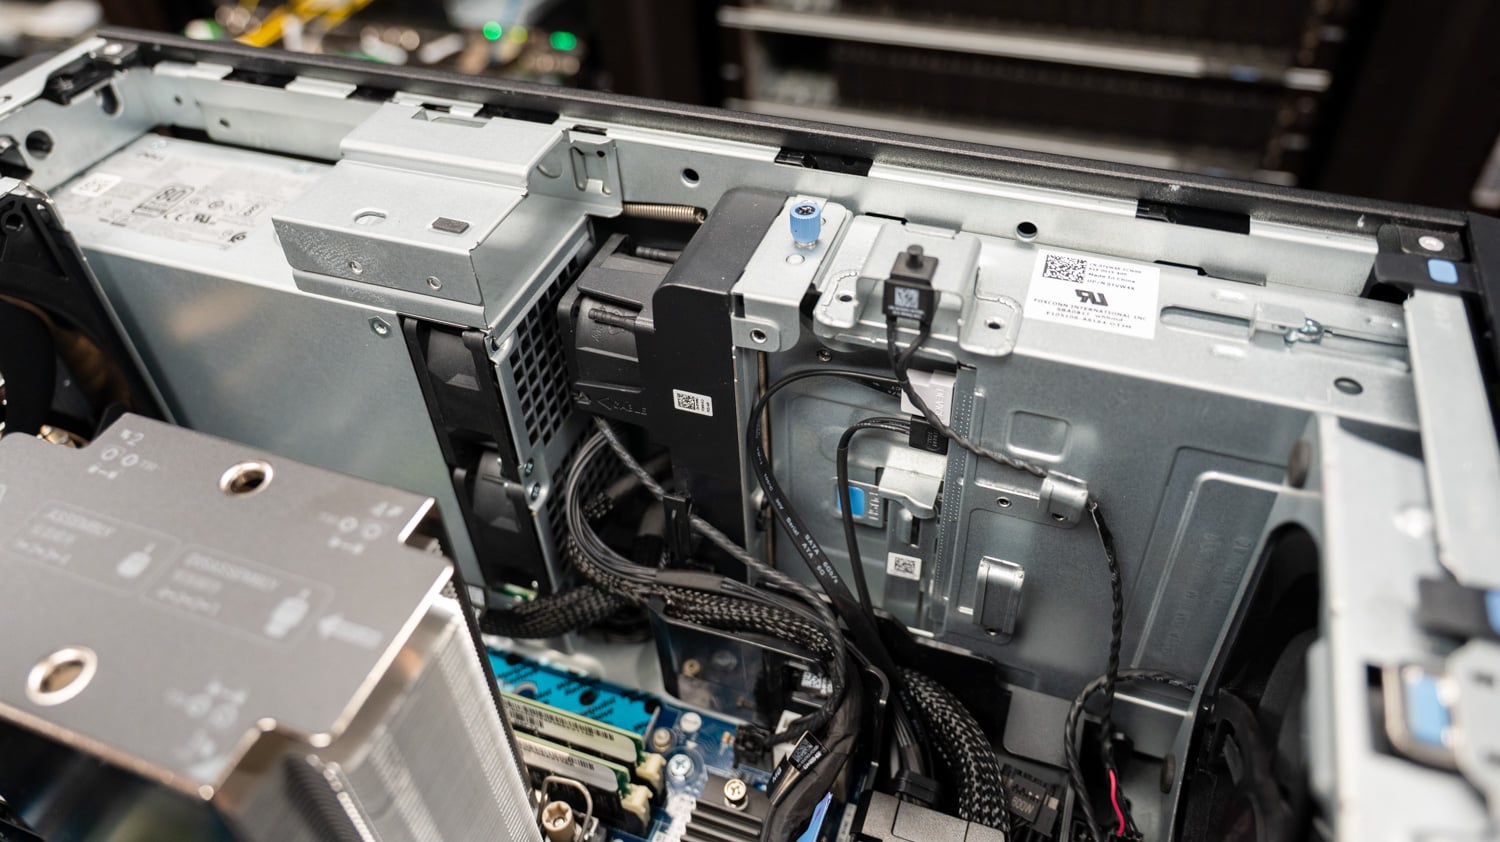
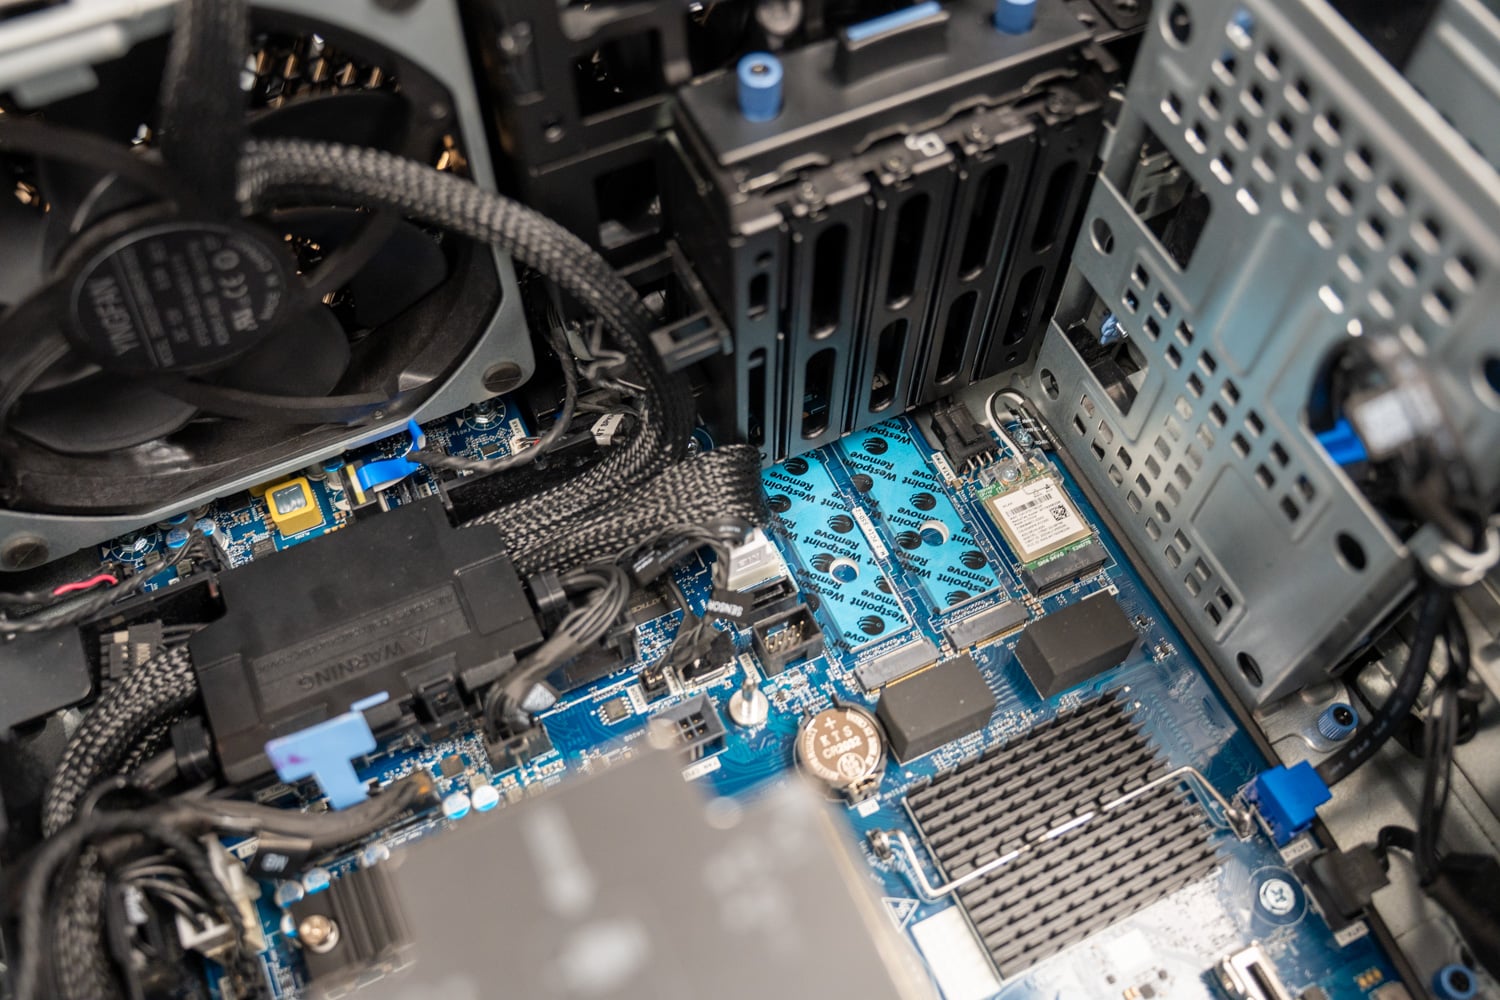
シャーシ内部はエアフローを重視して設計されており、デルは空気の流れを必要な場所に正確に誘導します。DIMMを冷却し、CPUからの熱気をシャーシの外へ排出する大型の冷却シュラウドには、ファンが内蔵されています。ケースを開けると、シュラウドがシャーシの構造にどのように組み込まれているかが分かります。シュラウドの下端はGPUサポートブラケットに接し、サイドカバーにぴったりと収まっています。
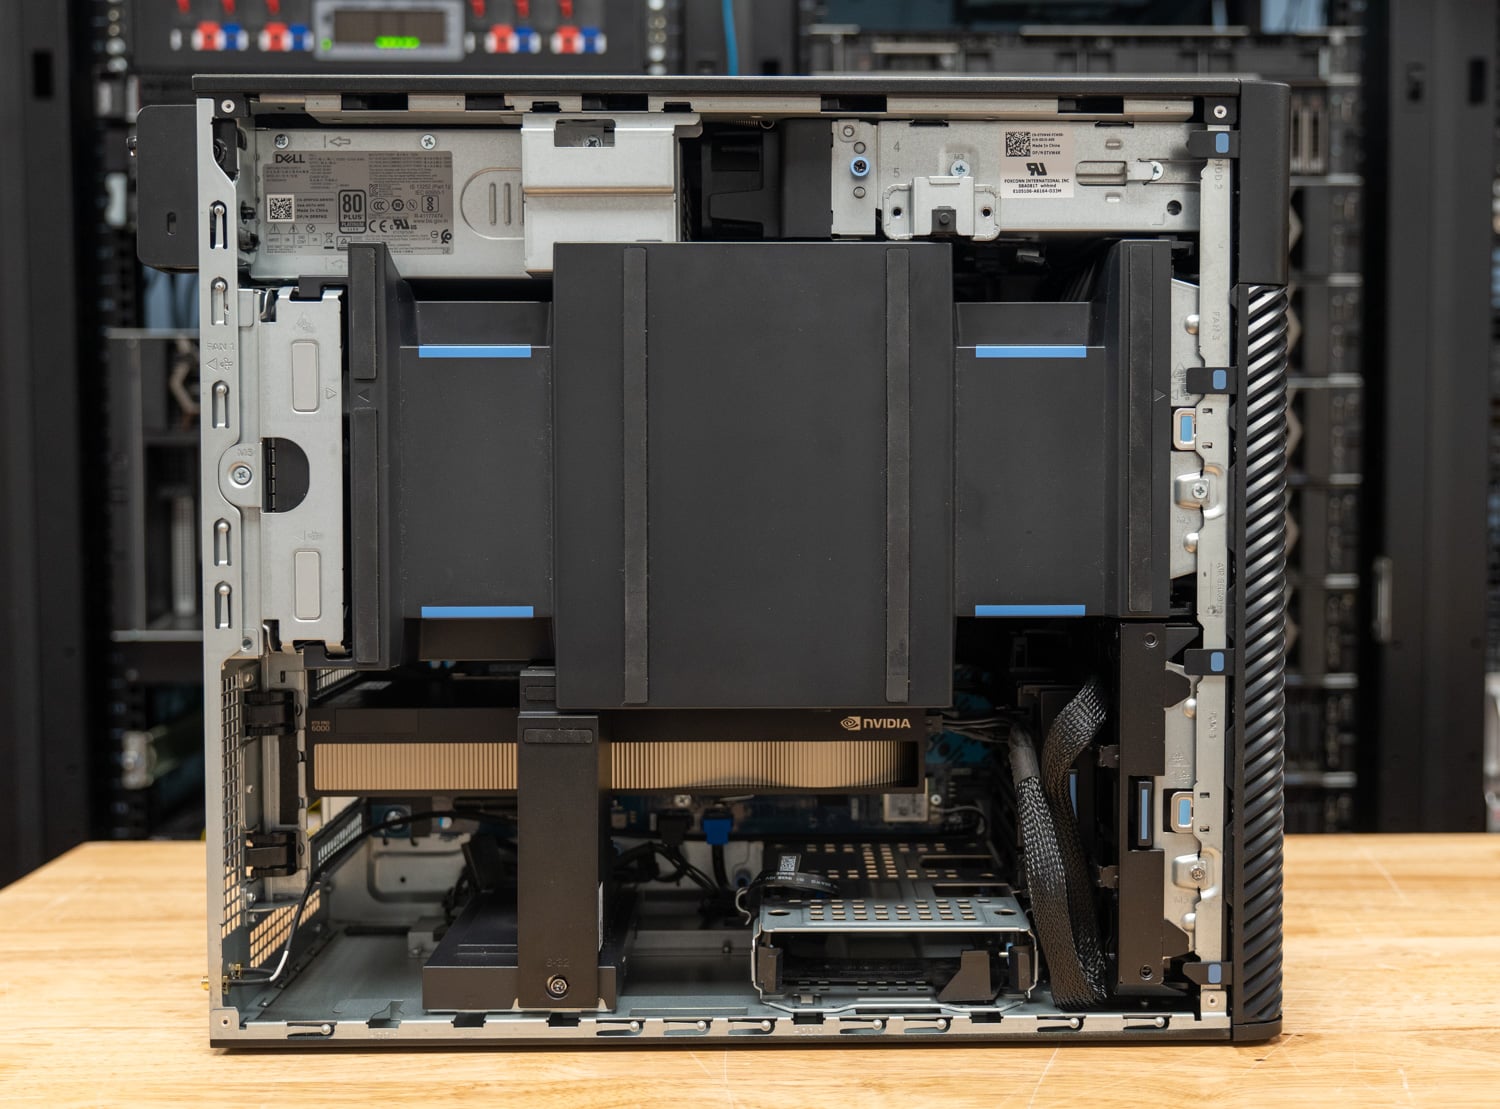
内部のレイアウトは Pro Max タワーと同じで、プロセッサと 4 つの DIMM スロットは拡張エリアの上にあり、Gen5 x16 スロットの GPU は端が保持ブラケットで支えられ、電源ユニットは背面にハンドル付きで取り付けられ、ツールなしで取り外すことができます。 5 つのスロットはすべてフルハイトです。スロット 2 は GPU 用の Gen5 x16、スロット 1 は Gen5 x4、残りの 3 つは Gen4、1 つは x16、2 つはオープンエンドの x8 で、NIC、ストレージ カード、または 2 つ目の GPU に使用できます。前面の E3.S ベイの後ろには、3 つの内部 M.2 2280 Gen5 スロットと 2 つの 3.5 インチ SATA ベイがあります。
前面のI/Oは、ヘッドセットジャック、PowerShare対応の20Gbps USB-Cポート、10Gbps USB-Cポート、2つのUSB-Aポート、およびオプションのSDスロットです。背面には、オーディオライン出力、20Gbpsおよび10GbpsのUSB-Cポート、SmartPower対応のUSB 2.0ポート2つ、5Gbps USB-Aポート2つ、1GbE、5GbE NICまたはUSB-Aポート2つを追加できるオプションのモジュールスロット、およびオプションのレガシーシリアルポートがあります。私たちのユニットには、内部のM.2 2230スロットにMediaTek MT7925 Wi-Fi 7カードと、600W GPU用に発売されたIntel E810-XXV 25GbEカードが追加されました。

Dell Pro Precision 9 T2 の仕様
| 製品仕様 | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| プラットフォームの概要 | |
| プロセッサのオプション | Intel Xeon 634 (12コア、150W)、636 (12コア、170W)、638 (16コア、180W)、654 (18コア、200W)、656 (20コア、210W)、658X (24コア/48スレッド、144MB L3、250W) テスト対象:Xeon 658X |
| メモリ | DDR5 RDIMM ECC、5600または6400 MT/s、4スロット、最大1TB(256GB×4) テスト時のメモリは128GB(32GB×4)DDR5-6400です。 |
| グラフィックオプション | NVIDIA RTX A400、A1000、RTX PRO 2000 / 4000 / 4500 / 5000 / 6000 Blackwell (600W) / 6000 Blackwell Max-Q (300W)、A800 Active、AMD Radeon Pro W7400、一部のカードではデュアル構成とトリプル構成に対応。 RTX PRO 6000 Blackwell Max-Q Workstation Edition、96GB GDDR7(テスト済み) |
| Storage | フロントFlexBay:最大2台のE3.S/NVMeドライブとオプションのスリムODD、または1台の3.5インチSATAベイ 内部:M.2 2280 Gen5 NVMe x 3、3.5インチSATA x 2 RAID: Intel VMD with VROC by Graid Technology (RAID0ブート、内部RAID0) テスト済み:2 x 2TB E3.S Gen5 NVMe(RAID0構成、4,097GB) |
| 拡大 | スロット1:Gen5 x4、スロット2:Gen5 x16、スロット3:Gen4 x8(x4電気接続、オープンエンド)、スロット4:Gen4 x16、スロット5:Gen4 x8(オープンエンド)、Wi-Fi用M.2 2230 |
| I / O | |
| フロントポート | PowerShare対応USB-C 20Gbpsポート×1、USB-C 10Gbpsポート×1、PowerShare対応USB-A 5Gbpsポート×1、USB-A 5Gbpsポート×1、ヘッドセットジャック、オプションのSDカードスロット |
| 背面ポート | USB-C 20Gbps x 1、USB-C 10Gbps x 1、USB 2.0 (SmartPower) x 2、USB-A 5Gbps x 2、オーディオライン出力、RJ45 1GbE x 1、オプションで5GbEまたはデュアルUSB-Aモジュール、オプションでシリアルポート |
| テスト済みのネットワーク | Intel E810-XXV DA2 デュアルポート 25GbE SFP28(600W GPU動作時は取り外す);MediaTek MT7925 Wi-Fi 7、Bluetooth 5.4 |
| パワーと身体 | |
| 電源 | 標準750W、オプションで500Wまたは1500W、テスト済みは1500W |
| 寸法 | 387 x 187.7 x 438mm(15.23 x 7.38 x 17.24インチ) |
| 重量 | 最小11.6kg(25.57ポンド)から最大21.8kg(48.06ポンド) |
| オペレーティングシステム | Windows 11 Pro for Workstations(テスト環境)またはUbuntu Linux 24.04 LTS |
| 管理とセキュリティ | Intel vPro、TPM 2.0、シャーシ侵入検知スイッチ、ロック可能なベゼルオプション、ケンジントン スロット |
| 価格 | Dell.com 基本構成は3,978ドル(Xeon 634、16GB、RTX A400、256GB、750W)、テスト構成は約28,300ドル(Xeon 658X、128GB DDR5-6400、RTX PRO 6000 Max-Q、2 x 2TB Gen5 FlexBayドライブ(RAID0構成)、1500W、25GbE、Wi-Fi 7)、Dell.comの価格は2026年10月19日時点。 |
この価格には2つの注意点があります。Dell.comのコンフィギュレーターではFlexBayドライブは2TB M.2 2280 Gen5モジュールとして1個1,700ドルと記載されていますが、私たちのユニットに搭載されているドライブはE3.Sです。E3.Sオプションがオンラインで利用可能になる時期については、Dellに問い合わせています。また、Dellはビジネスワークステーションがウェブ価格で購入されることはほとんどないと率直に認めているため、28,300ドルはボリュームディスカウントや契約価格の上限として考えてください。メモリとGPUがそのうち19,090ドルを占めており、GPUオプションは300Wカードでも600Wカードでも同じ価格です。
Dellはこのレビュー用ユニットを31,700ドルとしており、この金額には、E810-XXV 25GbEアダプター、Wi-Fi 7、光学ドライブ、および3年間のProSupportが、私たちが価格を算出した構成に加算されています。
テストのセットアップと方法論
本レビューのすべての結果は、スクリプト化されたWindowsクライアントベンチマークスイートであるsr-client 1.2をフル実行プロファイルで実行した結果です。4つの構成すべてにおいて、Dellの工場出荷時のWindowsイメージ、Dellのドライバー、およびNVIDIAドライバー596.71を使用しています。このスイートでは、すべての構成で同じ設定が適用されます。Windowsの電源モードは「最高のパフォーマンス」、スリープタイマーとディスプレイオフタイマーはすべて無効、WindowsファイアウォールとUACプロンプトは無効、VBSとメモリ整合性は出荷時のまま有効です。各結果は複数回のパスの中央値であり、スイートは結果のばらつきが2%を超えるテストを再実行してから結果を受け入れます。
以下の 4 つの構成は、2 つのタワーと 2 つの GPU で構成されています。Pro Precision 9 T2 は、Max-Q カードを使用してフルスイートを実行し、次に Pro Max Tower T2 の 600W RTX PRO 6000 Blackwell を使用して再度実行しました。Pro Max Tower T2 は両方のカードを順番に実行したため、タワー内の GPU 列はカードのみが異なり、GPU 内のタワー列はプラットフォームのみが異なります。Core T2 のドライブは出荷時に搭載されていた 2TB Gen5 M.2 1 台で、Xeon T2 のドライブは 2 台のドライブで構成される E3.S ストライプであるため、ストレージとモデル読み込みの行は、構成どおりに比較されます。
| CPU | メモリ | GPU | ブートドライブ | OSと電源モード | |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260)、Max-Q | Intel Xeon 658X、24コア/48スレッド、250W | 128GB DDR5-6400 RDIMM ECC (32GB x 4) | NVIDIA RTX PRO 6000 Blackwell Max-Q ワークステーションエディション、300W、96GB | 2 x 2TB E3.S Gen5 NVMe、VROC RAID0(4,097GBブートボリューム) | Windows 11 Pro for Workstations 25H2、最高のパフォーマンス |
| Dell Pro Precision 9 T2 (PW9T2260)、600W | Intel Xeon 658X、24コア/48スレッド、250W | 128GB DDR5-6400 RDIMM ECC (32GB x 4) | NVIDIA RTX PRO 6000 Blackwellワークステーションエディション、600W、96GB | 2 x 2TB E3.S Gen5 NVMe、VROC RAID0(4,097GBブートボリューム) | Windows 11 Pro for Workstations 25H2、最高のパフォーマンス |
| Dell Pro Max Tower T2 (FCT2250)、Max-Q | Intel Core Ultra 9 285K、24コア/24スレッド、125W | 128GB DDR5-4400 ECC (32GB x 4) | NVIDIA RTX PRO 6000 Blackwell Max-Q ワークステーションエディション、300W、96GB | SK hynix PCB01 2TB、Gen5 x4 | Windows 11 Pro 26H2、最高のパフォーマンス |
| Dell Pro Max Tower T2 (FCT2250)、600W | Intel Core Ultra 9 285K、24コア/24スレッド、125W | 128GB DDR5-4400 ECC (32GB x 4) | NVIDIA RTX PRO 6000 Blackwellワークステーションエディション、600W、96GB | SK hynix PCB01 2TB、Gen5 x4 | Windows 11 Pro 26H2、最高のパフォーマンス |
ここではいくつかのテストが初公開されます。まず、LLMサービングでは、4つのモデルでllama-serverを実行し、同時実行数を1リクエストからGPUメモリに収まる最大数までスイープして、合計およびユーザーごとのスループット、最初のトークンまでの時間、および出力トークンごとの時間を報告します。画像生成テストでは、FLUX.2 klein 4B、Z-Image Turbo 6B、およびQwen-Image 20Bを使用して1024×1024の画像をQ4_0、Q8_0、およびBF16の重みでレンダリングし、量子化された出力をPSNRとSSIMを使用してBF16と比較してスコアリングするため、速度と忠実度が両立します。コーディングエージェントテストはCrushで実行され、エージェントサイドユーザーテストでは、ブラウザベンチマークを3回のフルパスに保持する改訂された方法を使用します。
表には、N/A から始まる 3 つのラベルが繰り返し登場します。N/A は、テストがハードウェアに適用されないことを意味します。具体的には、SMT がない 285K の SMT シングルコア、および 24 コアが 1 つのクラスである Xeon の OpenBLAS トップコアクラスの行です。Partial は、スイートがメモ付きで受け入れた結果を示し、多くの場合、3 回の実行のうち 1 つがテストに失敗したコーディング エージェント ティアです。どちらのデスクトップも、スイートのセンサー パスに CPU または GPU の温度を公開していないため、このレビューでは、サーマル テーブルの代わりにテストごとの平均 CPU クロックを報告します。
ローカルAIパフォーマンス
どの構成にも96GBのGDDR7が搭載されているため、モデル容量は当然確保されており、ローカルAIスイートのすべてのティアは4つすべてで動作します。したがって、結果はGPUの電力制限によって分かれます。テストがメモリ帯域幅によって制限される場合、Max-Qカードと600Wカードはほぼ同等の性能を発揮し、演算能力によって制限される場合は、600Wカードが優位に立ちます。CPUプラットフォームはほとんど影響しませんが、影響する場合、その方向性は注目に値します。
MLPerfクライアントv2.0
MLPerf Clientは、Llama 3.1 8BとPhi-4-miniを5つのプロンプトカテゴリで実行し、最初のトークンまでの時間と、その後のトークンレートをカテゴリ全体の幾何平均として報告します。すべての構成において、エンジンとしてCUDA上のllama.cppが使用されます。エージェントシナリオでは、Llama 3.1 8Bをデータアナリストエージェントおよびソフトウェアエンジニアリングエージェントとして実行し、複数ターンにわたってツールを呼び出します。

| MLPerfクライアントv2.0 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| Llama 3.1 8B、最初のトークン取得までの時間、幾何平均(秒、値が小さいほど良い) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B、トークンレート、幾何平均(トークン/秒) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini、最初のトークンまでの時間、幾何平均(s、値が小さいほど良い) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini、トークンレート、幾何平均(トークン/秒) | 345.9 | 379.0 | 351.0 | 374.3 |
| データアナリストエージェント、エンドツーエンド(s、数値が低いほど良い) | 17.5 | 15.7 | 16.2 | 14.4 |
| データアナリストエージェント、トークンレート(tok/秒) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWEエージェント、エンドツーエンド(s、数値が小さいほど良い) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWEエージェント、トークンレート(tok/秒) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q カードは、Xeon タワーで Llama 3.1 8B を毎秒 230.9 トークン、Core タワーで毎秒 230.0 トークンで生成し、同じ GPU が同じ作業を行っている場合、Phi-4-mini は毎秒 345.9 トークンと毎秒 351.0 トークンで生成しました。600W カードは、Xeon タワーで毎秒 252.8 トークンと毎秒 379.0 トークンに向上し、約 9% の増加となり、Llama の最初のトークンまでの時間を 0.082 秒から 0.059 秒に短縮し、28% 短縮しました。プロンプト処理は計算量に依存し、デコードは帯域幅に依存し、2 つのカードは同じメモリを共有しているため、電力制限は最初のトークンでそれ以降のトークンよりもはるかに顕著に現れます。
エージェントのシナリオでは、CPUプラットフォームの性能が顕著に現れます。データアナリストエージェントは、Max-Qカードを搭載したCore T2では16.2秒、Xeon T2では17.5秒で完了しました。SWEエージェントは14.6秒で完了しましたが、Xeonではツール呼び出しフェーズにそれぞれ約1.5秒余計にかかっています。トークンレートは1%以内で一致しているため、違いはモデル呼び出しの間にCPU上で実行されるツールにあり、285Kの高速コアの方が早く処理を完了します。
モデルのロード
このテストでは、Ollama のローカル モデルがドライブから最初のトークンが生成されるまで、コールド (ファイル キャッシュがフラッシュされた状態) とウォーム (ファイルが既にメモリにある状態) の時間を計測し、コールド ロード中にドライブが読み取られた速度、重みが GPU メモリに到着したタイミング、およびロード中の読み取り速度をドライブの 1MB シーケンシャル上限と比較したロード効率値を報告します。96GB の VRAM を使用すると、3 つのティアすべてが実行されます。gpt-oss:20b は 12.8GB、Qwen3.6-35B-A3B は 21.1GB、gpt-oss:120b は 60.9GB です。

| モデルの読み込み(メモリマッピング有効) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| gpt-oss:20b、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b、最初のトークンをウォームロードします(s、数値が小さいほど良い) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b、GPUメモリへの到着、コールド(秒、数値が低いほど良い) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B、最初のトークンへのウォームロード(s、数値が小さいほど良い) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b、最初のトークンへのコールドロード(s、数値が小さいほど良い) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b、最初のトークンをウォームロードします(s、数値が小さいほど良い) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b、コールドロード時の読み取りスループット(MB/秒) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b、GPUメモリへの到着、コールド(秒、数値が低いほど良い) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b を gpt-oss:20b から切り替えた後にロードします (s、数値が小さいほど良い) | 14.30 | 13.97 | 11.89 | 11.93 |
| ドライブの上限、ディスク速度 1MB シーケンシャル読み取り (MB/秒) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2 はすべてのモデルをより速くロードしますが、その理由はドライブにあります。gpt-oss:120b は、Core T2 では 28.54 秒で最初のトークンに到達しましたが、Xeon T2 では 32.06 秒でした。61GB の重みが GPU メモリに到着するまでの時間は、7.74 秒で、11.33 秒でした。単一の PCB01 は、11,633MB/s の DiskSpd 上限値にちょうど達する速度でロードを供給しましたが、E3.S ストライプは、11,306MB/s の上限値に対して 9,875MB/s でロードを供給しました。RAID ボリュームは、大きなブロックを単一ドライブとほぼ同じ速度で読み取りますが、Ollama のメモリマップド ロード パスではその速度を維持できません。
ウォームロードでは、ファイルが既にシステムメモリに格納されているため、VRAMへの転送とllama.cppのセットアップのみが残りとなり、その差は1~2秒に縮まります。gpt-oss:120bではXeon T2で27.18秒、gpt-oss:20bでは7.52秒、6.60秒となります。予想通り、GPUの電力制限はロード時間に一貫した影響を与えません。
コーディングエージェント
端末コーディングエージェントである Crush は、Ollama が提供するローカルモデルを、固定リポジトリ内の固定コーディングタスクに通し、リポジトリの 11 個のテストに合格するまで最大 3 ラウンド実行します。ここでは、3 回の実行の中央値ウォールタイム、成功した回数、および生成レートを報告します。ウォールタイムは、モデルが使用するツール呼び出しとトークンの数に依存し、実行ごとに異なるため、生成レートの方がハードウェアの比較に適しています。エージェントとユーザーのテストでは、エージェントと Speedometer を同時に実行し、それぞれが相手の処理をどれだけ遅くするかを報告します。

| クラッシュコーディングエージェント | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| ティアS、gpt-oss:20b、64Kコンテキスト | ||||
| 壁面時間、中央値(秒、数値が低いほど良い) | 55.1 | 99.8 | 57.2 | 43.2 |
| 成功例(全3件) | 3 | 2 | 3 | 2 |
| 生成速度(tok/秒) | 214.1 | 237.9 | 218.0 | 237.7 |
| ティアM、Qwen3.6-35B-A3B、64Kコンテキスト | ||||
| 壁面時間、中央値(秒、数値が低いほど良い) | 35.2 | 27.0 | 86.7 | 32.1 |
| 成功例(全3件) | 3 | 3 | 3 | 3 |
| 生成速度(tok/秒) | 234.5 | 242.9 | 223.3 | 245.8 |
| ティアL、Qwen3.6-35B-A3B、128Kコンテキスト | ||||
| 壁面時間、中央値(秒、数値が低いほど良い) | 38.1 | 30.6 | 74.1 | 58.8 |
| 成功例(全3件) | 3 | 3 | 3 | 3 |
| 生成速度(tok/秒) | 222.9 | 237.0 | 231.1 | 252.8 |
| ティアW、gpt-oss:120b、128Kコンテキスト | ||||
| 壁面時間、中央値(秒、数値が低いほど良い) | 49.1 | 37.9 | 56.6 | 30.8 |
| 成功例(全3件) | 3 | 3 | 3 | 3 |
| 生成速度(tok/秒) | 160.9 | 177.1 | 158.5 | 174.4 |
| ユーザーの横にあるエージェント(gpt-oss:20bとスピードメーターが一緒に表示される) | ||||
| エージェント(スコア)の横にあるスピードメーター | 36.6 | 36.7 | 43.2 | 45.2 |
| スピードメーターの減速度(x、数値が低いほど良い) | 1.005 | 1.011 | 1.053 | 1.044 |
| スピードメーター横のエージェント生成率(tok/秒) | 218.2 | 231.6 | 212.4 | 229.2 |
| エージェントの速度低下(x、数値が低いほど良い) | 1.006 | 1.009 | 1.023 | 0.998 |
すべての構成で、スイートの中で最大のモデルである gpt-oss:120b を使用して、ティア W タスクの 3 回の実行すべてが完了し、Xeon タワーでは毎秒 160.9 ~ 177.1 トークン、Core タワーでは毎秒 158.5 ~ 174.4 トークンを生成しました。どちらの構成でも 600W カードは約 10% の貢献をしています。Qwen3.6 タスクもすべての環境で 3 回すべてに合格し、毎秒 223 ~ 253 トークンでした。gpt-oss:20b はつまずいたモデルです。ティア S タスクは 4 つの構成のうち 2 つで 3 回の実行のうち 1 回に失敗し、128K コンテキストのティア M タスク (図示せず) はすべての環境で少なくとも 1 回の実行に失敗しました。これはハードウェアによって変更されないモデルの動作です。
専用 GPU と 24 コアの余裕があるタワーでは、エージェントとブラウザ ベンチマークを同時に実行してもほとんどコストがかかりません。エージェントが実行されている状態では、Speedometer は Xeon T2 で 1.005 倍、Core T2 で 1.053 倍遅くなり、エージェントの生成レートはどのケースでも 2 パーセント以下しか変化しませんでした。エージェントの横にある Xeon T2 の Speedometer スコア 36.6 は、Core T2 の 43.2 よりも低いですが、これは単独で低いのと同じ理由です。つまり、285K のコアあたりの速度です。
検索拡張生成
RAGテストでは、20,963個のSQuAD v1.1パッセージをnomic-embed-textで埋め込み、2,000問それぞれについて上位5つのパッセージを取得し、そのうち400問にPhi-4-miniで回答します。回答は、参照回答との完全一致率とF1スコアで評価されます。モデルは小規模であるため、このテストではGPUフェーズ間のCPU側ベクトル検索を含むパイプライン全体を測定します。

| RAG | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| 摂取壁時間:20,963回(秒、数値が低いほど良い) | 128.5 | 125.5 | 108.1 | 103.0 |
| 埋め込み率(tok/秒) | 29,875 | 30,592 | 35,165 | 37,508 |
| 検索クエリ時間、p50(ミリ秒、数値が低いほど良い) | 30.6 | 27.2 | 23.4 | 18.7 |
| 回答、最初のトークンまでのPhi-4-mini時間、p50(秒、数値が小さいほど良い) | 0.099 | 0.087 | 0.089 | 0.083 |
| 回答、即時処理(tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| 回答、生成速度(tok/秒) | 296.4 | 337.8 | 324.3 | 344.1 |
| 質問への回答、p50(数値が低いほど良い) | 0.152 | 0.133 | 0.130 | 0.120 |
| 5%リコール率(%) | 82.7 | 82.7 | 82.7 | 82.7 |
| 回答 F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Core T2 はこのパイプラインをより高速に処理します。同じ Max-Q カードを搭載した Xeon T2 の 128.5 秒に対し、Core T2 は 108.1 秒でコーパスを取り込み、中央値で 30.6 ms に対し 23.4 ms でデータを取得し、0.152 秒に対し 0.130 秒で質問に答えます。埋め込みと取得の両方に CPU ボトルネックとなるステージがあり、それらは 285K に有利です。600W カードは、両方のプラットフォームでプロンプト処理を 25 ~ 30 パーセント向上させ、Xeon T2 では毎秒 20,318 トークンから 26,549 トークンになりました。また、温度 0 で同じモデルを使用した場合と同様に、4 つの構成すべてで精度は同じでした。
LLM サービング
サービングテストでは、Ministral 3 3B および 8B (4,096 トークンのプロンプト、1,024 トークンの出力)、Qwen3.8 27B、および gpt-oss 120B (8,192 トークンのプロンプト) を使用して llama-server を実行し、重み付け後に GPU メモリに収まる限りのスロットを割り当て、同時実行を 1 つのリクエストからその制限までスイープします。合計スループット (プロンプトと出力トークンを合わせたもの)、出力スループット、最初のトークンまでの時間、および出力トークンあたりの時間を中央値で報告します。96GB カードでは、gpt-oss 120B は 22.5GiB の KV キャッシュで 64 スロットに適合し、Qwen3.8 27B は 8 スロットに適合し、2 つの Ministral モデルはそれぞれのコンテキストで 4 スロットに適合します。

| llamaサーバー、gpt-oss 120B、8,192トークンのプロンプト、1,024トークンの出力 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| 1同時実行:出力スループット(tok/秒) | 160.6 | 182.7 | 158.4 | 179.0 |
| 同時接続数1:最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 1,241 | 918 | 1,238 | 923 |
| 同時接続数1:出力トークンあたりの処理時間、中央値(ミリ秒、数値が低いほど良い) | 5.03 | 4.58 | 5.11 | 4.70 |
| 同時接続数:8 総スループット(tok/秒) | 2,088 | 2,460 | 2,154 | 2,534 |
| 同時接続数:8 ユーザーあたりの出力(tok/秒) | 29.0 | 34.2 | 29.9 | 35.2 |
| 同時接続数8:最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 2,847 | 2,152 | 2,856 | 2,121 |
| 同時接続数:64 総スループット(tok/秒) | 3,296 | 3,805 | 3,531 | 4,220 |
| 同時接続数:64 ユーザーあたりの出力(tok/秒) | 5.7 | 6.6 | 6.1 | 7.3 |
| 同時接続数64:最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 4,315 | 3,491 | 4,607 | 3,622 |
| 同時接続数64:出力トークンあたりの処理時間、中央値(ミリ秒、数値が低いほど良い) | 163.0 | 141.3 | 152.7 | 126.3 |
シングルユーザーは、Max-Q カードで 1 秒あたり 160.6 トークン、600W カードで 182.7 トークンの gpt-oss 120B を取得し、最初のトークンは 8,192 トークンのプロンプトから 1,241 ms と 918 ms 後に届きます。カードに 64 の同時リクエストをロードすると、合計スループットは Max-Q カードで 1 秒あたり 3,296 トークン、600W カードで 3,805 トークンに上昇し、ユーザー 1 秒あたり 5.7 トークンと 6.6 トークン、最初のトークンは 4.3 秒と 3.5 秒のコストがかかります。曲線は 4 ~ 32 の同時リクエストの間で平坦になり、64 で再び急上昇し、バッチ処理によって長いプロンプトが最終的に償却されます。

| llama-server、適合する最大同時接続数での出力スループット(tok/秒) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| 大臣 3 3B 推論、4 同時並行 | 562.5 | 600.4 | 576.8 | 625.3 |
| 大臣 3 8B 推論、4 同時並行 | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B、同時実行8 | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B、同時接続64 | 366.3 | 422.8 | 392.3 | 468.9 |
| 単一リクエストの出力スループット(tok/秒) | ||||
| 大臣3 3B 推理 | 232.1 | 241.8 | 232.1 | 246.0 |
| 大臣3 8B 推理 | 165.0 | 183.3 | 164.1 | 180.4 |
| クウェン3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
高密度の Qwen3.8 27B は、Max-Q 上で毎秒 54.0 トークンというシングル ユーザー向けの最も遅いモデルです。これは、すべてのトークンが 270 億のパラメータすべてにアクセスするためです。一方、エキスパートの混合 gpt-oss 120B は、ディスク上では 4 倍のサイズであるにもかかわらず、3.0 倍高速に動作します。600W カードの優位性は、高密度モデルで最大で、同時リクエスト 8 件で 24 パーセント、Ministral 3B で最小で、約 7 パーセントです。2 つのタワーは、64 リクエストの gpt-oss の場合を除いて、ほぼ 3 パーセント以内の差です。64 リクエストの gpt-oss の場合、どちらのカードでも Core T2 が 7 ~ 11 パーセントリードしているため、このバッチ サイズでのサーバーの CPU 側の作業は、より高速なコアに有利です。
画像生成
画像生成テストでは、3つの拡散モデルと3つの重み精度を用いて1024×1024ピクセルの画像をレンダリングし、画像ごとの処理時間、ノイズ除去率、および重みが占めるGPUメモリ量を報告します。また、同じシードをBF16でレンダリングし、Q4_0とQ8_0の出力をPSNRとSSIMで比較評価することで、量子化が画像に及ぼすコストを数値化します。

| 画像生成、1024×1024 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| FLUX.2 クライン 4B、4ステップ | ||||
| Q8_0:画像1枚あたりの秒数(数値が小さいほど良い) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: 1分あたりの画像数 | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16:画像1枚あたりの秒数(数値が小さいほど良い) | 1.60 | 1.34 | 1.55 | 1.27 |
| Zイメージターボ6B、8ステップ | ||||
| Q8_0:画像1枚あたりの秒数(数値が小さいほど良い) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: 1分あたりの画像数 | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16:画像1枚あたりの秒数(数値が小さいほど良い) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B、20ステップ | ||||
| Q4_0:画像1枚あたりの秒数(数値が小さいほど良い) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0:画像1枚あたりの秒数(数値が小さいほど良い) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16:画像1枚あたりの秒数(数値が小さいほど良い) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: 1分あたりの画像数 | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16:重み付け用GPUメモリ(GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
拡散処理は計算能力に依存しており、600W カードではそれが顕著に表れています。Qwen-Image 20B at Q8_0 では Max-Q で 1 画像あたり 26.1 秒、Xeon タワーの 600W カードでは 19.7 秒かかり、1 分あたりの画像数が 33 % 向上しました。Z-Image Turbo では 32 %、FLUX.2 klein では 21 % 向上しています。CPU プラットフォームはここでは関係なく、サーバー起動時を除いて、2 つのタワーはすべての行で 1 % 以内の差に収まっています。サーバー起動時には、Xeon T2 の RAID ボリュームが重みをロードするのに数秒余計にかかります。
| BF16に対する量子化忠実度(同一シード) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| PSNR(dB、数値が高いほど良い)/SSIM(数値が高いほど良い) | ||||
| FLUX.2 クライン 4B、Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 クライン 4B、Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Zイメージターボ6B、Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Zイメージターボ6B、Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B、Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B、Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
出力はハードウェアではなく重みに依存するため、忠実度行は 4 つの構成すべてで同一です。Q8_0 は、SSIM が 0.938 ~ 0.987、PSNR が 28 ~ 36 dB で BF16 画像を再現しますが、Q4_0 は SSIM が 0.75 ~ 0.79、PSNR が 18 ~ 22 dB に低下し、画像が異なります。96GB カードでは、これらのモデルを Q8_0 未満で実行するメモリ上の理由はありません。Qwen-Image の BF16 重みは 45.3GiB に収まり、Q8_0 パスは逆量子化に時間を費やすため、3 つのモデルすべてで BF16 のレンダリング速度は Q8_0 と同等か、わずかに高速です。
CPUパフォーマンス
2つのプロセッサは、当社のCPUスイートを明確な線で分割しています。テストですべてのコアを使用する場合、Xeon 658Xはほとんどの場合27~150パーセントの差で勝利し、ベクトルが広く、メモリトラフィックが多いほど、その差は大きくなります。テストが1つまたは少数のスレッドで実行される場合、Core Ultra 9 285Kは、5.7GHzのPコアの強みにより、キャッシュとメモリレイテンシが高い4.9GHzのXeonコアに対して13~31パーセントの差で勝利します。600W GPUがXeonの全コア結果に与える影響は、各表で説明され、クロックのセクションでまとめられています。
Cinebench 2026と持続負荷
Cinebench 2026は、CPU上でMaxonのRedshiftエンジンを使用してシーンをレンダリングし、シングルコア、SMTシングルコア(1つの物理コアで2つのスレッドを実行)、およびマルチコアのスループットを測定します。その後、マルチコア実行を約30分間繰り返す持続ループを実行し、定常状態を最初の実行結果と比較します。

| Cinebench 2026(ポイント、数値が高いほど性能が良い) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| シングルコア | 454.1 | 455.6 | 564.4 | 564.5 |
| SMTシングルコア | 599.1 | 601.0 | 該当なし(SMTなし) | 該当なし(SMTなし) |
| マルチコア | 12,322 | 11,705 | 8,856 | 8,838 |
| 持続ループ、1回目の通過 | 12,201 | 11,731 | 8,717 | 8,788 |
| 持続ループ、定常状態 | 12,328 | 11,764 | 8,825 | 8,844 |
| 定常状態/初回通過 | 1.010 | 1.003 | 1.012 | 1.006 |
| 持続ループ、定常状態のCPUクロック(MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
658X は Max-Q カードをインストールした状態でマルチコア スコア 12,322 を記録し、285K の 8,856 を 39% 上回り、30 分間のループを通して 12,328 を維持し、最初のパスより 1% 高い安定した状態となりました。シングル コアでは順位が逆転し、285K は 564.4 を記録し、Xeon は 454.1 を記録しました。また、285K のシングル スレッドの数値を上回るには、Xeon の 1 つのコアで 2 つのスレッドを実行する必要があり、そのスコアは 599.1 でした。
600W のカードに交換すると、Xeon のマルチコア スコアは 11,705、定常状態は 11,764 となり、5% 低下し、定常状態のクロックは 4,274 MHz から 4,178 MHz に低下しました。Core T2 では、8,856 と 8,838 のままで、このような変化は見られませんでした。このテストスイートでは、どちらのタワーでも CPU または GPU の温度は測定されなかったため、250W プロセッサが 600W カードの熱によって性能が低下しているのか、電力バジェットの共有によって性能が低下しているのかは判断できませんが、シャーシに大型カードが搭載されている場合、すべての全コア テストで 4 ~ 5% 低下することがわかっています。
7-Zip
7-Zipに内蔵されているベンチマーク機能は、LZMA圧縮および解凍のスループットをギガ命令/秒単位で報告します。この数値は、各スレッドで1回、単一コアに固定して1回測定されます。LZMAは整数スループット、分岐予測、キャッシュおよびメモリのレイテンシに依存するため、ベクトル幅よりもコア数と高速なメモリパスが有利に働きます。

| 7-Zip(GIPS値、数値が高いほど良い) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| すべてのスレッド | ||||
| トータル | 289.6 | 288.9 | 174.8 | 175.7 |
| 圧縮する | 276.4 | 273.5 | 151.5 | 151.9 |
| 圧縮解除する | 303.0 | 304.4 | 198.1 | 199.4 |
| 1本の糸 | ||||
| トータル | 8.74 | 8.05 | 10.82 | 10.83 |
| 圧縮する | 8.66 | 7.80 | 9.31 | 9.31 |
| 圧縮解除する | 8.83 | 8.30 | 12.33 | 12.34 |
48スレッドでは、Xeonは289.6 GIPSを記録し、24スレッドの285Kの174.8 GIPSを66%上回りました。圧縮では82%、解凍では53%の差がありました。1スレッドでは、285Kが10.82 GIPSで8.74 GIPSを上回り、Xeonタワーに600Wカードを搭載した場合は、その構成で動作したクロック周波数が低いため、差は8.05 GIPSに広がりました。
Blender、HandBrake、およびLLVM
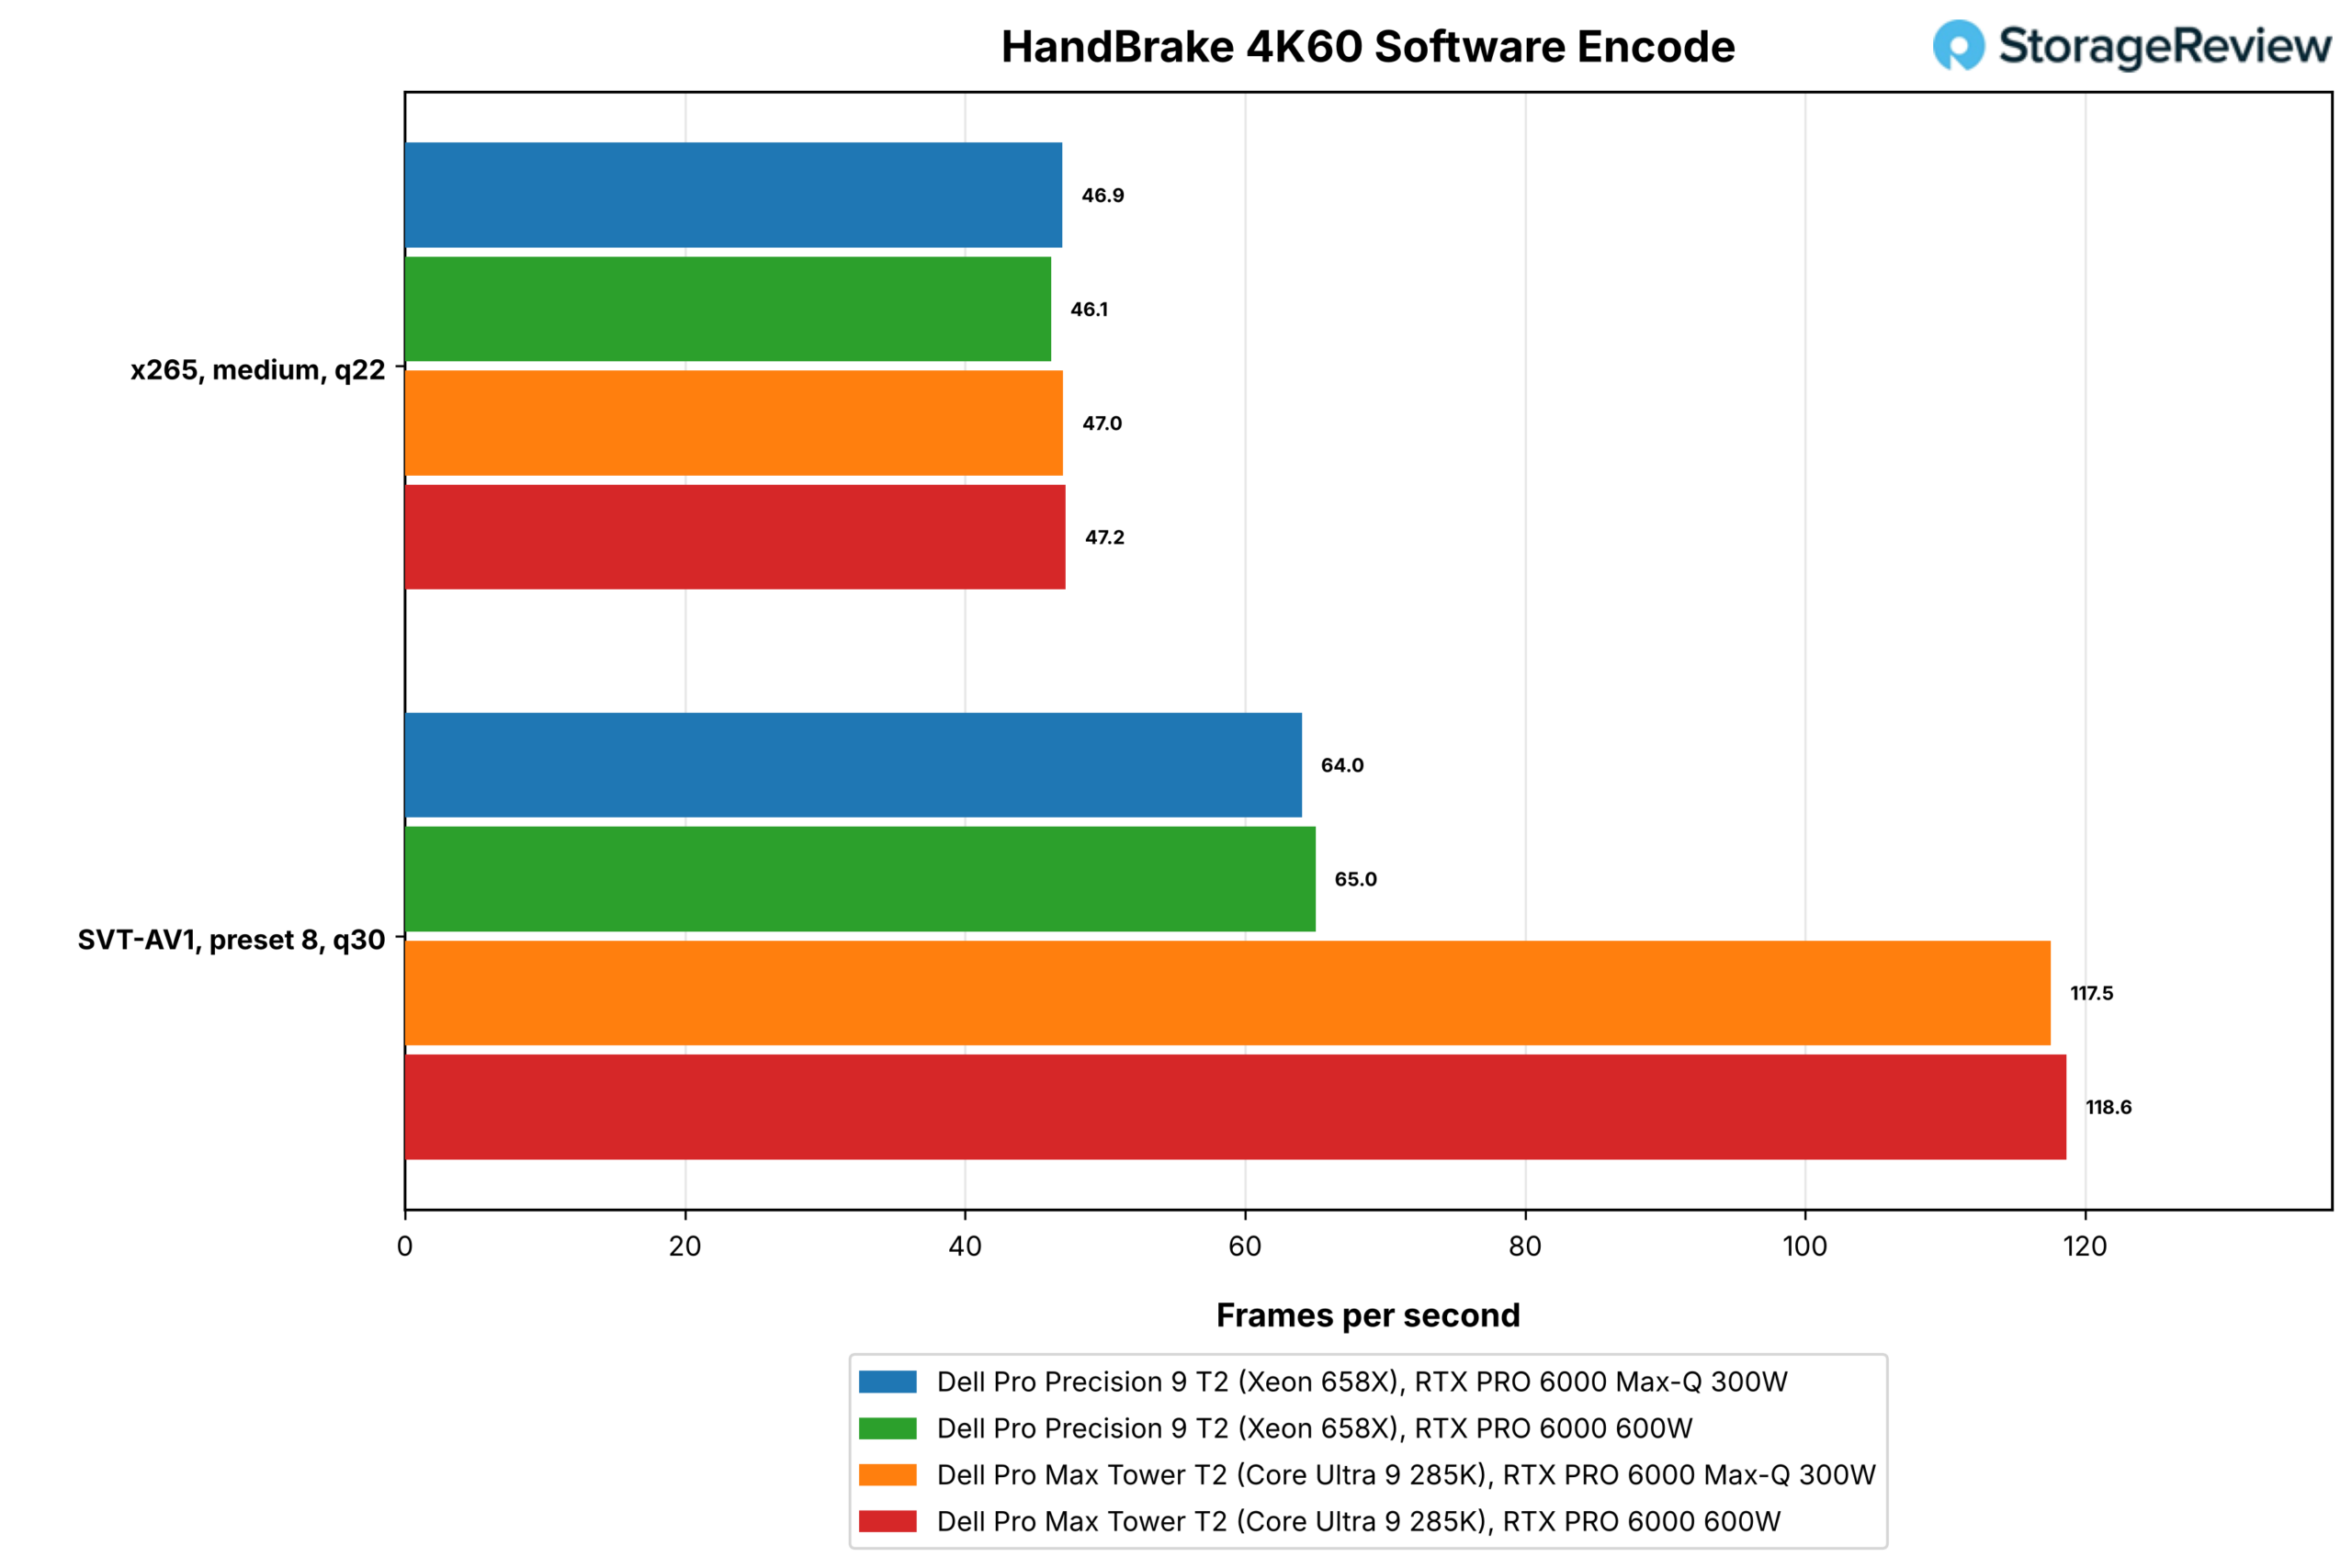
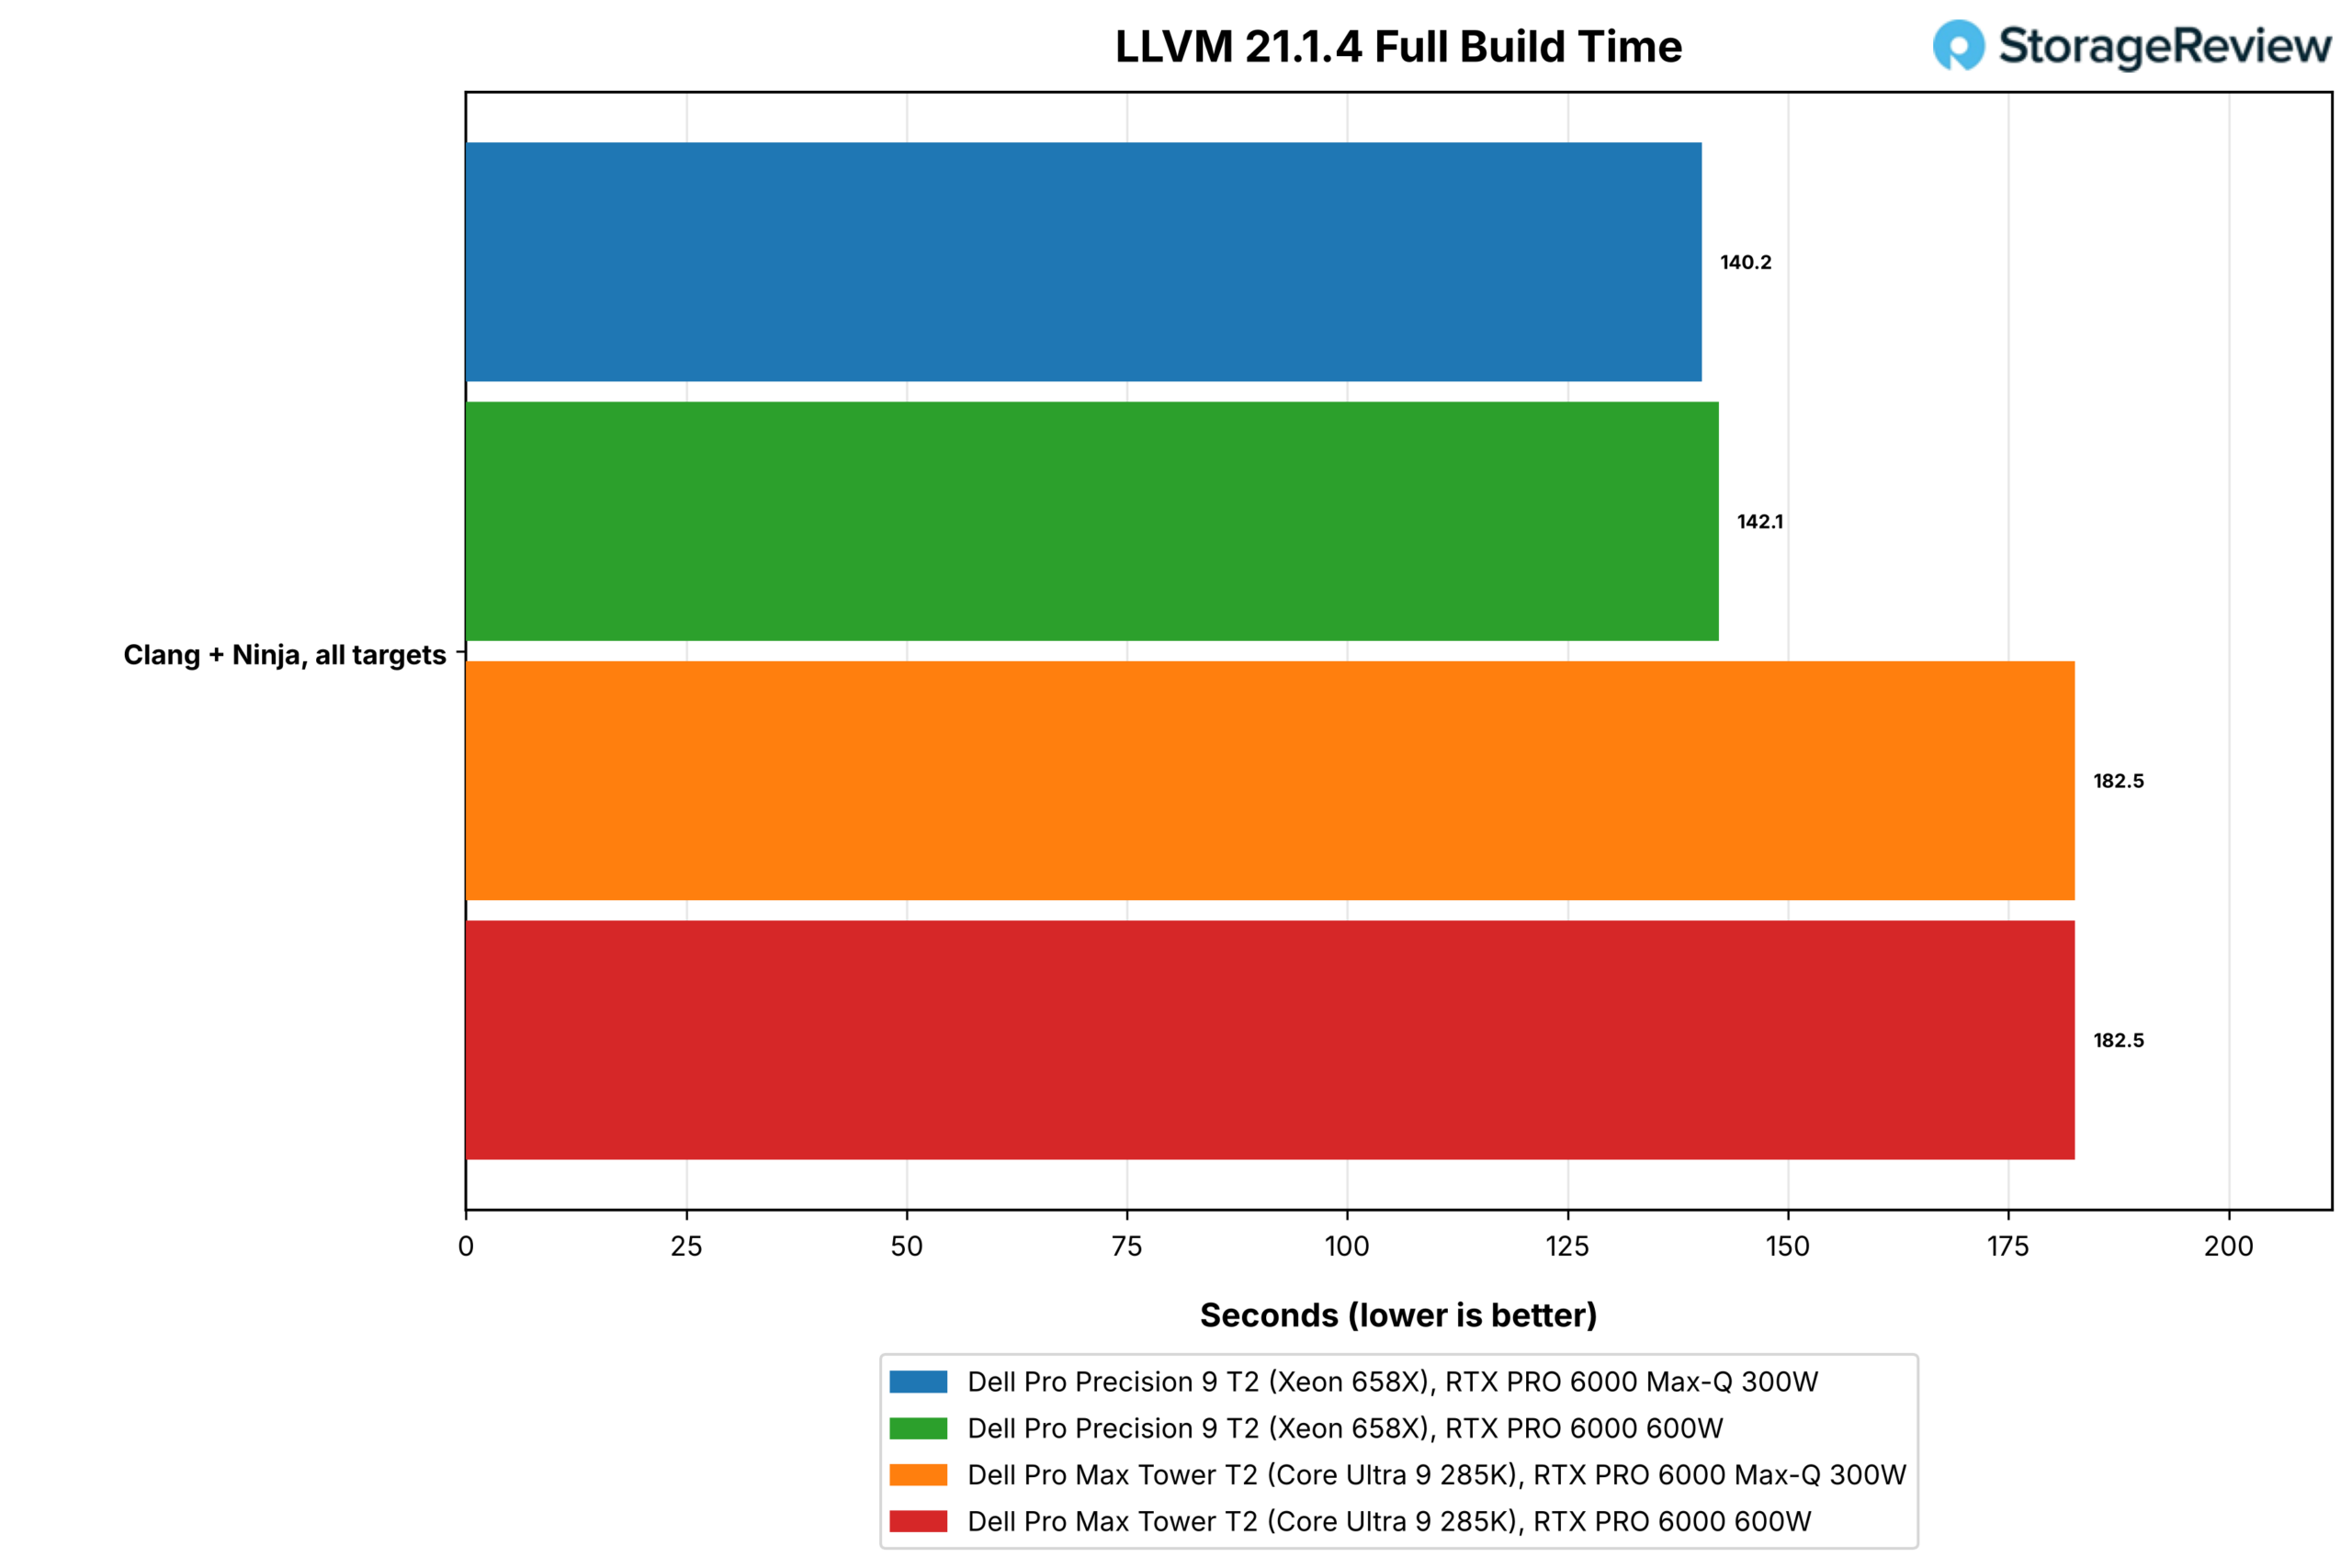
Blender 4.5 は、CPU 上で Cycles を使用して Monster、Junkshop、および Classroom シーンをレンダリングします。HandBrake は、4K60 クリップの 60 秒をソフトウェアで x265 (HEVC、中程度のプリセット、品質 22) と SVT-AV1 (プリセット 8、品質 30) を使用してエンコードします。LLVM テストは、スイート内で最長の全コアワークロードである Clang と Ninja を使用して、LLVM 21.1.4 ツリー全体をコンパイルします。

| ホイール試乗 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| Blender 4.5 モンスター(サンプル数/分、数値が高いほど良い) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (サンプル/分) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Classroom(サンプル/分) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265、中設定、q22(フレームレート、数値が高いほど良い) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1、プリセット8、q30(fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 ビルド (s、数値が低いほど良い) | 140.2 | 142.1 | 182.5 | 182.5 |
XeonはMonsterを毎分366.2サンプルでレンダリングし、285Kの259.6サンプルを上回り、41%の差をつけました。この差は3つのシーンすべてで2ポイント以内の差に収まっています。また、LLVMのビルド時間は140.2秒で、23%短縮されました。600Wカードを搭載した場合、XeonのBlenderスコアは7~10%低下し、CPUスイートの中でカードによるコストが最も高くなりました。
HandBrakeはエンコーダーごとに結果が分かれました。x265のミディアムプリセットでは、Xeonで46.9fps、285Kで47.0fpsと同率でしたが、SVT-AV1のプリセット8では、Xeonで64.0fps、285Kで117.5fpsでした。
私たちはそのギャップに午後を費やしましたが、これはスレッドごとの結果です。エンコーダーはこのプリセットで並列度レベル6が上限で、Xeon上で約9つの論理プロセッサ分の作業を常に実行しています。AVX-512の代わりにAVX2カーネルを強制的に使用しても何も変わりませんでした(63.8fps対63.9fps)。また、物理コアごとに1つのスレッドに固定すると2%遅くなりました(62.6fps)。したがって、ベクターパスもSMTスケジューリングも原因ではありません。残るのはXeonコア自体とコア間のメッシュであり、パイプラインエンコーダーはステージ間のハンドオフを待つため、毎フレームその影響を受けます。
Stockfish、Primesieve、Python、そしてブラウザ
Stockfishの組み込みベンチマークは、チェスの検索速度を1秒あたりのノード数(百万単位)で報告します。primesieveは、すべてのスレッドで10^12以下の素数を、1つのスレッドで10^11以下の素数をカウントします。PyPerformanceは、1つの高速コアに固定して3つのCPythonベンチマーク(go、nbody、regex_compile)を実行し、Speedometer 3.1はMicrosoft EdgeでのWebアプリケーションの応答性を測定します。
| ホイール試乗 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| Stockfishベンチ、全スレッド(Mnps、数値が高いほど良い) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfishベンチ、スレッド1つ(Mnps、数値が高いほど良い) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12、全スレッド(s、数値が小さいほど良い) | 7.69 | 7.51 | 6.77 | 6.84 |
| プライムシーブ 1e11、スレッド1つ(s、数値が低いほど良い) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ミリ秒、数値が小さいほど良い) | 88.6 | 90.5 | 61.1 | 61.2 |
| スピードメーター 3.1、エッジ(スコア、数値が高いほど良い) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish は 48 スレッドで Xeon 上で 40.87 Mnps を達成し、285K 上では 30.10 Mnps でした。また、1 スレッドでは 285K が 1.99 対 1.65 でリードしました。primesieve は、285K が 7.69 秒に対して 6.77 秒で勝利した唯一の全スレッド テストです。これは、そのシーブがキャッシュに収まり、コア数と同様にクロック数にも比例してスケーリングするためです。シングル スレッドの行はすべて 285K が 13 ~ 31 パーセント速くなっています。PyPerformance は 91.4 ms に対して 64.8 ms、regex_compile は 88.6 ms に対して 61.1 ms、Speedometer は 36.8 ms に対して 46.3 ms です。
そのブラウザの数値は、購入者が実際にデスクで体感する数値です。Speedometerのスコア36.8は絶対値としては依然として高速ですが、同じ筐体のCoreタワー型モデルより5分の1劣っており、スループットを重視してXeonを選択するユーザーは、マシンのインタラクティブな動作速度がCore Ultraデスクトップよりも若干遅いことを覚悟しておく必要があります。
GROMACS、OpenBLAS、およびメモリ
GROMACSは、4つのランクとスレッド構成で16コアを使用してbenchMEM分子動力学ケースを実行し、最適な構成での1日あたりのシミュレーション時間をナノ秒単位で報告します。OpenBLASテストでは、3つの問題サイズでHPLスタイルの倍精度LUソルバーとDGEMM行列乗算をすべてのコアで実行し、285Kでは8つのPコアのみで再度実行します。Xeonの24コアは1つのクラスであるため、これらの行は適用されません。STREAMは持続的なメモリ帯域幅を測定し、レイテンシの行はメモリへの単一のアクセスとコア間のアクセスを測定します。

| テスト(数値が高いほど良い) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| GROMACS benchMEM、最適なレイアウト(ns/日) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000、すべてのコア (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000、すべてのコア (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000、すべてのコア (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000、Pコアのみ(GFLOPS) | 該当なし(必須科目1科目) | 該当なし(必須科目1科目) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000、全コア(GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000、Pコアのみ(GFLOPS) | 該当なし(必須科目1科目) | 該当なし(必須科目1科目) | 565.3 | 566.5 |
AVX-512、144MBのL3、4チャネルのDDR5-6400がここで相乗効果を発揮します。DGEMMはXeonで1,638 GFLOPS、285Kで768 GFLOPSを達成し、メモリを通して11.9GBをストリーミングするN=40000 LUソルブは、Coreタワーの2.5倍である668 GFLOPSに対し1,659 GFLOPSで実行されました。285Kの結果は、その時点で帯域幅がボトルネックになっているため、N=20000からN=40000までほとんど変化しませんが、Xeonはスケーリングを続けています。16コアのGROMACSは、47.39 ns/日でXeonが27パーセント有利でした。

| ホイール試乗 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| ストリームコピー(MB/秒、数値が高いほど良い) | 106,698 | 106,512 | 39,477 | 39,426 |
| ストリームスケール(MB/秒) | 105,368 | 105,180 | 39,788 | 39,801 |
| ストリーム追加 (MB/秒) | 119,520 | 119,332 | 36,324 | 36,306 |
| ストリームトライアド(MB/秒) | 122,233 | 122,135 | 33,003 | 33,014 |
| メモリレイテンシ、1GiBバッファ、4KiBページ(ナノ秒、数値が小さいほど良い) | 148.3 | 147.8 | 135.2 | 135.4 |
| コア間レイテンシ、全ペアの平均値(ns、数値が小さいほど良好) | 56.2 | 56.0 | 38.1 | 38.2 |
| コア間レイテンシ、最小ペア(ナノ秒) | 4.6 | 4.6 | 18.6 | 18.6 |
| コア間レイテンシ、最大ペア(ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triadは、Xeon T2では122,233MB/s、Core T2では33,003MB/sの速度で動作し、帯域幅は3.7倍でした。これは、DIMMの速度に追いつけないプラットフォームで、DDR5-6400 RDIMMの4チャネルとDDR5-4400 UDIMMの4チャネルを比較した場合の結果です。コストはレイテンシです。Xeonではメモリまで148.3 ns、285Kでは135.2 ns、コア間平均レイテンシは56.2 ns、285Kでは38.1 nsです。Xeonの最小レイテンシ4.6 nsは1つのコア上のSMT兄弟ペアで、最大レイテンシ65.7 nsはメッシュを横断するトリップです。
ゲーム業界
SuperTuxKart 1.5 は、内蔵ベンチマークを 1080p フルスクリーン、最高プリセット、垂直同期オフで実行し、平均フレームレートと安定フレームレートを報告します。この解像度では GPU に余裕があるため、結果は CPU に追従し、このテストは同様の制限を受ける多くのプロフェッショナル ビューポートの代わりとなります。エンコード テストの NVENC パスはこれらのシステムでは完了しなかったため、省略しています。

| SuperTuxKart 1.5、1080p Ultra、垂直同期オフ(フレームレート、高いほど良い) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| 平均 | 304.6 | 323.2 | 359.1 | 383.5 |
| 分解能 | 304 | 322 | 354 | 376 |
| 着実 | 161 | 174 | 122 | 135 |
Core T2はMax-Qカード使用時で平均359.1fpsを記録したのに対し、Xeon T2は304.6fpsで、ここでもシングルスレッド性能の差が顕著に表れた。一方、Xeonタワーは161fpsと、122fpsよりも安定したフレームレートを維持し、フレームレートの低下も少なかった。600Wカードは、どちらのタワーでも平均フレームレートを約6%向上させた。
負荷のかかったクロック
どちらのタワーもスイートのセンサー経路を通じてCPUまたはGPUの温度を報告しなかったため、通常公開している熱表は、各テスト中の平均CPUクロックに置き換えられています。この数値が、600WカードがXeonに与える影響を説明するものです。Max-Qを搭載した658Xは、30分間の持続ループで4,269MHz、より短い全コアテストで4,040~4,480MHzを維持しました。シャーシに600Wカードを搭載すると、これらのテストのほとんどは最大300MHz低く、すべてのテストでスコアが低くなりました。
| テスト中の平均CPUクロック周波数(MHz) | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| 持続ループ | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| 干し魚 | 4,291 | 3,995 | 4,749 | 4,741 |
| ブレンダー | 4,258 | 4,253 | 4,582 | 4,552 |
| ハンドブレーキ | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVMビルド | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| OpenBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| STREAM | 4,321 | 4,326 | 4,687 | 4,676 |
| プライムシーブ | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerfクライアント | 4,191 | 4,138 | 3,814 | 3,686 |
| コーディングエージェント | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM(法学修士)として勤務 | 4,261 | 4,169 | 4,229 | 4,209 |
| 画像生成 | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| スーパータックスカート | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfishは4,291MHzから3,995MHzに、primesieveは4,441MHzから4,268MHzに、7-Zipは4,414MHzから4,307MHzに、そして持続ループは4,269MHzから4,182MHzに低下しましたが、285Kはカードの種類に関係なく、すべての全コアテストで20MHz以内の差で動作しました。
平均クロックだけでは説明がつきません。CinebenchとBlenderはMax-Qの値から10MHz以内で平均しましたが、それでも5~10%低下しました。これは、テストごとの平均値が平滑化している短い変動を示しています。658Xは最大250W、600Wカードはさらに600Wを消費し、どちらも前面吸気口の後ろにある同じ32リットルの容積に排気します。制限要因がプロセッサの熱的余裕なのか、プラットフォームの電力制限なのかは、外部電源と温度のログ記録による次回のテストで明らかになるでしょう。今のところ、全コアCPU作業を実行する購入者は、Max-Q構成がCPU側でより高速であることを知っておく必要があります。
貯蔵性能
ストレージ テストでは、fio の four corners を 5GB と 25GB のフットプリントでブート ドライブに対して実行し、ファイルシステムを介して、また生のデバイスに対して再度実行し、ここでは 25GB の結果を報告します。Core T2 では、ブート ドライブは Gen5 x4 上の 1 台の 2TB SK hynix PCB01 です。Pro Precision 9 T2 では、FlexBay 内の 2 台の E3.S Gen5 ドライブが Graid Technology の VROC によって 4,097GB RAID0 ボリュームにストライピングされています。4 つの構成すべてで BitLocker は無効になっているため、ファイルシステム行は暗号化ではなく NTFS と RAID レイヤーを測定します。


| fio、25GBのフットプリント、QD32 | Pro Precision 9 T2、Max-Q 300W | プロプレシジョン9 T2、600W | Pro Max Tower T2、Max-Q 300W | Pro Max Tower T2、600W |
|---|---|---|---|---|
| シーケンシャル読み取り 128K、ファイルシステム (MB/秒) | 9,332 | 9,255 | 11,377 | 11,406 |
| シーケンシャル読み取り 128K、生デバイス (MB/秒) | 10,782 | 10,675 | 11,186 | 11,444 |
| シーケンシャル書き込み速度 128K (MB/秒) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MBのプリフィル読み取り、QD32(MB/秒) | 4,617 | 4,679 | 6,440 | 6,346 |
| ランダム読み取り 4K、ファイルシステム、ピーク (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| ランダム読み取り4K、デバイス生データ、ピーク値(IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| ランダム書き込み4K、ピーク値(IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| 生データ/ファイルシステムランダム読み取り | 1.32x | 1.31x | 1.29x | 1.31x |
| ランダム読み取り4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 506 | 485 | 183 | 185 |
| ランダム読み取り4K、16ジョブ、p99.99レイテンシ(米国、数値が低いほど良い) | 15,270 | 23,462 | 676 | 676 |
| ランダム書き込み4K、4ジョブ、p99レイテンシ(米国、数値が低いほど良い) | 610 | 594 | 228 | 228 |
| 駆動温度、最大(℃) | 該当なし(RAID構成) | 該当なし(RAID構成) | 50 | 57 |
ストライプはシングルドライブよりも高速ではなく、小さなブロックではかなり遅れています。 2 台の E3.S ドライブは、NTFS を介してシーケンシャルに 9,332MB/s、生ボリュームから 10,782MB/s を読み取りましたが、PCB01 では 11,377MB/s と 11,186MB/s でした。書き込みは 6,507MB/s で、7,401MB/s でした。 4K ランダム読み取りでは、ボリュームはファイルシステムを介して 840.1K IOPS、生ボリュームで 1.11M IOPS のピークに達しましたが、シングルドライブでは 1.78M と 2.30M でした。ランダム書き込みでは 557.5K IOPS で、957.5K IOPS でした。生ボリュームとファイルシステムの比率はどちらも約 1.3 倍なので、NTFS のコストはどちらも同じです。違いは、両方のパスの下にある VROC レイヤーです。
テールレイテンシは次のとおりです。16 ジョブの場合、ランダム読み取りの最も遅い 0.01 パーセントはボリュームで 15.3 ms かかり、単一ドライブでは 0.68 ms でした。また、4 ジョブの p99 読み取りレイテンシは 506 マイクロ秒で、単一ドライブでは 183 マイクロ秒でした。2 つの NVMe デバイスにまたがるソフトウェア RAID は、すべての I/O に CPU ホップを追加し、fio CPU の読み取り値にもそれが表れており、シーケンシャル パスでは 80 パーセント、Core T2 では 40 パーセントとなっています。ボリュームはドライブの SMART データも隠蔽するため、スイートではドライブの温度をログに記録できませんでした。
だからといってFlexBayが間違った選択というわけではありません。FlexBayは、T2に前面からアクセス可能でホットプラグ対応のドライブを提供し、M.2では実現できない容量まで拡張可能なフォームファクタを実現しています。また、2台のドライブで4TBのブートボリュームを作成できるのも便利です。ただし、ワークロードが小規模ブロックのランダムI/O、ローカルデータベース、またはキャッシュを多用するモデルディレクトリである場合は、ストライプなしのE3.Sドライブ1台、または内部M.2スロットを検討すべきでしょう。Core T2のテスト結果を見れば、このシャーシでGen5ドライブ1台がどのような性能を発揮するかが分かります。
結論
Dell Pro Precision 9 T2は、ワークステーションプロセッサを搭載したPro Max Tower T2であり、レビューデータによると、まさに購入者が期待すべき製品です。同じ32リットルの筐体に搭載されたXeon 658Xは、Cinebenchマルチコアスループットが39%向上し、メモリ帯域幅が3.7倍、DGEMMレートが2倍、AVX-512、AMX、レジスタードECCメモリ、最大1TBへのパスを備えた24コア48スレッドプロセッサです。primesieveからPythonまで、シングルスレッド処理で13~31%のパフォーマンス向上を実現しており、ビューポートやターミナルで1日を過ごすユーザーはその違いを実感できるでしょう。
このレビューは、購入者がGPUの選択を理解するのに役立つように作成されました。Max-Qと600WのRTX PRO 6000カードは96GBのメモリを共有し、デコード速度は7~20%しか違いません。600Wカードは、最初のトークンまでの時間が3分の1以上短縮される高速処理と、画像が20~34%速く表示される拡散処理によってその性能を発揮します。
Xeonタワー型PCの場合、600Wカードは全コア処理時にプロセッサの消費電力を4~5%増加させ、隣接するスロットを占有します。今回のテスト機では、25GbEアダプタを取り外す必要がありました。CPUレンダリングやシミュレーション、ローカルモデルの実行などを行うユーザーにとって、Dellが出荷しているMax-Qカードはバランスの取れた選択肢と言えるでしょう。一方、チームにモデルを提供したり、終日画像レンダリングを行うユーザーにとっては、600Wカードはスロットを占有し、1500W電源を供給する価値があります。
FlexBayに搭載されたE3.Sは、長年タワー型PCに求めてきたフォームファクターです。Graid TechnologyのVROCは、RAIDスタックに最適な組み合わせです。Core T2に搭載されている単一のM.2ドライブと比較すると、小規模なランダムI/Oでは速度が劣り、4K読み書きでは約半分の速度となります。RAID構成のブートボリュームを必要としないユーザーは、代わりにE3.Sドライブ1台、または内蔵M.2スロットの使用を検討してもよいでしょう。
一方、E3.S SSDの容量が60TBを超えるようになったことで、極めて大量のデータを使用するユーザーは、以前は外付けケースを使用したり、共有ストレージボリュームをマウントしたりすることを意味していた、まったく新しい世界にアクセスできるようになりました。フラッシュストレージの価格が、実用的な限界だったのです。
Dell.comで約28,300ドルで販売されているPro Precision 9 T2は、ほとんどの法人顧客が目にするボリュームディスカウント価格が適用される前に、同じ構成のPro Max Tower T2よりも約4,500ドル高くなっています。285Kプロセッサ、128GBのDDR5-4400 ECCメモリ、RTX PRO 6000グラフィックス、2TB Gen5ドライブ、1500W電源を搭載したPro Max Tower T2は約23,800ドルで、両タワーのGPUとメモリのオプション価格は900ドル以内の差です。この価格差のうち1,700ドルは2つ目のFlexBayドライブによるもので、残りはXeonプラットフォームによるものです。
これにより、デスクトップと同じ設置面積でありながら、全コア負荷時には小型サーバーのように動作するシングルソケットのタワー型PCが手に入る。そして、まさにそれがPrecisionというブランド名の復活の理由なのだ。
ランキング: Dell Pro Precision 9 T2は、当社の「ベストデスクトップワークステーション」ランキングで総合ベストに輝いており、そのRTX PRO 6000の性能は「ベストエンタープライズGPU」ランキングにも掲載されています。



 Amazon