

Memblaze PBlaze5 910 は、アプリケーションのパフォーマンスを大幅に向上させるように設計された高性能 NVMe SSD です。 64 層 3D NAND を搭載した PBlaze5 は、最大 15.36TB の大規模なシングルディスク容量を備えており、これは以前のモデルより 40% 増加しています。 Memblaze は、これにより、新しい SSD によってストレージ サーバー アプリケーションのラック密度が向上し、スペースが節約され、エネルギー コストが削減されると述べています。データセンターのエネルギー効率をこれまで以上に高めた 910 シリーズは、ワットあたりのパフォーマンスが 38% 向上することも報告されており、16 W から 10 W までの 25 の電力モード設定をサポートしています。
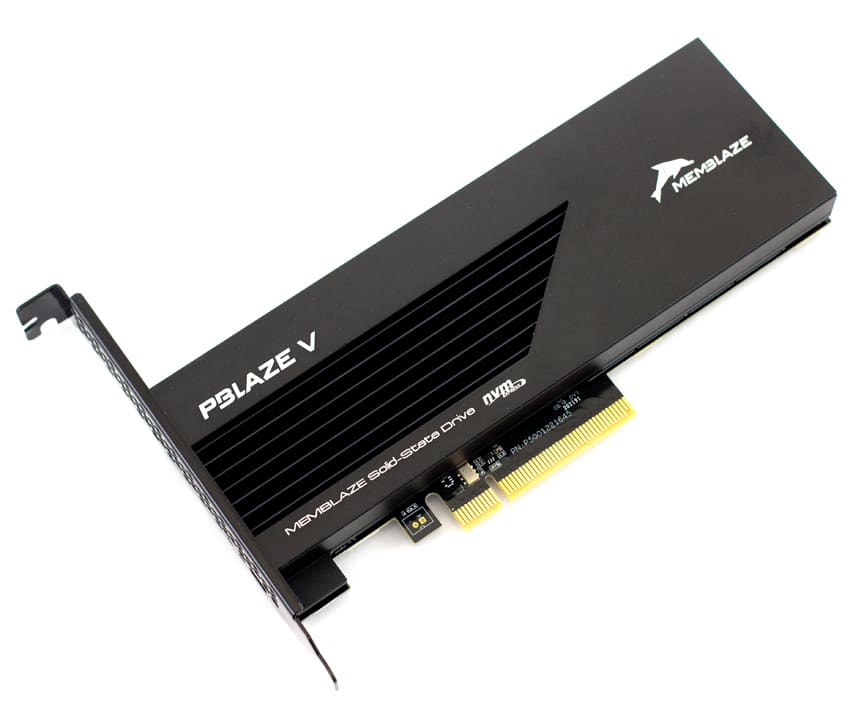
パフォーマンスに関する限り、Memblaze は 910 シリーズの読み取りと書き込みの速度がそれぞれ最大 6 GB/s と 3.8 GB/s であり、持続的なランダム スループットでは読み取り 1 万 IOPS、書き込み 135,000 IOPS であると述べています。
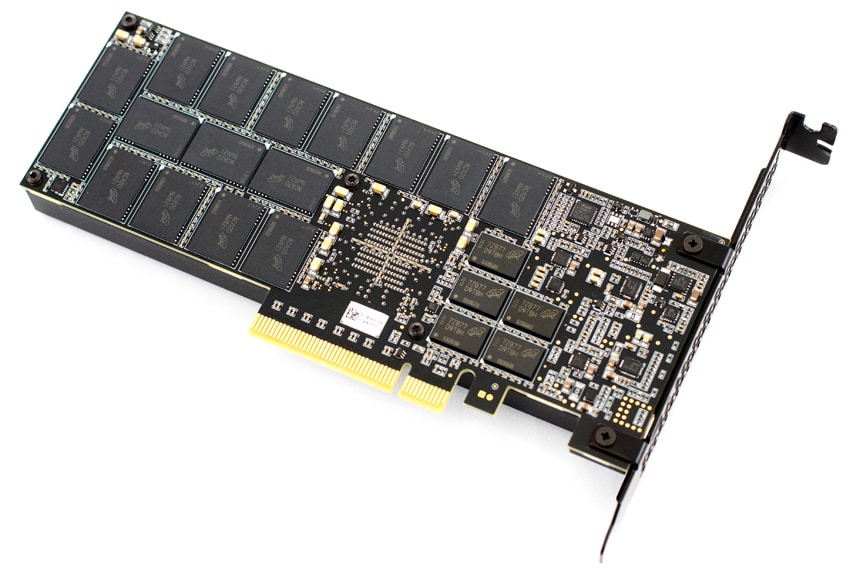
PBlaze5 910 シリーズは、AES 256 データ暗号化、完全なデータ パス保護、および強化された電源障害保護をサポートし、エンタープライズ アプリケーション データの整合性を確保します。また、デュアル ポート機能も備えており、両方のポートに同時にアクセスできるため、単一パス障害の問題が本質的に解消されます。
Memblaze PBlaze5 910 NVMe SSD 仕様
| フォームファクター | HHHL AIC | ||
| 容量 | 3.84TB | 7.68TB | |
| NAND | 3D eTLC | ||
| インタフェース | PCIe 3.0×8 | ||
| プロトコル | NVMe 1.2a | ||
| パフォーマンス | |||
| シーケンシャルリード (128KB) | 5.5GB /秒 | 6.0GB /秒 | |
| シーケンシャルライト(128KB) | 3.1GB /秒 | 3.8GB /秒 | |
| 持続ランダム読み取り (4KB) | 850K IOPS | 1万IOPS | |
| 持続ランダム書き込み (4KB) | 99K IOPS | 135K IOPS | |
| レイテンシー読み取り/書き込み | 87 /12μs | ||
| DWPD | 1 | ||
| UBER | <10^-17 | ||
| MTBF | 2百万時間 | ||
| 消費電力 | 7〜25W | ||
パフォーマンス
テストベッド
当社のエンタープライズSSDレビューでは、アプリケーションテストにLenovo ThinkSystem SR850、合成ベンチマークにDell PowerEdge R740xdを使用しています。ThinkSystem SR850は高性能なクアッドCPUプラットフォームであり、高性能ローカルストレージに負荷をかけるのに必要なCPUパワーをはるかに上回る性能を備えています。CPUリソースをあまり必要としない合成テストには、より一般的なデュアルプロセッササーバーを使用しています。どちらの場合も、ストレージベンダーが公表している最大ドライブ仕様に沿って、ローカルストレージの性能を最大限に引き出すことを目的としています。
レノボ シンクシステム SR850
- 4 x Intel Platinum 8160 CPU (2.1GHz x 24 コア)
- 16 x 32GB DDR4-2666Mhz ECC DRAM
- 2 x RAID 930-8i 12Gb/秒 RAID カード
- 8 つの NVMe ベイ
- VMware ESXI 6.5
デル PowerEdge R740xd
- 2 x Intel Gold 6130 CPU (2.1GHz x 16 コア)
- 16 x 16GB DDR4-2666MHz ECC DRAM
- 1x PERC 730 2GB 12Gb/秒 RAID カード
- アドインNVMeアダプター
- Ubuntu-16.04.3-デスクトップ-amd64
テストの背景と比較対象
StorageReviewのエンタープライズテストラボは、実際の導入環境で管理者が遭遇する状況に匹敵する環境で、エンタープライズストレージデバイスのベンチマークテストを実施するための柔軟なアーキテクチャを提供します。このエンタープライズテストラボには、さまざまなサーバー、ネットワーク機器、電源調整装置、その他のネットワークインフラストラクチャが組み込まれており、当社のスタッフが実際の使用環境に近い状況を作り出し、レビュー中にパフォーマンスを正確に評価することができます。
ラボ環境とプロトコルに関するこれらの詳細情報をレビューに盛り込むことで、IT担当者やストレージ調達担当者が、当社が以下の結果を達成した条件を理解できるようにしています。当社のレビューは、テスト対象機器のメーカーから報酬を受け取ったり、メーカーの監督を受けたりすることはありません。StorageReviewエンタープライズテストラボの詳細およびネットワーク機能の概要については、それぞれのページをご覧ください。
このレビューの比較対象:
- メンブレイズ PBlaze5 3.2TB
- メンブレイズ PBlaze4 3.2TB
- インテル P3700 2TB
- インテル P4500 2TB
- HGST SN100 3.2TB
- 東芝 PX04 1.6TB
アプリケーションのワークロード分析
エンタープライズストレージデバイスのパフォーマンス特性を理解するには、実際の運用環境におけるインフラストラクチャとアプリケーションワークロードをモデル化することが不可欠です。そのため、Memblaze PBlaze5 910のベンチマークとして、SysBenchによるMySQL OLTPパフォーマンスと、 TCP-CワークロードをシミュレートしたMicrosoft SQL Server OLTPパフォーマンスを測定しました。アプリケーションワークロードについては、各ドライブ上で同一構成の仮想マシンを2~4台実行します。
SQLサーバーのパフォーマンス
各 SQL Server VM は 100 つの vDisk で構成されています。ブート用の 500 GB ボリュームと、データベースとログ ファイル用の 16 GB のボリュームです。システム リソースの観点から、各 VM に 64 個の vCPU、XNUMX GB の DRAM を構成し、LSI Logic SAS SCSI コントローラーを活用しました。以前にテストした Sysbench ワークロードはストレージ I/O と容量の両方でプラットフォームを飽和させましたが、SQL テストではレイテンシーのパフォーマンスを調べています。
このテストでは、Windows Server 2012 R2 ゲスト VM 上で動作する SQL Server 2014 を使用し、Quest の Benchmark Factory for Databases で負荷をかけます。StorageReview のMicrosoft SQL Server OLTP テスト プロトコルでは、複雑なアプリケーション環境で発生するアクティビティをシミュレートするオンライン トランザクション処理ベンチマークである Transaction Processing Performance Council の Benchmark C (TPC-C) の最新ドラフトを採用しています。TPC-C ベンチマークは、合成パフォーマンス ベンチマークよりも、データベース環境におけるストレージ インフラストラクチャのパフォーマンスの強みとボトルネックをより正確に評価できます。このレビューで使用する SQL Server VM の各インスタンスは、333GB (1,500 スケール) の SQL Server データベースを使用し、15,000 人の仮想ユーザーの負荷がかかった状態でトランザクションのパフォーマンスとレイテンシを測定します。
SQL Server テスト構成 (VM ごと)
- Windows Serverの2012 R2
- ストレージ フットプリント: 600GB 割り当て、500GB 使用
- SQL Serverの2014
- データベースのサイズ: 1,500 スケール
- 仮想クライアント負荷: 15,000
- RAMバッファ: 48GB
- テスト時間: 3 時間
- 2.5時間のプレコンディショニング
- 30 分のサンプル期間
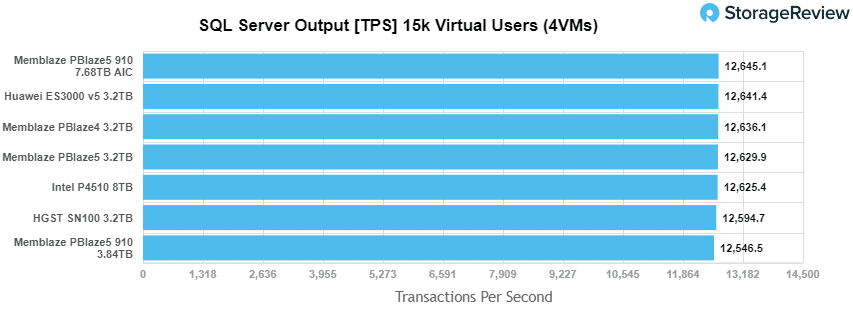
SQL Server トランザクション ベンチマークでは、Memblaze PBlaze5 910 AIC が 12,645.1 TPS という最高のパフォーマンスを誇りました。
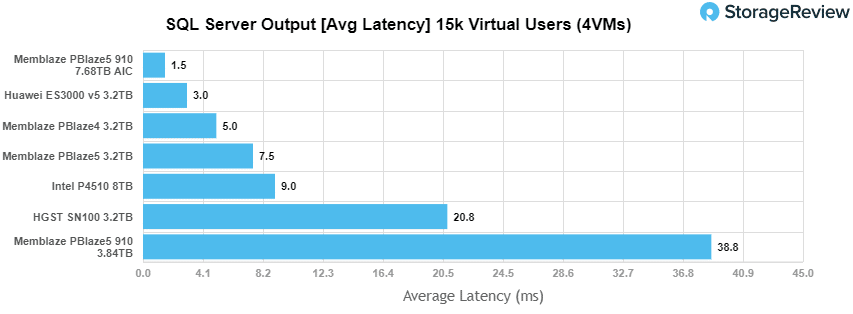
910 AIC モデルの遅延もわずか 1.5 ミリ秒と最も低く、3000 位の Huawei EDXNUMX の遅延の半分でした。
システムベンチのパフォーマンス
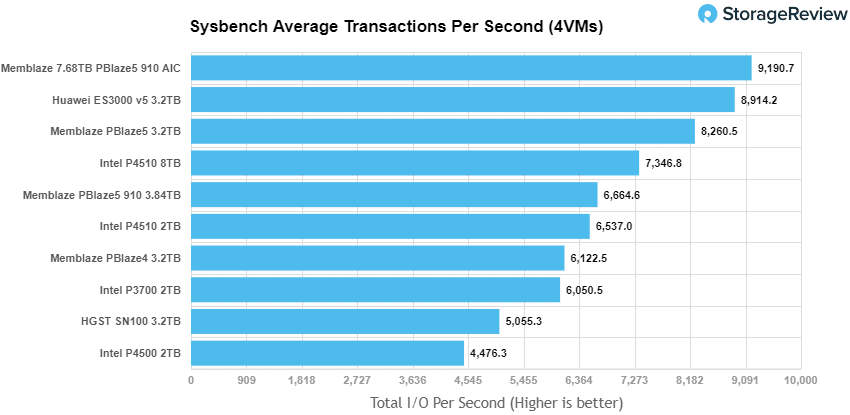
次のアプリケーションベンチマークは、 SysBenchを使用して測定されるPercona MySQL OLTPデータベースで構成されています。このテストでは、平均TPS(1秒あたりのトランザクション数)、平均レイテンシ、および平均99パーセンタイルレイテンシも測定されます。
各Sysbench VMは、3つのvDiskで構成されています。1つはブート用(約92GB)、1つは構築済みデータベース用(約447GB)、そして3つ目はテスト対象データベース用(270GB)です。システムリソースの観点から、各VMには16個のvCPU、60GBのDRAMを搭載し、LSI Logic SAS SCSIコントローラを活用しました。
Sysbench テスト構成 (VM ごと)
- CentOS 6.3 64 ビット
- Percona XtraDB 5.5.30-rel30.1
- データベーステーブル: 100
- データベースのサイズ: 10,000,000
- データベーススレッド: 32
- RAMバッファ: 24GB
- テスト時間: 3 時間
- 2 スレッドのプリコンディショニングに 32 時間
- 1時間 32スレッド
Sysbench トランザクション ベンチマークでは、AIC 910 は 9,190.7 TPS という目覚ましいパフォーマンスを継続し、リーダーボードのトップになりました。
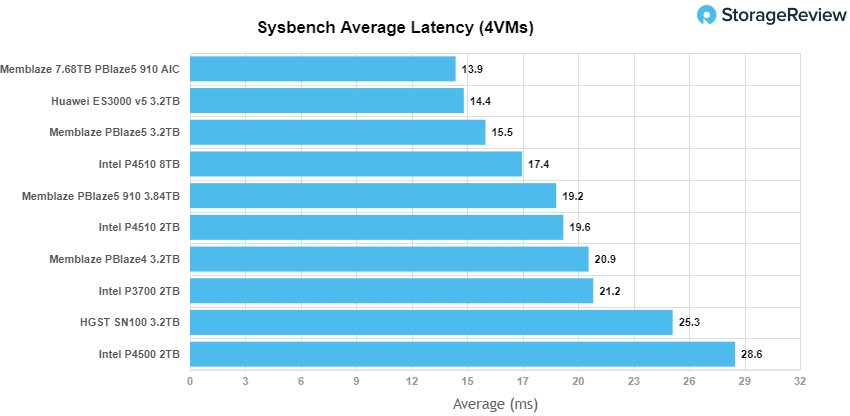
Sysbench の平均レイテンシでは、AIC 910 が 13.9 ミリ秒で再び最高のパフォーマンスを示しました。
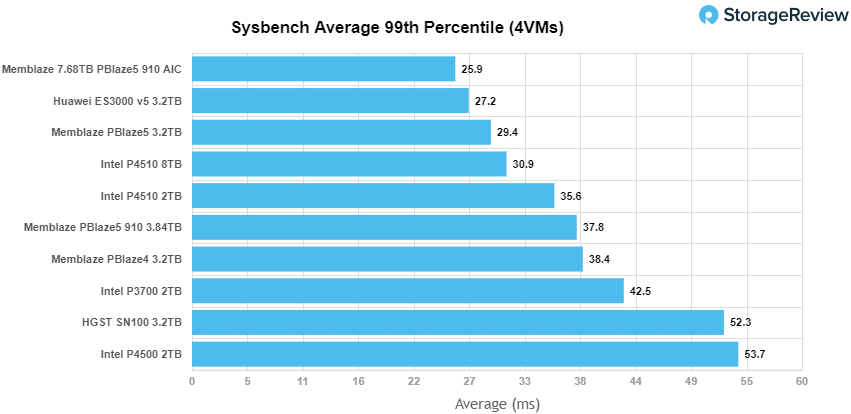
最悪のシナリオの遅延ベンチマークでは、AIC 910 がわずか 25.9 ミリ秒でトップに立っています。
SideFX の Houdini
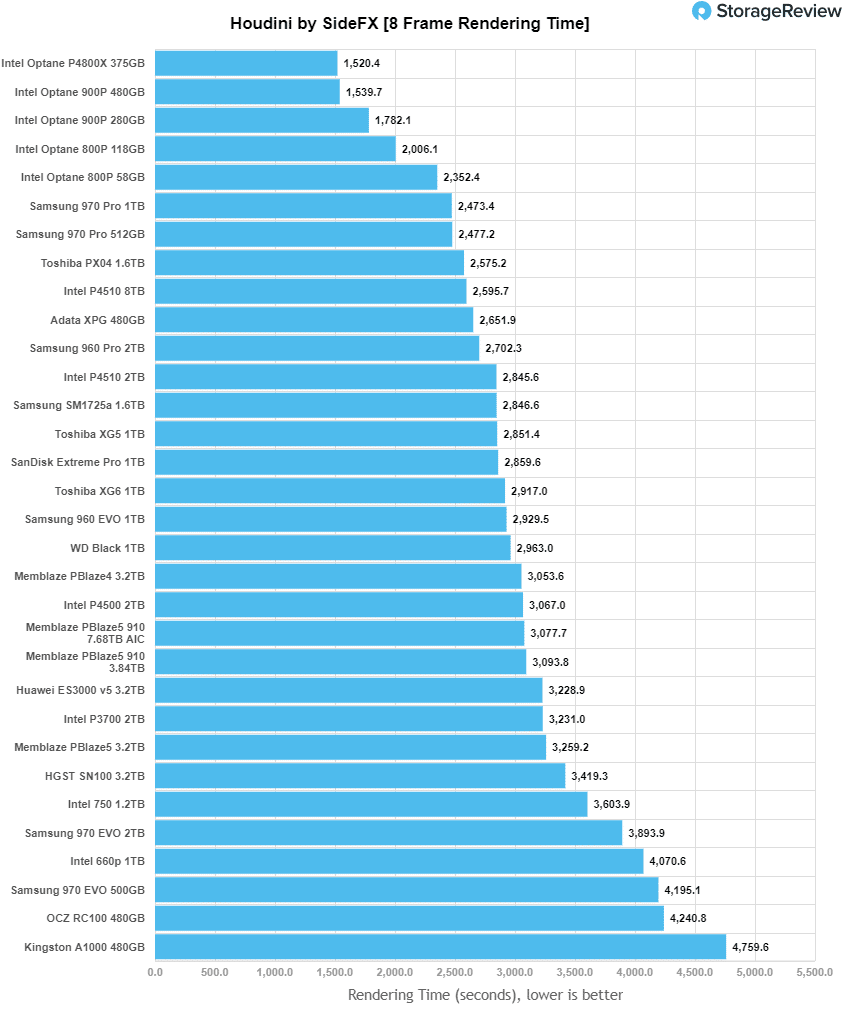
Houdiniテストは、CGIレンダリングに関連するストレージパフォーマンスを評価するために特別に設計されています。このアプリケーションのテスト環境は、ラボで使用しているコアDell PowerEdge R740xdサーバータイプのバリアントで、デュアルIntel 6130 CPUと64GB DRAMを搭載しています。今回は、ベアメタル環境でUbuntu Desktop(ubuntu-16.04.3-desktop-amd64)をインストールしました。ベンチマークの出力は完了までの秒数で測定され、数値が小さいほど性能が良いことを示します。
Maelstrom デモは、拡張メモリの形式としてスワップ ファイルを効果的に使用する機能をデモンストレーションすることで、ストレージのパフォーマンス機能を強調するレンダリング パイプラインのセクションを表します。このテストでは、基礎となるストレージ コンポーネントに対する待ち時間の影響を分離するために、結果データの書き出しやポイントの処理は行いません。テスト自体は 5 つのフェーズで構成されており、そのうちの 3 つはベンチマークの一部として実行されます。次のとおりです。
- パックされたポイントをディスクからロードします。これがディスクからの読み取りの時間です。これはシングルスレッドであるため、全体のスループットが制限される可能性があります。
- ポイントを処理できるようにするために、ポイントを単一のフラット配列に解凍します。ポイントが他のポイントに依存していない場合、ワーキング セットはコア内に留まるように調整できます。このステップはマルチスレッドです。
- (実行しない)ポイントを処理します。
- ディスクに戻すのに適したバケット化されたブロックにそれらを再パックします。このステップはマルチスレッドです。
- (実行しない)バケット化されたブロックをディスクに書き込みます。
Houdini テストでは、910 AIC は 3,077.7 秒で中位から下位に位置し、Memblaze 製品の中でも U.2 モデルのすぐ上でした。
VDBench ワークロード分析
ストレージ デバイスのベンチマークに関しては、アプリケーション テストが最適であり、総合テストは 25 番目になります。実際のワークロードを完全に表現しているわけではありませんが、合成テストは、競合ソリューション間での完全な比較を容易にする再現性係数を備えたストレージ デバイスのベースラインを確立するのに役立ちます。これらのワークロードは、「100 コーナー」テスト、一般的なデータベース転送サイズ テスト、さまざまな VDI 環境からのトレース キャプチャに至るまで、さまざまなテスト プロファイルを提供します。これらのテストはすべて、スクリプト エンジンを備えた共通の vdBench ワークロード ジェネレーターを利用して、大規模なコンピューティング テスト クラスターの結果を自動化して取得します。これにより、フラッシュ アレイや個々のストレージ デバイスを含む幅広いストレージ デバイスにわたって同じワークロードを繰り返すことができます。これらのベンチマークのテスト プロセスでは、ドライブの表面全体にデータを埋めてから、ドライブ容量の XNUMX% に相当するドライブ セクションを分割して、ドライブがアプリケーションのワークロードにどのように応答するかをシミュレートします。これは、ドライブを XNUMX% 使用して定常状態にするフル エントロピー テストとは異なります。結果として、これらの数値は、より高い持続的な書き込み速度を反映することになります。
プロフィール:
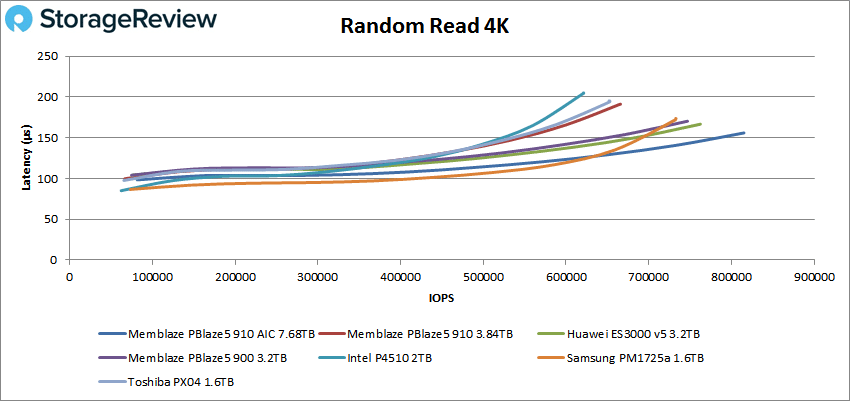
- 4K ランダム読み取り: 100% 読み取り、128 スレッド、0 ~ 120% iorate
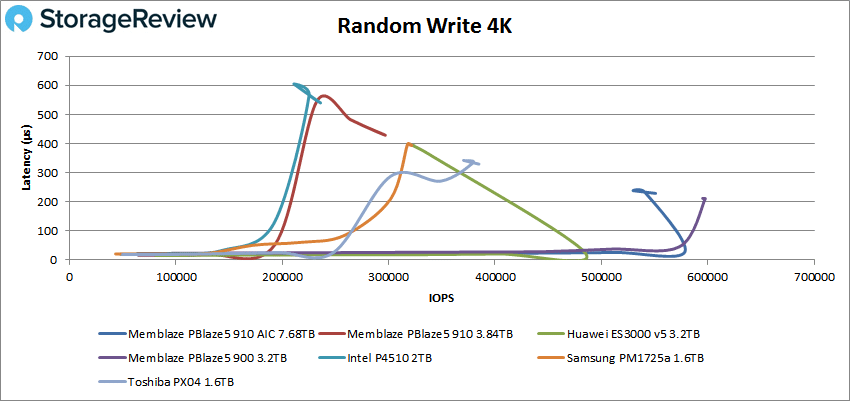
- 4K ランダム書き込み: 100% 書き込み、64 スレッド、0 ~ 120% iorate
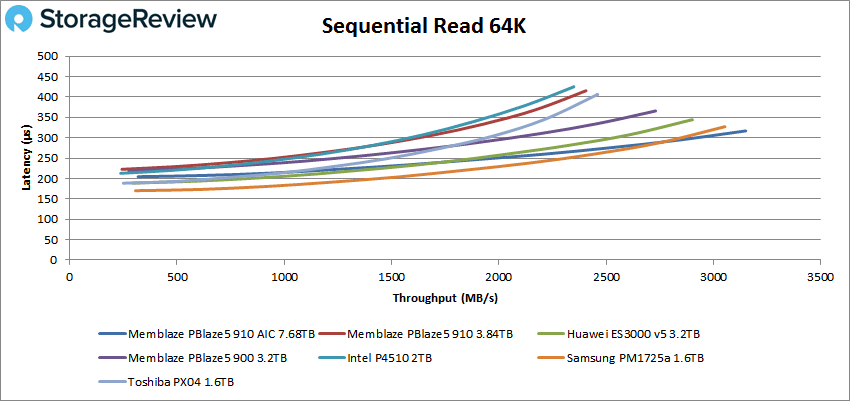
- 64K シーケンシャル読み取り: 100% 読み取り、16 スレッド、0 ~ 120% の iorate
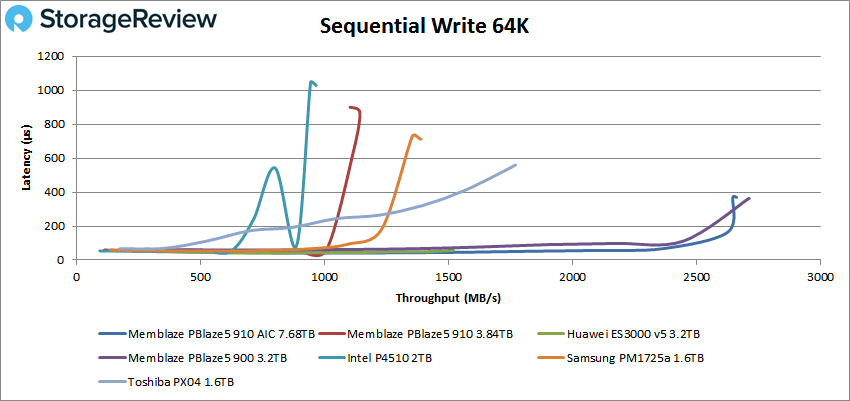
- 64K シーケンシャル書き込み: 100% 書き込み、8 スレッド、0 ~ 120% iorate
- 合成データベース: SQL および Oracle
- VDI フル クローンおよびリンク クローン トレース
最初の VDBench ワークロード分析であるランダム 4K 読み取りでは、Memblaze PBlaze5 910 AIC はテスト全体を通じて 1 ミリ秒未満にとどまり、ピーク値 814,640 IOPS、レイテンシー 155.9 μs を達成し、堂々の XNUMX 位にランクインしました。
ここでも、4K ランダム書き込みパフォーマンスは、全体を通してミリ秒未満の遅延を示しました。 910 AIC は、ピーク パフォーマンス 900 IOPS、遅延 550,864μs で、テスト ドライブの中で 229.3 位になりました (PBlaze XNUMX が XNUMX 位)。
シーケンシャル ワークロードに切り替えると、910K シーケンシャル読み取りでパックの先頭に配置された 64 AIC は、ピーク スコア 50,372 IOPS または 3.14GB/s、レイテンシ 317μs を達成しました。
PBlaze 900 と入れ替わり、910 AIC は 42,563K シーケンシャル書き込みで 2.66μs のレイテンシーで 370 IOPS または 64GB/s のピークに達しました。
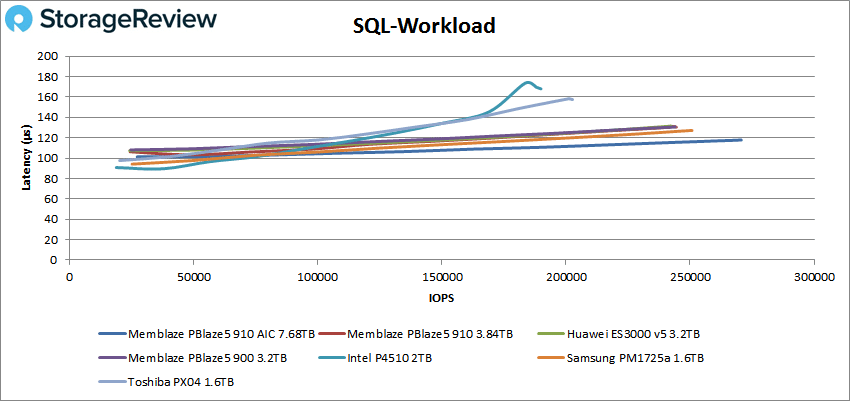
SQL ワークロードに移ると、910 AIC はわずか 270,432μs の遅延で 117.8 IOPS に達し、再びリーダーボードのトップになりました。
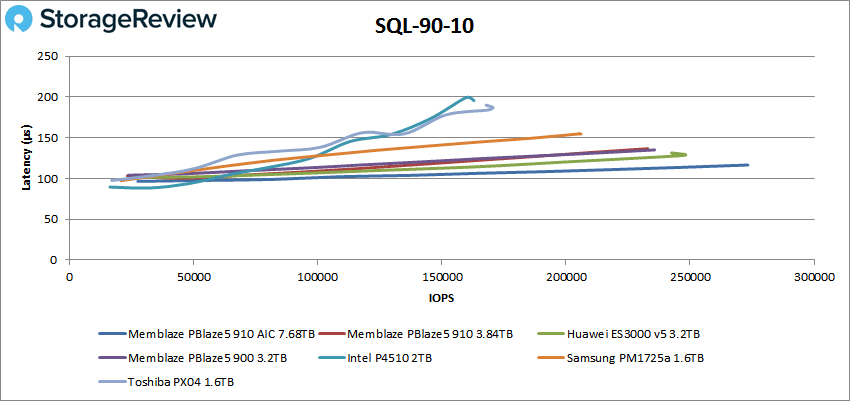
SQL 90-10では、910がピークスコア273,321 IOPS、レイテンシ116.6μsで大差をつけてトップの座を維持した。
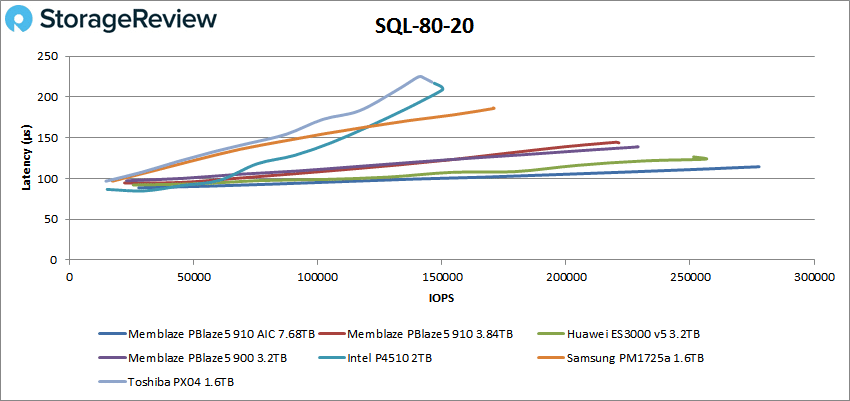
910 AIC は、SQL 277,815-114 ベンチマークで 80 IOPS、レイテンシ 20.μs でピークに達し、リーダーボードのトップを維持しました。
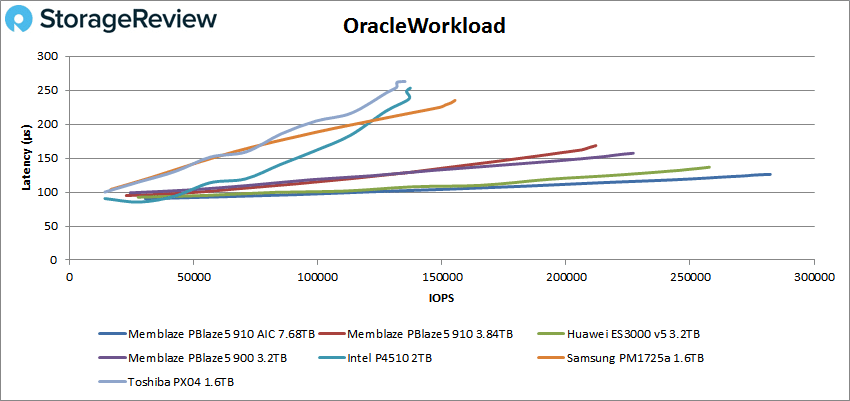
Oracle ワークロードでは、910 AIC が引き続き優位性を維持し、ピーク スコアは 282,326 IOPS、レイテンシは 126.2μs でした。
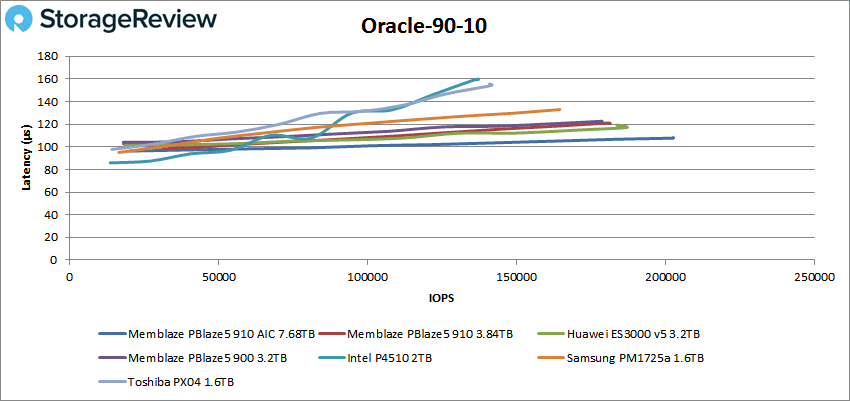
Oracle 90-10 の場合、910 AIC は 202,695 IOPS のピークと 108μs のレイテンシを示し、トップの座を獲得しました。
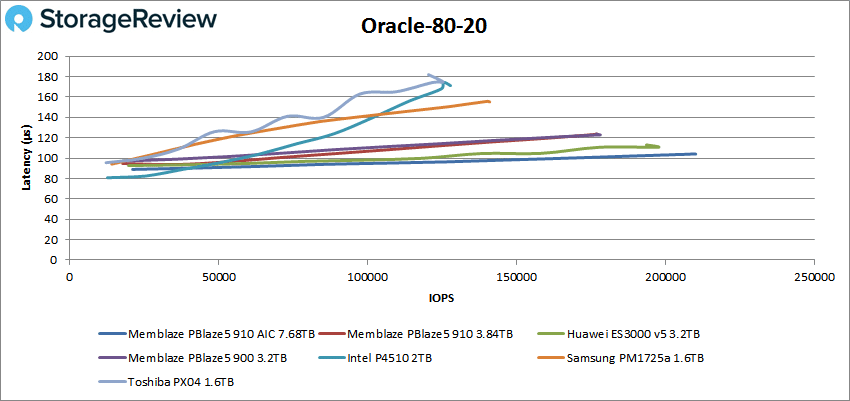
80 年から 20 年にかけて、910 は Oracle テストを終了し、210,228 IOPS という素晴らしいピーク パフォーマンスと 104μs のレイテンシーを達成しました。
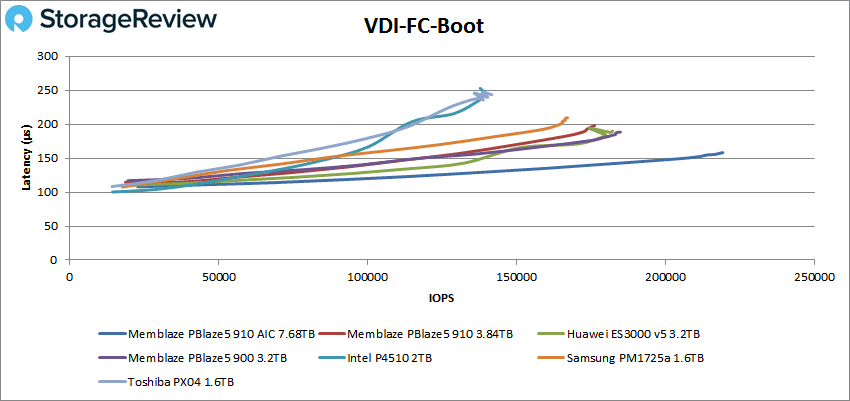
次に、VDI クローン ベンチマークのフルおよびリンクに進み、ほとんどのテストで 910 AIC が最高のパフォーマンスを示しました。 VDI フル クローン ブートの場合、910 AIC のピーク パフォーマンスは 219,337 IOPS、遅延は 158.2μs でした。
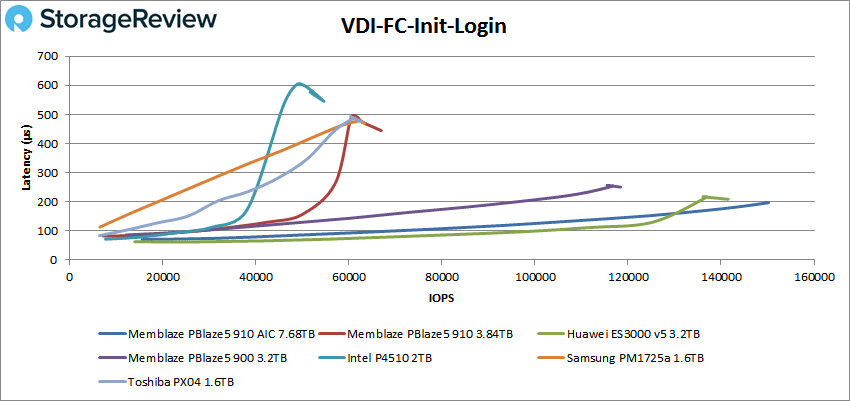
VDI FC 初期ログインでは、910 AIC が 150,121 IOPS のピーク パフォーマンスと 197μs のレイテンシでトップの座を獲得しました。
VDI FC Monday Loginテストでは、910 AICは101,128 IOPS、156.3μsのレイテンシでHuaweiに次ぐ2位となりました。
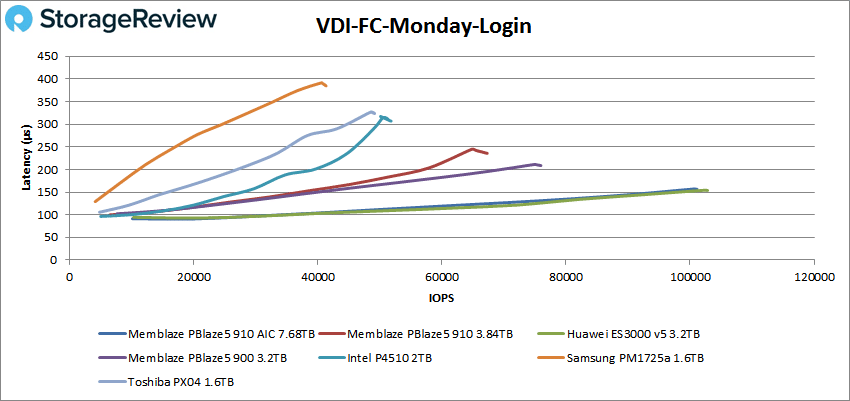
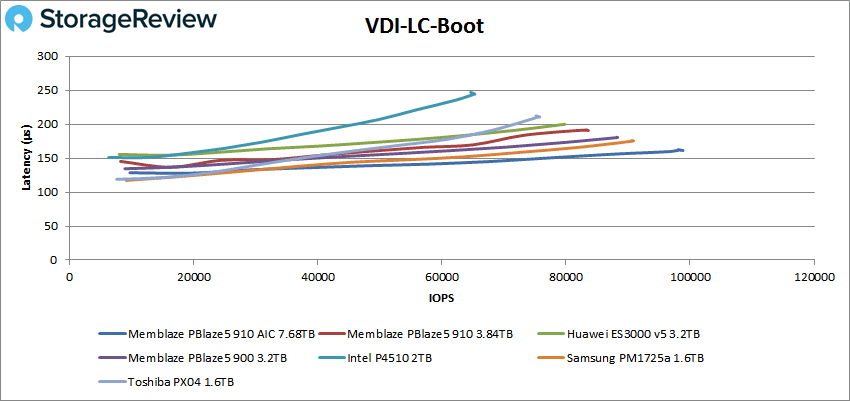
リンク クローン (LC) に切り替えて、最初にブート テストを調べました。このシナリオでは、910 AIC が 98,284 IOPS、レイテンシ 161.3μs で XNUMX 位になりました。
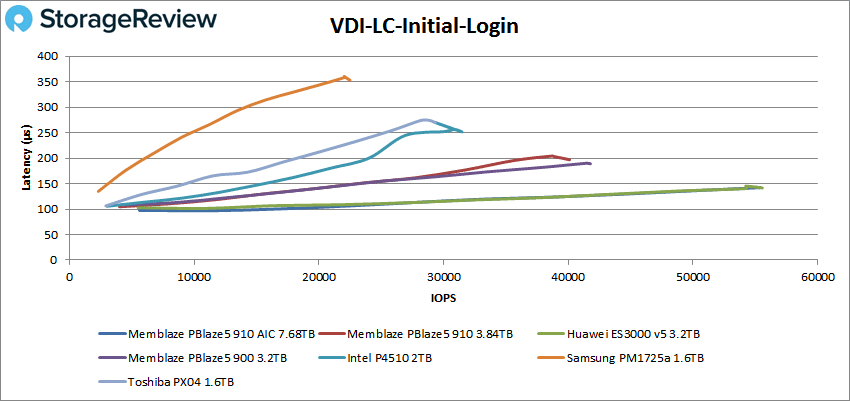
VDI LC の初期ログインでは、910 AIC と Huawei の間で 55,061 IOPS、遅延 143.4μs というほぼ同等のパフォーマンスが示されました。
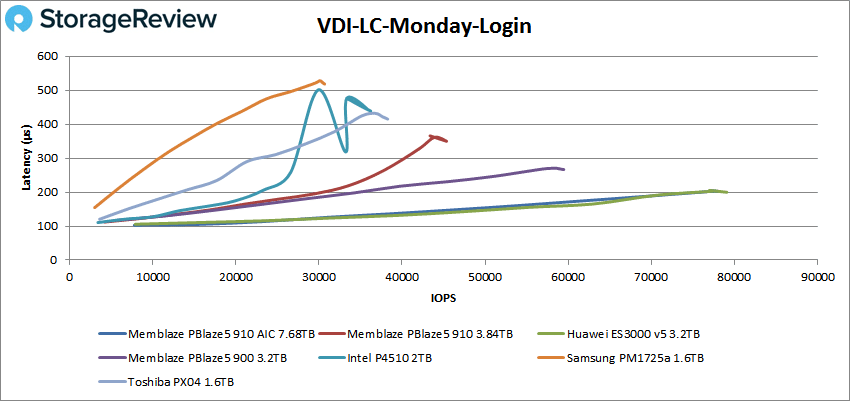
VDI LC Monday Login テストでは、Huawei と 910 AIC が再び互角のパフォーマンスを示し、ピーク 77,721 IOPS、レイテンシ 203.8μs で、再び XNUMX 位となりました。
結論
U.2 と AIC フォームファクター モデルの両方で構成される Memblaze の PBlaze5 910 は、64 層 3D NAND を使用する最新の NVMe データセンター ドライブです。このレビューでは AIC モデルを検討しました。このモデルには 3.84 TB と 7.68 TB の容量があり、パフォーマンスは読み取り 6.0 GB/s と書き込み 3.8 GB/s に達し、読み取り最大 1 万 IOPS のスループット パフォーマンスを謳っています。 910 AIC は、AES 256 データ暗号化や最大 8TB/s の TRIM 機能サポートなどの幅広い保護機能と併せて、使用されるほぼすべてのアプリケーションで優れた性能を発揮するために必要な能力を備えています。
パフォーマンスの詳細を詳しく調べると、テストした多くのワークロードで 910 AIC がリーダーボードのトップにあることがわかりました。 SQL Server ベンチマークでは、12,645.1 TPS で 1.5 位となり、平均レイテンシはわずか 9,190.7 ミリ秒でした。 Sysbench では、このドライブは 13.3 TPS、平均遅延 25.9 ミリ秒、最悪のシナリオの遅延 910 ミリ秒で再びリーダーボードのトップに躍り出ました。 Houdini by SideFX ベンチマークでは、3,077.7 AIC は 2 秒を記録しました。これは、U.910 モデルや他の Memblaze 製品よりもわずかに優れていました。 VDBench ベンチマークでは、4 AIC はすべてのテストを通じてミリ秒未満の遅延を維持し、ほとんどのカテゴリで最高のパフォーマンスを示しました。ランダム 5K 読み取りおよび書き込みでは、Memblaze PBlaze910 814,640 AIC はそれぞれ 550,864 IOPS と 3.14 IOPS に達し、シーケンシャル ワークロードではそれぞれ 2.66 GB/秒と 277,000 GB/秒を記録しました。 SQL の結果は約 270,000 万 IOPS を保持し、Oracle テストは XNUMX IOPS ~ XNUMX IOPS で実行されました。
x4 インターフェイスから x8 インターフェイスに移行した Memblaze PBlaze5 910 は、sme ファミリの U.2 フォームファクター バージョンと比較してパフォーマンスが大幅に向上しました。全体的に、AIC 910 はインターフェイスが限定された U.2 モデルよりも優れていることを示し、特定のアプリケーションがより大きなフォーム ファクターを活用できれば何が可能になるかを顧客に示しました。


 Amazon