

VMwareは最近、 vSphere 7.0でストレージネットワークプロトコルオプションとしてNVMe over Fabric(NVMe-oF)を追加しました。世界で最も人気のある仮想化ソフトウェアで最速の共有ストレージソリューションが利用できるようになったことは、まさに画期的な出来事であり、仮想化データセンターの新たなユースケースを切り開きます。これはまた、vSphere上のNVMe-oF対応仮想マシン(VM)上でベアメタルアプリケーションを実行できるようになったことを意味します。これには、人工知能(AI)、機械学習(ML)、インメモリデータベース、ハイパフォーマンスコンピューティング(HPC)、高頻度取引(HFT)、オンライン取引処理(OLTP)など、極めて低いレイテンシと大容量ストレージを必要とするあらゆるアプリケーションが含まれます。
StorageReview.com では、最新技術が実際の環境でどのように機能するかを検証することに常に興味を持っています。NVMe-oF に関するこれまでの経験から、vSphere のアプリケーション パフォーマンスが大幅に向上すると確信しています。NVMe-oF がパフォーマンスにどのような影響を与えるかを実際に把握するために、vSphere データ センターにおけるブロック ストレージの現在の標準である iSCSI と比較します。ただし、今回のテストには独自の工夫が凝らされています。高度に専門化されたニッチな技術は使用せず、現在データ センターで一般的に使用されている製品を使用します。テストは、NVIDIA の ConnectX-5 デュアル ポート アダプタ (25GbE で動作) を介してNVMe-oF をサポートするPure Storage FlashArray//Xに接続された Dell R720XD サーバーで行います。
テストの結果を説明する前に、まず VMware が NVMe-oF でサポートしている内容の概要を説明し、次に NVMe と NVMe-oF の背景を少し説明し、NVMe と NVMe-oF のパフォーマンスが優れている理由を説明します。 iSCSI。また、vSphere で NVMe をセットアップするために実行した手順の一部についても説明します。
VMware は最近 NVMe-oF サポートを有効にしました (2020 年 2016 月) が、NVMe-oF 標準は 2018 年にリリースされました。Linux は 2020 年からそれを使用できるようになり、ストレージ アレイでの NVMe-oF サポートも数年前から利用可能になりました。 。 NVMe-oF は、新興ではあるものの安定したテクノロジーであると考えられています。 7.0 年 XNUMX 月、VMware は vSphere XNUMX をリリースしました。このリリースには NVMe-oF のサポートが含まれており、NVMe over Fibre Channel (NVMe/FC) または NVMe over RDMA Converged Ethernet (NVMe-RoCE、NVMe-RoCE とも呼ばれます) のいずれかを使用して NVMe アレイに接続できるようになります。 NVMe/RDMA)。
NVMe と NVMe-oF の概要
最近まで、SSDは外付けストレージの事実上の標準メディアでした。しかし、SSDには重大なボトルネックがありました。SSDはSATAまたはSASコネクタを使用しますが、これらはHDDで使用するために設計されたものであり、SSDのパフォーマンスを著しく制限していました。この問題を解決するため、2011年に90社以上の企業が結集し、SATAのボトルネックのないコンピュータにSSDを接続するための新しい仕様を発表しました。このソリューションは最終的にNVMeとして知られるようになりました。
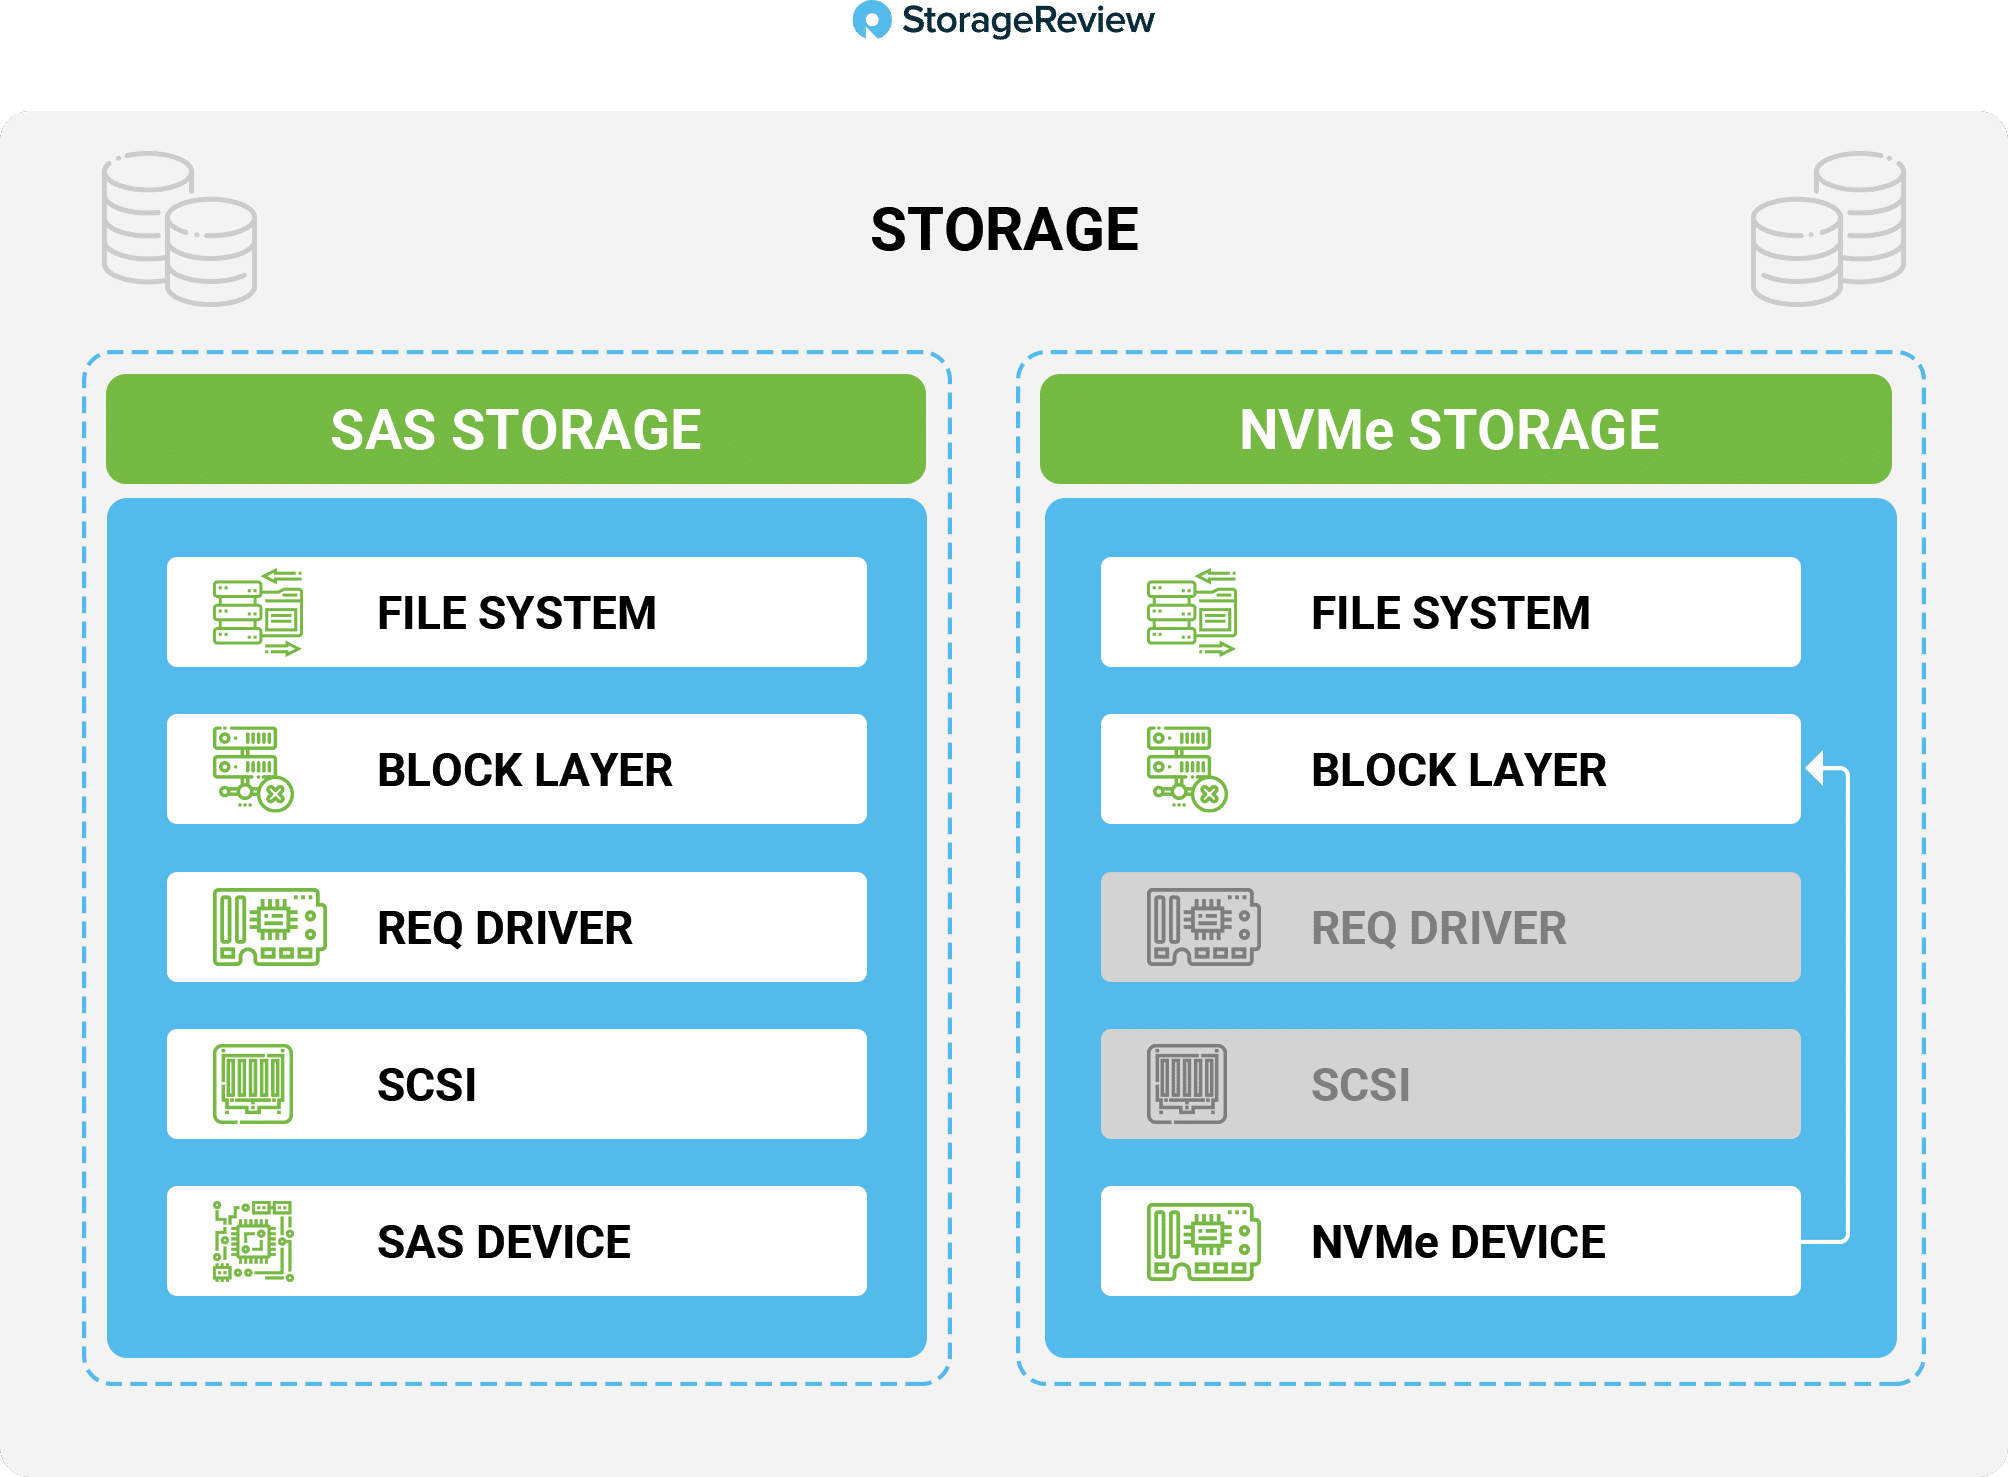
NVMe デバイスは高速です。 SATA/SAS SSD が過去 4 年間にストレージ業界を根本的に変えたのに対し、NVMe は今世紀に入ってストレージ業界を根本的に変えています。たとえば、500K 読み取りワークロードを使用した最近のテストでは、SATA ドライブ (Kingston DC80,000M) は 1000 IOPS 弱を実現できますが、NVMe ドライブ (Kingston DC580,000M) は 7.25 IOPS を実現でき、その差は XNUMX 倍であることがわかりました。 NVMe が SATA ドライブよりもはるかにパフォーマンスが高い理由を説明する技術的な理由はたくさんありますが、最も重要な理由の XNUMX つは、データ パスが短いことです。以下の図は、SAS などの最終世代のストレージと比較して、NVMe のデータ パスがどのように大幅に短いかを簡略化して示しています。
 パフォーマンスの向上と価格の急激な低下により、NVMe は現代のデータセンターの最愛の人になりました。
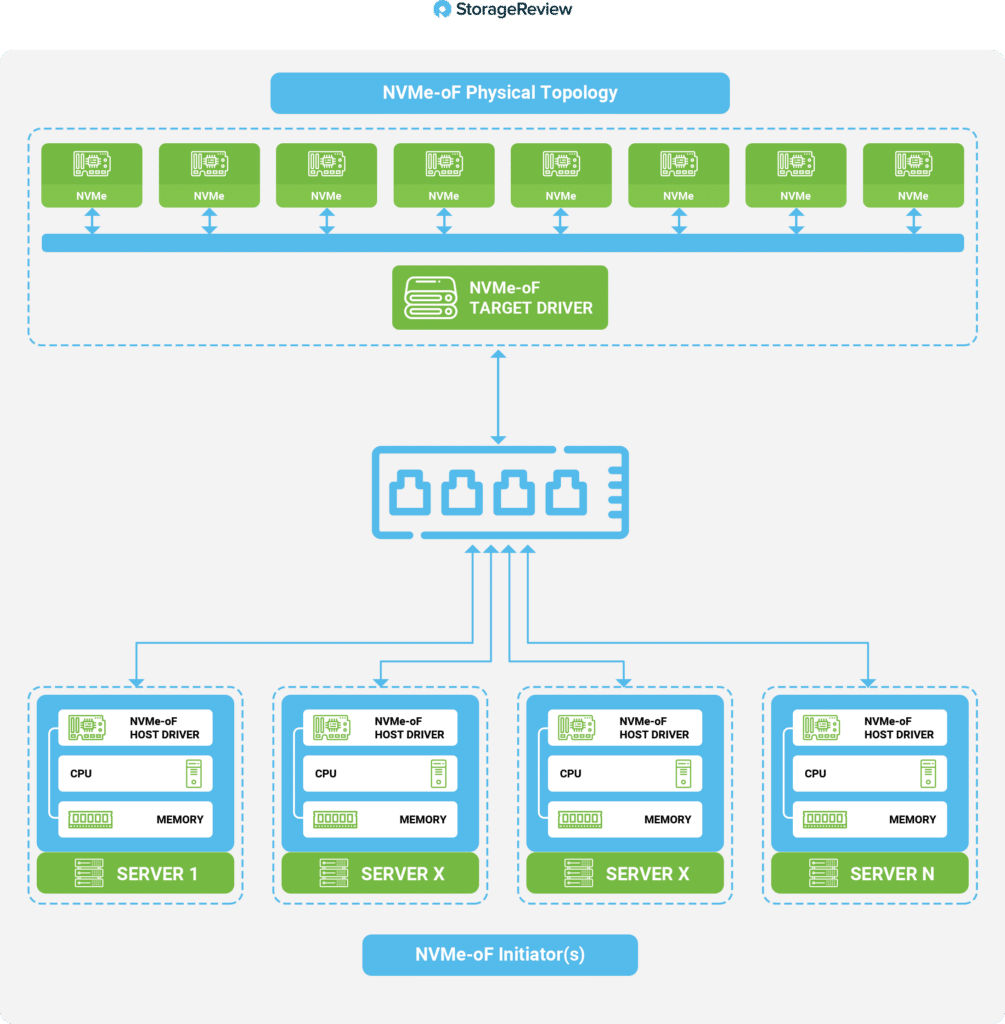
NVMe ドライブがデータセンターで広く使用されるようになった直後、人々はデバイスがその可能性を最大限に活用されていないことに気づき、直接接続ストレージとしての限界がより明確になりました。 NVMe デバイスはサーバーから切り離す必要があるため、別の企業グループが協力して、ネットワーク経由で NVMe を配信する方法に関する仕様を開発しました。 NVMe ストレージのトランスポート メカニズムが利用可能になると、ストレージ システム内の NVMe デバイスを集約、抽象化し、ESXi ホストを含むさまざまなシステムで共有できるようになります。 NVMe-oF では、ターゲット/イニシエーターの用語が使用されます。
RoCE では、イーサネット ネットワーク経由でリモート ダイレクト メモリ アクセス (RDMA) が可能になります。 RoCE には、RoCE v1 と RoCE v2 の 1 つのバージョンがあります。 RoCE v2 では、同じイーサネット ブロードキャスト ドメイン (レイヤー 2) 内の任意の 3 つのホスト間の通信が可能ですが、RoCE v2 は TCP (レイヤー 2) 上で実行されるためルーティング可能であり、イーサネット ブロードキャスト ドメインの外部のホストに接続できます。その固有の利点とデータセンターでの人気により、VMware は vXNUMX のみをサポートします。この記事では、RoCE vXNUMX を単に RoCE と呼びます。
RoCE には、標準の NIC の代わりに RDMA ネットワーク インターフェイス コントローラー (rNIC) が必要です。 RoCE ネットワークでは通常、優先フロー制御を構成する必要がありますが、Spectrum スイッチは ConnectX アダプターと併用すると輻輳制御用に最適化され、構成が不要になります。 RoCE は非常に人気があり、rNIC と NVMe-oF サブシステムの両方を提供する活発なエコシステムがあります。現在、世界最大級のハイパースケール データセンターの一部で使用されており、これにより rNIC の価格は最初に導入されたときよりも大幅に下がりました。
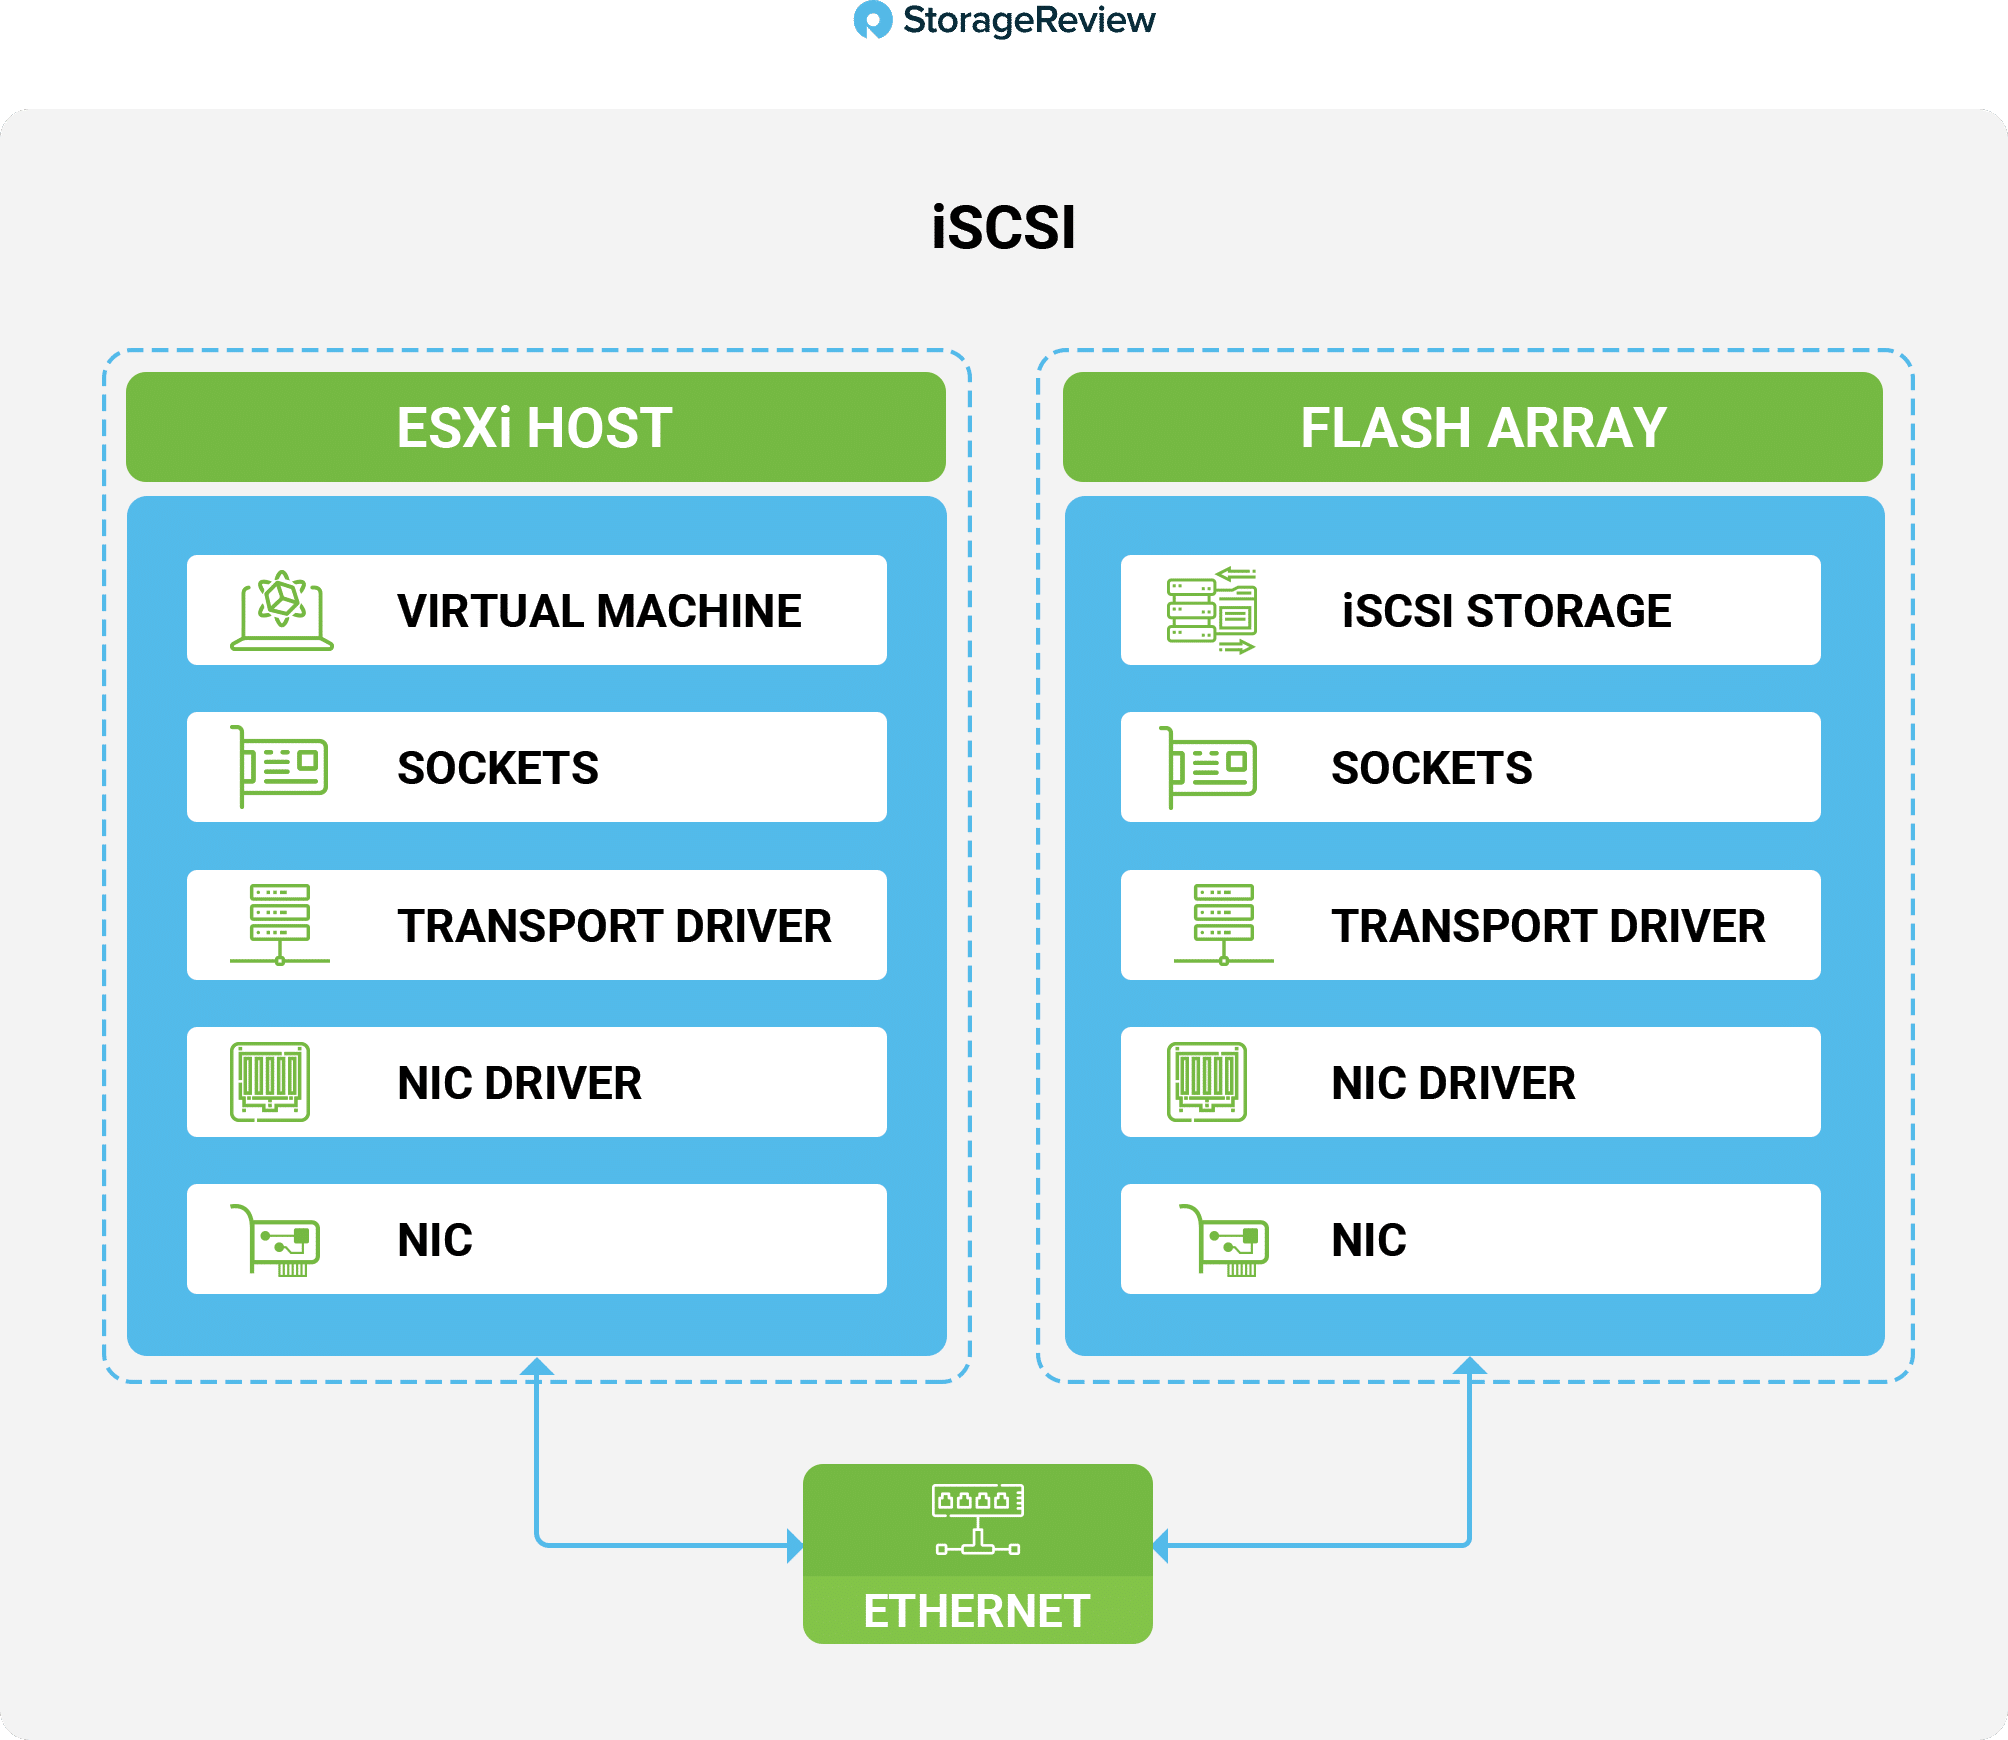
RDMA を使用すると、標準の伝送制御プロトコル/インターネット プロトコル (TCP/IP) スタックを使用する場合と同様に、データをメモリ バッファにコピーすることなく、NVMe-oF デバイスからホストに直接転送できます。 RDMA はバッファをバイパスすることにより、ホスト上の CPU 使用率を削減し、リモート NVMe デバイス上のデータにアクセスするための遅延を短縮します。 NVMe-oF が前世代のネットワーク ストレージ テクノロジよりもパフォーマンスが高いのには、多くの技術的な理由があります。注目すべきは、NVMe-oF がサポートする膨大な数のキュー (64K) ですが、おそらく最も特徴的なのは NVMe-oF データ パスでしょう。以下の図は、iSCSI ストレージと比較した場合、NVMe-oF のデータ パスがどのように大幅に短いかを簡略化して示しています。
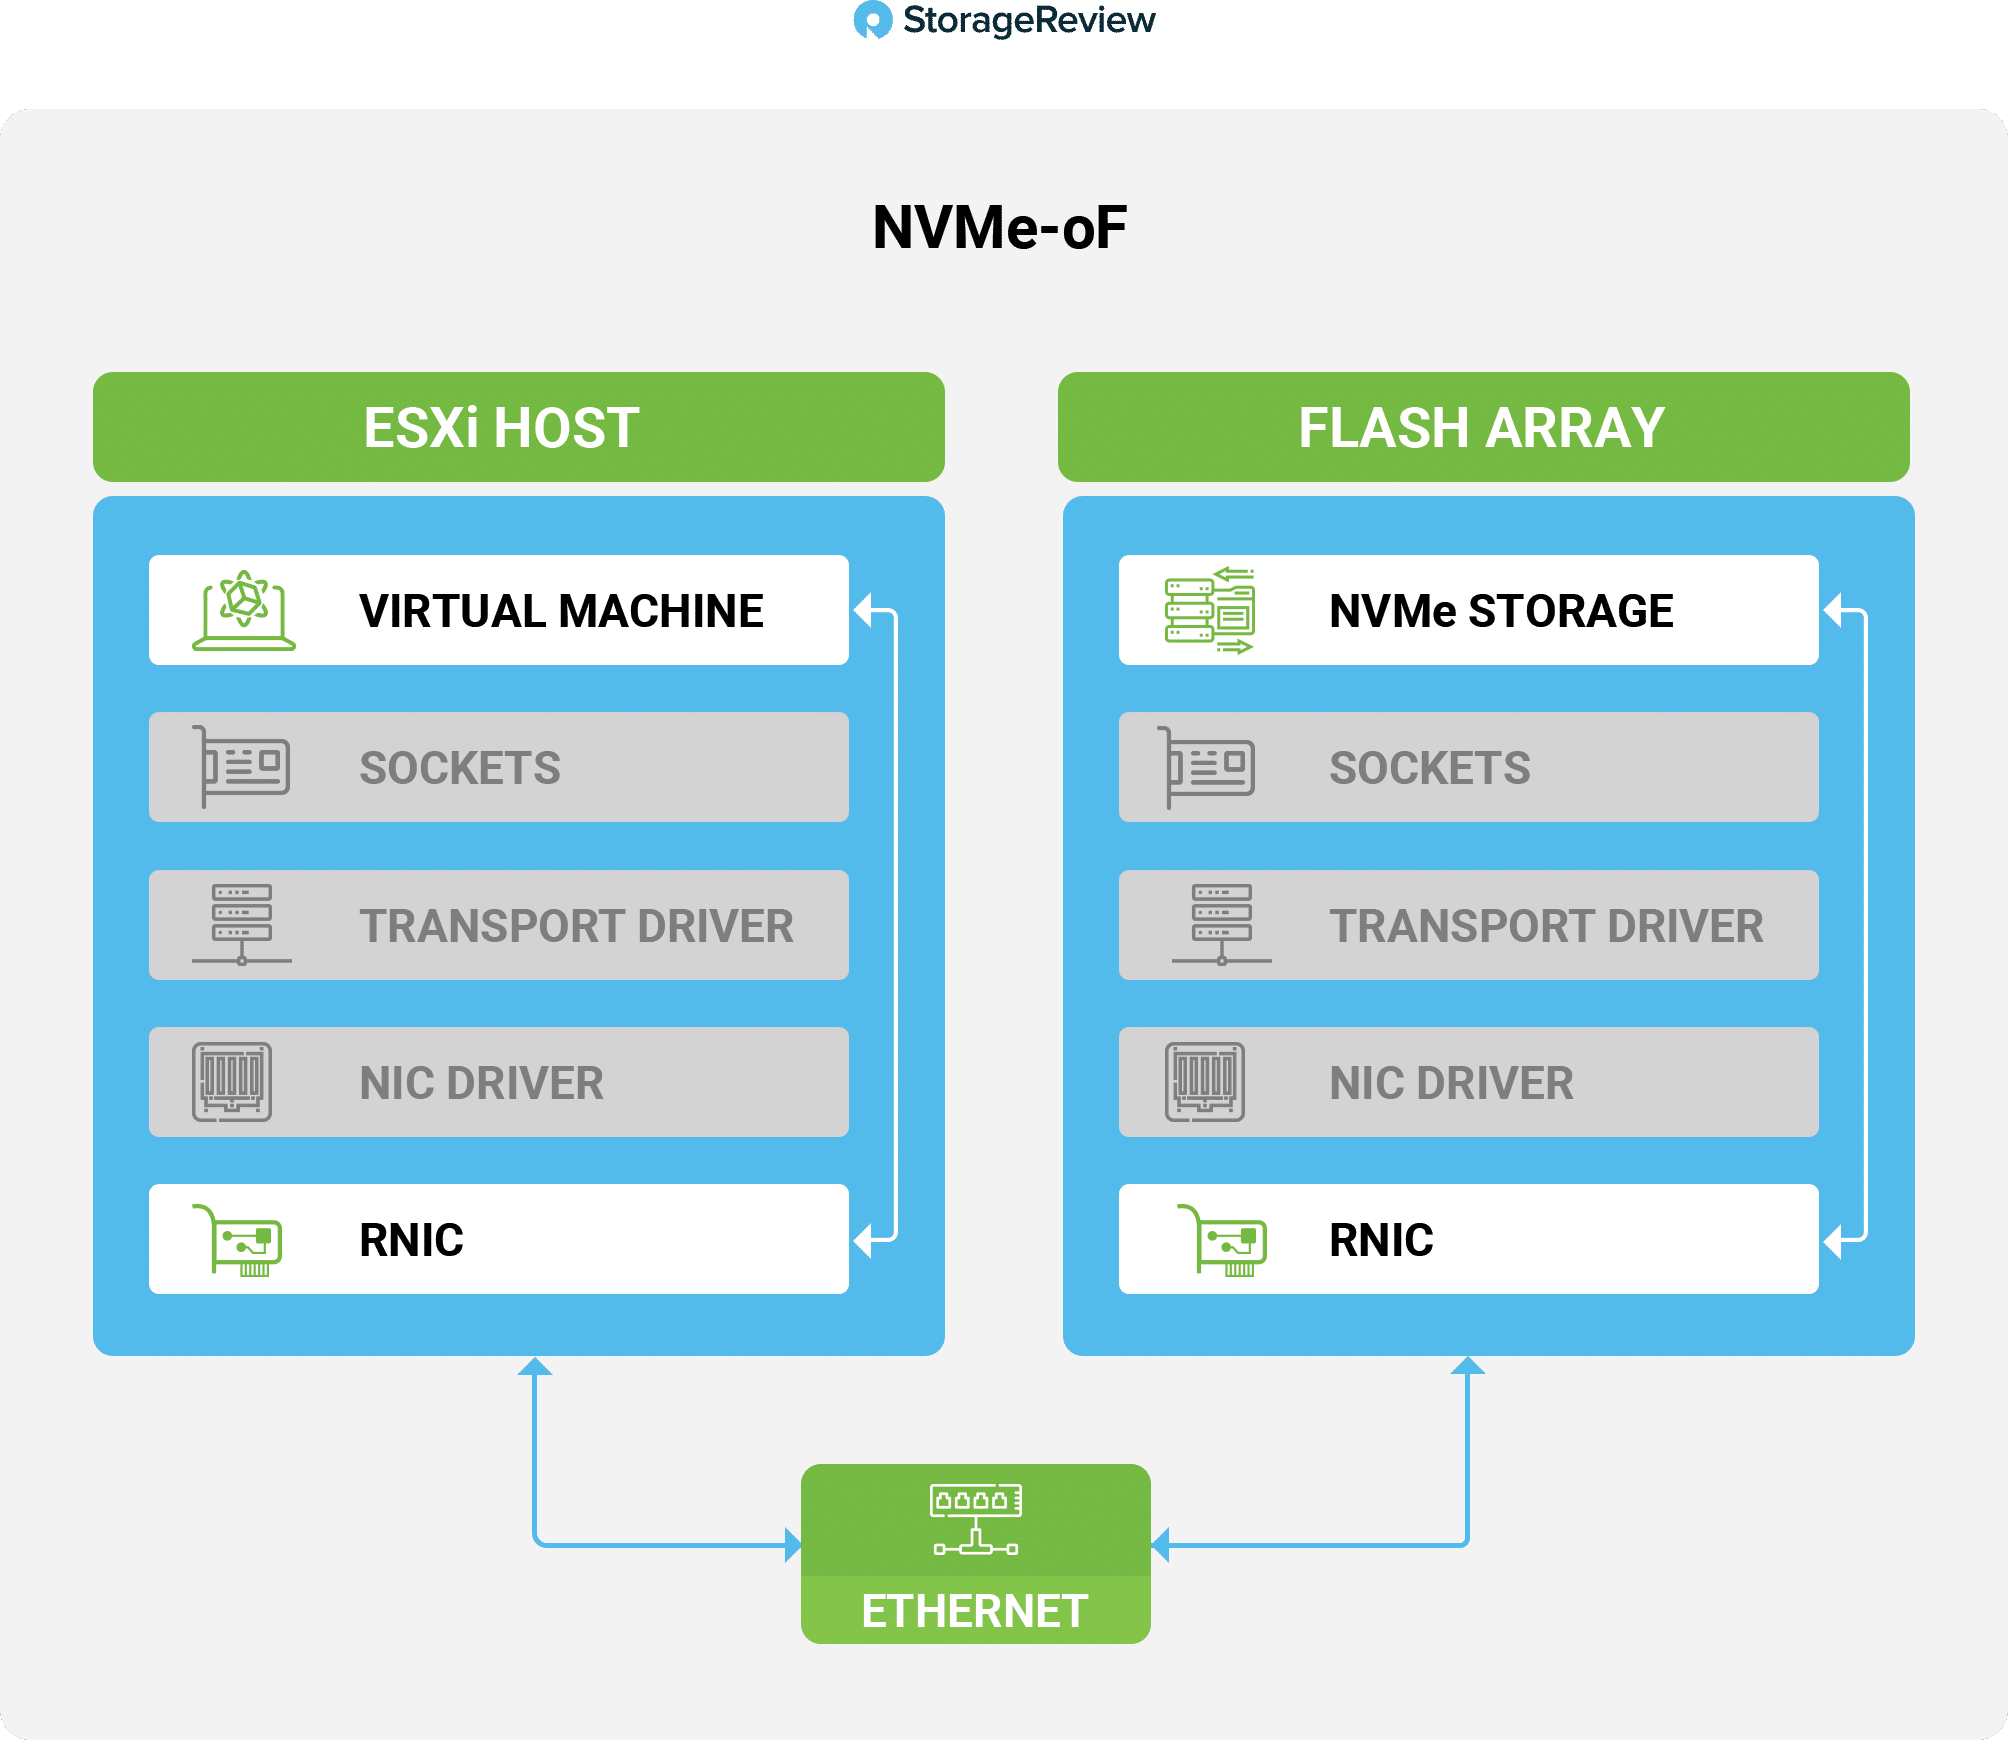
RoCE は UDP を使用します。UDP は必要なオーバーヘッドが少ないため、パフォーマンスに影響を与えます。ただし、RoCE は完全なロスレス接続を提供するためにエンドツーエンドの互換性に依存しています。最新のネットワーク スイッチはロスレス接続をサポートしていますが、ロスレス接続をサポートしていない古いスイッチが NVMe-oF のネットワーク パスに存在しないように注意する必要があります。
これらすべての結果として、NVMe-oF により、アクセスするサーバーに対してローカルであるかのように、ネットワークの NVMe ドライブにアクセスできるようになります。初期のレポートでは、プールされたストレージのレイテンシは、iSCSI オールフラッシュ ストレージ アレイの 100 μs 以上ではなく、約 500 μs であることが示されています。
vSphere を使用した NVMe-oF
vSphere での NVMe-oF の要件は単純です。
- RDMA (RoCE) トランスポートをサポートする NVMe アレイ
- 互換性のある ESXi ホスト
- ロスレスネットワークをサポートするイーサネットスイッチ
- RoCEをサポートするネットワークアダプター
- ソフトウェアNVMe over RDMAアダプター
- NVMeコントローラー
- レイヤ 2 とレイヤ 3 の両方でロスレス ネットワーク、または NVIDIA の ZTR (Zero Touch RoCE) ソリューションを使用したロスレス ネットワーク
- NVMe ターゲットへの専用リンク、VMkernel、RDMA アダプター
- 専用のレイヤー 3 VLAN またはレイヤー 2 接続
NVMe-oF は VMware にとって新しいものであるため、vSphere のすべての機能が利用できるわけではありません。不足している機能としては、共有 VMDK、Raw Device Maps (RDM)、vVol のサポート、NVMe-oF から起動する機能などがあります。
NVMe-oFの実装
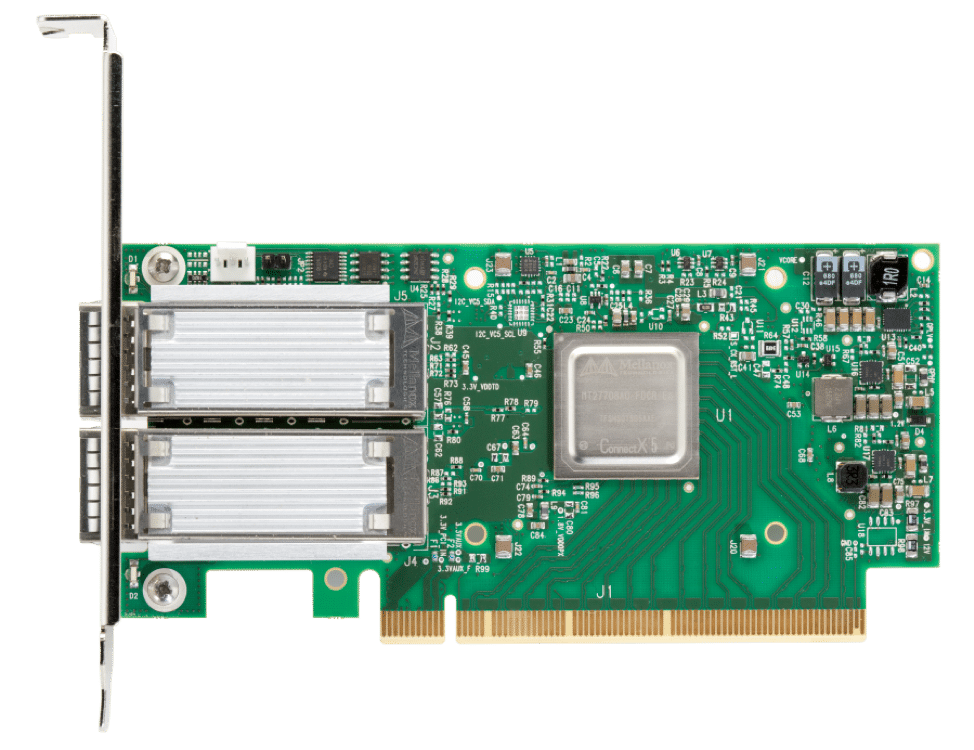
データセンターで最も一般的なカードの 5 つである NVIDIA の ConnectX-3.0 rNIC を使用しました。これらのカードは、RDMA 対応のシングル ポートまたはデュアル ポート ネットワーク アダプタです。これらは PCIe Gen 4.0 および Gen 1 サーバーで使用でき、10、25、40、50、100、および 750 Gb をサポートします。遅延は 200ns で、XNUMX 秒あたり最大 XNUMX 億のメッセージを送信できます。ストレージ ワークロードで使用すると、幅広いアクセラレーション テクノロジがサポートされます。
テストでは、NVIDIA の Spectrum SN3.0 スイッチのペアを介して Pure Storage フラッシュ アレイに接続されたネットワーク上の、Dell R5 サーバーのペアで 25GbE の PCIe Gen 720 ConnectX-2010 カードを実行しました。
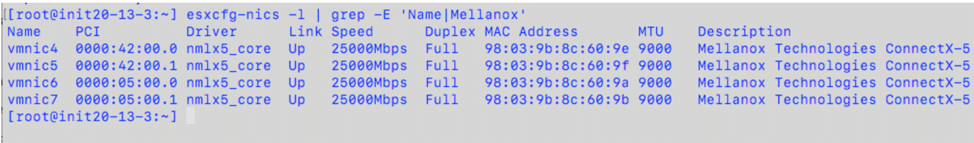
まず、esxcfg -nics -l |grep -E 'Name|NVIDIA'と入力して、nmlx5_core ドライバーが実行されていることを確認しました。
nmlx4_core ドライバを実行している場合は、ESXi CLI から RoCE を有効にすることができました。
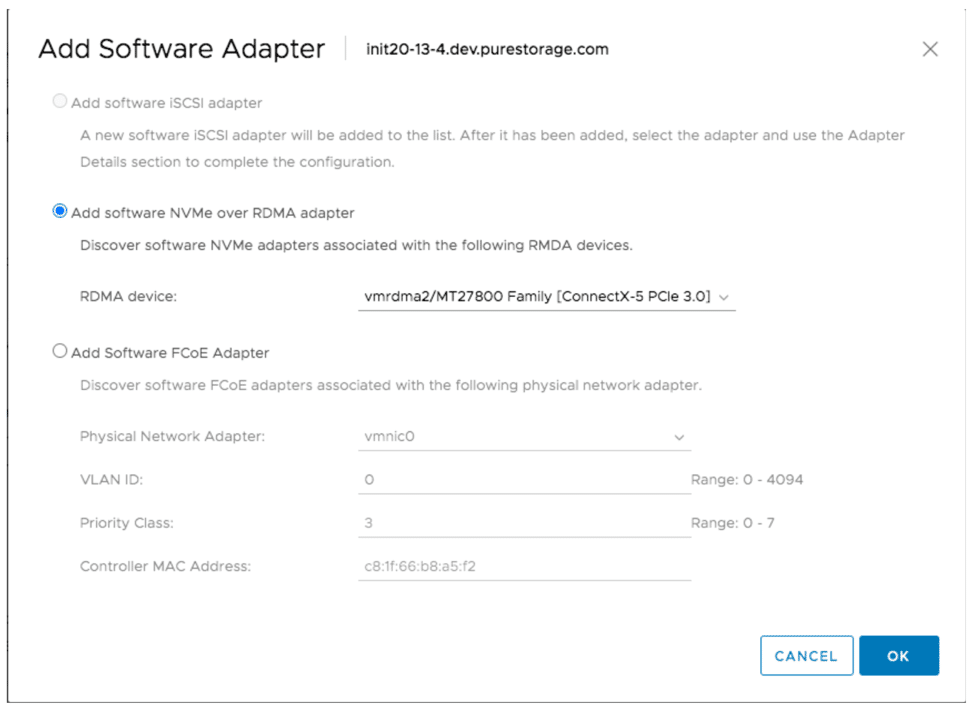
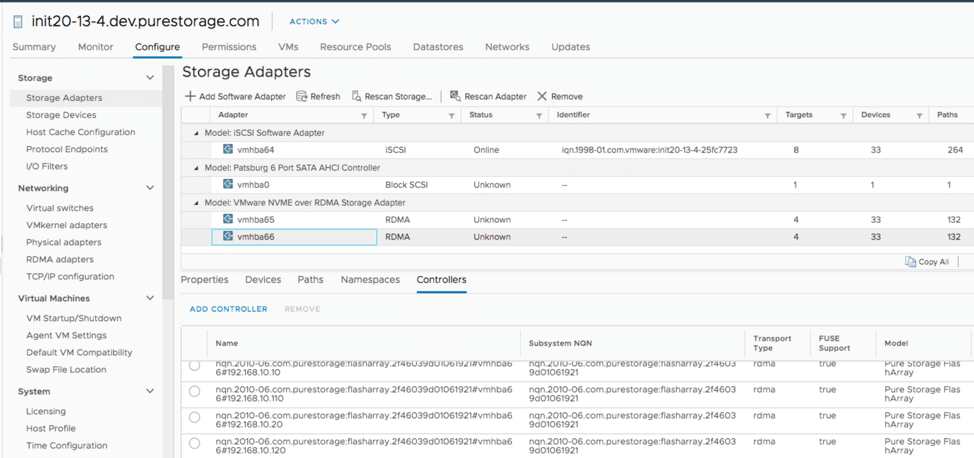
NVMe-oF を有効にするプロセス (iSCSI を設定して有効にするプロセスと同様) には、ESXi ホスト上の vSwitch、ポート グループ、および VMkernel ポートの構成が含まれます。主な違いは、各 ESXi ホストに少なくとも 2 つのソフトウェア NVMe over RDMA アダプタを追加する必要があることです。
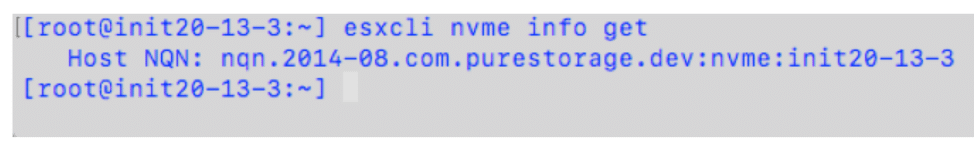
最後に完了する必要があった手順は、 esxcli nvme info getと入力して ESXi ホストの NVMe 修飾名 (NQN) を特定することでした。
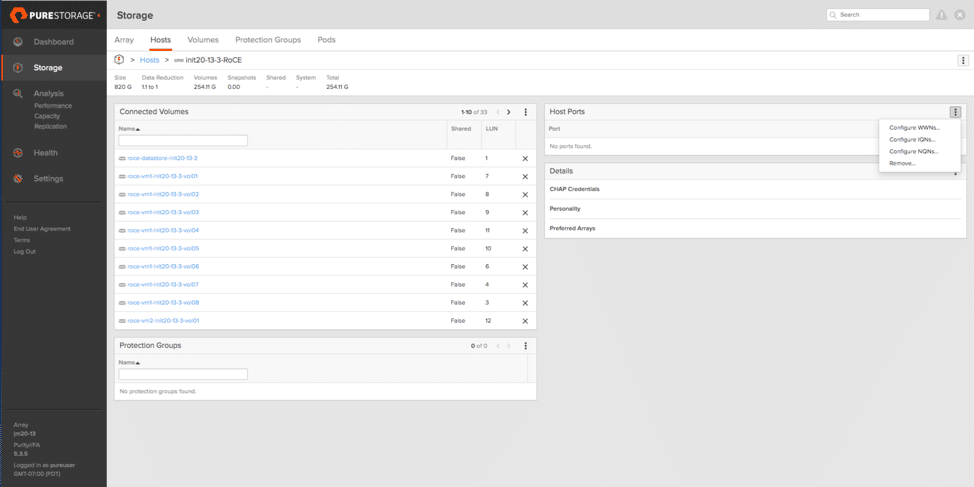
Pure Storage アレイでは、iSCSI アレイの設定と似ていましたが、大きな例外が 1 つありました。NQNの構成を選択する必要がありました。
vSphere による NVMe-oF のテスト結果
このテストでは、生地を除いてすべてを一定に保ちました。私たちが評価したいのは、より伝統的な iSCSI から RoCE への移行の影響です。明確にしておきますが、これはストレージのベンチマーク演習ではありません。これは、ほとんど変更を必要としない VMware 環境における NVMe-oF の利点を調べるための検査です。 2 台の Dell EMC PowerEdge サーバーと、ストレージ バックエンドとして Pure FlashArray//X RXNUMX を使用しました。
私たちのテスト計画には、8 つの VM (各 ESXi ホストに 4 つ) の合計パフォーマンスを測定することと、vdBench を使用して従来の 64 コーナーと混合ワークロードを測定することが含まれていました。各 VM は 512 GB のストレージを消費し、プロトコルの変更に伴うパフォーマンスの変化を比較するために利用できるワークロードあたりの合計フットプリントは XNUMX GB でした。
これらの結果を解釈するには、スループットの場合は改善する方が良いのに対し、レイテンシの場合は減少させる方が良いことに注意してください。
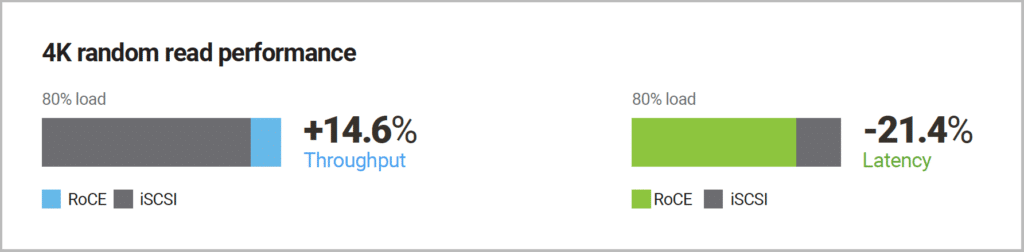 4% の負荷で 80K ランダム読み取りパフォーマンスを測定した最初のワークロードでは、スループットが 14.6% 増加し、読み取りレイテンシが 21.4% 低下したことが測定されました。
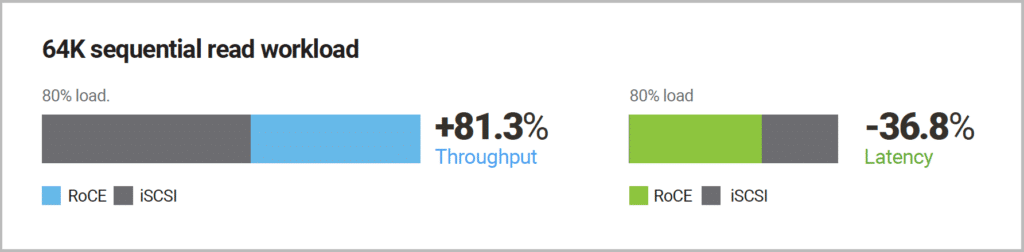 次に、64K シーケンシャル読み取りワークロードの読み取り帯域幅を確認すると、やはり負荷 81.3% で、スループットが 36.8% 向上し、レイテンシが 80% 減少したことがわかりました。
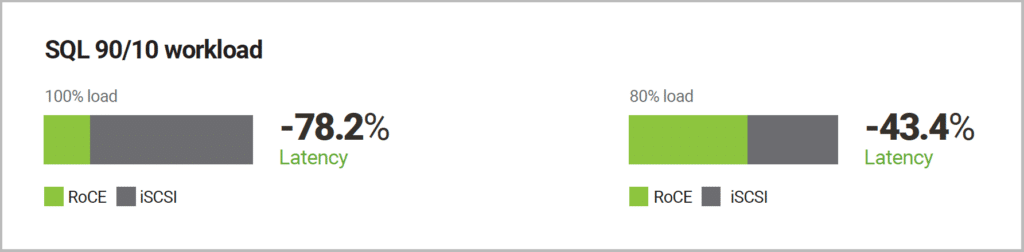 測定された最大の向上は読み取りワークロードでしたが、いくつかの一般的な混合ワークロードも調べました。最初のワークロードは SQL 90/10 でした。このワークロードでは、78.2% 負荷でレイテンシが最大 100% 減少し、43.4% 負荷でレイテンシが 80% 低下することが測定されました。
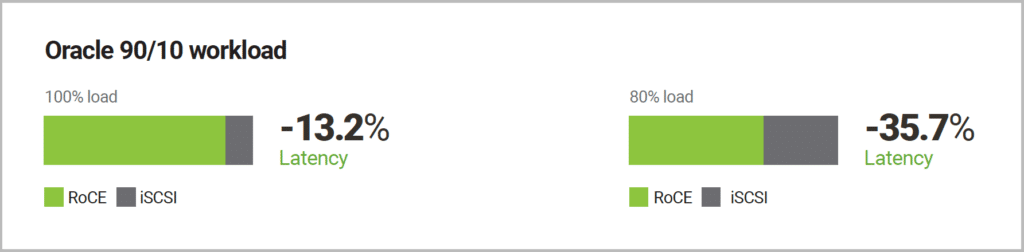 最後に、Oracle 90/10 ワークロードでは、13.2% 負荷でレイテンシが 100% 低下し、35.7% 負荷でレイテンシが 80% 低下しました。
このテストでは、明らかに RoCE は企業内で一般的な幅広いワークロードにわたって大幅な改善を示しました。
結論
私たちのテストでは、現実世界における NVMe-oF が単なる概念ではないことが証明されました。 NVMe-oF は、Gen 3.0 PCI スロット、NVIDIA の ConnectX-5 NIC、Pure Storage FlashArray//X R2 を備えたサーバーなど、データセンターの現在のハードウェアを使用して優れたパフォーマンスを提供できます (Pure は現在、さらに優れた機能を備えた //X R3 を出荷しています)パフォーマンスの向上)。
私たちのテストでは、小さなブロックと大きなブロックの読み取りワークロードで大幅な向上が見られました。ほとんどのワークロードは基盤となるストレージ プラットフォームを完全に飽和させていないため、実際の影響を確認するために、ワークロードの飽和度が 100% 未満であることに焦点を当てました。 4K ランダム読み取りパフォーマンスを測定したテストでは、21.4% のワークロードでレイテンシーが 80% 減少しました。 64K ワークロードでのシーケンシャル読み取りパフォーマンスでは、81.3% の負荷でスループットが 80% 大幅に向上しました。また、SQL 43.4/35.7 ワークロードと Oracle 90/10 ワークロードでは、やはり 90% の負荷でレイテンシがそれぞれ 10% と 80% 低下しました。これらの数字は、要求の厳しいベアメタル ワークロードを VMware に移行する追加の機会があることを示しています。
私たちは、NVMe-oF がストレージ テクノロジの次の目玉になると確信しており、データ センターでの人気が急速に広まると予想しています。当社は、今後数年間にわたってこのカテゴリが発展する中で最前線に立ち、他のおよび隣接する NVMe テクノロジーがリリースされ次第調査することを楽しみにしています。
追加情報について:
このレポートは NVIDIA の後援を受けています。このレポートで表明されているすべての見解や意見は、検討中の製品に対する当社の公平な見解に基づいています。


 Amazon