

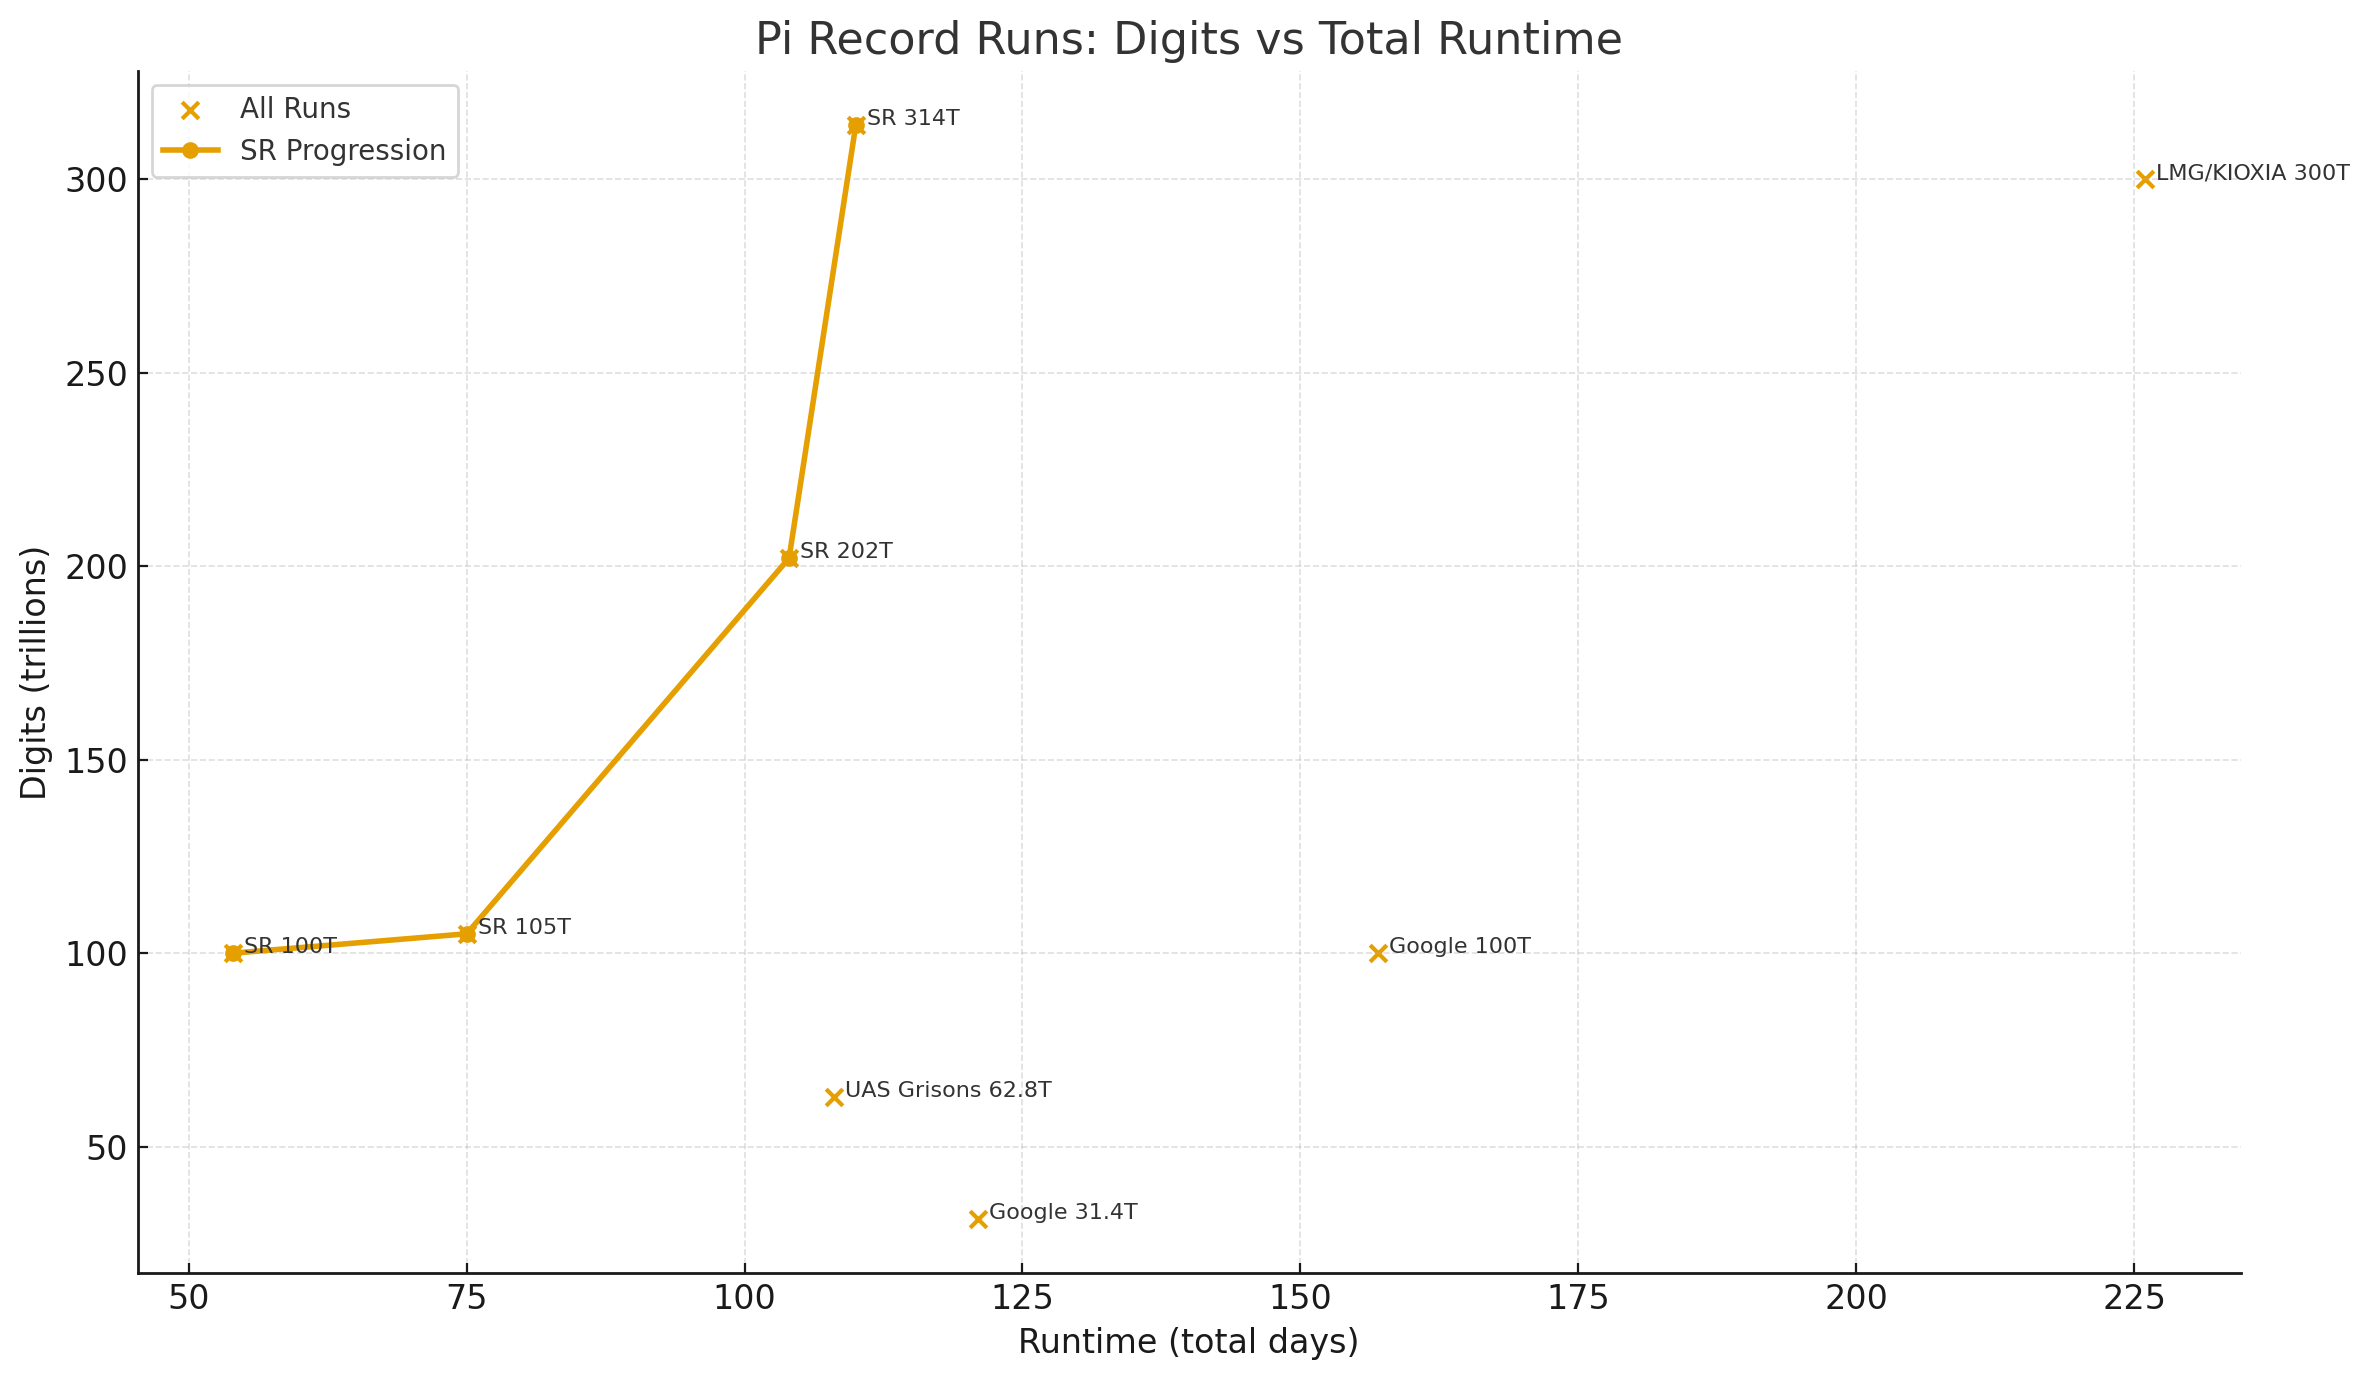
StorageReviewは、円周率の新たな記録を314兆桁まで解き、人気の計算技術の王座を奪還しました。現代の円周率競争は、クラウド実験から本格的なインフラの柔軟性へと移行しました。2022年、Google Cloudは円周率を100兆桁まで押し上げ、膨大なクラウドインスタンス群でy-cruncherを実行し、その過程で数十ペタバイトのI/Oを処理しました。この記録は、従来のインフラで「どこまで可能か」を示す重要な数字となりました。
その後、活動の舞台はラボへと移りました。2024年初頭、約1ペタバイトのSolidigm QLC SSDを搭載したシステムで、記録を105兆桁にまで引き上げました。この成果はスケールの新たなベンチマークとなり、オンプレミスのマシン1台がいかに効率的に動作できるかを実証しました。数か月後、再び同じ成果を上げ、今度は202兆桁を達成しました。これにより、高密度フラッシュと綿密なチューニングによって、この特定の高負荷ワークロードにおいてハイパースケールインフラストラクチャを上回るパフォーマンスを発揮できることが実証されました。
もちろん、記録は挑戦者を呼ぶものです。Linus Media GroupとKIOXIAは、2PBのフラッシュを搭載した大規模なWeka共有ストレージクラスタを活用し、300兆桁の演算処理で王座を獲得しました。この成果は、ハードウェアラックの設置、高額な電力コスト、そして複雑な冷却システムといった制約はあるものの、ストレージを多用する従来のインフラストラクチャで何ができるかを示しました。私たちは、この記録を黙って見過ごすわけにはいきませんでした。

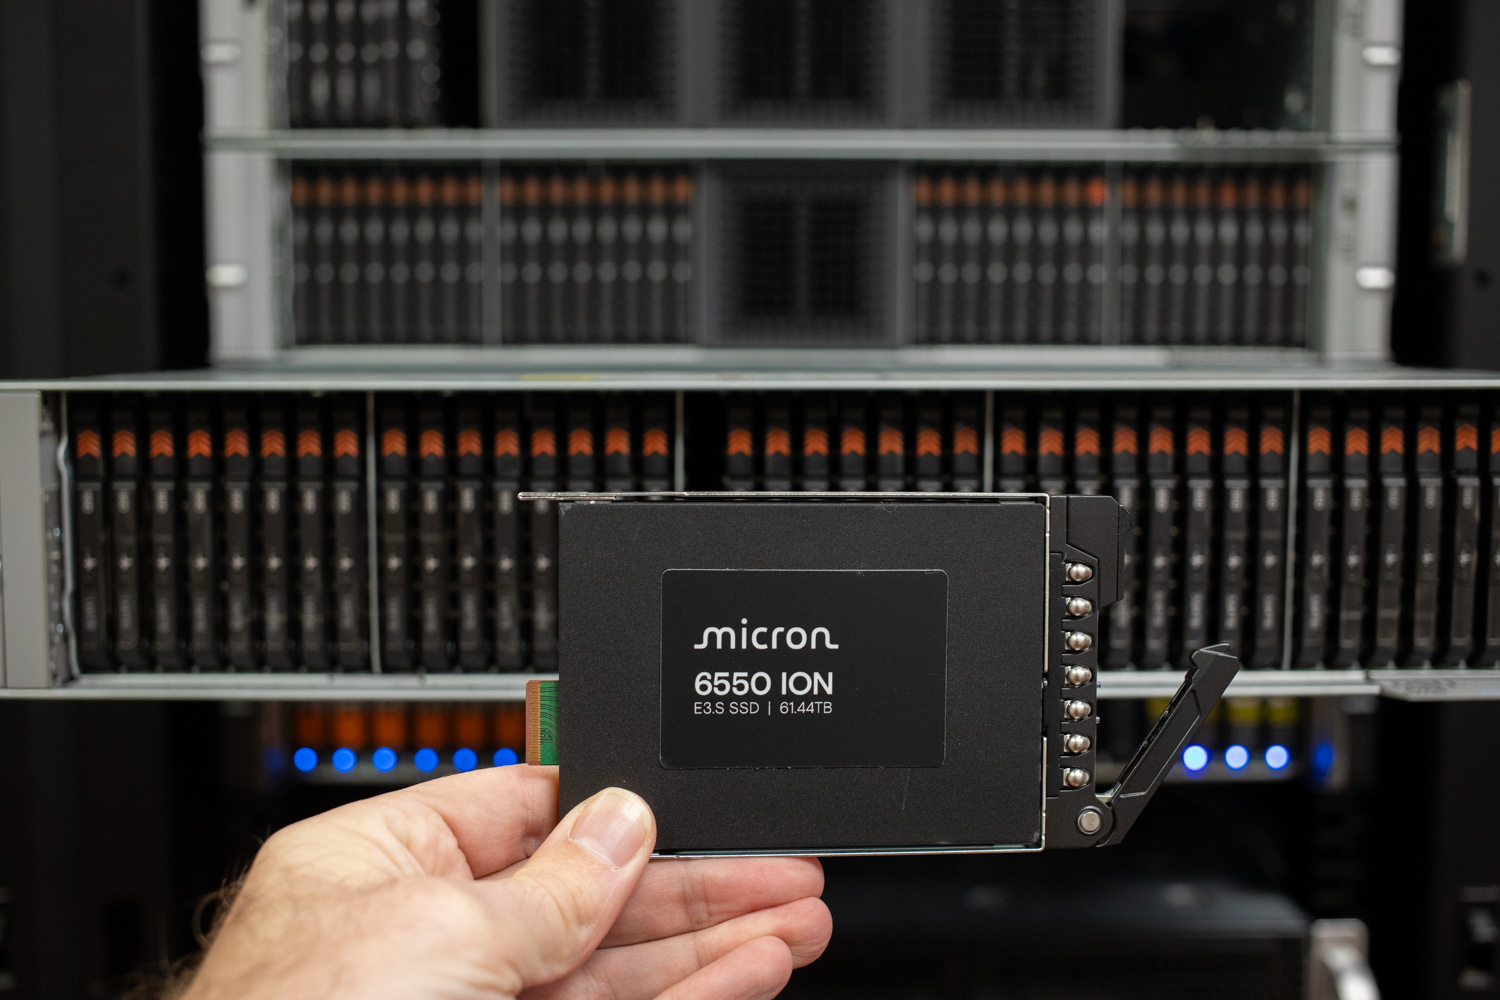
StorageReview は、デュアル AMD EPYC 192 コア CPU と 40 台の 61.44 TB Micron 6550 Ion SSD を搭載した単一の 2U Dell PowerEdge R7725サーバーを使用して、π を 314 兆桁まで拡張しました。システムの構築と調整は 7 月に行われ、実行は 2025 年 7 月 31 日に開始されました。幸運なことに、π の実行は SC25 の 2 日目に終了し、新しい HPC 記録にふさわしいものとなりました。
y-cruncherを314兆桁まで拡張
数百兆桁を超えると、y-cruncher は従来のベンチマークというより、長距離インフラストラクチャのストレステストのように動作します。アプリケーション自体は単純ですが、この規模でハードウェアと対話する方法が決定的な要素になります。すべては、システムが CPU を停止させたりストレージ層に過大な負荷をかけたりすることなく、何千もの多精度演算をどれだけうまく進めることができるかにかかっています。具体的には、ストレージ層こそが、この記録が実際に達成された場所です。40 台の Micron 6550 Ion Gen5 NVMe SSD を展開し、そのうち 34 台を y-cruncher に割り当てました。この SSD プールは約 2.1 ペタバイトを提供し、y-cruncher が 314T の実行を実行するのに十分なスペースを提供しました。残りの 6 台の SSD はソフトウェア RAID10 ボリュームを構築するために使用され、これを使用して 314T 桁の円周率を記録しました。
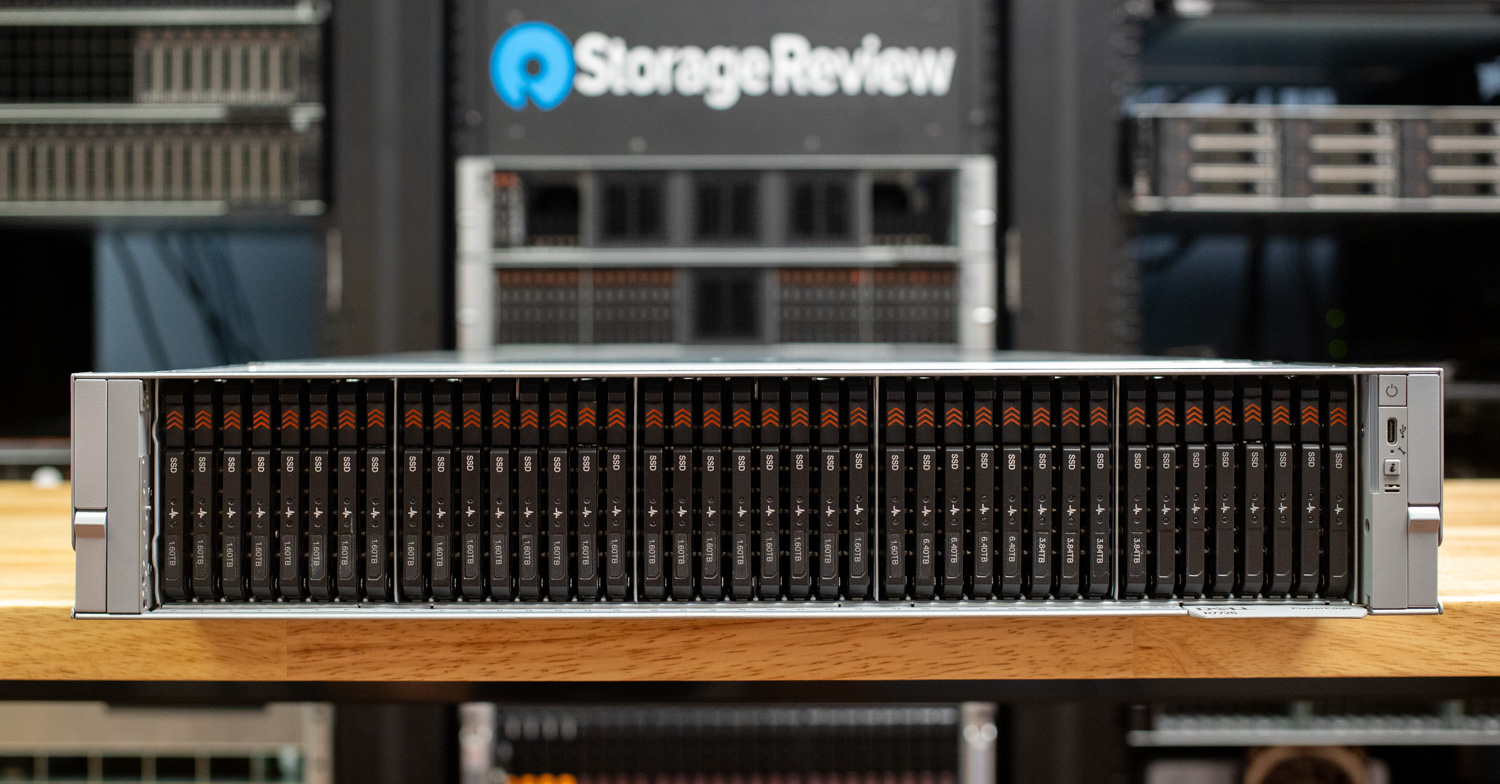
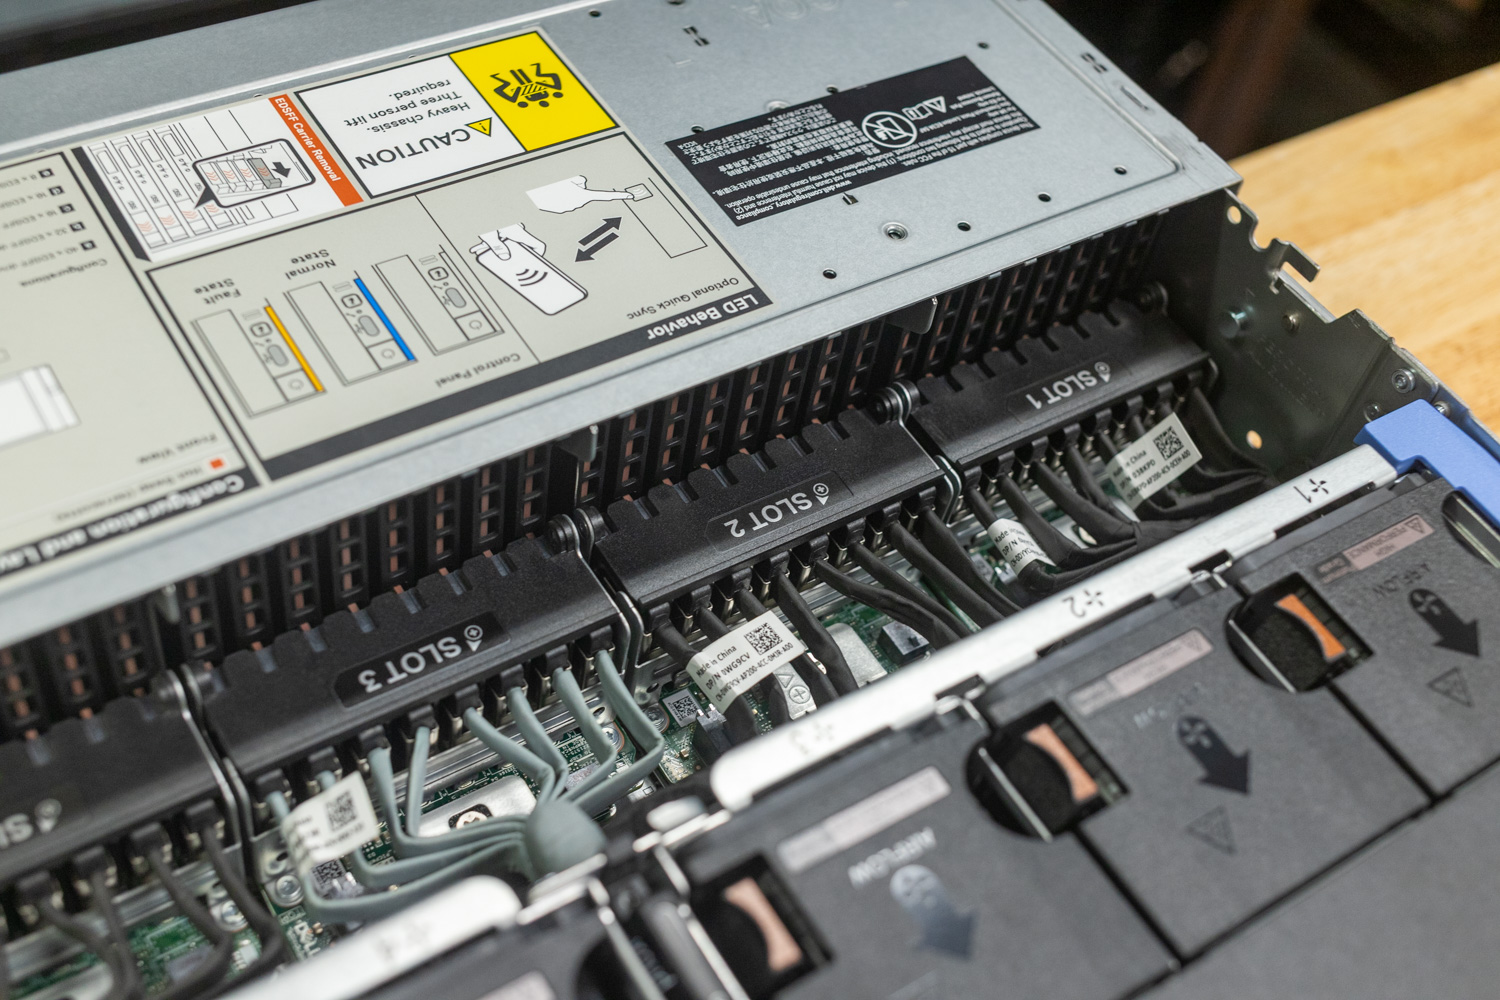
第 16 世代と第 17 世代の Dell PowerEdge サーバー間の設計変更も、最新の 314T 記録実行のパフォーマンス向上に貢献しています。以前の 202T 記録では、ドライブ バックプレーンで PCIe スイッチを使用する 24 ベイの Dell PowerEdge R760 を活用し、ドライブ密度と引き換えにパフォーマンスを実現していました。Intel ベースの R770 や AMD ベースの R7725 などの第 17 世代 Dell PowerEdge サーバーでは、バックプレーンは直接接続のみに戻り、ベイあたり 2 つまたは 4 つの PCIe レーンを備えています。40 ベイの Gen5 E3.S バックプレーンを備えた PowerEdge R7725 では、各 SSD に 2 つの PCIe レーンが割り当てられています。これはパフォーマンスの低下のように思われるかもしれませんが、40 ベイすべてに同時にアクセスした場合でも、プラットフォームは最大 280GB/秒の読み取りおよび書き込み速度を実現できます。
社内のy-cruncherストレージベンチマークを使用し、各実行で使用した構成における各プラットフォームのストレージパフォーマンスを記録しました。各ワークロードにおいて、ストレージパフォーマンスは72%から383%向上し、読み取りと書き込みのメトリクスのバランスも良好でした。
| メトリック | 202Tシステム(旧記録) | 314Tシステム(新記録) | パーセント差(314T vs 202T) |
|---|---|---|---|
| シーケンシャルライト | 47.0 GiB/秒 | 107 GiB/秒 | + 127.7% |
| シーケンシャルリード | 56.7 GiB/秒 | 127 GiB/秒 | + 124.0% |
| しきい値ストライド書き込み | 62.2 GiB/秒 | 107 GiB/秒 | + 72.0% |
| 閾値ストライド読み取り | 20.9 GiB/秒 | 101 GiB/秒 | + 383.3% |
Dell PowerEdge R7725は単なるストレージボックスではありません。デュアルソケットAMD Turinプラットフォームとして、優れたコンピューティング能力も備えています。192コアのAMD EPYC 9965 CPUを搭載し、合計384コアを実現しました。また、標準の空冷ヒートシンクを水冷式のCoolIT SP5コールドプレートに交換し、CoolIT AHx10 Liquid-to-Air CDUで冷却しました。この組み合わせにより、CPUの持続クロック速度を高く維持し、シャーシファンを約30%のPWMで動作させ、平均システム消費電力を約1,600Wに抑えることができました。
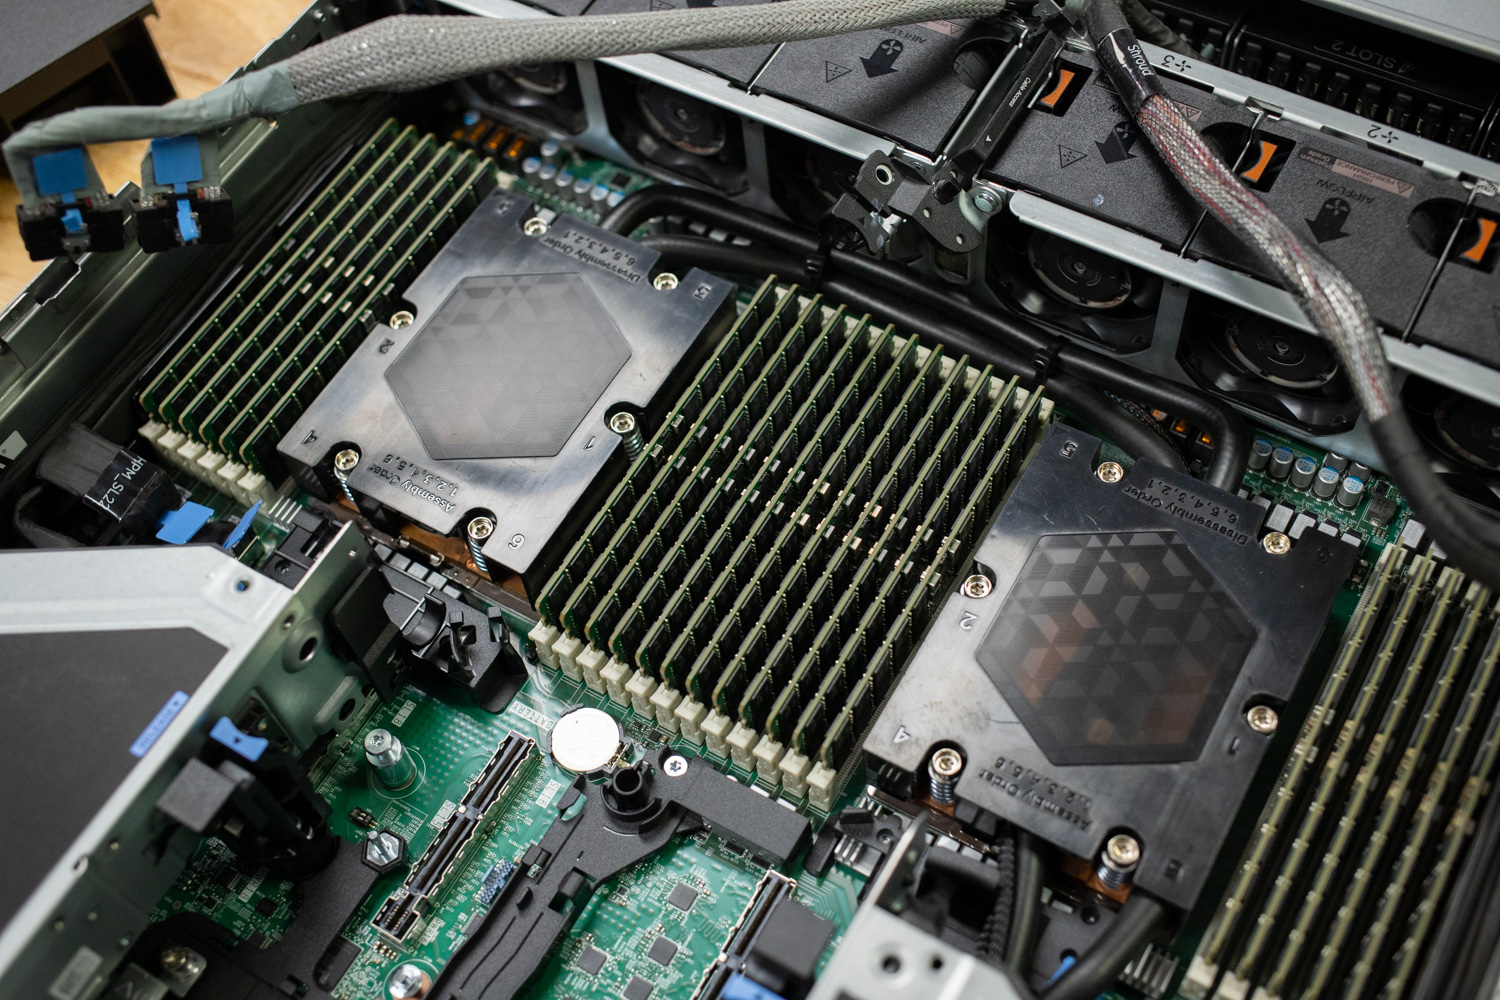
ソフトウェア面では、過去の実行ではWindows ServerではなくUbuntu 24.04.2 LTS Serverを使用しました。これによりシステムの安定性が最大限に高まり、ワークロードのパフォーマンスが大幅に向上しました。実行開始前に、384コアのうち4コアをバックグラウンドシステム操作用に予約するなど、数多くのテストを繰り返し実施しました。その結果、既存のPi記録を破っただけでなく、数々の指標でそれを凌駕する記録を達成しました。パフォーマンス、消費電力、そして何よりも印象的な信頼性において、私たちの実行に匹敵するものはありません。また、大規模なPi世界記録実行において、1秒たりともダウンタイムを生じさせなかったのは私たちの実行だけです。実行開始から終了まで、一度も再開する必要はありませんでした。
記録的な電力効率
StorageReview が円周率記録の各実行で採用してきたアプローチは、複雑さを軽減し、必要最小限の電力でベンチマークを実行することです。以前の 300T 記録は、分散ストレージ クラスターと高速ネットワークを活用したもので、より大きな電力と冷却要件を犠牲にしました。私たちは別の方法を採用し、ストレージ密度に重点を置き、スワップと出力の両方のストレージに単一の 2U サーバーを使用しました。これは、全体的な電力と冷却のフットプリントを削減する上で重要な役割を果たしました。Dell PowerEdge R7725 は、314T 実行中の消費電力はわずか 4,304.662 kWh で、1 兆桁あたりわずか 13.70 kWh に相当します。これは、大規模円周率計算の中で最もエネルギー効率の高いものの 1 つであることを示しています。2 つのアプローチを比較すると、下の表に示すように、その違いはすぐに明らかになります。
| ラン | 総kWh | コスト @ 0.12ドル/kWh | コスト @ 0.20ドル/kWh |
|---|---|---|---|
| 300T Weka クラスターラン | 33,600kWh(推定) | $4,032 | $6,720 |
| 314T シングルサーバー実行 | 4,304.662キロワット | $517 | $861 |
計算中、314Tの実行ではデータ復元力のないJBOD構成のSSDを使用したことに留意することが重要です。消費電力とシステム全体のパフォーマンスがこの決定につながった要因でしたが、ワークロードに合わせてストレージソリューションを設計するという議論も生まれました。ワークロードはそれぞれ異なり、本番環境への影響を最小限に抑えて再起動できるワークロードでも、必ずしも同等のフォールトトレランスレベルを必要としない場合があります。今回のケースでは、従来のソフトウェアRAIDを使用してデータ出力を保護することに重点を置きました。
総実行時間110日間
これまでのどの実行よりも多くの桁数を計算したにもかかわらず、実測時間は以前の記録(完了までに約225日(ダウンタイムを除く175日))を大幅に下回りました。110日間の中断のない実行時間は、安定したOS、最小限のバックグラウンド負荷、バランスの取れたNUMAトポロジ、そしてこの規模でy-cruncherが生成するパターンに合わせて設計されたスクラッチアレイによって実現しました。
技術的なハイライト
- 計算された合計桁数314,000,000,000,000年
- 使用したハードウェア: Dell PowerEdge R7725、AMD EPYC 9965 CPU 2基、1.5TB DDR5 DRAM、Micron 61.44TB 6550 Ion 40基
- ソフトウェアとアルゴリズム: y-cruncher v0.8.6.9545、Chudnovsky
- SMARTごとのSSD摩耗: ドライブあたり7.3PB書き込み、またはスワップ用に使用される34台のSSD全体で249.11PB
- 論理的に最大のチェックポイント: 850,538,385,064,992 (774 TiB)
- 論理ピークディスク使用量: 1,605,960,520,636,440 (1.43 PiB)
- 論理ディスクの読み取りバイト数: 148,356,635,606,263,504 (132 PiB)
- 論理ディスクに書き込まれたバイト数: 126,658,805,195,776,600 (112 PiB)
- 開戦日: 2025年7月31日(木) 17:16:41
- 終了日: 2025年11月18日火曜日 05:57:08
- 円周率: 8793223.144秒、101.773日
- 合計計算時間:9274878.580秒
- 開始から終了までの所要時間:9463226.454秒
閉じた思考
数十年にわたり、エクストリームπ実行は、当時「ビッグアイアン」と呼ばれていたものを誇示する手段でした。初期の記録は高性能デスクトップと外付けストレージに依存していましたが、その後、ローカルのエンタープライズ機器へと移行しました。近年では、競争はクラウドへと移り、Googleの100兆桁実行のようなジョブは、十分なインスタンス数と十分なI/Oがあれば、総当たり方式で記録を達成できることを実証しました。その後、大規模な共有ストレージクラスターが登場し、シンプルさは犠牲になり、粗雑な並列処理と莫大な電力・冷却コストが伴うようになりました。
私たちのアプローチは正反対の方向に進みました。複数回の記録達成を経て、y-cruncherを単発の試みではなく、本格的なHPCワークロードとして扱うようになりました。105Tと202Tのソリューションは、真のボトルネックを特定し、スクラッチストレージのサイズとチューニングを行い、I/O層を酷使することなくCPUへの負荷を維持し、数ヶ月かかるジョブを実際に完了させるシステム強化に役立ちました。314Tの実行は、こうした経験の成果です。単なる数値の増加ではなく、より成熟した設計と言えるでしょう。
測定結果がそれを裏付けています。40基のMicron 6550 Ion SSDとデュアル192コアAMD EPYC CPUを搭載した2U Dell PowerEdge R7725(1基あたり300兆桁)を突破し、システムを110日間連続オンライン状態に維持し、いかなる障害からも復旧させる必要は一度もありませんでした。ストレージスループットは202Tプラットフォームと比較して2倍以上向上しましたが、サーバーの平均消費電力は約1,600Wで、総消費電力は4,305kWhでした。これは1兆桁あたり13.70kWhに相当し、従来の300Tクラスターの推定消費電力のほんの一部に過ぎません。つまり、ノード数が少なく、複雑さが軽減され、消費電力も少なく、処理能力は向上したのです。
だからこそ、この記録は単なる自慢以上の意味を持つのです。商用2Uサーバー1台で、これほどの規模のY-Cruncherを、これほどの信頼性と効率性で稼働させられるのであれば、同じ設計パターンをそのまま生産科学に応用できるのです。長期稼働の気候モデル、物理シミュレーション、ゲノミクスパイプライン、AIトレーニングジョブはすべて、バランスの取れたI/O、予測可能な温度、安定したファームウェア、そして数ヶ月間も稼働し続けられるアーキテクチャという、同じ基本原理の上に成り立っています。このプラットフォームは、エラーが許されない条件下でも、まさにそれを実現できることを証明しました。
はい、StorageReviewが314兆桁という記録で円周率の王座を奪還しました。さらに重要なのは、実ハードウェア上での大規模数値計算において「良い」とは何を意味するのかという基準を設定したことです。もし誰かがこの記録を破りたいのであれば、桁数の増加、消費電力の削減、処理時間の短縮、そしてダウンタイムゼロの信頼性といった、全てを網羅した記録を樹立してほしいと思っています。それまでは、これが効率性のベンチマークとなるでしょう。


 Amazon