

세레브라스 시스템즈(Cerebras Systems)는 최첨단 학습 및 고동시 추론 워크로드에 최적화된 웨이퍼 스케일 AI 슈퍼컴퓨팅 플랫폼 4세대인 CS-4 를 공식 출시했습니다. 이 시스템은 새롭게 개발된 3개의 WSE-3(Wafer Scale Engine 3) 터보 프로세서를 중심으로 설계되었으며, 넥서스(Nexus)라는 완전히 새로운 랙 스케일 플랫폼에 탑재되어 있습니다. 세레브라스는 CS-4가 GPU 기반 솔루션보다 최대 30배 빠른 추론 성능을 제공한다고 주장하며, 이는 GPT-OSS-120B 테스트 결과를 바탕으로 합니다 . 해당 테스트에서 사용자당 초당 4,400개 이상의 토큰을 처리했으며, 이전 세대 CS-3 대비 와트당 처리량이 10배 증가했다고 밝혔습니다.
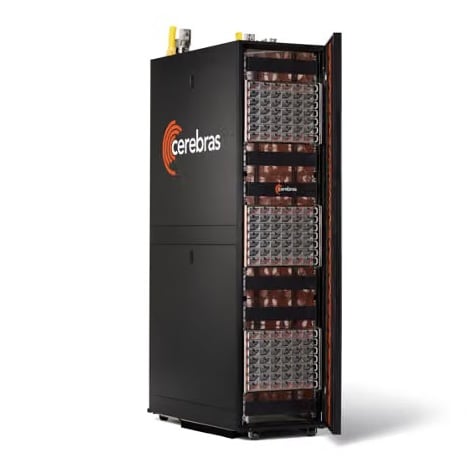
CS-4는 개별 멀티노드 GPU 클러스터에 내재된 시스템적 확장성 한계를 해결하도록 설계되었습니다. 이러한 클러스터에서는 칩 간 통신, 전력 변환 손실 및 열 제한으로 인해 지속적인 컴퓨팅 효율성이 저하되는 경우가 많습니다. Cerebras는 추론 워크로드 스펙트럼의 양극단을 모두 지원할 수 있도록 플랫폼을 구축했습니다. 복잡한 에이전트 워크플로우와 대화형 추론에 필요한 밀리초 미만의 응답 시간을 제공하는 동시에 하이퍼스케일러가 기가와트당 컴퓨팅 밀도를 극대화하는 데 필요한 총 용량을 제공합니다.
상호 연결 패브릭 개선은 플랫폼의 멀티프로세서 확장 기능의 핵심입니다. CS-4는 웨이퍼 간 상호 연결 지연 시간을 2마이크로초까지 낮춰 멀티웨이퍼 패브릭이 거의 단일체처럼 작동할 수 있도록 합니다. 이러한 초저지연 패브릭 덕분에 CS-4는 10조 개 이상의 파라미터를 가진 모델에서도 초당 1,000개 이상의 토큰 생성 속도를 유지할 수 있으며, 파라미터 수 증가로 인해 대화형 토큰 전달 속도가 심각하게 저하되었던 기존 성능 격차를 해소합니다.

넥서스 랙 아키텍처 및 웨이퍼 스케일 백팩
CS-4의 주요 엔지니어링 혁신은 독립적인 컴퓨팅, 전력 및 I/O 도메인을 중심으로 구축된 모듈식 랙 구현인 Cerebras Nexus 플랫폼 아키텍처입니다. 컴퓨팅 밀도는 새롭게 설계된 후면 장착형 웨이퍼 스케일 백팩을 통해 확보되며, 이 백팩은 주 전력 어레이에 수직으로 연결됩니다. 각 백팩은 칩 직접 냉각 매니폴드, 부하 지점 전력 변환 단계, 고속 네트워킹 경로 및 실리콘 웨이퍼 바로 뒤에 위치한 온보드 제어 전자 장치를 포함하는 독립형 장치입니다. 핵심 컴퓨팅 계층을 대규모 전력 분배 프레임에서 분리함으로써 Cerebras는 시스템 구성 요소 수를 50% 줄이고 자동 조립 속도를 60% 향상시키며 데이터 센터 구축 시간을 단 몇 시간으로 단축했습니다.

전력 공급 효율은 DC-to-DC 전압 조절 모듈을 일반적인 서버 보드 구현 방식보다 실리콘 경계에 100배 더 가깝게 재배치함으로써 향상되었습니다. 이러한 부하 지점 배치는 저항성 전력 분배 네트워크(PDN) 손실을 줄이고 Nexus 프레임이 각 WSE-3 Turbo 프로세서에 두 배의 전력을 공급할 수 있도록 하여 열 스로틀링 없이 더 높은 클럭 주파수를 지속적으로 유지할 수 있도록 합니다.

I/O 서브시스템은 프로그래밍 가능한 웨이퍼 I/O 모듈로 확장되어 에지 간 패브릭 대역폭을 두 배로 늘리는 동시에 전송 지연 시간을 줄였습니다. 시스템 네트워킹은 두 가지 모드로 작동합니다. 하나는 기존 엔터프라이즈 네트워킹 및 타사 가속기 노드에 저지연 패브릭 연결을 위한 표준 RoCE v2(RDMA over Converged Ethernet) 인터페이스이고, 다른 하나는 랙 내 및 랙 간 인접 시스템 간에 스위치 없이 직접 상호 연결 경로를 제공하는 독자적인 Direct Wafer Links입니다.
CS-4 및 WSE-3 터보 사양
| CS-4 시스템 | |
| 아키텍처 | 모듈형 컴퓨팅 백팩 3개가 포함된 액티브 파워 랙 |
| 웨이퍼 스케일 엔진 | 시스템당 WSE-3 터보 3개 |
| AI 컴퓨팅 | 750 PFLOPS* |
| 메모리 대역폭 | 129.6PB/초 |
| 온칩 패브릭 대역폭 | 160.5PB/초 |
| 입출력 대역폭 | 7.2Tbit/s |
| 입출력 지연 시간 | 2 마이크로 초 |
| WSE-3 터보 (웨이퍼당) | |
| 트랜지스터/실리콘 | 트랜지스터 4조 개; 46,225 mm2, TSMC 5nm |
| AI 코어 / 온칩 SRAM | 900,000만 개의 코어; 44GB SRAM |
| AI 컴퓨팅 | 250 PFLOPS* |
| 메모리 대역폭 | 43.2PB/초 |
| 온칩 패브릭 대역폭 | 53.5PB/초 |
| 입출력 대역폭 | 2.4Tbit/s |
| *AI 연산은 희소 FP16으로 표시됩니다. | |
분산 추론 및 가용성
CS-4는 아키텍처적으로 분산형 추론 토폴로지를 기본적으로 지원하도록 설계되었습니다. 기업 및 클라우드 환경에서 운영자는 AMD Helios 또는 AWS Trainium과 같은 특수 외부 프리필 가속기를 사용하여 프롬프트 컨텍스트를 수집하고 모델 상태를 구축함으로써 추론의 계산 단계를 분리할 수 있습니다. 계산 집약적인 KV 캐시는 고속 링크를 통해 CS-4의 대용량 SRAM 패브릭으로 전송되어 초저지연 자기회귀 토큰 생성을 수행합니다.
세레브라스는 CS-4 플랫폼의 초기 생산 배치 및 출하가 이번 분기에 시작될 예정이라고 확인했습니다.


 아마존