

인텔은 오늘 OCP 글로벌 서밋에서 크레센트 아일랜드(Crescent Island)라는 제품명을 발표했습니다. 인텔 GPU D 시리즈는 Xe3P 아키텍처를 기반으로 하며, 최대 480GB의 LPDDR5X 메모리와 1.5TB/s의 메모리 대역폭, 1.3페타플롭스의 FP8 연산 성능을 350W 공랭식 PCIe 카드에 담았습니다. 480GB는 파트너사에서 제작한 카드에 적용되는 용량이며, 인텔 자체 브랜드 카드는 160GB입니다. 인텔은 서버 OEM, ODM, 네오클라우드 및 독립 소프트웨어 벤더를 대상으로 샘플링을 진행 중이라고 밝혔습니다. 인텔이 발표와 함께 공개한 렌더링 이미지에는 GPU D270이라는 부품 번호가 표시되어 있는데, 이는 해당 시리즈에 부여된 첫 번째 부품 번호입니다.
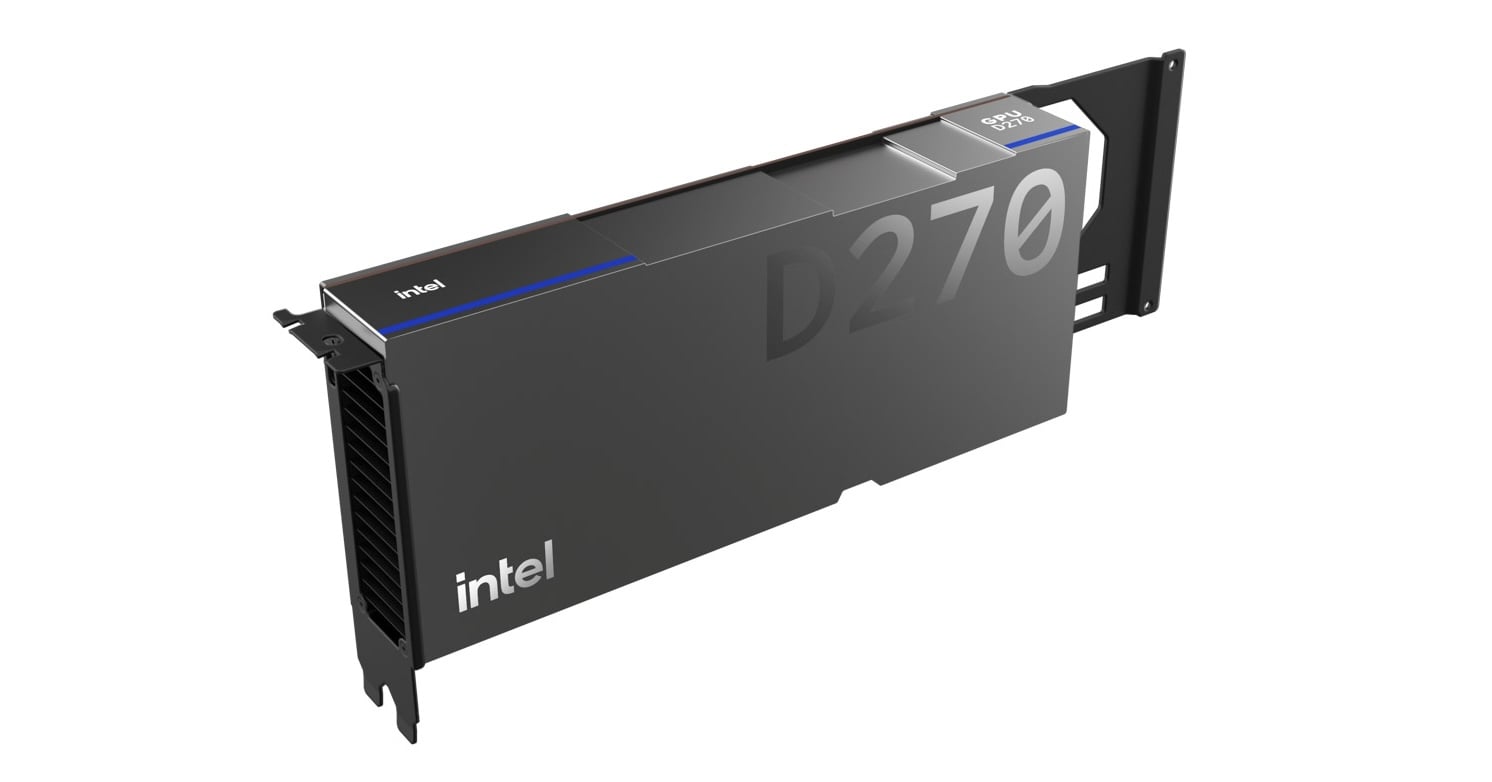
Xe3P 아키텍처는 메모리 제약 추론을 목표로 합니다.
인텔은 OCP 2025 에서 크레센트 아일랜드(Crescent Island)를 처음 소개했고 , 8월 핫칩스(Hot Chips) 에서 32개의 Xe 코어와 256개의 XMX 엔진(Xe3P 기반)을 탑재하고, HBM 대신 LPDDR5X 메모리를 사용하여 기존 공랭식 랙에 바로 장착할 수 있도록 설계했다고 자세히 설명했습니다. 오늘 발표된 내용은 제품명, 대역폭 및 연산 성능 수치, 그리고 고객들이 샘플 하드웨어를 이미 확보했다는 사실입니다.
참고로, 인텔이 현재 출시하는 PCIe 추론 가속기는 128GB의 HBM2e 메모리와 3.7TB/s의 대역폭을 갖춘 Gaudi 3이며, 저희는 지난 2월 Dell PowerEdge XE7740 에 탑재된 해당 카드를 자세히 살펴본 바 있습니다 . 인텔은 OCP 2025에서 GPU를 처음 공개했을 때 Crescent Island 아키텍처에 Gaudi 3 랙 디자인을 적용했는데, D 시리즈는 메모리 용량은 카드당 거의 4배에 달하지만 대역폭은 절반에도 못 미치는 수준으로 줄였습니다.
인텔에 따르면, D 시리즈 카드 한 장은 최대 약 3천억 개의 파라미터를 가진 모델을 처리할 수 있으며, 8개의 GPU로 구성된 호스트는 1조 개 이상의 파라미터까지 확장 가능합니다. 인텔은 이 카드를 지속적인 멀티테넌트 추론 및 장기 컨텍스트 에이전트 워크로드에 적합하게 설계했으며, 이러한 환경에서는 KV 캐시의 성장이 컴퓨팅 성능 향상보다 메모리 사용량 증가 속도를 더 빠르게 합니다. 1.5TB/s의 대역폭을 제공하는 이 카드는 HBM급 가속기에 비해 다소 낮은 수준이지만, 인텔은 디코딩 작업이 많은 환경에서는 최대 대역폭보다 와트당 용량과 가격당 용량이 더 중요하다고 강조합니다.
인텔 데이터센터 그룹의 AI 제품 및 GTM 담당 부사장인 아닐 난두리는 “추론은 AI 워크로드의 핵심으로 자리 잡고 있으며, 기업은 적절한 비용으로 최적의 성능을 제공하는 인프라가 필요합니다.”라고 말했습니다. “인텔은 GPU D 시리즈를 통해 고용량 추론을 실용적으로 배포하고 경제적으로 확장할 수 있도록 하는 데 집중하고 있습니다.” 소프트웨어 측면은 공통 Xe 기반 위에 구축되어 있으며, 인텔은 이를 통해 GPU 제품군 전반에 걸쳐 바이너리 이식성을 제공한다고 밝혔습니다. 따라서 Arc Pro 카드에서 개발된 코드는 커널을 다시 작성할 필요 없이 D 시리즈에서도 사용할 수 있습니다.
인텔의 스택은 Xeon 호스트와 D 시리즈 가속기 전반에 걸쳐 업스트림 런타임 및 서비스 프레임워크를 통합하며, Meta가 로컬 에이전트 작업을 위해 구축한 300억 개 매개변수의 개방형 가중치 모델인 Muse Glimmer를 출시 당일부터 지원합니다. 현재 Xeon에서 실행되는 Intel AI for Enterprise Agent Toolkit은 공급자 기반 아키텍처를 사용하며, 하드웨어가 출시되면 D 시리즈를 대상으로 지원 범위를 확장할 예정이므로, 가속기가 대량으로 보급되기 전에 오케스트레이션 계층이 구축됩니다.
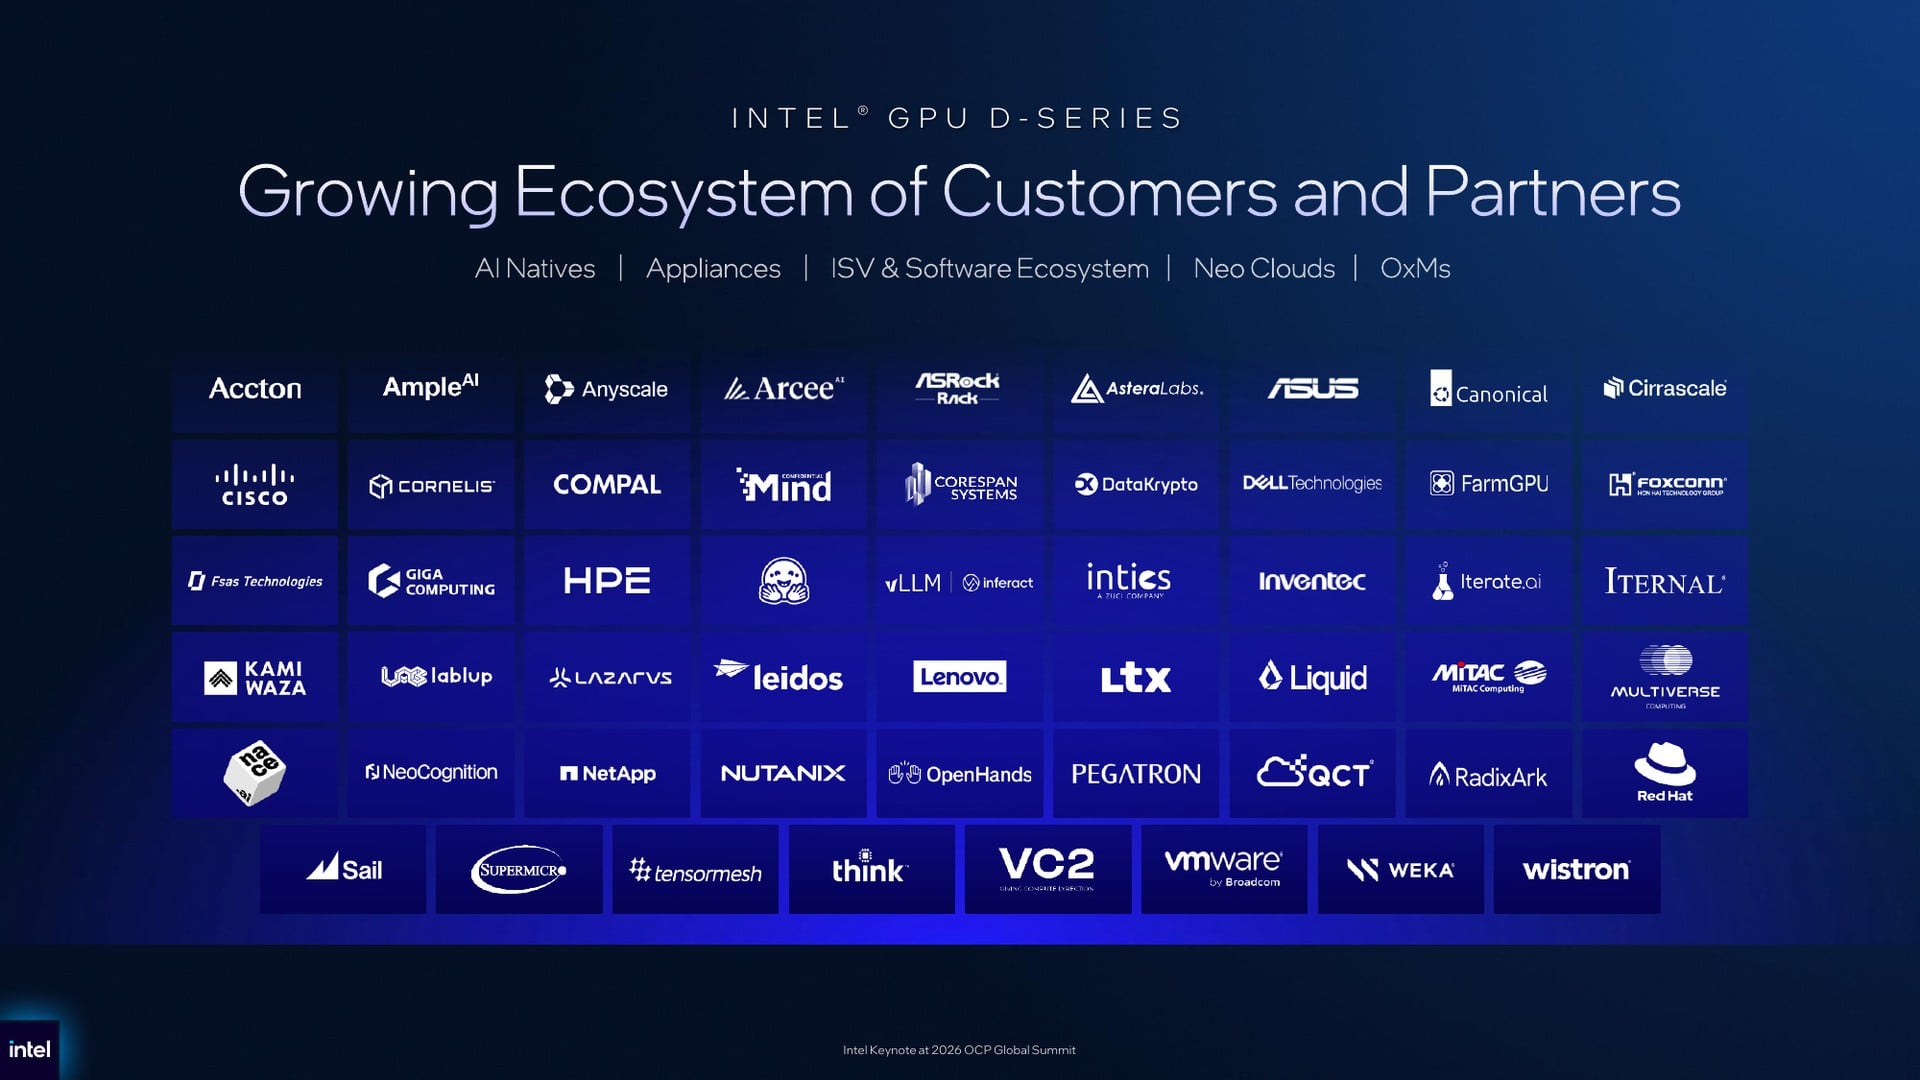
인텔이 기조연설에서 공개한 파트너 슬라이드에는 AI 네이티브 기업, 어플라이언스 공급업체, 소프트웨어 업체, 네오클라우드, OEM 및 ODM 업체 등 53개의 로고가 나열되어 있습니다. 서버 업체로는 Dell, HPE, Lenovo, Supermicro, Cisco, ASUS, ASRock Rack, Giga Computing, MiTAC, Pegatron, QCT, Wistron, Inventec, Compal, Foxconn 등 예상대로 유명 업체들이 포함되어 있습니다. 휴대성을 강조한 카드인 만큼 소프트웨어 업체 목록은 더욱 중요한데, Red Hat, Canonical, VMware by Broadcom, Nutanix, NetApp, WEKA, vLLM, Hugging Face, Anyscale, OpenHands 등이 보드에 탑재되어 있으며, 인터커넥트 업체로는 Astera Labs와 Cornelis가 참여했습니다.
ORv3 Xeon 랙, 46,000개 이상의 코어 지원
인텔은 카드와 함께 Xeon 6+ 프로세서를 기반으로 OCP Open Rack v3 사양에 맞춰 구축된 랙 규모 시스템을 선보였습니다 . 인텔에 따르면 가장 고밀도 구성은 랙당 46,000개 이상의 코어를 갖추고 총 전력 소모량은 133.45kW에 달합니다. 288코어 Xeon 6+는 160개의 소켓(랙 하나에 듀얼 소켓 노드 80개, 소켓당 약 834W)으로 이러한 성능을 구현하며, 나머지 랙 공간도 전력 소모에 포함됩니다. 인텔은 이러한 랙을 에이전트 파이프라인의 CPU 측, 즉 토큰 라우팅, 검색, 데이터베이스 조회, 코드 실행 및 가속기에 I/O를 지속적으로 공급하는 데 사용하도록 설계했습니다.
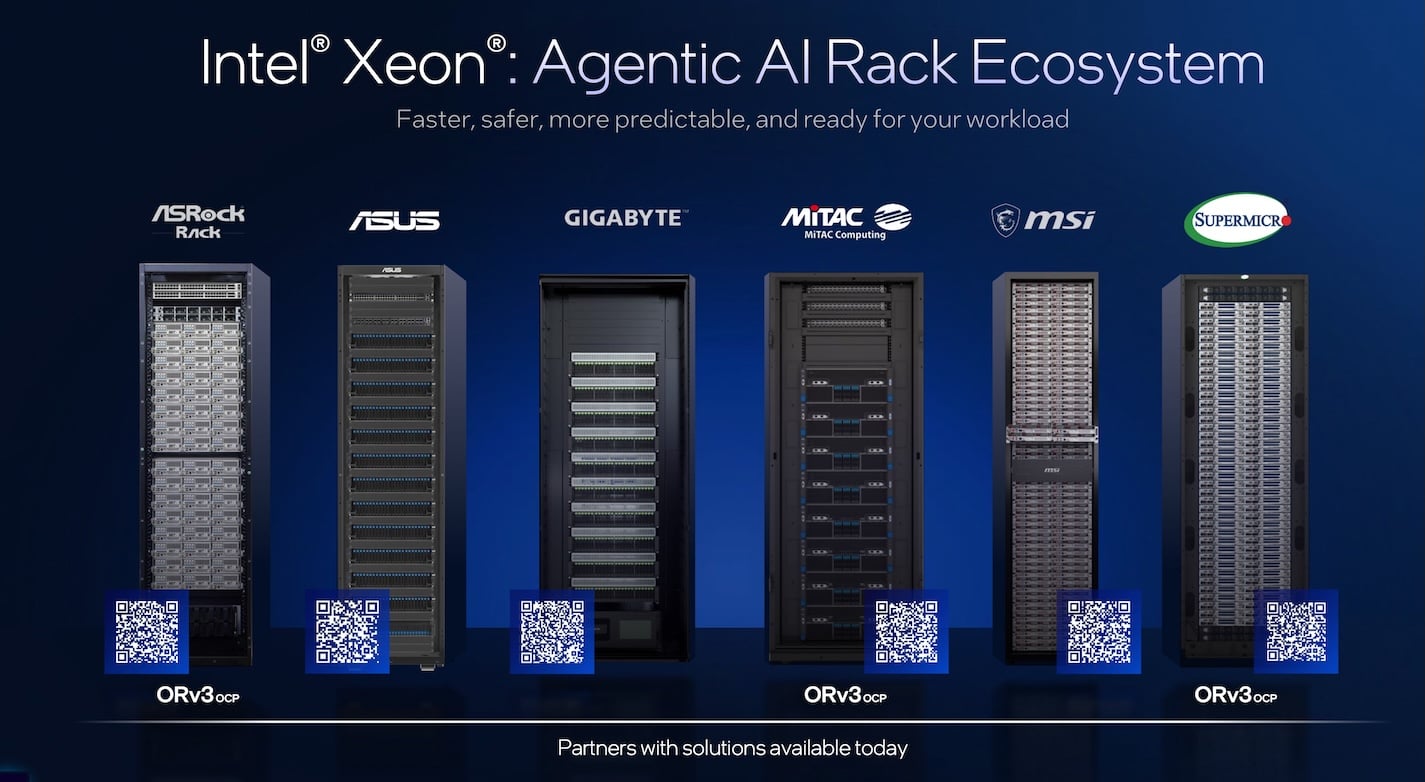
파트너 슬라이드에는 ASRock Rack, ASUS, GIGABYTE, MiTAC Computing, MSI, Supermicro가 현재 시스템을 제공하는 벤더로 명시되어 있으며, 6개의 랙 중 3개는 ORv3 구성이고 나머지는 19인치 섀시입니다. 인텔은 AI 랙의 성능 기준이 목표 지연 시간에서 동시에 처리할 수 있는 에이전트 수로 바뀌고 있다고 밝혔습니다. 인텔 데이터 센터 그룹의 총괄 부사장인 케보크 케치치안은 "에이전트 AI는 고객이 데이터 센터에 요구하는 바를 변화시키고 있습니다. 단순히 토큰을 더 빠르게 생성하는 것만으로는 더 이상 충분하지 않습니다. 인프라는 복잡한 워크플로우를 조율하고, 작업을 실행하며, 유용한 결과물을 효율적으로 대규모로 제공해야 합니다."라고 말했습니다.
OCP에서 오픈 어댑터 카드 개발 작업이 계속 진행 중입니다.
인텔은 또한 올해 초 AMD, 델, NVIDIA, 퀄컴과 함께 결성한 OCP(Open Adapter Card) 워크그룹에서의 활동을 언급했습니다. 이 그룹은 표준 PCIe 카드와 풀랙 규모 시스템 사이에 위치하는 서브랙 가속기 폼 팩터를 정의하고 있으며, 표준화된 기계적, 전력 및 대역 외 관리 인터페이스를 통해 서로 다른 공급업체의 가속기를 동일한 개방형 섀시에 장착할 수 있도록 지원합니다.
이 작업 그룹의 목표는 19인치 및 21인치 랙 모두에서 사용할 수 있는 추론 및 중간 수준 학습 플랫폼용 고성능 어댑터이며, 인텔과 AMD는 이번 주 서밋에서 해당 사양의 진행 상황을 발표할 예정입니다. 인텔은 2011년 이후 OCP에 116건의 기여를 했으며, Nic Dubé의 기조 연설 "모든 프롬프트를 제자리에 배치하라"는 10월 13일 오전 10시 30분(태평양 표준시)에 예정되어 있습니다.


 아마존