

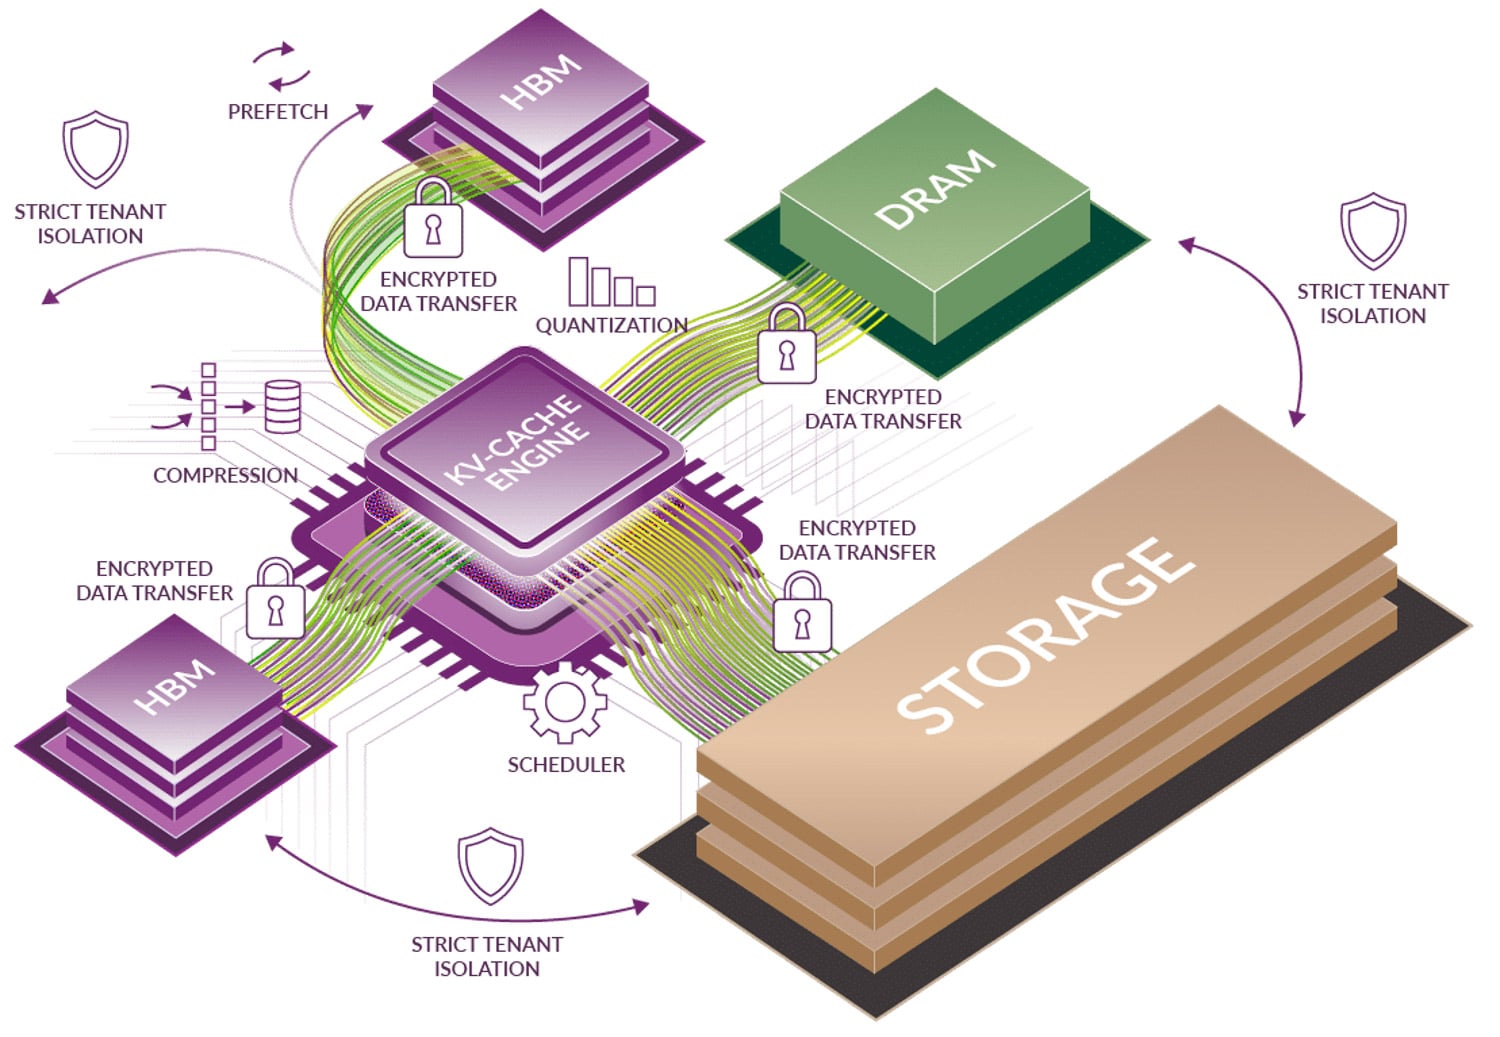
NVMe over TCP를 개발한 Lightbits Labs가 KV 캐시 오케스트레이션 엔진인 Inferra를 통해 추론 소프트웨어 시장에 진출합니다. Inferra는 오는 9월 15일 샌타클라라에서 열리는 AI 인프라 서밋에서 처음 공개됩니다. 이 소프트웨어는 DRAM과 NVMe 스토리지 계층에 걸쳐 GPU 메모리를 가상화하고 KV 캐시를 영구 데이터 계층으로 전환하여, 장시간 컨텍스트 및 다중 세션 워크로드에 필요한 어텐션 상태를 HBM에 저장하거나 캐시에서 누락될 경우 다시 계산할 필요가 없도록 합니다. Lightbits는 기존 GPU에서 최대 16배 더 많은 동시 추론 세션을 지원하고, 어텐션 상태를 다시 계산하는 대신 미리 가져와 지연 시간을 100배 이상 단축하며, 컨텍스트 윈도우를 최대 1천만 토큰까지 확장할 수 있다고 주장합니다. 또한, OVH를 포함한 여러 고객사의 베타 프로그램에서 이미 테스트를 완료했다고 밝혔습니다.
재계산 대신 사전 가져오기
Inferra가 해결하고자 하는 병목 현상은 KV 캐시를 플래시 메모리로 오프로드하는 과정에서 설명했던 내용과 동일 합니다. 컨텍스트 길이가 길어지고 세션 수가 증가함에 따라 KV 캐시의 용량이 GPU 메모리 용량을 초과하게 되고, 서빙 스택은 캐시를 제거하고 나중에 프리필을 다시 계산하거나 GPU가 처리할 수 있는 세션 수를 제한합니다. 두 가지 방법 모두 이미 완료된 작업에 GPU 사이클을 낭비하게 됩니다. Inferra는 메모리와 스토리지 계층 전반에 걸쳐 캐시를 활성화 상태로 유지하고, 예측 프리페처를 통해 모델이 필요로 하기 전에 어텐션 상태를 GPU로 미리 가져옵니다. Lightbits는 이러한 접근 방식이 TTFT(Time-to-First-Token)와 TPOT(Time Per Output Token)를 모두 단축시키며, 100배라는 수치는 해당 상태를 처음부터 다시 계산하는 것과 비교했을 때 지연 시간 개선 효과를 나타낸다고 밝혔습니다.
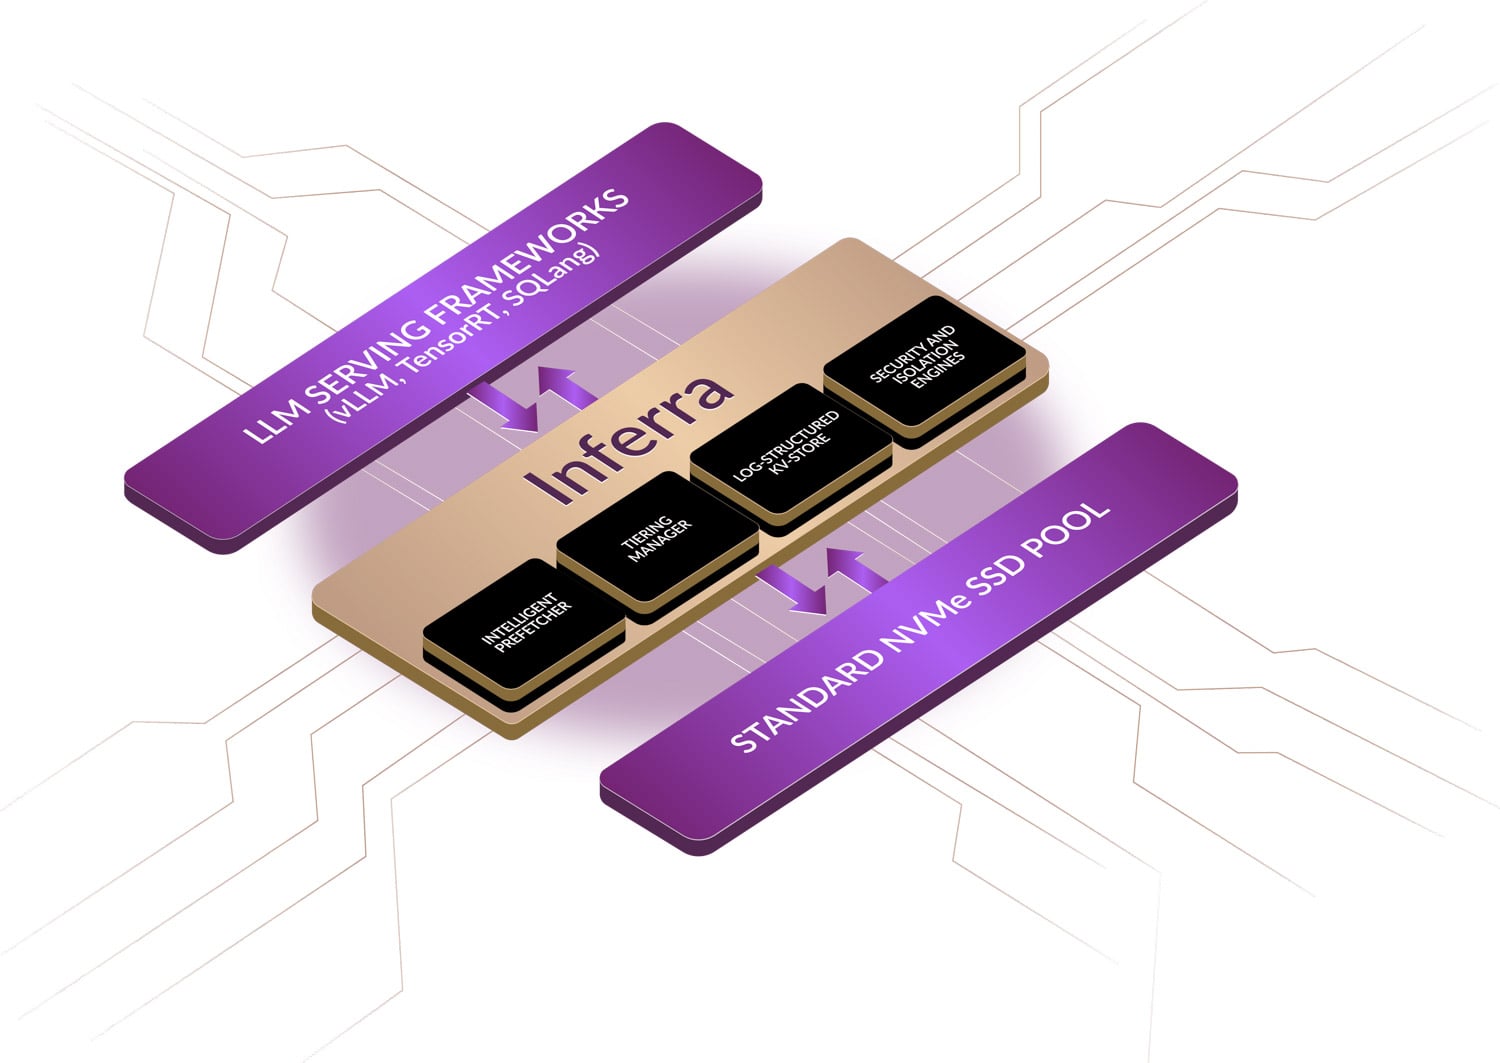
Lightbits의 블록 다이어그램은 지능형 프리페처, 티어링 관리자, 로그 구조 KV 스토어, 그리고 보안 및 격리 엔진의 네 가지 구성 요소를 보여줍니다. 이 구성 요소들은 위쪽의 서비스 프레임워크와 아래쪽의 표준 NVMe SSD 풀 사이에 위치합니다. Lightbits는 vLLM, TensorRT, SGLang을 지원하는 서비스 프레임워크로 명시하고 있으며, 엔진은 GPU와 SSD에 구애받지 않는다고 설명합니다. 로그 구조 스토어는 업데이트를 순차적으로 추가하고 드라이브에 작은 임의 쓰기 작업을 최소화하여 지속적으로 변경되는 캐시에 플래시 티어를 사용할 수 있도록 해줍니다. 저희는 Solidigm D7-PS1030 리뷰 에서 3 DWPD 드라이브가 이러한 역할을 수행하는 방식을 살펴보았습니다 . 멀티 테넌트 측면에서 Lightbits는 공유 추론 인프라 전반에 걸쳐 안전한 테넌트 격리와 지능형 캐시 관리를 제공하며, 티어 간 암호화된 전송을 통해 네오클라우드가 하나의 KV 풀을 여러 고객에게 일관된 SLA로 제공할 수 있도록 한다고 설명합니다.
Lightbits Labs의 공동 창립자이자 회장인 아비그도르 빌렌즈는 이번 출시를 학습 파이프라인에 맞춰 구축된 스토리지와의 단절이라고 설명했습니다. 그는 추론은 "완전히 다른 패러다임"이라며, "기존의 학습 및 스토리지 시스템을 개조하여 KV 캐시 병목 현상을 해결하는 것은 효과가 없다. 그것은 다른 시대에 맞춰 설계된 것이다. 우리는 GPU 효율성 문제를 해결하기 위해 Inferra를 처음부터 새롭게 설계했으며, 이미 고객 베타 프로그램에서 그 효과를 입증했다"고 밝혔습니다.
OVH, Solidigm 및 부스 219 데모
OVH는 베타 고객으로 선정되었습니다. OVH의 최고 제품 및 기술 책임자인 야니브 프디다는 "인페라의 지능형 KV 캐시 티어링을 통해 GPU 활용률을 크게 향상시킬 수 있었으며, 이를 통해 고객에게 AI 에이전트 및 RAG 워크로드에 더욱 확장 가능하고 비용 효율적인 기반을 제공할 수 있게 되었습니다."라고 말했습니다. 솔리디그는 AI 센트럴 랩에서 D7-PS1010 드라이브를 사용하여 엔진을 실행했으며, 이 회사의 에코시스템, 솔루션 및 시장 활성화 담당 부사장인 아비 셰티는 "지능형 소프트웨어 계층 가상화를 갖춘 네트워크 연결 스토리지가 대규모 컨텍스트의 에이전트형 AI에서 메모리 한계를 어떻게 극복할 수 있는지 보여주는 결과"라고 평가했습니다. 네트워크 연결 NVMe 풀과 소프트웨어 계층의 조합은 라이트비츠의 주력 분야입니다. 라이트비츠의 LightOS 블록 스토리지 는 2019년부터 NVMe/TCP를 기반으로 구축되었습니다.
Lightbits의 AI 제품 및 비즈니스 담당 수석 부사장인 Ramesh Chettuvetty는 Inferra를 "일반 하드웨어에서 유휴 GPU를 없애고 최대 10천만 토큰의 전력 컨텍스트 윈도우를 생성하는 세계 최초의 KV 캐시 가속 엔진"이라고 소개하며, "즉각적인 투자 회수와 첫날부터 순 비용 절감 효과를 제공한다"고 밝혔습니다. 하지만 이는 독립적인 테스트 결과에 앞서 발표된 제조사의 주장이며, 가격, 패키징, 정식 출시일은 공개되지 않았습니다. 현재 Inferra는 고객 베타 테스트 중입니다. Lightbits는 이번 서밋 기간 동안 부스 219에서 세션 밀도 및 지연 시간 결과에 대한 라이브 데모를 진행하고 있으며, 클러스터 예약 전에 GPU 비용 절감 효과를 시뮬레이션해 보고 싶은 팀을 위해 Pod 효율성 분석 도구를 제공하고 있습니다.


 아마존