

MLPerf Inference v5.1은 LLM, 비전 및 멀티모달 작업 전반에 걸쳐 AI 추론에 대한 엄격한 벤치마크를 제공합니다. NVIDIA의 Blackwell Ultra 결과와 AMD의 Instinct MI300X/MI325X/MI355X 제출 결과에 대한 기술 분석은 다음과 같습니다. 여기에는 상세한 벤치마크 데이터, 소프트웨어 최적화, 아키텍처 전략, 그리고 하이퍼스케일러 및 기업에 대한 시사점이 포함되어 있습니다.
MLPerf 벤치마킹 프레임워크
MLPerf 추론 벤치마크는 AI 가속기의 평가 기준 역할을 하며, 이미지 분류, 언어 모델, 추천 시스템 전반의 성능을 측정하는 표준화된 비교 분석 방식을 제공합니다. 대규모 GPU를 구축하는 기업의 경우, 이러한 수치는 중요한 구매 결정의 기준이 되는 경우가 많습니다.
MLPerf 추론은 MLCommons에 의해 관리되며, 폐쇄형 분할과 개방형 분할 규칙을 정의합니다. 다음과 같은 시나리오가 있습니다.
- 오프라인: 처리량 중심(가능한 한 많은 쿼리를 일괄 처리).
- 서버: 지연 시간에 맞는 다중 스트림 추론.
- 대화 형: 엄격한 TTFT(첫 번째 토큰까지의 시간) 및 TPS(초당 토큰 @ 99번째 백분위수).
v5.1 워크로드 제품군에는 다음이 포함됩니다.
- 딥시크-R1: 671B 전문가 혼합 모델(추론 추론에 대한 스트레스 테스트).
- 라마-3.1-405B 및 8B: 다양한 추론 모드에 걸친 최신 LLM입니다.
- 속삭임: ASR이 RNN-T를 대체합니다.
- 안정 확산 XL(SD-XL): 텍스트-이미지 생성 AI.
- 믹스트랄, DLRMv2ResNet-50과 같은 레거시 워크로드도 포함됩니다.
처리량(토큰/초 또는 샘플/초) 차트를 보면 일반적으로 NVIDIA가 절대적인 수치, 특히 GPU당 처리량에서 여전히 우위를 점하고 있음을 알 수 있습니다. 그러나 AMD는 상대적인 효율성과 확장성 측면에서 꾸준히 발전하여, 특히 서버 환경 및 멀티 노드 배포에서 NVIDIA와의 격차를 점차 좁혀가고 있습니다.
NVIDIA Blackwell Ultra 결과
Blackwell Ultra 시스템은 모든 새로운 워크로드에서 기록적인 처리량을 달성했습니다. 주요 요인:
- NVFP4 정밀도: 맞춤형 4비트 부동 소수점, DeepSeek 및 Llama 가속화.
- FP8 KV-캐시: 주의 계층을 위한 메모리 절약.
- 분산된 서비스 제공: 72GB/s NVLink를 통해 1,800개 GPU에 걸쳐 컨텍스트 대 생성 단계를 분할합니다.
- 소프트웨어: CUDA Graphs, TensorRT-LLM, ADP Balance.
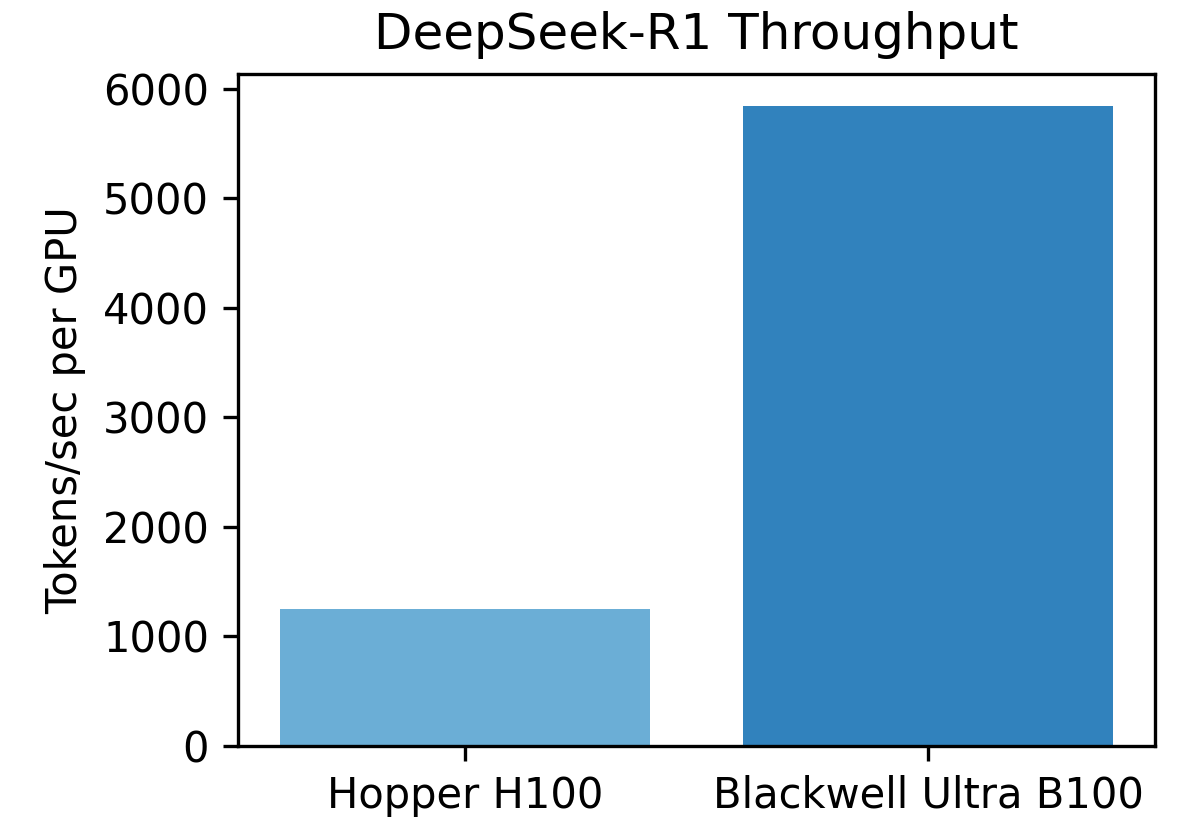
GPU당 Hopper와 Blackwell Ultra를 비교한 아래 막대 그래프는 DeepSeek-R5에서 처리량이 거의 1배 증가했음을 보여줍니다. 이는 미세 데이터 형식(NVFP4)과 랙 전체 대역폭이 대규모 추론 워크로드에 대해 선형적으로 확장됨을 보여줍니다. 대화형 Llama-405B의 기록적인 결과를 기반으로 한 또 다른 그래프는 NVIDIA가 NVLink 패브릭과 분산 서비스를 사용하여 지연 시간 SLA를 유지하면서도 이전 처리량 한계를 뛰어넘는 방식을 보여줍니다. 결론: NVIDIA는 순수한 속도와 지연 시간에 민감한 워크로드에서 여전히 업계 선두 주자입니다.
AMD Instinct MI300X/MI325X/MI355X 결과
AMD는 효율성과 유연성을 목표로 삼았습니다.
- MI4X의 FP355: MI2.7X FP2 대비 70배 더 많은 Llama-325-8B 처리량을 제공합니다.
- 구조화된 가지치기: Llama-405B에서는 정확도에 영향을 주지 않고 FLOP를 21~33% 줄였으며, 처리량을 약 82~90% 증가시켰습니다.
- 스케일링: 최대 8개 노드까지 원활한 선형적 확장이 입증되었습니다. 최초의 이기종 클러스터(4 × MI300X + 2 × MI325X)는 94%의 확장 효율성을 달성했습니다.
- ROCm 생태계 재현성: 파트너 제출물은 AMD 자체 결과와 지속적으로 1~3% 이내로 나타났습니다.
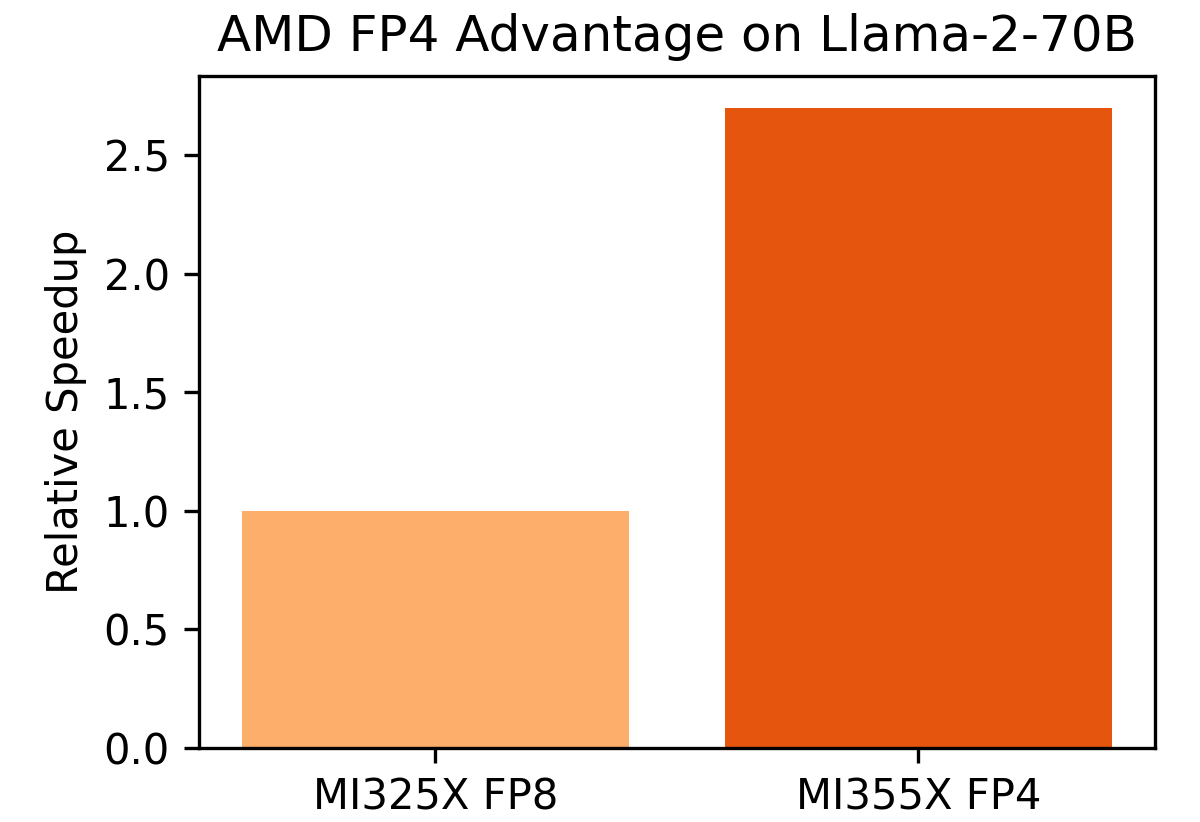
MI325X FP8과 MI355X FP4를 비교한 위 차트는 획기적인 FP4의 이점을 보여줍니다. 정확도 손실은 최소화하면서 초당 토큰 수는 더 높으며, FP4가 실험적인 단계가 아니라 배포에 적합한 상태임을 증명합니다.
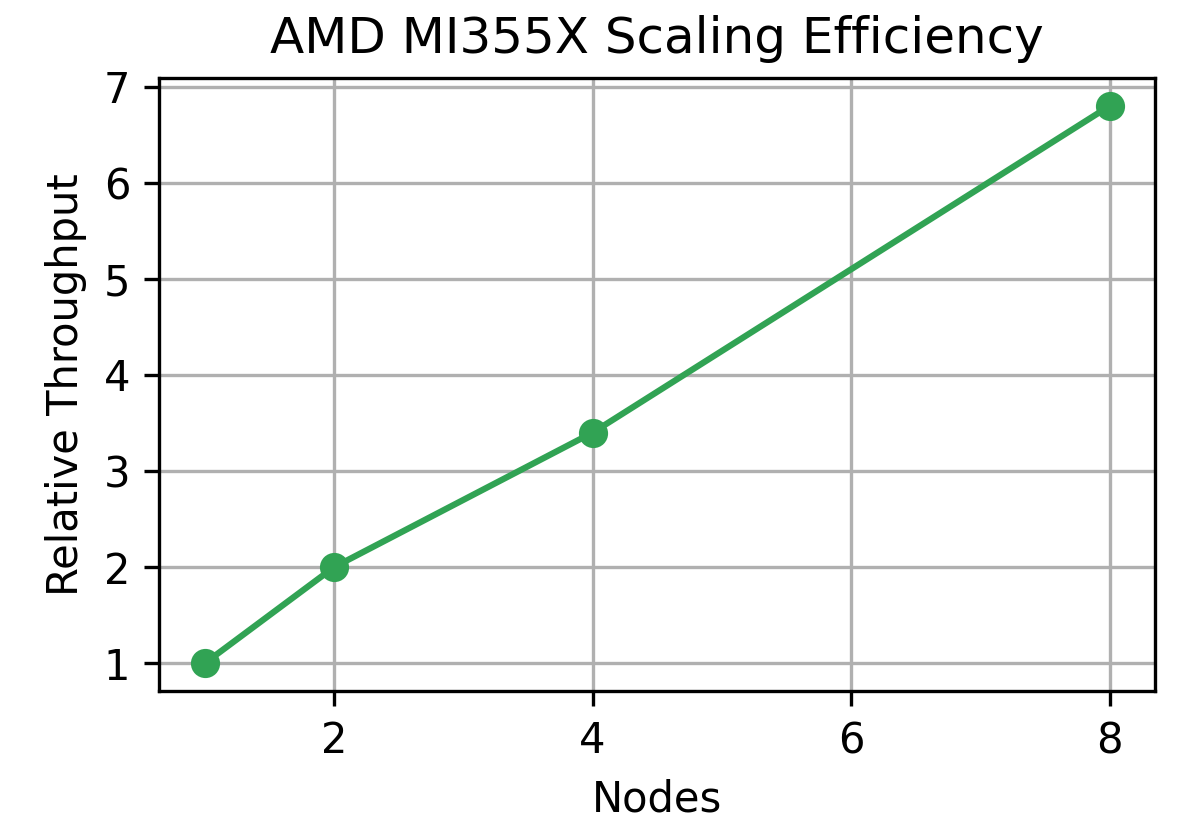
이 확장 곡선 (1 → 8 노드) 차트는 거의 선형적인 확장성을 보여주는데, 이는 하이퍼스케일러들이 예측 가능한 확장 비용으로 해석하기 때문에 매우 중요하게 여기는 요소입니다. 한편, 구조적 가지치기 개략도는 AMD가 하드웨어 성능뿐만 아니라 알고리즘 효율성에도 중점을 두고 있음을 보여줍니다. 이는 전력과 공간 제약이 있는 실제 추론 클러스터 환경에 매우 중요합니다.
AMD-NVIDIA 직접 비교
|
메트릭 |
엔비디아 블랙웰 울트라 |
AMD MI355X |
노트 |
승자 |
|
GPU당 초당 토큰 |
5842(딥시크-R1) |
~2200(확장된 FP4) |
더 높은 NVIDIA 원시 성능 |
NVIDIA |
|
GPU당 메모리 |
192GB HBM3e |
288GB HBM3e |
AMD, 520B 모델 단일 GPU 탑재 |
AMD |
|
정밀 지원 |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
4비트 리드 둘 다 |
넥타이 |
|
스케일링 패브릭 |
72 GPU NVLink |
선형 노드를 8로 확장 |
다양한 규모 전략 |
넥타이 |
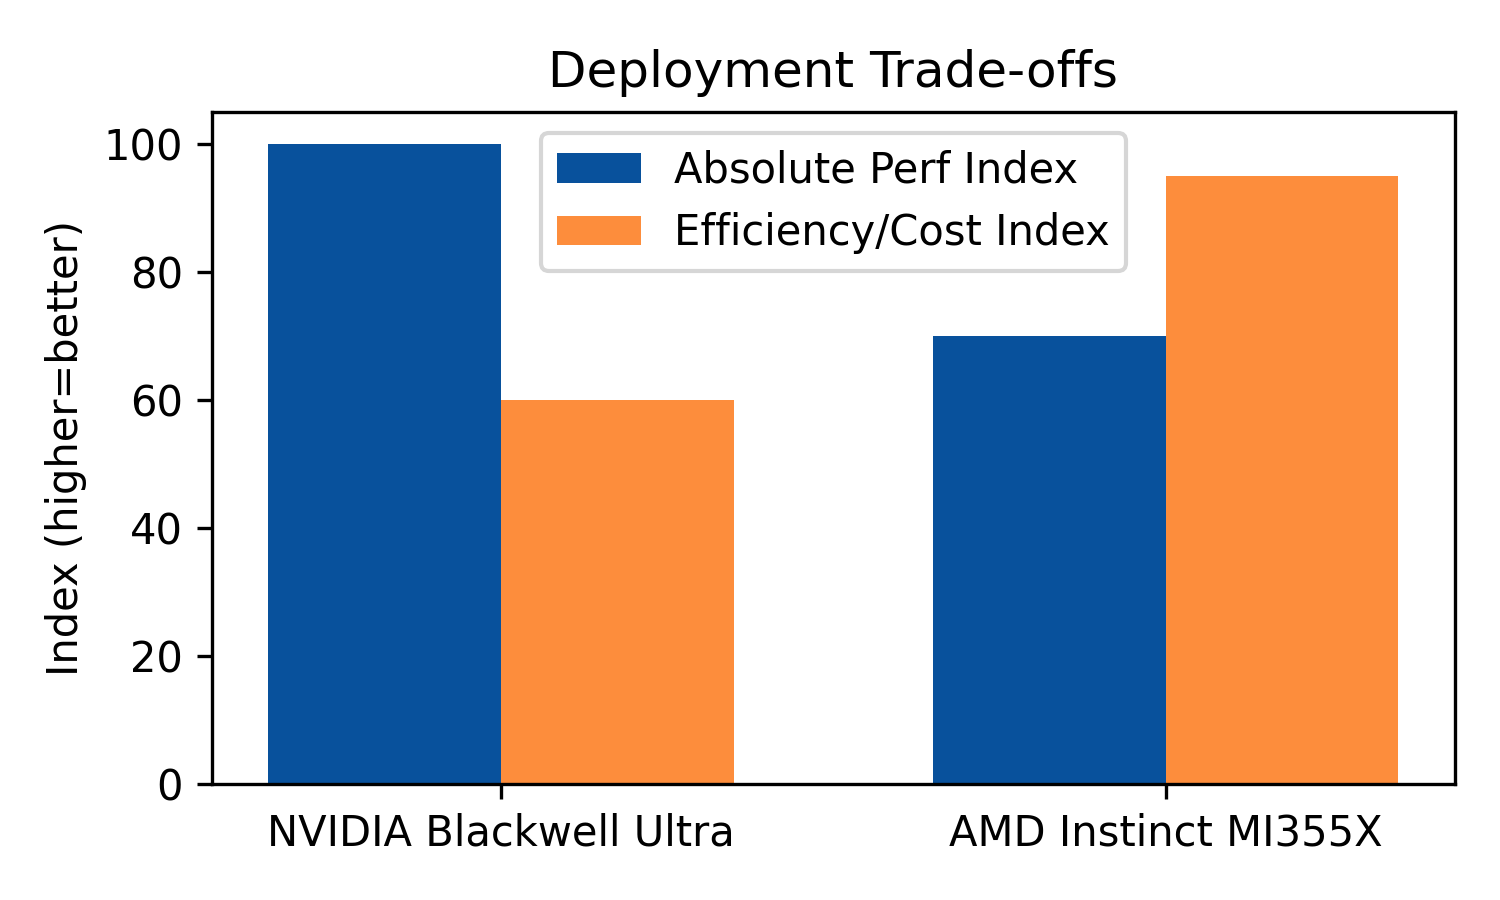
나란히 비교한 시각화는 상충관계를 강조합니다.
- NVIDIA는 GPU당 처리량이 압도적이어서 플롭 밀도가 중요한 AI 팩토리에 이상적입니다.
- 더 큰 메모리(288GB)와 FP4 프루닝 기능을 갖춘 AMD는 토큰당 비용과 배포 유연성이 가장 중요한 분야에서 빛을 발합니다.
업계에 미치는 영향
- 하이퍼스케일러: NVIDIA는 최고 성능을 추구하는 AI 팩토리에 여전히 최고의 선택입니다. 그러나 AMD의 효율성 혁신은 비용 최적화된 확장성을 제공하여 여러 계층에 걸쳐 워크로드를 균형 있게 분산하는 데 적합합니다.
- 클라우드 제공 업체: 이기종 제품, 고성능 NVIDIA 티어와 비용 효율적인 AMD Kubernetes 포드를 기대하세요.
- 기업: 구조적 프루닝, FP4, 그리고 이기종 클러스터 지원을 통해 AMD는 더 낮은 TCO로 405억 개 이상의 모델 추론을 제공할 수 있습니다. NVIDIA의 혁신 기술(분산 서비스 및 Dynamo)은 지연 시간에 민감한 앱(예: 실시간 LLM 챗봇)에 여전히 유용합니다.
- 미래 전망: 4비트 추론을 기준으로 보편적으로 채택하고, 이기종 GPU 풀을 더 폭넓게 활용하며, 긴 시퀀스를 위한 NVIDIA의 Rubin CPX와 더 많은 프레임워크를 포괄하기 위한 AMD의 ROCm 확장을 포함한 새로운 시스템 설계를 기대합니다.
NVIDIA는 원시 처리량 부문에서 선두를 달리고 있으며, H200 GPU는 폐쇄형 분할 벤치마크에서 ResNet-50 및 BERT 추론 성능을 선도하고 있습니다. AMD의 MI300 역시 크게 뒤처지지 않고 있으며, 서버 및 오프라인 환경에서 경쟁력 있는 수치를 기록하는 동시에 전력 효율에서도 큰 향상을 보였습니다. 핵심은 NVIDIA가 여전히 선두를 유지하고 있다는 것뿐만 아니라, AMD가 불과 한 라운드 전 MLPerf 테스트와 비교하여 격차를 크게 줄였다는 것입니다. 구매자들에게 이는 친환경 GPU만 고려하던 시대는 끝났음을 의미합니다. ROCm은 성숙기에 접어들었고, MI300은 실제 추론 환경에서도 활용 가능합니다.


 아마존