

샌호세에서 열린 GTC 2026에서 NVIDIA CEO 젠슨 황은 기조연설을 통해 차세대 AI 인프라 플랫폼을 소개하고, 실리콘, 시스템, 소프트웨어, 에코시스템 파트너십을 아우르는 광범위한 발표를 진행했습니다. 190여 개국에서 3만 명 이상의 참석자가 모인 GTC 2026은 NVIDIA가 블랙웰 출시 이후 가장 포괄적인 플랫폼 개편을 선보인 자리였으며, 베라 루빈 아키텍처의 본격적인 상용화와 Groq 30,000 LPU 기술의 NVIDIA 데이터센터 에코시스템 통합이 핵심이었습니다. 황 CEO는 기조연설에서 에이전트형 AI의 변곡점이 도래했으며, 베라 루빈은 NVIDIA가 역사상 가장 위대한 인프라 구축이라고 묘사하는 프로젝트의 시작을 알린다고 강조했습니다.
기조연설의 핵심 주제는 네 번째 AI 확장 법칙인 에이전트 확장의 등장이었습니다. 이는 AI 시스템이 인간뿐만 아니라 다른 AI 에이전트와도 소통하면서 저지연, 대규모 컨텍스트 추론에 대한 수요가 전례 없는 규모로 기하급수적으로 증가하는 현상을 의미합니다. NVIDIA는 이러한 새로운 영역을 지원하는 인프라 기반으로 Vera Rubin 플랫폼을 제시했습니다. 이 플랫폼은 AI 팩토리를 위해 특별히 설계된 5개의 새로운 랙 규모 시스템에 걸쳐 공동 설계된 7개의 칩을 결합합니다. Frontier AI 연구소에서도 이 플랫폼에 대한 지지를 표명했습니다. Anthropic의 CEO이자 공동 창립자인 Dario Amodei는 "기업과 개발자들은 점점 더 복잡한 추론, 에이전트 워크플로, 그리고 미션 크리티컬한 의사 결정을 위해 Claude를 사용하고 있습니다. 이를 위해서는 그에 발맞춰 나갈 수 있는 인프라가 필요합니다. NVIDIA의 Vera Rubin 플랫폼은 고객이 의존하는 안전성과 신뢰성을 향상시키면서 지속적으로 서비스를 제공할 수 있는 컴퓨팅, 네트워킹 및 시스템 설계 역량을 제공합니다."라고 언급했습니다. OpenAI CEO 샘 알트만은 "NVIDIA 인프라는 우리가 AI의 한계를 계속해서 넓혀갈 수 있도록 해주는 기반입니다. NVIDIA Vera Rubin을 통해 더욱 강력한 모델과 에이전트를 대규모로 실행하고 수억 명의 사용자에게 더욱 빠르고 안정적인 시스템을 제공할 수 있을 것입니다."라고 밝혔습니다.
베라 루빈 플랫폼: 에이전트 기반 AI의 새로운 지평을 열다
CES 2026에서 처음 공개된 Vera Rubin NVL72 아키텍처를 기반으로, GTC 2026에서는 플랫폼을 확장하여 포괄적인 POD 규모의 AI 팩토리 생태계를 구축했습니다. NVIDIA는 이를 개별 칩과 독립형 서버에서 완전히 통합된 랙 규모 시스템, POD 규모 배포, 그리고 독립적인 AI 팩토리로의 전환으로 설명하고 있습니다. Vera Rubin 플랫폼은 NVIDIA Vera CPU, Rubin GPU, NVLink 6 스위치, ConnectX-9 SuperNIC, BlueField-4 DPU, Spectrum-6 이더넷 스위치, 그리고 새롭게 통합된 NVIDIA Groq 3 LPU를 모두 포함하며, 컴퓨팅, 네트워킹, 스토리지 전반에 걸친 심층적인 공동 설계를 통해 단일 통합 AI 슈퍼컴퓨터로 작동하도록 설계되었습니다. 또한, 80개 이상의 MGX 파트너로 구성된 글로벌 공급망 생태계의 지원을 받습니다.

NVIDIA는 이 플랫폼이 모든 AI 워크로드에서 Blackwell 세대 대비 와트당 최대 10배 더 높은 추론 처리량과 10분의 1의 토큰 비용을 제공한다고 주장합니다. 대규모 Mixture-of-Experts 모델 학습의 경우, Vera Rubin은 동등한 성능을 달성하는 데 필요한 GPU 수를 4분의 1로 줄였습니다. NVL72는 NVIDIA Quantum-X800 InfiniBand 및 Spectrum-X Ethernet과 원활하게 연동되어 대규모 GPU 클러스터에서 높은 활용률을 유지하면서 학습 시간과 총 소유 비용을 절감합니다.
세대 비교: 블랙웰 울트라 vs. 베라 루빈 NVL72
| 스펙 | GB300 NVL72 (블랙웰 울트라) | VR NVL72 (베라 루빈) |
|---|---|---|
| 컴퓨팅 아키텍처 | ||
| GPU 개수 | 72개의 블랙웰 울트라 GPU | 72개의 루빈 GPU |
| CPU 수 | 36개의 그레이스 CPU | 36개의 Vera CPU |
| CPU 코어 | CPU당 72개의 ARM 코어 | CPU당 88개의 올림푸스 ARM 코어 |
| AI 성능 | ||
| FP4 추론 성능 | 1.44 엑사플롭스 | 3.6 엑사플롭스 |
| GPU당 NVFP4 (추론) | 20PFLOPS | 50PFLOPS |
| GPU당 NVFP4 (학습) | 10PFLOPS | 35PFLOPS |
| 메모리 | ||
| GPU 메모리 유형 | HBM3e | HBM4 |
| GPU 메모리 대역폭 | ~8TB/초 | ~22TB/초 |
| 상호 연결 | ||
| NVLink 생성 | NV링크 5 | NV링크 6 |
| NVLink 대역폭(GPU당) | 1.8 TB / 초 | 3.6 TB / 초 |
| 랙 규모 NVLink 대역폭 | 130 TB / 초 | 260 TB / 초 |
| 네트워킹 | ||
| 스케일아웃 NIC | ConnectX-8 (800Gb/s) | ConnectX-9 (1.6TB/s) |
| CPU-GPU 상호 연결 | NVLink-C2C (900GB/s) | NVLink-C2C (1.8 TB/s) |
베라 루빈 기반 제품은 2026년 하반기부터 파트너사를 통해 출시될 예정입니다. 주요 클라우드 제공업체인 아마존 웹 서비스(AWS), 구글 클라우드, 마이크로소프트 애저, 오라클 클라우드 인프라스트럭처를 비롯하여 NVIDIA 클라우드 파트너사인 코어위브, 크루소, 람다, 네비우스, 엔스케일, 투게더 AI 등이 포함됩니다. 글로벌 시스템 제조업체인 델 테크놀로지스, HPE, 레노버, 슈퍼마이크로는 물론 ASUS, 폭스콘, 기가바이트, 인벤텍, 페가트론, QCT, 위스트론, 위윈 등도 베라 루빈 제품 기반 서버를 선보일 것으로 예상됩니다.
CPX에서 LPX로: NVIDIA의 Groq 인수가 디코딩 가속을 어떻게 재편했는가
작년 AI 인프라 서밋에서 NVIDIA는 장기 컨텍스트 추론 쿼리 가속화를 위해 설계된 몇 가지 구성의 CPX 랙을 발표했습니다. 당시 발표를 다루면서 CPX의 실제 기능에 대한 몇 가지 의문점이 생겼습니다. 언뜻 보기에는 흥미로운 아키텍처 개념이었지만, CPX는 어텐션 연산에 대한 추가 가속 기능 외에는 Rubin GPU 자체보다 실질적으로 더 나은 점을 제공하는 것처럼 보이지 않았습니다.
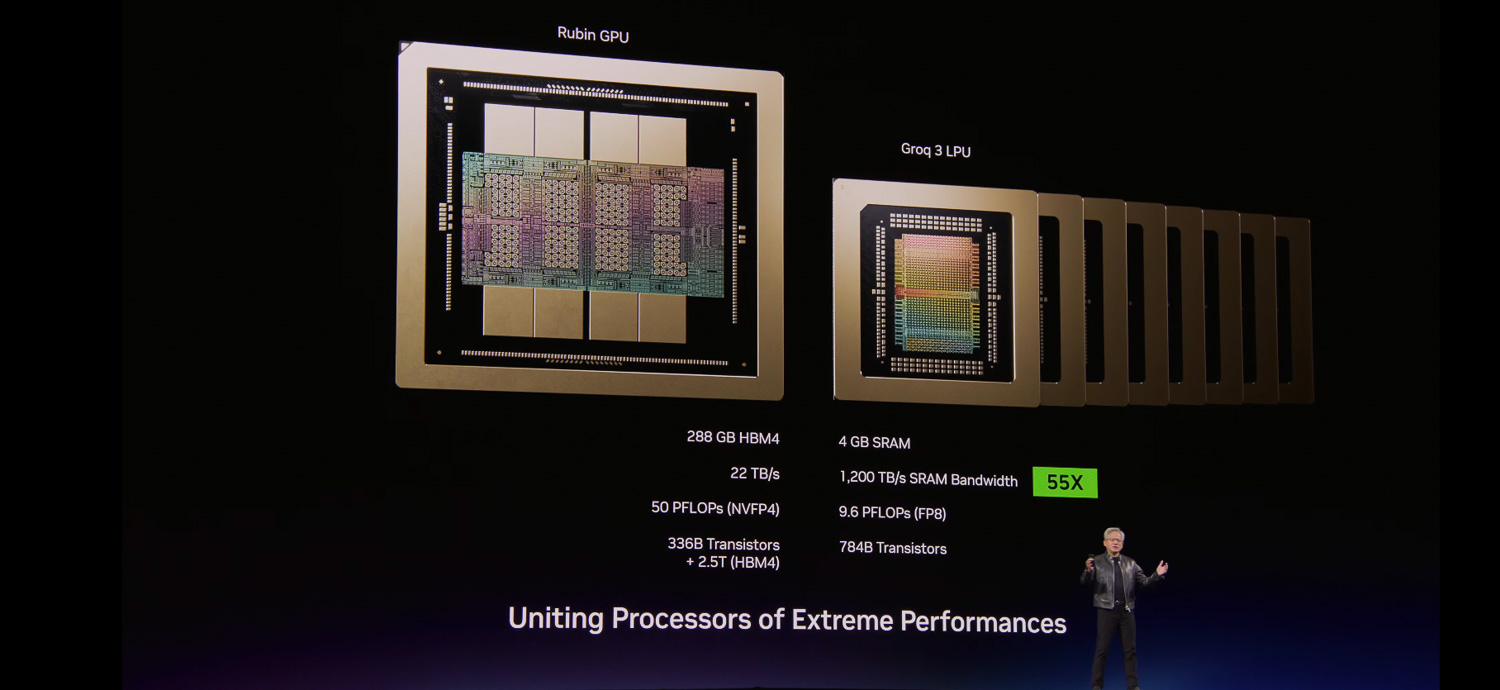
그 후 업계에서 엄청난 화제를 불러일으킨 Groq 인수 소식이 전해졌고, NVIDIA가 Groq의 LPU 기술을 Vera Rubin 플랫폼에 어떻게 통합할지에 대한 추측이 난무했습니다. NVIDIA는 GTC 2026에서 LPX를 발표하며 이러한 궁금증을 해소했습니다. 발표 내용을 보면, 기존 CPX 랙 콘셉트가 Groq 3 LPX 랙으로 진화했으며, CPX의 컨텍스트 처리 중심 설계는 Groq의 실리콘을 기반으로 하는 근본적으로 다른 디코딩 가속 아키텍처로 대체된 것으로 보입니다.
Rubin GPU와 Groq 3 LPU: 상호 보완적인 아키텍처
| 스펙 | 루빈 GPU | Groq 3 LPU (LP30) |
|---|---|---|
| 메모리 유형 | HBM4 | 적층형 SRAM |
| 메모리 용량(칩당) | 288 GB | 500 MB |
| 메모리 대역폭 | 22 TB / 초 | 150 TB / 초 |
| 내구력 | 고처리량 교육 및 사전 충전 | 초저지연 토큰 디코딩 |
| 전개 | VR NVL72 (랙당 72개) | LPX 랙 (랙당 256개) |
| 집합 랙 메모리 | 약 20.7TB HBM4 | 128GB SRAM |
| 확장 대역폭(랙) | 260TB/s NVLink 6 | 640 TB / 초 |
하나의 LPX 랙에는 256개의 Groq 3 LPU가 탑재됩니다. 각 LPU는 약 500MB의 적층형 SRAM을 포함하고 있어, 랙 전체에 약 128GB의 온칩 SRAM과 640TB/s의 확장 대역폭을 제공하며, 초저지연 디코딩 가속에 최적화되어 있습니다. 두 프로세서 유형 간의 성능 차이는 극명합니다. Rubin GPU는 22TB/s의 대역폭을 제공하는 288GB의 HBM4를 탑재한 반면, LPU는 용량을 희생하는 대신 칩당 SRAM 풀에서 150TB/s의 대역폭을 제공합니다. 맞춤형 Spectrum X 기반 인터커넥트를 통해 VR NVL72와 함께 배포될 경우, 두 랙은 모든 디코딩 토큰을 협력적으로 처리하도록 설계되었습니다. 어텐션 디코딩은 Rubin에서 수행되고 피드 포워드 레이어는 LPU로 오프로드됩니다. 수조 개의 파라미터를 가진 모델과 수백만 개의 토큰을 처리하는 컨텍스트에 최적화된 공동 설계된 LPX 아키텍처는 Vera Rubin과 결합하여 전력, 메모리 및 컴퓨팅 효율성을 극대화합니다. LPX 랙은 완전 액체 냉각 방식이며 MGX 인프라를 기반으로 구축되었고, Vera Rubin의 전반적인 출시 시기와 맞춰 2026년 하반기에 출시될 예정입니다.

중요한 점은 NVIDIA가 CUDA에 대한 변경이 필요하지 않다고 확인했다는 것입니다. LPU는 Vera 및 NVL72 플랫폼에서 실행되는 기존 CUDA 스택의 가속기 역할을 하며, 연산은 토큰 단위로 투명하게 오프로드됩니다. GTC 질의응답에서 NVIDIA는 LPU를 "디코딩 모델 부스터"라고 설명하며, 차세대 프리미엄 및 울트라 프리미엄 모델 서비스를 구현하기 위해 "수조 개의 매개변수를 가진 모델을 배포하는 AI 연구소 및 AI 프론티어 모델 빌더와 긴밀히 협력할 것"이라고 밝혔습니다. Groq의 창립자와 엔지니어들이 NVIDIA에 합류했으며, 두 팀 간의 협력은 Groq 로드맵을 MGX 인프라에 통합하는 과정에서 매우 성공적으로 진행되고 있는 것으로 알려져 있습니다. LPX 배포는 초기에는 광범위한 OEM 공급보다는 모델 빌더와 서비스 제공업체에 초점을 맞출 예정입니다. NVIDIA와 Groq의 통합을 통해 실제 성능 향상이 어떻게 나타날지 기대됩니다.
Vera CPU 랙: 강화 학습 및 에이전트 기반 워크로드에 최적화된 컴퓨팅 환경
에이전트형 AI에 새로운 유형의 CPU가 필요한 이유
NVIDIA가 전용 CPU 랙을 구축한 이유를 이해하려면 현대 AI 개발의 학습 후 단계에서 강화 학습(RL)이 어떻게 작동하는지 이해하는 것이 도움이 됩니다. 학습 후 단계는 모델이 대규모 데이터 세트로 사전 학습된 후, 특정 사용 사례에 맞게 모델을 개선하고 특화하는 단계입니다.
강화 학습 환경에서 학습 과정은 세 가지 핵심 요소로 구성됩니다. 정책 모델(학습 대상 모델), 모델이 행동을 취하고 피드백을 받는 환경, 그리고 행동의 질을 평가하는 보상 신호입니다. 정책 모델은 후보 출력값을 생성하고, 이 출력값들은 환경에서 실행되어 보상 모델에 의해 점수가 매겨지며, 결과로 얻은 기울기를 사용하여 정책을 업데이트합니다.
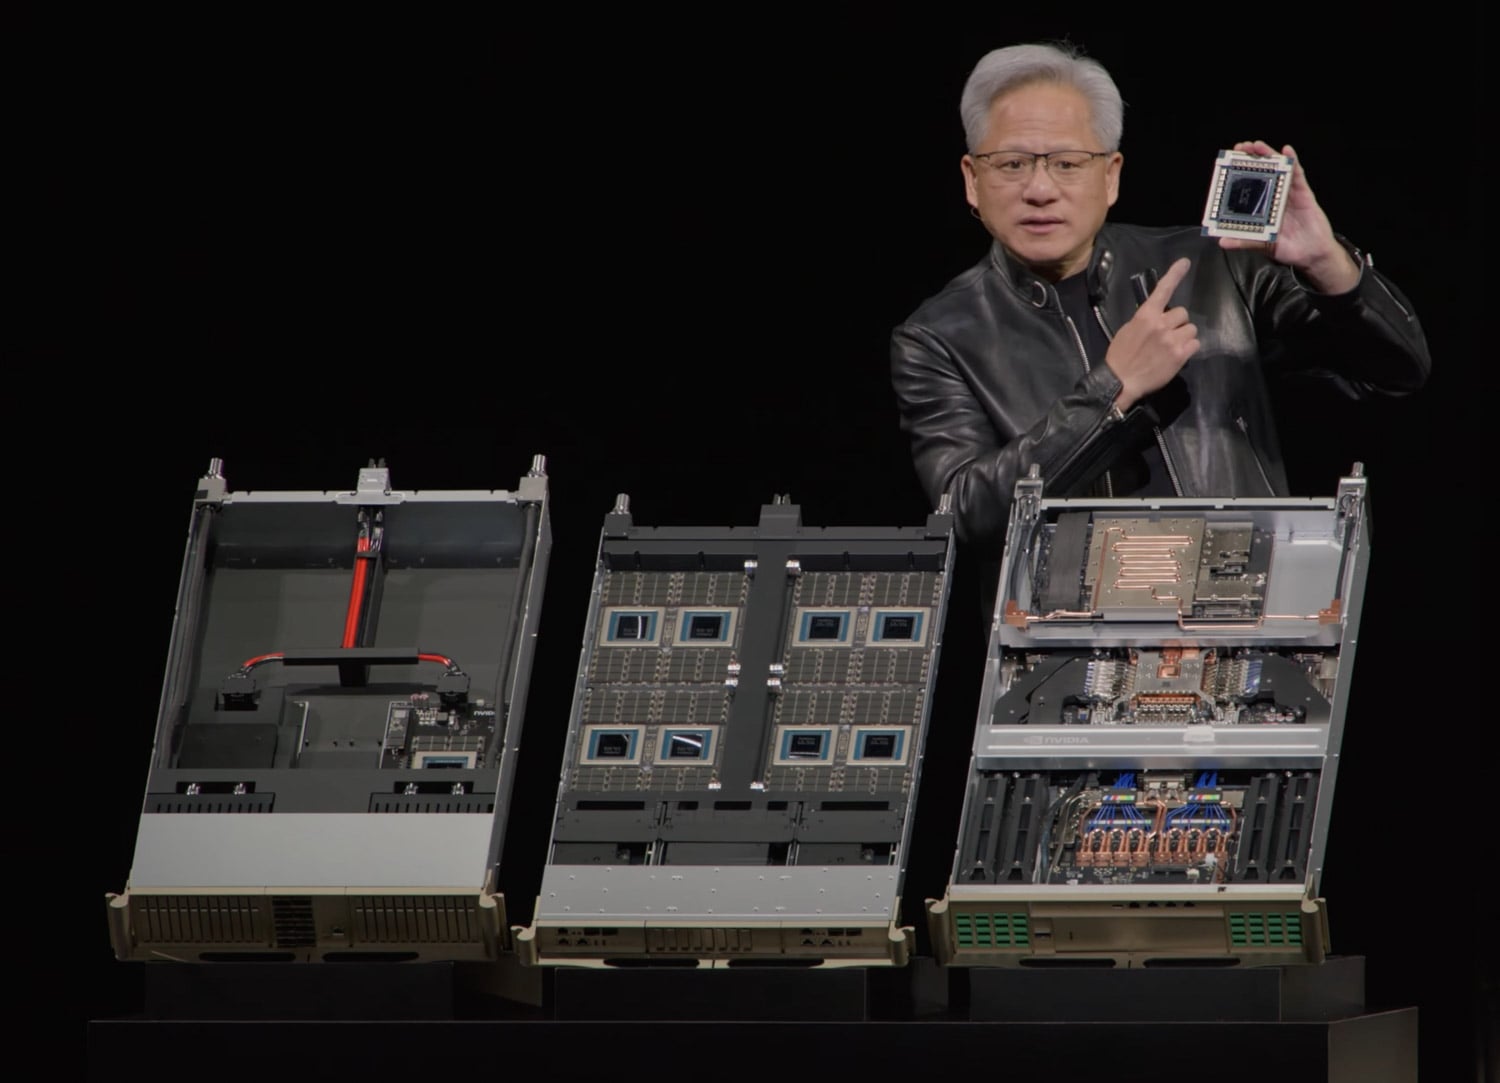
에이전트형 AI 워크로드의 경우, 이러한 강화 학습(RL) 환경은 추상적인 시뮬레이션이 아니라 실제 컴퓨팅 샌드박스입니다. 예를 들어, Claude Code와 같은 도구나 유사한 자율 코딩 에이전트를 사용하여 에이전트형 코딩 모델을 학습 후 처리하는 경우를 생각해 보세요. 이 환경에서는 세 가지 컴퓨팅 풀이 동시에 작동해야 합니다. 첫째, 정책 모델 가중치를 업데이트하는 GPU 가속기로 구성된 학습 풀이 있습니다. 둘째, 추론 가속기는 현재 정책 모델 체크포인트를 실행하여 후보 동작(코드 수정, 도구 호출, 파일 작업)을 대규모로 생성합니다. 셋째, 그리고 가장 중요한 것은 실제 RL 환경이 실행되는 대규모 일반 CPU 컴퓨팅 풀입니다. 이러한 환경에서 에이전트는 생성된 코드를 실행하고, 테스트 스위트를 실행하고, 도구를 호출하고, SQL 쿼리를 실행하고, 바이너리를 컴파일하고, 파일 시스템과 상호 작용하고, 학습 루프에 피드백되는 보상 신호를 생성하는 모든 샌드박스 작업을 수행합니다.
기존 컴퓨팅 요구 사항의 규모는 상당합니다. 정책 모델의 각 실행은 수십 개의 순차적인 도구 호출을 트리거할 수 있으며, 다음 단계로 진행하기 전에 각 도구 호출이 실행, 평가 및 반환되어야 합니다. 학습 실행 중에 수천 개의 데이터 포인트를 병렬로 생성할 때, GPU 학습 클러스터가 환경 실행으로 인해 멈추지 않도록 하려면 엄청난 수의 고속 CPU가 필요합니다. CPU 샌드박스 풀의 지연 시간은 GPU 사이클 유휴 및 학습 컴퓨팅 자원 낭비로 직결됩니다. 이러한 문제는 배포된 에이전트 시스템의 추론 시간에도 동일하게 적용됩니다. 에이전트가 수행하는 모든 도구 호출, 코드 컴파일 및 샌드박스 실행은 CPU 작업이며, 엔드투엔드 에이전트 파이프라인의 응답성을 유지하기 위해 충분히 빠르게 완료되어야 합니다. NVIDIA의 보도 자료에서 언급했듯이, CPU는 더 이상 단순히 모델을 지원하는 역할을 하는 것이 아니라 모델을 구동하는 역할을 합니다.
Vera CPU 랙: NVIDIA의 해답
이러한 요구 사항을 충족하기 위해 NVIDIA는 에이전트형 AI 및 강화 학습 시대를 위해 특별히 설계된 세계 최초의 프로세서인 Vera CPU를 출시했습니다. Vera CPU 랙은 256개의 액체 냉각 방식 Vera 프로세서를 탑재한 전용 랙 규모 시스템으로, 22,500개 이상의 동시 CPU 환경을 지원하며 각 환경은 독립적으로 최대 성능으로 실행될 수 있습니다. AI 팩토리는 단일 랙에서 수만 개의 동시 인스턴스와 에이전트형 도구를 신속하게 배포하고 확장할 수 있습니다. 이 랙은 총 400TB의 메모리, 300TB/s의 총 메모리 대역폭, 그리고 64개의 BlueField-4 DPU를 제공하며, 이 모든 구성 요소는 Vera Rubin 및 DGX 에코시스템과 호환되고 NVIDIA MGX 모듈형 레퍼런스 아키텍처를 기반으로 구축되었습니다.
Vera CPU 자체는 NVIDIA가 맞춤 설계한 88개의 Olympus 코어로 구성되어 있으며, Armv9.2와 완벽하게 호환됩니다. 각 코어는 NVIDIA 공간 멀티스레딩(Spatial Multithreading)을 사용하여 두 개의 작업을 동시에 처리할 수 있습니다. 2세대 저전력 메모리 서브시스템은 LPDDR5X 기반으로 최대 1.2TB/s의 대역폭을 제공하며, 이는 일반 CPU 대비 두 배의 대역폭을 절반의 전력 소비로 구현한 것입니다.
성능 특성 외에도 Vera Rack은 실질적인 공급망 문제를 해결합니다. 수만 대의 GPU를 사용하는 대규모 AI 팩토리를 운영하는 기업은 환경 실행을 위해 그에 상응하는 대규모 CPU가 필요하며, AMD나 Intel로부터 필요한 규모와 일정에 맞춰 고성능 x86 프로세서를 조달하는 것은 상당한 구매 및 공급 문제를 야기할 수 있습니다. 수직적으로 통합된 NVIDIA CPU 랙은 이러한 의존성을 간소화합니다.
NVIDIA와 협력하여 Vera CPU를 배포하는 고객사로는 Alibaba, ByteDance, Meta, Oracle Cloud Infrastructure를 비롯하여 CoreWeave, Crusoe, Lambda, Nebius, Nscale, Cloudflare, Together AI, Vultr 등이 있습니다. 제조 파트너사로는 Dell Technologies, HPE, Lenovo, Supermicro, ASUS, Cisco, Foxconn, GIGABYTE, QCT 등이 있습니다.
BlueField-4 STX 및 NVIDIA CMX: 추론 컨텍스트 메모리 저장소의 기반이 되는 참조 아키텍처
NVIDIA는 CES 2026에서 대규모 LLM 추론에서 키-값(KV) 캐시 관리를 위해 특별히 설계된 새로운 AI 네이티브 스토리지 인프라인 ICMS(Inference Context Memory Storage) 플랫폼을 발표했습니다. GTC 2026에서는 이 플랫폼을 구동하는 레퍼런스 아키텍처인 BlueField-4 STX를 공개했습니다. STX는 에이전트 컨텍스트 및 KV 캐시 데이터를 위해 GPU 메모리를 포드 전체에 걸쳐 원활하게 확장하는 모듈형 설계입니다. STX의 첫 번째 랙 스케일 구현인 새로운 NVIDIA CMX 컨텍스트 메모리 스토리지 플랫폼은 확장 가능한 추론 및 에이전트 시스템을 위해 고성능 컨텍스트 레이어를 통해 GPU 메모리를 확장합니다.
트랜스포머 기반 추론의 확장성을 살펴보면 전용 스토리지 계층의 필요성이 명확해집니다. 생성된 모든 토큰은 어텐션 메커니즘을 통해 이전의 모든 토큰을 처리해야 하며, 키-값(KV) 캐시는 미리 계산된 어텐션 행렬을 저장하여 재사용함으로써 재계산을 방지합니다. 문제는 KV 캐시 크기가 시퀀스 길이와 배치 크기에 따라 증가한다는 것입니다. 수백만 개의 토큰 컨텍스트 윈도우에서 수천 개의 동시 요청을 처리하는 멀티테넌트 환경에서는 GPU HBM이 한계에 도달합니다. 운영자는 배치 크기를 줄이거나, 컨텍스트 윈도우를 단축하거나, GPU를 추가해야 하는데, 이 모든 방법은 경제성이나 성능을 저하시킵니다.
BlueField-4 STX는 GPU HBM과 기존 스토리지 사이에 위치하는 고대역폭 공유 스토리지 계층을 제공하여 이러한 문제를 해결합니다. 이 계층은 KV 캐시 액세스 패턴에 최적화되어 있습니다. Vera Rubin 플랫폼으로 가속되며, Vera CPU와 ConnectX-9 SuperNIC을 결합한 스토리지 최적화 BlueField-4 프로세서, Spectrum-X 이더넷 네트워킹, NVIDIA DOCA 및 NVIDIA AI Enterprise 소프트웨어를 활용합니다. NVIDIA는 CMX 플랫폼이 기존 스토리지 대비 최대 5배 빠른 토큰 처리 속도, 고성능 스토리지용 기존 CPU 아키텍처 대비 4배 높은 에너지 효율, 그리고 엔터프라이즈 AI 데이터의 2배 빠른 데이터 수집 속도를 제공한다고 주장합니다.
NVIDIA는 또한 DOCA Memos라는 새로운 DOCA 프레임워크를 선보입니다. 이 프레임워크는 전용 KV 캐시 처리를 통해 BlueField-4 스토리지를 강화하여 추론 처리량을 높이는 동시에 전력 효율성을 크게 개선합니다. 결과적으로 POD 전반에 걸친 컨텍스트를 통해 AI 에이전트와의 더욱 빠른 멀티턴 상호 작용, 확장 가능한 AI 서비스, 그리고 전반적인 인프라 활용률 향상을 제공합니다. 이는 분산형 사전 채우기/디코딩 단계, 스마트 라우팅, 계층형 스토리지 오프로딩을 위한 소프트웨어 프레임워크를 제공하는 오픈 소스 NVIDIA Dynamo 프로젝트와 연계됩니다.
STX는 NVIDIA가 직접 판매하지는 않지만 스토리지 에코시스템 파트너에게 제공하는 레퍼런스 아키텍처입니다. Cloudian, DDN, Dell Technologies, Everpure, Hitachi Vantara, HPE, IBM, MinIO, NetApp, Nutanix, VAST Data, WEKA 등 여러 스토리지 공급업체가 STX 기반 차세대 인프라를 공동 설계하고 있습니다. AIC, Supermicro, QCT는 STX 기반 시스템을 구축하는 제조 파트너입니다. CoreWeave, Crusoe, IREN, Lambda, Mistral AI, Nebius, Oracle Cloud Infrastructure, Vultr 등은 컨텍스트 메모리 스토리지에 STX를 도입할 계획인 주요 AI 연구소 및 클라우드 제공업체입니다. STX 기반 플랫폼은 2026년 하반기부터 파트너사를 통해 제공될 예정입니다.
베라 루빈 DSX AI 팩토리 레퍼런스 디자인 및 옴니버스 DSX 블루프린트
NVIDIA는 개별 랙과 포드를 넘어, 베라 루빈 DSX AI 팩토리 레퍼런스 디자인과 NVIDIA 옴니버스 DSX 블루프린트의 정식 출시를 발표했습니다. 이 둘은 와트당 토큰 효율을 극대화하고 최초 생산 시간을 단축하는 공동 설계 AI 인프라를 설계, 구축 및 운영하기 위한 포괄적인 프레임워크를 제공합니다. 컴퓨팅, 네트워킹, 스토리지, 전력 및 냉각을 긴밀하게 통합한 이 아키텍처는 에너지 효율성을 높이고 AI 팩토리가 지속적인 고강도 워크로드에서도 안정적으로 확장될 수 있도록 보장하며, 동시에 최대 가동 시간을 유지합니다.
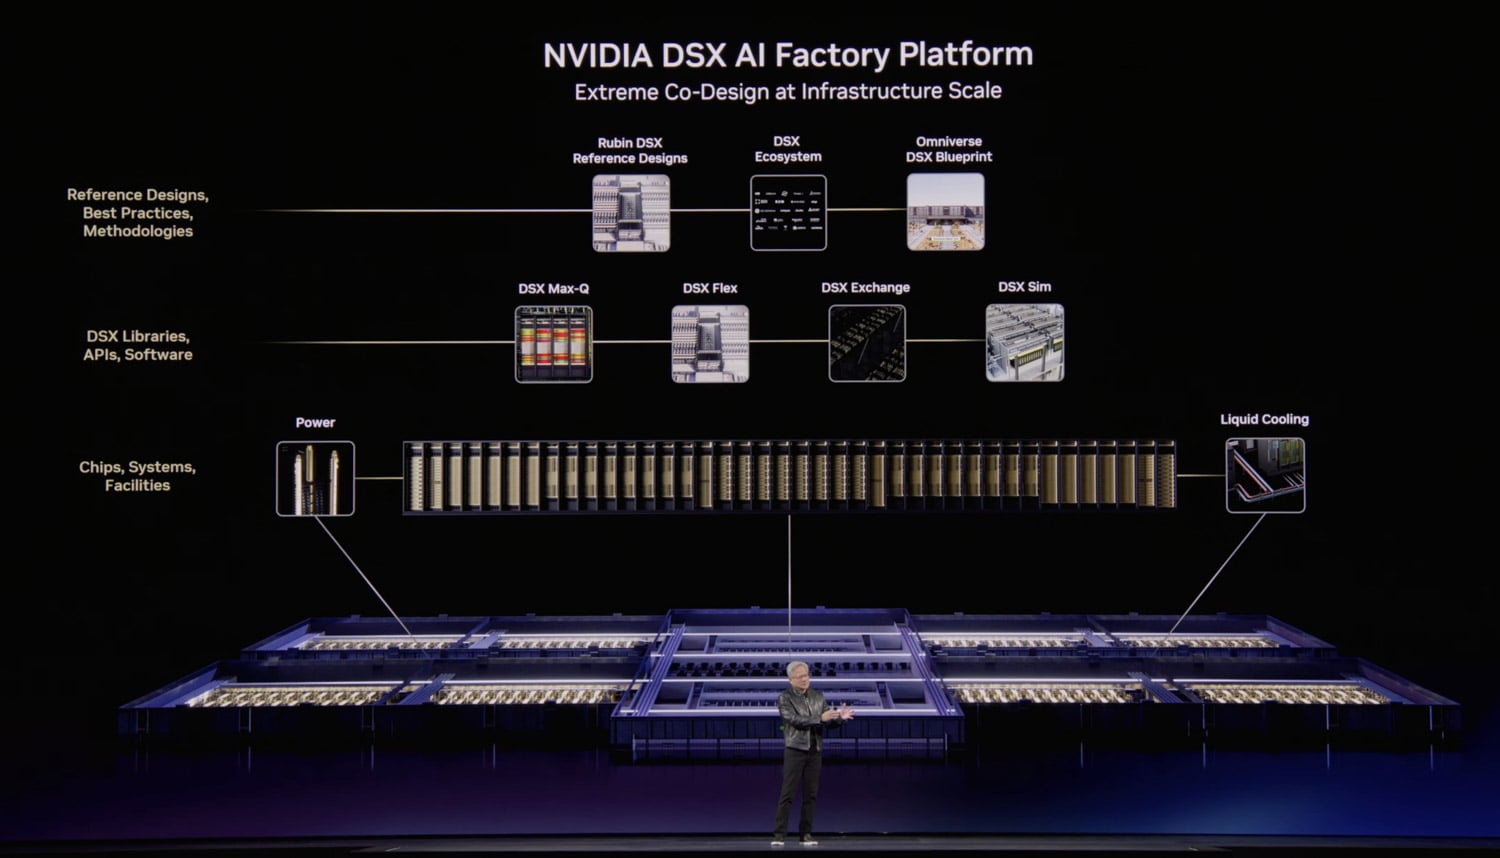
Rubin DSX 소프트웨어 스택은 개방형, 모듈형, 구성 가능한 구조로 클러스터 하드웨어와 전원 및 냉각 시스템을 연결합니다. 여기에는 여러 구성 요소 라이브러리가 포함됩니다. DSX Max-Q는 AI 팩토리 전체에 걸쳐 동적 전력 공급을 지원하여 고정 전력 데이터 센터 내에서 AI 인프라를 30% 더 확장할 수 있도록 합니다. DSX Flex는 AI 팩토리를 그리드 유연성을 갖춘 자산으로 만들어 NVIDIA가 추산하는 100기가와트(GW)의 미활용 전력을 활용할 수 있도록 합니다. 이는 현재 에너지가 AI 인프라 구축의 가장 큰 병목 현상이며, 300천억 달러 이상의 장비 미공급과 200GW 이상의 프로젝트가 미국 내 전력망 연결 대기열에 있는 상황에서 매우 중요한 기능입니다. DSX Exchange는 IT, 운영 기술 및 운영 담당자 간에 컴퓨팅, 네트워크, 에너지, 전력 및 냉각 신호를 확장 가능하고 안전하게 통합할 수 있도록 합니다. DSX Sim 모델은 NVIDIA DSX Air 플랫폼을 사용하여 AI 팩토리를 고정밀 디지털 트윈으로 검증합니다.
이제 build.nvidia.com에서 정식 출시된 Omniverse DSX 블루프린트는 Vera Rubin DSX 레퍼런스 디자인과 완벽하게 호환됩니다. 개발자는 이 블루프린트를 통해 AI 공장의 물리적으로 정확한 디지털 트윈을 구축하고, 실시간으로 운영을 시뮬레이션하며, 건설 또는 배포 전에 성능을 최적화할 수 있습니다. 이를 통해 전력, 냉각, 네트워킹 및 운영을 단일 환경으로 통합하여 수익 창출 시간을 단축하고 AI 효율성을 높일 수 있습니다.
Cadence, Dassault Systèmes, Eaton, Jacobs, Nscale, Phaidra, Procore Technologies, PTC, Schneider Electric, Siemens, Switch, Trane Technologies, Vertiv 등 업계 주요 기업들이 DSX 아키텍처 및 청사진 개발에 참여했습니다. 특히 Nscale과 Caterpillar는 웨스트버지니아에 위치한 수 기가와트 규모의 AI 팩토리(세계 최대 규모 중 하나로 꼽힘)에서 DSX Vera Rubin 레퍼런스 디자인을 구현하고 있습니다. 에너지 분야에서는 Emerald AI, GE Vernova, Hitachi, Siemens Energy가 DSX 레퍼런스 아키텍처를 활용하여 전력망 용량을 확보하고 새로운 AI 팩토리 구축에 필요한 전력을 공급하고 있습니다. Phaidra는 DSX Max-Q를 자체 학습형 AI 에이전트에 통합하여 냉각 부하 급증을 줄이고 안전성을 유지하면서 약 10% 향상된 컴퓨팅 성능을 제공하고 있습니다.
NVIDIA 에이전트 툴킷 및 OpenCLAW: 자율 에이전트를 위한 소프트웨어 스택
TC 2026에서는 에이전트 기반 AI 워크로드의 급속한 성장이 주목받았으며, NVIDIA는 자율 에이전트를 자사 역사상 가장 빠르게 성장하는 워크로드라고 설명했습니다. 소프트웨어 발표의 핵심은 역사상 가장 중요한 소프트웨어 릴리스로 평가받는 OpenCLAW였습니다. OpenCLAW는 CLAW라고 불리는 장기 실행형 자율 진화 에이전트를 위한 오케스트레이션 프레임워크로, 개별 작업이 아닌 전체 임무를 계획, 실행 및 수행할 수 있는 자율 시스템입니다. NVIDIA는 CLAW를 AI의 새로운 애플리케이션 레이어로 규정하며, "무엇을, 어떻게, 왜"라는 질문에서 "만들고, 만들고, 제작하라"라는 질문으로 전환되었다고 언급했습니다.
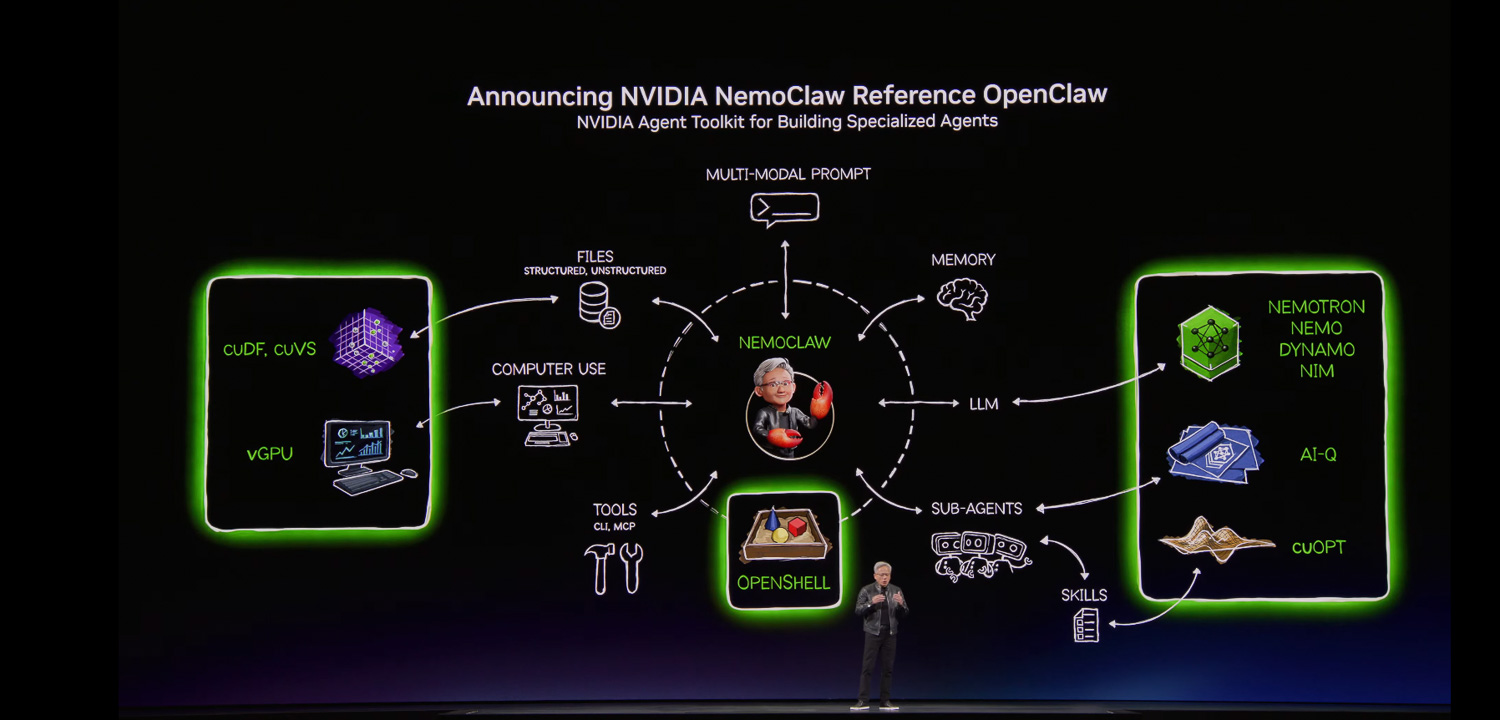
NVIDIA는 장시간 실행되는 자율 에이전트를 구축, 평가 및 최적화하기 위한 모델, 런타임 및 블루프린트 모음인 NVIDIA Agent Toolkit을 발표했습니다. 주요 구성 요소로는 추론, 코딩 및 음성 처리를 위한 Nemotron 오픈 소스 모델, 에이전트 프로파일링 및 사용자 정의를 위한 Nemo, 모델 추론을 위한 NIM, 그리고 확장형 서비스를 위한 Dynamo 1.0이 있습니다. 새롭게 추가된 구성 요소로는 에이전트 실행을 위한 정책 기반 네트워크, 개인 정보 보호 및 보안 가드레일을 제공하는 오픈 소스 안전 및 보안 런타임인 NVIDIA OpenShell과, 딥 리서치 에이전트를 위한 최첨단 오픈 소스 모델 인텔리전스를 결합한 오픈 소스 블루프린트인 IQ가 있습니다. IQ는 Deep Research Bench 1과 Complex Deep Research Bench 2 벤치마크 모두에서 1위를 차지한 최초의 연구 시스템입니다. 또한, 새로운 cuOPT 스킬은 자연어로 설명된 최적화 문제에 대한 전문 지식을 제공합니다.
NVIDIA는 OpenCLAW 개발자인 피터 스타인버거와 협력하여 개발한 OpenCLAW 커뮤니티 기여 프로젝트인 Nemo CLAW도 발표했습니다. Nemo CLAW는 단일 명령으로 OpenCLAW, Nemotron 모델 및 OpenShell 런타임을 설치하여 에이전트가 정의된 개인 정보 보호 및 보안 가이드라인 내에서 작동하면서 새로운 기술을 개발하고 학습할 수 있는 기반을 제공합니다. 클라우드 인프라부터 온프레미스 RTX PC, DGX Station 및 DGX Spark에 이르기까지 모든 플랫폼에서 실행할 수 있습니다.
DGX Spark 및 DGX Station: 로컬 CLAW 개발 플랫폼
NVIDIA는 많은 개발자들이 컴퓨팅 리소스를 완벽하게 제어할 수 있는 로컬 개발 환경을 선호한다는 점을 인식하고 CLAW 에이전트 개발에 특화된 두 가지 새로운 플랫폼을 출시했습니다. DGX Spark는 안전하고 항상 가동되는 자율 에이전트를 실행하기 위한 고성능, 고효율 플랫폼으로, DGX Spark 및 GB10 기반 OEM 파트너 시스템은 현재 전 세계적으로 공급되고 있습니다. 최고의 로컬 CLAW 개발 플랫폼으로 자리매김한 DGX Station은 개발자가 클라우드 연결 없이 온프레미스 환경에서 최첨단 인텔리전스를 갖춘 모델을 실행할 수 있도록 지원합니다. 이는 개발에 있어 매우 중요한 요소로, 모든 리소스가 로컬에 저장되어 완벽한 제어와 보안을 보장합니다. DGX Station 시스템은 2026년 3월 16일부터 OEM 파트너를 통해 주문할 수 있습니다.
베라 루빈 우주 모듈: 지구 너머의 AI 인프라
NVIDIA는 최신 가속 컴퓨팅 플랫폼이 우주 혁신의 새로운 시대를 열어 궤도 데이터 센터(ODC), 지리 공간 정보 및 자율 우주 작전에 AI 컴퓨팅을 제공한다고 발표했습니다. NVIDIA Vera Rubin 우주 모듈은 NVIDIA H100 GPU보다 최대 25배 더 강력한 우주 기반 추론 AI 컴퓨팅 성능을 제공하여 대규모 언어 모델과 고급 기반 모델을 궤도에서 직접 실행할 수 있도록 합니다. 긴밀하게 통합된 CPU-GPU 아키텍처는 우주 기반 장비에서 발생하는 대규모 데이터 스트림을 실시간으로 처리하는 데 필요한 성능과 메모리를 제공합니다.
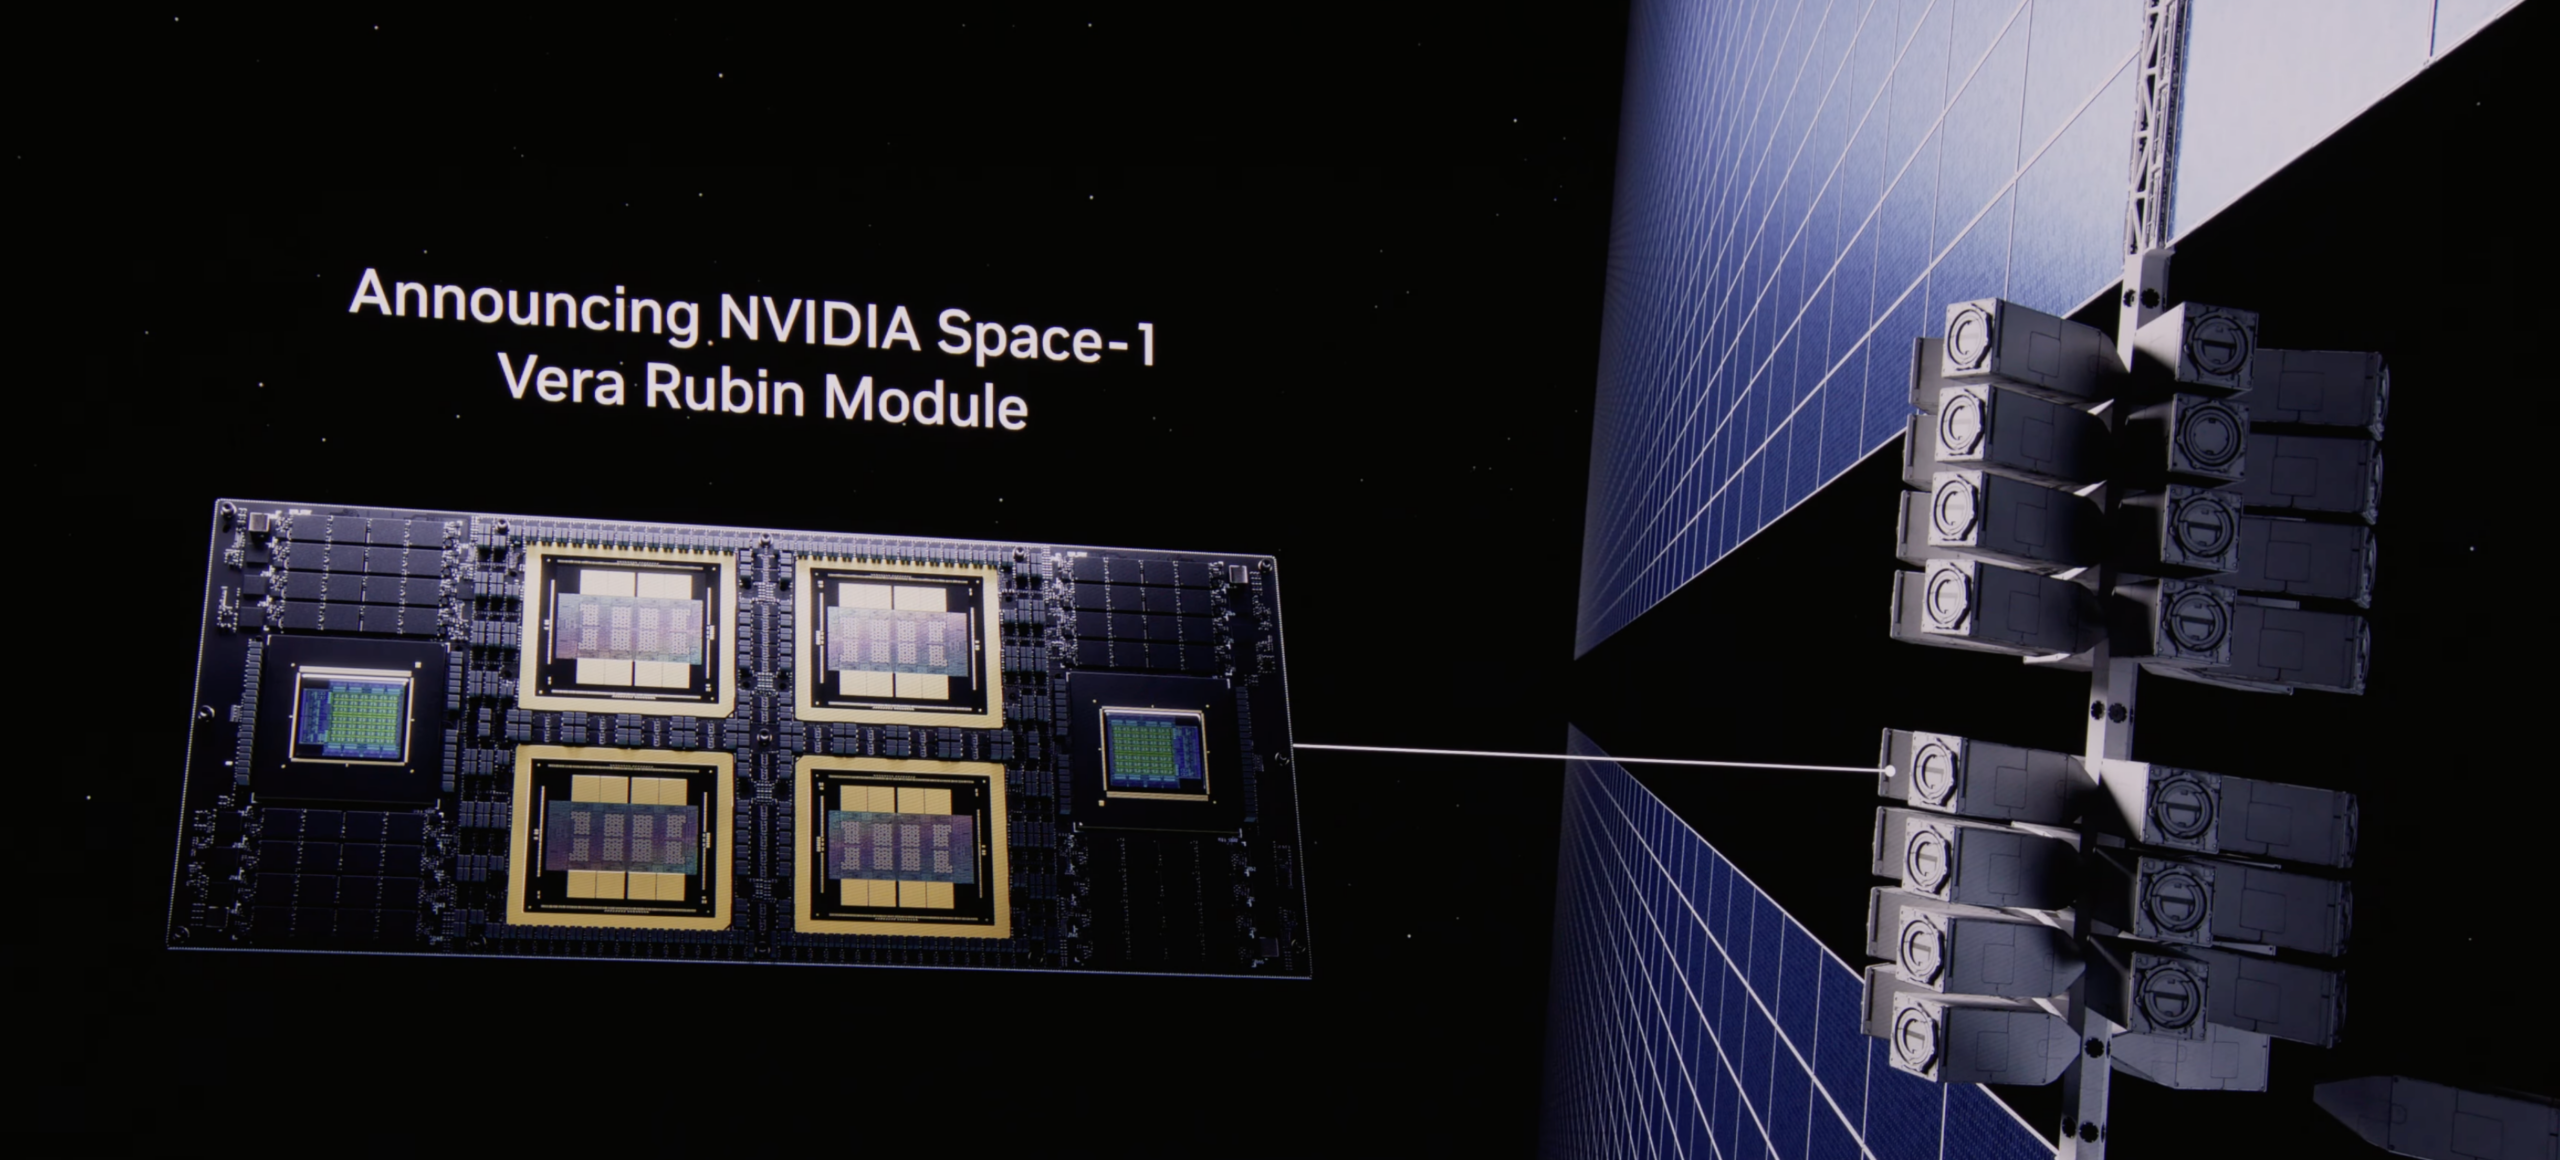
베라 루빈 우주 모듈과 함께 NVIDIA IGX Thor는 궤도상의 임무 수행에 필수적인 엣지 환경을 위한 산업용 수준의 내구성을 제공하며, Jetson Orin은 SWaP(크기, 무게, 전력) 제약이 있는 우주선에 최적화된 초소형 모듈에서 고성능 AI 추론을 제공합니다. 지상에서는 RTX PRO 6000 Blackwell Server Edition GPU가 지리 공간 정보 처리를 위한 기존 CPU 기반 배치 시스템 대비 최대 100배 빠른 성능을 제공합니다. Aetherflux, Axiom Space, Kepler Communications, Planet Labs, Sophia Space, Starcloud 등의 파트너사들은 이러한 플랫폼을 기반으로 궤도 데이터 센터, 자율 우주 작전, 실시간 지구 관측 등 차세대 우주 임무를 구축하고 있습니다.
NVIDIA Dynamo 1.0: AI 팩토리를 위한 추론 운영 체제
GTC 2026 발표의 마지막을 장식하며, NVIDIA는 AI 팩토리 추론을 위한 최초의 분산 운영 체제로 소개되는 오픈 소스 소프트웨어 Dynamo 1.0의 상용화를 시작했습니다. 컴퓨터의 운영 체제가 하드웨어와 애플리케이션을 조율하는 것처럼, Dynamo 1.0은 AI 팩토리를 위한 분산 오케스트레이션 계층 역할을 하며, 클러스터 전체의 GPU 및 메모리 리소스를 원활하게 관리하여 복잡하고 이기종적인 AI 워크로드를 대규모로 처리합니다.
Dynamo 1.0은 지능형 라우팅과 GPU 및 저비용 스토리지 계층 간 데이터 이동 기능을 통해 추론 작업을 GPU에 분산시켜 불필요한 연산을 줄이고 메모리 제약을 완화합니다. 에이전트형 AI 및 장기 컨텍스트 워크로드의 경우, Dynamo는 이전 단계에서 가장 관련성이 높은 KV 캐시 데이터를 이미 보유하고 있는 GPU로 요청을 라우팅한 다음, 필요하지 않을 때는 해당 메모리를 오프로드할 수 있습니다. 이 기능은 BlueField-4 STX/ICMS 스토리지 아키텍처와 직접적으로 연동됩니다. 최근 업계 벤치마크에서 Dynamo는 NVIDIA Blackwell GPU의 추론 성능을 최대 7배까지 향상시켜 토큰 비용을 절감하고 수백만 대의 GPU에 대한 수익 창출 기회를 확대했으며, 이 모든 것을 무료 오픈 소스 소프트웨어로 제공합니다.
NVIDIA는 LangChain, llm-d, LMCache, SGLang, vLLM을 비롯한 인기 있는 추론 프레임워크에 Dynamo 및 TensorRT-LLM 최적화 기능을 통합하여 오픈 소스 생태계를 가속화하고 있습니다. 핵심 Dynamo 구성 요소, 메모리 관리를 위한 KVBM, GPU 간 빠른 데이터 이동을 위한 NIXL, 그리고 확장성을 간소화하는 Grove는 독립형 모듈로도 제공됩니다. 또한 NVIDIA는 오픈 소스 프레임워크에 기본적으로 통합될 수 있도록 FlashInfer 프로젝트에 TensorRT-LLM CUDA 커널을 제공하고 있습니다.
채택 범위가 매우 넓다는 점이 주목할 만합니다. NVIDIA 추론 플랫폼은 이제 AWS, Microsoft Azure, Google Cloud, Oracle Cloud Infrastructure를 비롯한 클라우드 제공업체와 NVIDIA 클라우드 파트너인 Alibaba Cloud, CoreWeave, Crusoe, DigitalOcean, Nebius, Nscale, Together AI와 통합되었습니다. AI 네이티브 기업인 Cursor, Hebbia, Perplexity와 추론 엔드포인트 제공업체인 Baseten, Deep Infra, Fireworks도 이 플랫폼을 도입했습니다. Amazon, AstraZeneca, BlackRock, ByteDance, Coupang, Instacart, Meituan, PayPal, Pinterest, Shopee, SoftBank Corp. 등 글로벌 기업들도 NVIDIA 추론 스택을 채택했습니다. Dynamo 1.0은 오늘부터 전 세계 개발자들이 사용할 수 있습니다.


 아마존