

NVIDIA Hopper 아키텍처는 차세대 AI 데이터 센터를 강화하는 데 중점을 두고 NVIDIA GTC에서 중심 무대에 올랐습니다. 선구적인 미국 컴퓨터 과학자인 Grace Hopper의 이름을 딴 이 차세대 가속 컴퓨팅 플랫폼은 이전 제품인 NVIDIA Ampere보다 훨씬 뛰어난 성능을 제공합니다.
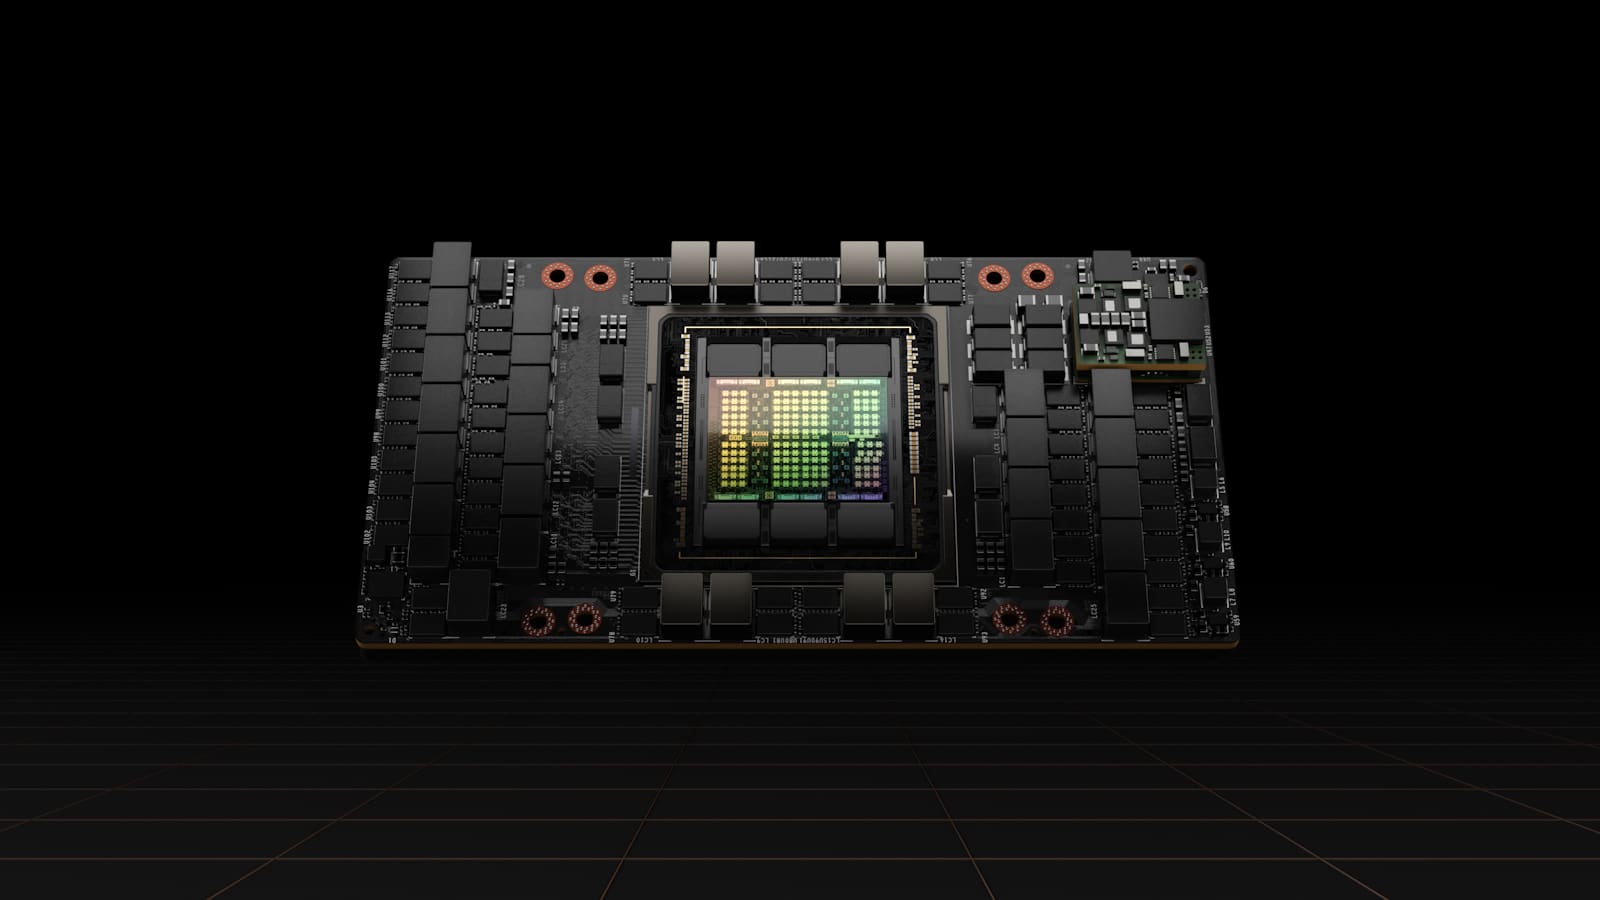
NVIDIA는 또한 100억 개의 트랜지스터가 탑재된 최초의 Hopper 기반 GPU인 NVIDIA H80을 발표했습니다. 세계에서 가장 크고 가장 강력한 가속기로 알려진 H100은 거대한 AI 언어 모델, 딥 추천 시스템, 유전체학 및 복잡한 디지털 트윈을 발전시키기 위한 트랜스포머 엔진과 확장성이 뛰어난 NVIDIA NVLink 상호 연결을 특징으로 합니다.
NVIDIA의 창립자이자 CEO인 Jensen Huang은 “데이터 센터는 인공 지능 공장이 되어 산더미 같은 데이터를 처리 및 정제하여 지능을 생산하고 있습니다. "NVIDIA H100은 기업이 AI 기반 비즈니스를 가속화하는 데 사용하는 세계 AI 인프라의 엔진입니다."
H100 기술
NVIDIA의 가속화된 컴퓨팅 요구 사항을 위해 설계된 최첨단 TSMC 4N 프로세스를 사용하여 구축된 H100은 거의 5TB/s 외부 연결을 포함하여 AI, HPC, 메모리 대역폭, 상호 연결 및 통신을 가속화하는 상당한 발전을 제공합니다. Hopper H100은 PCIe Gen5를 지원하고 3TB/s의 메모리 대역폭을 가능하게 하는 HBM3(High Bandwidth Memory 3)를 활용하는 최초의 GPU입니다. 100개의 HXNUMX GPU는 전 세계 인터넷 트래픽과 맞먹는 성능을 유지할 수 있어 고객이 고급 추천 시스템과 실시간으로 데이터에 대한 추론을 실행하는 대규모 언어 모델을 제공할 수 있습니다.
자연어 처리를 위한 선택인 Transformer Engine은 지금까지 발명된 가장 중요한 딥 러닝 모델 중 하나입니다. H100 가속기의 트랜스포머 엔진은 정확도를 잃지 않고 이전 세대에 비해 이러한 네트워크 속도를 6배까지 높일 수 있도록 제작되었습니다.
다중 인스턴스 GPU(MIG) 기술을 사용하는 Hopper 아키텍처를 사용하면 단일 GPU를 7개의 더 작고 완전히 격리된 인스턴스로 분할하여 다양한 유형의 작업을 처리할 수 있습니다. MIG 기능을 이전 세대에 비해 최대 XNUMX배까지 확장함으로써 Hopper 아키텍처는 각 GPU 인스턴스의 클라우드 환경에서 안전한 다중 테넌트 구성을 제공합니다.
H100은 처리 중에 AI 모델과 고객 데이터를 보호하는 기밀 컴퓨팅 기능을 갖춘 세계 최초의 가속기입니다. 또한 고객은 의료, 금융 서비스 및 공유 클라우드 인프라와 같이 개인 정보에 민감한 산업을 위한 연합 학습에 기밀 컴퓨팅을 적용할 수 있습니다.
4세대 NVIDIA NVLink는 새로운 외부 NVLink 스위치와 결합하여 서버를 넘어 스케일업 네트워크로 확장하여 NVIDIA HDR Quantum InfiniBand를 사용하는 이전 세대에 비해 256배 더 높은 대역폭으로 최대 100개의 H9 GPU를 연결합니다.
NVIDIA H100은 온프레미스, 클라우드, 하이브리드 클라우드, 에지를 포함한 거의 모든 데이터 센터에 배포할 수 있으며 올해 후반에 출시될 예정입니다.
DGX H100 시스템
NVIDIA는 새로운 FP100 정밀도에서 100페타플롭스의 AI 성능을 제공하는 32개의 H8 GPU를 갖춘 XNUMX세대 DGX 시스템인 DGX HXNUMX을 발표했습니다. .
각 DGX H100 시스템은 100세대 NVLink로 연결된 900개의 H1.5 GPU를 탑재하여 이전 세대보다 XNUMX배 증가한 XNUMXGB/s 연결을 제공합니다. NVIDIA의 NVLink는 성공적인 데이터 전달을 보장하는 링크 수준 오류 감지 및 패킷 재생 메커니즘과 같은 탄력성 기능을 포함하는 대기 시간이 짧고 무손실 GPU 간 상호 연결입니다.
100세대 NVLink 외에도 H256은 새로운 NVLink 네트워크 상호 연결도 도입했습니다. 이 확장 가능한 버전의 NVLink는 여러 컴퓨팅 노드에서 최대 64개의 GPU에 대한 GPU 간 통신을 가능하게 합니다. NVIDIA는 또한 서버, 클러스터 및 데이터 센터 환경에서 여러 GPU를 연결하기 위해 노드 내부 및 외부 모두에 스위치를 포함하는 7.2세대 NVSwitch 기술을 도입했습니다. 새로운 NVSwitch가 있는 노드는 13.6개의 NVLink 포트를 제공하여 다중 GPU 연결을 가속화하여 총 스위치 처리량을 100Tbits/s에서 32Tbits/s로 거의 두 배로 늘립니다. NVSwitch는 H100 GPU XNUMX개 모두가 NVLink를 통해 연결할 수 있도록 합니다. 외부 NVLink 스위치는 차세대 NVIDIA DGX SuperPOD 슈퍼컴퓨터에서 최대 XNUMX개의 DGX HXNUMX 노드를 네트워크로 연결할 수 있습니다.
그레이스 CPU 슈퍼칩
NVIDIA는 단일 소켓에 144개의 Arm 코어가 포함된 Grace CPU Superchip을 발표했습니다. 이것은 AI 인프라 및 고성능 컴퓨팅을 위해 설계된 최초의 Arm Neoverse 기반 개별 데이터 센터 CPU로, 두 배의 메모리 대역폭과 에너지 효율성을 제공합니다.
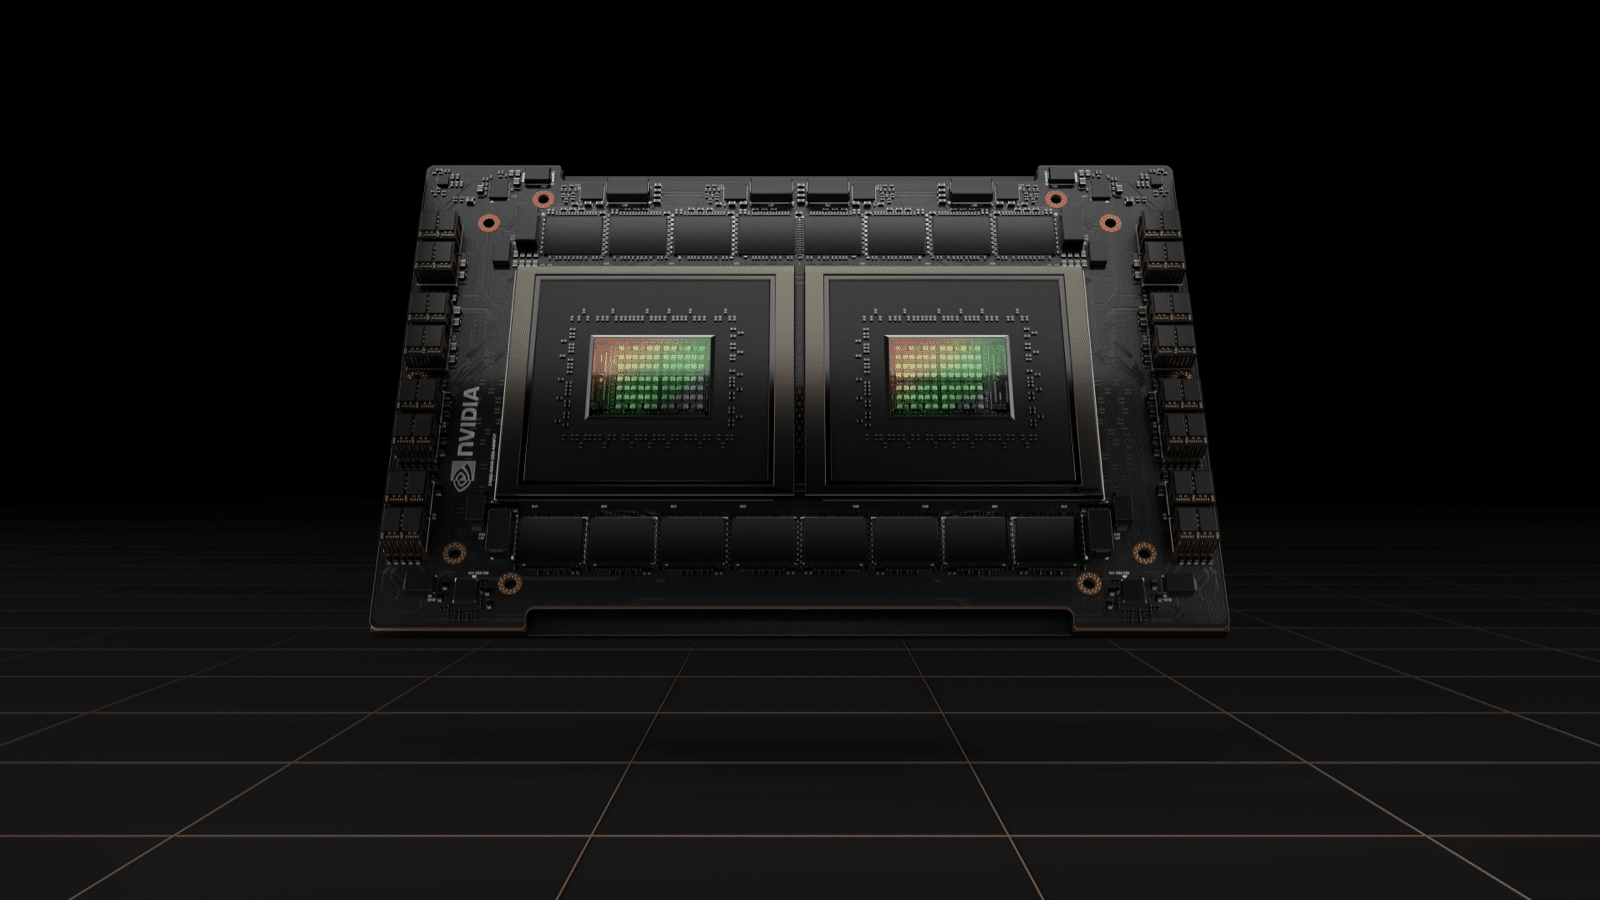
메모리 하위 시스템은 속도와 전력 소비의 균형을 위한 오류 수정 코드가 있는 LPDDR5x 메모리로 구성됩니다. LPDDR5x 메모리 하위 시스템은 기존 DDR5 설계의 대역폭을 1TB/s로 두 배로 늘리는 동시에 훨씬 적은 전력을 소비합니다.
Grace CPU Superchip은 NVIDIA RTX, NVIDIA HPC, NVIDIA AI 및 Omniverse를 포함한 NVIDIA의 모든 컴퓨팅 소프트웨어 스택을 실행할 것입니다. Grace CPU Superchip은 NVIDIA ConnectX-7 NIC와 함께 독립 실행형 CPU 전용 시스템 또는 XNUMX, XNUMX, XNUMX 또는 XNUMX개의 호퍼 기반 GPU가 있는 GPU 가속 서버로 서버에 구성할 수 있는 유연성을 제공하여 고객이 성능을 최적화할 수 있도록 합니다. 단일 소프트웨어 스택을 유지하면서 특정 워크로드에 대해
옴니버스 컴퓨팅 시스템
데이터 센터에 초점을 맞추면서 NVIDIA는 대규모 디지털 트윈을 지원하도록 설계된 컴퓨팅 시스템인 NVIDIA OVX를 발표했습니다. 디지털 트윈은 물리적 세계에 연결된 가상 세계입니다. NVIDIA OVX는 물리적으로 정확한 실시간 세계 시뮬레이션 및 3D 디자인 협업 플랫폼인 NVIDIA Omniverse 내에서 실행되는 복잡한 디지털 트윈 시뮬레이션을 작동하도록 설계되었습니다.
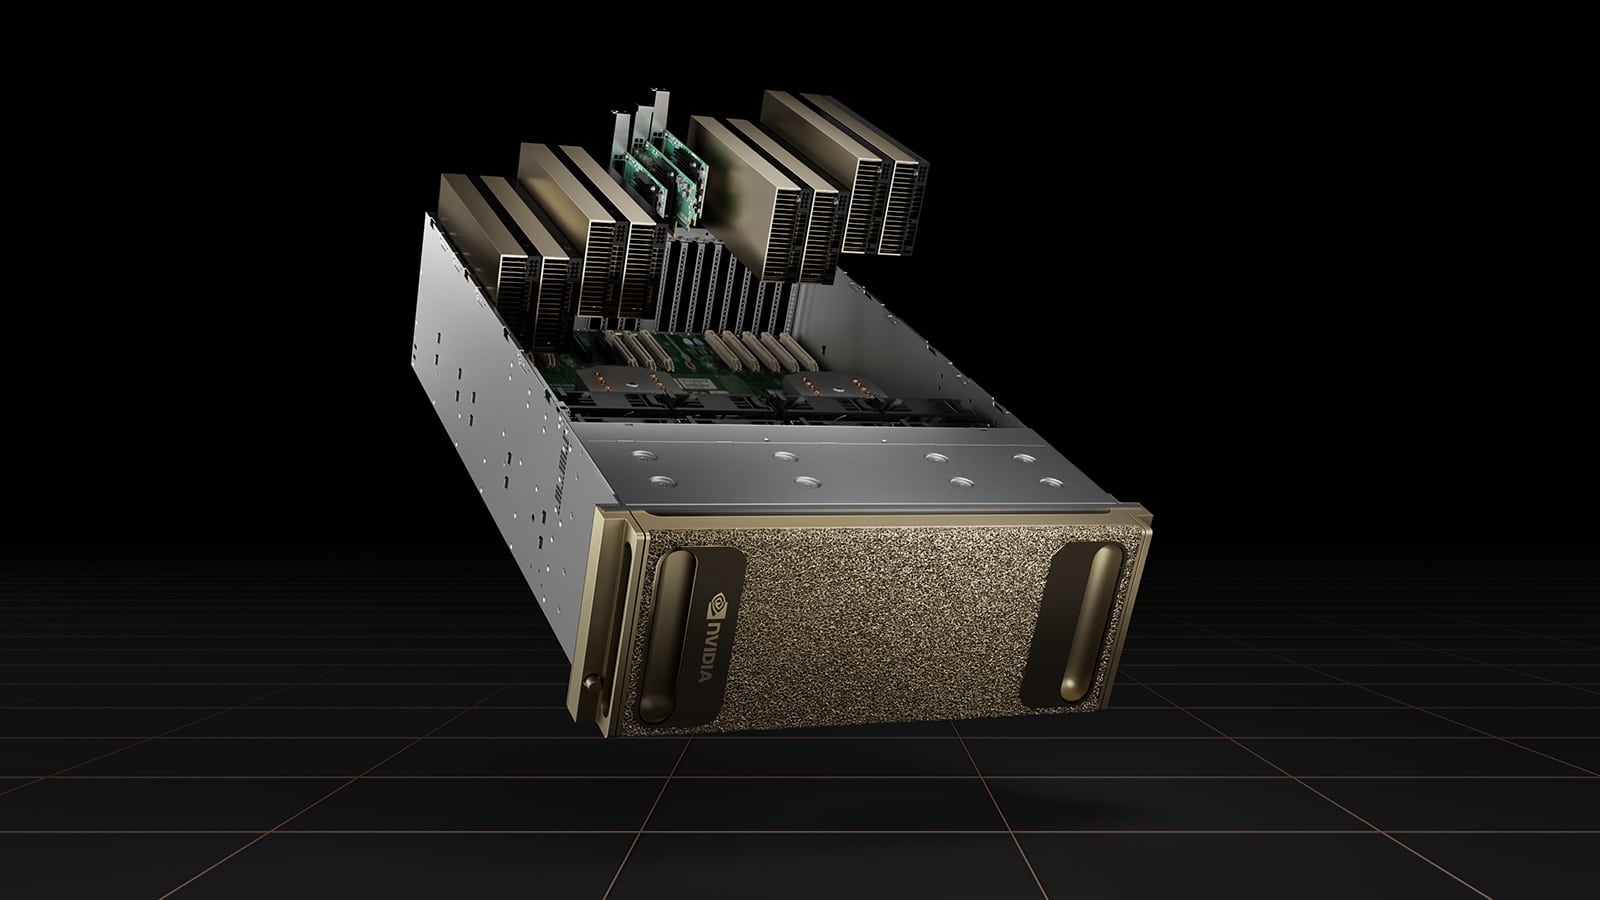
고성능 GPU 가속 컴퓨팅, 그래픽 및 AI를 지연 시간이 짧은 고속 스토리지 액세스와 결합한 OVX 시스템은 실제 정확도로 디지털 트윈을 생성하는 데 필요한 성능을 제공합니다. OVX는 건물, 공장, 도시 및 세계를 모델링하기 위해 복잡한 디지털 트윈을 시뮬레이션할 수 있습니다.
OVX 서버에는 40개의 NVIDIA A6 GPU, 200개의 ConnectX-1 DX 16Gbps NIC, 32TB 메모리 및 3TB NVMe 스토리지가 포함됩니다. OVX 시스템은 XNUMX대의 OVX 서버로 구성된 단일 포드에서 NVIDIA Spectrum-XNUMX 스위치 또는 여러 OVX SuperPOD를 통해 연결된 XNUMX대의 서버가 있는 OVX SuperPOD로 확장됩니다.
Jetson AGX Orin 개발자 키트
NVIDIA는 또한 고급 로봇 공학, 자율 기계, 차세대 임베디드 및 에지 컴퓨팅을 위한 작고 에너지 효율적인 AI 슈퍼컴퓨터인 Jetson AGX Orin 개발자 키트의 출시를 발표했습니다. Jetson AGX Orin의 사양은 손바닥 크기의 폼 팩터를 유지하면서 이전 모델보다 처리 능력이 275배 이상 높은 초당 8조 회를 제공하는 인상적인 사양입니다. NVIDIA Ampere 아키텍처 GPU, Arm Cortex-A78AE CPU, 차세대 딥 러닝 및 비전 가속기, 더 빠른 메모리 대역폭, 고속 인터페이스 및 다중 모드 센서를 갖춘 Jetson AGX Orin은 여러 개의 동시 AI 애플리케이션 파이프라인을 공급할 수 있습니다.
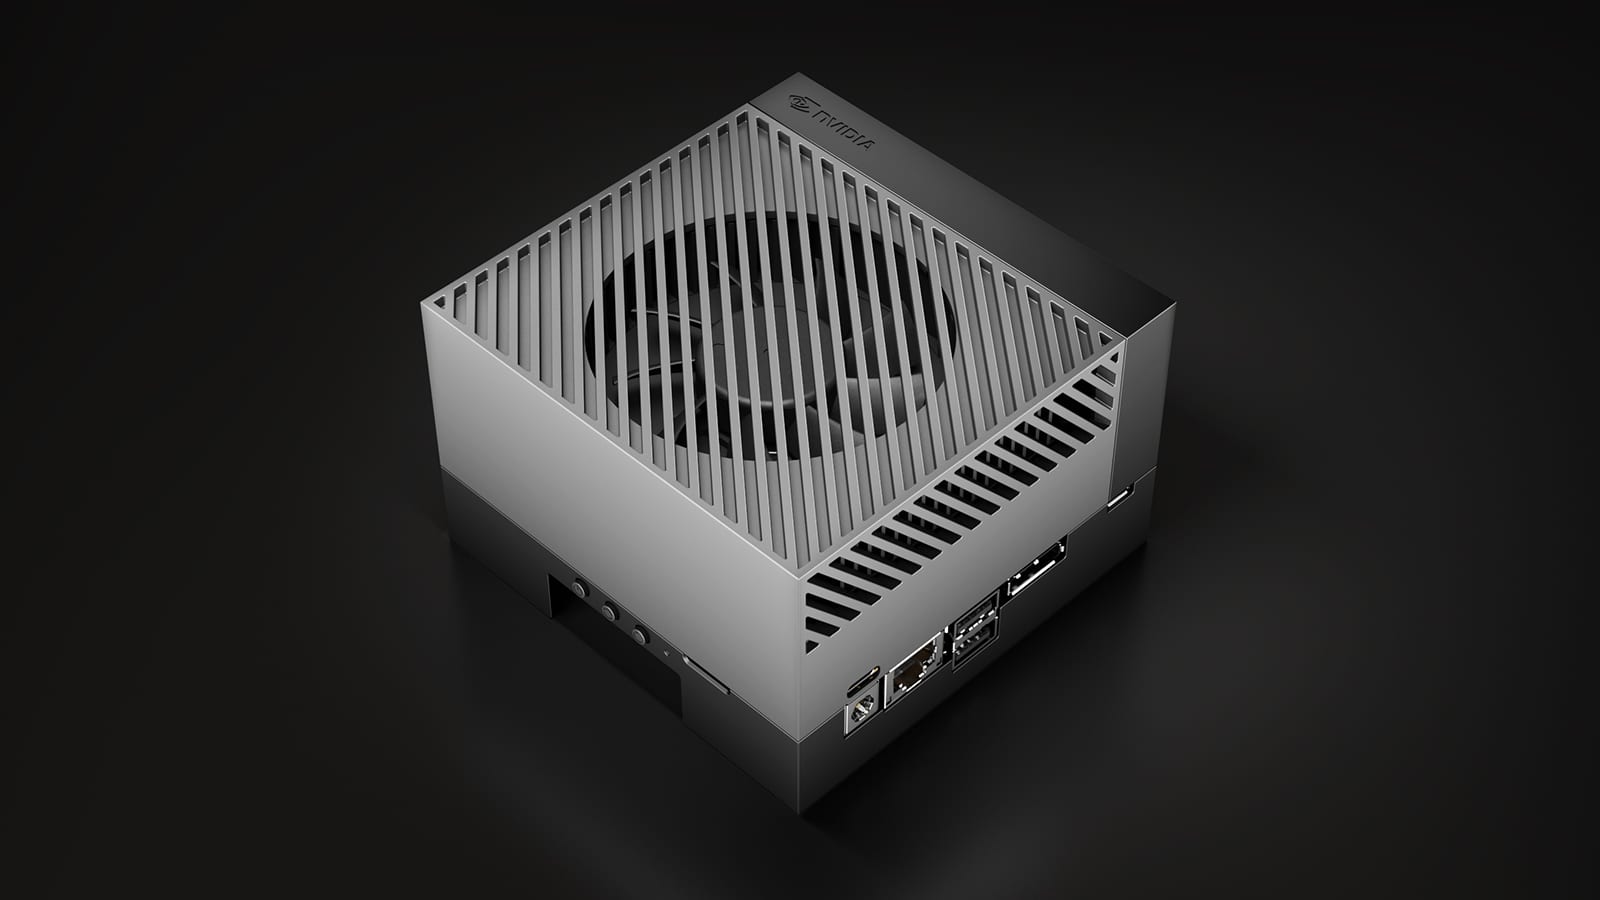
Jetson AGX Orin을 사용하는 고객은 라이브러리, 도구 및 기술 컬렉션에 대한 60개의 업데이트와 함께 전체 NVIDIA CUDA-X 가속 컴퓨팅 스택을 활용할 수 있습니다. 또한 NVIDIA JetPack SDK, NVIDIA NGC 카탈로그의 사전 훈련된 모델, Omniverse의 NVIDIA Isaac, NVIDIA Metropolis 및 NVIDIA TAO Toolkit과 같은 애플리케이션 개발 및 최적화를 위한 최신 프레임워크 및 도구에 대한 전체 액세스 권한을 갖게 됩니다.
엔비디아 스펙트럼-4
데이터 센터에 집중하면서 NVIDIA는 NVIDIA Spectrum-4 이더넷 플랫폼을 발표했습니다. 차세대 스위치는 이전 세대보다 400배 높은 스위칭 처리량으로 종단간 4Gbps를 제공합니다. Spectrum-4에는 ConnectX-7 SmartNIC, BlueField-3 DPLU 및 DOCA 데이터 센터 인프라 소프트웨어가 포함되어 있습니다.
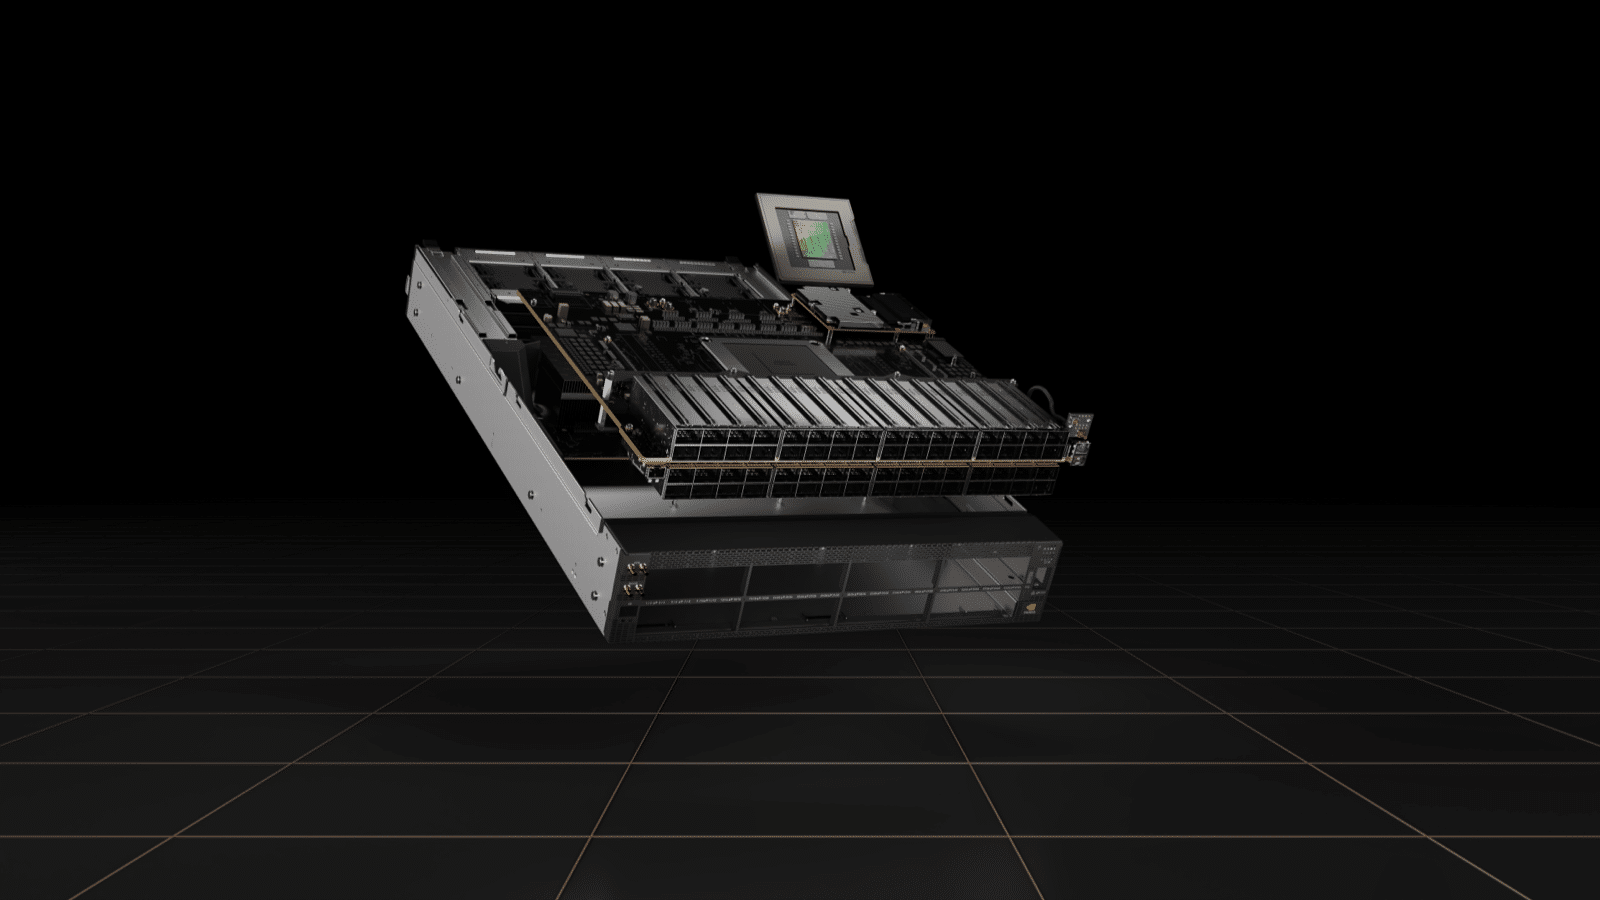
AI용으로 제작된 Spectrum-4 스위치는 이전 세대보다 2배 더 빠른 포트당 대역폭, 4배 더 적은 스위치, 40% 더 낮은 전력 소비로 네트워크 패브릭을 나노초 단위의 정밀도, 가속화, 단순화 및 보호합니다. 51.2Tbps 총 ASIC 대역폭 지원 128GBE의 400개 포트, 적응형 라우팅 및 향상된 정체 제어 메커니즘을 갖춘 Spectrum-4는 RDMA over Converged Ethernet 패브릭을 최적화하여 데이터 센터를 획기적으로 가속화합니다.
시공 종합
NVIDIA의 GTC 행사에서는 소프트웨어, 성능, 속도 등 다양한 측면에서 새로운 제품 업데이트가 쏟아졌습니다. 데이터 센터에 초점을 맞추는 한편, 자율 이동 로봇(AMR) 분야와 엣지 컴퓨팅 시장에도 주목했습니다. 이번 행사의 하이라이트는 Hopper H100 GPU였지만, 이 제품 하나가 다른 여러 발표 내용들을 하나로 엮어주는 역할을 했습니다. NVIDIA는 모든 보도 자료와 블로그 주요 내용을 여기에 정리해 놓았 으니, 꼭 한번 살펴보시기 바랍니다.


 아마존