

하이퍼스케일러와 AI 중심 인프라 운영업체들은 대규모 언어 모델과 복잡한 추론 워크로드에 대응하기 위해 자체 개발한 AI 가속기 및 XPU를 점점 더 많이 개발하고 있습니다. 대규모로 자체 개발 실리콘을 배포할 때 발생하는 물리적, 메모리 및 네트워킹 문제를 해결하기 위해 NVIDIA는 NVLink Fusion 인터커넥트와 NVHBM 맞춤형 베이스 다이 메모리 아키텍처를 상세히 설명했습니다 . 이 통합 포트폴리오는 맞춤형 실리콘과 NVIDIA의 기존 스케일업 네트워킹 및 MGX 랙 스케일 플랫폼을 연결하도록 설계되었습니다.
가장 먼저 나선 곳은 아마존의 안나푸르나 랩스(Annapurna Labs)로, AWS와의 파트너십을 통해 2만 개의 GPU를 확장 하면서 NVHBM 계획을 발표했습니다 . 이번 발표는 해당 협력의 기반이 되는 아키텍처를 공개하고, NVLink Fusion을 지원하는 최초의 Trainium 세대로 Trainium4를 명명했습니다. NVIDIA는 또한 여러 메모리 공급업체에서 사용할 수 있는 표준 NVHBM 구현을 구축하여 공급업체 간 메모리 통합 및 검증에 필요한 엔지니어링 노력을 줄일 수 있다고 밝혔습니다. 아마존 안나푸르나 랩스의 부사장인 나페아 브샤라(Nafea Bshara)는 "NVHBM은 고대역폭 메모리 성능과 효율성을 향상시키는 새로운 아키텍처 접근 방식을 제시합니다."라며, "이번 기술 협력을 통해 향후 AWS 인프라 설계에 도움이 되기를 기대합니다."라고 말했습니다.
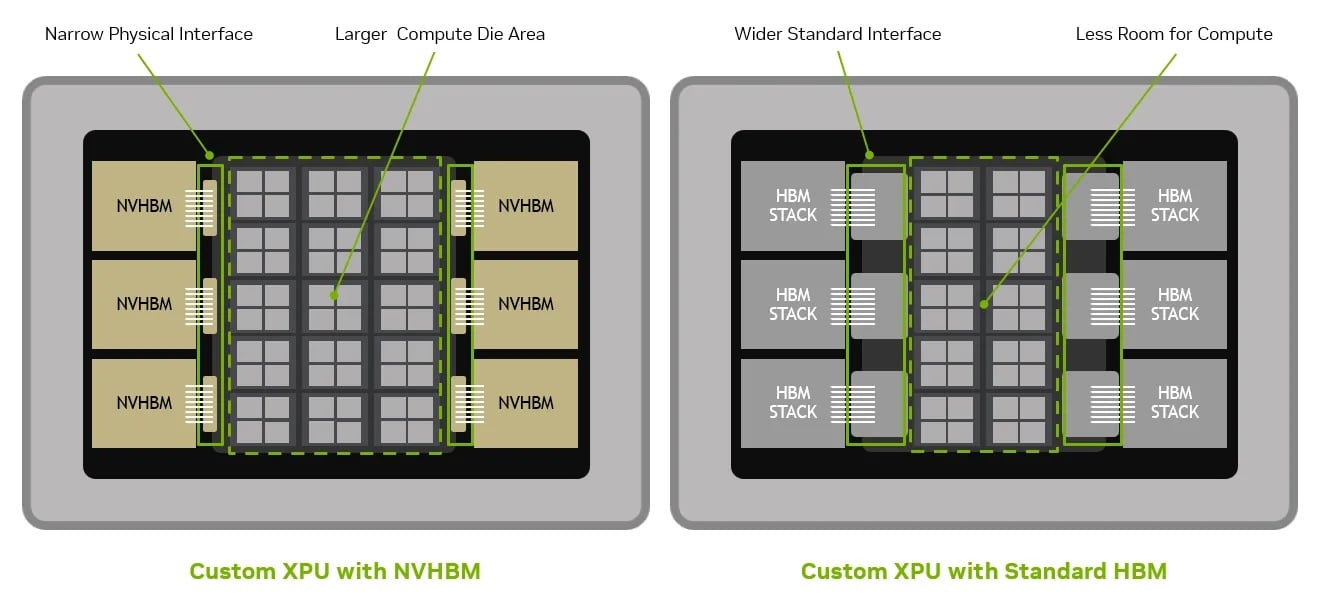
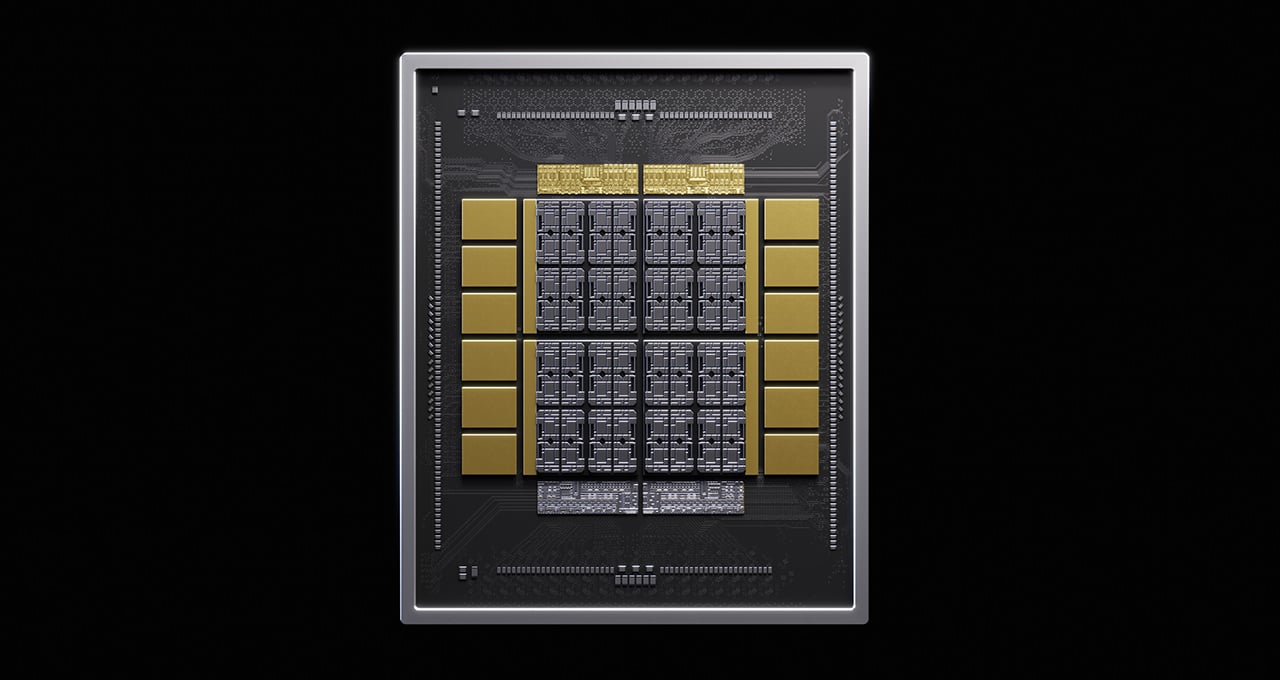
고밀도 데이터 센터에 맞춤형 XPU를 배포하려면 컴퓨팅 로직, 전력 분배, 열 관리, 고대역폭 메모리 간의 균형을 맞춰야 합니다. 최첨단 메모리 스택을 통합하고 검증하는 과정에서 패키징 및 개발에 상당한 병목 현상이 발생하는 경우가 많습니다. NVLink Fusion과 NVHBM을 통해 설계자는 사전 검증된 기본 다이와 인터페이스 IP를 활용하여 통합 복잡성을 줄이고 출시 기간을 단축할 수 있습니다.
메모리 대역폭 및 지연 시간 최적화
최신 AI 워크로드, 특히 대규모 모델 추론 및 에이전트 파이프라인은 모델 가중치, 활성화 값 및 키-값(KV) 캐시 항목을 읽는 데 필요한 메모리 처리량에 상당한 부담을 줍니다. NVHBM은 메모리 제조업체와 협력하여 개발한 맞춤형 베이스 다이를 제공하며, 표준 JEDEC HBM4E 사양 대비 스택당 최대 30% 더 높은 메모리 대역폭을 제공합니다.
| 제품 특장점 | NVHBM 혜택 |
| 대역폭 | 표준 HBM4e 대비 최대 30% 향상된 메모리 대역폭 |
| 지역 | 더욱 효율적인 인터페이스 연결을 통해 XPU 기능을 강화하기 위한 컴퓨팅 다이 면적을 최대 25%까지 늘릴 수 있습니다. |
| 출력 | 표준 HBM4e 대비 최대 15% 낮은 HBM 전력 사용량은 수천 개의 XPU에서 비용 절감으로 이어집니다. |
표 1. NVHBM은 AI 가속기 프로그램에 세 가지 주요 플랫폼 수준 이점을 제공합니다. 더 높은 메모리 대역폭, 더 넓은 패키지 및 실리콘 면적, 그리고 더 낮은 HBM 전력 사용량입니다.
이러한 대역폭 증가는 메모리 제약이 심한 실행 단계에서 컴퓨팅 엔진의 자원 부족 현상을 최소화합니다. HBM 스택과 온보드 컴퓨팅 로직 간의 데이터 전송 속도를 향상시킴으로써, 가속기는 고밀도 추론 워크로드 동안 더 높은 활용률을 유지하고 사용자별 토큰 생성 속도를 개선할 수 있습니다.
다이 영역 재할당 및 PHY 최적화
최신 가속기 패키지의 실리콘 공간은 엄격하게 제한되어 있으므로 설계자는 연산 ALU, 행렬 엔진, 온칩 SRAM 및 주변 장치 인터페이스 간의 공간 균형을 맞춰야 합니다. 표준 HBM 아키텍처는 상당한 레이아웃 면적을 차지하는 넓은 물리적 인터페이스를 필요로 합니다.
NVHBM은 메모리 컨트롤러를 3D HBM 스택에 직접 배치하고 맞춤형 물리 계층(PHY)을 활용하여 이러한 문제를 해결합니다. 이 접근 방식을 통해 표준 HBM4E 구현 대비 PHY 및 주변 장치 지원 영역을 최대 67%까지 줄일 수 있으며, 인터포저 트레이스 라우팅을 단순화하여 레이아웃 전체에서 최대 80%의 가용 실리콘을 확보할 수 있습니다. 또한, 더 좁은 메모리 인터페이스 덕분에 패키지 공간을 확보하여 설계자는 고정된 물리적 크기 내에서 중앙 AI 컴퓨팅 다이를 최대 30%까지 확장하여 매트릭스 코어, 벡터 유닛 또는 캐시 계층 구조를 추가할 수 있습니다.
전력 효율성 및 시설 규모의 여유 공간
전력 분배는 하이퍼스케일 데이터 센터 운영에서 가장 엄격한 제약 조건 중 하나이며, 가속기 열 설계 및 냉각 요구 사항에 직접적인 영향을 미칩니다. NVHBM은 표준 HBM4E에 비해 HBM의 전력 소비를 15% 절감합니다.
실리콘 레벨에서 메모리 전력 감소는 열 압력을 낮추어 컴퓨팅 코어를 더 높은 지속 주파수로 구동할 수 있는 추가적인 전기적 여유 공간을 확보합니다. 시설 규모에서는 이러한 전력 절감 효과가 크게 증폭됩니다. 이론적으로 1기가와트 규모의 데이터 센터에 2,000와트의 XPU를 배포한다고 가정할 때, 메모리 전력 감소로 인해 최대 15,000개의 XPU를 추가로 지원할 수 있는 충분한 열 및 전기적 용량을 확보할 수 있습니다.
NVLink Fusion을 통한 랙 규모 통합
NVHBM은 개별 패키지 수준에서 성능을 최적화하는 반면, NVLink Fusion은 시스템 수준의 브리지 역할을 합니다. 전용 NVLink Fusion 칩렛을 활용하면 맞춤형 XPU를 6세대 NVLink 스케일업 패브릭 에 직접 연결하여 랙 내의 모든 가속기를 단일의 일관된 메모리 및 컴퓨팅 도메인으로 통합할 수 있습니다.
이러한 확장형 패브릭은 EP(Expert Parallelism) 및 WideEP와 같은 고급 병렬화 방식에 매우 중요합니다. 이러한 방식에서는 분산된 전문가 혼합 모델이 여러 물리적 장치에 걸쳐 활성화 상태와 은닉 상태를 낮은 지연 시간으로 동기화해야 합니다. 또한 사용자 정의 프로세서는 NVLink-C2C를 통해 호스트 CPU에 연결할 수 있습니다.
NVLink Fusion은 반맞춤형 실리콘을 보다 광범위한 NVIDIA 하드웨어 및 소프트웨어 생태계에 통합함으로써, 운영자가 표준화된 MGX 랙 아키텍처 하에서 맞춤형 XPU와 표준 NVIDIA GPU를 혼합하는 이기종 환경을 배포할 수 있도록 지원하여 운영 및 워크로드 프로비저닝을 간소화합니다.


 아마존