

여러 세대에 걸친 하드웨어 발전 과정에서 메모리 및 네트워킹 공급업체들은 고성능 컴퓨팅 클러스터의 다양한 병목 현상을 파악해 왔습니다. 메모리 제조업체들은 패키지 내 메모리 대역폭에 집중했고, 네트워크 패브릭 공급업체들은 섀시 간 및 랙 간 처리량 문제를 해결했습니다. 오늘날 이 두 가지 관점은 분산 컴퓨팅 노드와 메모리 풀 간의 데이터 이동을 제한하는 대역폭 장벽이라는 동일한 병목 현상에 집중하고 있습니다.
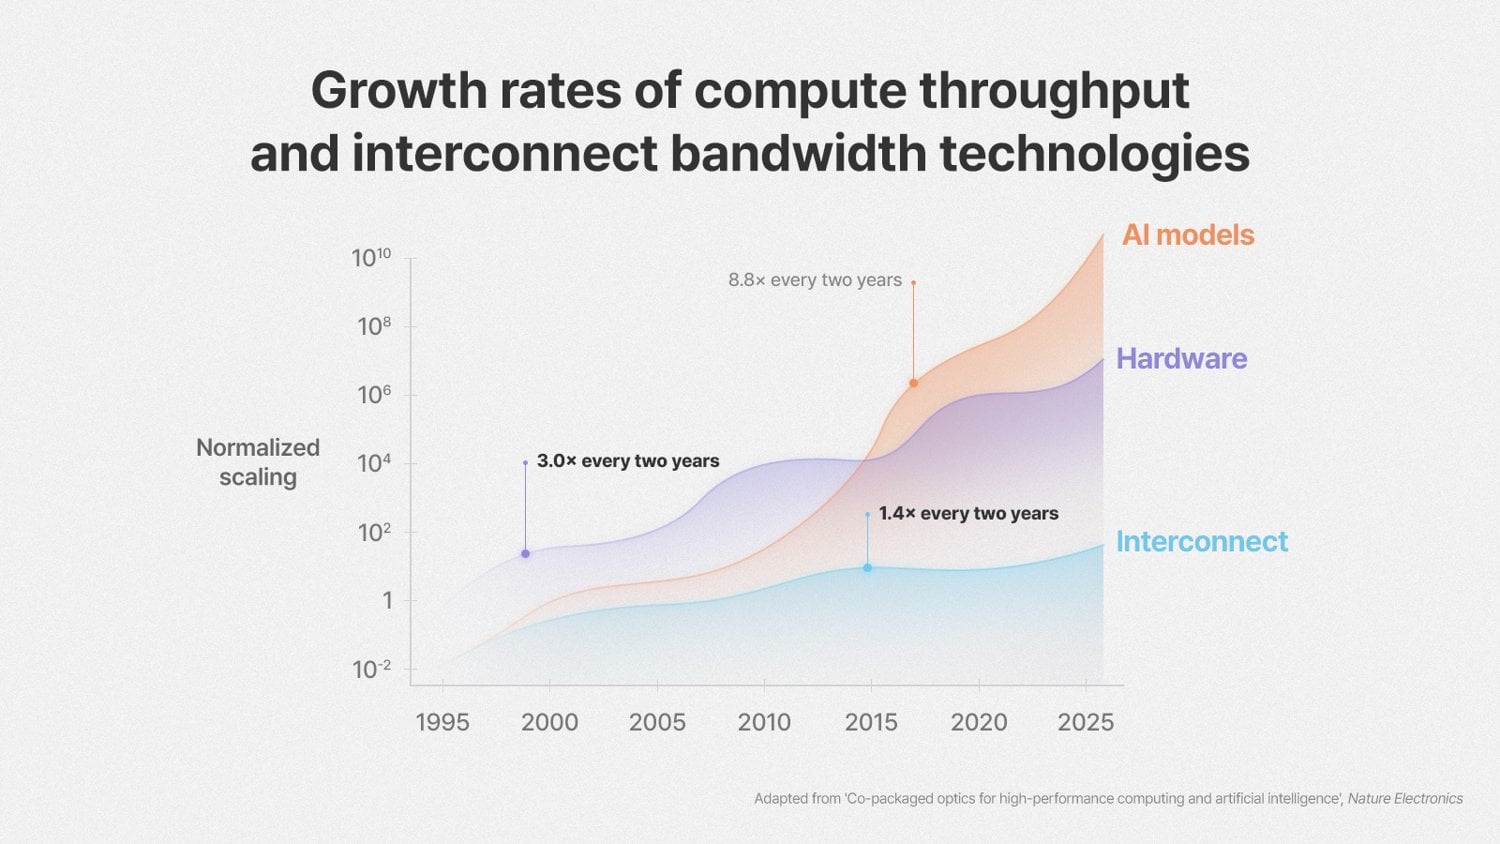
고대역폭 메모리 (HBM)는 개별 AI 가속기의 패키지 수준 대역폭 제한 문제를 효과적으로 해결 했지만 , 최신 하이퍼스케일 학습 및 추론 워크로드는 이제 랙과 포드에 분산된 수만 개의 프로세서에 걸쳐 확장됩니다. 이러한 분산 토폴로지에서 컴퓨팅 처리량은 역사적으로 약 2년마다 약 3배씩 증가해 왔지만, 상호 연결 대역폭은 같은 기간 동안 약 1.4배 증가했습니다. 이러한 불균형으로 인해 주요 확장 병목 현상은 물리적 상호 연결 계층에 집중됩니다.
이번 평가는 SK하이닉스 와 버지니아대학교, 일리노이대학교 어바나-샴페인 캠퍼스, MIT, 난양공과대학교, 연세대학교 연구진이 공동 저술하고 8월 20일 네이처 일렉트로닉스(Nature Electronics)에 게재된 "고성능 컴퓨팅 및 인공지능을 위한 코패키징 광학 소자(Co-packaged optics for high-performance computing and artificial intelligence)"라는 제목의 논문을 바탕으로 합니다. SK하이닉스 AI 인프라 팀장 홍승훈과 버지니아대학교 이규상 교수가 교신저자로 참여했습니다.
| 단계 | 결과 |
|---|---|
| AI 클러스터 확장 병목 현상 해소 | |
| HBM 패키지 내 | 칩/패키지 메모리 병목 현상 해결 |
| 구리 흔적 | 물리적 감쇠/전력 한계에 부딪힘(칩 외부) |
| CPO 통합 | 광학 직물을 기판에 직접 집속합니다. |
이러한 제약을 해결하기 위해 SK하이닉스는 버지니아 대학교, 일리노이 대학교 어바나-샴페인(UIUC), 난양공과대학교(NTU), MIT, 연세대학교 연구진과 협력하여 Nature Electronics 에 "고성능 컴퓨팅 및 인공지능을 위한 코패키징 광학(Co-packaged optics for high-performance computing and artificial intelligence)"이라는 제목의 연구 논문을 발표했습니다. 이 논문은 미래의 클러스터 확장을 지원하기 위해 코패키징 광학 (CPO)과 광 컴퓨팅 인터커넥트 (OCI)가 메모리 및 패키징 아키텍처와 함께 어떻게 발전해야 하는지를 자세히 설명합니다.
구리 상호 연결의 물리적 한계
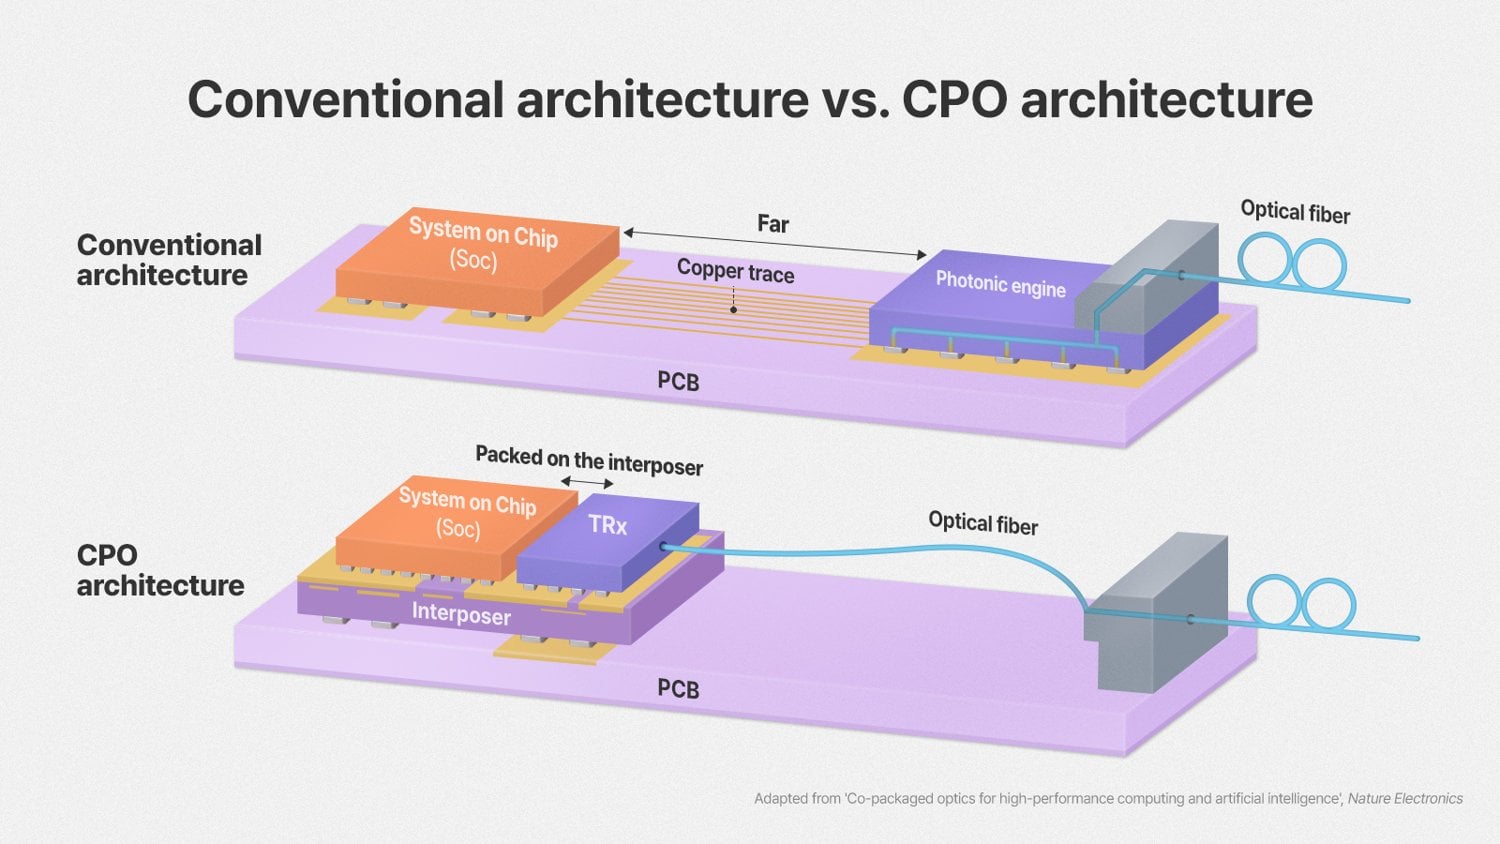
구리 트레이스와 직접 연결 구리 케이블에 의존하는 표준 전기 상호 연결 방식은 짧은 물리적 거리에서는 여전히 실용적입니다. 그러나 데이터 전송 속도가 증가함에 따라 전기 신호는 심각한 신호 감쇠, 삽입 손실 및 전력 소비 증가 문제를 겪게 됩니다. 더 긴 보드 트레이스와 백플레인을 통해 고속 신호를 관리하려면 복잡한 이퀄라이제이션 및 리타이밍 회로가 필요하며, 이는 추가적인 지연 시간을 발생시키고 상당한 전력을 소모합니다.
코패키징 광학 기술이 어떻게 미래를 바꿀 수 있을까
CPO는 호스트 프로세서 또는 가속기와 동일한 패키지 기판에 광 트랜시버를 직접 장착함으로써 이러한 물리적 한계를 극복합니다. 고속 전기 신호를 컴퓨팅 실리콘 바로 옆의 광자 채널로 변환함으로써 전기 배선 길이를 최소화하고 기생 정전 용량 및 신호 저하를 완화합니다. 이러한 아키텍처를 통해 보드, 랙 및 포드 전반에 걸쳐 저손실, 고대역폭 광 전송이 가능하며, 동시에 더 높은 대역폭 밀도와 향상된 전자기 간섭 내성을 유지할 수 있습니다.
| 메트릭 | 목표 사양 |
|---|---|
| CPO 노드에 대한 목표 사양 | |
| 노드 대역폭 밀도 | 노드당 100Tb/s 이상 |
| 에너지 효율 | < 1 pJ/bit |
| 칩 간 상호 연결 지연 시간 | 10ns 미만 |
| 통합 경로 | 2.5D 인터포저를 3D 이종 시스템으로 변환 |
로드맵은 표준 2D 멀티칩 모듈 및 2.5D 실리콘 인터포저 통합에서 3D 이종 스태킹으로 나아가는 아키텍처 발전 방향을 제시합니다. 궁극적인 아키텍처적 이정표는 광 링크를 메모리 서브시스템 자체에 직접 확장하는 것입니다.
광자 인터포저를 사용하여 메모리 스택과 컴퓨팅 엔진을 직접 연결함으로써, 시스템은 기존 보드 레벨 라우팅의 제약을 극복할 수 있습니다. 이러한 접근 방식을 통해 분산형 저지연 공유 메모리 풀을 구현할 수 있으며, 여러 컴퓨팅 엔진이 기존 네트워크 패브릭에서 흔히 발생하는 직렬화 및 역직렬화로 인한 성능 저하 없이 광 백플레인을 통해 공유 용량에 접근할 수 있습니다.
상용화를 위한 엔지니어링 과제
CPO를 고급 패키징 시연 단계에서 실제 데이터 센터 하드웨어 생산 단계로 전환하는 데에는 여러 가지 미해결된 엔지니어링 과제가 있습니다. 저전력 실리콘 포토닉 소자를 고출력 호스트 로직과 통합하려면 정교한 열 절연과 고급 미세유체 또는 직접 패키지 냉각 설계가 필요합니다.
또한, 업계는 독자적인 소프트웨어 오버헤드 없이 광학적으로 결합된 메모리 트랜잭션을 조율할 수 있는 표준화되고 지연 시간이 짧은 코히어런스 프로토콜을 개발해야 합니다. 안정적인 상용화를 위해서는 DRAM 다이 토폴로지, 맞춤형 메모리 컨트롤러, 포토닉 엔진, 이종 기판 패키징을 아우르는 엔드 투 엔드 하드웨어 공동 설계가 필요합니다. SK하이닉스는 기존 로드맵과 함께 광학 로드맵을 추진하고 있으며, FMS 2026에서 16층 HBM4와 웨이퍼 본딩 방식의 375층 NAND를 공개했습니다.


 아마존