

ASUS ExpertCenter Pro ET900N G3는 저희가 테스트한 두 번째 GB300 DGX 스테이션이며, 연구실에서 직접 사용해 본 첫 번째 제품입니다. MSI XpertStation WS300 테스트는 원격으로 진행했습니다. 이 제품은 MSI XpertStation WS300에 사용된 것과 동일한 NVIDIA 칩셋을 사용합니다. 72개의 Grace 코어를 갖춘 Grace Blackwell Ultra Desktop Superchip, B300 GPU, 252GB의 HBM3e, 496GB의 LPDDR5X, 그리고 두 개의 400GbE 포트를 지원하는 ConnectX-8 SuperNIC이 탑재되어 있습니다. ASUS는 이 핵심 플랫폼을 데스크탑 AI 환경에 최적화된 깔끔한 타워형 케이스에 담아냈으며, WS300에는 없었던 몇 가지 특징을 추가했습니다. 상단에 두 개의 손잡이, ConnectX-8 광학 장치 케이지를 냉각하는 전용 팬, 그리고 80 PLUS Titanium 등급의 1,600W 파워 서플라이가 그것입니다.
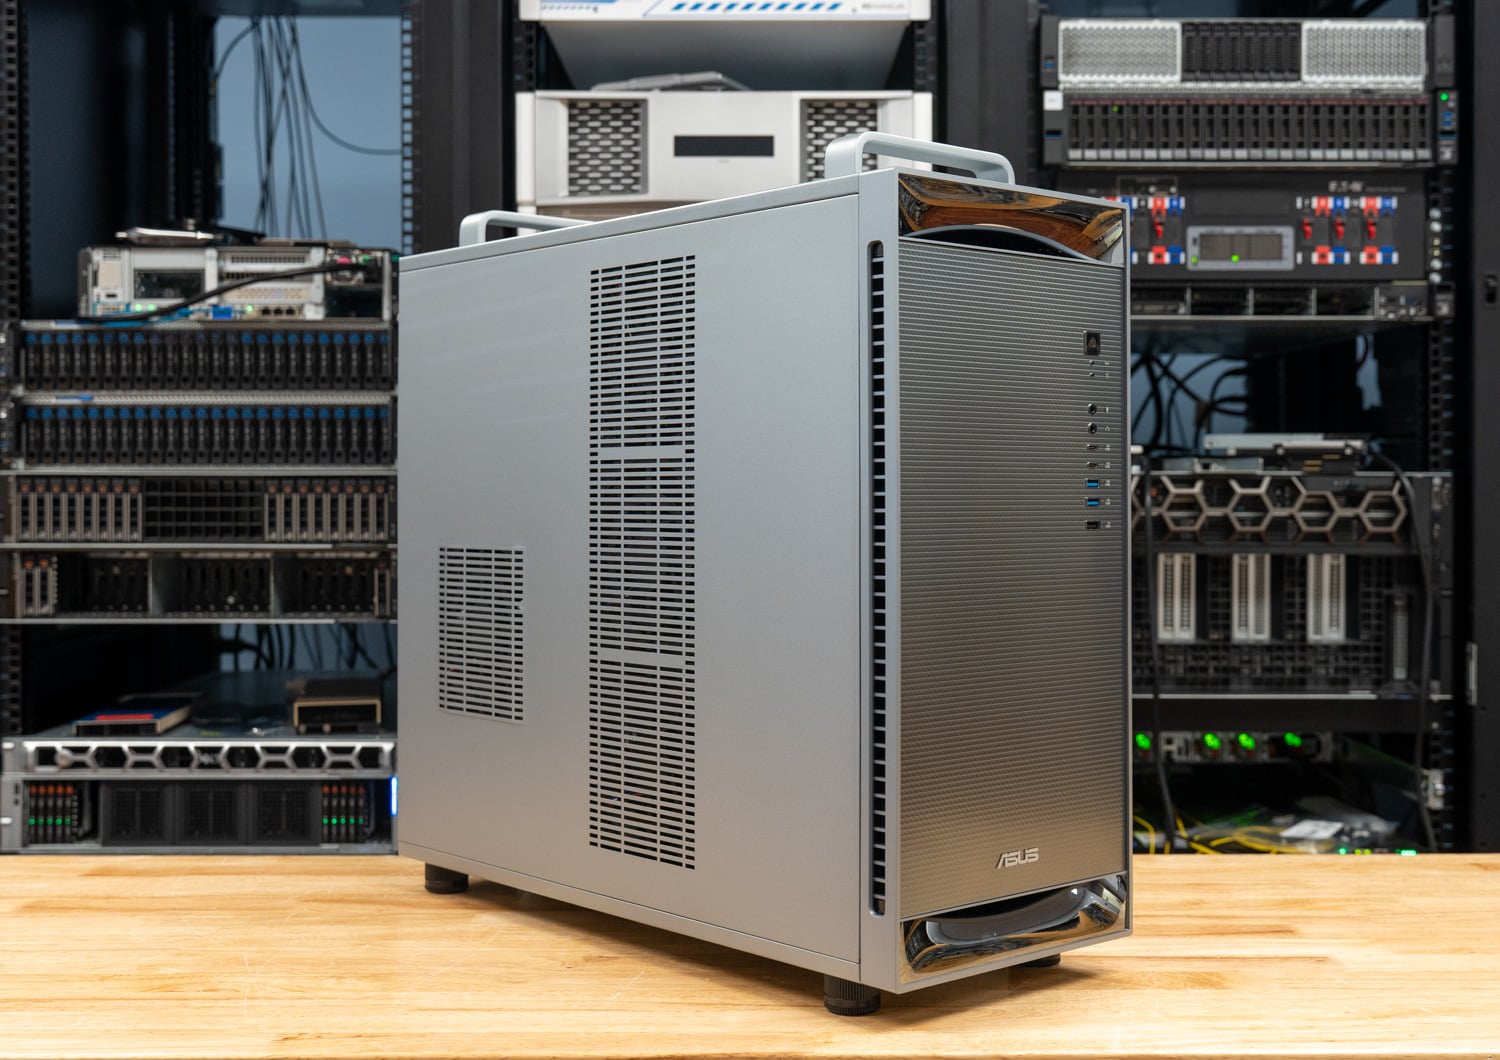
ASUS는 RTX PRO 2000이 장착된 ET900N G3를 연구실로 보내 약 일주일 동안 벤치마킹, 사진 촬영 및 물리적 검사를 진행했습니다. 플랫폼 자체, B300 메인보드, Grace 칩셋, NVLink-C2C, MIG 인터페이스, 그리고 DGX 스테이션의 용도에 대한 자세한 내용 은 WS300 리뷰 에서 다루었습니다. 이 리뷰에서는 ASUS가 Superchip을 기반으로 구축한 구성과, 이전에 테스트했던 GB300 타워형 케이스와 비교했을 때 성능이 얼마나 우수한지에 대해 살펴보겠습니다.
ASUS ExpertCenter Pro ET900N G3 사양
| 스펙 | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| 플랫폼 개요 | |
| 슈퍼칩 | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72개의 Arm Neoverse V2 코어 |
| GPU | NVIDIA Blackwell Ultra(B300), 희소성을 고려한 최대 20 PFLOPS NVFP4 성능 |
| CPU-GPU 상호 연결 | NVLink-C2C, 900GB/s 양방향 |
| 메모리 | |
| 일관된 기억 | 748GB |
| GPU 메모리 | 252GB HBM3e, 7.1TB/s |
| CPU 메모리 | 496GB LPDDR5X, 396GB/s, 4x SOCAMM |
| 스토리지 | |
| 부트 드라이브 | 2개의 M.2 2280 PCIe 5.0 x4(Key M) 슬롯에 2TB NVMe SSD 2개를 RAID 1로 구성하여 장착했습니다. |
| 확장 드라이브 | ASUS 규격에 따르면 2개의 M.2 2280(Key M) 슬롯이 PCIe 6.0 x4로 구성되어 있으며, 공장에서 개봉된 상태입니다. |
| 네트워킹 | |
| 슈퍼NIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | Marvell 10GbE 1개 1x Realtek 1GbE (BMC) |
| 확장 | |
| PCIe 슬롯 | PCIe 1 x5.0 16 개 2개의 PCIe 5.0 x16(x8 신호) |
| 추가 GPU | NVIDIA RTX PRO Blackwell 카드 최대 1개 장착 가능; 리뷰용 제품에는 RTX PRO 2000 Blackwell이 장착되어 배송되었습니다. |
| I / O | |
| 앞 | USB 10Gbps 타입-C 포트 2개 USB 10Gbps 타입 A 포트 2개 1x USB 2.0 헤드폰 및 마이크 잭 |
| 후방 | USB 10Gbps 타입 A 포트 4개 1x 마이크로 USB COM (BMC 직렬 콘솔) 미니 디스플레이포트(BMC) 1개 오디오 잭 3개 |
| 관리 및 보안 | |
| BMC | ASPEED AST2600 (AMI MegaRAC 펌웨어, IPMI 및 Redfish 탑재) |
| 보안 | 온보드 TPM 2.0 |
| 전원 및 냉각 | |
| 전원 공급 장치 | 1x 1,600W ATX, 80 PLUS Titanium |
| 냉각 | ASUS에 따르면 GB300, SOCAMM 및 ConnectX-8에 콜드 플레이트가 장착된 일체형 수랭 쿨링 시스템(AIO)이 적용되었으며, 전면 및 상단 라디에이터, 후면 섀시 팬, QSFP112 케이지 위에 별도의 팬이 설치되어 있습니다. |
| 작동 온도 | 10C에서 35C |
| 소프트웨어 및 폼 팩터 | |
| 운영체제 | NVIDIA AI 개발자 도구가 포함된 Ubuntu 배포; ASUS는 Windows 기반 AI 개발 지원을 계획 중이라고 밝혔습니다. |
| 크기 | ASUS에서 밝힌 크기는 584 x 232 x 565mm (23.0 x 9.1 x 22.3인치)입니다. |
| 중량(평량) | 순중량 27kg, 총중량 32kg |
설계 및 구축
ASUS는 ET900N G3를 비즈니스 워크스테이션처럼 디자인했습니다. 브러시드 실버 섀시, 어두운 메시 전면 패널, 크롬으로 마감된 상단 및 하단 패널, 그리고 전면 하단에 ASUS 로고가 자리하고 있습니다. 크기는 플랫폼에 맞춰 584 x 232 x 565mm로, ASUS 공식 사양에 따르면 WS300(높이 529mm, 깊이 570mm, 너비 246mm)보다 약간 더 크고 좁습니다. 27kg에 달하는 무게 때문에 쉽게 옮길 수 있는 시스템은 아니며, 바로 이 부분에서 ASUS만의 특별한 디자인 철학이 드러납니다. 상단 가장자리에 앞뒤로 각각 하나씩, 총 두 개의 금속 손잡이가 있어 두 사람이 패널을 잡지 않고도 책상이나 카트에 쉽게 옮길 수 있습니다. 사무용 기기에는 다소 어색해 보일 수 있지만, 연구실에서 GB300 타워를 옮겨본 경험이 있다면 그 존재 이유를 실감하게 될 것입니다.
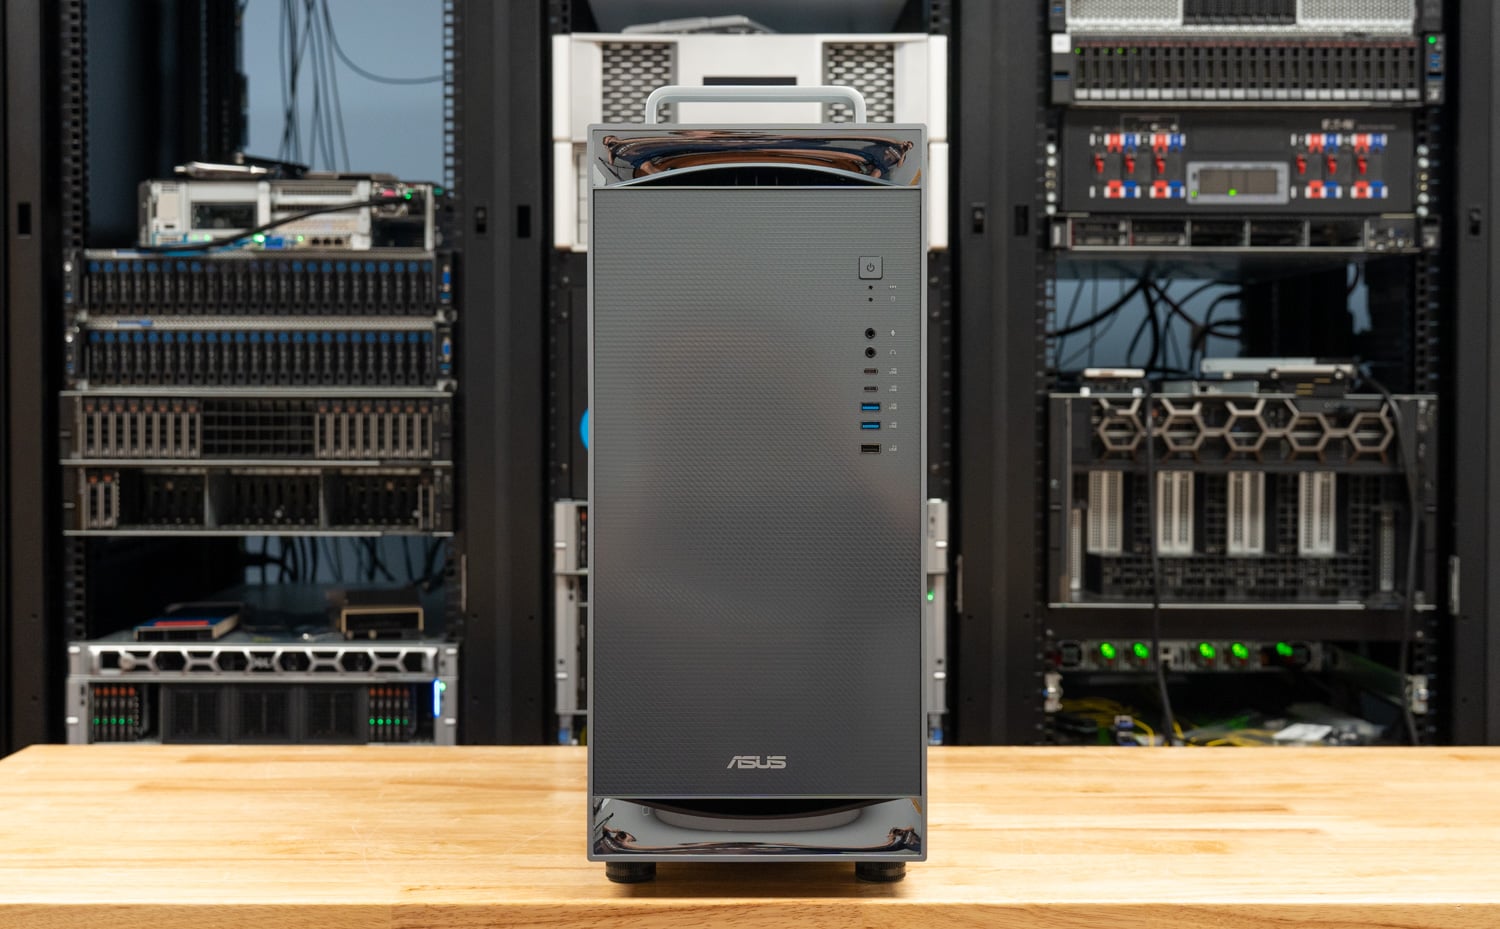
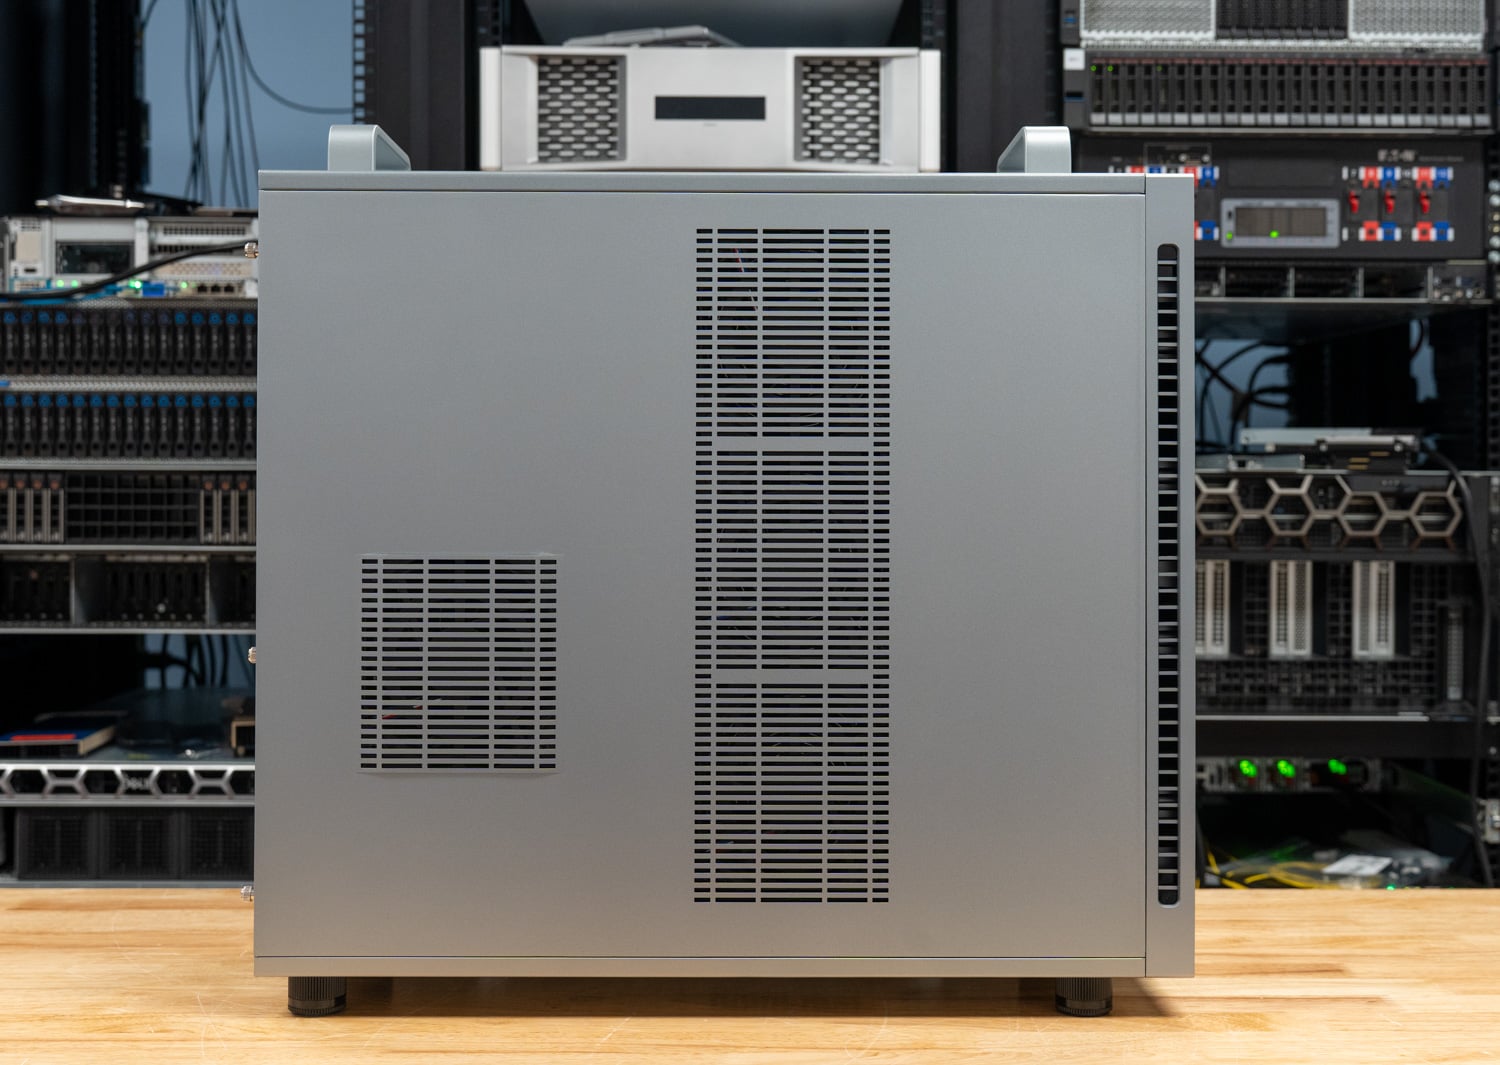
전면 패널에는 전원 버튼, 10Gbps USB Type-A 포트 2개, 10Gbps USB Type-C 포트 2개, USB 2.0 포트 1개, 헤드폰 및 마이크 잭이 모두 메쉬 패널 오른쪽 상단에 세로로 배열되어 있습니다. 측면 패널은 통풍구가 있는 커다란 판 형태로, 전면에는 라디에이터 흡입구를 위한 긴 천공 기둥이 있고 후면에는 시스템 팬과 일렬로 정렬된 작은 사각형 그릴이 있습니다. 투명 창이나 조명은 없으며, 이는 주요 구매층에 적합합니다.
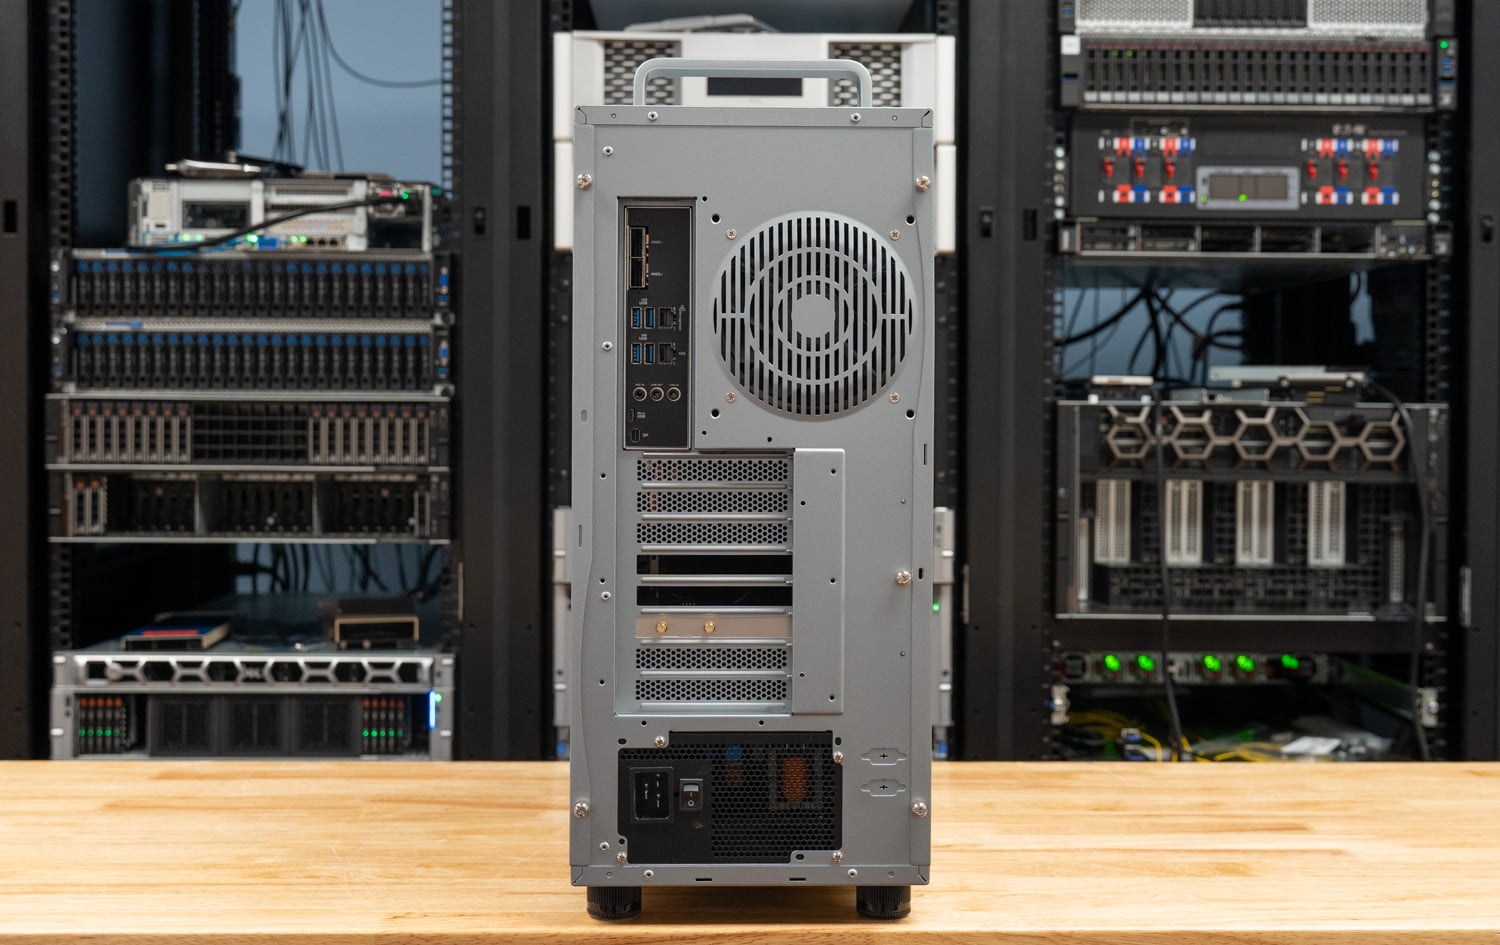
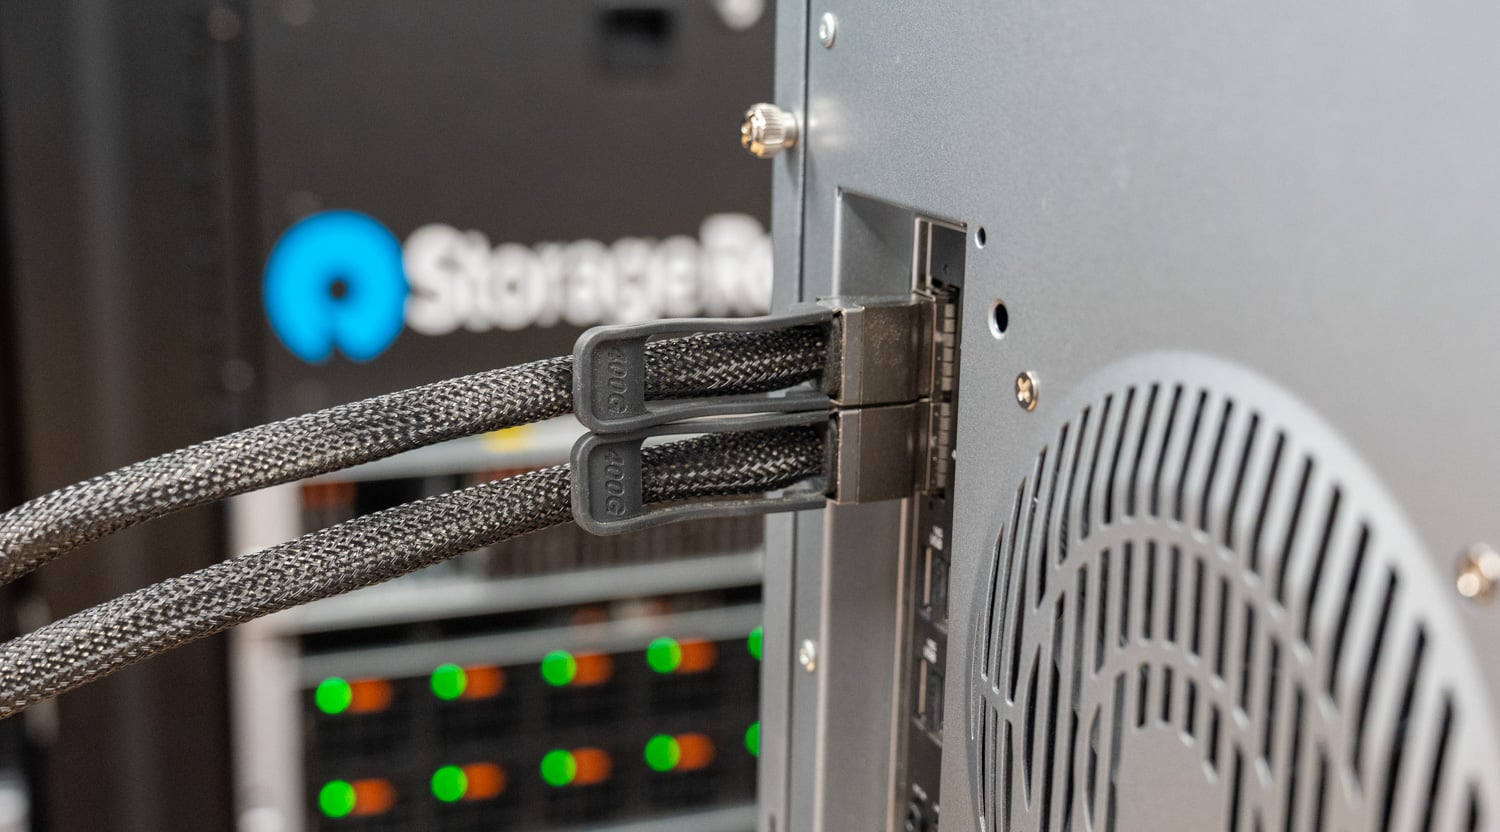
후면 레이아웃은 워크스테이션 I/O와 아래쪽 서버 하드웨어를 분리합니다. 상단에는 4개의 10Gbps USB Type-A 포트, 10GbE 및 1GbE RJ45 잭, 3개의 오디오 잭, BMC의 Micro-USB 콘솔 포트, 그리고 BMC 설정에 사용되는 Mini DisplayPort가 있습니다. ConnectX-8용 QSFP112 케이지 2개는 I/O 쉴드 상단에 위치하고, 그 옆에는 배기 팬이 있습니다. 3개의 확장 슬롯 커버는 중앙에 있으며, C19 흡입구가 있는 전원 공급 장치는 하단에 있습니다. WS300과 마찬가지로 Mini DisplayPort는 초기 설정 및 문제 해결을 위한 BMC 출력입니다. 이 시스템에서 데스크톱 환경을 사용하려면 RTX PRO 그래픽 카드가 필요합니다.
ET900N G3 내부
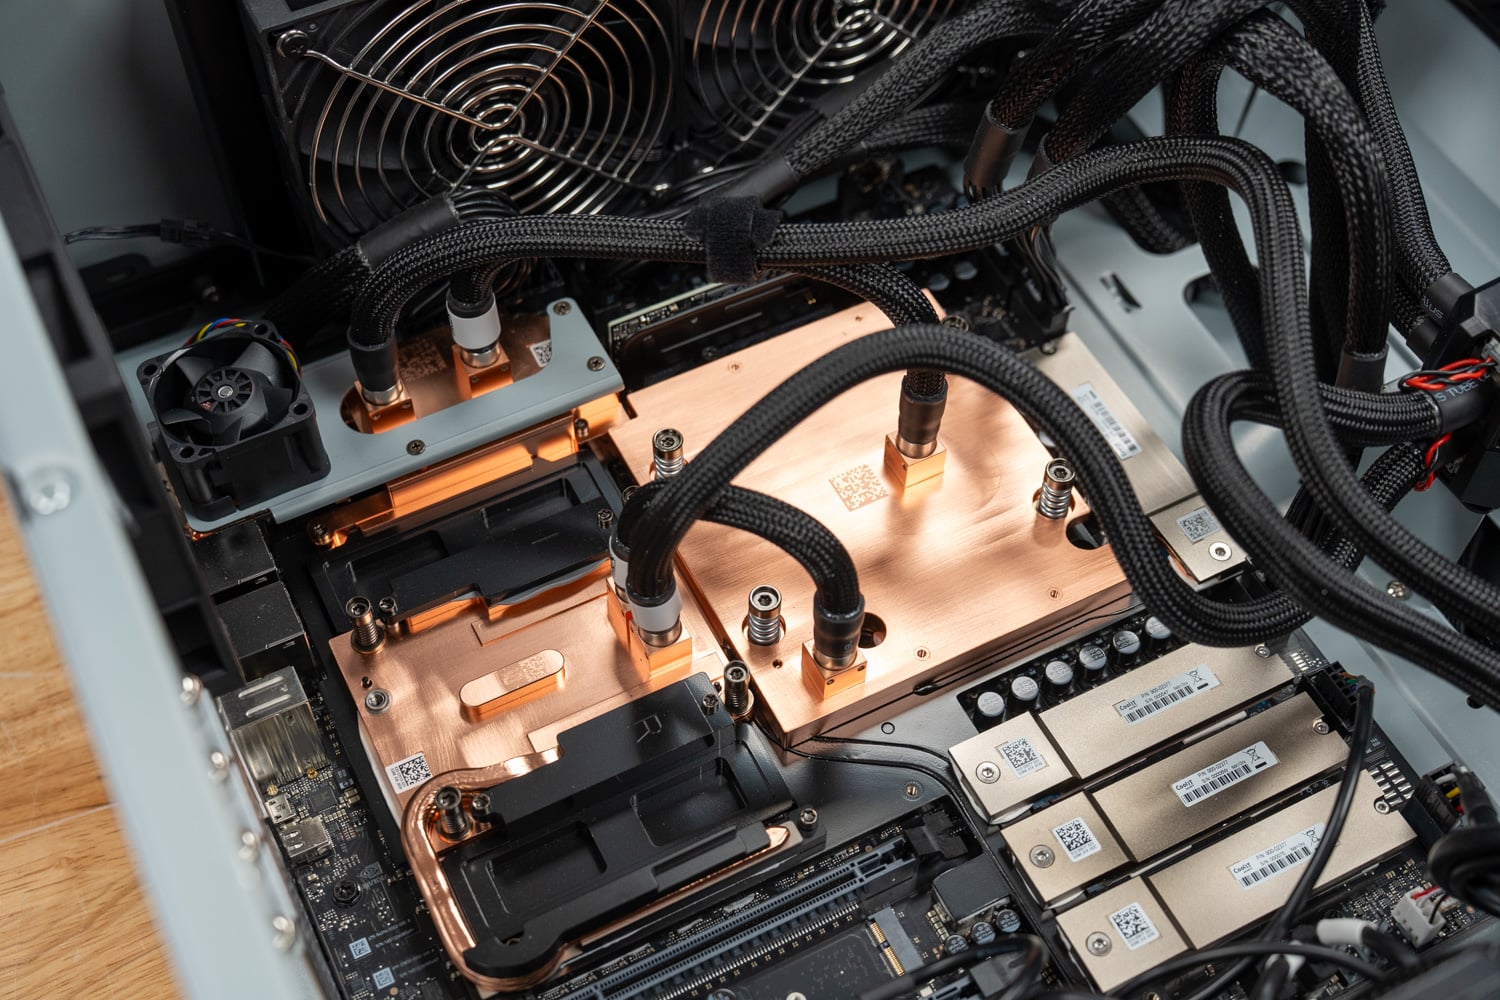
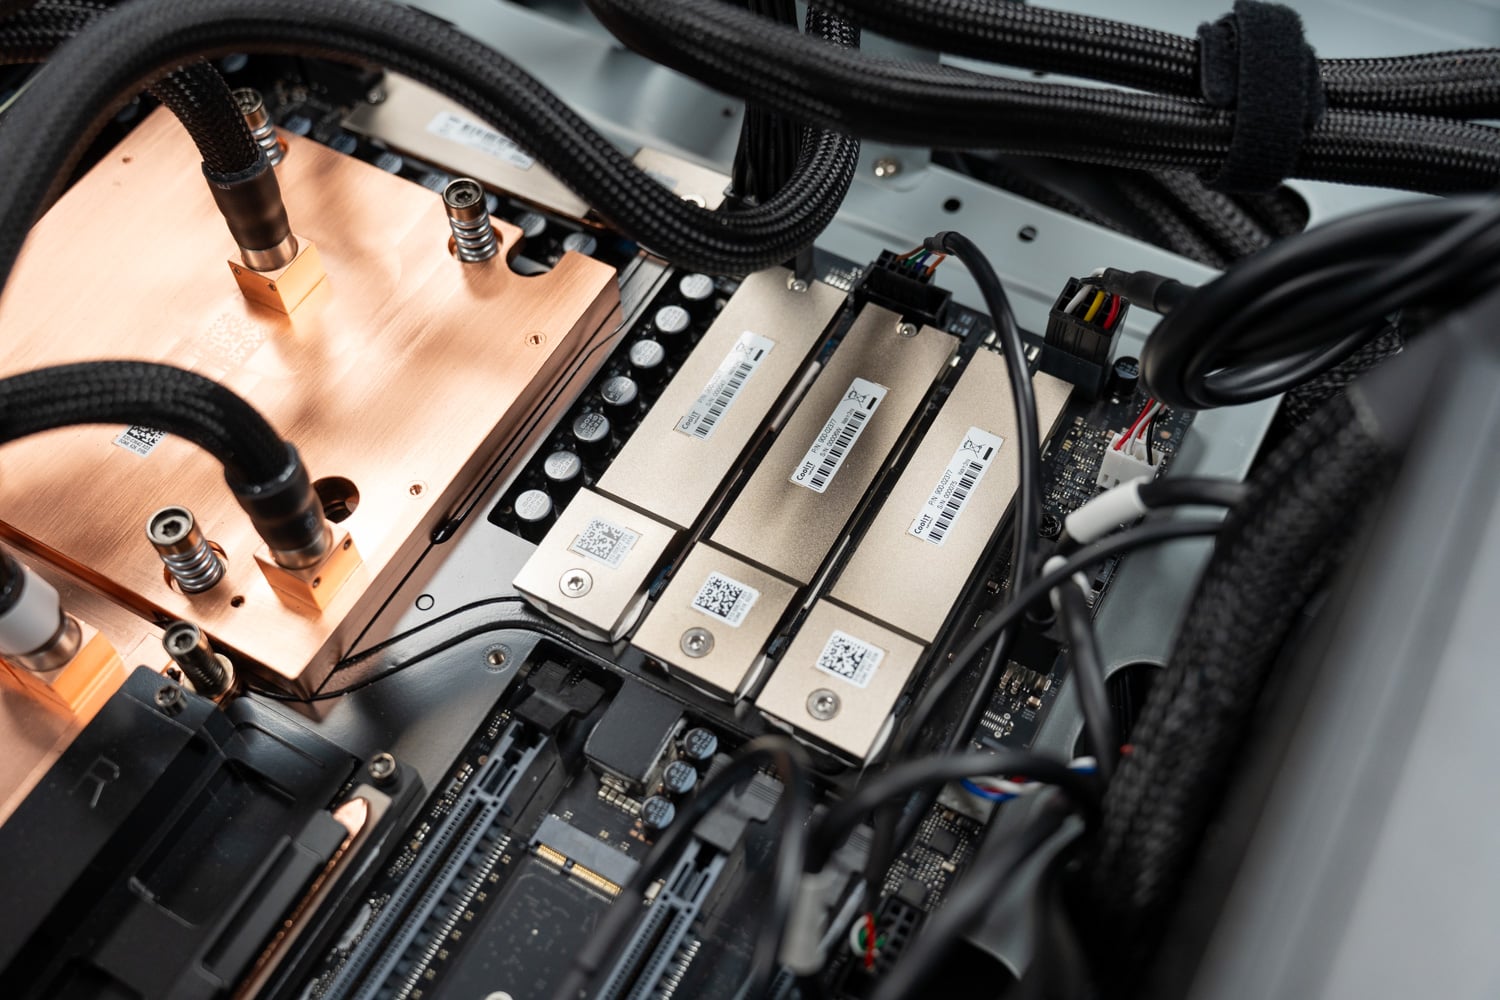
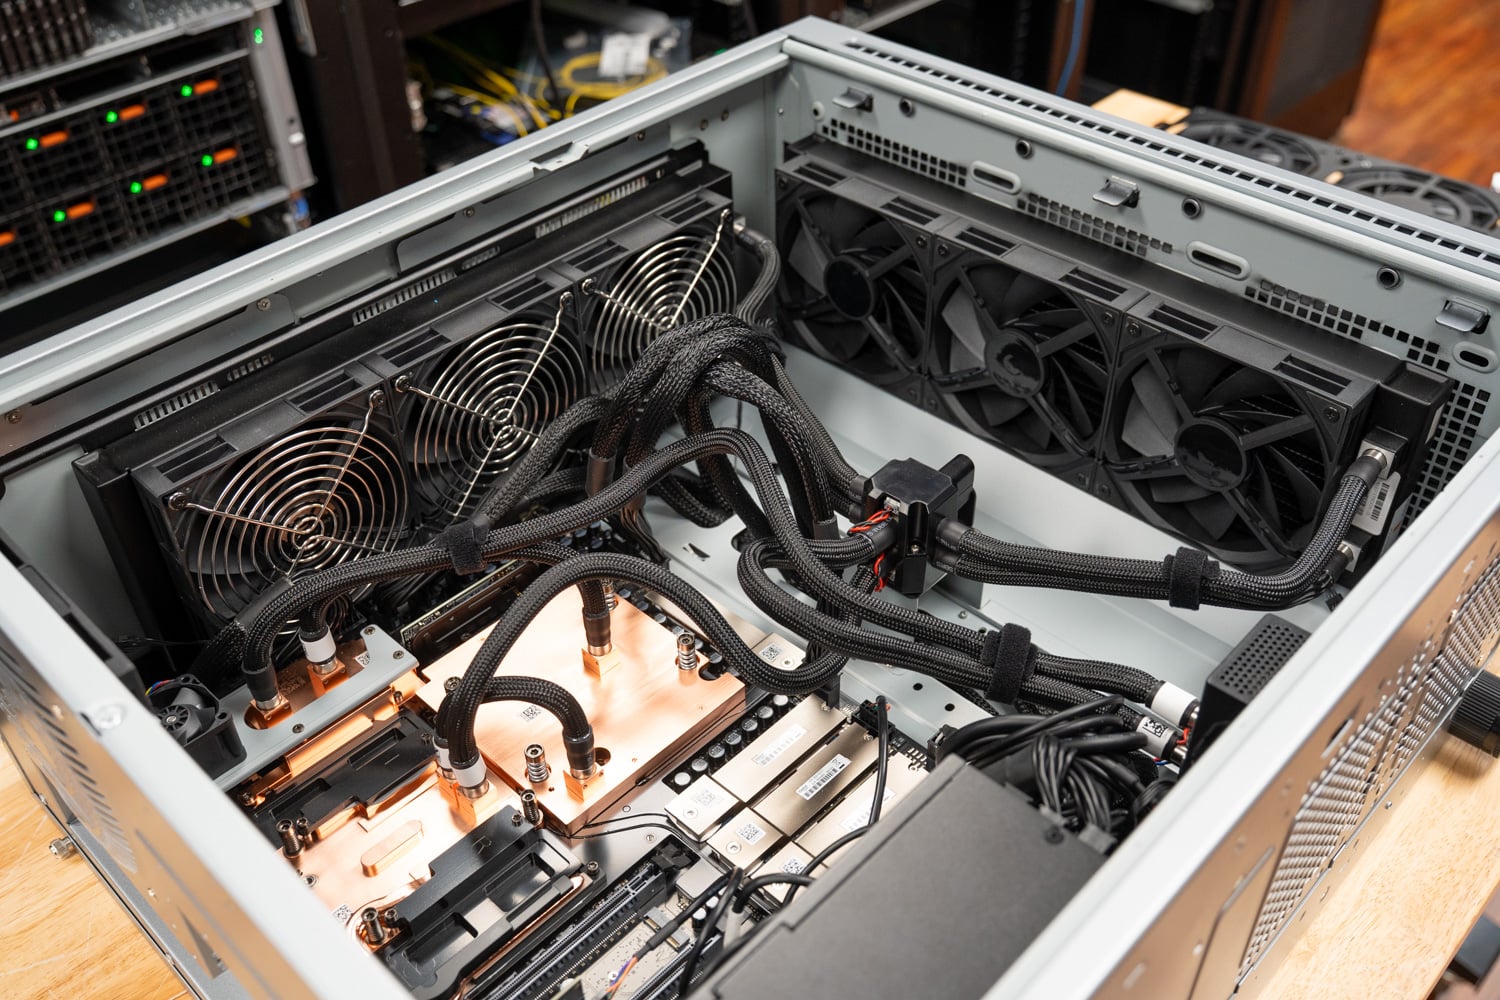
측면 패널을 제거하면 ET900N G3는 WS300과 매우 유사한 외관을 가지고 있는데, 이는 두 제품 모두 동일한 NVIDIA 메인보드를 공유한다는 점을 고려하면 당연한 결과입니다. GB300 슈퍼칩은 섀시 왼쪽의 구리 냉각판 아래에 위치하고 있으며, SOCAMM 모듈은 그 옆의 구리 냉각판 아래에, ConnectX-8은 후면 I/O 패널 근처의 세 번째 블록 아래에 자리 잡고 있습니다. 브레이드 튜브는 블록에서 섀시 크로스멤버에 장착된 분배 매니폴드로 연결되고, 거기에서 라디에이터로 이어집니다. 3개의 풀 사이즈 PCIe 슬롯은 슈퍼칩 아래에 있으며, 전원 공급 장치는 하단 전면 모서리에 위치하고, 금속 덮개가 하단 케이블 경로를 덮고 있습니다.
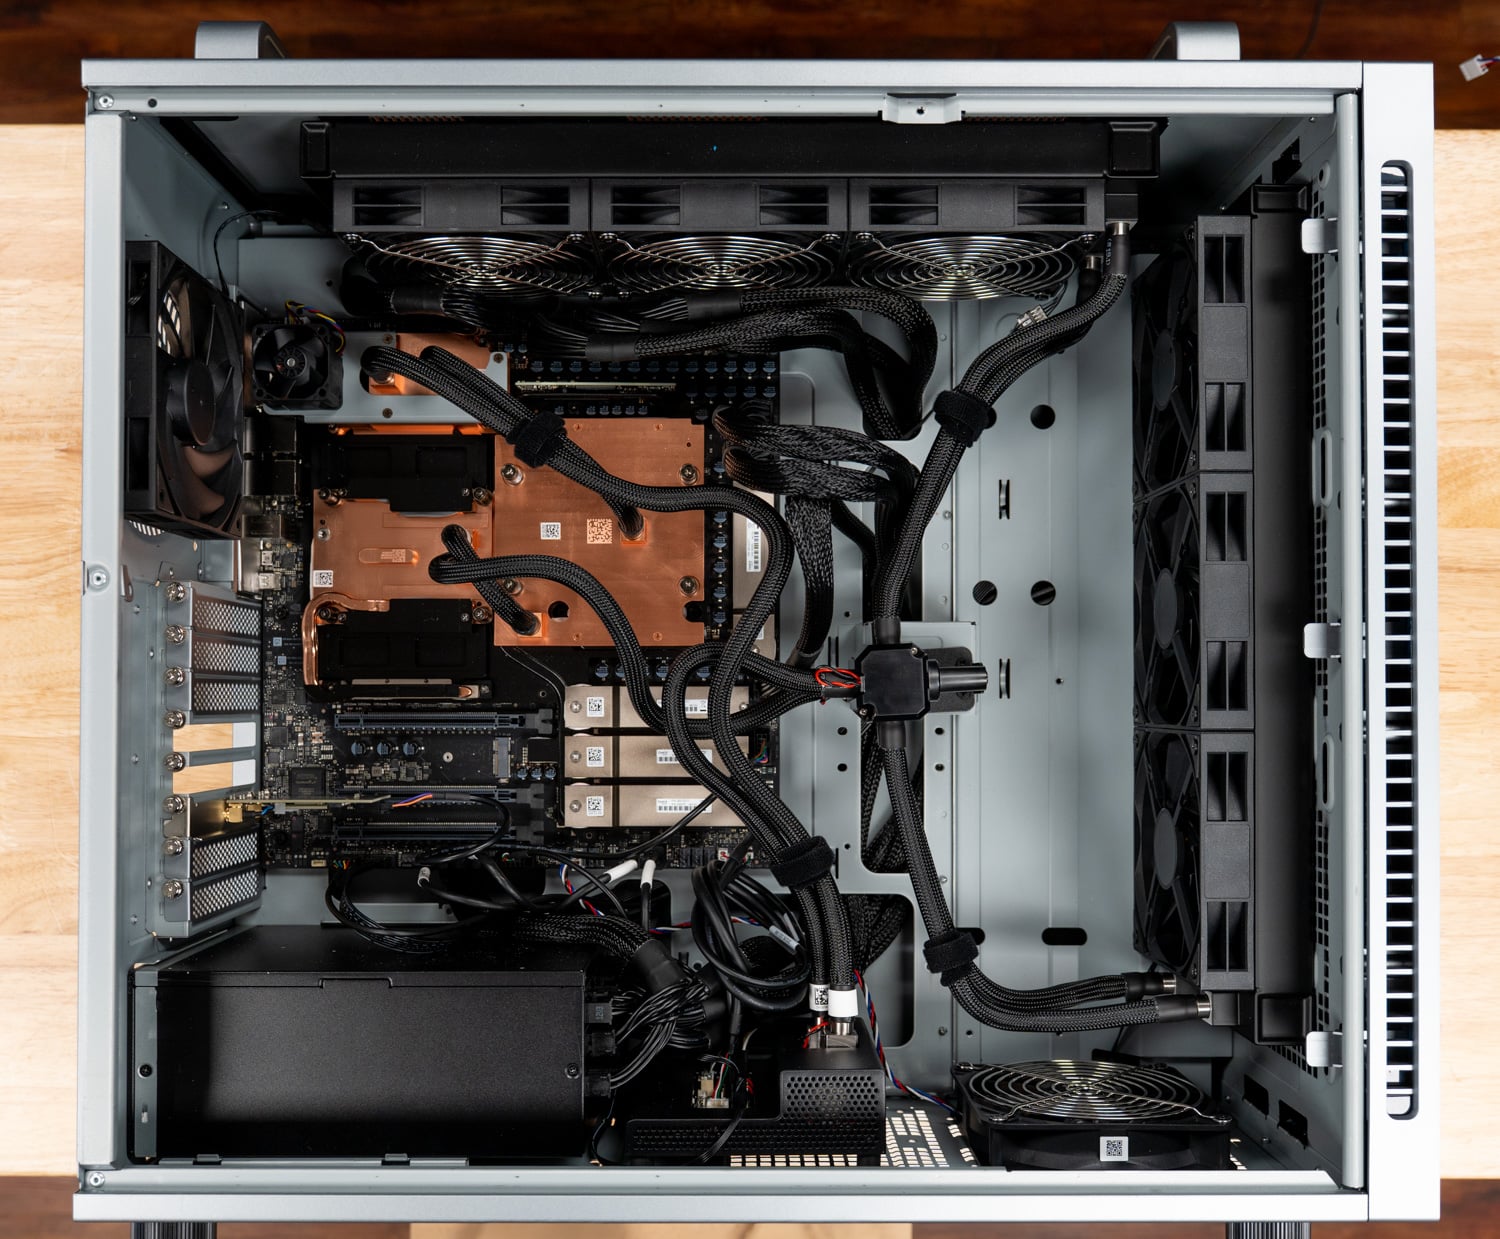
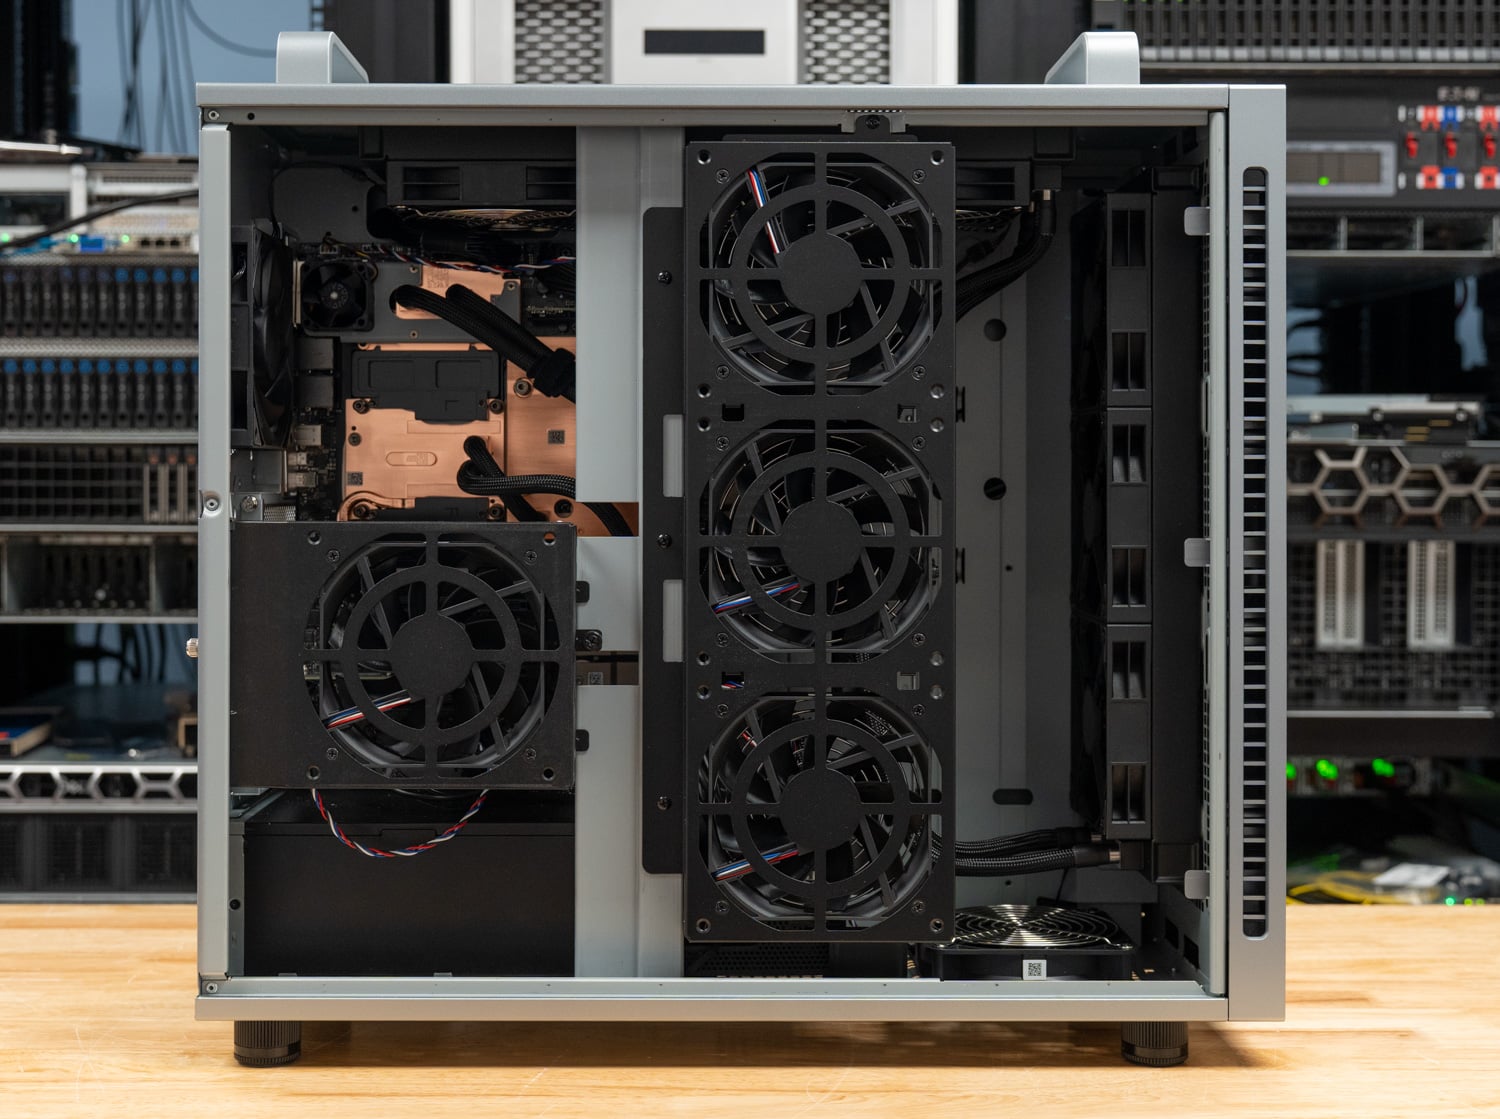
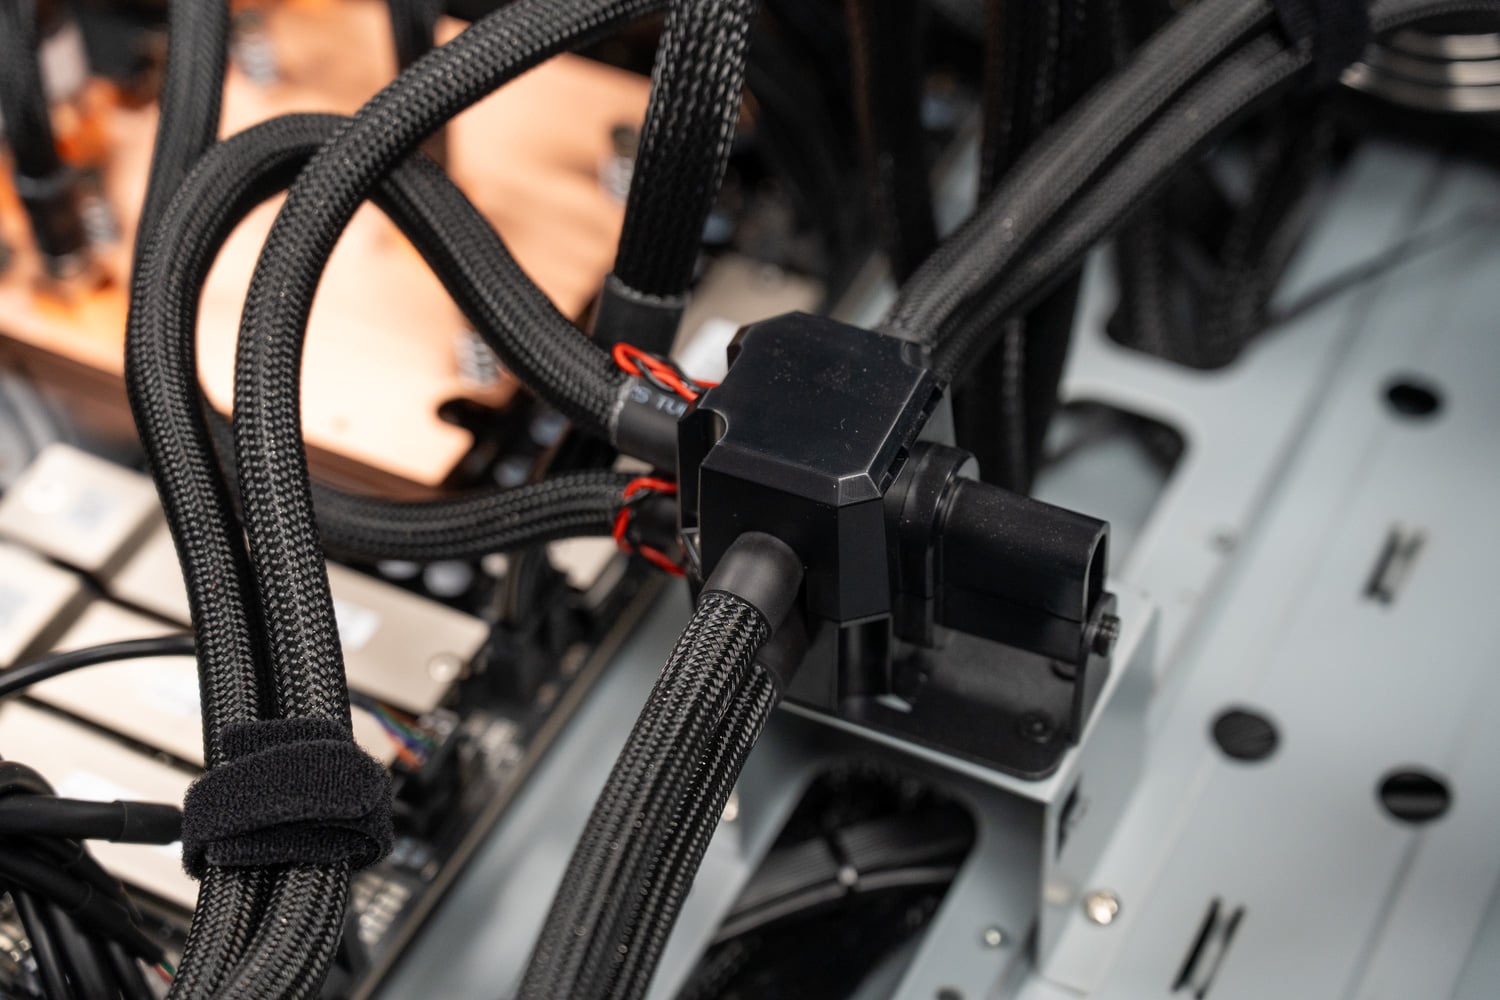
내부 구조는 WS300과 동일한 패턴을 따릅니다. 전면 메쉬 뒤쪽에 수직으로 장착된 라디에이터 하나와 상단에 장착된 또 다른 라디에이터 하나가 있으며, 각각 팬이 일렬로 배치되어 있고 후면에는 섀시 팬이 있습니다. 냉각수 라인은 슬리브 처리되어 벨크로 스트랩으로 크로스멤버에 고정되며, 매니폴드는 4개의 콜드 플레이트에서 나오는 라인을 통합하여 각 라디에이터에 두 개의 라인만 연결되도록 합니다.
광학 팬
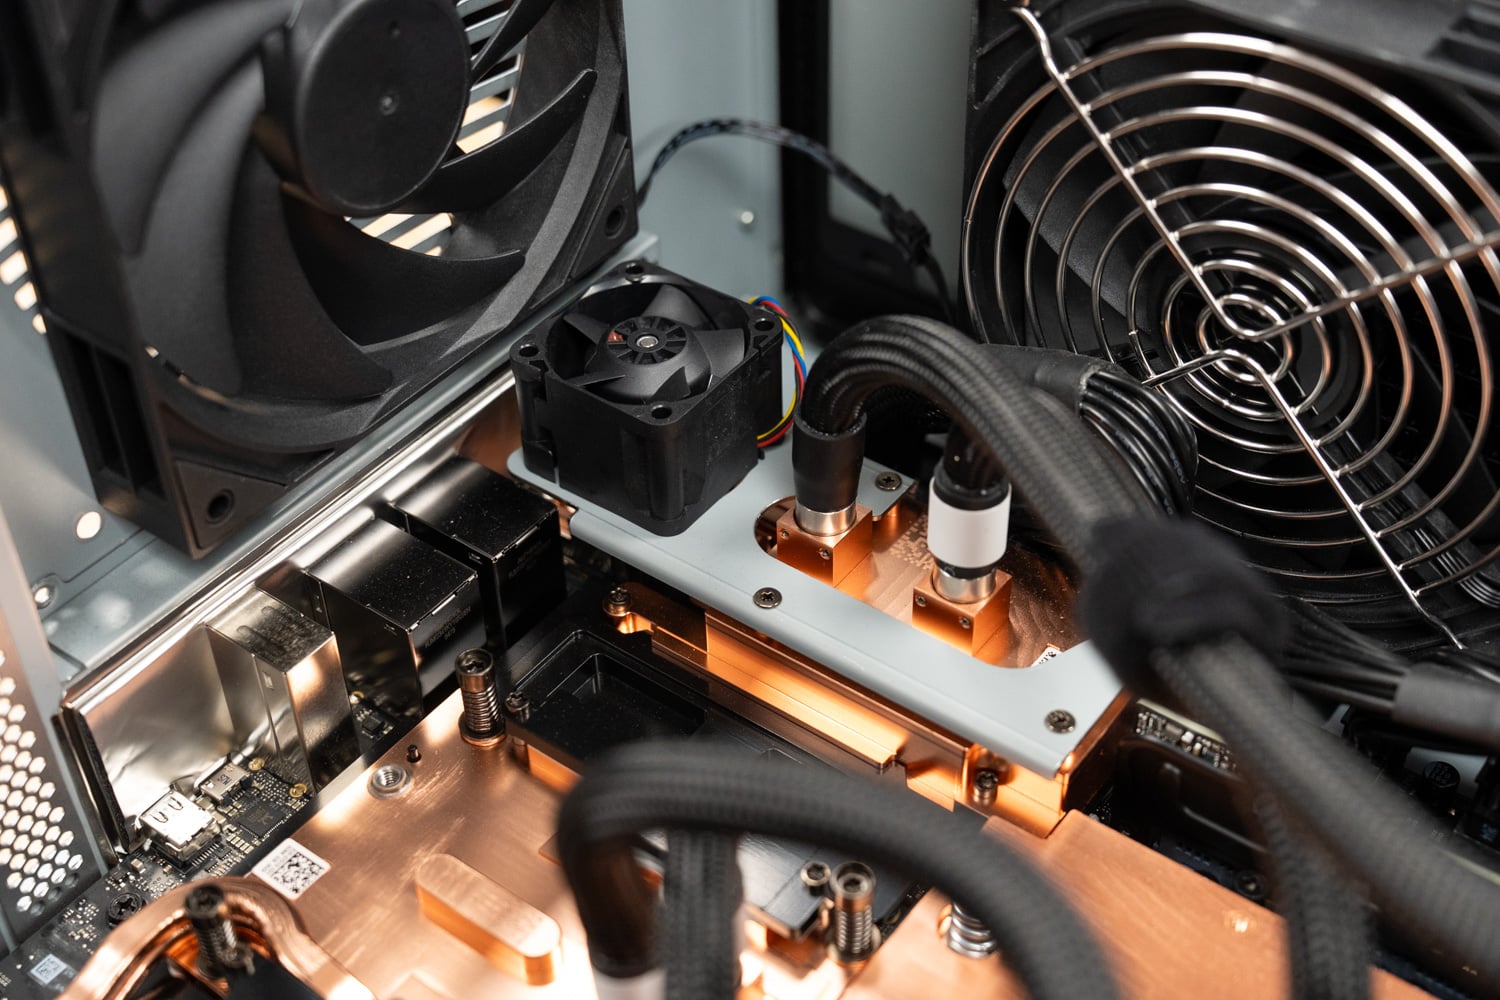
WS300에는 없는 유일한 냉각 요소는 ConnectX-8 콜드 플레이트 위에 있는 브래킷에 장착되어 QSFP112 케이지를 향하는 작은 팬입니다. 액체 냉각 루프는 SuperNIC 실리콘 자체를 냉각하지만, 400G 광 트랜시버는 자체적으로 열을 발생시키고 콜드 플레이트가 전도 방식으로만 열을 전달할 수 있는 금속 케이지에 위치합니다. 다른 테스트에서 ConnectX-8은 지속적인 부하 시 온도가 올라가고 광 모듈 자체도 뜨거워질 수 있다는 점을 확인했으므로, 케이지를 가로지르는 전용 공기 흐름 경로는 ET900N G3를 광섬유 케이블로 장시간 작동시키려는 사용자에게 유용한 설계 요소입니다. DAC 케이블(현재 진행 중인 클러스터 추론 심층 분석을 위해 두 번째 GB300 스테이션에 연결한 방식)을 사용하는 경우 팬의 역할은 줄어듭니다.
저장 용량, 확장성 및 전원 공급
ASUS는 ET900N G3에 운영 체제와 NVIDIA 소프트웨어 스택용 2TB NVMe 드라이브 하나를 장착하여 출고했으며, 이 드라이브는 PCIe 5.0 x4를 통해 Grace에 연결된 두 개의 M.2 2280 슬롯에 장착되었습니다. 나머지 두 개의 슬롯은 ConnectX-8에 통합된 PCIe 스위치에 연결되어 있으며, 출고 시에는 비어 있었습니다.
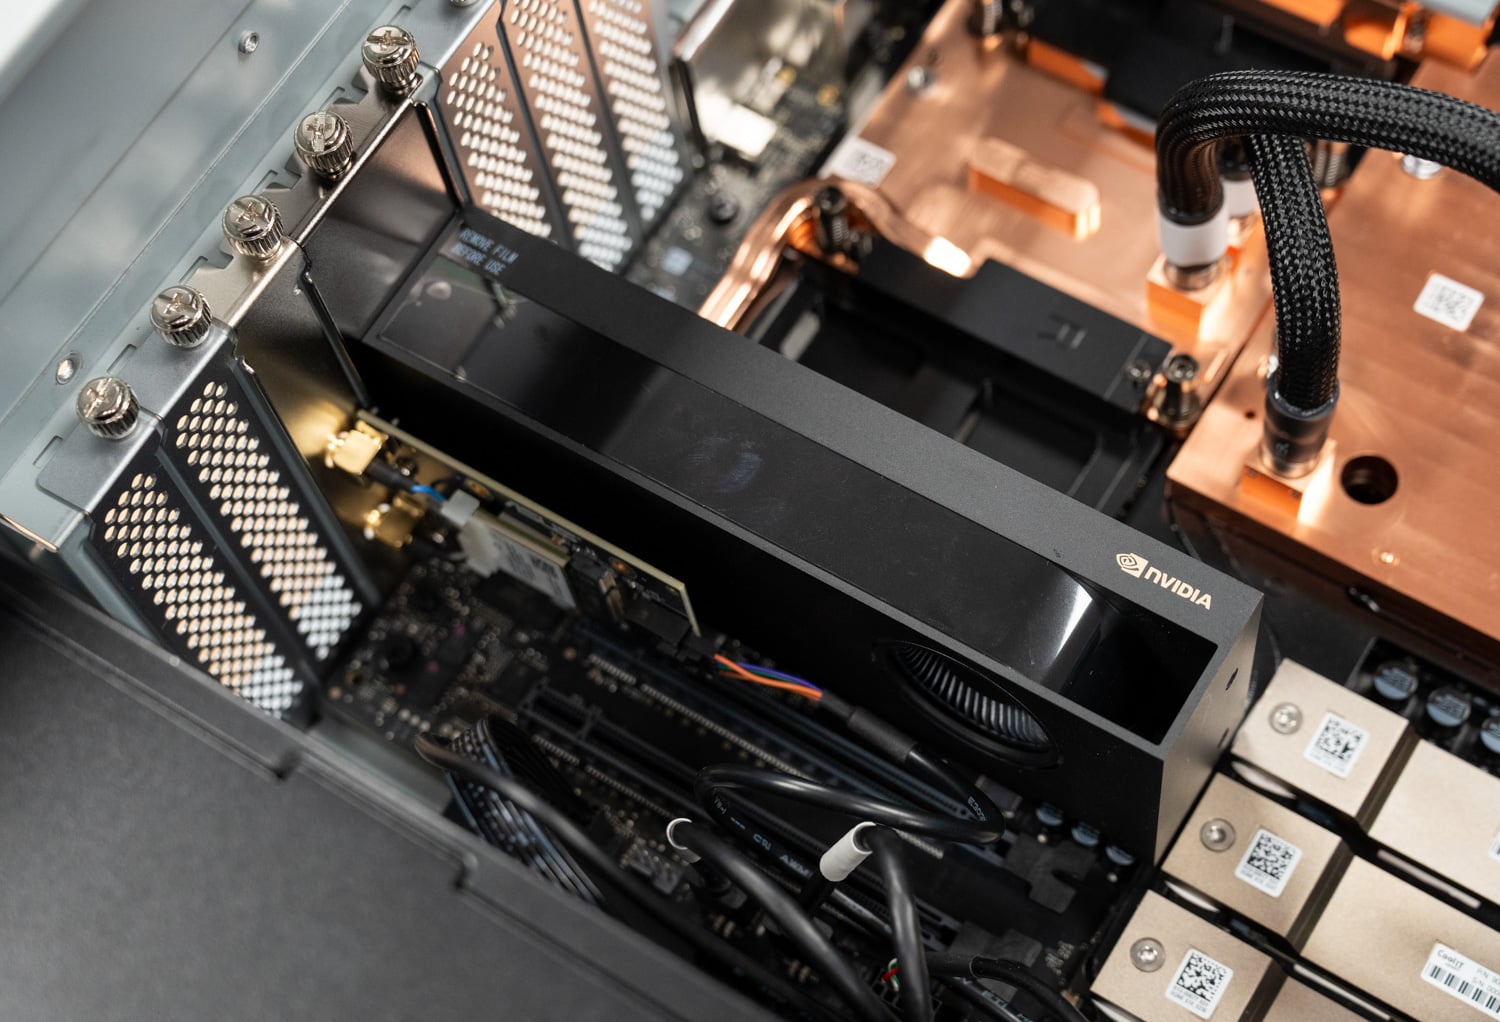
저희 리뷰용 제품은 ASUS에서 제공하는 구성 중 하나인 PCIe 5.0 x16 슬롯에 NVIDIA RTX PRO 2000 Blackwell이 장착된 상태로 배송되었습니다. 이 그래픽 카드는 GB300의 전력 소모를 크게 늘리지 않으면서 디스플레이 출력을 제공하며, ASUS는 이 섀시에 RTX PRO Blackwell 카드를 최대 1개까지 장착할 수 있다고 밝혔습니다. 벤치마킹을 진행하기 전에 RTX PRO 2000을 제거하여 Superchip이 최대 전력을 활용할 수 있도록 했습니다. 이는 WS300 테스트와 동일한 조건입니다. 또한, 이 섀시에서는 고성능 RTX PRO 카드를 테스트하지 않았습니다. 고성능 RTX PRO 카드를 사용할 경우 전력 소모에 미치는 영향은 향후 GB300 Station 리뷰에서 자세히 다룰 예정입니다.
파워 서플라이는 ASUS가 80 PLUS Titanium 등급을 부여한 1,600W ATX 유닛으로, WS300에 탑재된 Platinum 등급보다 한 단계 위입니다. Titanium 등급은 115V 입력에서 50% 부하 시 94%의 효율을 요구하며, Platinum 등급은 92%입니다. 또한 Titanium 등급은 10% 부하에서 최소 효율 기준을 설정하는 유일한 등급이므로, ET900N G3는 GB300에 최대 부하가 걸렸을 때 벽면 콘센트에서 수십 와트의 전력 손실을 줄여줍니다. 전력 예산은 여전히 공유됩니다. Grace 메인보드, B300 메인보드, 펌프, 팬, 스토리지, 그리고 RTX PRO 그래픽 카드는 모두 동일한 1,600W 전력을 사용하며, NVIDIA의 vsloshd 서비스는 Superchip과 추가 GPU의 전력 소모량 변화에 따라 여유 전력을 자동으로 조정합니다. 고정된 전력 제한은 없습니다. WS300 리뷰에서 이 정책에 대해 자세히 설명했으며, 이 제품에서도 변경되지 않았습니다. 북미 지역 설치 시에는 20A 전용 회로가 필수입니다.
입/출력 라인
ConnectX-8의 두 개의 QSFP112 포트는 ET900N G3를 스토리지, 두 번째 DGX 스테이션 또는 클러스터 패브릭과 같은 다른 모든 장치와 연결하는 데 사용됩니다. 이 포트는 이미 연구실에서 사용 중이며, ET900N G3는 400G DAC 케이블을 통해 두 번째 GB300 스테이션에 연결되어 클러스터 추론에 대한 심층 분석을 진행하고 있으며, 관련 내용은 별도로 게시할 예정입니다. 10GbE Marvell 포트는 일반 호스트 트래픽을 처리하고, Realtek 1GbE 포트는 BMC 전용으로 사용됩니다.
테스트 노트
본 리뷰의 모든 결과는 ASUS에서 저희 연구실로 배송한 제품(252GB HBM3e 및 496GB LPDDR5X의 기본 메모리 구성)을 기준으로 합니다. 시스템에는 RTX PRO 카드가 설치되지 않았으므로 GB300 Superchip은 WS300 테스트와 동일한 조건에서 최대 가속기 전력을 사용할 수 있었습니다. 소프트웨어 스택, vLLM 구성, 워크로드 프로파일 및 동시 실행 스윕은 WS300 테스트에 사용한 것과 동일하므로 두 제품을 직접 비교할 수 있습니다. 본 리뷰는 성능만을 다루며, 전력 소모량이나 발열은 측정하지 않았습니다.
워크로드는 모든 로컬 AI 시스템에서 실행하는 동일한 두 가지 vLLM 실시간 추론 프로파일입니다. 하나는 입력 토큰 512개와 출력 토큰 512개를 사용하는 동일 워크로드이고, 다른 하나는 입력 토큰 8,192개와 출력 토큰 1,024개를 사용하는 사전 채우기 비중이 높은 워크로드로, 동시 스트림 수는 1개에서 128개까지 다양합니다. 최첨단 규모 모델의 경우, RTX PRO 6000 카드 2개 또는 4개가 장착된 Dell PowerEdge XE7740 GPU 서버와 비교합니다. 이는 이러한 검증 지점에 가장 가까운 단일 박스 대안입니다. 소규모 모델의 경우, 동일한 XE7740에 장착된 RTX PRO 6000 카드 1개, Dell PowerEdge R770 에 장착된 H200 NVL 카드 1개 , 그리고 WS300 리뷰에서 사용했던 것과 동일한 Acer Veriton GN100 으로 대표되는 GB10 DGX Spark 와 비교합니다. 아래 ET900N G3 수치는 실행 로그에서 가져온 정확한 값입니다. 비교 시스템 수치는 결과 차트에서 읽어옵니다.
추론 성능
일관성 있는 메모리 풀에 대한 프론티어 모델
GB300의 존재 이유는 B300의 252GB HBM3e 용량 경계를 기준으로 양쪽 모델에 서비스를 제공하기 위함입니다. 따라서 이 경계를 아우르는 네 가지 기준점을 살펴보겠습니다. DeepSeek V4 플래시와 MiniMax M2.7은 HBM에 여유 공간을 두고 장착할 수 있지만, MiniMax M3는 간신히 장착되어 일부 고성능 메모리를 Grace 메모리로 옮겨야 하며, GLM-5.2는 용량의 절반 정도를 호스트 메모리로 분산합니다. 각 기준점의 반대편에는 가장 가까운 단일 박스 대안인 PowerEdge XE7740에 RTX PRO 6000 카드를 함께 사용하는 구성이 있으며, 필요한 경우 고성능 메모리를 호스트 메모리로 분산합니다.
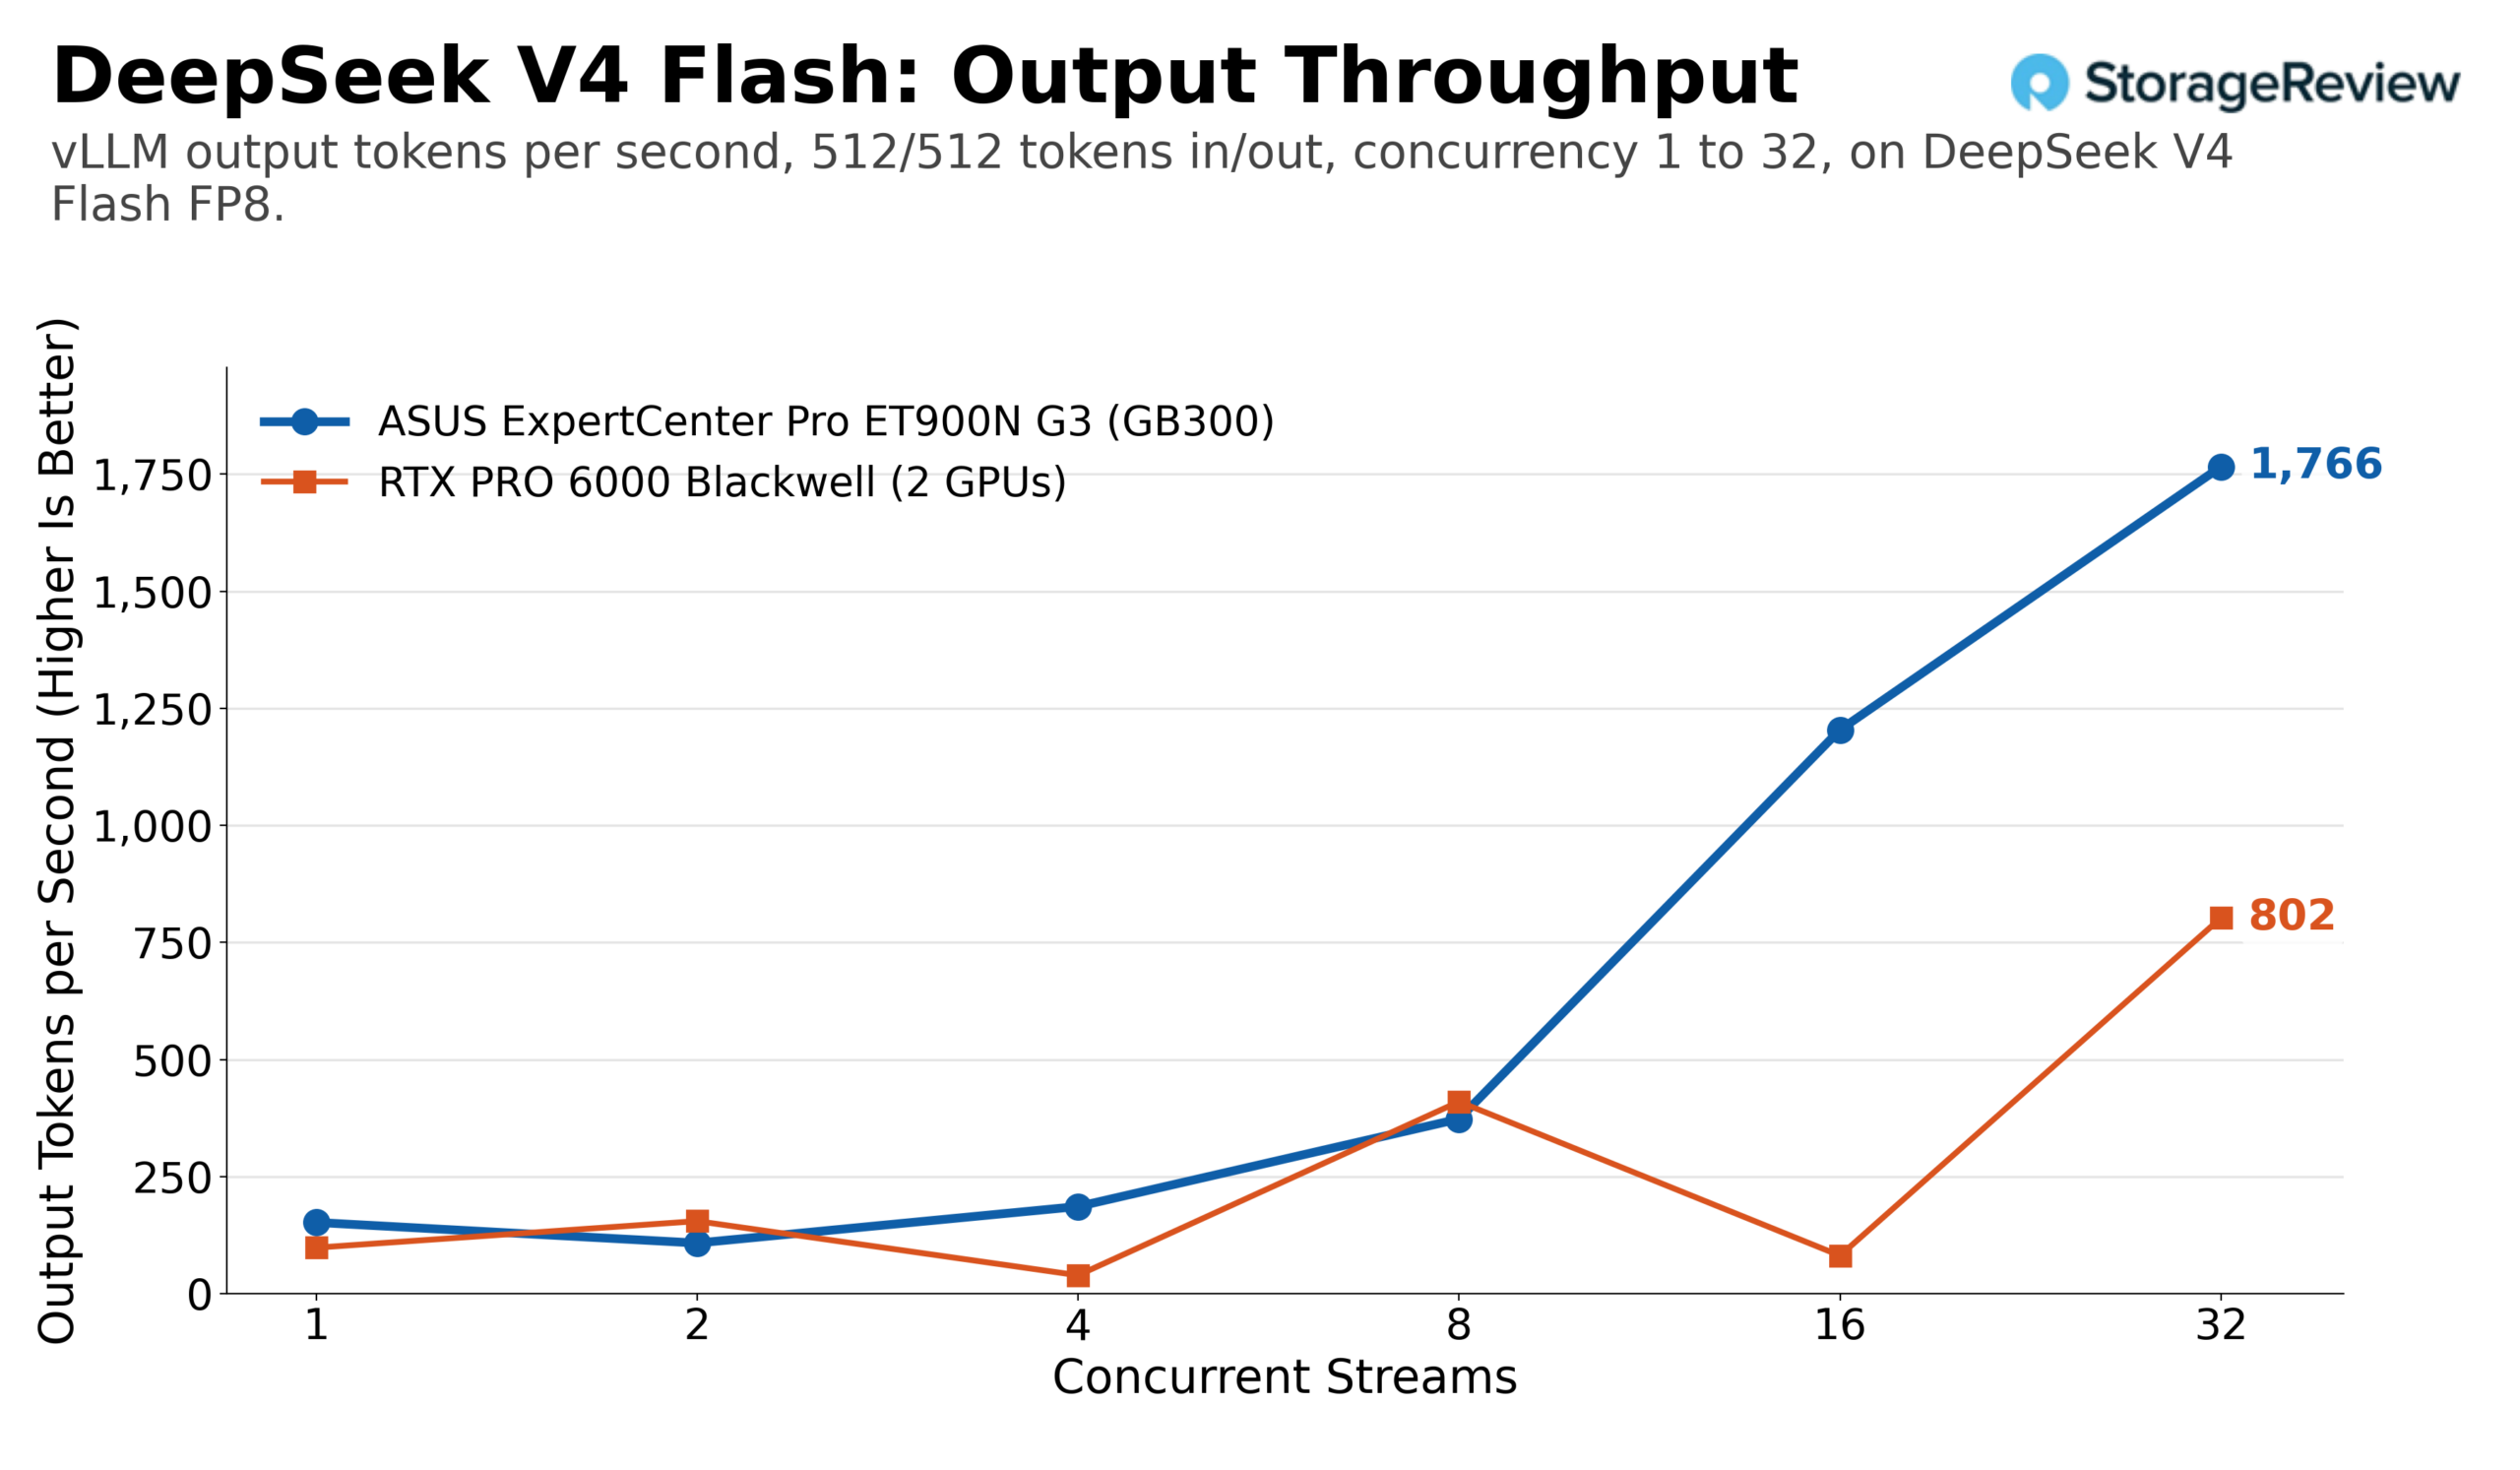
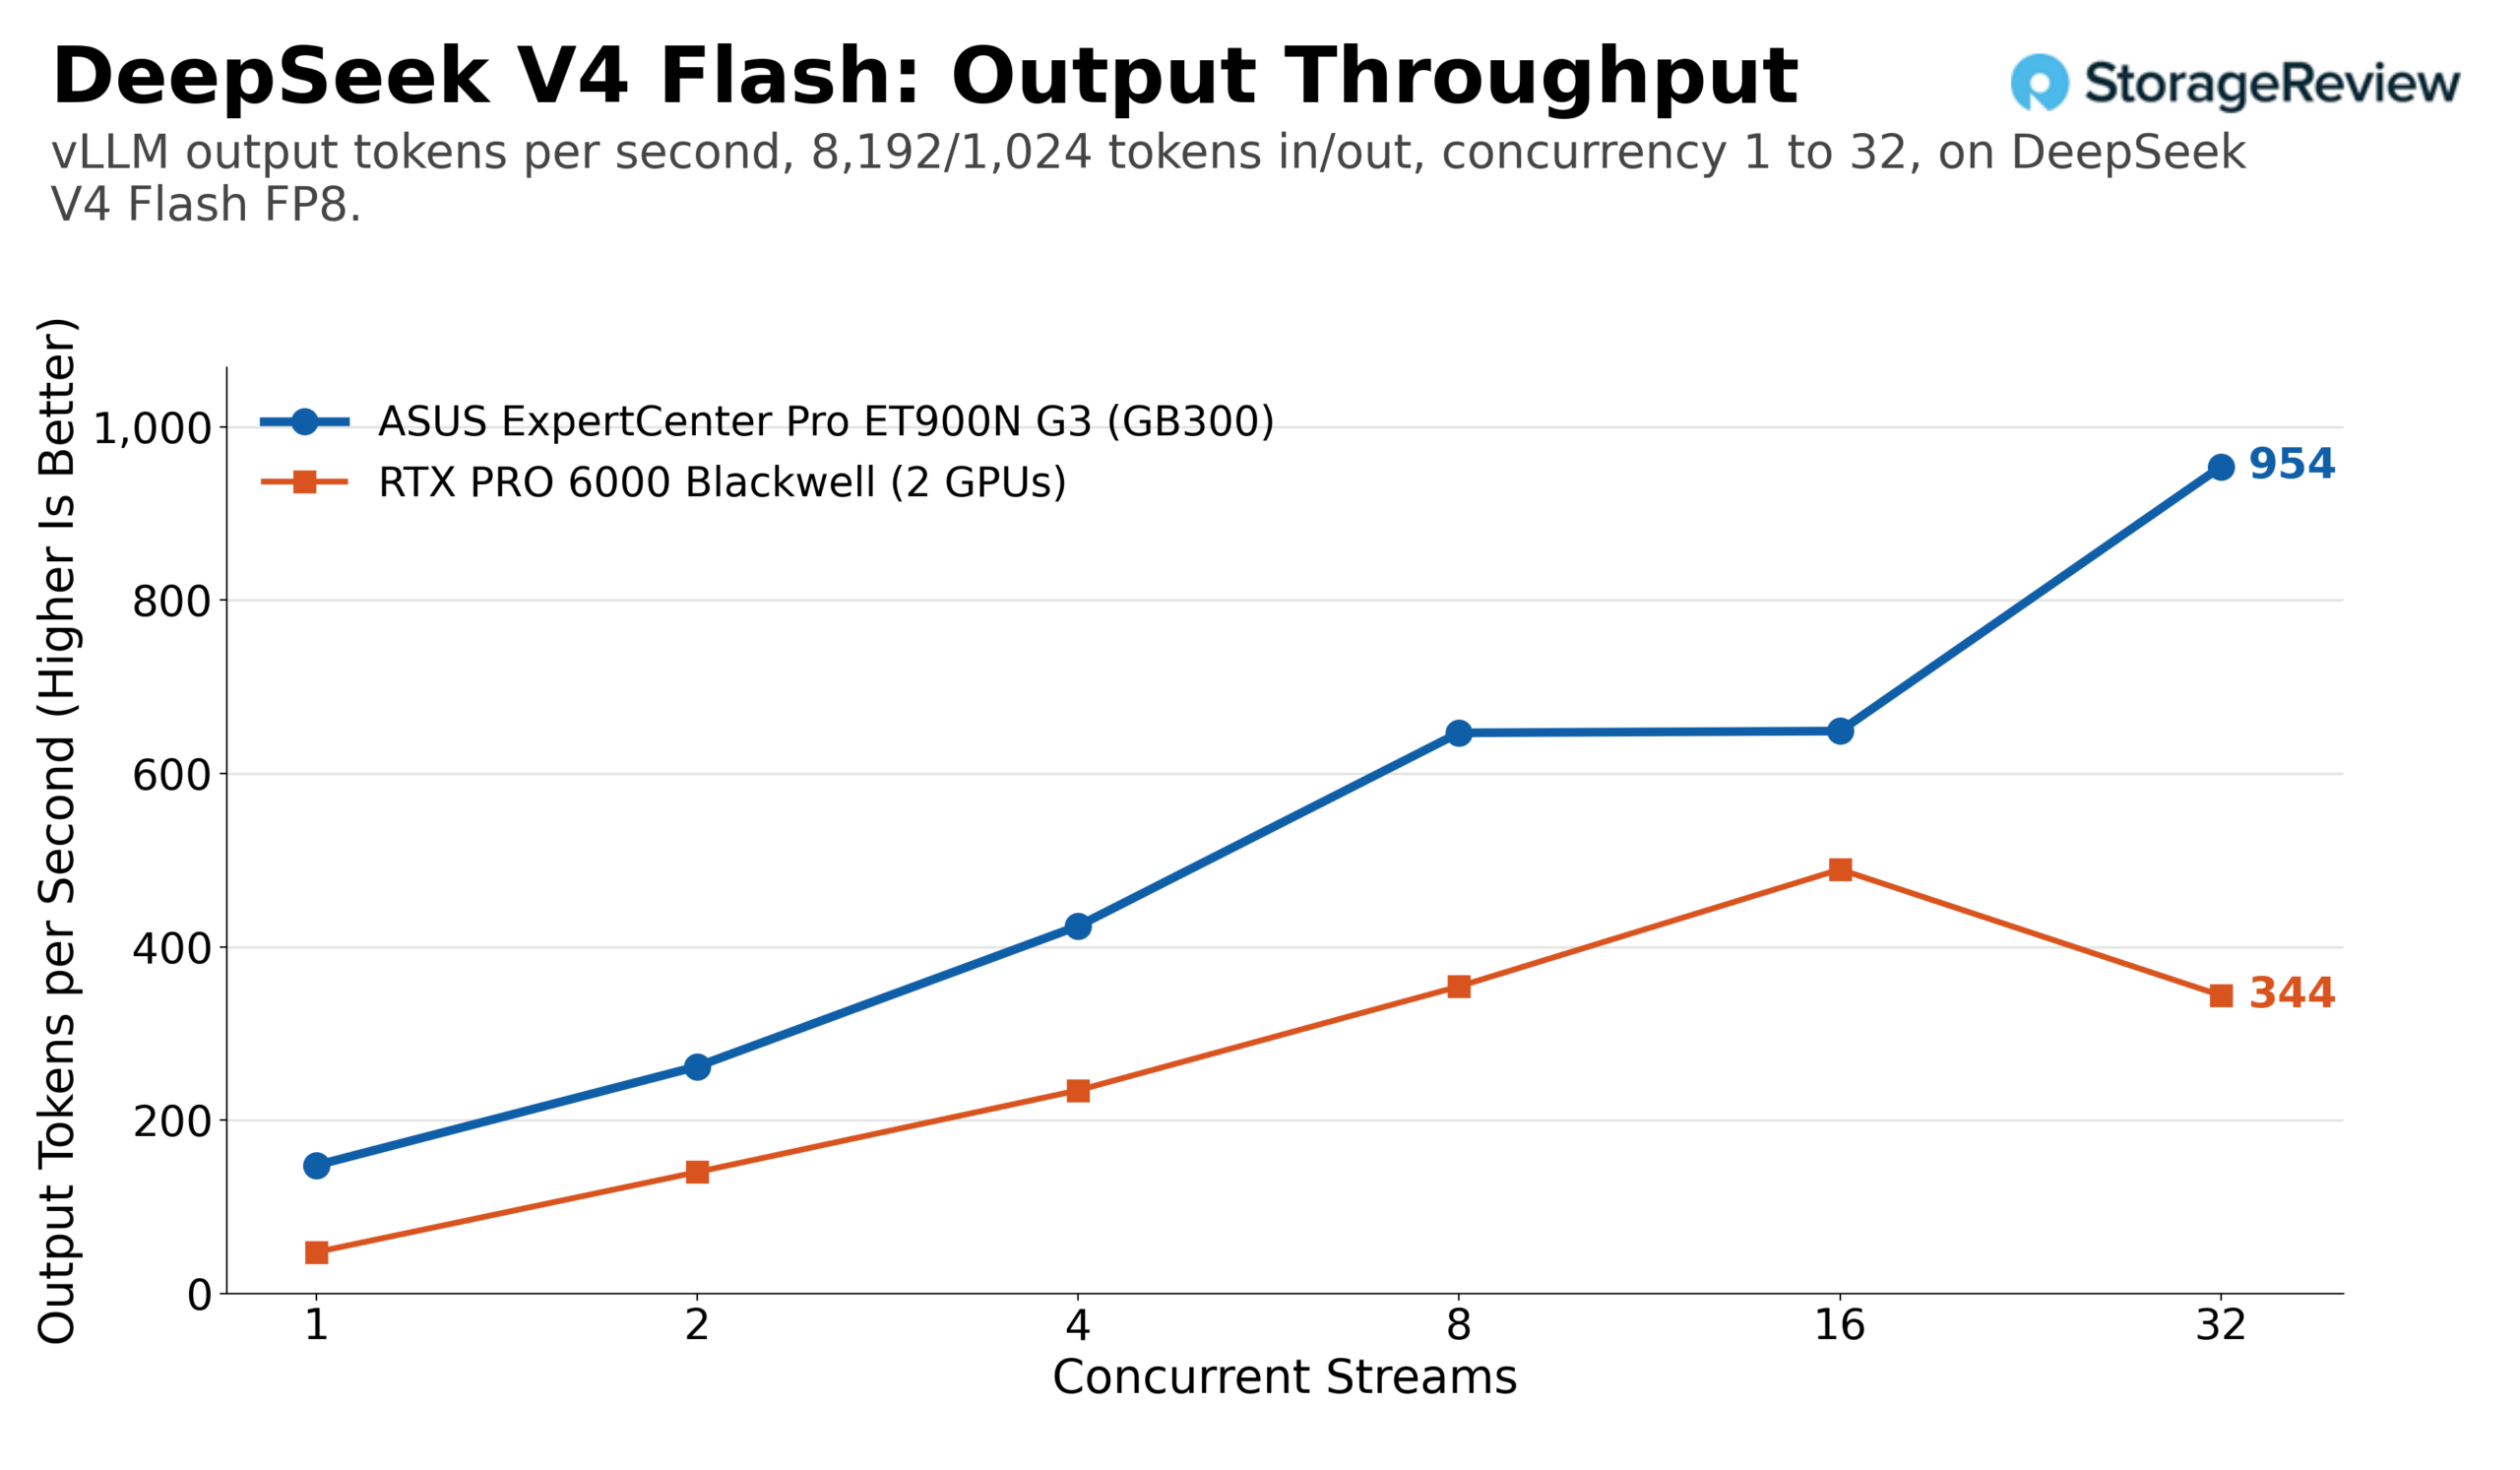
DeepSeek V4 플래시는 처리가 쉬운 경우입니다. B300은 약 20GB의 네이티브 FP8 체크포인트를 무리 없이 제공합니다. 동일한 워크로드에서 출력 처리량은 스트림 1개일 때 초당 152개 토큰에서 스트림 32개일 때 1,766개 토큰으로 증가하여 총 토큰 처리량은 3,532개가 되었습니다. 사전 입력량이 많은 프로파일에서 ET900N G3는 초당 148개에서 954개로 출력 토큰이 증가했으며, 총 토큰 처리량은 8,587개였습니다. RTX PRO 6000 카드 두 장은 동일한 워크로드에서 초당 약 800개의 출력 토큰을, 긴 프롬프트에서는 약 490개의 출력 토큰을 기록했으며, 동시 접속자 수가 적을 때는 처리량 곡선이 고르지 못했습니다.
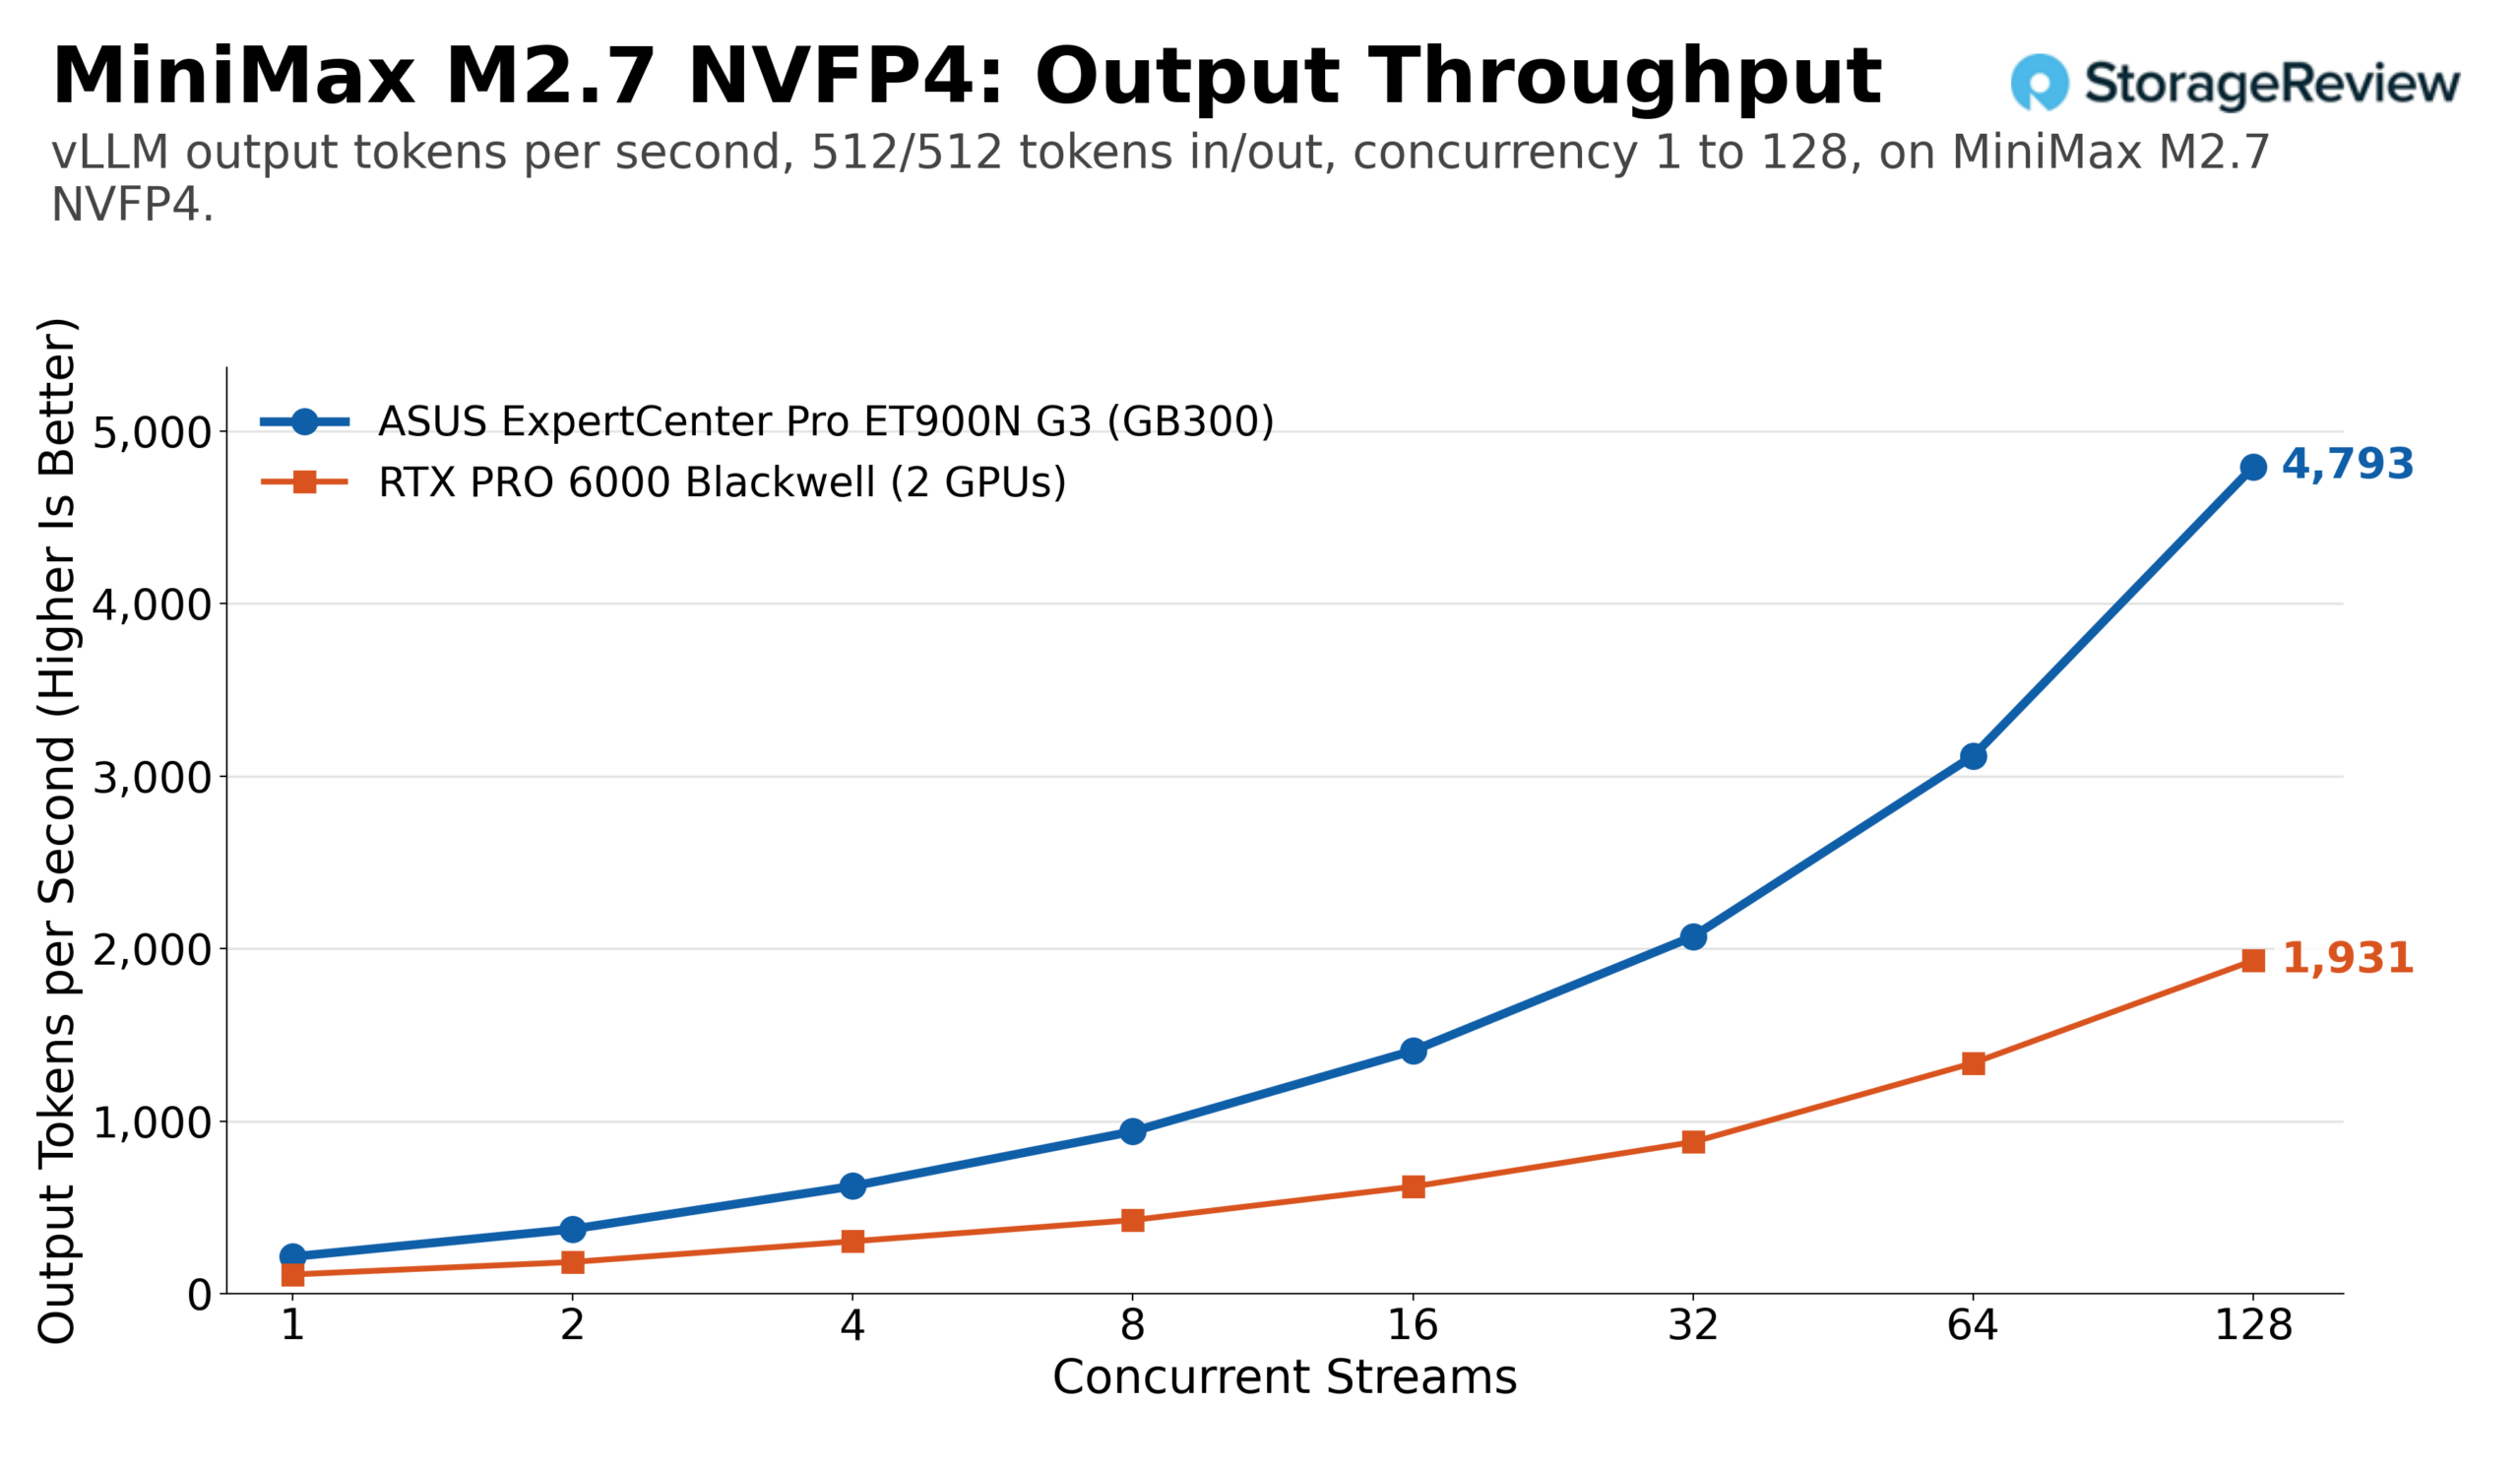
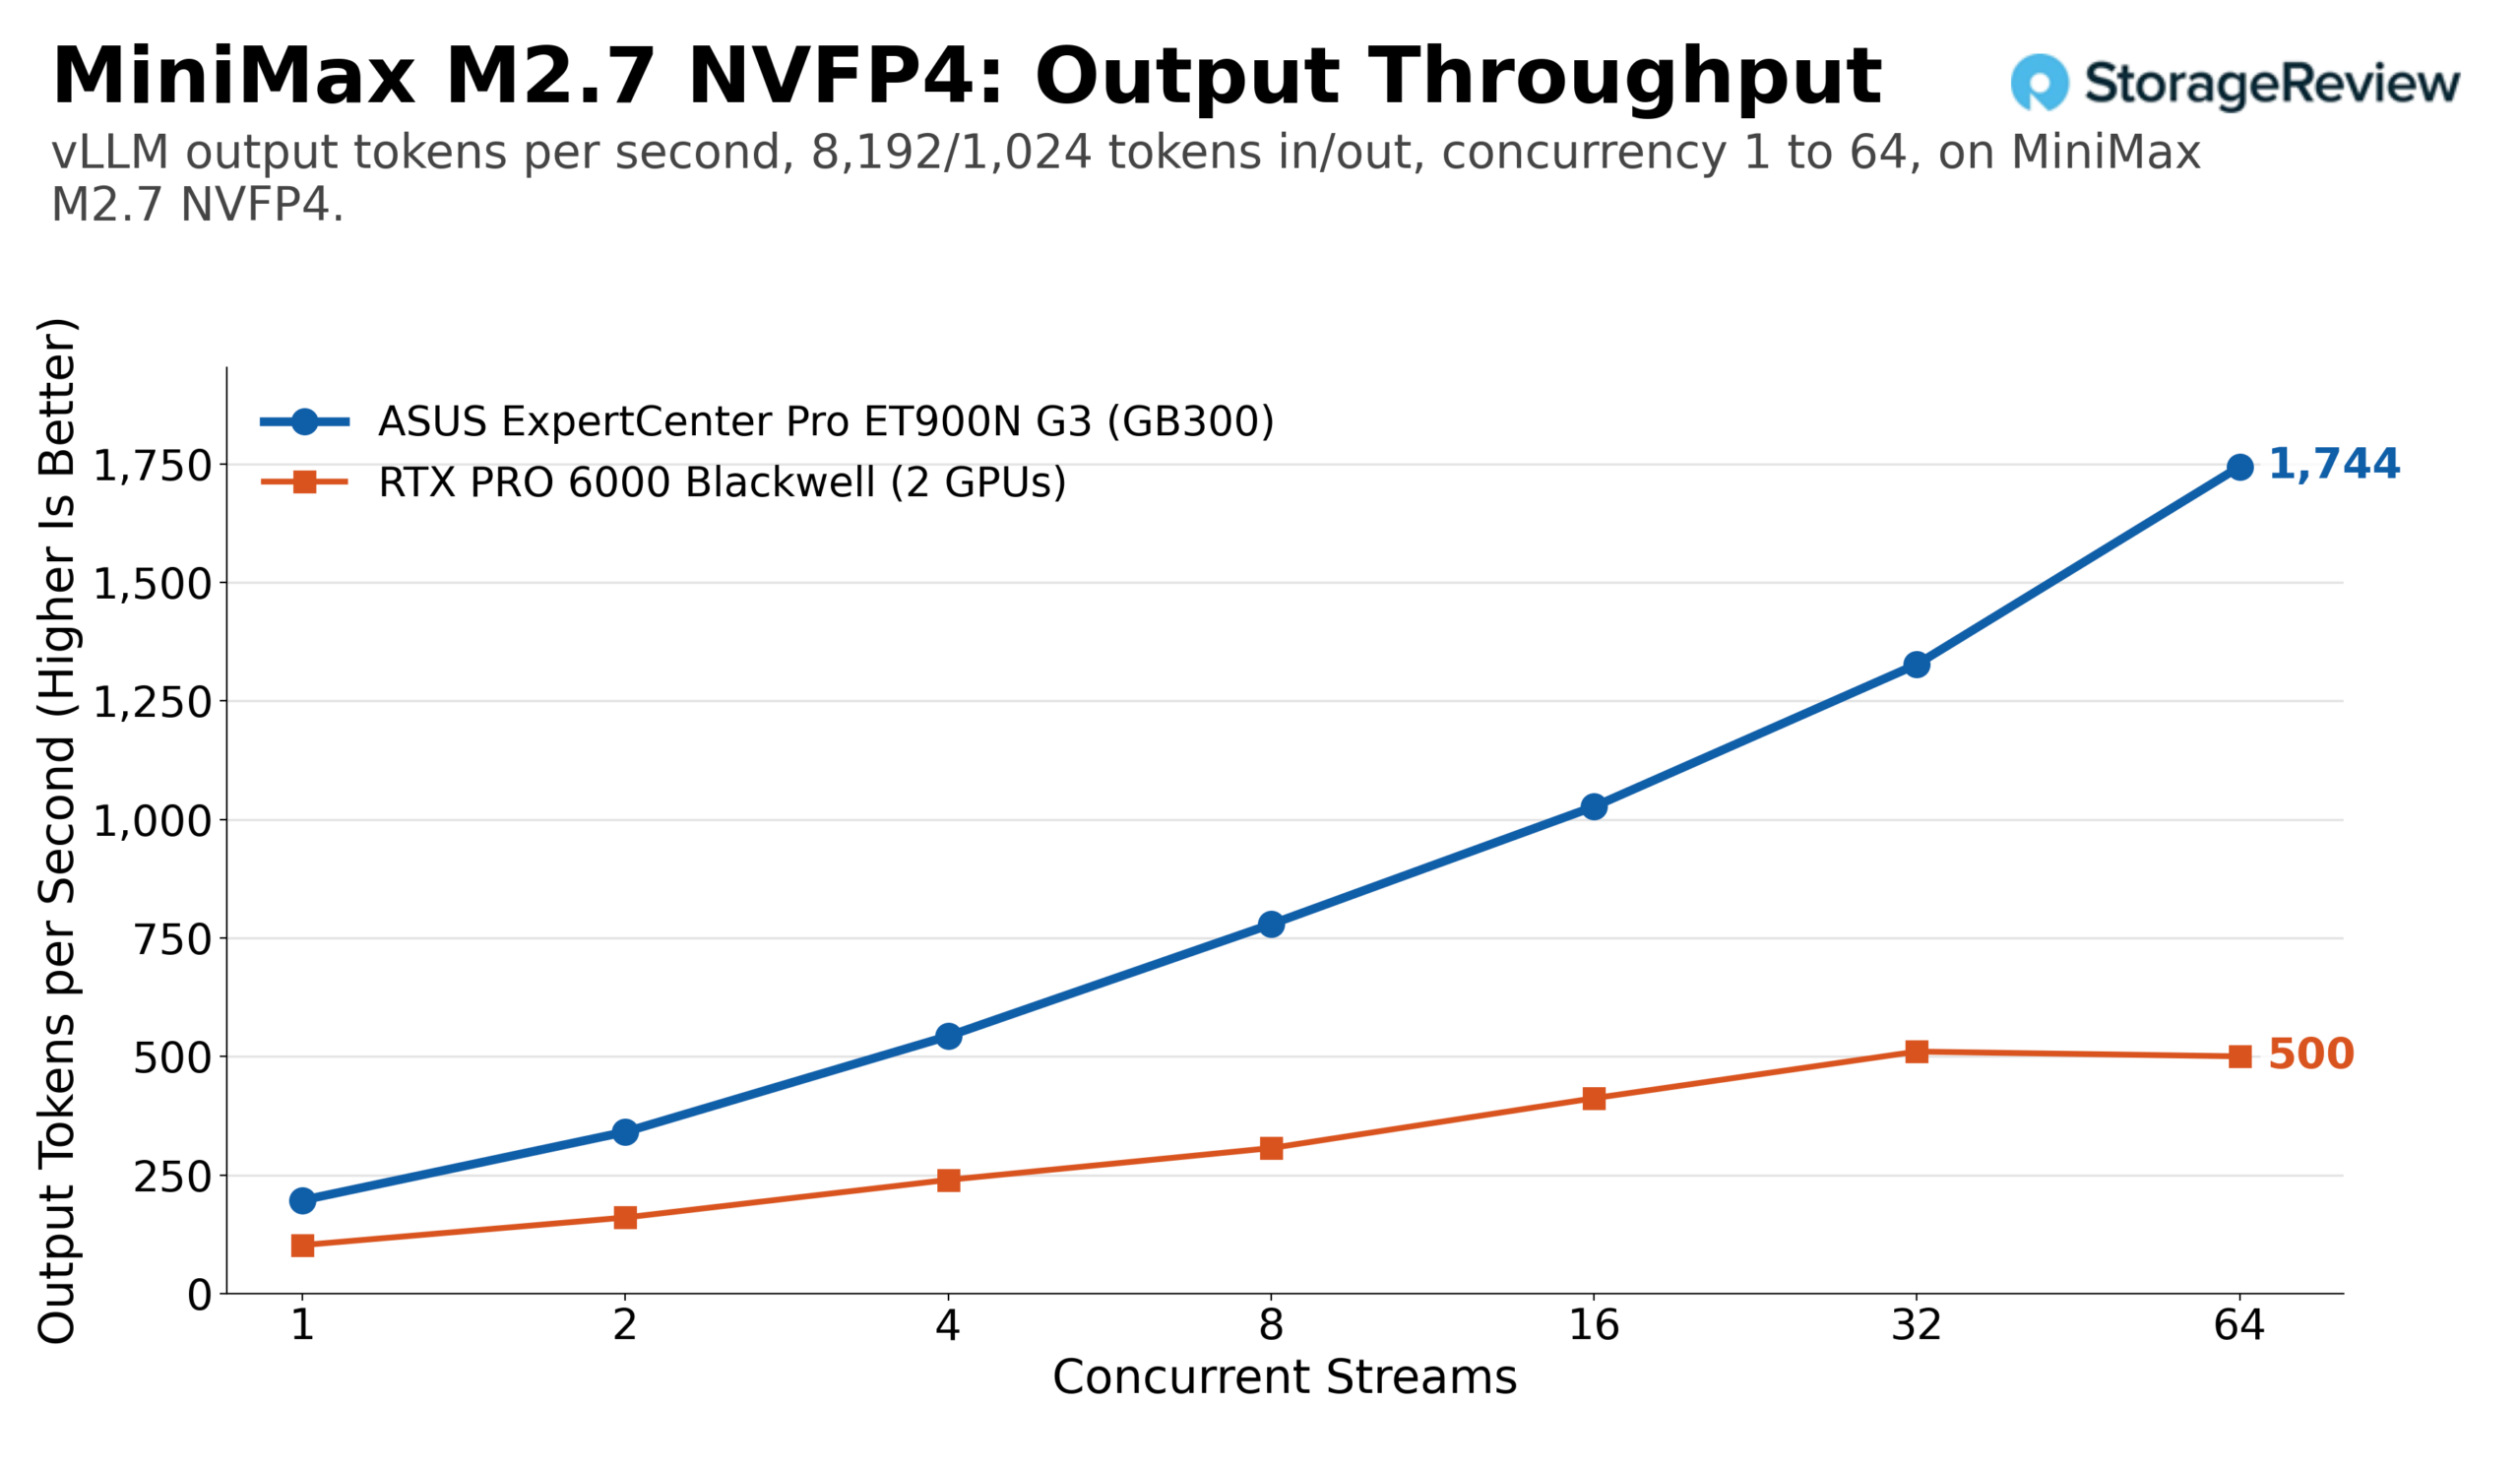
NVIDIA의 NVFP4 양자화에 사용되는 MiniMax M2.7은 약 125GB의 HBM 메모리를 차지하며, 네 가지 칩셋 중 가장 뛰어난 확장성을 보였습니다. 동일한 작업 부하에서 출력 토큰 수는 단일 스트림에서 초당 214개에서 128개 스트림에서 4,793개로 증가했으며, 총 처리량은 9,586개에 달했습니다. 사전 채우기 작업이 많은 테스트에서는 출력 토큰 수가 초당 1,744개, 총 처리량은 초당 15,700개로 증가했으며, 이는 64개 스트림에서 달성되었습니다. 두 개의 RTX PRO 6000 카드는 높이가 절반도 안 되지만 비슷한 성능을 보였으며, 동일한 작업 부하에서 최대 출력 토큰 수는 초당 약 1,930개, 긴 프롬프트에서는 약 510개에 이르렀습니다.
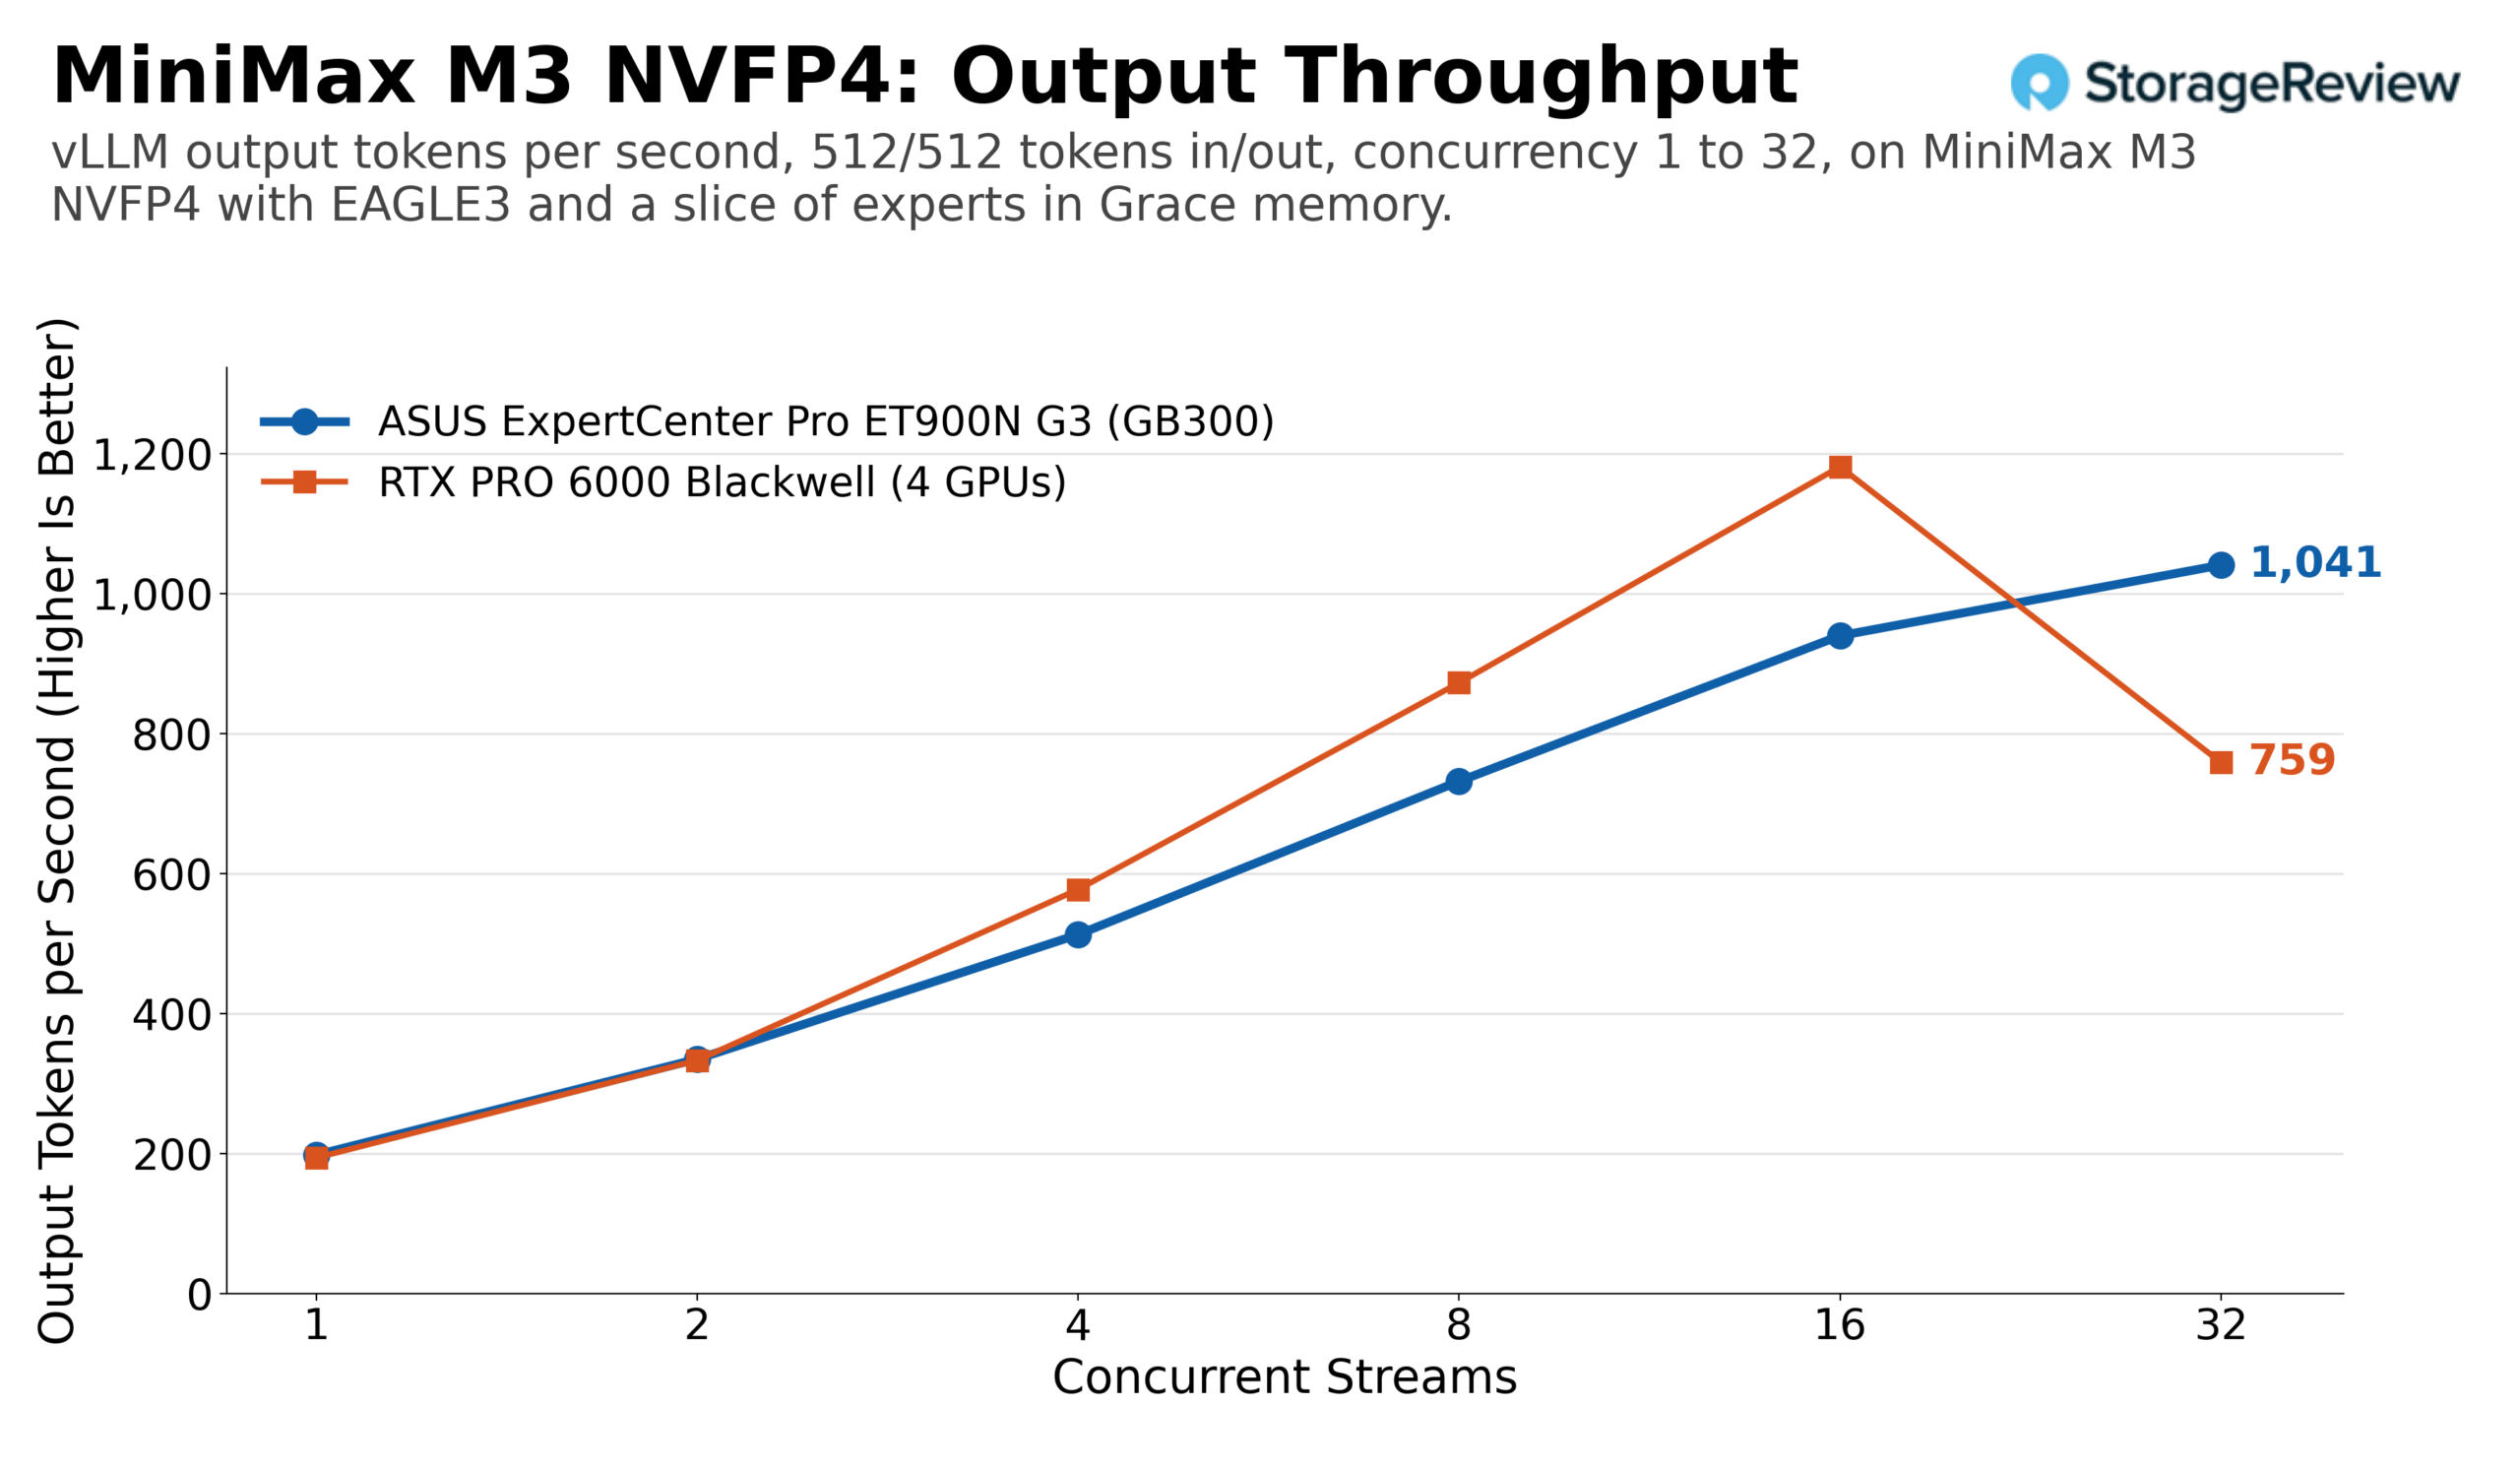
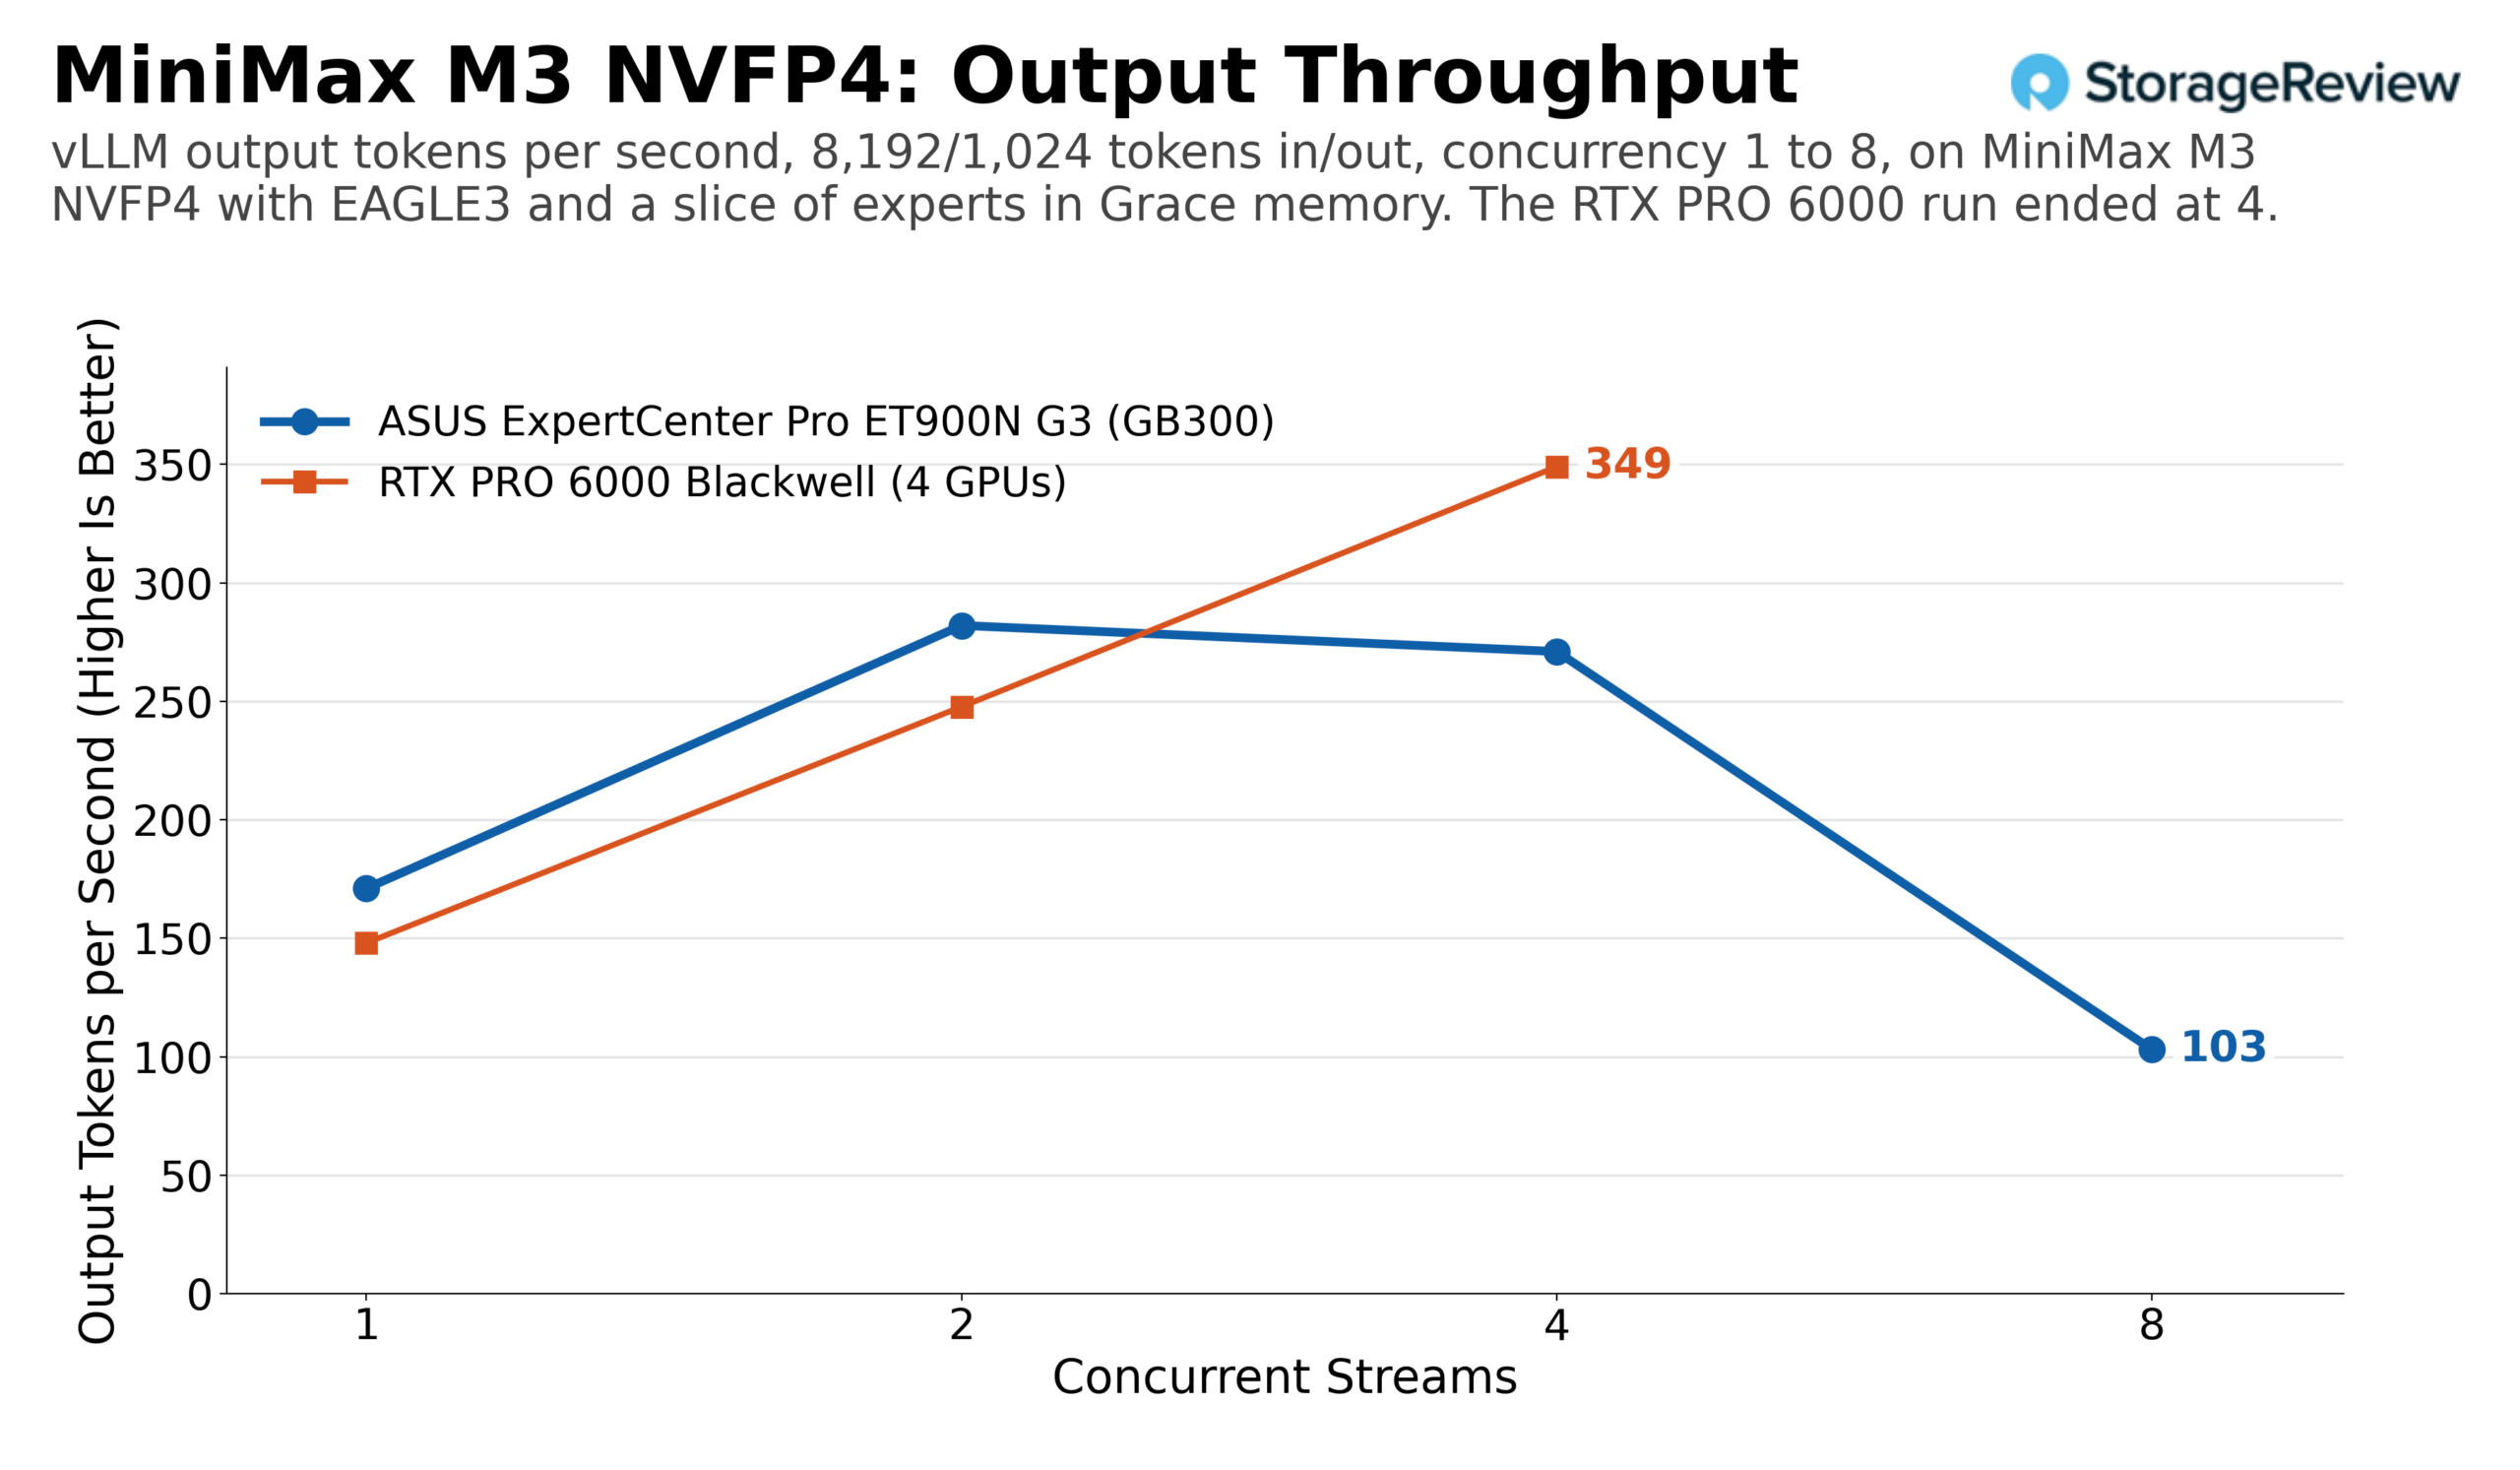
MiniMax M3는 메모리 용량에 아슬아슬하게 들어맞는 성능을 보여줍니다. NVFP4 체크포인트는 252GB보다 작지만, 런타임과 KV 캐시에도 공간이 필요하기 때문에 일부 전문가 함수는 Grace 메모리에 상주하고, 디코딩 과정에서 이 함수들을 거치는 모든 단계는 NVLink-C2C를 통해 전송됩니다. EAGLE3 투기적 디코딩을 사용했을 때, ET900N G3는 동일한 작업 부하에서 32개 스트림으로 초당 1,041개의 출력 토큰을 처리했습니다. 프리필 사용량이 많은 프로파일에서는 2개 스트림에서 최대 282개, 4개 스트림에서 271개를 기록했고, 8개 스트림에서는 긴 프롬프트로 인해 남은 캐시 용량이 소진되면서 103개로 떨어졌습니다. 동일한 투기적 디코더를 사용하는 4개의 RTX PRO 6000 카드는 8개 스트림까지는 비슷한 성능을 보였고, 16개 스트림에서는 초당 약 1,180개의 출력 토큰으로 앞서 나갔지만, 32개 스트림에서는 약 760개로 다시 떨어졌습니다. 사전 데이터 입력량이 많은 프로파일에서 4개의 카드로 구성된 박스는 4개의 스트림에서 초당 약 349개의 출력 토큰을 처리했으며, 이는 Station의 271개에 비해 낮은 수치입니다. HBM 경계에 위치한 이 모델은 4개의 카드에 걸쳐 384GB의 VRAM을 탑재하여 252GB의 HBM과 오프로드 기능을 제공하는 이 제품군과 경쟁하는 유일한 사례입니다.
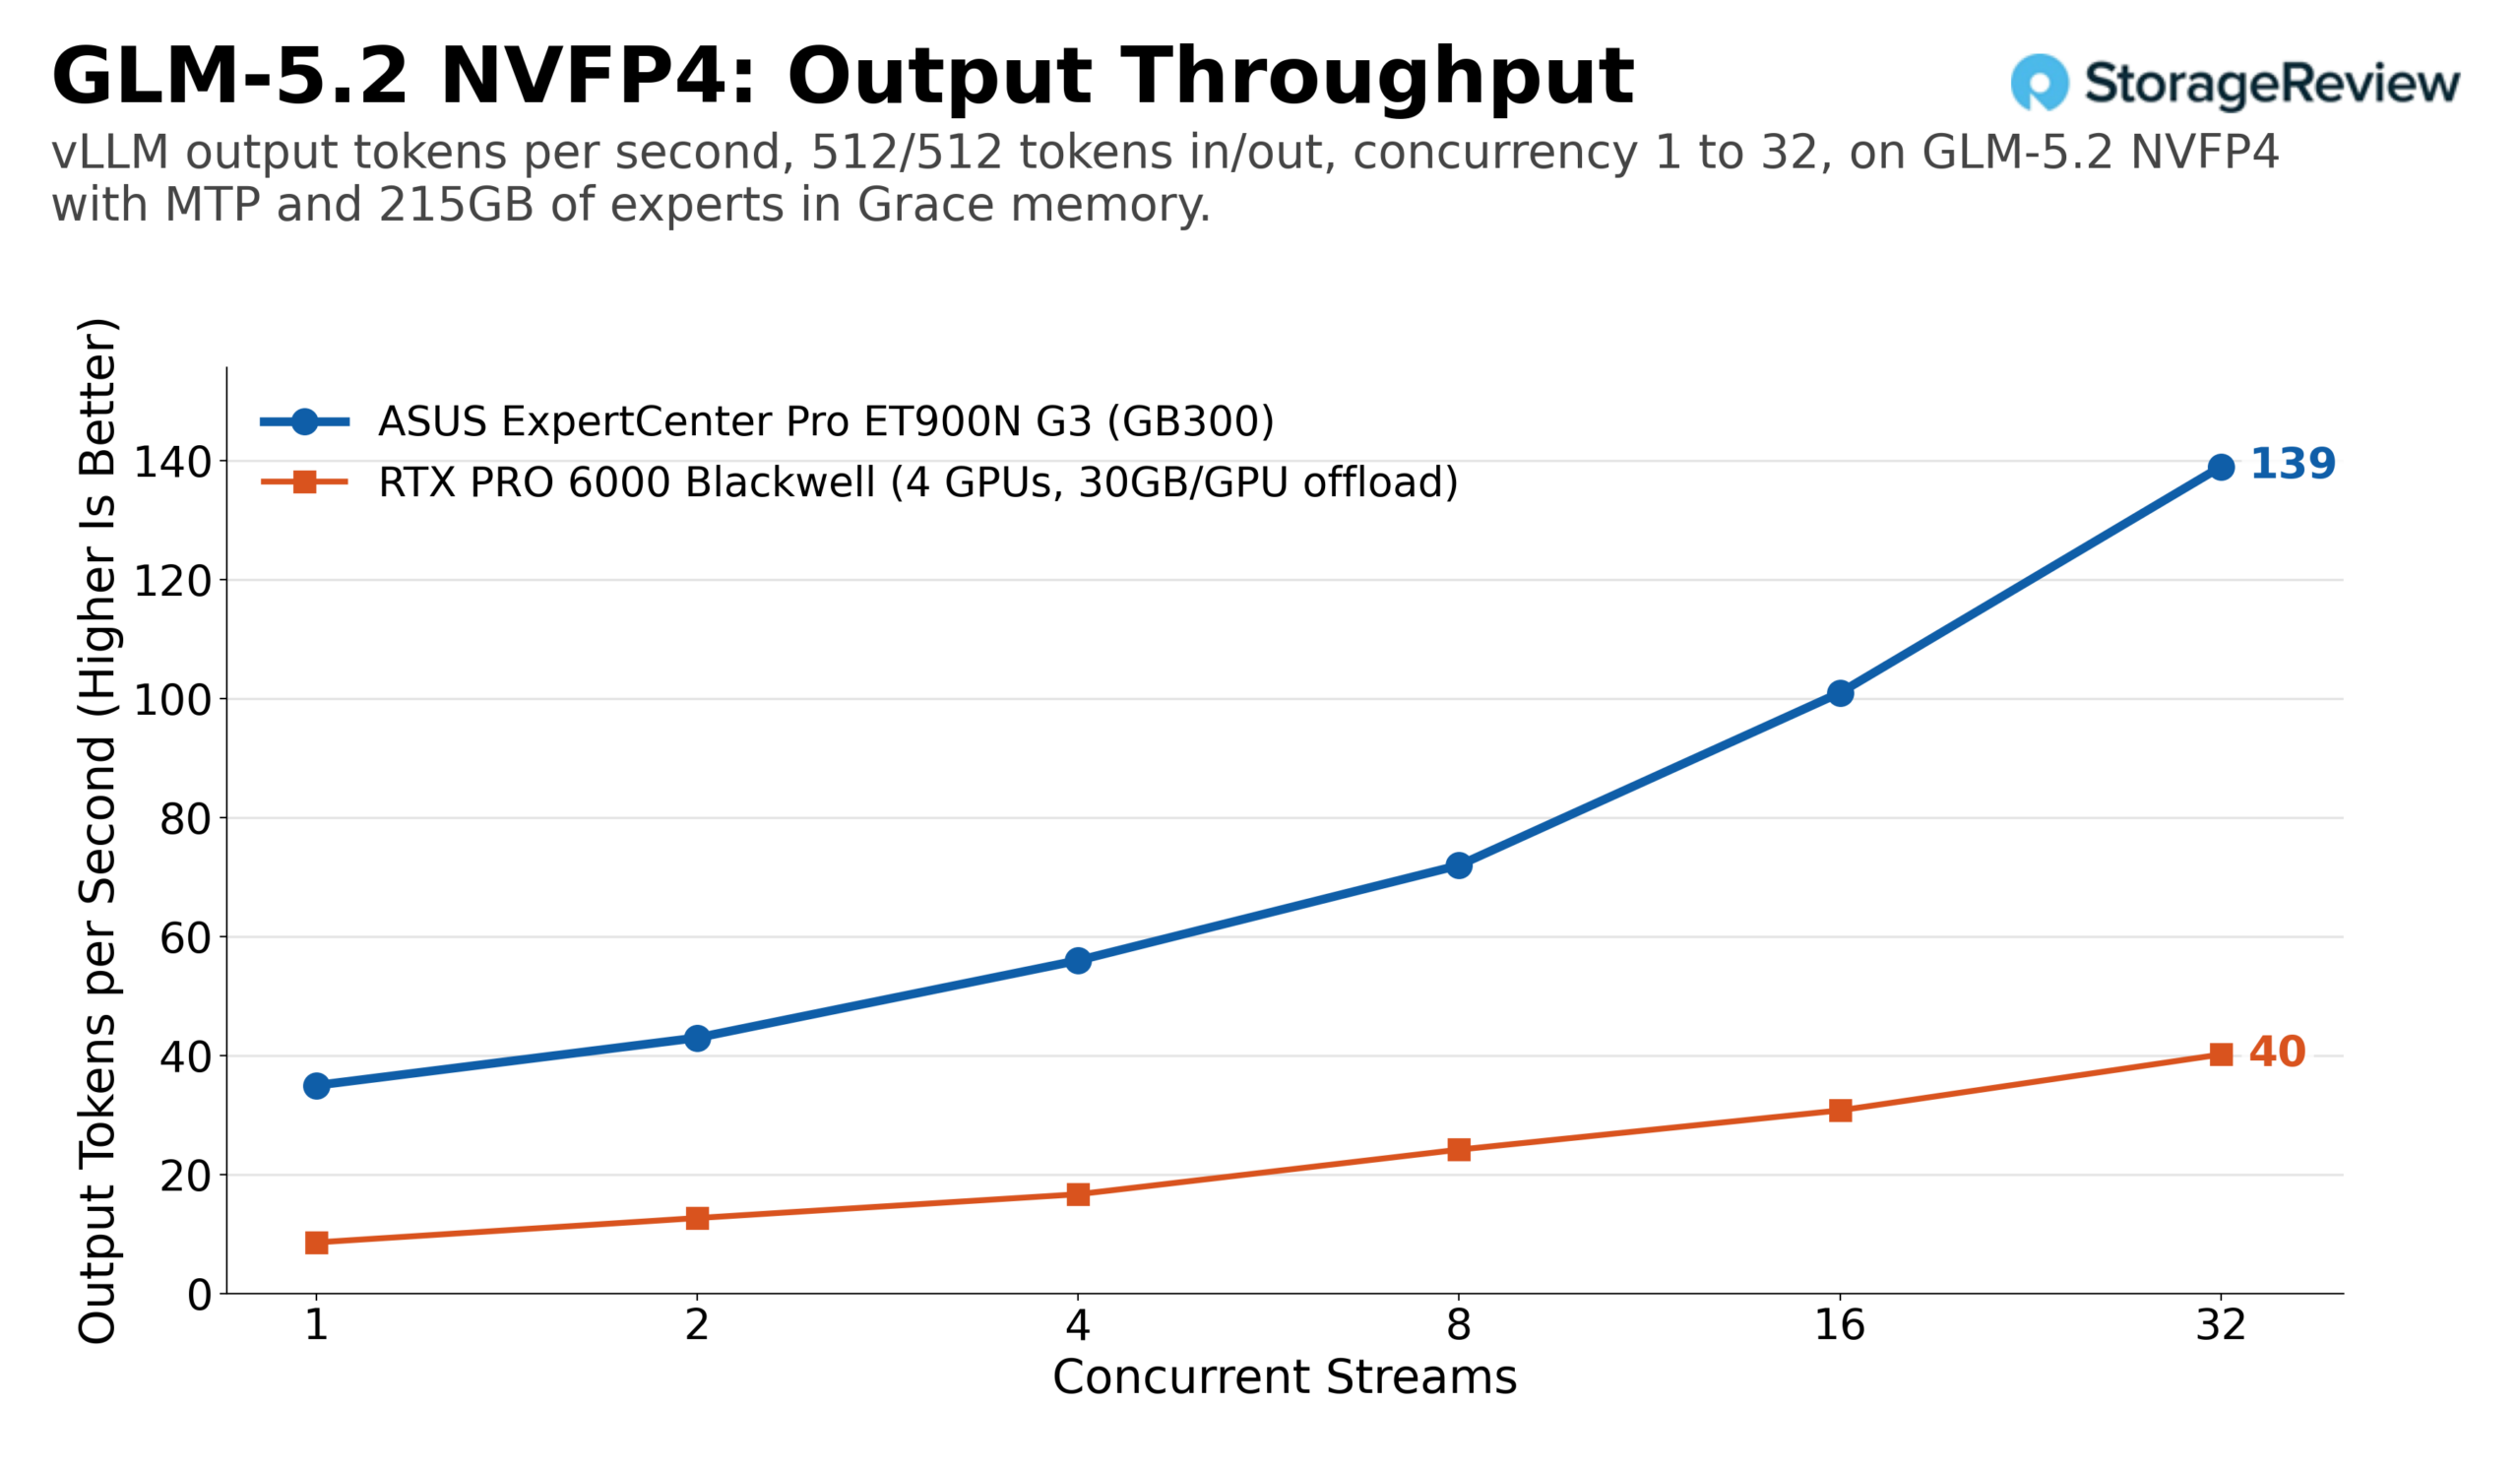
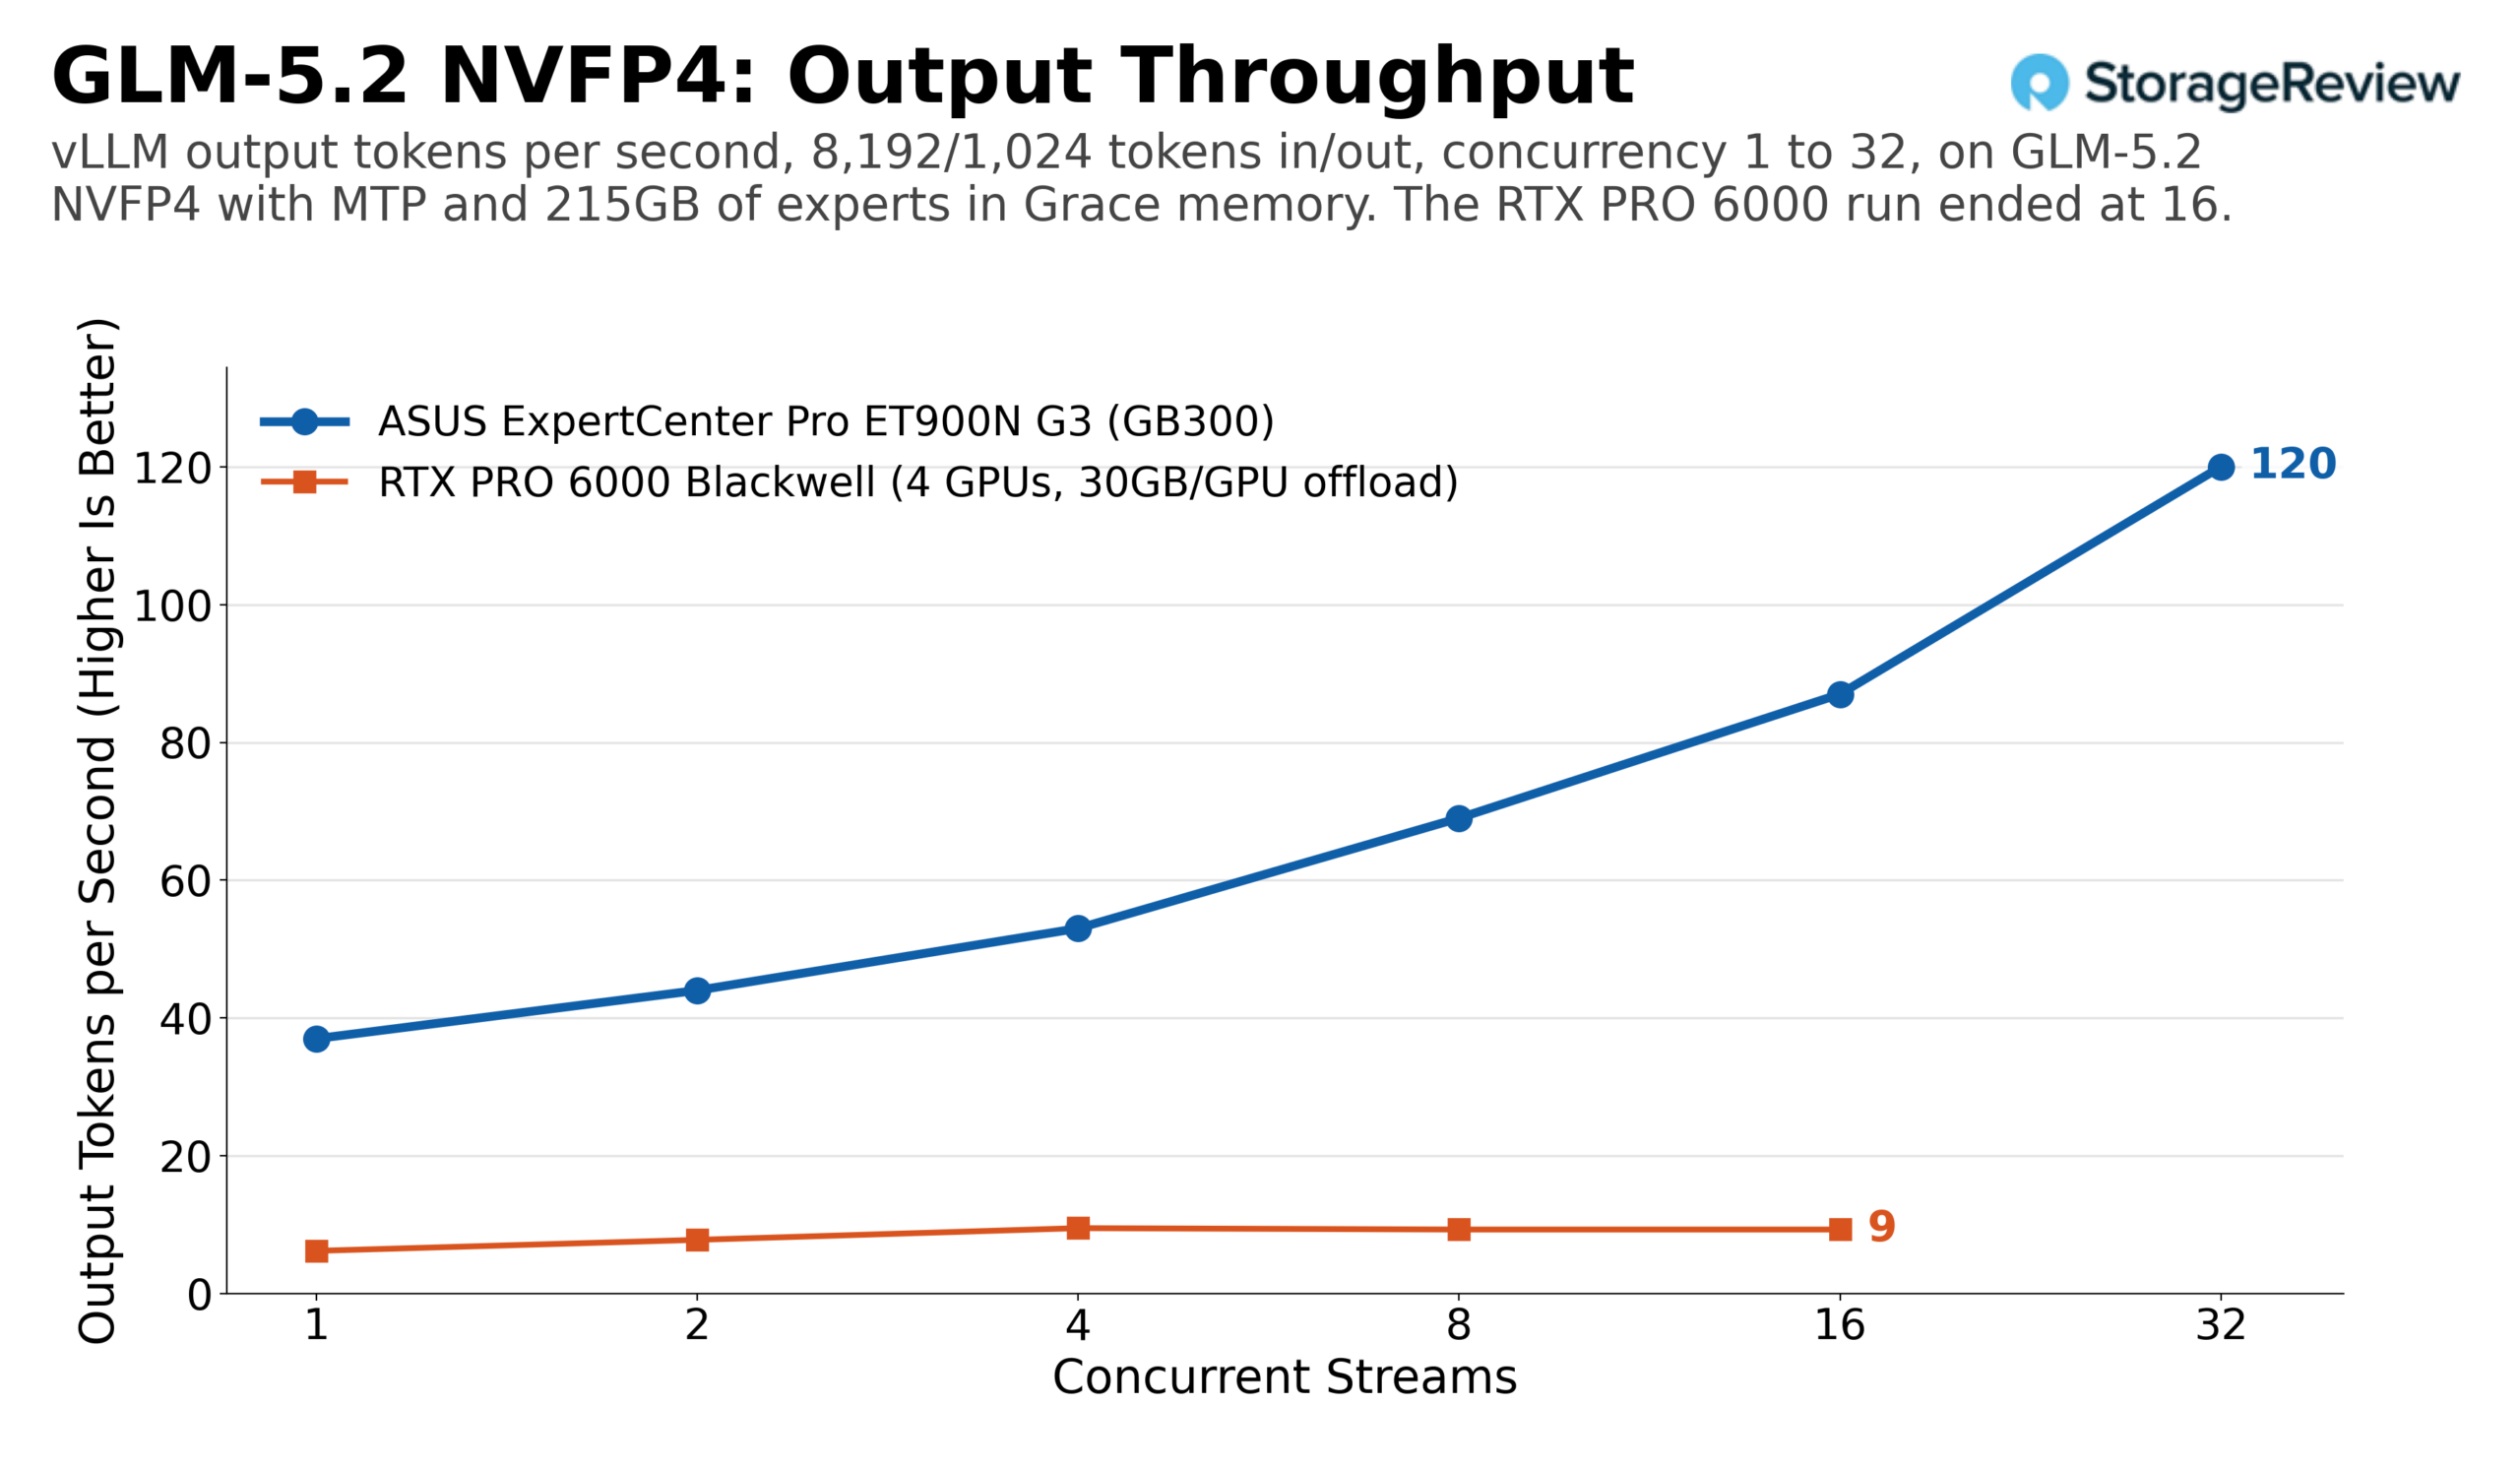
GLM-5.2는 일관성 있는 풀을 통해서만 가능한 사용 사례입니다. NVFP4 체크포인트는 MTP 투기적 디코딩을 사용하여 약 215GB의 전문가 가중치를 Grace 메모리에 저장하며, ET900N G3는 동일한 작업 부하에서 단일 스트림의 경우 초당 35개의 출력 토큰, 32개 스트림의 경우 초당 139개의 출력 토큰을 처리하여 총 처리량이 277에 달했습니다. 사전 채우기 작업이 많은 프로파일에서는 32개 스트림까지 실행하여 초당 120개의 출력 토큰과 총 1,079개의 토큰을 처리했습니다. 각각 약 30GB를 호스트 메모리로 오프로드하는 4개의 RTX PRO 6000 카드는 32개 스트림에서 초당 약 40개의 출력 토큰을 처리했으며, 4개 스트림부터는 긴 프롬프트에서 초당 약 9~10개로 평탄화되었습니다. 두 시스템 모두 433GB 모델을 빠르다고 느끼게 하지는 않지만, GB300의 396GB/s LPDDR5X와 900GB/s NVLink-C2C 경로를 통해 오프로드된 전문가용 메모리는 4개의 카드에 걸쳐 PCIe로 연결된 호스트 메모리가 한계를 넘어서는 확장성을 제공합니다.
MSI WS300과 비교했을 때, ET900N G3의 최첨단 모델 테스트 결과는 비교 가능한 모든 지점에서 약 1% 이내의 차이를 보였습니다. DeepSeek V4 Flash에서 32개 스트림으로 테스트했을 때 두 기기 모두 초당 1,766개의 출력 토큰을 처리했고, MiniMax M2.7에서는 128개 스트림으로 테스트했을 때 4,793개(MSI WS4,801 대비)를, MiniMax M3에서는 32개 스트림으로 테스트했을 때 두 기기 모두 초당 1,041개의 출력 토큰을, GLM-5.2에서는 32개 스트림으로 테스트했을 때 두 기기 모두 초당 139개의 출력 토큰을 처리했습니다.
RTX PRO 6000, H200 NVL 및 DGX Spark에 대한 공통 모델
벤치마킹 후반부에는 모든 시스템에서 처리 가능한 크기의 모델들을 사용했습니다. 사용된 모델은 GPT-OSS-20B 및 120B(네이티브 MXFP4), Llama 3.1 8B(BF16 및 FP8), Mistral Small 24B(BF16 및 FP8), 그리고 Qwen3 Coder 30B(BF16 및 FP8)입니다. WS300 리뷰 이후 새롭게 추가된 항목으로는 NVIDIA의 141GB Hopper 카드인 H200 NVL이 있으며, 이를 통해 한 세대 전의 데이터 센터용 가속기를 비교 대상으로 삼았습니다.
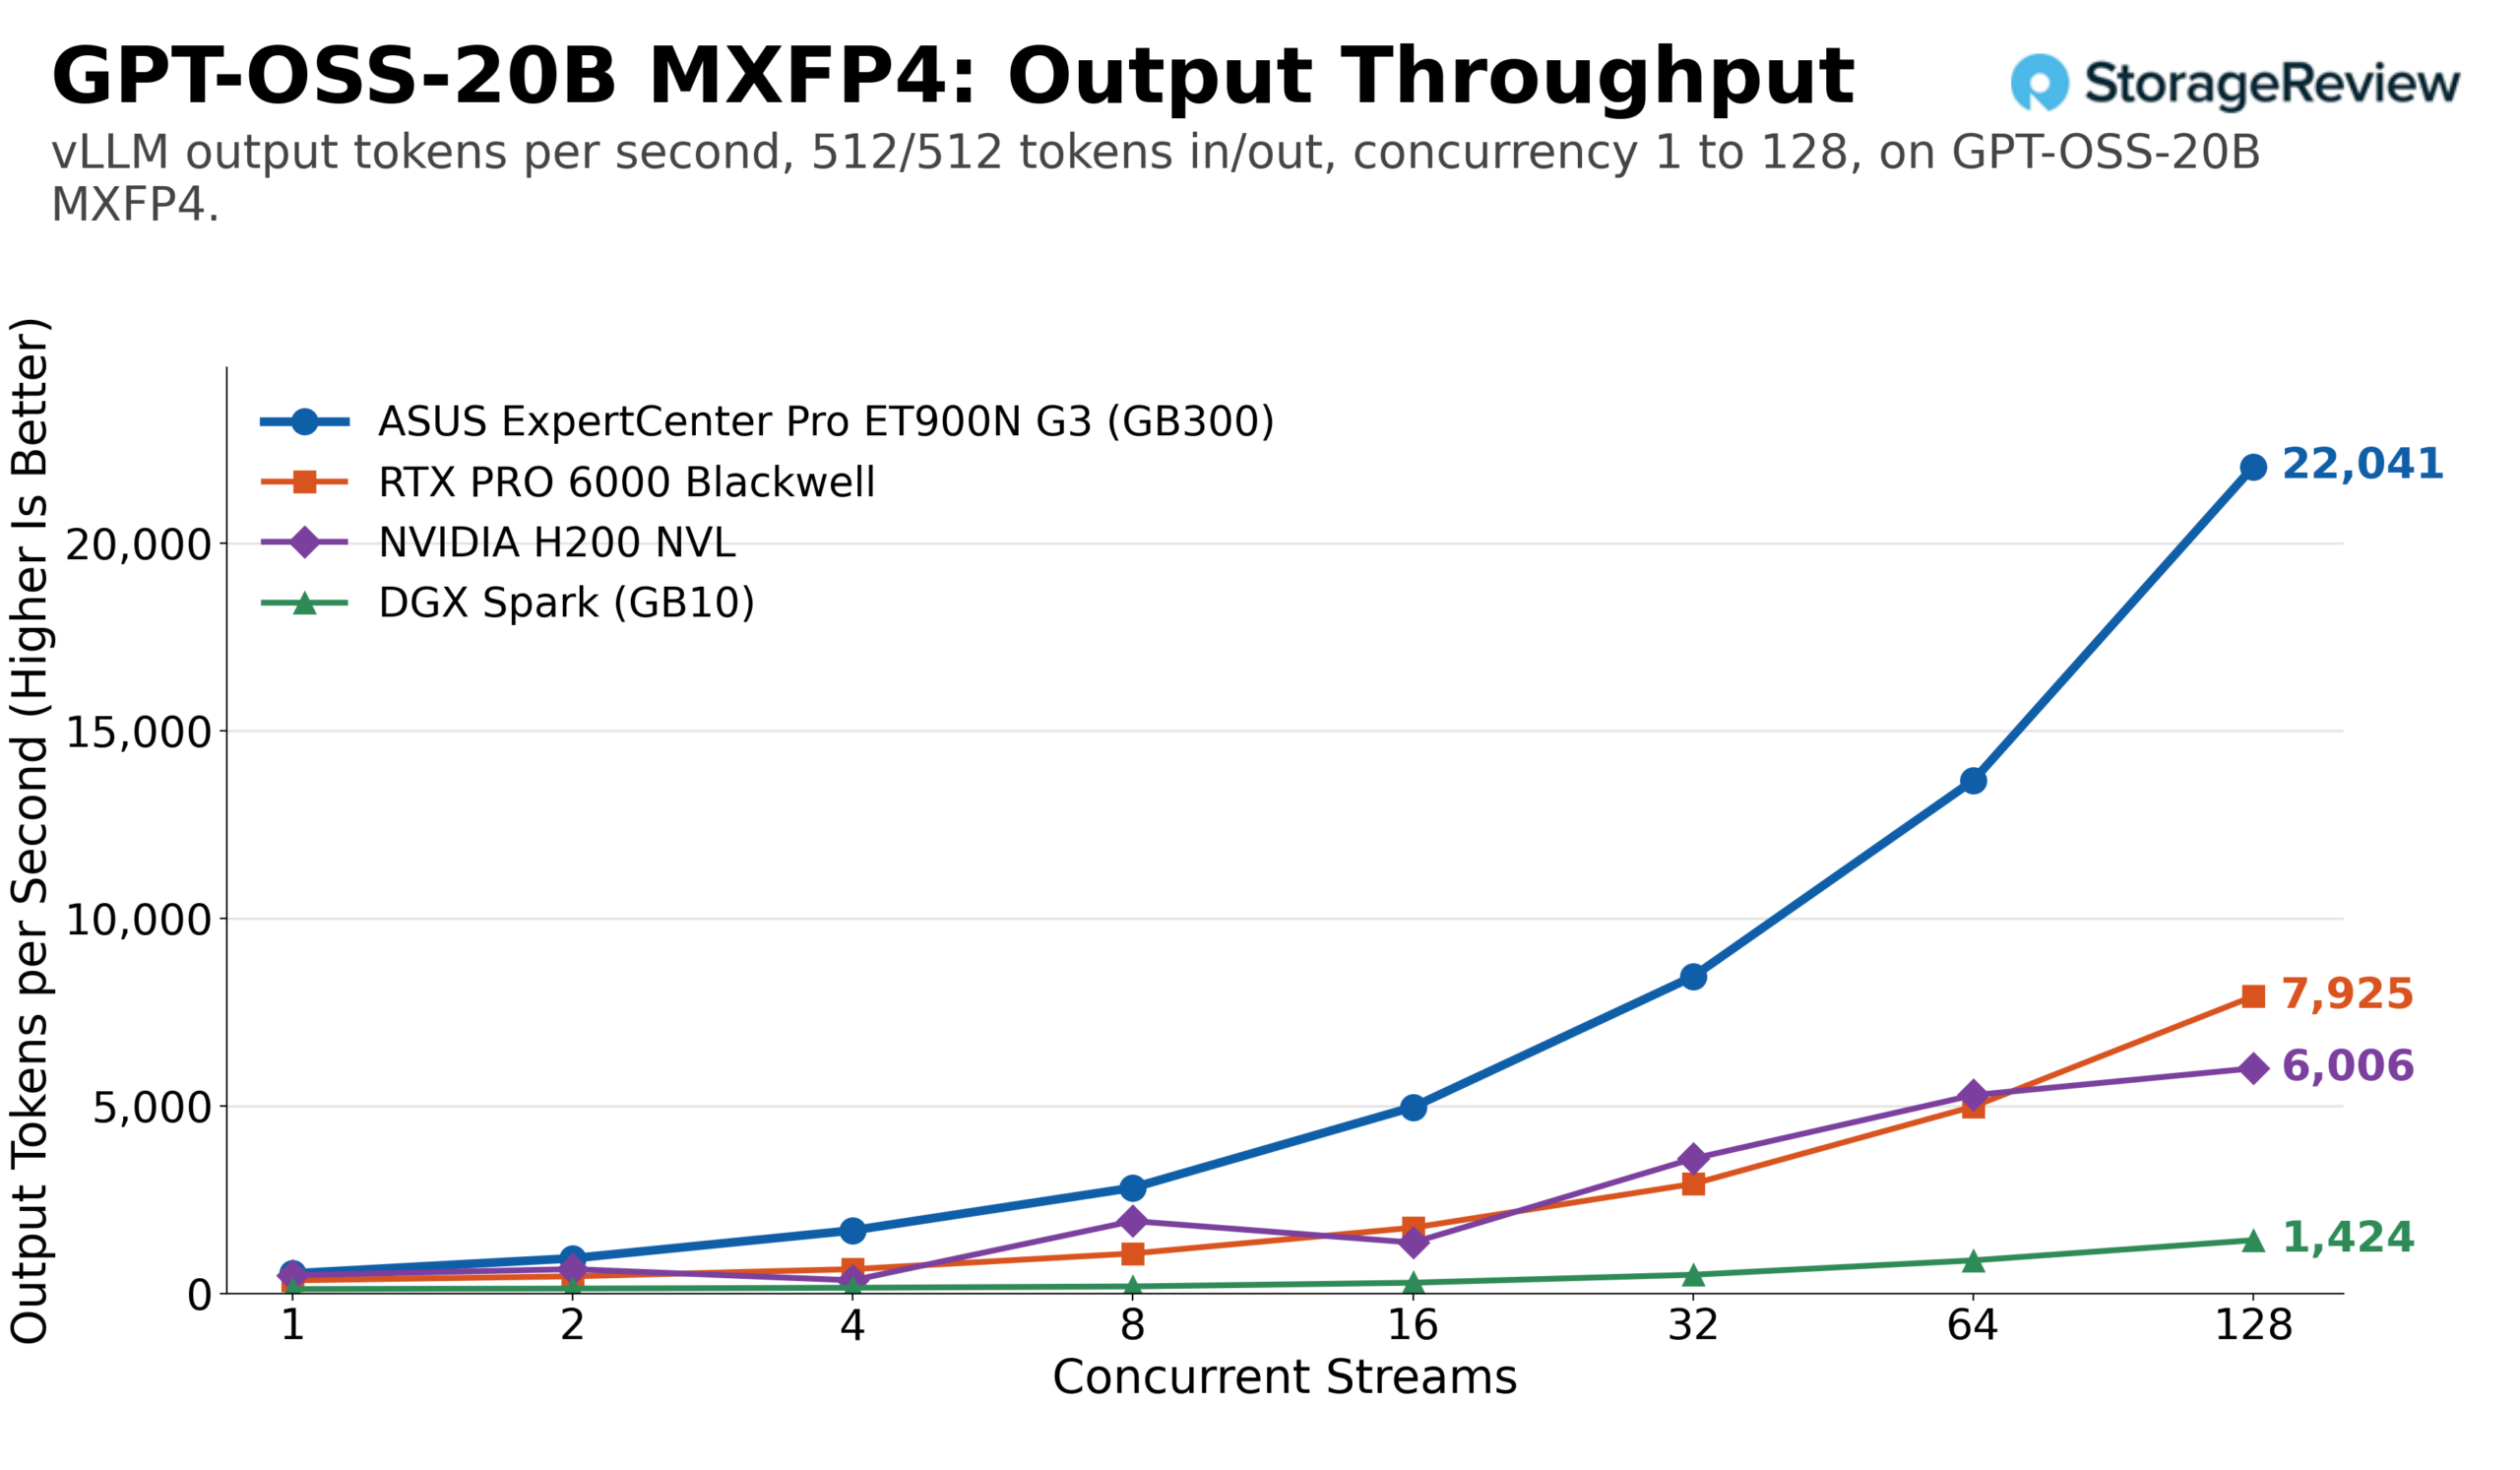
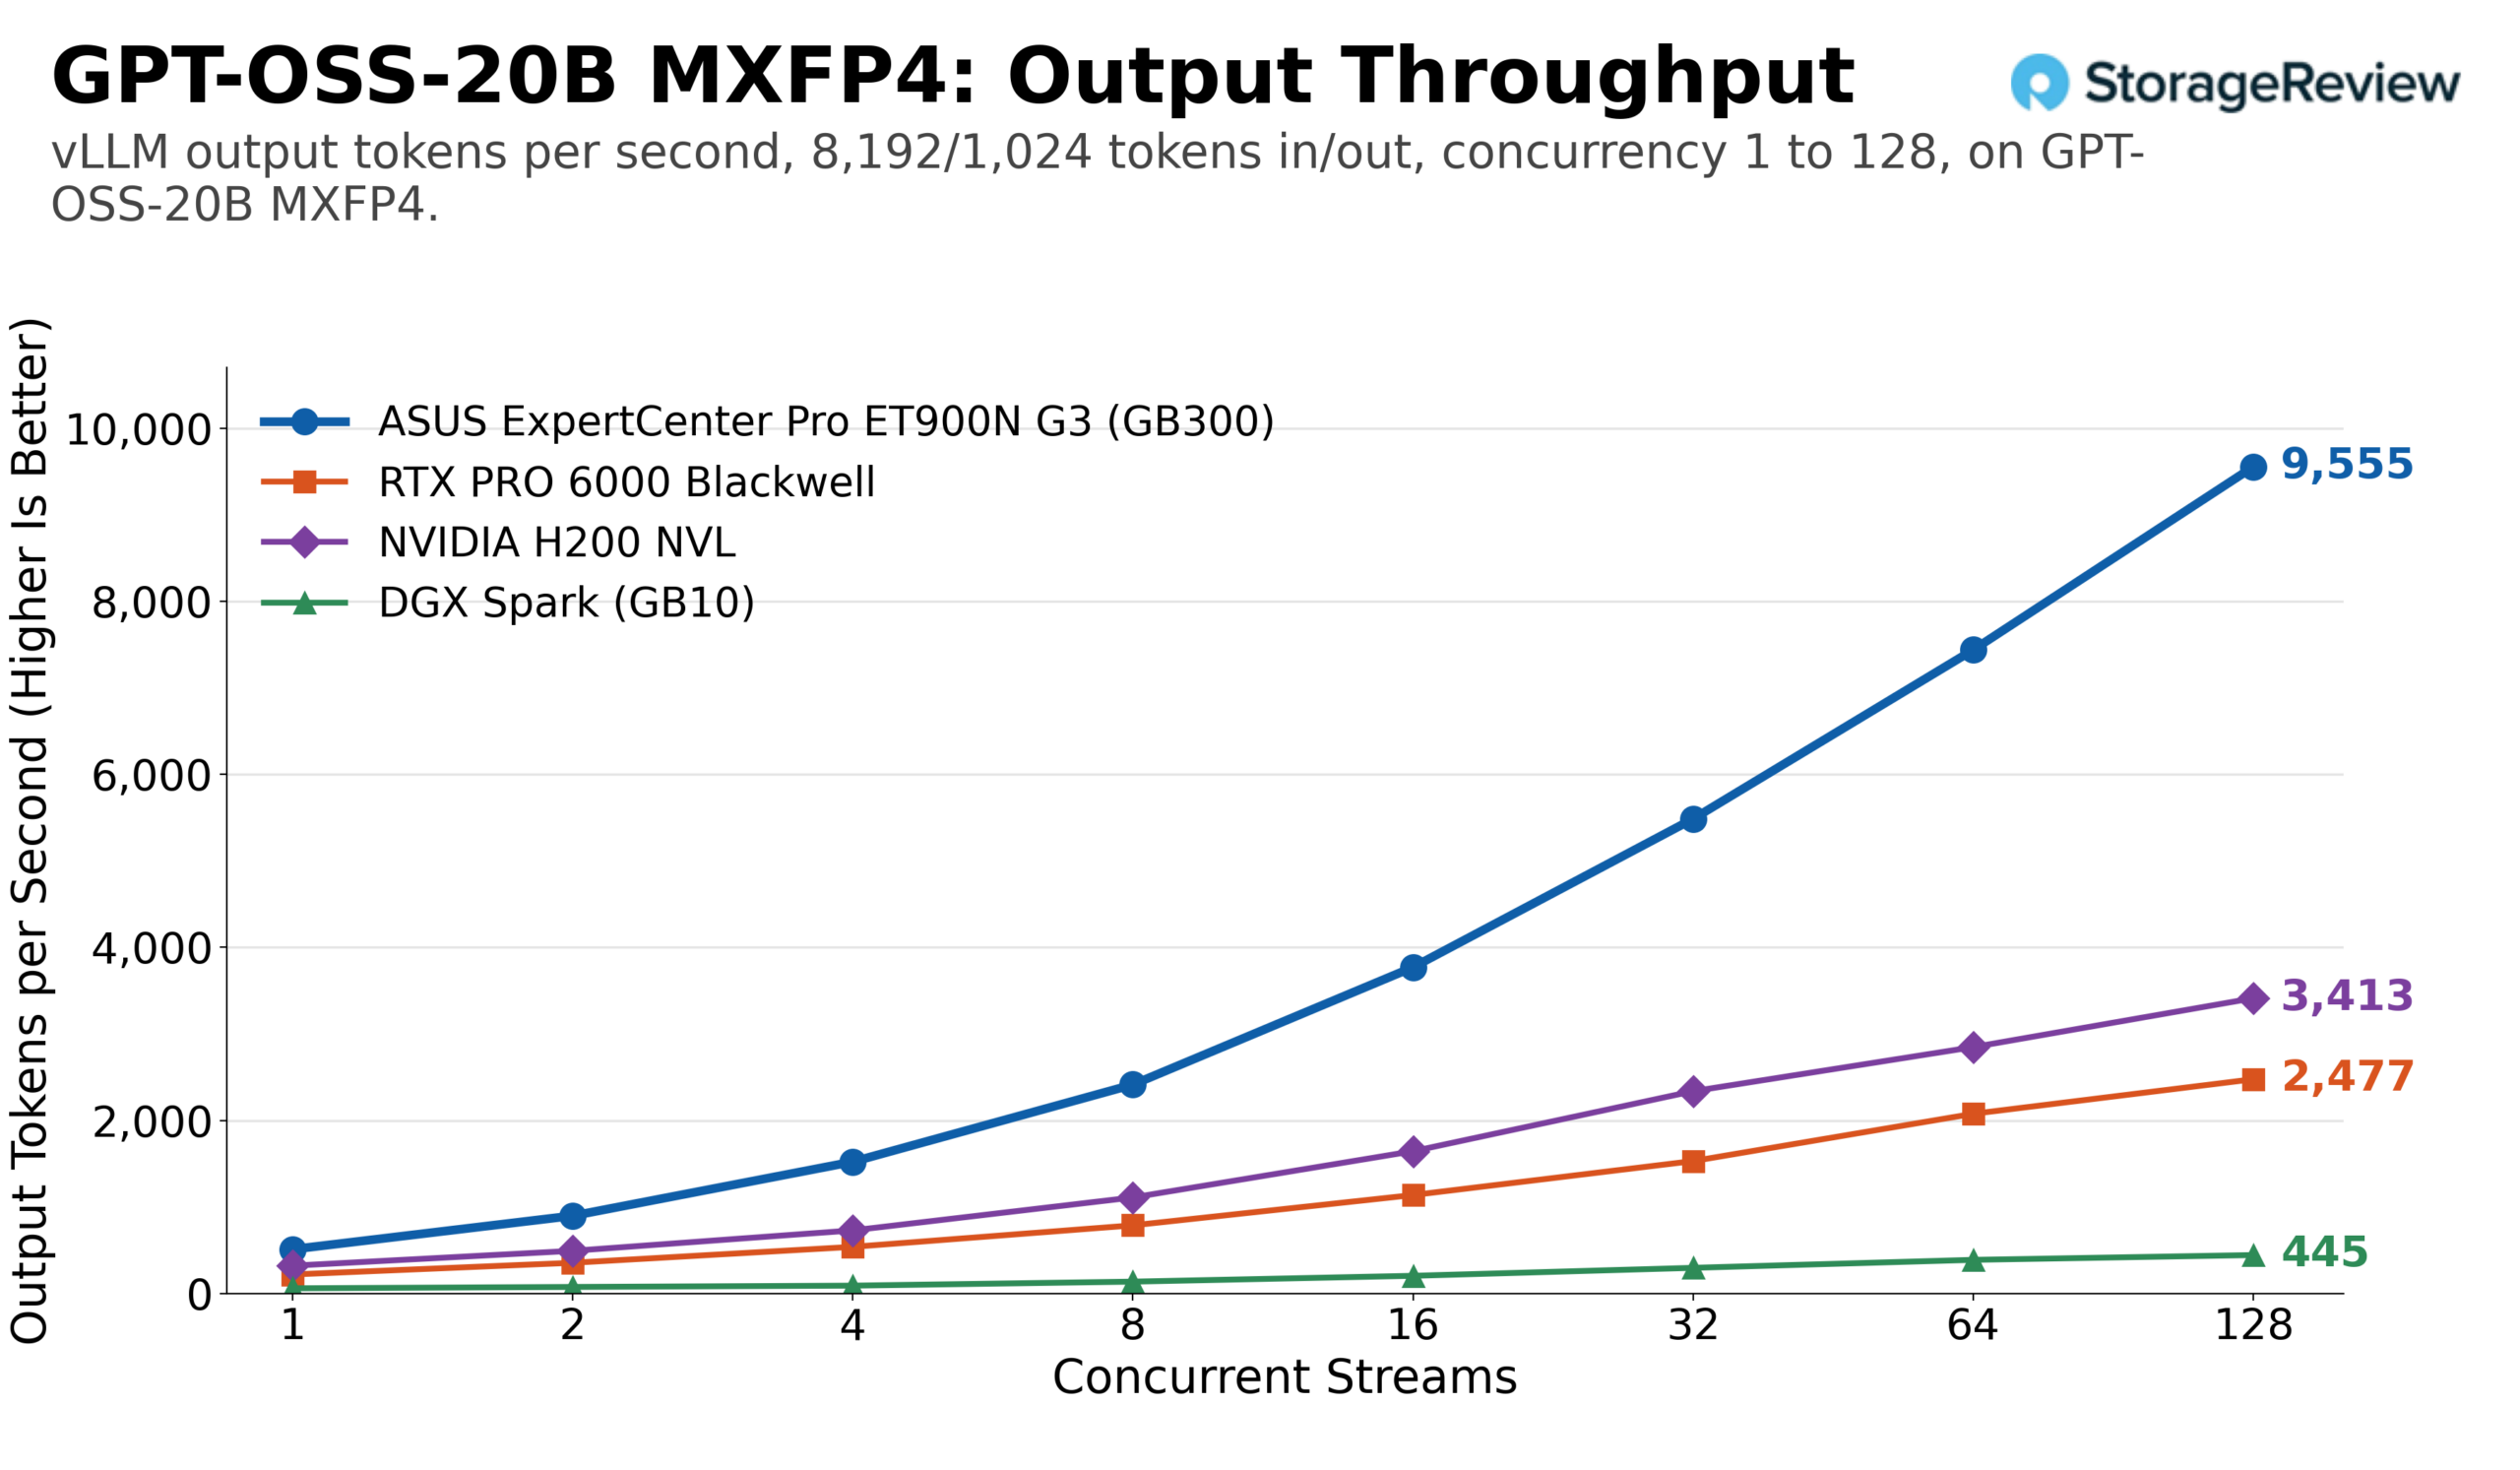
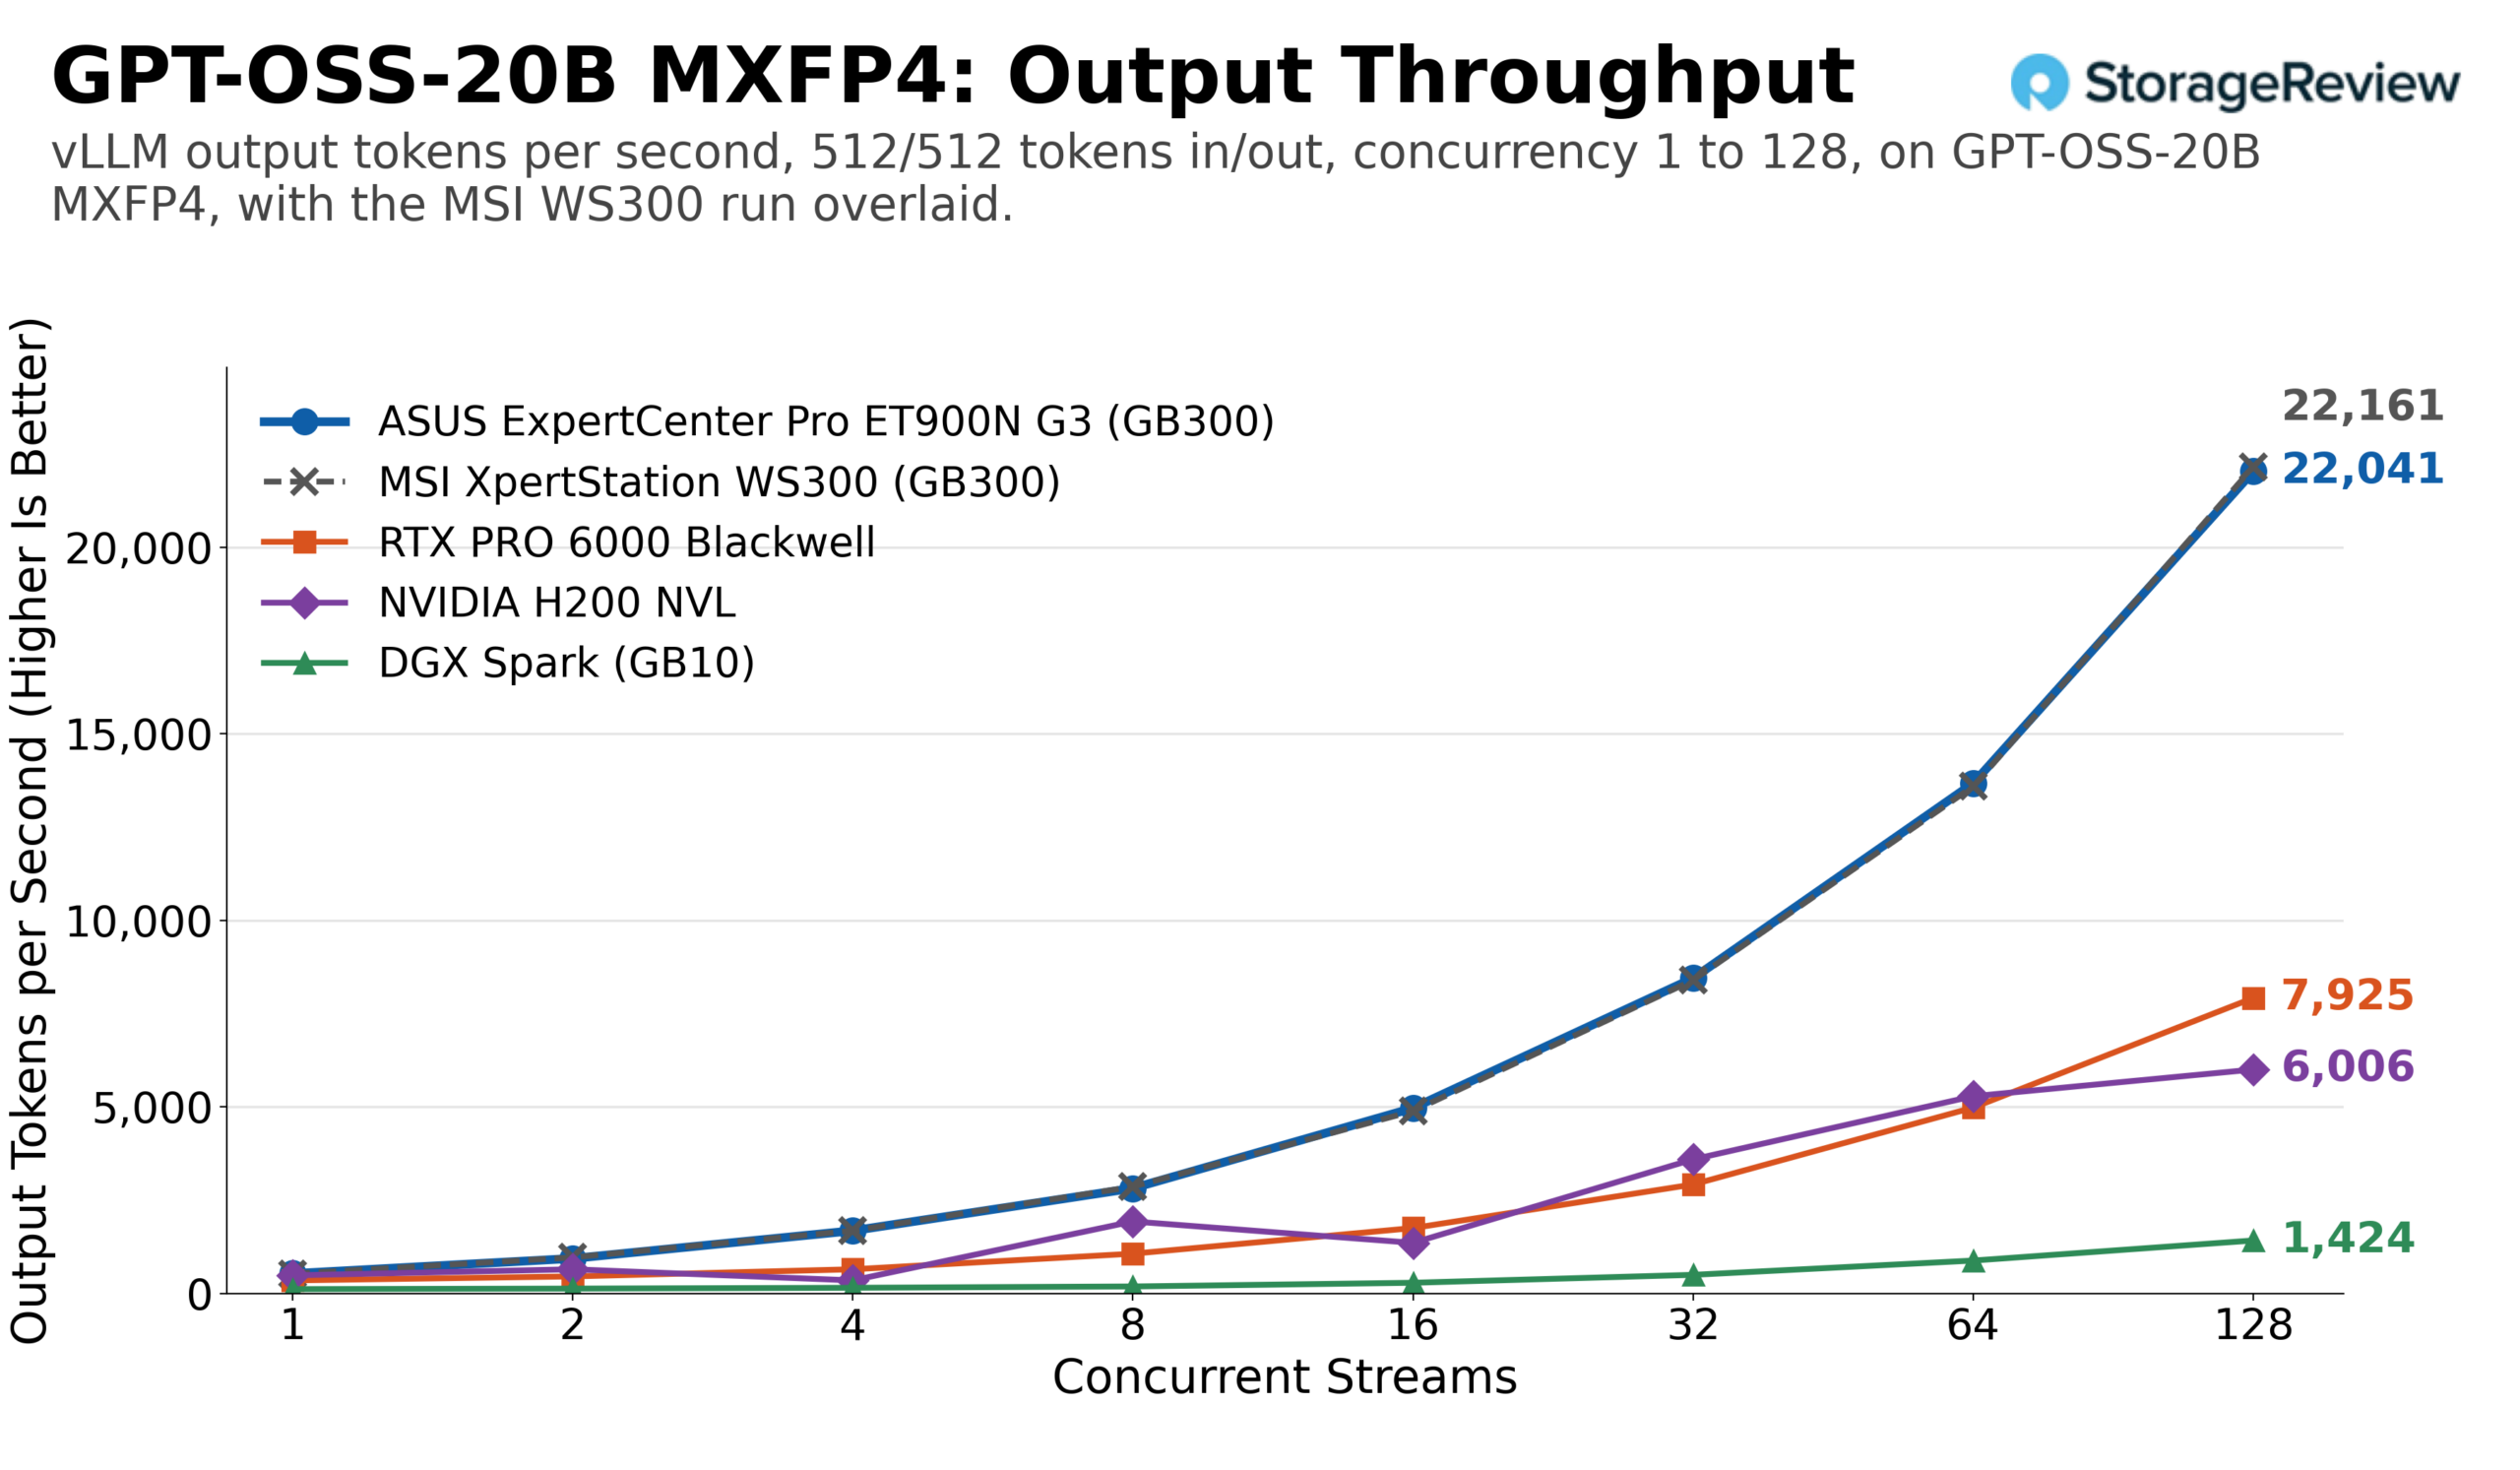
GPT-OSS-20B는 테스트 세트 중 가장 다루기 쉬운 테스트로, 모든 시스템이 무리 없이 통과하는 체크포인트입니다. 동일한 작업 부하에서 ET900N G3는 128개 스트림에서 초당 22,041개의 출력 토큰, 총 44,082개의 토큰을 처리했으며, RTX PRO 6000은 약 7,920개, H200 NVL은 6,010개, DGX Spark는 1,420개를 처리했습니다. 싱글 스트림 모드에서 Station은 초당 536개의 출력 토큰을 생성했는데, 이는 그래픽 카드의 354개, H200의 489개, Spark의 120개보다 높은 수치입니다. 프리필 사용량이 많은 프로파일에서는 격차가 더욱 벌어졌습니다. 128개 스트림에서 Station은 초당 9,555개의 출력 토큰과 총 85,994개의 토큰을 생성했고, RTX PRO 6000은 약 2,480개, H200 NVL은 3,410개, Spark는 445개를 기록했습니다.
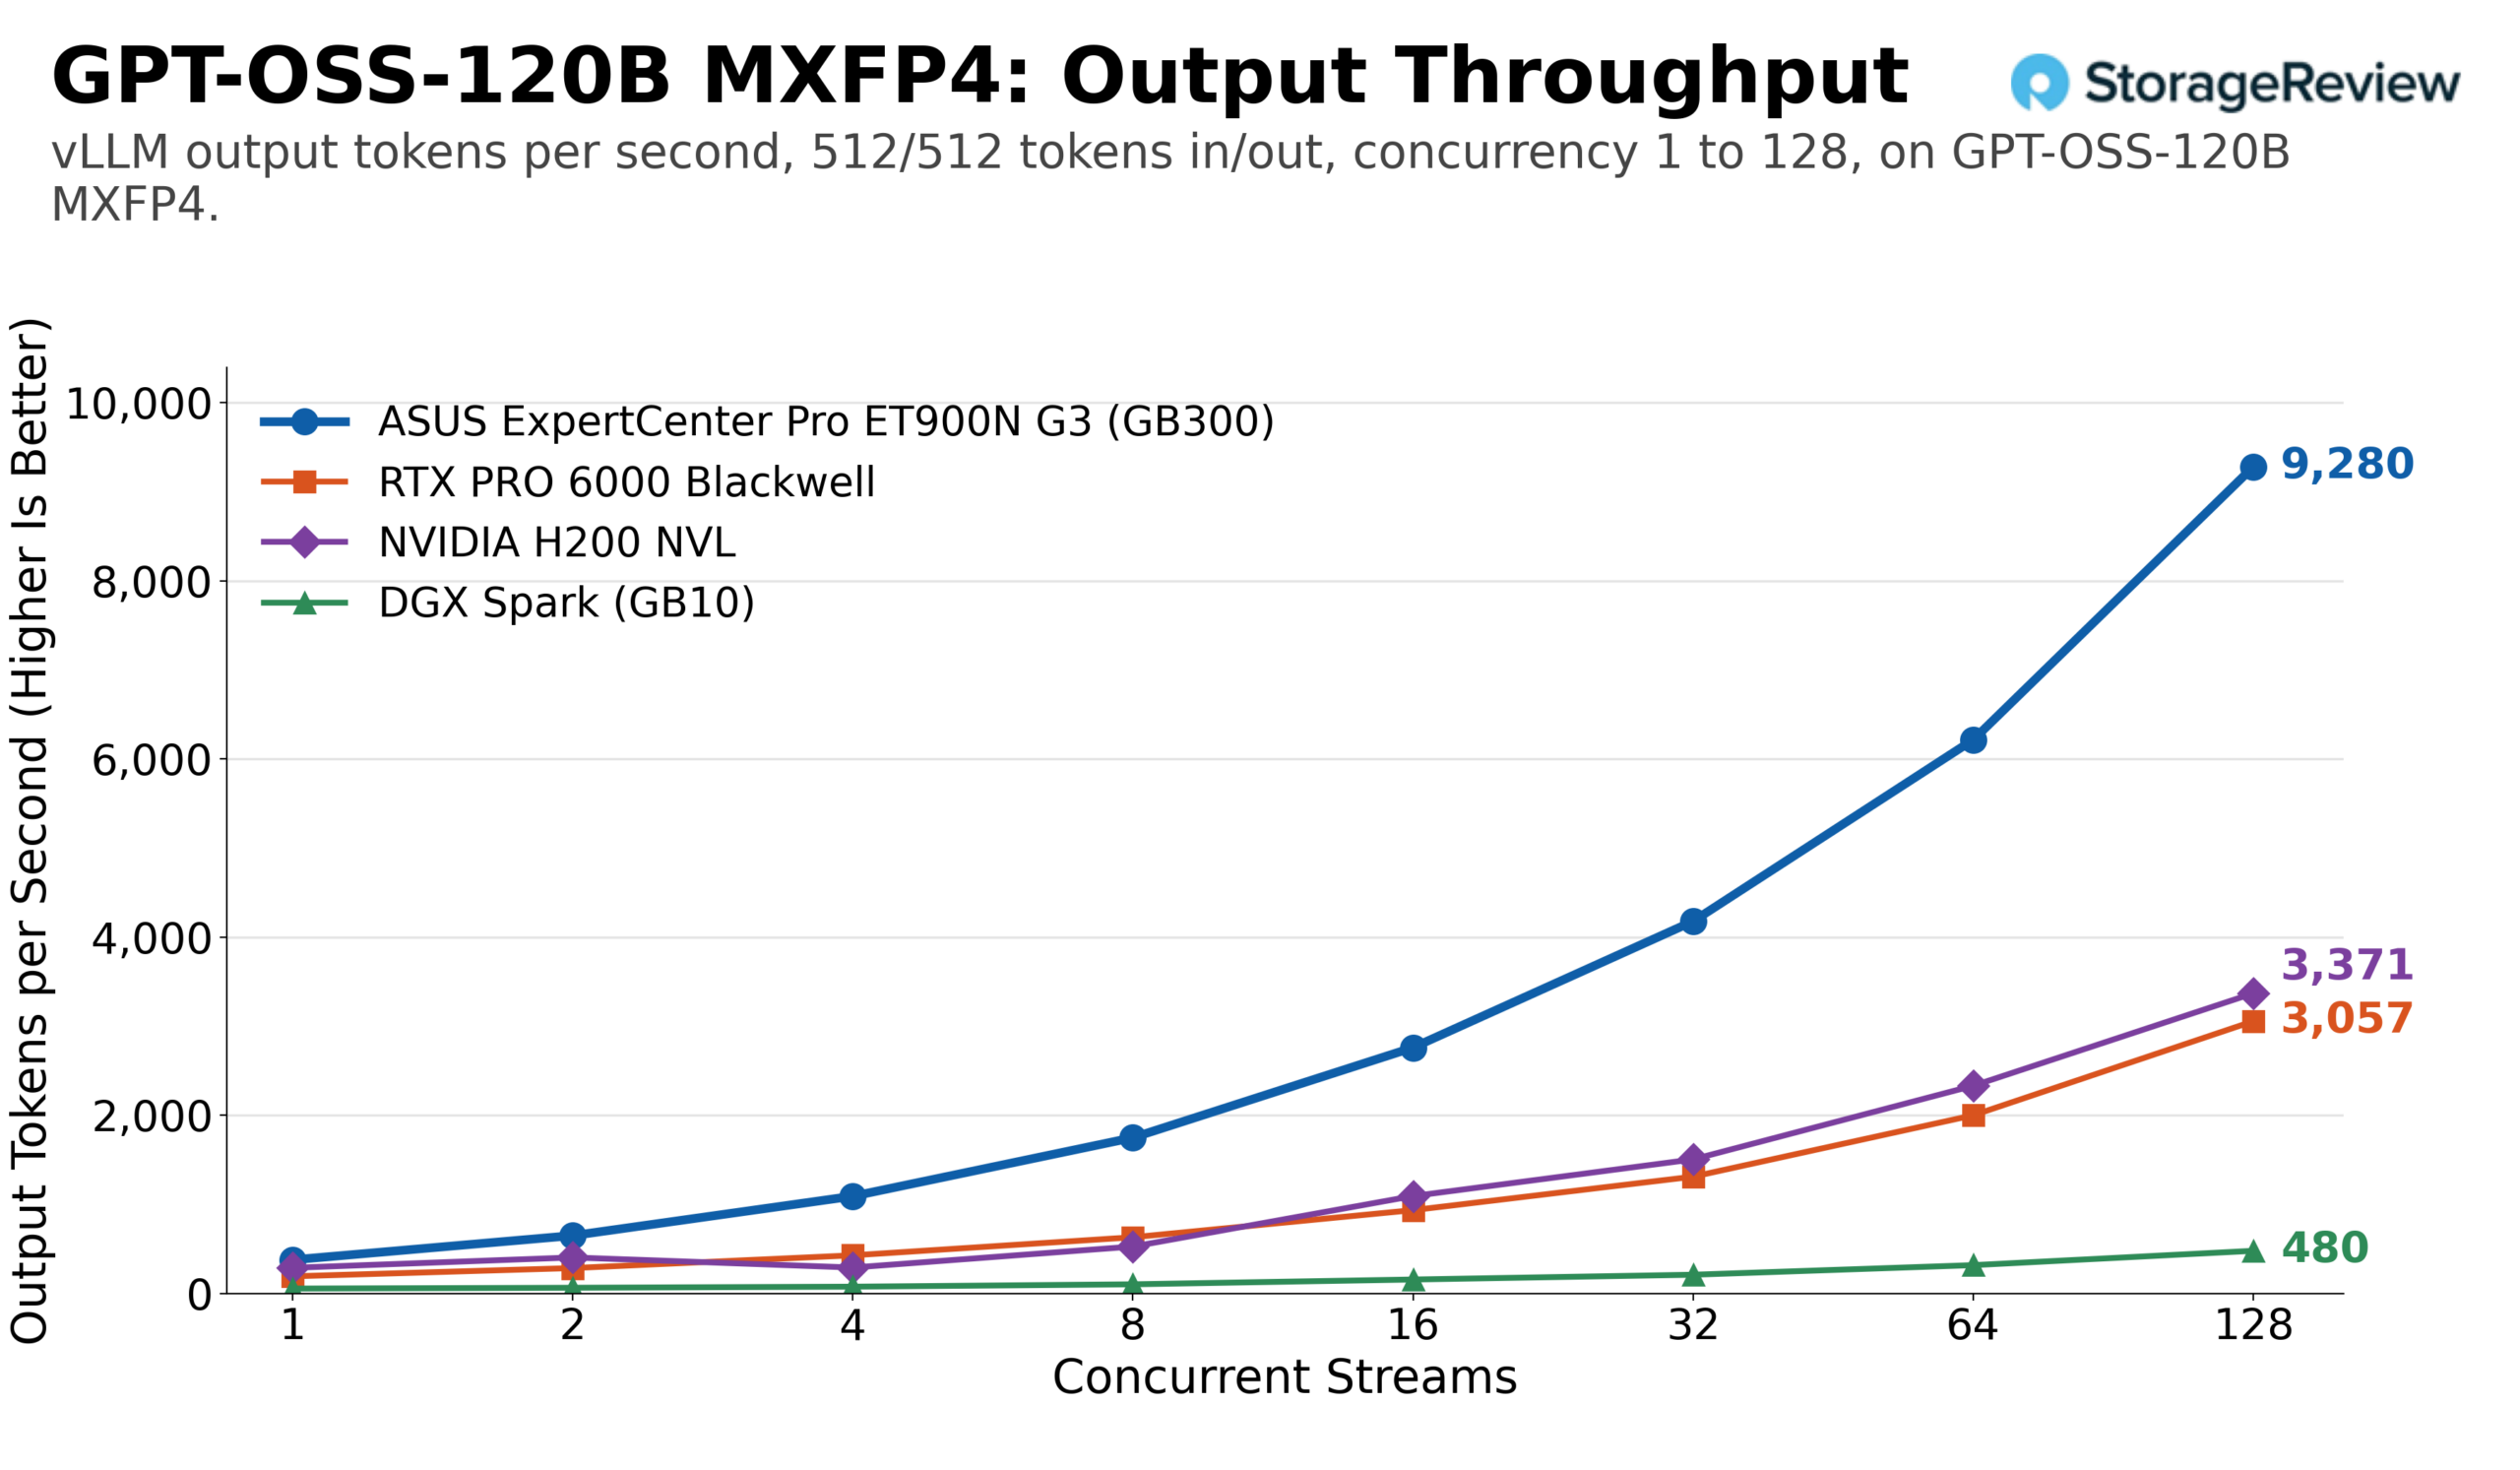
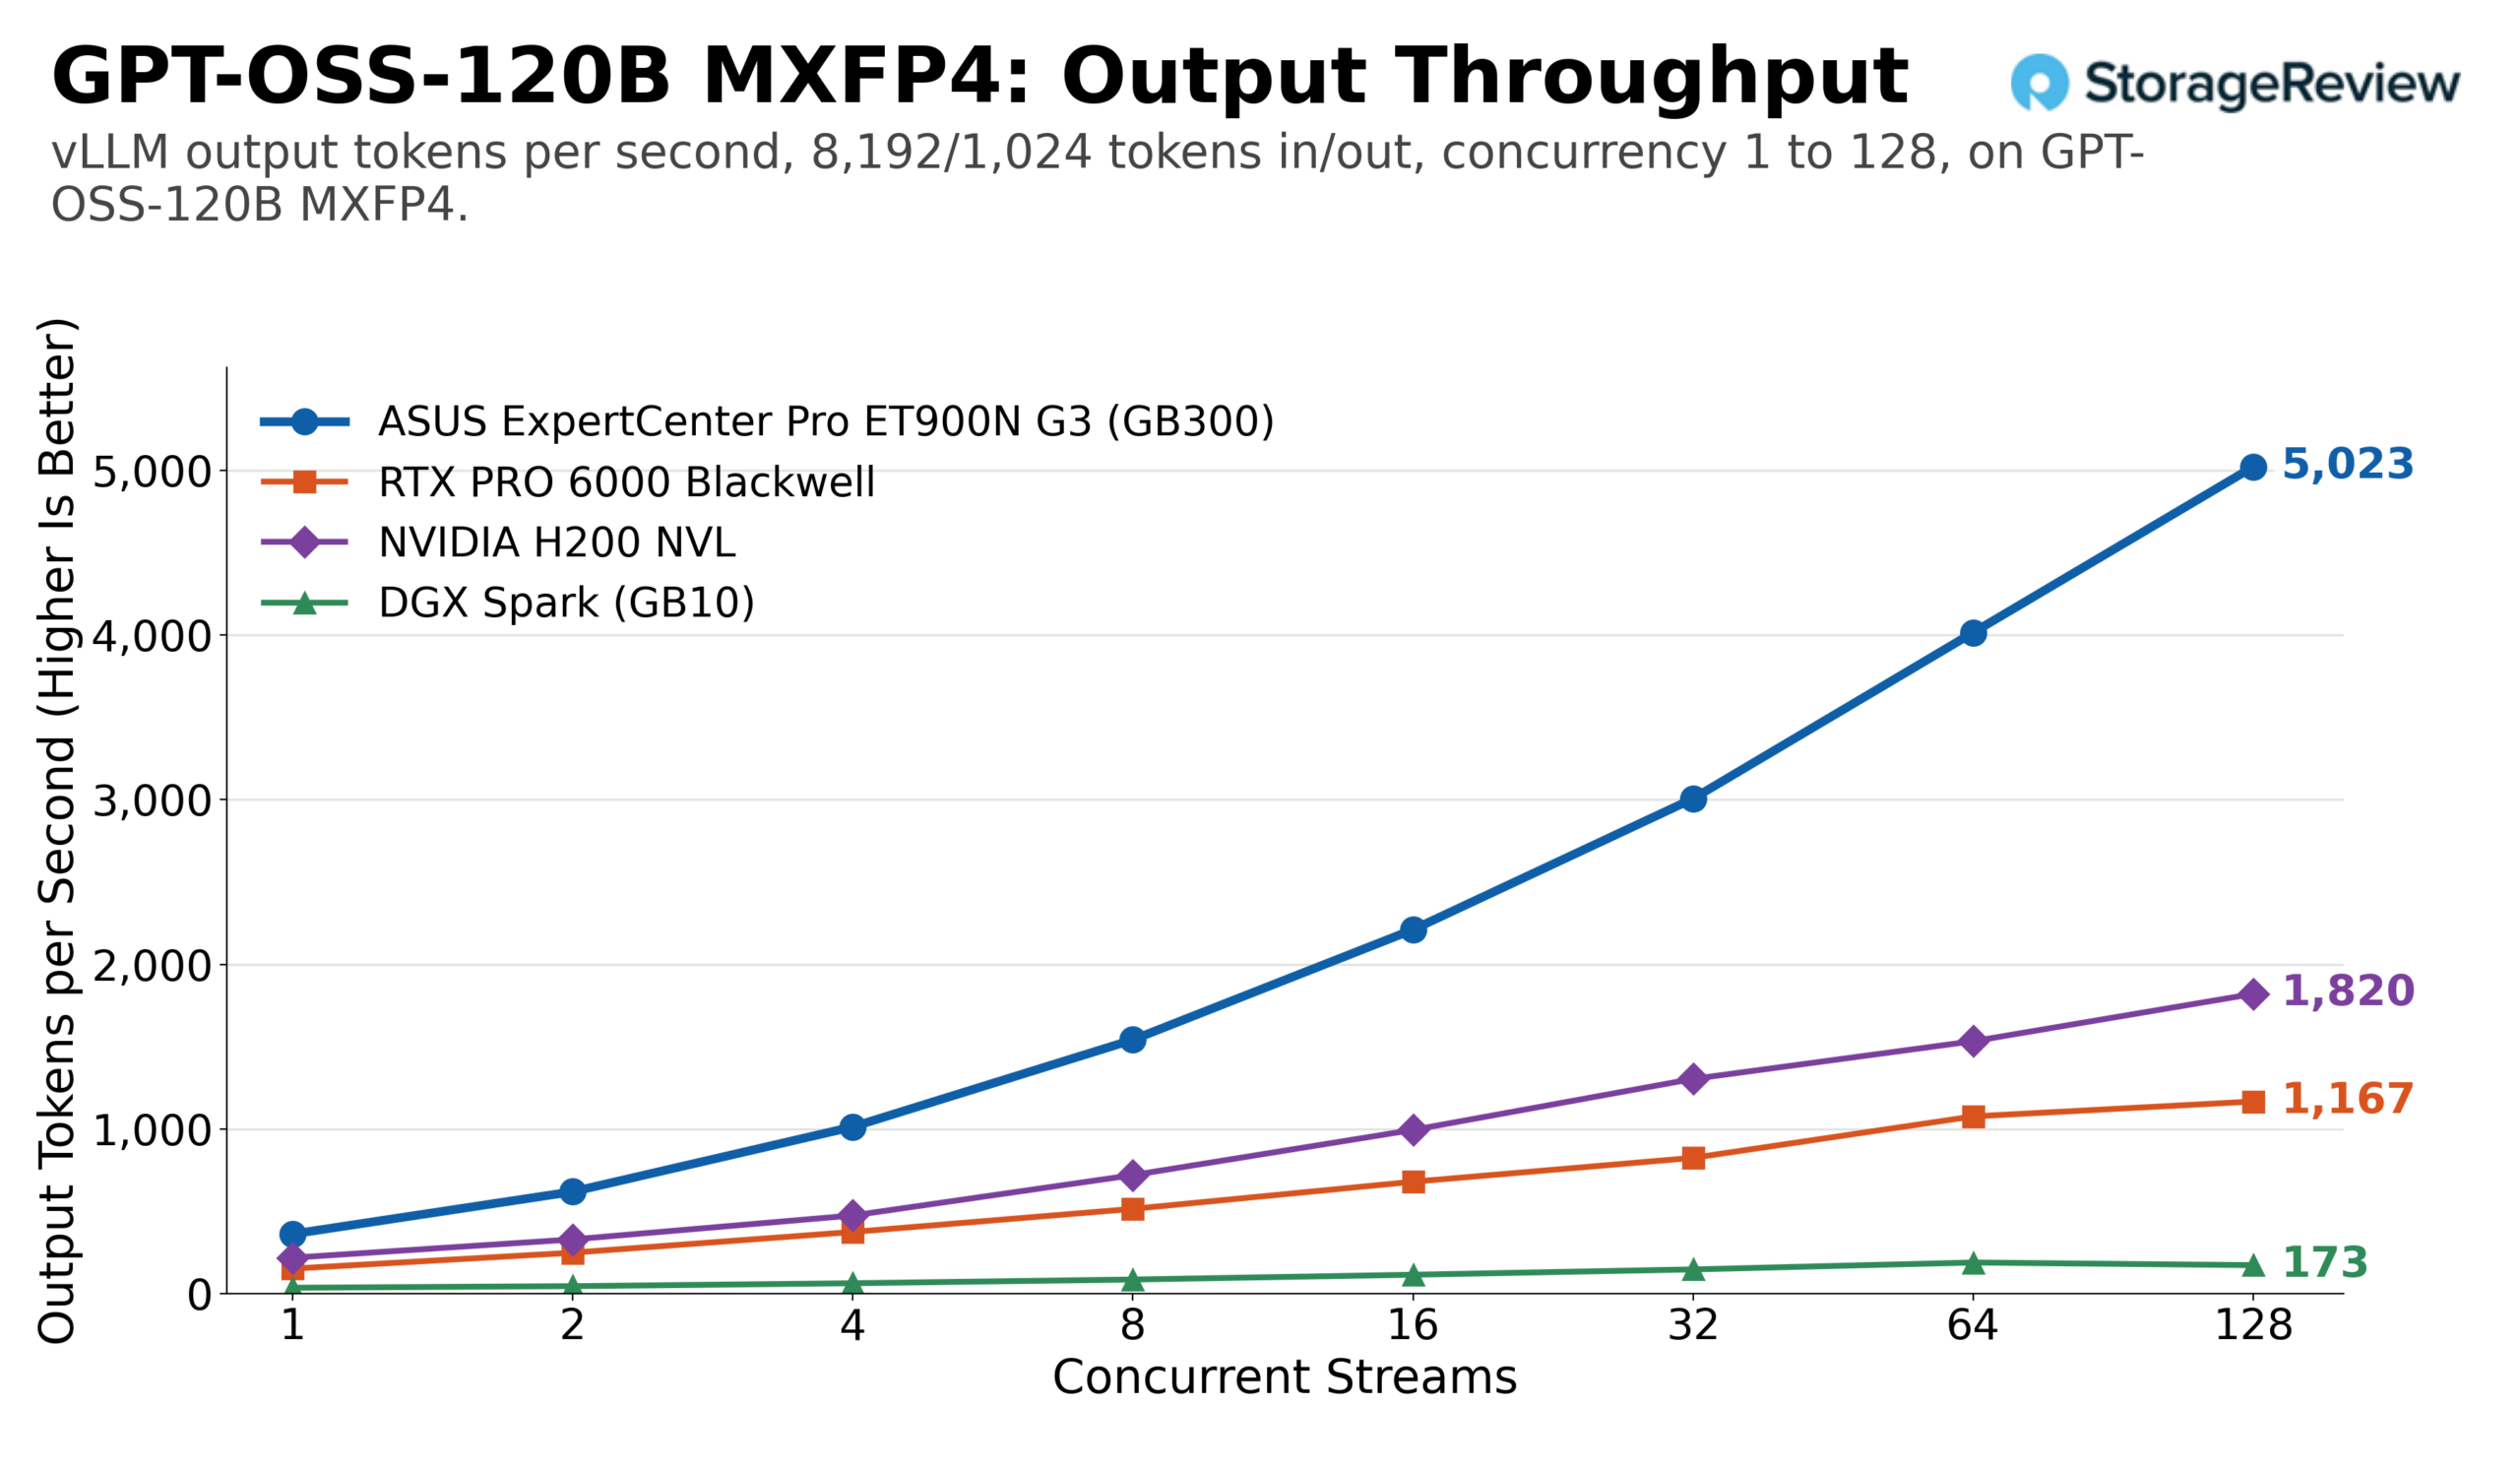
GPT-OSS-120B는 메모리 성능이 중요한 역할을 하는 부분입니다. ET900N G3는 동일한 워크로드에서 128개의 스트림을 사용하여 초당 9,280개의 출력 토큰을 처리했는데, 이는 RTX PRO 6000의 3,060개보다 약 3배, H200 NVL의 3,370개보다 2.8배, Spark의 480개보다 19배 이상 높은 수치입니다. 긴 프롬프트 처리 시에는 소형 시스템들이 KV 캐시 여유 공간이 부족해지는 현상이 나타났습니다. RTX PRO 6000은 초당 약 1,170개의 출력 토큰에서, H200 NVL은 거의 1,820개에서 최고치를 기록한 반면, Station은 128개의 스트림에서 계속 증가하다가 5,023개로 마무리되었으며, 총 처리량은 초당 45,205개의 토큰이었습니다.
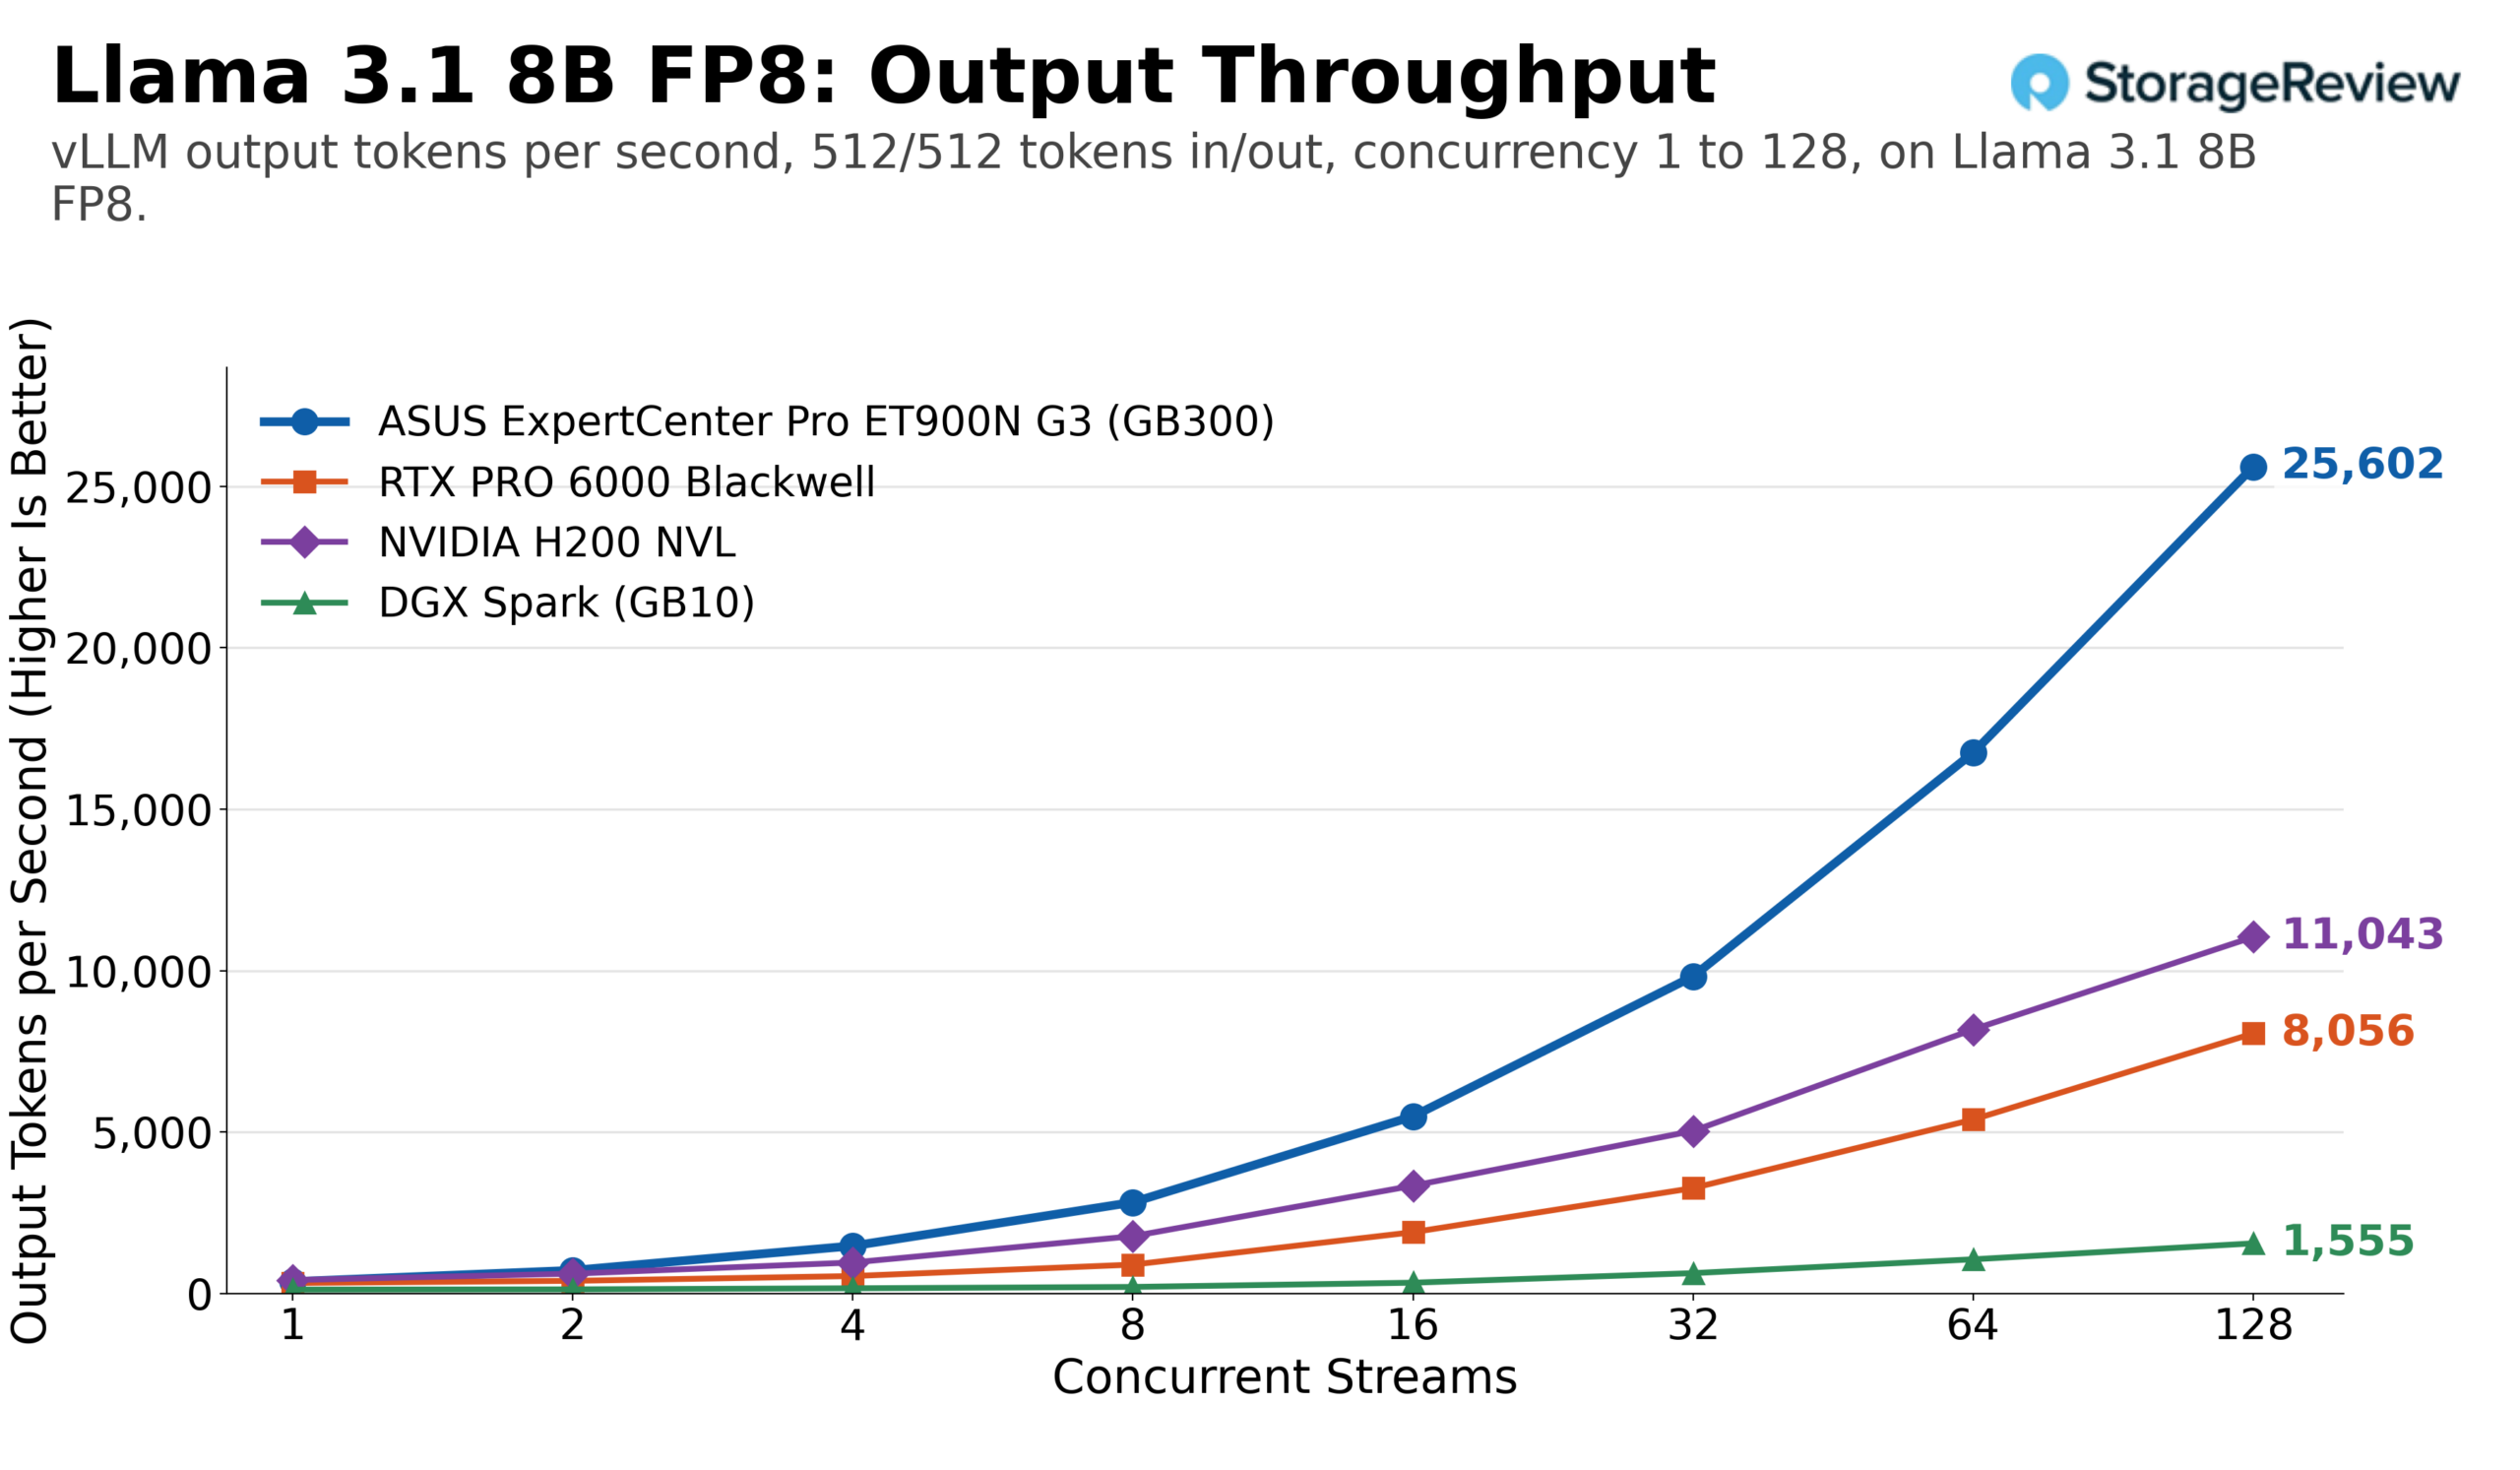
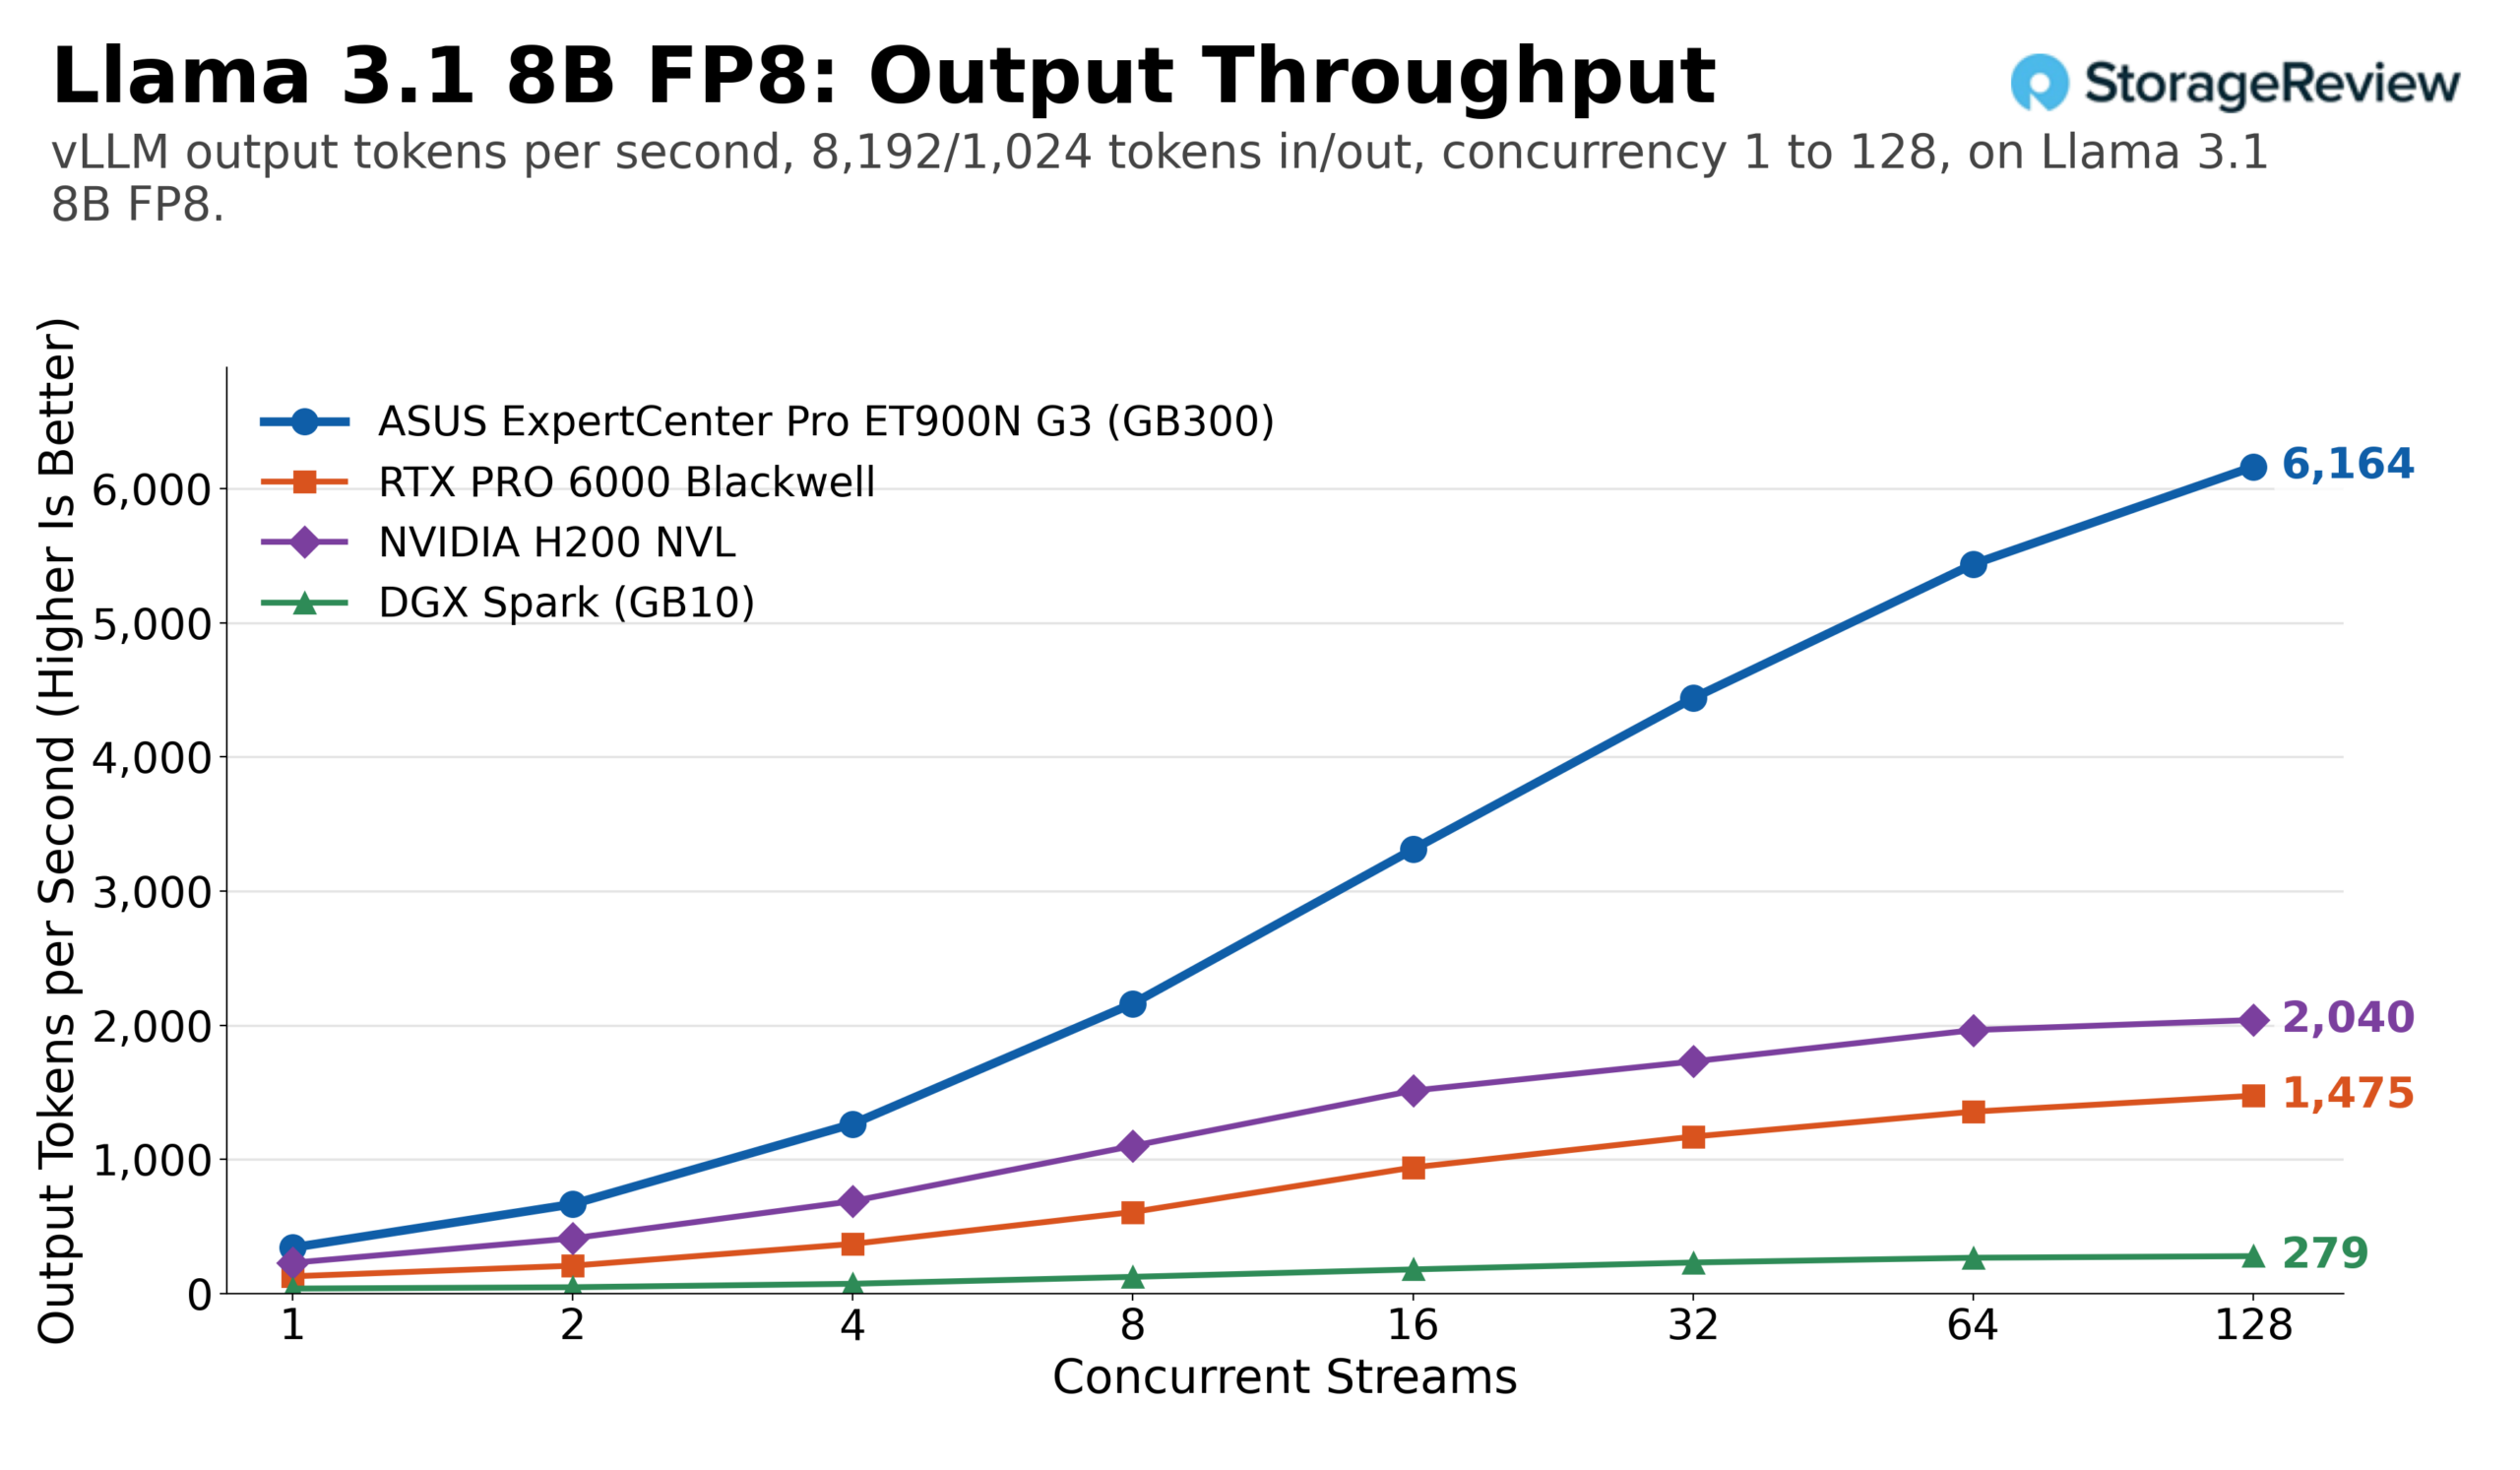
Llama 3.1 8B FP8 프로파일은 테스트 세트에서 가장 높은 단일 수치를 기록했습니다. ET900N G3는 동일한 워크로드에서 128개 스트림을 통해 초당 25,602개의 출력 토큰(총 51,205개)을 처리했으며, RTX PRO 6000은 약 8,060개, H200 NVL은 11,040개를 처리했습니다. BF16에서 FP8로 프로파일을 변경했을 때 Station의 성능은 약 50% 향상(17,074개에서 25,602개로)되었고, RTX PRO 6000은 약 70%, H200 NVL은 약 37% 향상되었습니다. 프리필(prefill) 비중이 높은 프로파일에서는 모든 데이터가 압축되었으며, Station은 초당 6,164개의 출력 토큰, ET900N G3는 1,480개, H200 NVL은 2,040개를 기록했습니다.
Mistral Small 24B FP8 테스트에서 가장 큰 성능 차이를 보였습니다. ET900N G3는 동일한 작업 부하에서 초당 최대 11,075개의 출력 토큰을 처리했는데, 이는 RTX PRO 6000(3,240개)의 3.4배, H200 NVL(4,610개)의 2.4배, Spark(559개)의 거의 20배에 달하는 수치입니다. 긴 프롬프트 처리 시, RTX PRO 6000은 최대 32개의 스트림에서 초당 약 480개의 출력 토큰을 처리한 후 성능이 저하되었고, H200 NVL은 약 854개, Station은 128개의 스트림에서 2,302개의 출력 토큰을 처리했습니다.


Qwen3 Coder 30B는 활성 파라미터 수가 적은 혼합형 전문가 모델로, 단일 스트림 성능 격차가 좁혀지는 지점입니다. 동일한 워크로드에서 단일 스트림으로 테스트했을 때, RTX PRO 6000은 초당 약 232개의 출력 토큰을 처리한 반면, Station은 319개, H200 NVL은 308개를 처리했습니다. 배치 처리를 사용하면 순위가 다시 올라갑니다. 128개의 스트림에서 ET900N G3는 FP8 기준으로 초당 12,439개의 출력 토큰을 처리했는데, 이는 Station의 3,990개보다 3.1배, H200 NVL의 7,450개보다 1.7배 높은 수치입니다. 프리필 작업이 많은 프로파일에서는 Station이 초당 3,837개의 출력 토큰을 처리한 반면, RTX PRO 6000은 64개의 스트림에서 약 880개, H200 NVL은 약 1,820개의 출력 토큰을 처리했습니다.


공통 모델들을 비교해 보면, ET900N G3는 단일 RTX PRO 6000보다 2.8~3.4배, H200 NVL보다 1.7~3.7배 높은 성능을 보였습니다. 특히 긴 프롬프트 처리 시간에서는 KV 캐시 헤드룸이 부족해지면서 두 제품 간의 성능 차이가 더욱 벌어졌습니다. WS300과의 비교에서도 이 네 제품은 1% 이내의 차이를 보였습니다. GPT-OSS-20B에서는 22,041 대 22,161, GPT-OSS-120B에서는 9,280 대 9,294, Mistral Small FP8에서는 11,075 대 11,157, Qwen3 Coder FP8에서는 12,439 대 12,425의 성능을 나타냈습니다. 성능 차이가 큰 세 모델을 포함한 전체 14개 모델 비교 결과는 다음 섹션에서 확인할 수 있습니다.
두 개의 타워, 하나의 베이스보드: ASUS ET900N G3 vs MSI WS300
ET900N G3와 MSI XpertStation WS300은 동일한 NVIDIA GB300 DGX Station 베이스보드를 두 개의 OEM 섀시에 탑재한 제품으로, 동일한 14개 모델, 동일한 2가지 워크로드, 그리고 동일한 vLLM 빌드 환경에서 동일한 동시 실행 테스트를 거쳤습니다. 아래 표는 모든 모델에서 ET900N G3의 최대 출력 처리량을 WS300과 비교한 것입니다.
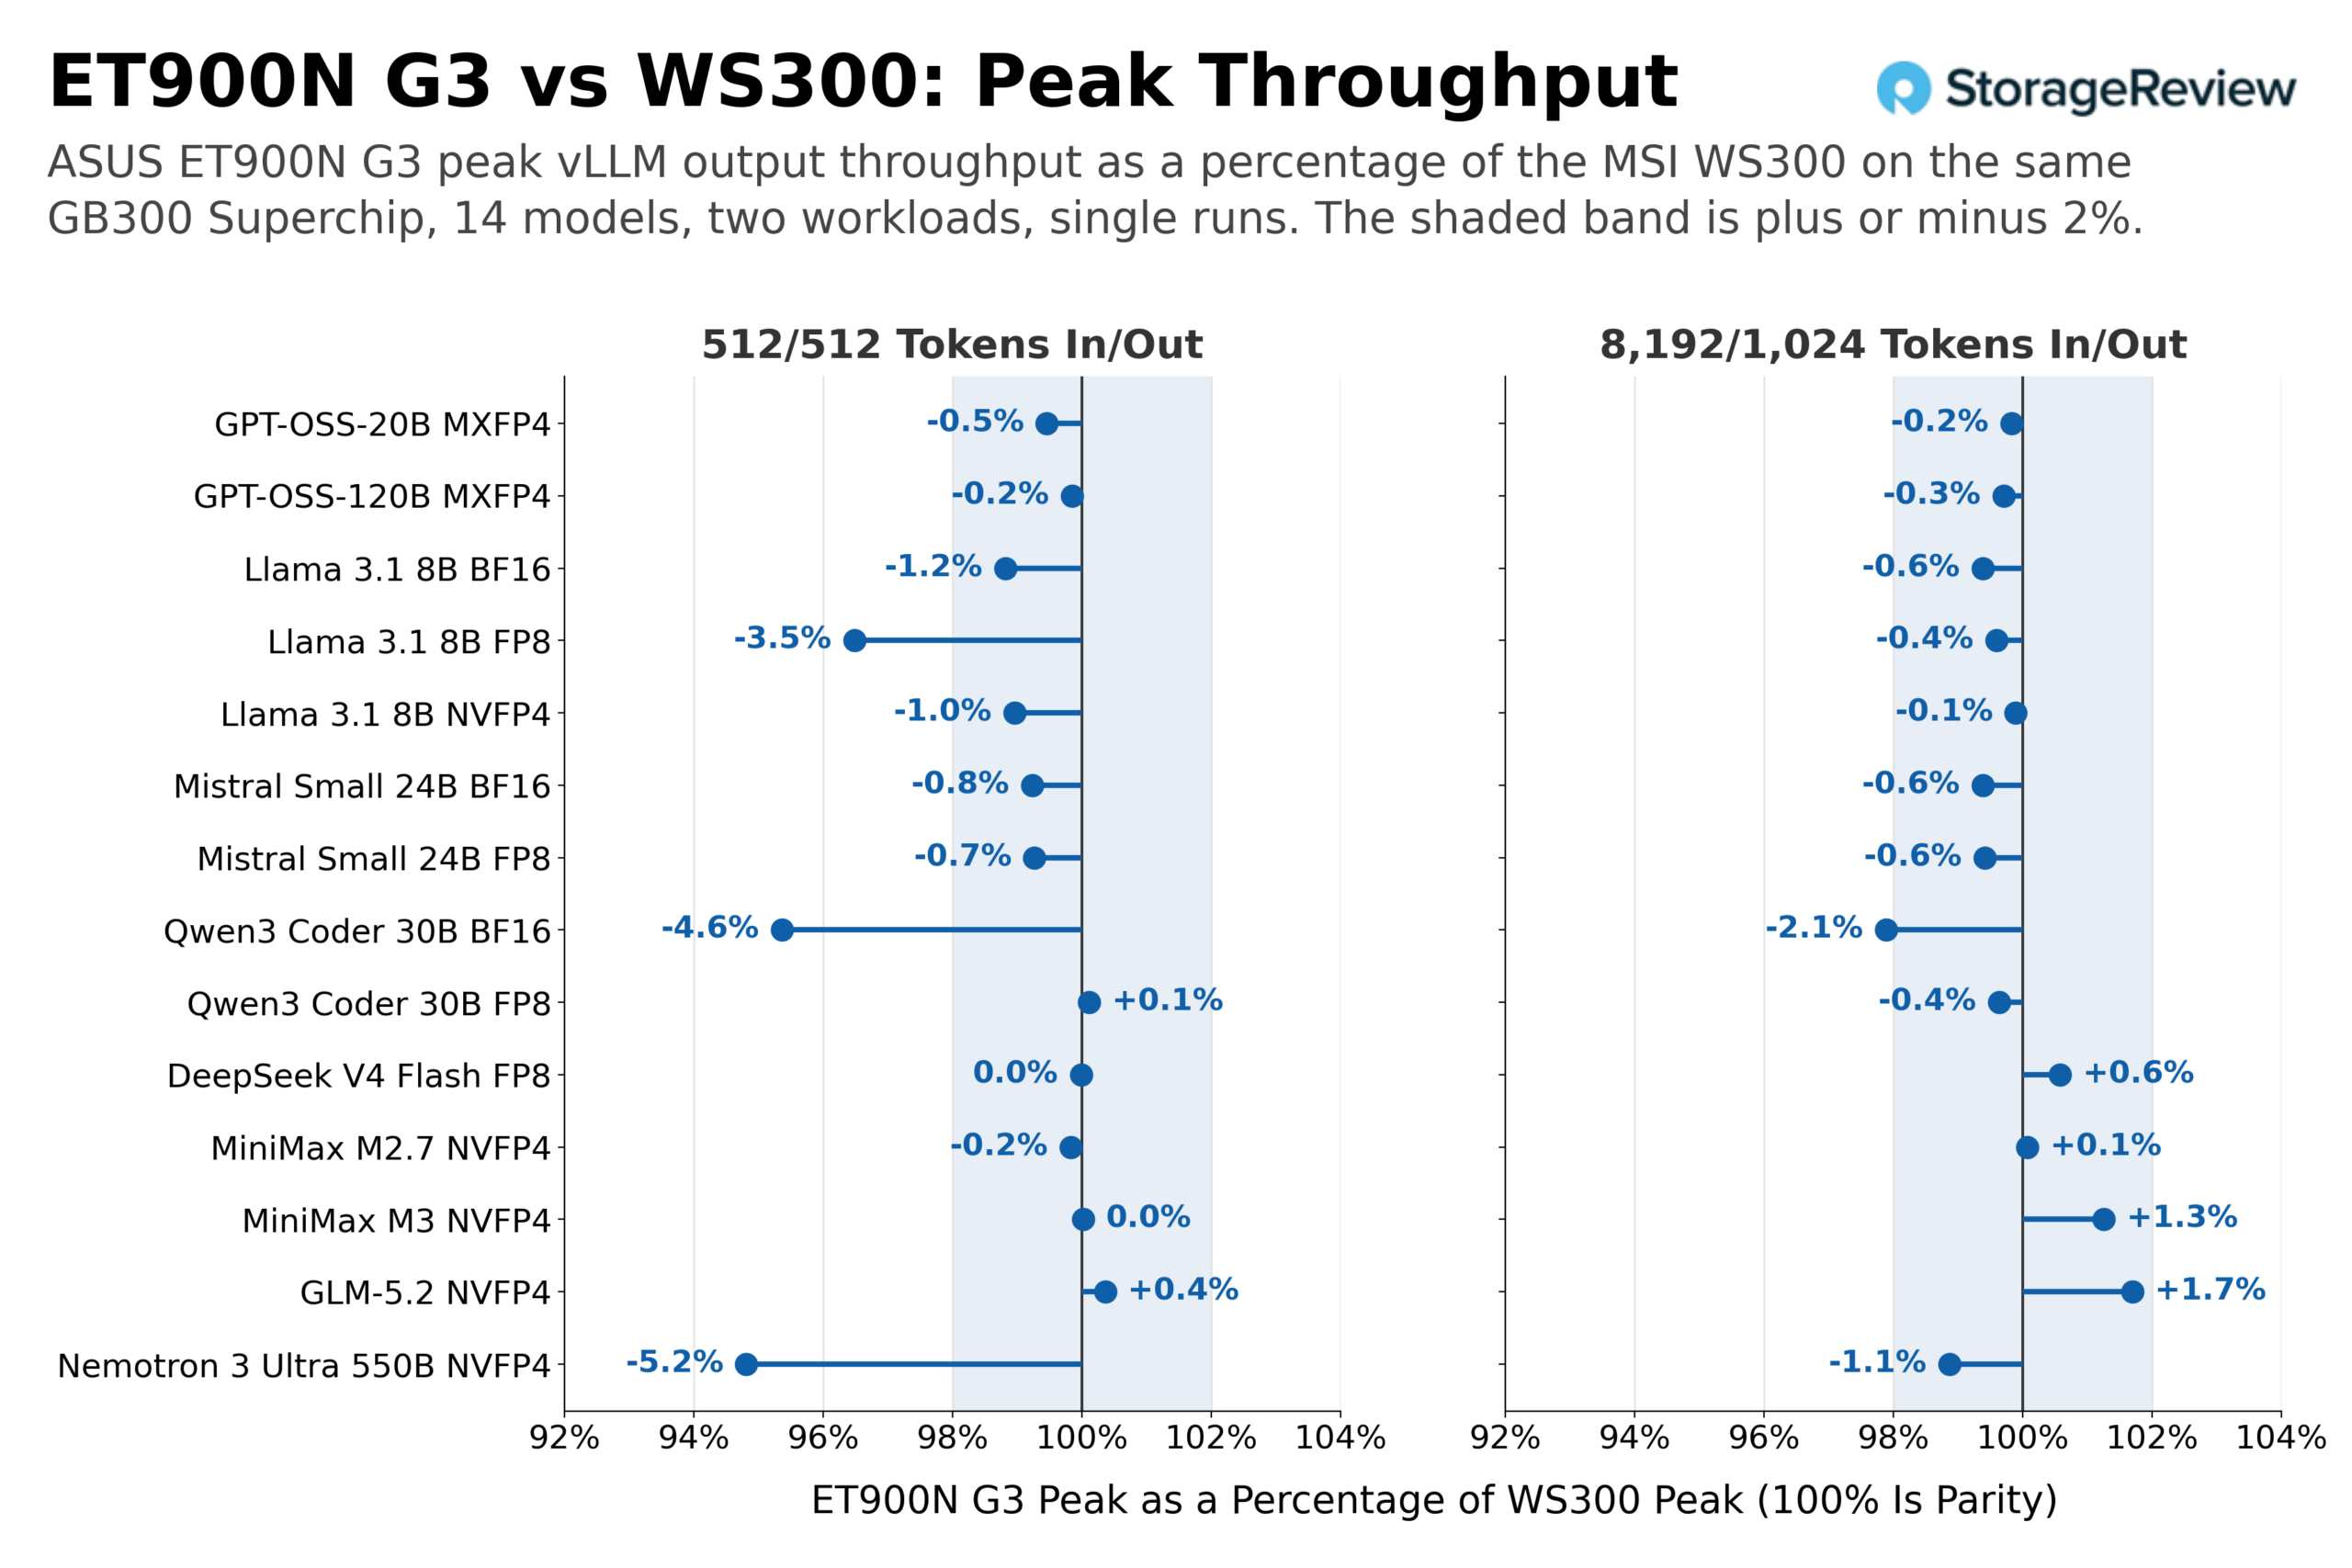
28개의 모델-워크로드 쌍 중에서 24개는 서로 2% 이내의 차이를 보였으며, 대부분은 WS300이 1% 미만의 차이로 우위를 보였습니다. 나머지 4개는 이 범위를 벗어났는데, 그중 3개는 동일한 워크로드에서였습니다. Llama 3.1 8B FP8은 WS300보다 3.5% 낮은 성능(초당 출력 토큰 25,602개 대 26,536개), Qwen3 Coder 30B BF16은 4.6% 낮은 성능(초당 출력 토큰 10,000개 대 10,486개), Nemotron 3 Ultra 550B는 5.2% 낮은 성능(초당 출력 토큰 159개 대 168개)을 보였습니다. 또한, Qwen3 Coder 30B BF16은 긴 프롬프트에서 다시 2.1% 낮은 성능을 보였습니다. 여기에 제시된 모든 수치는 각 타워에서 한 번씩 실행한 결과이므로, 14개 모델 중 3개 모델에서 2~5%의 차이가 발생하는 것을 섀시의 문제로 단정짓기는 어렵습니다. 저희는 단순히 데이터와 두 결과 간의 차이를 기록하고 있을 뿐입니다. 일관성 있는 메모리 풀을 사용하는 MiniMax M3 및 GLM-5.2 모델은 두 워크로드 모두에서 동등하거나 그 이상의 성능을 보였습니다. 이는 플랫폼에 있어 가장 중요한 결과라고 생각합니다. 즉, Grace 오프로드 경로는 ASUS 케이스와 MSI 케이스에서 동일한 성능을 발휘합니다.
| 모델 | WS300 512/512 | ET900N G3 512/512 | 델타 | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | 델타 |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5 % | 9,572 | 9,555 | -0.2 % |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2 % | 5,038 | 5,023 | -0.3 % |
| 라마 3.1 8B BF16 | 17,278 | 17,074 | -1.2 % | 3,520 | 3,498 | -0.6 % |
| 라마 3.1 8B FP8 | 26,536 | 25,602 | -3.5 % | 6,189 | 6,164 | -0.4 % |
| 라마 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0 % | 6,744 | 6,737 | -0.1 % |
| 미스트랄 스몰 24B BF16 | 7,922 | 7,861 | -0.8 % | 1,643 | 1,633 | -0.6 % |
| 미스트랄 스몰 24B FP8 | 11,157 | 11,075 | -0.7 % | 2,316 | 2,302 | -0.6 % |
| Qwen3 코더 30B BF16 | 10,486 | 10,000 | -4.6 % | 3,830 | 3,749 | -2.1 % |
| Qwen3 코더 30B FP8 | 12,425 | 12,439 | 0.1% | 3,851 | 3,837 | -0.4 % |
| DeepSeek V4 플래시 FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | 0.6% |
| 미니맥스 M2.7 NVFP4 | 4,801 | 4,793 | -0.2 % | 1,743 | 1,744 | 0.1% |
| 미니맥스 M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | 0.4% | 118 | 120 | 1.7% |
| 네모트론 3 울트라 550B NVFP4 | 168 | 159 | -5.2 % | 142 | 140 | -1.1 % |
데이터셋에서 가장 높은 처리량을 보이는 밀집형 사례인 GPT-OSS-20B와 오프로드 사례인 GLM-5.2는 비율 없이도 겹치는 부분을 보여줍니다. 두 경우 모두에서 WS300의 실행 결과는 ET900N G3의 실행 결과를 정확히 따라갑니다.
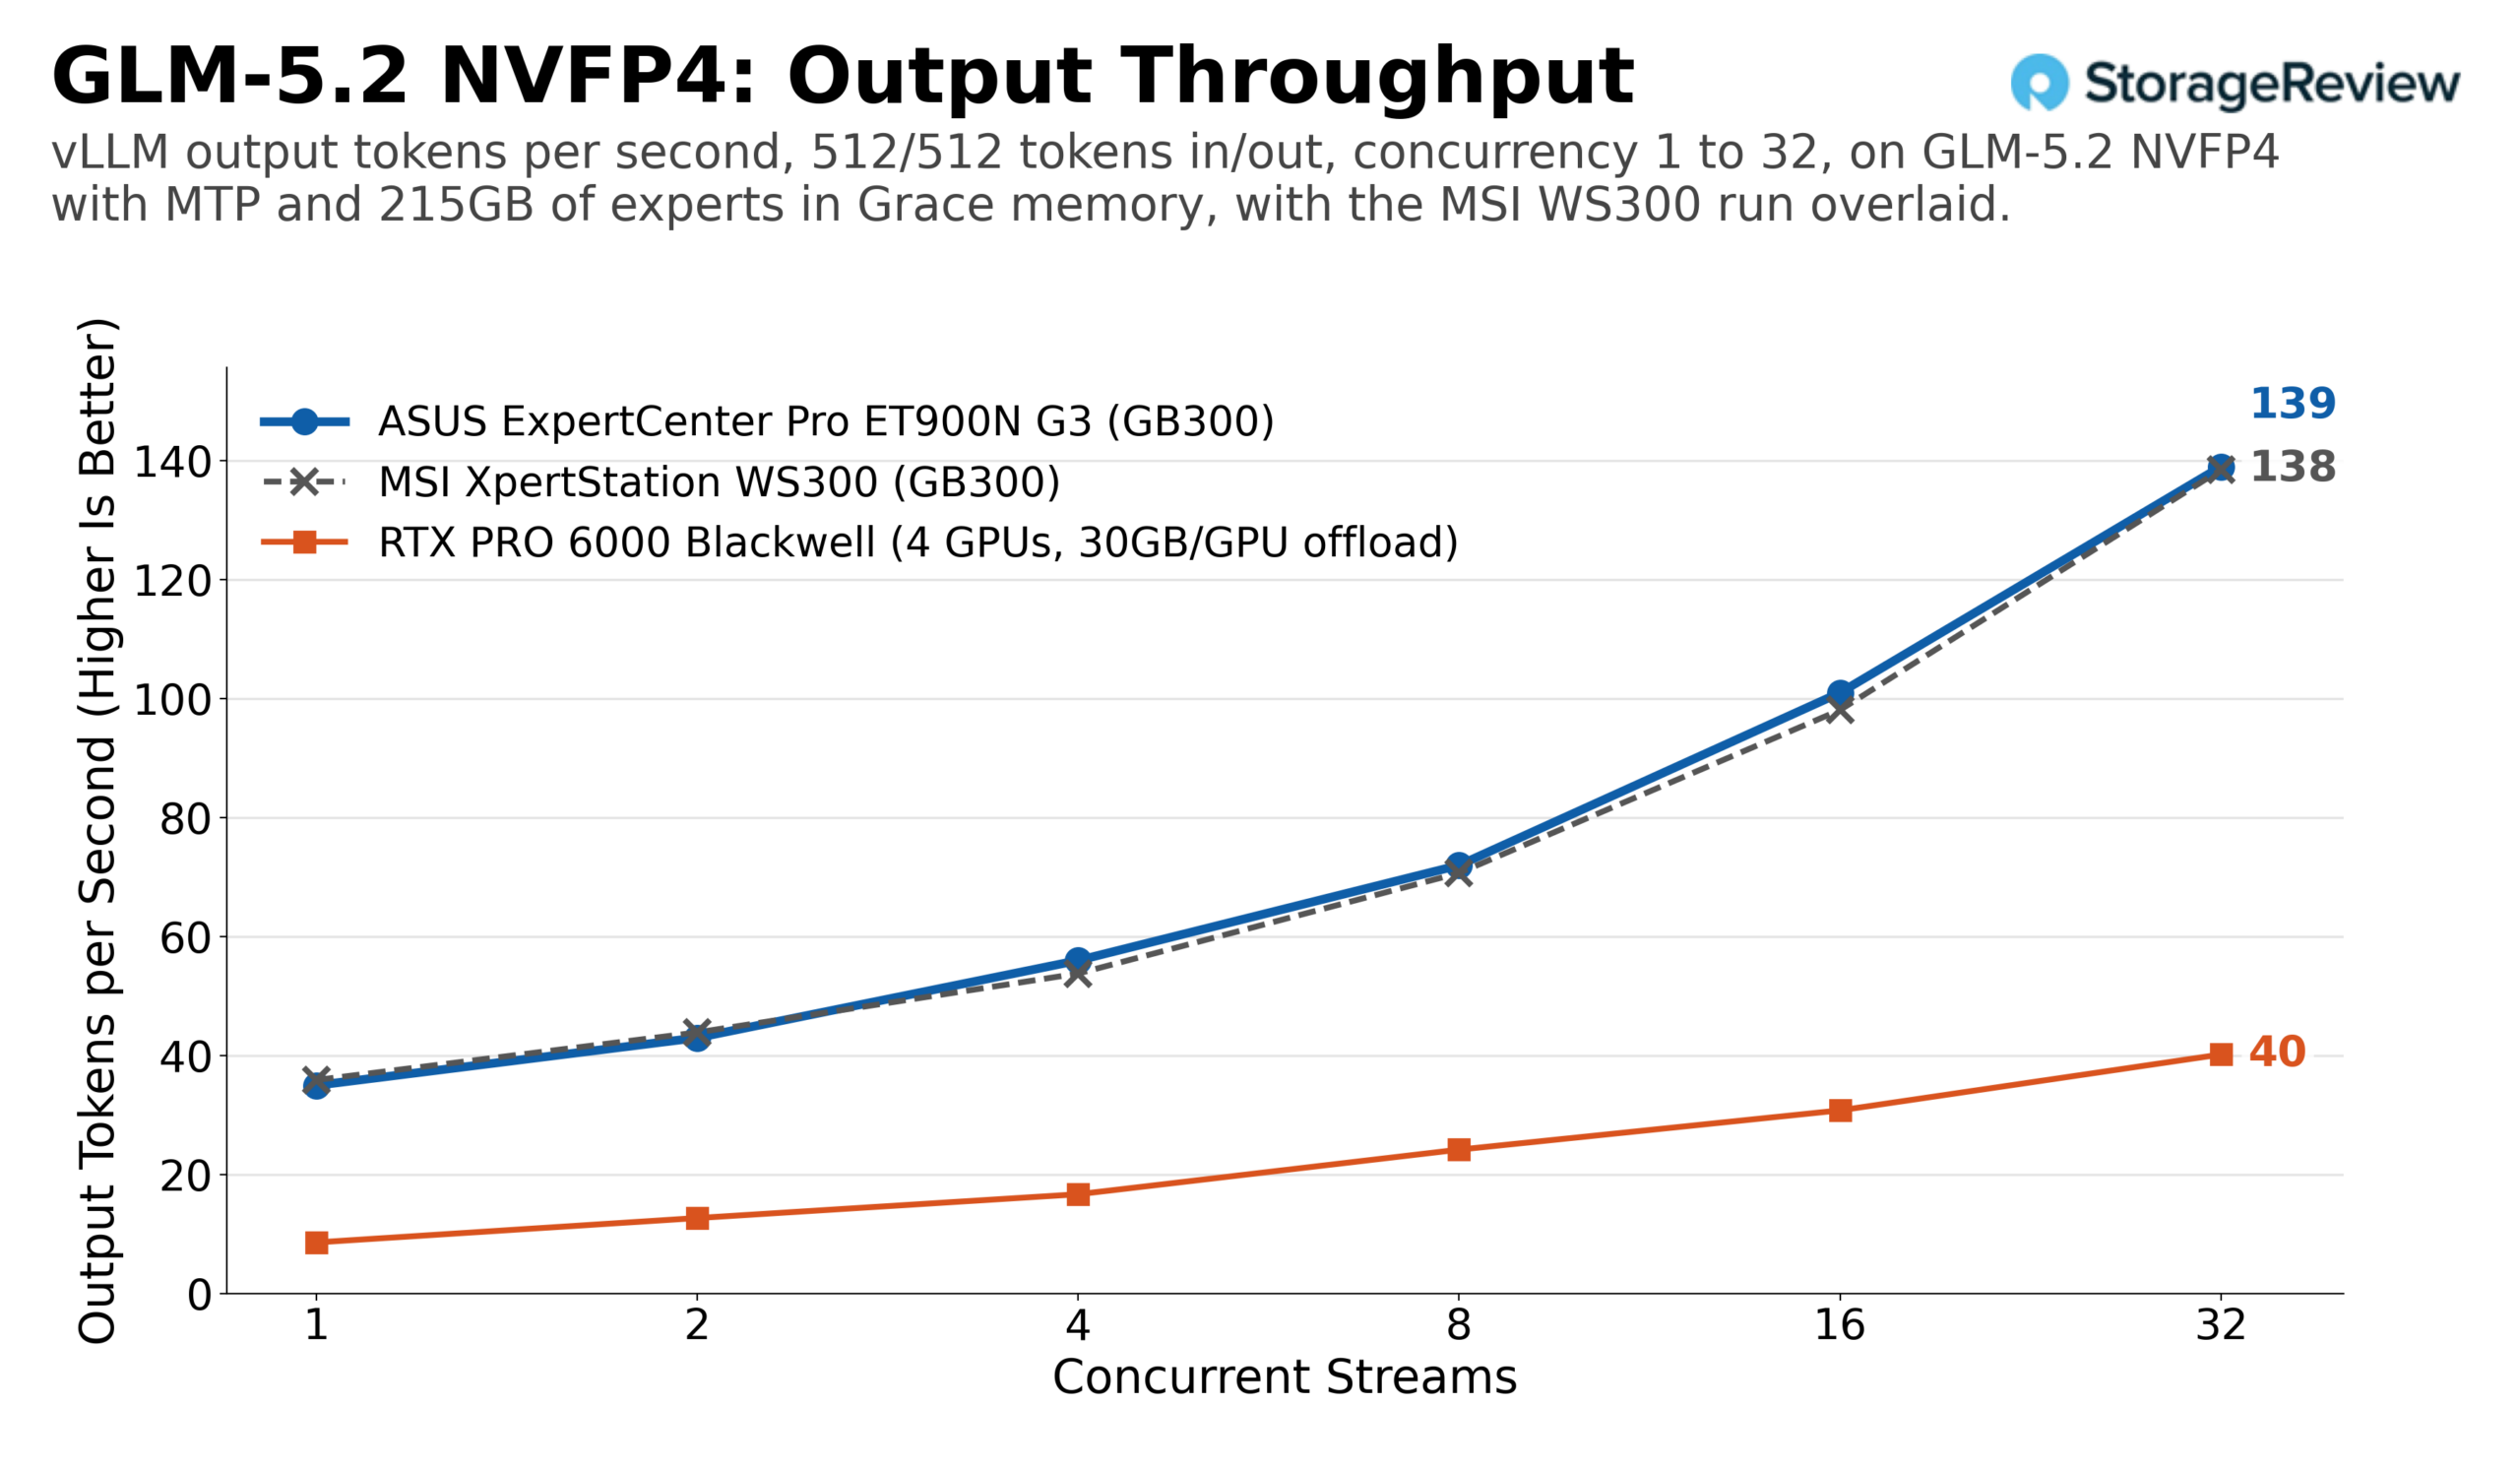
앞으로 더 많은 GB300 타워가 연구실에 들어오면 이 비교 자료를 기반으로 분석을 진행할 예정입니다. 다음은 HP ZGX이며, 이후 더 많은 제품이 테스트될 것입니다. 모든 제품은 동일한 테스트를 거치므로 OEM 구현 방식의 차이는 각 타워별 차트에 표시되며, 모델별 차트에는 원본 데이터가 보관됩니다.
맺음말
ASUS ExpertCenter Pro ET900N G3는 레퍼런스 플랫폼의 두 번째 구현으로서 마땅히 해야 할 일을 해냈습니다. 바로 첫 번째 레퍼런스 플랫폼의 성능을 입증한 것입니다. 14개 모델과 2가지 워크로드를 대상으로 테스트한 결과, 최대 vLLM 처리량은 DeepSeek V4 Flash에서 초당 1,766개의 출력 토큰부터 GPT-OSS-20B에서 초당 22,041개의 출력 토큰까지 28개 비교 항목 중 24개에서 MSI XpertStation WS300과 2% 이내의 차이를 보였습니다. 단 4개의 단일 실행 결과는 2~5% 정도의 차이를 나타냈을 뿐입니다. 또한, 215GB의 Grace 메모리에 전문가 데이터를 탑재한 GLM-5.2 워크로드에서는 4개의 RTX PRO 6000 그래픽 카드조차 따라잡지 못하는 처리량을 보여주었습니다. GB300 Superchip이 성능의 한계를 설정했고, ASUS는 이를 훌륭하게 구현해냈습니다.
ASUS가 추가한 부분은 실용적인 측면입니다. 손잡이 덕분에 27kg짜리 타워형 케이스를 두 사람이 패널을 잡지 않고도 옮길 수 있게 되었고, QSFP112 케이지 위에 설치된 팬은 400G 광학 모듈을 장시간 사용하는 사용자가 겪을 수 있는 잠재적인 문제를 해결해 줍니다. 또한, 티타늄 파워 서플라이는 전력 소비를 몇 와트 줄여줍니다. ARM 호스트, 20A 회로, BMC 전용 디스플레이 출력, 그리고 대형 그래픽 카드 설치 시 공유되는 1,600W 전력 예산은 두 타워형 케이스 모두에 동일하게 적용되는 플랫폼의 특징입니다.
GB300 DGX 스테이션은 우리가 책상 위에 올려본 제품 중 가장 뛰어난 성능을 자랑하며, ASUS는 자사 버전을 통해 이 제품을 구매할 수 있는 좋은 기회를 제공합니다.
우리에 로컬 AI에 가장 적합한 데스크톱 leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 아마존