

저희는 연산 능력의 한계를 뛰어넘는 데 익숙하지만, 이번에는 파이(π)의 자릿수를 넘어서는 도전을 해봤습니다. 작년에 100 조 자리 숫자 계산에 성공한 데 이어, 이번에는 파이의 알려진 자릿수를 105조 자리까지 늘려보기로 했습니다. 즉, 3 뒤에 105,000,000,000,000개의 숫자가 들어가는 것입니다. 작년 시도 이후 플랫폼을 몇 가지 업데이트하고, 그 과정에서 몇 가지 놀라운 사실을 발견했으며, 그 과정에서 여러 가지 새로운 사실들을 알게 되었습니다. 그중 하나가 바로 파이의 105조 번째 자리 숫자, 6입니다!
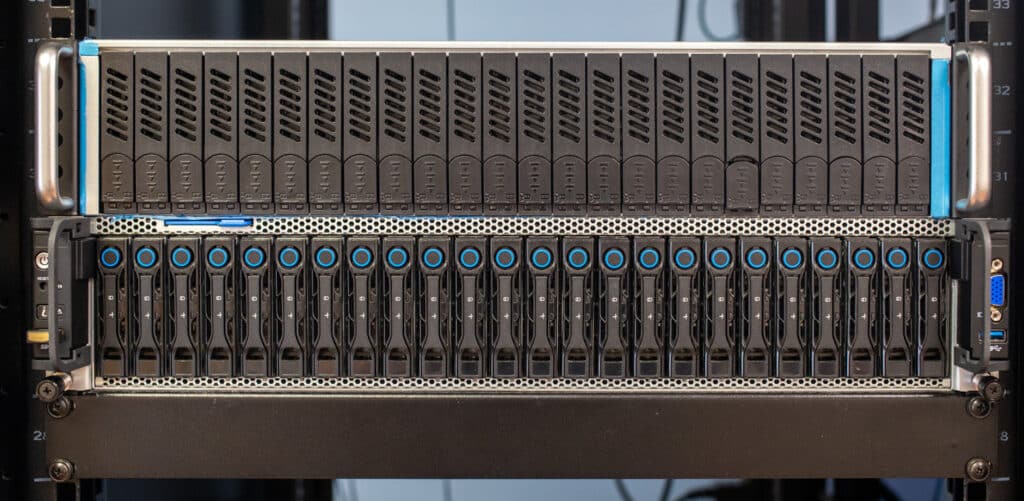
StorageReview 연구소는 Pi를 105조 자릿수까지 계산하여 세계 기록을 깨는 최신 하드웨어의 놀라운 기능을 강조했습니다. 2TB의 DRAM과 거의 128페타바이트에 달하는 Solidigm QLC SSD를 탑재한 최첨단 1.5P XNUMX코어 AMD EPYC Bergamo 시스템을 기반으로 한 이러한 노력은 컴퓨팅 및 스토리지 기술 분야에서 획기적인 성과를 나타냅니다.
도전
100조 디지털 런에서 우리는 몇 가지 기술적 한계에 부딪혔습니다. 예를 들어 서버 플랫폼은 전면 슬롯에서 16개의 NVMe SSD만 지원했습니다. CPU 성능은 충분했지만 이 계산에는 프로세스 도중과 최종 TXT 파일이 출력될 때 백엔드에 막대한 저장 공간이 필요했습니다.
지난번 스토리지 문제를 해결하기 위해 우리는 PCIe NVME 어댑터 슬레드를 사용하여 SSD 0개를 더 집어넣었습니다. 그런 다음 출력을 위해 RAIDXNUMX에 HDD 스토리지 서버가 있었고 iSCSI 공유가 계산 상자에 다시 포함되었습니다. 이번에 우리는 이 서버를 좀 더 "기업"적으로 만들고 싶었기 때문에 도움을 줄 친구 몇 명을 데려왔습니다. 흥미롭게도 서버에 여러 개의 NVMe SSD를 추가하는 것이 보이는 것처럼 쉽지 않습니다.
하드웨어
이 기념비적인 프로젝트의 핵심은 각각 128개의 코어를 제공하는 듀얼 프로세서 AMD EPYC 9754 Bergamo 시스템이었습니다. 고난이도 연산 작업 (AI, HPC, 빅데이터 분석) 에서 탁월한 성능으로 정평이 나 있는 AMD 프로세서는 필요한 처리 능력을 제공했습니다. 여기에 1.5TB의 DRAM이 더해져 신속한 데이터 처리 및 전송 속도를 보장했습니다. 또한, 거의 1페타바이트에 달하는 Solidigm QLC 스토리지는 전례 없는 용량과 안정성을 제공했습니다.
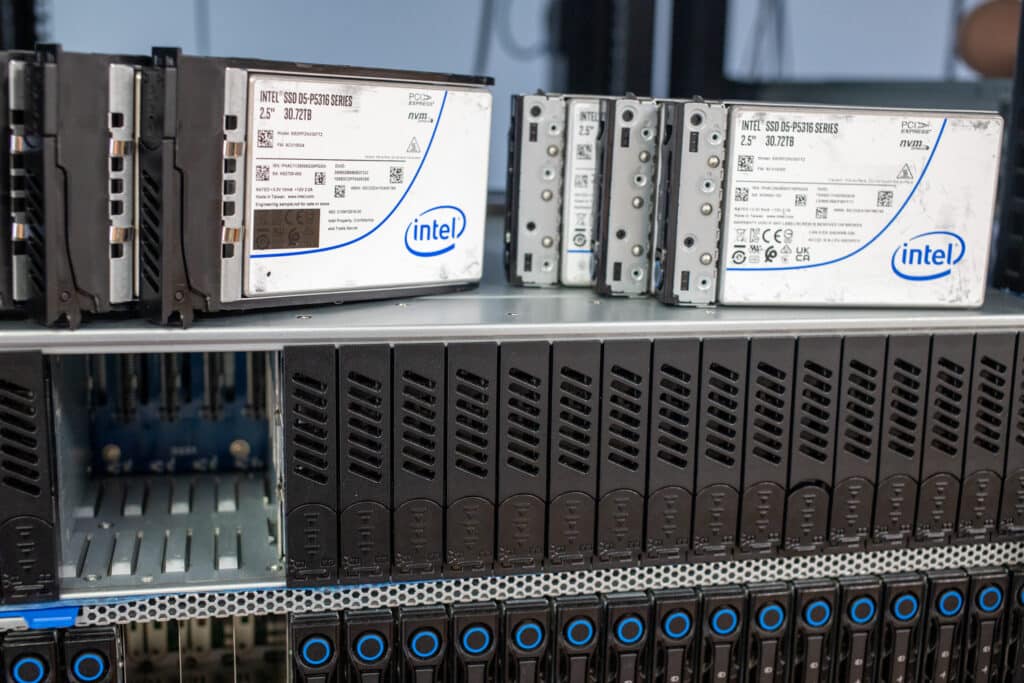
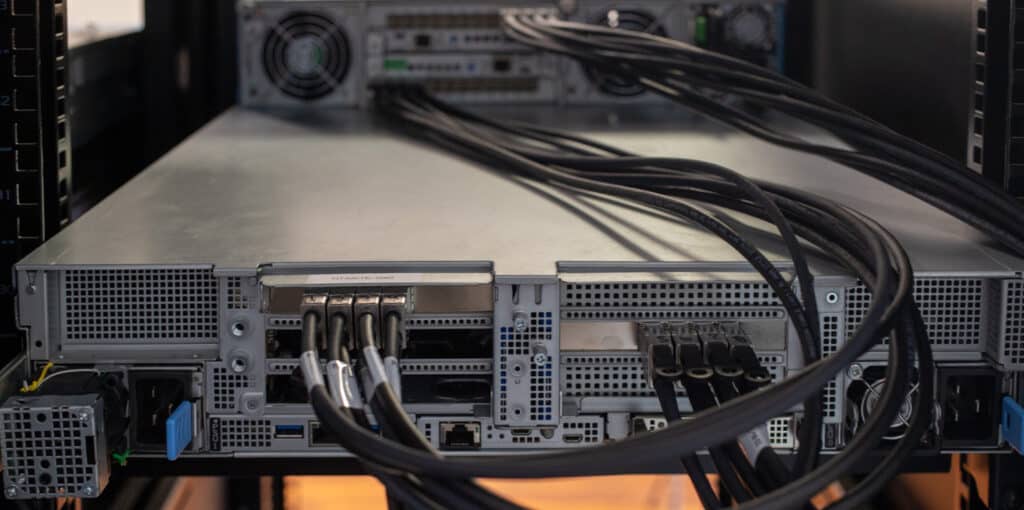
기본 섀시 플랫폼은 작년(QCT 박스)과 동일하게 유지되었지만 CPU를 AMD EPYC 9754 Bergamo 칩으로 업그레이드했습니다. 우리는 계산을 위한 스토리지 사용을 피하면서 속도와 소수점 개선을 추구하고 싶었습니다. 이는 JBOF를 제공하기 위해 SerialCables를 호출해야 함을 의미합니다. 이는 그 자체로 몇 가지 과제를 제시했으며 이에 대해서는 아래에서 자세히 설명하겠습니다.
| 매개 변수 | 가치관 |
|---|---|
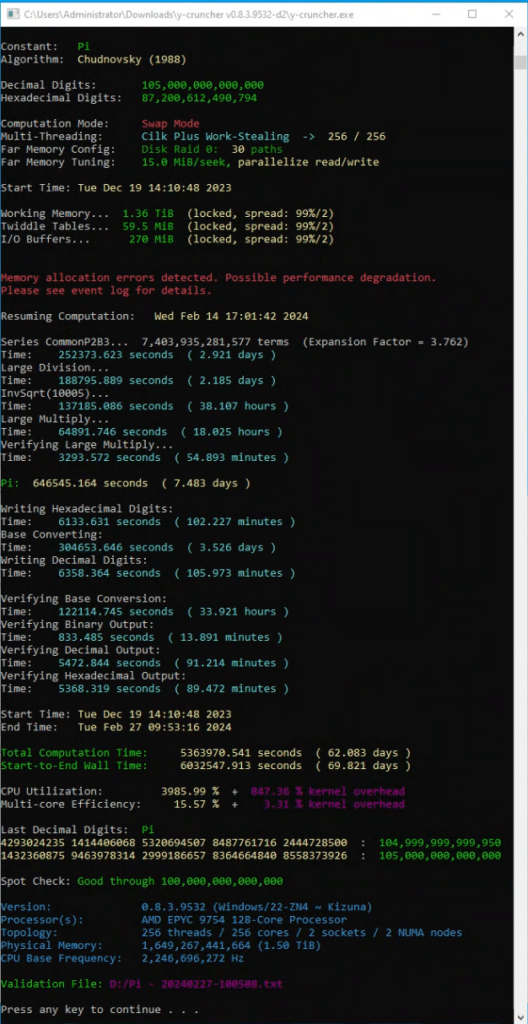
| 시작 날짜 | 19년 14월 10일 (화) 48:2023:XNUMX |
| 종료 날짜 | 27년 09월 53일 (화) 16:2024:XNUMX |
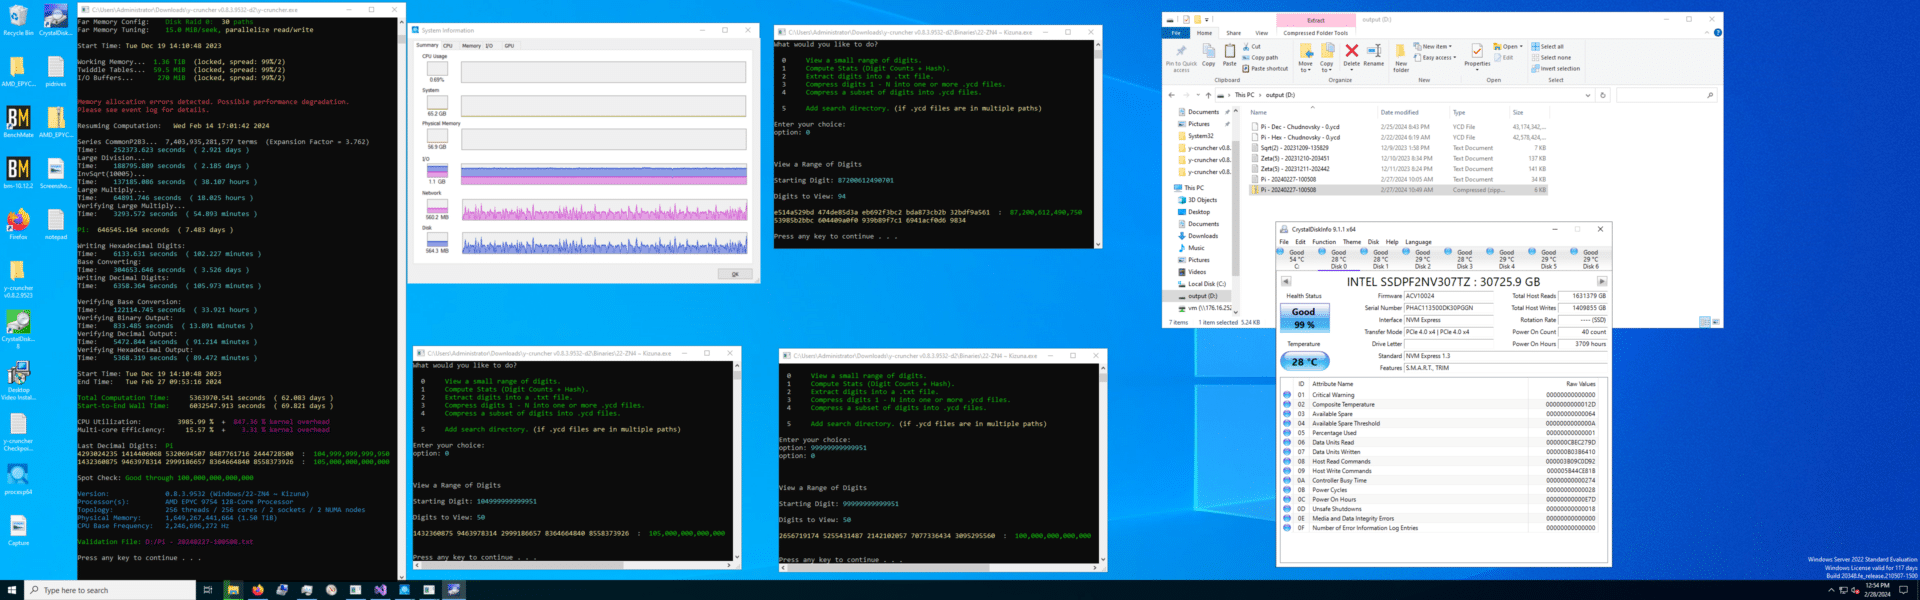
| 총 계산 시간 | 5,363,970.541초 / 62.08일 |
| 시작부터 끝까지 벽 시간 | 6,032,547.913초 / 69.82일 |
계산 기간: 2023년 12월 14일 ~ 2024년 2월 27일 (총 75일).
- CPU : 듀얼 AMD Epyc 9754 Bergamo 프로세서, BIOS에서 동시 멀티스레딩(SMT)이 비활성화된 256개 코어.
- 메모리 : 1.5TB의 DDR5 RAM.
- 스토리지 : 36x 30.72TB Solidigm D5-P5316 SSD.
- SerialCables JBOF에 24x 30.72TB Solidigm D5-P5316 SSD
- 서버 직접 연결형 12x 30.72TB Solidigm D5-P5316 SSD.
- 운영 체제 : 윈도우 서버 2022(21H2).
105조를 향한 길
| 매개 변수 | 가치관 |
|---|---|
| 상수 | Pi |
| 암호알고리즘 | 추드노프스키 (1988) |
| 십진수 | 105,000,000,000,000 |
| 16진수 | 87,200,612,490,794 |
| 스레딩 모드 | Cilk Plus 작업훔치기 -> 256 / 256 |
| 메모리 작동 | 1,492,670,259,968(1.36TiB) |
| 총 메모리 | 1,492,984,298,368(1.36TiB) |
| 논리적으로 가장 큰 체크포인트 | 157,783,654,587,576(144TiB) |
| 논리적 최대 디스크 사용량 | 534,615,969,510,896(486TiB) |
| 논리 디스크 읽은 바이트 수 | 44,823,456,487,834,568(39.8PiB) |
| 쓴 논리 디스크 바이트 수 | 38,717,269,572,788,080(34.4PiB) |
직면한 도전
이번 테스트 실행에서 프로세서에 사용할 수 있는 저장 공간을 확장하기 위해 새로운 구성 요소로 NVMe JBOF를 추가했습니다. 저희 테스트 플랫폼은 16개의 NVMe 베이를 제공했고, 나머지 8개는 SATA로만 연결되어 있었습니다. 100조 용량 테스트 실행에서는 3개의 내부 PCIe U.2 어댑터를 활용하여 NVMe 드라이브 수를 19개로 확장했지만, 최적의 구성은 아니었습니다. 이번 재실행에서는 Serial Cables의 24베이 U.2 JBOF를 추가했는데 , 이는 컴퓨팅 스왑 저장 공간과 내부 출력 파일 저장 공간 측면에서 두 가지 면에서 크게 개선되었습니다. 이제 더 이상 복잡한 RAID0 HDD 저장 서버를 사용할 필요가 없습니다!
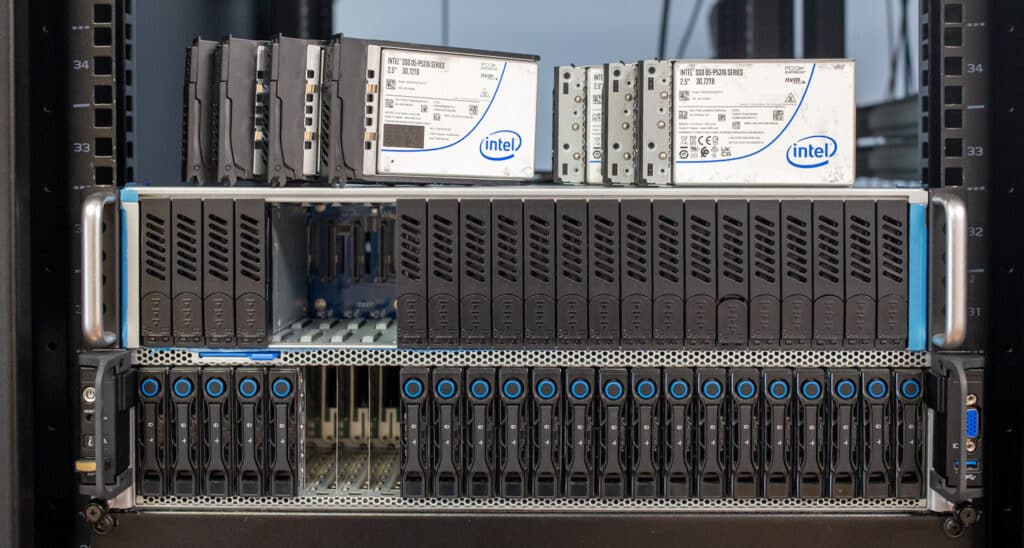
직렬 케이블 24베이 JBOF를 사용하면 원래 실행보다 드라이브 수를 거의 두 배로 늘릴 수 있었습니다. y-cruncher 스왑 공간에 30개의 드라이브를 할당하고 스토리지 공간 RAID6 출력 볼륨에 5개의 SSD를 남겨 두었습니다. 이러한 접근 방식의 큰 장점은 출력 단계에서 나타났습니다. 출력 단계에서는 첫 번째 10T Pi 반복과 같이 단일 100Gb 연결 속도에 제약을 받지 않았습니다. JBOF는 총 드라이브 수 문제를 해결했지만 개별 드라이브 성능이라는 한 가지 제한 사항을 도입했습니다.
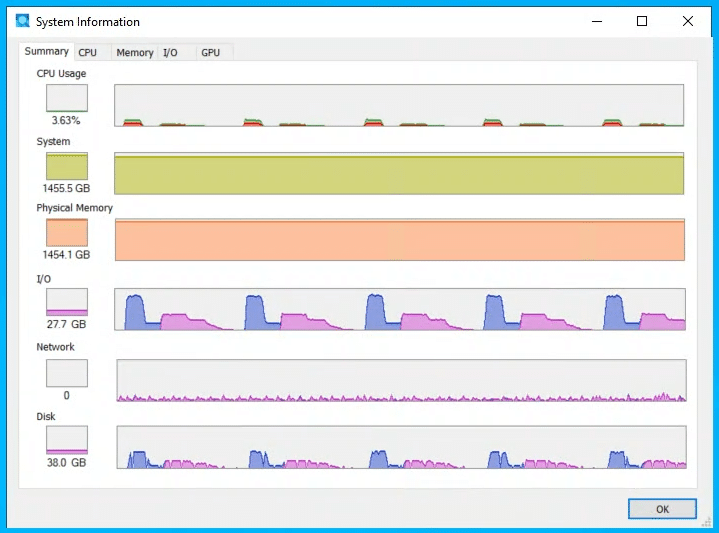
직접 연결된 U.2 SSD가 있는 서버에는 드라이브당 96개의 PCIe 레인이 있습니다. 각 드라이브가 마더보드에 직접 연결되면 SSD 24개에 대해 XNUMX개의 PCIe 레인이 작동됩니다. JBOF의 총 대역폭은 호스트에 다시 연결할 수 있는 PCIe 레인 수에 따라 제한됩니다.
이 경우에는 12개의 PCIe 스위치 호스트 카드를 사용하여 JBOF를 12개의 SSD로 구성된 두 그룹으로 분할했습니다. SSD 16개로 구성된 각 그룹은 XNUMX개의 PCIe 레인을 공유했습니다. SSD를 호스트에 연결하는 데 여전히 상당한 이점을 제공하지만 JBOF를 통해 실행되는 스왑 드라이브가 서버에 직접 연결된 드라이브보다 뒤처지는 시나리오도 있었습니다. 이것은 JBOF의 잘못이 아닙니다. 이는 단지 기술적인 제한이거나 서버가 작동할 수 있는 PCIe 레인 수에 대한 제한일 뿐입니다.
기민한 독자라면 이번 실행에서 왜 SSD를 36개로 늘리지 않고 40개로 멈췄는지 궁금해할 것입니다. 재미있는 이야기입니다. 주소 지정이 가능한 PCIe 공간은 많은 서버에서 제한이 있습니다. 우리의 경우 드라이브 수가 38개일 때 마지막 SSD가 USB 칩셋의 PCIe 주소를 가져갔고 서버 제어권을 잃었습니다. 안전하게 플레이하기 위해 우리는 BIOS로 들어가거나 서버에 로그인할 수 있도록 SSD를 36개로 백업했습니다. 경계를 넓히면 몇 가지 놀라운 발견이 가능해집니다.
진단 통찰력 및 해결 방법
우리가 직면한 두 가지 주요 과제 중 첫 번째는 성능 관련 문제였습니다. 이 과정에서 암달의 법칙이 실제로 적용되는 것을 발견했습니다. 256코어 AMD 베르가모 시스템에서 대규모 스왑 모드 작업을 수행하는 동안 y-cruncher가 마치 "멈춰버린" 것처럼 보이는 특이한 현상이 발생했습니다. CPU 및 디스크 I/O 활동이 거의 없는 이 멈춤 현상은 소프트웨어 동작에 대한 기존 기대치를 뛰어넘는 것이었습니다. 이는 병렬 컴퓨팅과 하드웨어 상호 작용의 복잡성에 대한 심층적인 연구로 이어졌습니다.
검색 프로세스에 따르면 해당 프로그램은 실제로 정지된 것이 아니라 광범위한 256코어 설정에서 단일 스레드로 실행되면서 심각하게 제한된 용량으로 작동하고 있는 것으로 나타났습니다. 이러한 비정상적인 동작은 암달의 법칙의 잠재적 영향에 대한 의문을 불러일으켰습니다. 특히 관련된 작업은 컴퓨팅 집약적이지 않았고 1.5TB RAM이 장착된 시스템에서 심각한 지연을 초래해서는 안 되었기 때문입니다.
조사는 예상치 못한 방향으로 흘러갔는데, 동일한 문제가 일반 소비자용 데스크톱에서도 재현되면서 암달의 법칙이 비교적 단순한 시스템에서도 심각한 영향을 미칠 수 있음을 보여주었습니다. 이를 계기로 근본적인 원인에 대한 심층적인 조사가 이루어졌고, 그 결과 젠4 아키텍처 특유의 CPU 결함, 즉 슈퍼 정렬과 그것이 메모리 접근 패턴에 미치는 영향이 밝혀졌습니다.
이 문제는 단순한 특성으로 인해 관찰된 것보다 훨씬 빠르게 실행되어야 하는 코드의 루프로 인해 AMD 프로세서에서 더욱 악화되었습니다. 근본 원인은 AMD의 로드 저장 장치에 의한 메모리 앨리어싱을 비효율적으로 처리하는 것으로 나타났습니다. 이 복잡한 문제를 해결하려면 AVX512를 사용하여 루프의 벡터화를 통해 초정렬 위험을 완화하고 향상된 병렬성을 통해 암달의 법칙으로 인한 속도 저하를 해결해야 했습니다. 이러한 포괄적인 접근 방식은 즉각적인 문제를 해결했을 뿐만 아니라 y-cruncher의 계산 프로세스를 크게 최적화하여 고성능 컴퓨팅 환경에서 유사한 문제를 해결하는 선례를 세웠습니다.
다음 문제는 계산의 마지막 단계에서 발생했는데, 이는 예기치 않게 중단되고 충돌 원인에 대한 정보를 제공하지 않습니다. Alexander Yee에게 원격 액세스 권한이 부여되었으며, 10년 만에 처음으로 Pi 기록을 완성하려면 개발자의 직접적인 개입이 필요했습니다.
저희는 이 진단 과정에 직접 참여하지는 않았지만, N63 곱셈 알고리즘의 AVX512 코드 경로에 심각한 부동 소수점 연산 오류가 있었습니다. Alexander는 원격으로 오류를 진단하고 , 수정된 바이너리 파일을 제공했으며, 체크포인트부터 작업을 재개하여 중요한 소프트웨어 수정 사항을 적용한 후 최종적으로 계산을 성공적으로 완료했습니다.
성찰과 전진
이러한 노력은 고성능 컴퓨팅의 복잡성과 예측 불가능성을 보여줍니다. 이러한 과제를 해결함으로써 새로운 Pi 계산 기록을 세우고 소프트웨어 개발 및 테스트 방법론에 대한 귀중한 통찰력을 제공했습니다. 최신 y-cruncher 릴리스인 v0.8.4에는 확인된 문제에 대한 수정 사항이 포함되어 있어 향후 계산의 안정성이 향상될 것을 약속합니다.
Pi를 105조 자릿수까지 계산하는 것은 결코 쉬운 일이 아니었습니다. 여기에는 세심한 계획, 최적화 및 실행이 포함되었습니다. StorageReview 팀은 오픈 소스와 독점 소프트웨어의 조합을 활용하여 알고리즘 프로세스를 최적화하여 하드웨어 기능을 최대한 활용하고 계산 시간을 줄이고 효율성을 높였습니다.
PCIe Gen4 포화 읽기 성능과 최대 61.44TB의 업계 최고 용량을 갖춘 Solidigm QLC SSD는 믿을 수 없는 결과를 제공합니다. Solidigm의 전략 계획 및 마케팅 부사장인 Greg Matson은 "이러한 드라이브가 고성능 컴퓨팅 또는 AI 집약적 애플리케이션에서 무엇을 가능하게 할 수 있는지 상상해 보십시오."라고 말했습니다. Solidigm의 SSD가 Storagereview의 두 번째 기록 경신 파이 계산 시도에 힘을 실어줄 수 있다는 사실에 매우 기쁩니다. 그들의 노력은 Solidigm 스토리지 드라이브의 진정한 기능을 입증하여 데이터 집약적인 AI 애플리케이션에 대한 가능성의 세계를 열어줍니다.”
맺음말
105조 자릿수 Pi를 실행하는 작업은 우리가 예상했던 것보다 훨씬 더 복잡했습니다. 곰곰히 생각해보면 우리는 새로운 문제에 직면할 것을 예상했어야 했습니다. 결국 우리는 이전에 한 번도 수행된 적이 없는 계산을 완료하고 있습니다. 그러나 훨씬 더 많은 "덕트 테이프와 치킨 와이어" 구성으로 100조 계산이 완료되면서 우리는 해냈다고 생각했습니다. 궁극적으로 이 장비를 결승선에 통과시키기 위해서는 공동의 노력이 필요했습니다.
우리는 파트너들과 함께 이 기록적인 기록을 기뻐하면서 "이것이 무엇을 의미하는가?"라고 질문해야 합니다. 5조 자리의 파이가 더 많다고 해서 수학에 큰 변화는 없을 것입니다. 그럼에도 불구하고 우리는 계산 작업 부하와 이를 지원하기 위한 최신 기본 하드웨어의 필요성 사이에 몇 가지 선을 그을 수 있습니다. 기본적으로 이 연습은 엔터프라이즈 데이터 센터 클러스터이든 대규모 HPC 설치든 적절한 하드웨어가 모든 차이를 만든다는 점을 반영합니다.
파이(π) 계산에 있어서 우리는 저장 용량의 제약에 완전히 직면했습니다. 더 빠른 CPU는 계산 속도를 높이는 데 도움이 되지만, 많은 신기록 경신의 한계는 결국 시스템 내 로컬 저장 용량에 달려 있습니다. 이번 실험에서도 우리는 Solidigm D5-P5316 30.72TB SSD를 활용하여 시스템에 1.1PB가 넘는 플래시 메모리를 확보했습니다. 이 SSD 덕분에 이전 기록을 깨고 파이의 105조 자리까지 계산할 수 있었습니다.
하지만 여기서 흥미로운 질문이 생깁니다. 많은 팔로워분들이 알고 계시겠지만, Solidigm은 D5-P5336 모델에 61.44TB , D5-P5430 모델에 최대 30.72TB의 SSD를 다양한 폼팩터와 용량으로 제공하고 있습니다. 저희는 이 드라이브들을 리뷰했고, 소셜 미디어에도 이 놀라운 고용량 드라이브들을 소개하는 게시물을 여러 개 올렸습니다. 이 SSD 32개를 사용하면 거의 2PB에 달하는 저장 용량을 확보할 수 있는데, 그렇다면 파이(π)의 105조 자리 숫자가 세계 최대 저장 용량 기록을 얼마나 오래 유지할 수 있을지 궁금해집니다. 아마 오래가지는 못할 거라고 생각합니다.
Pi의 가장 큰 알려진 십진수
1432360875 9463978314 2999186657 8364664840 8558373926: 자릿수를 105,000,000,000,000까지


 아마존