

내년에 많은 기업들이 내릴 가장 중요한 AI 인프라 관련 결정은 GPU 투자가 아니라 데이터베이스 업그레이드가 될 것입니다. 오라클은 19c 설치 기반 사용자들을 대상으로 장기 지원 릴리스인 Oracle AI Database 26ai를 권장하고 있습니다. 26ai는 벡터 검색 기능을 트랜잭션을 저장하는 동일한 엔진에 통합했습니다. 벡터 인덱스가 데이터베이스에 저장되면 블록 어레이와 그 뒤에 있는 SAN 패브릭은 AI 인프라 역할을 수행하며, 기존에 처리하던 트랜잭션과 함께 검색 트래픽도 처리하게 됩니다.
인공지능 덕분에 데이터베이스가 바뀌었습니다.
오라클은 이러한 아이디어를 바탕으로 26ai를 개발했습니다. 네이티브 벡터 데이터 타입, SQL 벡터 검색 함수, ONNX를 통한 데이터베이스 내 모델 실행, 자연어 쿼리를 위한 SELECT AI 등 300개 이상의 새로운 기능을 포함한 LTS 버전을 출시했습니다. 실제로 DBA는 임베딩을 생성하고, 해당 행 옆에 저장한 다음, 주문 조회와 동일한 트랜잭션 범위 내에서 유사성 검색을 실행할 수 있습니다. 별도의 벡터 저장소를 운영하거나 동기화 파이프라인을 유지 관리할 필요가 없으며, 감사 추적 외부에 규제 대상 데이터의 두 번째 복사본을 보관할 필요도 없습니다.
IBM은 IDC의 보고서를 인용하여 이러한 추세를 다음과 같이 설명합니다. "기업들이 에이전트형 AI를 위한 통합되고 관리되는 환경을 선호함에 따라, 통합 벡터 데이터베이스는 벡터 임베딩을 저장하고 쿼리하는 데 있어 확실한 선택 플랫폼이 되고 있습니다." IBM과 브로드컴의 고객들은 기존에 신뢰하는 데이터베이스를 확장한 후, 새로운 데이터베이스를 함께 구축하기를 원합니다.
오라클만 이런 방향으로 나아가는 것은 아닙니다. DB-Engines의 2026년 10월 인기 순위에서 상위 4개 관계형 및 멀티모델 데이터베이스 엔진은 오라클, MySQL, Microsoft SQL Server, PostgreSQL로 선정되었으며, 이 네 가지 모두 기본적으로 또는 pgvector와 같은 확장 기능을 통해 벡터 데이터 유형이나 벡터 검색 기능을 추가했습니다. IBM이 오라클을 검증 대상으로 선택한 주된 이유는 시장 선도적 지위 때문이었지만, 이 글에서 다루는 스토리지 관련 논의는 다른 제품에도 동일하게 적용됩니다.

AI가 도입되었다고 해서 온프레미스 블록 스토리지를 유지해야 하는 이유가 바뀌는 것은 아닙니다. 환자 기록, 청구, 주문, 거래 내역 등 AI 배포를 유용하게 만드는 데이터는 외부로 유출될 수 없기 때문입니다. 이러한 데이터를 전용 AI 플랫폼으로 복사하면 스토리지 비용을 두 번 지불해야 하고, 복사본이 프로덕션 클러스터와 분리될 가능성을 감수해야 하며, 원본 데이터의 법적 보호 기능을 보장했던 거버넌스 제어 권한을 잃게 됩니다. 데이터베이스 내에서 데이터 검색을 유지하면 이 세 가지 문제를 모두 해결할 수 있습니다. 1밀리초 미만의 빠른 행 조회 속도를 제공하는 스토리지 어레이는 이제 임상의를 위한 벡터 유사성 스캔과 백업 스트림도 동시에 처리합니다.
IBM 스토리지와 브로드컴의 파이버 채널(FC) 그룹은 혼합 워크로드 사례를 검증하기 위해 브로드컴의 브로케이드 8세대 SAN 패브릭과 에뮬렉스 64G SecureHBA를 사용하는 IBM 플래시시스템 기반 Oracle AI Database 26ai 환경을 구축했습니다 . 그런 다음 인프라 팀이 제기했던 질문들을 하나씩 해결해 나갔습니다. 예를 들어, 벡터 워크로드가 바로 옆에서 시작될 때 트랜잭션 지연 시간에 미치는 영향, 패브릭 속도가 벡터 검색 처리량에 미치는 영향, 임베딩이 소비하는 용량, RMAN 백업 볼륨을 대상으로 하는 랜섬웨어 탐지의 효율성, 그리고 영역 지정 티켓 없이 SAN에 호스트를 추가하는 데 필요한 요건은 무엇인지 등이었습니다.
데이터는 이미 블록 스토리지에 저장되어 있으며, 이제 인공지능이 그 데이터에 접근합니다.
이 모든 것이 AI 워크로드가 일반적으로 블록 스토리지에 적합하다는 것을 의미하는 것은 아닙니다. 기업들은 문서, 이미지, 비디오, 학습 데이터 세트, 모델 체크포인트와 같이 데이터베이스에 저장되지 않았고 앞으로도 저장될 가능성이 낮은 비정형 데이터를 위해 파일 및 객체 스토리지를 사용할 것입니다. 이어지는 의료 분야 사례에서 IBM은 원본 X선 이미지를 객체 스토리지에 저장하고 임베딩 및 사례 메타데이터만 Oracle에 저장합니다. 달라지는 것은 스토리지에 가해지는 부하인데, 이제 스토리지는 매우 다양한 I/O 프로파일을 가진 여러 워크로드를 동시에 처리하게 됩니다.
관계형 계층은 가장 익숙한 계층입니다. 초당 수백만 건의 4KB~16KB 크기의 임의 I/O 작업, 마이크로초 단위로 처리되어야 하는 행 조회 및 커밋, 리두, 언두 및 체크포인트 트래픽으로 인한 높은 쓰기 동시성, 그리고 사용자 인터페이스 애플리케이션이 대기하고 있기 때문에 예측 가능한 지연 시간을 보이는 특징이 있습니다. 오라클의 백업 유틸리티인 RMAN은 이와 정반대입니다. 첫 번째 워크로드에 영향을 주지 않고 정해진 시간 내에 작업을 완료하기 위해 여유 공간이 필요한 순차 스트림 방식입니다. 이 두 가지 유형 모두 잘 알려져 있으며, IBM의 스토리지 어레이는 이러한 유형에 맞게 최적화되어 있습니다.
벡터 계층은 대규모 벡터 임베딩 테이블로 인해 벡터 검색이 대역폭 집약적인 워크로드, 즉 대규모 순차 스캔처럼 보일 수 있기 때문에 특성을 규정하기가 더 어렵습니다. IBM은 Oracle 26ai 벡터 경로를 OLTP에 더 가깝게 특성화했습니다. 인덱스를 통과하는 각 단계는 약 4KB의 임의 읽기이며, 쿼리 경로는 IOPS에 의해 제한되고 지연 시간에 민감하며, 쓰기 작업은 별도의 데이터 수집 및 인덱스 구축 단계에서 수행되므로 읽기 작업이 대부분을 차지합니다.
인덱스를 구축하거나 코퍼스를 재임베딩할 때와 같이 트래픽이 급증하는 상황에서 대역폭이 중요해집니다. 이러한 급증은 대개 상당히 큰 규모로 발생합니다. 이러한 트래픽 분산이 혼합 I/O 문제의 핵심입니다. 쿼리 경로에서 벡터 워크로드는 트랜잭션과 동일한 큐를 두고 경쟁하므로 격리가 서비스 품질 문제로 작용합니다. 그리고 이러한 급증 단계에서 패브릭 대역폭이 한계에 도달하게 되는데, 이 글 후반부에서 32G와 64G 비교 결과가 이를 보여줍니다.
검증된 아키텍처
IBM과 브로드컴은 브로드컴의 콜로라도 AI 연구소에 이 검증을 위한 환경을 구축했습니다. 스토리지는 IBM FlashSystem 9000 시리즈 어레이로, IBM Storage Virtualize 9.1.3이 실행되며 24개의 FlashCore 모듈로 구성되어 있습니다. 이 어레이는 64G 파이버 채널 포트를 통해 두 대의 Brocade Gen 8 G820 SAN 스위치에 연결됩니다. 데이터베이스 호스트는 듀얼 소켓 Intel Xeon 6767P 서버이며, 2포트 Emulex LPe38102 64G SecureHBA 두 개가 장착되어 있습니다. 이 서버는 스토리지 경로에 GPU 없이 ASM 기반의 Oracle AI Database 26ai를 실행합니다. IBM Storage Insights가 어레이를 모니터링합니다.

해당 호스트에서만 BioASQ 1M 데이터셋을 사용하여 VectorDBBench로 패브릭 및 용량 결과, 32G와 64G 벡터 검색 비교, 그리고 풋프린트 측정을 수행했습니다. 동일한 구성으로 애플리케이션 워크로드도 처리했습니다. Supermicro 821GE-TNHR 서버(Xeon Platinum 8470 프로세서 2개, NVIDIA H100 80GB GPU 8개 탑재)에서 의료 애플리케이션과 언어 모델을 호스팅합니다. 소프트웨어 스택에는 Oracle의 데이터베이스 내 ONNX 임베딩, Llama 3를 지원하는 Ollama, 그리고 NVIDIA cuVS가 포함됩니다. Broadcom Tomahawk 5 스위치와 Thor 2 400GbE NIC가 두 서버를 연결합니다. I/O QoS, 멀티테넌시, 랜섬웨어 탐지 및 의료 애플리케이션 데모는 이 환경에서 실행되었습니다.

IBM에 따르면 FlashSystem 제품군( 5300 및 5600, 7300 및 7600, 9500 및 9600)은 동일한 Storage Virtualize 소프트웨어를 실행하며, I/O 스로틀링, 자동 영역 설정, 랜섬웨어 탐지, 정책 기반 고가용성(HA), 스토리지 파티션 마이그레이션을 포함한 여기에 설명된 기능은 동일한 코드 레벨에서 Oracle AI Database 26ai와 함께 동일하게 작동합니다. 성능 및 밀도는 모델 및 FlashCore 모듈 세대에 따라 다르므로 이 문서의 모든 수치는 측정된 시스템을 기준으로 합니다.
I/O QoS를 통해 최적의 OLTP 및 벡터 워크로드 성능 보장
IBM과 브로드컴이 가장 먼저 답을 찾고자 했던 질문은 모든 DBA가 프로덕션 어레이에 벡터 워크로드가 제안될 때 던지는 질문, 즉 코어 트랜잭션은 어떻게 처리되는가 하는 것이었습니다. IBM은 볼륨 수준 I/O 스로틀링(IBM이 I/O QoS라고 부르는 메커니즘)을 사용하여 FlashSystem 9000 시리즈 어레이에서 두 가지 데모를 실행했습니다. 데이터베이스는 30개의 볼륨에 걸쳐 구성되었습니다. 192명의 사용자를 대상으로 하는 Swingbench Order Entry 환경에서 OLTP 테이블스페이스(ORCL16~ORCL30)용 15개 볼륨과, 상위 k개 500개 유사도 쿼리를 실행하는 200스레드 합성 생성기 환경에서 벡터 테이블(ORCL31~ORCL45)용 15개 볼륨으로 구성되었으며, Storage Insights를 통해 각 볼륨 그룹의 상태를 차트로 시각화했습니다.
OLTP만 단독으로 실행될 때는 각 OLTP 볼륨의 처리량이 초당 20,500회로 일정하게 유지되었습니다. 벡터 생성기가 시작되자 벡터 볼륨의 처리량은 1분 이내에 각각 초당 약 73,000회까지 급증했고, OLTP 볼륨의 처리량은 약 13,000회로 감소하여 트랜잭션 측면에서 아무런 변화가 없음에도 불구하고 37%나 줄어들었습니다. 벡터 검색 경로는 트랜잭션과 동일한 블록 크기의 4KB 임의 읽기 방식이므로 동일한 큐를 사용하며 어레이가 제공하는 처리량을 그대로 사용합니다.

벡터 볼륨당 45,000 IOPS 제한, 한 줄 mkthrottle CLI에서 벡터 볼륨을 제한까지 끌어올리자 OLTP 처리량이 약 17,000 ops/s로 떨어졌습니다. 제한을 해제하자 상황이 반전되었고, 벡터 실행이 종료되자 OLTP 처리량은 20,500 ops/s로 돌아왔습니다. 대시보드에서도 동일한 현상이 집계되어 나타났습니다. 제한이 해제된 상태에서는 1.28만 IOPS, 제한치보다 약 950,000만 IOPS 낮은 수치를 기록했는데, 이는 몇 퍼센트 오차 범위 내에서 볼륨당 처리량에 30개 볼륨을 곱한 값과 거의 일치합니다.

두 번째 데모는 IBM이 실제 운영 환경에 배포할 것으로 예상하는 구성입니다. 먼저 벡터 볼륨당 45,000 IOPS, OLTP 볼륨당 20,000 IOPS로 제한을 설정한 후 두 워크로드를 동시에 실행했습니다. 벡터 볼륨은 제한 속도에 도달했고, OLTP 볼륨은 약 12,200 ops/s로 안정화되어 실행 시간 내내 안정적으로 유지되었습니다. 전체 어레이는 25% CPU 사용률에서 377마이크로초의 응답 속도와 6.9GB/s의 처리량으로 870,000 IOPS(읽기 800,000, 쓰기 70,000)를 처리했습니다. OLTP 제한은 워크로드 요구량을 초과하여 실제로 작동하지 않았습니다. 이는 어느 한쪽이 과부하되더라도 다른 쪽의 워크로드에 영향을 주지 않도록 하기 위한 것입니다.
Swingbench는 192명의 사용자를 대상으로 분당 약 1.19만 건의 트랜잭션(초당 약 19,500건의 TPS)을 실행 시간 동안 유지했습니다. 이 생성기는 최대 처리량을 달성하도록 최적화되었기 때문에 쿼리당 지연 시간은 애플리케이션 벤치마크가 아닙니다. 30분 동안의 실행에서 초당 19.8건의 속도로 총 35,672건의 쿼리가 완료되었으며, 중앙값 지연 시간은 약 10초, 99% 신뢰구간(p99)은 14.3초였습니다. 애플리케이션 타임아웃은 15초로 설정되었으며, 99건의 쿼리(0.28%)에서 타임아웃이 발생했지만 트랜잭션 처리에는 아무런 영향도 미치지 않았습니다.


FlashSystem 스로틀링은 호스트나 경로와 관계없이 어레이 전체에 적용되는 볼륨 상한선이며, 선택적으로 IOPS 제한과 함께 대역폭 제한을 설정할 수 있습니다. 이는 인접 어레이의 성능을 제한하며, 별도의 대역폭은 예약하지 않습니다. 이 상한선은 어레이 크기 조정을 통해 결정됩니다. 예를 들어, 45,000 IOPS의 벡터 볼륨 15개를 사용하는 경우 675,000 IOPS의 벡터 헤드룸이 확보되어 이 어레이의 OLTP 볼륨에 필요한 성능을 충분히 제공할 수 있습니다. 어레이 구성이나 종류에 따라 이 수치는 달라질 수 있습니다. 트랜잭션 지연 시간이 가장 긴 지점에 벡터 상한선을 설정하면, 벡터 워크로드는 그 이상의 성능을 모두 활용할 수 있습니다.
운영 중인 Oracle 볼륨에서 랜섬웨어 탐지
Sophos가 2024년에 랜섬웨어 공격을 받은 2,974개 조직을 대상으로 실시한 조사에 따르면, 94%가 공격자가 백업을 노리는 것을 목격했으며, 그 시도는 57%의 확률로 성공했고, 성공했을 경우 복구 비용은 평균 8배 더 높았습니다. IBM은 동일한 전제를 바탕으로 백업을 우선시하고 프로덕션은 그다음으로 고려하여 테스트를 진행했습니다. 데이터베이스 볼륨은 그대로 두고 RMAN 백업을 공격 대상으로 삼았습니다. RMAN은 백업 세트를 FlashSystem 볼륨에 기록하고, 랜섬웨어 시뮬레이터를 실행했으며, 호스트 에이전트를 개입시키지 않고 어레이가 자체적으로 공격을 감지하도록 했습니다.
탐지는 드라이브 내부에서 이루어집니다. FCM4 및 FCM5 FlashCore 모듈은 모든 쓰기 작업이 완료될 때마다 블록 크기, 주소 및 재기록 패턴과 함께 엔트로피 및 압축률을 계산하고, 2초마다 볼륨별 요약 정보를 Storage Virtualize(FCM 펌웨어 4.1 이상, 버전 8.6.3 이상) 내의 추론 엔진으로 전달합니다. 이 모델은 FlashSystem GUI 및 IBM Storage Insights Pro에 경고를 표시하고, Storage Defender 또는 SIEM으로 전달하며, 자체적으로 패치가 가능하므로 재학습된 모델은 펌웨어 업그레이드 없이 소규모 보안 업데이트로 제공됩니다.
분석은 모듈에서 실행되므로 호스트가 손상된 경우에도 계속 작동합니다. 암호화된 출력은 엔트로피가 높아 압축이 중단되는데, 공격자가 파일 확장자를 변경하거나, 블록 하나씩 건너뛰어 암호화하거나, 엔드포인트 에이전트를 피하기 위해 전송 속도를 늦추는 등의 방법을 사용하더라도 이러한 현상은 통계에 나타납니다.
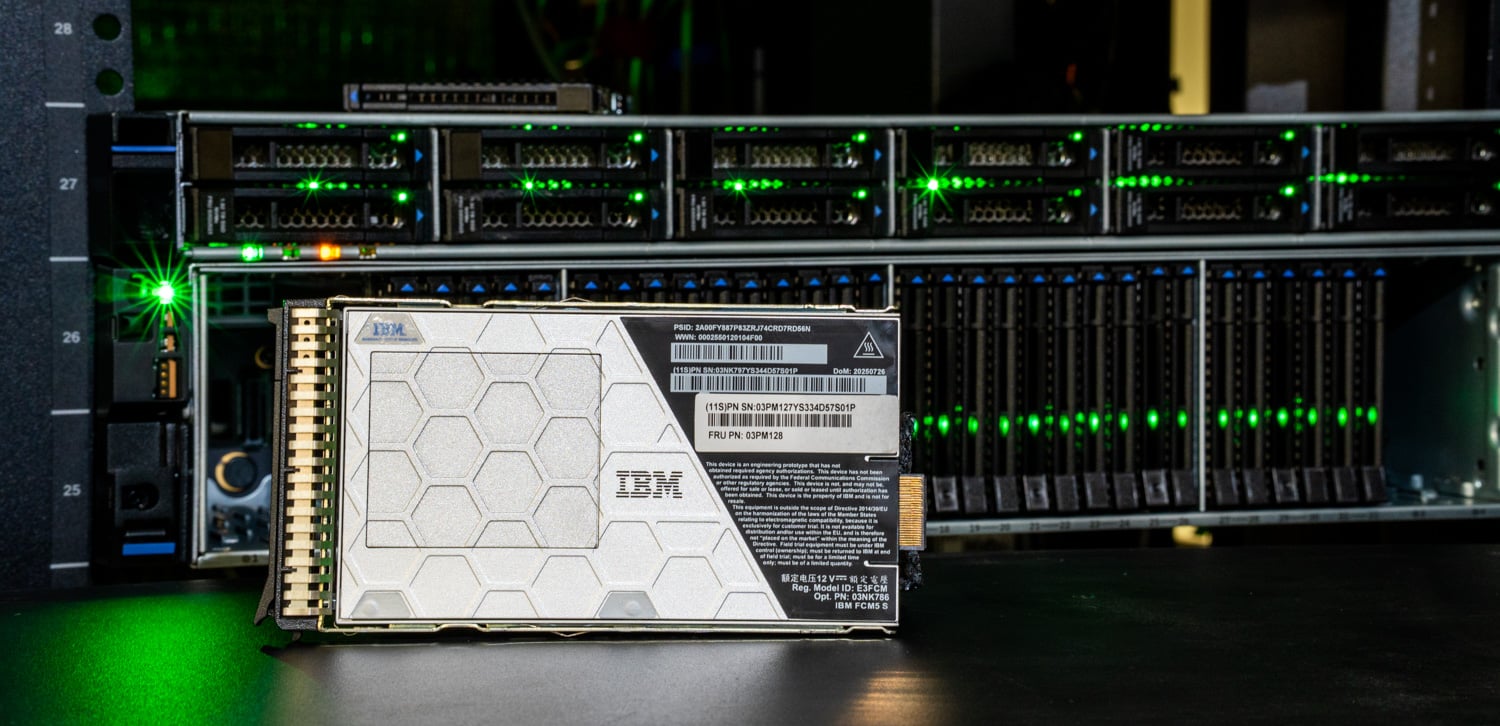
검증 과정에서 RMAN은 16개의 병렬 채널에 백업을 기록했으며, 각 백업 세트는 150GB로 제한되었습니다. 데이터베이스는 OLTP 및 벡터 데이터용으로 ASM 디스크 그룹당 15개의 200GB 디스크에 저장되었습니다. IBM은 해당 백업 대상에 대한 공격을 실행했고, 경고는 60초 이내에 Storage Insights에 도달했는데, 이는 IBM이 해당 기능에 대해 발표한 탐지 시간 범위 내입니다. Storage Insights는 볼륨 그룹의 모든 31개 볼륨에 경고를 표시했는데, 하나의 볼륨에 대한 경고는 전체 그룹을 위협으로 간주하기 때문입니다.
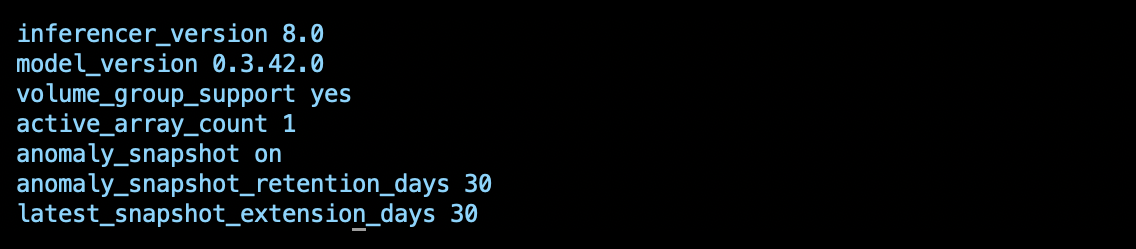
응답은 '보호된 복사본'이며, 어레이는 운영자 개입 없이 이를 처리했습니다. FlashSystem은 위협이 발생한 순간 해당 볼륨 그룹의 변경 불가능한 스냅샷을 생성하고 동시에 마지막으로 확인된 정상 스냅샷의 보존 기간을 연장했습니다. lsanomalydetection 배열에서 출력된 내용은 다음과 같은 구성을 보여줍니다. 추론 엔진 8.0, 모델 0.3.42.0, anomaly_snapshot 활성화, 새 스냅샷 보존 기간 30일, 그리고 마지막 정상 스냅샷 보존 기간 30일입니다. Storage Virtualize는 의심스러운 스냅샷을 표시하여 아무도 해당 스냅샷에서 복원하지 못하도록 하고, 암호화가 시작되기 전 시점의 깨끗한 복원 지점을 유지합니다.
이 패브릭에는 보안 계층도 포함되어 있습니다. 브로드컴은 브로케이드 8세대 패브릭에 양자 후 암호화 기술을 내장했고, 에뮬렉스 시큐어HBA는 호스트와 패브릭 간 전송 중인 데이터를 암호화하며, FCIA의 새로운 FC-SP-3 표준은 파이버 채널 전체에 대한 양자 컴퓨팅 대비 보안 기준을 설정합니다.
존닝 티켓 없이 SAN 확장: Broadcom 타겟 기반 존닝을 사용한 IBM FlashSystem 자동 존닝
일반적으로 파이버 채널 SAN에 호스트를 추가하려면 티켓을 발행하고 두 팀이 협력해야 합니다. 서버 관리자는 HBA WWPN을 수집하고, SAN 관리자는 두 패브릭 모두에 수동으로 영역을 구축하며, 스토리지 관리자는 호스트를 올바른 대상 포트에 매핑합니다. WWPN을 잘못 입력하면 새 Oracle RAC 노드에 경로가 할당되지 않을 수 있습니다. AutoZoning은 이러한 작업을 어레이로 옮깁니다. FlashSystem은 패브릭과 직접 통신하여 시작 WWPN을 식별하고 대상 포트를 선택한 다음, 스위치에 로그인할 필요 없이 자동으로 영역을 생성합니다.

이 기능은 Brocade Target Driven Zoning(TDZ)을 기반으로 하며 FlashSystem 소프트웨어 9.1.2 버전에 포함되었습니다. 이 기능을 사용하려면 Fabric OS 9.1.1 이상이 실행되는 Brocade 스위치가 필요하며, 패브릭 관리자가 FlashSystem 타겟 포트에 연결된 스위치 포트에서 TDZ를 활성화해야 합니다. 이 활성화 작업은 SAN 팀에서 담당하며, AutoZoning은 활성화가 완료될 때까지 포트에 아무런 조치를 취하지 않습니다. 활성화가 완료되면 FlashSystem은 피어 영역을 생성하여 호스트 이니시에이터가 타겟 포트에 접근할 수는 있지만 서로는 접근할 수 없도록 합니다. 이때 호스트 이니시에이터는 어레이 관리형임을 나타내는 예측 가능한 IBM_SV_ 이름을 사용합니다.
설정은 파이버 채널 포트 보기에서 시작됩니다. 이 보기에는 각 포트가 연결된 스위치, 포트의 AutoZone 지원 여부, 그리고 연결이 대칭인지 여부(즉, 모든 노드의 동일한 포트 ID가 동일한 패브릭에 연결되는지 여부)가 표시됩니다. 토폴로지 보기에서는 이러한 정보가 색상으로 표시되며, 활성화되어 있고 AutoZone을 지원하며 대칭인 포트만 녹색으로 표시됩니다. 비대칭 포트는 다른 조건이 충족되더라도 GUI에서 이중화 및 장애 조치 기능을 손상시킬 수 있다는 경고 메시지가 표시되므로 목록에서 제외됩니다.

호스트 생성은 FDMI를 통해 채워지는 구성되지 않은 호스트 목록에서 시작됩니다. FDMI는 각 HBA의 호스트 이름, 운영 체제 및 포트를 패브릭에 보고합니다. IBM의 안내에 따르면, 호스트 추가 대화 상자가 서버 이름, 운영 체제 및 아직 영역이 채워지지 않은 호스트의 두 HBA 포트와 함께 열렸습니다. 관리자는 호스트가 도달할 수 있는 대상 포트를 정의하는 AutoZone이 활성화된 포트 세트를 선택하고 추가를 클릭했습니다. FlashSystem은 대상 포트를 호스트 이니시에이터와 연결하고 두 스위치에 영역을 푸시했으며, 호스트는 두 개의 패브릭에 걸쳐 네 개의 경로를 통해 온라인 상태가 되었습니다.

Oracle의 경우, IBM은 AutoZoning 기능을 RAC 노드 추가 및 HBA 교체에 활용합니다. 이 기능은 호스트 또는 스토리지 연결 변경 사항을 추적하고 그에 맞춰 영역 정의를 자동으로 조정하므로, HBA를 교체하더라도 수동으로 영역을 재설정할 필요가 없습니다. 스토리지 파티션 마이그레이션이나 정책 기반 고가용성(PBHA)을 위해 호스트가 두 번째 어레이에 대한 경로가 필요한 경우에도 동일한 자동화 기능이 적용됩니다. TDZ를 활성화하기 전까지는 포트에서 아무런 작업도 수행되지 않으므로, SAN 팀은 어떤 대상 포트가 참여할지 여전히 제어합니다. 결과적으로 호스트 추가 시 더 이상 영역 변경을 기다릴 필요가 없습니다.
운영 범위: PBHA, 그리드 마이그레이션, 다중 테넌시 및 배치
정책 기반 고가용성(PBHA)은 메트로 네트워크 거리 내에 있는 두 개의 FlashSystem 어레이 간에 스토리지 파티션을 동기적으로 복제하며, 양쪽 사이트에서 액티브-액티브 호스트 액세스를 지원합니다. IBM은 이 기능이 RPO(복구 시점 목표) 0을 달성하고, 적절하게 클러스터링된 Oracle 배포 환경에서 데이터 손실 없이 스토리지 장애 조치를 견딜 수 있도록 설계되었다고 밝혔습니다. 장애가 발생한 사이트가 복구되면 데이터가 다시 동기화되고 워크로드가 중단 없이 다시 사용됩니다.
FlashSystem Grid 기능은 최대 32개의 FlashSystem 어레이를 하나의 관리 보기에서 통합 관리할 수 있도록 지원하며, 스토리지 파티션 마이그레이션을 통해 파티션, 해당 볼륨, 볼륨 그룹 및 호스트를 애플리케이션 다운타임 없이 한 어레이에서 다른 어레이로 이동할 수 있습니다. Oracle의 경우, IBM은 하드웨어 교체, 펌웨어 업데이트 전 시스템 데이터 드레인, 임베딩 세트 확장에 따른 용량 증가에 따라 벡터 파티션을 더 큰 용량의 시스템으로 이동하는 등의 사례를 예로 들었습니다. 시스템은 파이버 채널 또는 고속 이더넷을 통해 한 번에 하나의 파티션씩 마이그레이션할 수 있으며, 호스트는 파이버 채널, iSCSI 또는 NVMe/TCP를 통해 연결할 수 있습니다. 또한, PBHA로 이미 구성된 파티션은 마이그레이션 대상에서 제외됩니다.
Storage Insights 배치 어드바이저는 동일한 그리드에 대한 계획을 관리합니다. 워크로드의 용량, 성장률, I/O 프로필 및 목표 지연 시간을 입력받아 그리드의 모든 시스템에 점수를 매기고, 프로비저닝 전에 최적의 배치 위치를 순위별로 제시합니다. 또한 CPU 또는 IOPS 불균형이 감지되면 마이그레이션을 권장할 수도 있습니다. 마이그레이션과 배치 모두 Storage Insights Pro를 사용하며, 모든 그리드 시스템은 동일한 Storage Insights 테넌트에 등록됩니다.

멀티테넌시를 사용하면 DBA 팀과 AI 팀이 관리 권한을 공유하지 않고도 그리드를 공유할 수 있습니다. IBM의 실습 과정에서 관리자는 동일한 어레이에 두 개의 테넌트(Tenant_Scale 및 Tenant_oracle_ai)를 생성하고 각 테넌트에 시스템, 테넌트 역할을 가진 사용자 그룹, 그리고 첫 번째 사용자를 할당했습니다. 그런 다음 각 테넌트에 대해 별도의 볼륨 그룹, 볼륨 및 호스트 매핑을 사용하여 스토리지 파티션을 생성했습니다. GUI는 새 파티션이 생성되는 즉시 복제 구성을 제안합니다. Tenant_Scale 사용자로 로그인했을 때 GUI에는 해당 테넌트의 파티션과 리소스만 표시되고 Tenant_oracle_ai에 속한 내용은 전혀 표시되지 않았으며, Tenant_oracle_ai 측에서도 동일한 확인이 이루어졌습니다.
패브릭 이점: 벡터 검색을 통한 32G vs. 64G 파이버 채널 비교
IBM과 Broadcom이 이번 테스트에서 의도적으로 변경한 유일한 변수는 패브릭이었습니다. 동일한 어레이, 호스트 및 Emulex LPe38102 SecureHBA를 사용하여 BioASQ 1M 데이터셋(생의학 질의응답 코퍼스에서 추출한 100만 개의 1,024차원 벡터)에 대해 VectorDBBench를 두 번 실행했습니다. 한 번은 두 개의 HBA 포트를 32G로, 다른 한 번은 64G로 설정하여 동일한 Brocade G820 스위치를 통해 실행했습니다. 16개의 ASM 볼륨부터 4GB SGA까지 나머지 모든 구성 요소는 그대로 유지되었으므로 두 실행 간의 차이점은 파이버 채널 세대뿐입니다.

이 벤치마크의 검색 단계는 읽기 전용 스캔입니다. Oracle의 IVF_FLAT 인덱스는 각 쿼리를 파티션 클러스터로 라우팅하여 전체를 읽는데, 1,024차원의 FLOAT32 벡터를 사용하는 경우 상당한 대역폭 부하가 발생합니다. 32G 포트 두 개를 사용했을 때 호스트 측 읽기 속도는 6.3GB/s(포트 쌍의 회선 속도)로 안정화되었고, 검색 곡선은 20개의 스레드에서 초당 43.7개의 쿼리로 평탄해졌습니다. 동일한 호스트에서 64G 포트 두 개를 사용했을 때는 읽기 속도가 12.5GB/s에 달했고, 80개의 스레드에서 초당 85.0개의 쿼리까지 확장되어 동일한 스토리지 용량에서 처리량이 95% 증가했습니다.

지연 시간은 64G의 또 다른 측면을 보여줍니다. 스레드가 하나일 때는 두 패브릭의 지연 시간이 8% 이내의 차이를 보이며, 각각 0.107초와 0.099초입니다. 이는 단일 쿼리가 어느 한쪽 파이프라인을 완전히 채우지 않기 때문입니다. 하지만 스레드가 5개 이상일 때는 32G 패브릭에서 쿼리가 대기열에 쌓입니다. 평균 지연 시간은 매 단계마다 64G의 두 배로 증가하며, 스레드가 80개일 때는 p99 값이 4.08초에 달해 1.14초를 크게 웃돕니다. 포화된 FC 패브릭은 장애가 발생하는 것은 아니지만, 모든 쿼리가 대기열에 쌓이고, 이 대기 시간이 꼬리 지연 시간으로 나타납니다.

로드 단계도 달라졌습니다. 백만 개의 벡터를 수집하는 데 32G에서는 94.1초, 64G에서는 84.5초가 걸렸고, IVF_FLAT 인덱스 구축에는 108.4초에서 139.6초로, 속도가 느린 64G 환경에서 28.8% 더 오래 걸렸습니다. 따라서 총 로드 시간은 193.0초에서 233.7초로 증가했습니다. 재현율과 NDCG는 두 실행에서 0.1% 이내의 차이를 보였습니다(32G에서 83.81%와 84.42%, 64G에서 83.95%와 84.56%). 따라서 패브릭이 응답 속도에 영향을 미쳤음을 알 수 있습니다. 배포 이후 32G 환경에서 운영되어 온 데이터베이스의 경우, HBA 및 스위치 업그레이드는 성능 향상을 위한 확실한 기회입니다.
벡터 벡터 용량 증대를 위한 계획 수립
벡터 검색은 성능에 영향을 주기 전에 용량 계산 방식을 변경합니다. 임베딩은 소스 데이터 덩어리의 고정 너비 숫자 복사본이며, 텍스트의 경우 이 복사본은 일반적으로 원본 덩어리보다 큽니다. 예를 들어 1,000바이트의 구절은 데이터베이스가 이를 저장하기 위해 행을 추가하기 전에 4,096바이트 크기의 1,024차원 FLOAT32 벡터가 됩니다. 연구팀은 이를 벡터 스토리지 증폭이라고 부르며, 패브릭 비교에 사용된 것과 동일한 BioASQ 1M 데이터 세트에서 이를 측정했습니다.
백만 개의 벡터에 사용된 원본 텍스트의 크기는 0.90GB입니다. Oracle 26ai에서는 이 데이터가 약 0.3GB의 행 오버헤드를 포함하여 7.67GB 크기의 벡터 테이블로 변환되었고, IVF_FLAT 인덱스는 모든 벡터의 클러스터링된 복사본을 두 번째로 저장하고 약 4MB의 센트로이드 데이터를 추가하기 때문에 8.57GB의 용량을 더했습니다. SAN에 저장되는 영구 저장소의 크기는 16.24GB로, 원본 텍스트 크기의 18배에 달합니다. 여기에 Oracle이 필요로 하는 운영 공간(인덱스 구축 중 15~23GB의 TEMP 공간, 데이터 수집 중 4~8GB의 UNDO 공간, 약 15GB의 REDO 공간)까지 더해집니다.

승수는 임베딩 모델에 따라 달라집니다. 브로드컴은 동일한 방법을 사용하여 768차원 Cohere v3 모델(측정값 기준)을 소스 대비 4.8배, 384차원 MiniLM을 9.6배, 4,096차원 Mistral 모델을 32.5배로 추정했습니다. 청크 크기는 너비만큼 중요합니다. 긴 구간에 걸쳐 넓은 벡터를 사용하면 짧은 구간에 걸쳐 동일한 벡터를 사용할 때보다 증폭률이 낮아지기 때문입니다. 또한 양자화된 인덱스는 인덱스 점유율을 줄입니다.
이 모든 것은 FlashSystem이나 Oracle에만 국한된 것이 아닙니다. 증폭은 어레이가 바이트를 처리하기 전에 데이터베이스 내부에서 이루어지며, 모든 플랫폼의 모든 벡터 인덱스는 벡터 복사본을 보유하므로 GPU와 함께 벡터 프로젝트가 승인되는 날부터 용량 예산에 포함되어야 합니다. 어레이가 결정하는 것은 이러한 증가분을 얼마나 수용할 수 있는지입니다. IBM의 5세대 FlashCore 모듈은 모듈당 105.6TB까지 지원하며, 가장 큰 FlashSystem 모델의 2U 인클로저에 3.3PB의 원시 용량을 제공하고 IBM의 수치에 따르면 11.8PB의 유효 용량을 제공합니다. 따라서 벡터 계층은 파티션을 이동해야 하기 전까지 수년 동안 제자리에서 확장할 수 있습니다.
IBM이 제시하는 의료 애플리케이션용 사이징 모델은 이미지의 경우 정반대로 작동합니다. 100GB의 X선 이미지는 데이터베이스 내에서 약 2GB의 공간을 차지하는데, 이는 임베딩과 사례 메타데이터만 저장되기 때문입니다. 텍스트는 훨씬 더 많은 용량을 차지합니다. 100GB의 청크 처리된 임상 텍스트는 860GB에서 1.2TB에 이르며, 대부분 HNSW 인덱스 데이터입니다. 사이징 입력값은 청크 수와 모델 너비이며, 소스 코퍼스는 좋은 지표가 되지 못합니다. 또한 IBM의 경험에 따르면 임베딩은 행보다 압축률이 낮습니다(관계형 데이터의 2~4배 압축률에 비해 1.2~2배). 따라서 FlashCore Module 데이터 축소로 인한 용량 증가분 복구율이 낮고, 재임베딩을 수행할 때마다 TEMP 공간이 다시 필요합니다.
IBM의 실용적인 원칙은 실행하기 전에 측정하는 것입니다. 실제 코퍼스의 1~5%를 프로덕션 임베딩 모델과 청킹 설정으로 로드하고, 벡터당 실제 바이트 수를 측정한 다음, 선형적으로 확장하고, 모델, 차원 개수 또는 청킹 정책이 변경될 때마다 이 과정을 반복합니다.
엔드투엔드 AI 추론: 의료 분야 적용 사례
IBM은 이 검증을 위해 방사선과 및 소화기내과 보조 애플리케이션인 RAD-AI를 개발했습니다. 이는 실제 운영 환경과 유사한 요구 사항을 충족하는 샘플 애플리케이션으로, 본 논문에서는 앞부분에서 측정했던 것과 동일한 어레이 및 패브릭에서 완전한 추론 파이프라인을 구현하는 방법을 보여줍니다. 임상의는 환자의 나이, 성별, 주된 증상을 입력하고 흉부 X선 또는 내시경 이미지를 업로드하면, 아카이브에 저장된 가장 유사한 이전 사례들을 기반으로 구축된 구조화된 보고서를 받게 됩니다.
이 아카이브에는 NIH ChestX-ray14 데이터셋의 흉부 X선 이미지 112,120개와 HyperKvasir의 위장관 내시경 이미지 10,000개 이상이 저장되어 있으며, 여기에는 367개의 전체 내시경 비디오에서 추출한 프레임별 벡터를 포함하여 172,000개 이상의 사전 임베딩된 사례가 포함됩니다. 각 이미지는 Oracle AI Database 26ai 내에서 ONNX 런타임을 통해 실행되는 CLIP ViT-L/14 모델을 통해 768차원 벡터로 변환되므로, 임베딩은 해당 이미지를 포함하는 행과 동일한 트랜잭션 내에서 처리됩니다. 원본 이미지는 객체 스토리지에 유지되고, 벡터와 사례 메타데이터는 Oracle에 저장됩니다.

쿼리 시 Oracle은 아카이브 전체에서 코사인 거리를 이용한 근사 최근접 이웃 검색을 실행하고, 가장 유사한 사례와 해당 사례의 원래 소견, 진단 및 결과를 반환합니다. 이렇게 검색된 데이터 세트는 Supermicro 서버의 H100 GPU 중 하나에서 실행되는 Ollama에 의해 처리되는 Llama 3의 컨텍스트로 사용되어 보고서를 생성합니다. 보고서에는 임상 우선순위, 소견 요약, 순위가 매겨진 감별 진단, 권장 조치가 포함되며, 그 아래에 일치하는 사례 목록이 표시됩니다. 내시경 검사도 동일한 과정을 거쳐 임상 기록을 추가하고, 비디오의 경우 파이프라인은 프레임별로 영상을 삽입하여 위장관을 따라 병변의 이동을 추적할 수 있도록 합니다.
이 애플리케이션은 동일한 FlashSystem 볼륨에 대해 두 가지 워크로드를 실행합니다. 트랜잭션 워크로드는 로그인, 보고서 저장, 감사 로깅 및 세션을 처리하고, 벡터 워크로드는 임베딩 테이블과 사례 메타데이터 전반에 걸쳐 높은 팬아웃 무작위 읽기를 수행하여 I/O QoS 데모의 생성기 프로파일과 일치합니다. IBM의 배포 환경에서는 앞서 설명한 볼륨 스로틀이 설정되어 있어 배치 재임베딩 작업으로 인해 임상의가 사례에 입력하는 속도가 느려지지 않으며, 위에 설명된 랜섬웨어 탐지 및 파티션 마이그레이션은 이러한 볼륨에 변경 없이 적용됩니다.

리소스 집약적인 단계는 아카이브 구축입니다. IBM은 동일한 모델과 동일한 VECTOR(768, FLOAT32) 타겟을 사용하여 112,120개의 흉부 X선 이미지 전체 세트를 두 번 임베딩하여 이 단계를 측정했습니다. 호스트 CPU의 데이터베이스 내에서 ONNX 모델을 실행했을 때 파이프라인은 초당 3.41개의 이미지를 처리했으며, 이미지 임베딩당 0.272초가 소요되었고 전체 데이터 세트를 처리하는 데 9.1시간이 걸렸습니다. 모델을 두 번째 서버의 Oracle Private AI Services 컨테이너로 옮기자 처리량이 초당 8.55개의 이미지(이미지당 0.097초)로 향상되었고, 동일한 데이터 수집 작업은 3.6시간 만에 완료되었습니다.

이미지 전처리(이미지당 약 0.019초)와 Oracle 삽입(1밀리초 미만)은 두 실행 모두 동일했으므로 2.5배의 성능 향상은 전적으로 모델 실행 위치에서 비롯됩니다. Private AI Services 임베딩 서비스는 CPU ONNX 런타임에서 실행되므로 해당 서버의 H100은 이번 테스트에서 제외되었습니다. 성능 향상은 모델을 데이터베이스 호스트에서 분리함으로써 달성되었으며, 파이프라인에서 GPU가 차지하는 부분은 다음에 다룰 인덱스 구축입니다.
IBM은 콜로라도 연구소에서 이러한 수치를 측정했으며, 저희는 해당 테스트를 실행하거나 검토하지 않았습니다. 실질적으로 중요한 점은 아카이브를 처음 임베딩할 때와 모델 변경 후 다시 임베딩할 때마다 몇 시간이 걸리는 배치 작업이 수행되는 반면, 그 이후의 검색 작업은 CPU와 스토리지를 사용하여 밀리초 단위로 측정되는 작업이라는 것입니다.
동일한 컨테이너에서 인덱스 생성도 처리합니다. Oracle 26ai는 HNSW 빌드를 컨테이너의 벡터 인덱스 서비스로 전송할 수 있으며, 이 서비스는 GPU에서 NVIDIA cuVS를 사용하여 네이버 그래프를 구축한 후 완성된 인덱스를 데이터베이스로 반환합니다. 이후 검색은 GPU 개입 없이 실행됩니다. IBM의 기록에 따르면, 기본 HNSW 빌드(네이버 32개, efConstruction 200)는 데이터베이스에서 8.47초가 걸렸지만 오프로드를 적용했을 때는 2.26초로 3.7배 단축되었습니다. 이 실행은 소규모 데모 테이블을 사용했으므로 해당 구성에서 이 경로가 제대로 작동하는 것을 확인시켜 줍니다. 임상 규모에서의 성능 측정은 추가 연구가 필요합니다.
이 애플리케이션은 본 논문의 핵심인 분업 구조를 보여줍니다. GPU 서버는 언어 모델을 호스팅하고, 아카이브 구축 또는 재구축 과정에서 임베딩 및 인덱싱 서비스를 제공합니다. 데이터베이스는 벡터와 해당 벡터가 설명하는 레코드를 저장하고, 어레이와 패브릭은 검색 읽기 및 트랜잭션을 처리합니다. 검색 경로의 어떤 단계에서도 외부 API를 사용하지 않으며, 환자 데이터는 데이터 센터를 벗어나지 않습니다.
IBM은 개념 증명을 위해 의료 분야를 선택했지만, 이 패턴은 의료 분야에만 국한된 것이 아닙니다. X선 기록 보관소를 청구 내역, 유지 보수 기록 또는 제품 카탈로그로 바꾸더라도 동일한 세 가지 요소가 적용됩니다. 즉, 해당 기록 옆에 벡터를 저장하고, GPU 서버에서 생성하며, 하나의 어레이에서 검색 및 트랜잭션을 수행하는 방식입니다. 이미 보유하고 있는 데이터에 대해 추론을 실행하는 모든 산업 분야는 동일한 아키텍처를 기반으로 합니다.
다음에 오는 것
검증은 동일한 하드웨어에서 계속됩니다. 2단계에서는 추론 엔진의 KV 캐시를 GPU 메모리에서 동일한 파이버 채널 패브릭을 통해 FlashSystem으로 이동시켜 장기 컨텍스트 모델이 더 많은 작업 세트에 접근할 수 있도록 합니다. 이 시리즈의 다음 논문에서 해당 작업에 대해 다룹니다. IBM은 또한 콘텐츠 인식 새로 고침 파이프라인을 구축하고 있으며, IBM Storage Scale AFM과 Kafka를 사용하여 새 문서가 도착하는 즉시 데이터베이스 내 ONNX 벡터화에 공급함으로써 벡터 인덱스가 일괄 재삽입 없이 소스를 추적할 수 있도록 합니다. IBM은 또한 벡터 검색이 추가된 다른 멀티 모델 데이터베이스에도 동일한 스토리지 검증을 확장할 계획입니다.
2단계에서는 새로운 데이터에 대한 보안 계층도 적용됩니다. KV 캐시가 FlashSystem으로 이동하면 의료 모델의 작업 컨텍스트(환자 이력 포함)가 벡터 인덱스 및 거래 기록과 동일한 파이버 채널 링크를 통해 전송됩니다. Emulex SecureHBA는 호스트와 패브릭 간 전송 중인 데이터를 암호화하고, Brocade Gen 8의 양자 후 암호화 기술은 스위치 측을 보호합니다. 각 단계는 데이터가 암호화되지 않은 상태로 전송되는 경로를 추가하지 않고 패브릭에 워크로드를 추가합니다.
순위표: IBM의 베스트 스토리지 어레이 페이지 프로필에 이제 스토리지 스케일과 함께 플래시시스템 블록 스토리지가 포함되었습니다.
이 보고서는 Broadcom의 후원을 받습니다. 이 보고서에 표현된 모든 견해와 의견은 고려 중인 제품에 대한 우리의 편견 없는 견해에 기초합니다.



 아마존