

NVIDIA DGX Spark에 대한 이야기가 나오면 항상 두 가지가 먼저 언급됩니다. 첫 번째는 핵심 사양입니다. 약 4,000달러짜리 데스크톱 장비에 128GB의 통합 메모리가 탑재되어 있다는 점인데, 불과 2년 전만 해도 엔지니어의 책상 위에 놓일 거라고는 상상도 못 했을 수치입니다. 두 번째는 장비 후면에 있는 200GB 네트워크입니다. 데스크톱 장비에 진정한 데이터센터급 네트워크 패브릭이 탑재되었다는 점이 사람들의 관심을 끄는 이유입니다. 이는 단순히 속도가 빠른 단일 워크스테이션 이상의 의미를 내포합니다. Spark를 물리적으로 연결하고 복제하여, 과거에는 랙에서만 가능했던 멀티 노드 구성을 구현할 수 있다는 것을 의미합니다.
이 리뷰에서는 해당 기능을 살펴봅니다. 저희는 보유하고 있는 세 가지 OEM Spark 구현체를 200Gb 패브릭으로 연결된 2노드 클러스터로 구성하고, 다양한 모델 변형과 세 가지 워크로드 형태를 적용하여 분산 추론 성능을 벤치마킹했습니다. 또한, NVIDIA의 기본 권장 사항과는 다른 방식으로 모델을 두 서버에 분산 배치하는 방법을 의도적으로 선택했으며, 그 타당성을 데이터로 뒷받침합니다. 하지만 그 모든 것에 앞서, 클러스터링을 가능하게 하는 네트워크 구조와 사용자가 클러스터링을 사용하거나 사용하지 않을 이유라는 두 가지 중요한 맥락을 먼저 고려해야 합니다.
200GB 패브릭
저희는 기존 DGX Spark 리뷰에서 네트워킹 구현에 대해 자세히 다뤘지만, 이 리뷰의 모든 내용이 기본에 기반하므로 다시 한번 설명드리겠습니다. 모든 Spark 후면에는 NVIDIA ConnectX-7 SmartNIC이 내장된 두 개의 QSFP56 슬롯이 있습니다. 이론상으로는 두 개의 슬롯을 통해 총 400Gbps의 연결 속도를 제공하는 것처럼 보이지만, 실제 최대 대역폭은 PCIe에 있습니다. ConnectX-7은 Gen5 x4 링크 두 개 뒤에 위치하며, 슬롯 연결 방식과 관계없이 플랫폼의 유효 대역폭은 최대 200Gbps입니다. 하나의 QSFP56 슬롯만 사용해도 플랫폼이 지원하는 최대 200Gbps 속도를 사용할 수 있으므로, 두 번째 포트는 추가적인 처리량 확보보다는 토폴로지 유연성을 위한 것입니다.
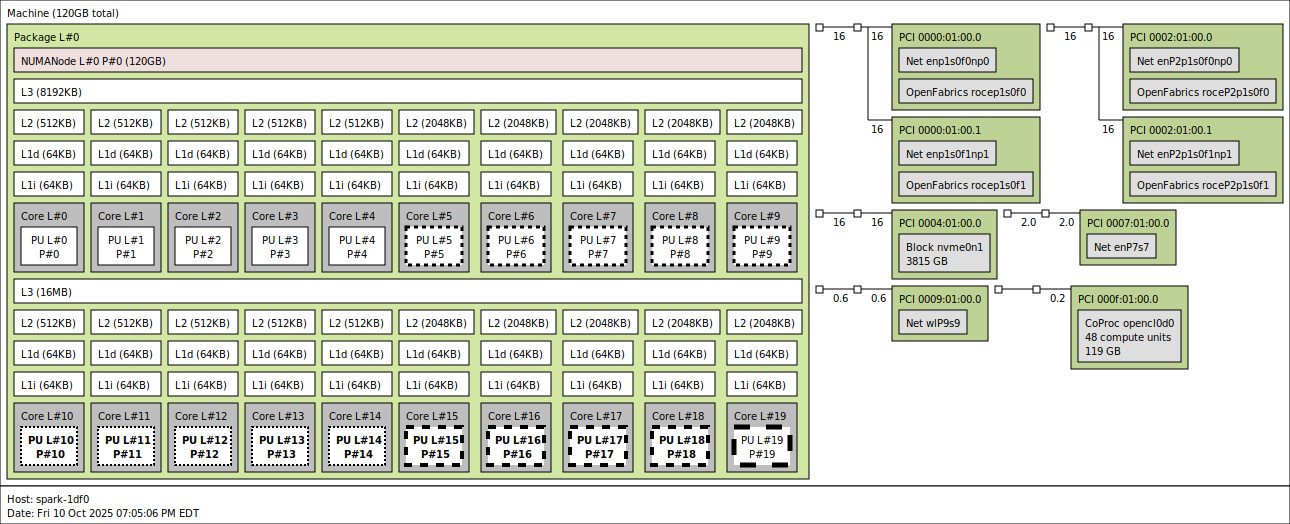
이러한 유연성은 세 가지 일반적인 구성에서 나타납니다. 가장 간단한 구성은 Spark 간 직접 연결에 사용되는 단일 200Gb 포트로, NVIDIA에서 검증한 2노드 구성이며 본 리뷰에서도 사용한 구성입니다. 두 번째는 스위치 없이 Spark 간에 링 형태의 토폴로지를 구성하기 위해 두 개의 100Gb 포트를 사용하는 구성입니다. 세 번째는 역할을 분할하는 구성으로, 하나의 케이지는 클러스터링을 위해 다른 Spark에 연결되고 다른 케이지는 NVMe-oF를 통한 고속 스토리지에 연결됩니다. 이 구성은 작업 데이터 세트가 Spark의 내부 NVMe에 맞지 않을 때 유용합니다.
NVIDIA는 Spark를 네트워크 사용 방식에 맞춰 세 가지 구성으로 판매합니다. 개별 데스크톱 작업을 위한 단일 Spark, 확장 모델을 위해 200Gb 패브릭을 통해 직접 연결된 검증된 2개의 Spark 클러스터, 그리고 올해 GTC에서 NVIDIA가 2노드 한계를 넘어서는 사용자 요구에 부응하여 공개한 4개 Spark 구성이 있습니다. NVIDIA가 적극적으로 마케팅하는 구성이자 대부분의 사용자가 실제로 사용할 구성이며, 이 하드웨어에서 프로덕션 수준의 추론을 위한 합리적인 상한선이라고 생각하는 구성도 바로 이 2개의 Spark 구성입니다. 또한 이 리뷰에서는 이 구성을 대상으로 엔드 투 엔드 벤치마크를 진행합니다.
애초에 클러스터 스파크가 존재하는 이유는 무엇일까요?
Spark 클러스터링의 가장 명백한 이유는 다른 클러스터와 마찬가지로 단일 128GB 서버로는 중요한 모든 모델을 처리할 수 없기 때문입니다. 120억 개의 파라미터를 가진 모델을 두 대의 서버에 분산시키면 기존 방식으로는 처리할 수 없었던 다양한 워크로드를 처리할 수 있게 됩니다. 이것이 바로 Spark 클러스터링의 핵심적인 사용 사례이며, 가장 많이 시연되는 부분이기도 합니다.
덜 명확하지만, NVIDIA의 실제 고객층에게 있어 이 플랫폼에서 더욱 중요한 이유는 바로 학습입니다. NVIDIA는 Spark를 진입점으로 포지셔닝합니다. 공식 문서 , 샘플 노트북, 파트너 플레이북은 Spark를 교육용 장비로 활용합니다. 로컬 채팅 인터페이스 뒤에서 사전 구축된 모델을 실행하는 것부터 호스팅된 엔드포인트에 대한 코딩 어시스턴트 실행, 소규모 모델 미세 조정, PyTorch 및 JAX를 사용한 엔드투엔드 애플리케이션 구축에 이르기까지 모든 것에 대한 훌륭한 가이드를 제공합니다. NVIDIA의 핵심 메시지는 CUDA 커널을 한 번도 작성해 본 적이 없는 사람도 주말 동안 책상에서 작동하는 AI 워크플로우를 구축할 수 있다는 것이며, 머신러닝 분야가 아닌 엔지니어들도 완벽하게 제어할 수 있는 자체적인 샌드박스를 원할 때 동일하게 적용됩니다. 두 개의 Spark 클러스터는 이러한 교육 환경을 멀티 노드 환경으로 확장합니다. 이제 사용자는 실제 네트워크 환경에서 텐서 병렬 처리, 파이프라인 병렬 처리, 집단 통신 라이브러리가 실제로 어떻게 작동하는지, 그리고 실제 병목 현상을 어떻게 드러내는지까지 학습할 수 있습니다.
하지만 NVIDIA의 어떤 홍보 자료에서도 눈에 띄게 빠져 있는 것은 Spark가 프로덕션 추론 서비스에 적합하다는 주장입니다. 젠슨은 지난 몇 년간 거의 모든 기조연설에서 하드웨어-소프트웨어 공동 설계에 대해 이야기해 왔으며, 이 원칙은 Spark에도 적용됩니다. 모든 NVIDIA 플랫폼은 특정 워크로드 형태에 최적화되어 있으며, Spark는 개별 탐색 및 학습에 최적화되어 있지 트래픽 처리에 최적화되어 있지 않습니다. 이전 Spark 리뷰에서 이미 대부분의 추론 작업에서 플랫폼이 메모리 대역폭에 크게 제약을 받는다는 것을 보여주었으며, 클러스터링 시 네트워크 제약은 더욱 심화됩니다. 데스크톱 환경에서는 인상적인 200Gb 링크 하나조차도 단일 섀시 내의 PCIe Gen5 x16 연결보다 상당히 느리며, NVLink로 연결된 데이터센터 GPU 쌍에서 원활하게 작동하는 집단 통신 패턴은 200Gb 패브릭으로 옮겨갈 때 상당한 지연 시간 손실을 초래합니다.
NVIDIA가 오랫동안 공식 지원 구성을 Spark 2대로 제한했던 진짜 이유는 바로 이것이며, GTC에서 선보인 4대 유닛 시연이 자연스러운 제품 확장이라기보다는 사용자 요구에 대한 응답이었던 이유이기도 합니다. 소프트웨어 스택은 4개 또는 8개의 노드에서 실행될 수 있으며, 여러 사용자와 매체에서 더 큰 클러스터에 대한 결과를 발표했습니다. 하지만 이러한 실험에서 얻은 성능 수치는 일반적으로 만족스럽지 않습니다. 노드 간 연결 비용이 주요 비용이 되고, 전체 성능이 급격히 저하될 뿐만 아니라, 클러스터 구성의 한계에 다다르면 클러스터를 사용할 만큼 충분히 큰 모델의 경우 사용자당 처리량이 초당 한 자릿수 토큰 수준으로 떨어질 수 있습니다. 이 시점에서는 해당 구성이 서비스 플랫폼이라기보다는 사실상 학습 연구실에 가까워집니다.
그렇다고 해서 클러스터링을 폄하하려는 의도는 전혀 없습니다. Spark 클러스터링은 수십만 달러에 달하는 데이터센터 하드웨어에 의존해야만 가능한 분산 추론 및 학습에 대한 직관을 기르는 데 있어 정말 훌륭한 방법이며, 직접 소유한 시스템에서 파이프라인 버블, 모든 리듀스 병목 현상, 병렬 처리 간의 상충 관계를 직접 확인할 수 있다는 교육적 가치는 매우 큽니다. 저희는 후속 연구로 10억 개 또는 그 미만의 파라미터를 가진 소규모 모델을 듀얼 Spark 클러스터에서 처음부터 학습시켜 실제 분산 사전 학습 실행 환경과 최대한 유사한 조건을 만들어, 이러한 유형의 클러스터가 어떤 경우에 적합하고 어떤 경우에 적합하지 않은지 정확히 보여주고자 했습니다. 하지만 현재 다른 연구 과제를 진행하고 새로운 800Gb 랩 코어 스위치용 광케이블이 도착하기를 기다리는 동안 해당 프로젝트는 잠시 보류 중입니다. 랩 구축이 완료되면 다시 검토할 예정입니다.
다음에서는 듀얼 Spark 구성이 가장 적합한 사용 사례, 즉 두 개의 Spark 서버가 모두 필요한 대규모 모델의 분산 추론에 초점을 맞추고, 현재 확보한 세 가지 OEM 구현 모두에서 벤치마킹 결과를 제시합니다. 모델별 수치를 살펴보기 전에, 다음 섹션에서는 NVIDIA 공식 문서에서 기본적으로 제시하는 텐서 병렬 구성이 아닌 파이프라인 병렬 구성으로 수치를 보고하는 이유를 설명합니다.
성능 시험
파이프라인 병렬 처리를 보고하고 텐서 병렬 처리를 보고하지 않는 이유는 무엇일까요?
NVIDIA에서 발행한 DGX Spark 가이드 와 대부분의 참고 자료는 두 개의 Spark 서버에 걸쳐 모델을 확장하는 방법을 설명하기 위해 텐서 병렬 처리(TP)를 사용합니다. TP는 모든 행렬 곱셈을 두 GPU에 분산시켜 각 레이어가 두 장치에서 동시에 실행되도록 하고, 각 어텐션 및 MLP 블록 후에 전체 리듀스(all-reduce)를 통해 부분 결과를 결합합니다. 파이프라인 병렬 처리(PP)는 다른 방식을 사용합니다. 모델을 레이어별로 절반으로 나누어 첫 번째 절반은 한 서버에, 두 번째 절반은 다른 서버에 배치한 다음 활성화 값을 두 서버 간에 스트리밍합니다. 각 요청은 여전히 전체 모델을 거치지만, 특정 시점에는 한 서버에서만 해당 토큰에 대한 계산을 수행하고 다른 서버에서는 다음 마이크로배치를 처리합니다.
절충점은 네트워크를 통해 전송되는 데이터에 달려 있습니다. 듀얼 Spark 스택은 ConnectX-7 200GbE 링크를 통해 두 시스템을 연결하는데, 이는 네트워크 링크로서는 빠르지만 단일 Spark 내의 메모리 대역폭과 비교하면 느립니다. TP의 all-reduce는 트랜스포머 레이어당 두 번씩 실행되므로, TP=2로 실행되는 80레이어 모델은 출력 토큰 하나당 160번의 박스 간 데이터 교환을 발생시키고, 이러한 교환은 매번 다음 연산을 차단합니다. 반면 PP=2는 모델의 두 부분 사이의 경계에서 토큰당 한 번만 활성화를 전달합니다. 상당한 지연 시간이 발생하는 200GbE 링크에서는 이러한 차이가 다른 모든 요소를 압도합니다.
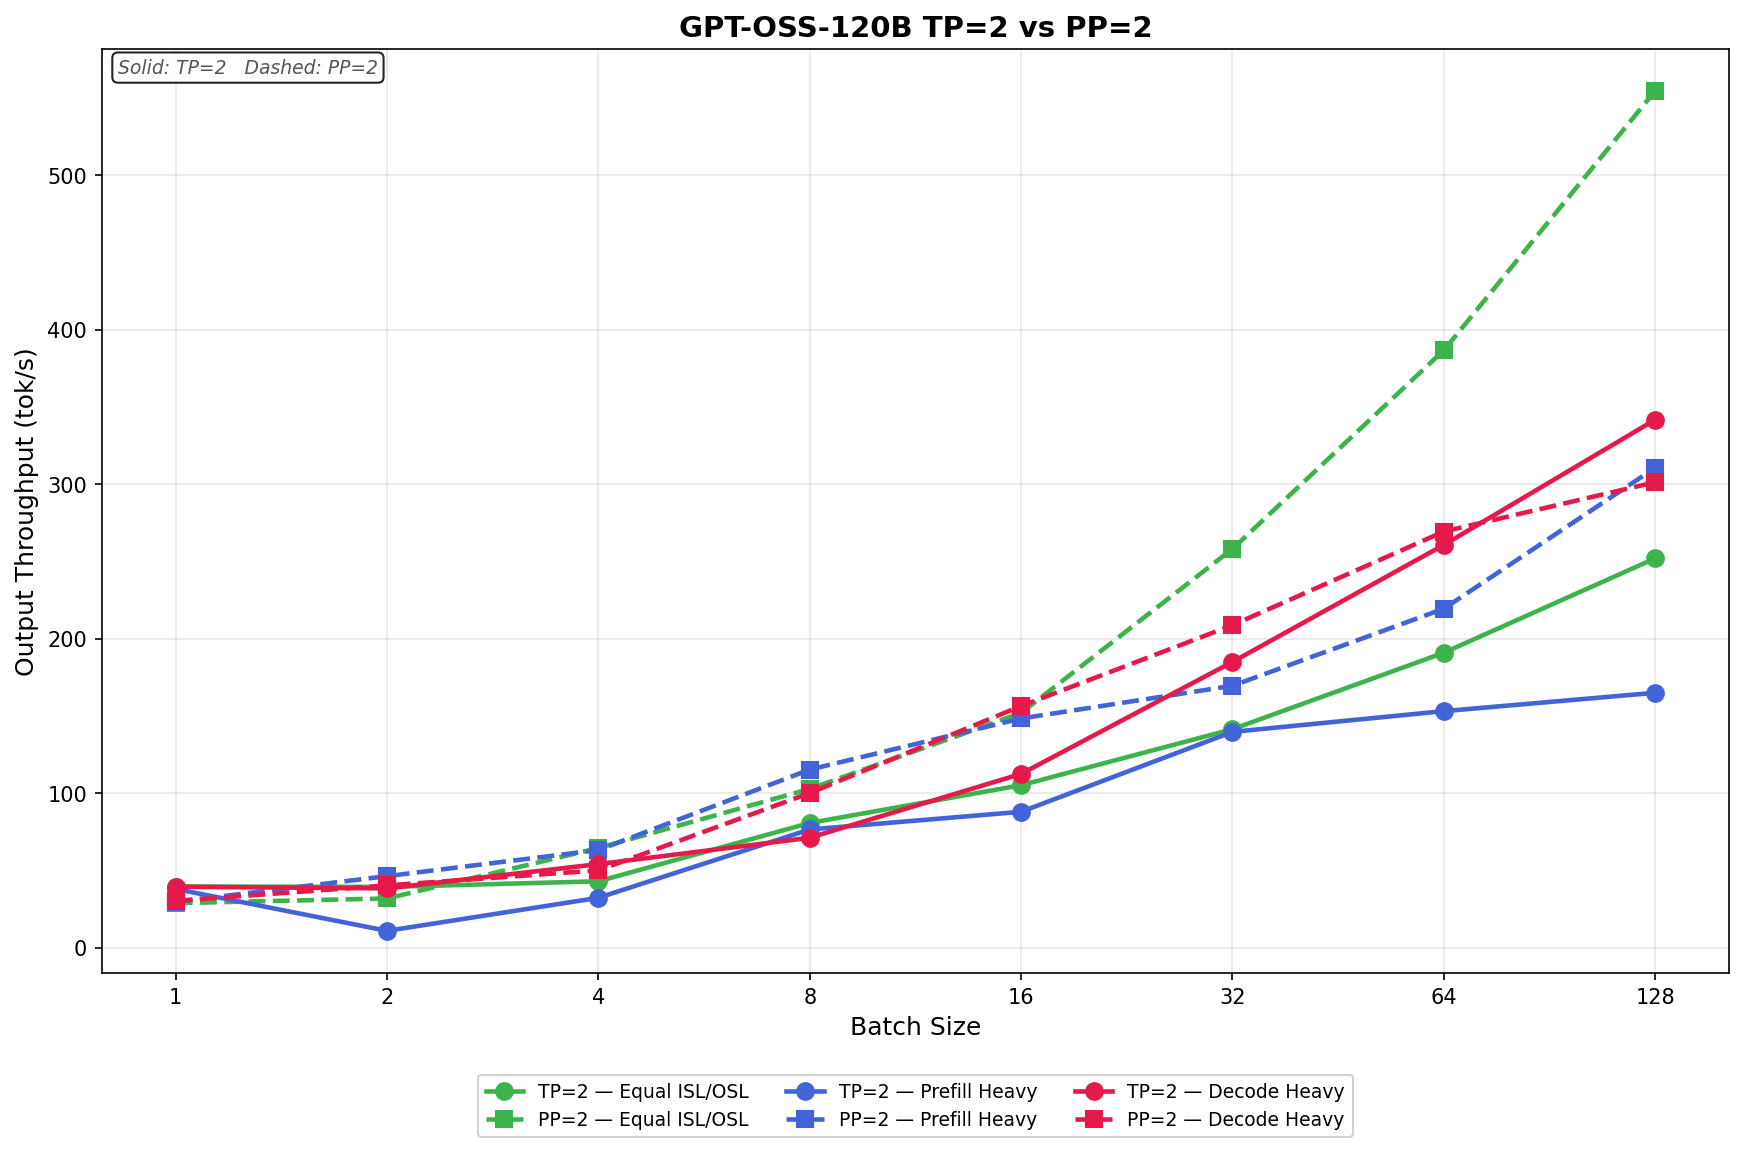
GPT-OSS-120B 측정 결과는 이를 명확히 뒷받침합니다. 배치 크기가 1인 경우를 제외하고, 워크로드가 너무 적어 두 전략의 오버헤드를 숨길 수 없는 상황에서는 PP=2가 우위를 점하고 동시 처리량이 증가함에 따라 그 격차를 유지합니다. ISL/OSL이 동일한 워크로드에서 TP=2는 배치 크기 128에서 252.01 tok/s에 도달하는 반면, PP=2는 동일한 하드웨어에서 554.69 tok/s까지 상승하여 2.20배의 우위를 보입니다. Prefill Heavy 시나리오에서도 비슷한 양상을 보이며, PP=2는 310.63 tok/s, TP=2는 164.99 tok/s를 기록했습니다. Decode Heavy 시나리오는 세 가지 시나리오 중 가장 근접한 결과를 보이지만, PP=2는 배치 크기 8부터 64까지 여전히 우위를 유지하며, 8K 길이의 출력으로 인해 파이프라인 버블 비용이 증가하는 배치 크기 128에서만 약간의 격차를 보입니다.
TP=2는 특정 상황에서만 유리한 성능을 보입니다. 모든 시나리오에서 배치 크기가 1일 때, TP는 작지만 확실한 우위를 제공합니다. Equal 시나리오에서는 39.55 tok/s 대 28.79 tok/s, Prefill Heavy 시나리오에서는 37.97 tok/s 대 29.60 tok/s, Decode Heavy 시나리오에서는 39.42 tok/s 대 30.28 tok/s의 성능을 보입니다. 처리 중인 요청이 하나뿐인 경우, 유휴 파이프라인 단계를 계속 바쁘게 유지할 두 번째 마이크로배치가 없으므로, PP는 매 단계마다 빈 슬롯에 대한 비용을 지불하는 반면, TP는 존재하는 유일한 토큰에 대해 두 개의 GPU를 모두 사용할 수 있습니다. 이것이 바로 NVIDIA의 TP 가이드라인이 설계된 환경입니다. 즉, 첫 번째이자 유일한 요청의 지연 시간이 전체 처리량보다 중요한 대화형 단일 스트림 서비스 환경입니다. 배포 환경이 진정한 채팅 스타일이고, 박스당 사용자가 한 명이며, TTFT(Time To First Time) 목표가 엄격한 경우 TP=2가 적합하며, 이는 NVIDIA가 Spark를 바라보는 관점과도 일치합니다.
배치 추론과 다수의 동시 요청이 발생하는 대규모 인프라 서비스 워크로드의 경우, 특히 Expert Parallelism과 같은 전략을 사용하지 않을 때는 Pipeline Parallelism이 서버 간 확장에 더 적합합니다. 200GbE 패브릭은 컴퓨팅 자원을 유휴 상태로 두지 않고 TP의 토큰별 all-reduce 트래픽을 처리할 수 없으며, 배치 크기가 4 또는 8이 되면 PP의 버블 비용이 안정적인 스트림에 녹아들어 사라집니다. 따라서 이 글의 나머지 부분에서는 모든 모델별 수치를 TP=1, PP=2로 설정하여 보고합니다. 이는 실제 작업을 수행할 때 듀얼 Spark 배포 환경에서 제공할 수 있는 성능을 나타내는 구성입니다.
저희는 의도적으로 GPT-OSS-120B를 TP와 PP의 성능 차이를 보여주는 대표적인 차트로 선택했습니다. 하지만 모든 모델에서 이러한 결과가 나타나는 것은 아니며, 이러한 매개변수들이 모델의 특성에 따라 달라진다는 점도 보여드리고자 합니다. BF16의 Llama-3.1-8B-Instruct 모델은 훨씬 더 안정적인 결과를 보여줍니다. 이 모델은 크기가 작아서 각 레이어의 계산 속도가 빠르고, 따라서 TP의 모든 리듀스 트래픽도 상대적으로 적습니다. 반면, PP의 단계별 조정 비용은 모델 크기에 관계없이 고정되어 있습니다. 결과적으로 TP=2가 거의 전체 배치 스윕에서 선두를 유지합니다. Equal ISL/OSL에서 TP=2는 배치 크기 1(23.2 vs 13.4 tok/s)부터 배치 크기 32(388.7 vs 349.3 tok/s)까지 PP=2를 앞서며, 배치 크기 64(524.8 vs 638.2 tok/s)와 배치 크기 128(679.2 vs 1,047.1 tok/s)에서만 우위를 내줍니다. Prefill Heavy에서도 동일한 패턴이 나타나는데, 배치 크기 32까지는 TP=2가 앞서다가 64와 128에서 PP=2가 우위를 점합니다. Decode Heavy에서 가장 확실한 우위를 보입니다. TP=2는 모든 배치 크기에서 PP=2를 제치고 128 배치에서 366.7 tok/s를 기록했습니다(PP=2는 330.5 tok/s).
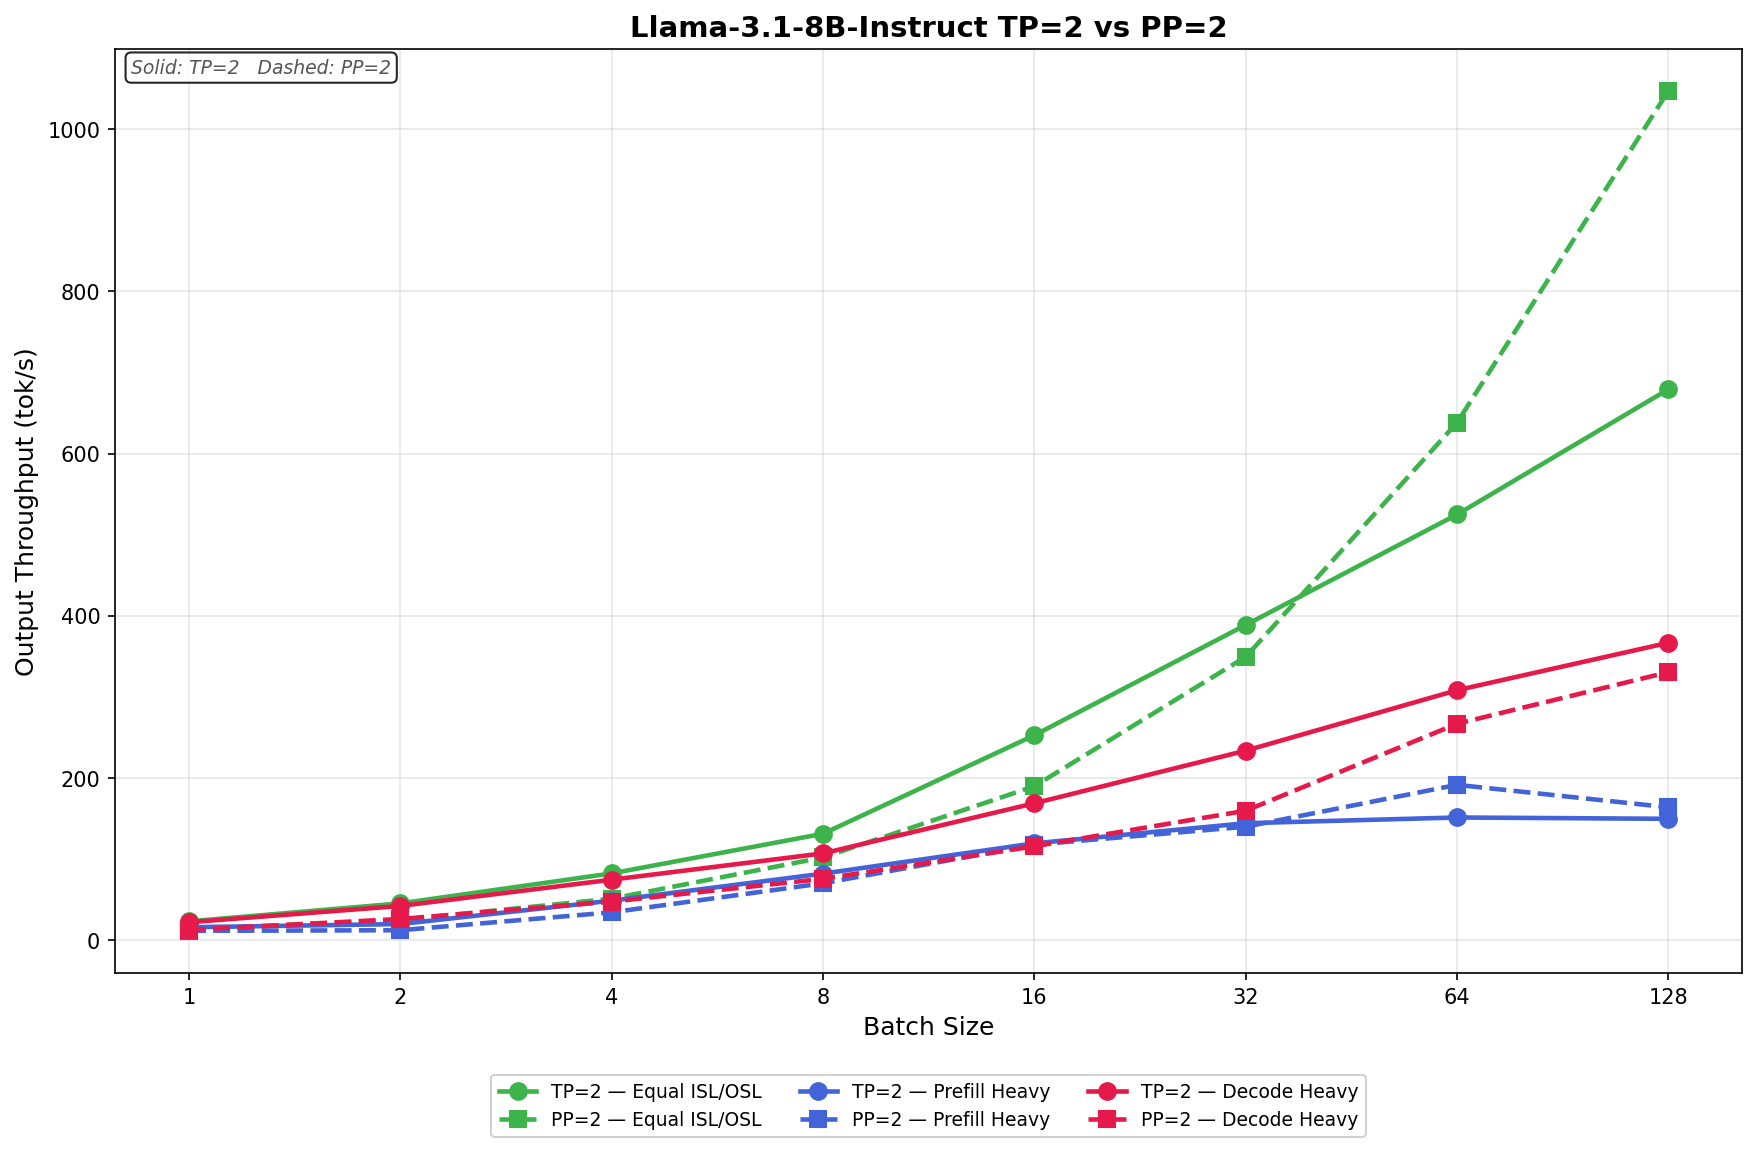
이 반례는 근본적인 메커니즘을 반박하기보다는 오히려 강화합니다. PP=2는 배치 크기가 파이프라인을 가득 채우고 버블 비용을 완전히 상쇄할 만큼 충분히 클 때, 그리고 모델 자체가 TP의 레이어별 전체 리듀스 비용이 저렴할 만큼 충분히 작을 때만 승리합니다. 이러한 교차점은 점점 더 뒤로 밀려납니다. 디코딩 중심 모델 결과 또한 일관적입니다. 출력 시퀀스가 길어질수록 디코딩 단계가 많아지고, 파이프라인 버블 비용이 연속적으로 더 많이 상쇄되며, PP가 차이를 만회할 수 있는 기회가 줄어듭니다. 즉, 배치 크기 128에서 GPT-OSS-120B에 대해 PP가 2.20배의 승리를 거두는 것과 동일한 물리적 원리가 8B 모델에서 PP가 상위 두 배치 크기에서만 승리하고 디코딩 중심 모델에서는 결코 승리하지 못하는 이유를 설명합니다.
GPT-OSS-120B
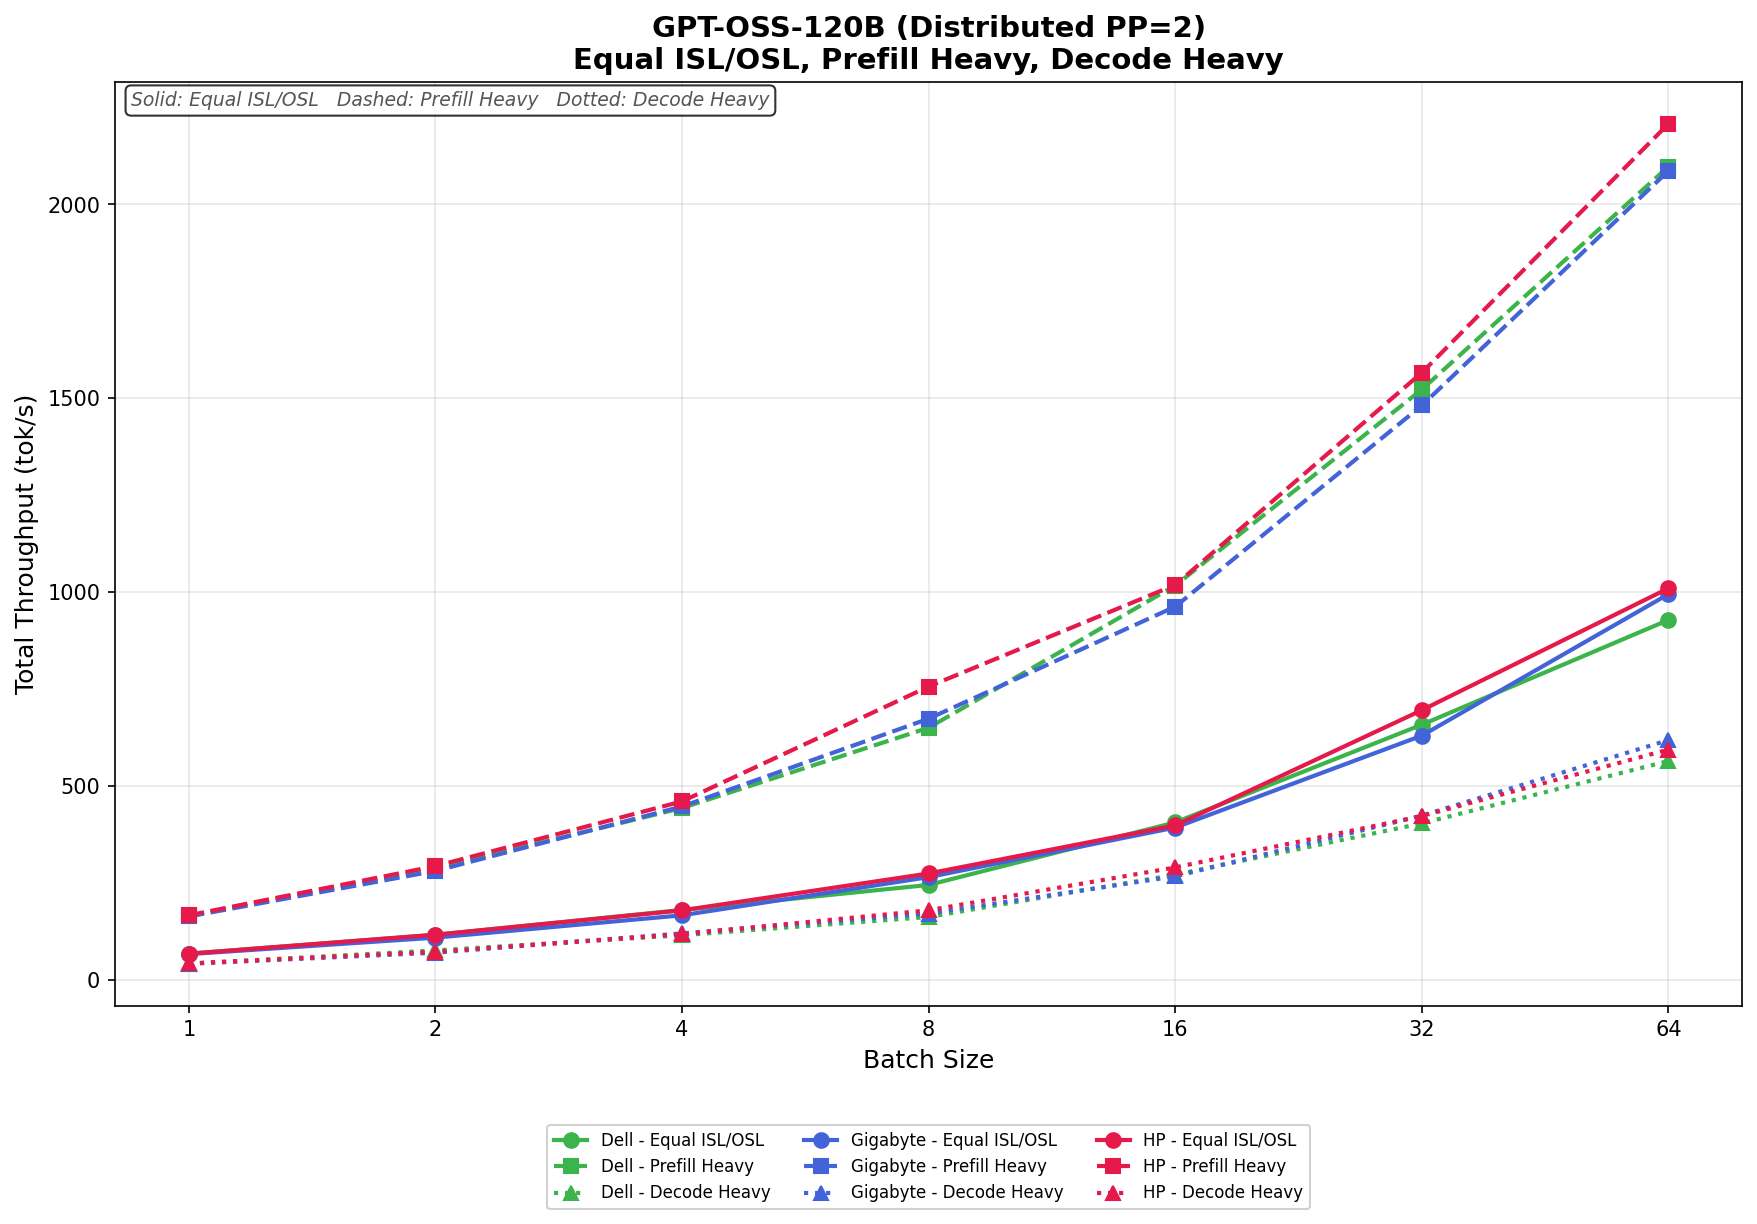
동일 ISL/OSL 조건에서 Dell은 67.06 tok/s로 시작하여 배치 크기 64에서 927.93 tok/s까지 확장됩니다. GIGABYTE는 65.77 tok/s로 약간 낮은 속도로 시작하지만 994.53 tok/s로 더 강력한 성능을 보이며, HP는 1,009.75 tok/s로 최고 속도를 기록했습니다. 대부분의 구간에서 성능 차이는 크지 않았지만, 배치 크기 32부터 HP가 앞서나가기 시작했습니다.
Prefill Heavy 테스트에서 처리량은 전반적으로 훨씬 더 가파르게 증가했습니다. Dell은 164.42 tok/s에서 2,097.80 tok/s로, GIGABYTE는 162.96 tok/s에서 2,086.72 tok/s로 향상되었으며, HP는 165.95 tok/s에서 2,208.16 tok/s로 가장 뛰어난 결과를 보여주었습니다. HP는 거의 모든 배치 크기에서 선두를 차지했으며, Dell과 GIGABYTE는 특히 배치 크기 32와 64에서 매우 근접한 성능을 보였습니다.
디코딩 부하가 높은 환경에서는 예상대로 전반적인 성능이 저하됩니다. Dell은 41.20 tok/s에서 563.98 tok/s 사이의 성능을 보이고, GIGABYTE는 40.83 tok/s에서 617.96 tok/s 사이의 성능을, HP는 41.63 tok/s에서 593.56 tok/s 사이의 성능을 보입니다. 배치 크기가 64일 때 GIGABYTE가 가장 우수한 성능을 나타냈고, HP는 중간 범위에서 선두를 차지했으며, Dell은 높은 동시 처리량에서도 비슷한 성능을 유지했지만 약간 뒤처졌습니다.
GPT-OSS-20B
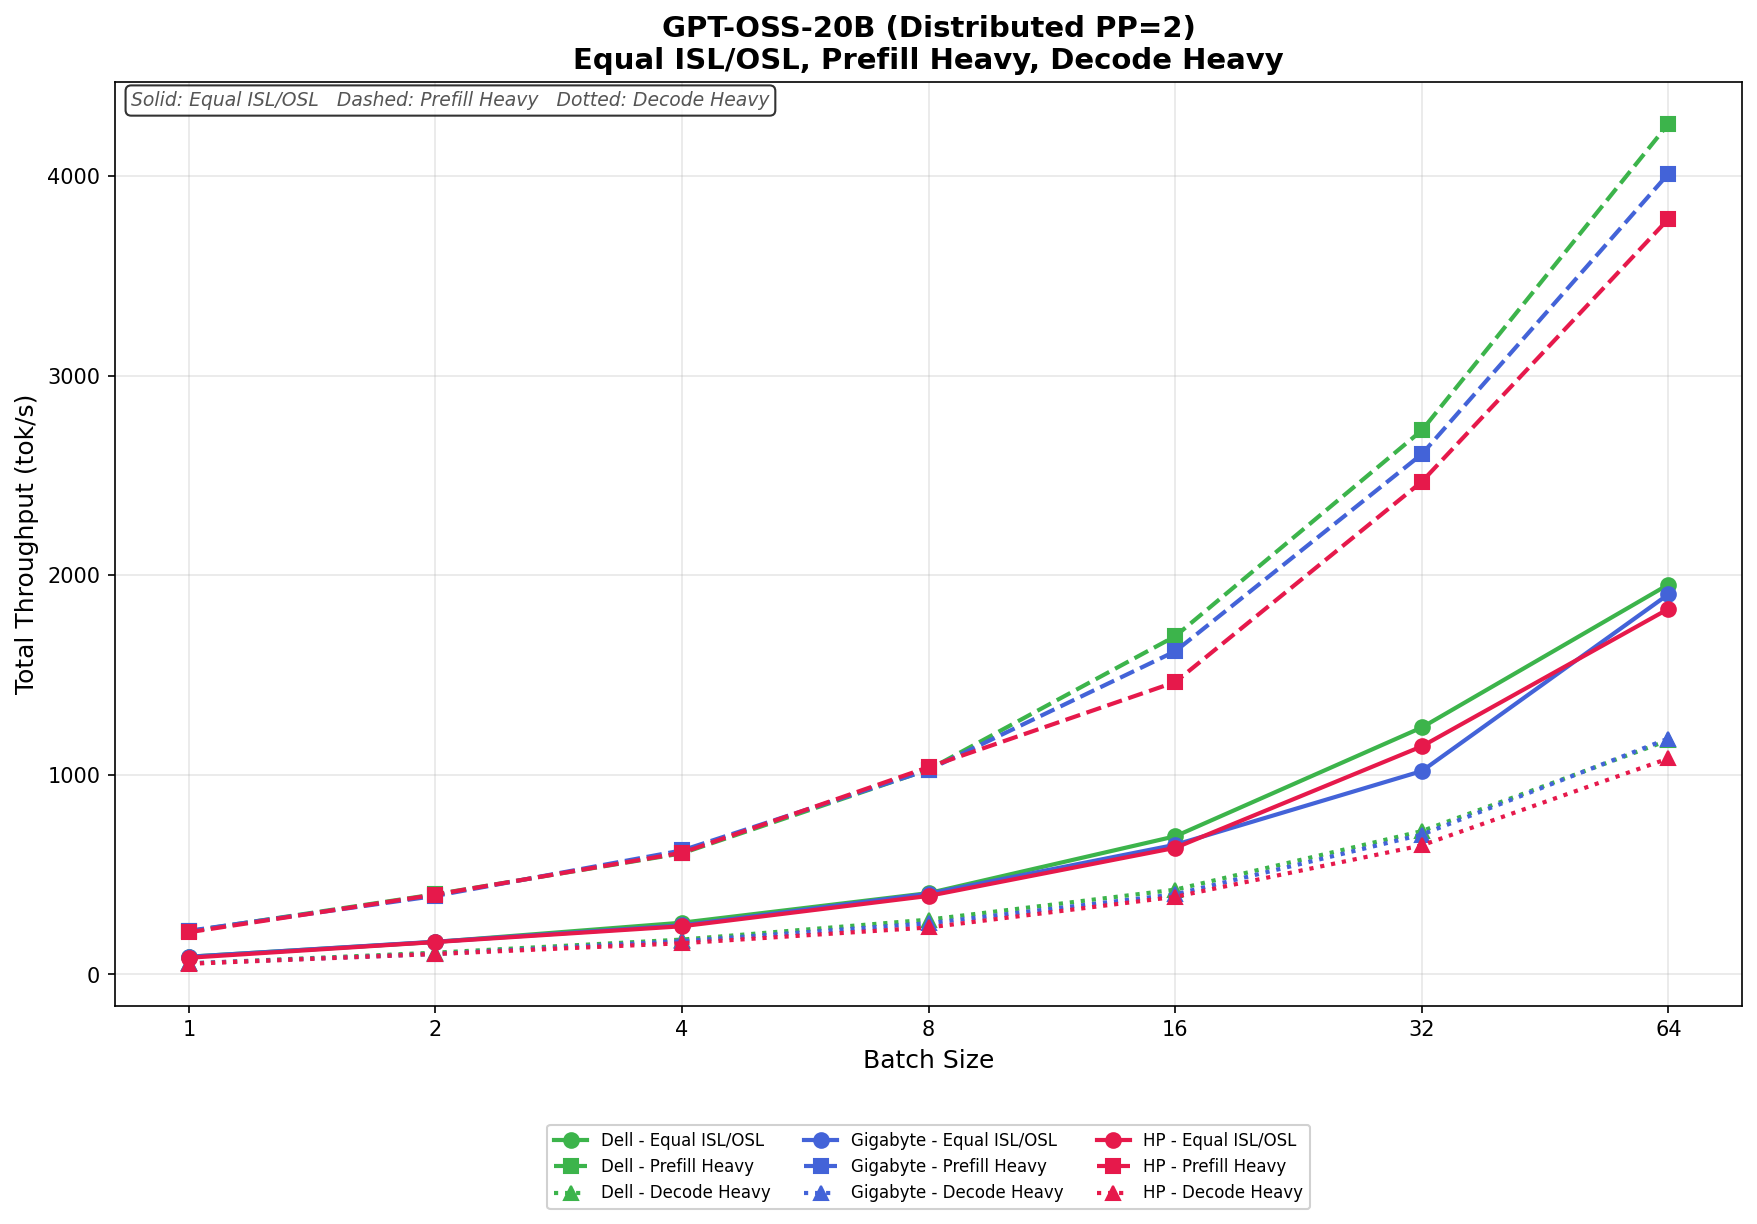
동일 ISL/OSL 조건에서 Dell은 배치 크기 1에서 88.73 tok/s, 배치 크기 64에서 1,953.55 tok/s까지 확장하며 대부분의 구간에서 선두를 차지했습니다. GIGABYTE는 88.42 tok/s에서 1,904.62 tok/s로 증가하며 그 뒤를 바짝 쫓았고, HP는 83.49 tok/s에서 1,831.45 tok/s 사이의 증가세를 보였습니다. Dell은 특히 배치 크기 16부터 전반적으로 가장 강력한 상위 영역 확장성을 유지했습니다.
Prefill Heavy 테스트에서 세 시스템 모두 처리량이 급격히 증가했습니다. Dell은 배치 크기 64에서 216.05 tok/s에서 4,261.96 tok/s로 가장 높은 결과를 보여주었습니다. GIGABYTE는 4,011.86 tok/s로 그 뒤를 이었고, HP는 3,785.25 tok/s를 기록했습니다. 배치 크기가 작을 때는 세 시스템의 성능이 비슷했지만, 배치 크기 16부터 Dell이 격차를 벌리기 시작하여 테스트 후반까지 선두를 유지했습니다.
Decode Heavy 테스트에서 확장성은 다소 완만하지만 모든 플랫폼에서 강력한 성능을 보여줍니다. Dell은 54.88 tok/s에서 1,173.31 tok/s로, GIGABYTE는 55.24 tok/s에서 1,181.94 tok/s로, HP는 53.20 tok/s에서 1,082.23 tok/s로 확장됩니다. 가장 큰 배치 크기에서는 GIGABYTE가 Dell을 근소하게 앞서지만, HP는 높은 동시 처리량 수준에서 두 시스템 모두에 뒤처집니다.
라마 3.1 8B 인스트럭션 베이스
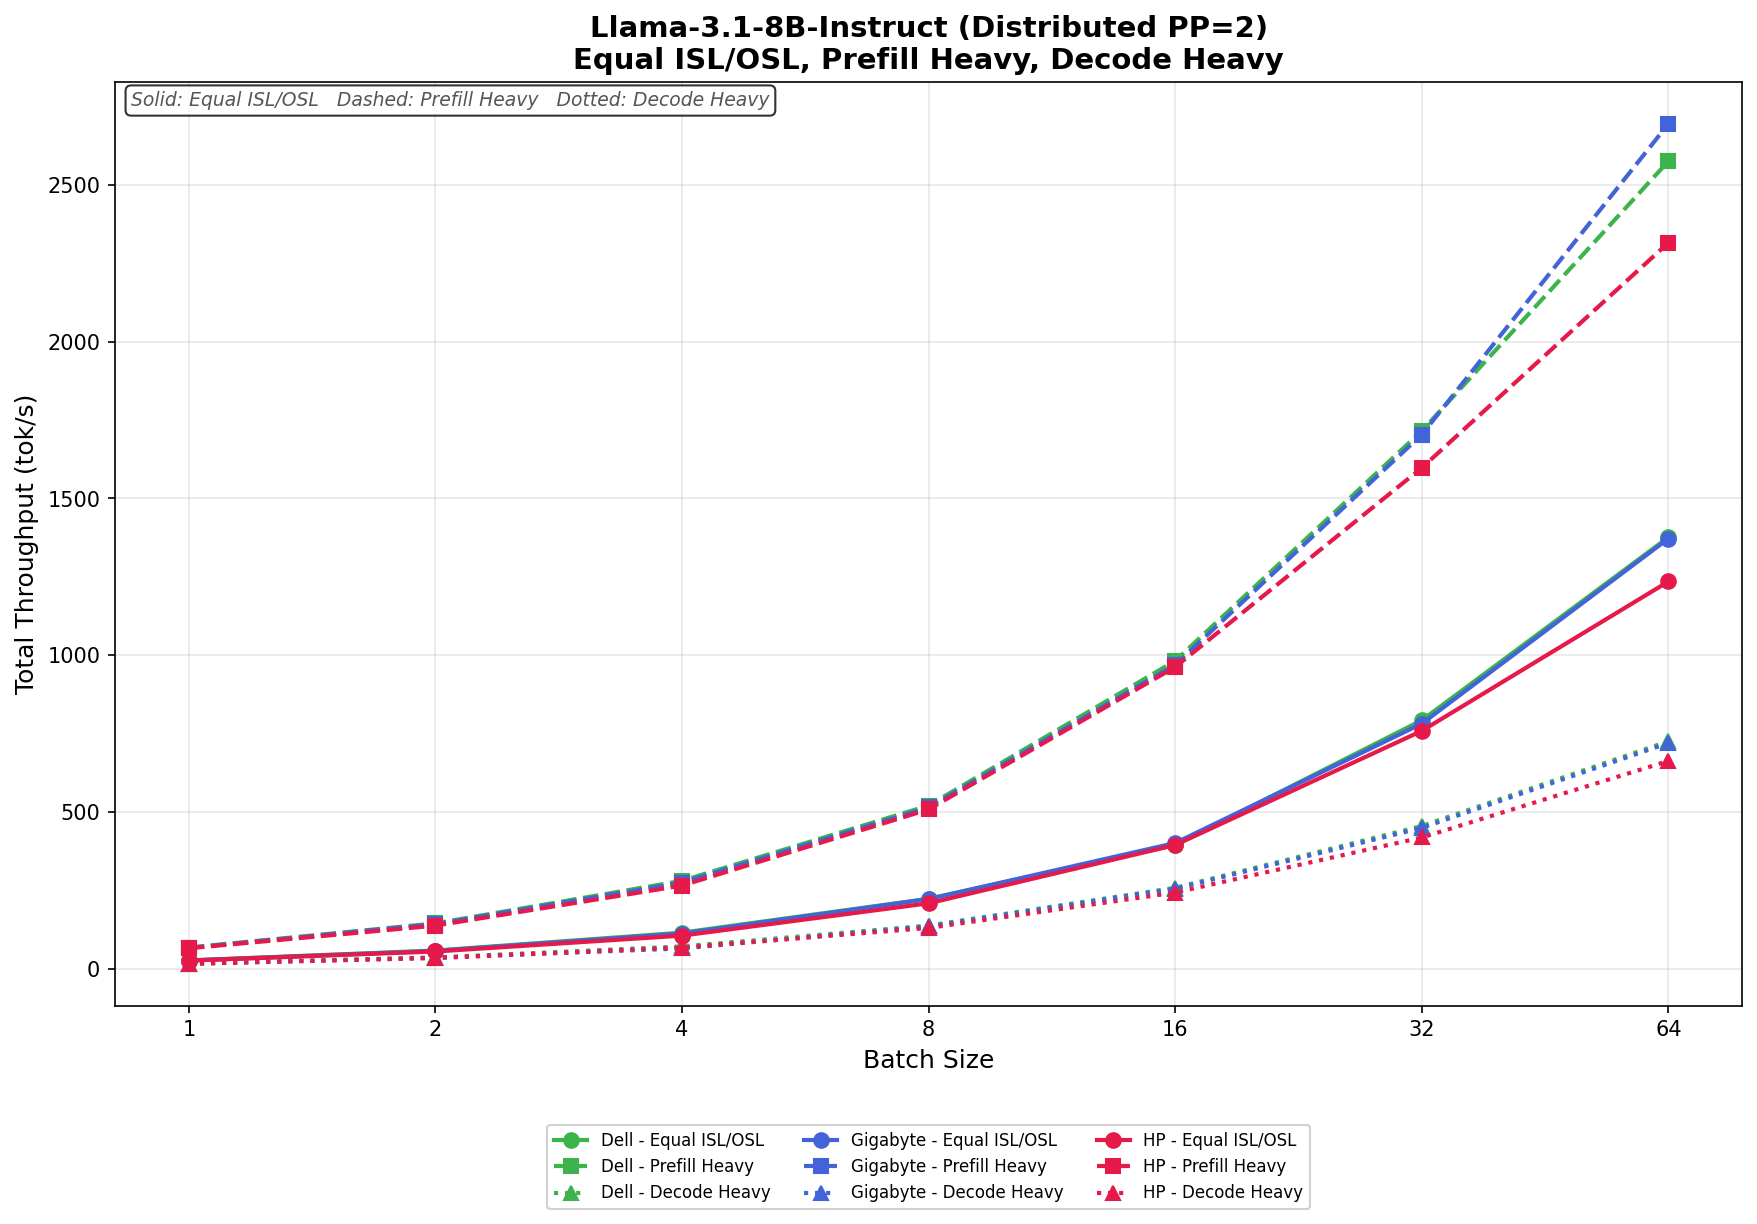
동일한 ISL/OSL 환경에서 Dell은 배치 크기 64에서 27.69 tok/s에서 1,376.38 tok/s까지 확장되는 성능을 보여주며, 27.23 tok/s에서 1,372.27 tok/s까지의 성능을 보이는 GIGABYTE를 근소하게 앞섰습니다. HP는 26.89 tok/s에서 1,235.32 tok/s까지의 확장성을 보이며 전반적으로 약간 뒤처졌습니다. 세 시스템 모두 배치 크기 16까지는 매우 유사한 성능을 보이다가, 더 높은 동시 처리량 수준에서 Dell이 약간 앞서나가기 시작했습니다.
프리필 헤비(Prefill Heavy) 테스트에서 배치 크기가 커질수록 처리량이 급격히 증가합니다. Dell은 68.60 tok/s에서 2,575.25 tok/s로 증가했으며, GIGABYTE는 배치 크기 64에서 67.49 tok/s에서 2,694.25 tok/s로 가장 뛰어난 성능을 보였습니다. HP는 2,315.15 tok/s를 기록하며 경쟁력 있는 수준을 유지했지만, 배치 크기가 커질수록 Dell과 GIGABYTE에 비해 지속적으로 뒤처졌습니다. 특히 배치 크기가 64 이상일 때 GIGABYTE가 선두를 차지했습니다.
Decode Heavy 테스트에서 성능 확장은 전 구간에 걸쳐 안정적으로 유지되었습니다. Dell은 17.19 tok/s에서 726.22 tok/s까지, GIGABYTE는 16.96 tok/s에서 720.57 tok/s까지, HP는 16.79 tok/s에서 663.31 tok/s까지 확장되었습니다. Dell과 GIGABYTE는 테스트 대부분 구간에서 거의 동일한 성능을 보였으며, 최고 동시 처리량 수준에서 Dell이 근소한 우위를 나타냈습니다. 반면, HP는 배치 크기가 커질수록 약간 뒤처지는 모습을 보였습니다.
Llama 3.1 8B 명령어 FP4
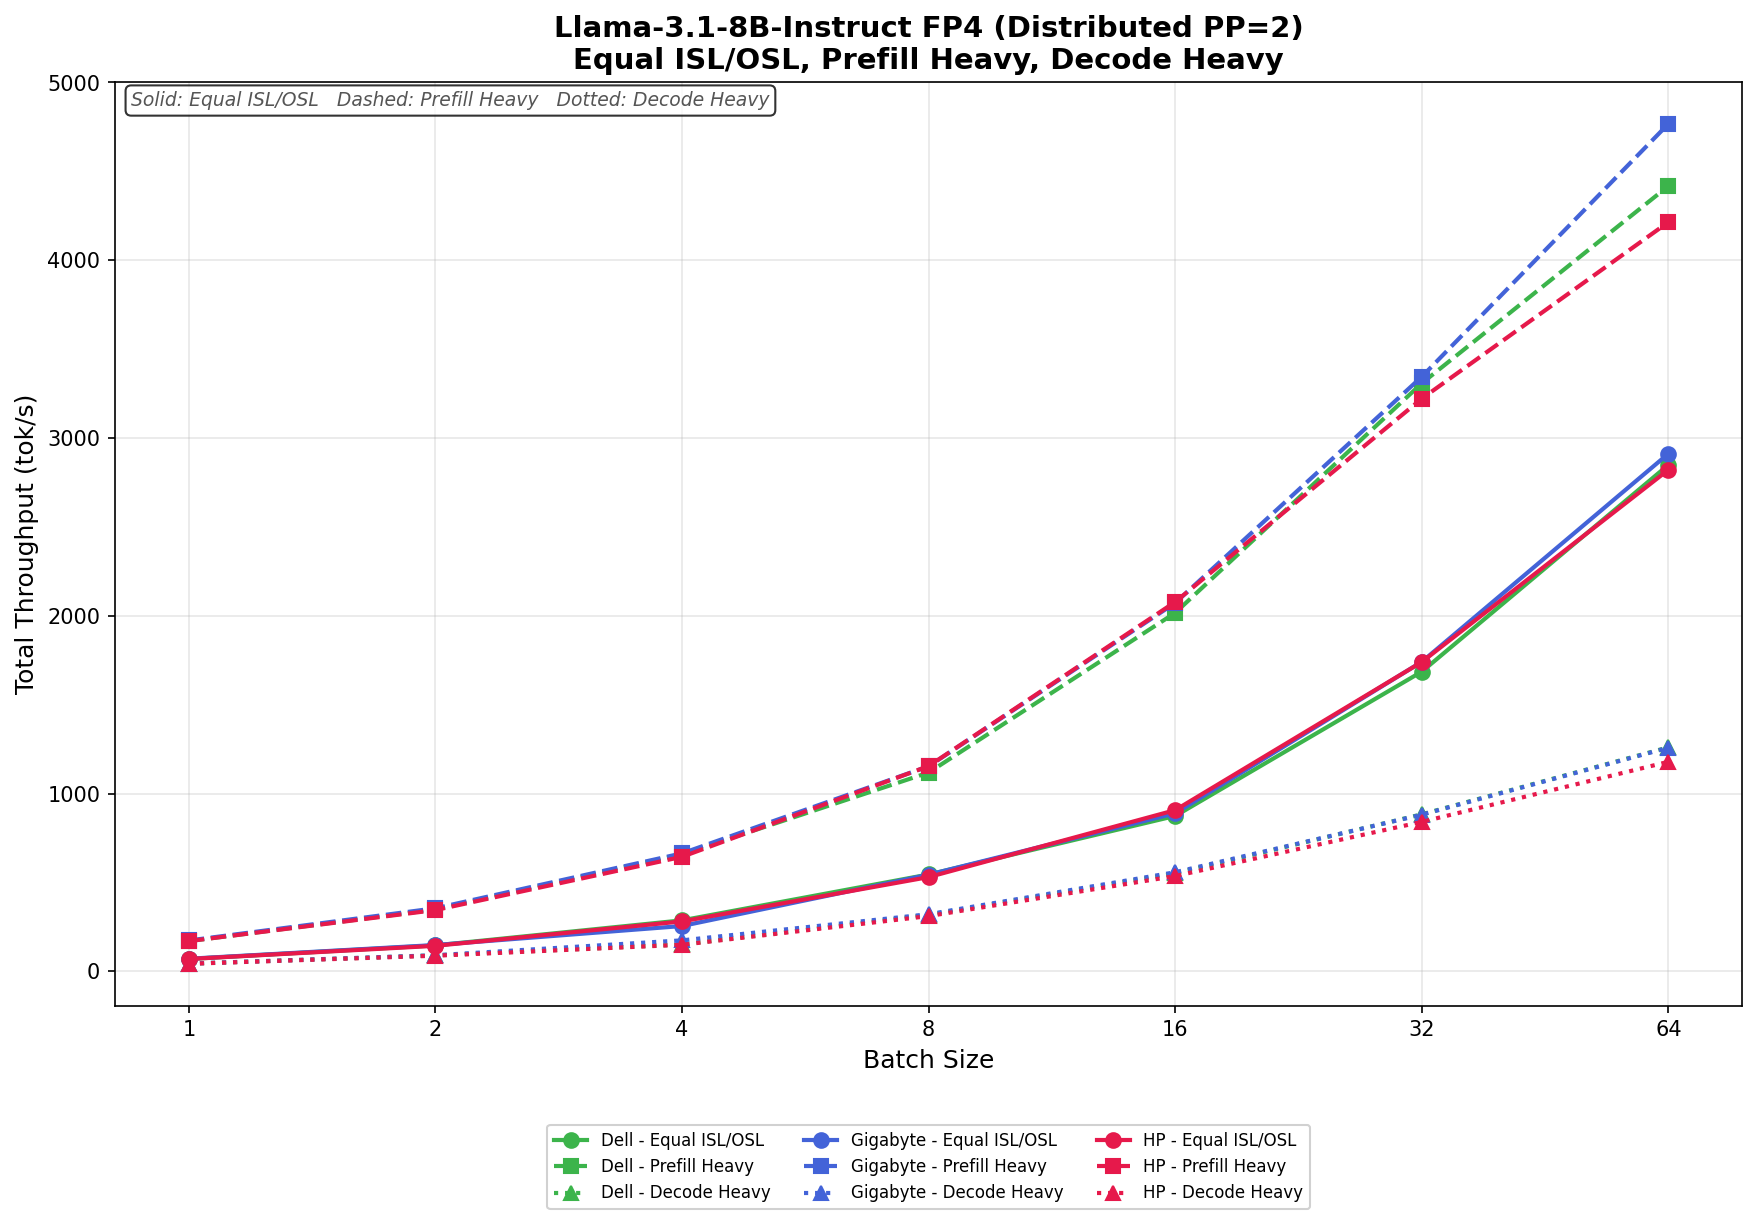
동일한 ISL/OSL 조건에서 Dell은 배치 크기 64에서 69.71 tok/s에서 2,849.20 tok/s로 확장되는 반면, GIGABYTE는 70.92 tok/s에서 2,912.03 tok/s로 약간 앞서 나갑니다. HP는 69.52 tok/s에서 2,821.50 tok/s 사이의 성능을 유지하며 경쟁력 있는 모습을 보입니다. 세 시스템은 전체 워크로드에서 매우 유사한 성능을 보이며, 높은 동시 처리량 수준에서만 약간의 차이가 나타납니다.
Prefill Heavy 테스트에서 확장성은 특히 배치 크기가 클수록 훨씬 더 공격적으로 나타납니다. Dell은 170.09 tok/s에서 4,417.65 tok/s로 증가했으며, GIGABYTE는 배치 크기 64에서 173.55 tok/s에서 4,767.43 tok/s로 증가하며 그룹 내에서 가장 뛰어난 결과를 보여주었습니다. HP는 170.12 tok/s에서 4,214.57 tok/s로 확장되었습니다. GIGABYTE는 배치 크기가 32를 넘어서면서 다른 업체들과의 격차를 벌리기 시작했으며, 이 워크로드에서 가장 강력한 최고 처리량을 제공했습니다.
Decode Heavy 테스트에서 세 시스템 모두 대부분의 구간에서 비슷한 성능을 보였습니다. Dell은 43.19 tok/s에서 1,260.24 tok/s까지, GIGABYTE는 43.53 tok/s에서 1,258.05 tok/s까지, HP는 42.54 tok/s에서 1,178.74 tok/s까지 성능을 확장했습니다. Dell과 GIGABYTE는 배치 크기에 따라 선두 자리를 번갈아 차지하는 반면, HP는 최대 동시 처리량 수준에서 두 시스템보다 약간 뒤처지는 모습을 보였습니다.
Llama 3.1 8B 명령어 FP8
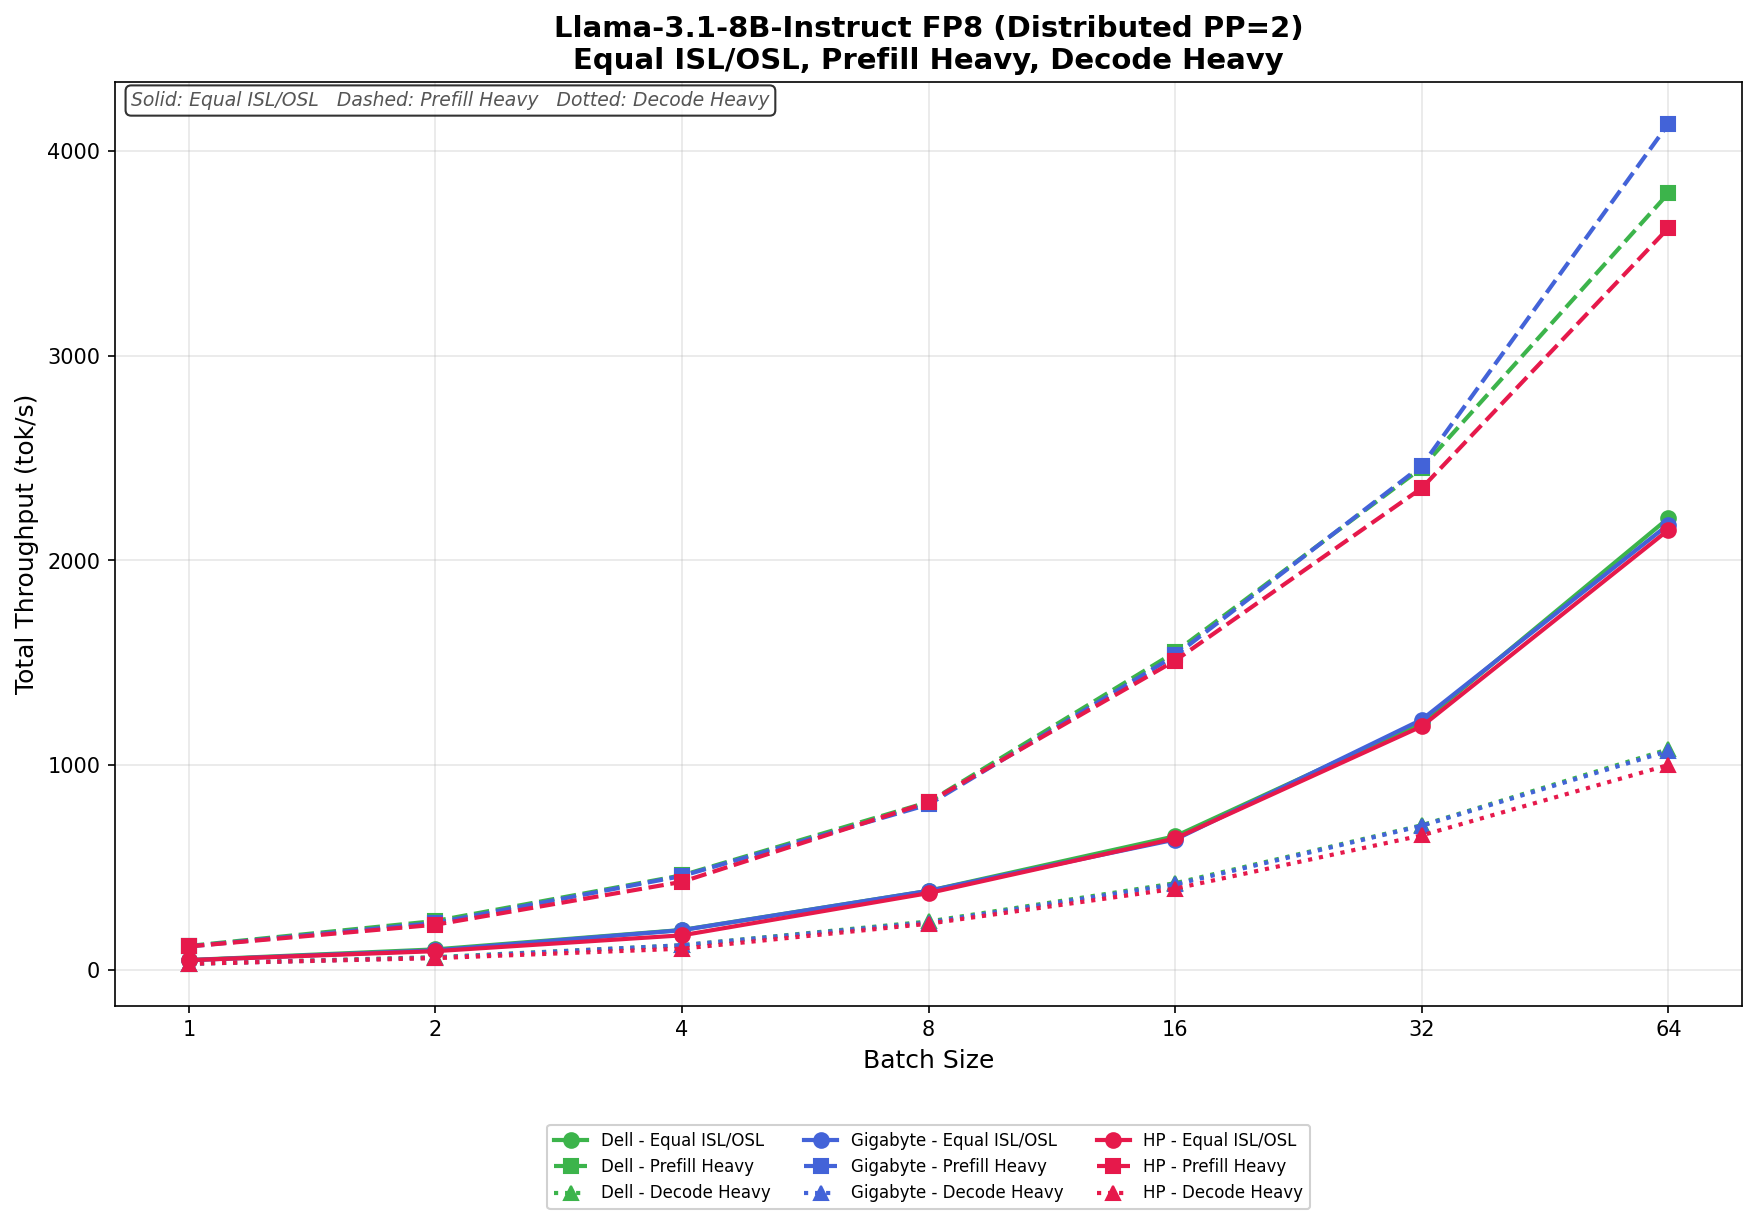
동일한 ISL/OSL 조건에서 Dell은 배치 크기 64에서 46.93 tok/s에서 2,206.52 tok/s로 확장되는 반면, GIGABYTE는 46.16 tok/s에서 2,175.44 tok/s로 확장됩니다. HP는 46.40 tok/s에서 2,149.15 tok/s로 증가하며 그 뒤를 바짝 쫓습니다. 전체적인 편차는 테스트 전반에 걸쳐 좁게 유지되며, 세 시스템 모두 배치 크기 32까지 거의 동일한 확장 동작을 보입니다.
Prefill Heavy 테스트에서 동시 처리량이 증가함에 따라 처리량 증가 속도가 더욱 가파르게 나타납니다. Dell은 115.85 tok/s에서 3,794.52 tok/s로 증가했으며, GIGABYTE는 배치 크기 64에서 113.34 tok/s에서 4,133.76 tok/s로 확장하며 전반적으로 가장 우수한 결과를 보였습니다. HP는 3,624.73 tok/s를 기록했습니다. GIGABYTE는 특히 배치 크기 32부터 배치 크기가 커질수록 더욱 뚜렷한 우위를 점하기 시작합니다.
Decode Heavy 테스트에서 세 시스템은 낮은 동시 실행 수준에서는 매우 근접한 성능을 보이다가 높은 동시 실행 수준에서 약간의 차이가 나타납니다. Dell은 29.11 tok/s에서 1,077.07 tok/s까지, GIGABYTE는 28.64 tok/s에서 1,068.92 tok/s까지, HP는 28.68 tok/s에서 1,000.20 tok/s까지 성능을 확장합니다. Dell은 대부분의 워크로드에서 근소한 차이로 앞서 나가고, GIGABYTE는 매우 근접한 차이로 뒤를 쫓으며, HP는 배치 크기가 커질수록 약간 뒤처집니다.
미스트랄 스몰 3.1 24V
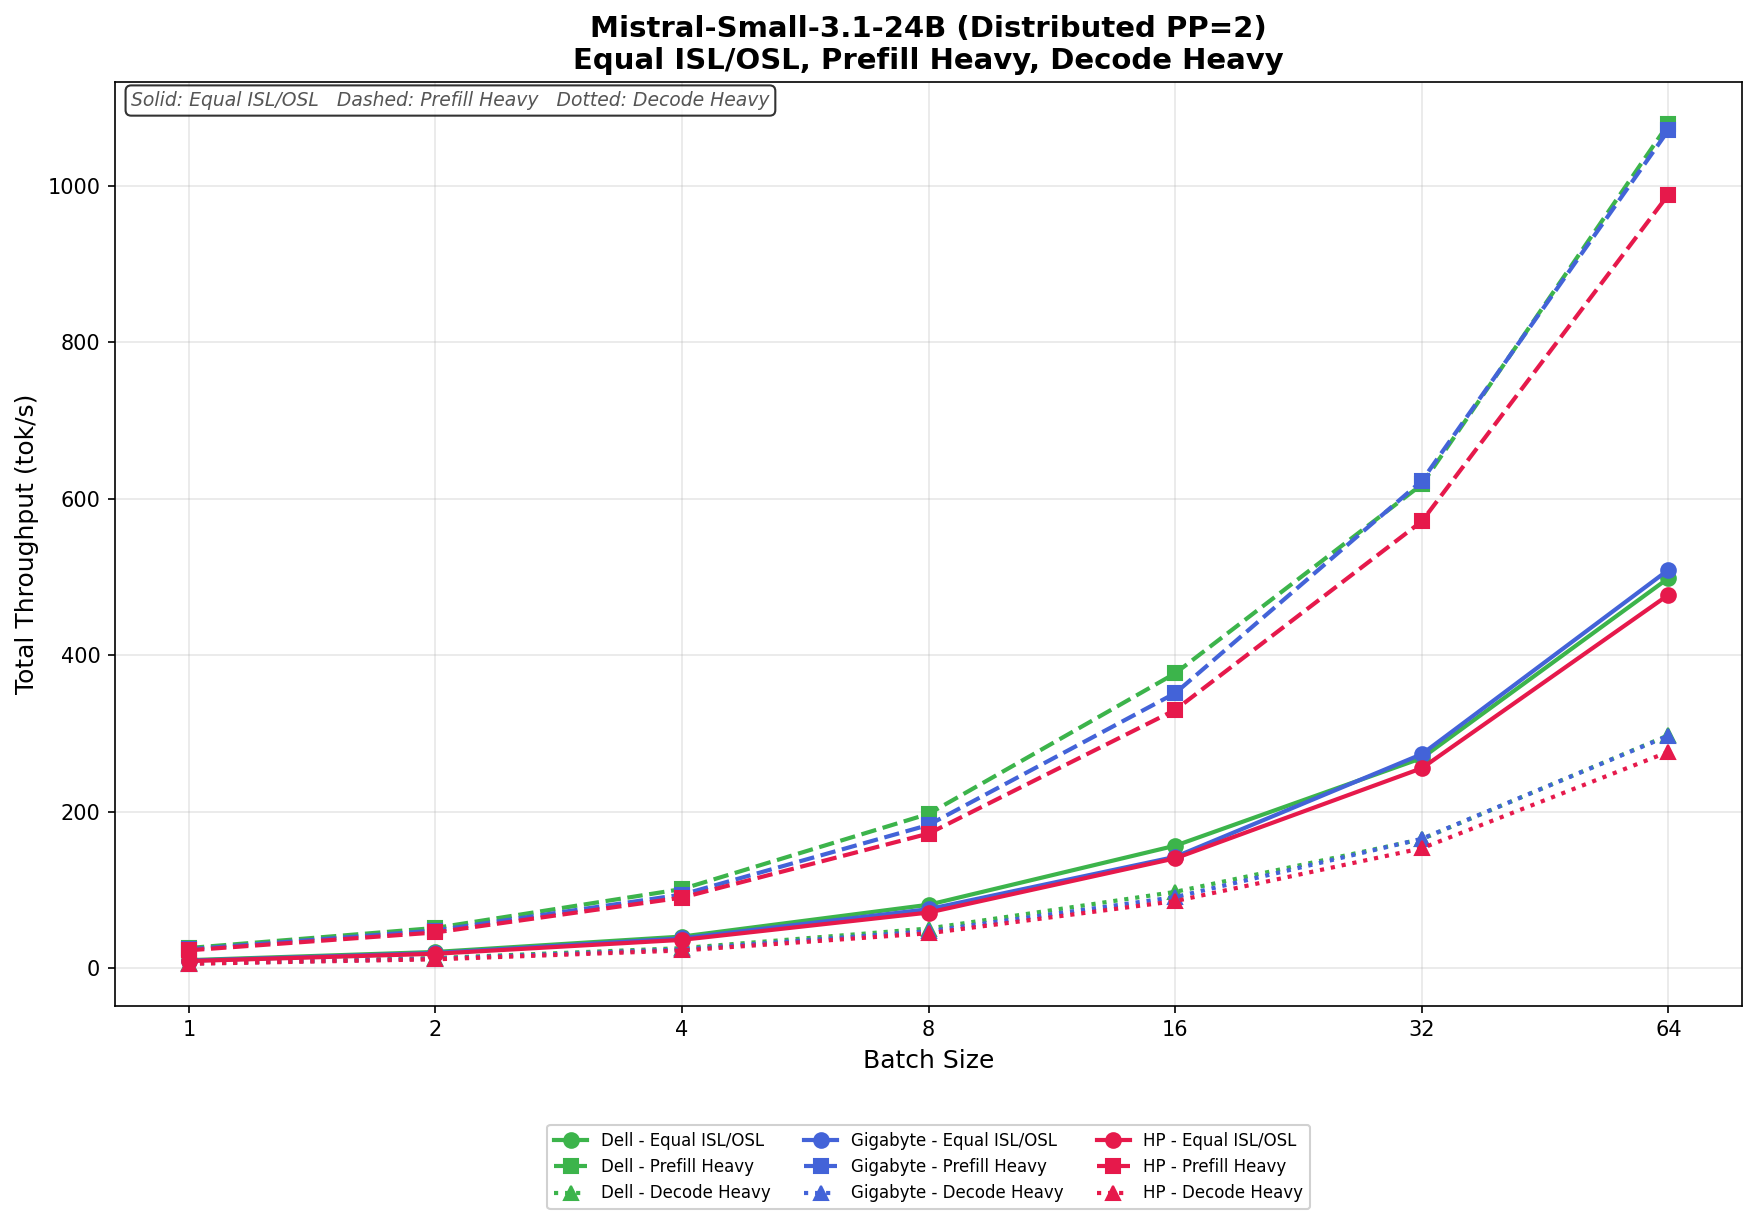
동일한 ISL/OSL 환경에서 Dell은 배치 크기 64에서 10.41 tok/s에서 498.56 tok/s로 확장되는 반면, GIGABYTE는 상위 영역에서 9.76 tok/s에서 509.18 tok/s로 약간 앞서 나갑니다. HP는 9.25 tok/s에서 477.25 tok/s 사이의 성능을 보이며 두 시스템 모두에 다소 뒤처집니다. 시스템 간의 성능 차이는 특히 낮은 및 중간 수준의 동시 처리량에서 전체 작업 부하에 걸쳐 비교적 작게 유지됩니다.
사전 채우기 작업량이 많은 환경에서 세 시스템 모두 확장성이 크게 향상되었습니다. Dell은 25.91 tok/s에서 1,079.19 tok/s로, GIGABYTE는 24.25 tok/s에서 1,071.07 tok/s로 성능이 향상되었습니다. HP는 배치 크기 64에서 988.82 tok/s를 달성했습니다. Dell과 GIGABYTE는 대부분의 테스트 구간에서 거의 동일한 성능을 보였지만, 최고 동시 처리량 수준에서 Dell이 약간 우위를 점했습니다.
디코딩 집중 테스트에서 처리량은 예상대로 대형 모델에서 디코딩에 초점을 맞춘 워크로드 특성상 전반적으로 상당히 낮게 유지되었습니다. Dell은 6.49 tok/s에서 297.82 tok/s까지, GIGABYTE는 6.10 tok/s에서 297.23 tok/s까지, HP는 5.77 tok/s에서 276.55 tok/s까지 처리량이 증가했습니다. Dell과 GIGABYTE는 테스트 전반에 걸쳐 거의 동일한 성능을 보였지만, HP는 배치 크기가 커질수록 두 시스템 모두에 비해 지속적으로 약간 뒤처지는 모습을 보였습니다.
Qwen3 코더 30B A3B 베이스
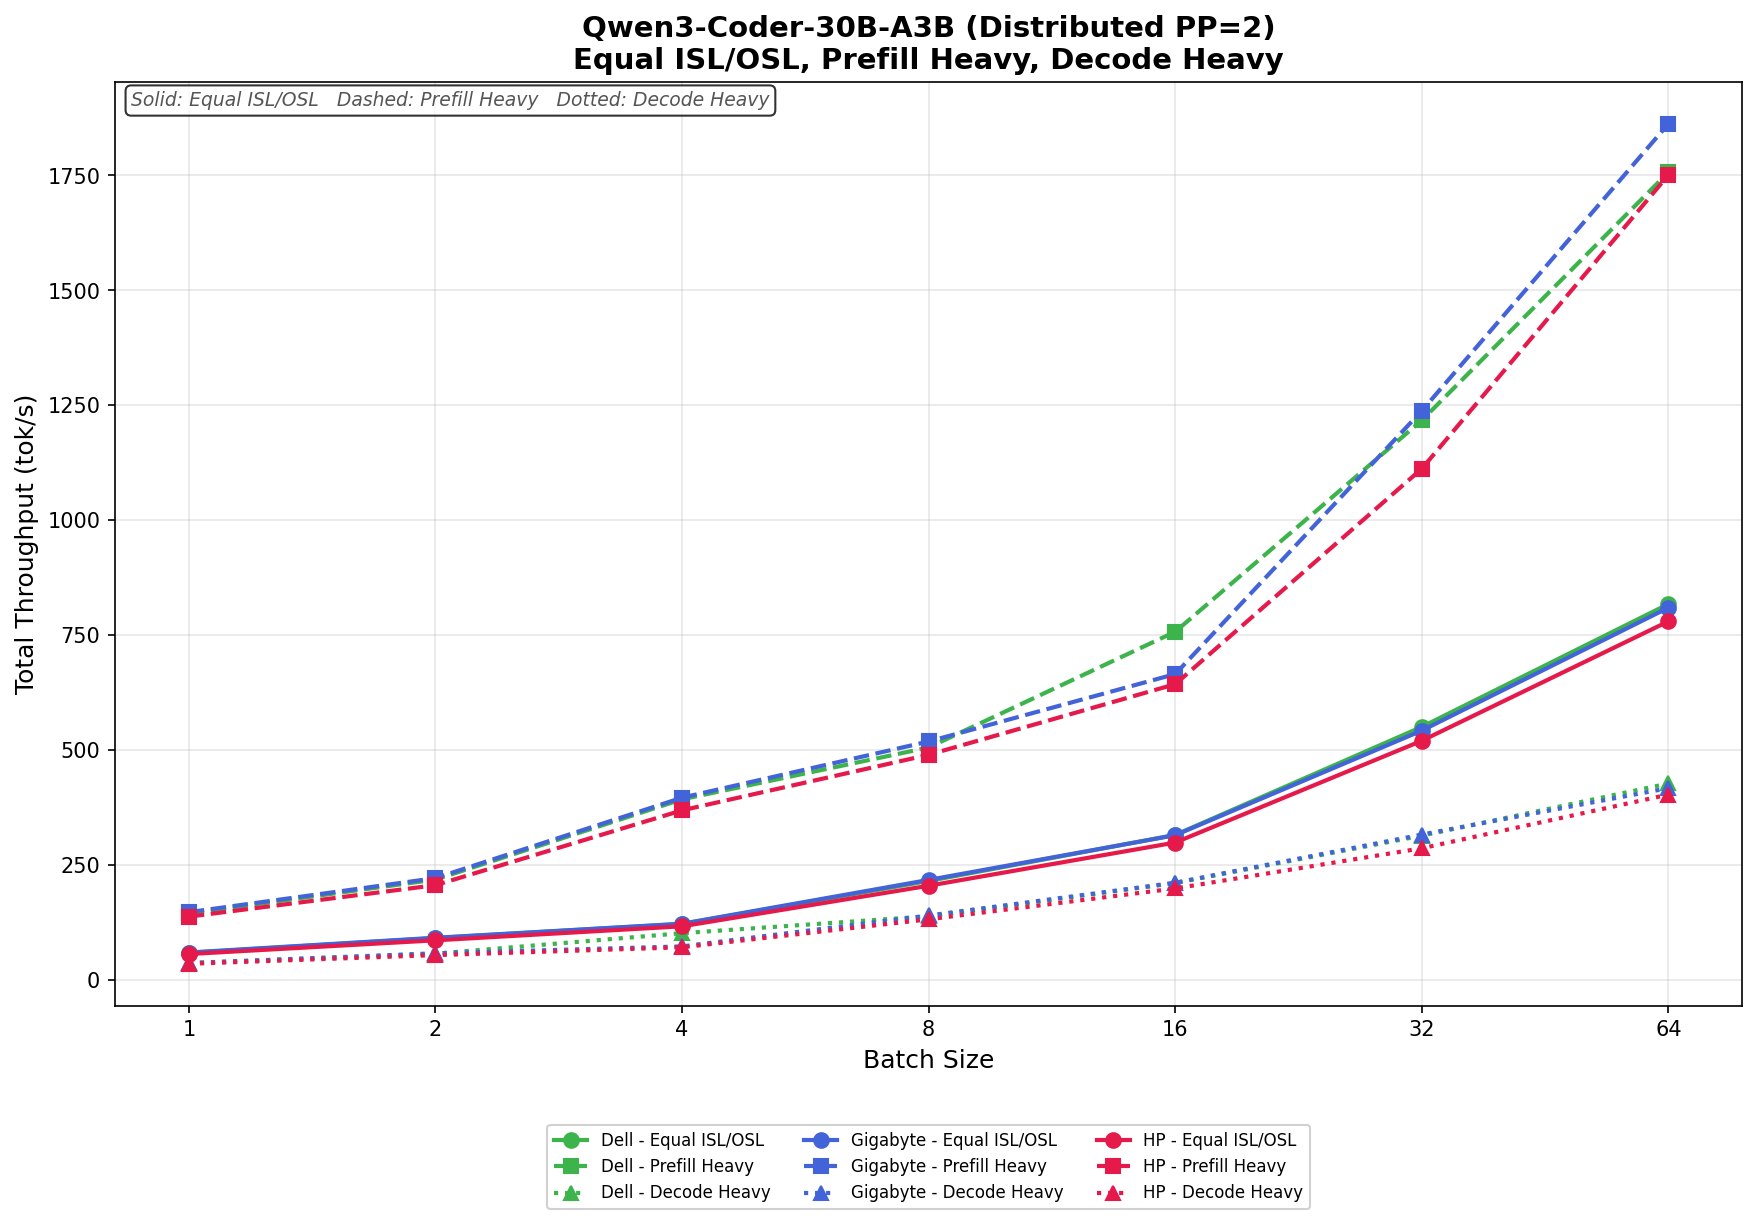
동일한 ISL/OSL 조건에서 Dell은 배치 크기 64에서 59.05 tok/s에서 817.82 tok/s까지 확장되는 반면, GIGABYTE는 59.81 tok/s에서 809.88 tok/s까지 확장됩니다. HP는 두 시스템보다 약간 뒤처지며 56.51 tok/s에서 780.21 tok/s로 증가합니다. Dell과 GIGABYTE의 성능은 대부분의 구간에서 거의 동일하게 유지되며, 배치 크기가 커질수록 약간의 차이가 나타납니다.
Prefill Heavy 테스트에서 동시 처리량이 증가함에 따라 처리량이 크게 증가합니다. Dell은 144.81 tok/s에서 1,756.99 tok/s로 증가했으며, GIGABYTE는 배치 크기 64에서 147.55 tok/s에서 1,862.40 tok/s로 증가하며 전반적으로 가장 뛰어난 확장성을 보였습니다. HP는 1,751.17 tok/s를 기록하며 경쟁력 있는 수준을 유지했지만, 상위 배치 크기에서는 다른 두 시스템에 비해 약간 뒤처졌습니다. GIGABYTE는 배치 크기 32 부근부터 소폭 우위를 점하기 시작하여 테스트의 마지막 단계까지 그 격차를 유지했습니다.
Decode Heavy 테스트에서 세 시스템은 대부분의 워크로드 구간에서 다시 한번 매우 유사한 성능을 보였습니다. Dell은 36.69 tok/s에서 427.48 tok/s 사이의 처리 속도를 보였고, GIGABYTE는 36.92 tok/s에서 417.42 tok/s까지, HP는 35.30 tok/s에서 403.32 tok/s까지 처리 속도가 향상되었습니다. Dell은 가장 큰 배치 크기에서 약간의 우위를 유지했으며, HP는 디코딩 중심 워크로드 전반에 걸쳐 Dell과 GIGABYTE에 비해 약간 뒤처지는 모습을 보였습니다.
Qwen3 코더 30B A3B FB8
동일한 ISL/OSL 조건에서 Dell은 배치 크기 64에서 98.65 tok/s에서 1,379.26 tok/s까지 확장되는 반면, GIGABYTE는 100.20 tok/s에서 1,308.79 tok/s까지 확장됩니다. HP는 97.06 tok/s에서 1,354.23 tok/s까지 증가하며 전반적으로 경쟁력 있는 성능을 유지합니다. HP는 몇몇 낮은 배치 크기와 중간 배치 크기에서 잠시 앞서지만, Dell은 전반적으로 가장 높은 처리량을 보여줍니다.
Prefill Heavy 테스트에서 세 시스템 모두 처리량이 급격히 증가했습니다. Dell은 240.43 tok/s에서 3,041.72 tok/s로 증가했으며, GIGABYTE는 배치 크기 64에서 245.92 tok/s에서 3,088.62 tok/s로 증가하며 전반적으로 가장 우수한 결과를 보였습니다. HP는 2,857.80 tok/s를 기록했습니다. GIGABYTE는 배치 크기 4부터 뚜렷한 우위를 점하기 시작하여 테스트가 끝날 때까지 그 격차를 유지했습니다.
Decode Heavy 테스트에서 Dell은 전반적으로 가장 강력한 상위 확장성을 보여줍니다. Dell은 60.91 tok/s에서 705.77 tok/s까지 확장되는 반면, GIGABYTE는 61.53 tok/s에서 639.80 tok/s까지, HP는 59.85 tok/s에서 635.25 tok/s까지 확장됩니다. HP는 작은 배치 크기에서 잠시 앞서지만, Dell은 더 큰 동시 처리량 수준에서 다시 앞서나가며 그룹 내에서 가장 강력한 디코딩 처리량을 기록합니다.
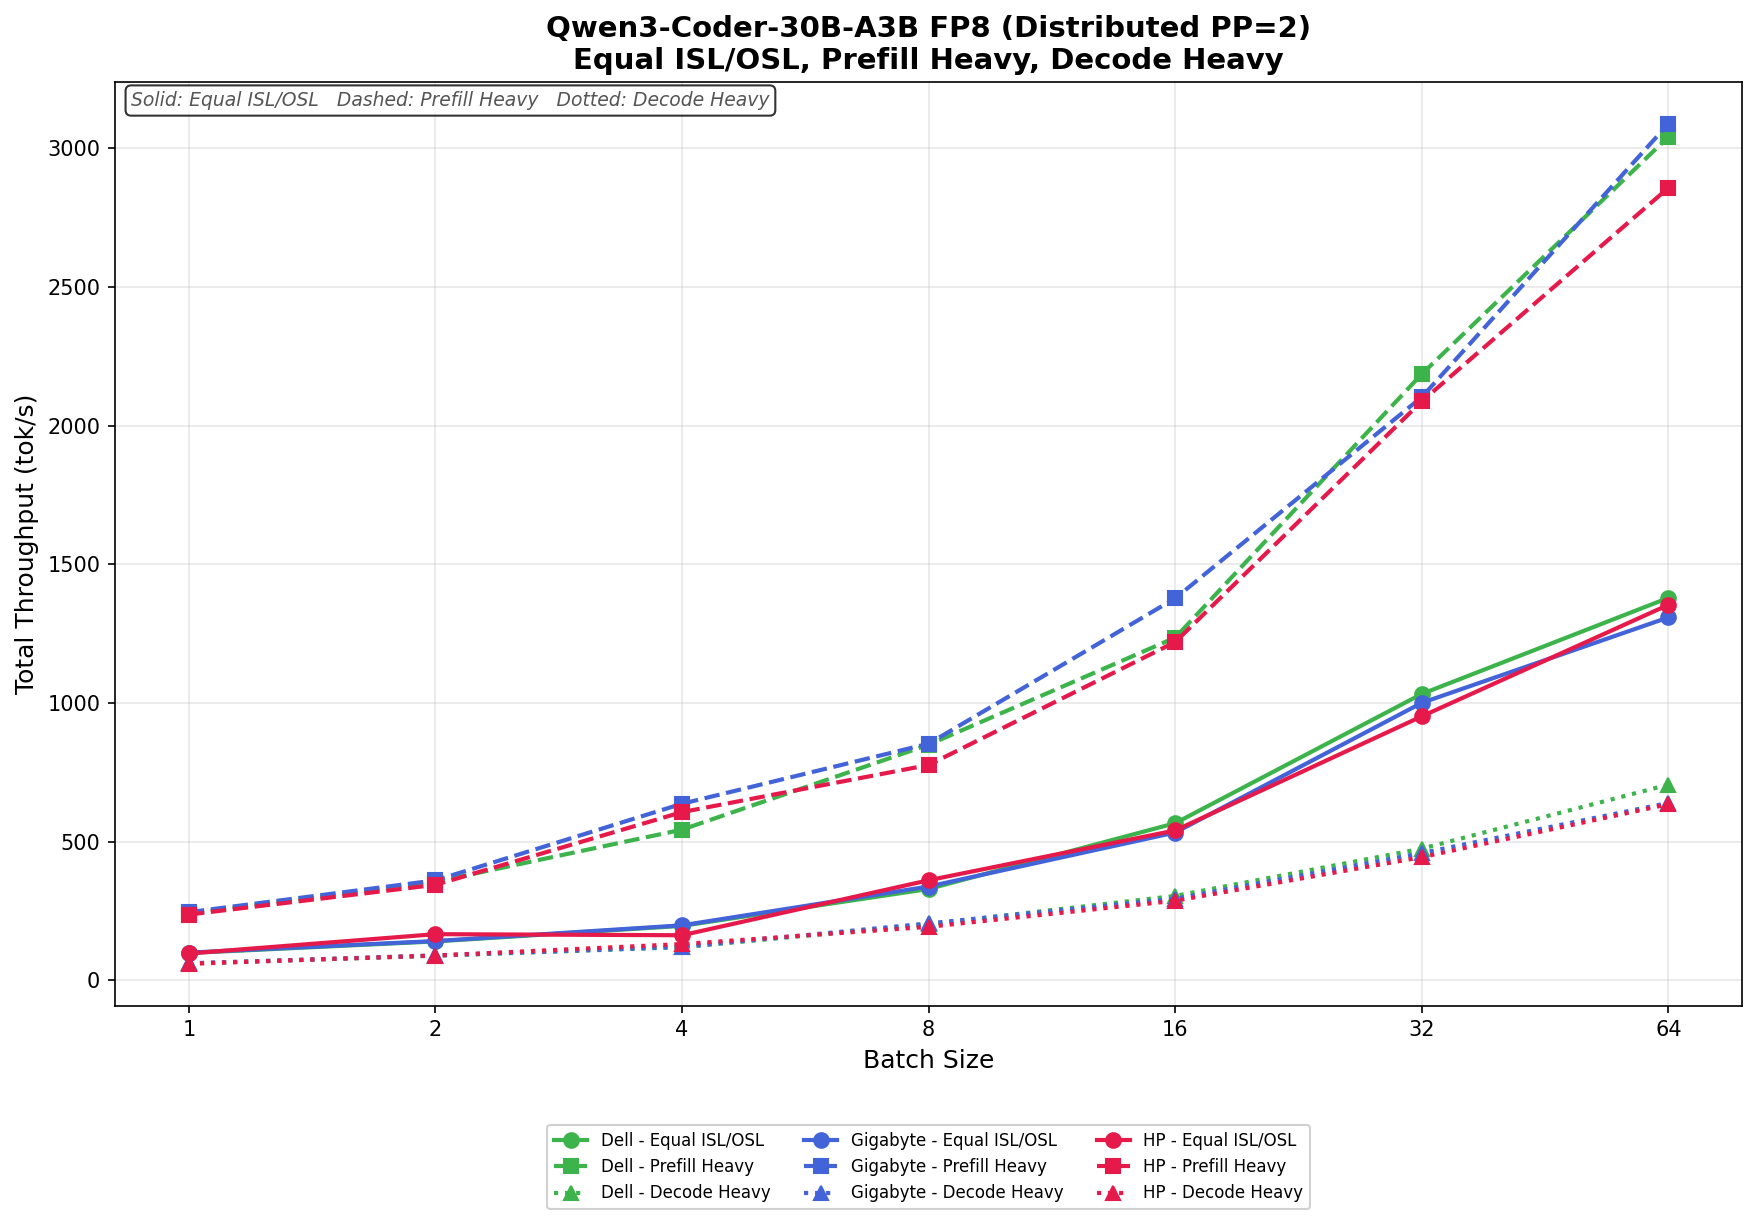
듀얼 스파크 시스템 최대 출력 요약
아래 표는 Dell, GIGABYTE 및 HP 듀얼 Spark 시스템에서 분산 PP=2 테스트 중에 관찰된 최대 토큰 출력 처리량을 요약한 것입니다. 각 값은 테스트된 배치 크기에서 해당 워크로드 시나리오에 대해 측정된 최고 출력 처리량(tok/s)을 나타냅니다. 굵게 표시된 값은 해당 특정 워크로드 시나리오에서 가장 우수한 성능을 보인 시스템을 나타냅니다.
| 모델 | 시나리오 (BS – 64) | 델 최대 출력 | 기가바이트 최대 출력 | HP 최대 출력 |
|---|---|---|---|---|
| GPT-OSS 모델 | ||||
| GPT-OSS-120B | 동등한 ISL/OSL | 463.97 토크/초 | 497.26 토크/초 | 504.88 토크/초 |
| GPT-OSS-120B | 미리 채운 양 | 419.56 토크/초 | 417.34 토크/초 | 441.63 토크/초 |
| GPT-OSS-120B | 디코드 헤비 | 451.18 토크/초 | 494.37 토크/초 | 474.85 토크/초 |
| GPT-OSS-20B | 동등한 ISL/OSL | 976.77 토크/초 | 952.31 토크/초 | 915.72 토크/초 |
| GPT-OSS-20B | 미리 채운 양 | 852.39 토크/초 | 802.37 토크/초 | 757.05 토크/초 |
| GPT-OSS-20B | 디코드 헤비 | 938.65 토크/초 | 945.55 토크/초 | 865.78 토크/초 |
| 라마 모델 | ||||
| 라마-3.1-8B-지시 | 동등한 ISL/OSL | 689.53 토크/초 | 687.48 토크/초 | 618.87 토크/초 |
| 라마-3.1-8B-지시 | 미리 채운 양 | 515.45 토크/초 | 539.27 토크/초 | 463.39 토크/초 |
| 라마-3.1-8B-지시 | 디코드 헤비 | 581.43 토크/초 | 576.91 토크/초 | 531.07 토크/초 |
| 라마-3.1-8B-FP4 | 동등한 ISL/OSL | 1427.39 토크/초 | 1458.86 토크/초 | 1413.51 토크/초 |
| 라마-3.1-8B-FP4 | 미리 채운 양 | 884.22 토크/초 | 954.23 토크/초 | 843.57 토크/초 |
| 라마-3.1-8B-FP4 | 디코드 헤비 | 1008.98 토크/초 | 1007.23 토크/초 | 943.73 토크/초 |
| 라마-3.1-8B-FP8 | 동등한 ISL/OSL | 1105.42 토크/초 | 1089.85 토크/초 | 1076.68 토크/초 |
| 라마-3.1-8B-FP8 | 미리 채운 양 | 759.50 토크/초 | 827.40 토크/초 | 725.51 토크/초 |
| 라마-3.1-8B-FP8 | 디코드 헤비 | 862.33 토크/초 | 855.81 토크/초 | 800.78 토크/초 |
| 미스트랄 및 퀘인 모델 | ||||
| 미스트랄-스몰-3.1-24B | 동등한 ISL/OSL | 249.77 토크/초 | 255.09 토크/초 | 239.09 토크/초 |
| 미스트랄-스몰-3.1-24B | 미리 채운 양 | 216.01 토크/초 | 214.38 토크/초 | 197.92 토크/초 |
| 미스트랄-스몰-3.1-24B | 디코드 헤비 | 238.44 토크/초 | 237.97 토크/초 | 221.41 토크/초 |
맺음말
이번 테스트에서 가장 유용한 결과는 어떤 OEM이 어떤 워크로드에서 우위를 점했는지와는 거의 관련이 없습니다. 테스트한 모든 모델과 워크로드 유형에서 Dell, GIGABYTE, HP의 세 가지 Spark 구현은 좁은 범위 내에서 성능을 보였습니다. 특정 배치 크기에서 약간의 우위가 나타났지만, 어떤 플랫폼도 절대적인 승자가 되지 못했고, 지속적으로 뒤처지지도 않았습니다. 세 플랫폼 중 하나를 선택하는 구매자는 벤치마크 결과 차이보다는 섀시 디자인, 발열 관리, 보증 조건 및 지원 관계를 기준으로 결정해야 합니다. 벤치마크 결과는 데스크톱급 시스템이 지속적인 부하 상태에서 나타내는 실행 간 편차와 거의 유사하기 때문입니다.
더 흥미로운 결과는 방법론적인 측면입니다. 두 개의 Spark 인스턴스를 연결하는 200GbE 패브릭에서 텐서 병렬 처리와 파이프라인 병렬 처리 중 어느 것을 선택할지는 세 OEM 간의 차이보다 더 중요하며, 적절한 동시성 수준의 배치 추론에서는 파이프라인 병렬 처리가 더 적합합니다. TP=2의 계층별 전체 리듀스 트래픽은 ConnectX-7 링크를 통과하는 동안 컴퓨팅 리소스를 유휴 상태로 만들지 않고는 처리할 수 없으며, PP=2의 파이프라인 버블 비용은 배치가 파이프라인을 가득 채우는 즉시 안정적인 스트림에 분산됩니다. NVIDIA 문서에서 기본적으로 TP를 권장하는 데에는 타당한 이유가 있습니다. NVIDIA는 Spark를 주로 TTFT가 매우 빠른 대화형 단일 스트림 서비스에 사용하는데, 이는 TP=2가 확실히 우세한 유일한 환경이기 때문입니다. 워크로드가 채팅 인터페이스가 아닌 서비스 인프라처럼 보이는 순간, 판단 기준은 완전히 바뀝니다.
그러한 역전 현상은 Spark의 본질과 한계를 명확히 보여줍니다. 2노드 Spark 클러스터는 개발 및 학습 플랫폼으로서, 단일 엔지니어가 실제 데이터센터 환경을 모방할 만큼 빠른 네트워크에서 분산 추론 동작을 직접 경험해 볼 수 있도록 해줍니다. 동시에, 실제 운영 환경에서 대규모 배포 시 발생하는 병목 현상을 파악할 수 있도록 충분한 제약 조건도 마련되어 있습니다.
더 큰 규모의 Spark 구성은 그에 맞는 워크로드와 병렬 처리 전략을 통해 별도로 검토할 가치가 있으며, 관련 작업은 로드맵에 포함되어 있습니다. 이와는 별도로, 이번 실험 다음으로 예정된 실험은 추론에서 학습으로 전환하는 것입니다. 1억 개 미만의 파라미터를 가진 모델을 듀얼 Spark 클러스터에서 처음부터 학습시키는데, 이 클러스터는 훨씬 더 큰 시스템의 분산 사전 학습 조건을 모방하도록 구성되었습니다. 이 작업은 새로운 800Gb 랩 코어 스위치용 광 모듈이 도착할 때까지 일시 중단되었으며, 새 코어 스위치가 가동되면 결과를 발표할 예정입니다.


 아마존