

인공 지능의 세계는 맹렬한 속도로 진화하고 있습니다. 깜박이면 다음 발전을 놓칠 것입니다. 모델 크기가 점점 더 커지면서 연구원과 개발자는 AI 모델의 효율성과 성능을 개선할 방법을 지속적으로 모색하고 있습니다. 이를 달성하는 가장 쉬운 방법 중 하나는 AI 교육 및 추론을 위해 여러 GPU(Graphics Processing Unit) 또는 Tensor Processing Unit(TPU, 다음 기사에서 자세히 설명)을 사용하는 것입니다.
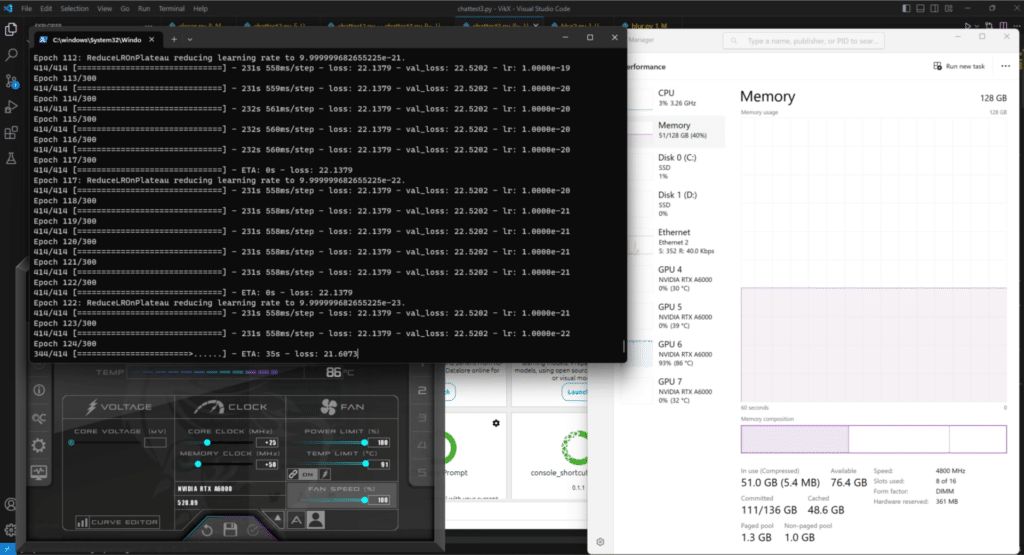
HP z8 G5 Fury에 대한 DNN 교육
지난번 AI 연구실 시리즈 에서 다뤘던 내용을 바탕으로 , HP Z8 G5 Fury 워크스테이션에서 단일 GPU에서 두 개, 그리고 최종적으로는 네 개의 강력한 GPU를 사용하는 것으로 전환했을 때 얻을 수 있는 이점을 심층적으로 살펴보고, 특히 PyTorch 모델 병렬 처리에 초점을 맞춰 실질적인 실험을 진행했습니다.
모델 병렬 처리의 힘
세부 사항을 살펴보기 전에 병렬 처리의 개념을 이해하는 것이 중요합니다. AI의 맥락에서 병렬화는 여러 계산을 동시에 실행하는 프로세스를 의미합니다. 이는 대량의 데이터를 처리해야 하는 AI 교육 및 추론에 특히 유용합니다. 실험실에서 사용하는 오픈 소스 기계 학습 라이브러리인 PyTorch는 여러 GPU에 AI 모델을 배포할 수 있는 모델 병렬성을 제공합니다. 이를 통해 교육 시간이 단축되고 추론이 더 효율적이며 더 크고 복잡한 모델을 실행할 수 있습니다.
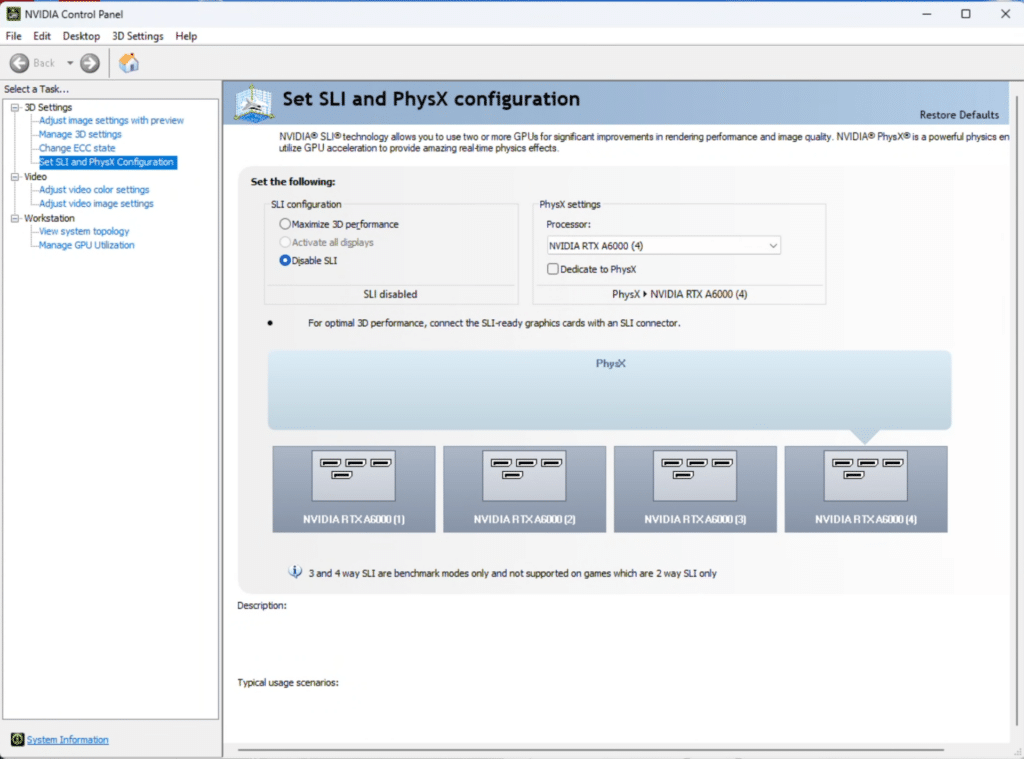
SLI가 비활성화되었는지 확인하는 것이 중요합니다.
확장의 이점
단일 GPU
단일 GPU로 시작하는 이 설정은 AI 교육 및 추론을 위한 견고한 기반을 제공합니다. 개발을 위해 워크스테이션에서 단일 최신(또는 몇 세대 이전) GPU를 실행하는 것만으로도 POC 단계에 충분합니다. 합리적인 양의 데이터를 처리할 수 있으며 더 작은 AI 모델에 대해 만족스러운 결과를 제공할 수 있습니다. 그러나 모델의 복잡성과 크기가 증가함에 따라 단일 GPU가 빠르게 따라잡기 어려워 훈련 시간이 길어지고 추론 속도가 느려질 수 있습니다.
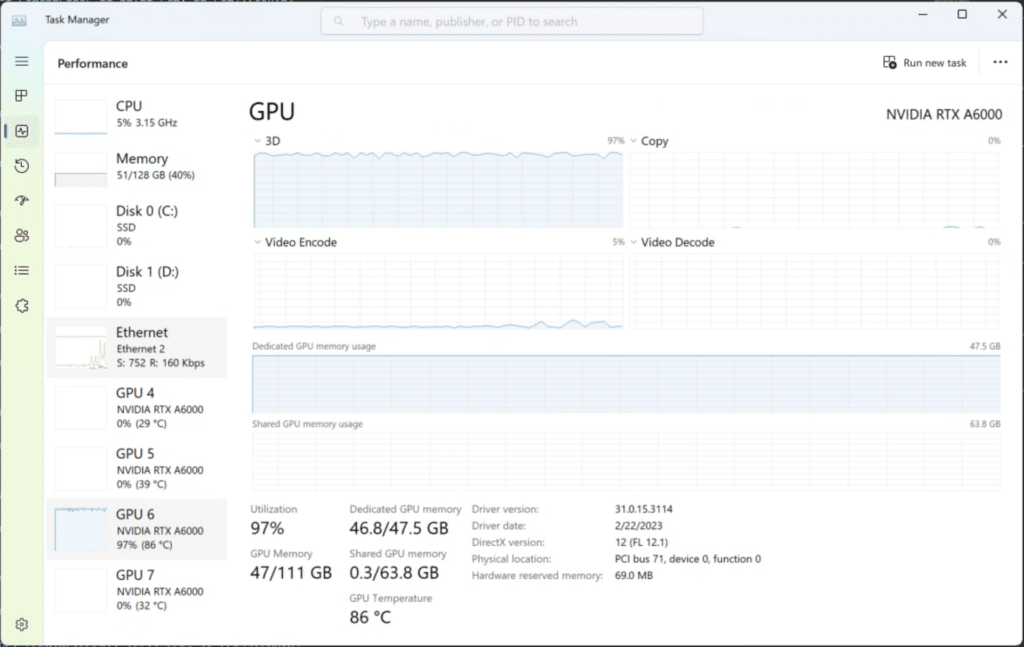
단일 GPU 활용
XNUMX개의 GPU
한 쌍의 GPU로 전환하면 AI 모델의 성능이 눈에 띄게 향상될 수 있습니다. 생각해 보십시오. 두 배의 처리 능력으로 교육 시간을 크게 단축하여 더 빠른 반복과 결과로의 빠른 여정을 위한 길을 닦을 수 있습니다.
추론 단계는 또한 더 효율적으로 성장하고 더 큰 데이터 배치를 동시에 처리할 수 있는 이점이 있습니다. 이러한 환경에서 PyTorch의 모델 병렬 처리가 작동합니다. 두 장치 간에 작업 부하를 효과적으로 분산하여 사용을 극대화합니다. 생산성이 높은 AI 작업을 달성하기 위해 하드웨어의 각 부분이 무게를 지탱하도록 하는 현명한 방법입니다.
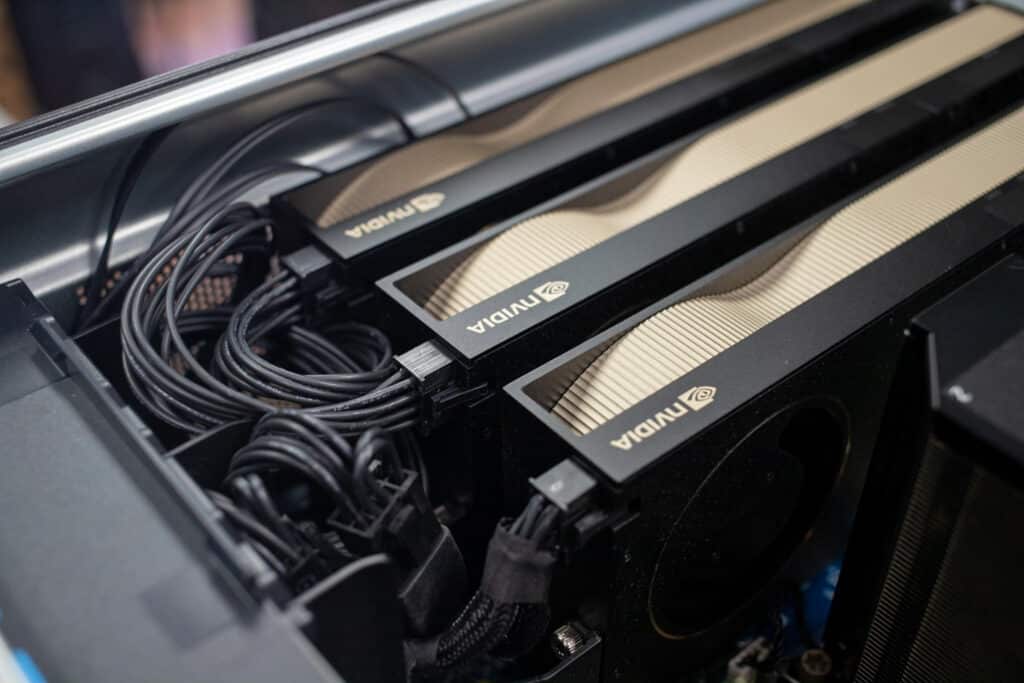
3배의 재미, NVIDIA A6000
GPU XNUMX개
최대 XNUMX개의 GPU로 확장하면 다중 GPU 활용의 이점을 다른 수준으로 끌어올릴 수 있습니다. XNUMX배의 처리 능력으로 AI 모델을 전례 없는 속도로 훈련하고 추론할 수 있습니다. 이 설정은 상당한 계산 리소스가 필요한 크고 복잡한 모델에 특히 유용합니다. PyTorch의 모델 병렬 처리는 모델을 XNUMX개 장치 모두에 분산시켜 최적의 활용도와 성능을 보장합니다.
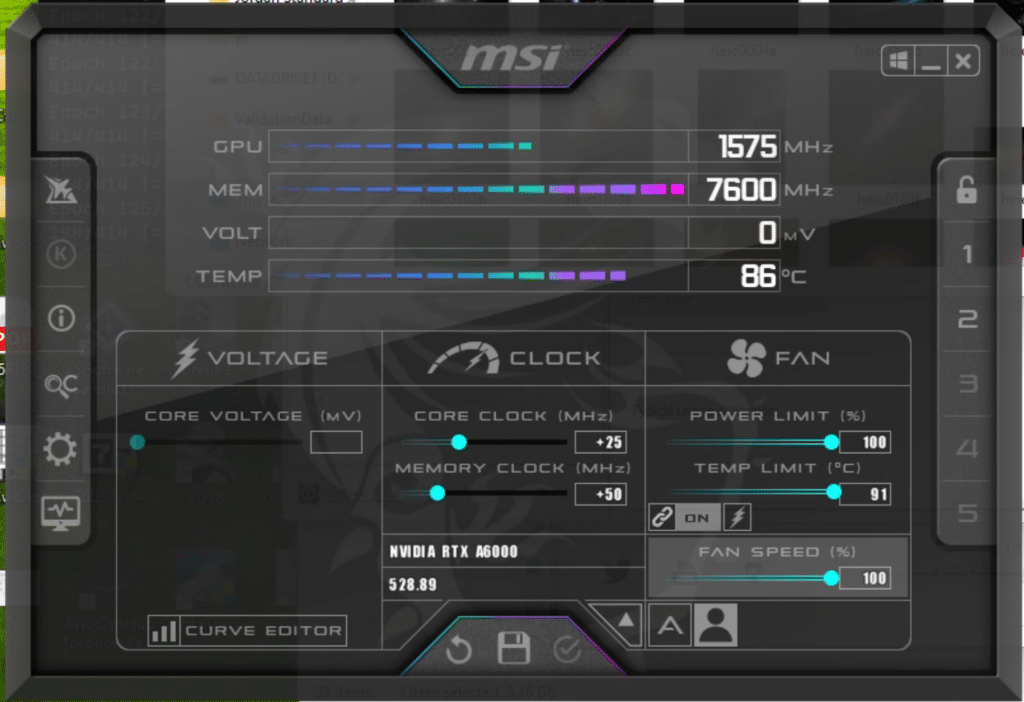
워크스테이션에서 수동 팬 및 시계 값을 적용하면 교육 성능도 향상될 수 있습니다.
실험실에서의 구현
XNUMX인 단위에서 XNUMX인조로, 그리고 결국에는 AI 훈련 및 추론을 위한 XNUMX개의 GPU로 발전하면 상당한 이점을 얻을 수 있습니다. PyTorch의 모델 병렬 처리 덕분에 이러한 이점을 최적으로 활용하여 더 빠르고 효율적인 AI 모델을 생성할 수 있습니다.
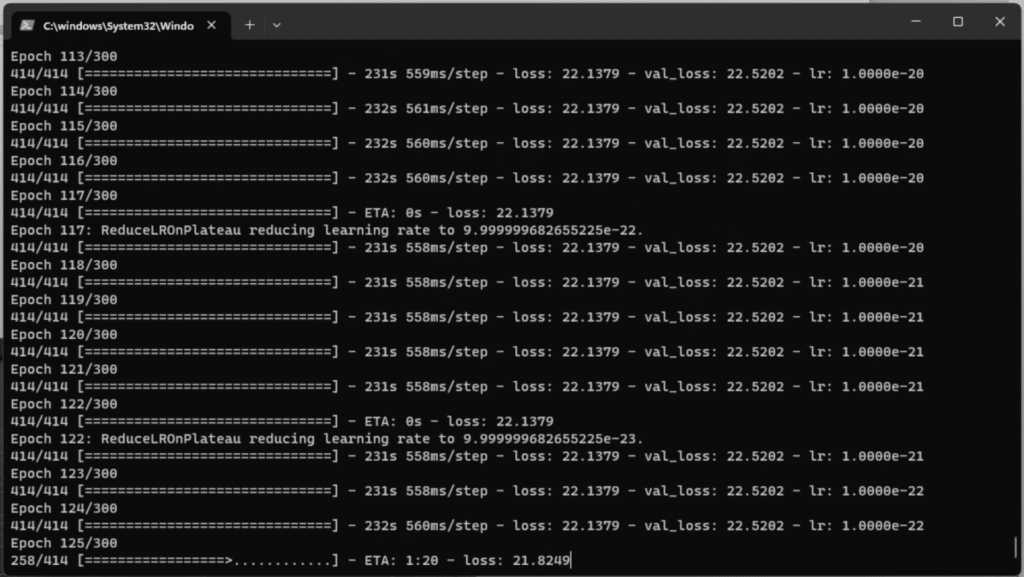
AI/ML/DL 교육에서는 시행착오, 인내가 핵심입니다.
더 복잡하고 유능한 AI에 대한 우리의 갈증이 부풀어 오르면서 다중 GPU의 채택은 의심할 여지없이 중요성이 커질 것입니다. 다음 기사에서는 더 많은 처리 능력을 추가하고 시스템 전체에 배포함에 따라 복잡성 개선 사항을 보여줍니다.
참고: 이 글은 2023년 6월 기준 AI 및 PyTorch의 현황을 바탕으로 작성되었습니다. 최신 정보를 원하시면 최근 AI 관련 게시글을 확인해 주세요.


 아마존