

Updated October 24, 2026: The Mac Studio answer now reflects the M5 Max and M5 Ultra models Apple began shipping in September, and the 64GB DGX Spark note reflects its October 23 launch; picks unchanged. On October 20, the entry bar became two or more GPUs on vLLM under Linux, or a shared memory pool with at least 96GB available to models.
Elk systeem dat op deze pagina wordt vermeld, is getest in het StorageReview-lab. We benchmarken de lokale AI-prestaties direct: vLLM online serving throughput, time-to-first-token en time-per-output-token voor modellen zoals GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B en Qwen3 Coder 30B, plus MAMF compute efficiency en GDSIO storage tests. Geen enkel systeem wordt gerangschikt op basis van een specificatieblad.
De bepalende vraag voor een lokale AI-desktop in 2026 is: geïntegreerd geheugen versus afzonderlijk VRAM ? Desktop-systemen zoals NVIDIA's GB10-gebaseerde DGX Spark en AMD's Ryzen AI Max (Strix Halo) bieden 128 GB geïntegreerd geheugen op één chip tegen een aantrekkelijke prijs, waardoor ze geschikt zijn voor systemen die anders meerdere afzonderlijke GPU's zouden vereisen.
Workstation-towers bieden pure doorvoer: RTX PRO 6000 Blackwell-kaarten leveren aanzienlijk meer tokens per seconde, maar dit gaat gepaard met een veel hogere prijs en een hoger stroomverbruik. Op deze pagina worden beide typen kaarten in aparte categorieën gerangschikt op basis van één consistente testsuite, omdat het juiste antwoord afhangt van het grootste model dat u wilt draaien en hoe snel de reactiesnelheid moet zijn.
In een oogopslag
| Categorie | Systeem | Geheugen | GPU's (getest / maximaal) | Volledige recensie |
|---|---|---|---|---|
| Beste AI-systeem voor gebruik op het bureau in het algemeen | NVIDIA DGX-Spark | 128 GB gecombineerd LPDDR5X-geheugen | GB10 geïntegreerd (vast) | DGX Spark review |
| Beste GB10-implementatie | Acer Veriton GN100 | 128 GB gecombineerd LPDDR5X-geheugen | GB10 geïntegreerd (vast) | Veriton GN100 recensie |
| Beste x86-alternatief | AMD Ryzen AI-halo (Strix-halo) | Tot 128 GB aan gecombineerd LPDDR5X-geheugen | Geïntegreerde Radeon 8060S (vast) | Ryzen AI Halo review |
| Het beste resultaat zonder aparte grafische kaart. | HP Z2 Mini G1a | Unified LPDDR5X (draaide GPT-OSS 120B) | Geïntegreerd, geen dGPU (vast) | Review van de Z2 Mini G1a |
| Beste GB300-systeem | MSI XpertStation WS300 (alternatief: ASUS ET900N G3) | 748 GB coherent (252 GB HBM3e + 496 GB LPDDR5X) | GB300 geïntegreerd (vast) | Review van de XpertStation WS300 |
| Beste toren voor lokale AI | Dell Precision 7875 | 192 GB GDDR7 (2 x 96 GB) | 2× RTX PRO 6000 / 2 max | Review van de Precision 7875 |
| Beste platform met meerdere GPU's | HP Z8 Fury G6i | 192 GB GDDR7 zoals getest / tot 384 GB | 2× RTX PRO 6000 getest / 4 max. | Review van de Z8 Fury G6i |
| De extreme keuze | Comino Grando RTX PRO 6000 | 768 GB GDDR7 (8 x 96 GB) | 8× RTX PRO 6000 / 8 max | Comino Grando recensie |
AI-apparaten voor op het bureau
De appliance-categorie, wat Dell deskside AI noemt en NVIDIA de persoonlijke AI-supercomputer , ruilt piekdoorvoer in voor modelcapaciteit, energie-efficiëntie en prijs. Met 128 GB aan geïntegreerd geheugen kunnen deze systemen probleemloos 70B-klasse modellen met hoge kwantisering aan en zelfs 120B-klasse taken, waarvoor in een tower-pc meerdere afzonderlijke GPU's nodig zouden zijn.
Essentiële laboratoriuminformatie voor deze categorie: onze DGX Spark thermische test vergelijkt OEM-koelingsontwerpen van de onderstaande GB10-systemen en is van toepassing op elk apparaat in deze klasse totdat deze platforms een herziening ondergaan.
Beste AI-systeem voor gebruik op het bureau: NVIDIA DGX Spark
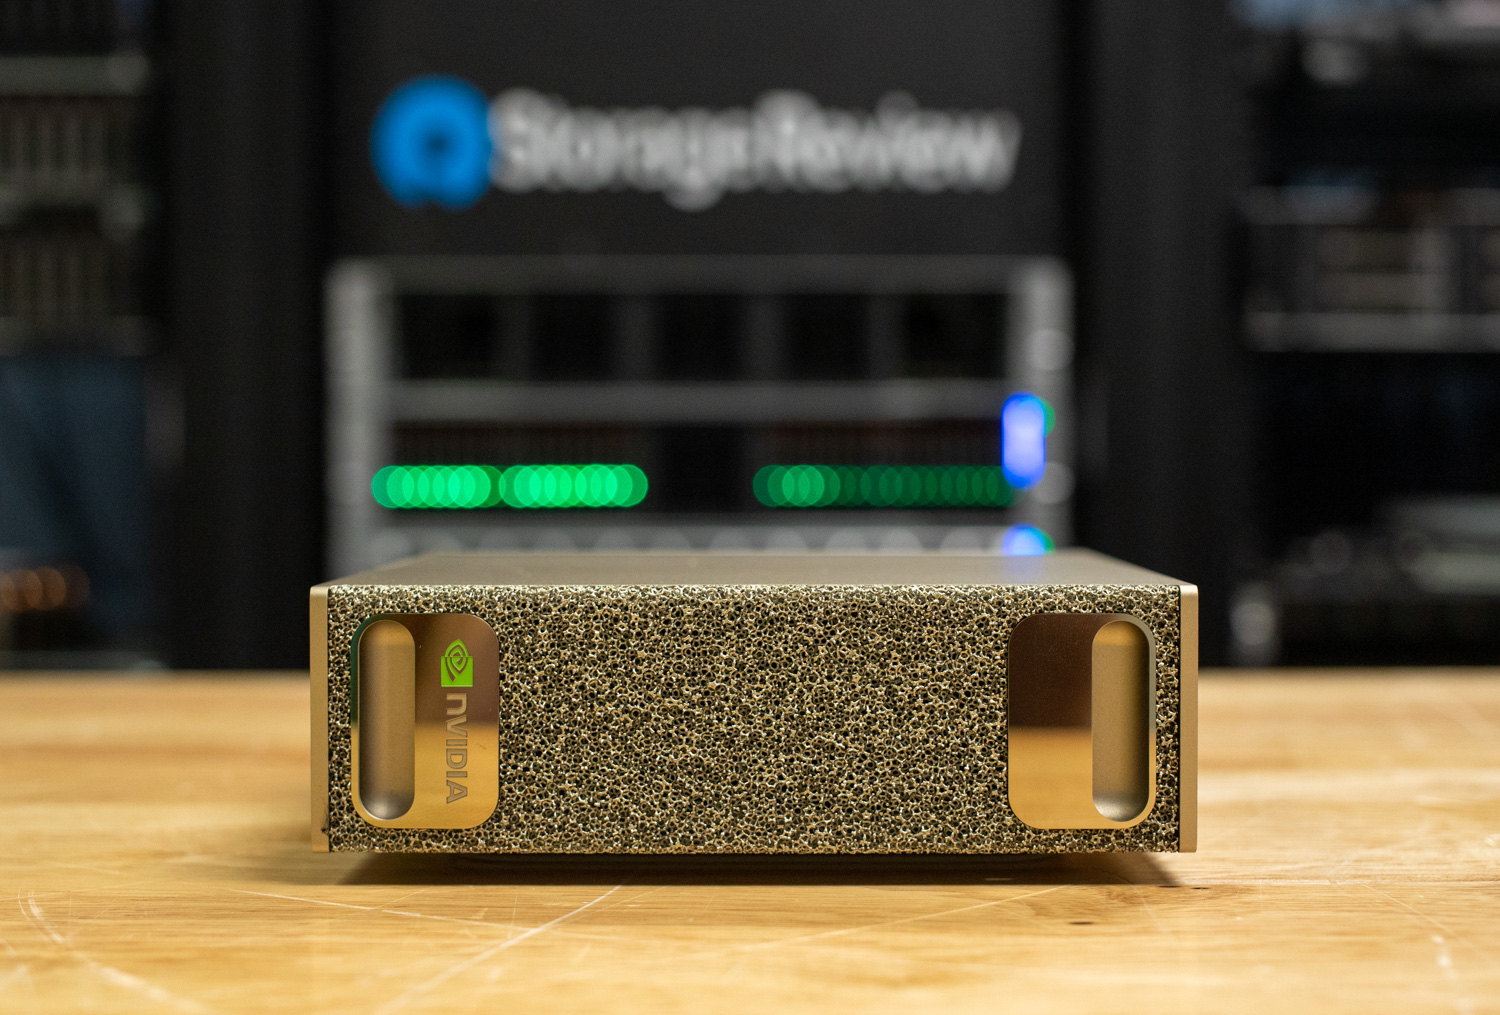
De DGX Spark is de maatstaf waaraan alle andere desktop AI-systemen worden afgemeten. De GB10 Grace Blackwell-superchip combineert een 20-core Arm CPU met 128 GB aan LPDDR5X-geheugen en twee ConnectX-7 200GbE-poorten, waardoor het de enige appliance in onze testklasse is die direct clustering mogelijk maakt: onze tests met gedistribueerde inferentie op twee nodes voerden parallelle workloads uit op Dell-, GIGABYTE- en HP-nodes via 200GbE.
That clustering story now has a cheaper on-ramp: NVIDIA launched a De 64GB DGX Spark SKU is vanaf 23 oktober verkrijgbaar voor $4,999.De geheugenmodules worden via dezelfde zes OEM's verkocht, en twee daarvan vormen een duo via één 200GbE-kabel om 128 GB te bundelen; NVIDIA claimt dat het geclusterde paar tot 1.7 keer de snelheid van een enkele 128 GB-eenheid kan bereiken op de Qwen3.8 27B, een bewering die we nog niet hebben getest. De CUDA-softwarestack blijft de meest uitgebreide in dit segment.
De enige echte beperking van het platform is de opslagcapaciteit: elk GB10-systeem heeft een maximum van ongeveer 4 TB op een enkele M.2-sleuf. Onze gedeelde opslagconfiguratie met acht Spark-systemen is de oplossing voor dit probleem: een enkele, beheerde QLC-array die gebruikmaakt van de 100 GbE-poorten die elke Spark al heeft. Eén client haalde daarbij een leessnelheid van 10.8 GiB/s, wat overeenkomt met de snelste interne M.2-sleuf die we in een GB10-systeem hebben gemeten. Een centraal gehost model van 78 GB presteerde bovendien binnen 13% van de lokale NVMe-snelheid.
Lees de volledige DGX Spark-recensie
Beste GB10-implementatie: Acer Veriton GN100
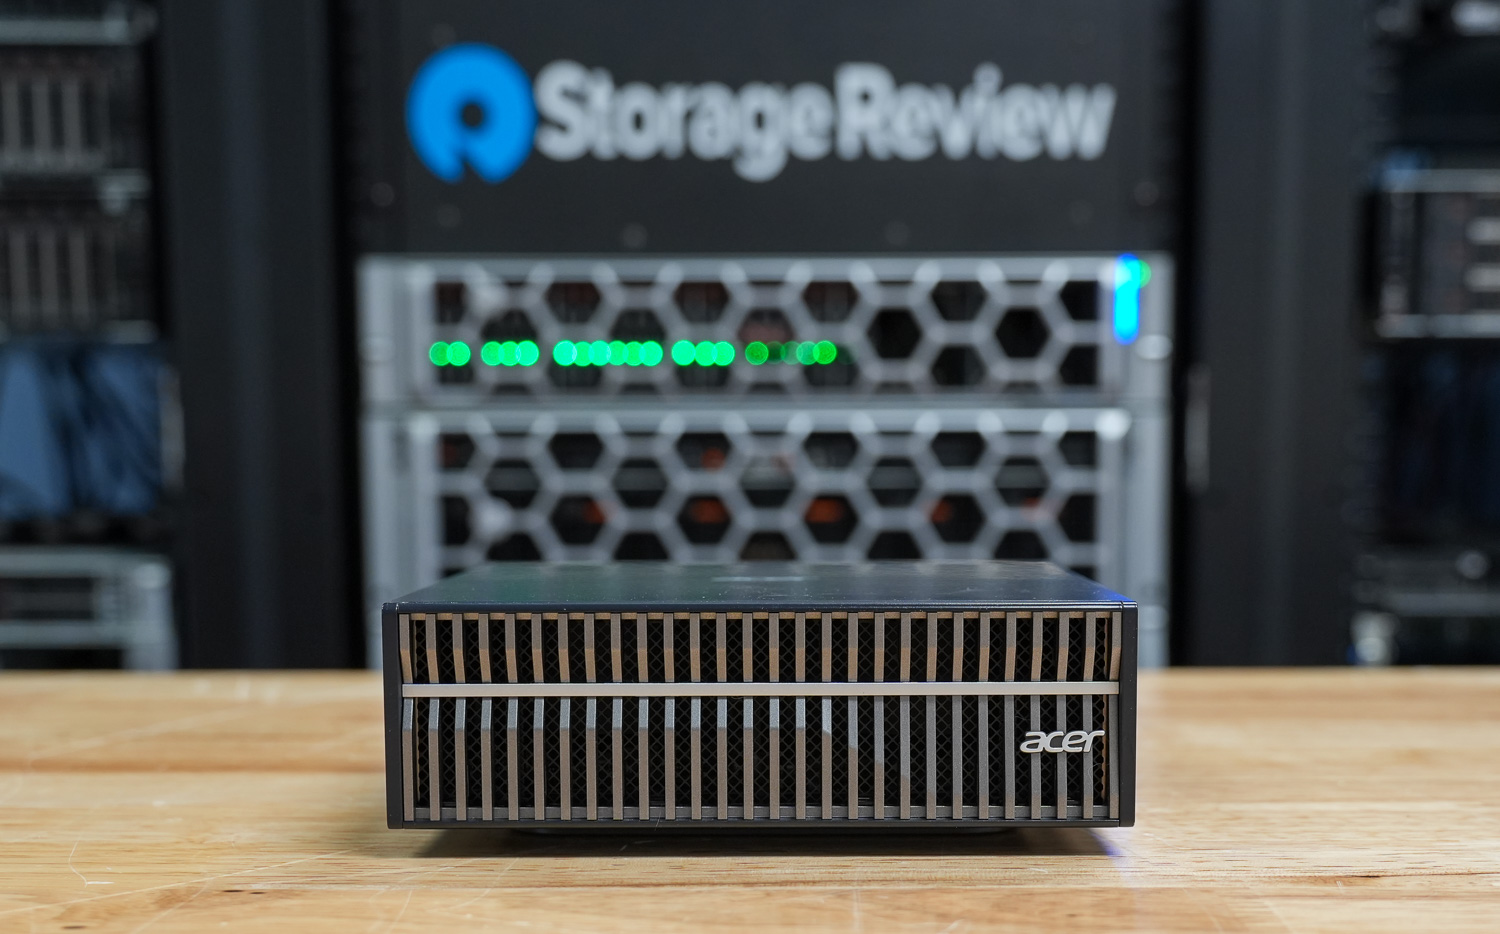
Bij de GB10 OEM-systemen is het thermische ontwerp de belangrijkste factor die het verschil maakt, en de Veriton GN100 kwam in onze tests als beste uit de bus. Alle GB10-systemen delen dezelfde chip en geheugenconfiguratie, dus de prestaties hangen grotendeels af van de koeling. Onze vergelijking van de koeling van meerdere OEM-systemen is, voor zover wij weten, de enige in zijn soort die gepubliceerd is.
Lees de volledige recensie van de Veriton GN100.
Beste x86-alternatief: AMD Ryzen AI Halo
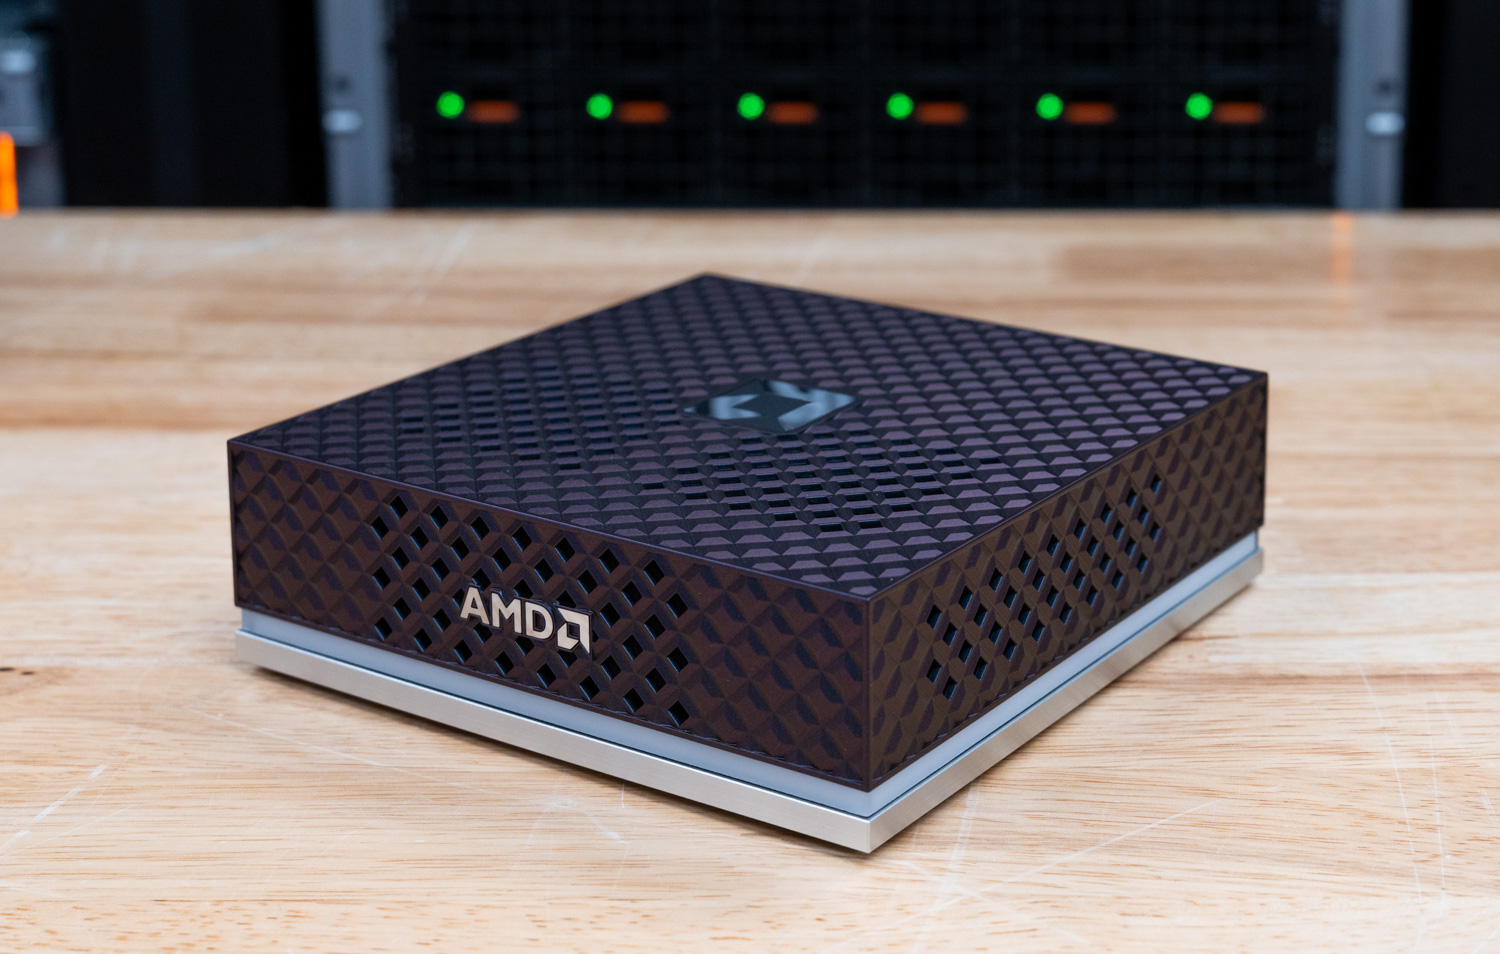
Als je Windows of een standaard x86-softwarepakket nodig hebt, is Strix Halo de ideale oplossing voor op je bureau. AMD's Ryzen AI Max+ 395-platform combineert 128 GB aan geïntegreerd geheugen met een dual-OS-configuratie en in onze tests kon het modellen van de 200B-parameterklasse aan, een directe concurrent voor de DGX Spark zonder de verplichting van Arm/DGX OS.
Lees de volledige Ryzen AI Halo-recensie.
Beste keuze zonder aparte grafische kaart: HP Z2 Mini G1a
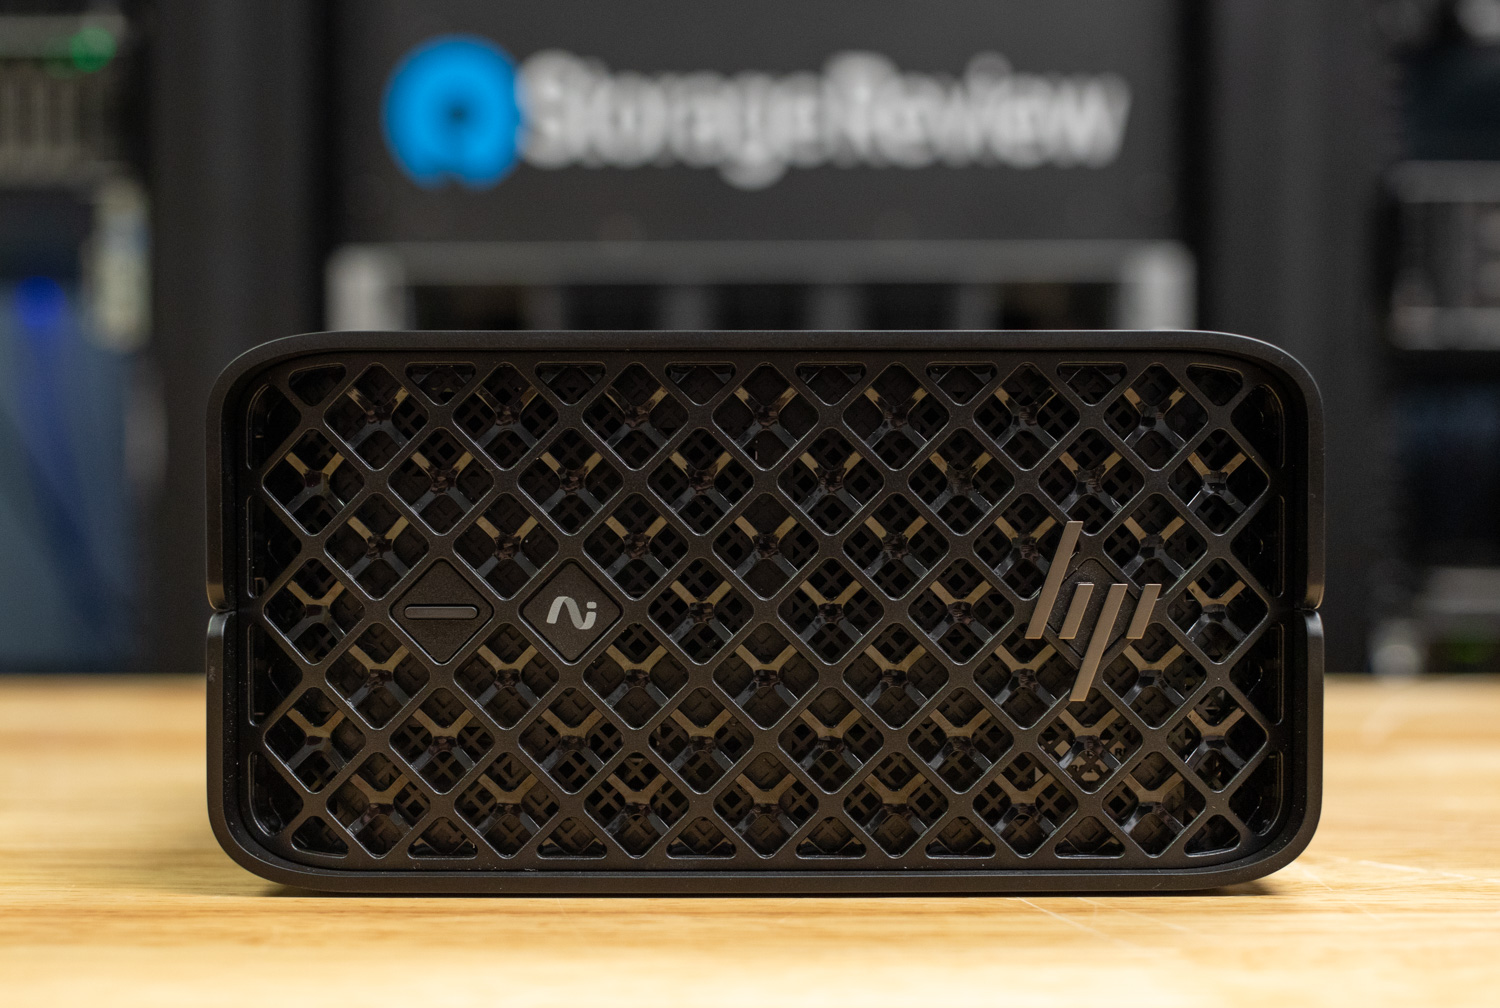
De Z2 Mini G1a draaide GPT-OSS 120B helemaal zonder aparte grafische kaart. HP's mini-werkstation combineert AMD's Ryzen AI Max+ PRO-processor in een compacte, stille en IT-vriendelijke behuizing en is daarmee het duidelijkste bewijs dat x86-systemen met geïntegreerd geheugen de mogelijkheden van een kleine kantoorcomputer hebben veranderd ten opzichte van grotere modellen.
Lees de volledige review van de Z2 Mini G1a
Beste GB300-systeem: MSI XpertStation WS300
De WS300 is het eerste GB300 DGX-station dat we in ons lab hebben getest en legt de lat voor dit type apparaat hoger. De Grace Blackwell Ultra-superchip beschikt over 748 GB coherent geheugen, bestaande uit 252 GB HBM3e en 496 GB LPDDR5X, goed voor 20 petaFLOPS FP4-rekenkracht. In onze tests verwerkte het apparaat een GLM-5.2-checkpoint van 433 GB met 216 GB aan expert-gewichten in het Grace-geheugen – een model dat eigenlijk niet geschikt is voor gebruik naast een bureau. Net als elk DGX-systeem draait het op DGX OS in plaats van Windows; dat is de prijs die je betaalt voor zoveel geheugen.
Qua prijs en vermogen bevindt hij zich dichter bij de extremen van de tower-categorie dan bij de GB10-boxen daarboven, maar geen enkel ander apparaat in de categorie huishoudelijke apparaten heeft een model van dit formaat. De voor de hand liggende vraag of een 1,300W-processor in een tower-behuizing gaat throttlen, heeft nu een meetbaar antwoord: onze diepgaande thermische analyse van de WS300 registreerde een continue test van 2.8 uur waarbij de Blackwell Ultra-chip op 60°C werd gehouden, een constante kloksnelheid van 2.07 GHz zonder dips en ongeveer 20°C thermische marge over bij volledige belasting.
Alternatief voor de GB300: de ASUS ExpertCenter Pro ET900N G3 is het tweede GB300 DGX-station dat we hebben getest en bevestigt de kwaliteit van het platform: in 14 modellen en twee workloads lagen 24 van de 28 piekdoorvoervergelijkingen binnen 2% van de WS300, en de modellen met coherente pool presteerden gelijkwaardig of beter. ASUS heeft handgrepen toegevoegd aan de 27 kg zware tower, een speciale ventilator boven de 400G-optische cages en een 80 PLUS Titanium-voeding. Beide towers bieden het platform; lees onze review van de ET900N G3 voor een vergelijking tussen de twee towers.
Cluster-schaalbaarheid: twee van deze torens, met elkaar verbonden via hun eigen 400G-poorten, worden nu gemeten, niet beloofd: onze GB300-clustertest combineerde de ASUS- en HP-stations met twee DAC's, bereikte 98% van de lijnsnelheid op de NCCL-collectieven en zorgde ervoor dat GLM-5.2, een 433GB-model dat een enkel station alleen kan bedienen door 215GB aan gegevens in het Grace-geheugen te laden, van 139 uitvoertokens per seconde bij 32 streams naar 1,525 ging, en uiteindelijk naar 3,141 bij 256 streams.
Modellen die op één Station-schaal passen, presteren verschillend: de prefill/decode-disaggregatie verdrievoudigde de short-prompt-doorvoer van GLM-5.3 Flash, en DeepSeek V4.1 Flash behaalde 5,248 tokens per seconde, de hoogste output in de set.
Lees de volledige recensie van de XpertStation WS300.
In het lab: HP ZGX Fury AI-station
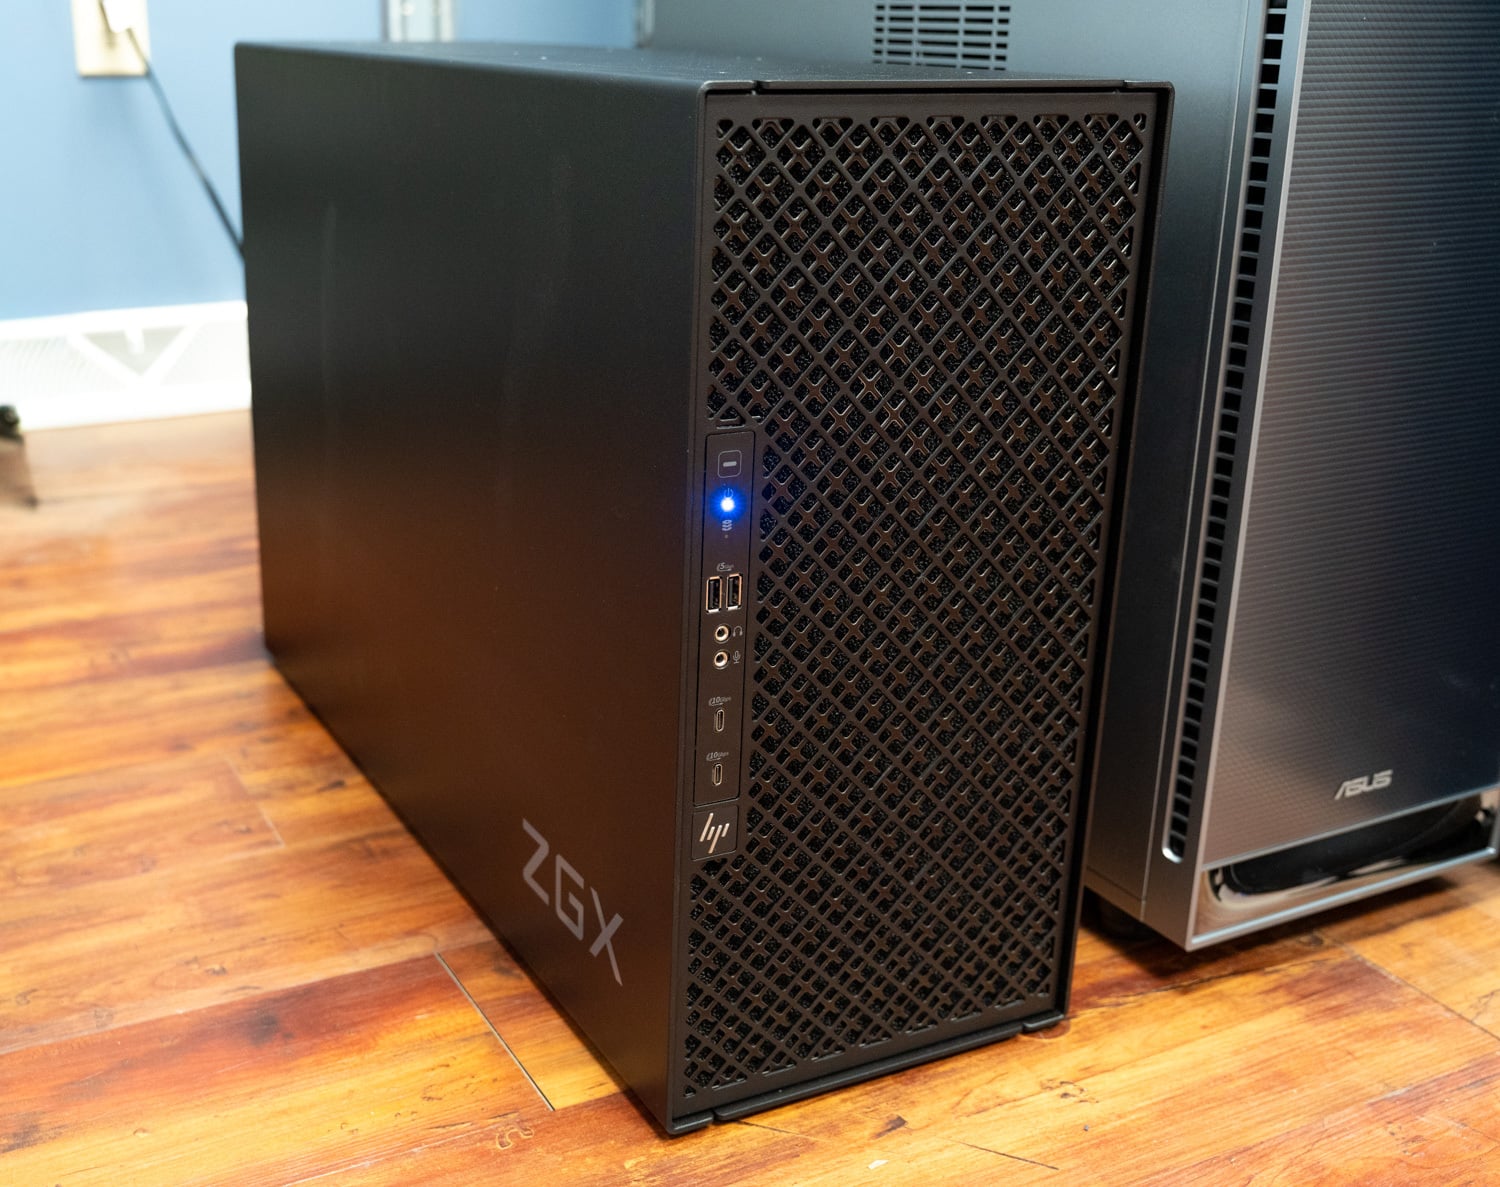
De HP ZGX Fury AI Station is het derde systeem uit de GB300-klasse dat ons lab bereikte, na de MSI WS300 en de ASUS ET900N G3, waarvan de resultaten voor deze twee towers binnen 2% van elkaar lagen.
De HP ZGX Fury AI Station staat nu in ons lab. Hij is gebouwd op hetzelfde NVIDIA GB300 Grace Blackwell Ultra-platform als de MSI XpertStation WS300 hierboven, waardoor het de eerste gelegenheid is om te zien hoe de implementaties van de DGX Station-architectuur van twee fabrikanten zich tot elkaar verhouden op dezelfde testopstelling: thermische prestaties, geluidsproductie, continue kloksnelheden en de praktische ervaring van het gebruik van de machine.
De eerste openbare cijfers zijn al bekend: de ZGX Fury fungeerde als tweede tower in onze GB300-clustertest met twee stations , waarbij de decodering werd uitgevoerd voor de gedisaggregeerde GLM-5.3 Flash-configuratie en de helft van elke tensor-parallelle run. De eigen review is in volle gang en de ZGX Fury wordt in de ranglijst opgenomen zodra de eigen benchmarkresultaten bekend zijn.
De ZGX Fury is ook een van de eerste twee systemen die Microsoft heeft aangekondigd voor DGX Station voor Windows , naast de Dell Pro Precision met GB300. NVIDIA heeft de Windows-versie voor het vierde kwartaal aangekondigd. De hardware komt overeen met de GB300-torens die we op Ubuntu hebben getest, en het is nog de vraag of serverstacks native op Windows of onder WSL draaien.
In aantocht: AMD Threadripper Halo Station
De Threadripper Halo Station van AMD, aangekondigd op IFA 2026 maar nog niet in een testlab getest, is het eerste directe antwoord op de GB300-klasse hierboven. De aanpak is precies het tegenovergestelde van die van NVIDIA: in plaats van één grote, samenhangende geheugenpool combineert AMD een 96-core Threadripper PRO op een platform met maximaal 2 TB aan achtkanaals DDR5-geheugen en 128 PCIe 5.0-lanes met twee 600W Instinct MI350P-acceleratoren die elk 144 GB HBM3E-geheugen ondersteunen, en een uitbreidingsmogelijkheid naar vier kaarten en 576 GB HBM-geheugen. Het hele systeem is vloeistofgekoeld en de x86-host omzeilt de problemen met de Arm-toolchain die we in de WS300-review hebben aangekaart.
De open vraag is hoe goed modellen presteren tussen PCIe-aangesloten kaarten en NVLink-C2C-compatibiliteit. AMD heeft nog geen benchmarks, prijzen of beschikbaarheid bekendgemaakt, dus dit is een product om in de gaten te houden, geen product om aan te bevelen. Meer details vind je in ons bericht over de aankondiging ; het product wordt in de ranglijst opgenomen zodra de hardware in ons lab arriveert.
Ook getest: AI-apparaten voor op het bureau
Deze systemen hebben hetzelfde testproces in het laboratorium doorlopen en zijn solide keuzes die geen plek in een categorie hebben ingenomen: Dell Pro Max met GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n en HP EliteDesk 8 Mini G1a.
Werkstationtorens voor lokale AI
Wanneer responstijd belangrijker is dan aanschafkosten (interactieve code-assistenten, multi-user service, agentische pipelines met lange tool-call chains), blijft discreet VRAM de beste keuze. Deze towers worden hier gerangschikt op inferentiedoorvoer en geheugenlimiet. Voor elke tower vermelden we de GPU-configuratie die we hebben getest, samen met de maximale capaciteit van de behuizing. Wat een behuizing uiteindelijk kan bevatten is immers net zo belangrijk als wat er in onze build is meegeleverd; een tower heeft twee of meer GPU's nodig om in deze sectie te worden opgenomen. Towers met één GPU, inclusief die met een 96GB RTX PRO 6000, worden gerangschikt op onze pagina 'Beste desktopwerkstations ' in onze Windows-clientsuite, omdat ze een andere vraag beantwoorden.
Beste tower voor lokale AI: Dell Precision 7875
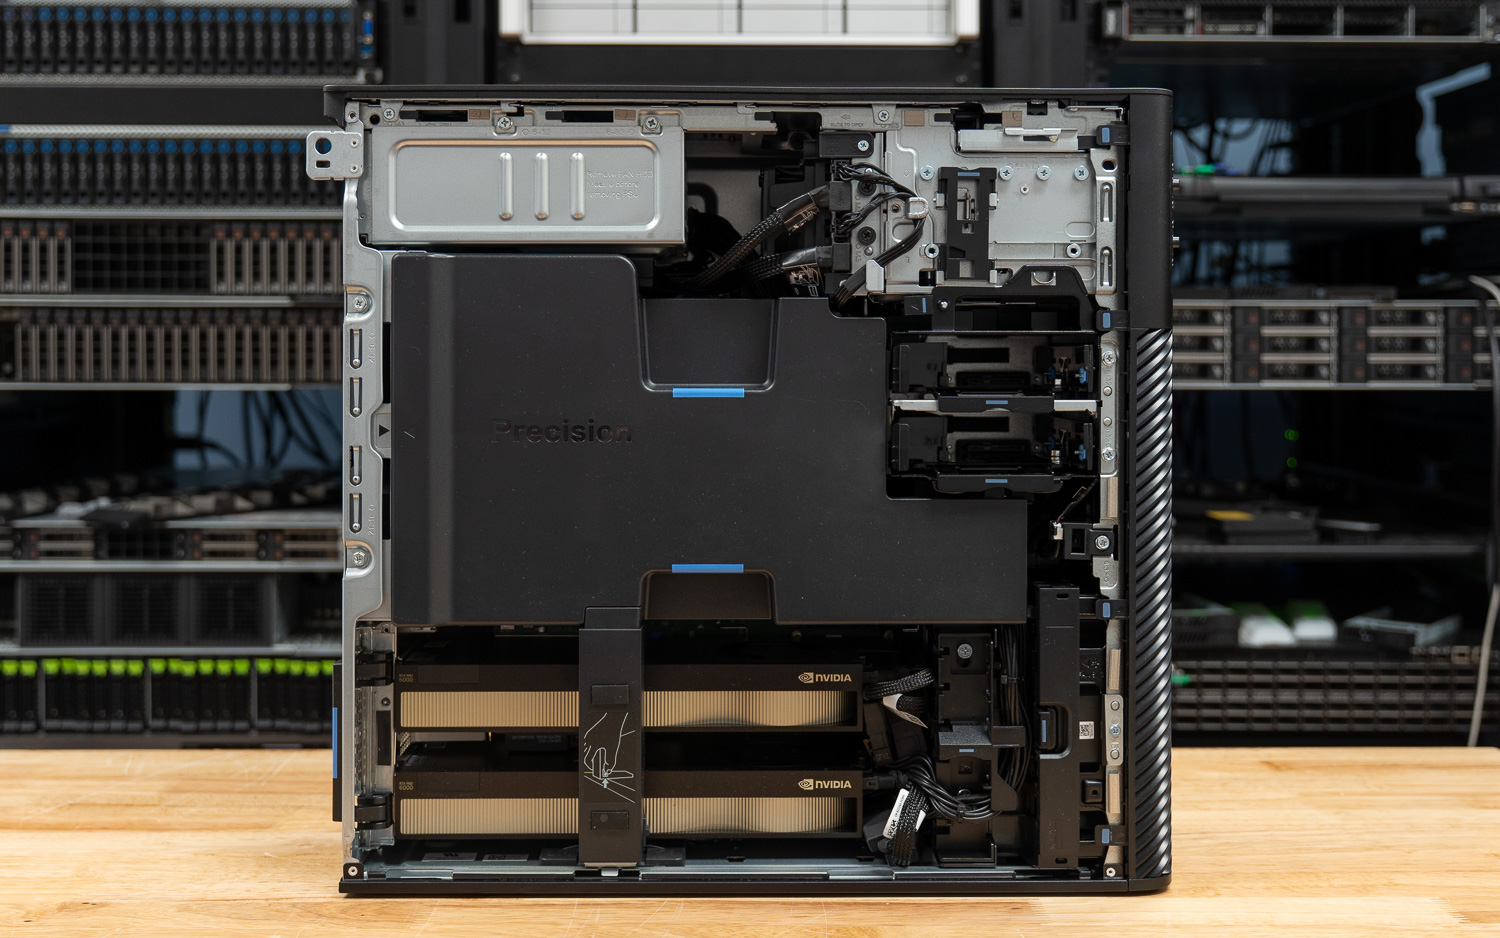
Dankzij de twee RTX PRO 6000 Blackwell GPU's is de Precision 7875 het snelste standaard-systeem dat we hebben getest voor lokale inferentie. Met een Threadripper PRO 9995WX en 192 GB gecombineerd VRAM verdeeld over twee kaarten, kan het 100B-klasse modellen volledig in GPU-geheugen verwerken en levert het interactieve time-to-first-token die geen enkel systeem met geïntegreerd geheugen kan evenaren. Houd echter rekening met de limiet: de 7875-behuizing ondersteunt maximaal twee dual-width kaarten, dus onze configuratie met twee GPU's is de maximale configuratie; het is niet mogelijk om later een derde kaart toe te voegen.
Lees de volledige review van de Precision 7875.
Beste platform met meerdere GPU's: HP Z8 Fury G6i
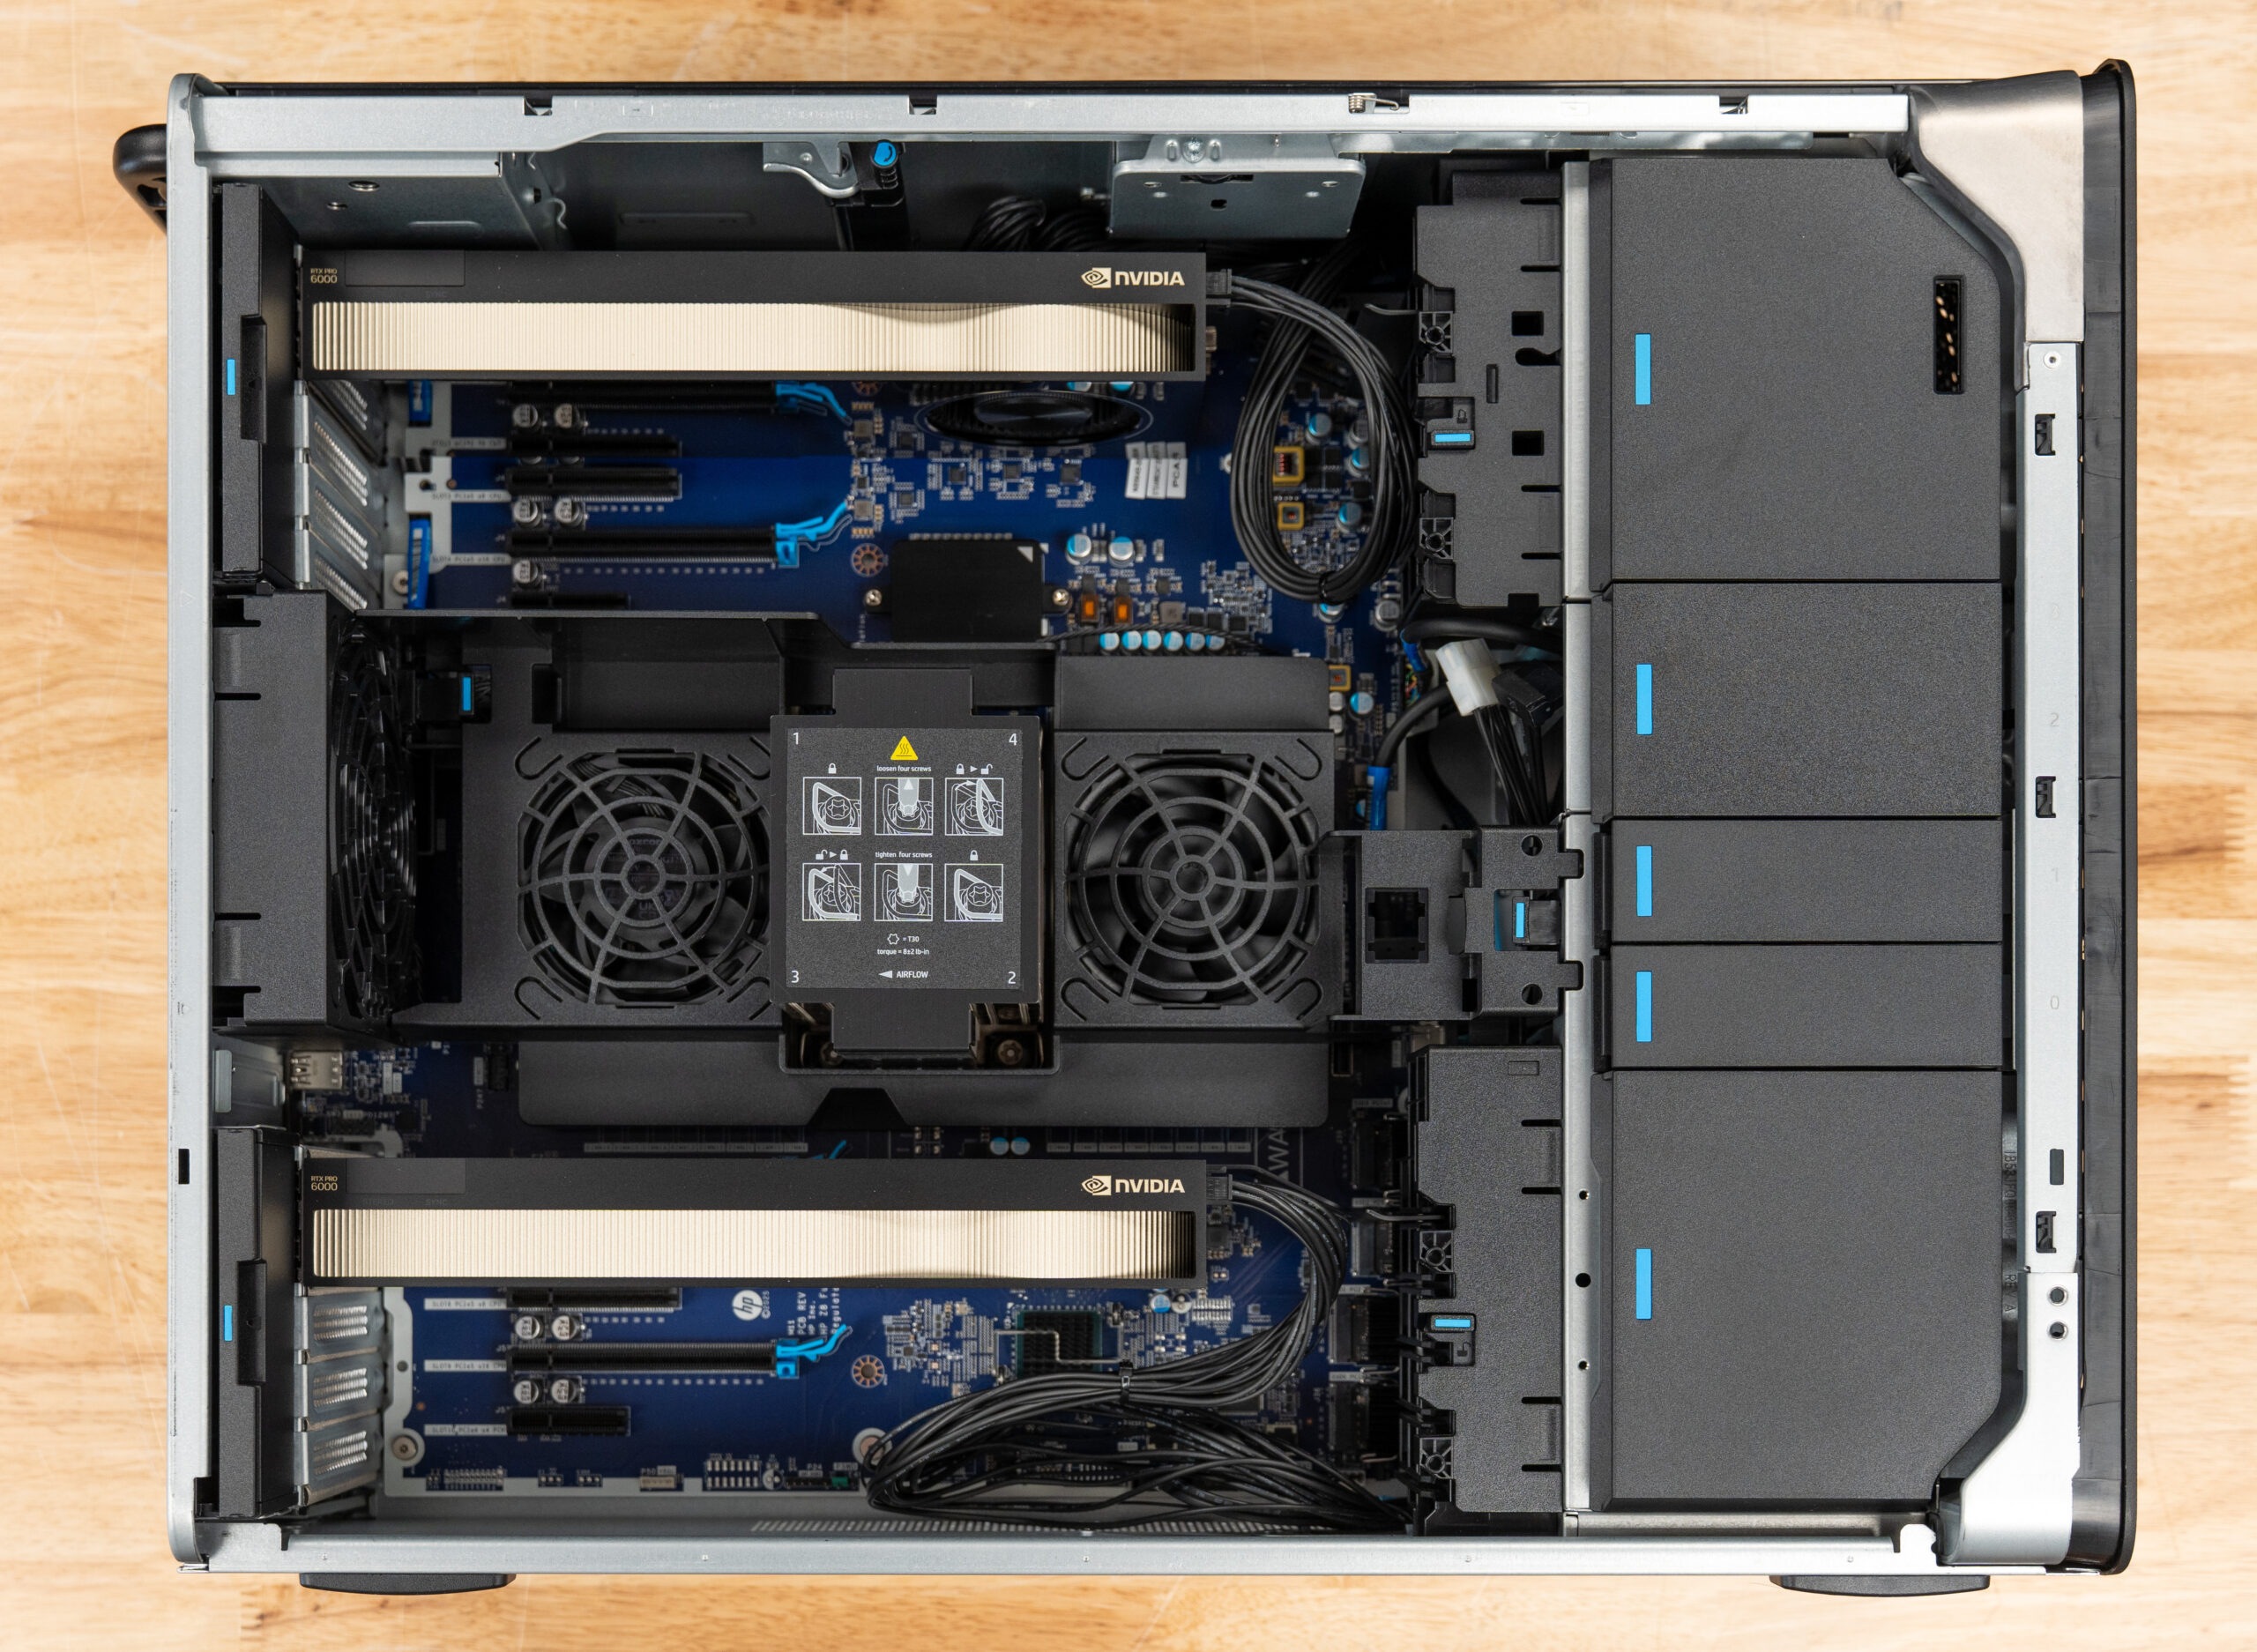
De Z8 Fury G6i is de tower die je koopt als je van plan bent om in de toekomst meer GPU's te installeren. Ons testmodel had twee RTX PRO 6000 Max-Q-kaarten met een gecombineerd VRAM van 192 GB, maar de behuizing, gevoed door twee voedingen met een totaal vermogen van 2700 W, ondersteunt tot vier Blackwell-kaarten en 384 GB VRAM. Dat verschil tussen de geteste en de maximale configuratie is precies de bedoeling: geen enkele standaard OEM-tower die we hebben getest biedt meer ruimte voor GPU's, en de overstap van twee naar vier kaarten vereist geen aanpassing van de behuizing.
Lees de volledige review van de Z8 Fury G6i
De extreme keuze: Comino Grando RTX PRO 6000
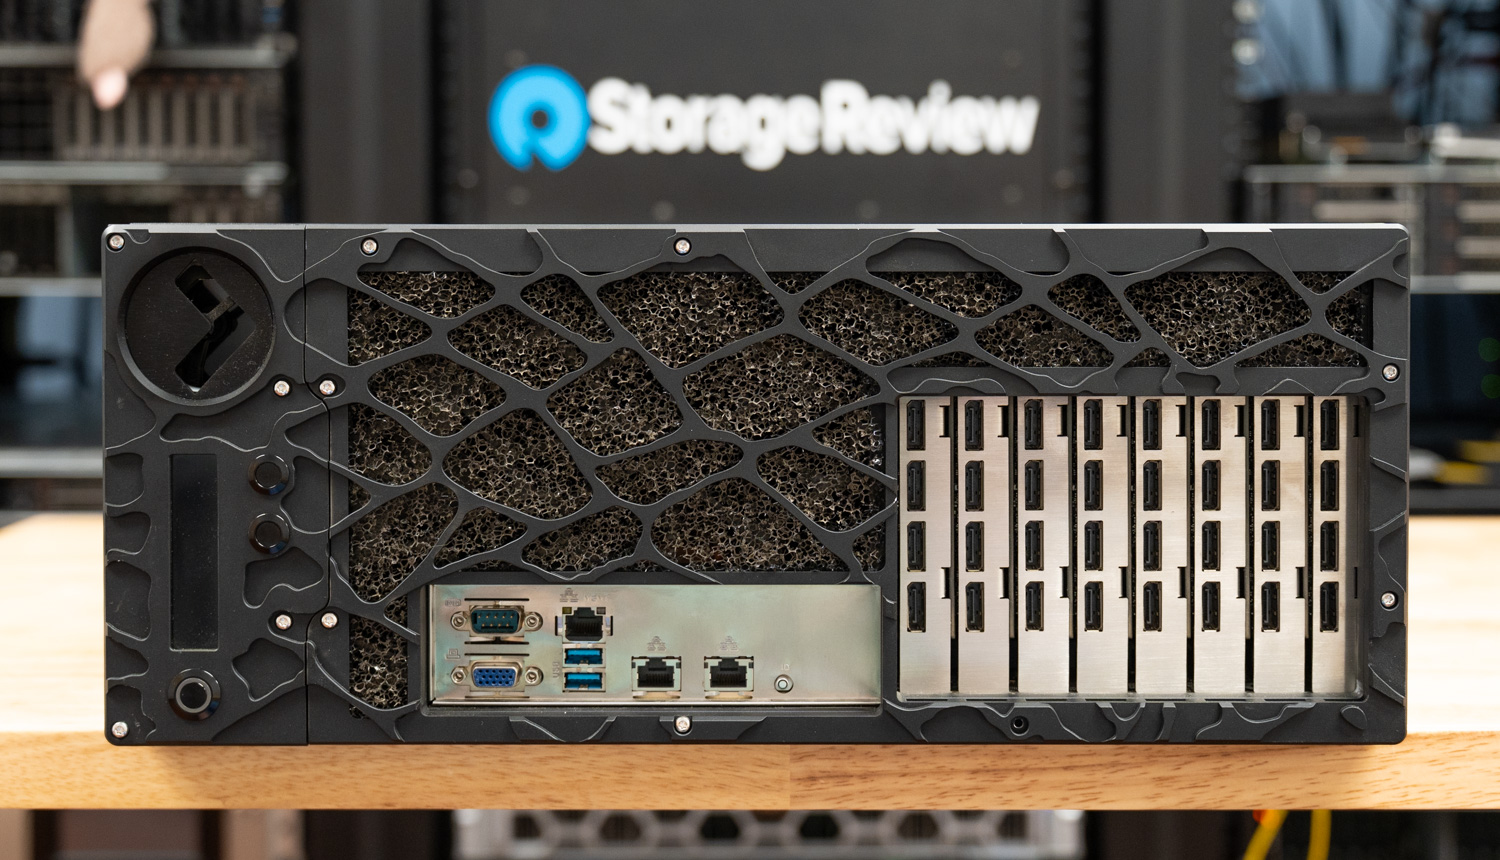
768 GB VRAM in een vloeistofgekoelde 4U-behuizing: de Grando is er voor de koper wiens model nergens anders past. Ons testexemplaar werd geleverd met acht RTX PRO 6000 Blackwell-kaarten van elk 96 GB, het maximum dat de behuizing toelaat, en Comino's vloeistofkoeling houdt alle acht kaarten continu op volle TDP zonder throttling. Dat is meer GPU-geheugen dan veel rackservers, in een behuizing die nog steeds naast een bureau past. De prijs is hoog, maar het geluid niet, en het is bewust de buitenbeentje in deze lijst: bewijs van de grenzen van wat er naast een bureau mogelijk is.
Lees de volledige recensie van Comino Grando
Hoe we rang
Er gelden drie regels voor elk StorageReview-klassement, en de eerste is dat Alleen in het laboratorium geteste systemen worden gerangschikt.Als we het niet hebben vergeleken met andere producten, kan het wel genoemd worden, maar het kan geen categorie vormen. Ten tweede worden systemen per meeteenheid één keer gerangschikt. De bovenstaande towers stonden ook in onze ranglijst voor desktopwerkstations op basis van SPECworkstation- en renderingprestaties tot oktober 2026, toen die pagina werd verplaatst naar systemen met één GPU; hun resultaten daar blijven in de betreffende reviews staan, en hier worden ze gerangschikt op inferentiedoorvoer en geheugenlimiet.
Ten derde is er een toegangsbarrière: Een systeem heeft twee of meer GPU's nodig, getest met vLLM onder Linux, of een gedeelde geheugenpool met minimaal 96 GB beschikbaar voor de modellen. Towers met één GPU, zelfs met een kaart van 96 GB, scoren lager op onze ranglijst. Beste desktopwerkstations pagina over onze Windows-clientsuite.
De ranglijsten zijn gebaseerd op een combinatie van vLLM online serverdoorvoer, tijd tot eerste token, tijd per outputtoken, MAMF rekenefficiëntie, GDSIO opslagprestaties en verkoopprijs. Bij gelijke scores binnen de ranglijsten beslist de redactie. Leveranciers zien de ranglijsten niet vóór publicatie en plaatsing op deze pagina is niet betaald.
Veelgestelde vragen over lokale AI-desktops
Wat is de beste desktop voor agentische AI?
Agentische workloads zoals codeeragents, tool-calling pipelines en autonome taken met meerdere stappen zijn gevoelig voor doorvoer en latentie op een manier die bij gebruik van één chat niet het geval is, omdat agents veel modelaanroepen met een grote context aan elkaar koppelen. Dat is in het voordeel van de tower-klasse: het discrete VRAM van de Dell Precision 7875 levert de constante tijd tot het eerste token die nodig is om lange agentketens responsief te houden. Voor budgetbewuste agentische experimenten draait een GB10-klasse appliance dezelfde stacks op een lagere snelheid. Onze volledige richtlijnen voor dimensionering vindt u in RAM, GPU & Storage voor Agentische AI.
Hoeveel geheugen heb ik nodig om een 70B-model lokaal te draaien?
In de praktijk heeft een 70B-model met 4-bits kwantisering ongeveer 40-48 GB aan modeltoegankelijk geheugen nodig vóór context; comfortabel interactief gebruik met een lange context vereist meer. Daarom kunnen apparaten met 128 GB aan uniform geheugen 70B-modellen goed aan, en daarom staan towers met één GPU op onze pagina met de beste desktopwerkstations.
Heb ik speciale stroom nodig om deze systemen te laten werken?
Voor de apparaten is het antwoord nee: GB10-klasse apparaten en Strix Halo-systemen werken prima op een standaard kantoorstopcontact. Voor de towers is het echter raadzaam om met de eigenaar van het gebouw te overleggen. Een volledig geconfigureerde HP Z8 Fury G6i kan twee voedingen met een totaal vermogen tot 2700W aan, meer dan een standaard 15-ampère, 120V-circuit kan leveren. De Comino Grando specificeert hot-swap voedingen van 2000W die een ingangsspanning van 180-264V vereisen, en 1000W-eenheden bij een 110V-aansluiting.
Voordat u bovenaan deze pagina een aankoop doet, controleer dan eerst wat de stroomvoorziening van het stopcontact toelaat; een aparte stroomkring of een 208/240V-aansluiting kan een deel van de werkelijke kosten van een complete GPU-configuratie uitmaken. Warmteontwikkeling volgt dezelfde formule, aangezien elke verbruikte watt uiteindelijk in de ruimte terechtkomt.
En wat dacht je van een Mac Studio?
Not yet, because we have not lab-tested one. Apple began shipping the Mac Studio with M5 Max and M5 Ultra on September 22, with the M5 Max at up to 128GB of unified memory from $2,499 and the M5 Ultra at up to 512GB from $5,499. The 512GB configuration, the one that matters most for very large models, is due in late October at a price Apple has not announced. If we test one, it is ranked on measured results like every system on this page.


 Amazon