

Bijgewerkt op 26 oktober 2026: De Lenovo ThinkPad P1 Gen 9 is toegevoegd aan 'Ook getest' met zijn nieuwe MLPerf Client-testresultaten; de keuzes blijven ongewijzigd. Op 16 oktober werden RTX Spark-laptops aan de pagina toegevoegd in een eigen sectie, met als hoogtepunten de HP OmniBook Ultra 16 en de Lenovo Yoga 9n 2-in-1 16.
Elke laptop die hier wordt vermeld, is getest in het StorageReview-lab. We meten de lokale AI-prestaties direct: UL Procyon AI Text Generation voert dezelfde modellen uit op elk systeem dat ze kan draaien, en waar de hardware dat toelaat, gaan we dieper in op de materie met LM Studio en Ollama. Niets op deze pagina is gerangschikt op basis van specificaties, en elke vermelding linkt naar de review waarin de gegevens zijn opgenomen.
Er zijn twee manieren om AI-modellen op een laptop te draaien in 2026. Discrete NVIDIA RTX PRO GPU's leveren de snelste tokens per seconde, maar het model moet wel binnen het VRAM van de kaart passen, dat varieert van 8 GB tot 24 GB. Ontwerpen met gedeeld geheugen, zoals AMD's Ryzen AI Max+ (Strix Halo) en Intel's Core Ultra LPCAMM2-platforms, ruilen pure snelheid in voor capaciteit: de GPU kan het grootste deel van het systeemgeheugen gebruiken, waardoor veel grotere modellen überhaupt laden. De onderstaande voorbeelden bestrijken beide mogelijkheden, plus de efficiëntieklasse met een NPU als prioriteit.
In een oogopslag
| Categorie | Systeem | AI-motor | Belangrijkste resultaat: | Volledige recensie |
|---|---|---|---|---|
| Beste laptop voor lokale AI | Dell Pro Max 18 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 185 tok/s (Phi, Procyon), de snelste laptop die we hebben getest. | Review van de Pro Max 18 Plus |
| Het meest geschikt voor grote modellen. | HP ZBook Ultra G1a 14 | Ryzen AI Max+ PRO 395, tot 96 GB toewijsbaar uniform geheugen | DeepSeek-R1 70B geladen; Gemma 3 27B met 9 tok/s | Recensie van de ZBook Ultra G1a |
| Beste 16-inch balans | Dell Pro Max 16 Plus | RTX PRO 5000 Blackwell 24GB / 128GB CAMM2 | 179 tok/s (Phi) met een batterijduur van 6 uur en 21 minuten. | Review van de Pro Max 16 Plus |
| Beste ultradraagbare | Lenovo ThinkPad P14s Gen 7 | RTX PRO 1000 Blackwell 8GB / 64GB LPCAMM2 | 55 tok/s (Phi) bij 3.59 lb | P14s Gen 7 Review |
| Het beste resultaat zonder aparte grafische kaart. | Dell Pro Precision 5 14s Intel | Intel Arc Pro B390 iGPU, 64 GB gedeeld LPCAMM2 | Bij modellen met meer dan 8 GB VRAM bedroeg de batterijduur 23 uur en 50 minuten. | Review van de Pro Precision 5 14s |
| Beste dunne en lichte NPU-systeem | HP EliteBook 6 G1q | Snapdragon X Plus, 45 TOPS Hexagon NPU, 32 GB | Llama 3.2 3B met 37 tok/s in LM Studio | Review van de EliteBook 6 G1q |
| Beste RTX Spark-laptop | HP OmniBook Ultra 16 | RTX Spark N1X, 20-core CPU / 6,144-core Blackwell GPU, 128 GB (64 GB voor de GPU) | 35B codeeragenttaak voltooid in 72.0 s met een snelheid van 89.5 tok/s, 3 van de 3 pogingen geslaagd | Review van de OmniBook Ultra 16 |
| Koelst draaiende RTX Spark-laptop | Lenovo Yoga 9n 2-in-1 16 | RTX Spark N1X, 20-core CPU / 6,144-core Blackwell GPU, 64 GB (32 GB voor de GPU) | Een piektemperatuur van 72 °C bij een continue belasting van 30 minuten, tegenover 98 °C bij de HP OmniBook Ultra 16. | Yoga 9n 2-in-1 16 Review |
De Keuzes
Beste laptop voor lokale AI: Dell Pro Max 18 Plus
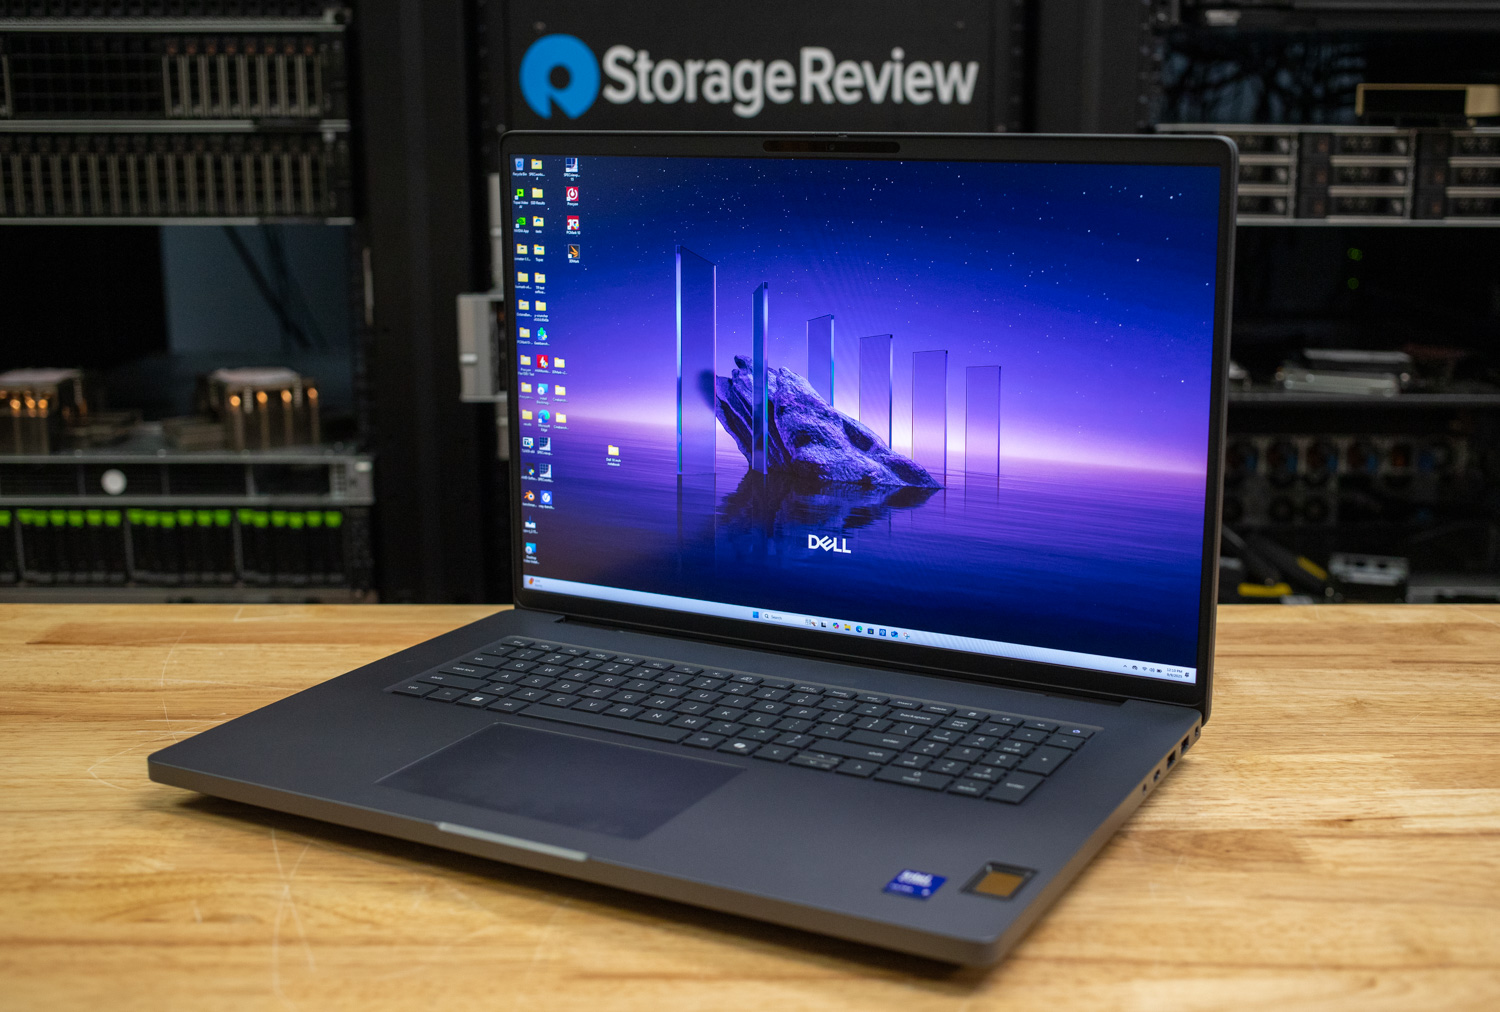
De Pro Max 18 Plus behaalde de snelste lokale AI-resultaten van alle laptops in het StorageReview-lab. In de UL Procyon AI Text Generation-test haalde de RTX PRO 5000 Blackwell (24 GB GDDR7) een snelheid van 185.1 tokens per seconde voor Phi, 140.5 voor Mistral en 119.7 voor Llama 3, met een tijd tot het eerste token van minder dan 0.35 seconden op elk model. De Core Ultra 9 285HX en 128 GB CAMM2-geheugen zorgen ervoor dat de rest van de pipeline soepel verloopt, en de 24 GB VRAM biedt voldoende ruimte voor 20B-klasse gekwantiseerde modellen.
De compromissen zijn precies wat de behuizing suggereert: 7.17 kg en een gemeten batterijduur van 3 uur en 39 minuten, de kortste gebruiksduur in onze dataset met laptops. Dit is een bureaulaptop die toevallig ook opvouwbaar is. De adviesprijs was $9,245 toen we hem testten. Als de snelheid van lokale inferentie het belangrijkste is, dan is dit het antwoord.
Review: Dell Pro Max 18 Plus: Blackwell RTX PRO 5000 prestaties voor onderweg
Beste keuze voor grote modellen: HP ZBook Ultra G1a 14
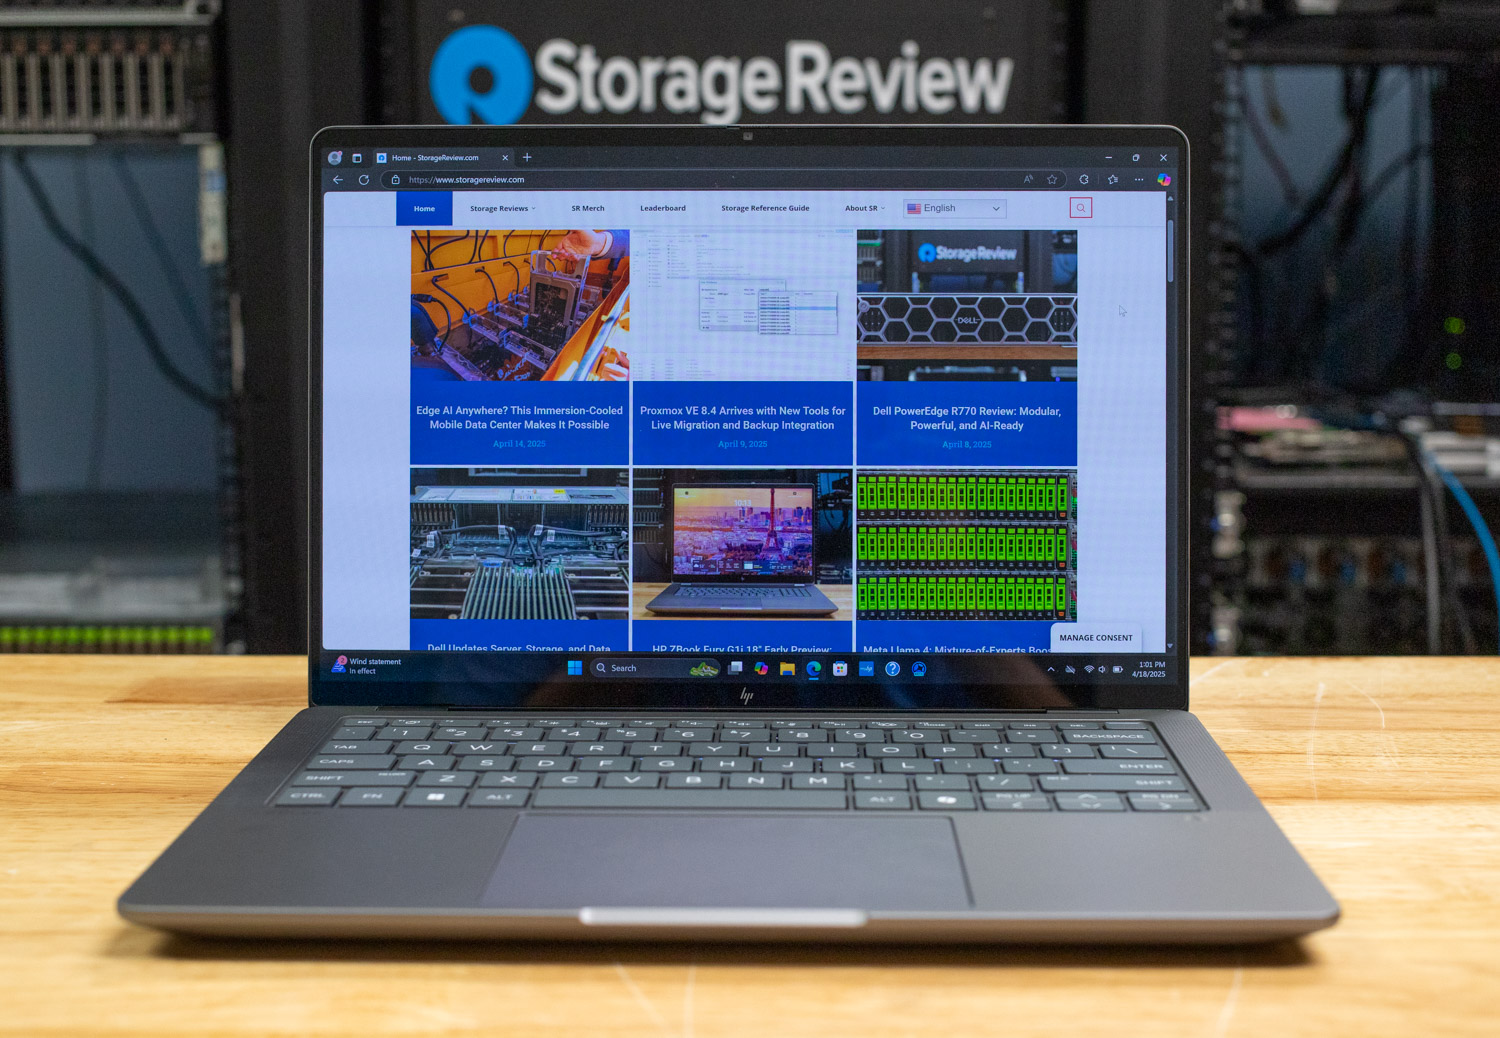
Snelheid is de ene as; capaciteit de andere. De ZBook Ultra G1a combineert AMD's Ryzen AI Max+ PRO 395 met 128 GB LPDDR5X-geheugen, waarvan tot 96 GB kan worden toegewezen aan de Radeon 8060S GPU. Met die hoeveelheid geheugen konden we modellen laden die geen enkele laptop met een aparte GPU aankan: DeepSeek-R1 70B en QwQ 32B draaiden beide lokaal in respectievelijk LM Studio en Ollama, en Gemma 3 27B genereerde 8.96 tokens per seconde met promptverwerking op 73 tokens per seconde.
De Procyon-prestaties blijven achter bij alle RTX PRO-machines in deze vergelijking (Phi haalt 65 tokens per seconde), dus dit is niet de beste keuze voor snelle chats op compacte modellen. Het is echter wel de beste keuze als het model zelf het belangrijkste is, en dat doet hij met een gewicht van slechts 3.3 kg en een accuduur van 10 uur en 35 minuten. Dit is hetzelfde verhaal met geïntegreerd geheugen als de AMD Strix Halo op onze desktops, maar dan in een 14-inch behuizing.
Review: HP ZBook Ultra G1a 14 Review
In aantocht: HP ZBook Ultra G3a 16
De beste keuze voor grote modellen hierboven zou deze categorie wel eens kunnen overdragen aan zijn eigen opvolger. De ZBook Ultra G3a 16 biedt 192 GB LPDDR5X-8533-geheugen, waarvan tot 160 GB aan de GPU kan worden toegewezen (de G1a 14 heeft maximaal 128 GB en 96 GB), een Ryzen AI Max+ PRO 495-processor en een verbeterd koelsysteem dat een stroomverbruik van 100 W aankan, waar de G1a 55 W nodig had. De G1a verdiende zijn plek in de categorie dankzij de grote capaciteit, maar het beperkte stroomverbruik; de G3a pakt beide aspecten tegelijk aan.
HP opende in oktober de ordermogelijkheid in de VS, met configuraties vanaf $3,149, en de G3a komt in de ranglijst terecht zodra de volledige Procyon- en LM Studio-tests beschikbaar zijn. Onze praktijktest betrof een pre-productiemodel, waarbij prestatietests niet waren toegestaan. De volledige review volgt zodra een productiemodel in ons lab arriveert.
Beste balans tussen 16-inch laptops en desktops: Dell Pro Max 16 Plus
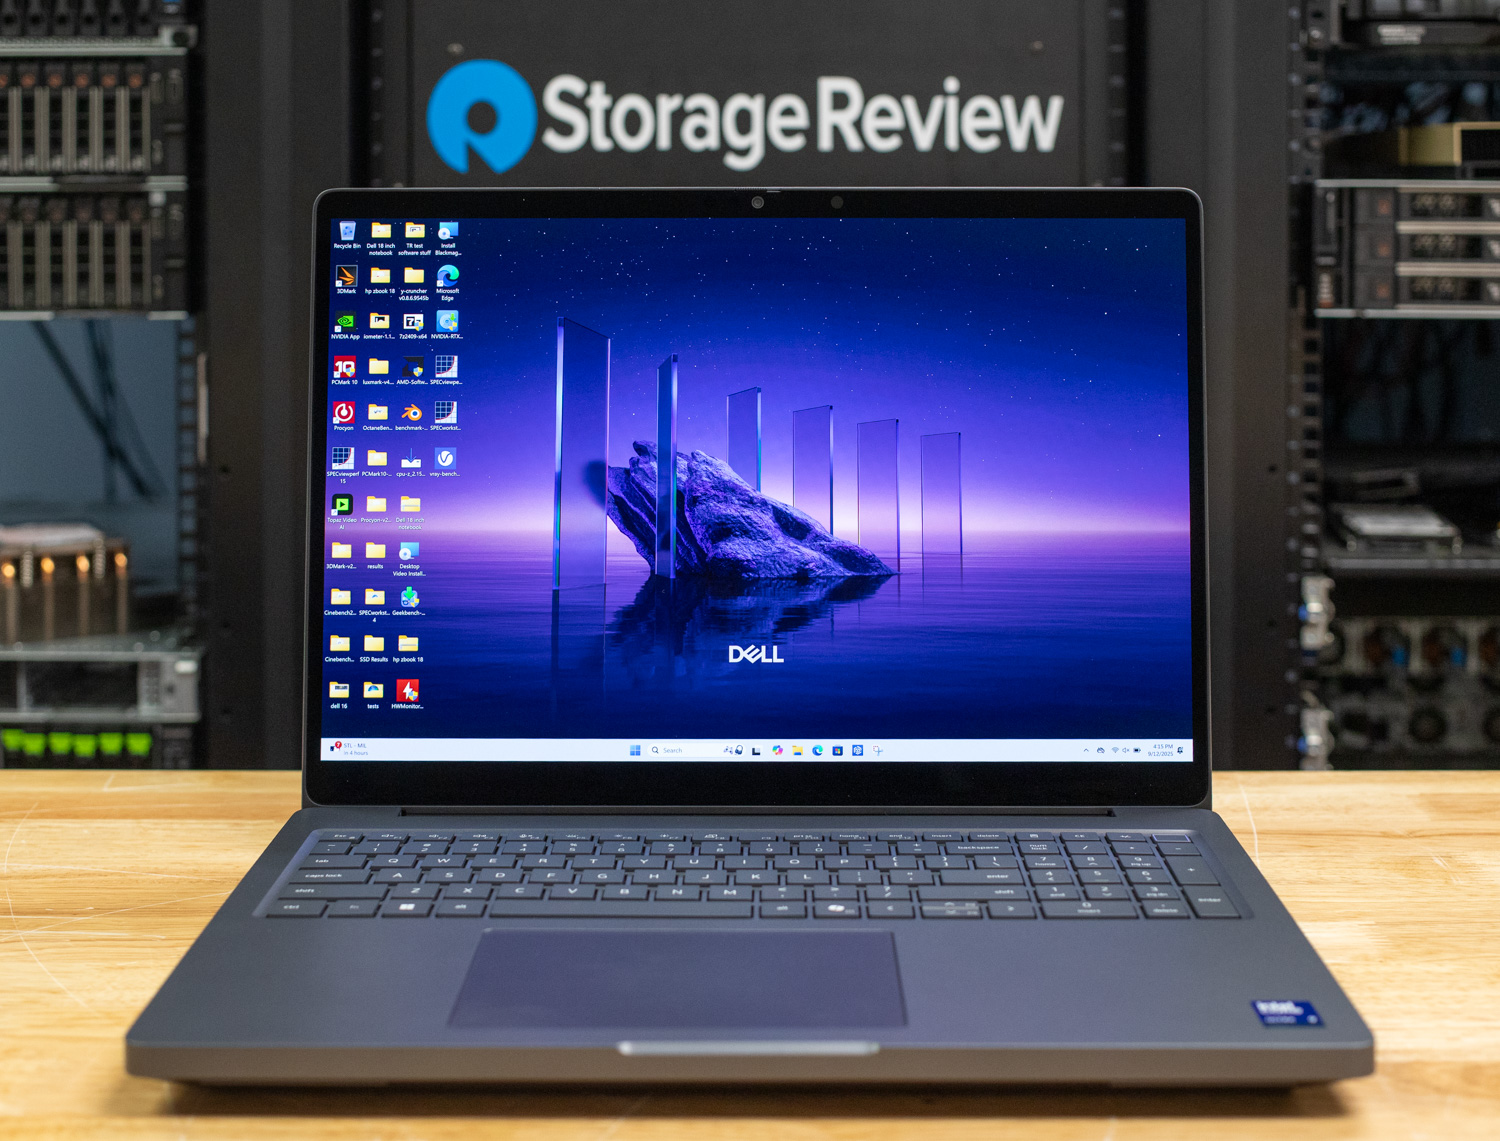
De Pro Max 16 Plus gebruikt dezelfde RTX PRO 5000 Blackwell 24GB als de 18 Plus en doet qua prestaties vrijwel niet onder: Phi haalt 178.6 tokens per seconde, Mistral 134.2 en Llama 3 114.7, wat neerkomt op ongeveer 96 procent van de doorvoersnelheid van het vlaggenschip. Daar staat tegenover dat hij 5.63 kg weegt (tegenover 7.17 kg) en de accuduur bijna verdubbelt tot 6 uur en 21 minuten.
Voor de meeste mensen die serieuze lokale inferentie in een compact apparaat willen, is dit de betere koop van de twee. Het is bovendien uitgeroepen tot Beste Mobiele Werkstation in onze ranglijst van Beste Mobiele Werkstations , dus de AI-snelheid wordt geleverd met een volledig gevalideerde professionele applicatiestack.
Review: Dell Pro Max 16 Plus: Gebouwd voor lange dagen en zware klussen
Beste ultradraagbare laptop: Lenovo ThinkPad P14s Gen 7
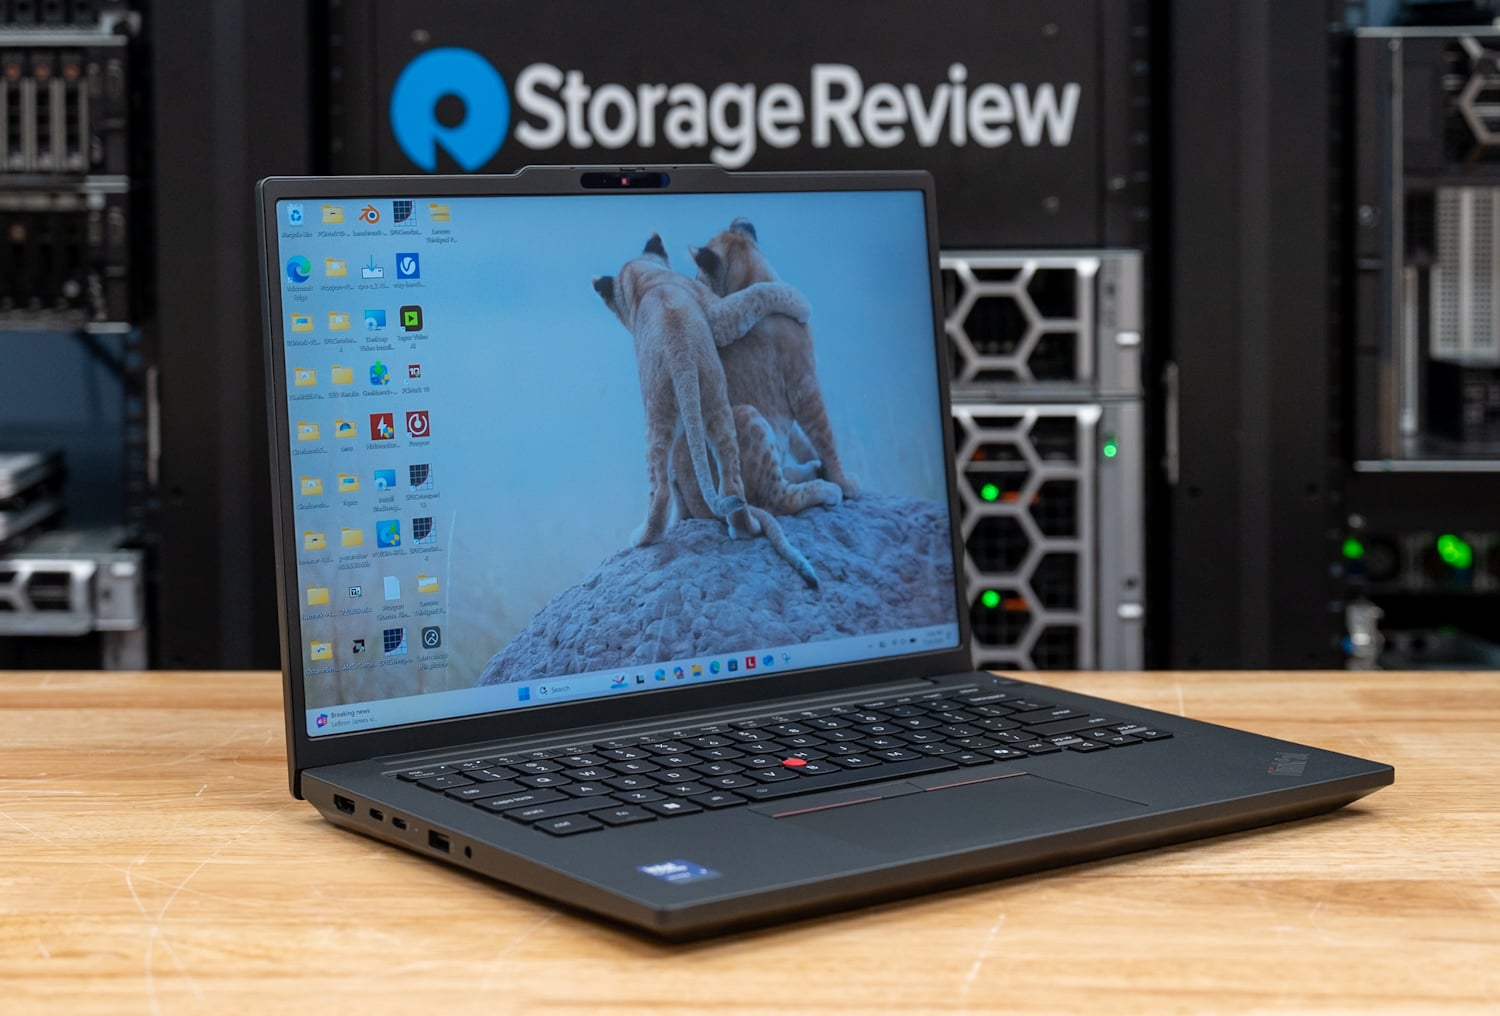
Met een gewicht van 3.59 kg is de P14s Gen 7 de lichtste laptop in deze vergelijking met een aparte Blackwell GPU. De RTX PRO 1000 (8 GB GDDR7) behaalde Phi-tokens van 55.1 tokens per seconde en Mistral-tokens van 40.3, echte interactieve snelheden voor modellen uit de 7B-klasse. De 50 TOPS NPU van Panther Lake maakt er een Copilot+-machine van. De accuduur van 15 uur en 52 minuten betekent dat de AI-functionaliteit je werkdag niet kost.
Ken de limiet voordat je koopt: onze Llama 2 13B-test is niet voltooid omdat dat model ongeveer 12 GB grafisch geheugen via de Procyon-interface nodig heeft, terwijl de GPU slechts 8 GB heeft. Voor modellen met een geheugencapaciteit van 7 GB of minder is dit een uitstekende keuze; voor grotere modellen kun je beter de volgende pagina raadplegen.
Review: Lenovo ThinkPad P14s Gen 7 Review
Beste laptop zonder aparte grafische kaart: Dell Pro Precision 5 14s Intel
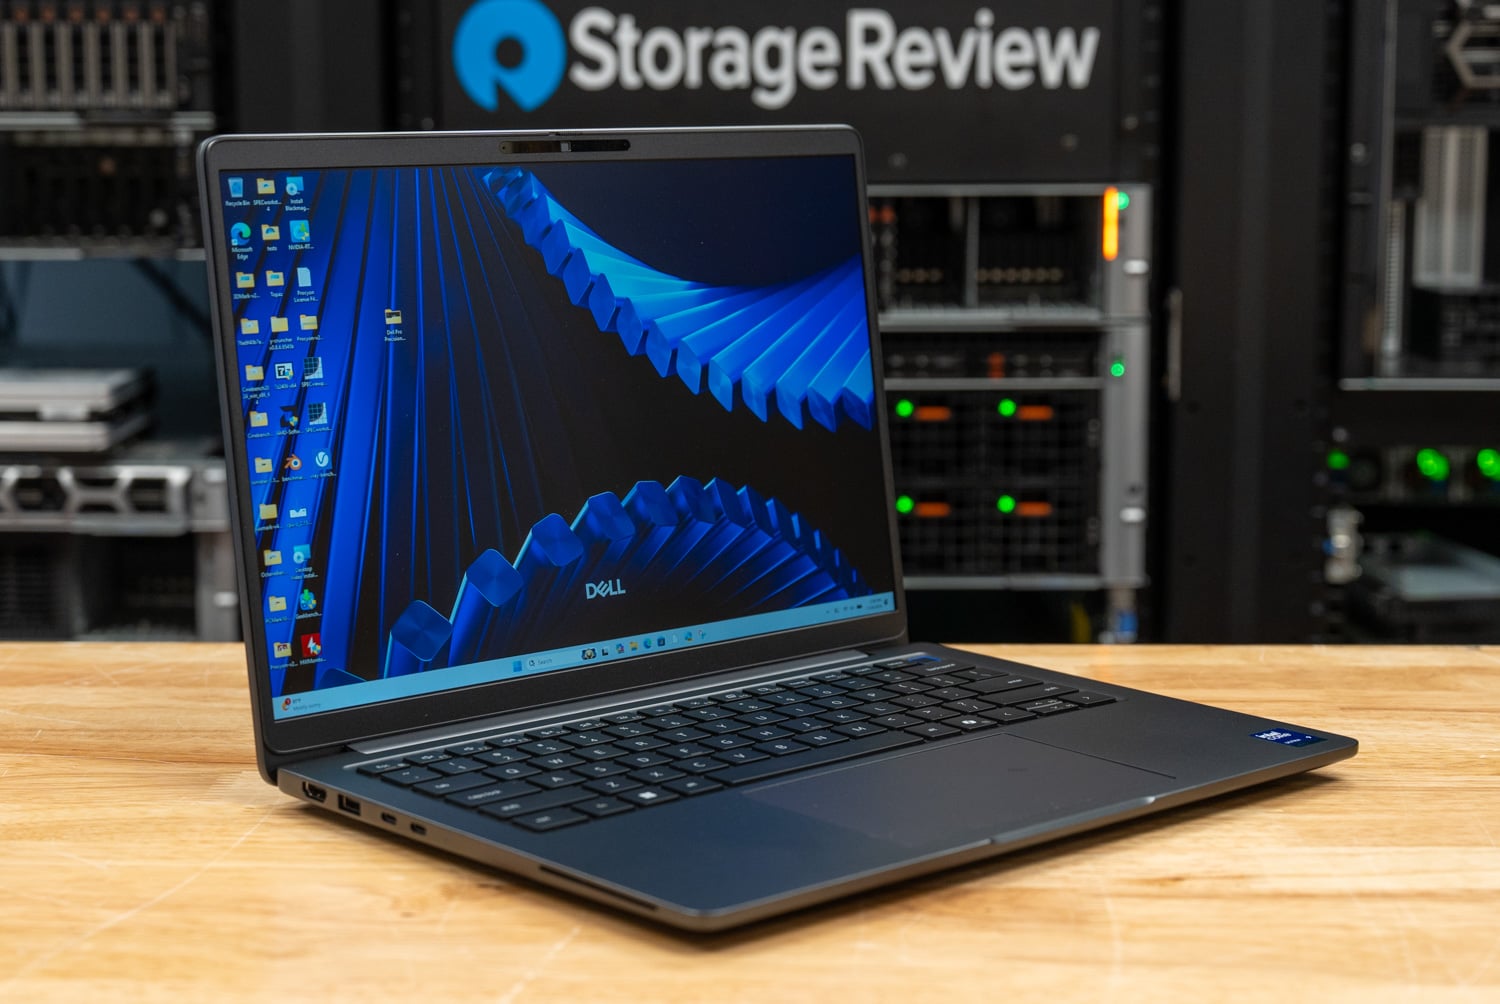
Een aparte grafische kaart is, binnen redelijke grenzen, geen probleem: de Pro Precision 5 14s Intel combineert de Core Ultra X9 388H (50 TOPS NPU) met geïntegreerde Intel Arc Pro B390-graphics die gebruikmaken van een gedeelde LPCAMM2-geheugenpool van 64 GB. In onze tests kon deze pool grotere lokale AI-workloads aan dan een aparte grafische kaart van 8 GB aankon, waardoor de volledige Procyon AI Text Generation-suite werd voltooid (scores van 887 op Phi en 786 op Llama 2), terwijl systemen met beperkt VRAM-geheugen faalden.
De generatiesnelheid is bescheiden in vergelijking met de RTX PRO-chip, waardoor deze processor meer geschikt is voor achtergrondtaken dan voor intensieve interactieve sessies. De rest van het pakket is opmerkelijk: 3.12 kg en een gemeten batterijduur van 23 uur en 50 minuten, de op één na langste in onze hele dataset. Het apparaat staat ook bovenaan onze lijst met beste ultradraagbare werkstations.
Review: Dell Pro Precision 5 14s Intel Review
Beste dunne en lichte NPU-systeem: HP EliteBook 6 G1q
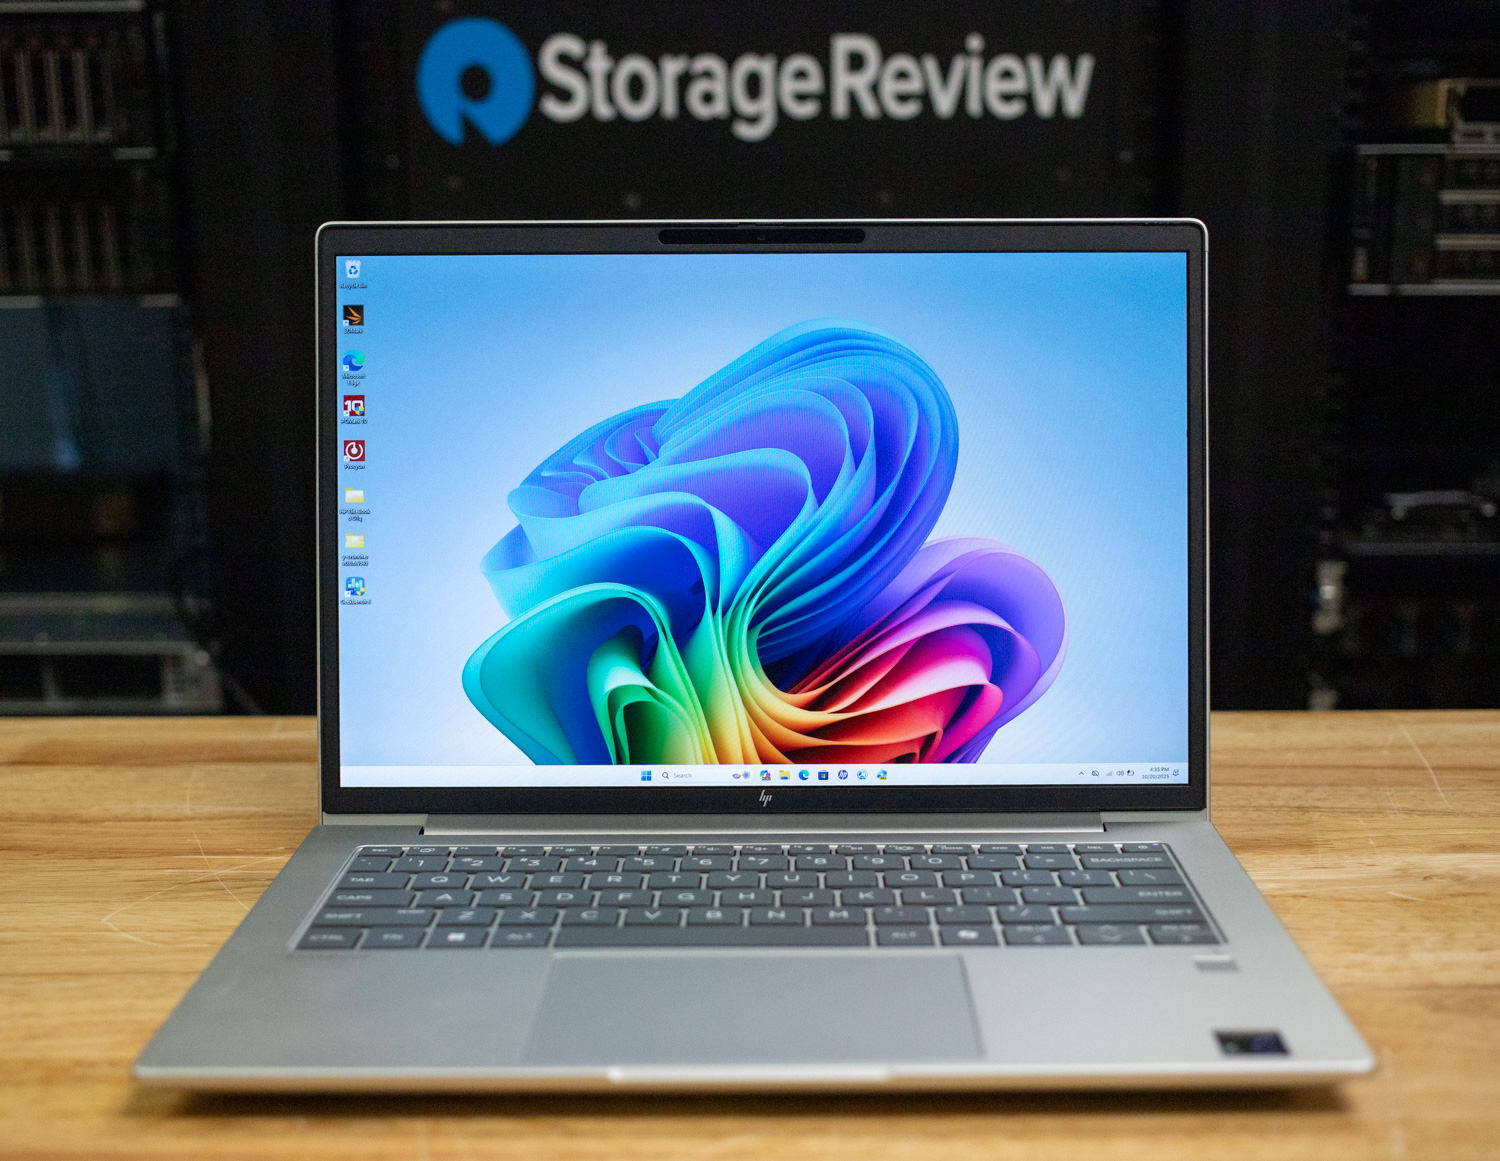
De EliteBook 6 G1q beantwoordt een andere vraag: hoe weinig rekenkracht heb je nodig voor nuttige AI op het apparaat zelf? De Snapdragon X Plus met een 45 TOPS Hexagon NPU draaide Llama 3.2 3B met 36.7 tokens per seconde en Gemma 3 4B met 29.3 tokens per seconde in LM Studio, terwijl de 1B-modellen zelfs 62 tokens per seconde haalden. Dat zijn bruikbare chatsnelheden voor een apparaat van slechts 3.17 kg dat een accuduur van 19 uur en 35 minuten had.
Het plafond is laag; 4B parameters was het grootste model dat we hebben getest, dus dit is bedoeld voor lokale chat, samenvattingen en offline assistenten. Zwaardere modellen vallen buiten bereik. Met een prijs van ongeveer $3,100 in de configuratie die we hebben getest, was het ook het minst dure systeem op deze pagina.
Review: HP EliteBook 6 G1q Review: Een lichtgewicht laptop die de hele dag meegaat
RTX Spark-laptops: getest met onze nieuwe klantensuite.
NVIDIA's RTX Spark N1X brengt de GB10-superchip van de DGX Spark naar Windows-laptops, met één pool LPDDR5X-geheugen die wordt gedeeld door een Grace-CPU en een Blackwell-GPU. Laptops zijn verkrijgbaar in twee varianten met een TDP van 45 tot 80 W: een 20-core CPU met een 6,144-core GPU en een 18-core CPU met een 5,120-core GPU. We testen deze systemen met sr-client 1.2, onze nieuwe Arm64-native clientsuite, dus de resultaten komen niet exact overeen met de Procyon-cijfers van de bovenstaande voorbeelden. Ons artikel over de lancering van de RTX Spark bevat alle platformdetails.
Het geheugen bepaalt welke modellen elke configuratie kan uitvoeren. Een firmware-instelling verdeelt de geheugenpool tussen Windows en de GPU, en onze kleinste lokale AI-modellaag heeft minstens 16 GB aan bruikbaar GPU-geheugen nodig. Een systeem met 32 GB geheugen dat is ingesteld op 12 GB voor de GPU kan de 12.8 GB grote gpt-oss:20b dus niet laden.
Beste RTX Spark-laptop: HP OmniBook Ultra 16
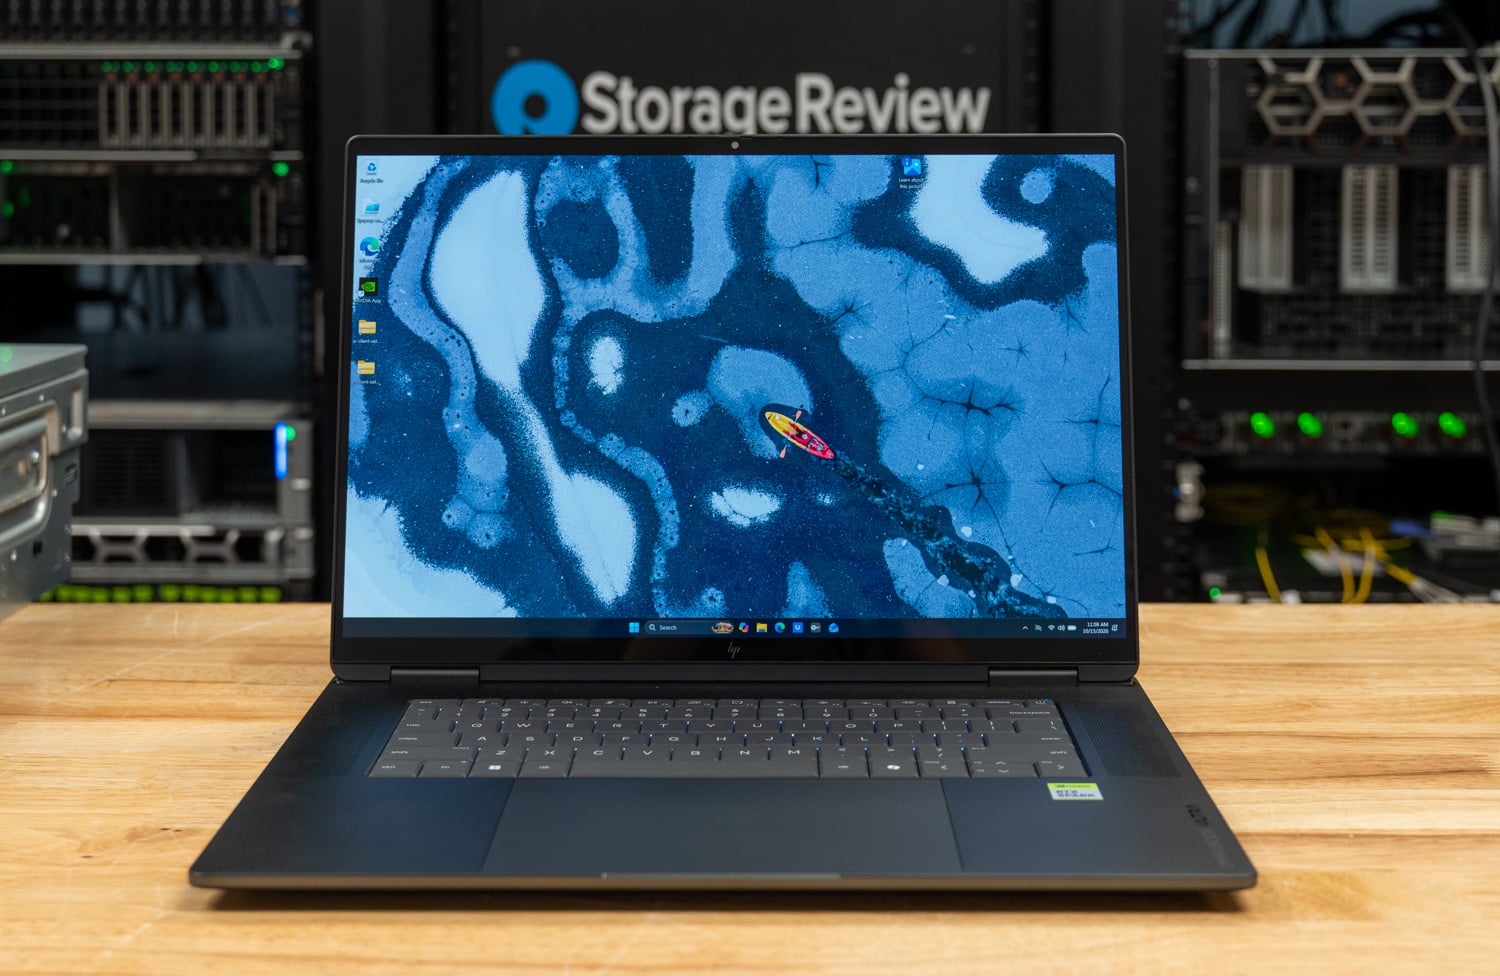
De 128GB OmniBook Ultra 16 is de meest complete RTX Spark-notebook die we hebben getest. Met 62.5GB aan bruikbaar GPU-geheugen draait hij beide van onze lokale AI-modelniveaus, waarbij gpt-oss:20b met 58.0 tokens per seconde en Qwen3.6-35B-A3B met 89.5 tokens per seconde wordt gegenereerd. Hij doorstond alle negen coding agent-tests en voltooide de Qwen3.6-taak in 72.0 seconden, de snelste in zijn groep. De all-core OpenBLAS-test werd voltooid bij een temperatuur van 98 °C, een test die twee Surface Laptop Ultra's van stroom voorzag.
De 7,004 punten in de Cinebench 2026 multi-core test waren de beste CPU-resultaten in die vergelijking, 35 procent sneller dan de Razer Blade 16. De RTX 5090 van de Blade genereert nog steeds tokens die 2.3 keer sneller zijn op modellen die in de 24 GB passen, en de browser van de OmniBook vertraagde met 1.73 keer toen de codeerapplicatie op de gedeelde GPU draaide. De door ons geteste versie met 128 GB en 2 TB is alleen verkrijgbaar via HP.com, waar HP deze op 14 oktober voor $ 6,229.99 aanbood. Het model met 32 GB van $ 3,199.99 behoudt dezelfde CPU-snelheid, maar kan onze modelniveaus niet laden en de resultaten van de batterijduur zijn nog niet bekend.
Review: HP OmniBook Ultra 16 Review: RTX Spark met 128 GB wint onze lokale test met codeeragents
Koelst draaiende RTX Spark-laptop: Lenovo Yoga 9n 2-in-1 16
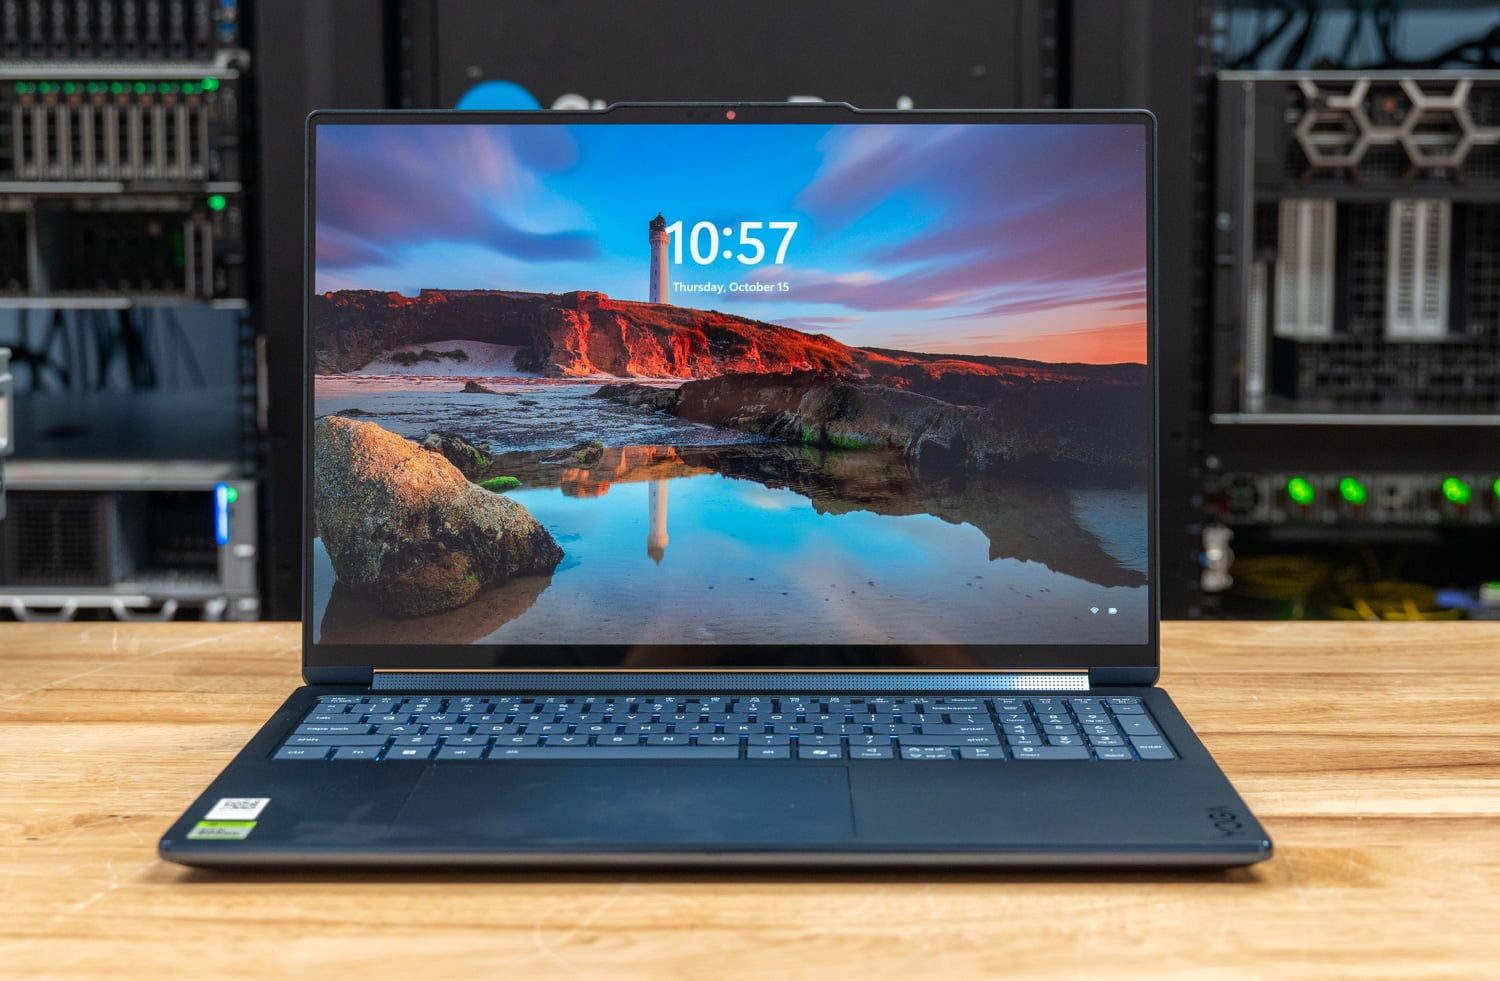
De Yoga 9n 2-in-1 16 presteerde met de N1X koeler dan elke andere RTX Spark-notebook die we hebben getest. Tijdens onze continue test van 30 minuten bereikte de CPU een piektemperatuur van 72 °C en bleef deze op 3,015 MHz draaien, waarmee de processor 100.1 procent van zijn capaciteit van de eerste testronde behield. De HP OmniBook Ultra 16 en Surface Laptop Ultra bereikten een temperatuur van 98 °C, en de Lenovo Pro 9n 15 een piek van 92 °C. Al deze metingen werden uitgevoerd via de thermische zones van Windows, de enige CPU-sensor die deze systemen tonen. Lenovo schrijft dit toe aan vergrote ventilatieopeningen, een verhoogde thermische rand en een scharnier dat ruimte achter de ventilatieopeningen creëert voor luchtcirculatie.
De koeling van de processor kost de Yoga wat extra snelheid ten opzichte van de HP. Multithreaded prestaties liggen in de meeste tests 4 tot 10 procent achter op de OmniBook, en de codeeragent vertraagde de browser 2.44 keer op de Yoga tegenover 1.73 keer op de HP. De 64GB-configuratie geeft de GPU 32GB, genoeg voor gpt-oss:20b met 58.0 tokens per seconde, maar net niet genoeg voor onze 35GB-limiet. Voor een 16-inch convertible die ook als tablet of op schoot gebruikt wordt, is die afweging logisch. De adviesprijs was $3,749.99 in de geteste versie, en de batterijduurresultaten zijn nog niet bekend.
Review: Lenovo Yoga 9n 2-in-1 16 Review: De koelst draaiende RTX Spark-notebook
Ook getest op de nieuwe suite:
- Lenovo Pro 9n 15De 18-core N1X met 32 GB geheugen in een behuizing van slechts 3.64 kg. Llama 3.1 8B haalde 55.1 tokens per seconde in MLPerf Client, binnen 2 procent van een 20-core N1X met dezelfde 12 GB GPU-verdeling. De hogere kloksnelheden van alle cores zorgen ervoor dat de prestaties bij rendering en compilatie binnen 8 tot 11 procent van de 20-core variant blijven, met een piektemperatuur van 93 °C. Met 12 GB GPU-geheugen is deze processor niet geschikt voor onze model-load- en coding agent-tests, dus lokale AI-kopers zouden meer geheugen moeten configureren. Lenovo biedt de 18-core, 32 GB, 512 GB-versie aan vanaf $ 2,999.99.
- Microsoft Surface Laptop Ultra voor bedrijven (zoals getest): de 128GB-eenheid genereerde gpt-oss:20b en Qwen3.6-35B-A3B met 58 tot 89 tokens per seconde en behaalde een score van 6,963 in Cinebench 2026 multi-core. Dit wordt weergegeven als 'zoals getest', omdat twee eenheden uitvielen onder onze OpenBLAS-belasting op alle cores.
De Dell XPS 16 Creator Edition wordt binnenkort in ons lab verwacht en zal aan dit gedeelte worden toegevoegd zodra we hem hebben getest. De batterijresultaten voor alle RTX Spark-systemen wachten op onze nieuwe, platformonafhankelijke batterijtest.
Ook getest
Deze systemen hebben hetzelfde laboratoriumproces doorlopen en zijn het overwegen waard voor de juiste koper, ook al hebben ze momenteel geen vaste plek in een categorie.
- Lenovo ThinkPad P16 Gen 3: de derde RTX PRO 5000-machine in de vloot (Phi op 141.2 tok/s); ons exemplaar werd geleverd met 32 GB RAM, wat de rest van de workflow vertraagde.
- HP ZBook Fury G1i 18Dezelfde 24GB Blackwell GPU-klasse als de Pro Max 18 Plus, een stapje lager qua doorvoersnelheid (Phi op 157.4 tok/s) en een prijs van $11,687 zoals getest tijdens de review.
- Dell Pro Precision 7 16 IntelDe RTX PRO 3000 Blackwell met 12 GB VRAM levert het beste resultaat in het middensegment van deze GPU-markt (Procyon-tekstgeneratiescore van 2,244 op Phi via DirectML); de 12 GB maakt de 14B-klasse mogelijk, iets wat kaarten met 8 GB niet kunnen.
- Lenovo ThinkPad P1 Gen 8: RTX PRO 2000 8GB in een behuizing van 4.06 kg met een batterijduur van 12 uur en 59 minuten; Phi bij 77.3 tok/s.
- Lenovo ThinkPad P1 Gen 9Getest op onze nieuwe klantensuite, genereerde de 50W RTX PRO 2000 een Llama 3.1 8B-score van 64.8 tokens per seconde in MLPerf Client. Dit is de snelste RTX PRO 2000 die we tot nu toe hebben getest en sneller dan de RTX Spark HP OmniBook Ultra 16 (56.5 tokens per seconde op dat model). De 8GB-kaart kon onze modellen met 20B en hoger echter niet laden.
- Dell Pro Max 14 Premium: RTX PRO 2000 8GB met een gewicht van 3.55 pond; Phi met 54.1 tok/s.
- Dell Pro Max 16 (Ryzen): RTX PRO 1000 8GB met een batterijduur van 16 uur en 2 minuten; Phi op 61.9 tok/s.
- Lenovo ThinkPad P14s Gen 6: RTX PRO 500 6GB; instapmodel Blackwell AI met 45.7 tok/s op Phi.
- Dell Pro Precision 5 16s Intel: het 16-inch broertje van onze keuze zonder dedicated GPU, gebouwd op hetzelfde platform met gedeeld geheugen, met de langste werkstationbatterij die we ooit hebben gemeten: 24 uur en 43 minuten.
- Dell Pro Precision 5 14s AMD: 60 TOPS NPU en een gedeelde pool van 64 GB; AMD's Procyon INT8-imagepad was ten tijde van de test nog niet beschikbaar, wat een vergelijking beperkt. Dell Pro Precision 5 16s AMD Deze processor combineert dezelfde Ryzen AI 9 HX PRO 475 en 60 TOPS NPU in een 16-inch behuizing en behaalde in onze tests de hoogste lokale LLM-doorvoer van de Pro Precision-lijn, ruim boven zijn Intel-tegenhanger op zowel Llama3 als Llama2. Daarmee is het de beste keuze binnen deze serie voor lokale inferentietaken.
- HP EliteBook X G1a: Ryzen AI 9 HX 375 met een 55 TOPS NPU; we hebben onze LLM-suite er nog niet op uitgevoerd.
Hoe we rang
UL Procyon AI Text Generation is onze standaard voor alle modellen: dezelfde vier modellen (Phi, Mistral, Llama 3 en Llama 2, indien van toepassing) op elke laptop die ze kan ondersteunen, waardoor de tokens-per-seconde-waarden direct vergelijkbaar zijn. Waar de hardware het interessant maakt, gaan we dieper in op de materie met LM Studio- en Ollama-runs op grotere modellen. Elke laptop wordt één keer per meetmethode beoordeeld en een systeem verschijnt alleen op deze pagina als het bruikbare lokale AI-resultaten in ons lab heeft opgeleverd.
De RTX Spark-systemen draaiden sr-client 1.2, onze nieuwe clientsuite, dus worden ze op deze pagina met elkaar vergeleken en niet met de Procyon-resultaten die achter de andere keuzes schuilgaan.
Prijzen fluctueren snel in deze markt, dus elk bedrag op deze pagina is de prijs zoals die gold op het moment van publicatie van de review. We doen geen uitspraken over de prijs-kwaliteitverhouding zonder de actuele prijzen van de leverancier te controleren, en wanneer we dat doen, vermelden we de datum van de controle.
Veelgestelde vragen over lokale AI op laptops
Wat is belangrijker voor lokale AI op een laptop: VRAM of het totale geheugen?
Beide, om verschillende redenen: een model moet passen in het geheugen dat de GPU kan bereiken: bij discrete kaarten is dat VRAM (8 GB tot 24 GB in dit geval), en onze Llama 2 13B liep vast op 8 GB-kaarten omdat er ongeveer 12 GB nodig was. Ontwerpen met uniform en gedeeld geheugen draaien de zaak om: AMD's Ryzen AI Max+ kan tot 96 GB systeem-RAM aan de GPU toewijzen, en Intel's gedeelde LPCAMM2-pools bereiken 64 GB, waardoor veel grotere modellen überhaupt laden, zij het met lagere snelheden. De compatibiliteit bepaalt of een model werkt; de chip bepaalt hoe snel.
Wat is het grootste model dat StorageReview ooit op een laptop heeft gedraaid?
DeepSeek-R1 70B, lokaal geladen op de HP ZBook Ultra G1a 14 via de 96 GB toewijsbare, uniforme geheugenpool. Voor continue generatie maten we Gemma 3 27B op 8.96 tokens per seconde op dezelfde machine. Aan de desktopkant ligt de lat hoger; de ranglijst ' Beste desktops voor lokale AI' omvat systemen die veel grotere modellen ondersteunen.
Zijn NPU TOPS-scores van belang voor het uitvoeren van LLM-programma's?
Minder dan de marketing suggereert, omdat de meeste lokale LLM-runtimes afhankelijk zijn van de GPU, en alle tokens-per-seconde-waarden op deze pagina zijn afkomstig van GPU-inferentie, behalve bij de Snapdragon EliteBook, waar de AI-stack van het platform de doorslaggevende factor is. NPU's bewijzen hun waarde momenteel door hun efficiëntie en door de INT8-beeldgeneratieprocessen, en dankzij hen komen verschillende van deze machines in aanmerking als Copilot+ pc's. Koop dus in de eerste plaats vanwege de GPU en het geheugen.
Wat gebeurt er met de batterijduur als je modellen lokaal uitvoert?
Inferentie is een van de zwaarste taken die een laptop langdurig kan uitvoeren, dus zorg ervoor dat je de laptop op netstroom aansluit tijdens intensieve sessies. De batterijduurcijfers op deze pagina zijn gebaseerd op PCMark 10 Modern Office-resultaten, een productiviteitsmeting, en het verschil is enorm: 3 uur en 39 minuten op onze snelste AI-laptop versus bijna 24 uur op de Dell met gedeeld geheugen. Ons klassement voor de batterijduur van laptops geeft een overzicht van alle laptops.
Hoe verhouden RTX Spark-laptops zich tot de laptops in deze ranglijst?
RTX Spark-laptops draaien op NVIDIA's N1X, die één pool van LPDDR5X deelt tussen een Grace-CPU en een Blackwell-GPU. We testen ze met sr-client 1.2, onze nieuwe clientsuite, dus hun resultaten komen niet exact overeen met de Procyon-resultaten die ten grondslag liggen aan de keuzes op deze pagina. Op de HP OmniBook Ultra 16 met 128 GB genereerden gpt-oss:20b en Qwen3.6-35B-A3B respectievelijk 58.0 en 89.5 tokens per seconde, en de 35B-coderingstaak slaagde voor drie van de drie runs in 72.0 seconden.
De geheugenverdeling bepaalt welke modellen geladen worden: de Lenovo Pro 9n 15 met 32 GB, ingesteld op 12 GB voor de GPU, kon de 12.8 GB gpt-oss:20b niet laden. De Lenovo Yoga 9n 2-in-1 16 bleef het koelst, met een piektemperatuur van 72 °C gedurende een continue belasting van 30 minuten. De Surface wordt alleen getoond zoals getest, omdat twee exemplaren uitvielen onder onze OpenBLAS-belasting op alle cores.
Zou ik in plaats daarvan gewoon een desktopcomputer voor lokale AI moeten kopen?
Als de machine op een bureau komt te staan, dan waarschijnlijk wel. Desktopsystemen voor op het bureau bieden meer geheugen per euro, een betere koeling en geen concessies aan de batterijduur; onze lijst met beste desktops voor lokale AI begint bij ongeveer dezelfde prijs als de laptops in het middensegment die hier worden besproken. De laptops op deze pagina zijn bedoeld voor mensen die met hun AI-werk onderweg moeten werken.


 Amazon