

Advancing AI 2026 was AMD's grootste lanceringsevenement tot nu toe, zo groot zelfs dat we onze berichtgeving in tweeën hebben gesplitst. Ons eerste artikel behandelde de Instinct MI455X en het Helios-rack met 72 GPU's; dit vervolgartikel gaat over wat er niet comfortabel naast paste: de 6e generatie EPYC-server-CPU's, met de codenaam Venice, en de Verano-hostprocessor. De CPU verdient een eigen kop. Venice biedt tot 256 cores en 512 threads per socket, een geheugenbandbreedte van 1.6 TB/s, de eerste PCIe Gen 6 in een server-CPU en een doorvoer die 18 keer hoger is dan die van de eerste generatie EPYC uit 2017.
Venice is ook geen chip. Het is een portfolio, een punt dat AMD in elke sessie herhaalde: één CPU-profiel is niet geschikt voor alle toepassingen. Dezelfde Zen 6-generatie is onderverdeeld in een processor met hoge dichtheid, een processor voor zakelijke toepassingen, een HPC-processor met gestapelde cache en een energiezuinige LPDDR-host. Laten we, voordat we het over snelheden en specificaties hebben, eerst eens naar het aanbod kijken.
Het programma van Venetië en Verano
AMD verdeelt het moderne datacenter in drie serverklassen, en het portfolio is ontworpen om ze allemaal te bedienen. Algemene CPU-servers draaien de webgateways, caches, applicatielagen, databases en opslag waarop alle andere systemen steunen. GPU-servers hebben een host-CPU nodig die de accelerators van stroom voorziet, een taak waarbij single-threaded snelheid en I/O-bandbreedte belangrijker zijn dan het aantal cores. De derde klasse bestaat uit compacte CPU-servers voor de orchestratie- en tool-executiecode die is ontstaan rondom AI-services; deze code bevat veel vertakkingen en is gevoelig voor vastlopen, en heeft daarom vooral behoefte aan threads.
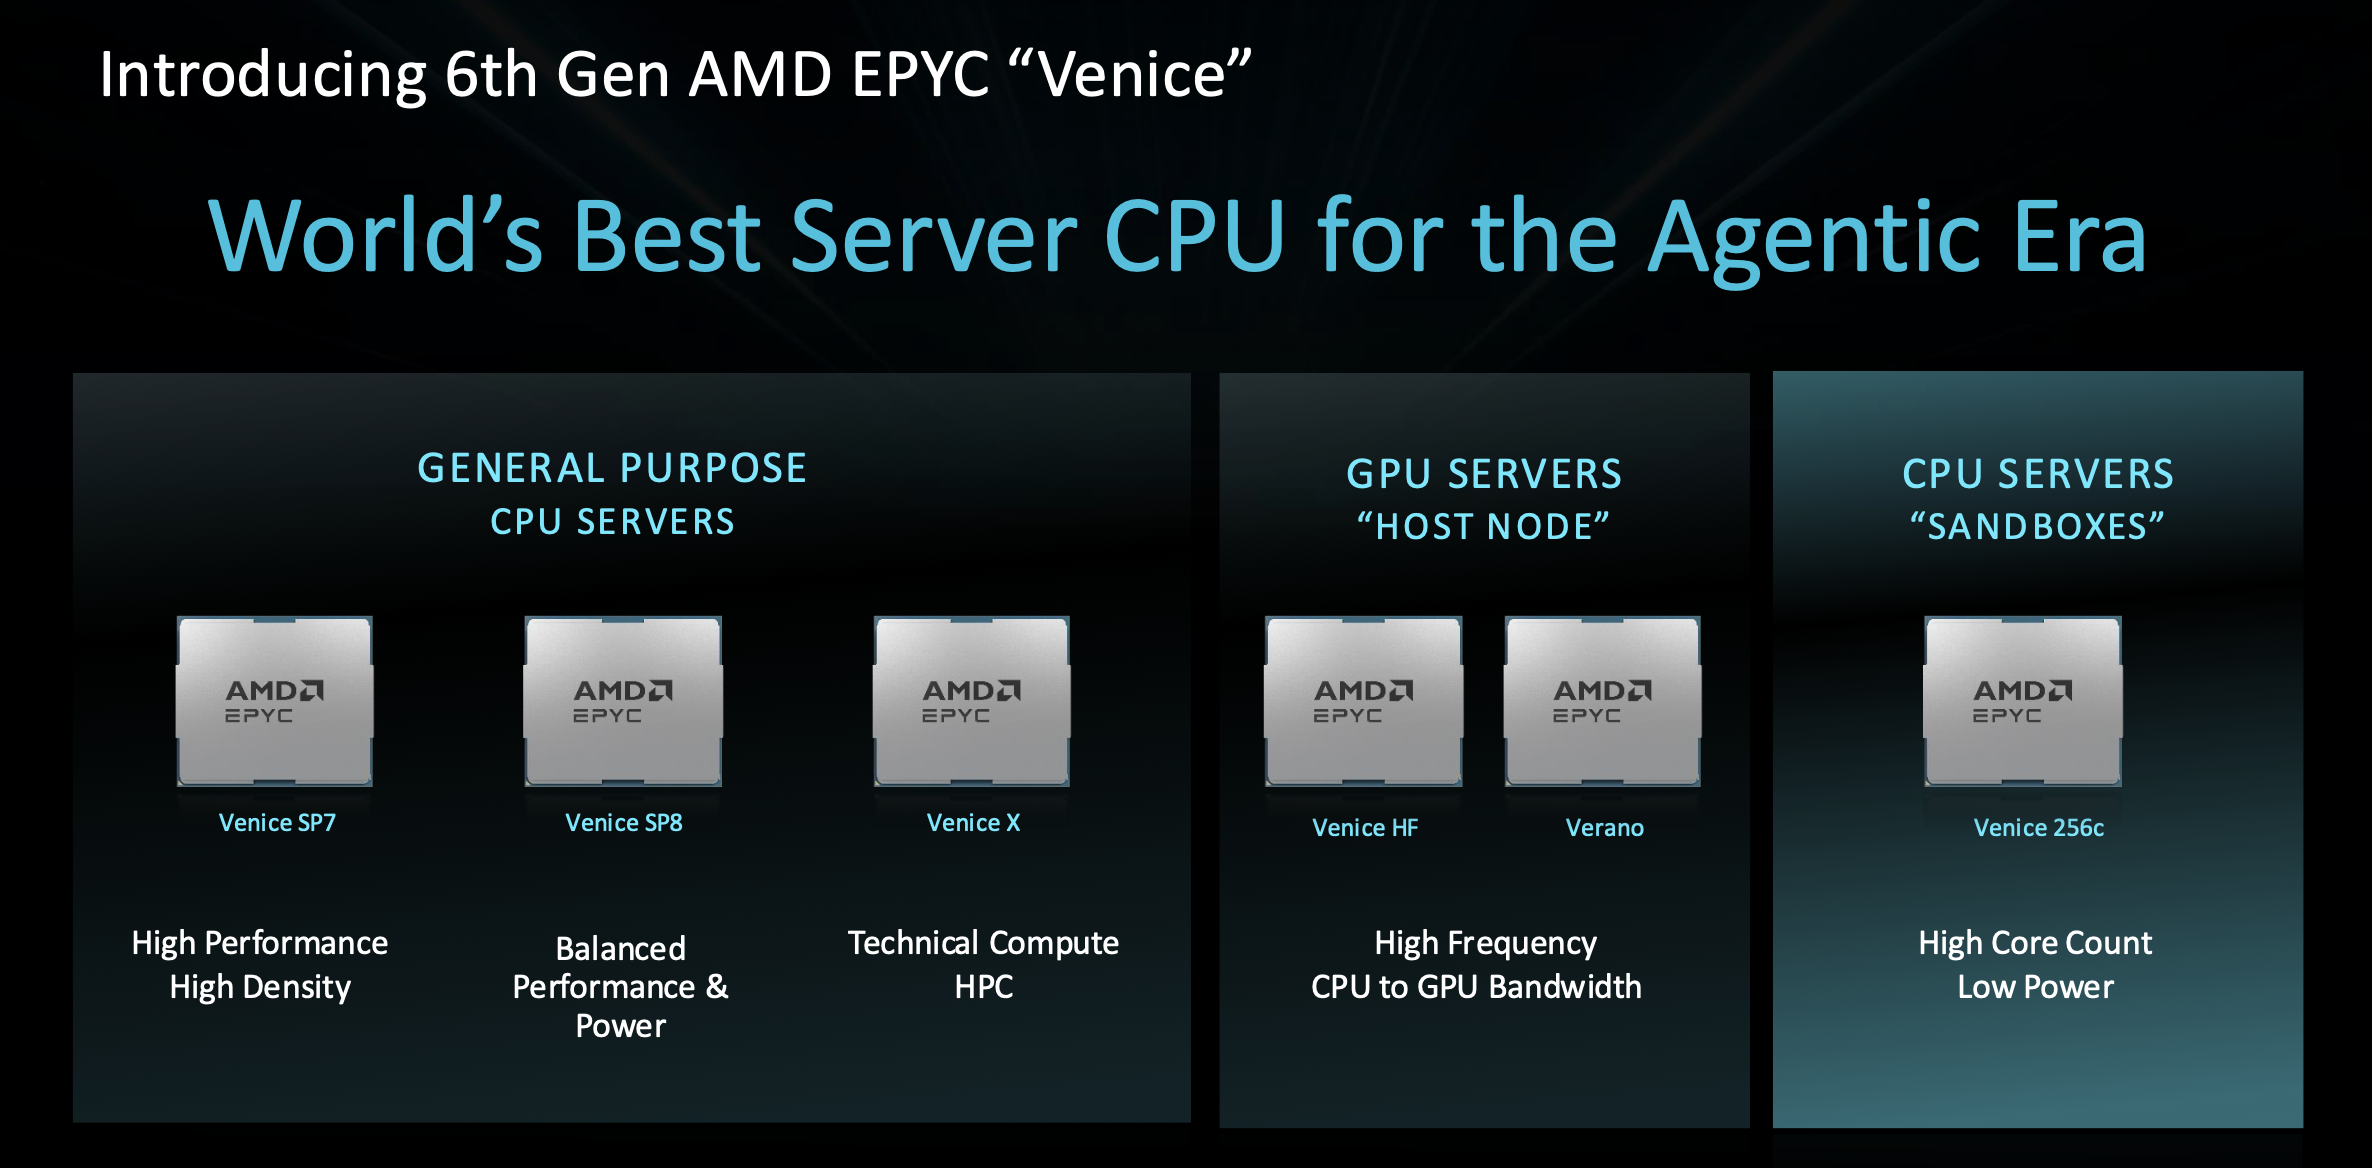
De line-up bestaat uit vier producten, en de platforms komen gefaseerd uit: Venice SP7 in het vierde kwartaal van 2026, Venice SP8 in de eerste helft van 2027, en Venice-X en Verano in de tweede helft. AMD verdeelt dezelfde chip in zes varianten, en de fijnmazigere verdeling komt rechtstreeks overeen met de drie niveaus. Voor algemene toepassingen zijn er Venice SP7, SP8 en Venice-X. Het hostsegment combineert een Venice-processor met hoge frequentie met Verano en LPDDR-geheugen. Voor intensieve rekenkracht is er de Venice 256c: een processor met een hoog aantal cores en een laag stroomverbruik, ontworpen om zoveel mogelijk threads in een rack te plaatsen als het stroombudget toelaat. Verano heeft ook een multifunctioneel karakter: AMD zegt dat bepaalde klanten deze processor zullen inzetten als een processor voor algemene toepassingen waar prestaties per systeemwatt de beperkende factor zijn.
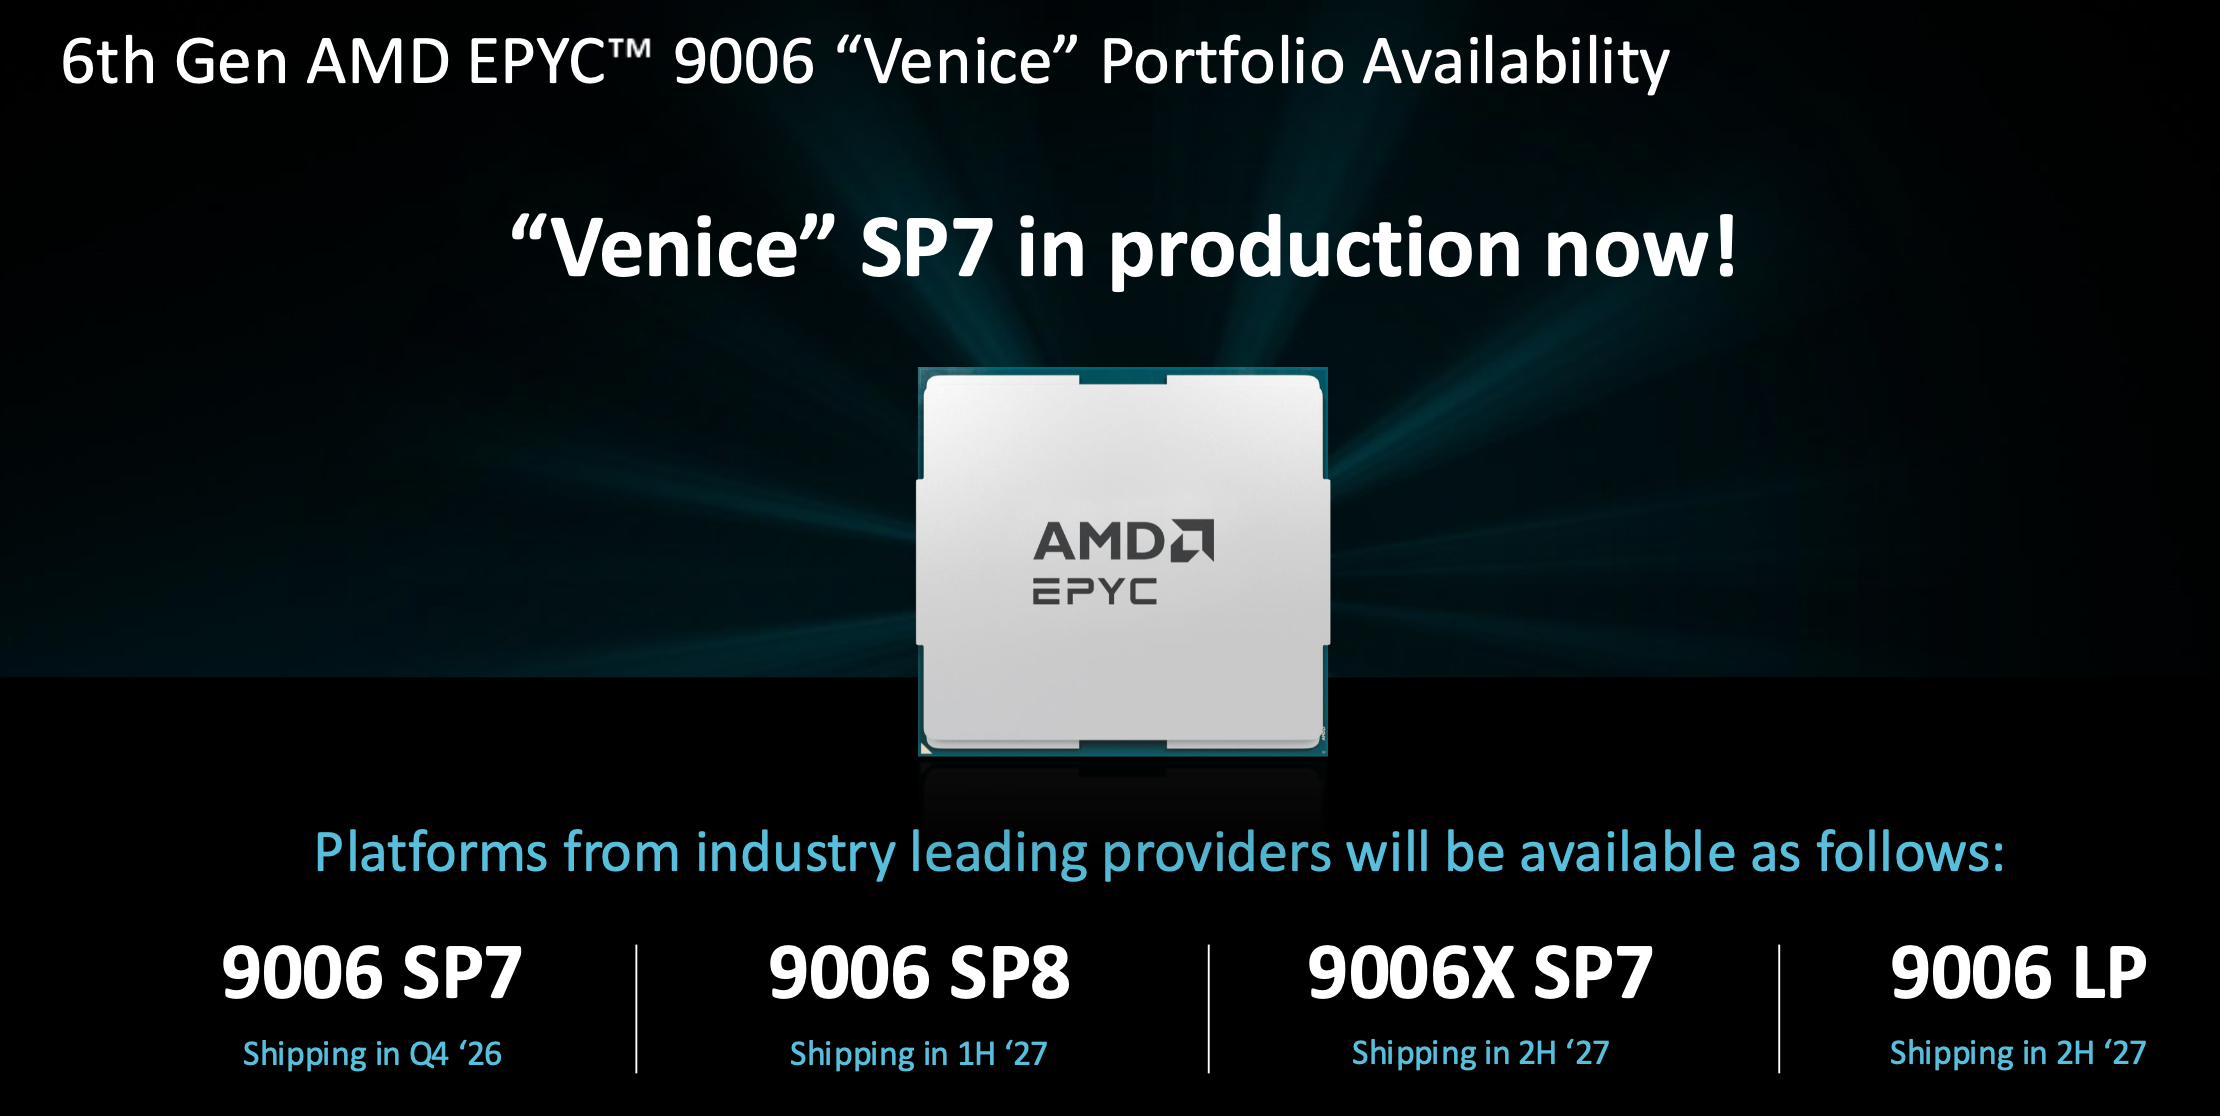
Dankzij de voetnoten krijgen we alvast een voorproefje van de SKU's. De 256-core EPYC 9996 is het topmodel, de 9956 heeft hetzelfde aantal cores maar met een vermogen van 400W, en de 96-core 9686F is de hostchip met hoge frequentie. Helios heeft zijn eigen versie van die hostchip, de EPYC 9G76, in elke compute-tray.
De compromisloze categorie
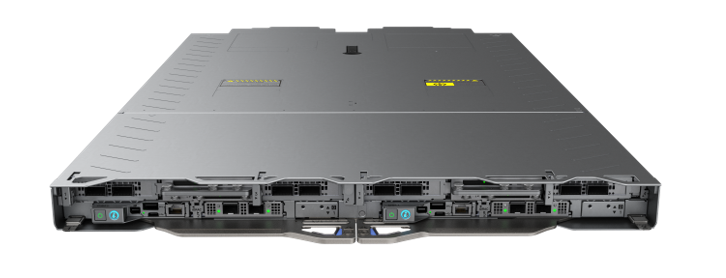
Voordat we de specificaties bekijken, eerst iets over de toepassing van de Venice SP7-socket. Venice SP2 is gereserveerd voor AMD's meest compromisloze prestatieklasse: datacenters, hyperscalers en HPC-systemen, waar de doorvoer per rack de doorslaggevende factor is en kosten noch moeite worden gespaard. Serverleveranciers passen hun prijsklassen hier al op aan. Dell heeft zijn aloude PowerEdge-naamgeving opgesplitst om ruimte te maken, en deze klasse van rekenkracht is nu ondergebracht in een nieuwe 9000-serie, aangevoerd door de PowerEdge R9825 en Rack Scale M9825, de vlaggenschepen met twee Venice-chips in een 3U-chassis.
De belangrijkste specificaties
De hele familie bouwt voort op één platform, en vrijwel elk hoekje ervan is nieuw sinds Turijn.
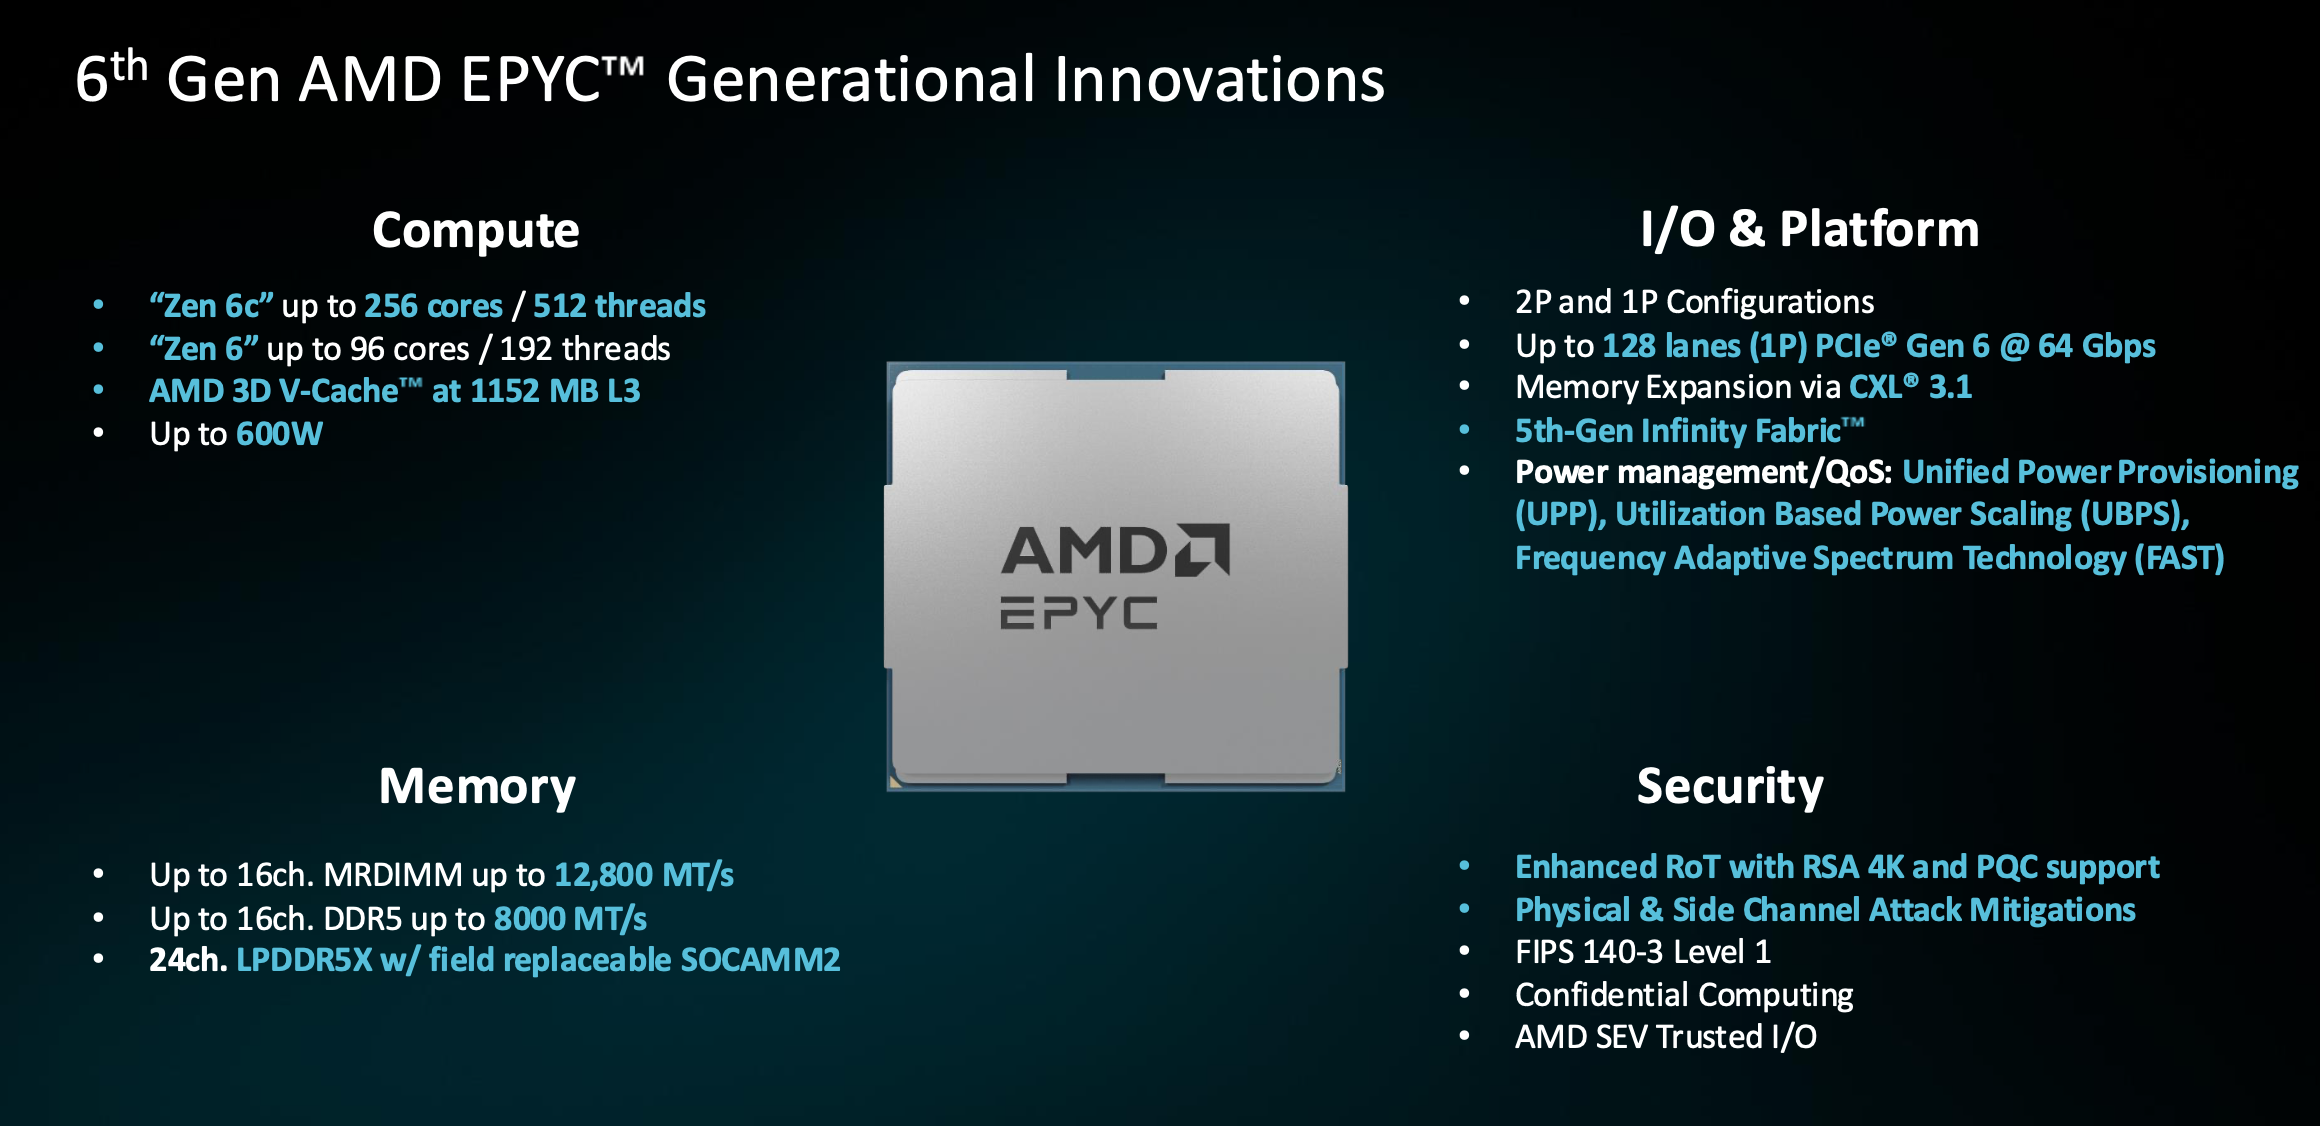
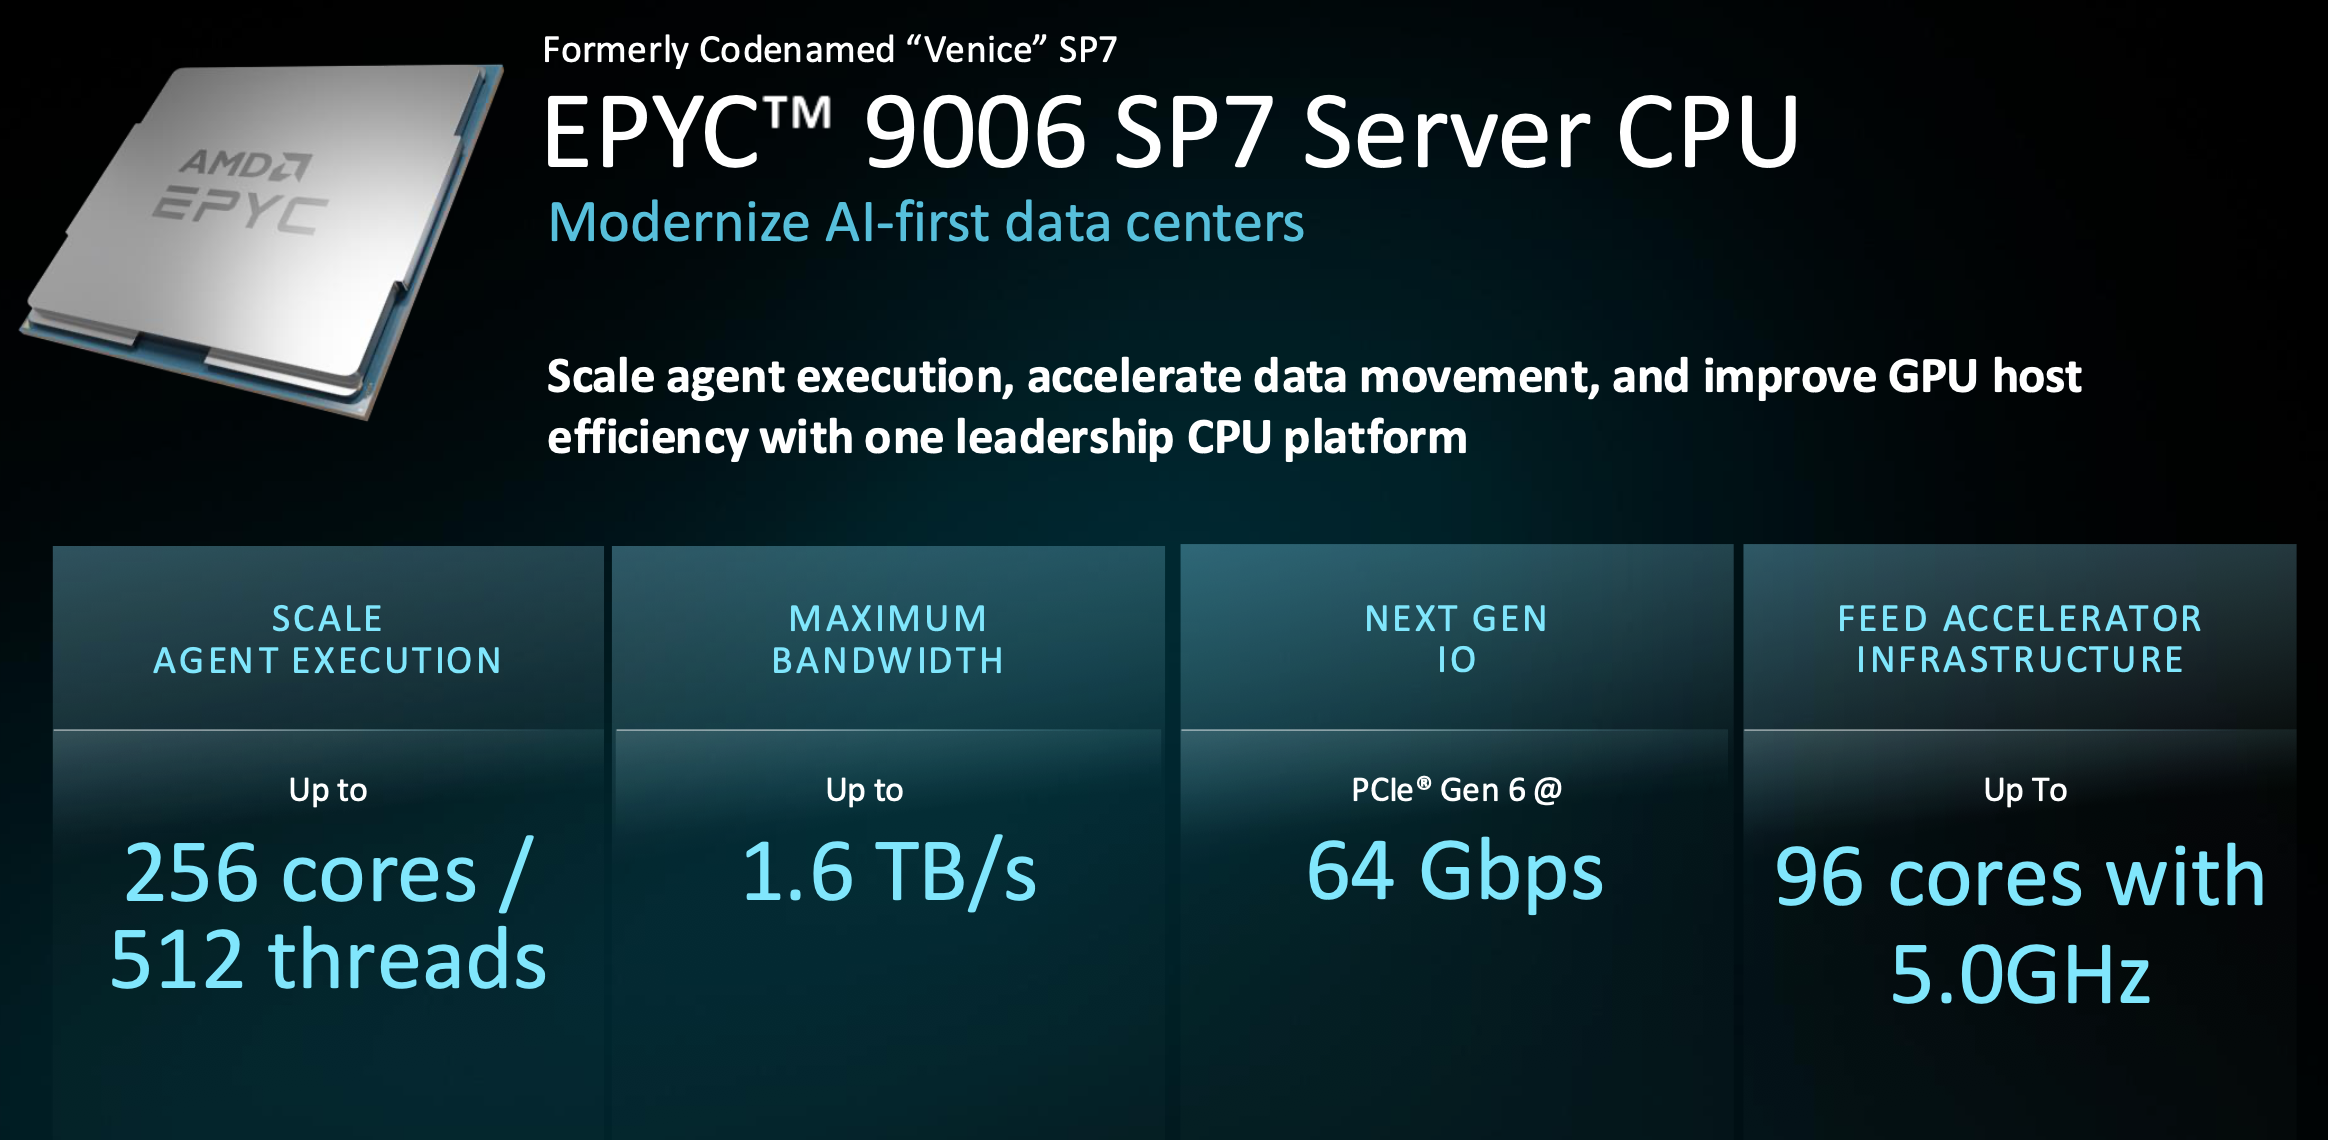
Laten we beginnen met de cores. Zen 6 is er in twee varianten: de compacte Zen 6c heeft 256 cores en 512 threads in één socket en verbruikt tot 600W, terwijl de standaardversie er 96 heeft, maar wel een kloksnelheid van 5GHz haalt. AMD claimt tot wel 20% meer prestaties per core dan concurrerende producten met een gelijk aantal cores, en de hoge dichtheid gaat niet ten koste van de cache: zelfs de 256-core chip behoudt ongeveer 4 MB L3-cache per core, tegenover een volledige gigabyte op het topmodel. AVX-512 ondersteunt de tokenizers en de modellen met 3 tot 8 miljard parameters die steeds vaker op de CPU zelf draaien.
Om die cores van data te voorzien, is een veel groter geheugensysteem nodig: 16 kanalen DDR5 met 8,000 MT/s, of MRDIMM met 12,800 MT/s, goed voor 1.6 TB/s per socket, terwijl Turin 614 GB/s haalde met 12 kanalen. I/O maakt dezelfde sprong. Venice is de eerste server-CPU met PCIe Gen 6, met 128 lanes van 64 GT/s, het dubbele van de bandbreedte per lane van alles wat momenteel op accelerators is aangesloten, en de basis voor de bewering over de host-node die we later verder toelichten. CXL 3.1 maakt gebruik van die lanes voor geheugenuitbreiding, en bepaalde AI-hostplatforms met twee sockets ruilen de xGMI-breedte tussen sockets in voor I/O om 160 bruikbare lanes te bereiken. Twee stillere toevoegingen verplaatsen gegevens zonder de processorkernen te belasten: SDXI ontlast de processor bij het kopiëren van geheugen en de cryptografische bewerkingen van 30 tot 50 processorkernen, en Smart Data Cache Injection plaatst netwerkpakketten rechtstreeks in de cache in plaats van ze via DRAM te routeren.
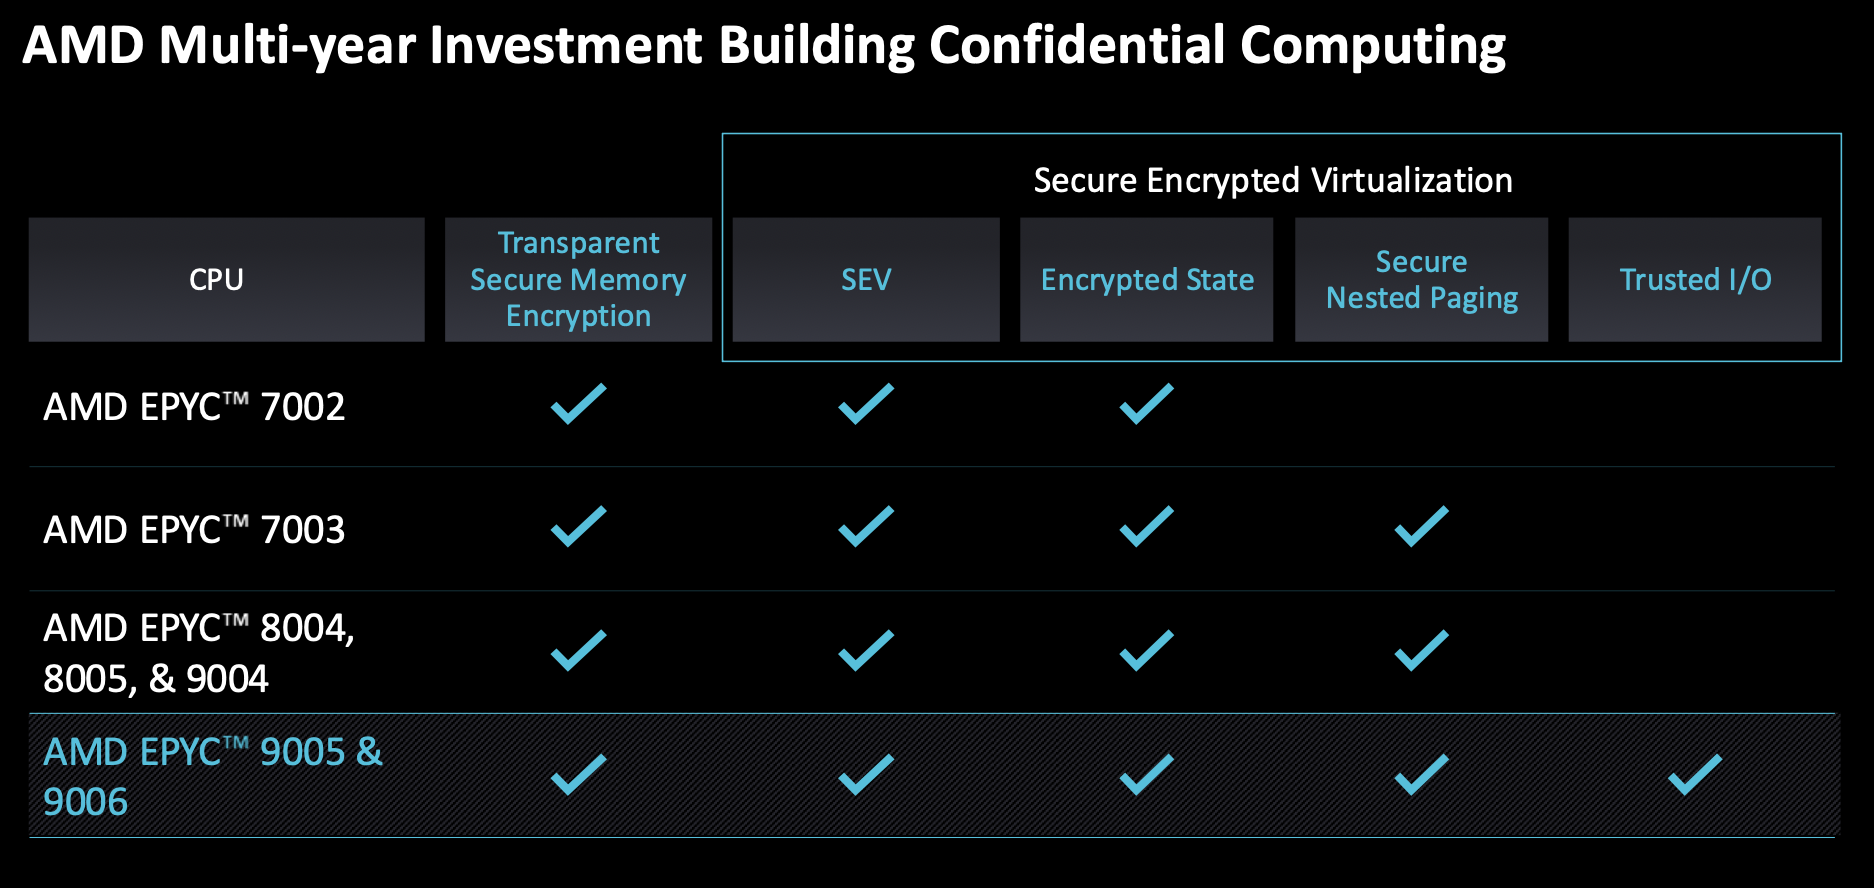
Energiebeheer krijgt drie nieuwe instellingen, en die zijn belangrijk omdat elke rackvergelijking die AMD later maakt, plaatsvindt binnen een bepaald energiebudget. UPP combineert de budgetten van de SoC en de DIMM's, waardoor een geheugenintensieve workload wattages naar de DIMM's verschuift en een rekenintensieve workload ze terugtrekt. Dit verhoogt de prestaties binnen een vast budget of maakt rackvermogen vrij voor meer nodes. UBPS beperkt het stroomverbruik bij lage belasting, waardoor de gebruikelijke prestatieverbetering bij lichte belasting wordt ingeruild voor een vlakke, voorspelbare belastinglijn; operators die de verbetering prefereren, kunnen deze uitschakelen. FAST splitst één SoC in twee 'persoonlijkheden', waarbij prioriteitskernen op een hoge frequentie blijven draaien terwijl achtergrondkernen langzamer draaien, zodat latency-kritische taken die een socket delen met batchtaken niet worden vertraagd.
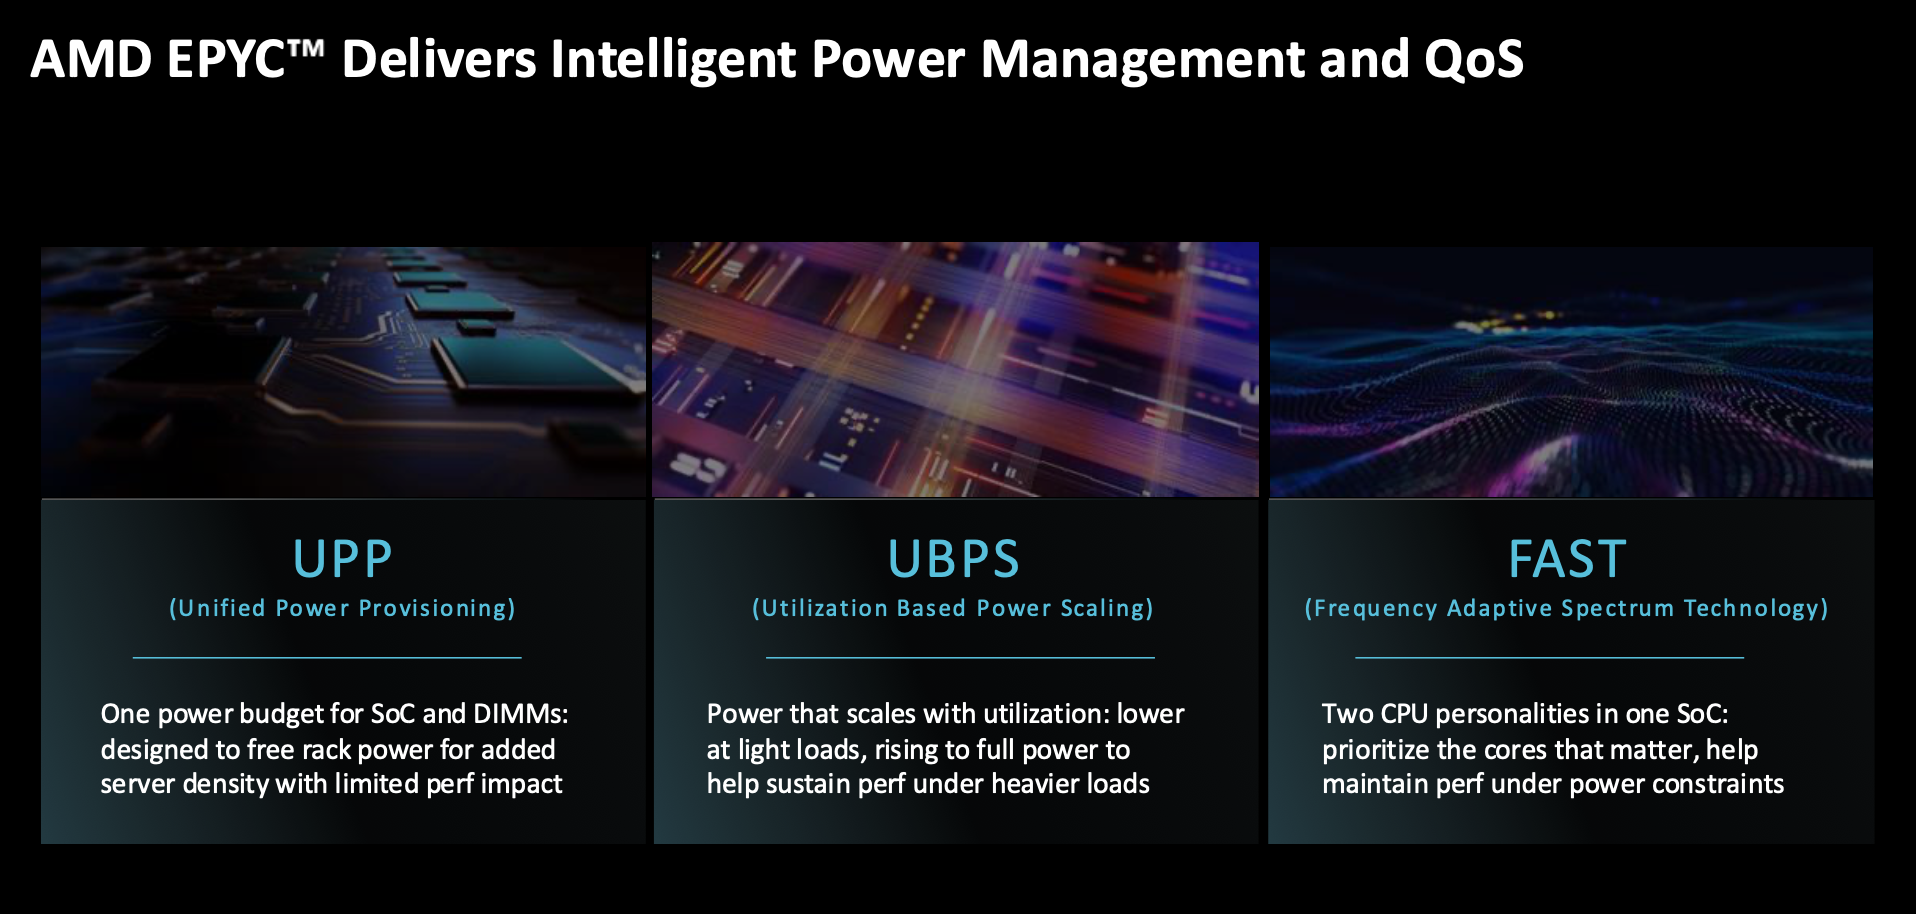
Op het gebied van beveiliging zet Venice een traditie van vertrouwelijke computerverwerking voort die teruggaat tot SEV op EPYC 7002, via versleutelde status, veilige geneste paging en de Trusted I/O die met Turin werd geïntroduceerd. Nieuw in deze generatie: een verbeterde root of trust met RSA-4K en post-quantumalgoritmen, bescherming tegen fysieke en side-channel-aanvallen, FIPS 140-3 Level 1-certificering en Device Provenance, een aantoonbare productiegeschiedenis die Venice als een van de eerste AMD-producten zal bieden.
Binnen het portfolio
De vier onderdelen verschillen meer van elkaar dan de gedeelde naam doet vermoeden.
| Specificaties | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP “Verano” |
|---|---|---|---|---|
| Cores | Tot 256 (512 threads) | 8 tot 128 | 96 | 72 |
| Piekfrequentie: | 5.0 GHz met 96 kernen (HF) | HF-opties aangeboden | ~ 5.15GHz | Tot 5.0GHz |
| Geheugen | 16 kanalen, tot 1.6 TB/s | 8 kanalen met 2 DIMM's per kanaal | 16-kanaals MRDIMM met een snelheid van 12,800 MT/s | 24ch LPDDR5X, SOCAMM2 |
| L3 cache | Tot 1024MB | afhankelijk van het aantal kernen | 1152 MB (3D V-Cache) | afhankelijk van het aantal kernen |
| I / O | PCIe Gen 6, 128 lanes 1P | 128 PCIe-lanes, 1P en 2P | PCIe Gen6 | Verbeterde xGMI bij 112 GT/s |
| Gericht op | Hyperscale dichtheid, AI-host | Enterprise, edge, NEBS-vriendelijk | HPC, AI-voorverwerking | Rack-scale AI-host |
EPYC 9006 SP7
SP7 is de vlaggenschip-socket en de socket die momenteel in productie is; partnerplatforms volgen in het vierde kwartaal. De hoogfrequente varianten volgen de Turin HF-processors op, die volgens AMD tot de snelst groeiende SKU's behoorden. De grootste toepassing is te vinden in Helios, waar de host-CPU in elke compute-tray via Infinity Fabric is verbonden met het coherente geheugendomein van het rack, met daarachter 1 TB DDR5-geheugen. Omdat de socket standaard is, kan elke SP7-SKU tot en met het vlaggenschip met 256 cores worden gebruikt, een punt dat we in het andere artikel hebben besproken.
EPYC 9006 SP8
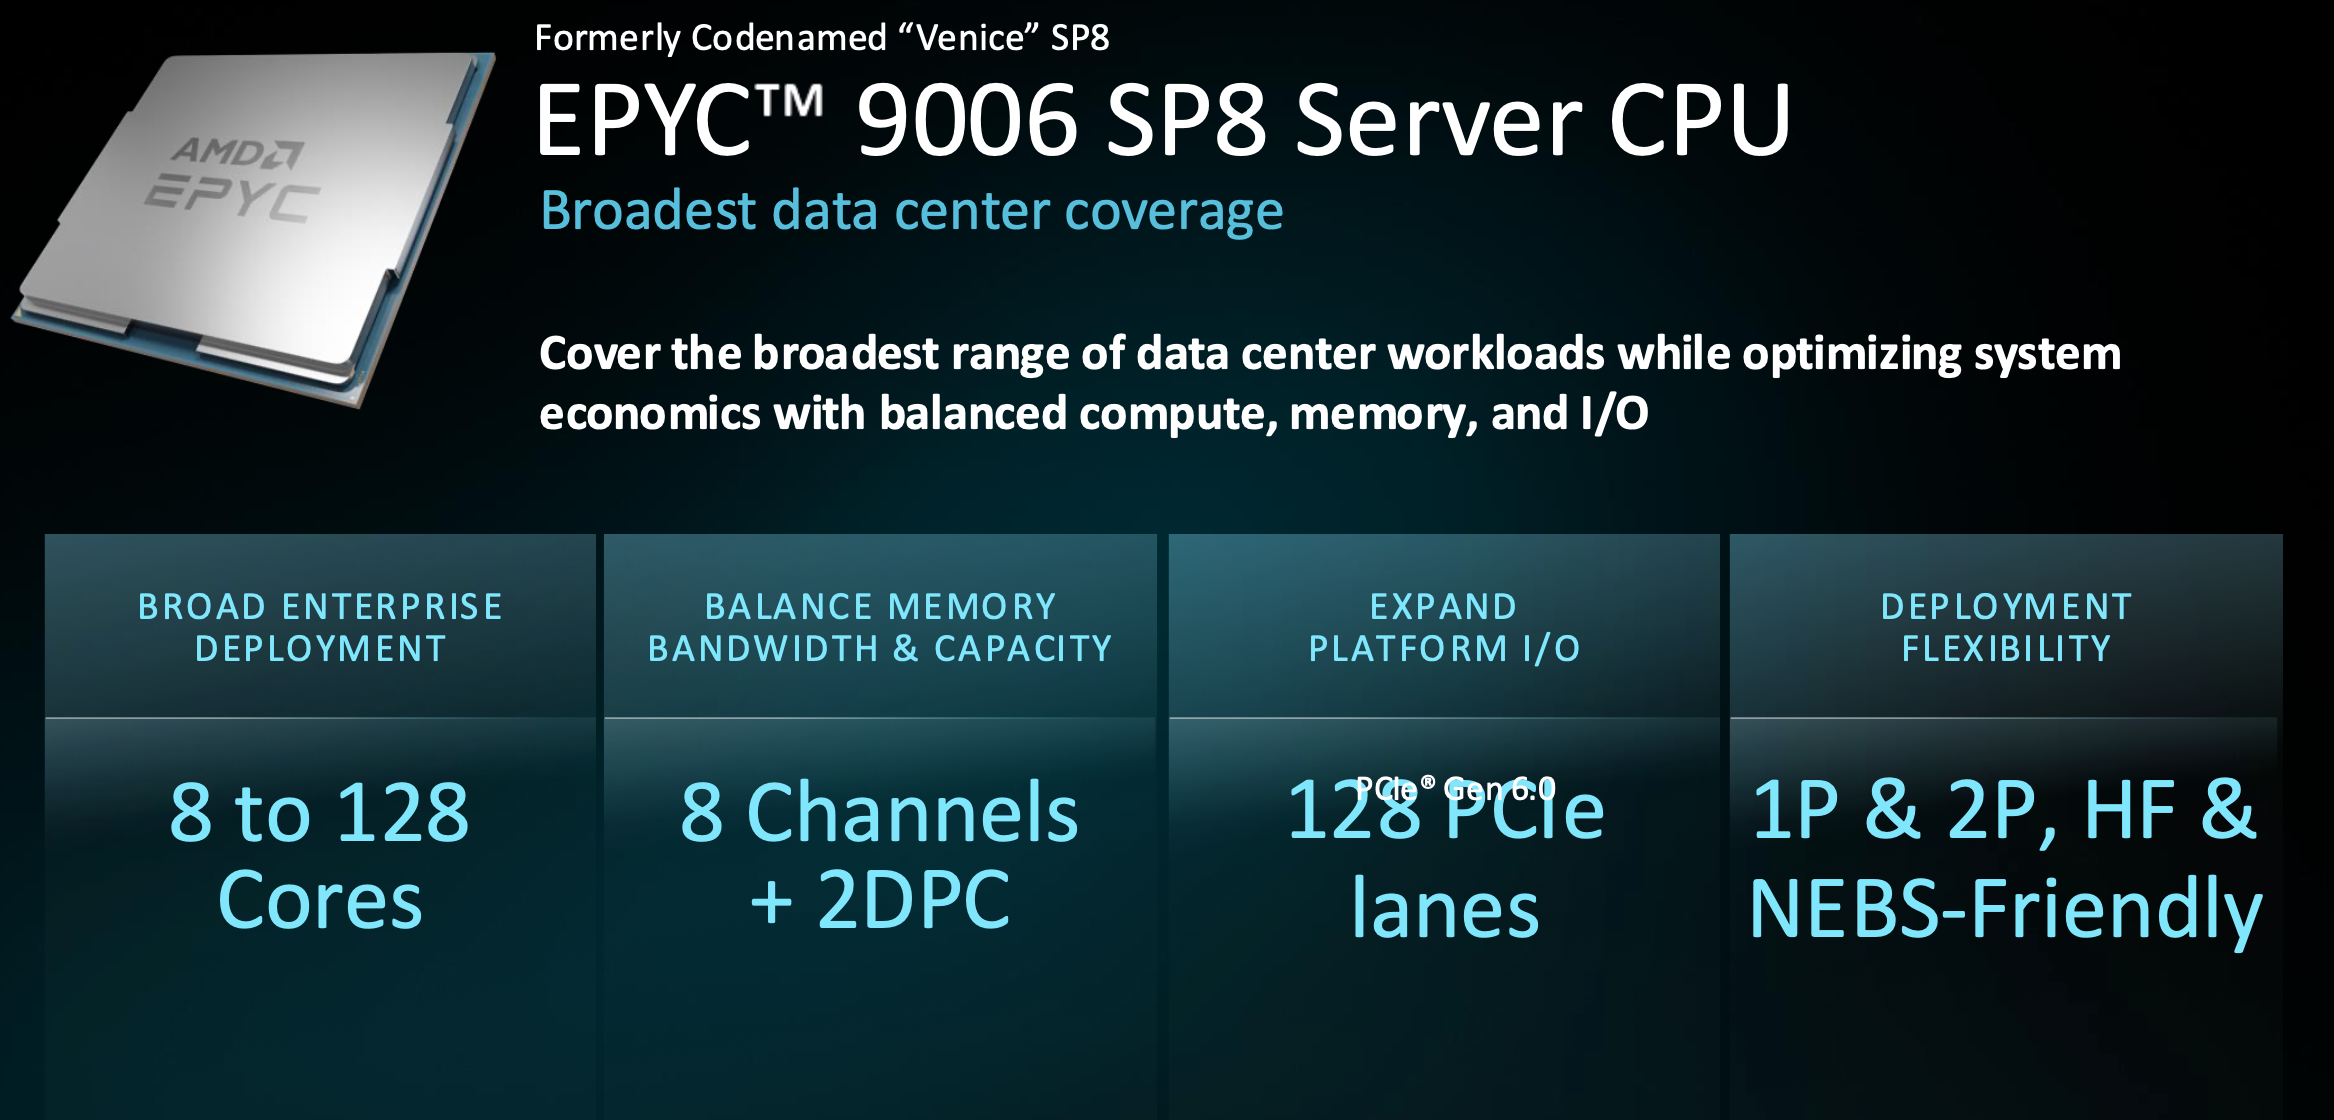
De SP8 ruilt de grote socket in voor een lagere systeemeconomie. Hij is verkrijgbaar met 8 tot 128 cores, heeft 8 geheugenkanalen met 2 DIMM's per kanaal, behoudt 128 PCIe-lanes en is beschikbaar in 1P- en 2P-uitvoeringen met opties voor hoge frequenties en NEBS-ondersteuning voor telecom- en edge-implementaties. AMD's verkoopargument is prestaties op maat voor de zakelijke markt, waar de doorslaggevende factor bij het sluiten van deals de prestaties per systeemdollar zijn in plaats van per rack.
EPYC 9006X “Venice-X”
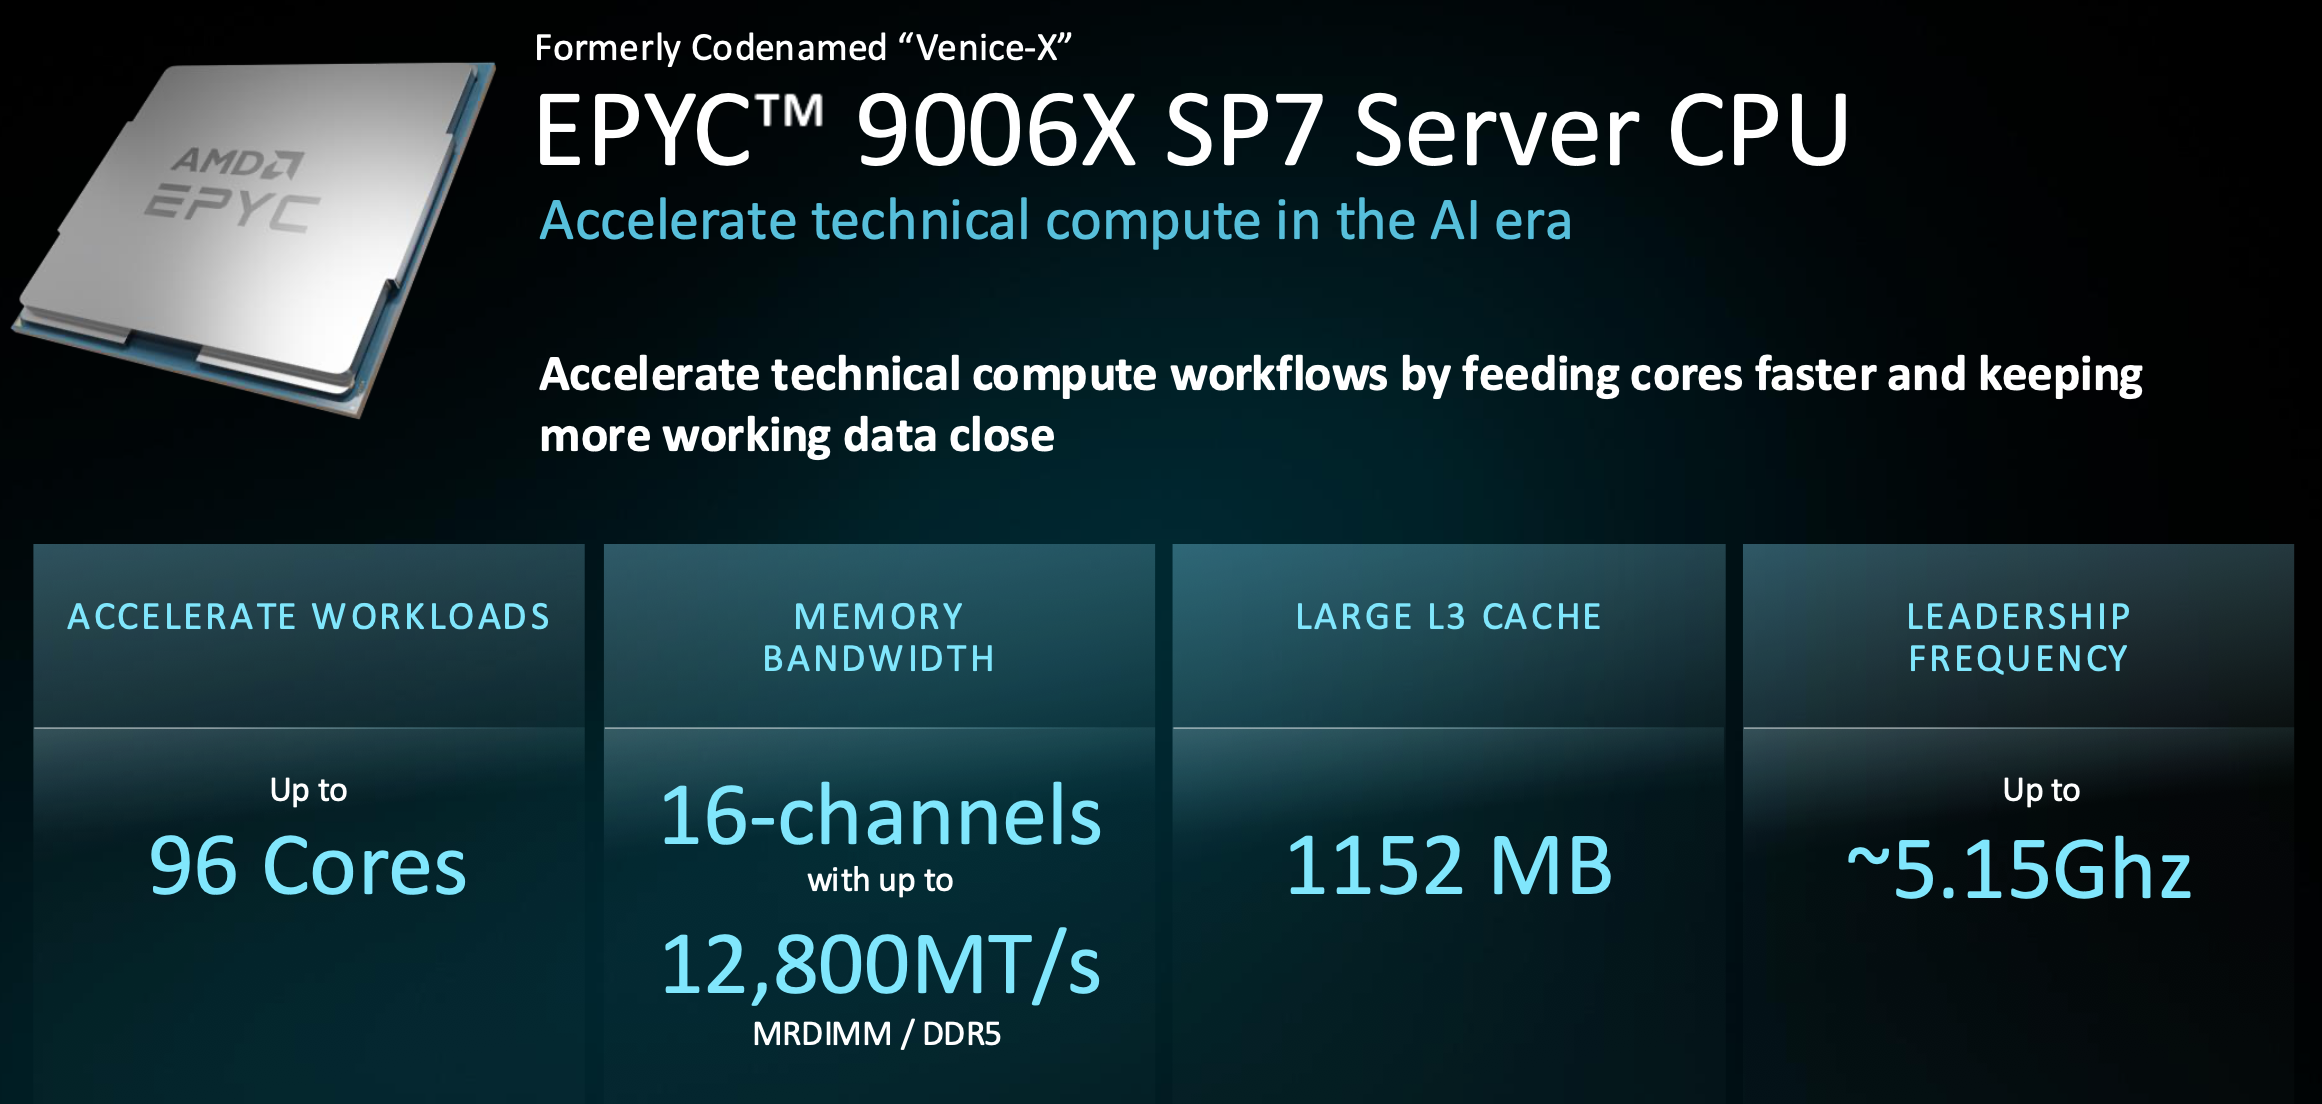
Venice-X combineert 3D V-Cache met de 96-core high-frequency configuratie en vergroot de L3-cache tot 1152 MB, ongeveer drie keer zoveel cache per core als de standaard SP7-processors. De kloksnelheid bereikt circa 5.15 GHz en het volledige 16-kanaals geheugensysteem met een snelheid van 12,800 MT/s is behouden. De processor is gericht op simulatie en modellering, grootschalige analyses, in-memory databases en AI-preprocessing die trainingspipelines voedt – workloads waarbij een werkset in de cache belangrijker is dan extra cores.
EPYC 9006 LP “Verano”
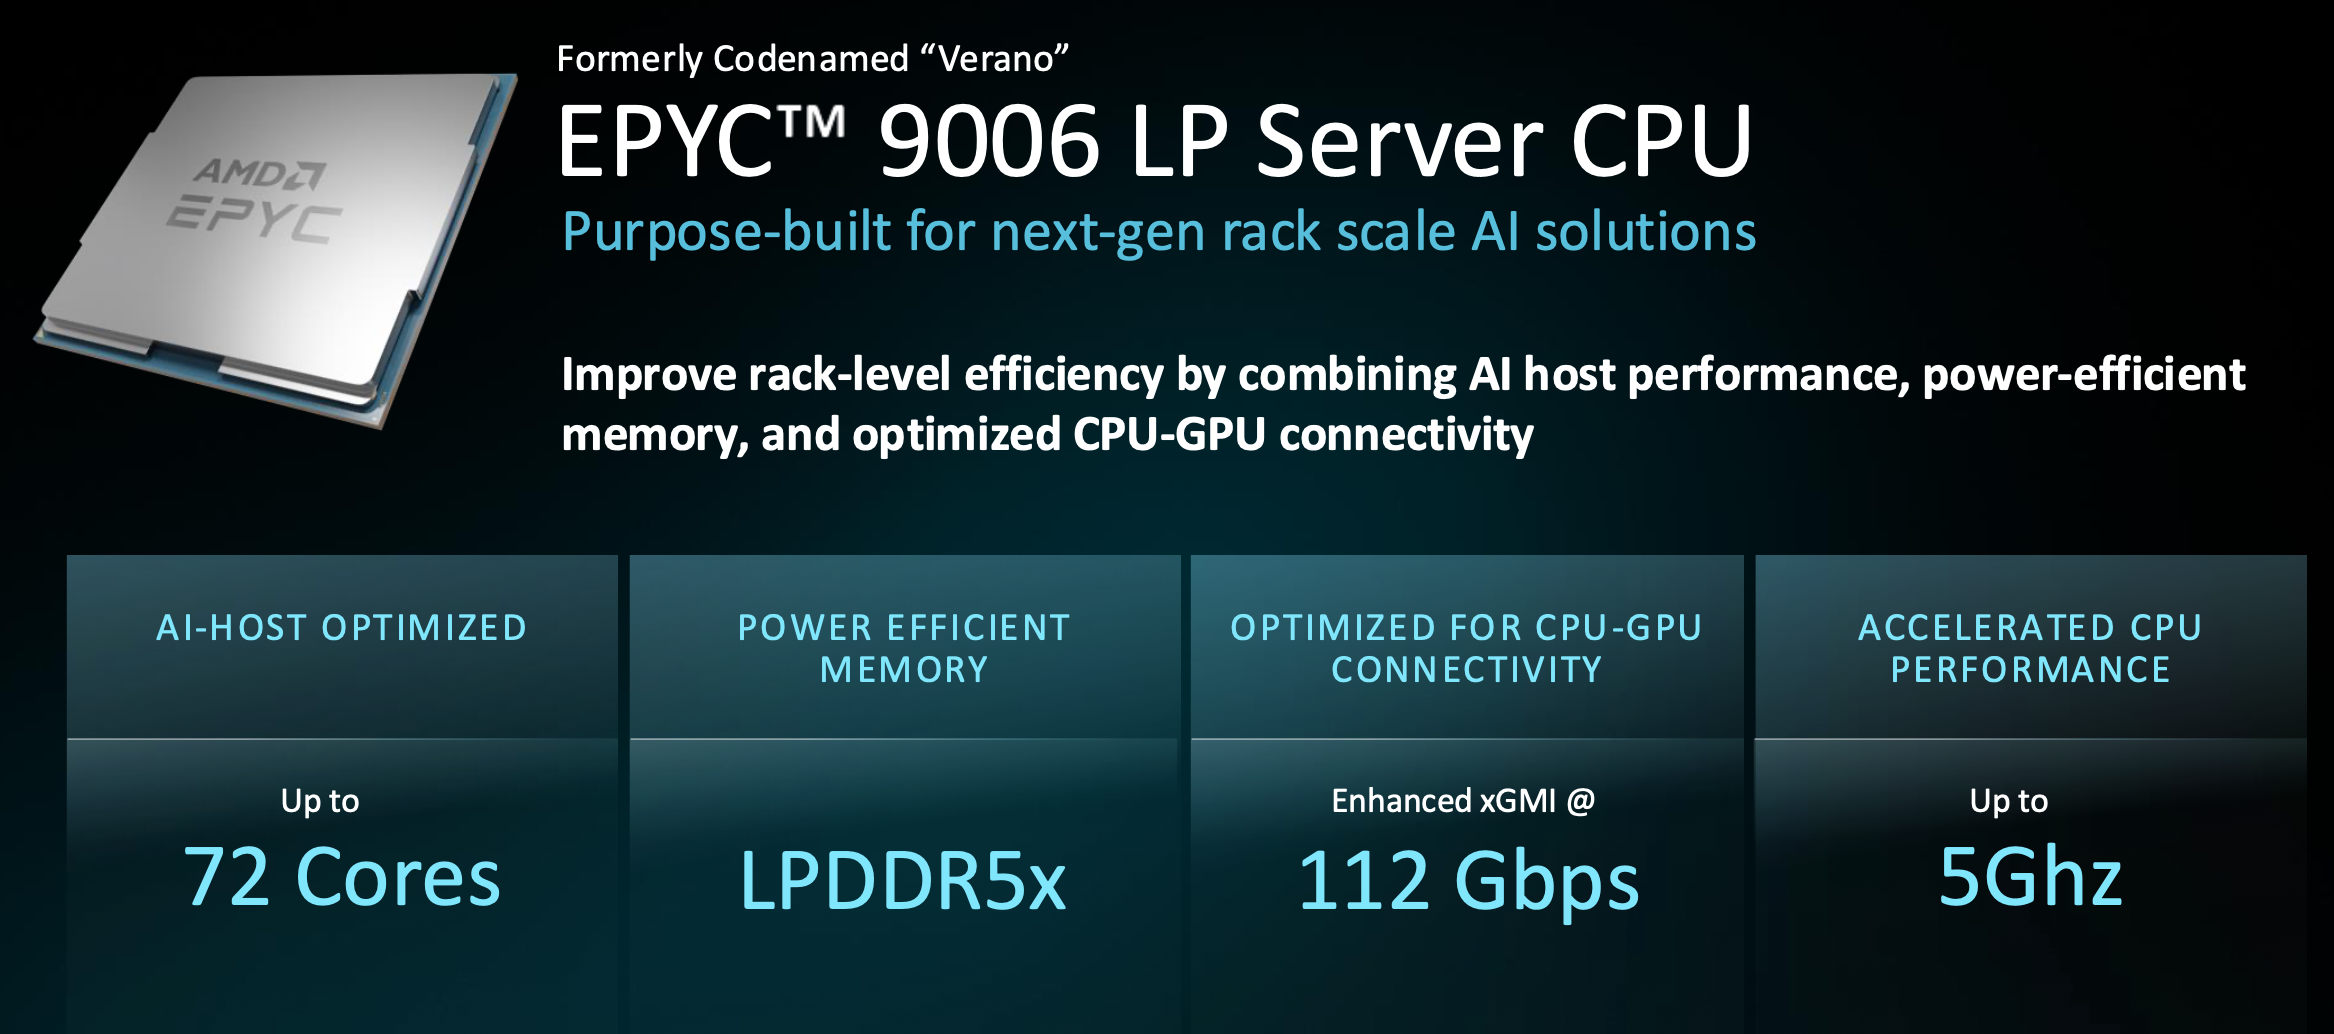
Verano is het meest gerichte onderdeel van de familie: in de eerste plaats een AI-hostnode, met maximaal 72 cores op 5 GHz, 24 kanalen LPDDR5X en een verbeterde 112 GT/s xGMI-link voor CPU-naar-GPU-verkeer. De LPDDR bevindt zich op SOCAMM2-modules die in het veld kunnen worden vervangen, wat belangrijk is in een vloot waar een defect aan vastgesoldeerd geheugen anders een heel moederbord onbruikbaar zou maken. Het is ook AMD's directe antwoord op NVIDIA's Vera, een confrontatie waar we later op terugkomen, omdat AMD dat zeker ook heeft gedaan.
Hoe Venetië zich verhoudt tot andere landen.
AMD presenteerde zijn argumenten in twee rondes, beginnend in Turijn om de reeds bestaande voorsprong te tonen, en vervolgens in Venetië om te laten zien hoe groot de voorsprong is.
Turijns voorsprong vandaag
AMD richtte de meeste vergelijkingen op NVIDIA's Vera, de Arm CPU in het Vera Rubin-platform, en begon met de generatie die het al levert. Volgens AMD's rack-level modellering levert een rack met Turin-processors 2.4 keer de algemene doorvoer van Vera en twee keer zoveel agents per watt. Het model gaat uit van een energiebudget van 100 kW voor beide racks, vergelijkt een 2P EPYC 9965 met 384 cores met een 2P Vera-kaart met 176 cores en middelt de resultaten over zes workloads: geschatte SPECrate 2017, server-side Java, NGINX, Redis, Memcached en een TPC-C-afgeleide.
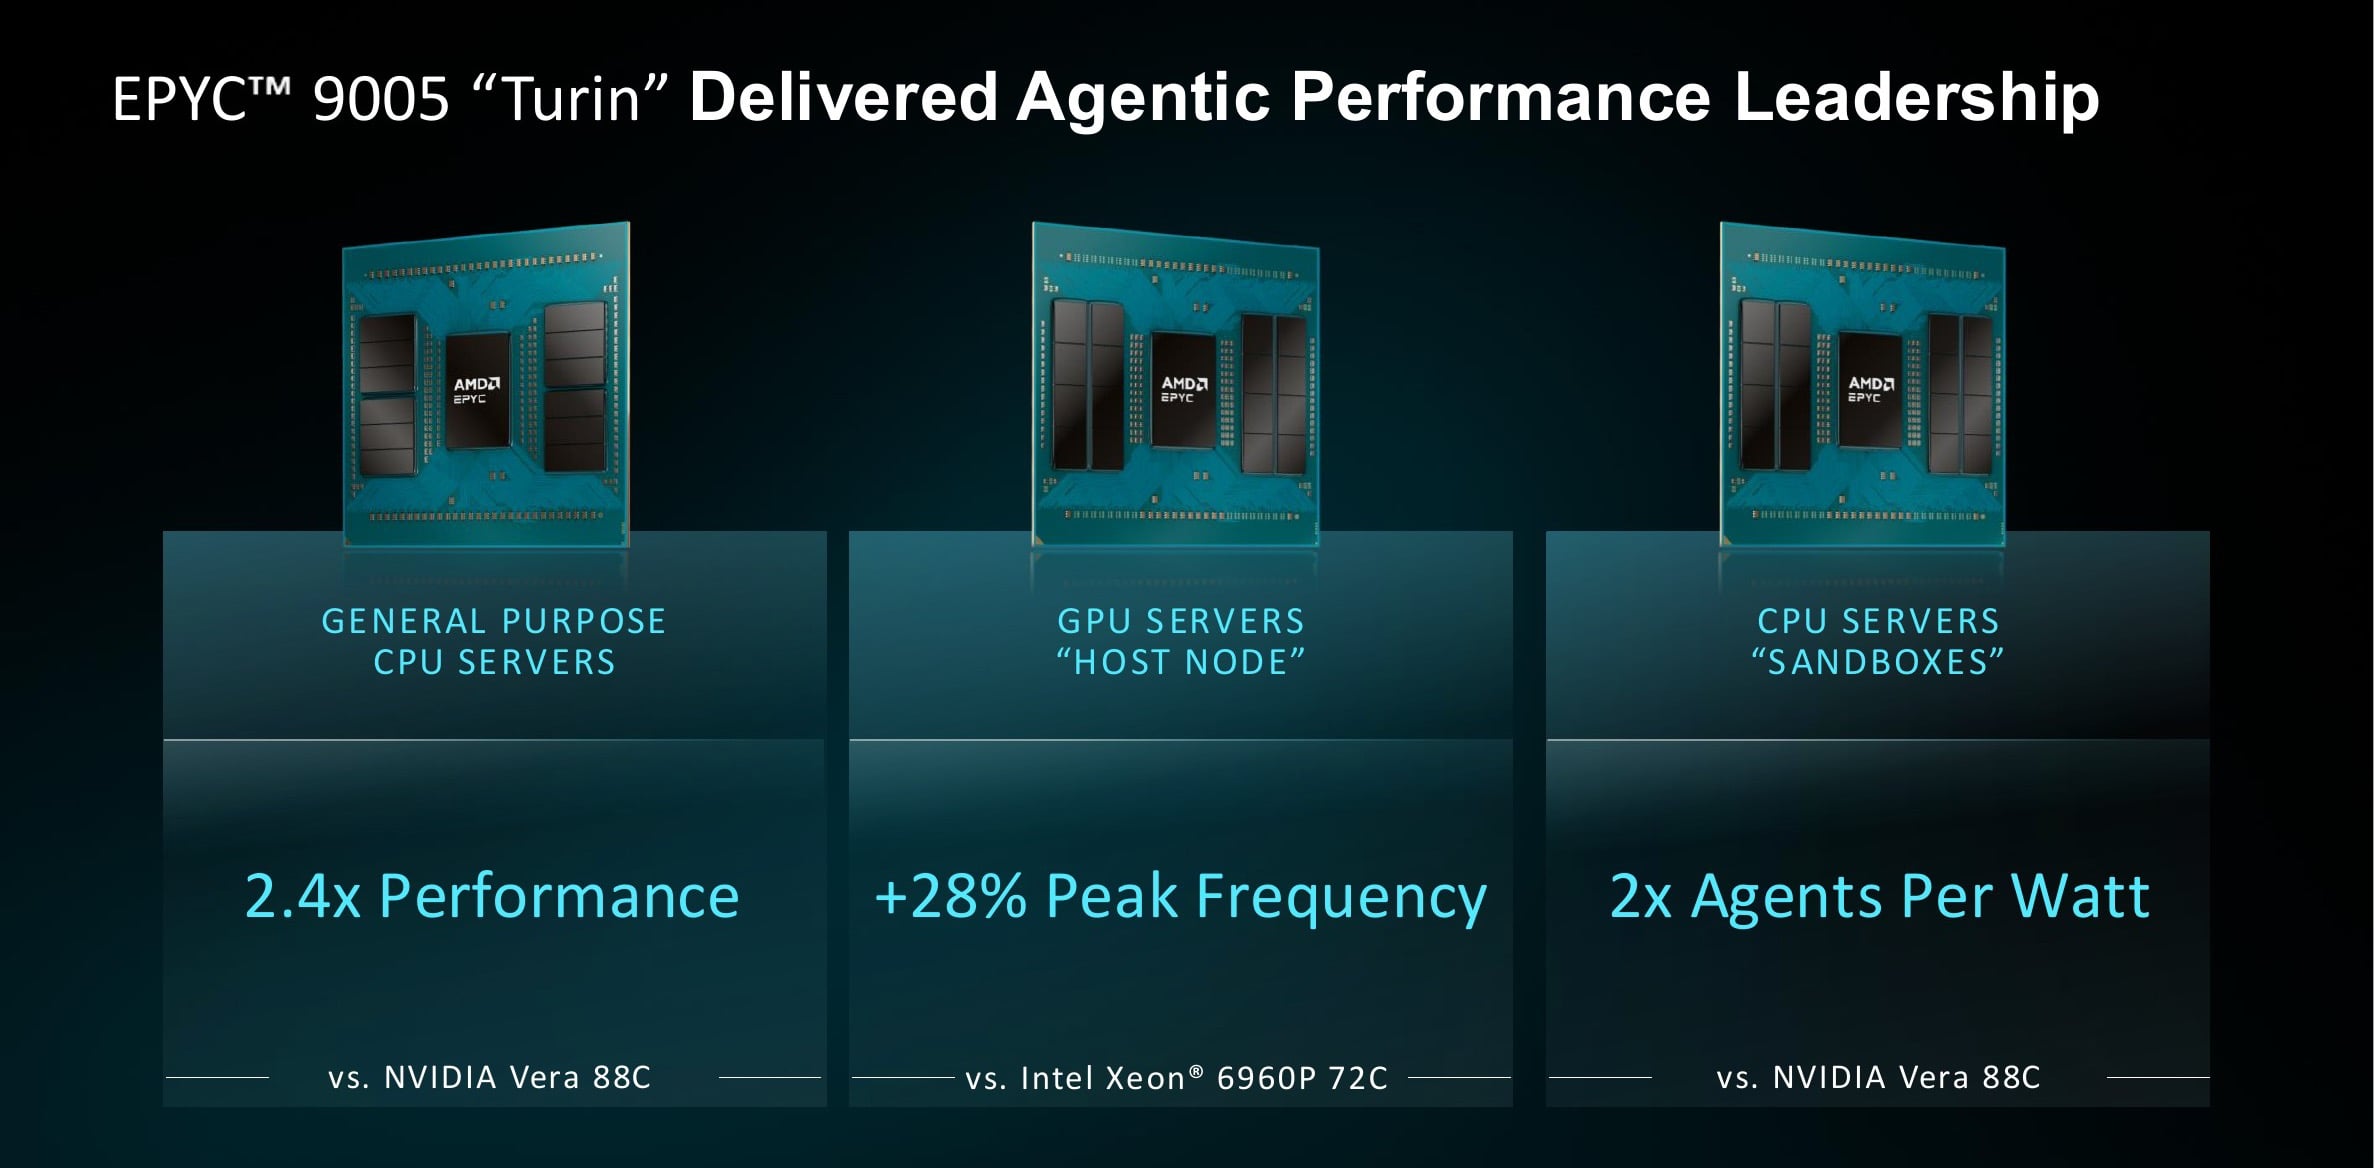
Twee belangrijke kanttekeningen zijn hier en in de rest van dit artikel van toepassing. Vera is nog niet uitgebracht, dus alle cijfers die voor Vera gelden, zijn schattingen van AMD voor de 88-core, 450W-processor die NVIDIA in haar openbare documentatie heeft beschreven. En omdat er geen standaardbenchmark bestaat voor workloads met agents, gebruikt AMD hardwarethreads als een benadering voor agents in haar berekening van agents per watt.
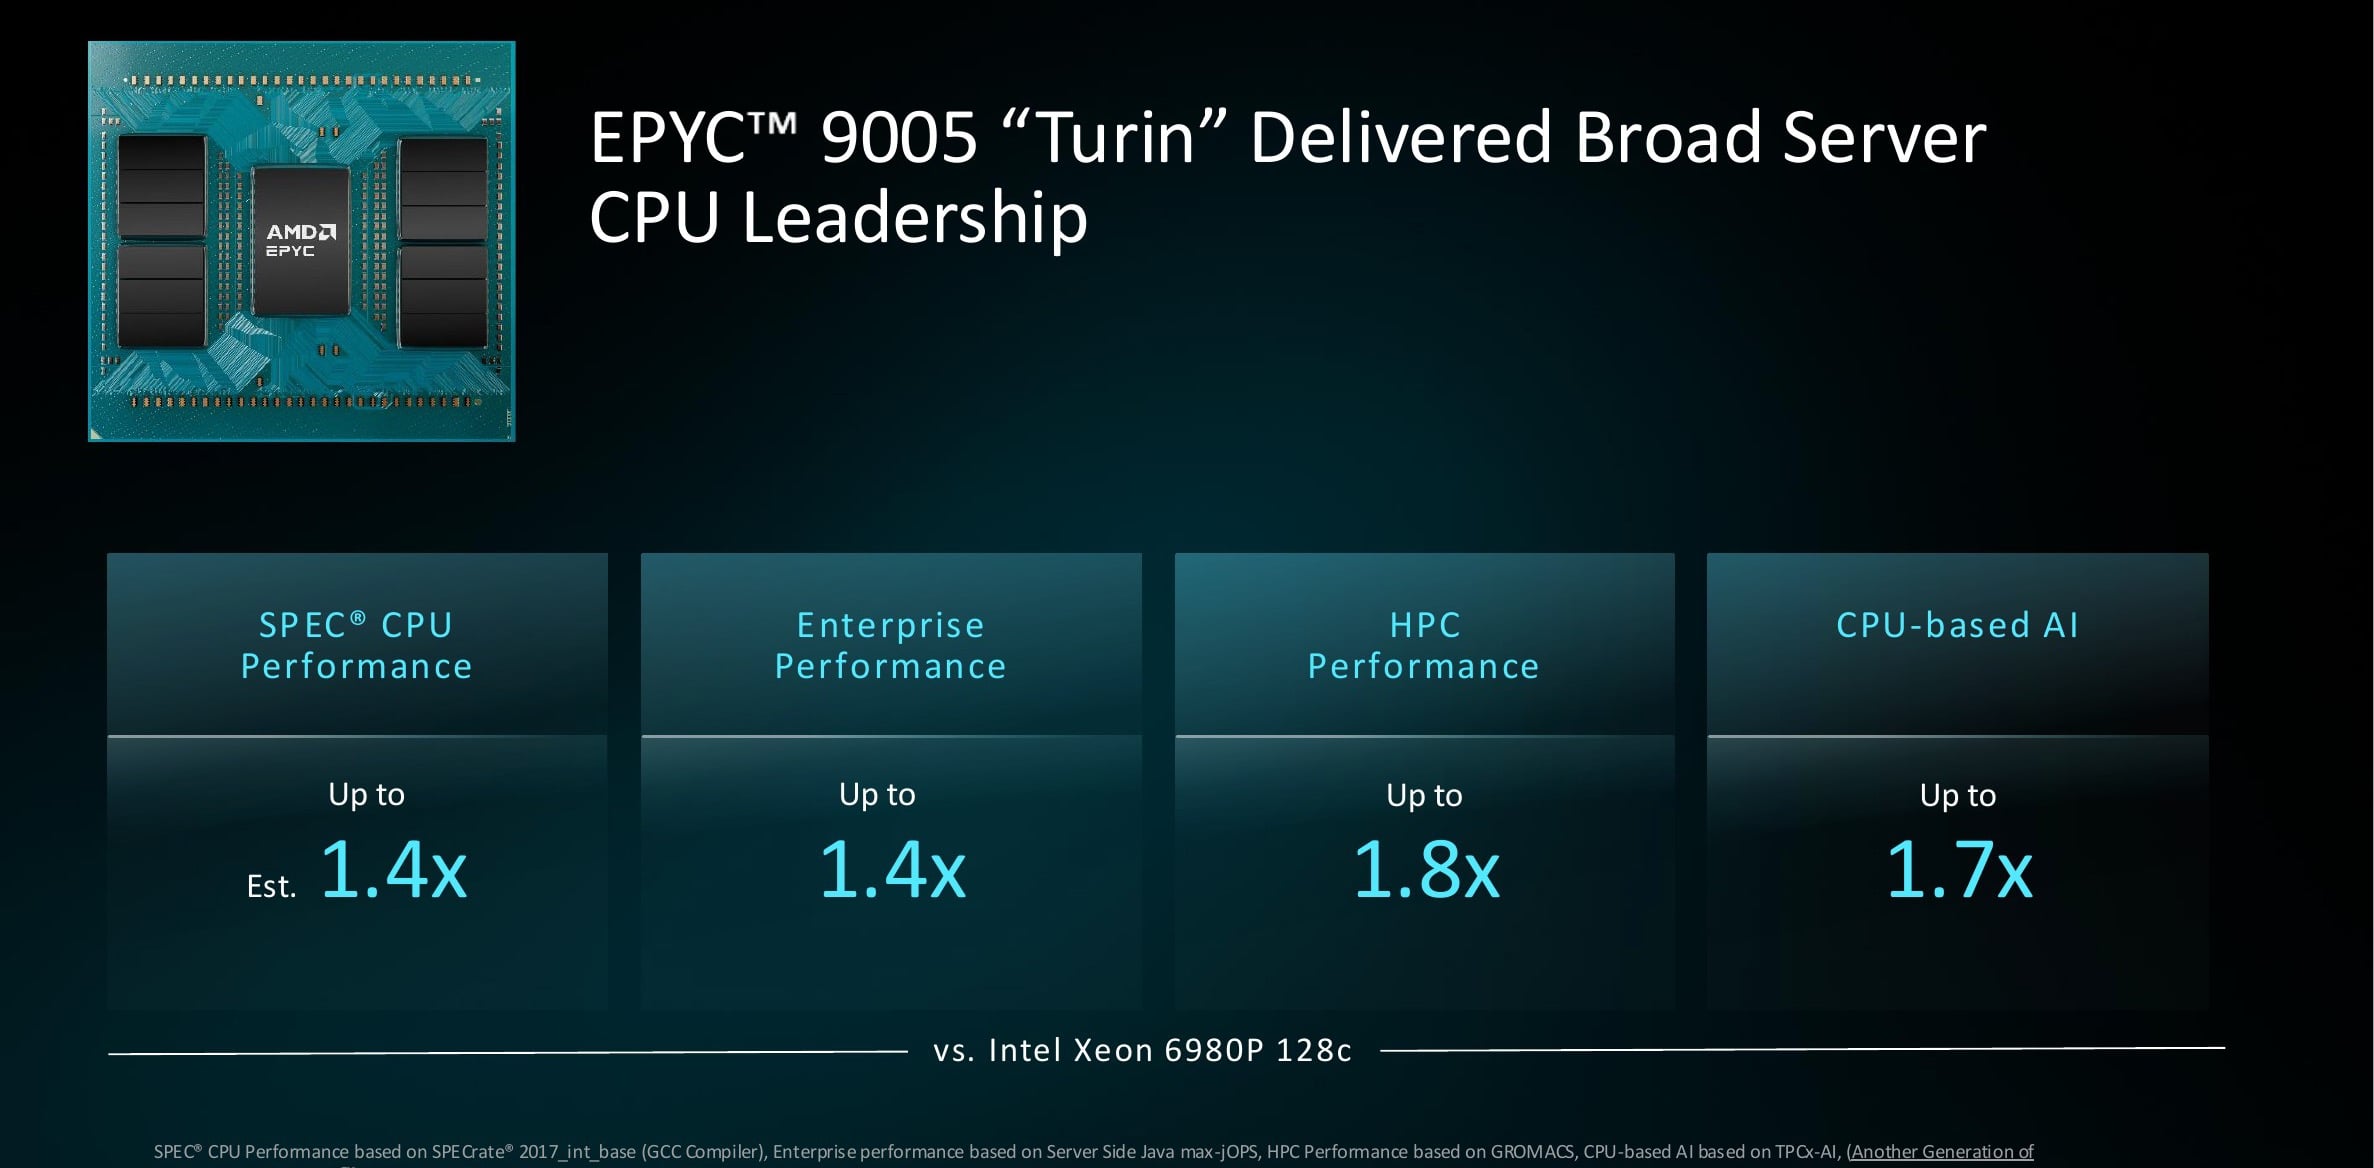
De vergelijking met Intel staat op een steviger fundament, aangezien beide partijen onderdelen leveren die AMD direct kon benchmarken. De host-CPU's van Turin halen 5.0 GHz, terwijl de vergelijkbare Xeon maximaal 3.9 GHz haalt, een frequentievoordeel van 28% dat van belang is wanneer individuele threads GPU's aansturen. Socket-voor-socket vergeleken met de 128-core Xeon 6980P, meet AMD Turin tot 1.4x sneller op SPEC CPU, 1.4x sneller op enterprise Java, 1.8x sneller op HPC en 1.7x sneller op CPU-gebaseerde AI.
Venetië vergroot elke kloof.
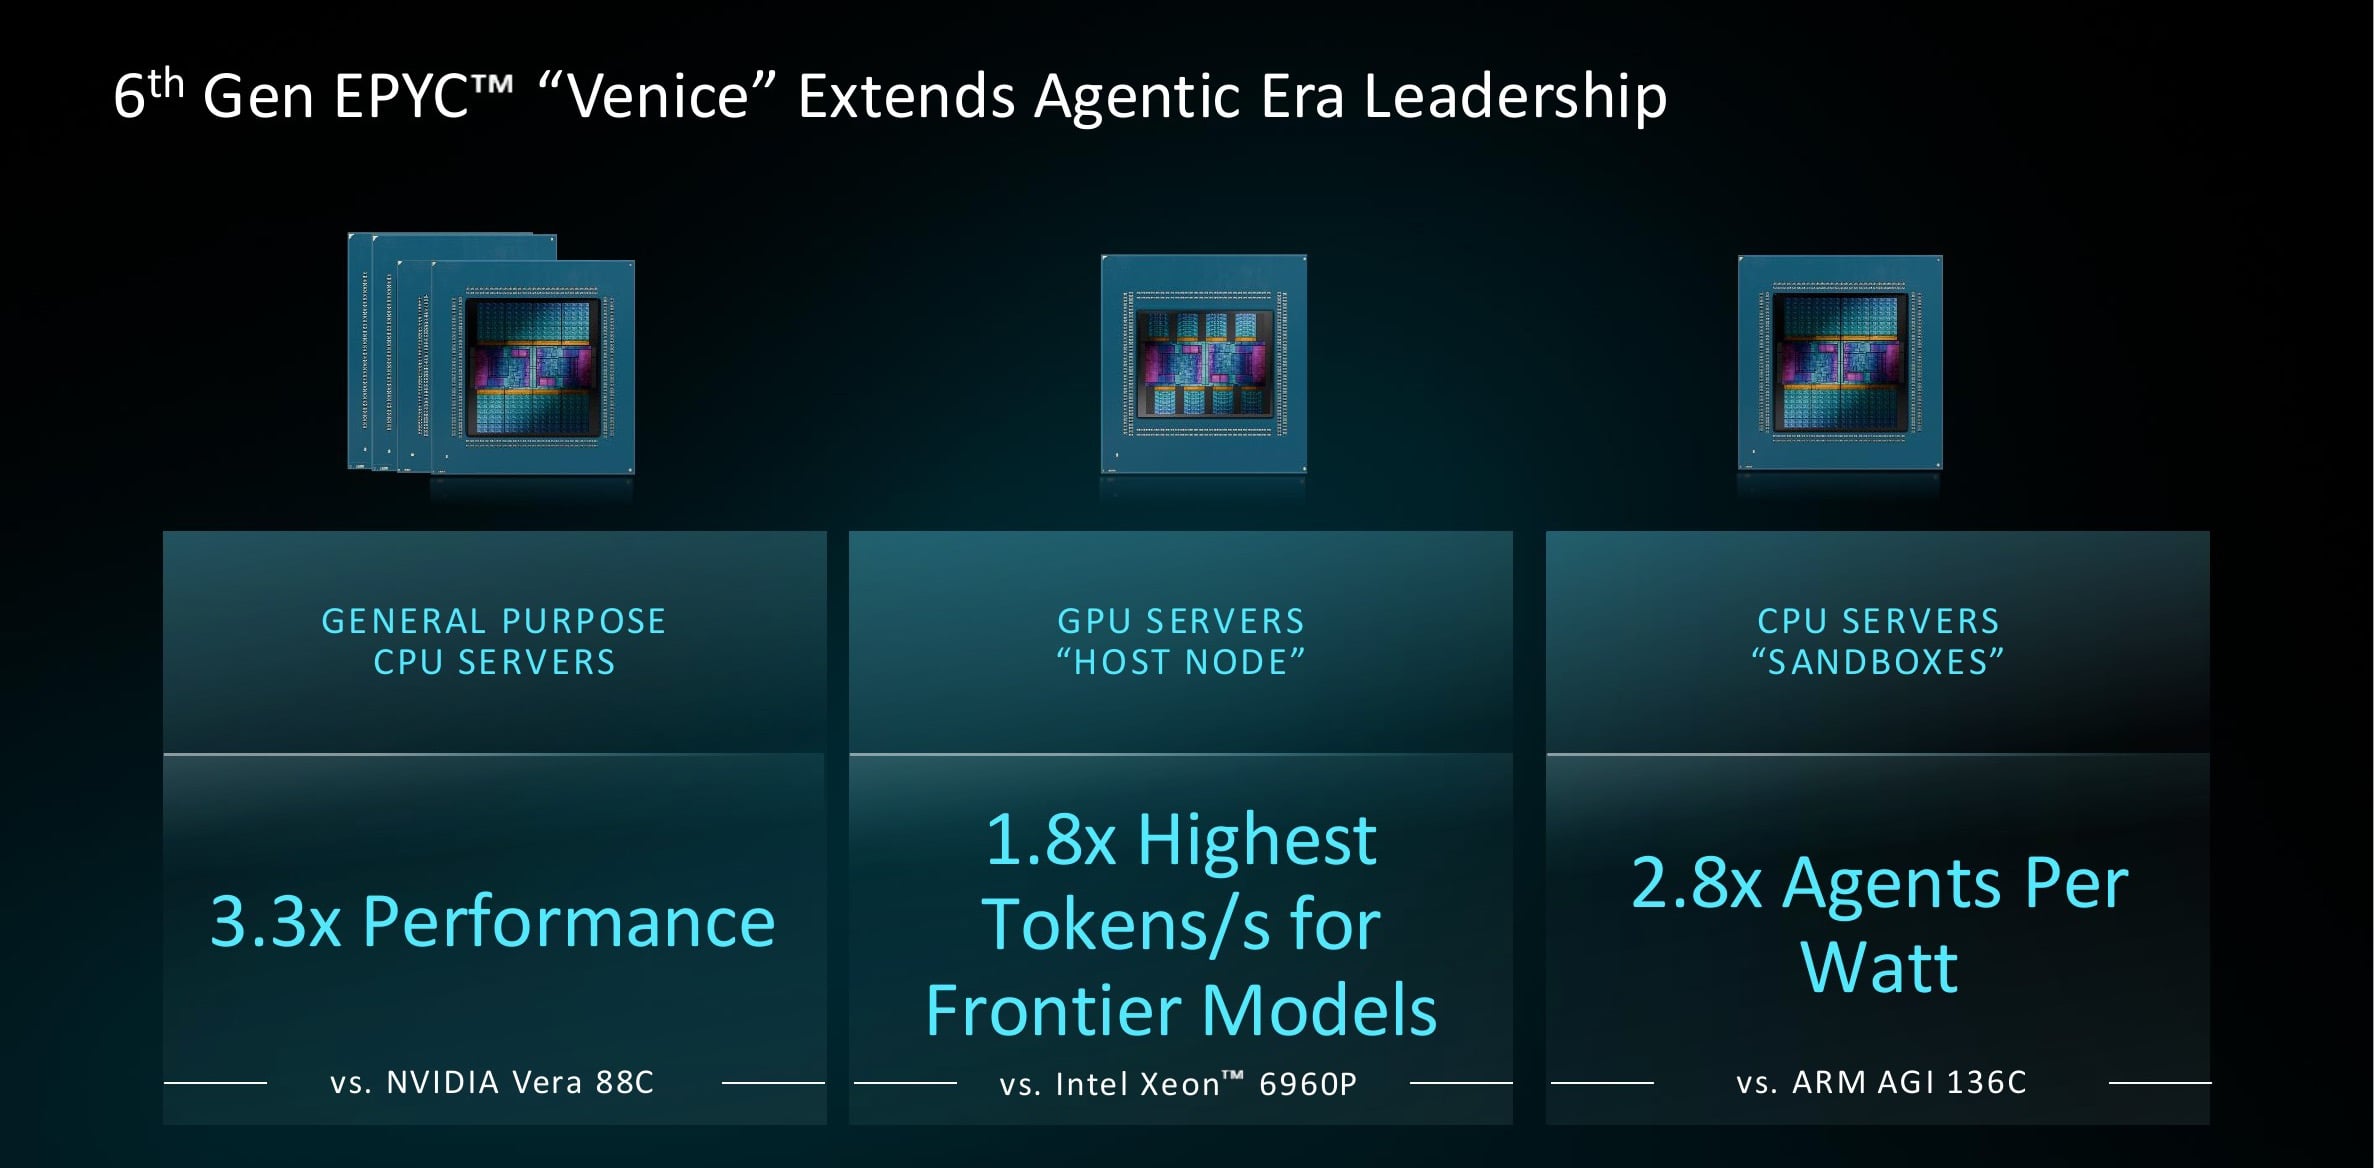
Venice breidt elk van die voorsprongen verder uit. Onder hetzelfde 100 kW rackmodel, nu met 512 Venice-cores tegenover 176 van Vera, claimt AMD 3.3 keer de algemene prestaties van Vera. Venice behaalt 2.8 keer het aantal agents per watt van de 136-core Arm AGI en 1.8 keer het aantal tokens per seconde op grensmodellen wanneer Venice GPU's host. Dat cijfer van 1.8 keer meet een beperkter scenario dan de kop doet vermoeden, en we komen hier later in het gedeelte over host-nodes op terug.
Een rechtstreeks duel met Vera
Volgens SPECrate 2026 schat AMD de prestaties van een 2P Venice 9996 op 2070, tegenover 925 voor Vera. Dit is een 2.2 keer hogere doorvoersnelheid en plaatst de 96-core high-frequency chip ongeveer 1.2 keer voor op Vera per core. Beide resultaten zijn samengesteld met GCC 15.2, dezelfde toolchain die NVIDIA gebruikte voor de gepubliceerde Vera-cijfers.
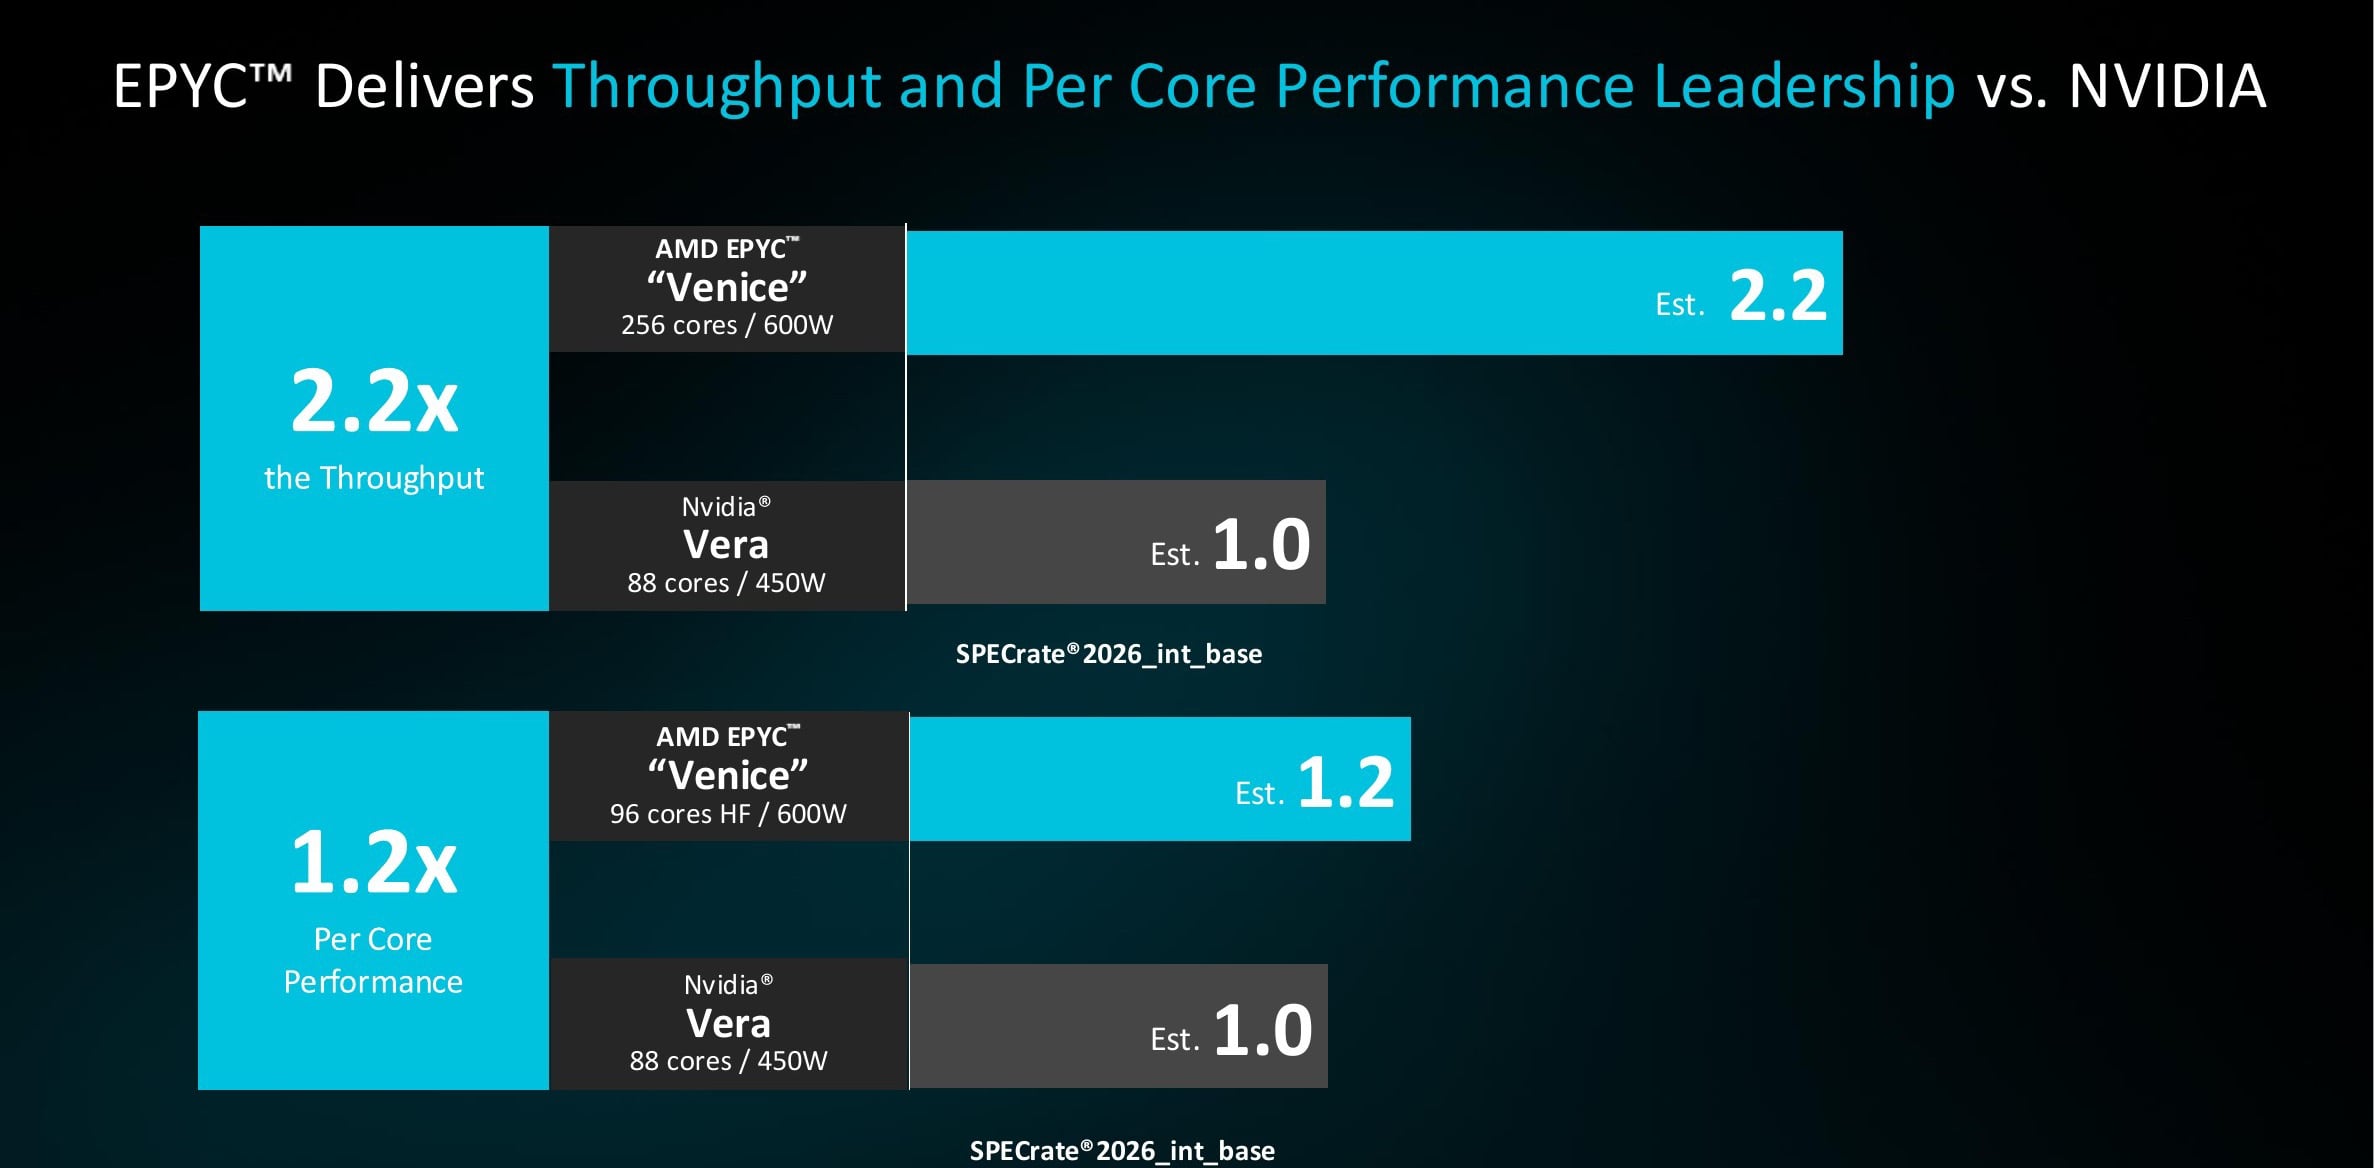
De bewering over de prestatieverbetering per core nam tijdens de lanceringsweek zelfs toe. Ravi Kuppuswamy, hoofd CPU-engineering bij AMD, vertelde de pers dat AMD aanvankelijk een voordeel van 10% per core had geclaimd. Nadat NVIDIA eerder die week zijn eigen Vera-cijfers had gepubliceerd, voerde het team de vergelijking opnieuw uit met dezelfde compiler en instellingen en mat een voorsprong van 20%, terwijl de optimalisatie nog niet was afgerond. Het verschil in doorvoersnelheid van 2.2x, zei hij, kwam overeen met de interne projecties van AMD. Een aparte voetnoot herberekent de prestatieverbetering per core op SPECrate 2017 met behulp van AMD's eigen AOCC-compiler en komt uit op 1.7x, waardoor 20% de meest conservatieve van de twee berekeningen is.
Intel en Arm
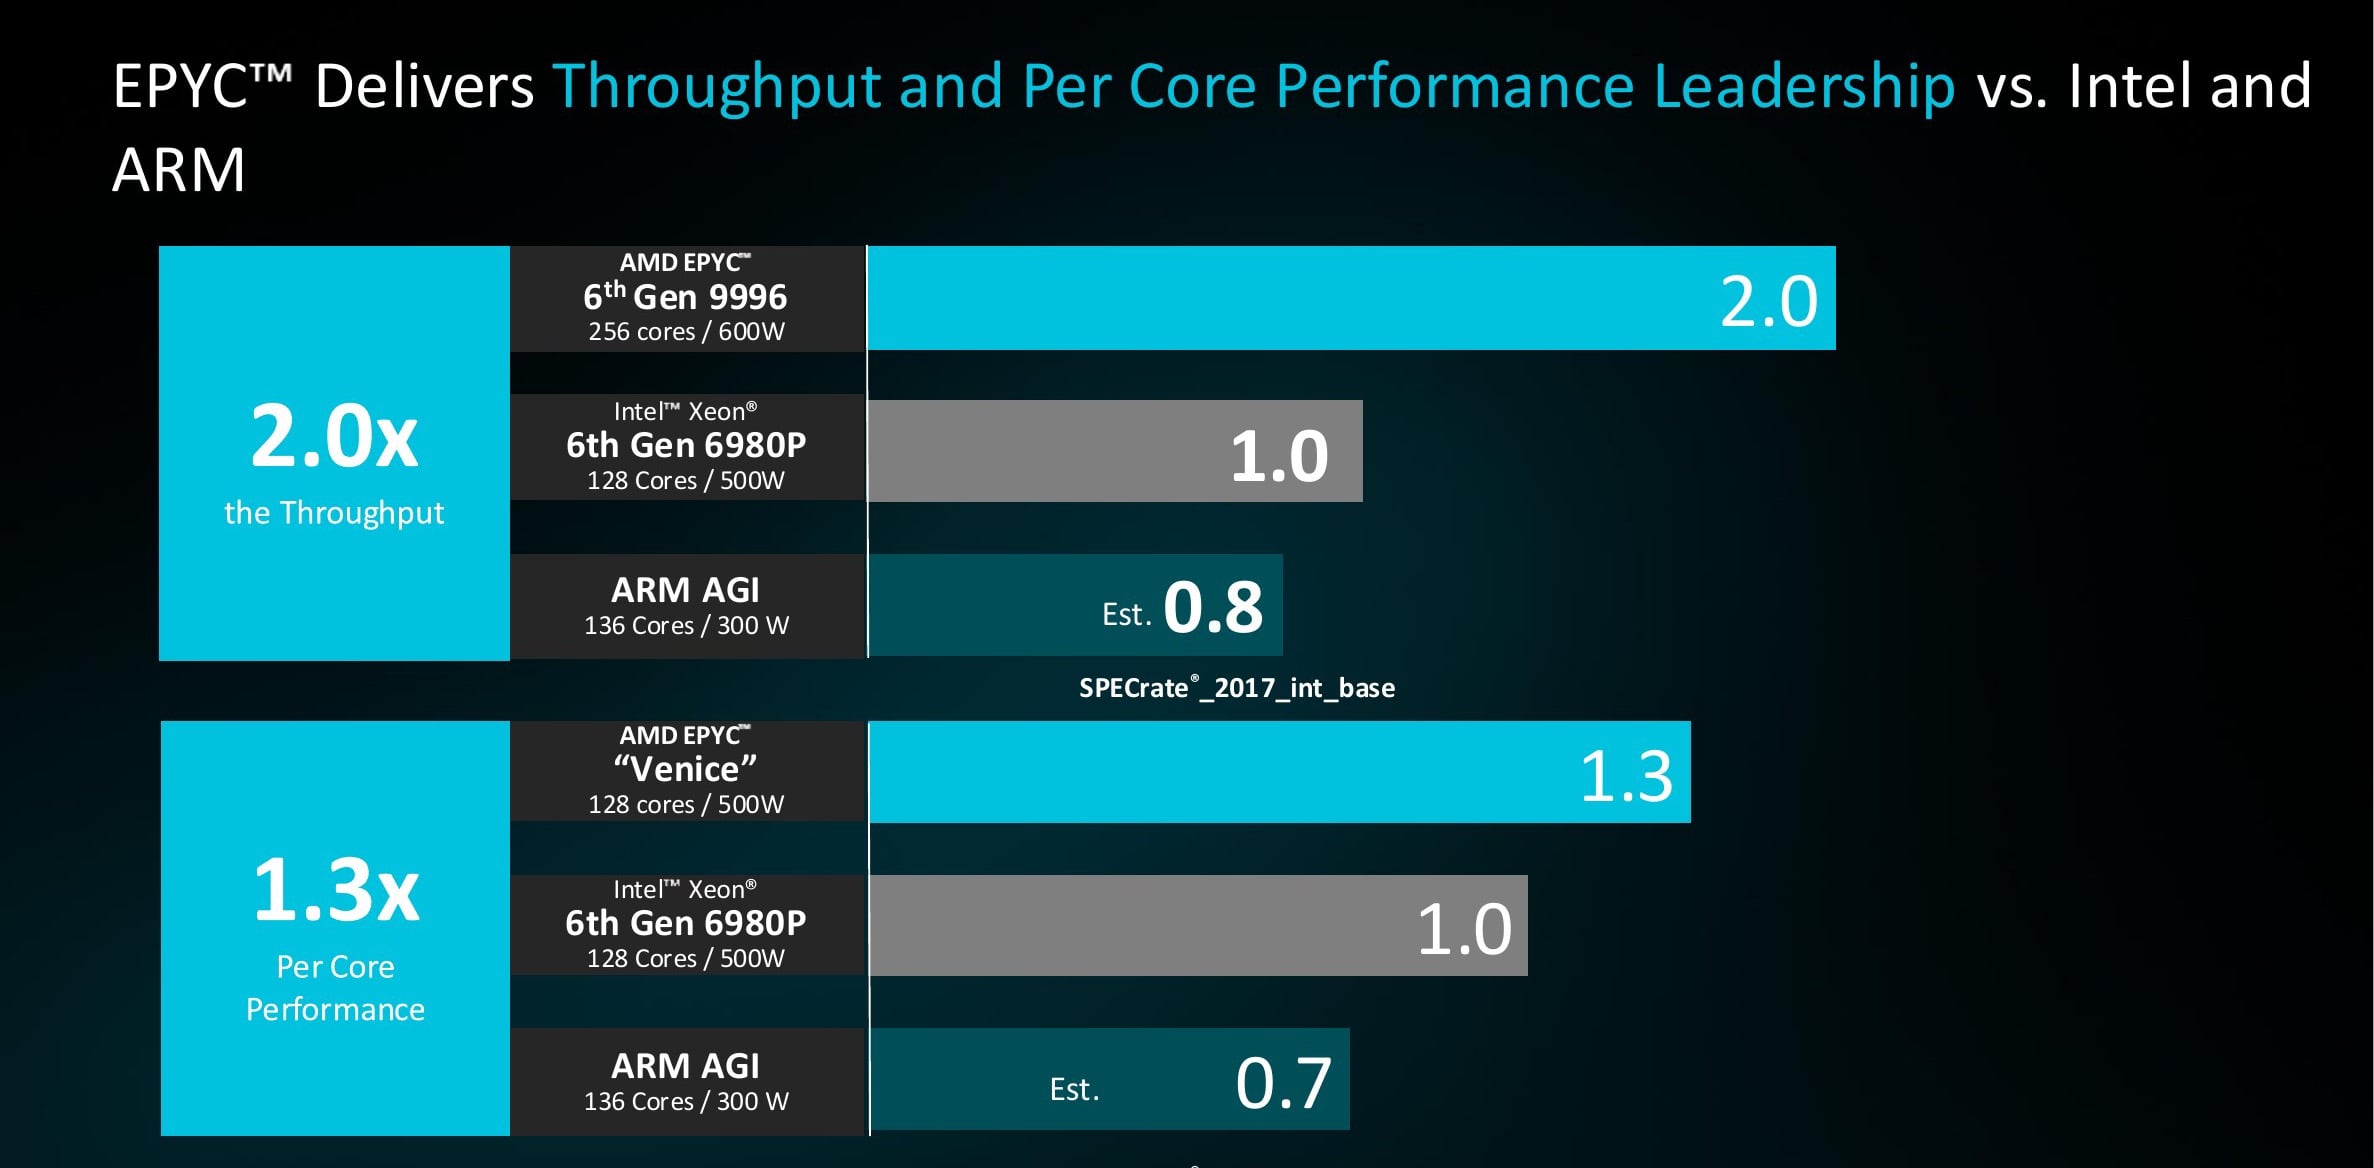
AMD presenteerde ook een bredere SPECrate 2017-ranking. Venice 9996 voert de lijst aan met 4900 punten (256 cores, 600W, $ 14,904 bij 1Ku), gevolgd door Turin 9965 met 3240 punten, Intel's Xeon 6980P met 2510 punten (128 cores, 500W, $ 13,955), Arm AGI met 1944 punten (136 cores, 300W) en Vera met 1459 punten. De cijfers voor 9996, AGI en Vera zijn schattingen van AMD; de scores voor Turin en Intel zijn gepubliceerde resultaten. In vergelijking met Intel komt dat neer op ongeveer twee keer de doorvoer bij een vergelijkbare prijs, of twee keer de prestaties per dollar. Per core scoort een Venice-configuratie met 128 cores en 500W 1.3 keer zo goed als de 6980P, terwijl Arm AGI 0.7 keer zo goed presteert. In tegenstelling tot de bovenstaande Vera-vergelijking, is de score van elke leverancier hier berekend met zijn eigen beste toolchain: AOCC voor AMD, OneAPI voor Intel en GCC 13 voor Arm.
Cloud native en HPC
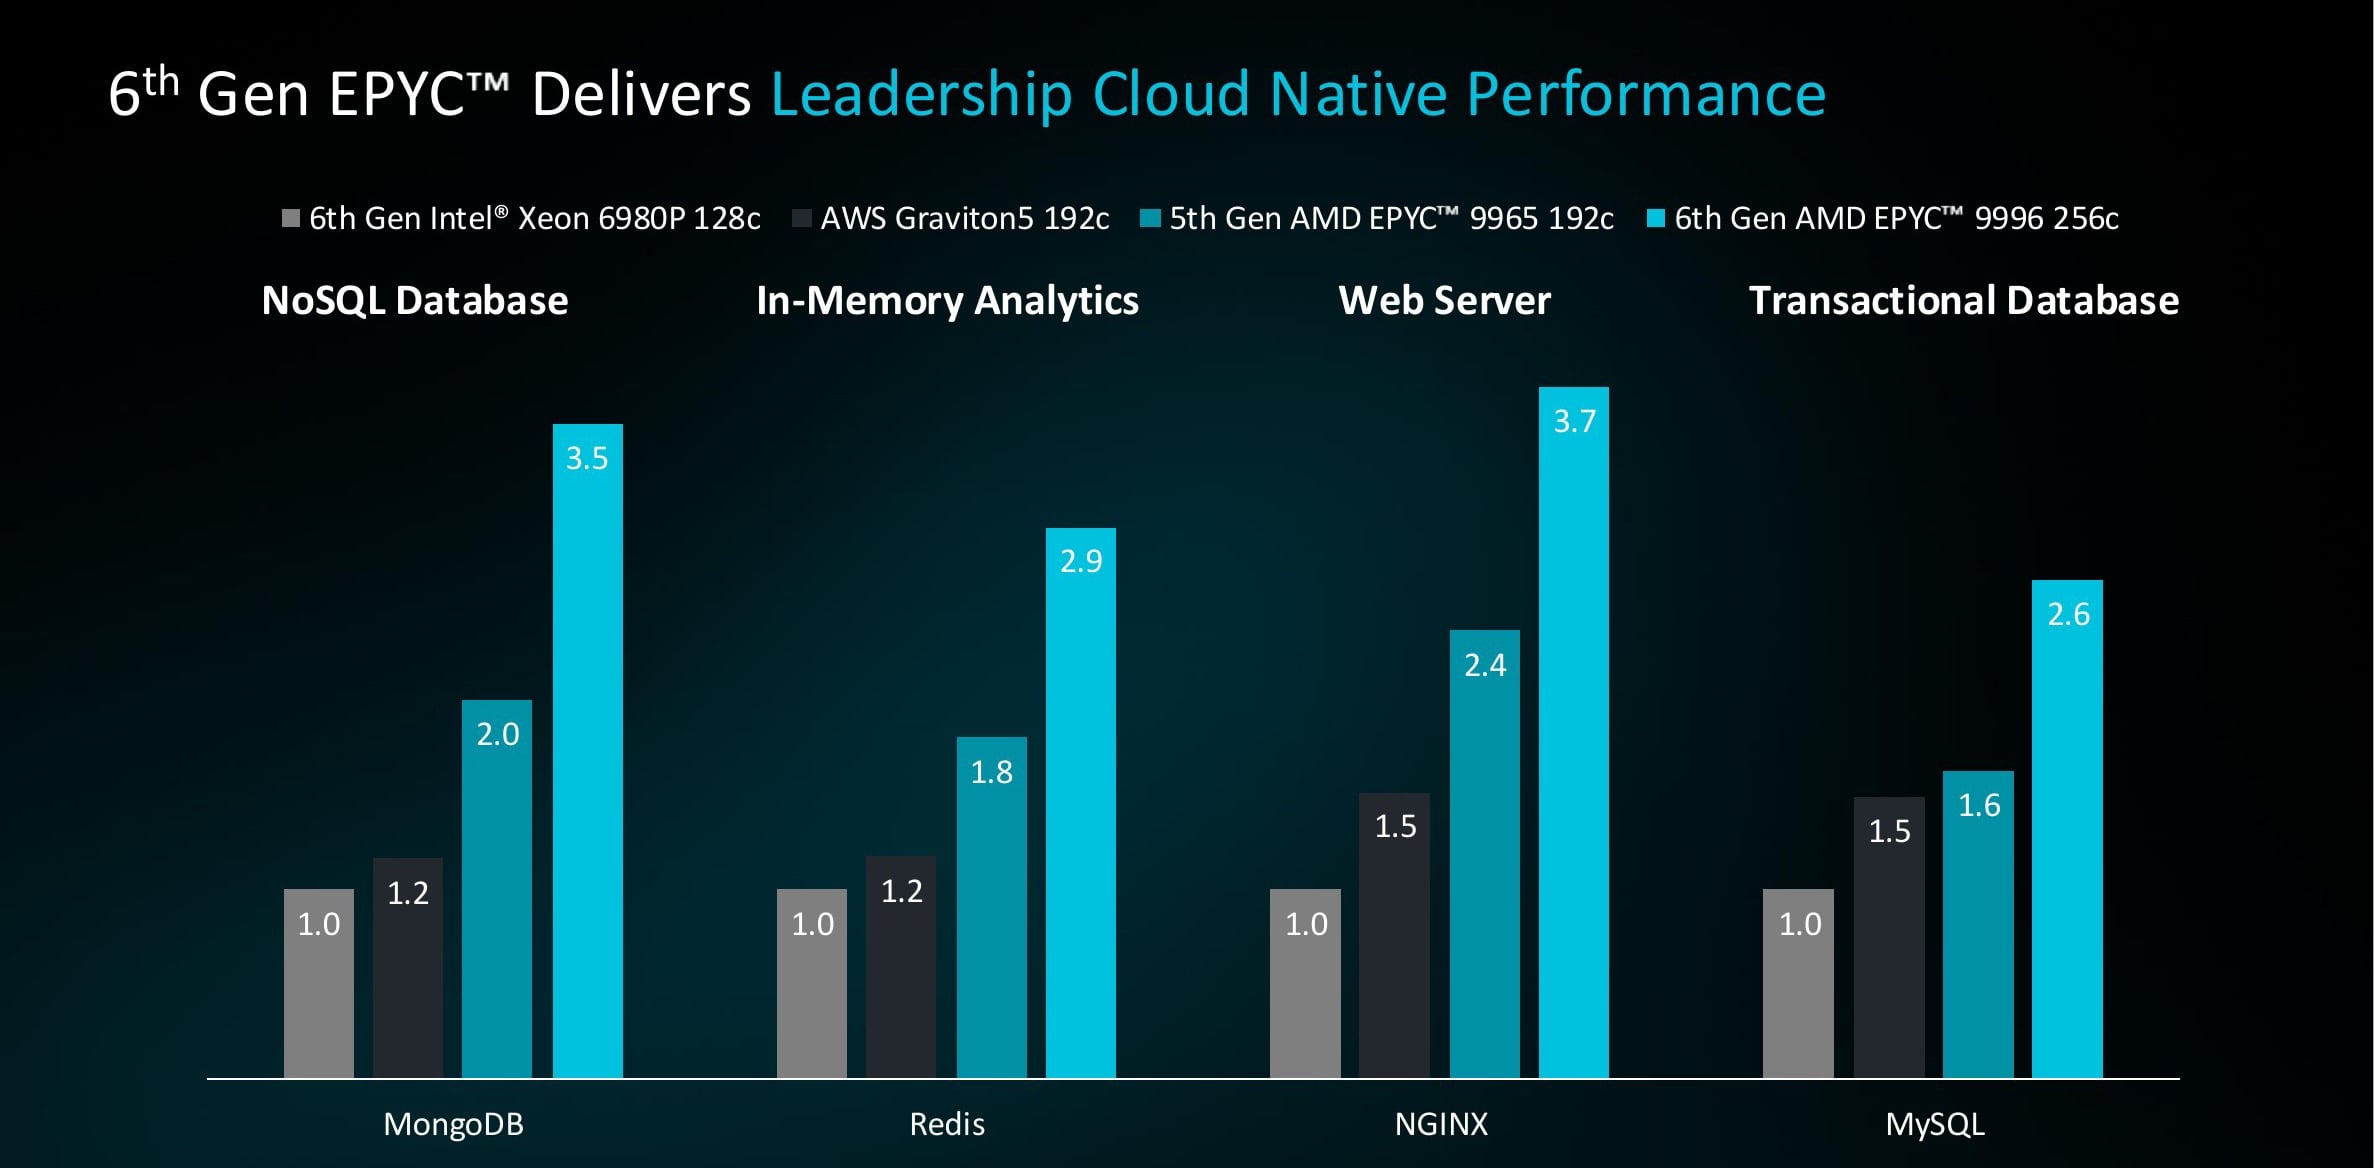
AMD heeft de vergelijking ook uitgesplitst per workload, waarbij elk resultaat is geïndexeerd ten opzichte van Intels 6980P met een waarde van 1.0. Wat betreft cloud-native prestaties behaalt de Venice 9996 met 256 cores 3.5x sneller op MongoDB, 2.9x sneller op Redis, 3.7x sneller op NGINX en 2.6x sneller op MySQL. Turin scoort tussen de 1.6x en 2.4x sneller in dezelfde tests, en Graviton5 tussen de 1.2x en 1.5x sneller.
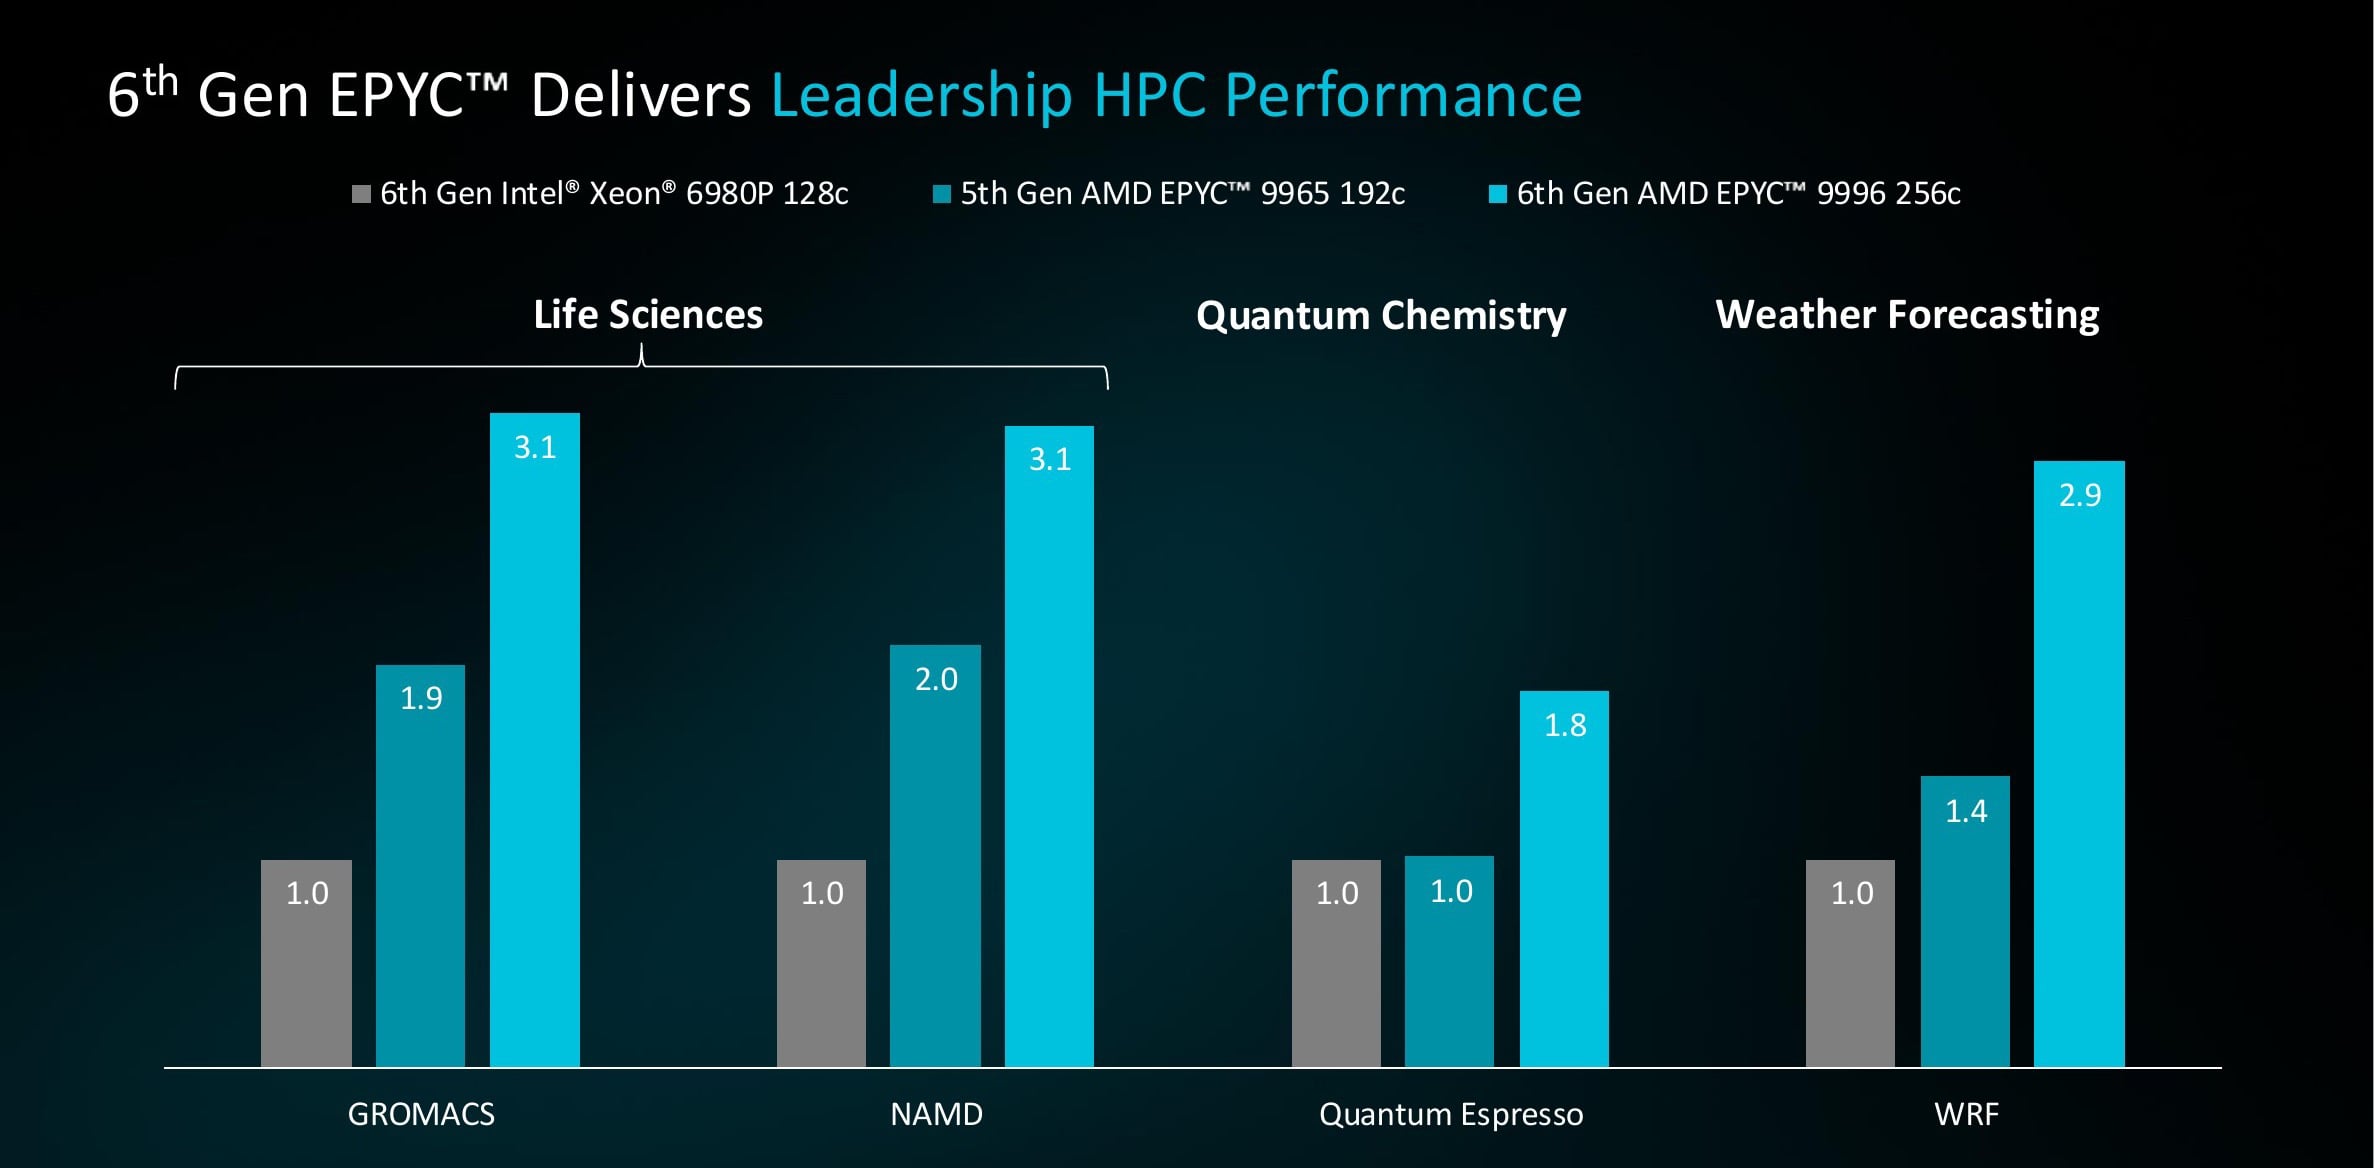
In HPC-tests behaalt Venice een score van 3.1x op GROMACS en NAMD, 2.9x op WRF en 1.8x op Quantum Espresso. De geheugenconfiguratie heeft een aanzienlijke invloed op deze cijfers. Met standaard 8,000 MT/s RDIMM's behaalt Venice een score van 2.81x ten opzichte van de Xeon-baseline op GROMACS; 12,800 MT/s MRDIMM's verhogen dit naar 3.13x, en dezelfde upgrade brengt de WRF-score van 2.25x naar 2.90x. AMD vat zijn voorsprong in HPC samen als 1.8x tot 3.5x, afhankelijk van de workload en het geheugen. De Intel-baseline draaide op 8,800 MT/s MRDIMM's, dus het verschil komt niet voort uit het combineren van geüpgraded AMD-geheugen met een trage Intel-configuratie.
Het hostknooppunt en de 1.8× claim
Dit brengt ons terug bij de bewering over 1.8 tokens per seconde. De hardwareverbeteringen die hieraan ten grondslag liggen, zijn gemakkelijk op te sommen: de 5 GHz-hostprocessor heeft nu 96 cores in plaats van 64, de bandbreedte van het hostgeheugen stijgt van 614 GB/s naar 1.6 TB/s, en PCIe Gen 6 verdubbelt de bandbreedte van de verbinding tussen de CPU en de GPU.
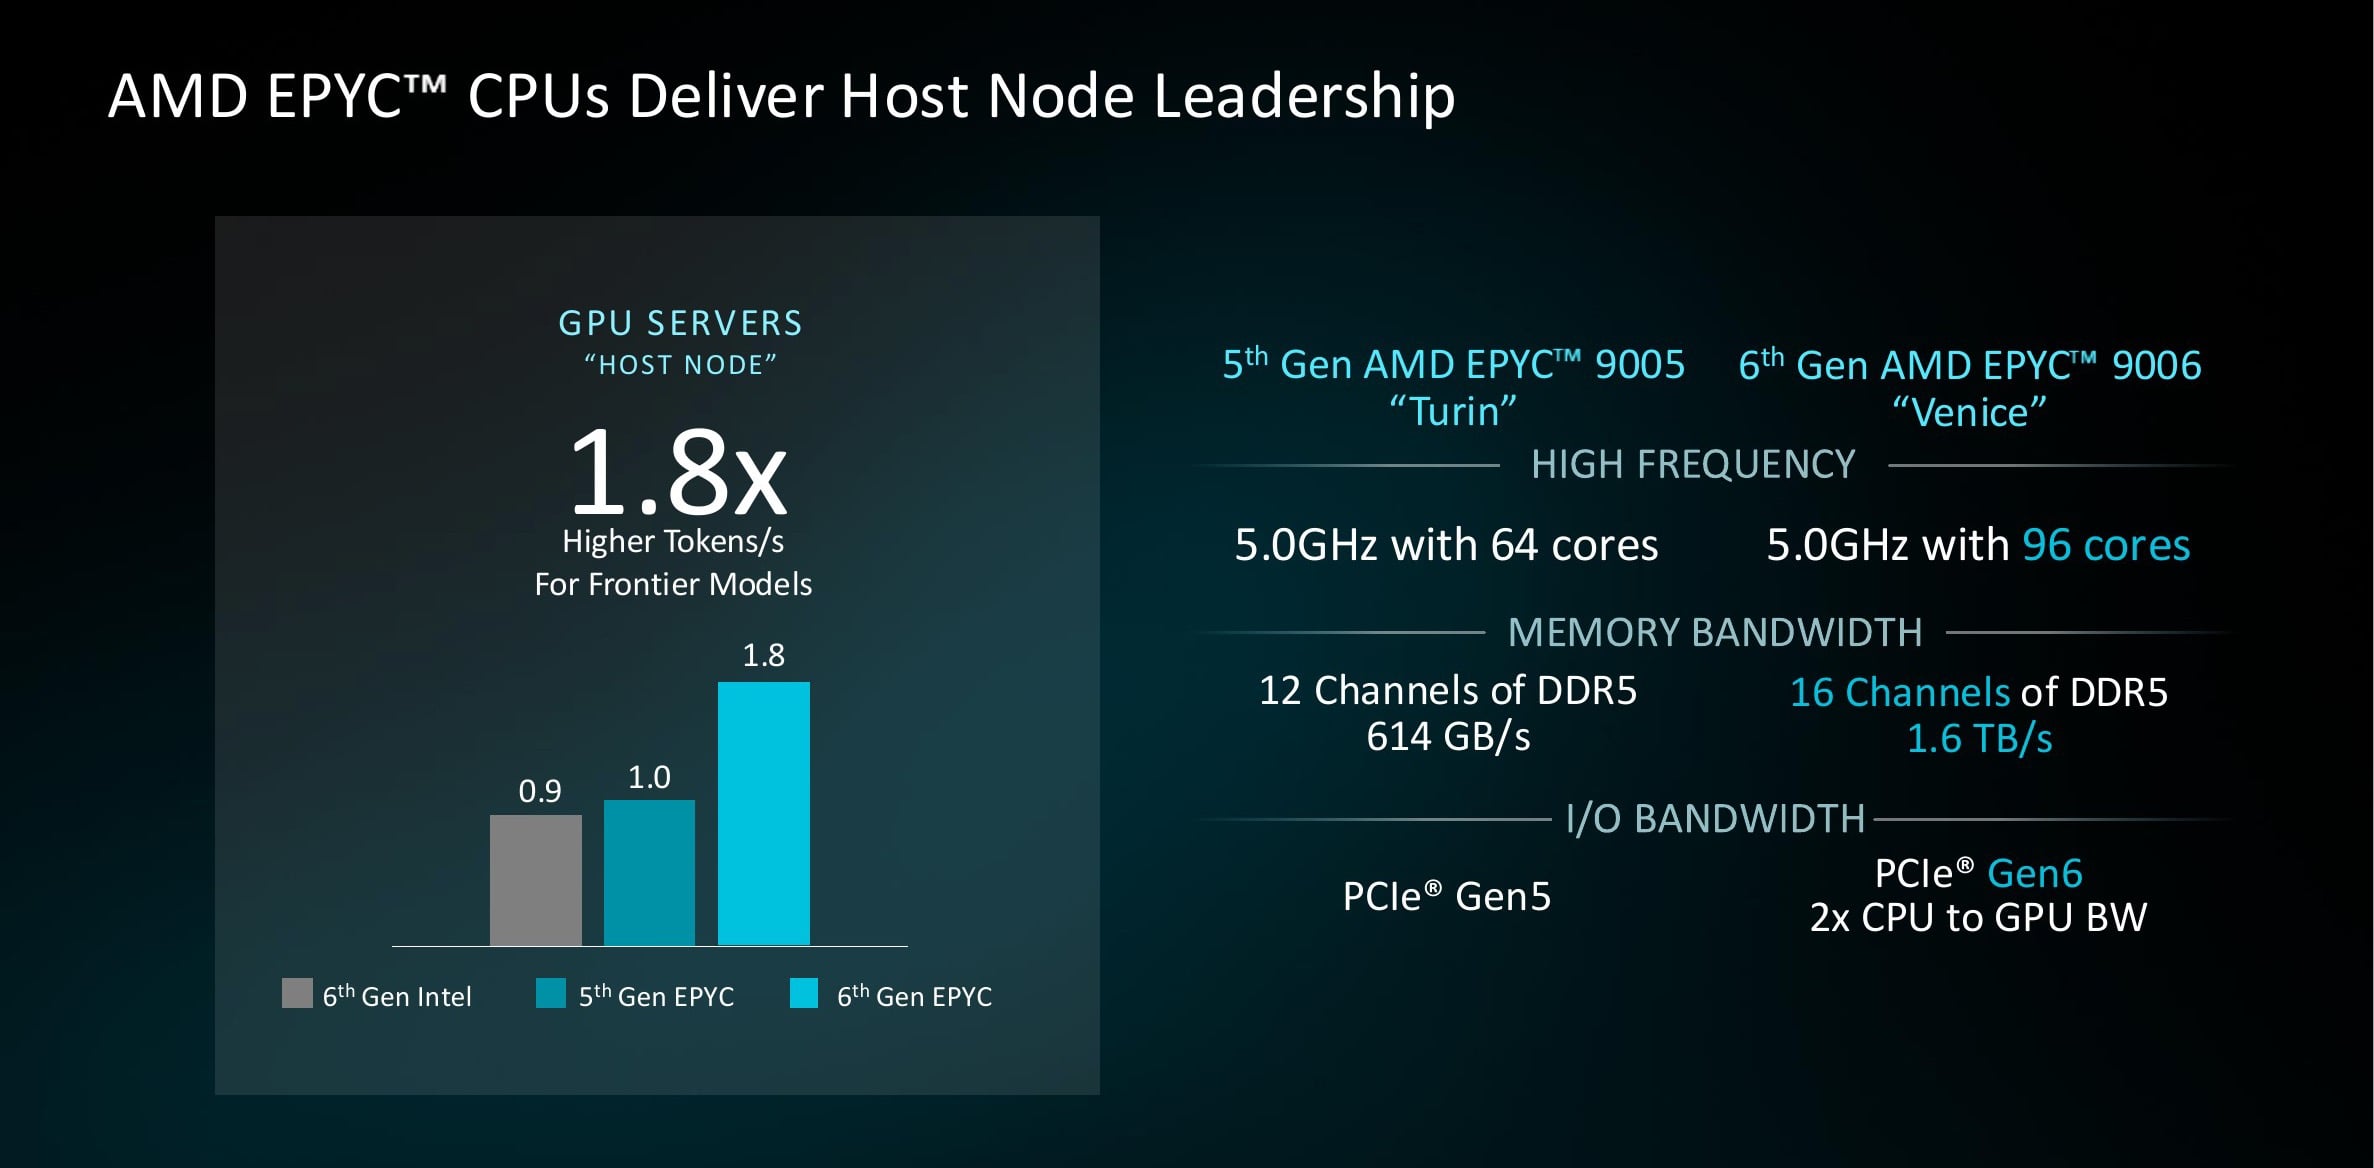
Het eerste wat we moeten controleren, is de basislijn. AMD heeft deze grafiek geïndexeerd met Turin op 1.0 in plaats van Intel, en de 6e generatie Xeon op 0.9 geplaatst. Daarom komt dezelfde bewering van bijna 2x overeen met de Xeon 6960P. De verwachte winst komt bijna volledig voort uit de I/O-bandbreedte. AMD voerde een CPU-offloadtest uit waarbij de BF16-gewichten van de Qwen3-30B vanuit het hostgeheugen naar de GPU werden gestreamd. Hieruit bleek dat het PCIe Gen 5 x16-ontvangstpad op 89% tot 95% van zijn theoretische maximum draaide, terwijl de DRAM-leesbewerkingen van de host onder de 10% van hun theoretische maximum bleven. De decodeersnelheid werd beperkt door de overdracht, dus het verdubbelen van de verbinding met PCIe Gen 6 levert een verbetering van 1.8x tot 1.9x op in deze test. Venice is momenteel de enige server-CPU die PCIe Gen 6 aan accelerators biedt, dus het voordeel is reëel en, voorlopig, exclusief. De reikwijdte is echter beperkt: de 1.8X beschrijft één bandbreedte-gebonden offloadpatroon en moet niet worden opgevat als een belofte dat GPU's elk model 1.8X sneller bedienen op Venice-hosts. In de hardware die momenteel op de markt is, verslaat een Turin-host een Xeon 6960P met een geometrisch gemiddelde van 13% in de tijd tot het eerste token bij vLLM- en NIM-workloads op hetzelfde 8X B200-systeem, met een maximale verbetering van 36%.
Rekdichtheid
De laatste bewering betreft de dichtheid: 49,152 Venetiaanse kernen in een rek, tegenover 36,864 voor Turijn en 22,528 voor Vera, waarbij elk deel twee keer zoveel draden als kernen bevat. Van alle beweringen in het kaartspel verandert deze het meest zodra de voetnoten worden toegevoegd.
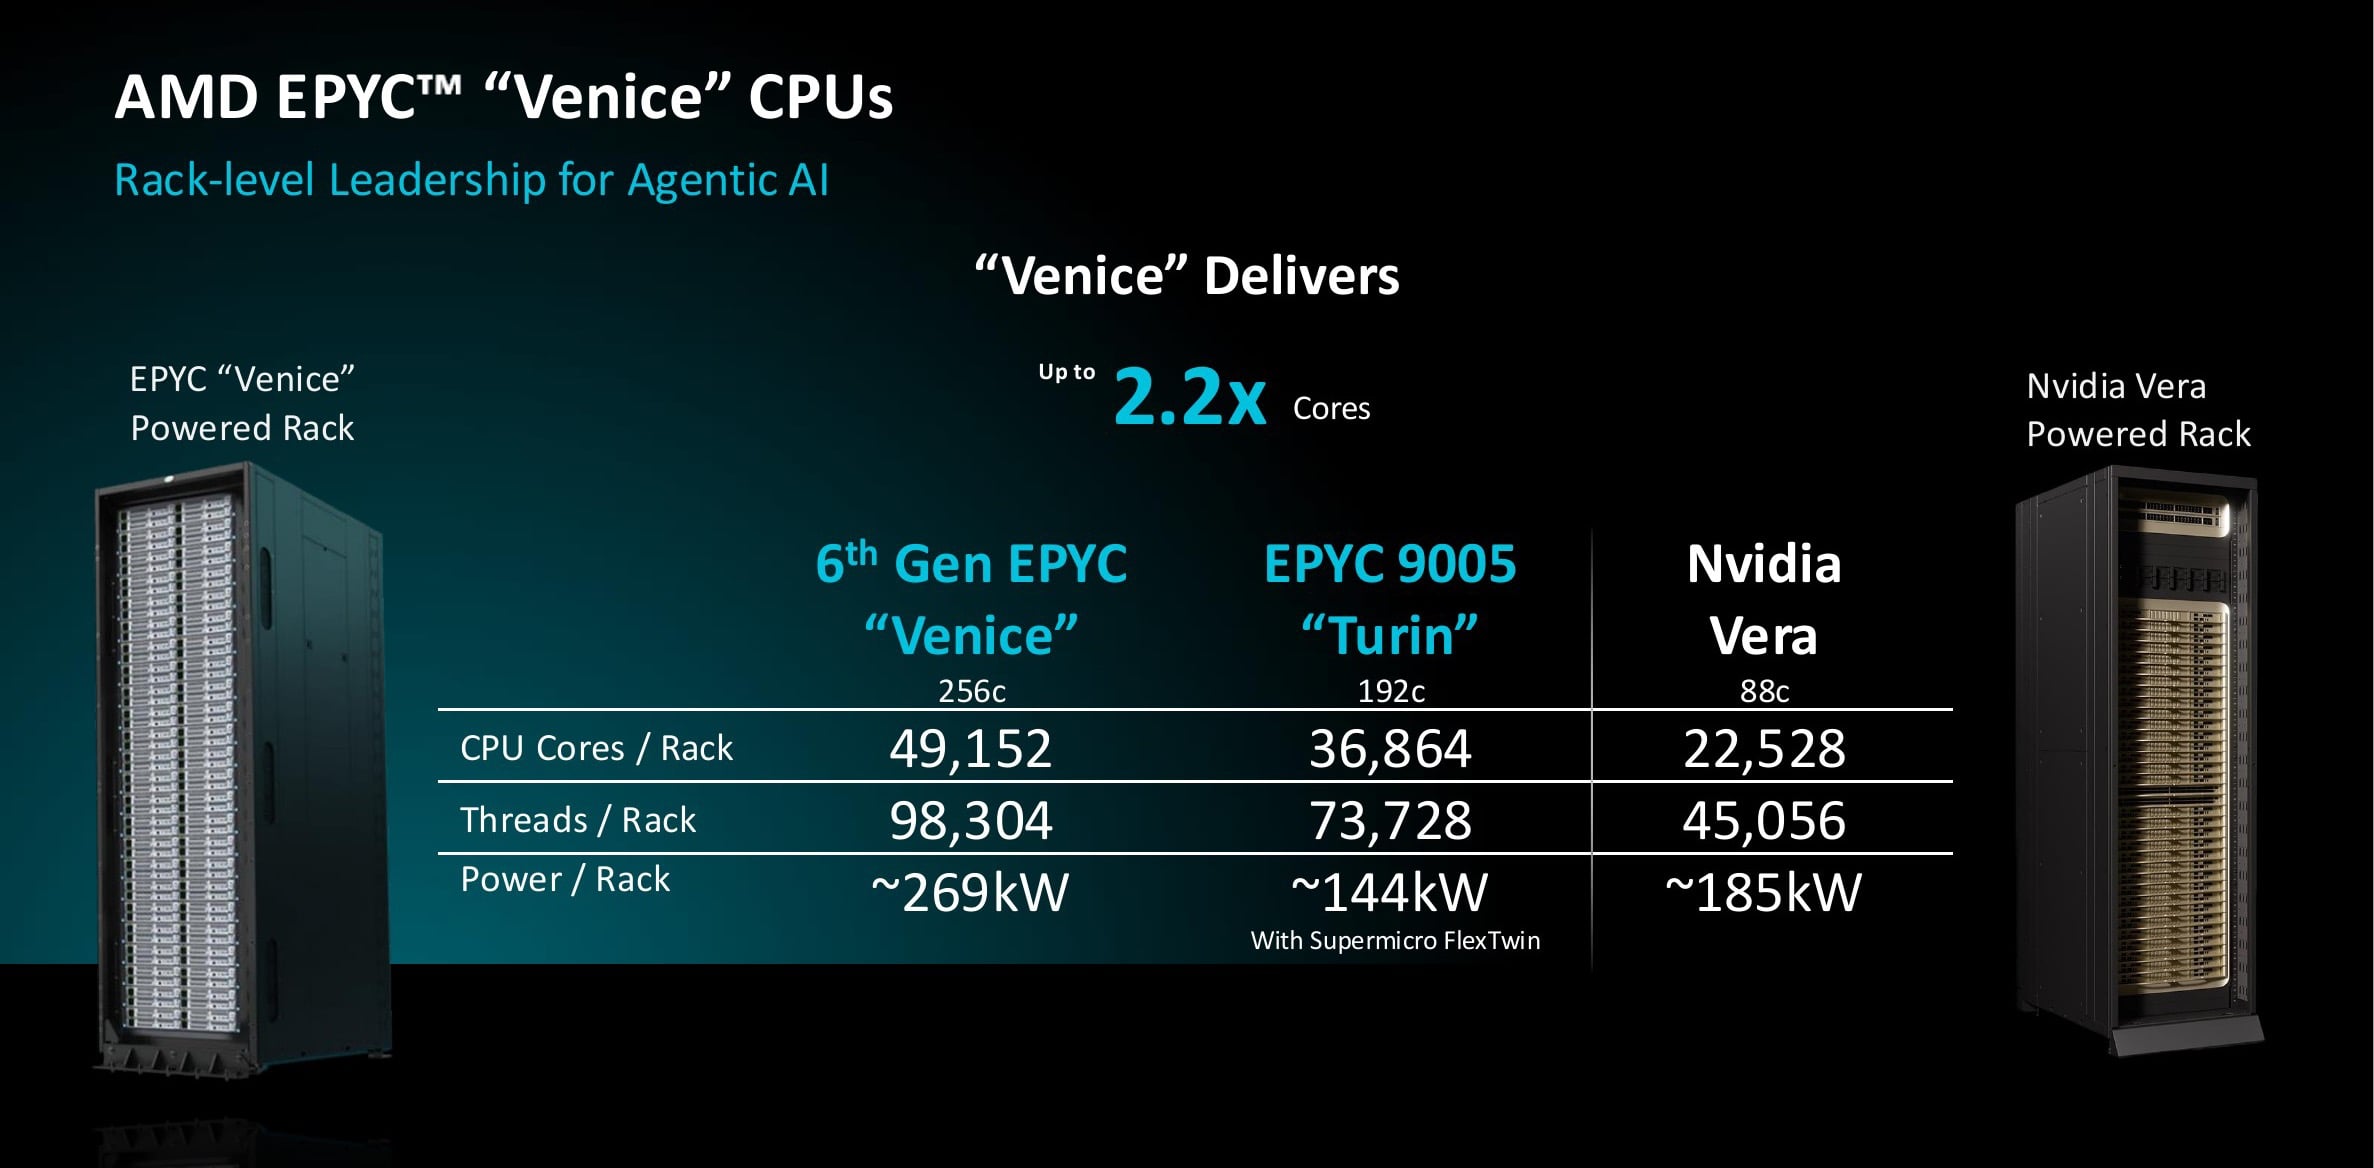
De koptekst vermeldt 2.2 keer zoveel cores als de Vera, maar het Venice-rack bereikt dit met een stroomverbruik van 269 kW, vergeleken met de 185 kW van de Vera. De twee racks worden dus niet vergeleken bij een gelijk stroomverbruik. De voetnoten van AMD geven genormaliseerde waarden weer. Met beide racks beperkt tot een stroomverbruik van 100 kW, levert de 9996 2.08 keer zoveel cores als de Vera, 1.86 keer zoveel als de Turin en 1.24 keer zoveel als de Intel 6980P. Door de 400W EPYC 9956 te gebruiken in plaats van het vlaggenschip, schat AMD dat de Vera 1.91 keer zoveel cores levert bij 26% minder stroomverbruik, wat resulteert in 2.57 keer zoveel cores per rackwatt. Afhankelijk van het vastgestelde stroombudget ligt de voorsprong tussen 1.9 en 2.2 keer. Net als bij alle Vera-cijfers in dit artikel is het NVIDIA-rack gebaseerd op gepubliceerde specificaties in plaats van op gemeten hardware. Het dichtheidsvoordeel blijft behouden na normalisatie; het is simpelweg kleiner dan de koptekst van 2.2X.
De grote pestkop
Los van de individuele beweringen: aan de top van de server-CPU-markt heeft AMD momenteel geen directe concurrent. Intels beste processor blijft achter bij de Turin-generatie, die AMD al aan het vervangen is. De Arm-concurrenten staan op alle door AMD getoonde grafieken onder de Turin-generatie. Vera is nog niet op de markt en AMD schat de doorvoersnelheid op minder dan de helft van die van een Turin 9965, die al anderhalf jaar verkrijgbaar is. Venice verdubbelt de doorvoersnelheid van Turin nog eens. Deze positie heeft AMD volgens Mercury Research een marktaandeel van 46% in de server-CPU-markt opgeleverd. De marktgegevens wijzen in dezelfde richting. De vraag naar hoogwaardige EPYC-processors is momenteel groter dan het aanbod, waardoor de levertijden langer zijn geworden.
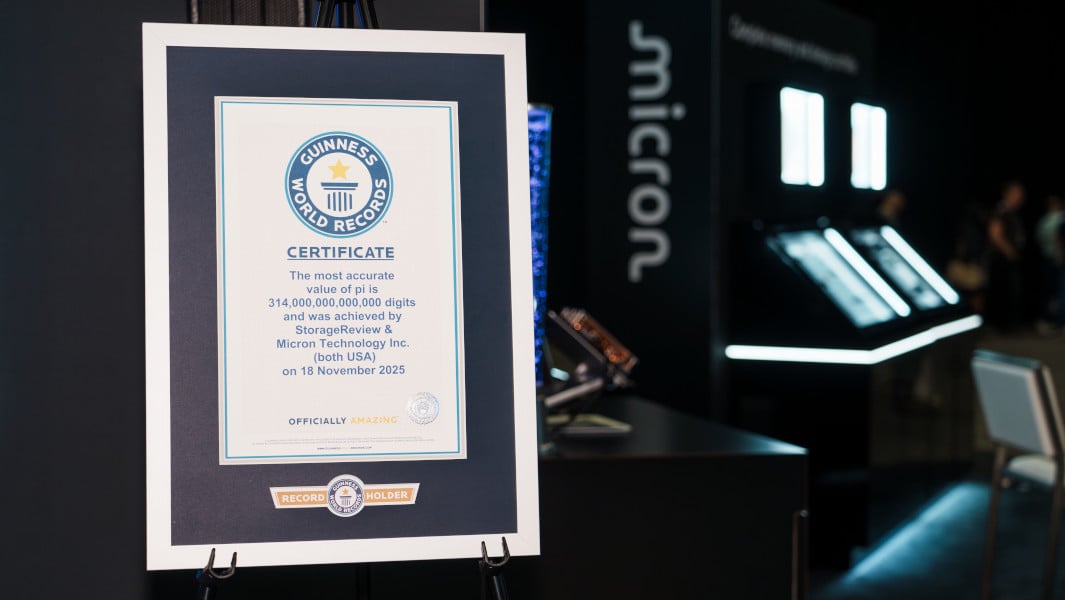
We kunnen hier ons eigen datapunt aan toevoegen. Ons wereldrecord voor Pi van 314 biljoen cijfers draaide op een Dell PowerEdge R7725 met twee 192-core EPYC 9965-processors en 1.5 TB DDR5-geheugen, dezelfde 384-core 2P-configuratie die AMD gebruikt voor zijn racks in Turijn. De berekening hield elke core 110 dagen lang volledig belast en werd zonder een seconde downtime voltooid; een enkele geheugenfout of crash zou de poging hebben gedwarsboomd. Het gemiddelde stroomverbruik bedroeg ongeveer 1,600 W en de volledige run verbruikte 4,305 kWh, oftewel 13.7 kWh per biljoen cijfers, tegenover een geschat verbruik van 33,600 kWh over ongeveer 225 dagen voor het vorige record van 300 biljoen cijfers.
Conclusie
Venice is de krachtigste server-CPU-lancering die AMD ooit heeft gehad, en de echte kracht ervan ligt in de breedte. Eén generatie Zen 6 omvat alles van een processor met 256 cores via een enterprise-socket en een HPC-chip met 1152 MB stacked cache tot een LPDDR-hostnode. Hierdoor kan een klant elke laag van een datacenter op dezelfde architectuur en softwarebasis bouwen. De cijfers die de lancering onderbouwen, blijken ook na het lezen van de details: ongeveer het dubbele van Intels doorvoer bij een vergelijkbare prijs, een voorsprong van 20% per core ten opzichte van Vera met een vergelijkbare compiler, en een rackdichtheid tussen 1.9 en 2.2 keer die van NVIDIA's host-CPU, afhankelijk van het stroomverbruik.
Het commerciële aspect van het verhaal behoeft geen voorspellingen. SP7 is nu in productie, met partnerplatformen die in het vierde kwartaal worden verwacht; SP8 volgt in de eerste helft van 2027, met Venice-X en Verano daarachter. Het bedrijf dat ze verkoopt, boekt al 46% van de omzet in server-CPU's, en de vraag naar de huidige onderdelen overtreft het aanbod ruimschoots, waardoor kopers liever in de rij staan dan overstappen naar een ander merk. Venice zou een jaar later kunnen verschijnen, en de vergelijkingen in dit artikel zouden nog steeds een teken van leiderschap zijn, omdat Turin al beter presteert dan alle andere bedrijven in de grafiek, ongeacht of de producten al geleverd zijn of niet. AMD loopt zo ver vooruit dat de dichtstbijzijnde concurrent, voorlopig, de eigen vorige generatie is.


 Amazon