

AMD heeft de Instinct MI350P aangekondigd, een PCIe-accelerator gericht op bedrijven die AI-inferentie lokaal willen uitvoeren zonder hun datacenter te hoeven verbouwen. De kaart is een dual-slot, full-height en full-length ontwerp, geschikt voor standaard luchtgekoelde servers. Het is bovendien de eerste keer in bijna vier jaar dat AMD een Instinct-chip van de huidige generatie in een formaat heeft geplaatst dat in een normale server past.
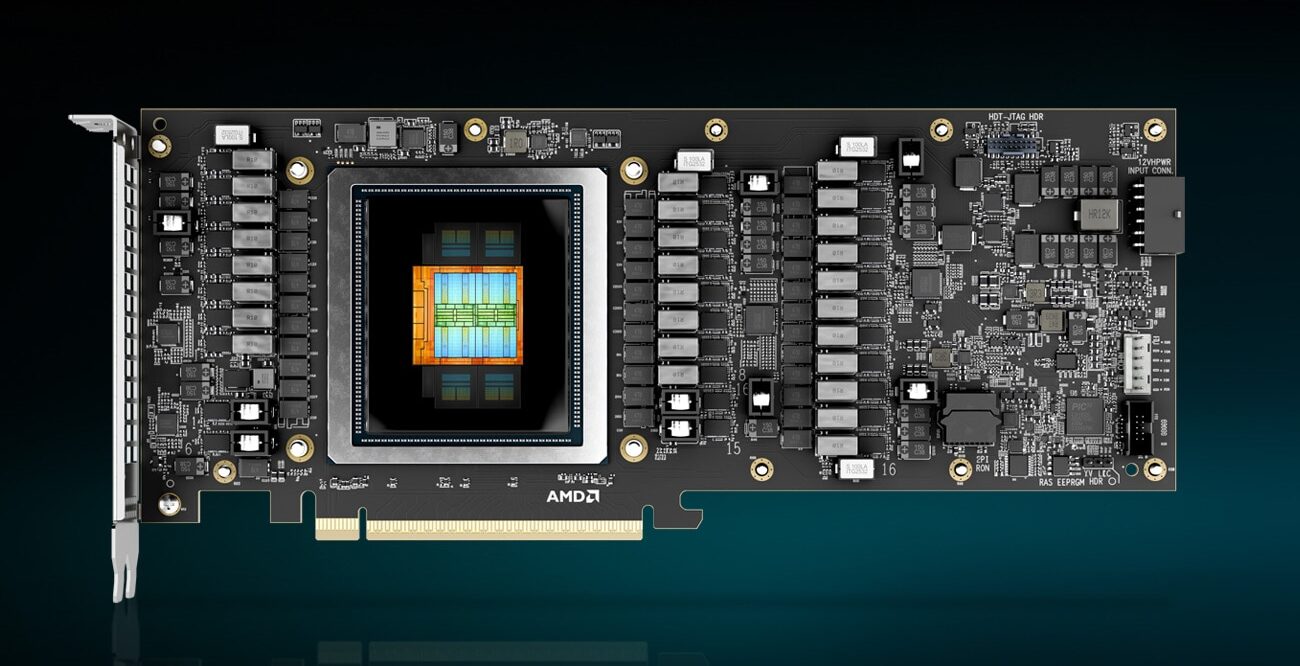
De PCIe Instinct-lijn was na de release van de MI210 begin 2022 vrijwel stilgevallen. Elke generatie sindsdien (MI300X, MI325X en de OAM MI350X) is een OAM-module op een universeel basisbord, waarvoor een speciaal ontworpen chassis nodig is met de stroomvoorziening en luchtstroom voor acht 1,000W-acceleratoren in één tray. Dat werkt voor hyperscalers die GPU's per rack kopen. Het werkt echter niet voor een bedrijf dat on-premise inferentie wil, maar geen eigen AI-rack kan of wil aanschaffen. De MI350P vult dat gat op en op dit moment heeft NVIDIA geen vlaggenschip-server PCIe-kaart in dezelfde klasse, dus AMD heeft dit segment voorlopig voor zichzelf.
Hardware: MI350P versus MI350X OAM
De MI350P is geen uitgekiende MI350X. AMD heeft er een kleinere chip voor ontworpen. De MI350X heeft twee I/O-dies, elk met vier accelerator complex dies (XCD's), voor een totaal van acht XCD's en 256 compute units. De MI350P heeft één I/O-die met vier XCD's en 128 compute units, de helft van de siliciumoppervlakte, en draait op dezelfde piekklokfrequentie van 2.2 GHz als zijn grotere broer. Het geheugen volgt hetzelfde patroon. Vier HBM3E-stacks in plaats van acht. Een 4,096-bits bus in plaats van een 8,192-bits bus. 144 GB met een bandbreedte van 4 TB/s in plaats van 288 GB met een bandbreedte van 8 TB/s.
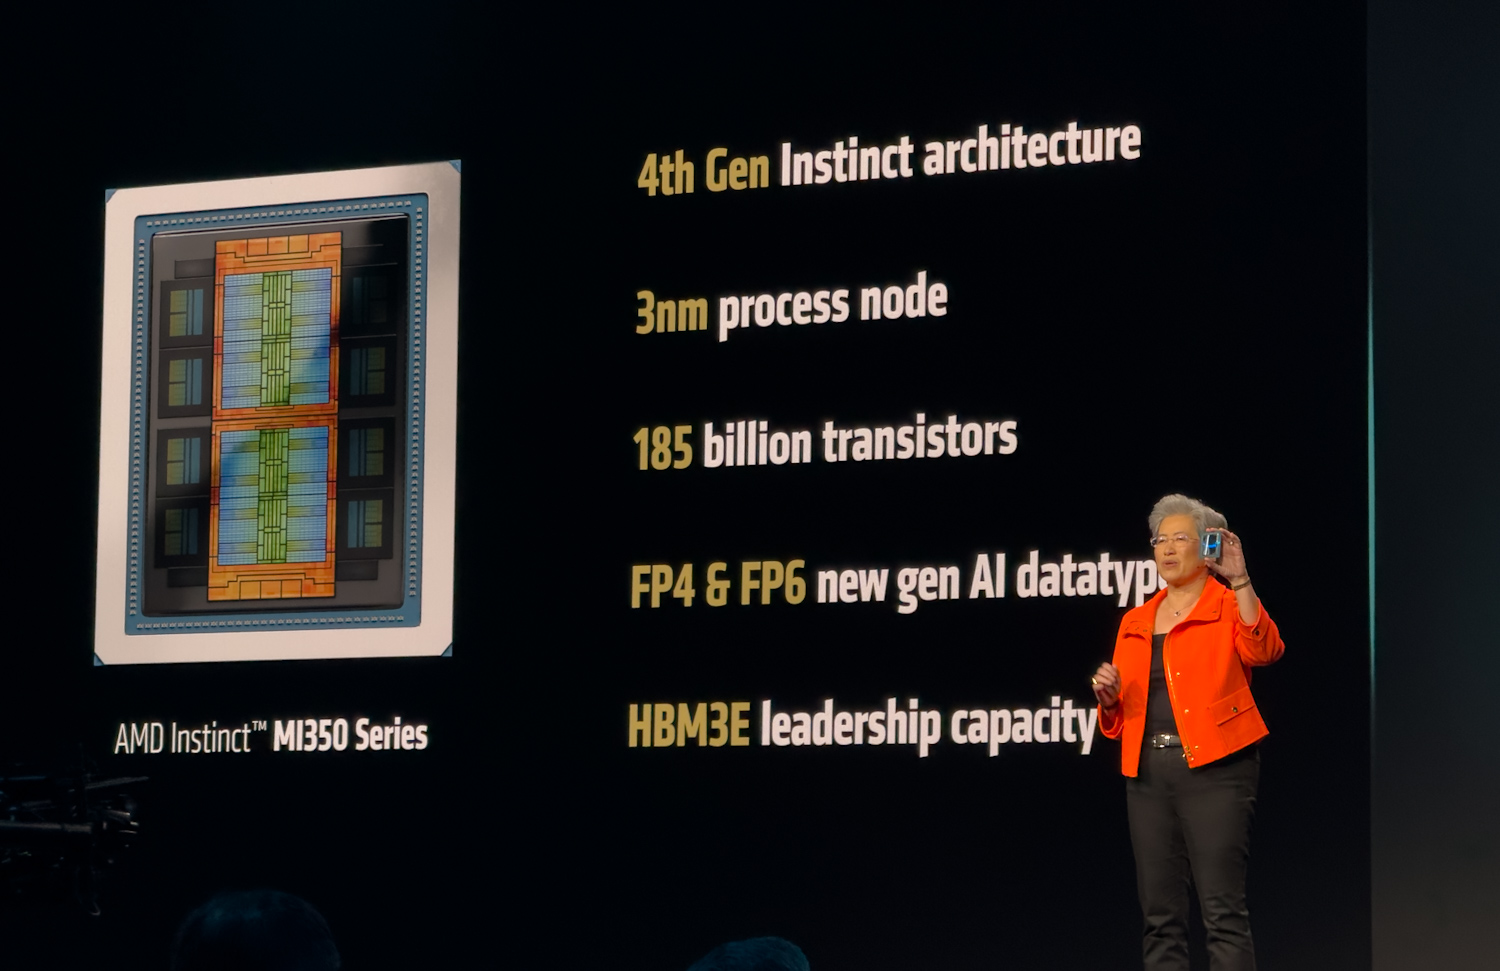
De piekprestaties halveren ook. De MI350P haalt maximaal 4,600 TFLOPS bij MXFP4, tegenover 9.2 PFLOPS voor de MI350X, en 2,300 TFLOPS bij FP8, tegenover 4.6 PFLOPS. BF16, FP16 en de rest van de precisiestack schalen op dezelfde manier. Het is verfrissend om te zien dat AMD naast de piekprestaties ook de daadwerkelijk geleverde cijfers publiceert. De geleverde cijfers zijn 2,299 TFLOPS bij MXFP4, 1,529 TFLOPS bij FP8 en 713 TFLOPS bij BF16. Deze cijfers weerspiegelen wat de kaart daadwerkelijk kan doen binnen een stroomverbruik van 600W, waar de beperkingen van de elektrische stroomvoorziening en de geheugenbandbreedte de theoretische piekprestaties beperken.
We hebben het MI350X-platform via Supermicro's Jumpstart-programma bekeken en waren oprecht onder de indruk van de prestaties bij inferentieworkloads. We kunnen niet wachten om de MI350P te testen en te zien hoe de PCIe-variant presteert in de meer conventionele serverbehuizing waarvoor deze is ontworpen.
| AMD Instinct MI350P PCIe-kaart | ||
|---|---|---|
| Specificaties | Geleverd (FLOPS) | Piek (TFLOPS) |
| Prestaties | ||
| BF16 | 713 | 1150 |
| FP16 | 672 | 1150 |
| FP8 | 1529 | 2300 |
| MXFP8 | 1327 | 2300 |
| MXFP6 | 1804 | 4600 |
| MXFP4 | 2299 | 4600 |
| Geheugen en partitionering | ||
| Geheugencapaciteit | 144 GB HBM3E | 144 GB HBM3E |
| Geheugen BW | 3.6 TB / s | 4.0 TB / s |
| GPU-instanties | Maximaal 4 stuks van elk 36 GB | Maximaal 4 stuks van elk 36 GB |
| Platform | ||
| Video- en JPEG-decodering | ||
| GPU-schaalversterkingsinterconnectie | Niet ondersteund | Niet ondersteund |
| Product FF | FHFL dual-slot luchtgekoeld | FHFL dual-slot luchtgekoeld |
| Maximaal totaal stroomverbruik van de printplaat (TBP) | 600W (450W instelbaar) |
600W (450W instelbaar) |
| PCIe-host | x16 PCIe Gen 5 met 128 GB/s | x16 PCIe Gen 5 met 128 GB/s |
Het stroomverbruik is niet helemaal gehalveerd. De MI350P heeft een TBP-vermogen van 600W, ongeveer 60% van de 1,000W van de MI350X. 600W is het maximum dat is vastgesteld door de PCIe CEM-specificatie, dus de kaart wordt zo warm als het slot toelaat. Er is een 450W-modus beschikbaar voor behuizingen die niet het volledige vermogen of de koeling kunnen leveren, waarbij de prestaties wel iets minder zijn. Met een vermogen van 600W valt de MI350P ook in dezelfde categorie als NVIDIA's H200 NVL en de RTX Pro 6000 Server, waarmee hij in dit segment zal concurreren.
In tegenstelling tot NVIDIA's NVL4-aanbod met de H200, stelt AMD de Infinity Fabric-verbindingen van de GPU niet beschikbaar op de MI350P; alle gezamenlijke communicatie verloopt via de PCIe Gen5 x16-verbinding (128 GB/s).
Het verhaal van de luchtgekoelde acht-GPU-processor
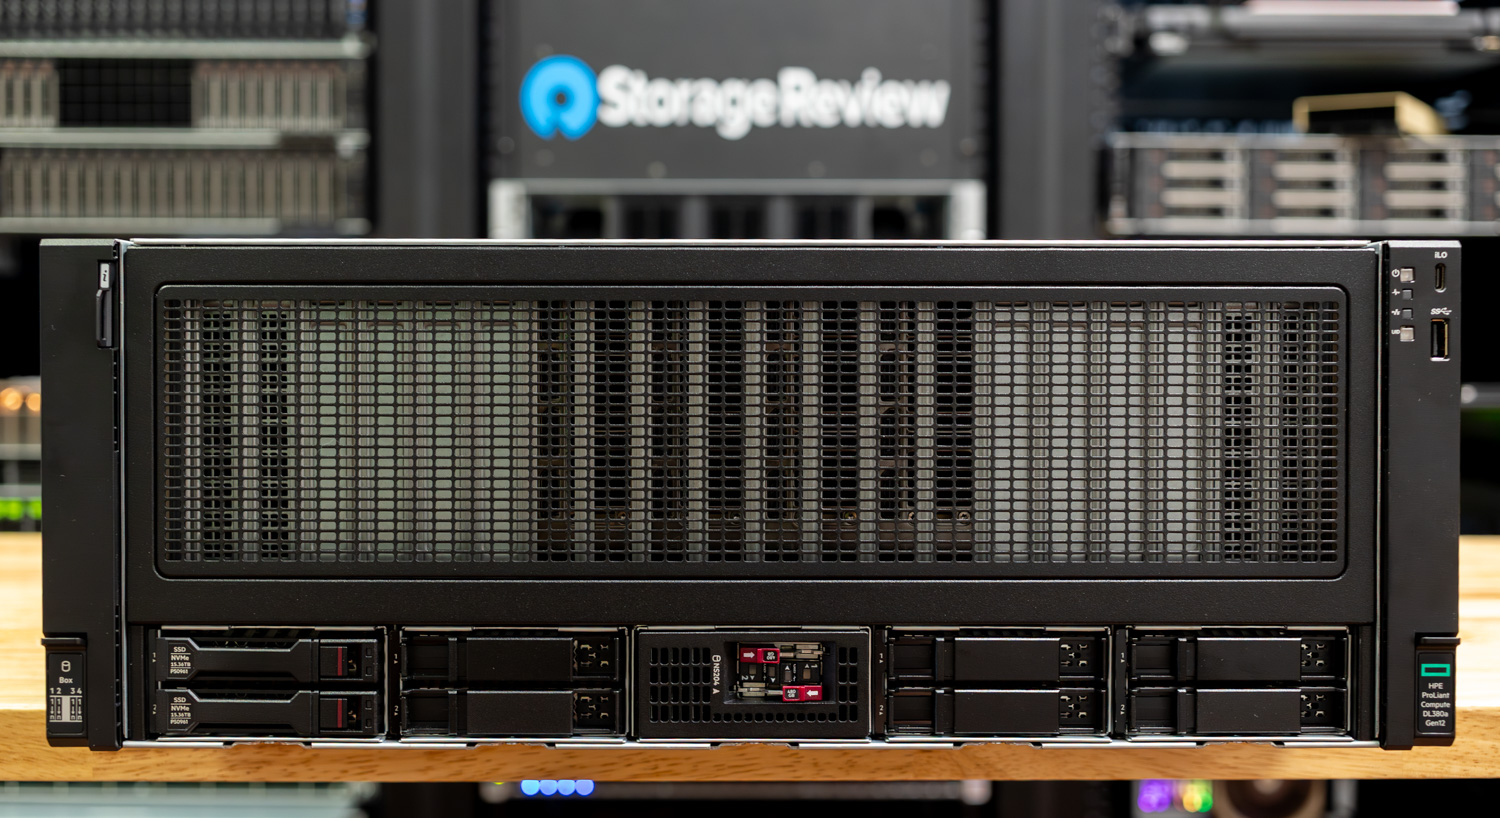
Omdat de MI350P een standaard dual-slot, full-height, full-length PCIe-kaart is, past deze in servers die bedrijven al inzetten en gebruiken, inclusief de compacte, luchtgekoelde platforms met acht GPU's die nu door de grote OEM's worden geproduceerd. De Dell PowerEdge XE7740 en de HPE ProLiant DL380a Gen12, die we beide eerder hebben getest, zijn hiervoor de meest voor de hand liggende kandidaten. Beide zijn specifiek ontworpen om acht dual-slot, FHFL-acceleratoren te huisvesten in een luchtgekoeld chassis met een stroomvoorziening en luchtstroom die al zijn afgestemd op kaarten van 600 W. Geen aangepast rack, geen waterkoeling, geen OAM-basisplaat.
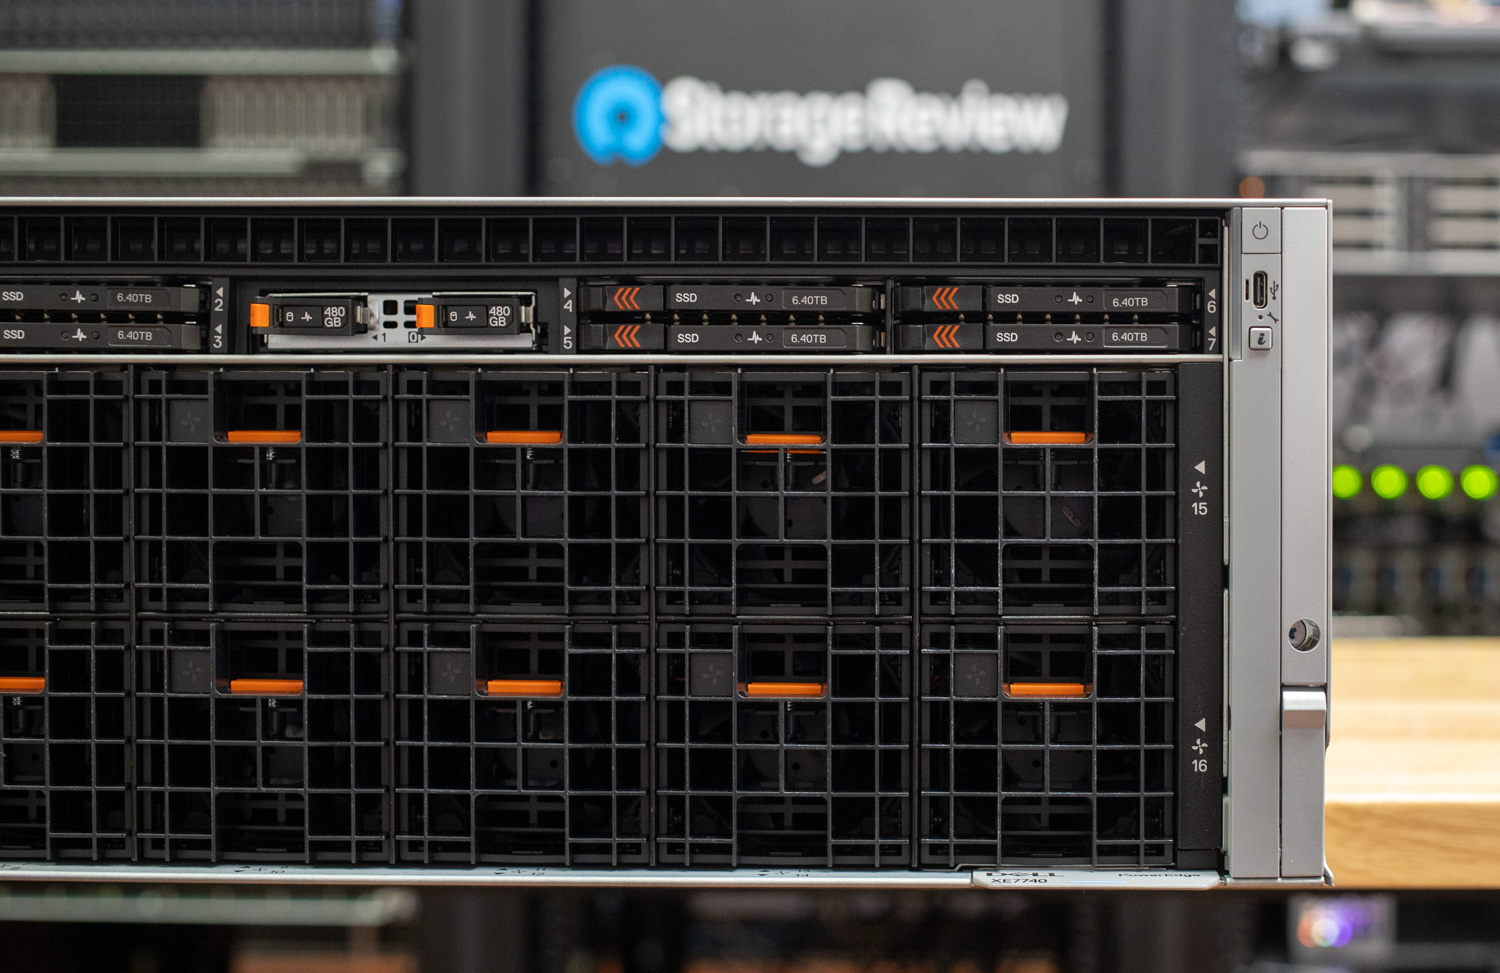
Een MI350P-configuratie met acht kaarten in een van deze systemen biedt 1,152 GB HBM3E en een totale geheugenbandbreedte van 32 TB/s in één luchtgekoelde behuizing. Voor inferentie op grote open-weight-modellen is dat voldoende om een model met een biljoen parameters op MXFP4 in één chassis te hosten. Maar zoals eerder vermeld, is het nadeel de afwezigheid van een schaalbare fabric. Op de OAM MI350X communiceren GPU's via Infinity Fabric over het Universal Baseboard. Op de MI350P maakt elke GPU-naar-GPU-verbinding gebruik van PCIe Gen5 x16 met een snelheid van 128 GB/s, hetzelfde pad dat wordt gebruikt om de host te bereiken. Voor inferentieworkloads, met name met tensor-parallelle sharding binnen een node en pipeline- of data-parallellisme over nodes, is dit werkbaar. Voor nauw gekoppelde trainingen waarbij de bandbreedte voor alle reduce-bewerkingen de staptijd domineert, blijft het OAM-platform de juiste oplossing.
Precieze formaten
Precisie is een belangrijk onderwerp, hoewel geen van de door de MI350P ondersteunde formaten nieuw is. De MI350X heeft dezelfde set. De reden dat het nog steeds relevant is, is dat de OCP-blokschalingsdatatypen (MXFP8, MXFP6, MXFP4) de standaard zijn geworden voor toonaangevende modelbouwlaboratoria om modellen te trainen en te publiceren. Met deze formaten kunnen laboratoria trainen met een lagere precisie met weinig tot geen kwaliteitsverlies, en de voordelen voor de inferentie zijn direct merkbaar.
Lagere precisie betekent sneller. MXFP4 is meer dan twee keer zo snel als FP8 en ongeveer vier keer zo snel als BF16 op zijn piek. Die snelheidsverbetering is merkbaar in de praktijk. De release van OpenAI's gpt-oss maakte de toename in doorvoer duidelijk, en grensverleggende modellen zoals Kimi K2.6 worden vanaf het begin native getraind met kwantiseringsbewustzijn in INT4, in plaats van achteraf gekwantiseerd te worden. Het andere deel van het verhaal is het geheugen. INT4- en MXFP4-gewichten nemen een kwart van de ruimte in beslag die BF16 vereist. Dat betekent dat modellen met biljoenen parameters in één server met acht GPU's passen. Voor een bedrijf dat een groot open-weight-model on-premise wil hosten, is het verschil slechts één serverrack versus een multi-node cluster met alle bijbehorende netwerk- en orchestratie-infrastructuur.
Tot slot
De meeste bedrijven die on-premise AI overwegen, lopen tegen problemen aan met stroomvoorziening, koeling, rackdichtheid of budget voordat ze tegen de limieten van de rekenkracht aanlopen. Een PCIe Instinct die in een bestaand serverlandschap kan worden geïntegreerd, omzeilt de ergste van deze beperkingen. NVIDIA heeft momenteel geen vlaggenschip PCIe-serverkaart die hiermee kan concurreren, waardoor AMD vrij spel heeft in dit segment zolang dat zo blijft.
Aanvullende informatie is beschikbaar op de AMD Instinct- pagina.


 Amazon