

IBM en NASA hebben het NASA-IBM Lunar Foundation Model als open source uitgebracht. Het is een van de eerste publiekelijk beschikbare basismodellen die zijn ontwikkeld voor wetenschappelijk onderzoek naar de maan. De gewichten, een technisch rapport en de dataset waarop het model is getraind, zijn beschikbaar op Hugging Face onder de Prithvi-familie, die al aardobservatie, weer en heliofysica omvat. Het idee erachter is dat tientallen jaren aan maangegevens van meerdere instrumenten de mogelijkheden van handmatig gefilterde kaarten en smalle, taakspecifieke modellen hebben overstegen. Een enkel, vooraf getraind basismodel kan worden aangepast voor het in kaart brengen van kraters, het detecteren van vulkanische structuren en het opsporen van ijs, zonder telkens opnieuw te hoeven beginnen. In eigen benchmarks van IBM en NASA verlaagde het model de wortelgemiddelde kwadratische fout bij het signaleren van mogelijke ijsafzettingen met maar liefst 22% ten opzichte van een SwinV2-B-referentiemodel.
Een TerraMind-backbone op 30 lagen van negen instrumenten.
Het model is gebouwd op een versie van TerraMind, het aardobservatiemodel dat IBM samen met de European Space Agency heeft ontwikkeld. Dit model is gekozen vanwege de manier waarop het omgaat met gemengde gegevenstypen en resoluties en hoe het correlaties tussen verschillende modaliteiten leert om ontbrekende of ruisende waarden aan te vullen. Voor elke maantaak wordt een fijnafstemming met low-rank adapters gebruikt, waarbij 90% van de basisgewichten bevroren blijft. Dit zorgt voor lage adaptatiekosten. Het trainingscorpus is het onderdeel dat volgens NASA voorheen niet bestond: een uniforme, ruimtelijk uitgelijnde dataset van meer dan 30 lagen van negen instrumenten uit vier missies, met ongeveer 2 miljoen beeldtegels, meer dan 1 miljoen camerabeelden van 1 meter en bijna 964,000 multispectrale beelden met een resolutie van 100 meter. Bronnen zijn onder andere beelden van NASA's Lunar Reconnaissance Orbiter, zwaartekrachtveldkaarten van de GRAIL-missie met een resolutie van 20 kilometer per pixel, gegevens van Lunar Prospector en aanvullende observaties van JAXA's SELENE/Kaguya. De referentiecollectie, genaamd SOMBench, wordt tegelijk met het model verzonden.
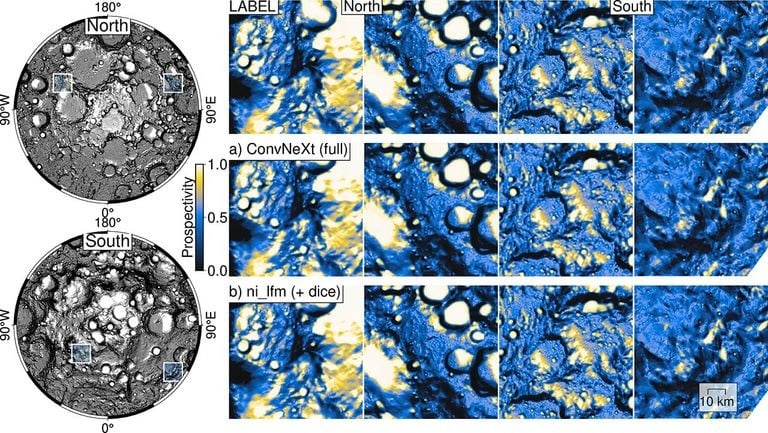
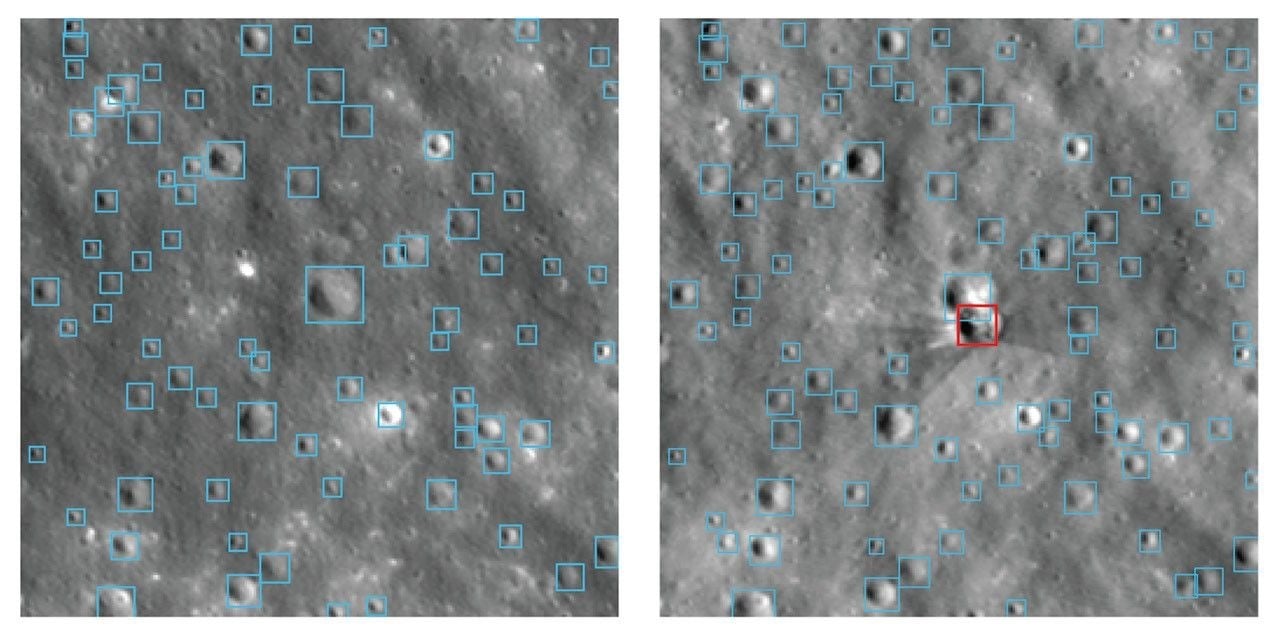
IJs, vulkanische plekken en kraters op twee schalen
Het percentage van 22% komt van de ijstaak, waarbij het model multimodale observaties met meerdere resoluties combineert om te voorspellen waar ijs zich mogelijk onder het oppervlak van permanent schaduwrijke gebieden bevindt – de plekken waar een toekomstige maanbasis water, zuurstof en raketbrandstof zou winnen. Voor de vulkanische geschiedenis brengt het model onregelmatige maregebieden in kaart met een 3% betere dekking dan SwinV2-B, terwijl het traint met onvolledige labels. IBM presenteert dit als een vergelijkbare nauwkeurigheid tegen lagere kosten voor fine-tuning. De detectie van kraters verschilt per schaal: op een resolutie van één meter evenaart het model SwinV2-B, en op een contextschaal van ongeveer 100 meter presteert het bijna 19% beter met de helft van de trainingsdata. Michael Barker, de NASA-expert op het gebied van maantopografie die het project mede leidde, zei dat de winst zit in kenmerken waarvan de ouderdom nog steeds wordt betwist: "De ouderdom van deze kenmerken blijft onderwerp van veel discussie, dus hoe beter we hun verspreiding en eigenschappen begrijpen, hoe groter de kans dat we dit mysterie kunnen oplossen."
“NASA heeft decennialang gewerkt aan het opbouwen van een buitengewoon wetenschappelijk archief van de maan, maar het verzamelen van gegevens is slechts een deel van het werk. We moeten het voor wetenschappers ook gemakkelijker maken om gegevens te onderzoeken en te gebruiken”, aldus Kevin Murphy, Chief Science Data Officer en waarnemend Chief Data and AI Officer bij het NASA-hoofdkantoor. Juan Bernabe-Moreno, directeur van IBM Research Europe, het Verenigd Koninkrijk en Ierland, zei dat het model “wetenschappers een basis biedt om de maan op grote schaal te onderzoeken, door waarnemingen van verschillende instrumenten met elkaar te verbinden, patronen te onthullen die moeilijk afzonderlijk te zien zijn, en een open platform te bieden waarop de wereldwijde onderzoeksgemeenschap kan voortbouwen.”
Alles is nu beschikbaar onder een open-source licentie, en IBM's onderzoeksblog beschrijft de drie eerste NASA-gebruiksscenario's uitgebreider. Het is dezelfde open-source strategie die IBM al heeft toegepast in de zakelijke markt met Granite 4.0 , hier toegepast op een wetenschappelijk domein waar de schaarse hulpbron gelabelde data is en de rekenkracht om daarop te verfijnen, en waar de directe gebruikers zich bezighouden met risicoanalyse van landingsplaatsen en het opsporen van grondstoffen voor een duurzame aanwezigheid op de maan.


 Amazon