

NVIDIA heeft een DGX Spark -configuratie met 64 GB unified memory toegevoegd , die vanaf $4,999 exclusief verkrijgbaar is via Acer, ASUS, Dell, Gigabyte, HP en MSI vanaf 23 oktober. De nieuwe variant is voorzien van dezelfde GB10 Grace Blackwell Superchip, ConnectX-7 netwerkfunctionaliteit, DGX OS en NVIDIA AI-softwarestack als het 128 GB-model. Volgens NVIDIA kan de 64 GB-variant op zichzelf modellen met maximaal 100 miljard parameters verwerken voor lokale inferentie, finetuning en agentworkflows, zonder data naar de cloud te hoeven verzenden.
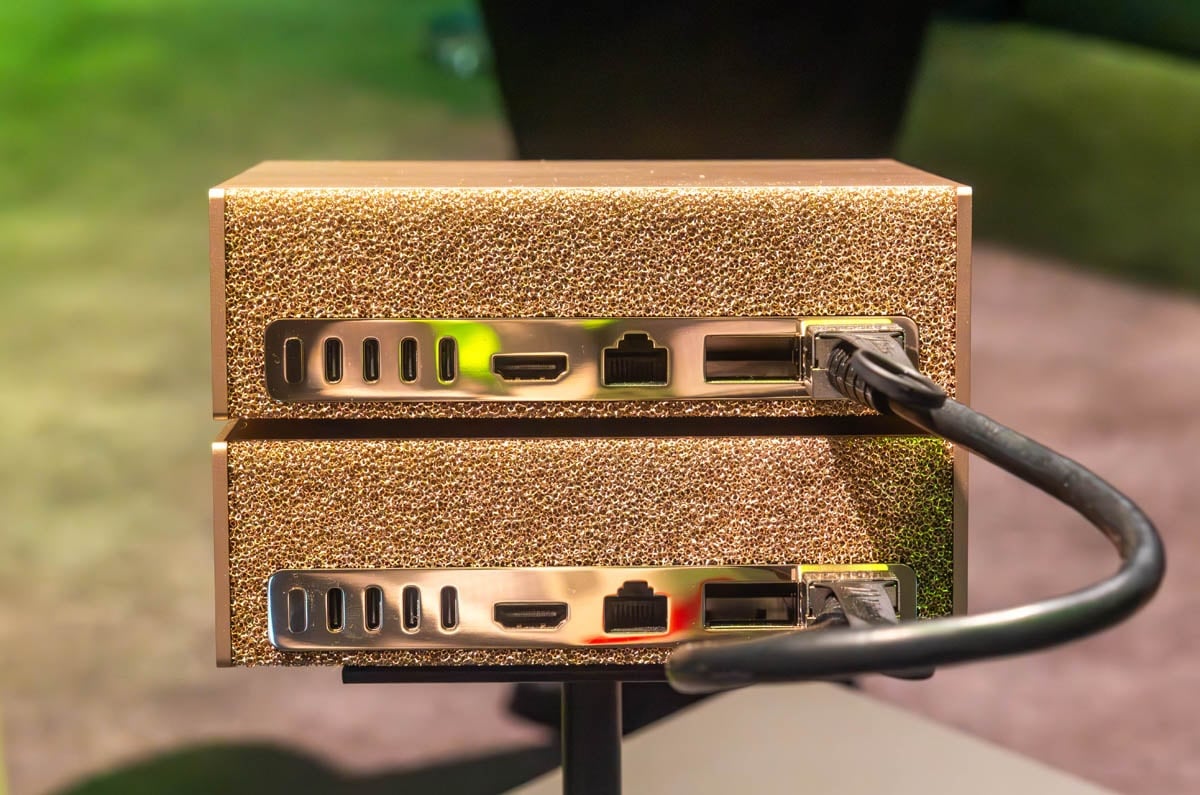
Twee Sparks van 64 GB voor één cluster van 128 GB
Het argument voor de goedkopere variant (vergeleken met de marktprijs van het grotere model) is dat twee exemplaren in een cluster prima presteren. Elke DGX Spark heeft een ingebouwde ConnectX-7 NIC, waardoor een paar rechtstreeks via een QSFP-kabel op een 200GbE-link kan worden aangesloten, zonder switch ertussen. De NVIDIA Sync Cluster Assistant zorgt voor de detectie, valideert de apparaatconfiguratie en zet het ConnectX-7-netwerk op. Twee modules van 64 GB worden samengevoegd tot 128 GB aan geheugen, wat volgens NVIDIA voldoende is om modellen met maximaal 200 miljard parameters te draaien.
Volgens interne cijfers van NVIDIA voor de combinatie met Qwen3.8 27B: twee geclusterde systemen van 64 GB leverden tot 1.7 keer de prestaties van één enkel systeem van 128 GB. Omdat elke node dezelfde CUDA-bibliotheken, inferentie-engines en DGX OS-image gebruikt, kan een workload over beide units worden verdeeld zonder dat de softwareomgeving opnieuw hoeft te worden opgebouwd. Ondersteunde inferentie-frameworks zijn onder andere llama.cpp, Ollama, vLLM en LM Studio. NVIDIA heeft een korte video over het verbinden van twee Sparks met NVIDIA Sync.
We hebben een gedistribueerd inferentiecluster opgezet met Dell-, Gigabyte- en HP DGX Spark-units , en recentelijk gedeelde opslag achter een Spark-cluster geplaatst via 100GbE . De 64GB-versie verlaagt de instapprijs voor een dergelijke configuratie, met als nadeel dat een enkele unit nu de helft van het geheugen van het origineel bevat.
De NVIDIA Sync Model Launcher verschijnt eind oktober.
Het tweede deel van de aankondiging betreft software. De NVIDIA Sync Model Launcher, die eind oktober verschijnt, downloadt en start een model op één Spark-server of een cluster van twee Spark-servers, met Qwen3.8 27B als voorbeeld, en stelt het resulterende eindpunt beschikbaar aan ontwikkelaarscomputers in het netwerk. Het kan ook OpenCode configureren voor dat model, zodat ontwikkelaars vanuit een browser kunnen programmeren terwijl het Spark-cluster de inferentie uitvoert.
De 64GB-systemen worden geleverd met dezelfde software als het 128GB-model: DGX OS, CUDA-X AI-bibliotheken, de NVIDIA Agent Toolkit, Nemotron open modellen en runtimes zoals Ollama, vLLM en PyTorch met CUDA. NVIDIA positioneert het apparaat als een lokaal platform voor agents, inferentie, finetuning, data science en edge-ontwikkeling, en dankzij de ConnectX-7-poort kan later een tweede unit worden toegevoegd. Voor ontwikkelaars van agents verwijst NVIDIA naar de playbooks voor NemoClaw, OpenClaw, Hermes Agent en OpenShell op build.nvidia.com als uitgangspunt.


 Amazon