

Grote taalmodellen bieden ongelooflijke nieuwe mogelijkheden, waardoor de grenzen van wat mogelijk is met AI worden verlegd. Hun grote omvang en unieke uitvoeringskenmerken kunnen het echter lastig maken om ze kosteneffectief te gebruiken. NVIDIA TensorRT-LLM is open source om de ontwikkeling van LLM's te versnellen.
Wat is NVIDIA TensorRT-LLM?
NVIDIA heeft nauw samengewerkt met toonaangevende bedrijven, waaronder Meta, AnyScale, Cohere, Deci, Grammarly, Mistral AI, MozaïekML, nu onderdeel van Databricks, OctoML, Tabnine en Together AI om LLM-inferentie te versnellen en te optimaliseren.
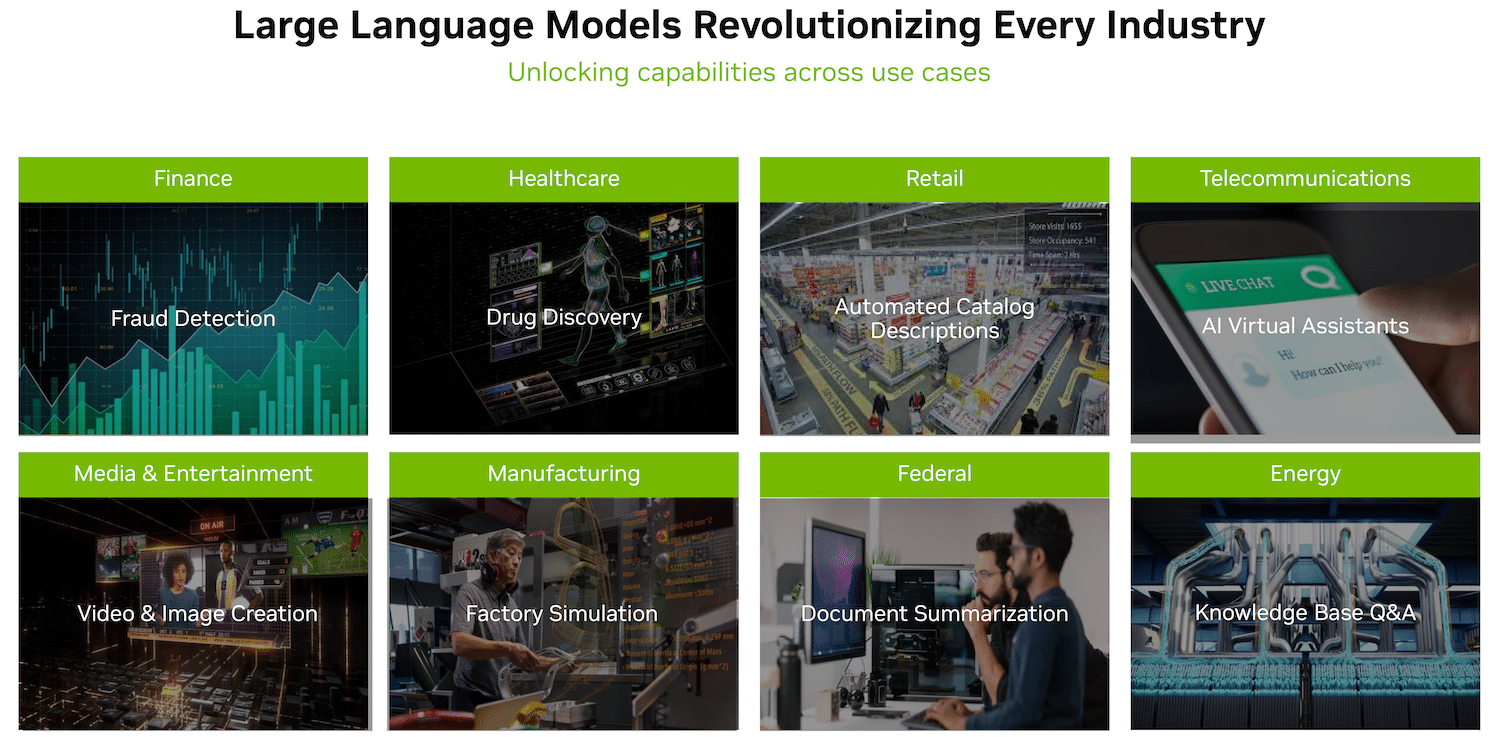
Deze innovaties zijn geïntegreerd in de open-source NVIDIA TensorRT-LLM- software, die de komende weken wordt uitgebracht. TensorRT-LLM bestaat uit de TensorRT deep learning-compiler en bevat geoptimaliseerde kernels, pre- en post-processingstappen en communicatieprimitieven voor meerdere GPU's/meerdere knooppunten voor baanbrekende prestaties op NVIDIA GPU's. Het stelt ontwikkelaars in staat om te experimenteren met nieuwe LLM's, biedt maximale prestaties en snelle aanpassingsmogelijkheden zonder diepgaande kennis van C++ of NVIDIA CUDA te vereisen.
TensorRT-LLM verbetert het gebruiksgemak en de uitbreidbaarheid via een open-source modulaire Python API voor het definiëren, optimaliseren en uitvoeren van nieuwe architecturen en verbeteringen naarmate LLM's evolueren en gemakkelijk kunnen worden aangepast.
MozaïekML heeft bijvoorbeeld naadloos specifieke functies toegevoegd die het nodig heeft bovenop TensorRT-LLM en deze geïntegreerd in hun bestaande serveerstapel. Naveen Rao, vice-president engineering bij Databricks, merkt op dat “het een absoluut briesje was.”
NVIDIA TensorRT-LLM-prestaties
Het samenvatten van artikelen is slechts één van de vele toepassingen van LLM's . De volgende benchmarks tonen de prestatieverbeteringen die TensorRT-LLM oplevert op de nieuwste NVIDIA Hopper-architectuur.
De volgende afbeeldingen weerspiegelen de samenvatting van artikelen met behulp van een NVIDIA A100 en NVIDIA H100 met CNN/Daily Mail, een bekende dataset voor het evalueren van de prestaties van samenvattingen.
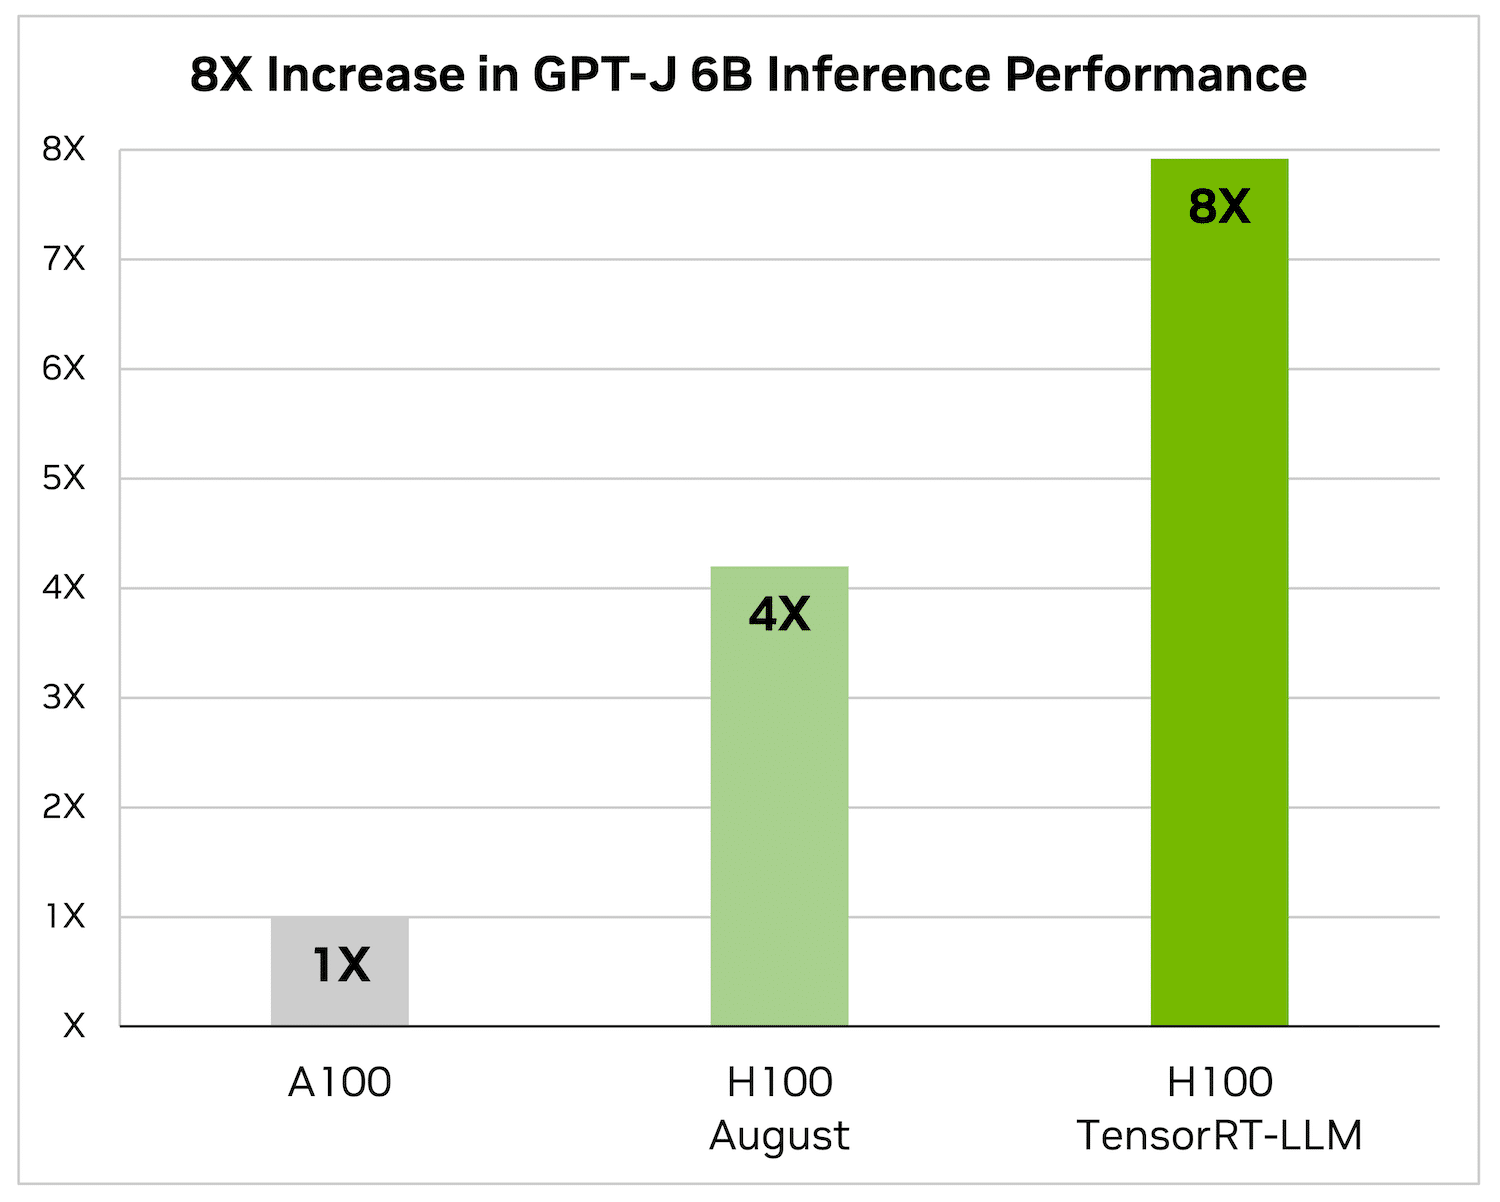
H100 alleen is 4x sneller dan A100. Het toevoegen van TensorRT-LLM en de voordelen ervan, inclusief batching tijdens de vlucht, resulteert in een 8x toename om de hoogste doorvoer te leveren.
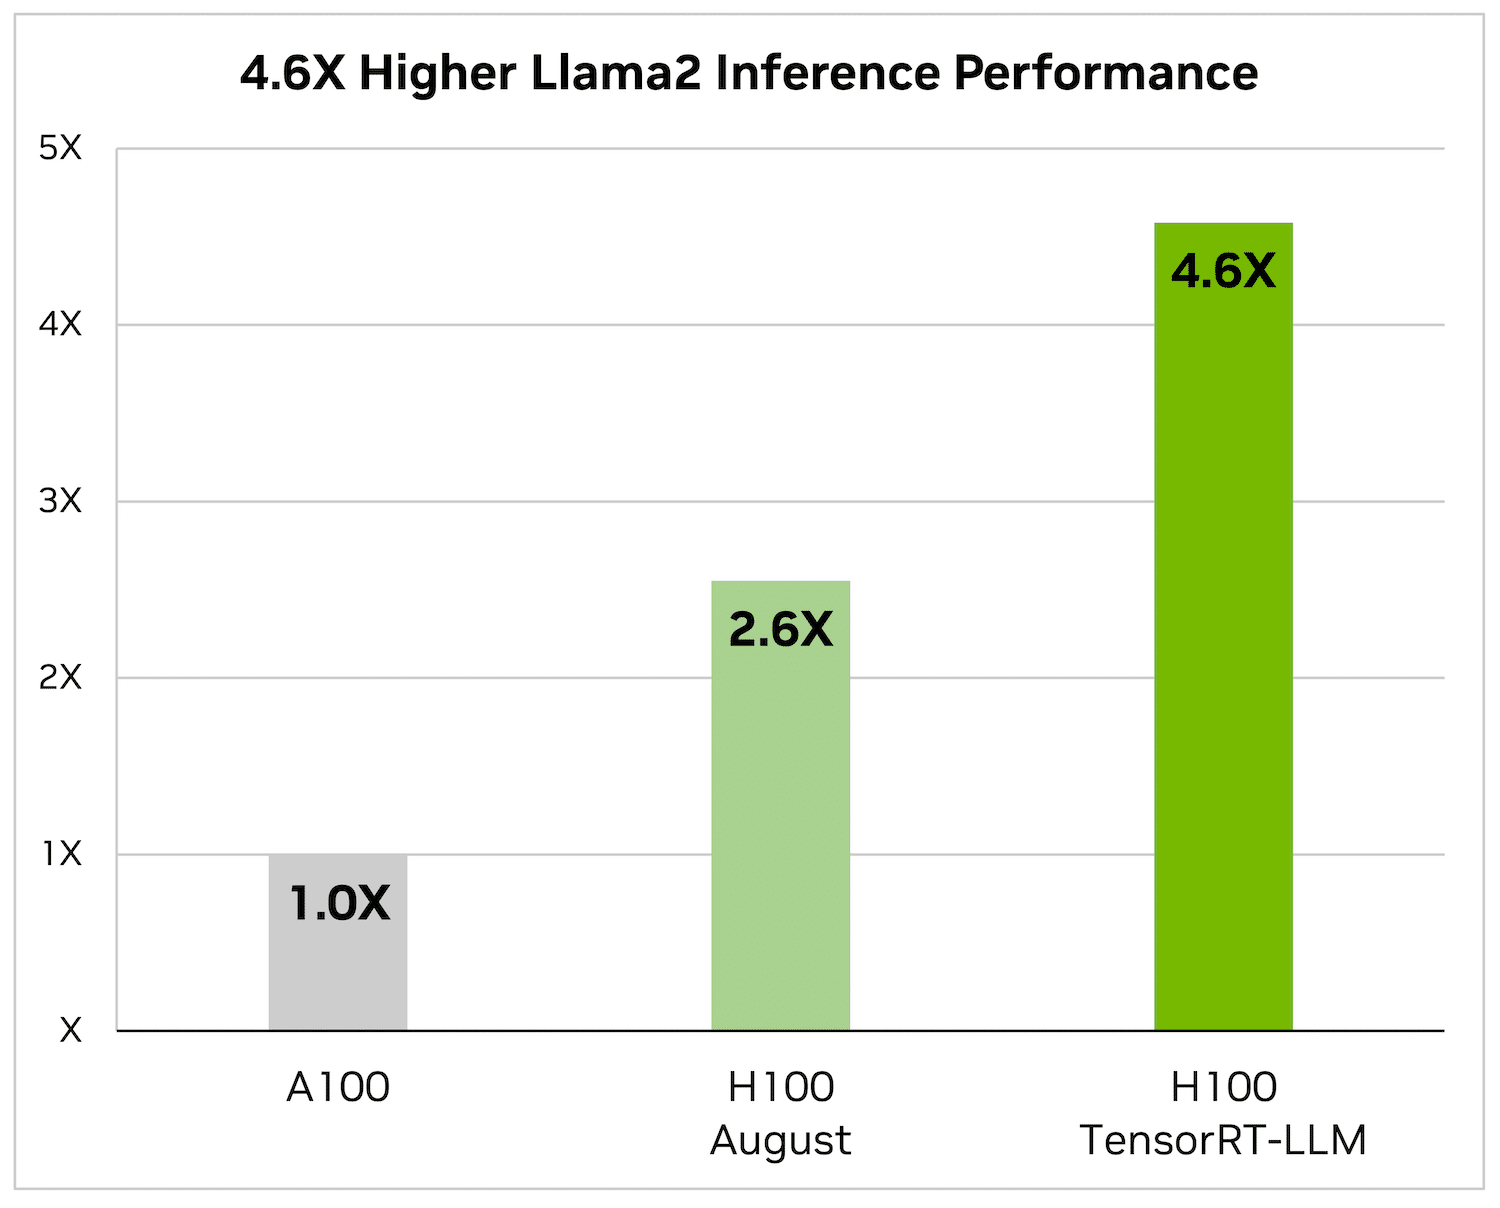
Op Llama 2 – een populair taalmodel dat onlangs door Meta is uitgebracht en veel wordt gebruikt door organisaties die generatieve AI willen integreren – kan TensorRT-LLM de inferentieprestaties met 4.6x versnellen vergeleken met A100 GPU's.
LLM Ecosysteeminnovatie evolueert snel
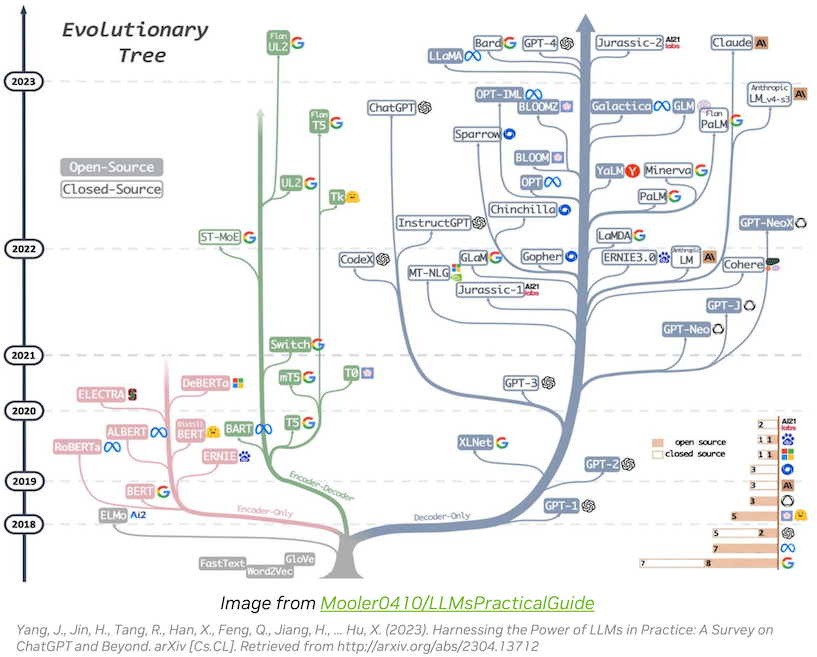
Het Large Language Model (LLM)-ecosysteem evolueert snel, wat aanleiding geeft tot diverse modelarchitecturen met uitgebreide mogelijkheden. Sommige van de grootste en meest geavanceerde LLM's, zoals Meta's Llama 70 met 2 miljard parameters, hebben meerdere GPU's nodig om realtime reacties te bieden. Voorheen omvatte het optimaliseren van LLM-inferentie voor topprestaties complexe taken zoals het handmatig splitsen van AI-modellen en het coördineren van GPU-uitvoering.
TensorRT-LLM vereenvoudigt dit proces door gebruik te maken van tensor-parallellisme, een vorm van modelparallellisme dat gewichtsmatrices over apparaten verdeelt. Deze aanpak maakt efficiënte schaal-out-inferentie mogelijk over meerdere GPU's die met elkaar zijn verbonden via NVLink en meerdere servers zonder tussenkomst van de ontwikkelaar of modelwijzigingen.
Naarmate er nieuwe LLM’s en modelarchitecturen verschijnen, kunnen ontwikkelaars hun modellen optimaliseren met behulp van de nieuwste NVIDIA AI-kernels die beschikbaar zijn in TensorRT-LLM, waaronder geavanceerde implementaties zoals FlashAttention en gemaskeerde multi-head aandacht.
Bovendien bevat TensorRT-LLM vooraf geoptimaliseerde versies van veelgebruikte LLM's, zoals Meta Llama 2, OpenAI GPT-2, GPT-3, Falcon, Mozaïek MPT, BLOOM en andere. Deze kunnen eenvoudig worden geïmplementeerd met behulp van de gebruiksvriendelijke TensorRT-LLM Python API, waardoor ontwikkelaars aangepaste LLM's kunnen maken die zijn afgestemd op verschillende industrieën.
Om de dynamische aard van LLM-workloads aan te pakken, introduceert TensorRT-LLM in-flight batching, waardoor de planning van verzoeken wordt geoptimaliseerd. Deze techniek verbetert het GPU-gebruik en verdubbelt bijna de doorvoer van echte LLM-verzoeken, waardoor de Total Cost of Ownership (TCO) wordt verlaagd.
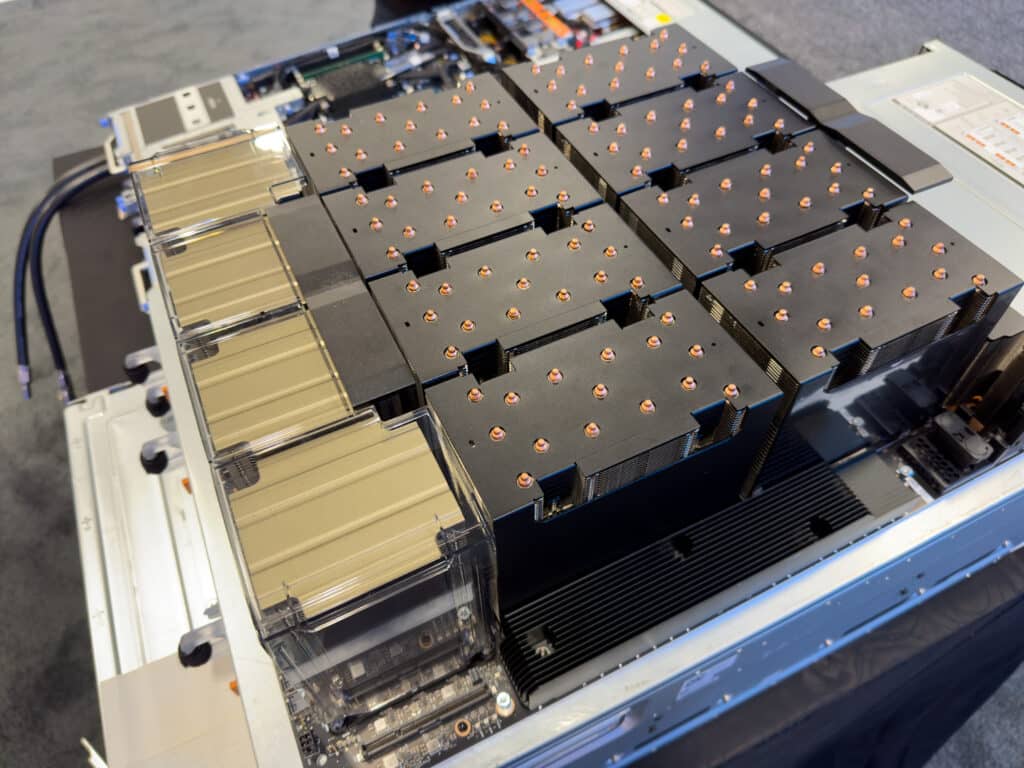
Dell XE9680 GPU-blok
Bovendien gebruikt TensorRT-LLM kwantiseringstechnieken om modelgewichten en activeringen met lagere precisie weer te geven (bijv. FP8). Dit vermindert het geheugengebruik, waardoor grotere modellen efficiënt op dezelfde hardware kunnen draaien en tegelijkertijd de geheugengerelateerde overhead tijdens de uitvoering wordt geminimaliseerd.
Het LLM-ecosysteem ontwikkelt zich snel en biedt grotere mogelijkheden en toepassingen in alle sectoren. TensorRT-LLM stroomlijnt LLM-inferentie, waardoor de prestaties en TCO worden verbeterd. Het stelt ontwikkelaars in staat modellen eenvoudig en efficiënt te optimaliseren. Om toegang te krijgen tot TensorRT-LLM kunnen ontwikkelaars en onderzoekers deelnemen aan het programma voor vroege toegang via het NVIDIA NeMo-framework of GitHub, op voorwaarde dat ze zijn geregistreerd in het NVIDIA Developer Program met het e-mailadres van een organisatie.
Sluiting Gedachten
We hebben in The Lab al lang opgemerkt dat er overhead beschikbaar is die onderbenut wordt door de softwarestack, en TensorRT-LLM maakt duidelijk dat een hernieuwde focus op optimalisaties en niet alleen op innovatie uiterst waardevol kan zijn. Terwijl we lokaal blijven experimenteren met verschillende raamwerken en geavanceerde technologie, zijn we van plan deze voordelen van de verbeterde bibliotheek- en SDK-releases onafhankelijk te testen en te valideren.
NVIDIA besteedt duidelijk ontwikkelingstijd en middelen om elke laatste druppel prestatie uit zijn hardware te halen, zijn positie als marktleider verder te verstevigen en zijn bijdragen aan de gemeenschap en de democratisering van AI voort te zetten door het open-source karakter van de tools te behouden. .


 Amazon