

NVIDIA presenteert op de Hot Chips-conferentie van Stanford een duidelijke boodschap: het datacenter is de computer, en de prestatielimiet ervan wordt meer bepaald door de verbindende infrastructuur dan door ruwe FLOPS. Gedurende vijf sessies laat NVIDIA zien hoe Spectrum-XGS Ethernet, vijfde-generatie NVLink met NVLink Fusion, CPO-gestuurde fotonische switches en de nieuwe DGX Spark desktop-supercomputer samenwerken. Deze integratie heeft als doel tienduizenden GPU's om te vormen tot één enkele, inkomsten genererende AI-fabriek.
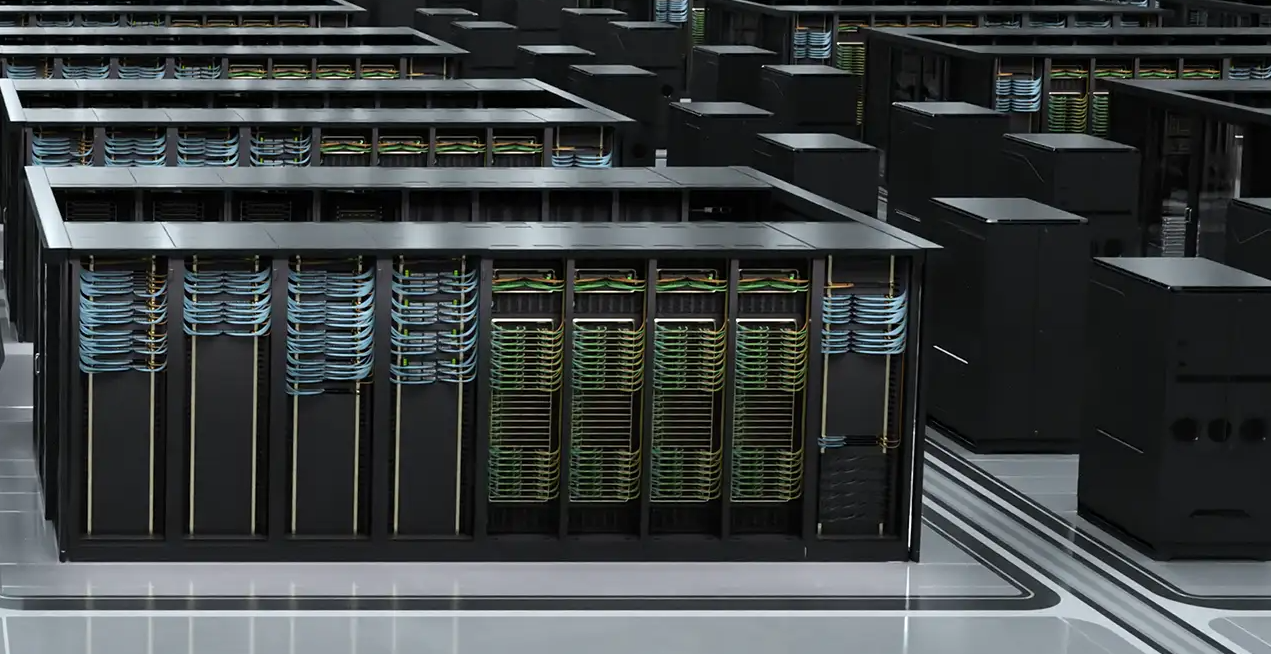
Een drielaags weefsel voor AI-fabrieken
Moderne LLM's zijn impliciet gedistribueerde applicaties. Ze streamen biljoenen parameters over GPU's, synchroniseren gradiëntupdates met een snelheid van microseconden en moeten een eerste token in minder dan een seconde aan een gebruiker retourneren. Die werklast drijft een hiërarchie van interconnects aan:
- Schaal op binnen een rack, zodat GPU's functioneren als cores op een enkele, grote processor.
- Schaalbaar over racks zodat het cluster als één systeem functioneert.
- Schaalbaar over volledige datacenters voor geografische redundantie, capaciteitsdeling en naleving van regelgeving.
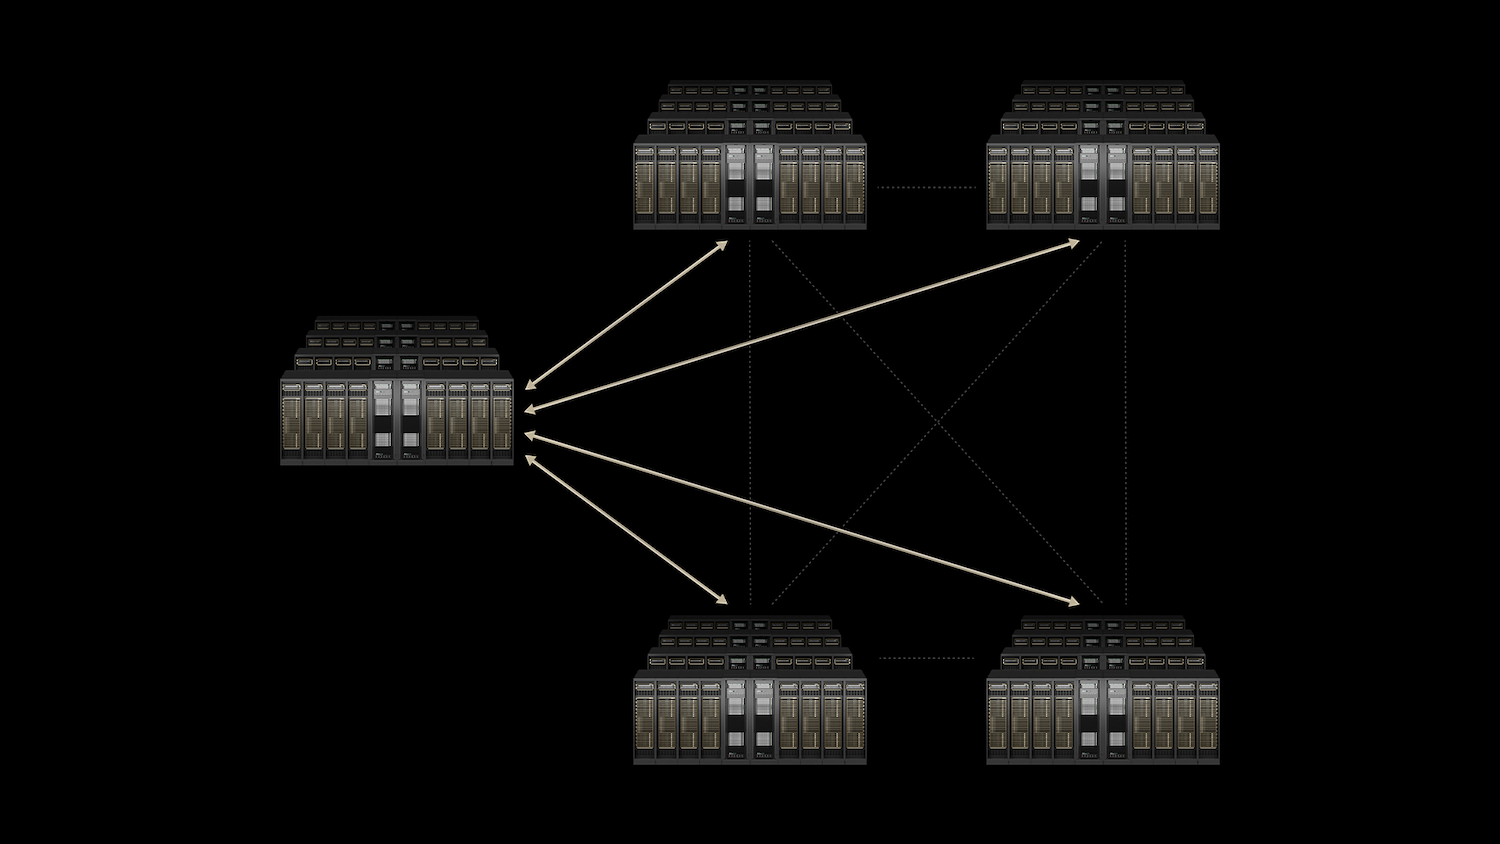
Het antwoord van NVIDIA is een verticaal geïntegreerde stack. NVLink en NVLink Switch zijn verantwoordelijk voor het scale-updomein; Quantum InfiniBand en Spectrum-X zijn verantwoordelijk voor scale-out; de nieuwe Spectrum-XGS Ethernet breidt lossless, AI-geoptimaliseerde netwerken uit naar datacenters. Co-Packaged Optics (CPO) verlaagt de stroom- en dichtheidslimieten die clusters met miljoenen GPU's anders zouden bereiken.
Spectrum-XGS Ethernet
Traditionele Ethernet-technologie was primair ontworpen om best-effort-verkeer af te handelen, wat betekent dat het goed werkte voor eenvoudige communicatie via één server. Nu we echter in een wereld terechtkomen die steeds afhankelijker wordt van AI, staan we voor nieuwe uitdagingen.
Met de opkomst van AI-collectieven en multi-tenant inferentiesystemen zijn de eisen aan netwerkprestaties aanzienlijk veranderd. Deze moderne toepassingen vereisen een betrouwbaarheids- en snelheidsniveau dat traditioneel Ethernet simpelweg niet kan bieden.
Concreet vereisen ze nul jitter, wat betekent dat er geen variabiliteit in latentie is, wat cruciaal is voor realtime verwerking. Bovendien zorgt deterministische latentie voor voorspelbare en consistente reacties, wat essentieel is voor toepassingen die afhankelijk zijn van directe feedback. Ten slotte is een doorvoersnelheid die bijna gelijk is aan de lijnsnelheid essentieel om de grote hoeveelheid data te verwerken die wordt verwerkt tijdens microbursty-belastingen, waarbij het dataverkeer onverwacht kan pieken.
Spectrum-X is een oplossing die naadloos functioneert binnen een datacenter, terwijl Spectrum-XGS deze innovatie naar een hoger niveau tilt door de mogelijkheden uit te breiden naar meerdere datacenters. Het integreert geavanceerde Spectrum-6 of -4 ASIC-switches met supersnelle 800 Gb/s SuperNIC's, met name de BlueField-3 of ConnectX-8 varianten. Deze technologieën werken samen om congestie efficiënt te beheren en pakketten opnieuw te ordenen, waardoor een soepele gegevensstroom wordt gegarandeerd.
Wat dit systeem onderscheidt, is de intelligente telemetrie die data van elke poort verzamelt en invoert in de congestiecontrolelogica van de switch, waardoor realtime verkeershervorming mogelijk is. In productieclusters resulteert dit in opmerkelijke prestaties, waarbij de doorvoer boven 95 procent van de theoretische capaciteit blijft bij een verbluffende 32k GPU-schaal. Traditioneel 800G Ethernet daarentegen heeft het moeilijk en haalt slechts ongeveer 60 procent doorvoer bij collectieve botsingen.
Bovendien garandeert Spectrum-XGS de naleving van de standaarden, waardoor SONiC en Cumulus Linux integrale componenten van het ecosysteem zijn. Dit betekent dat cloud- en enterprise-beheerders hun bestaande automatiseringsstacks kunnen behouden en tegelijkertijd profiteren van het superieure determinisme dat doorgaans met InfiniBand wordt geassocieerd. De verbeteringen leiden tot een hoger GPU-gebruik en een lagere latentie, wat zich vertaalt in meer tokens per watt en strengere serviceniveaus. Bovendien stelt het beheerders in staat om nieuwe gebruikers aan dezelfde vloot toe te voegen zonder prestatiedalingen te ervaren, wat het een game-changer in de branche maakt.
NVLink en NVLink Fusion: het rack als één gigantische GPU
De vijfde generatie NVLink levert een indrukwekkende point-to-point bandbreedte van 1.8 TB/s en een indrukwekkende totale bandbreedte van 130 TB/s binnen een NVL72-rack. Deze verbeterde connectiviteit zorgt ervoor dat elke GPU in één keer rechtstreeks met elke andere GPU kan communiceren, waardoor het hele rack in feite één coherent geheugendomein wordt. Dankzij de NVIDIA Collective Communications Library (NCCL), die in tien jaar tijd is verfijnd, kunnen applicatieontwikkelaars moeiteloos near-wire-snelheden bereiken zonder dat ze aangepaste communicatiecode voor verschillende topologieën hoeven te schrijven.
Bovendien opent de recente aankondiging van NVLink Fusion interessante mogelijkheden voor hyperscalers. Deze innovatie maakt het mogelijk dat aangepaste CPU's of XPU's NVLink SERDES of chiplets naadloos integreren via UCIe voor accelerators, of NVLink-C2C voor CPU's, waardoor deze componenten direct op de NVLink-fabric kunnen worden geplaatst. Een belangrijk voordeel van Fusion is de modulaire MGX-rackspecificatie, die wordt geleverd met een volledig gekwalificeerde toeleveringsketen. Dit betekent dat dezelfde leveranciers die momenteel NVL72-racks leveren, ook Fusion-racks kunnen leveren, wat de time-to-market aanzienlijk verkort voor bedrijven die deze technologie willen implementeren.
Als het gaat om inferentie-economie, is de invloed van NVLink duidelijk zichtbaar op de traditionele Pareto-grens tussen doorvoer per watt en latentie. Door over te stappen van een PCIe-mesh naar een NVLink Switch-node verbeteren zowel de doorvoer als de latentie, en kunnen verdere verbeteringen worden bereikt door te upgraden naar het NVLink-rack. Dit vertaalt zich in het verwerken van meer gebruikersquery's per kilowattuur en verlaagt tegelijkertijd de afgeschreven kapitaaluitgaven per gegenereerde token, wat NVLink tot een krachtig hulpmiddel maakt voor het verbeteren van de operationele efficiëntie.
NVLink van de vijfde generatie levert 1.8 TB/s point-to-point bandbreedte en 130 TB/s totale bandbreedte in een NVL72-rack. Met NVLink Switch ziet elke GPU elkaar in één hop, waardoor het volledige rack een coherent geheugendomein wordt. Collectieve bewerkingen worden uitgevoerd via NCCL, een bibliotheek die nu in het tiende jaar van productie is, afgestemd op elke denkbare topologie en automatisch topologiebewust. Applicatieontwikkelaars hebben dus geen aangepaste communicatiecode nodig om near-wire-snelheden te bereiken.
Co-Packaged Optics (CPO): het doorbreken van de energiebarrière bij 800 Gb/s en hoger
Traditionele plug-in moduleswitches zijn al geruime tijd de netwerkstandaard. De inefficiënties die inherent zijn aan deze systemen worden echter steeds duidelijker. Wanneer data de ASIC verlaat, reist deze via lange PCB-traces en verschillende connectoren voordat deze een optische module met veel DSP-functionaliteit bereikt. Deze reis resulteert in aanzienlijke verliezen, vaak tot wel 22 dB in het elektrische domein, en verbruikt maar liefst 30 W per poort om het signaal te herstellen. Naarmate we steeds hogere datasnelheden nastreven, zoals 200G PAM4 nu en een ambitieuze 1.6 T in de nabije toekomst, worden de beperkingen van deze architectuur duidelijk, wat leidt tot explosieve vermogensbudgetten en beperkingen op de frontplaatdichtheid.
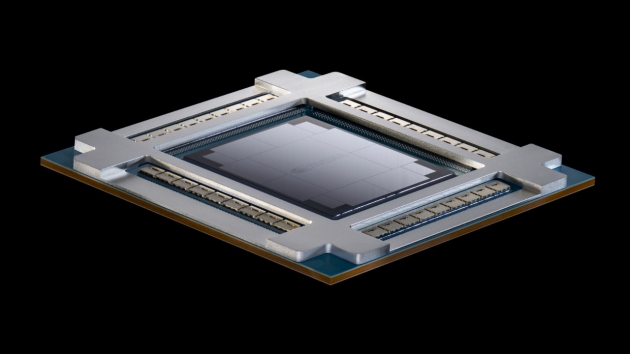
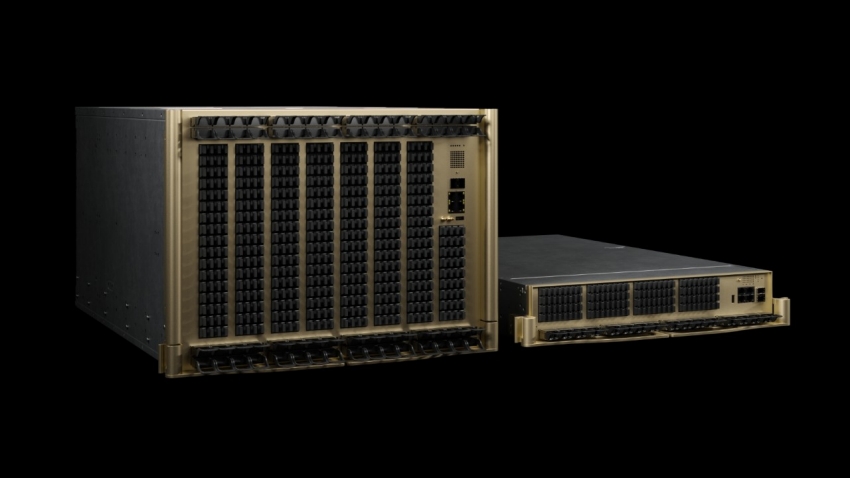
Maak kennis met de innovatieve oplossingen van NVIDIA: Quantum-X Photonics voor InfiniBand en Spectrum-X Photonics voor Ethernet. Door de optische engines rechtstreeks in de switchbehuizing te integreren, wordt de elektrische padlengte drastisch verminderd. Dit minimaliseert niet alleen het verlies tot ongeveer 4 dB, maar verlaagt ook het stroomverbruik van de poort tot ongeveer 9 W – een indrukwekkende verbetering.
Volgende week lanceren we twee geavanceerde vloeistofgekoelde behuizingen: het model met 128 poorten, met een indrukwekkende doorvoersnelheid van 102.4 TB/s, en het model met 512 poorten, dat deze grens nog verder verlegt naar 409.6 TB/s. Dit laatste model is voorzien van een geïntegreerde fiber shuffle, waardoor elke poort naadloos verbinding maakt met de juiste fiberbundel zonder dat omslachtig handmatig patchen nodig is. De eerste praktijkgegevens zijn veelbelovend en wijzen op een opmerkelijk 3.5 keer betere energie-efficiëntie en een ongeveer 10 keer langere gemiddelde tijd tussen storingen in vergelijking met traditionele pluggables. Bovendien is het opstartvenster per cluster 1.3 keer sneller, wat de implementatie stroomlijnt.
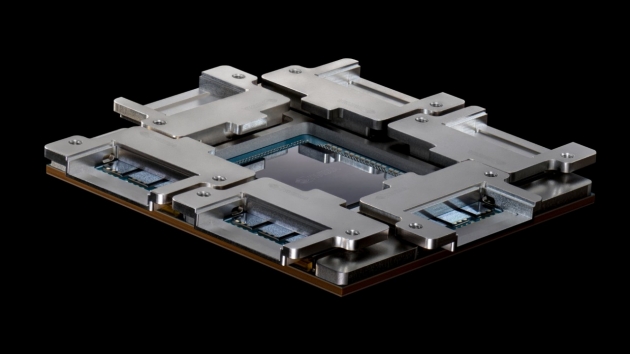
Hoewel deze geavanceerde oplossingen pas in 2026 beschikbaar zullen zijn, zijn de ontwerpen al in volle gang. Dit is cruciaal voor operators die gigawatt-klasse faciliteiten plannen of overheden die nationale labs met miljoenen GPU's overwegen. NVIDIA's CPO-technologie (Coherent Photonics Optics) definieert duidelijk een pad om binnen de vermogensgrenzen te blijven en de gevreesde nachtmerrie van optisch onderhoud te vermijden, wat de weg vrijmaakt voor een efficiëntere en krachtigere toekomst in high-performance netwerken.
DGX Spark en het systeem: van desktopprototype tot productie op rackschaal
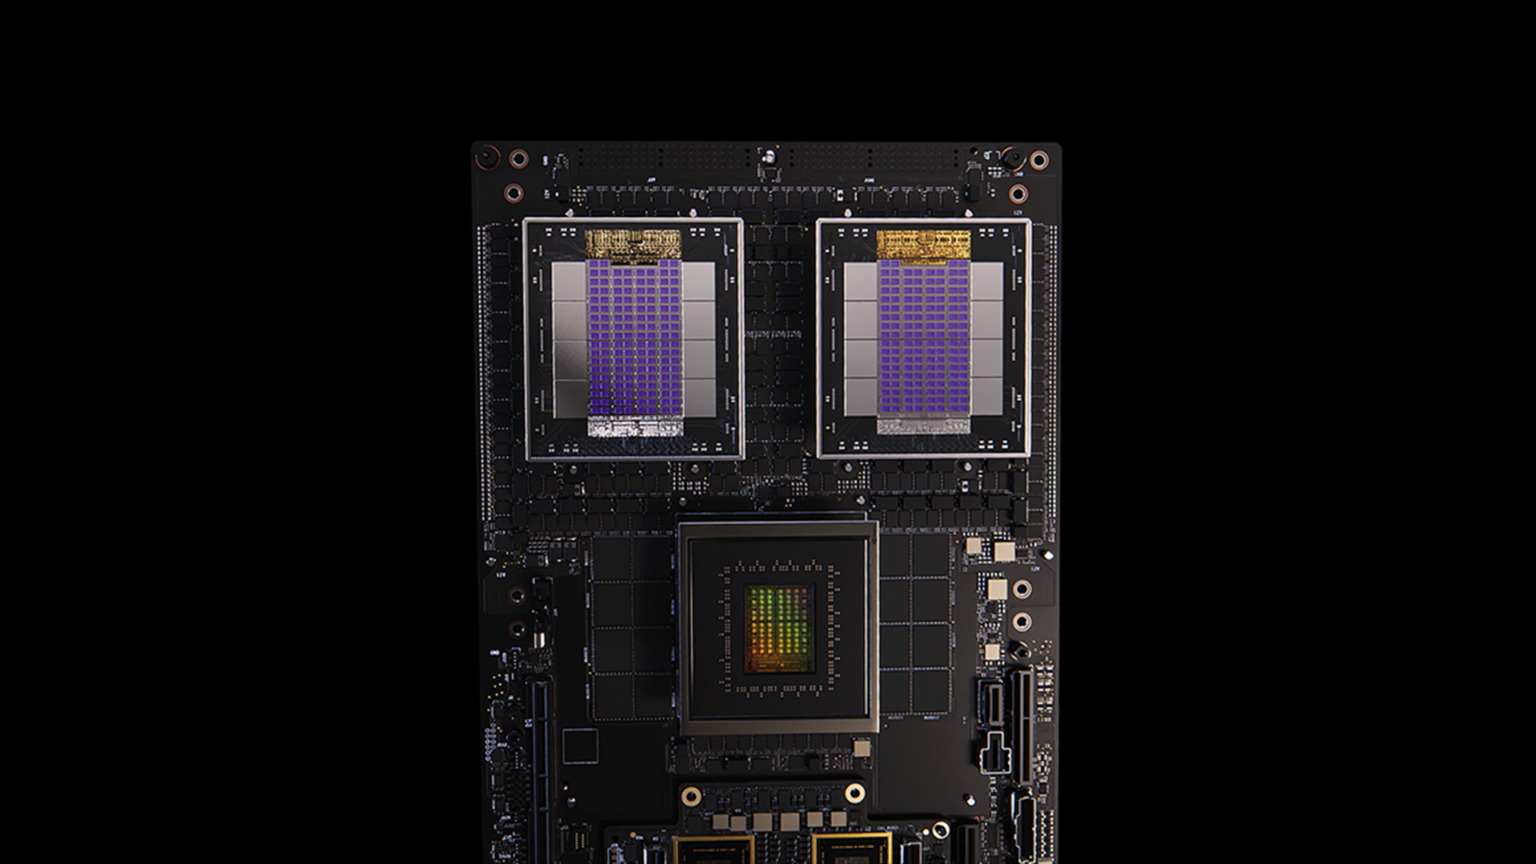
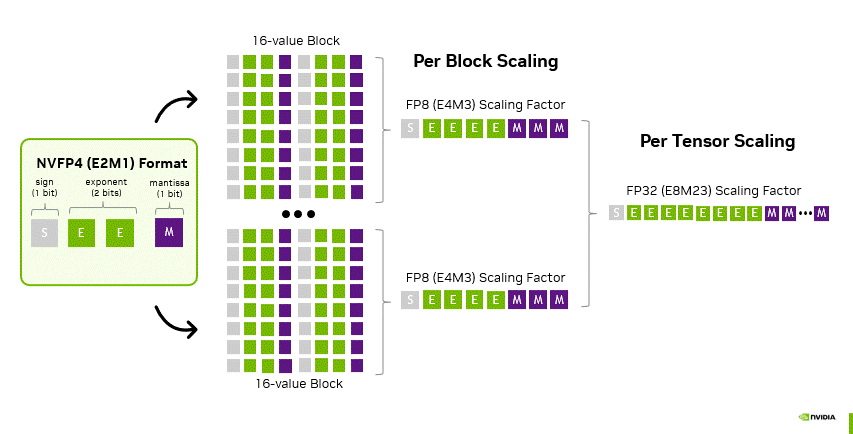
Niet elke workload begint op hyperschaal. DGX Spark , aangedreven door de nieuwe GB10 Superchip, comprimeert Blackwell Tensor Cores, NVFP4 (4-bits floating-point) inferentie en alle CUDA-X-bibliotheken in een compacte behuizing. Ontwikkelaars trainen, finetunen en RAG-componeren lokaal, waarna identieke containers eenvoudigweg kunnen worden overgezet naar GB200- of GB300 NVL72-racks wanneer de workloads volwassen zijn.
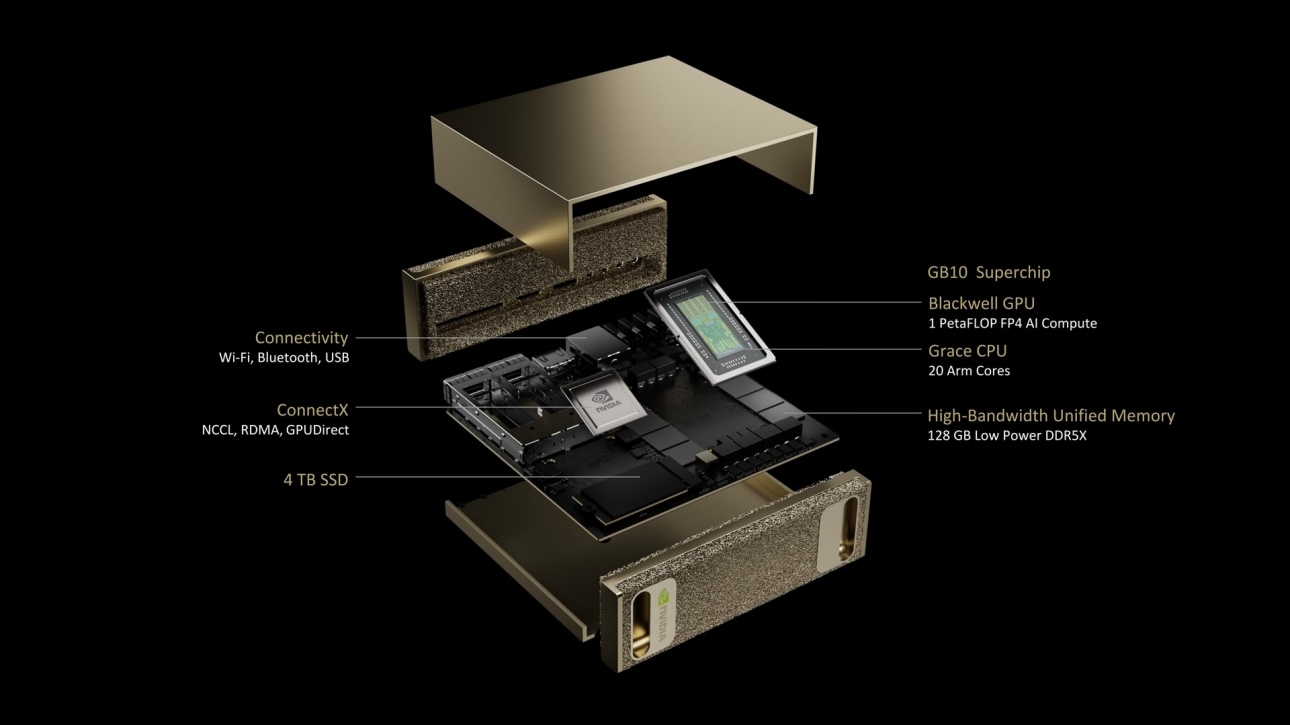
Dat continuüm stelt bedrijven in staat om agentische AI, roboticaperceptie of multimodale generatieve taken te testen zonder clusterslots te blokkeren. Voor de praktijk is Spark een Trojaans paard: plaats er een in een klantlab, laat hun onderzoekers 4-bits inferentiesnelheden zelf zien, en uitbreidingen volgen.
De softwarevermenigvuldiger: TensorRT-LLM, Dynamo en NIM Microservices
Hardware-interconnecties bepalen plafonds; software bepaalt hoe dicht de werkelijke workloads bij elkaar komen. NVIDIA demonstreert TensorRT-LLM met het GPT-OSS-model met 120 miljard parameters in NVFP4, met vier keer zoveel interactiviteit als de standaard TorchServe in lange contexten. Op GB200-racks realiseert DeepSeek-R1 met 671 B een 2.5x hogere doorvoer per GPU met Dynamo's disaggregated pipeline scheduler, zonder de kosten per query te verhogen. Dit alles wordt geleverd als NIM-microservices: gecontaineriseerde endpoints die in Kubernetes-clusters of on-premises bare-metal stacks kunnen worden geplaatst.
Open source vormt de basis van de stack. RAPIDS versnelt ETL end-to-end op GPU's; CUTLASS-templates maken aangepaste high-performance kernels mogelijk; NeMo en BioNeMo breiden PyTorch uit voor grensverleggende LLM- en eiwitvouwtraining, terwijl ze 100 procent OSS blijven. De boodschap aan kopers die op hun hoede zijn voor lock-in: NVIDIA is "open waar het ertoe doet, geoptimaliseerd waar het telt."
Concurrentiële en commerciële implicaties
NVIDIA heeft een unieke positie in het technologielandschap verworven door zijn verticaal geïntegreerde aanpak, met name in tegenstelling tot leveranciers van commerciële siliciumswitches en startups die zich richten op losse accelerators. Deze strategie stelt NVIDIA in staat om niet alleen losse componenten aan te bieden, maar ook complete oplossingen die een referentiearchitectuur omvatten. Deze architectuur wordt ondersteund door een bewezen toeleveringsketen, een duidelijk gedefinieerde roadmap voor twee jaar en een geavanceerd API-platform, beter bekend als NIM, dat de complexiteit van bedrading voor ontwikkelaars vereenvoudigt.
Voor hyperscalers zijn de aanbiedingen van NVIDIA aantrekkelijk vanwege de nadruk op deterministische Service Level Agreements (SLA's) en minimale operationele risico's. Door NVLink-racks te implementeren, kunnen deze organisaties hoogwaardige inferentiemogelijkheden realiseren, die essentieel zijn voor toepassingen die snelle gegevensverwerking vereisen. Bovendien vergemakkelijkt de Spectrum-X-technologie de schaalvergroting van de capaciteit, waardoor hyperscalers hun infrastructuur naadloos kunnen uitbreiden. De introductie van Spectrum-XGS maakt federatie van regio's mogelijk, wat de efficiëntie van de resourcetoewijzing over geografisch verspreide datacenters verbetert. Deze integratie ondersteunt de werking van standaard Ethernet-besturingsvlakken, wat zorgt voor compatibiliteit en eenvoudig beheer binnen de bestaande infrastructuur.
Voor bedrijven ligt de aantrekkingskracht van NVIDIA's technologie in het vermogen om de omzet per rack te maximaliseren. Het Spectrum-X-systeem verbetert bijvoorbeeld de effectiviteit van GPU-cycli aanzienlijk – naar verluidt met wel 35 procent. Dit betekent dat bedrijven een hogere output kunnen behalen, of het nu gaat om tokens, images of geautomatiseerde acties, zonder de kapitaaluitgaven te verhogen. Hierdoor kunnen bedrijven meer waarde halen uit hun bestaande investeringen en zo inspelen op de hedendaagse behoeften aan efficiëntie en kosteneffectiviteit in een concurrerende markt.
The Bottom Line
Het verhaal rond Hot Chips duidt op een opmerkelijke verschuiving in het landschap van computertechnologie, met name in relatie tot kunstmatige intelligentie (AI). Het benadrukt dat netwerken nu worden beschouwd als een fundamentele versneller in de computertechnologie, vergelijkbaar in belang met ontwikkelingen zoals tensorcores.
Technologieën zoals NVLink zijn cruciaal omdat ze een serverrack transformeren tot een samenhangende logische chip, wat de prestaties en efficiëntie verbetert. Spectrum-X speelt een cruciale rol bij het faciliteren van submilliseconde-collectieven over uitgebreide netwerken, terwijl Spectrum-XGS deze hoogwaardige infrastructuur wereldwijd uitbreidt. Daarnaast is CPO ontworpen om te garanderen dat de stroom- en dichtheidsvereisten toekomstbestendig zijn en inspelen op de veranderende eisen van AI-toepassingen. DGX Spark speelt daarentegen een cruciale rol bij het bevorderen van de acceptatie van deze technologieën en moedigt bedrijven aan om innovatieve oplossingen te omarmen.
Gezamenlijk hebben deze ontwikkelingen de potentie om de economische dynamiek van zowel inferentie- als trainingsprocessen te veranderen. Dit is met name relevant nu bedrijven zich op een kruispunt bevinden en hun opties afwegen tussen het bouwen van nieuwe infrastructuur, het huren van bestaande oplossingen of het uitstellen van investeringen in grootschalige AI-mogelijkheden. NVIDIA's standpunt is ondubbelzinnig: organisaties moeten investeren in de ontwikkeling van hun eigen infrastructuur, maar met de nadruk op een netwerkframework dat zorgvuldig is ontworpen – van de koperen ruggengraat tot de fotonische switch – om het aanstaande tijdperk van AI-gestuurde fabrieken te ondersteunen.


 Amazon