

VAST Data heeft de samenwerking met AMD uitgebreid op het gebied van AI-infrastructuur voor cloudproviders en bedrijven die AI-diensten inzetten voor training, inferentie, retrieval-augmented generation en agentische AI. Deze samenwerking combineert het VAST AI Operating System met 6e generatie AMD EPYC-processors , AMD Instinct GPU's, AMD-netwerkhardware en ROCm-software.
De samenwerking weerspiegelt een bredere verschuiving in de infrastructuur, van AI-clusters die zich richten op training naar omgevingen die ook persistente context, inferentie met hoge gelijktijdigheid en workflows met meerdere agentstappen moeten ondersteunen. Deze implementaties leggen meer nadruk op dataverplaatsing, KV-cachebeheer, GPU-gebruik en de mogelijkheid om toegang met lage latentie te bieden tot grote datasets met modellen en contextgegevens.
VAST positioneert zijn Disaggregated Shared Everything (DASE )-architectuur als de gedeelde datalaag voor deze omgevingen. Het platform combineert bestands- en objectopslag, databases, eventstreaming en datadiensten onder een uniforme, wereldwijde naamruimte. Het biedt tevens mogelijkheden voor multi-tenancy en workloadisolatie voor AI-clouds die gelijktijdig klant- en applicatieworkloads verwerken.
EPYC 9006-platforms voor VAST CBox- en EBox-systemen
VAST heeft de 6e generatie AMD EPYC-processors, voorheen bekend onder de codenaam Venice, geselecteerd voor zijn volgende generatie CBox- en EBox-platforms. Het bedrijf is van plan de processors te gebruiken in zijn zesde generatie CBox- en derde generatie EBox-systemen, die de basis vormen voor het VAST AI-besturingssysteem.
De ondersteuning voor AMD EPYC 9006 introduceert PCIe Gen6-connectiviteit in het VAST-hardwareplatform. VAST stelt dat de nieuwe interface de I/O-bandbreedte verdubbelt ten opzichte van de vorige generatie, waardoor de doorvoer van bestands- en objectopslag verbetert en de latentie voor datadiensten zoals databases, datawarehouses en eventstreaming-workloads die via VAST DataBase en DataEngine worden geleverd, wordt verlaagd.
Voor AI-infrastructuur kan een hogere I/O-bandbreedte knelpunten tussen rekenkracht, netwerk en NVMe-opslagbronnen helpen verminderen. Dit is met name relevant voor het laden van modellen, ophaalpipelines, toegang tot checkpoints en workflows met externe KV-caches, waar de GPU-geheugencapaciteit alleen onvoldoende is om de actieve context te behouden.
Referentiearchitectuur combineert Helios, VAST en DriveNets
VAST, AMD en DriveNets ontwikkelen ook een referentiearchitectuur voor AI-infrastructuur, gebouwd rondom de AMD Helios rack-scale AI-infrastructuur, het VAST AI-besturingssysteem en het DriveNets AI Fabric-netwerk.

De referentiearchitectuur is bedoeld als richtlijn voor de implementatie van workloads voor modeltraining, inferentie, reinforcement learning en KV-cache. Het omvat overwegingen met betrekking tot dimensionering en beschikbaarheid voor organisaties die AI-fabrieken bouwen die een gedeelde data-infrastructuur en krachtige netwerken naast GPU-computing vereisen.
VAST noemde ook de uitgebreide samenwerking met inferentiesoftwareleveranciers TensorMesh en EmbeddedLLM. De inspanningen binnen het ecosysteem zijn gericht op productieklare inferentiearchitecturen voor agentische AI-toepassingen, hoewel specifieke productintegraties en beschikbaarheidsdetails niet werden bekendgemaakt.
KV Cache Offload is gericht op inferentie bij hoge gelijktijdigheid.
Een belangrijk onderdeel van de aankondiging is de uitgebreide ondersteuning voor KV-cache met behulp van AMD Instinct GPU 's, AMD Infinity Context, ROCm-software en het VAST AI-besturingssysteem.
De KV-cache slaat tussentijdse informatie over de aandachtstoestand op die tijdens de inferentie wordt gegenereerd. Het bewaren van deze gegevens verbetert de prestaties bij interacties die meerdere beurten duren en bij workloads met een lange context, maar een grote cache kan aanzienlijk GPU-geheugen in beslag nemen. Door de KV-cache te externaliseren of te verdelen over een krachtig opslagplatform kan GPU-geheugen vrijkomen voor actieve workloads, terwijl de context voor latere inferentieverzoeken behouden blijft.
VAST meldde dat vroege tests met een AMD Instinct MI355X GPU een negenvoudige verbetering lieten zien in de tijd tot het eerste token en een 9.7 keer hogere tokendoorvoer bij gebruik van VAST voor KV-cache-offload in AI-workloads met hoge gelijktijdigheid. Het bedrijf merkte op dat deze resultaten afhankelijk zijn van de hardware, de kenmerken van de workload en de opslagconfiguratie.
De integratie past ook VAST-levenscyclusbeleid toe op KV-cachegegevens. Deze functionaliteit is bedoeld om automatisch gecachede informatie te laten verlopen en te verwijderen, wat relevant is wanneer de inferentiecontext gevoelige, persoonlijke of gereguleerde gegevens bevat.
Pensando Pollara 400 verbindt GPU's met gedeelde opslag.
De architectuur maakt gebruik van de AMD Pensando Pollara 400 AI NIC om AMD Instinct GPU's te verbinden met het VAST-opslagcluster. Volgens VAST ondersteunt de NIC de overdracht van GPU-naar-opslaggegevens via NFS over TCP en RDMA, waardoor toegang mogelijk is tot op NVMe SSD's gebaseerde VAST-clusters voor KV-cache en bredere inferentiegegevens.
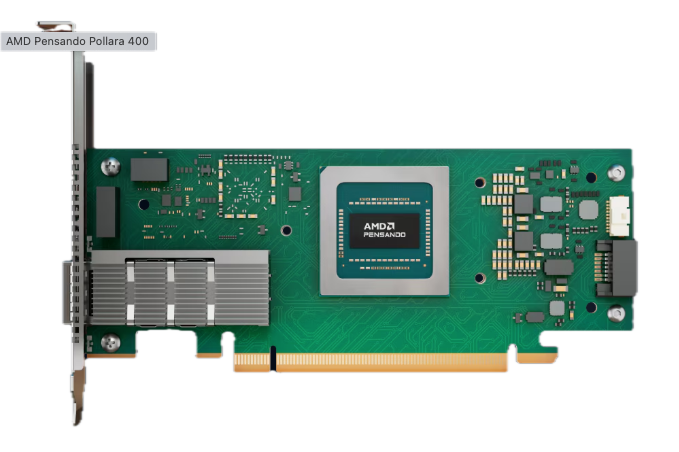
Het resulterende ontwerp is bedoeld ter ondersteuning van AI-omgevingen die contextbeheer onafhankelijk van GPU-geheugen moeten kunnen schalen. In plaats van opslag als een aparte persistentielaag te beschouwen, positioneert VAST het platform als een data- en uitvoeringslaag die modellen, databases, streaming data, bestandsdata en AI-context kan beheren in gedistribueerde infrastructuren.
Voor AI-cloudproviders is deze aanpak gericht op een hogere benutting van GPU's en een verbeterde operationele efficiëntie, naarmate implementaties verder gaan dan GPU-verhuur en batchtraining en zich richten op persistente inferentie en agentische AI-diensten.


 Amazon