

Als u StorageReview regelmatig volgt, heeft u het artikel over de OSU Ocean Study wellicht al live gezien . We spraken met Chris Sullivan, directeur Onderzoek en Academische Computering aan de Oregon State University, om beter te begrijpen hoe technologie onderzoekers helpt bij het bestuderen van het leven in de oceaan en welke impact dat heeft op het wereldwijde milieu.
Brian ontmoette Chris op SC25 om het onderwerp verder te bespreken. Het is zeldzaam dat we schrijven over hoe technologie wordt gebruikt in praktijksituaties zoals het planktononderzoek van OSU, dus dit artikel en de podcast gaven ons die kans.
Terwijl Brian en Chris het onderzoek bespreken dat aan de OSU wordt uitgevoerd, is er oprechte enthousiasme over hoe de technologie zich ontwikkelt ter ondersteuning van lopende oceanografische studies. Chris werkt al meer dan 24 jaar bij de Oregon State University en is de afgelopen drie jaar directeur van biocomputing geweest.
Deze live podcast laat Chris' enthousiasme voor wetenschap en technologie zien. Hij noemde SC25 "een snoepparadijs".
Dit is een levendige en openhartige discussie (met een vleugje humor) die waardevolle inzichten biedt in hoe onderzoek technologie inzet om realtime resultaten te leveren.
Het is een korte podcast die zeker de moeite waard is om te beluisteren, maar als je weinig tijd hebt, hebben we een transcriptie toegevoegd waarmee je direct naar de meest relevante gedeeltes kunt springen.
0:00 - 5:00
Een onderzoeksschip ombouwen tot een drijvende supercomputer
Chris Sullivan van Oregon State University legt uit hoe nieuwe technologie de manier waarop oceaanonderzoek wordt uitgevoerd fundamenteel verandert, met name grootschalige planktonstudies die worden uitgevoerd vanaf schepen die in feite kleine, drijvende datacenters zijn.
- Technologie is niet zomaar "coole gadgets"; het verandert direct dingen. wat de wetenschap mogelijk maakt en de mate van vertekening in de resultaten.
- Wetenschappelijke vertekening: beperkte of vertekende steekproeven die leiden tot onnauwkeurige conclusies; de oplossing is meer gegevenspunten op meer locaties.
- Doel: Het verzamelen van enorme, diverse datasets, zodat statistische analyses niet worden vertekend door het bemonsteren van slechts één locatie of één reeks omstandigheden.
- Traditionele HPC-configuraties dwongen tot een compromis: snelle lokale NVMe/SSD's met beperkte capaciteit versus grote maar tragere centrale opslagsystemen.
- Voor grootschalige experimenten moest Chris gebruikmaken van de eerstelijnsopslag in het hele cluster, omdat de lokale opslag (nulniveau) te klein was voor de enorme datasets.
- Grote, gedeelde opslag-"superpods" werden noodzakelijk om de GPU's van stroom te voorzien, maar ze zijn duur en niet realistisch om in het veld of op zee in te zetten.
5:00 - 10:00
Oceaanrobots, plankton en een cruise van een miljoen dollar
In dit gedeelte wordt dieper ingegaan op wat er zich daadwerkelijk aan boord van het schip afspeelt: hoe instrumenten worden gesleept, hoe enorme hoeveelheden beeldgegevens worden vastgelegd en waarom semi-realtime verwerking cruciaal is wanneer de kosten van de scheepstijd ongeveer $1 miljoen per tiendaagse cruise bedragen.
- Het nieuwe, door de NSF gesteunde onderzoeksschip is gebouwd als een "mini-Star Trek Enterprise", volgestouwd met technologie en zo'n 200 kilometer aan bekabeling op een boot van 200 meter.
- Eerder moest Chris zijn het te bezitten. Computerhardware aan boord van het schip plaatsen, glasvezelkabels door gangen leggen en werken zonder een degelijk datacenter aan boord.
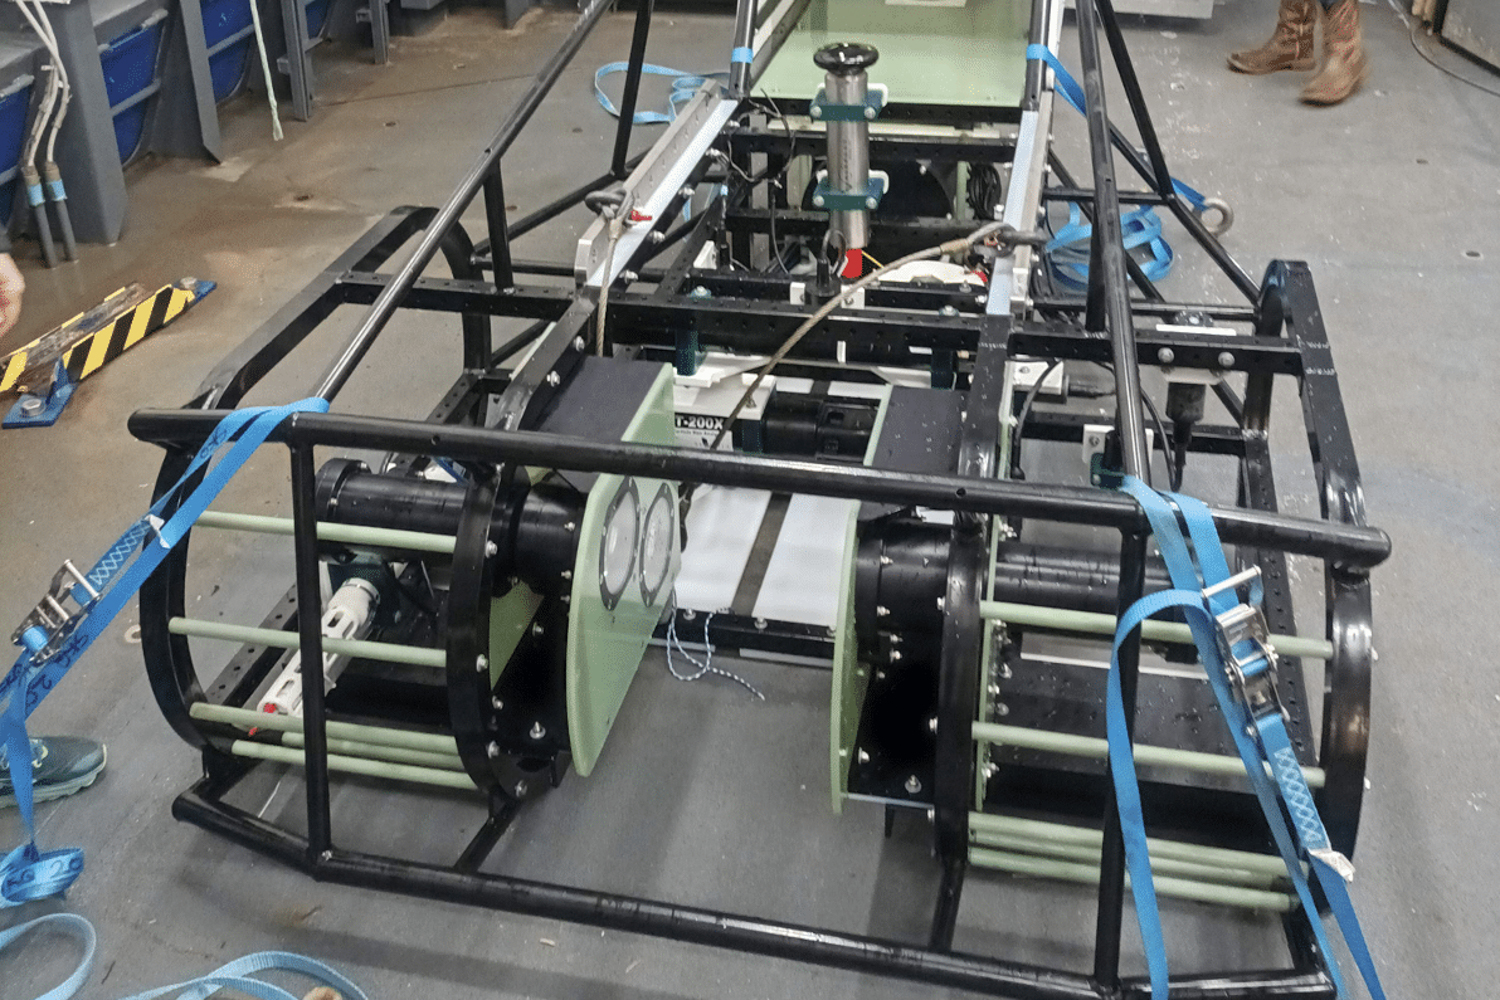
- Het planktonsysteem: een gesleept apparaat beweegt met een snelheid van 5 knopen op en neer door het water, waarbij ongeveer 162 liter water per seconde wordt verplaatst en ongeveer 10 GB aan beeldgegevens wordt gegenereerd. vers water .
- Een enkel planktonexperiment van 10 dagen: ~100 TB aan ruwe data; na verwerking, segmentatie en classificatie groeit dat aan tot ~300-400 TB aan bruikbare data.
- Ze moeten dit vrijwel in realtime verwerken; anders zou een cruise van 1 miljoen dollar die 10 dagen duurt, kunnen terugkeren met slechte of nutteloze gegevens en zonder de mogelijkheid om het schip om te leiden.
- Plankton is grotendeels overgeleverd aan de stromingen (het zijn geen sterke zwemmers), maar toch is het cruciaal: het produceert ongeveer 50% van de zuurstof op aarde, ongeveer 25% van de koolstofopslag, ongeveer 17% van het wereldwijde voedsel per hoofd van de bevolking en vormt de basis van het mariene voedselweb.
10:00 - 15:00
Edge AI op zee en in het bos.
De focus verschuift van het schip naar het bredere "randprobleem": hoe kunnen we de computerkracht dichter bij de plek brengen waar data wordt gegenereerd – op boten, in rangerstations en in bossen vol autonome sensoren.
- Nieuwe, krachtige SSD-systemen stellen hen in staat een systeem te bouwen. waar Tier nul op één apparaat: honderden TB aan data opslaan, in semi-realtime verwerken en nooit meer verplaatsen.
- Eerdere tests met kleinere NVMe-schijven vereisten constante offloading om ruimte vrij te maken, wat kostbare IO-bandbreedte verbruikte en het onderzoek vertraagde.
- Er is in principe geen speciaal IT-personeel aan boord van het schip; één persoon beheert de scheepssystemen en houdt zich afzijdig van de experimenten, dus promovendi en postdocs moeten zelf de hardware en dataverwerking beheren.
- Dit leidt tot een ontwerpeis: eenvoudige, robuuste pipelines en op zichzelf staande apparaten – geen kwetsbaar web van arrays, mounts en volumes.
- Aan de bosrand (bijvoorbeeld bij het Uilenproject) zetten ze zo'n 5,000 autonome opname-eenheden in en kunnen ze ongeveer 130 vogelsoorten uitsluitend op basis van geluid identificeren.
- Het pijnpunt: mensen moeten nog steeds SD-kaarten ophalen; tegen de tijd dat de data terug is, is veel van de tijdswaarde verloren gegaan. Edge processing is erop gericht om inzichten te extraheren. per direct op het moment van de vangst.
15:00 - 20:00
De juiste GPU's en opslag afstemmen op de taak
Hier leggen ze de GPU-strategie, Omniverse-gebaseerde training en de reden waarom flashgeheugen met grote capaciteit net zo belangrijk is als pure rekenkracht voor AI en wetenschappelijke visualisatie uit.
- Chris benadrukt het gebruik van de gepast De GPU is het meest geschikt voor de taak: grote, dure accelerators (bijv. H100/Hopper, "grasshoppers") moeten zich richten op training, terwijl meer kosteneffectieve kaarten zoals de RTX 6000 de inferentie op grote schaal afhandelen.
- Historisch gezien heerste er verwarring: te veel overlappende GPU-SKU's, onduidelijke "swim lanes" en veel geld verspild aan overbodige hardware voor simpele inferentie.
- RTX 6000-kaarten vervullen een dubbele rol: hoogwaardige inferentieprestaties plus grafische en renderingmogelijkheden die GPU's die uitsluitend voor datacenters bedoeld zijn, missen.
- Ze bouwen een digitale tweeling van het schip in het Omniverse om:
- Train studenten en postdocs virtueel terwijl het schip op zee is.
- Plan de fysieke indeling en het laden van apparatuur in krappe, bewegende ruimtes.
- Verspil geen kostbare scheepstijd aan basistrainingen en proefondervindelijke instellingen.
- Op een bewegend schip vormt alles met bewegende onderdelen een risico; solid-state opslag heeft de voorkeur vanwege de betrouwbaarheid en duurzaamheid.
- SSD's met een hoge capaciteit en een laag stroomverbruik maken energie vrij voor meer GPU's, verminderen de behoefte aan aparte arrays en verkleinen de totale hardwareomvang.
20:00 - 25:00
Van archiefkasten tot met glasvezel verbonden oceanen
Als we het grotere plaatje bekijken, zien we hoe goedkope opslag de weg vrijmaakte voor moderne AI, hoe oceanografische observatoria gegevens naar de kust streamen en waarom netwerk en opslag samen nieuwe vormen van wetenschap mogelijk maken.
- Chris betoogt dat de echte doorbraak van AI niet in nieuwe wiskunde lag – de meeste modellen dateren uit de jaren 1950-70 – maar in de goedkope harde schijf in de jaren negentig, toen gegevens van archiefkasten werden overgezet naar doorzoekbare, computergestuurde media.
- In het "tijdperk van de archiefkasten" hadden ze weliswaar enorm veel data, maar waren ze "informatiearm"—er was geen zoekfunctie, geen redundantie en geen schaalbare verwerking.
- Er is altijd een wapenwedstrijd geweest tussen verwerkingssnelheid en beschikbaarheid van data; SSD's met grote capaciteit verschuiven de balans nu opnieuw door moderne GPU's van veel meer data te voorzien.
- Oregon State is de belangrijkste ontwikkelaar van de cyberinfrastructuur voor het Ocean Observatories Initiative (OOI), een project van de NSF en WHOI ter waarde van een miljard dollar, dat gebruikmaakt van zweefvliegtuigen, boeien en onderzeese meetapparatuur om oceaangegevens te streamen.
- Ze bewaren zo'n 9 PB aan OOI-gegevens, met een glasvezelbackbone die via Link Oregon is opgewaardeerd van 200 Gbps naar 400 Gbps, waardoor realtime gegevensoverdracht van de oceaan naar het datacenter mogelijk is.
- Zelfs met Starlink aan boord van het schip en bij projecten op het land (zoals het onderzoek naar uilen), beperken de bandbreedte en de kosten van de satelliet de hoeveelheid gegevens die verzonden kan worden. Daarom testen ze LoRaWAN en andere mesh-netwerken om gegevens terug te sturen naar één enkel, met Starlink verbonden rangerstation.
25:00 - 27:52
Lessen voor bedrijven: uw datacenter is nu de rand van het netwerk.
Het gesprek wordt afgesloten met het vertalen van deze onderzoeksresultaten naar bedrijven en het benadrukken van de hardware die Chris van de beursvloer zou "stelen".
- Kernboodschap aan bedrijven: als u geen lokale verwerking toepast, verspilt u tijd en arbeid aan het heen en weer transporteren van ruwe data. En mist u realtime kansen.
- Edge AI en agents moeten lokaal voorverwerking, filtering en analyse uitvoeren om menselijke inspanningen te verleggen van logistiek naar taken met een hogere toegevoegde waarde en besluitvorming.
- Analogieën uit de praktijk:
- De detailhandel gebruikt edge analytics in winkels om bezoekersaantallen te volgen, aanbevelingen te doen en dynamische ervaringen te bieden, net zoals de bosbouw edge inference gebruikt om bedreigde diersoorten te beschermen en tegelijkertijd houtkap mogelijk te maken.
- De visserij wil "slimme vallen" en boeien, zodat ze alleen boten uitzenden als er daadwerkelijk krabben in de vallen zitten.
- Voor Chris is het ideale model datacenters op locatie die vervolgens worden rand Faciliteiten die geïntegreerd zijn met de cloud voor grootschalige trainingssessies en langdurige projecten.
- Favoriete hardware van de beurs: Dell's PowerEdge 7745; hij wil er meer van voor VR-labs en implementaties in het veld, omdat ze de juiste balans bieden tussen vermogen en formaat, flexibiliteit en mogelijkheden (rendering + inferentie + edge-werk).
- Hij ziet systemen zoals de 7745 als het voorbeeld: flexibel genoeg om te functioneren in een datacenter of in zware veldomstandigheden, en geschikt voor zowel traditionele HPC als geavanceerde AI/visualisatie aan de rand van het netwerk.


 Amazon