

Sommige servers breiden uit wat er al is, terwijl andere de verwachtingen bijstellen. De Dell PowerEdge R7725xd behoort tot de tweede categorie. In onze recente tests, geconfigureerd met 24 Micron 9550 PRO PCIe Gen5 NVMe SSD's en vier 2x 200GbE NIC's, behaalde deze 2U-server een hogere ruwe opslagdoorvoer dan elk systeem dat we eerder hebben gemeten. Intern voldeed het platform aan meer dan 300 GB/s via de NVMe-pool. Via het netwerk leverde het 160 GB/s met behulp van standaard RDMA, zonder extra complexiteit.
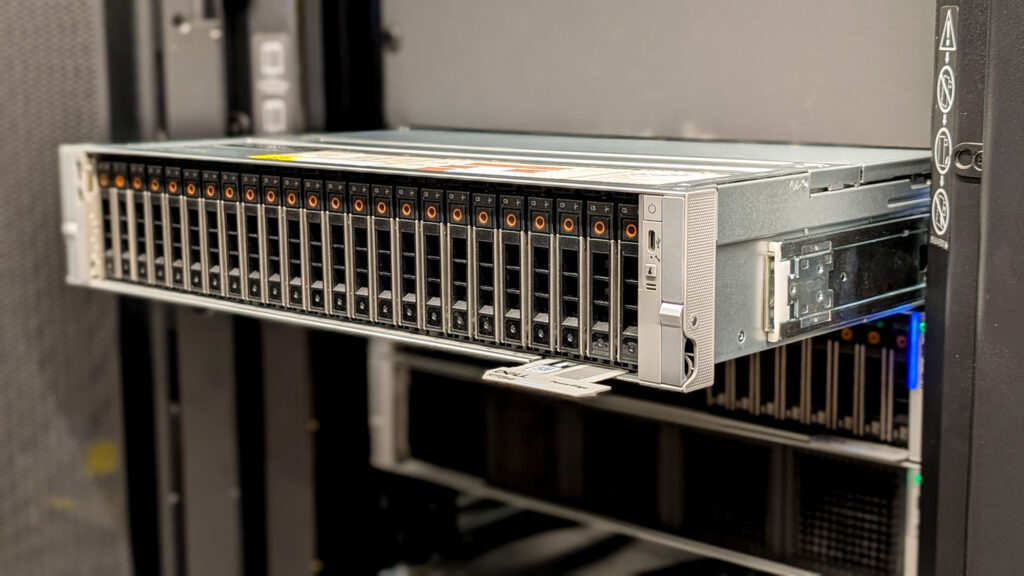
Dit is niet zomaar een snellere opslagserver. Het is een systeem dat de architectuur van data-intensieve computing verandert. Moderne AI-training en inferentiepijplijnen worden vaak niet beperkt door GPU-vermogen, maar door de snelheid waarmee data kan worden gestaged, gestreamd, geschud en gecontroleerd. Grote GPU-knooppunten blijven ongebruikt als de opslagcapaciteit het niet aankan. Teams pakken deze beperkingen aan door caches, overdimensionering en complexe tiering te gebruiken om ervoor te zorgen dat accelerators data snel genoeg ontvangen om hun kosten te rechtvaardigen.
De Dell PowerEdge R7725xd pakt de bottleneck bij de bron aan. De server is opgebouwd rond een U.2-backplane met 24 bays, waarbij elke schijf een eigen PCIe Gen5 x4-verbinding rechtstreeks naar het AMD EPYC CPU-complex heeft. Er is geen bandbreedte-fanout en er wordt geen midplane-expander gebruikt om gelijktijdigheid te verminderen. De prestaties schalen soepel omdat de hardware is ontworpen om de doorvoer te aggregeren zonder conflicten. In een traditionele configuratie met 2 sockets zijn de CPU's verbonden door 4 XGMI-verbindingen voor communicatie tussen sockets. In de R7725xd is één van deze verbindingen omgebouwd voor 16 extra PCIe Gen5-lanes per CPU, waardoor de server in totaal 160 PCIe Gen5-lanes heeft (96 voor de SSD's aan de voorzijde en 64 voor de vier PCIe-slots aan de achterzijde). In combinatie met de 9550 PRO SSD's van Micron, die zijn ontworpen voor aanhoudende schrijfwerklasten en een hoge duurzaamheid, wordt het systeem een data-engine met hoge doorvoer die checkpoint-intensieve en continue streaming-werklasten kan ondersteunen.
We hebben PEAK:AIO bovenop deze architectuur gebouwd om parallelle indieningspaden te benutten en de efficiëntie te behouden naarmate de gelijktijdigheid toenam. Het resultaat was niet alleen piekprestaties, maar ook aanhoudende prestaties onder belasting. Het platform kan functioneren als een lokaal uitvoeringsknooppunt voor voorbewerking, training of transformatie, of het kan opslag met hoge bandbreedte bieden over meerdere GPU-systemen via het netwerk. Als u zich avontuurlijk voelt, kunt u beide tegelijkertijd doen.
Key Takeaways
- Ongekende doorvoer in één knooppunt: De R7725xd haalde een interne bandbreedte van meer dan 300 GB/s en 160 GB/s via NVMe-oF RDMA, waarmee hij kon concurreren met multi-node storageclusters in een 2U-behuizing.
- Echte Gen5-architectuur, geen switches, geen fan-out: Alle 24 Micron 9550 PRO SSD's krijgen toegewezen x4 PCIe Gen5-lanes rechtstreeks van het CPU-complex, waardoor lijnsnelheidschaling mogelijk is zonder conflicten.
- Aangedreven door AMD EPYC 9005-serie: Dubbele AMD EPYC 9575F-processors bieden het aantal lanes, de geheugenbandbreedte en de NUMA-topologie die nodig zijn voor continue I/O met hoge gelijktijdigheid.
- Ontworpen voor AI, Analytics en checkpoint-intensieve workloads: Het systeem elimineert de I/O-knelpunten die moderne GPU-pijplijnen blokkeren, waardoor continue gegevenslevering met hoge bandbreedte mogelijk wordt.
- PEAK:AIO ontgrendelt volledige parallelliteit: De softwarestack van PEAK:AIO zorgt ervoor dat wachtrijstructuren verzadigd blijven onder belasting, waardoor bedrijfsprestaties worden geleverd met een aantrekkelijke dollar-per-GB-verhouding.
Speciaal gebouwd voor NVMe-doorvoer
In de nieuwste generatie servers stapte Dell af van het gebruik van PCIe-switches in serverconfiguraties met hoge opslagdichtheid. Modellen zoals de PowerEdge R770 of R7725 bieden PCIe Gen5 x4-bays, die tot 16 SSD-configuraties ondersteunen, en switchen naar x2-bays in configuraties met grotere storage-backplanes. Servers van de vorige generatie, zoals de PowerEdge R760, bevatten een PCIe-switch in NVMe-configuraties met 24 bays. Om builds te vereenvoudigen en de complexiteit van een PCIe-switch weg te nemen, kozen nieuwe servers voor een strategie om het aantal PCIe-lanes in storage-dichte builds te verminderen. Tot de komst van de R7725xd.
Het onderscheid tussen de standaard R7725 en de R7725xd komt neer op de manier waarop de platforms PCIe root-complexe resources toewijzen. De basis R7725 verdeelt PCIe-lanes over opslag, GPU-uitbreiding en algemene I/O. De 'xd'-variant herverdeelt dat budget, zodat het NVMe-subsysteem de primaire gebruiker van PCIe-bandbreedte wordt. De 24 U.2-bays zijn rechtstreeks aangesloten op de PCIe Gen5-roots van de CPU, waarbij elke SSD een eigen x4-eindpunt krijgt, en geen gedeelde uplink die toegankelijk is via een PCIe-switch of re-timer tree. Dit geeft elke schijf onafhankelijke wachtrijstructuren en onafhankelijke DMA-paden terug naar de geheugencontroller.
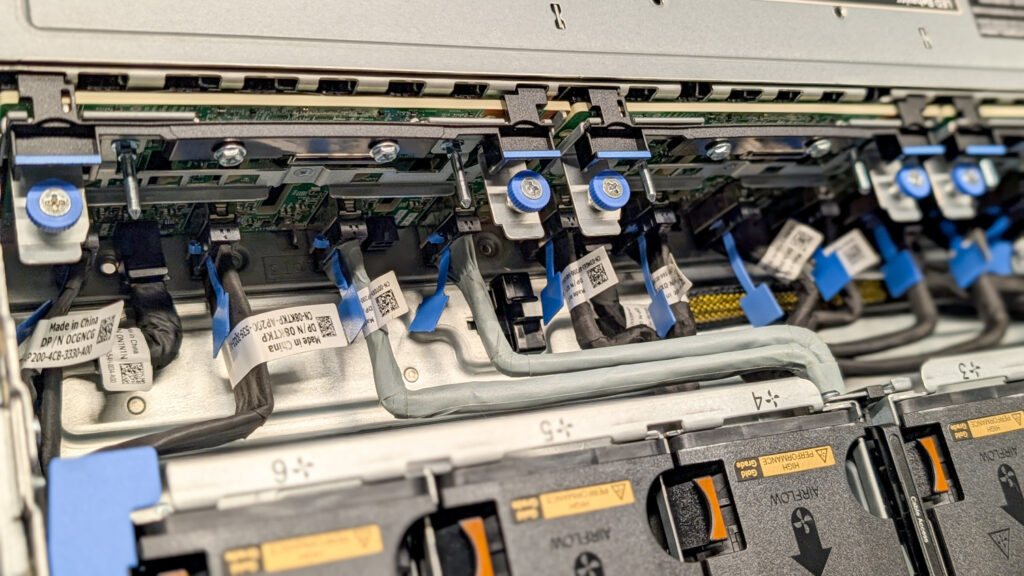
De backplane en riser-topologie weerspiegelen deze toewijding. Dell groepeert de NVMe-connectoren en PCIe-slots over beide AMD EPYC-sockets, zodat elke processor direct eigenaar is van een deel van de schijfset. In de praktijk creëert dit twee symmetrische NVMe-domeinen, elk met lokale latentiekenmerken en volledige lees-/schrijfconcurrentie. Toen we vier Broadcom dual-port 200GbE NIC's als uitbreidingskaarten installeerden, zorgde de plaatsing van de slots ervoor dat elke NIC in een PCIe-domein terechtkwam dat was afgestemd op de bijbehorende NVMe-groep. Onder NVMe-over-RDMA betekende dit dat het netwerkverkeer lokaal bleef ten opzichte van de socket die de bijbehorende schijf-I/O verwerkte, waardoor de Infinity Fabric-hop tussen sockets, die doorgaans latentie toevoegt en bandbreedte verbruikt onder belasting, werd vermeden.
Thermisch gedrag ondersteunt ook een constante doorvoer. U.2 blijft voordelig in compacte Gen5-configuraties omdat het een gedefinieerd luchtstroomkanaal en een voorspelbaar koellichaamoppervlak voor elk apparaat biedt. De ventilatormodules met hoge statische druk en de behuizingsleidingen van de R7725xd zorgen voor een consistente luchtstroom over alle 24 bays, waardoor schrijftaken op volledige schijfcapaciteit continu kunnen worden uitgevoerd zonder vertraging. Het mechanische ontwerp vormt een aanvulling op het elektrische ontwerp: elke schijf kan zijn volledige prestaties behouden omdat het platform is ontworpen om 24 gelijktijdige Gen5-apparaten onder belasting te koelen.
Deze combinatie van root-complex alignment, consistente non-uniform memory access (NUMA) lane-indeling, socket-bewuste NIC-plaatsing en thermisch stabiele U.2-verpakking stelt het systeem in staat om I/O op lijnsnelheid op schaal te realiseren. De architectuur vermijdt knelpunten en optimaliseert de prestaties.
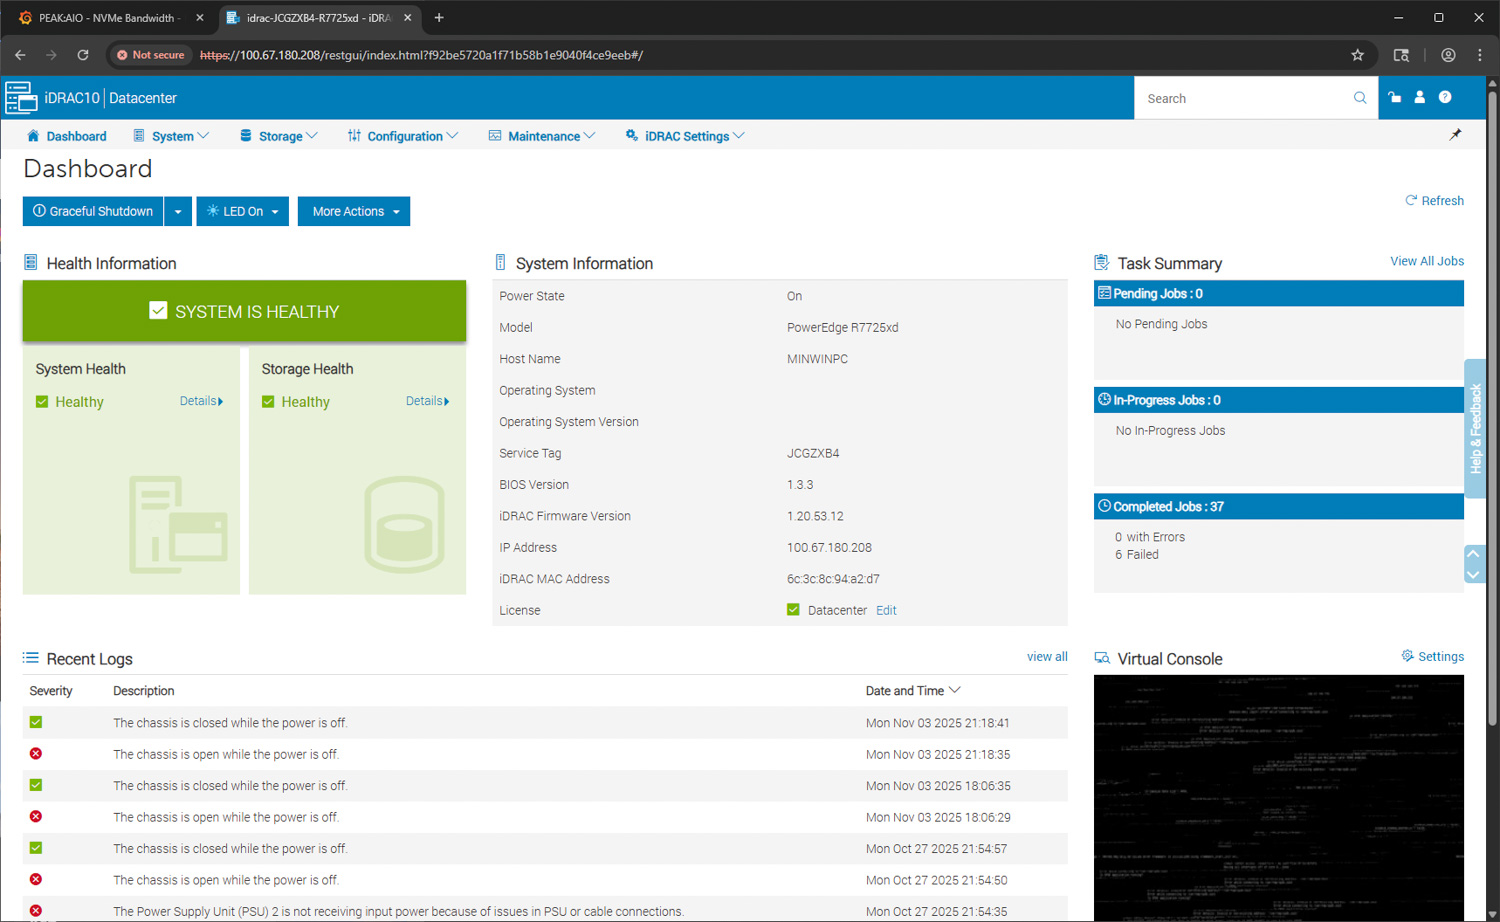
Dell PowerEdge R7725xd iDRAC 10 Overzicht
Deze generatie van de R7725xd is, net als veel andere 17e-generatie platforms die we hebben geëvalueerd, uitgerust met Dells nieuwe iDRAC 10-platform, dat dient als centraal punt voor beheer op afstand, statusbewaking en out-of-band controle. Het dashboard geeft direct een overzicht van de algehele systeemstatus, de opslagstatus en recente activiteit. Voor ons testexemplaar is het rapport over de systeem- en opslagstatus groen, wat bevestigt dat de server normaal functioneert. Belangrijke systeemgegevens zoals model, hostnaam, BIOS-versie, iDRAC-firmwareniveau, IP-adres en licentiegegevens worden rechts in de interface weergegeven.
Het dashboard bevat ook een taakoverzicht dat voltooide, in behandeling zijnde en lopende bewerkingen weergeeft. Daaronder legt een lijst met recente logs chassisintrusiegebeurtenissen en stroomvoorzieningsmeldingen vast, waardoor u snel inzicht krijgt in wijzigingen in de hardwarestatus zonder dat u naar diepere menu's hoeft te navigeren. Het virtuele consolepaneel is rechtsonder beschikbaar voor volledige KVM-bediening op afstand.
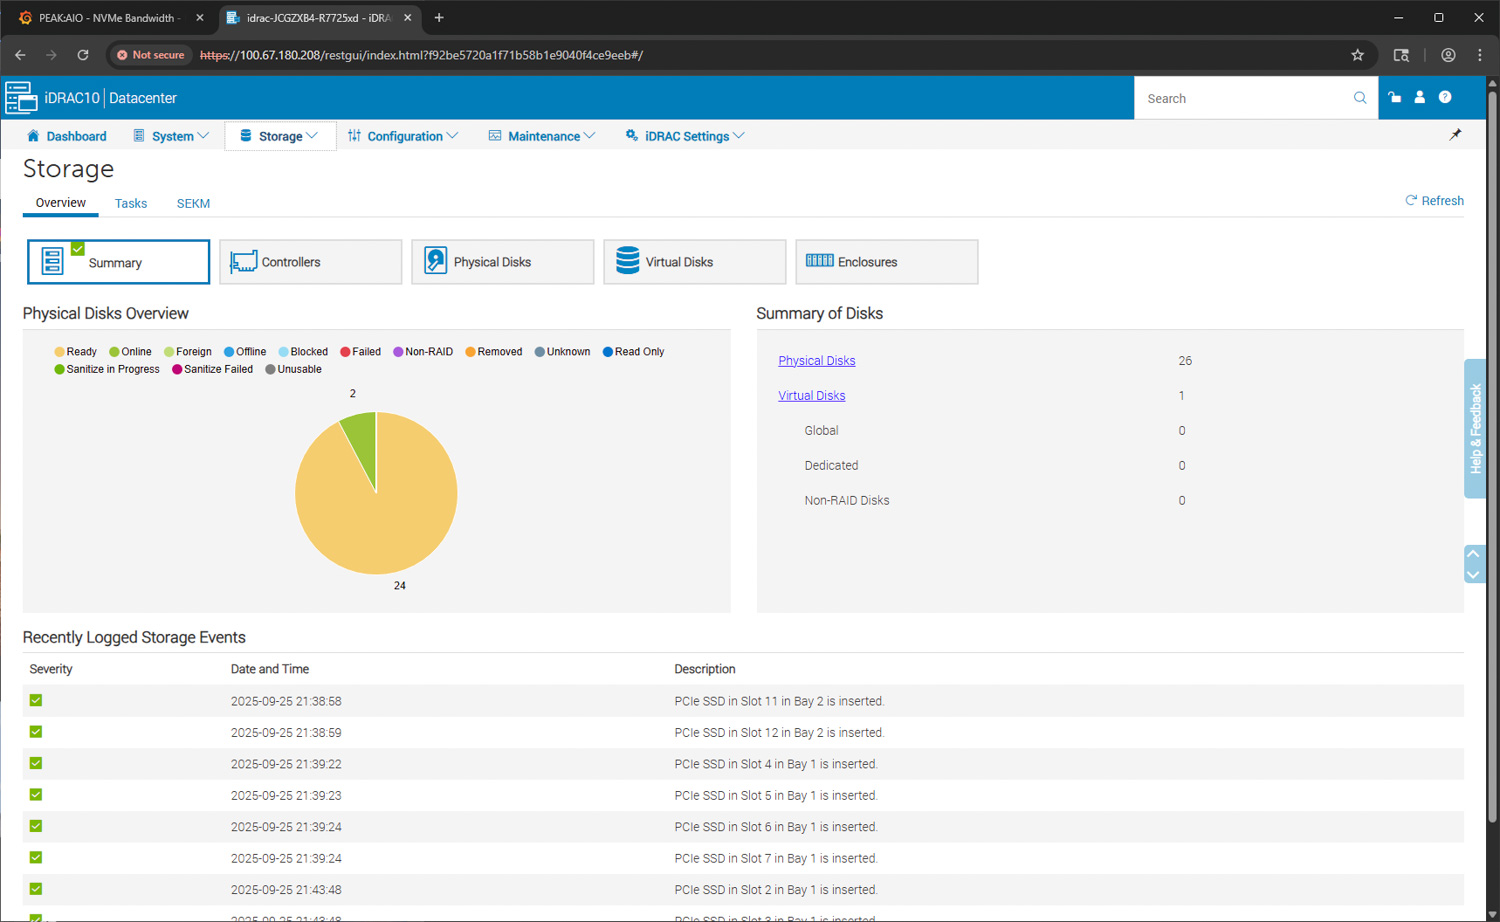
De opslagsectie van iDRAC 10 biedt een compleet overzicht van alle fysieke schijven die in de R7725xd zijn geïnstalleerd. Het overzichtspaneel toont een overzicht van alle aangesloten schijven, vergezeld van een visueel cirkeldiagram dat de schijfstatussen illustreert. In deze configuratie zijn 24 NVMe SSD's actief en rapporteren ze als gereed, met twee extra opstartapparaten in het systeem, los van de primaire NVMe-bank aan de voorzijde.
Rechts geeft het paneel 'Overzicht van schijven' een overzicht van deze schijven, onderverdeeld in fysieke schijven en eventuele bijbehorende virtuele schijven. Omdat de R7725xd een directe NVMe-architectuur zonder traditionele RAID-controllers gebruikt, worden alle schijven gerapporteerd als niet-RAID en individueel adresseerbaar, in lijn met het systeemontwerp voor grote NVMe-pools en SDS-platforms.
Onder het statusoverzicht bevat het gedeelte 'Recent geregistreerde opslaggebeurtenissen' invoeglogboeken voor elke PCIe SSD, geordend per bay en slot. Deze registratie bevestigt de juiste detectie in alle schijfbays en helpt bij het identificeren van problemen met plaatsing, bekabeling of hot-swap-activiteit. Bij grote implementaties zijn deze logboeken handig om de schijfinrichting te volgen of te controleren of de capaciteit zoals verwacht is ingevuld.
De laatste schermafbeelding toont de gedetailleerde weergave van het NVMe-apparaat in iDRAC10. Elke NVMe-schijf die in het systeem is geïnstalleerd, wordt weergegeven met de status, capaciteit en locatie van de schijfsleuf. Door een afzonderlijke schijf te selecteren, wordt een volledig overzicht van de kenmerken ervan geopend.
In dit voorbeeld geeft het informatiepaneel van de schijf de volledige modelreeks, het apparaatprotocol, de vormfactor en de onderhandelde PCIe-instellingen weer. De NVMe-apparaten werken met een verbindingssnelheid van 32 GT/s met een onderhandelde x4-verbinding, wat bevestigt dat de schijven op de volledige bandbreedte op de PCIe Gen5-backplane van het systeem werken. Het informatiegedeelte rapporteert ook het duurzaamheidspercentage, de beschikbare reservestatus en het protocoltype, zodat beheerders de status van de schijf en de verwachte levenscyclus kunnen bewaken.
Deze gedetailleerde schijfrapportage is waardevol in NVMe-configuraties met hoge dichtheid, waarbij de verbindingsbreedte, onderhandelde snelheid en de mediastatus rechtstreeks van invloed zijn op het werklastgedrag en de opslagprestaties.
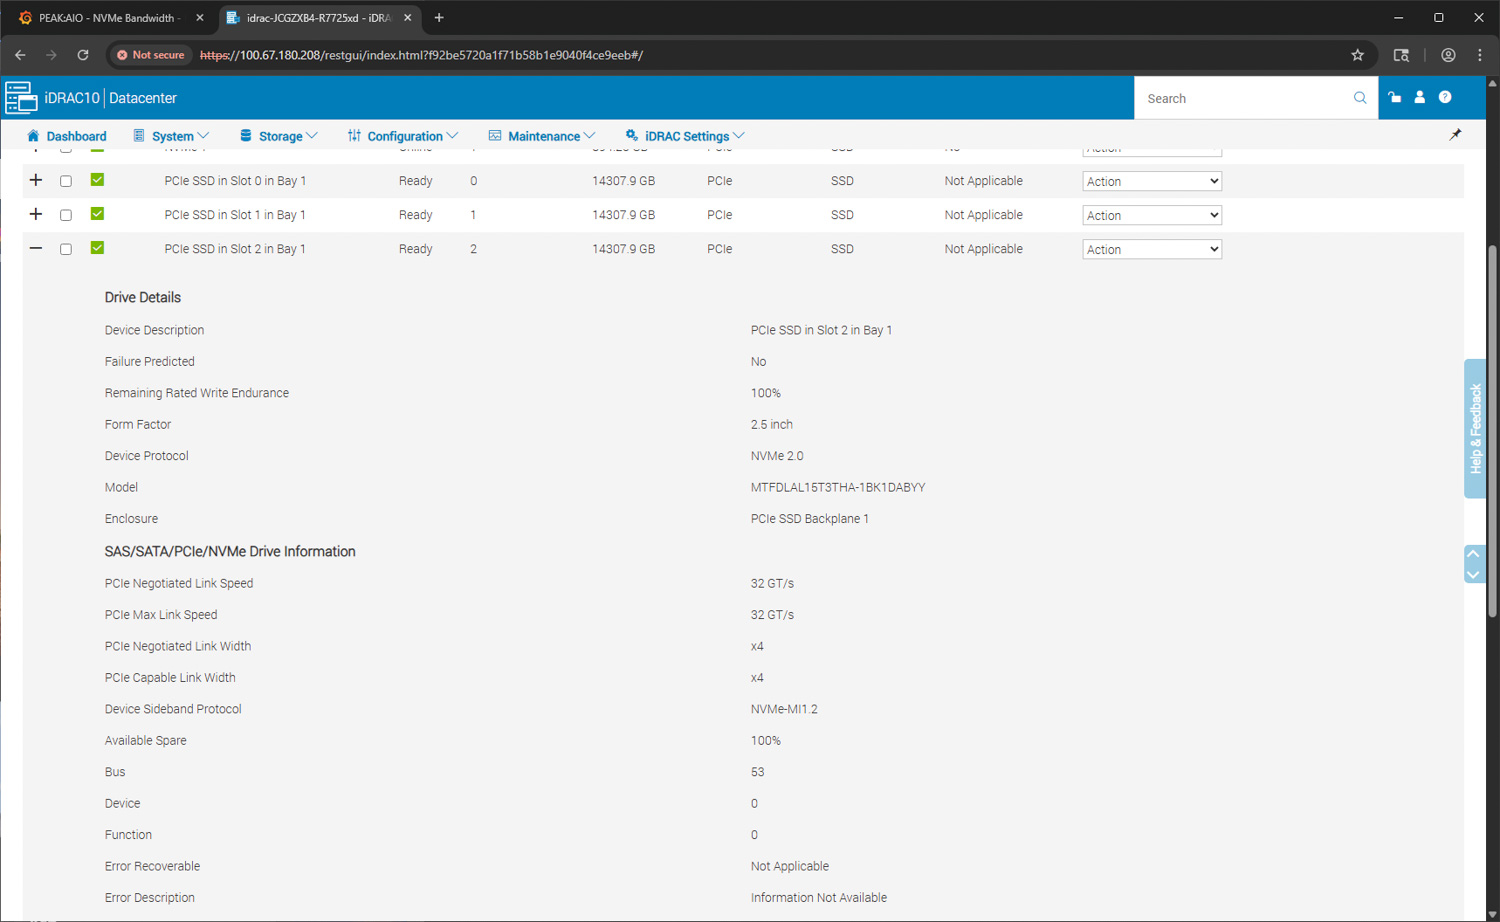
Over het geheel genomen biedt de iDRAC 10-interface een duidelijk, hardwaregericht overzicht van de NVMe-opslagarchitectuur van de R7725xd, waardoor u in één oogopslag de verbindingsstatus, schijfstatus en systeemintegriteit kunt valideren.
Dell PowerEdge R7725xd Prestaties
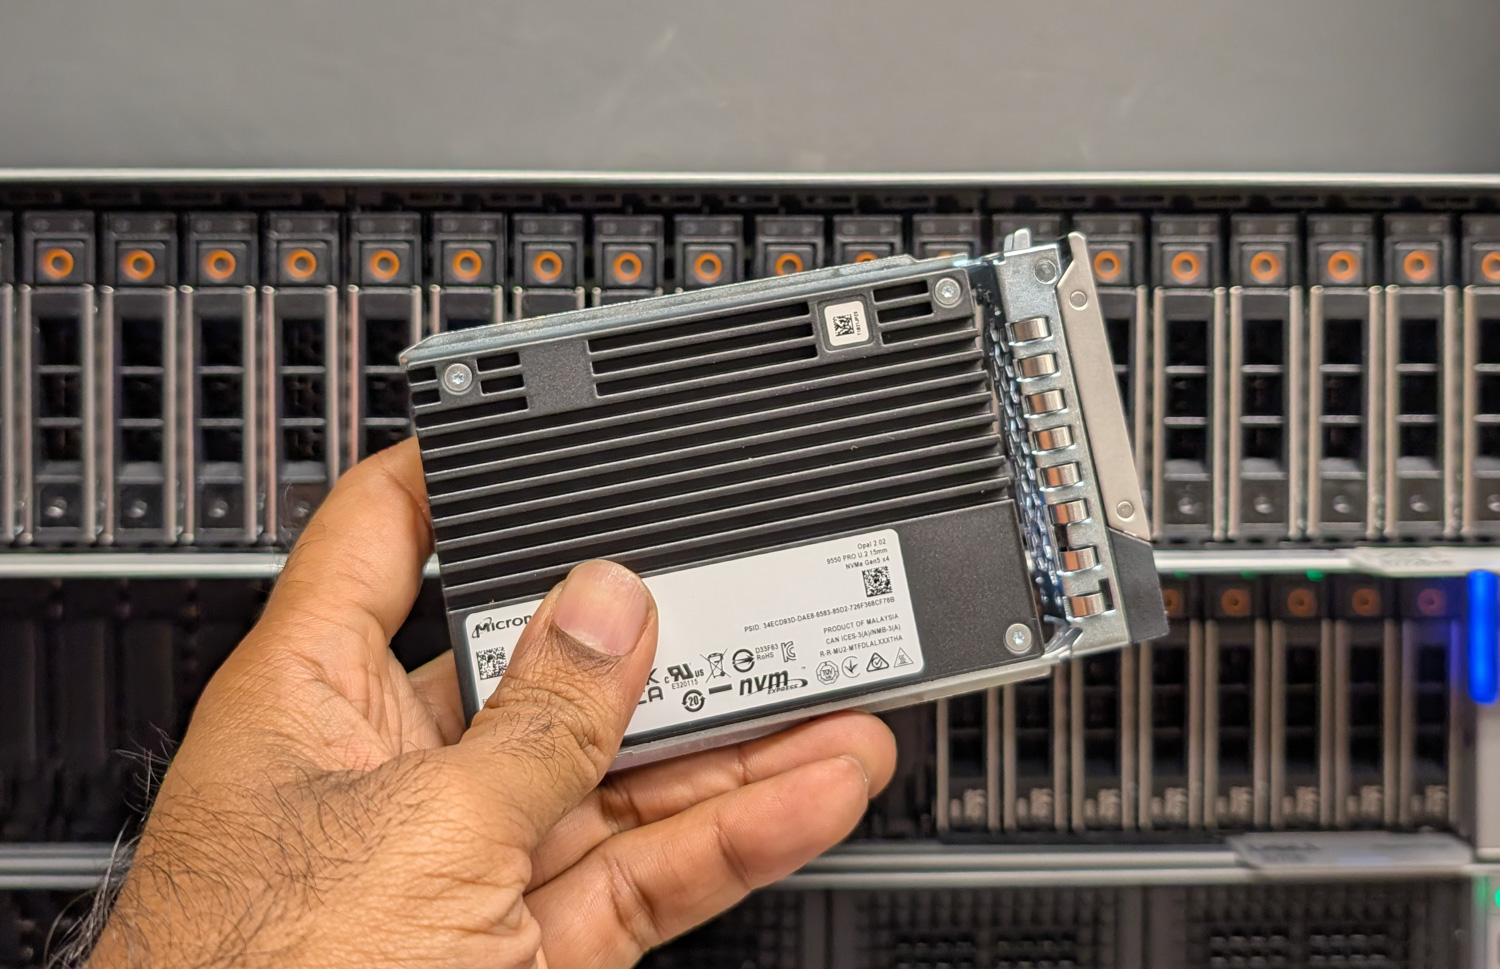
Vóór de test werd ons systeem geconfigureerd met een gebalanceerde maar krachtige loadout. Het systeem is uitgerust met twee AMD EPYC 9575F-processors, elk met 64 hoogfrequente cores, en gekoppeld aan 24 32GB DDR5 DIMM's met een snelheid van 6400 MT/s. Voor opslag is de behuizing volledig gevuld met 24 15.36TB Micron 9550 PRO U.2 NVMe SSD's, elk verbonden via een speciale PCIe Gen5 x4-verbinding. Dit levert een totale ruwe capaciteit op van 368.64 TB, en de Micron 9550 PRO-schijven leveren sequentiële leessnelheden tot 14,000 MB/s en sequentiële schrijfsnelheden tot 10,000 MB/s. Het netwerk wordt verzorgd door vier Broadcom BCM57608-adapters die samen acht 200Gb-poorten leveren, samen met een BCM57412 OCP NIC die twee extra 10-gigabit-poorten biedt.
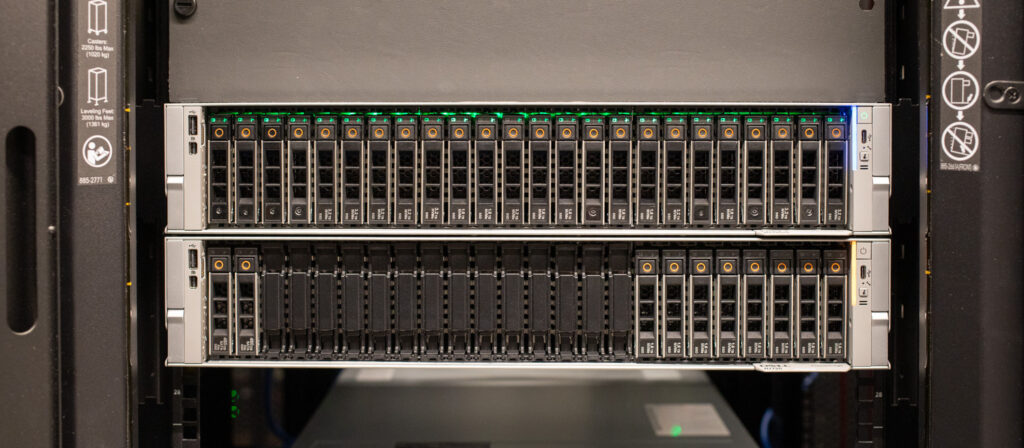
Testsysteem specificaties
- CPU: 2x AMD EPYC 9575F 64-core hoogfrequente processors
- Geheugen: 24x 32GB DDR5 @ 6400MT/s
- Opslag: 24x 15.36TB Micron 9550 PRO U.2-schijven (elk verbonden met 4x PCIe Gen5-lanes); ondersteunt vandaag de dag maximaal 128TB-schijven, met hogere capaciteiten in het verschiet
- Netwerk: 4x Broadcom BCM57608 2x200G NIC's, 1x BCM57412 2x10Gb OCP NIC
- Schakelaar: Dell PowerSwitch Z9664
FIO Prestatie Benchmark
Om de opslagprestaties van de PowerEdge R7725xd te meten, hebben we gebruikgemaakt van industriestandaard meetgegevens en de FIO-tool. In deze sectie concentreren we ons op de volgende FIO-benchmarks:
- Willekeurig 4K – 1M
- Sequentieel 4K – 1M
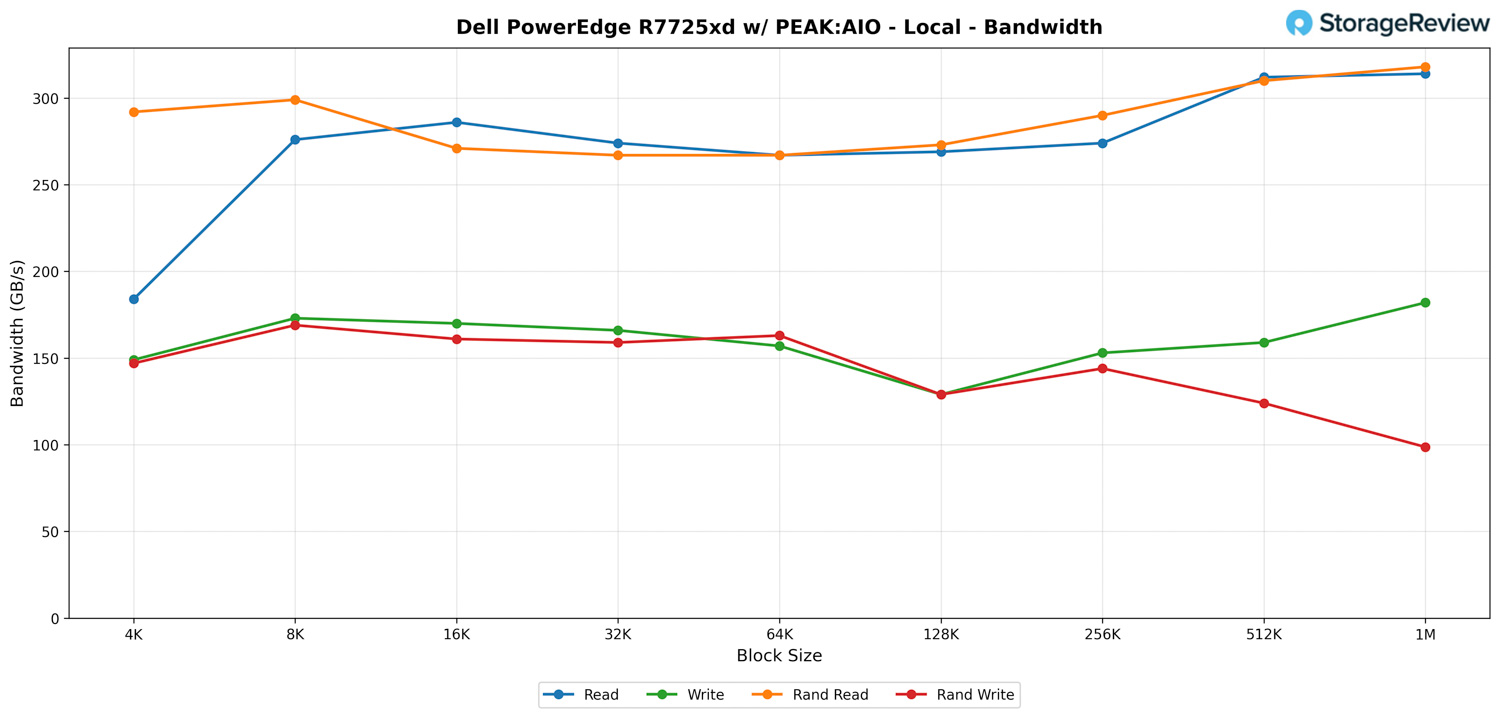
FIO – Lokaal – Bandbreedte
Bij het testen van de lokale toegang tot de 24 PCIe Gen5 NVMe-schijven in de Dell PowerEdge R7725xd, toont het systeem precies wat je zou verwachten van een platform waarop elke schijf is verbonden met de CPU's via een volledige x4-lane PCIe Gen5-verbinding. Zonder netwerklaag is dit de pure, interne doorvoer van Dell's Gen5-opslagindeling en de PCIe-bandbreedte van het AMD EPYC-platform die zonder beperkingen werken.
Sequentiële leessnelheden beginnen bij 184 GB/s met 4K-blokken en schalen snel op naarmate de blokgrootte toeneemt. Van 512K tot 1M handhaaft de server een consistente snelheid van 312 tot 314 GB/s, wat een sterke indicatie is van hoe goed het systeem alle 24×4 Gen5-lanes kan aggregeren tot een constante leesbandbreedte zonder knelpunten in de controller.
Sequentiële schrijfbewerkingen volgen een andere curve, maar blijven stevig binnen het verwachte bereik. Vanaf 149 GB/s stijgen de resultaten tot halverwege de 100 en bereiken ze 182 GB/s bij 1 miljoen. Dit komt overeen met het schrijfgedrag van de Micron 9550 PRO SSD's en de overhead die inherent is aan hoogparallelle NVMe-schrijfbewerkingen op zoveel onafhankelijke apparaten.
De prestaties bij willekeurig lezen zijn een ander hoogtepunt. Het systeem bereikt snelheden van bijna 300 GB/s bij de kleinste blokgroottes, daalt lichtjes in het middenbereik en herstelt zich vervolgens naar de bovenste 200 GB/s en de onderste 300 GB/s bij grotere blokgroottes. Bij 1M bereiken willekeurige leessnelheden een maximum van 318 GB/s, wat aantoont dat het platform gemengde bewerkingen gelijkmatig over alle 24 schijven kan verdelen.
Willekeurige schrijfbewerkingen verlopen met een lagere snelheid, wat typisch is voor verspreide metadata en schrijftoewijzingstaken over een brede NVMe-set. De resultaten blijven gedurende het grootste deel van de test binnen het bereik van 140 tot 160 GB/s en lopen af tot net onder de 100 GB/s bij 1 M.
FIO – Lokaal – IOPS
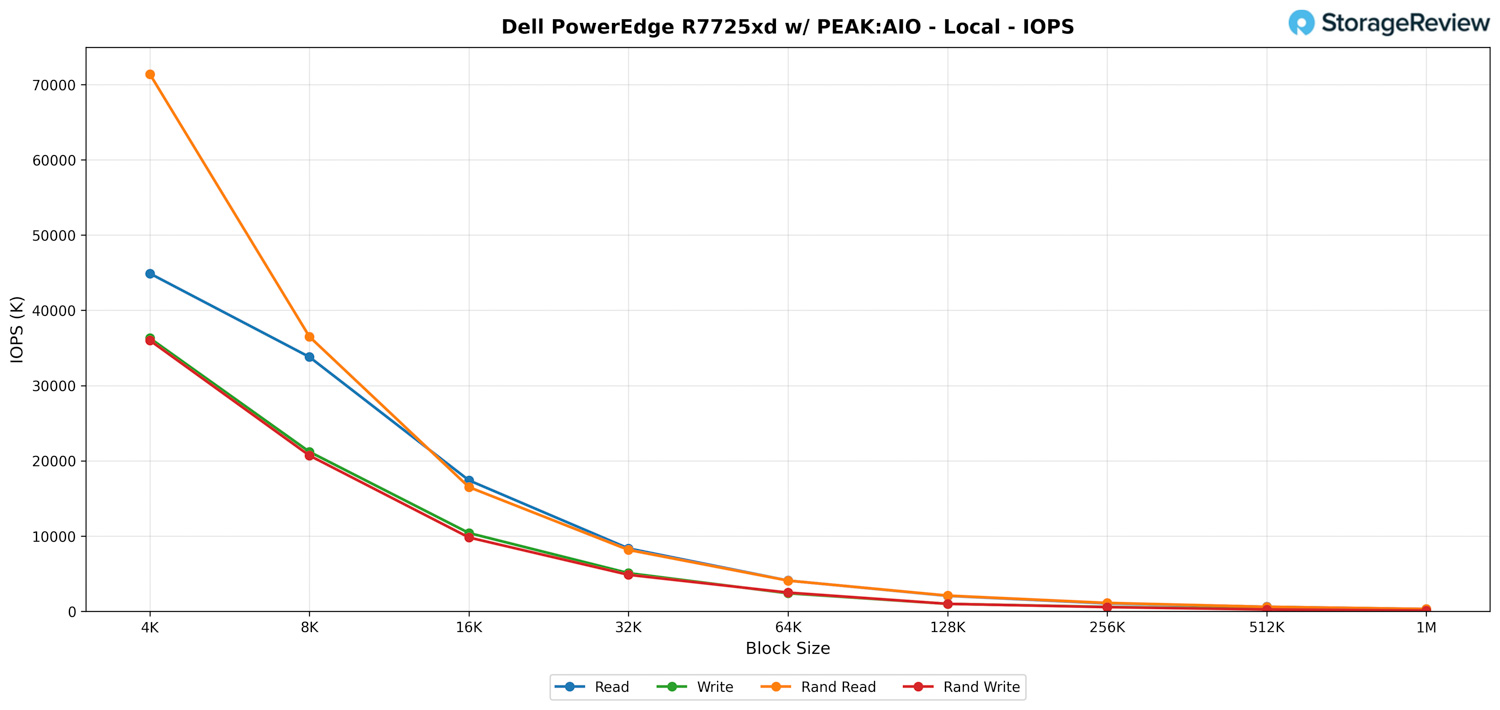
Bij onderzoek van de IOPS-kant laat de R7725xd robuuste prestaties zien bij kleine blokken, met aanvraagsnelheden die oplopen tot tientallen miljoenen voordat grotere blokken de werklast verplaatsen naar een bandbreedtegestuurd profiel.
Bij 4K bereiken de leessnelheden 44.9 miljoen IOPS en de schrijfsnelheden 36.3 miljoen. De willekeurige leessnelheden bereiken zelfs nog hogere niveaus met 71.4 miljoen IOPS, wat aantoont dat het systeem in staat is om workloads met een hoge wachtrij efficiënt over alle schijven te verdelen. Deze waarden nemen op natuurlijke wijze af naarmate de blokgroottes toenemen, maar de progressie blijft consistent in de bereiken van 8K, 16K en 32K.
Bij blokken van 16 en 32 blokken stabiliseren de reads zich op 17.4 miljoen en 8.35 miljoen IOPS, terwijl de random reads dicht bij elkaar liggen op 16.5 miljoen en 8.15 miljoen. De writes volgen het verwachte patroon, dalend maar stabiel over zowel sequentiële als random access-patronen.
Naarmate we 64K en hoger bereiken, gaat de test over van pure IOPS naar een meer bandbreedtegebonden scenario. IOPS vallen in het bereik van een paar miljoen en uiteindelijk in de honderdduizenden. Bij een blokgrootte van 1M bereiken lees-IOPS ongeveer 300K, schrijfbewerkingen ongeveer 174K en eindigen willekeurige bewerkingen in dezelfde buurt.
Over het geheel genomen tonen de lokale IOPS-resultaten duidelijk aan dat het systeem in staat is om workloads met een zeer hoge wachtrijdiepte te verwerken in kleine blokken, met voorspelbare schaalbaarheid naarmate het aantal overdrachten toeneemt en de bandbreedte de dominante factor wordt.
PEAK:AIO: Waarom de Dell PowerEdge R7725xd geschikt is voor deze workload
PEAK:AIO is ontworpen voor omgevingen die extreem snelle toegang met lage latentie tot grote datasets vereisen, doorgaans voor AI-training, inferentiepipelines, financiële modellering en realtime analyses. Het platform draait op compacte NVMe-opslag, gebalanceerde PCIe-bandbreedte en voorspelbare latentie op schaal. Om aan deze eisen te voldoen, moet de onderliggende hardware een constante doorvoer leveren en tegelijkertijd consistente en herhaalbare prestaties leveren onder gelijktijdige zware belasting.
Dit is waar de Dell PowerEdge R7725xd perfect aansluit bij PEAK:AIO. De architectuur van het systeem is ontworpen om de PCIe Gen5-bronnen te maximaliseren, waarbij de volledige bandbreedte van de 24 aan de voorzijde gemonteerde U.2 NVMe-bays rechtstreeks aan de CPU's wordt blootgesteld, zonder dat traditionele RAID-controllers nodig zijn. Deze lay-out geeft PEAK:AIO het parallellisme en latentieprofiel dat het verwacht van moderne NVMe-gebaseerde datapijplijnen. De systeemconfiguratie verdeelde de NVMe SSD's in twee RAID0-groepen.
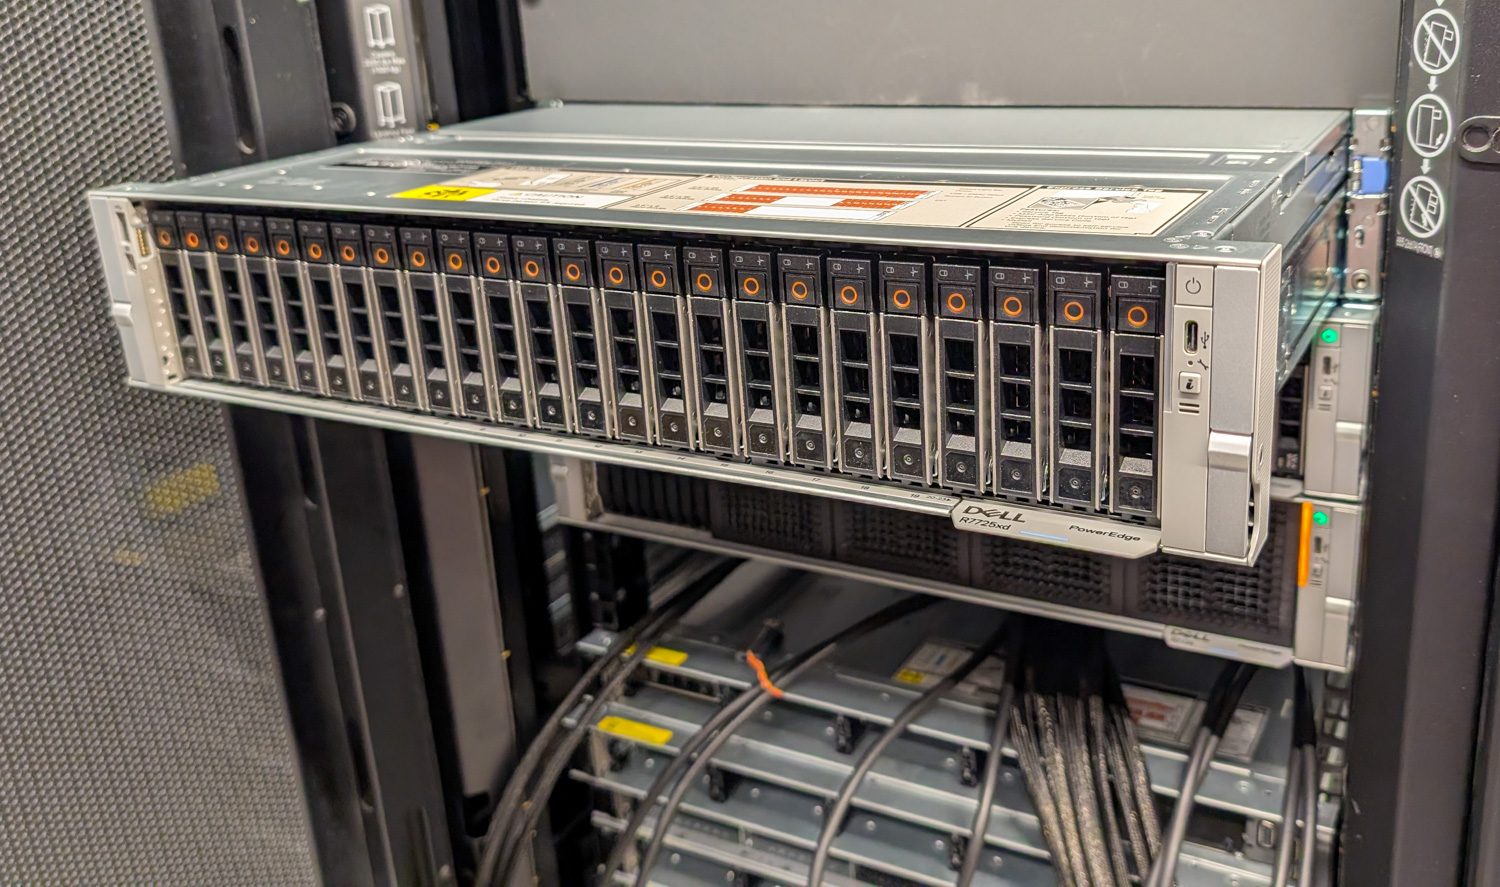
In het geteste scenario gebruikten we twee clientsystemen die verbonden waren met de R7725xd, elk uitgerust met Broadcom BCM57608 2x 200G NIC's. Dit resulteerde in totaal in vier 200G uplinks die naar elke client leidden, waardoor de R7725xd een realistische, krachtige configuratie kreeg die vergelijkbaar is met wat PEAK:AIO-implementaties in productie zien. Deze netwerkbandbreedte gaf ons de ruimte om het NVMe-subsysteem, de PCIe-topologie en de CPU-verbindingen volledig te belasten zonder knelpunten op de NIC-laag.
Het resultaat is een platform dat effectief aansluit op PEAK:AIO-workloads. De R7725xd biedt een hoge NVMe-capaciteit, PCIe Gen5-doorvoer, twee AMD EPYC 9005-processors voor parallellisme en de netwerkcapaciteit om gegevensverwerking van meerdere clients met honderden gigabit per client te ondersteunen. Al deze kenmerken zijn essentieel voor het behalen van de prestatieverwachtingen van PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Bandbreedte
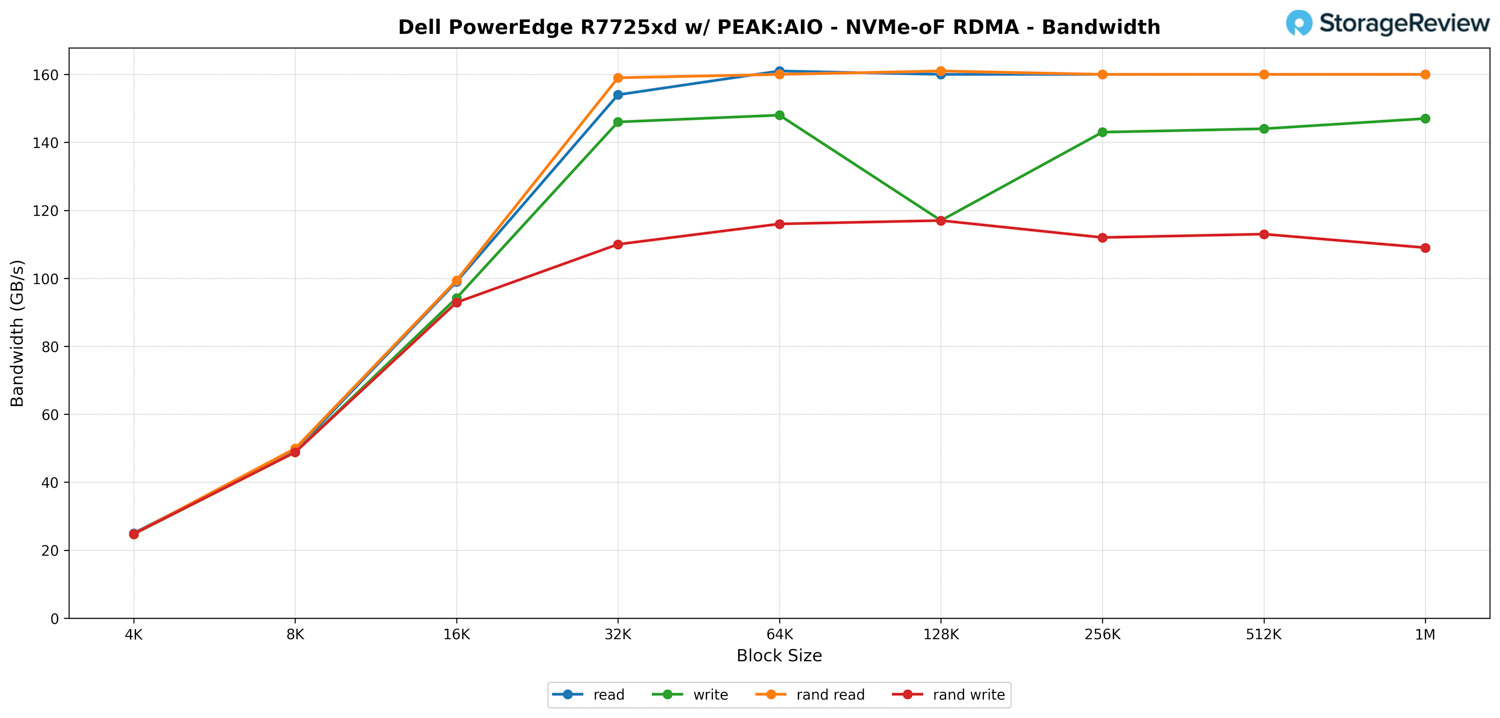
Als we de NVMe-oF RDMA-bandbreedteresultaten op de PowerEdge R7725xd met PEAK:AIO bekijken, zien we dat de algehele trend precies overeenkomt met wat we verwachten van een systeem met zoveel PCIe- en netwerkbandbreedte. Naarmate de blokgrootte toeneemt, neemt de doorvoer snel toe totdat deze zich stabiliseert rond de praktische limiet van het platform.
Bij de kleine blokgroottes beginnen de prestaties rond de 20 GB/s voor zowel lezen als schrijven, wat normaal is omdat 4K- en 8K-overdrachten het IOPS-pad veel zwaarder belasten dan het doorvoerpad. Zodra we de blokken van 16K en 32K bereiken, gaat de pijplijn open. De leessnelheid springt naar ongeveer 154 GB/s bij 32K en klimt verder naar 160 GB/s, precies waar we een dual-clientconfiguratie met vier 200 Gb/s-verbindingen zouden verwachten.
De prestaties bij willekeurig lezen weerspiegelen die van sequentieel lezen vrijwel perfect. PEAK:AIO houdt de opdrachtwachtrijen goed gevuld, dus de bandbreedte voor willekeurig lezen volgt in principe de sequentiële leesbandbreedte tot het einde, met een stabilisatie van ongeveer 159 tot 161 GB/s van 32K tot 1M. Dit geeft aan dat de storagestack geen bottleneck vormt bij gemengde toegangspatronen en dat de PCIe-topologie van de R7725xd de belasting gelijkmatig verdeelt over de 24 Gen5 NVMe-schijven.
Schrijfprestaties volgen een vergelijkbare curve, hoewel deze iets lager liggen dan leesprestaties. Sequentiële schrijfsnelheden blijven in het bereik van 140 tot 148 GB/s voor de middelgrote blokken, dalend tot ongeveer 117 GB/s bij 128K, maar herstellend naarmate de blokgrootte toeneemt. Willekeurige schrijfsnelheden gedragen zich anders en stabiliseren dichter bij 110-117 GB/s, wat normaal is voor workloads met gemengde wachtrijen die extra overhead met zich meebrengen.
De belangrijkste conclusie uit dit gedeelte is dat de R7725xd geen moeite heeft met het handhaven van extreem hoge bandbreedte over NVMe-oF, zelfs met meerdere clients die het systeem tot het uiterste drijven. Zodra blokgroottes 32K of hoger bereiken, overbelast de server constant de beschikbare netwerk- en opslagbandbreedte. Dit is precies het type prestatie dat PEAK:AIO beoogt te behalen, waardoor deze resultaten een sterke bevestiging vormen van het vermogen van het platform om te schalen onder realistische omstandigheden.
PEAK AIO – NVMe-oF RDMA IOPS
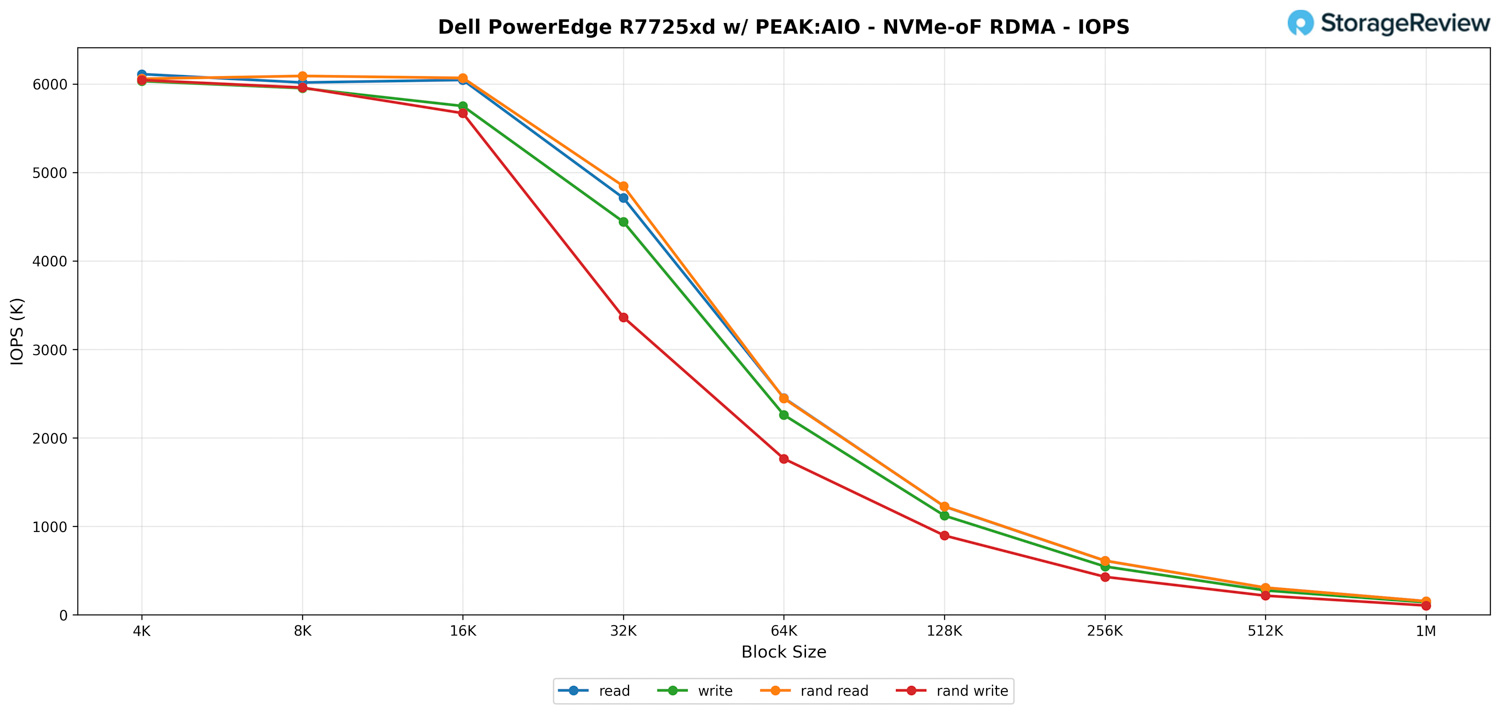
Wat IOPS betreft, vertoont de PowerEdge R7725xd sterke small-block prestaties, hoewel we aanvankelijk lagere cijfers dan verwacht zagen; dit probleem zal naar verwachting in de toekomst worden opgelost met verbeterde ondersteuning voor netwerkdrivers. Zelfs met deze ontwikkeling lijkt de algehele schaaltrend precies te zijn zoals NVMe-oF RDMA zich doorgaans gedraagt wanneer de blokgrootte toeneemt.
Bij de kleinste blokgrootte kan het systeem meer dan 6 miljoen IOPS leveren, zowel voor sequentiële als willekeurige workloads. Lezen, schrijven, willekeurig lezen en willekeurig schrijven bevinden zich allemaal ongeveer in hetzelfde bereik bij 4K en 8K, wat aangeeft dat de front-end clients, PCIe-infrastructuur en de NVMe-schijven zelf geen moeite hebben om de aanvraagsnelheid bij te benen.
Naarmate de blokgroottes toenemen, begint de verwachte daling in IOPS. Bij 32K komen de leesbewerkingen uit op ongeveer 4.7 miljoen IOPS, terwijl de schrijfbewerkingen iets achterblijven met ongeveer 4.4 miljoen. Willekeurige schrijfbewerkingen worden hier het hardst getroffen en dalen tot ongeveer 3.3 miljoen IOPS, wat overeenkomt met de extra wachtrij- en CPU-overhead die wordt veroorzaakt door patronen met gemengde toegang.
Bij de grote blokken blijft de IOPS op een voorspelbare lineaire manier afnemen. Tegen de tijd dat we 256K en 512K overdrachten bereiken, wordt de doorvoer de dominante maatstaf en daalt de IOPS op natuurlijke wijze naar de middenhonderdduizenden. Bij een blokgrootte van 1 miljoen convergeren alle workloads naar 140K-153K IOPS, wat overeenkomt met de bandbreedtewaarden die we in de vorige sectie zagen.
GPUDirect-opslagprestaties
Een van de tests die we op de R7725xd hebben uitgevoerd, was de Magnum IO GPUDirect Storage (GDS)-test. GDS is een door NVIDIA ontwikkelde functie waarmee GPU's de CPU kunnen omzeilen bij het benaderen van gegevens die zijn opgeslagen op NVMe-schijven of andere snelle opslagapparaten. In plaats van gegevens via de CPU en het systeemgeheugen te routeren, maakt GDS directe communicatie tussen de GPU en het opslagapparaat mogelijk, wat de latentie aanzienlijk vermindert en de gegevensdoorvoer verbetert.
Hoe GPUDirect-opslag werkt
Traditioneel, wanneer een GPU gegevens verwerkt die zijn opgeslagen op een NVMe-schijf, moeten de gegevens eerst door de CPU en het systeemgeheugen reizen voordat ze de GPU bereiken. Dit proces creëert knelpunten, omdat de CPU een tussenpersoon wordt, wat latentie verhoogt en waardevolle systeembronnen verbruikt. GPUDirect Storage elimineert deze inefficiëntie door de GPU in staat te stellen gegevens rechtstreeks vanaf het opslagapparaat te benaderen via de PCIe-bus. Dit directe pad vermindert de overhead van gegevensverplaatsing, wat zorgt voor snellere en efficiëntere gegevensoverdracht.
AI-workloads, met name die met deep learning, zijn zeer data-intensief. Het trainen van grote neurale netwerken vereist de verwerking van terabytes aan data, en elke vertraging in de dataoverdracht kan leiden tot onderbenutting van GPU's en langere trainingstijden. GPUDirect Storage pakt deze uitdaging aan door ervoor te zorgen dat data zo snel mogelijk naar de GPU wordt verzonden, waardoor inactieve tijd wordt geminimaliseerd en de rekenefficiëntie wordt gemaximaliseerd.
Bovendien is GDS met name gunstig voor workloads die het streamen van grote datasets omvatten, zoals videoverwerking, natuurlijke taalverwerking of realtime-inferentie. Door de afhankelijkheid van de CPU te verminderen, versnelt GDS de databeweging en maakt CPU-bronnen vrij voor andere taken, wat de algehele systeemprestaties verder verbetert.
Naast de ruwe bandbreedte levert GPUDirect met NVMe-oF (TCP/RDMA) ook I/O met extreem lage latentie. Dit zorgt ervoor dat GPU's nooit een datatekort hebben, waardoor het systeem ideaal is voor realtime AI-inferencing, analysepijplijnen en videoherhaling.
GDSIO Lees Sequentieel
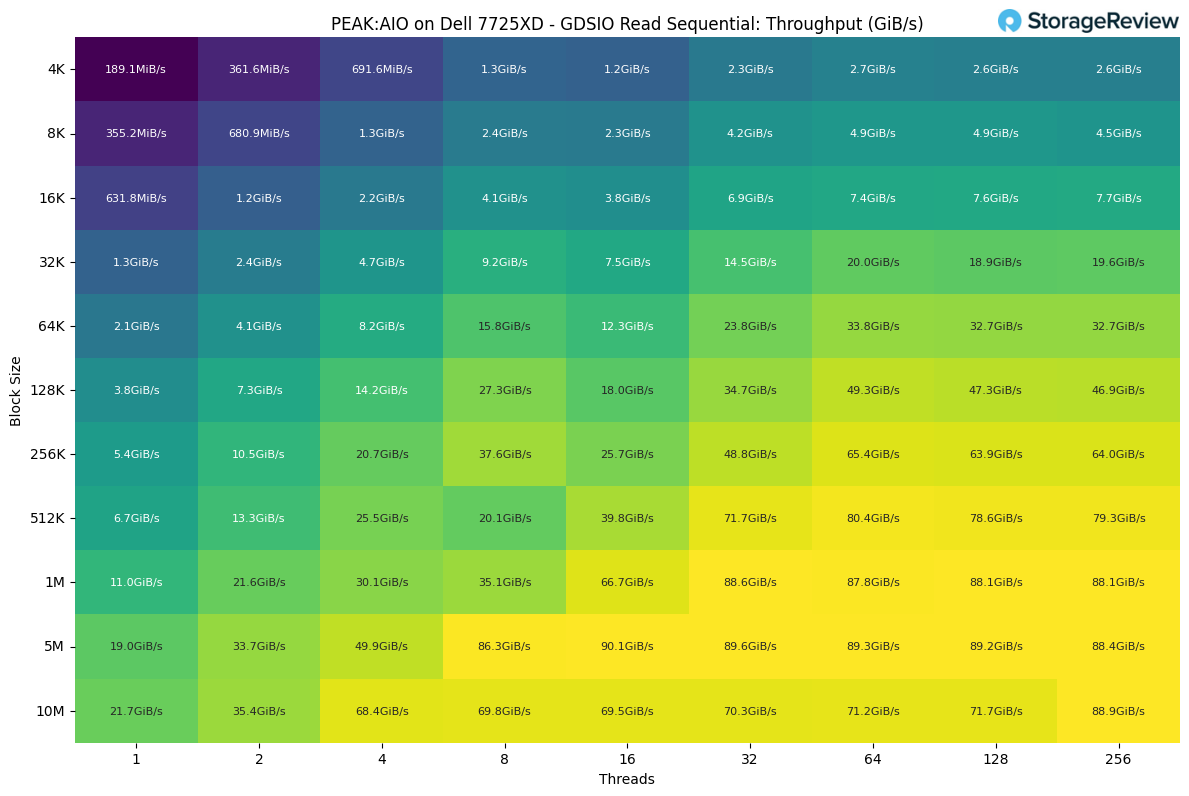
Bij het onderzoeken van PEAK:AIO met één client via GDSIO, vertoont de leesdoorvoer een duidelijk schaalpatroon naarmate zowel de blokgrootte als het aantal threads toenemen. Deze ene client was verbonden via twee 400G-verbindingen, waardoor het totale potentieel beperkt bleef tot 90 GB/s.
Bij de kleinste blokgroottes en lage threadaantallen zijn de prestaties bescheiden, met 4K-leessnelheden vanaf ongeveer 189 MiB/s bij één thread. Zodra we de threadparallelliteit verhogen, reageert het systeem direct en haalt het 691 MiB/s bij vier threads, en breekt het door naar het multi-GiB/s-bereik zodra we grotere blokken gebruiken.
De gemiddelde blokgroottes zijn het meest gevoelig voor het aantal threads. Bij 32K stijgt de doorvoer van 1.3 GiB/s bij één thread naar bijna 20 GiB/s bij 64 threads, met slechts een lichte afname daarboven. Een vergelijkbaar patroon is zichtbaar bij 64K en 128K, waar het systeem overgaat van een lage enkelcijferige GiB/s bij lage parallelliteit naar meer dan 30 GiB/s naarmate de werklast toeneemt.
Zodra we de grotere blokgroottes bereiken, begint de doorvoer af te vlakken naarmate het systeem zijn prestatieplafond voor één client nadert. Bij 1 MiB stijgt de prestatie van 11 GiB/s bij één thread naar ongeveer 88 GiB/s bij hoge threadaantallen. De overdrachten van 5 MiB en 10 MiB vertonen hetzelfde plateau, met pieken rond de 89-90 GiB/s, ongeacht of de test draait op 64, 128 of 256 threads.
GDSIO Schrijf Sequentieel
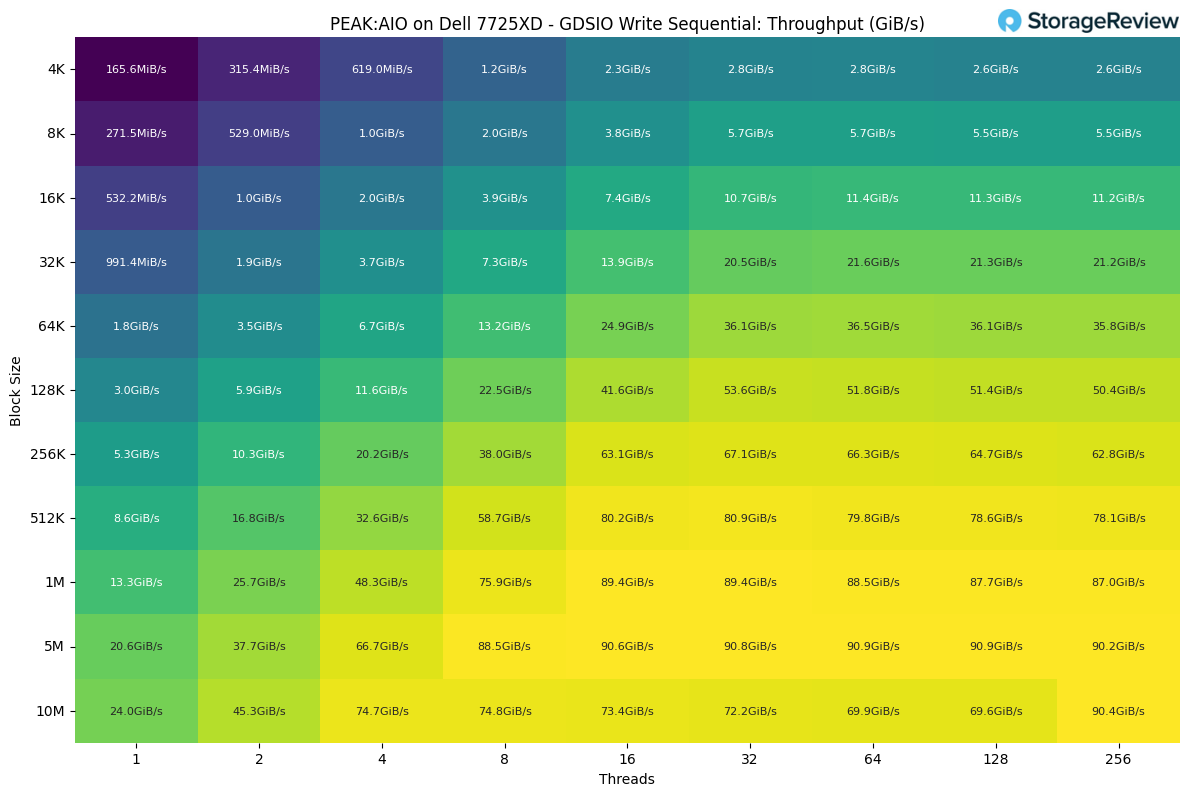
Aan de schrijfzijde volgt het schaalgedrag een vergelijkbaar patroon als bij het lezen, maar met iets lagere prestaties voor de meeste blokgroottes, wat te verwachten is voor sequentiële schrijftaken. Bij de kleinste blokgroottes begint de doorvoer bij 165 MiB/s voor één thread bij 4K en neemt gestaag toe naarmate de parallelliteit toeneemt. Bij vier threads groeit dit tot iets meer dan 619 MiB/s, voordat het bij acht threads boven de 1 GiB/s uitkomt.
Blokgroottes in het middensegment laten sterkere winsten zien naarmate het aantal threads stijgt. Bij 32K begint de doorvoer net onder de 1 GiB/s en schaalt deze op tot meer dan 21 GiB/s bij hogere threadniveaus. De bereiken van 64K en 128K zetten de trend voort en gaan van een laag enkelcijferig aantal GiB/s naar midden 30 GiB/s en 50 GiB/s naarmate de werklast meer parallel loopt.
Grotere overdrachten vinden plaats wanneer het systeem zijn natuurlijke schrijfsnelheid bereikt. Bij 1 MiB stijgt de prestatie van 13.3 GiB/s bij één thread naar iets minder dan 90 GiB/s bij een hoog aantal threads. De tests met 5 MiB en 10 MiB volgen een vergelijkbaar patroon, met resultaten die pieken rond de 90 GiB/s, ongeacht of het systeem draait op 64, 128 of 256 threads.
Prestaties opnieuw definiëren in het Gen5-tijdperk
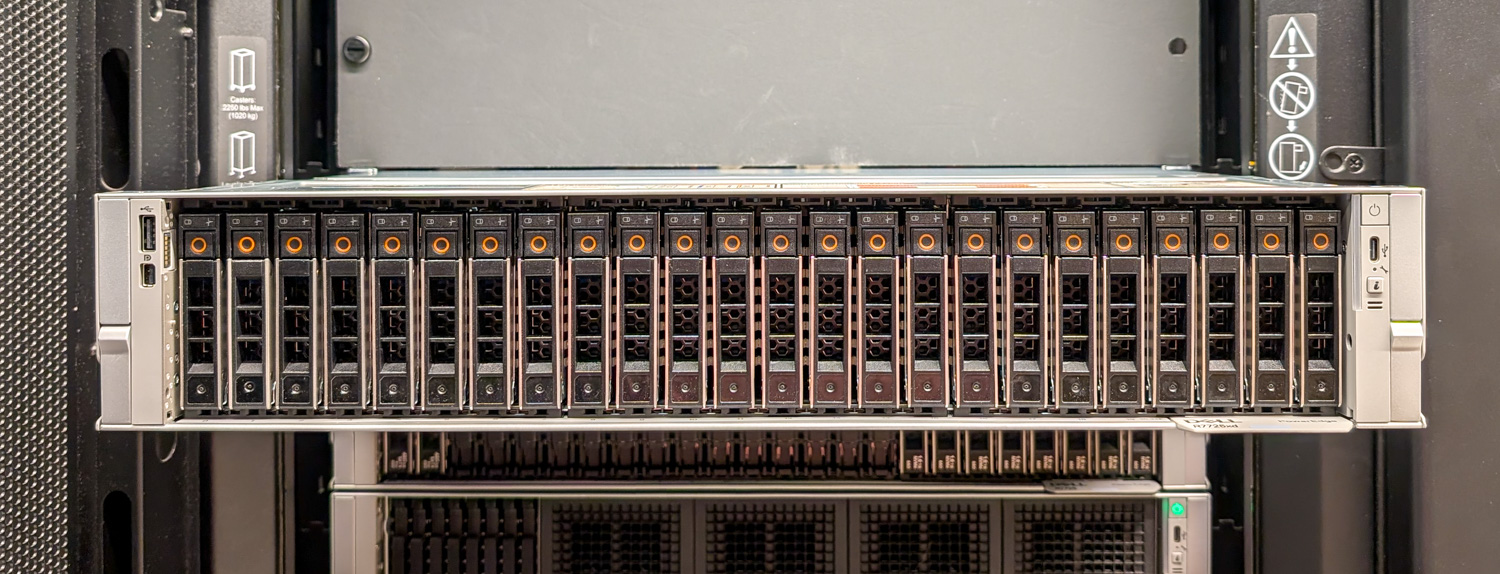
De Dell PowerEdge R7725xd is meer dan een storageserver; hij vertegenwoordigt een verschuiving in de manier waarop bandbreedte in het rack wordt geleverd. Door PCIe-switches te elimineren en elke NVMe-schijf een direct pad naar de CPU te geven, creëerde Dell een systeem waarbij de doorvoer soepel schaalt, de thermische prestaties voorspelbaar blijven en gelijktijdigheid een voordeel wordt in plaats van een uitdaging.
In combinatie met Microns 9550 PRO SSD's en de parallelle I/O-software van PEAK:AIO transformeert de R7725xd van een compacte NVMe-behuizing in een ware data-engine. Hij kan zijn lokale PCIe-netwerk verzadigen, GPU's via RDMA op lijnsnelheid aansturen of tegelijkertijd als reken- en opslagcapaciteit fungeren, allemaal binnen een 2U-behuizing.
Dell PowerEdge R7225xd
In de praktijk levert deze configuratie meer dan 300 GB/s lokale doorvoer en 160 GB/s via het netwerk, wat de prestaties van multi-node storageclusters evenaart, maar dan met een fractie van de complexiteit en kosten. Het is een demonstratie van wat er gebeurt als elke laag van de stack, van silicium tot software, is afgestemd op efficiëntie en continue bandbreedte.
De R7725xd zet een nieuwe standaard voor single-node storageprestaties in het Gen5-tijdperk. Voor organisaties die next-generation AI-pipelines, snelle analyses of controlegerichte trainingsomgevingen bouwen, biedt dit een voorproefje van wat er mogelijk is wanneer de knelpunten volledig uit het systeem worden weggewerkt.
Dit rapport wordt gesponsord door Dell Technologies. Alle standpunten en meningen in dit rapport zijn gebaseerd op onze onbevooroordeelde kijk op het (de) product(en) in kwestie.


 Amazon