

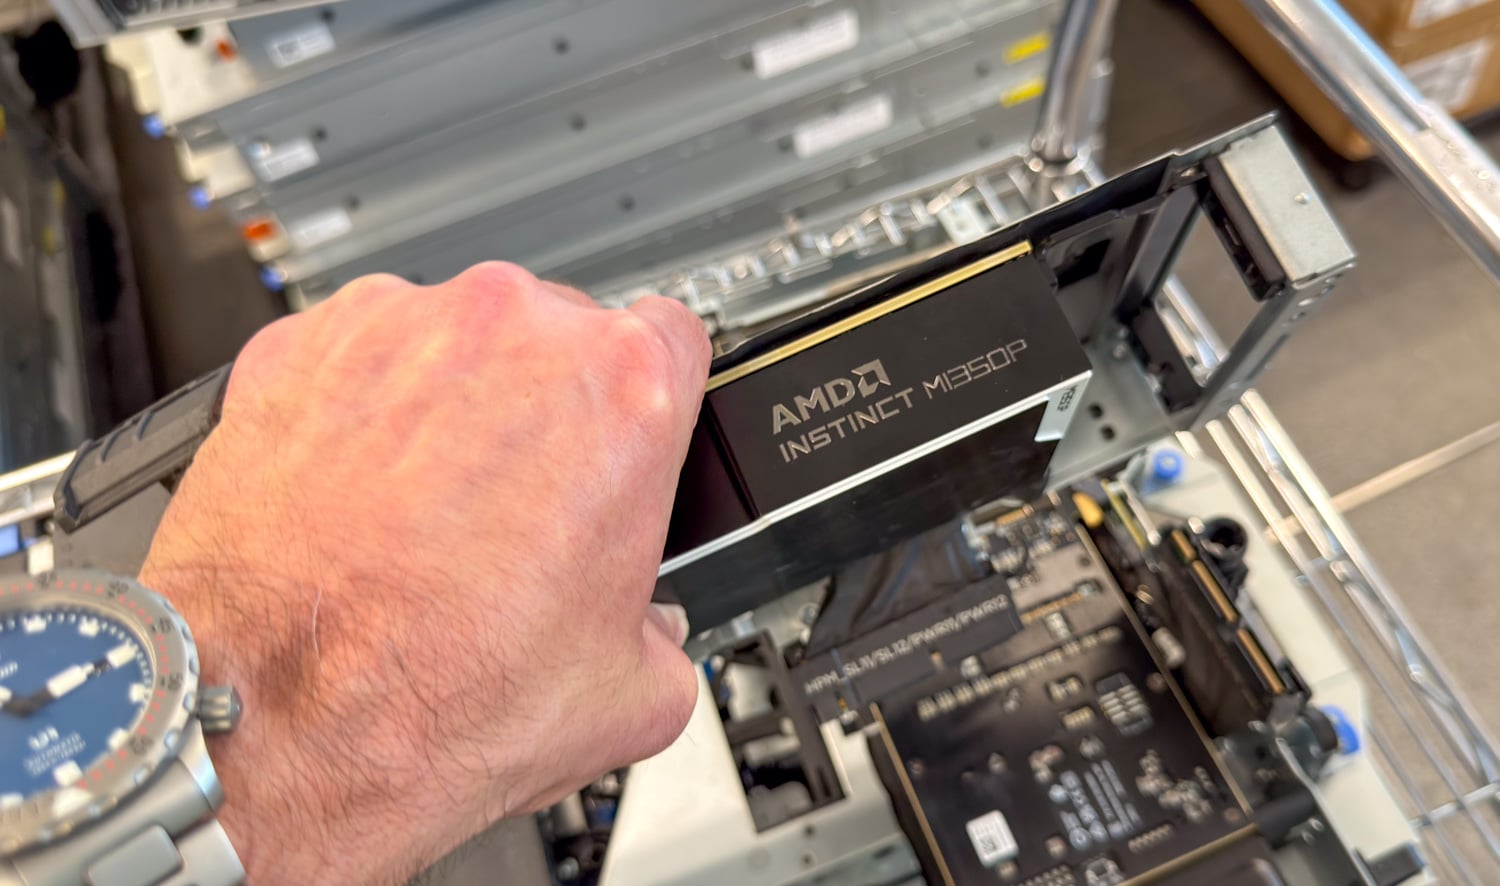
De AMD Instinct MI350P is AMD's eerste nieuwe PCIe Instinct GPU in vier jaar, na de MI210 uit 2022. Deze kaart brengt de CDNA 4-architectuur van het bedrijf naar een conventionele insteekkaart, met een MXFP4-prestatie tot 4.6 PFLOPS, 144 GB HBM3E-geheugen en een geheugenbandbreedte van 4 TB/s. Dit alles past in een dual-slot, luchtgekoelde kaart van 600 W, waardoor klanten een alternatieve manier hebben om Instinct GPU's te implementeren zonder over te stappen naar het grotere OAM MI350/5X-platform met 8 GPU's.
Key Takeaways
- 144 GB in een PCIe-slot, dat is het belangrijkste nieuws. De MI350P heeft het meeste geheugen van alle huidige PCIe-acceleratoren, 3 GB meer dan de H200 NVL en 48 GB meer dan de RTX PRO 6000 Blackwell, met daarachter 4 TB/s HBM3E. Tien van de veertien model- en precisiecombinaties in deze review draaiden op één kaart.
- De gemeten rekenkracht ligt tussen die van de twee NVIDIA-kaarten in. Met een vermogen van 450W behaalde MAMF 580 TFLOPS in BF16, 1,120 in FP8 en 2,228 in block-scaled FP4, 36 tot 38 procent meer dan een 600W RTX PRO 6000 bij elke precisie en minder dan de H200 NVL in BF16 en FP8, die geen FP4-pad heeft.
- GPT-OSS is het sterkste resultaat van de MI350P. Op AMDGPU 31.60, ROCm 10.1.0 en vLLM 0.32.0 behaalde GPT-OSS-120B 5,057 uitvoertokens per seconde bij 128 streams in de chat-workload, 65 procent meer dan de RTX PRO 6000 en 50 procent meer dan de H200 NVL, en de curve blijft stijgen tot 128 streams bij beide promptvormen.
- Korte prompts werken het beste op de MI350P; langere prompts presteren wisselend. Bij prompts met 512 tokens verslaat de kaart de RTX PRO 6000 op alle FP8-, BF16- en GPT-OSS-modellen met 35 tot 65 procent bij 128 streams, en de twee FP4-tegen-NVFP4-vergelijkingen liggen binnen 5 en 21 procent, terwijl bij prompts met 8,192 tokens de kaart de leiding neemt op GPT-OSS en Mistral Small en achterblijft op Llama, Qwen FP8 en MiniMax-M2.7, waar de curve al vroeg afvlakt.
- De resultaten van de tweekaartspeltest staan op ROCm 7.2.3. De resultaten voor DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 en GLM-5.3 Flash zijn afkomstig van runs op die stack, omdat de ROCm 10.1-runs op die modellen gebruik maakten van CPU expert offload en, bij DeepSeek, een speculatieve decoder die de NVIDIA-runs niet gebruikten.
- 600W is nog steeds een open vraag. Dell documenteert acht MI350P's met een vermogen van 600W in de PowerEdge XE7745, en een vervolgtest op vol vermogen staat gepland.
AMD presenteerde de MI350P ook op IFA 2026 in het Threadripper Halo Station-prototype, waar dezelfde accelerators vloeistofgekoeld waren. Het workstationconcept ondersteunt tot vier MI350P's in combinatie met een 96-core Threadripper PRO-processor, wat een totale HBM3E-capaciteit van 576 GB in één machine oplevert. Op de productpagina van AMD, die in oktober is bijgewerkt, staat nu dat het systeem in 2027 verschijnt. Dit geeft ons twee perspectieven op de MI350P: als een PCIe-accelerator voor servers en als bouwsteen voor een groter AI-systeem voor op het bureau, dat concurreert met machines zoals het GB300 DGX Station.
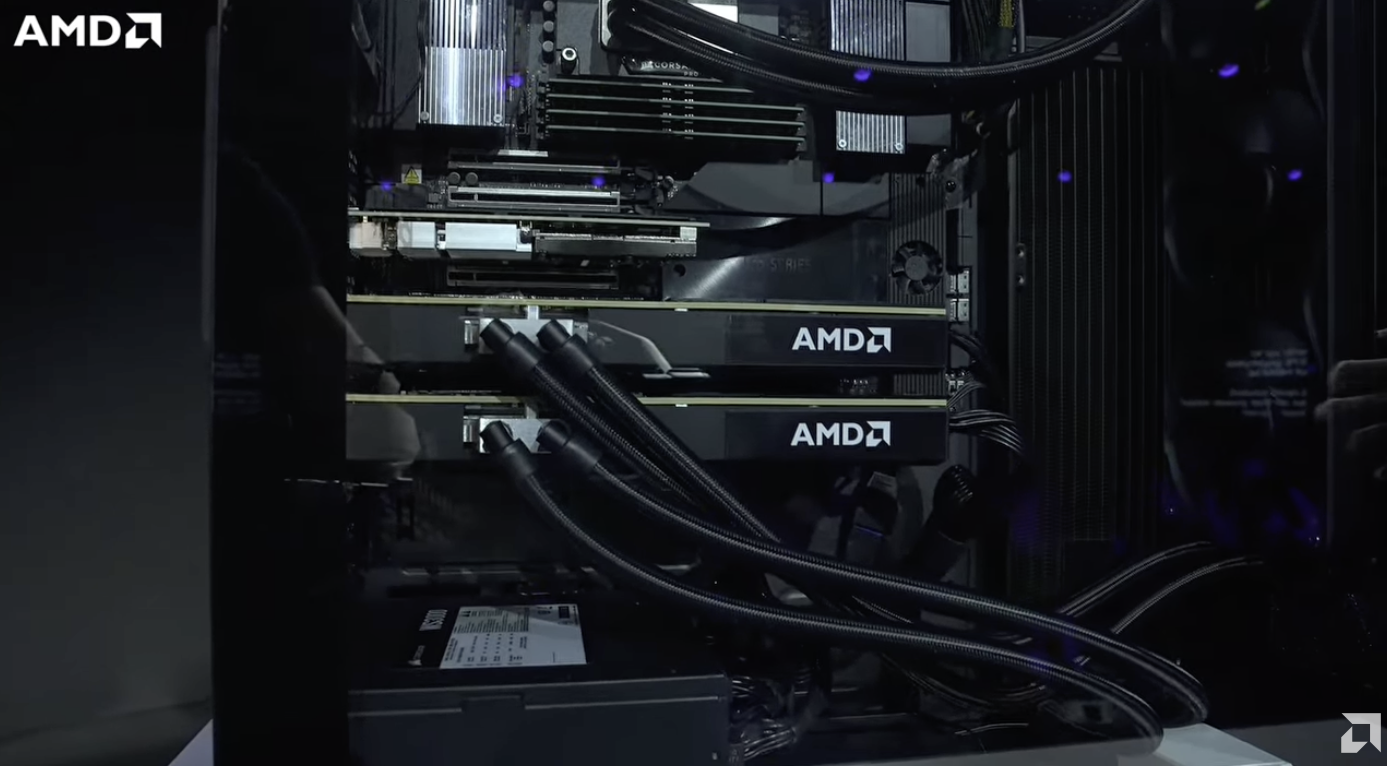
Deze eerste vergelijking bekijkt de serverconfiguratie, dus de vergelijking die ertoe doet voor een koper die een PCIe-accelerator specificeert, is de NVIDIA RTX PRO 6000 Blackwell. Deze kaart valt in dezelfde vermogensklasse en past in dezelfde slots. De H200 NVL is in de grafieken opgenomen als de meest capabele NVIDIA-uitbreidingskaart voor workloads waarbij de geheugenbandbreedte doorslaggevend is. Een enkele GB300 DGX Station dient als voorbeeld voor de desktopconfiguratie; dit is een machine van een andere klasse met een andere prijs, en dient om te laten zien hoeveel beter een volledige Blackwell Ultra GPU presteert dan welke PCIe-kaart dan ook.
Specificaties van de AMD Instinct MI350P
Volgens de door AMD gepubliceerde cijfers ligt de nadruk van de MI350P op lage precisie: 4.6 PFLOPS bij MXFP4 en MXFP6, 2.3 PFLOPS bij FP8 en 1.15 PFLOPS bij FP16 of BF16, allemaal dichte waarden. Het geheugen vormt de andere helft van de kaart: 144 GB HBM3E op een 4,096-bits interface met een snelheid van 4 TB/s, achter een 128 MB Infinity Cache, waarop de onderstaande resultaten voor single-stream berekeningen gebaseerd zijn. Het stroomverbruik van de kaart bedraagt 600 W met een configureerbare modus van 450 W; ons testexemplaar draaide op 450 W.
De MI350P gebruikt dezelfde CDNA 4-architectuur als de grotere, krachtigere MI350/5X GPU's. De MI350P kan in feite worden beschouwd als de helft van een MI350X. Om te begrijpen waarom, is het nuttig om te kijken naar de assemblage van de grotere GPU.
De MI350X is een 3D-gestapeld chiplet-ontwerp gebouwd op TSMC's CoWoS-verpakking (Chip-on-Wafer-on-Substrate), zonder één enkele monolithische chip. Acht acceleratorcomplex-chips (XCD's) bevinden zich boven twee I/O-chips, met vier XCD's op elke I/O-chip. AMD's Infinity Fabric verbindt de chiplets, terwijl acht HBM3E-stacks het geheugen van de GPU leveren. CoWoS beschrijft de integratie op pakketniveau; de compute-over-I/O-configuratie is het verticale, 3D-gestapelde onderdeel van het ontwerp.

De MI350P heeft de helft van die configuratie: vier XCD's, één I/O-die en vier HBM3E-stacks. Elke XCD heeft 32 actieve rekeneenheden, wat de kaart 128 rekeneenheden oplevert, vergeleken met de 256 van de MI350X. Ook de geheugencapaciteit is gehalveerd: 144 GB HBM3E tegenover 288 GB, 4 TB/s bandbreedte tegenover 8 TB/s en 128 MB Infinity Cache tegenover 256 MB.

| Specificaties | AMD Instinct MI350P |
|---|---|
| Platformoverzicht | |
| Architectuur | CDNA 4 |
| Bereken eenheden | 128 |
| Streamprocessors | 8,192 |
| Matrixkernen | 512 |
| Proces | TSMC 3nm en 6nm |
| Transistors | 73 miljard |
| Peak Engine Clock | 2,200MHz |
| Geheugen | |
| Hefvermogen | 144 GB HBM3E |
| Interface | 4,096-bit |
| bandbreedte | 4 TB/s |
| Laatste niveau cache | 128MB |
| ECC | Volledige chip |
| Maximale prestaties (aldus AMD) | |
| MXFP4 | 4.6 PFLOPS |
| MXFP6 | 4.6 PFLOPS |
| MXFP8 | 2.3 PFLOPS |
| OCP FP8 | 2.3 PFLOPS; 4.6 PFLOPS met gestructureerde spaarzaamheid |
| FP16 | 1.15 PFLOPS; 2.3 PFLOPS met sparse codering |
| BF16 | 1.15 PFLOPS; 2.3 PFLOPS met sparse codering |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Vermogen, koeling en vormfactor | |
| Typisch bordvermogen | Maximaal 600W; configureerbaar tot 450W |
| Stekker | 12V-2×6 |
| Koelen | Passieve |
| Form Factor | PCIe-uitbreidingskaart, volledige hoogte, dubbel slot |
| Bordlengte: | 10.5 binnen (267 mm) |
| Host Interface | PCIe 5.0 x16 |
| Kenmerken | |
| SR-IOV | Ja |
| Oneindige cache | Ja |
| RAS | Ja |
| Pensioen en vermijding | Ja |
Het vermogen van 600W is het maximum, en AMD laat de kaart configureren tot 450W, wat het verbruik was in onze 2U-host. De H200 NVL haalde hetzelfde vermogen van 450W in de R770, maar de RTX PRO 6000 draaide op zijn volle vermogen van 600W in de XE7740, waardoor de NVIDIA-kaart in elke vergelijking 150W meer vermogen had. De resultaten op vol vermogen wachten op een behuizing die een passieve kaart van 600W kan koelen, en in de technische handleiding van Dell voor de XE7745 staan acht MI350P's vermeld met een vermogen van 600W.
Nog een opmerking: de enkele 12V-2×6-connector en het 10.5-inch moederbord met twee sleuven, waardoor de kaart in dezelfde risers past als een RTX PRO 6000 of een H200 NVL.

De onderstaande tabel plaatst de MI350P naast de drie NVIDIA-systemen in onze grafieken: de RTX PRO 6000 Blackwell Server Edition, die dezelfde sleuf, hetzelfde stroomverbruik en dezelfde PCIe 5.0 x16 hostlink heeft; de H200 NVL, de Hopper-kaart met de bijbehorende geheugenbandbreedte; en de GB300 DGX Station, een enkele Blackwell Ultra GPU gekoppeld aan een Grace CPU via NVLink-C2C.
De belangrijkste gegevens om te lezen zijn de geheugencapaciteit, waarbij de 144 GB van de MI350P de grootste is van de drie PCIe-kaarten, 3 GB meer dan de H200 NVL en 48 GB meer dan de RTX PRO 6000; de geheugenbandbreedte, waar de 4 TB/s tussen die twee in ligt; en de FP4-lijn, waar AMD een dichte waarde noemt en NVIDIA een schaarse waarde.
| Specificaties | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server-editie | NVIDIA H200 NVL PCIe | NVIDIA GB300 DGX Station |
|---|---|---|---|---|
| GPU-architectuur | CDNA 4 | Blackwell | hopper | Blackwell-ultra |
| Vormfactor | PCIe-accelerator | PCIe-accelerator | PCIe-accelerator | Eén Blackwell Ultra GPU in combinatie met een Grace CPU met 72 kernen. |
| GPU-geheugen | 144 GB HBM3E | 96 GB GDDR7 ECC | 141 GB HBM3E | 252 GB HBM3E |
| GPU-geheugenbandbreedte | 4 TB/s | 1.6 TB/s | 4.8 TB/s | 7.1 TB/s |
| FP4 | 4.6 PFLOPS MXFP4 (Dense) | 4 PFLOPS NVFP4 (Sparse) | Geen native FP4 | 20 PFLOPS NVFP4 (Sparse) |
| FP8 | 2.3 PFLOPS (Dicht) | 2 PFLOPS (Sparse) | 3.3 PFLOPS (Sparse) | 10 PFLOPS (Sparse) |
| BF16 | 1.15 PFLOPS (Dicht) | 1 PFLOPS (Sparse) | 1.6 PFLOPS (Sparse) | 5 PFLOPS (Sparse) |
| FP32 | 72 TFLOPS (Dicht) | 120 TFLOPS (Sparse) | 60 TFLOPS (Sparse) | 80 TFLOPS (Sparse) |
| Hostverbinding | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C tussen Grace en GPU, 900 GB/s (BiDi) |
| Multi-GPU-connectiviteit | PCIe-gebaseerd | PCIe-gebaseerd | Twee- of vierweg NVLink, tot 900 GB/s per GPU (BiDi) | 800Gb/s ConnectX-8 netwerkverbinding tussen stations |
| Power | 450 tot 600W configureerbaar | 300 tot 600W configureerbaar | 450 tot 600W configureerbaar | Tot 1200W GPU met stroomschommelingen |
Het meest opvallende verschil met de RTX PRO 6000 is het geheugen van de MI350P. Deze heeft 50 procent meer GPU-geheugen en ongeveer 2.5 keer de geheugenbandbreedte. Voor een model dat niet comfortabel binnen 96 GB past, kan de extra capaciteit bepalend zijn of het op één GPU draait of dat het geheugen over meerdere GPU's verdeeld moet worden.
De RTX PRO 6000 is echter geschikt voor een breder scala aan taken, met hardware voor grafische weergave, raytracing en video, naast de AI-mogelijkheden. De keuze hangt van meer af dan alleen de twee piekrekenkrachtwaarden; het gaat er ook om wat het systeem verder moet doen.
De H200 NVL is de meest directe vergelijking voor de MI350P onder de PCIe-acceleratoren met veel geheugen; de grotere Blackwell datacenter-GPU's vallen in een andere categorie. De geheugencapaciteit is vrijwel identiek met 144 GB versus de 141 GB van de H200, beide gebruiken HBM3E, en de H200 biedt 20 procent meer geheugenbandbreedte met 4.8 TB/s. De twee schalen ook anders: alle drie de PCIe-kaarten maken via PCIe verbinding met de host, maar de H200 NVL voegt daar dedicated GPU-to-GPU-connectiviteit aan toe via NVLink-bridges waarmee tot vier GPU's kunnen worden verbonden.
De grotere MI350X en MI355X waren ontworpen om te concurreren met Blackwell, maar de MI350P halveert die hardwareconfiguratie. Daardoor komt hij qua geheugenkenmerken en algehele positionering dichter in de buurt van de H200 NVL. Een punt waarop de MI350P zich nog steeds onderscheidt, is de native ondersteuning voor MXFP4 en MXFP6, wat steeds belangrijker wordt naarmate inferentie zich ontwikkelt naar lagere precisie.
Het kleinere geheugensubsysteem is een ander compromis, omdat AMD de vermindering van het aantal HBM-stacks niet heeft gecompenseerd met snellere HBM3E. Daardoor blijft de MI350P met een bandbreedte van 4 TB/s achter op de H200 NVL wat dit betreft. Dit kan de prestaties beperken bij workloads die afhankelijk zijn van de geheugenbandbreedte, ongeacht de beschikbare rekenkracht, zoals de resultaten van de geheugenbandbreedte en de lange inferentietests later in de review aantonen.
De vergelijking met de DGX Station werkt precies andersom, omdat de GB300 Station een volledige B300 GPU bevat met één HBM-stack uitgeschakeld, een chip van datacenterklasse met een datacenter-energiebudget, terwijl de MI350P de helft is van een chip van datacenterklasse die past in de 600W-behuizing van een PCIe-uitbreidingskaart. AMD heeft twee of vier MI350P's nodig om aan die ene GPU te voldoen, en op papier doen twee ervan dat ook: 288 GB en 8 TB/s tegenover de 252 GB en 7.1 TB/s van de Station. Die resources bevinden zich echter op twee kaarten, en een workload die beide kaarten omvat, wisselt gegevens uit via PCIe peer-to-peer, wat de toegevoegde waarde van de tweede kaart beperkt.
Prestaties
Testplatform
Het MI350P-testmodel is een Dell PowerEdge R7725 met twee AMD EPYC 9555-processors (elk 64 cores), 1.5 TB DDR5-6400 verdeeld over 24 DIMM's en twee MI350P-kaarten ingesteld op 450 W, de limiet voor een 2U-server. De RTX PRO 6000 Blackwell Server Edition-kaarten (600 W) draaiden in de Dell PowerEdge XE7740 die onze inferentieconfiguratie met vier kaarten bevat, een enkele H200 NVL (450 W) draaide in de Dell PowerEdge R770 uit onze review en de GB300-cijfers zijn afkomstig van het ASUS ExpertCenter Pro ET900N G3 DGX-station dat we in september hebben getest.

De onderstaande iDRAC-inventaris laat zien hoe de twee kaarten zijn geplaatst. Ze zitten in PCIe-slots 2 en 7, beide Gen5 x16 en beide geven aan dat ze in goede staat verkeren. De apparaatsleutels, 0-139-0 en 1-199-0, geven aan dat er één kaart achter elke EPYC-socket zit. Tensor-parallel verkeer tussen de twee MI350P's loopt dus via de socketverbinding tussen de root-complexen. Dit is de standaardconfiguratie voor een 2U-server met twee kaarten, en het is belangrijk om dit in gedachten te houden bij de latere resultaten met twee kaarten.

De geheugenweergave toont de rest van de host: 24 DIMM's van 64 GB DDR5-6400, dual rank, goed voor 1,536 GB in een server die maximaal 6 TB kan bevatten, allemaal met multi-bit ECC. De beschikbare ruimte is belangrijk voor de GLM-5.2-run, waarbij het MXFP4-checkpoint niet in de 288 GB van twee kaarten past en vLLM een deel van de expert-taken naar het hostgeheugen verplaatst.

Maximaal haalbare Matmul FLOPS (MAMF)
Om de rekenkracht van de MI350P in perspectief te plaatsen, hebben we MAMF uitgevoerd op de vier systemen. MAMF (Maximum Achievable Matmul FLOPS) is een praktische prestatiemaatstaf die is ontworpen om de realistische piek van drijvende-komma-bewerkingen per seconde te meten die een accelerator bereikt tijdens matrixvermenigvuldiging. Dit is een nuttigere benchmark dan de theoretische piek-FLOPS in de specificaties. We hebben elk systeem getest in BF16, FP8 en blokgeschaalde FP4 en rapporteren het beste aanhoudende dichte resultaat per precisie; de gearceerde balken vermenigvuldigen het resultaat van elke PCIe-kaart met het aantal kaarten dat is gebruikt in de grote modelberekeningen en zijn berekend zonder dat er een meting aan ten grondslag ligt.

Met een vermogen van 450W behaalt één MI350P 580 TFLOPS in BF16, 1,120 in FP8 en 2,228 in FP4. De RTX PRO 6000 Blackwell volgt met 419, 820 en 1,634, waardoor de MI350P een voorsprong van 36 tot 38 procent heeft op de NVIDIA-kaart bij elke precisie, terwijl hij 150W minder verbruikt. Het grootste verschil wordt bereikt in BF16 met 38.4 procent.
De H200 NVL behaalt 652 TFLOPS in BF16 en 1,205 TFLOPS in FP8, waarmee hij de MI350P op beide vlakken voorbijstreeft, maar hij heeft geen FP4-pad. De GB300 DGX Station presteert beter dan alle drie de PCIe-kaarten met respectievelijk 1,924, 3,802 en 6,024 TFLOPS, ongeveer 3.3 keer zo goed als de MI350P in BF16 en 2.7 keer zo goed in FP4; twee MI350P's halen op papier respectievelijk 1,160 en 4,456 TFLOPS, maar blijven achter bij de enkele GPU van de Station. De NVIDIA MAMF-cijfers in deze review zijn afkomstig van onze meest recente tests met elke kaart en vervangen de resultaten van onze eerdere tests.
GPU-geheugenbandbreedte
De pure rekenkracht is alleen nuttig als de accelerator zijn uitvoereenheden constant van data kan voorzien. Dit is vooral belangrijk voor inferentie, waarbij de tokengeneratie tijdens de decodeerfase meer wordt beperkt door de geheugenbandbreedte dan door het aantal beschikbare FLOPS. De bandbreedtetest leest, schrijft en kopieert GPU-geheugen via rekenkernels en de kopieerengine, en toont de beschikbare bandbreedte binnen elke GPU ten opzichte van de nominale waarde.

Een MI350P leest zijn HBM3E-geheugen met een snelheid van 3,291 GB/s en schrijft met 3,204 GB/s, ongeveer 80 procent van de nominale 4 TB/s, met kopieersnelheden van 1,276 tot 1,283 GB/s; een kopie verbruikt tweemaal bandbreedte, eenmaal om de bron te lezen en eenmaal om de bestemming te schrijven. De GDDR7 van de RTX PRO 6000 haalt 1,540 GB/s bij het lezen en 1,483 GB/s bij het schrijven, dus de MI350P heeft ongeveer 2.1 keer zoveel bruikbare bandbreedte per kaart.
De H200 NVL haalt leessnelheden van 4,472 GB/s en schrijfsnelheden van 4,156 GB/s, respectievelijk 36 en 30 procent meer dan de MI350P, wat overeenkomt met de 4.8 TB/s van de MI350P tegenover 4 TB/s. De GB300 DGX Station haalt zelfs 6,869 GB/s. Twee MI350P's samen gemeten halen een leessnelheid van 6,529 GB/s, vergelijkbaar met de Station, maar die bandbreedte is verdeeld over twee PCIe-slots. Een model dat beide slots beslaat, betaalt voor elke uitwisseling via PCIe.
Gevolgtrekking
Nu de tests op laag niveau zijn afgerond, gaan we verder met LLM-inferentie. Onze vLLM-test voor online servering stuurt een OpenAI-compatibel eindpunt aan met een vast aantal gelijktijdige streams en registreert het aantal uitvoertokens per seconde gedurende de hele test. We rapporteren twee patronen: 512 tokens in en 512 uit, wat overeenkomt met de grootte van een chat en veel decodering vereist, en 8,192 in en 1,024 uit, wat overeenkomt met de grootte van een RAG en een document en sterk leunt op prefill. De gelijktijdigheid verdubbelt vanaf één stream en elke grafiek stopt bij de hoogste gelijktijdigheid waarbij elke kaart in de grafiek is voltooid. Elk punt vertegenwoordigt twee verzoeken per stream, dus de cijfers voor één stream zijn gebaseerd op twee verzoeken en vertonen meer variatie tussen runs dan de punten met een hogere gelijktijdigheid.
Elk model draaide op het minimale aantal kaarten dat het aankon: één MI350P voor alles tot en met GPT-OSS-120B en MiniMax-M2.7, en twee voor DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 en GLM-5.3 Flash. De RTX PRO 6000-runs volgen dezelfde regel, waarbij twee RTX-kaarten tegen één MI350P op MiniMax-M2.7 worden gezet en vier tegen twee op MiniMax-M3 en GLM-5.2. Builds met lage precisie verschillen per fabrikant: die van AMD zijn MXFP4 tot en met Quark, die van NVIDIA zijn NVFP4, en de FP4-combinaties worden overal zo gelabeld. GPT-OSS wordt geleverd als MXFP4 en draait met dezelfde gewichten op elke kaart. De H200 NVFP4-builds zijn niet inbegrepen.
| Model | MI350P | RTX PRO 6000 Blackwell | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|
| GLM-5.3 Flash | 2 kaarten, MXFP4 | Niet uitvoeren | Niet uitvoeren | NVFP4 |
| GLM-5.2 | 2 kaarten, MXFP4 (offloadt naar hostgeheugen) | 4 kaarten, NVFP4 | Niet uitvoeren | NVFP4 (ongeveer 215 GB aan geheugen voor experts in Grace) |
| MiniMax-M3 | 2 kaarten, MXFP4 | 4 kaarten, NVFP4 | Niet uitvoeren | NVFP4 (een deel van de experts in Grace-geheugen) |
| DeepSeek-V4-Flash | 2 kaarten, FP8 | 2 kaarten, FP8 | Niet uitvoeren | FP8 |
| MiniMax-M2.7 | 1 kaart, MXFP4 | 2 kaarten, NVFP4 | Niet uitvoeren | NVFP4 |
| GPT-OSS-120B | 1 kaart, MXFP4 | 1 kaart, MXFP4 | 1 kaart, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 kaart, MXFP4 | 1 kaart, MXFP4 | 1 kaart, MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | 1 kaart, FP8 en BF16 | 1 kaart, FP8 en BF16 | 1 kaart, FP8 en BF16 | FP8 en BF16 |
| Mistral Klein 3.1 24B | 1 kaart, FP8 en BF16 | 1 kaart, FP8 en BF16 | 1 kaart, FP8 en BF16 | FP8 en BF16 |
| Lama 3.1 8B | 1 kaart, MXFP4, FP8 en BF16 | 1 kaart, NVFP4, FP8 en BF16 | 1 kaart, FP8 en BF16 | NVFP4, FP8 en BF16 |
Als je de kolom MI350P bekijkt, zie je als eerste het aantal kaarten dat bij 144 GB hoort. Zes van de tien modellen draaien op één MI350P, terwijl de 96 GB van de RTX PRO 6000 een tweede kaart nodig heeft voor MiniMax-M2.7. De twee MXFP4-testmodellen die op twee MI350P's draaien, MiniMax-M3 en GLM-5.2, vereisen vier RTX PRO 6000's. GLM-5.2 is het model dat zelfs 288 GB overstijgt, en vLLM verplaatst een deel van zijn expertbelasting naar het hostgeheugen van de R7725 voor die test; de GB300 doet hetzelfde met ongeveer 215 GB aan expertbelasting in Grace-geheugen.
De MI350P-resultaten voor de modellen met één videokaart zijn gebaseerd op gegevens van 27 oktober, gebaseerd op AMDGPU 31.60, ROCm 10.1.0 en vLLM 0.32.0. De door Dell gevalideerde combinatie is vLLM 0.27 met ROCm 10.0 en AMDGPU 31.5, en wij zijn nog een stap verder gegaan naar de ROCm 10.1-release van 5 oktober. De NVIDIA-kaarten draaiden de vLLM 26.08-container op CUDA 13.4.1. De tabel geeft de build weer die bij elke run hoort.
| Model | vLLM-afbeelding |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 Flash MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Lama 3.1 8B BF16 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Small 3.1 24B BF16 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Mistral Small 3.1 24B FP8 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 op ROCm 10.1.0, AMDGPU 31.60 (27 oktober) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Small 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
De vier modellen met twee kaarten, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 en GLM-5.3 Flash, zijn afkomstig van tests uitgevoerd met ROCm 7.2.3. Onze ROCm 10.1-tests met deze modellen maakten gebruik van CPU expert offload en, bij DeepSeek-V4-Flash, een speculatieve decoder die de NVIDIA-tests niet gebruikten. Dit maakt ze tot een andere test, dus worden ze bewaard voor een schone test met de huidige stack. De tabellen labelen elke MI350P-rij met de bijbehorende stack.
AMD geeft de voorkeur aan de AIM-containers voor deze modellen; de Enterprise AI Suite 2.5-release van 9 oktober is gevalideerd op ROCm 10 en bevat AIM's voor GPT-OSS-120B, Llama 3.3 70B en Gemma 3 27B, maar de acceleratortabel van AMD vermeldt vooralsnog alleen een geoptimaliseerd MI350P-profiel voor Wan2.2. De standaard vLLM-configuratie is daarom nog steeds de route die een MI350P-koper momenteel kiest, en dat is ook wat wij hebben gemeten.
Inferentieresultaten in één oogopslag
Hieronder staan 28 grafieken, dus hier is de korte versie in twee tabellen: uitvoertokens per seconde voor elk model bij de hoogste gelijktijdigheid die elke kaart heeft voltooid, met eerst de workload van 512 in- en 512 uitgaande tokens (ter grootte van een chat). De cijfers voor de MI350P zijn gebaseerd op één kaart van 450W, tenzij de rij anders aangeeft, met een kolom voor de stack waar elke rij vandaan komt; het GB300 DGX Station is een enkele B300.
| Model | Videokaarten (MI350P / RTX PRO 6000) | MI350P-stapel | Streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 versus NVFP4) | 2 / geen | ROCm 7.2.3 | 32 | 1,462 | Niet uitvoeren | Niet uitvoeren | 828 |
| GLM-5.2 (MXFP4 versus NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 59 | 40 | Niet uitvoeren | 139 |
| MiniMax-M3 (MXFP4 versus NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 1,509 | 759 | Niet uitvoeren | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 1,081 | 829 | Niet uitvoeren | 1,766 |
| MiniMax-M2.7 (MXFP4 versus NVFP4) | 1 / 2 | ROCm 10.1 | 128 | 1,524 | 1,932 | Niet uitvoeren | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 8,383 | 8,869 | Niet uitvoeren | 28,400 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Lama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
Twee resultaten springen eruit in de chattabel: de MI350P verslaat de RTX PRO 6000 op elk FP8-, BF16- en GPT-OSS-model met 35 tot 65 procent bij 128 streams, blijft alleen achter bij NVIDIA's NVFP4-builds aan de bovenkant van de Llama- en MiniMax-M2.7-curves, en verdubbelt de NVIDIA-kaart ruwweg bij één stream op Llama 3.1 8B en Mistral Small 24B, waar 4 TB/s HBM3E het werk doet.
De H200 NVL, met 20 procent meer bandbreedte, blijft 4 tot 18 procent voor op de dense FP8- en BF16-modellen bij 128 streams en behaalt dezelfde resultaten als de Llama 3.1 8B FP8; op de twee GPT-OSS-modellen is de volgorde omgekeerd en eindigt de MI350P met een voorsprong van respectievelijk 50 en 78 procent.
De tweede tabel herhaalt de oefening met de prompts van 8,192 tokens, waarbij prefill de boventoon voert en de balans tussen rekenkracht en geheugenbandbreedte verschuift naar de NVIDIA-kaarten.
| Model | Videokaarten (MI350P / RTX PRO 6000) | MI350P-stapel | Streams | MI350P | RTX PRO 6000 | H200 NVL | GB300 DGX-station |
|---|---|---|---|---|---|---|---|
| GLM-5.3 Flash (MXFP4 versus NVFP4) | 2 / geen | ROCm 7.2.3 | 32 | 760 | Niet uitvoeren | Niet uitvoeren | 1,219 |
| GLM-5.2 (MXFP4 versus NVFP4) | 2 / 4 | ROCm 7.2.3 | 16 | 6 | 9 | Niet uitvoeren | 87 |
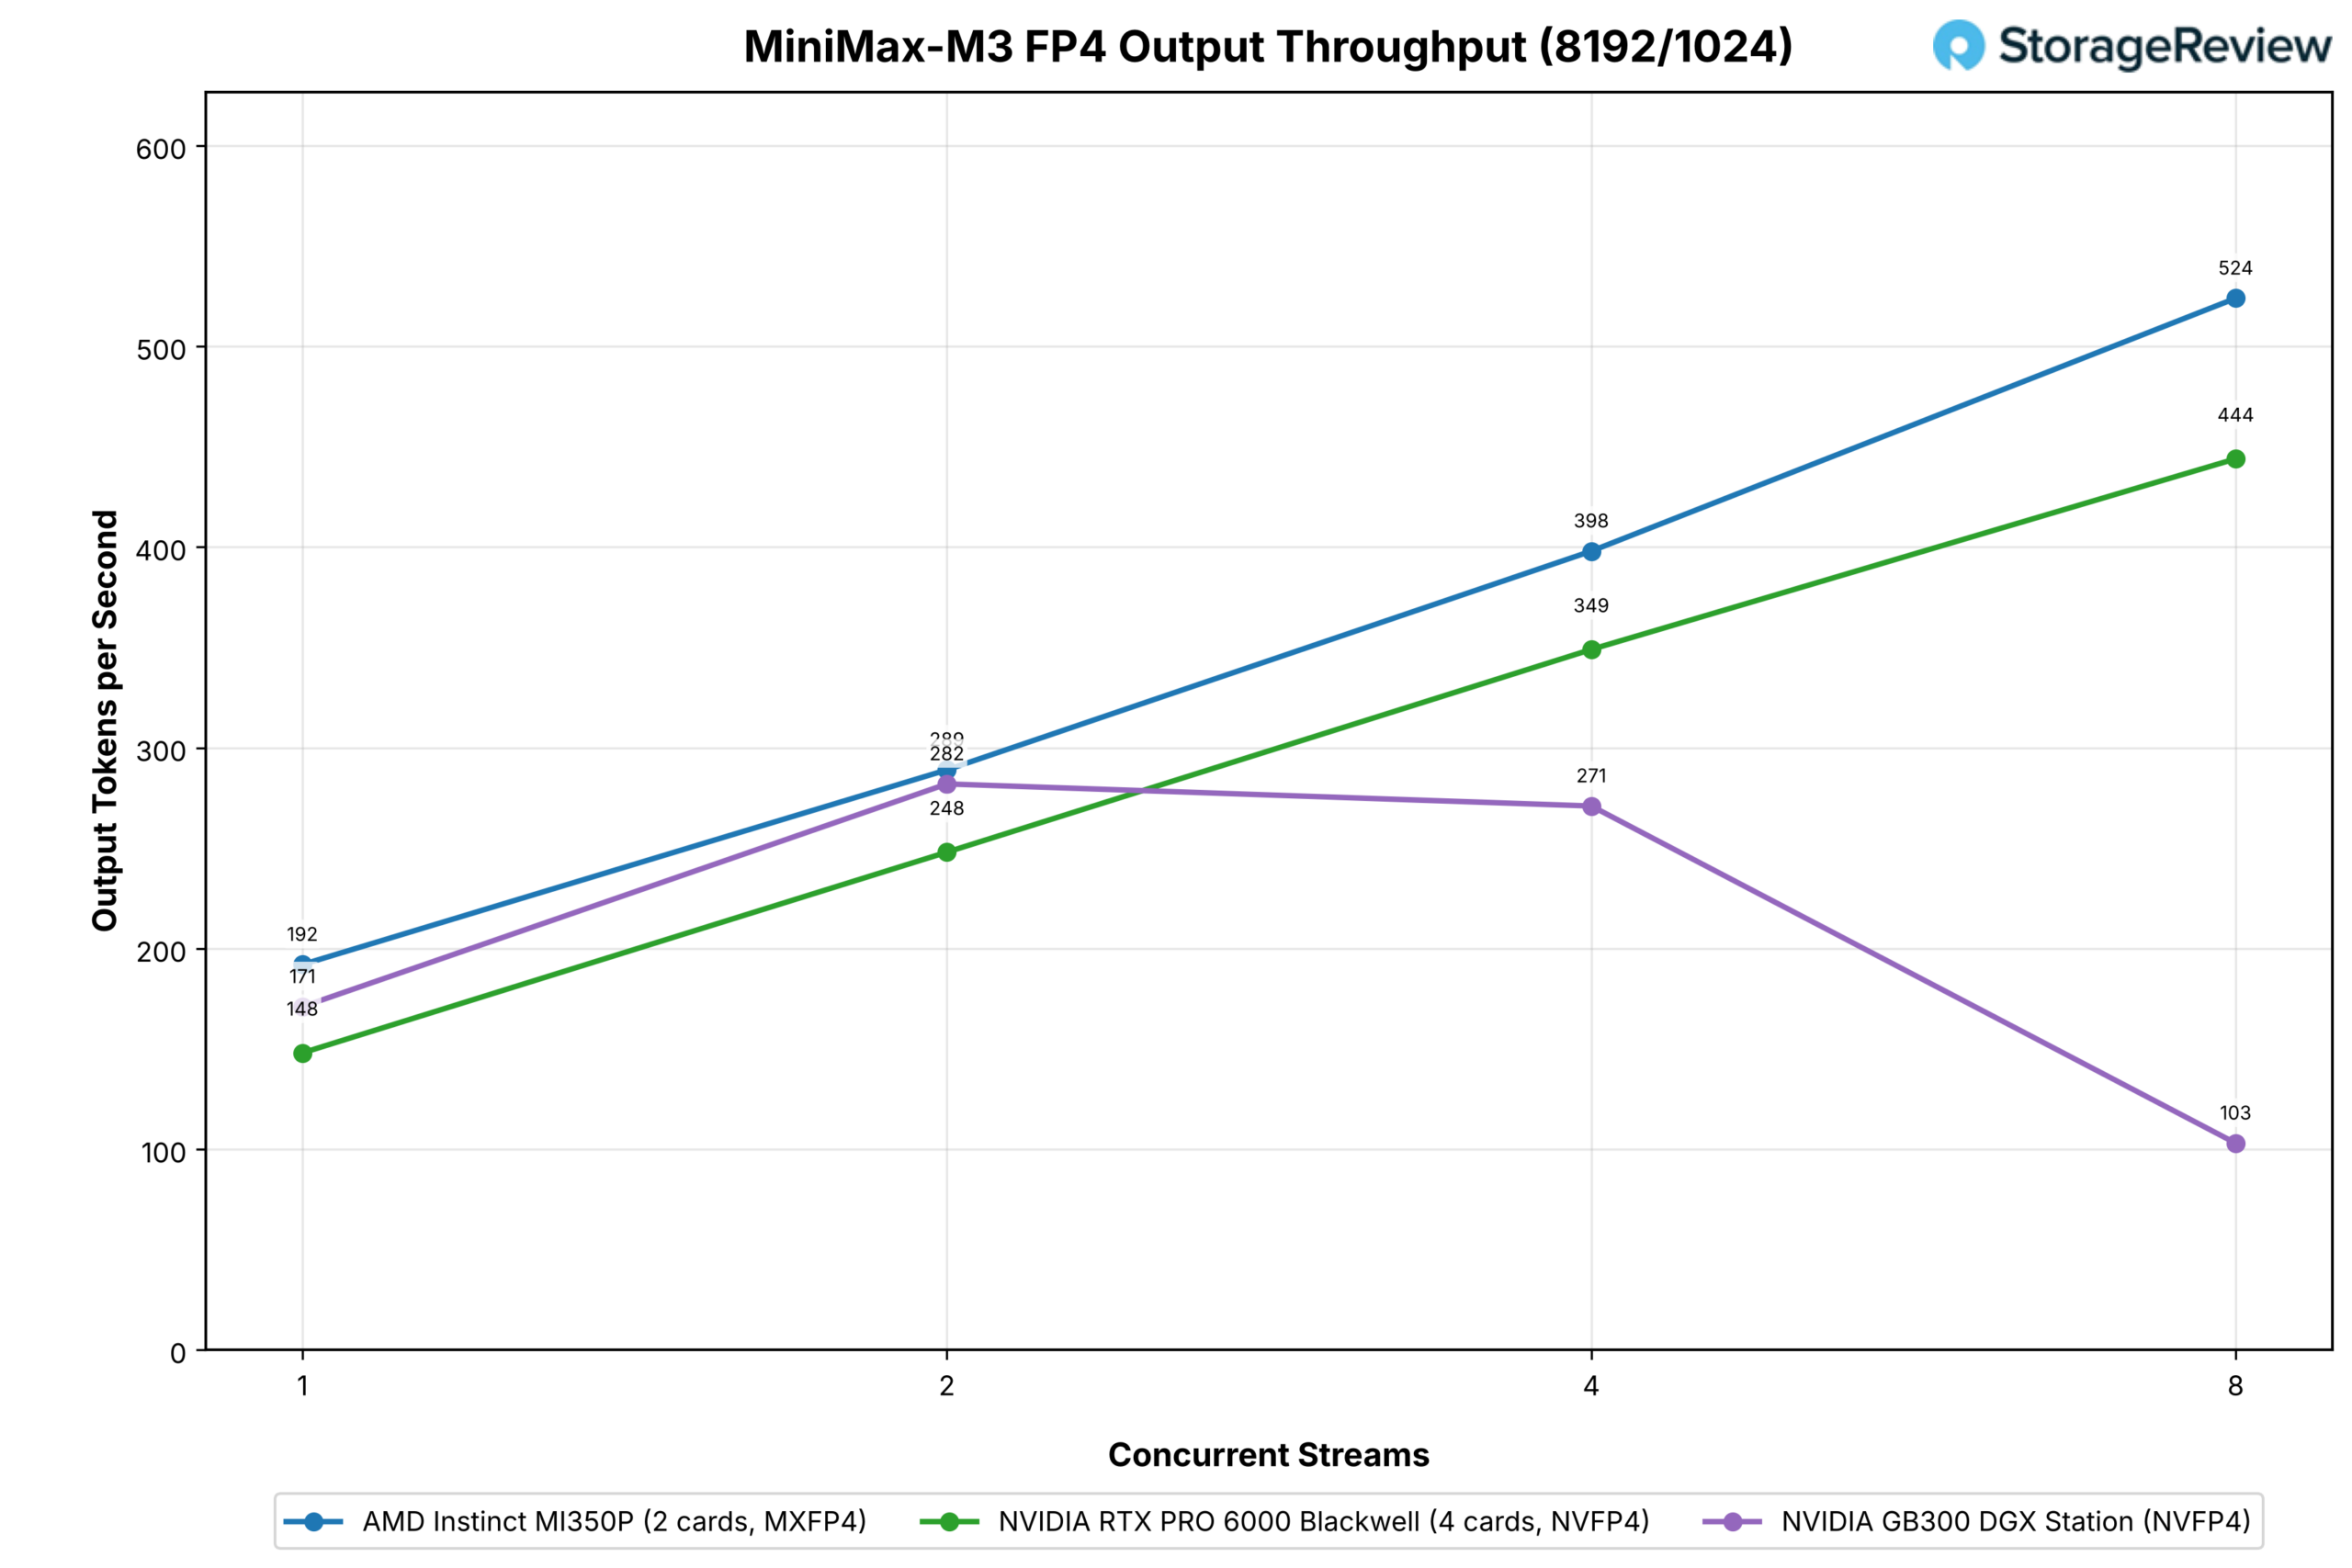
| MiniMax-M3 (MXFP4 versus NVFP4) | 2 / 4 | ROCm 7.2.3 | 8 | 524 | 444 | Niet uitvoeren | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 621 | 345 | Niet uitvoeren | 954 |
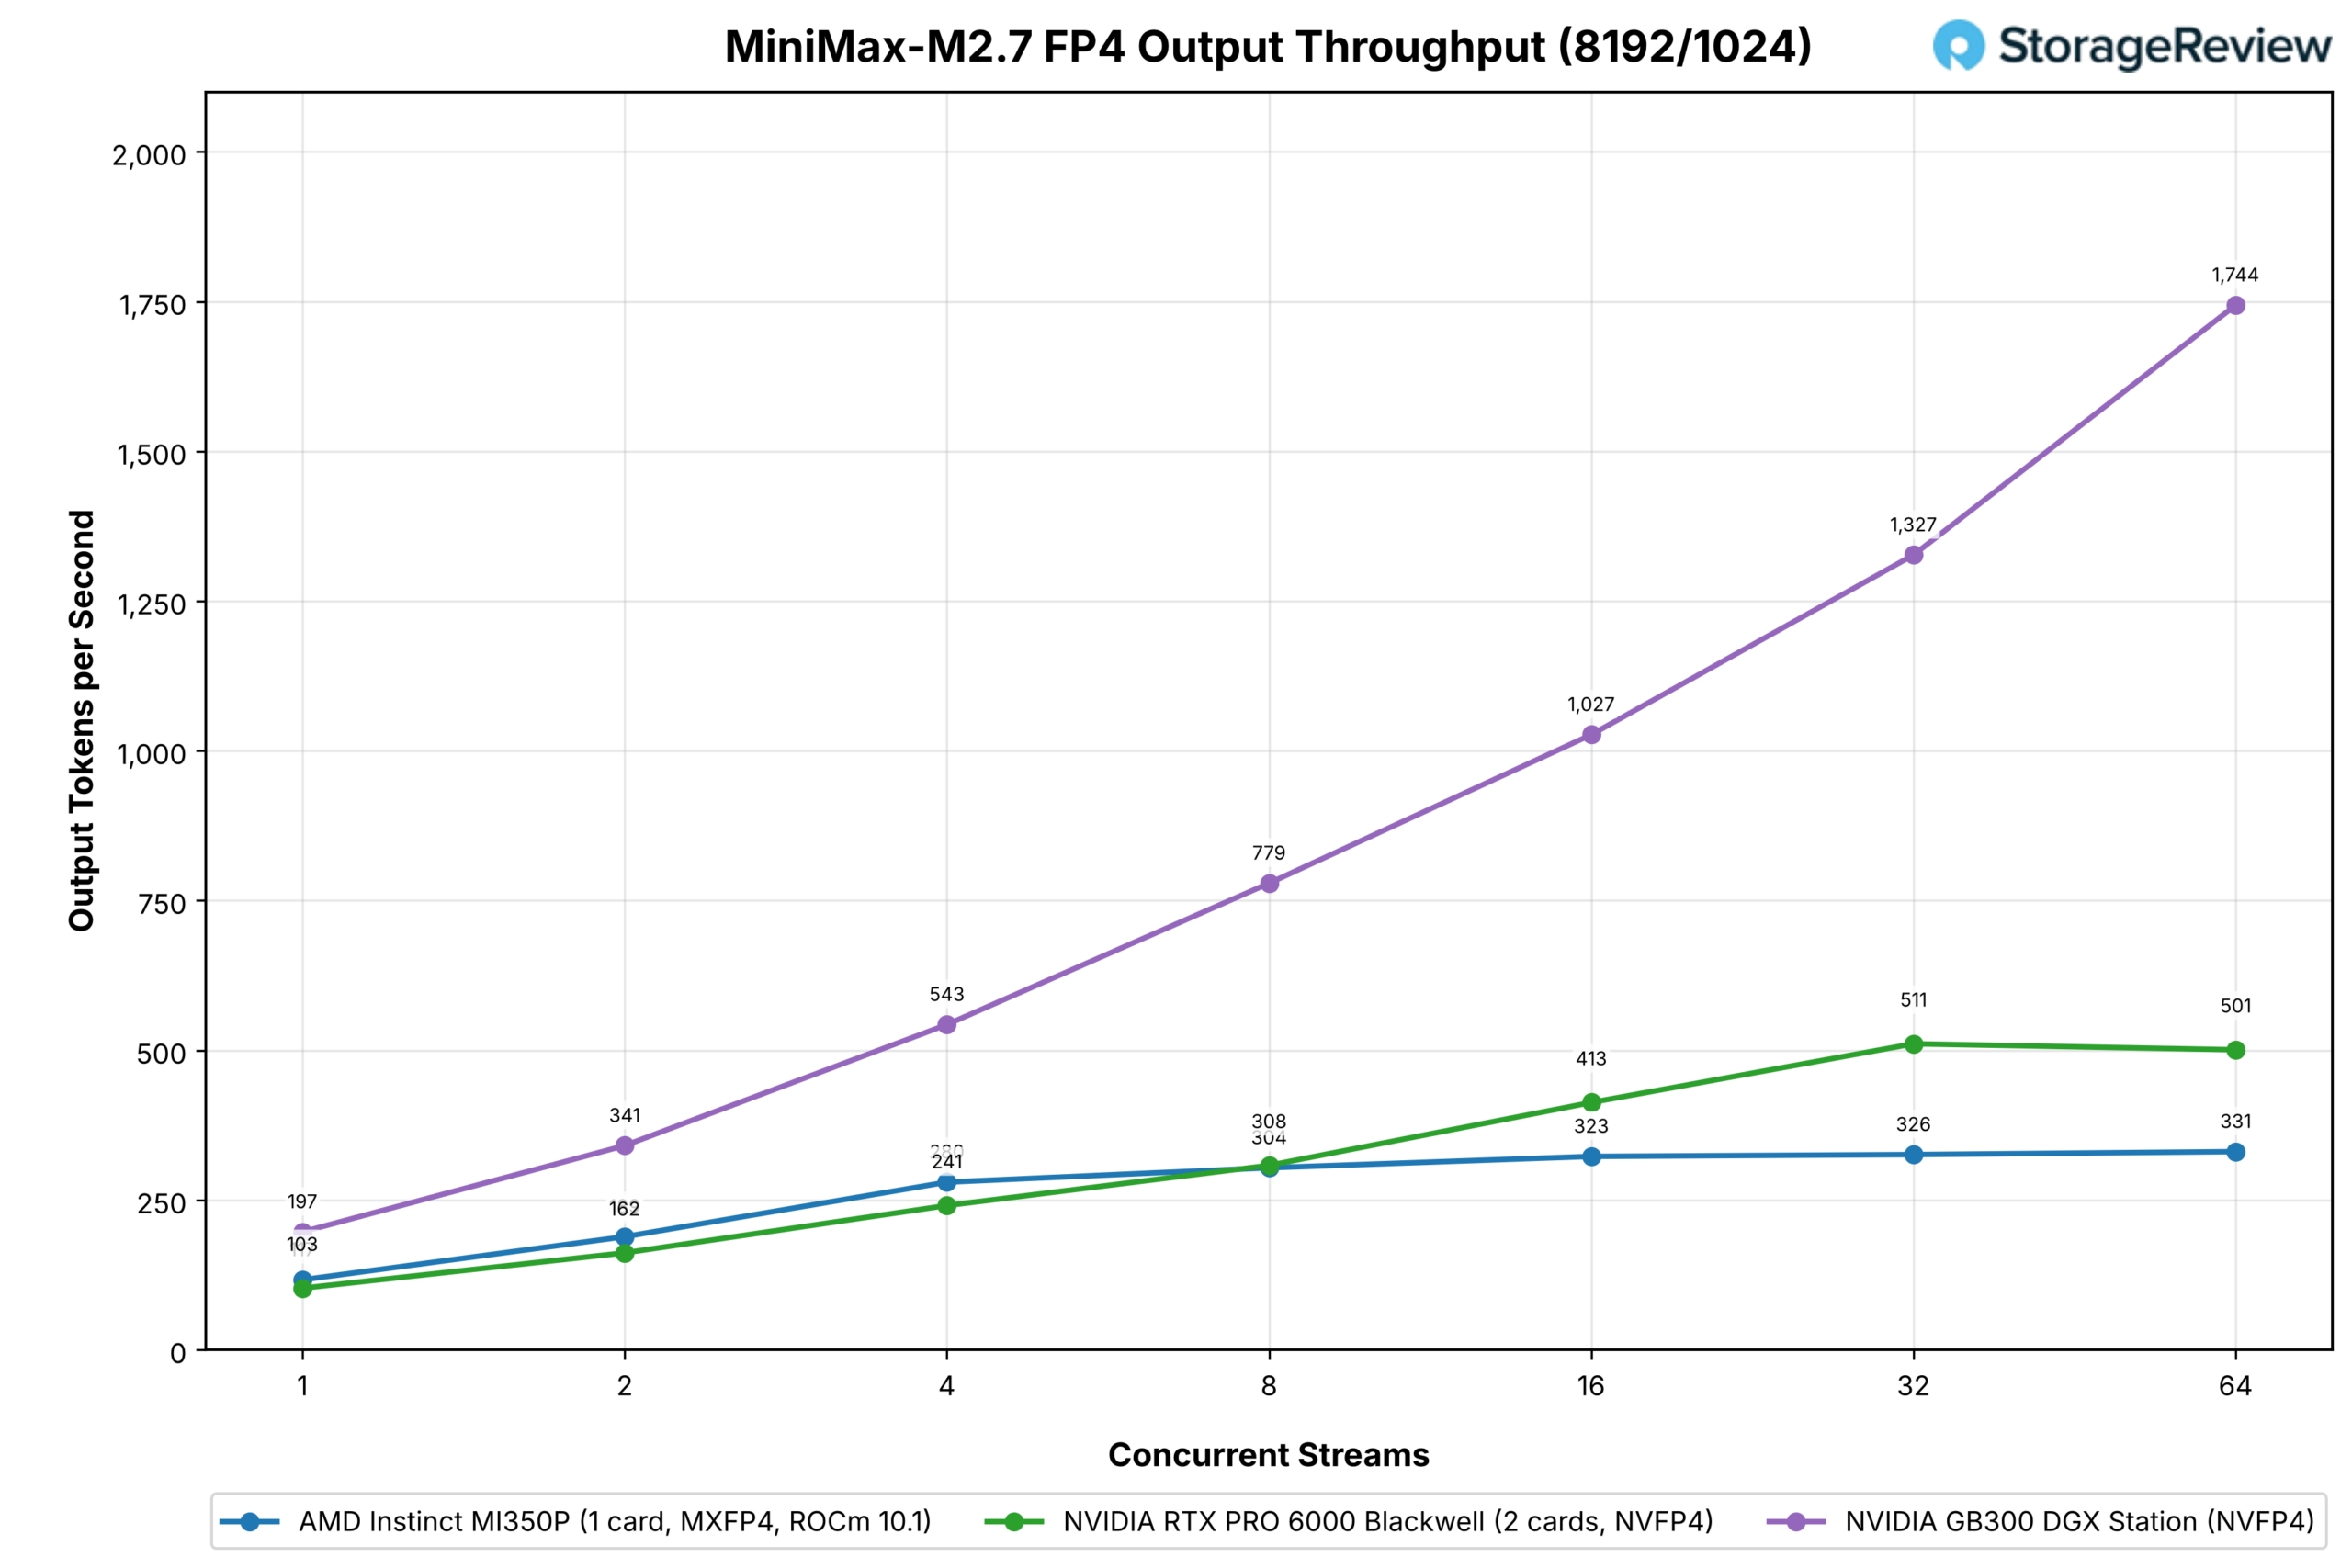
| MiniMax-M2.7 (MXFP4 versus NVFP4) | 1 / 2 | ROCm 10.1 | 64 | 331 | 501 | Niet uitvoeren | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
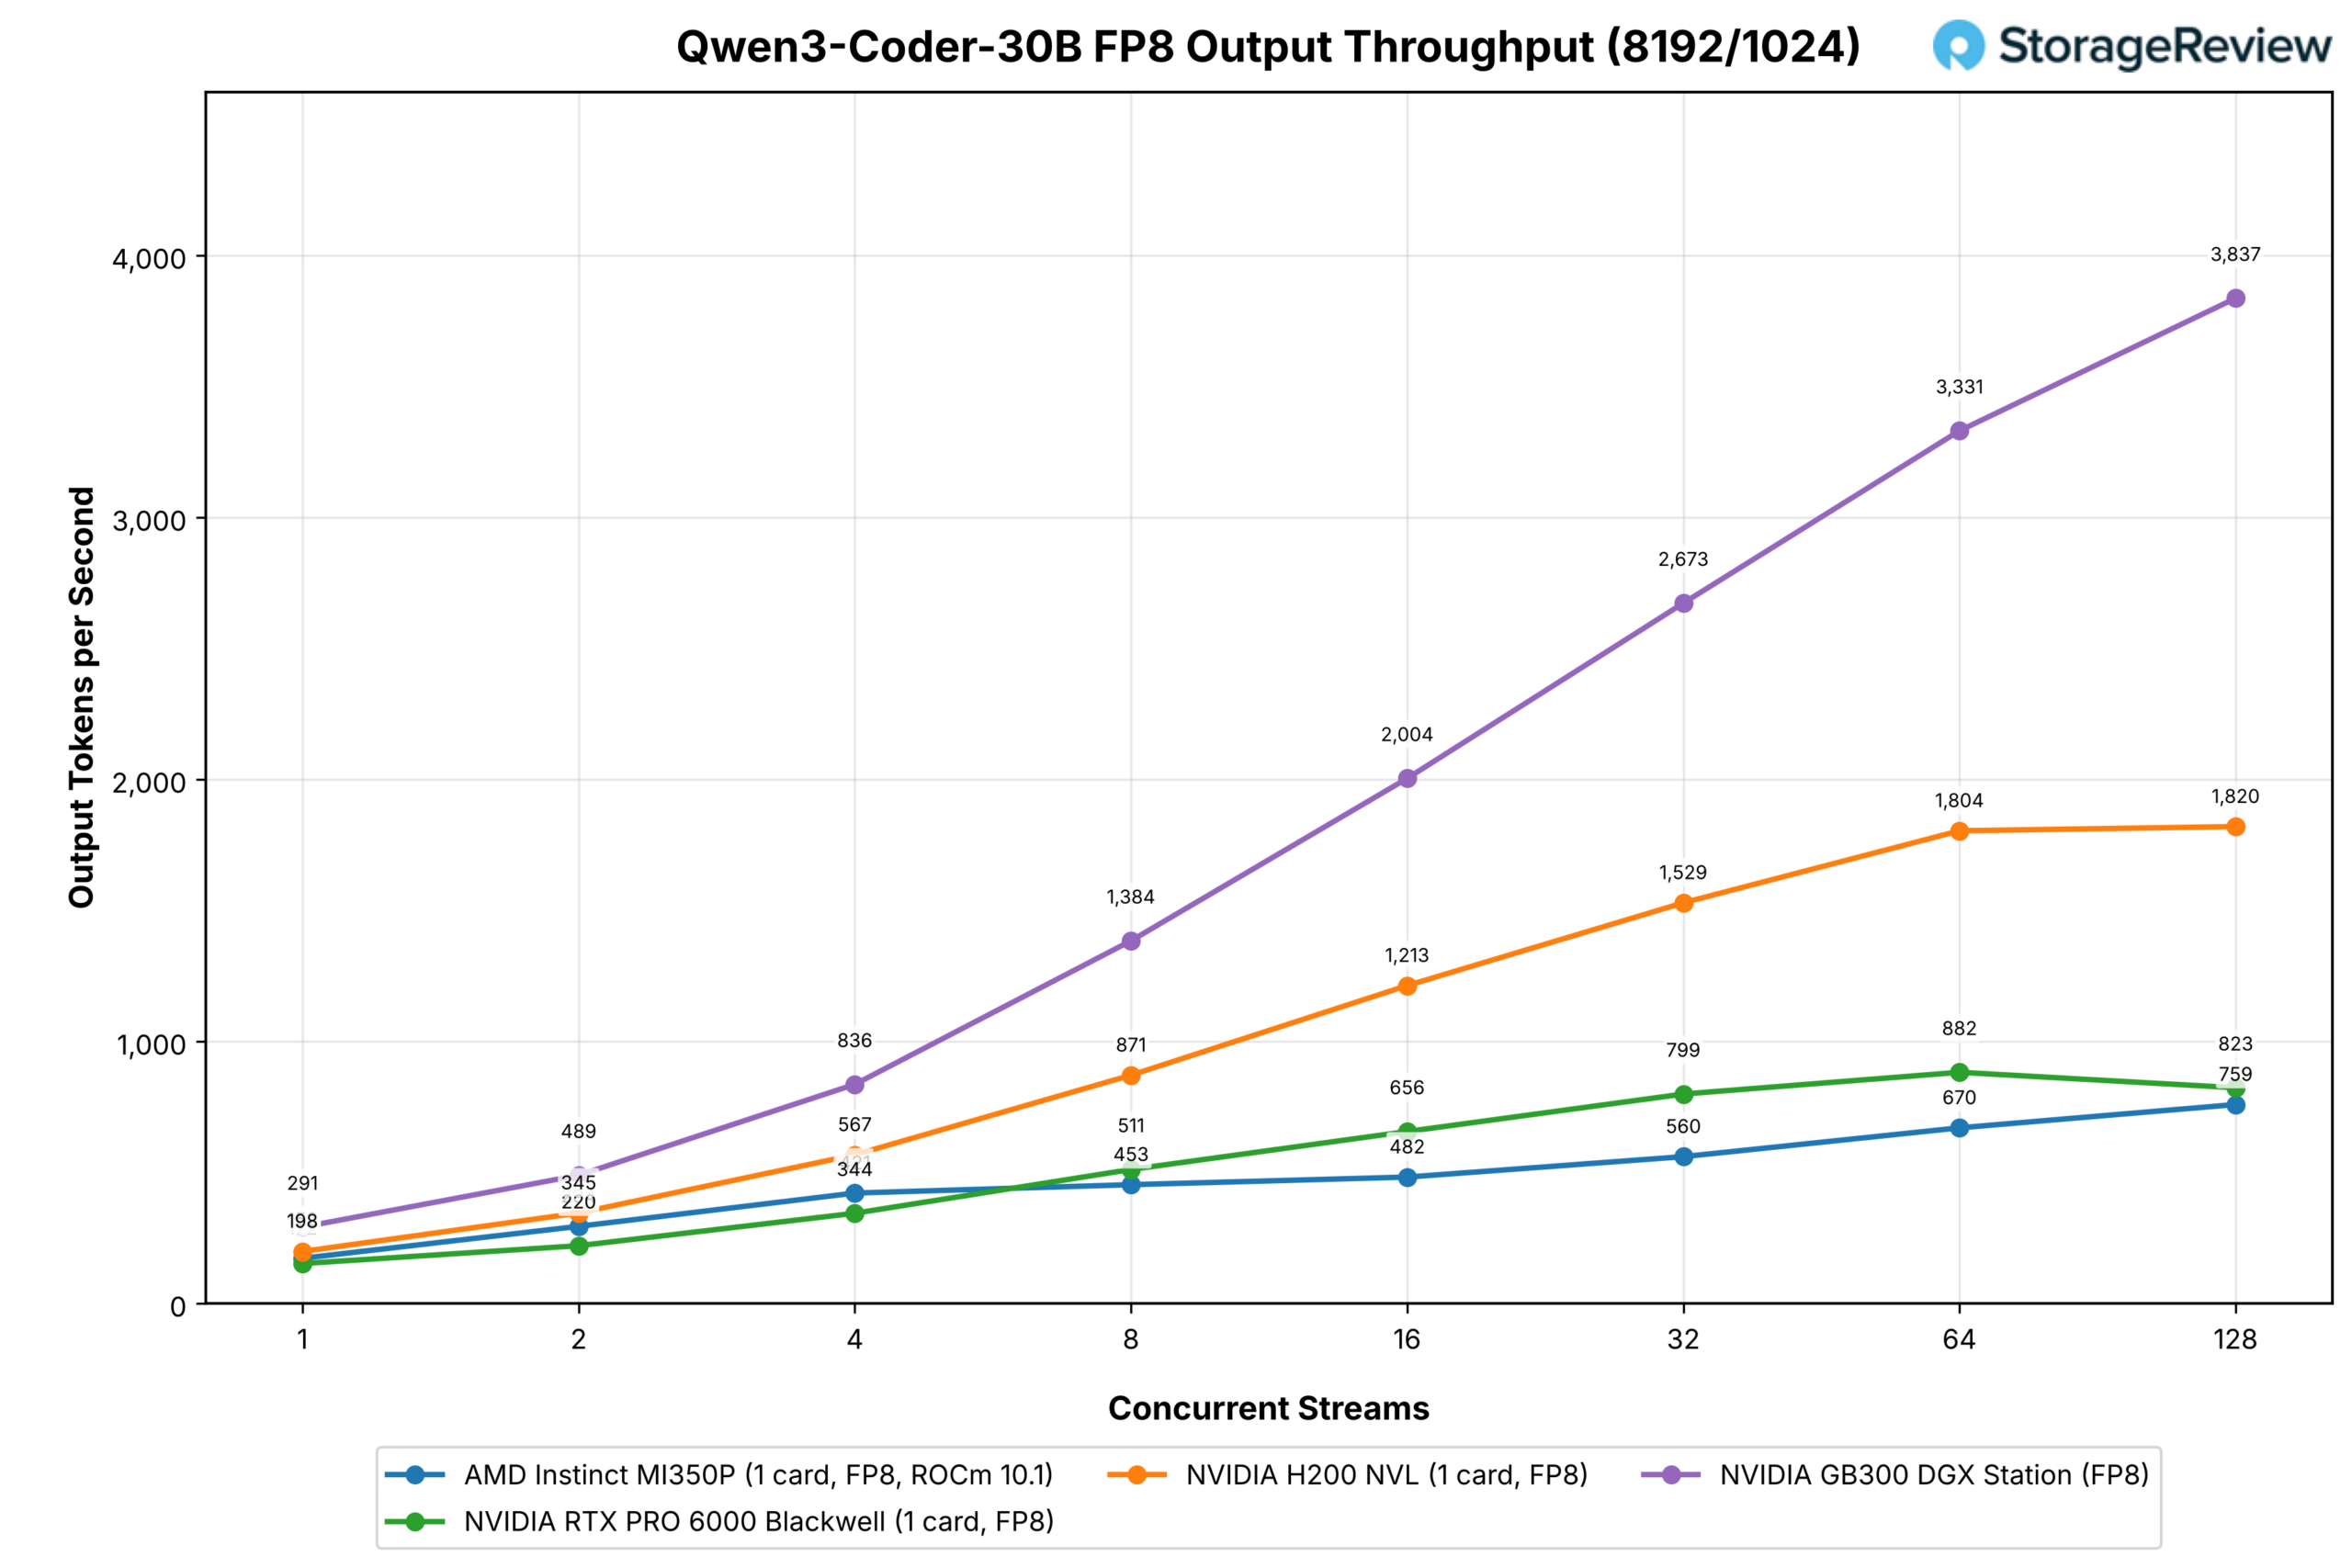
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
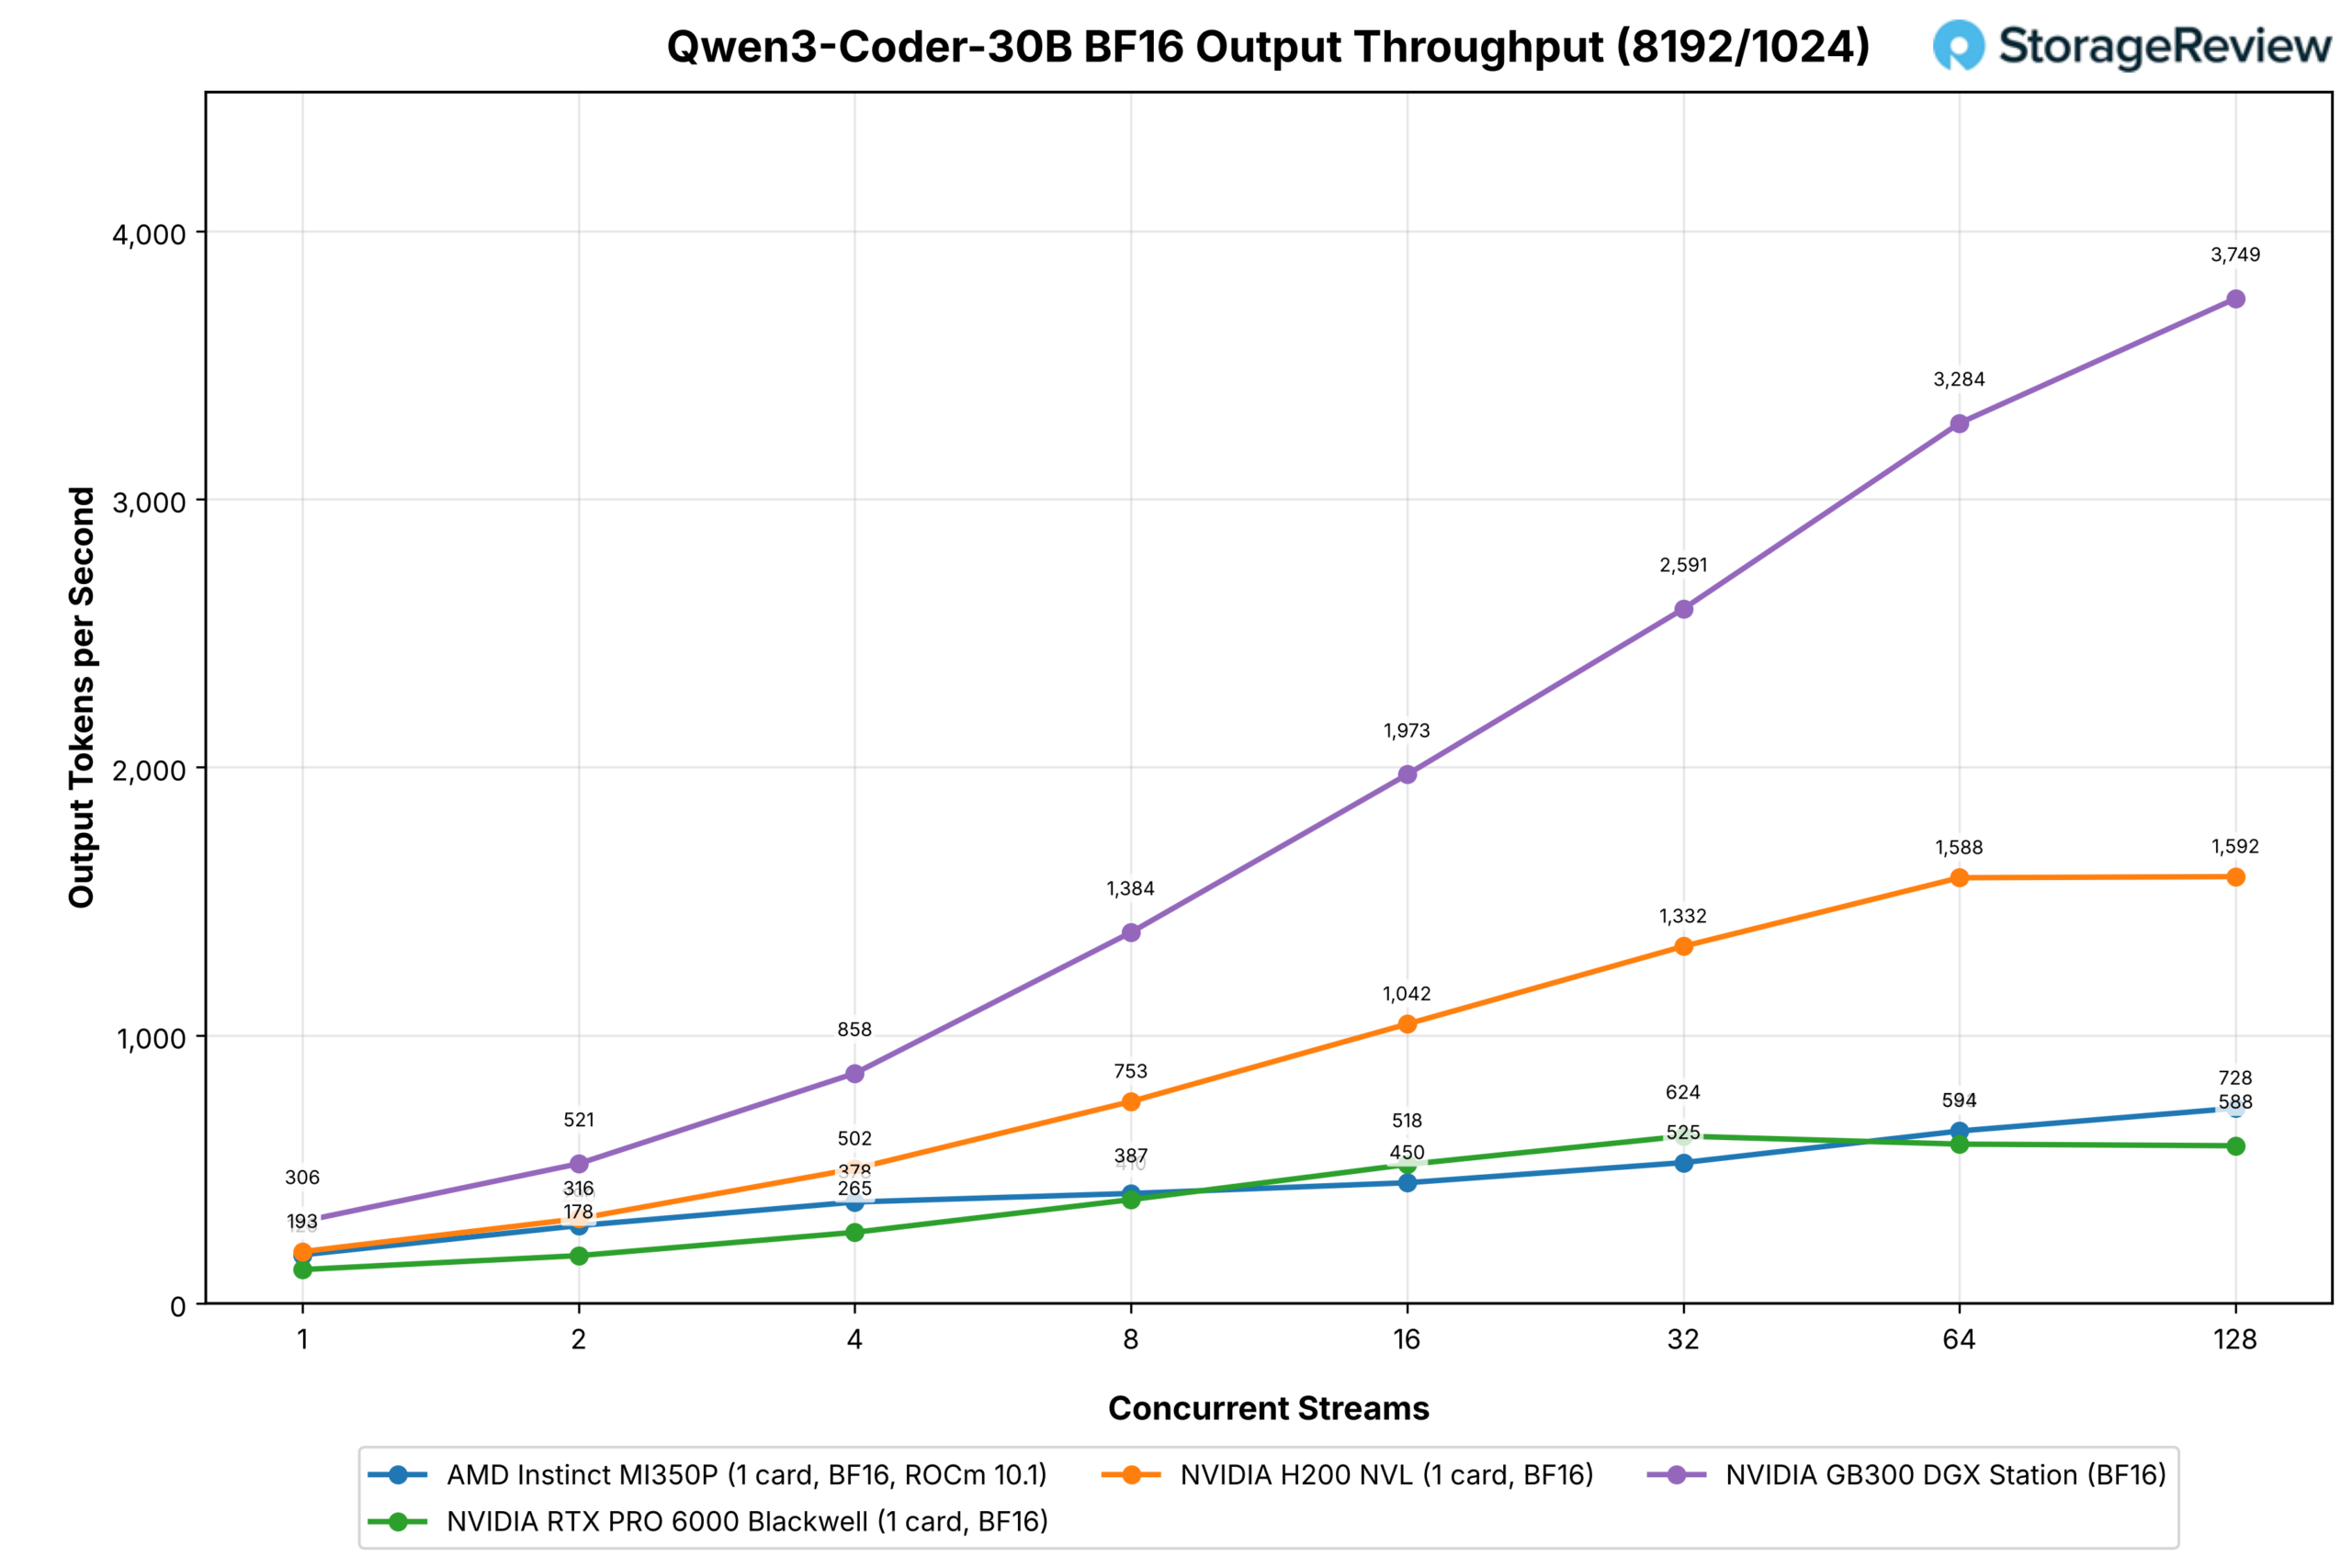
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
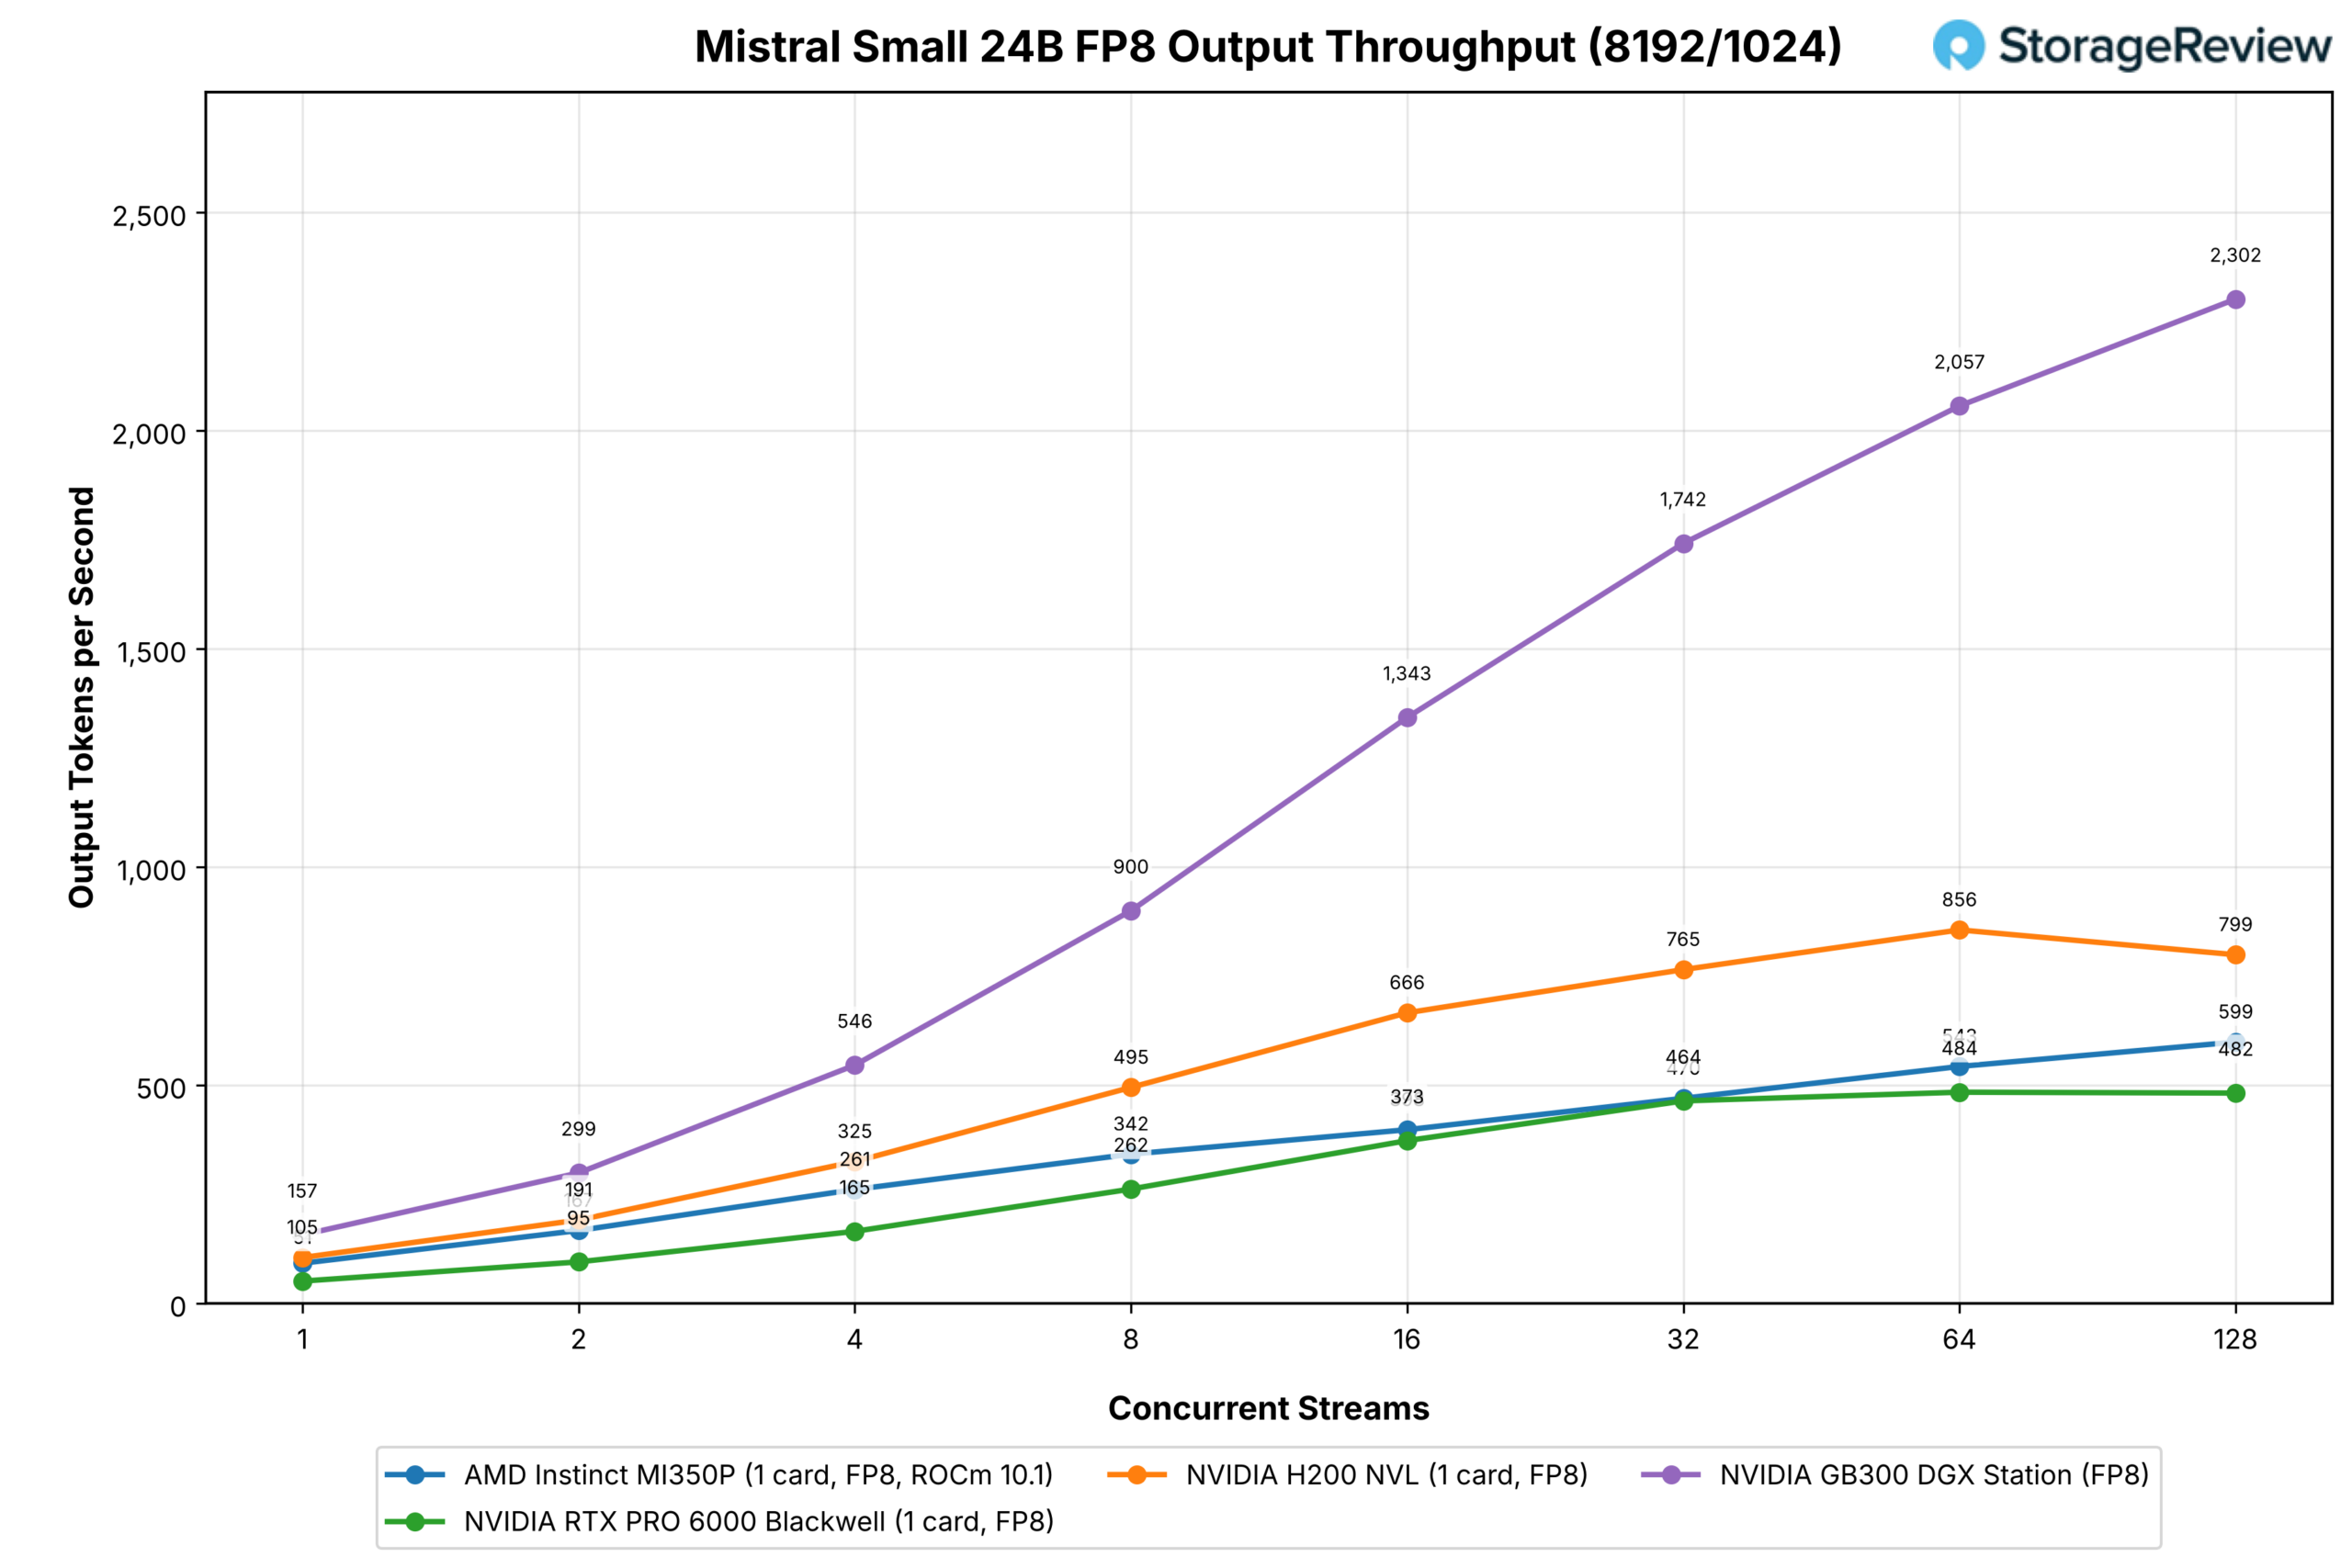
| Mistral Small 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
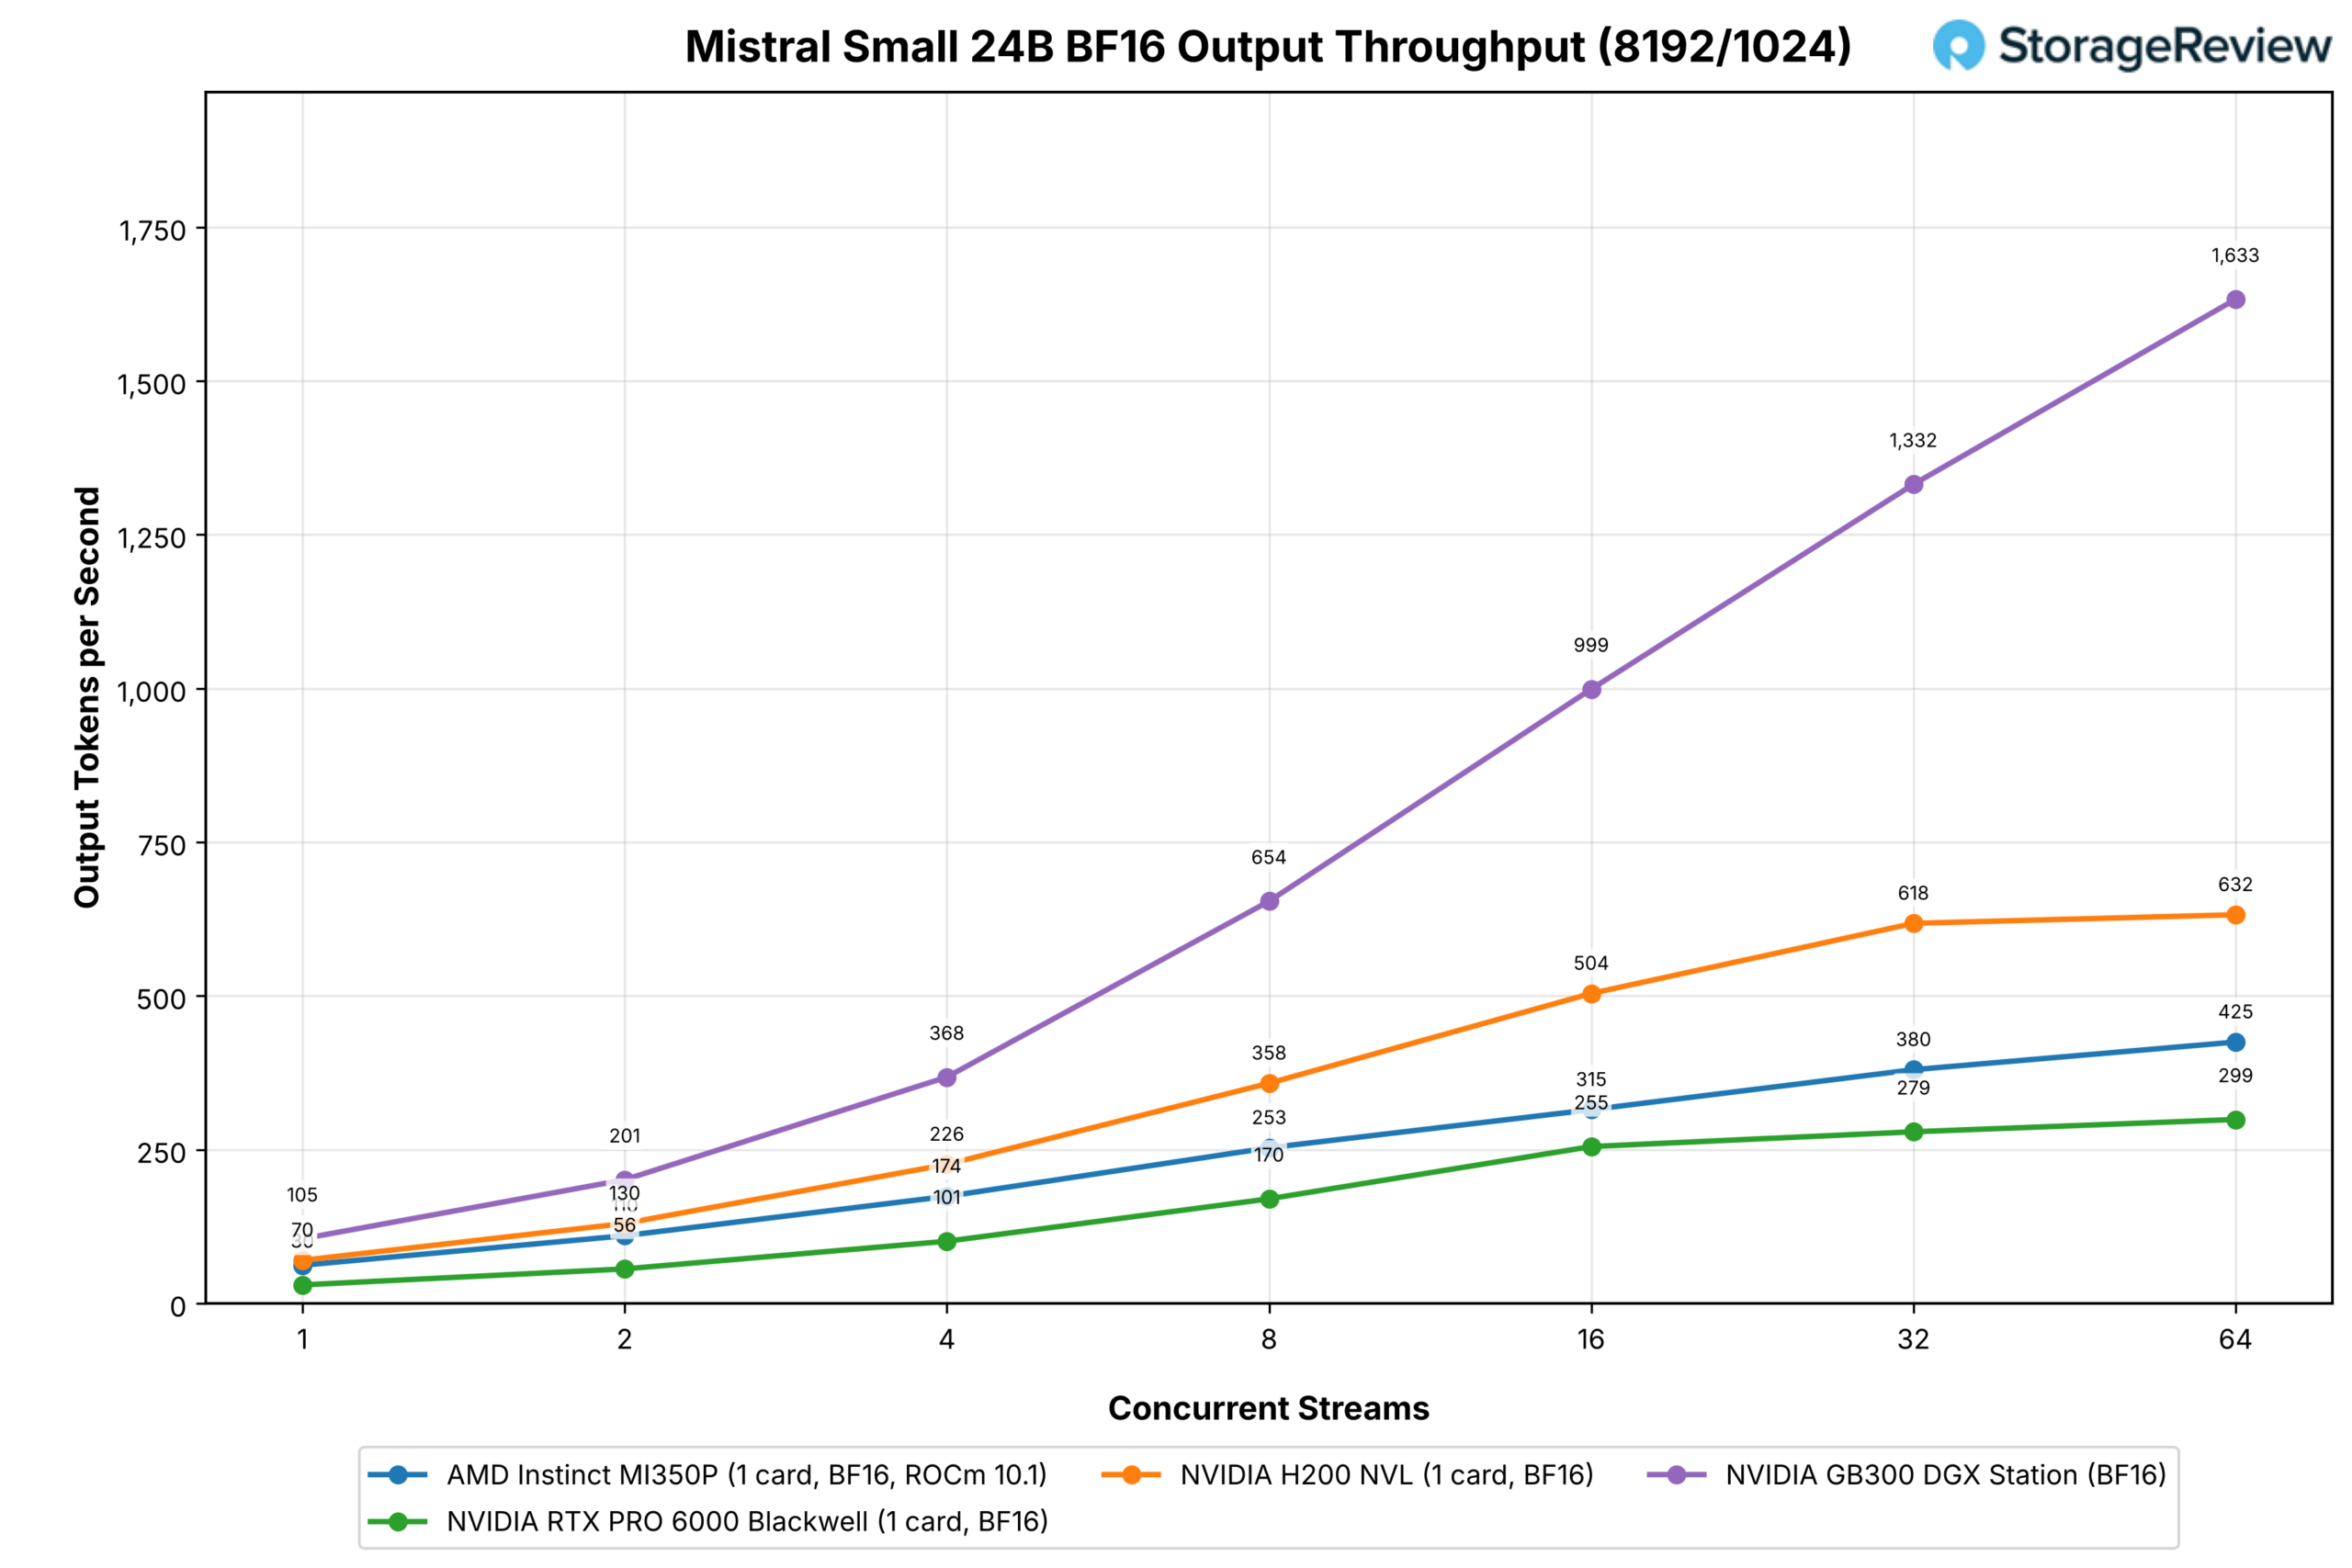
| Mistral Small 24B BF16 | 1 / 1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 964 | 1,644 | Niet uitvoeren | 6,737 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
| Lama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
Bij prompts met veel vooraf ingevulde gegevens is het beeld gemengd: de MI350P presteert beter dan de RTX PRO 6000 op beide GPT-OSS-modellen bij elk aantal streams en op Mistral Small, deelt de prestaties bij Qwen3-Coder bij 128 streams (24 procent voorsprong op BF16, 8 procent achterstand op FP8) en ligt 16 streams gelijk op Llama en MiniMax-M2.7, waar hij achter de NVIDIA-kaart eindigt. Ten opzichte van de H200 heeft hij een voorsprong van 15 procent op GPT-OSS bij het 120B-model en 5 procent bij het 20B-model bij 128 streams, maar blijft hij 25 tot 58 procent achter op de modellen met veel vooraf ingevulde gegevens.
Op de grootste modellen, waar twee MI350P's het opnemen tegen vier RTX PRO 6000's, leidt de NVIDIA-set met GLM-5.2 tot en met 16 streams in de chat-workload met 384 GB GDDR7 tegenover 288 GB HBM3E. Op de MiniMax-M3 blijven alle drie de configuraties binnen 10 procent van elkaar tot en met acht streams, waarna de RTX-quad bij 16 streams de leiding neemt. De enkele GB300 overtreft elke PCIe-configuratie met een ruime marge op alles wat in de 252 GB past.
GLM-5.3 Flash
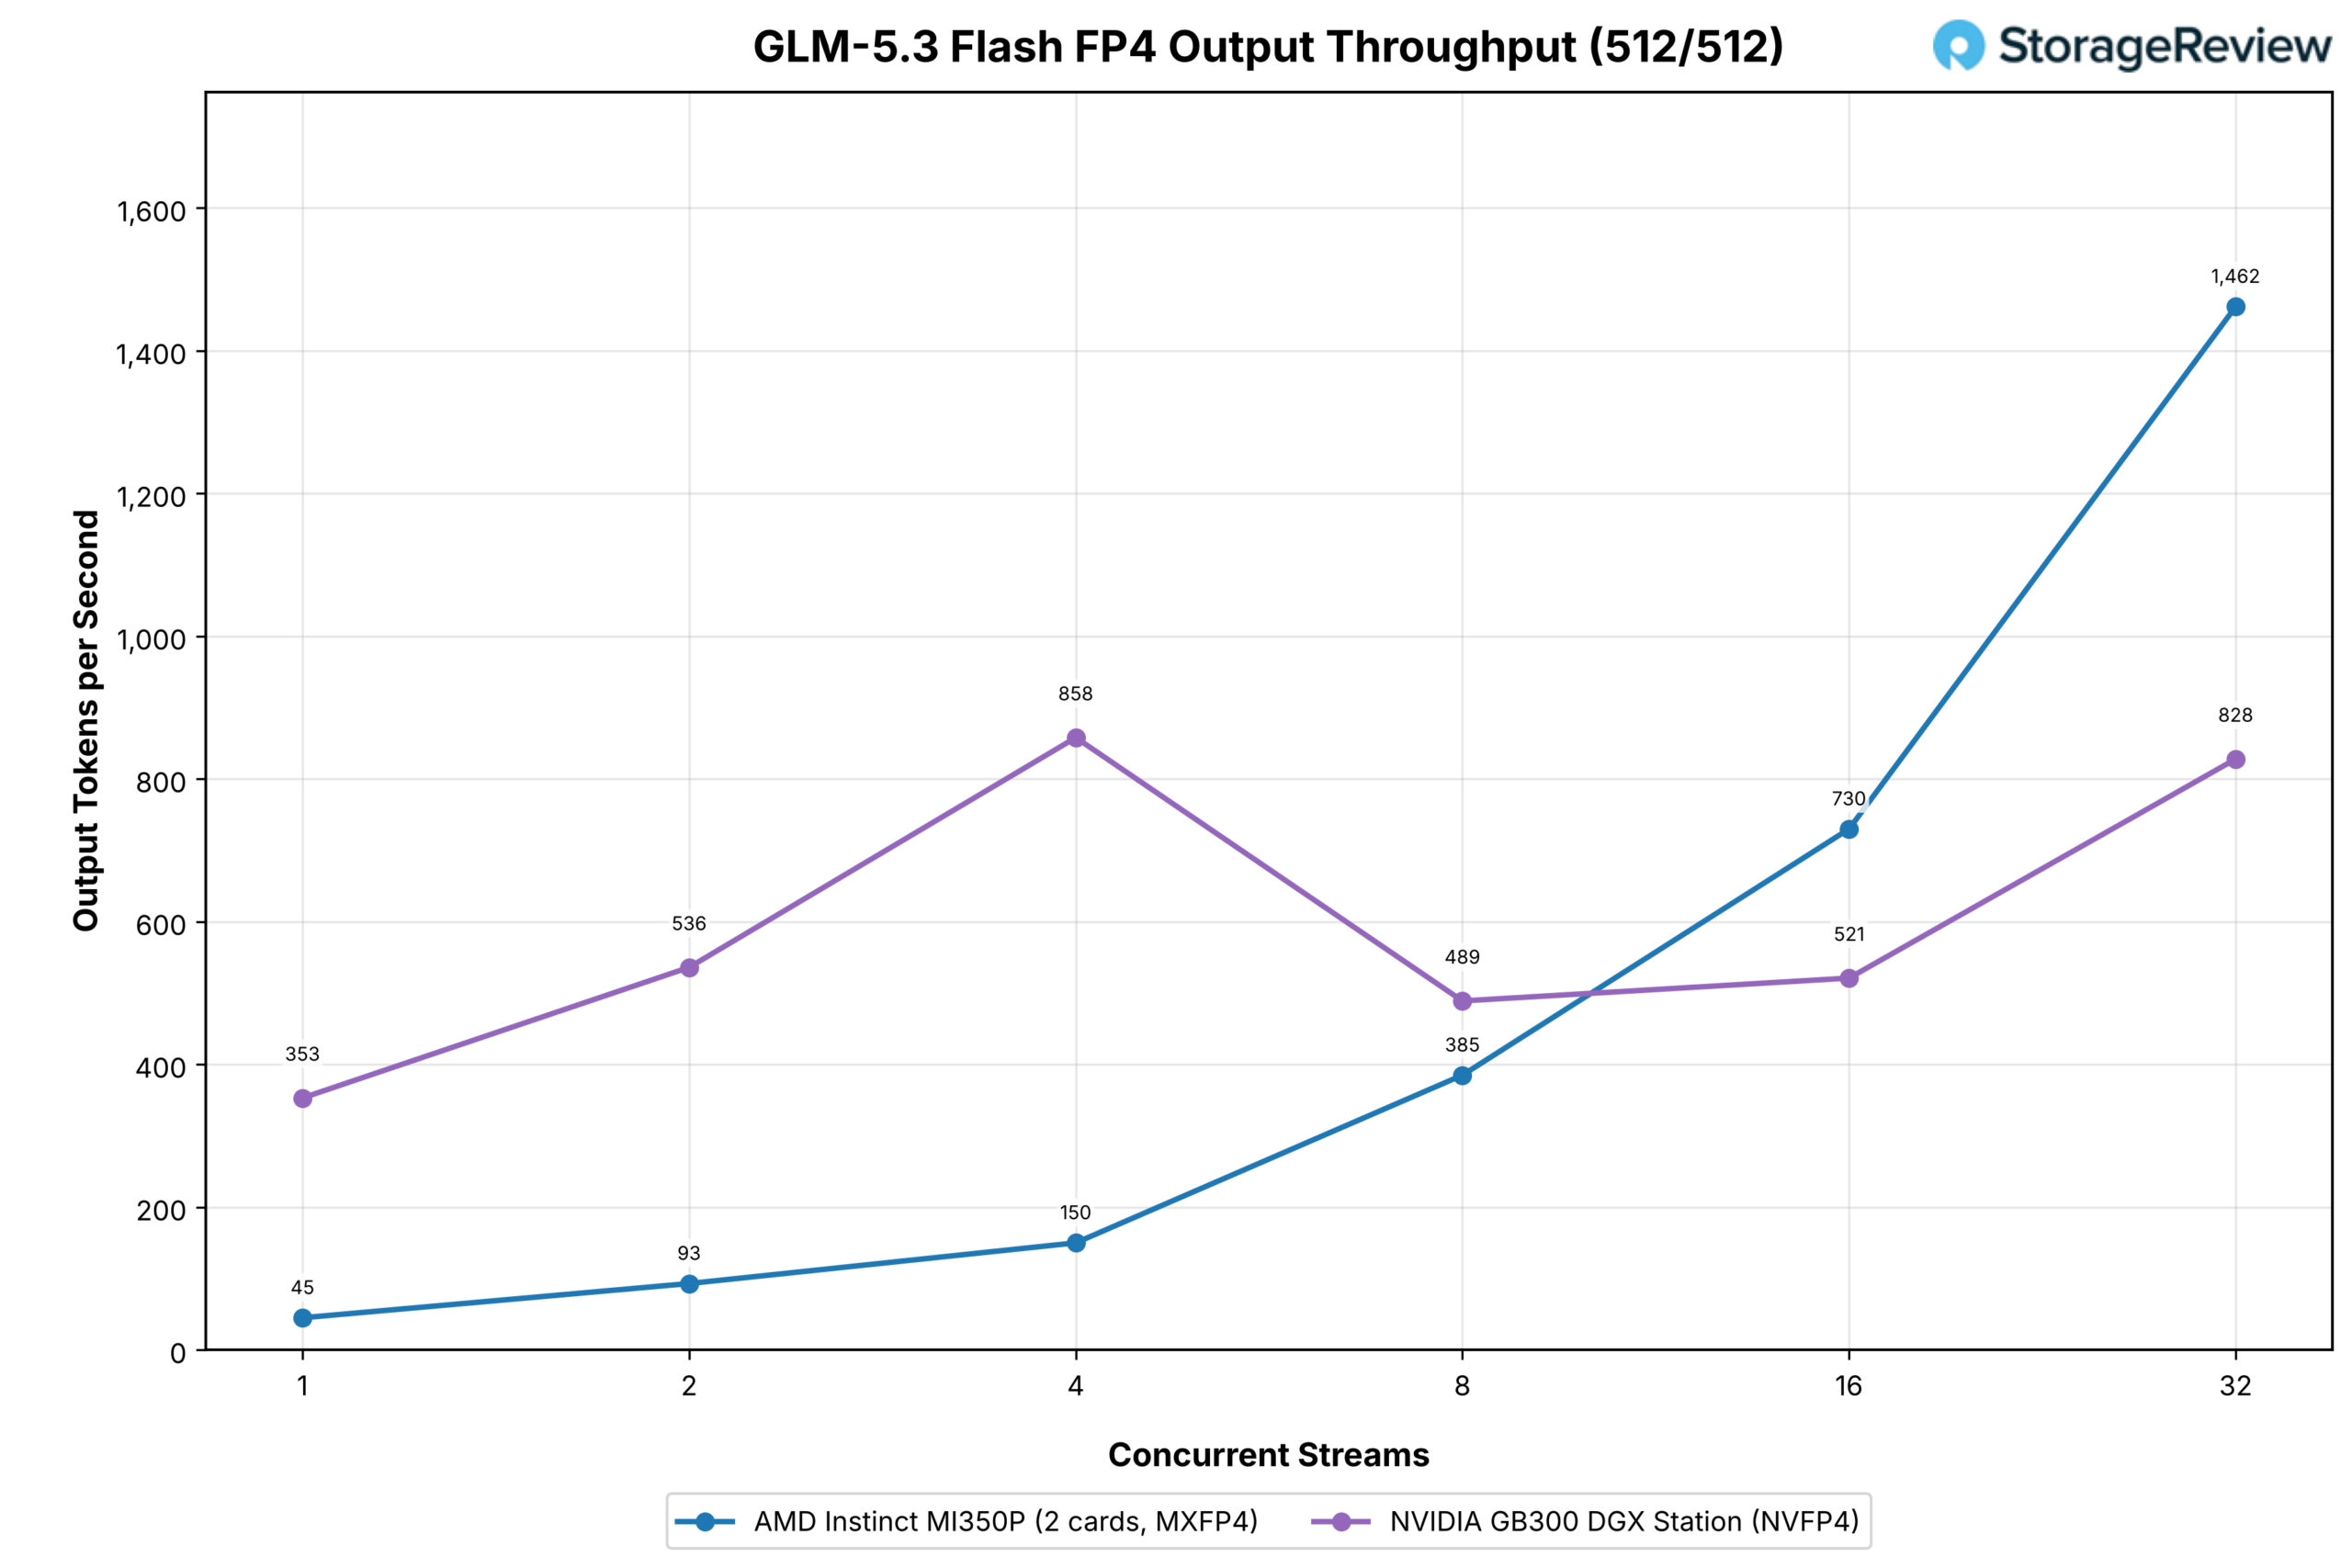
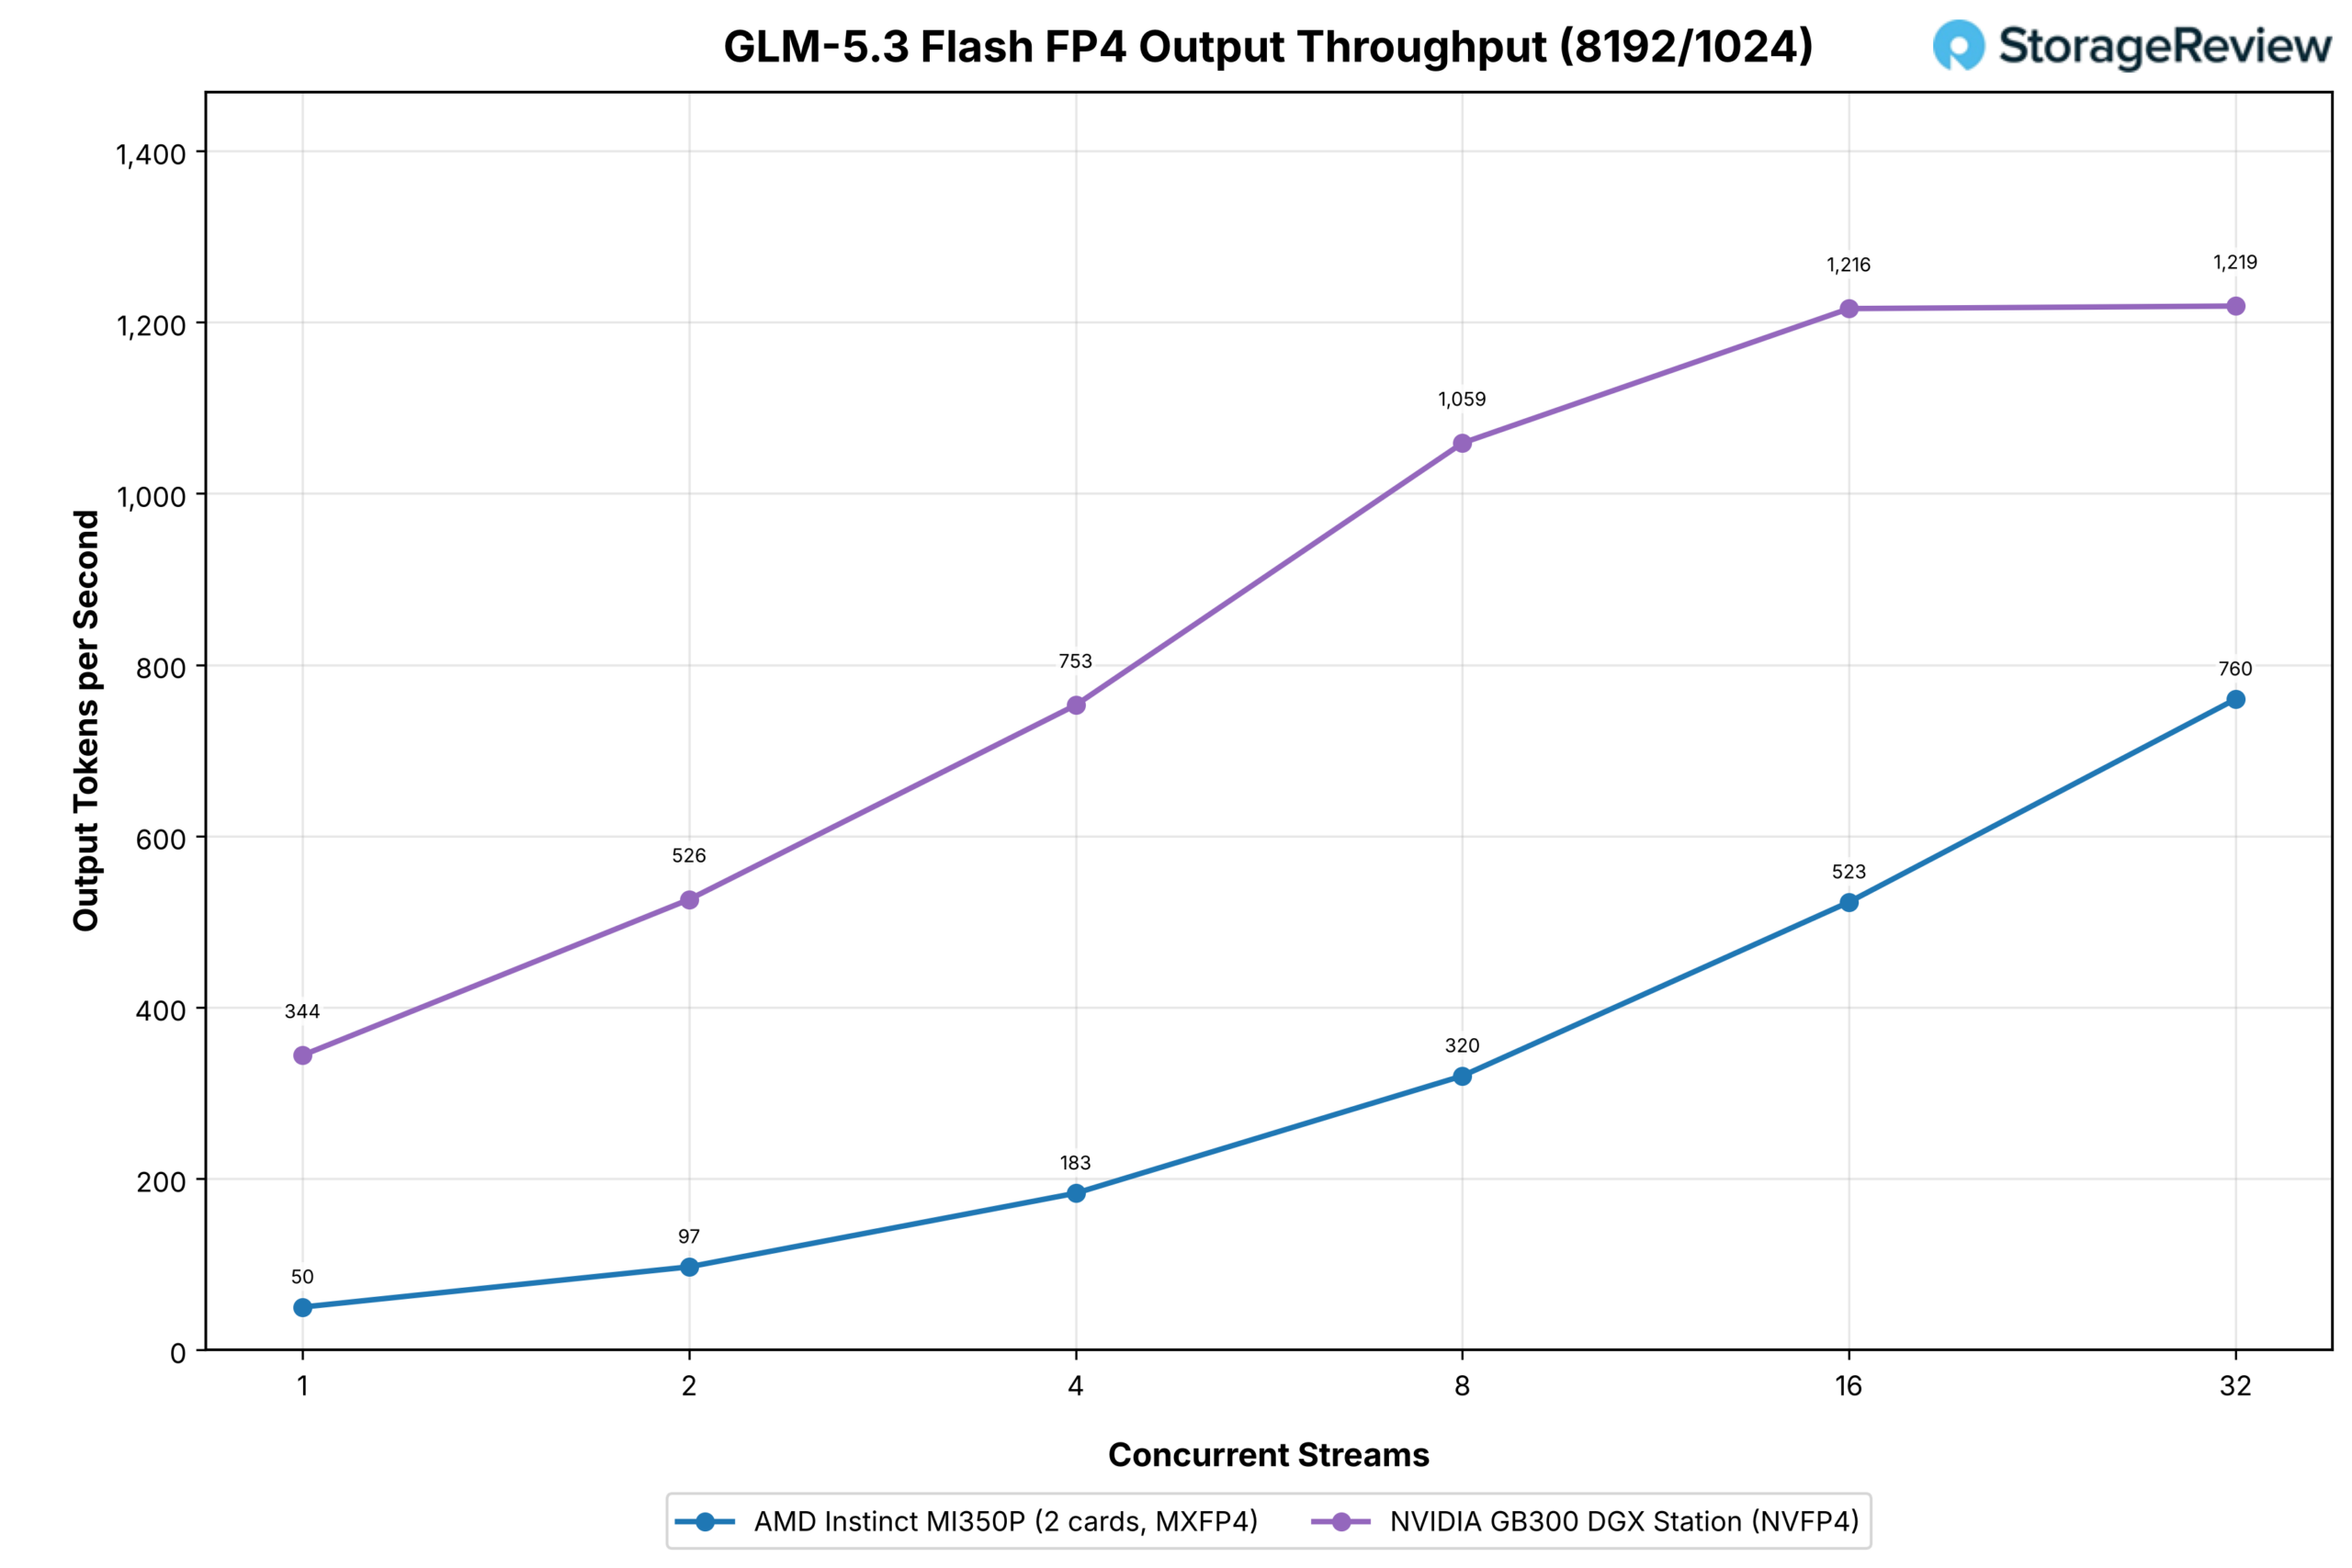
GLM-5.3 Flash is niet getest op de RTX PRO 6000, dus de vergelijking betreft twee MI350P-kaarten tegen één GB300 Station-kaart met 32 streams. Bij de chatworkload begint het MI350P-paar achter met 45 tegen 353 outputtokens per seconde bij één stream, en haalt de Station bij acht streams in, op weg naar 1,462 bij 32 streams, tegen 828 voor de Station. Bij de workload met veel prefill leidt de Station echter constant met 1,219 tegen 760 bij 32 streams, waarbij de prefill van het paar via PCIe tussen de twee kaarten moet verlopen en de B300 dit volledig via één HBM-chip doet.
GLM-5.2
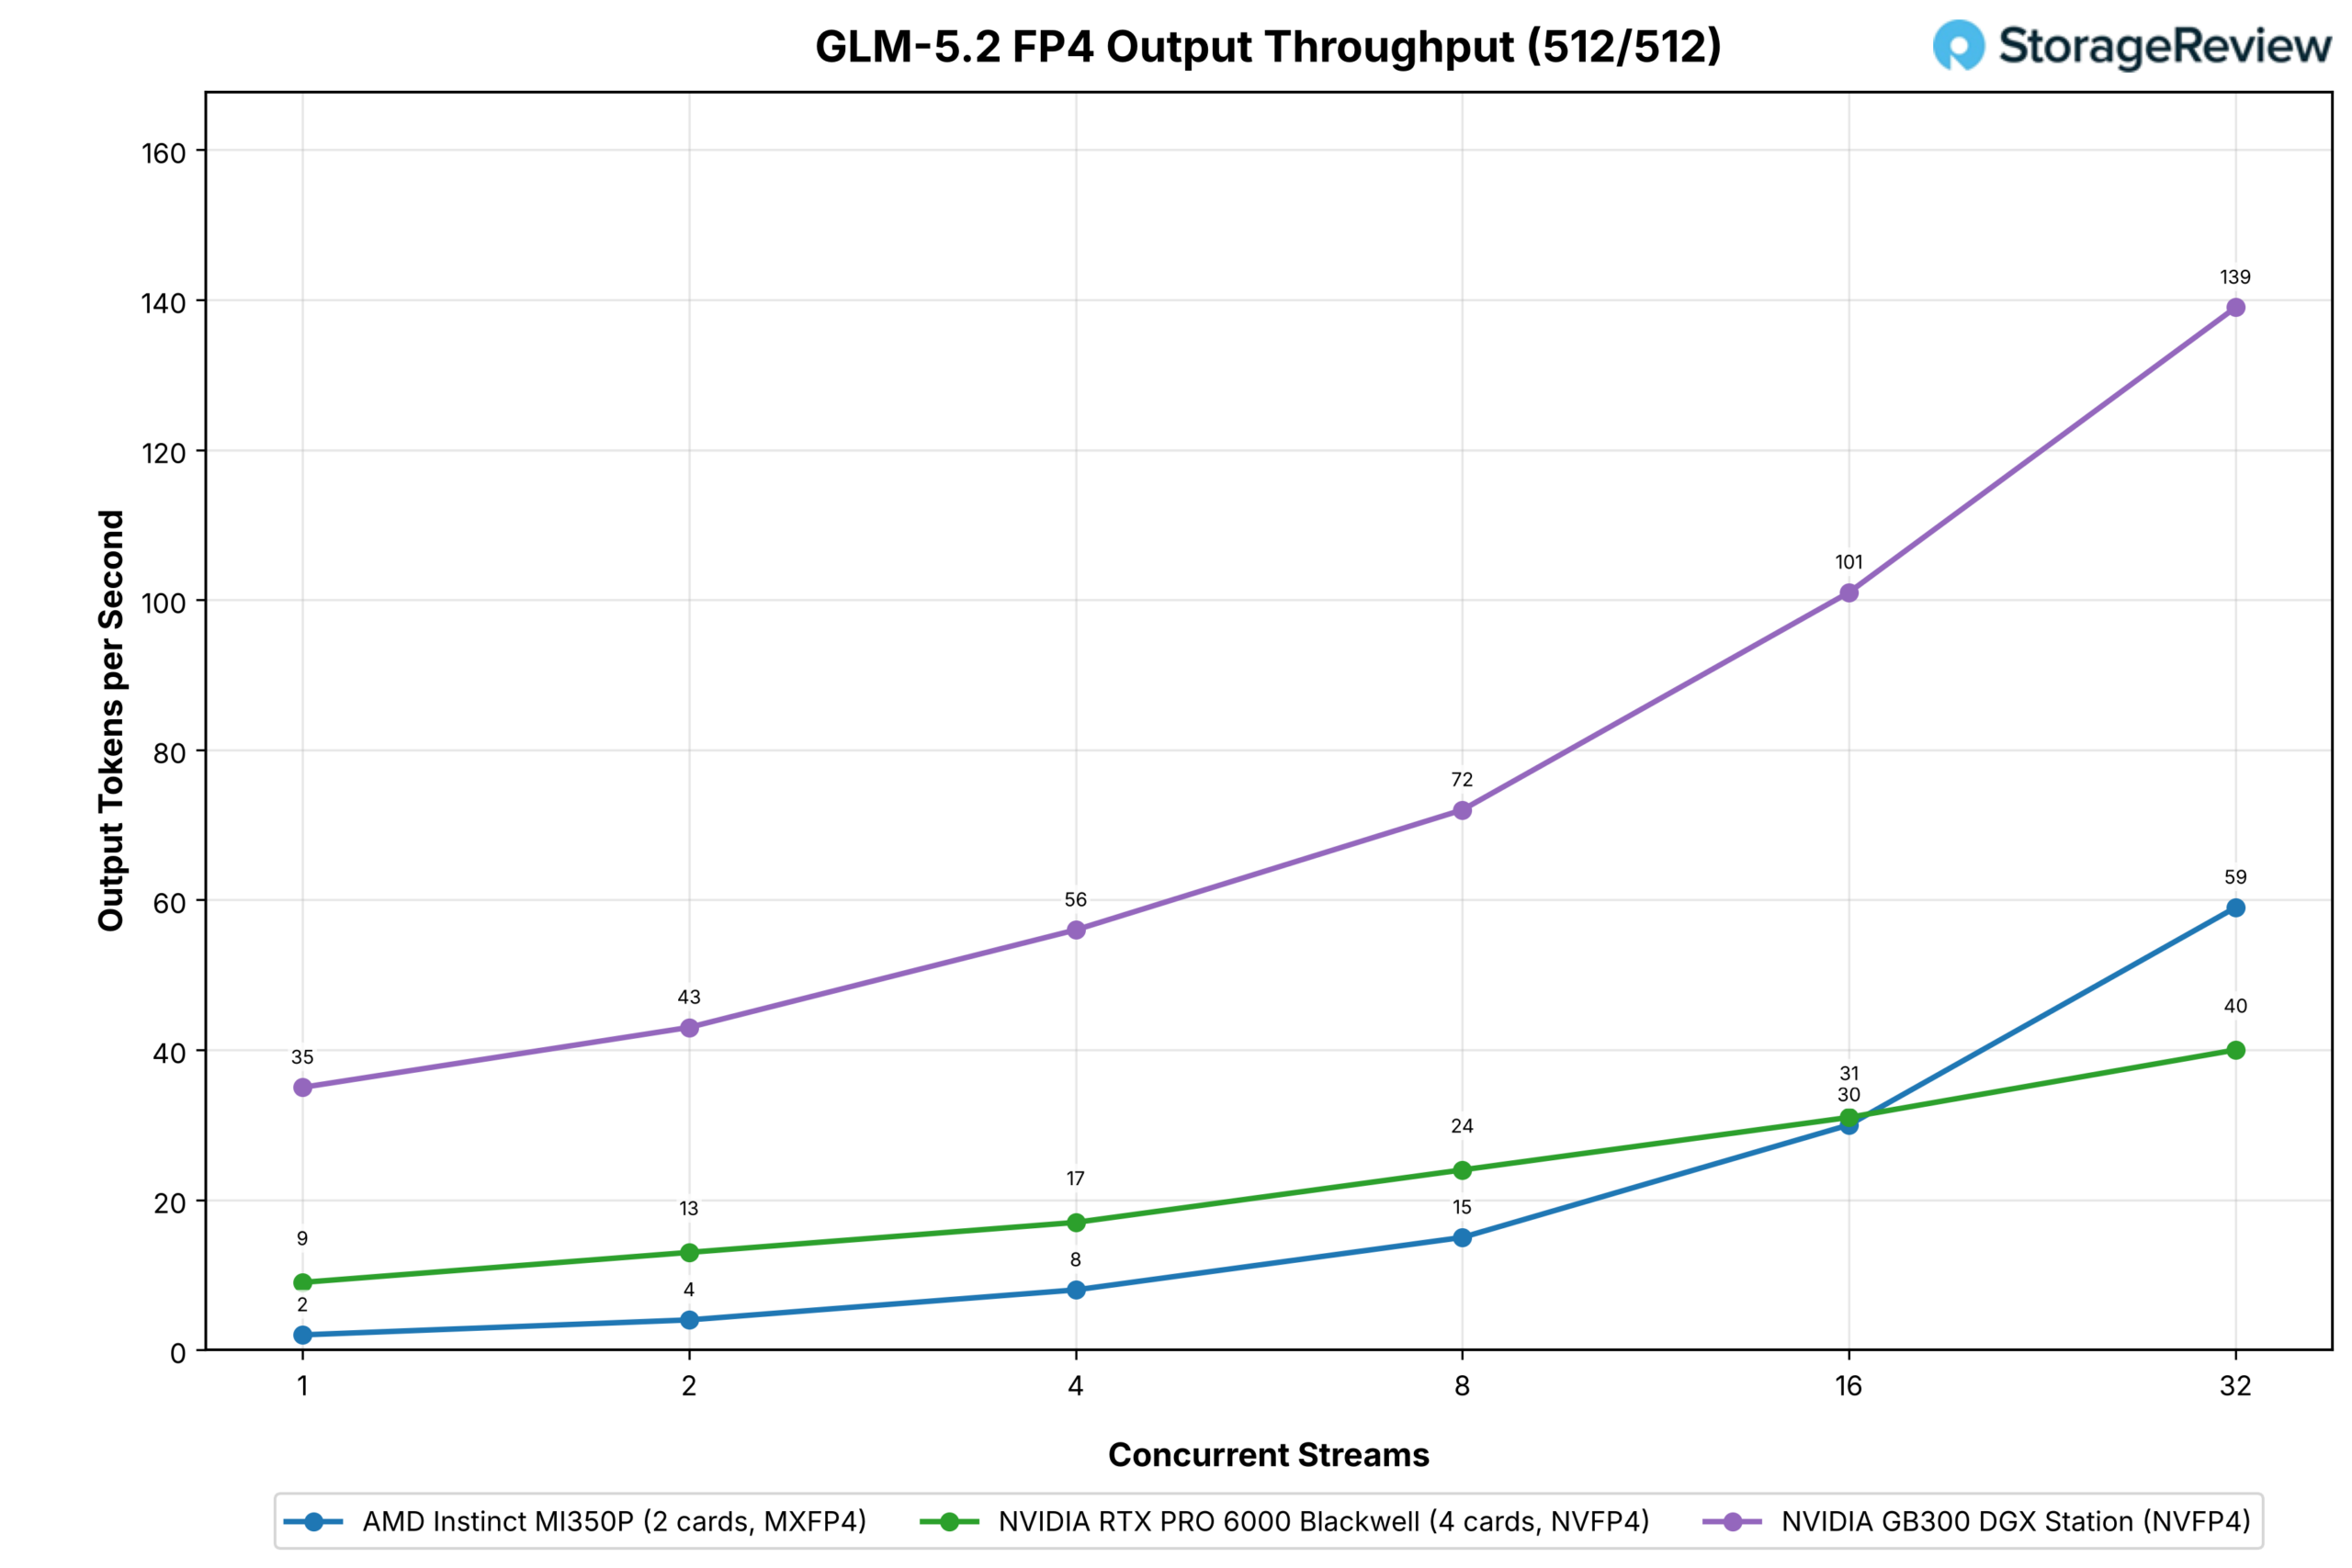
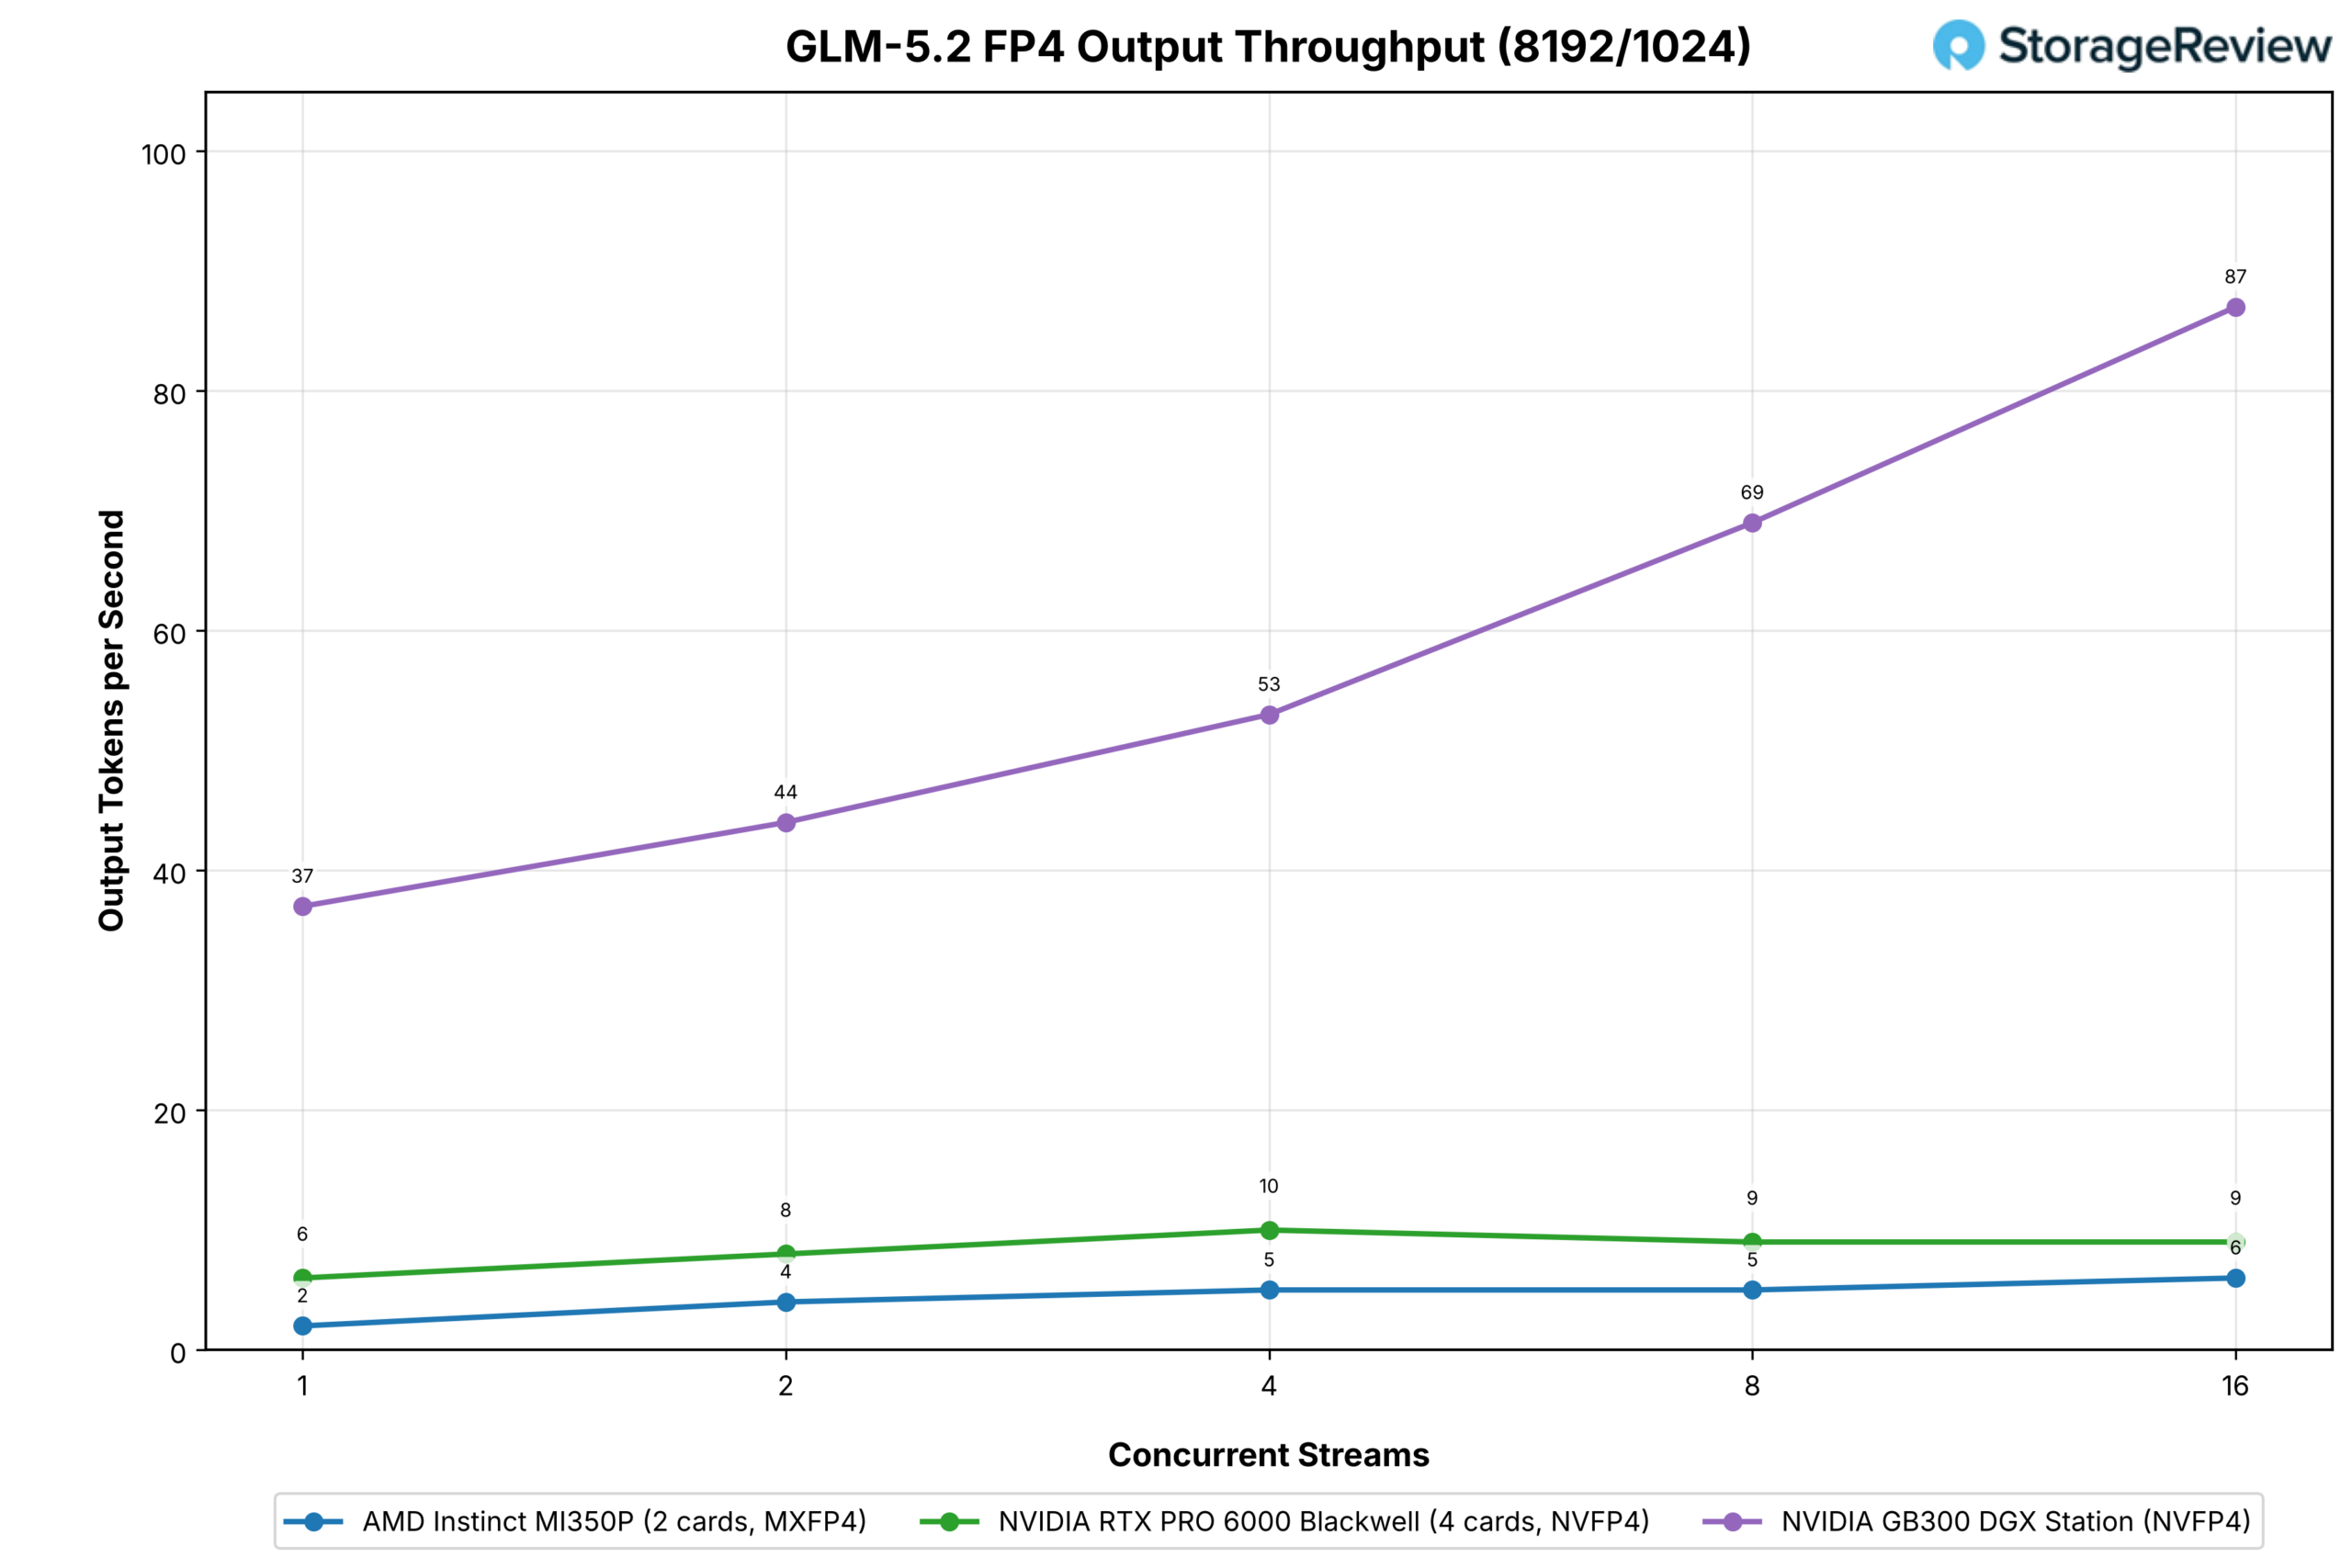
GLM-5.2 is het verhaal achter het geheugen in deze set. Het MXFP4-checkpoint loopt door de 288 GB van de twee MI350P-kaarten heen naar het hostgeheugen, waardoor de doorvoer van één stream 2 uitvoertokens per seconde bedraagt voor het paar, tegenover 9 voor vier RTX PRO 6000-kaarten met de ingebouwde NVFP4 in 384 GB GDDR7 en 35 voor het Station, dat ongeveer 215 GB aan experttaken naar Grace-geheugen verplaatst. De RTX quad presteert het best bij 16 streams in de chatworkload; bij 32 streams bereikt het MI350P-paar 59 tegenover 40, en het Station haalt 139. Bij prompts met veel prefill haalt geen van beide PCIe-configuraties meer dan een paar tokens per seconde bij 16 streams, tegenover 87 voor het Station.
MiniMax-M3
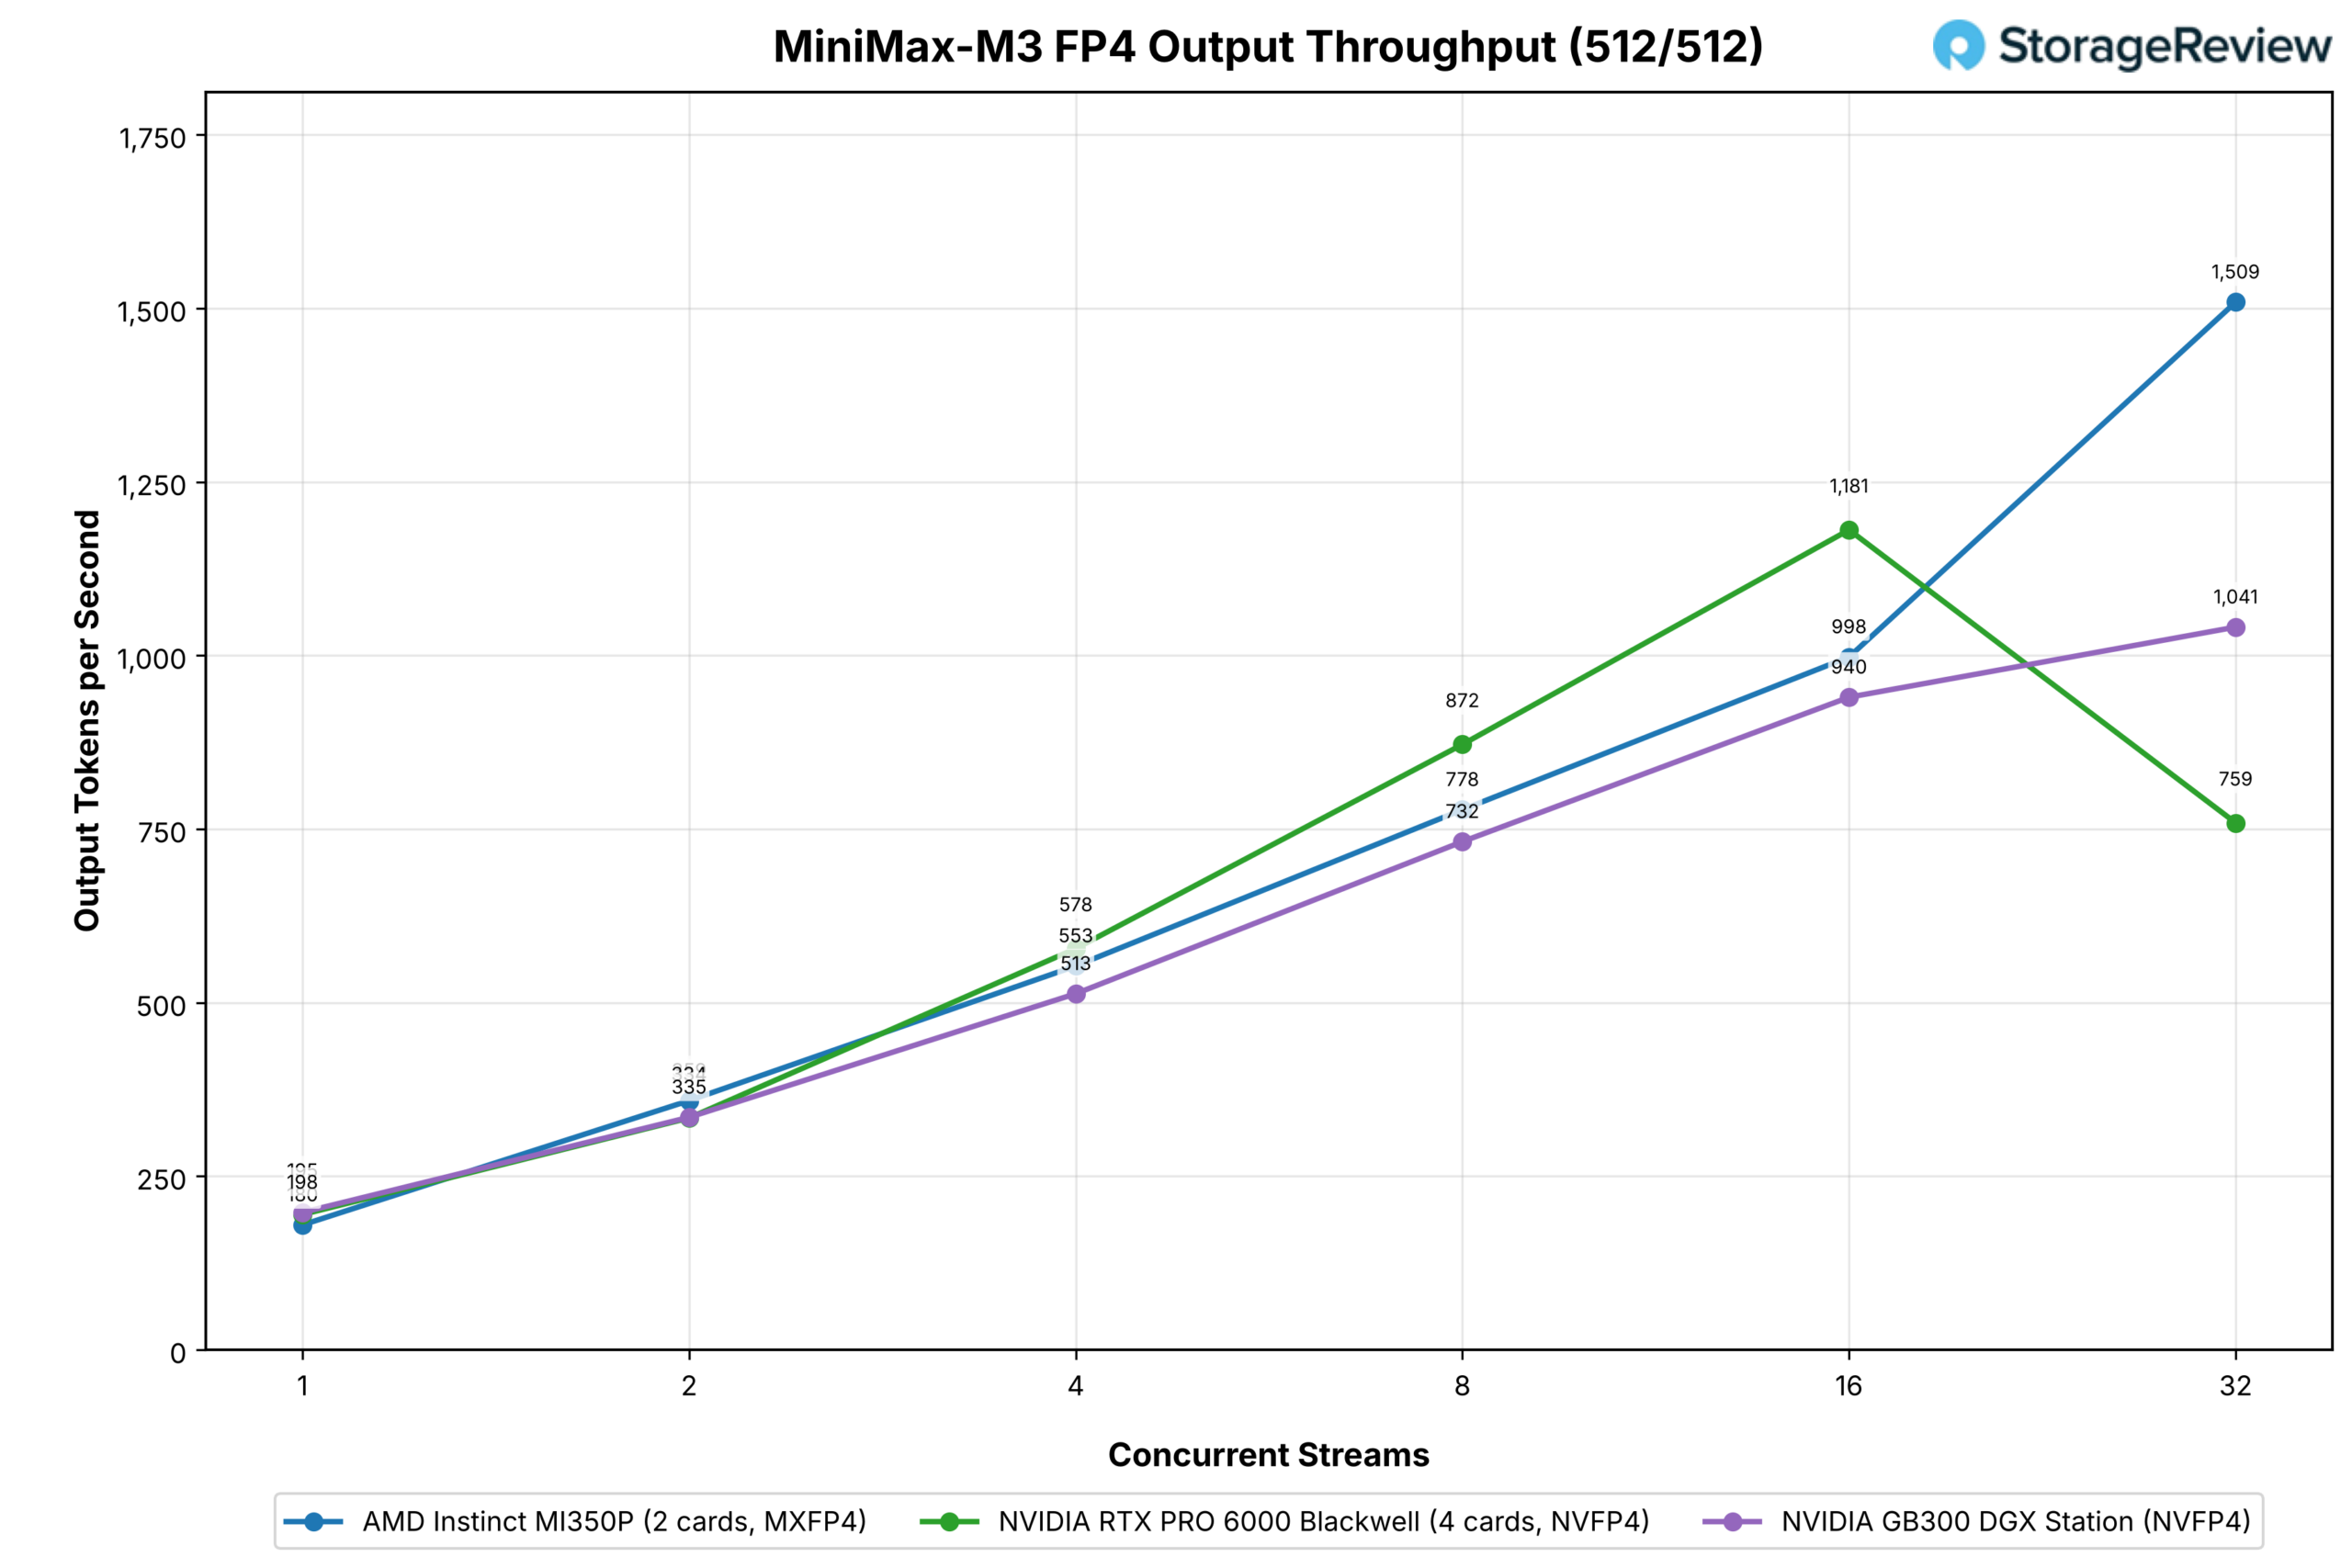
Twee MI350P-kaarten bevatten de MXFP4-versie van MiniMax-M3 met 288 GB geheugen; de NVIDIA-kant heeft vier RTX PRO 6000-kaarten nodig. De drie configuraties presteren binnen 10 procent van elkaar bij acht streams in de chat-workload; de RTX-quad presteert het best bij 16 streams (1,181 tegen 998 voor het paar en 940 voor het Station), en bij 32 streams behaalt het MI350P-paar 1,509 streams tegen 759 voor de quad en 1,041 voor het Station.
Bij prompts met veel vooraf ingevulde gegevens, presteert het MI350P-paar op elk punt beter in acht streams, met 524 tegen 444 voor de quad, terwijl de Station, die een deel van de experts van dit model in het Grace-geheugen bewaart, terugvalt naar 103.
DeepSeek-V4-Flash
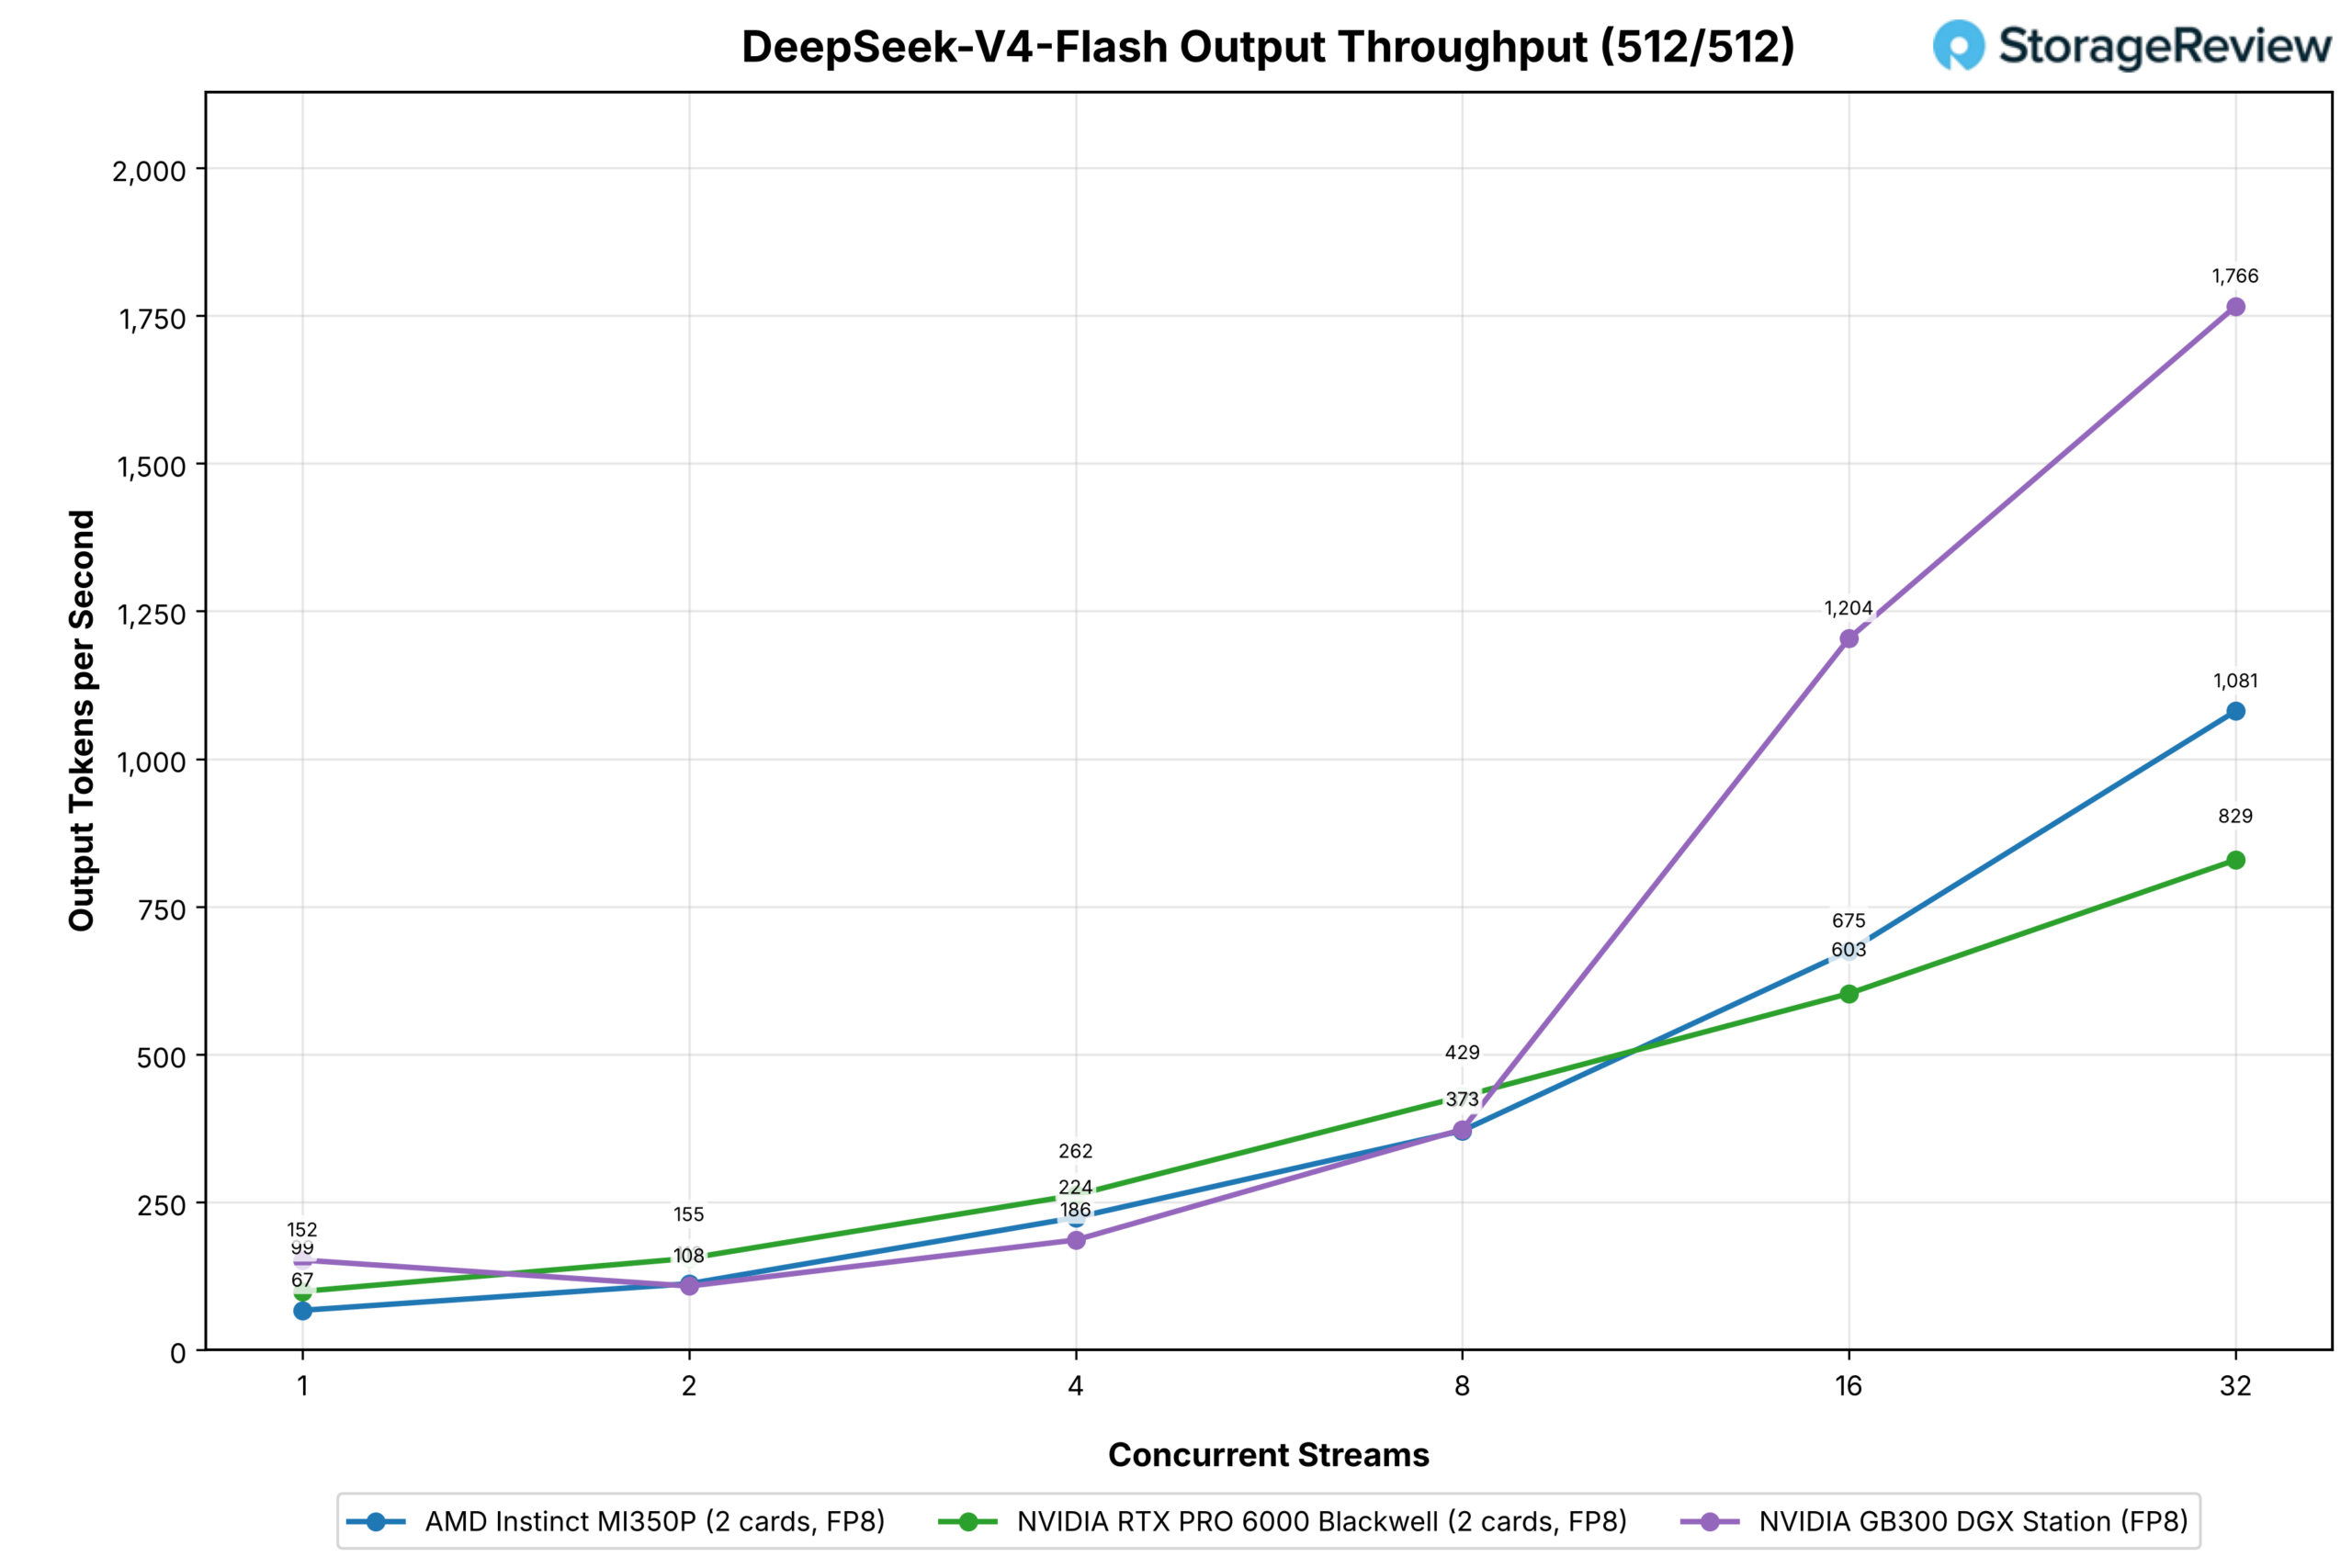
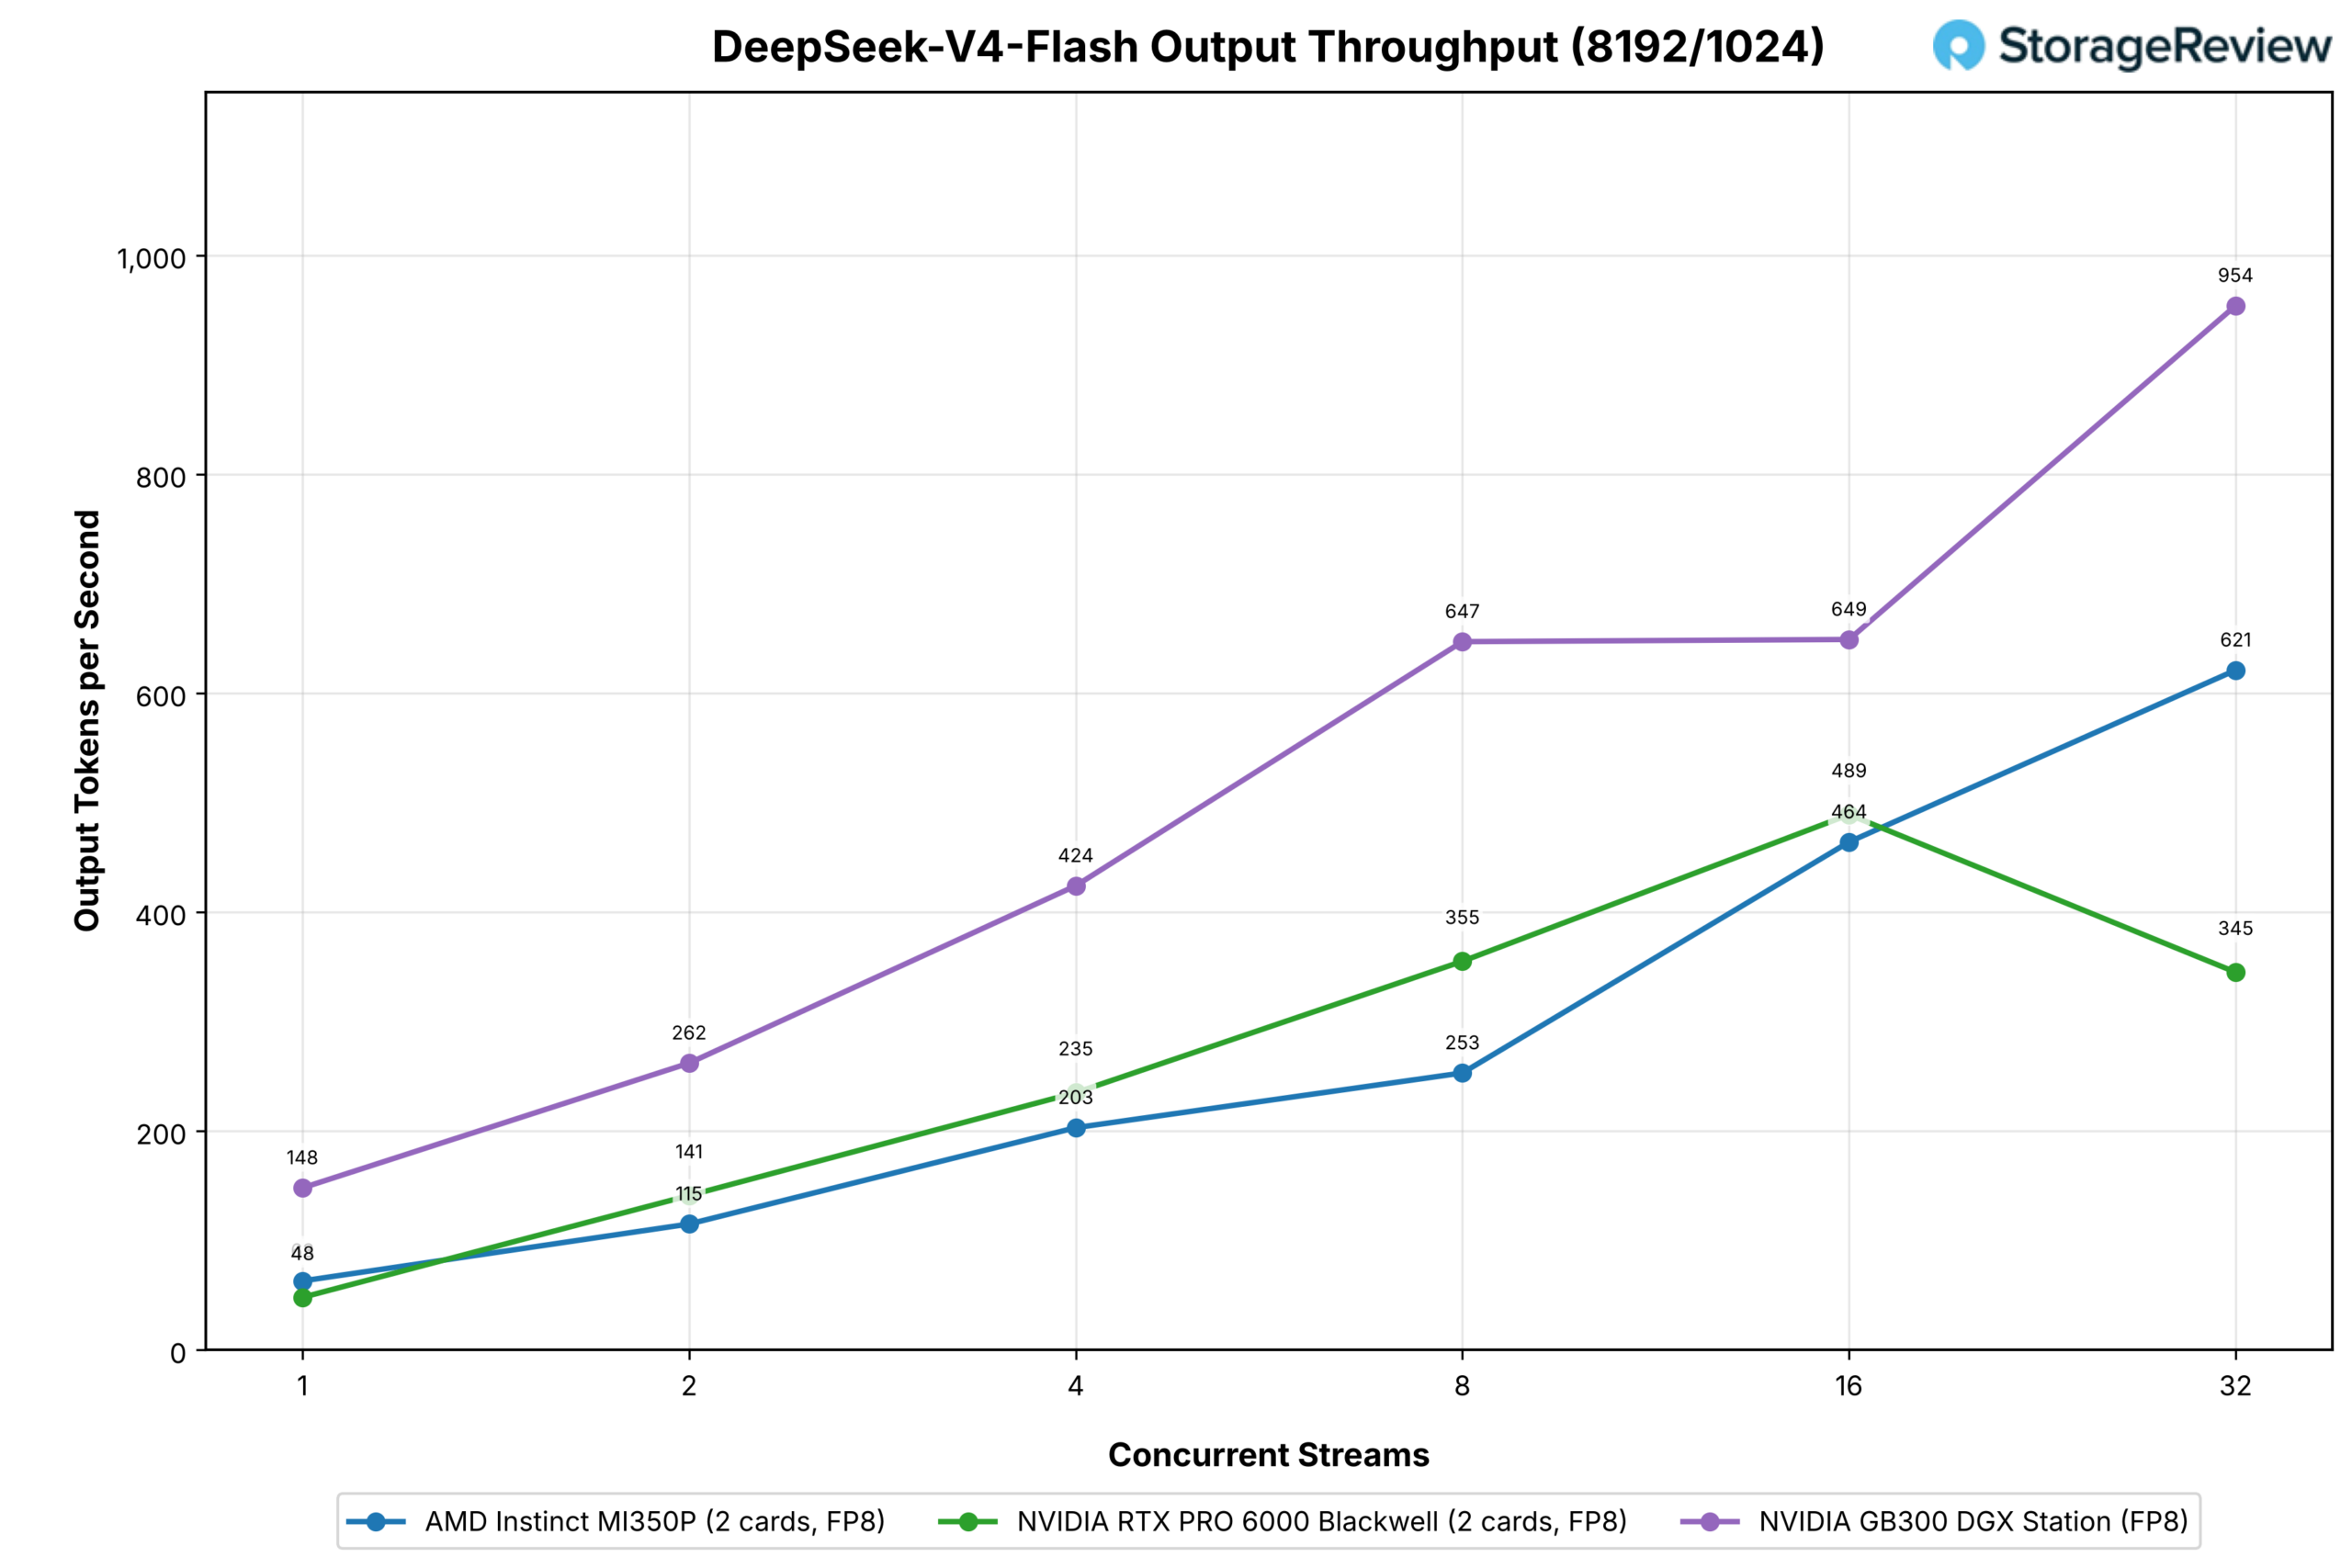
Met twee kaarten aan elke kant en het native FP8-checkpoint, leidt het RTX PRO 6000-paar na acht streams in de chat-workload, waarna het MI350P-paar het overneemt vanaf stream 16 en eindigt met een score van 1,081 tegenover 829 bij 32 streams; de enkele Station bereikt op hetzelfde punt een score van 1,766. De run met veel prefill volgt hetzelfde patroon: het MI350P-paar scoort 621 tegenover 345 voor het RTX-paar bij 32 streams en 954 voor de Station.
MiniMax-M2.7
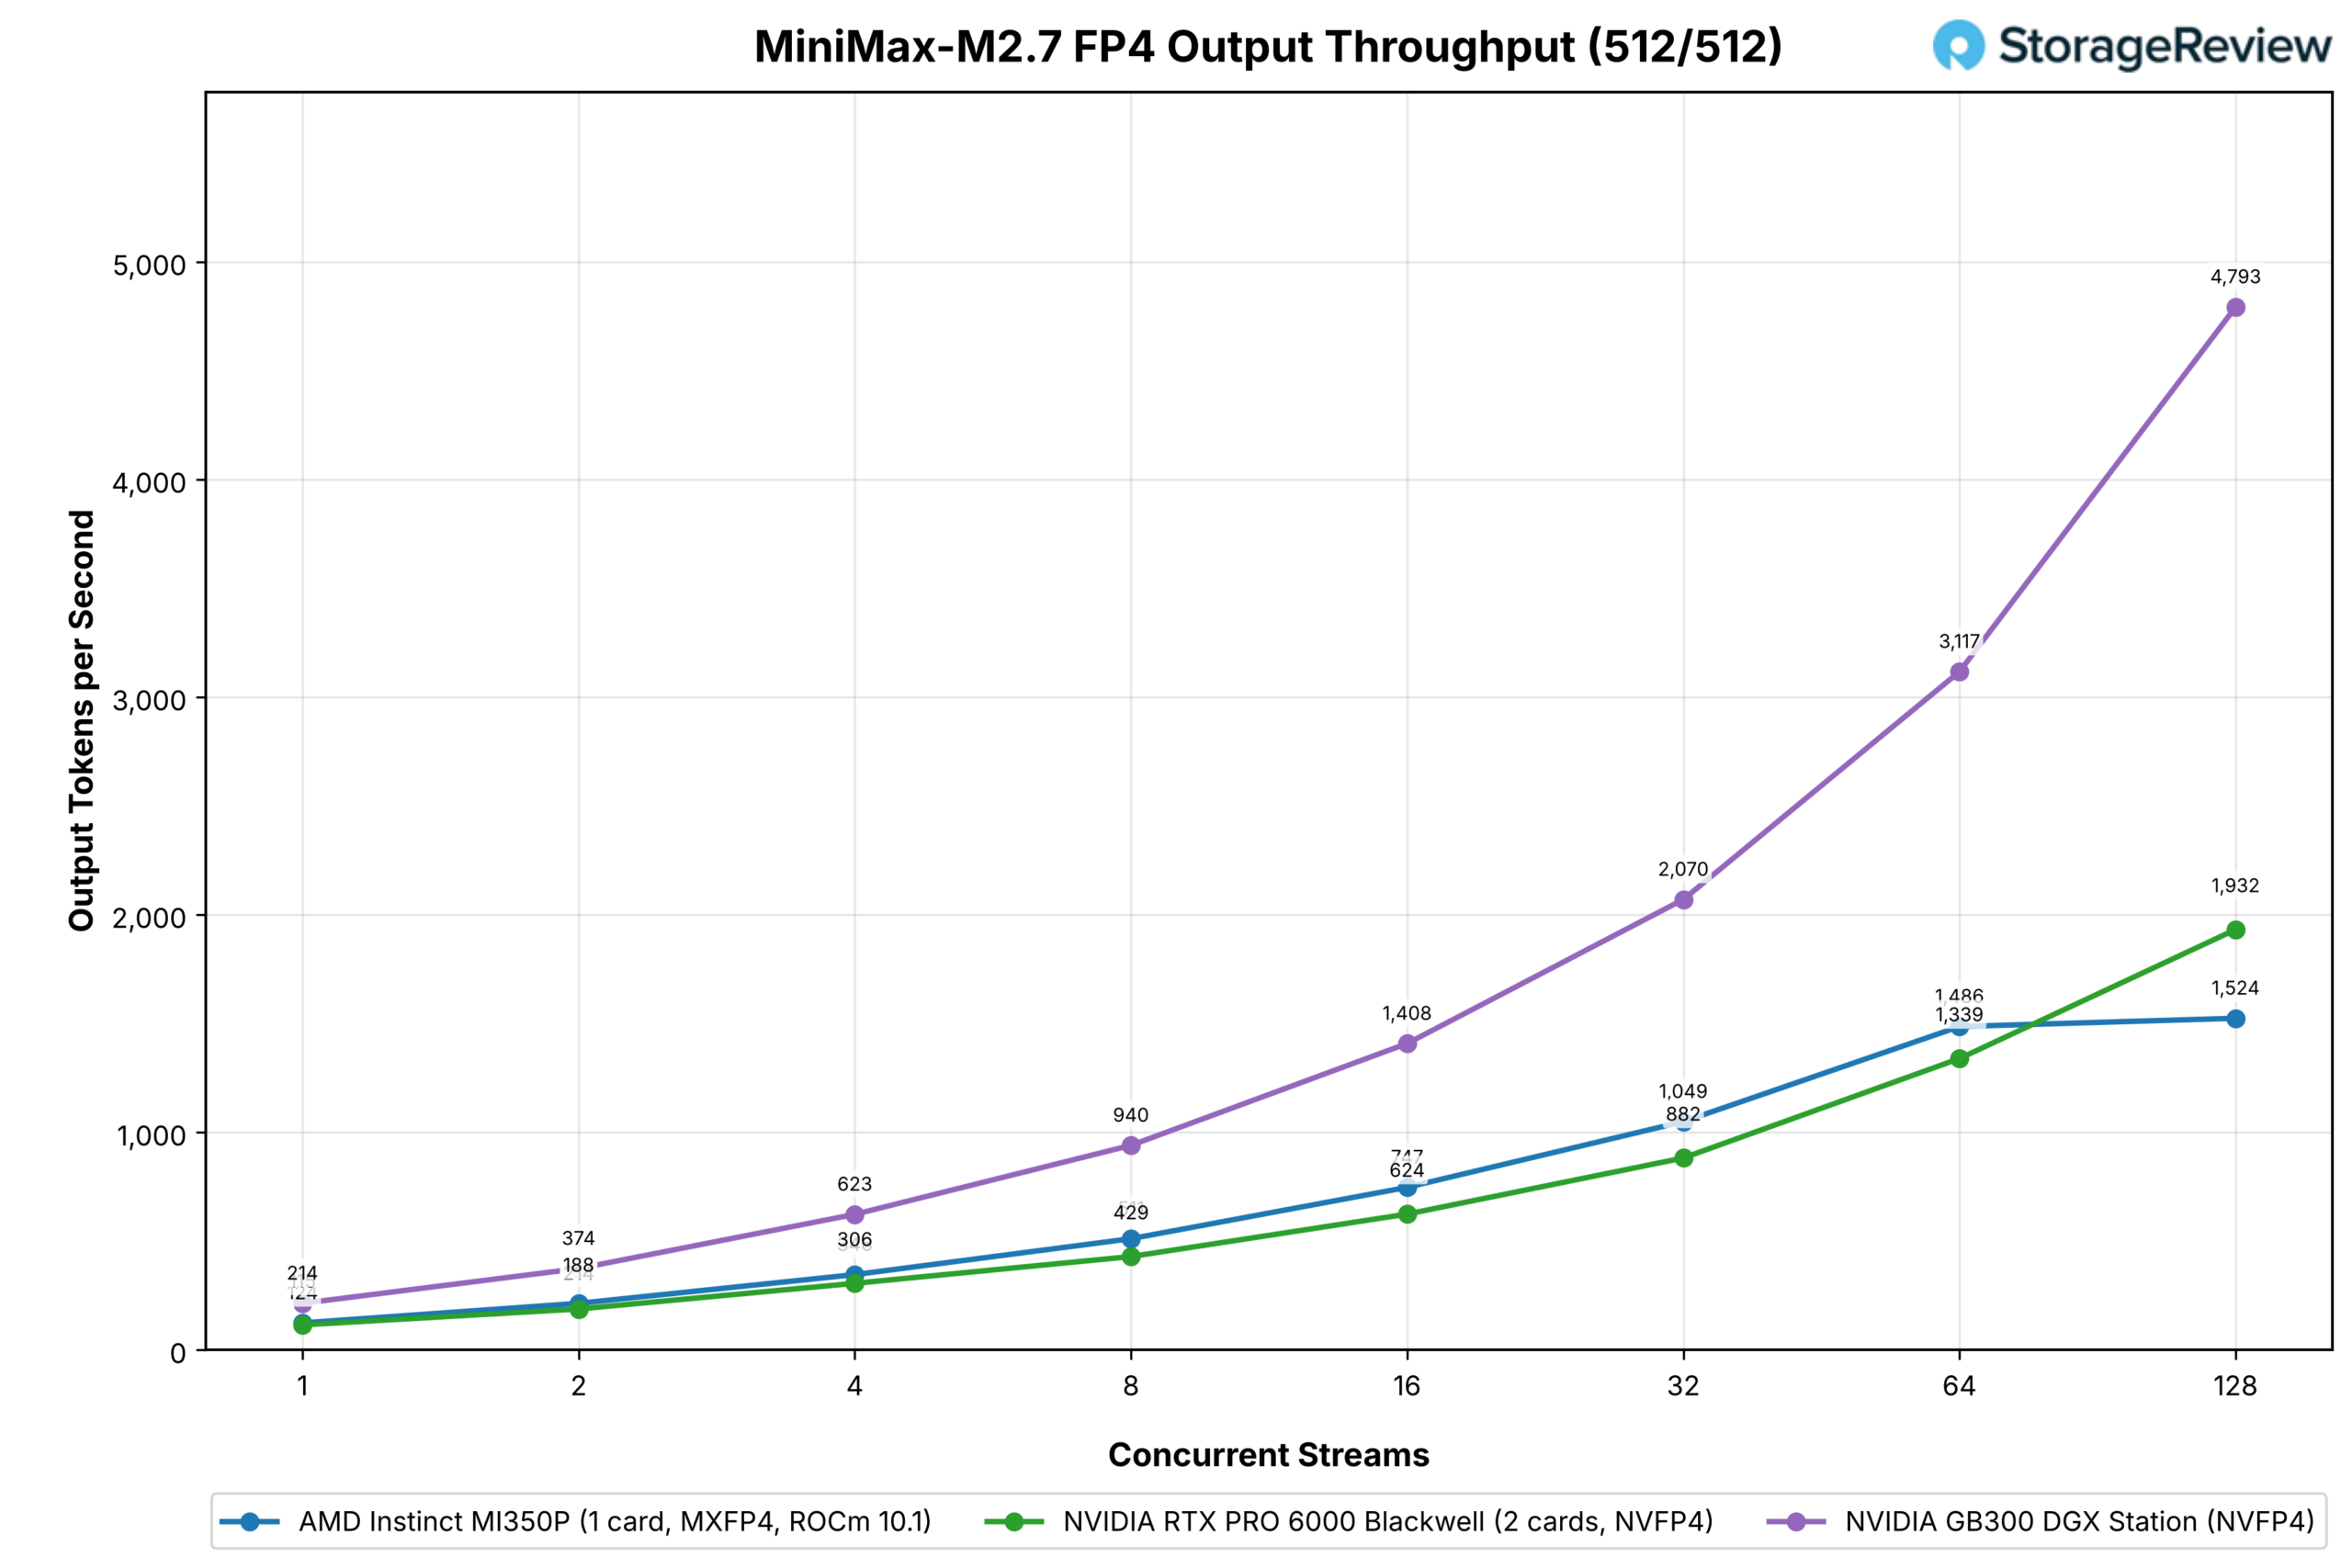
Eén MI350P draait de MXFP4-versie van MiniMax-M2.7 en neemt het op tegen twee RTX PRO 6000-kaarten met NVFP4. De enkele MI350P presteert beter bij één stream (124 tegen 115), blijft 8 tot 20 procent voor bij 64 streams (1,486 tegen 1,339), en stabiliseert zich vervolgens op 1,524 bij 128 en 1,557 bij 256 streams, terwijl het RTX-paar verder gaat naar 1,932 en 2,842; de Station bereikt 4,793.
Bij een workload met veel voorvulling haalt de MI350P 304 tot 331 uitvoertokens per seconde uit acht tot en met 64 streams, tegenover 501 voor het RTX-paar en 1,744 voor het Station.
GPT-OSS-120B
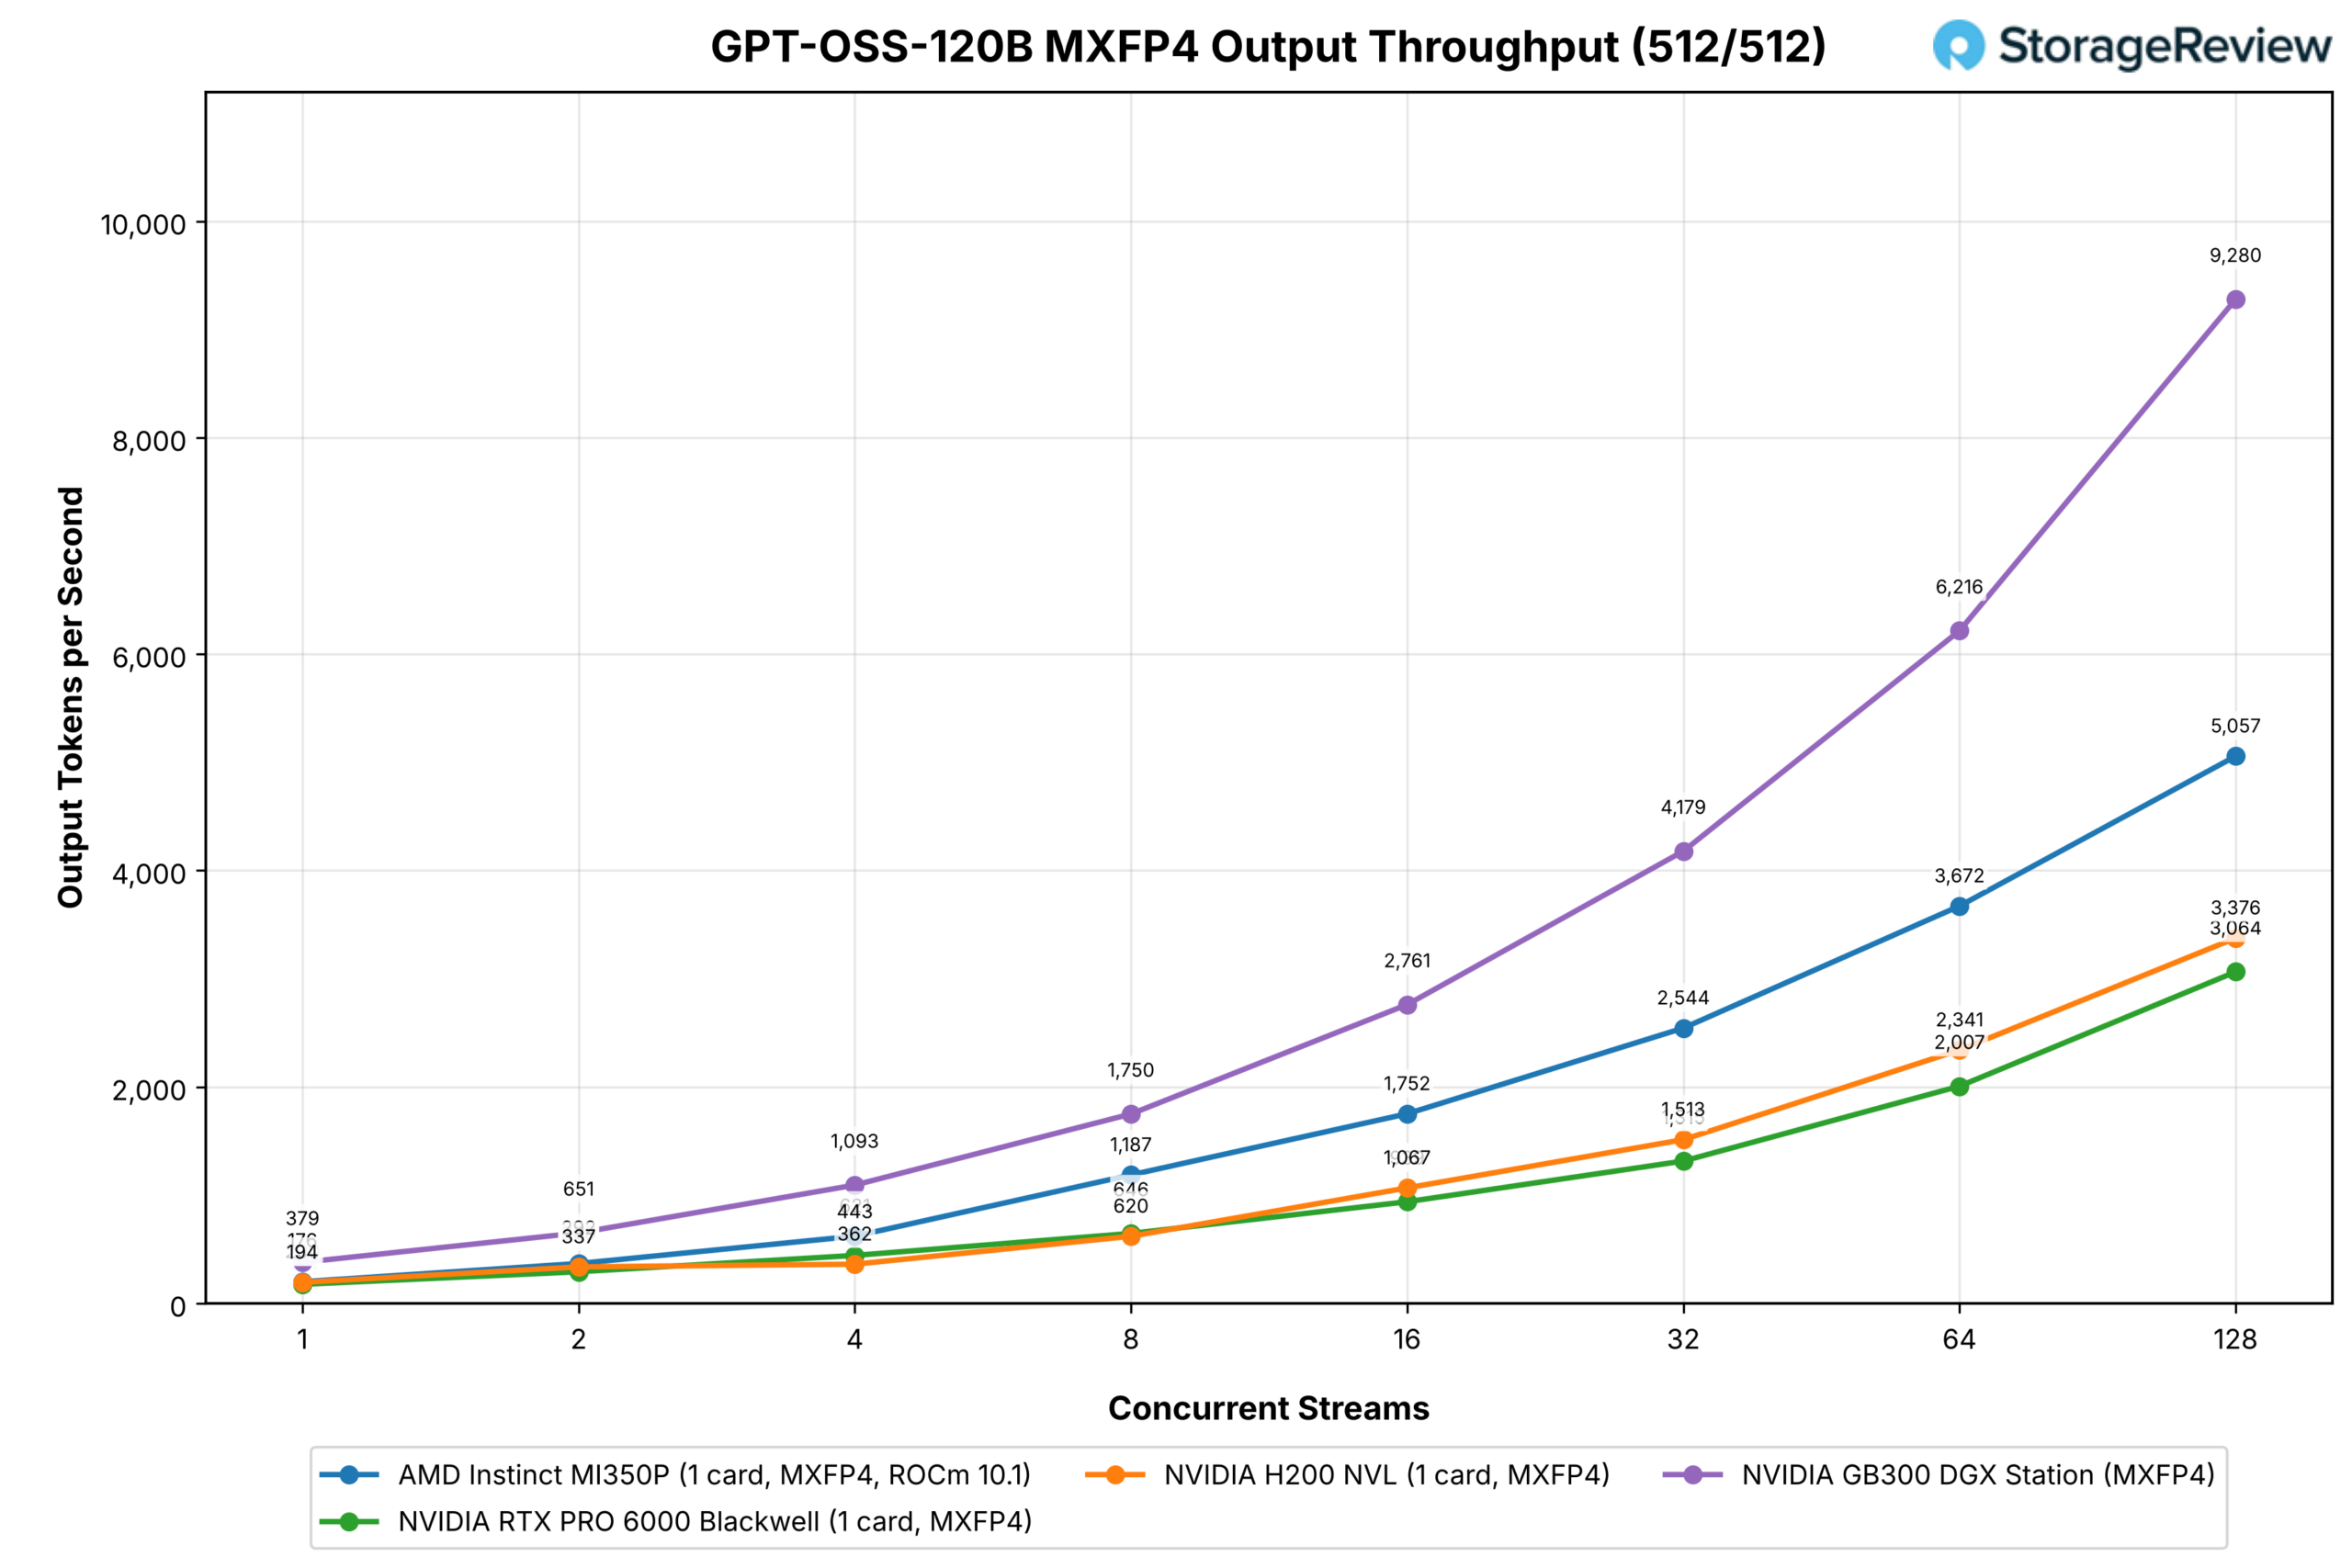
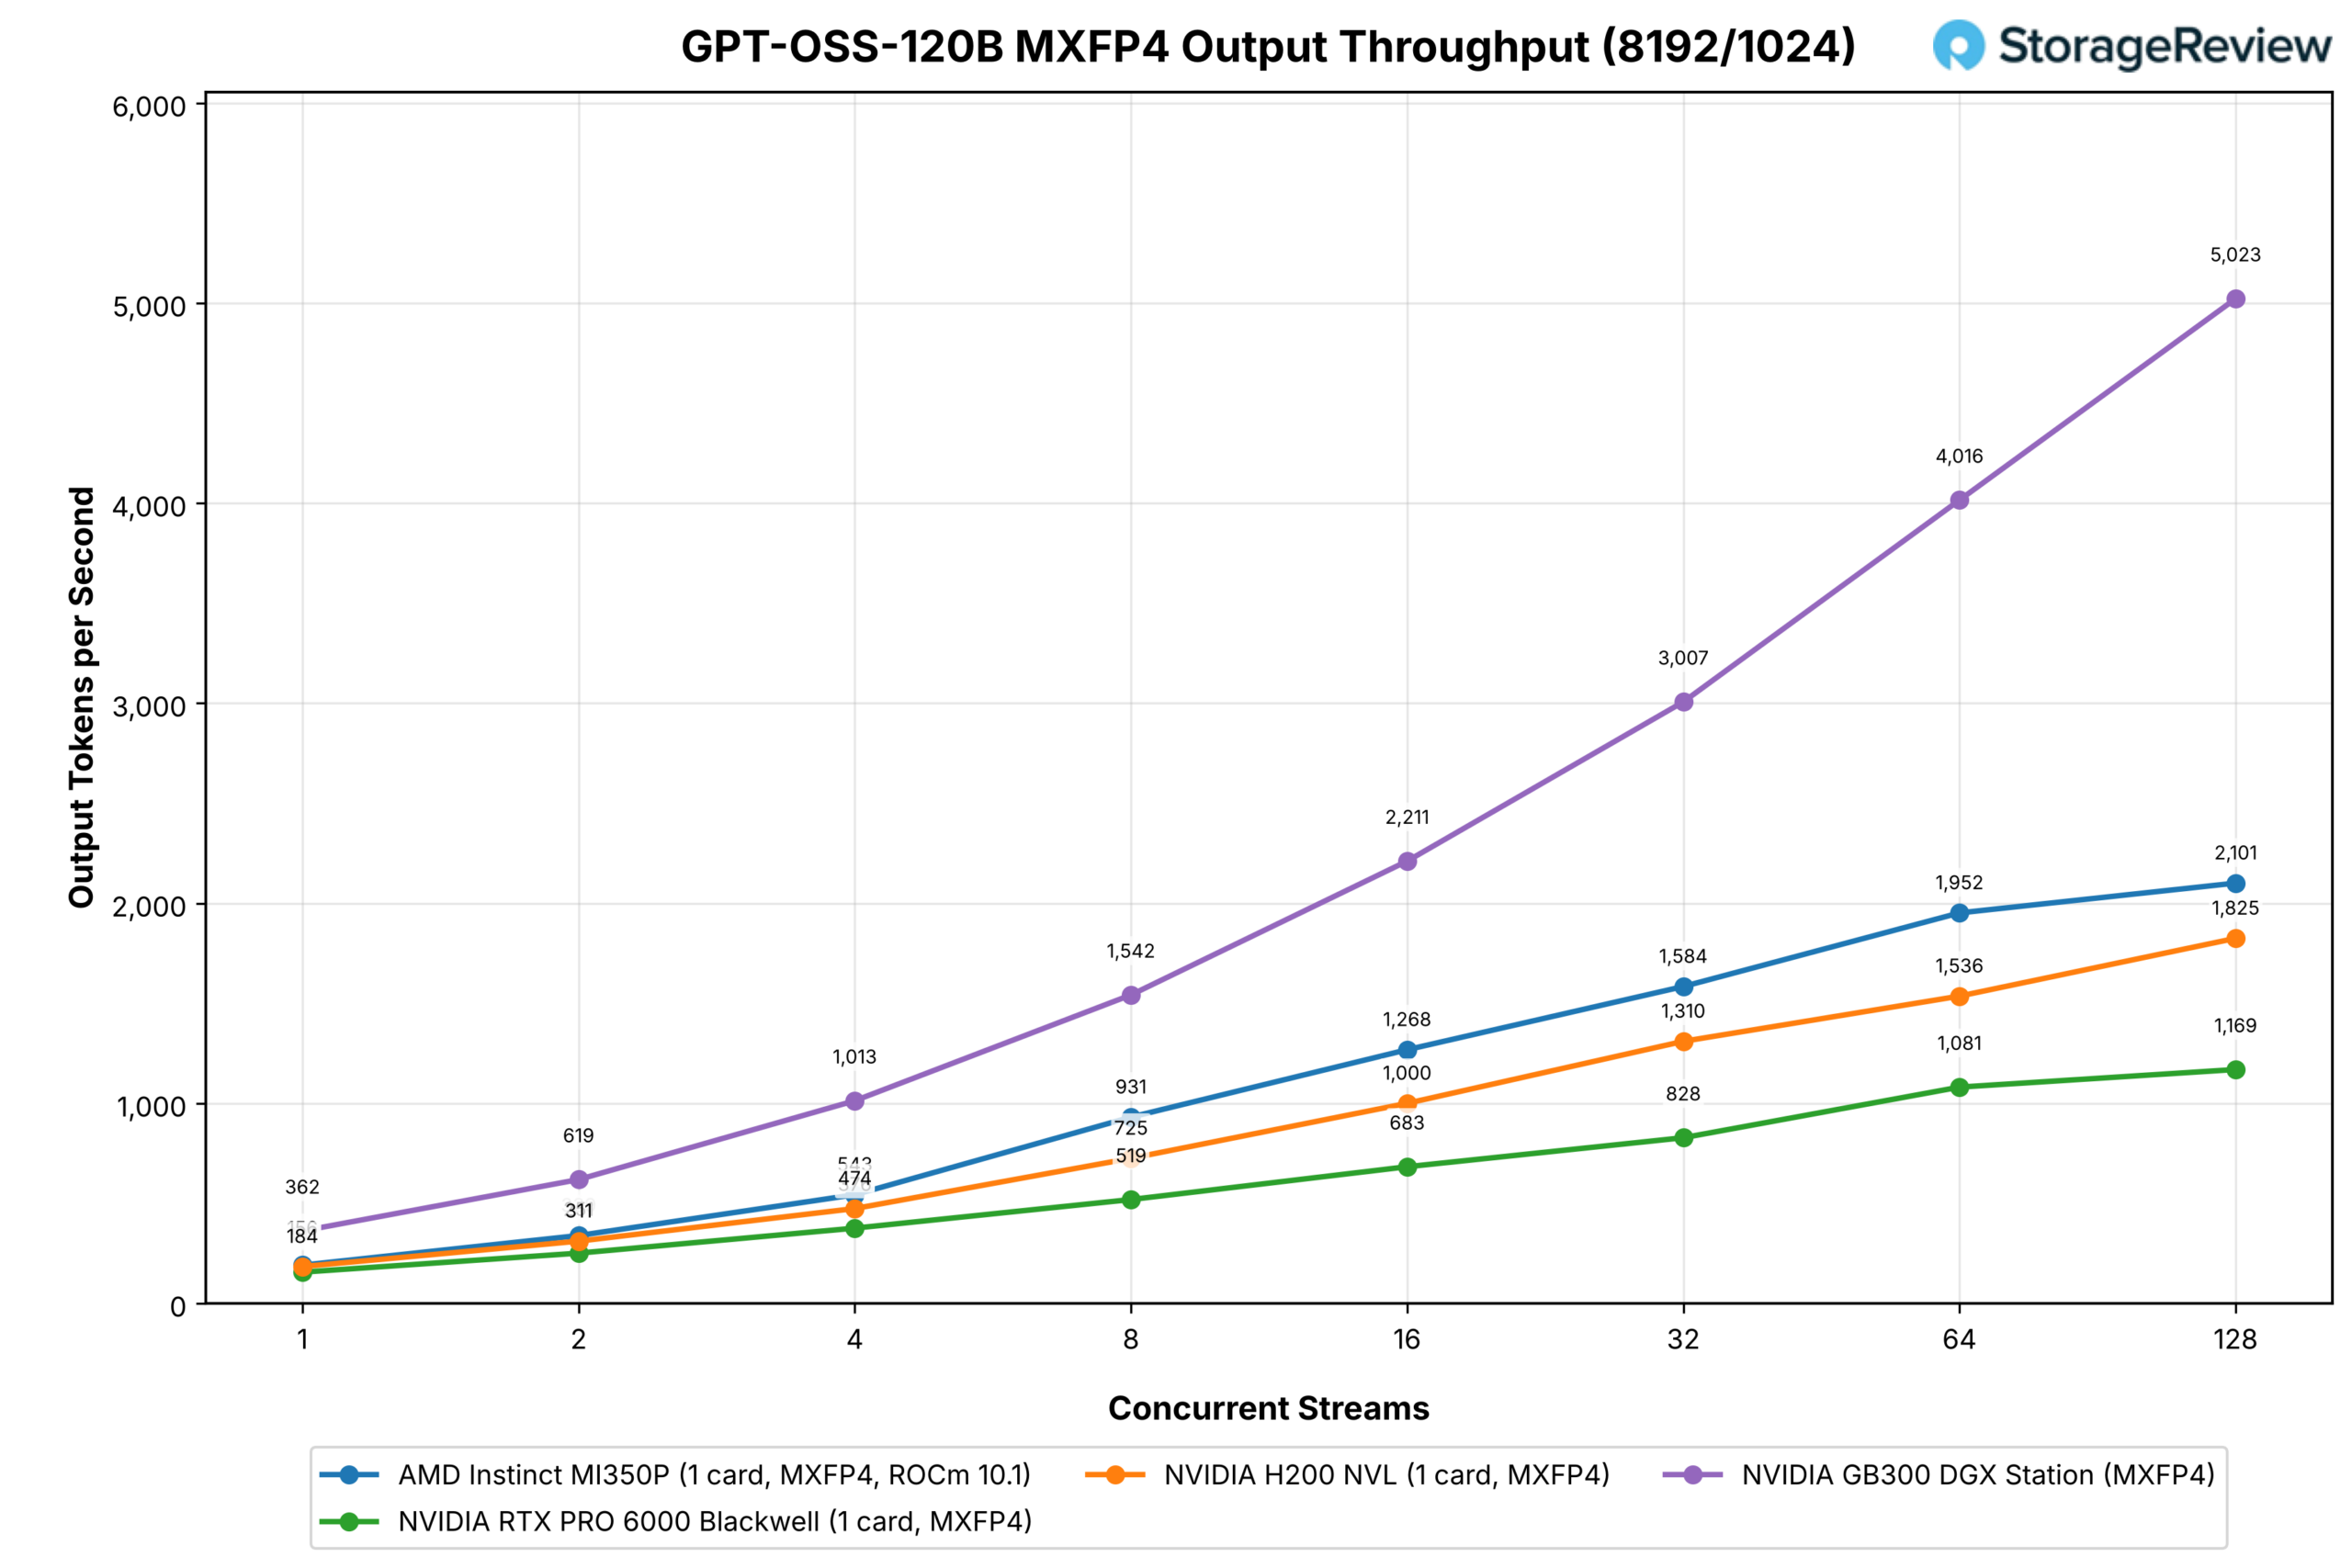
GPT-OSS wordt geleverd als MXFP4, dus elke kaart werkt met dezelfde gewichten. Een MI350P presteert bij elk aantal streams beter dan een RTX PRO 6000 in beide workloads, met een verschil van 40 tot 93 procent vanaf vier streams. De MI350P haalt 5,057 uitvoertokens per seconde in de chatworkload en 2,101 in de prefill-intensieve prompts bij 128 streams, tegenover 3,064 en 1,169 voor de RTX PRO 6000 en 3,376 en 1,825 voor de H200 NVL; de Station haalt 9,280 en 5,023.
De MLPerf Inference v6.1-inzending van AMD en Dell van 16 september legt een bovengrens vast voor hetzelfde model: acht MI350P's in een PowerEdge XE7745 produceerden 48,971 tokens per seconde offline en 40,868 in het serverscenario op GPT-OSS-120B, wat neerkomt op respectievelijk 6,121 en 5,108 tokens per GPU, met een geoptimaliseerde testomgeving. Die testomgeving en de onze zijn niet exact hetzelfde, maar de 5,057 die we hebben gemeten bij 128 streams met standaard vLLM ligt aan de onderkant van dat bereik.
GPT-OSS-20B
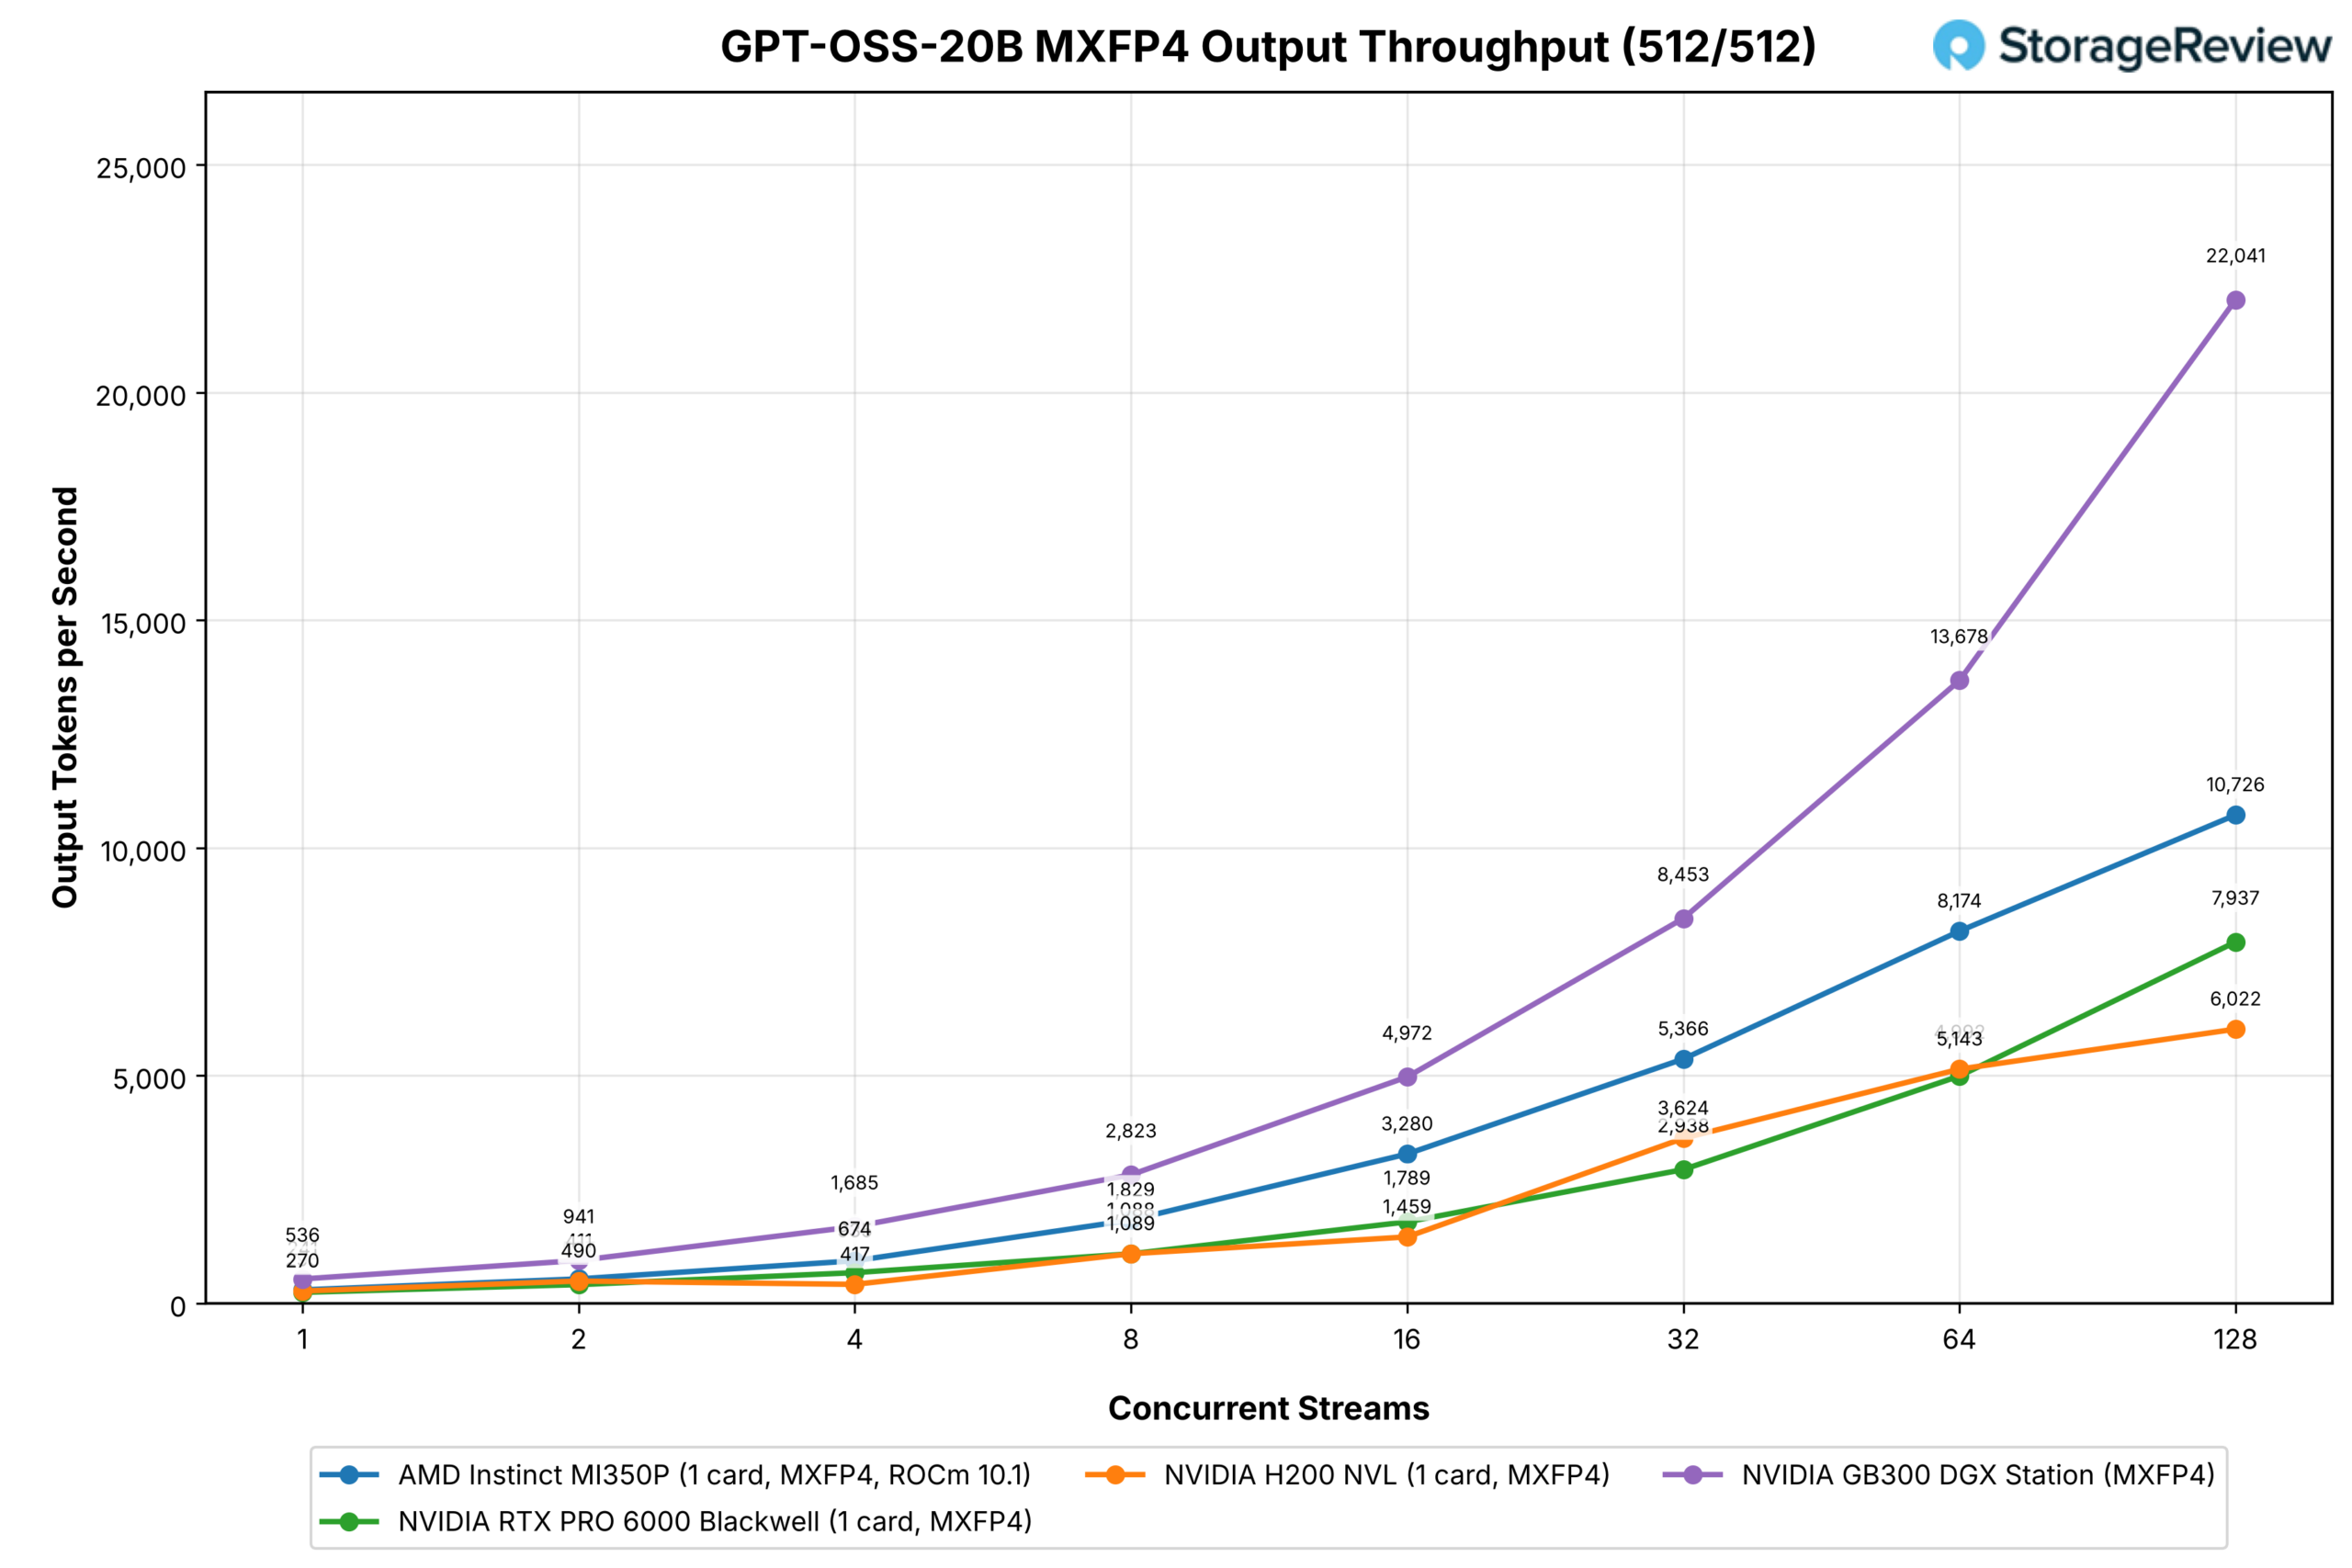
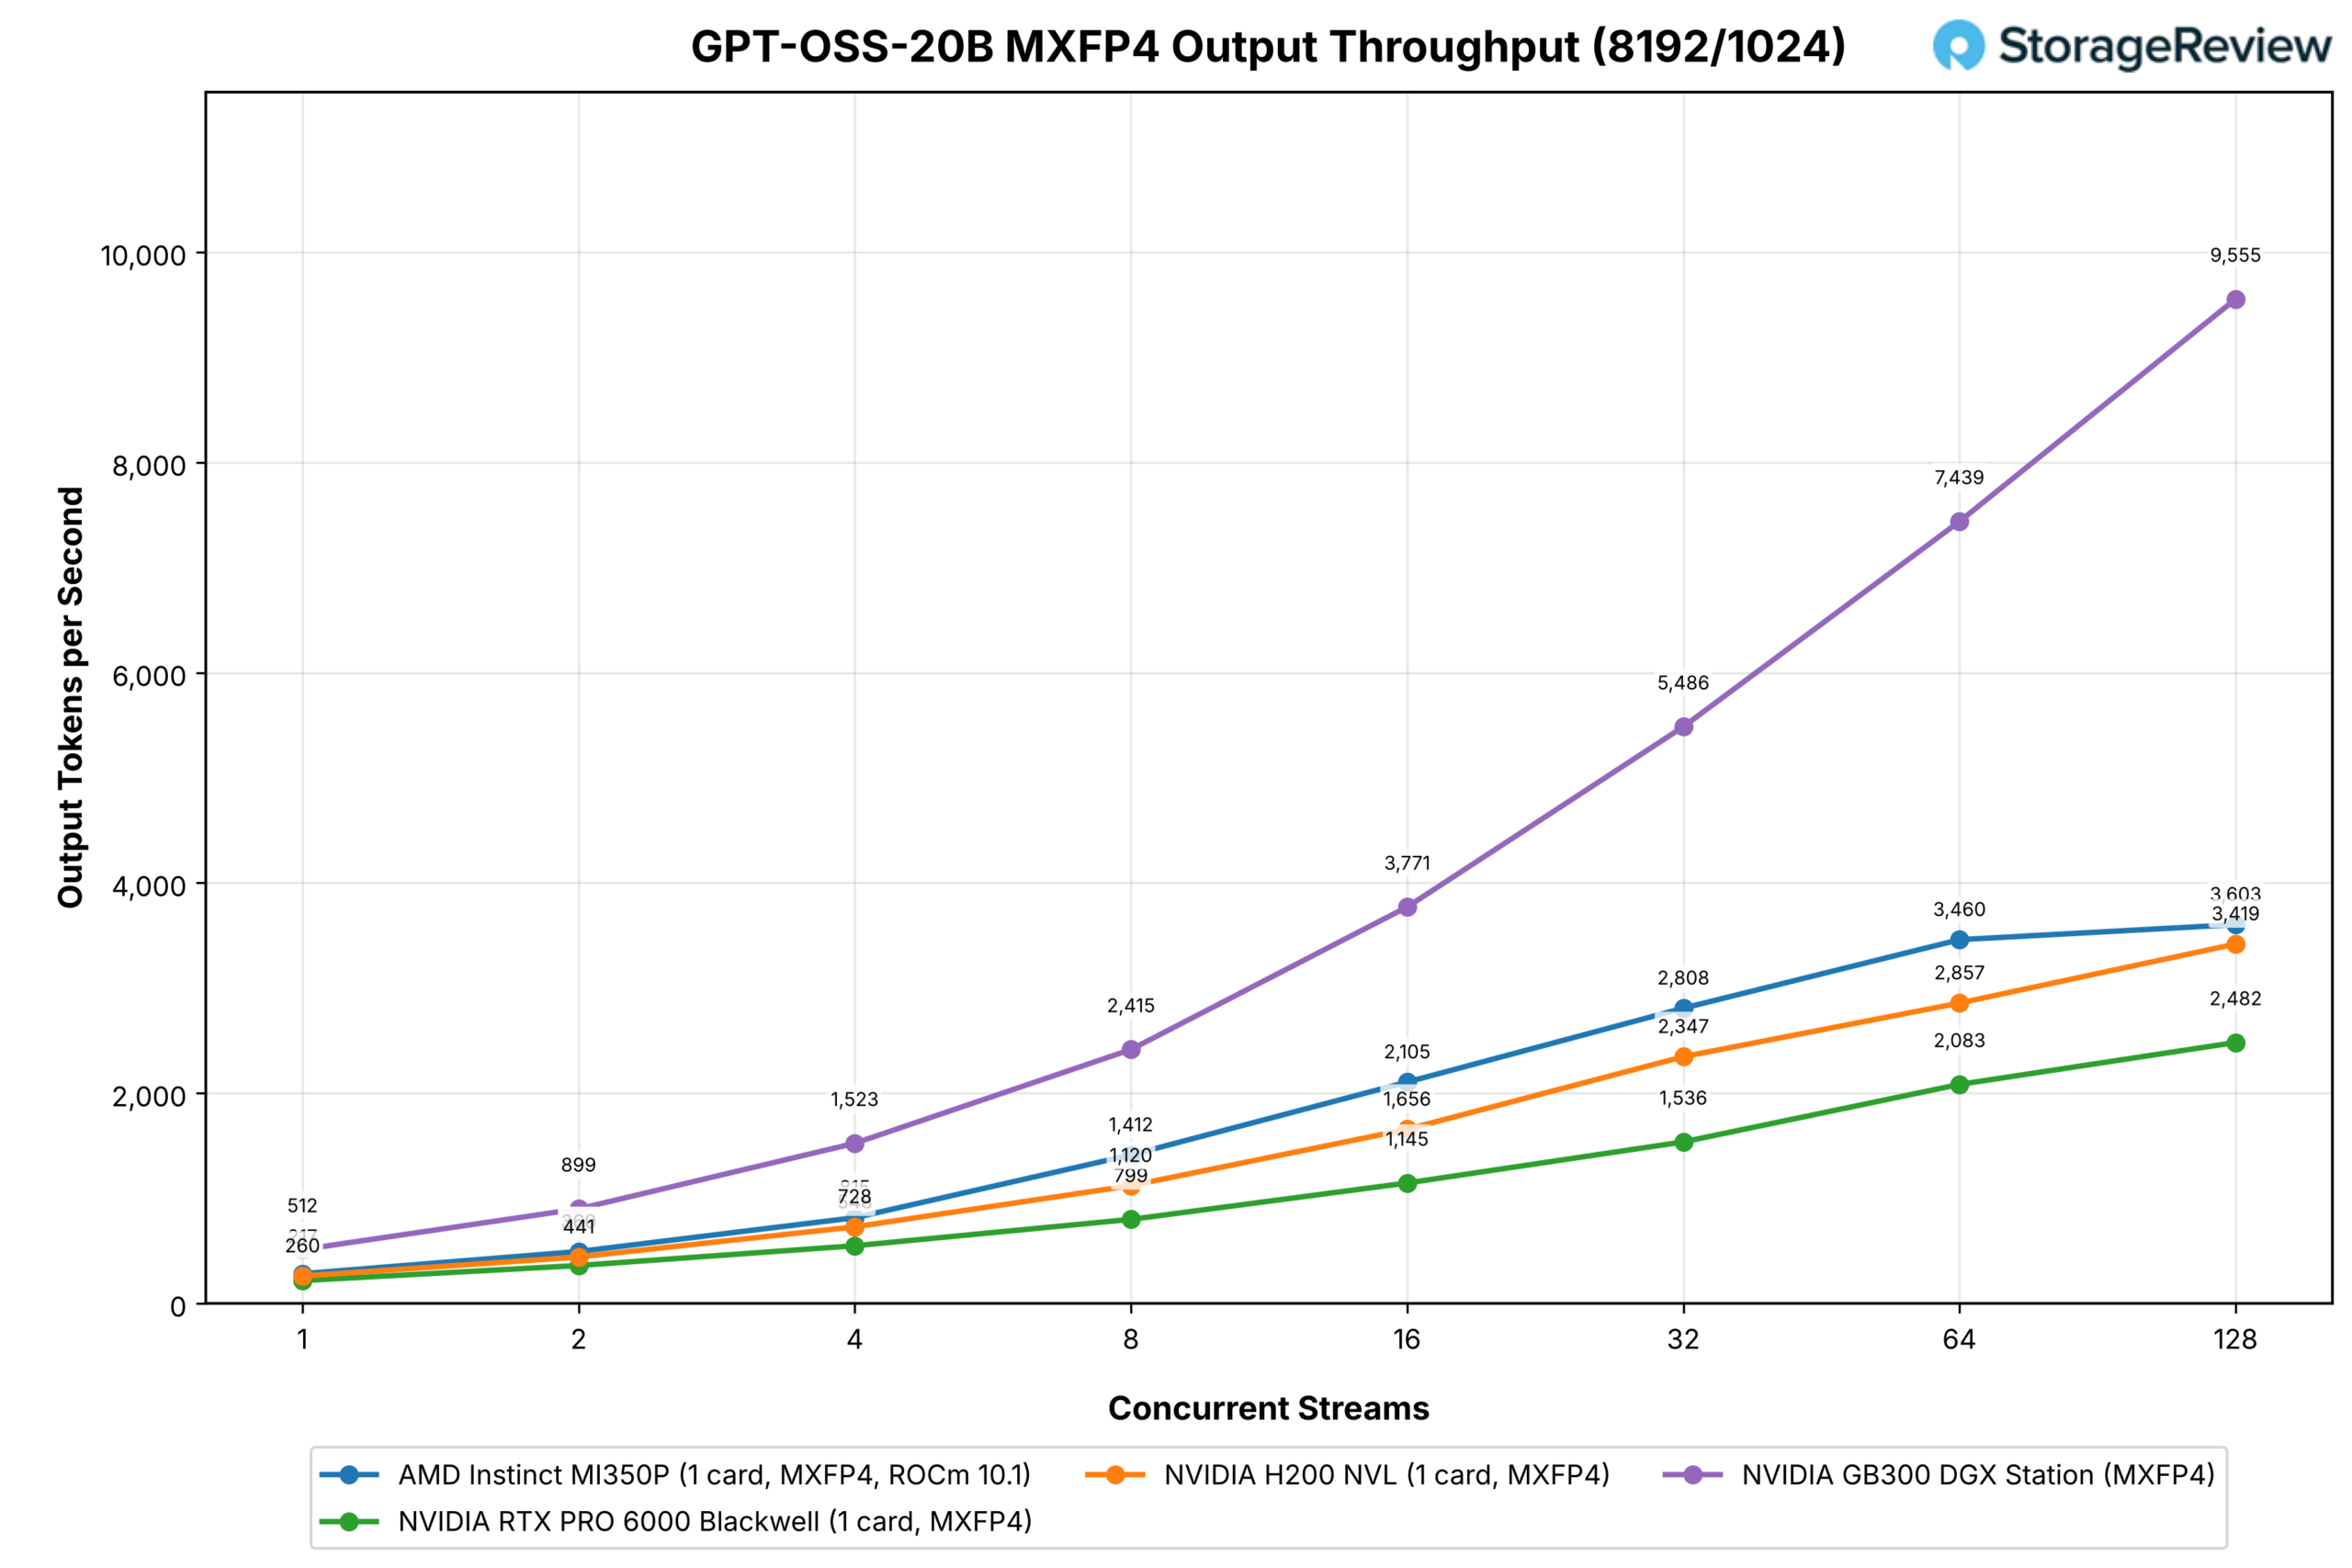
Het kleinere OpenAI-model volgt dezelfde curve. De MI350P presteert op elk punt beter dan de RTX PRO 6000: 8,174 tegen 4,992 bij 64 streams en 10,726 tegen 7,937 bij 128 streams voor de chatbelasting, en 3,460 tegen 2,083 en 3,603 tegen 2,482 voor prompts met veel vooraf ingevulde tekst. Bij 256 streams behaalt de MI350P een score van 16,406, terwijl de RTX PRO 6000 daar 11,077 scoort. De H200 NVL blijft achter bij de MI350P op beide curves, met scores van 6,022 en 3,419 bij 128 streams, en de Station scoort 22,041 en 9,555.
Qwen3-Coder-30B-A3B
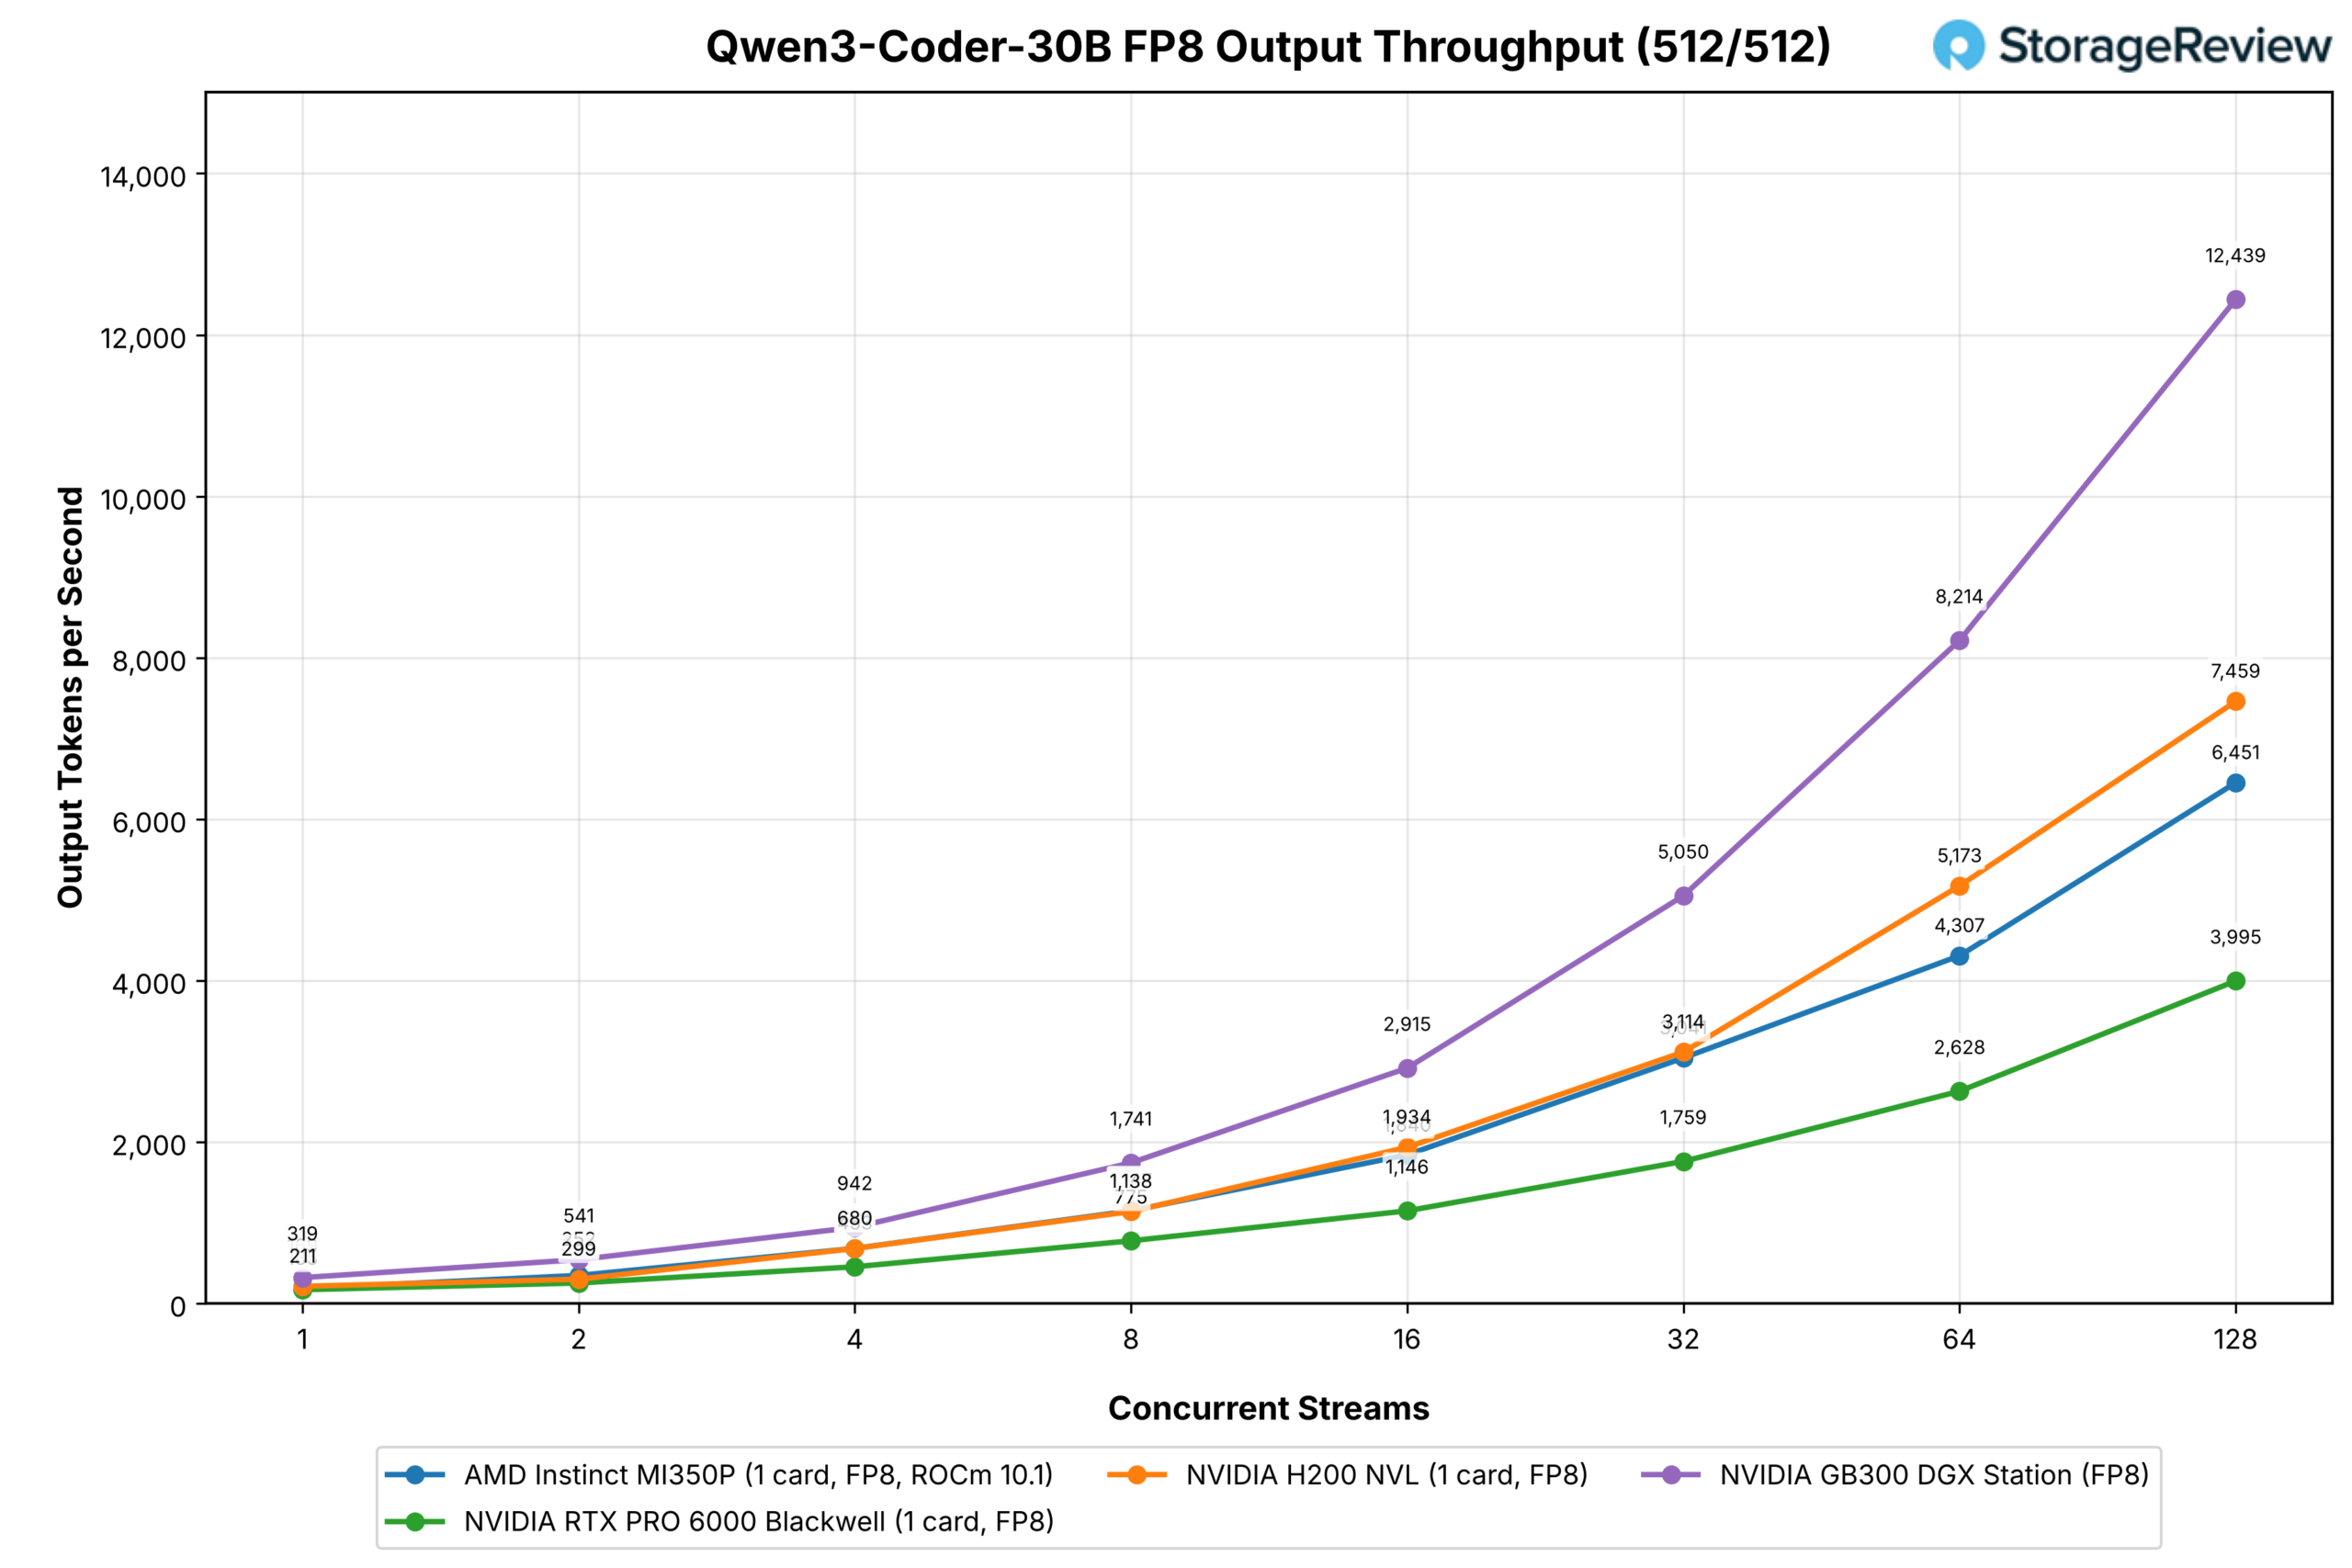
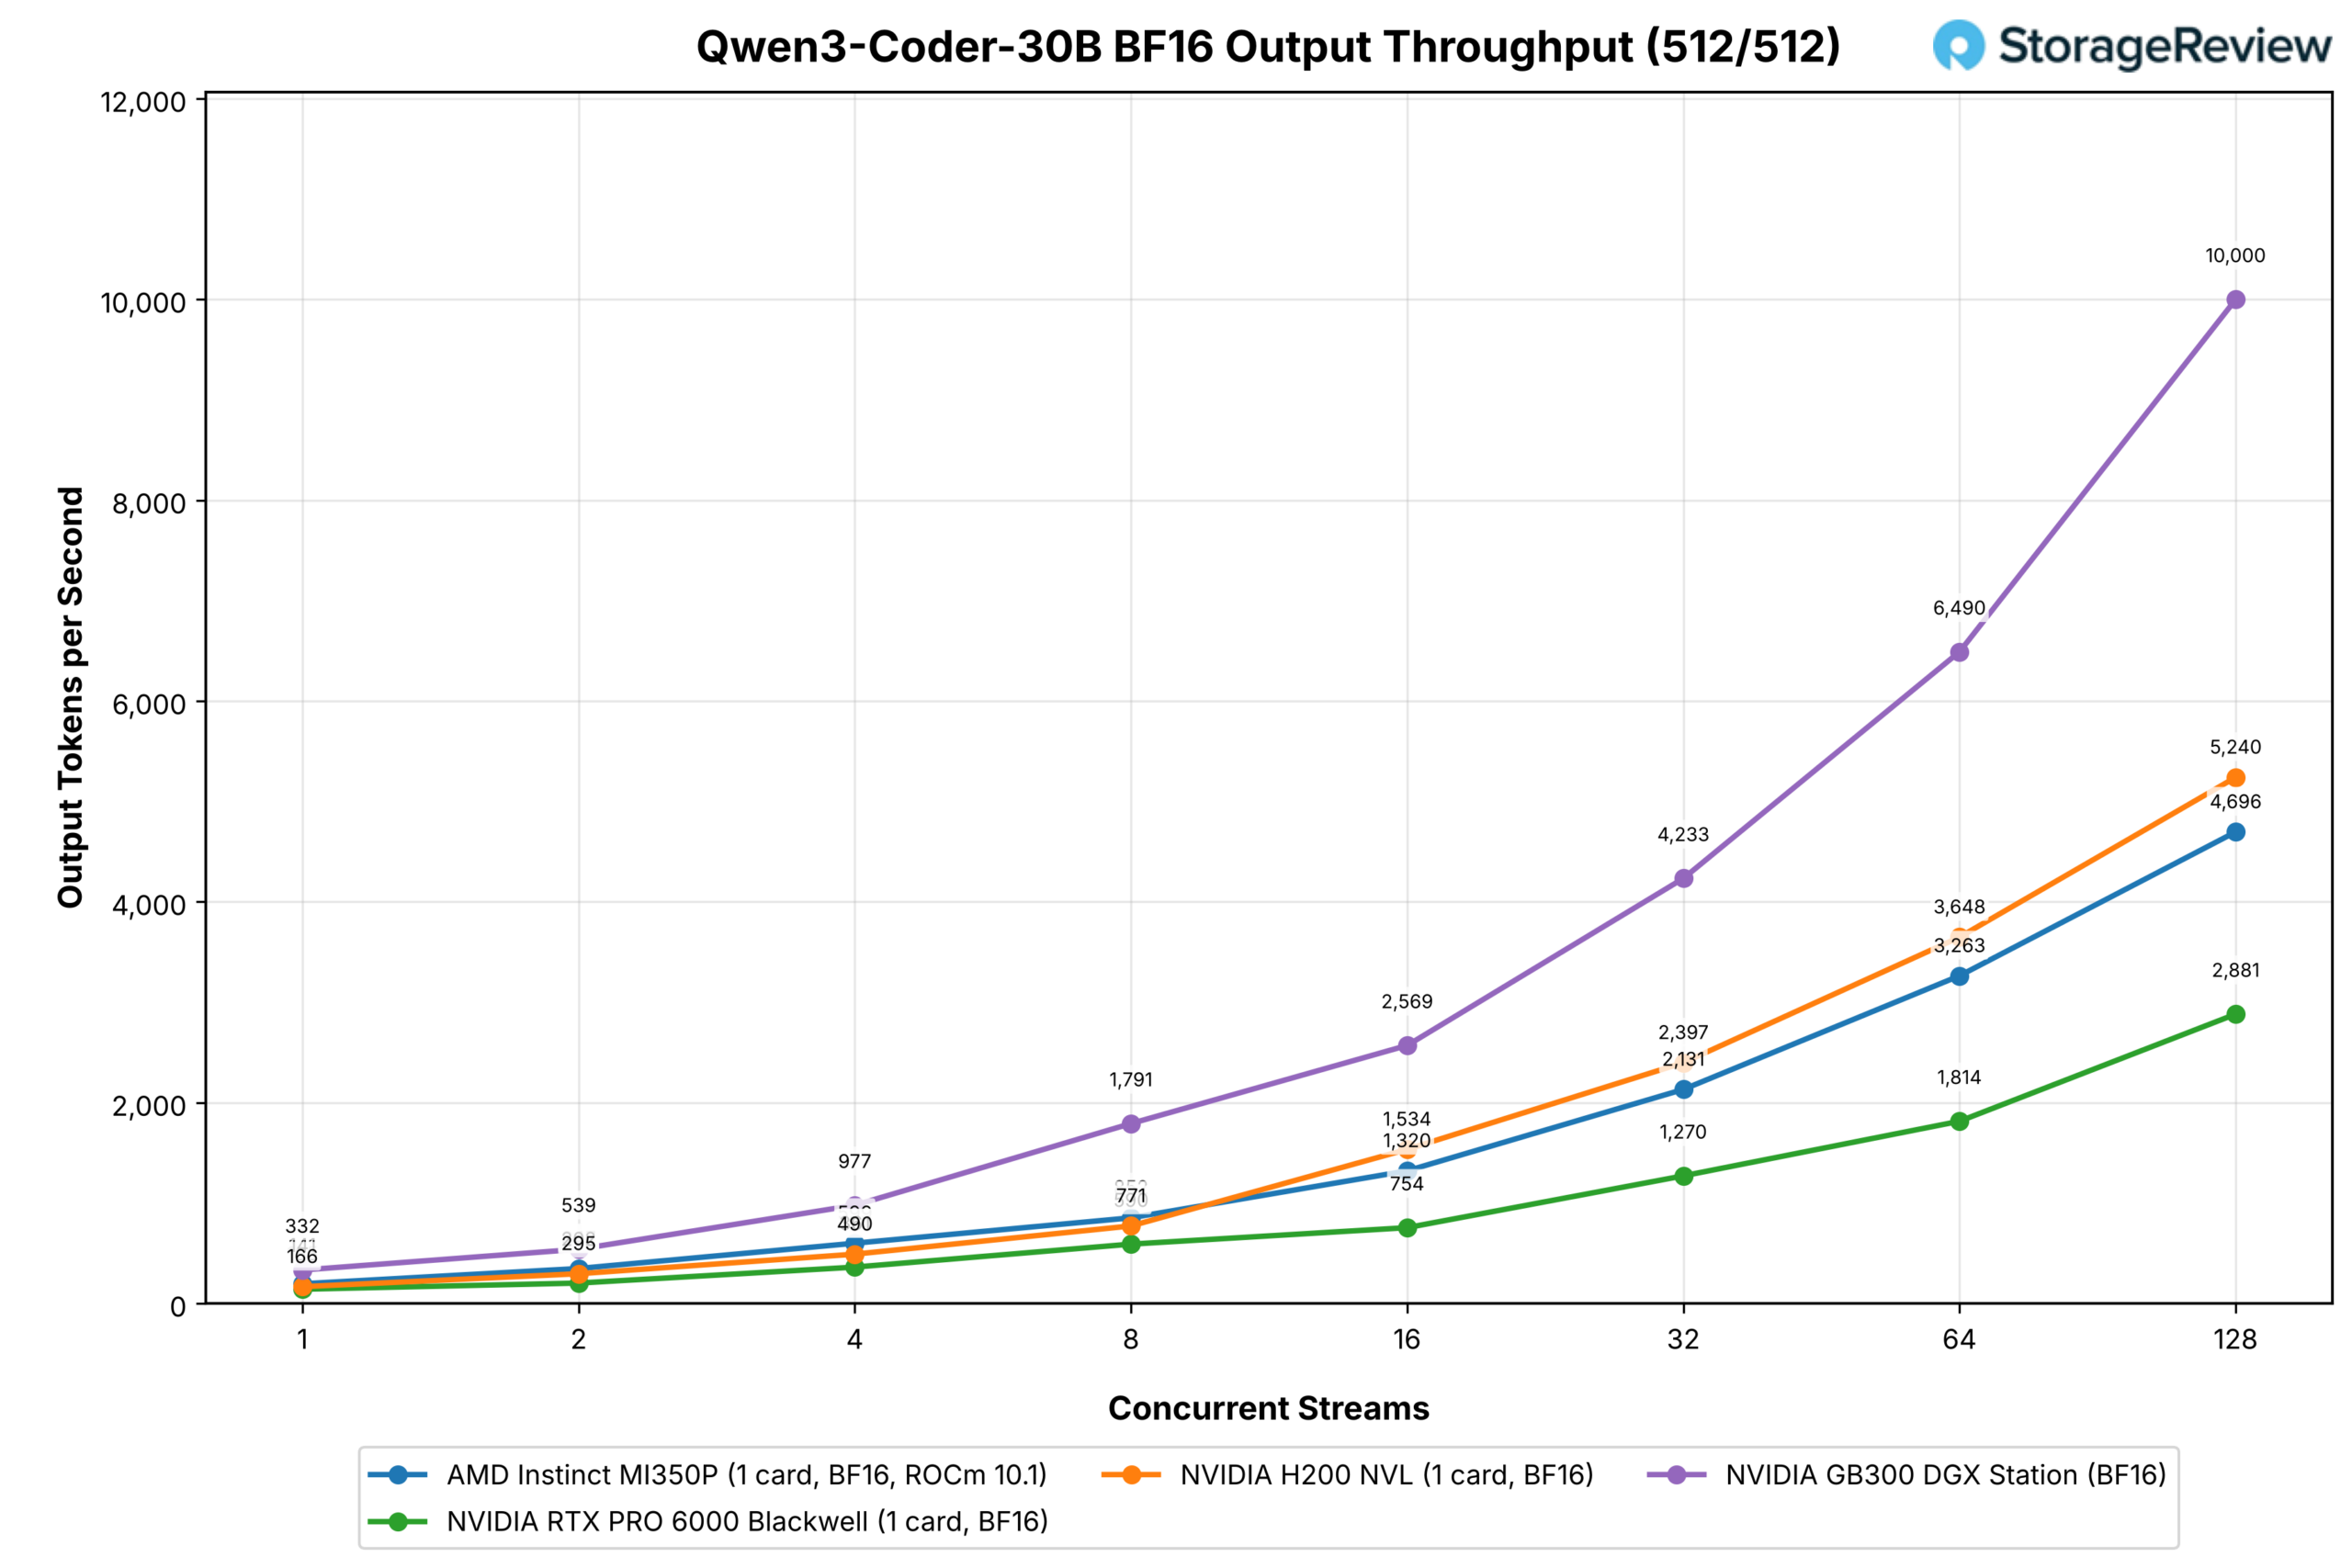
De 30B MoE met 3B actieve parameters geeft de MI350P een voorsprong op de RTX PRO 6000 bij elke gelijktijdigheid in de chat-workload, met een score van 6,451 tegen 3,995 in FP8 en 4,696 tegen 2,881 in BF16 bij 128 streams, terwijl de H200 respectievelijk 7,459 en 5,240 scoort.
Bij prompts met veel voorvulling loopt de FP8-run slechts tot vier streams voor en blijft vervolgens achter bij de RTX PRO 6000 van acht tot en met 128 streams, met een score van 759 tegen 823 op het hoogtepunt, en de H200 op 1,820; de BF16-run klimt naar 728 bij 128 streams tegen 588 en 1,592.
Mistral Klein 3.1 24B
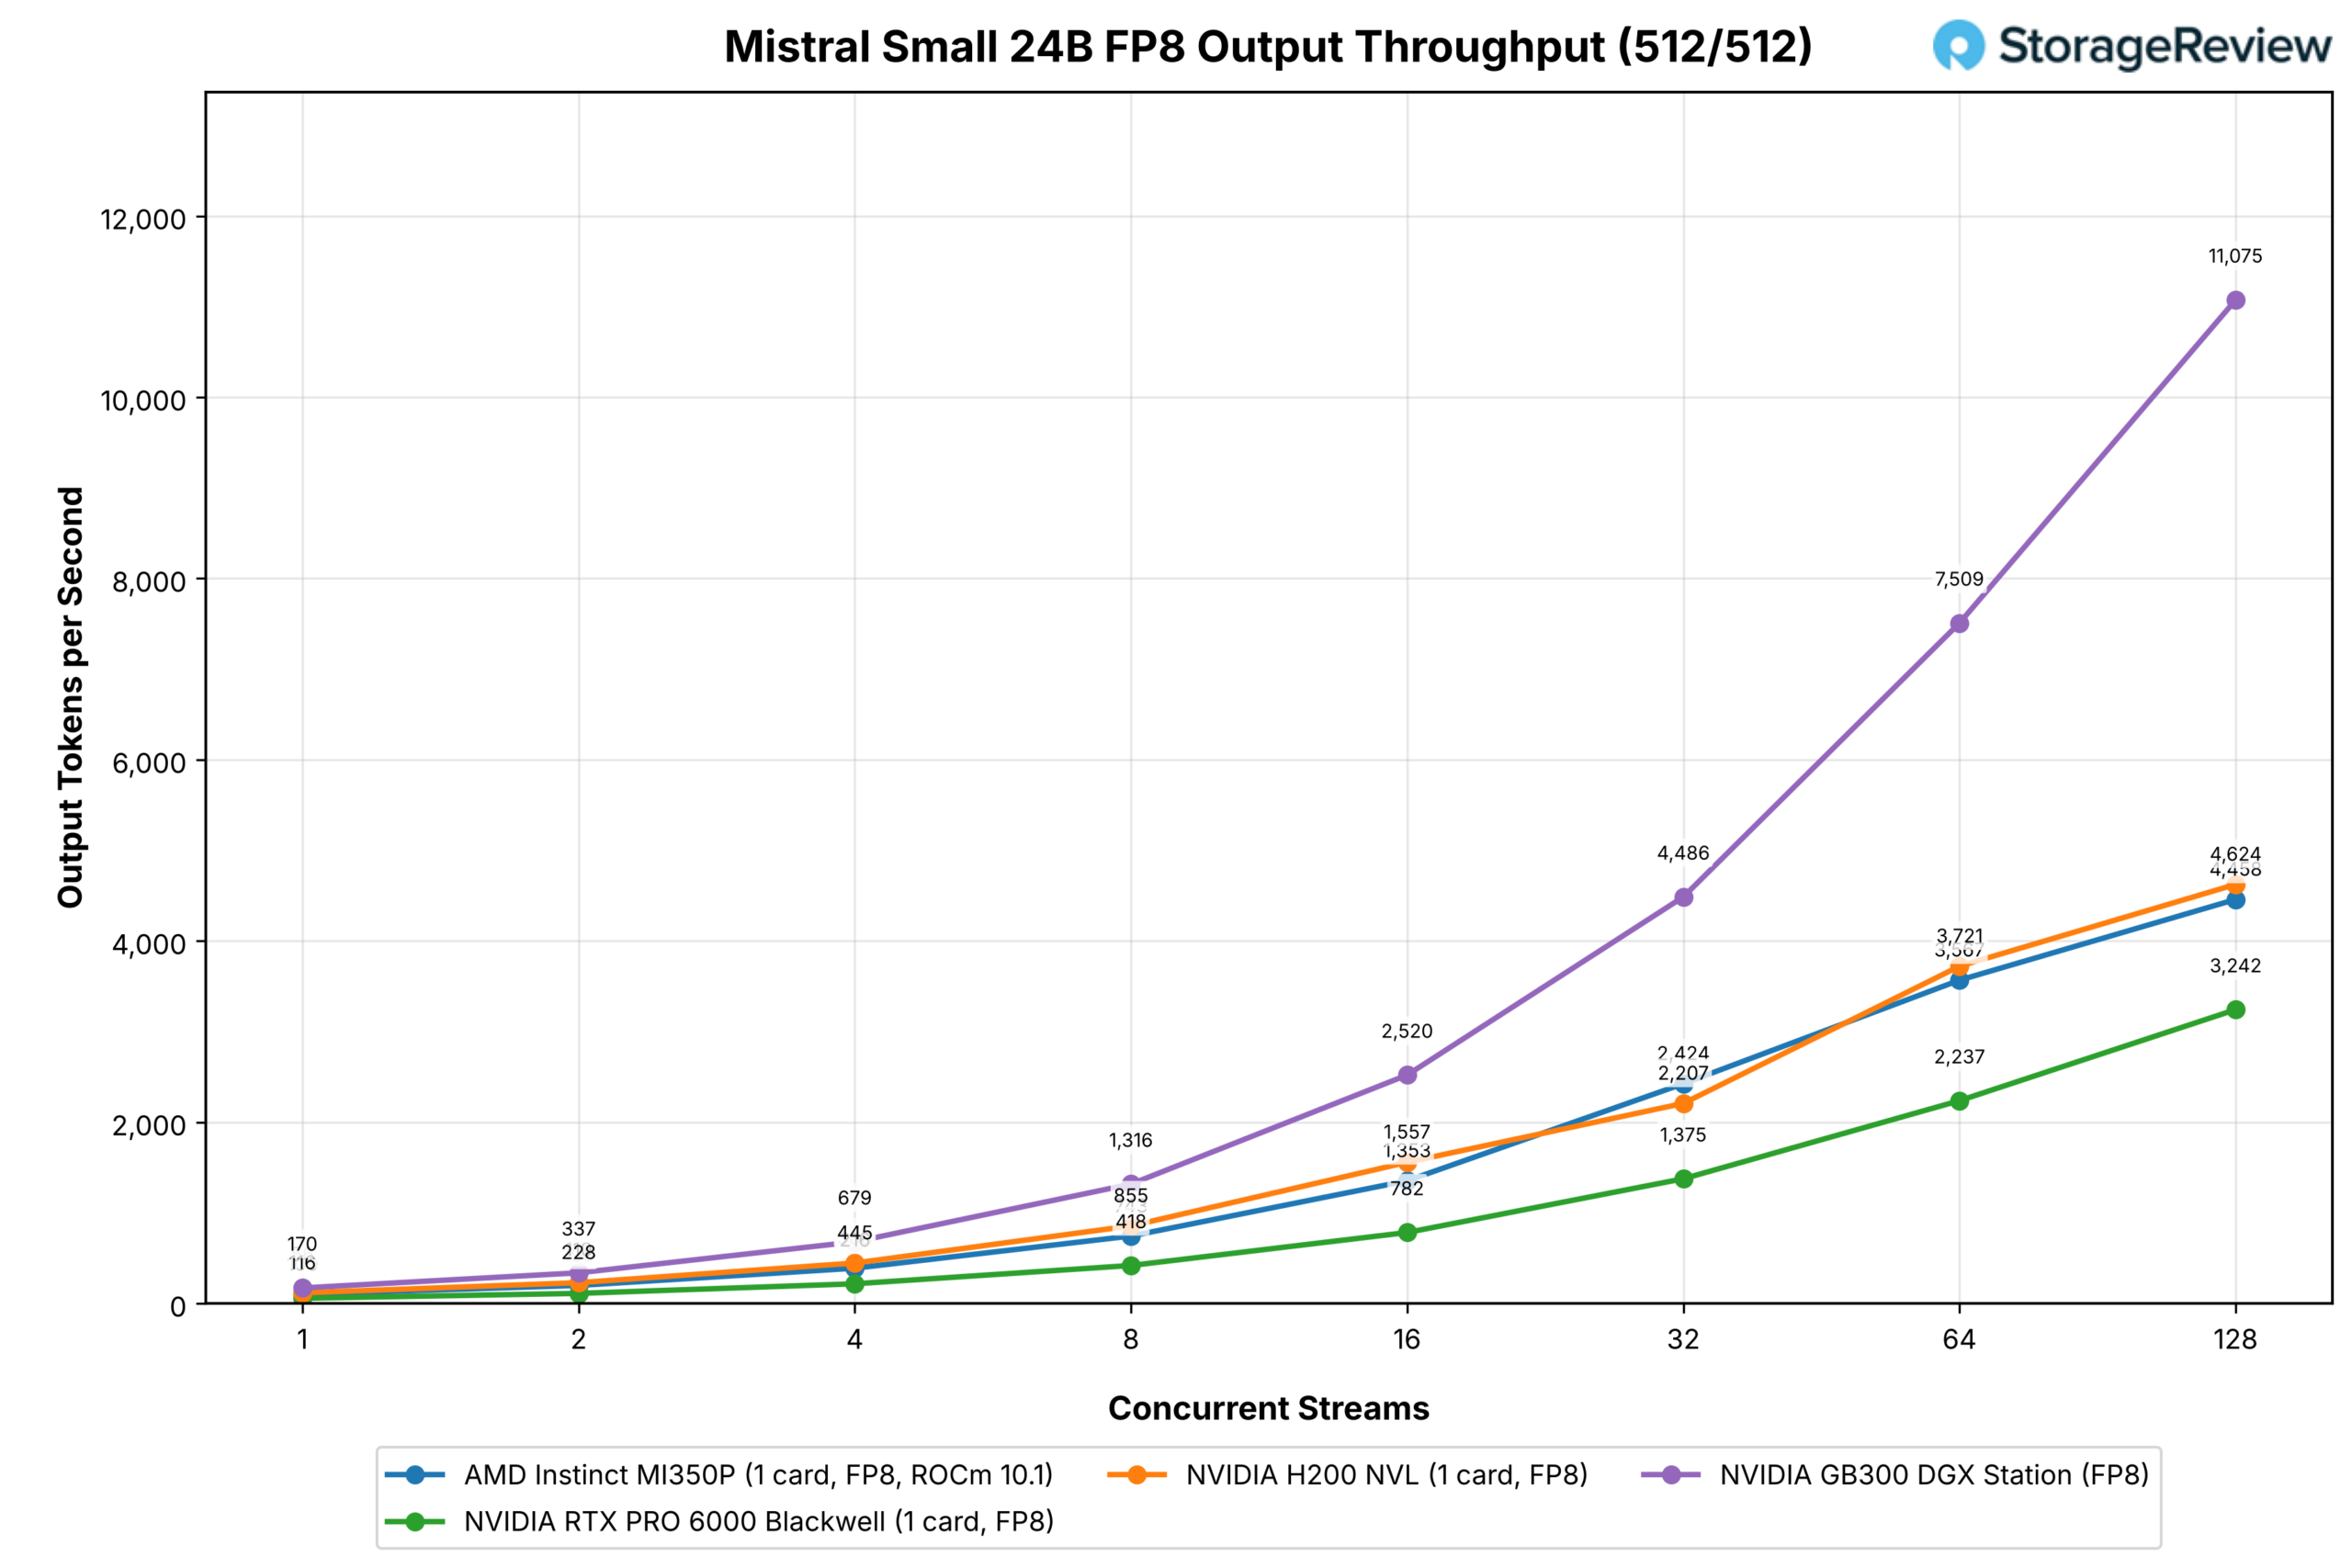
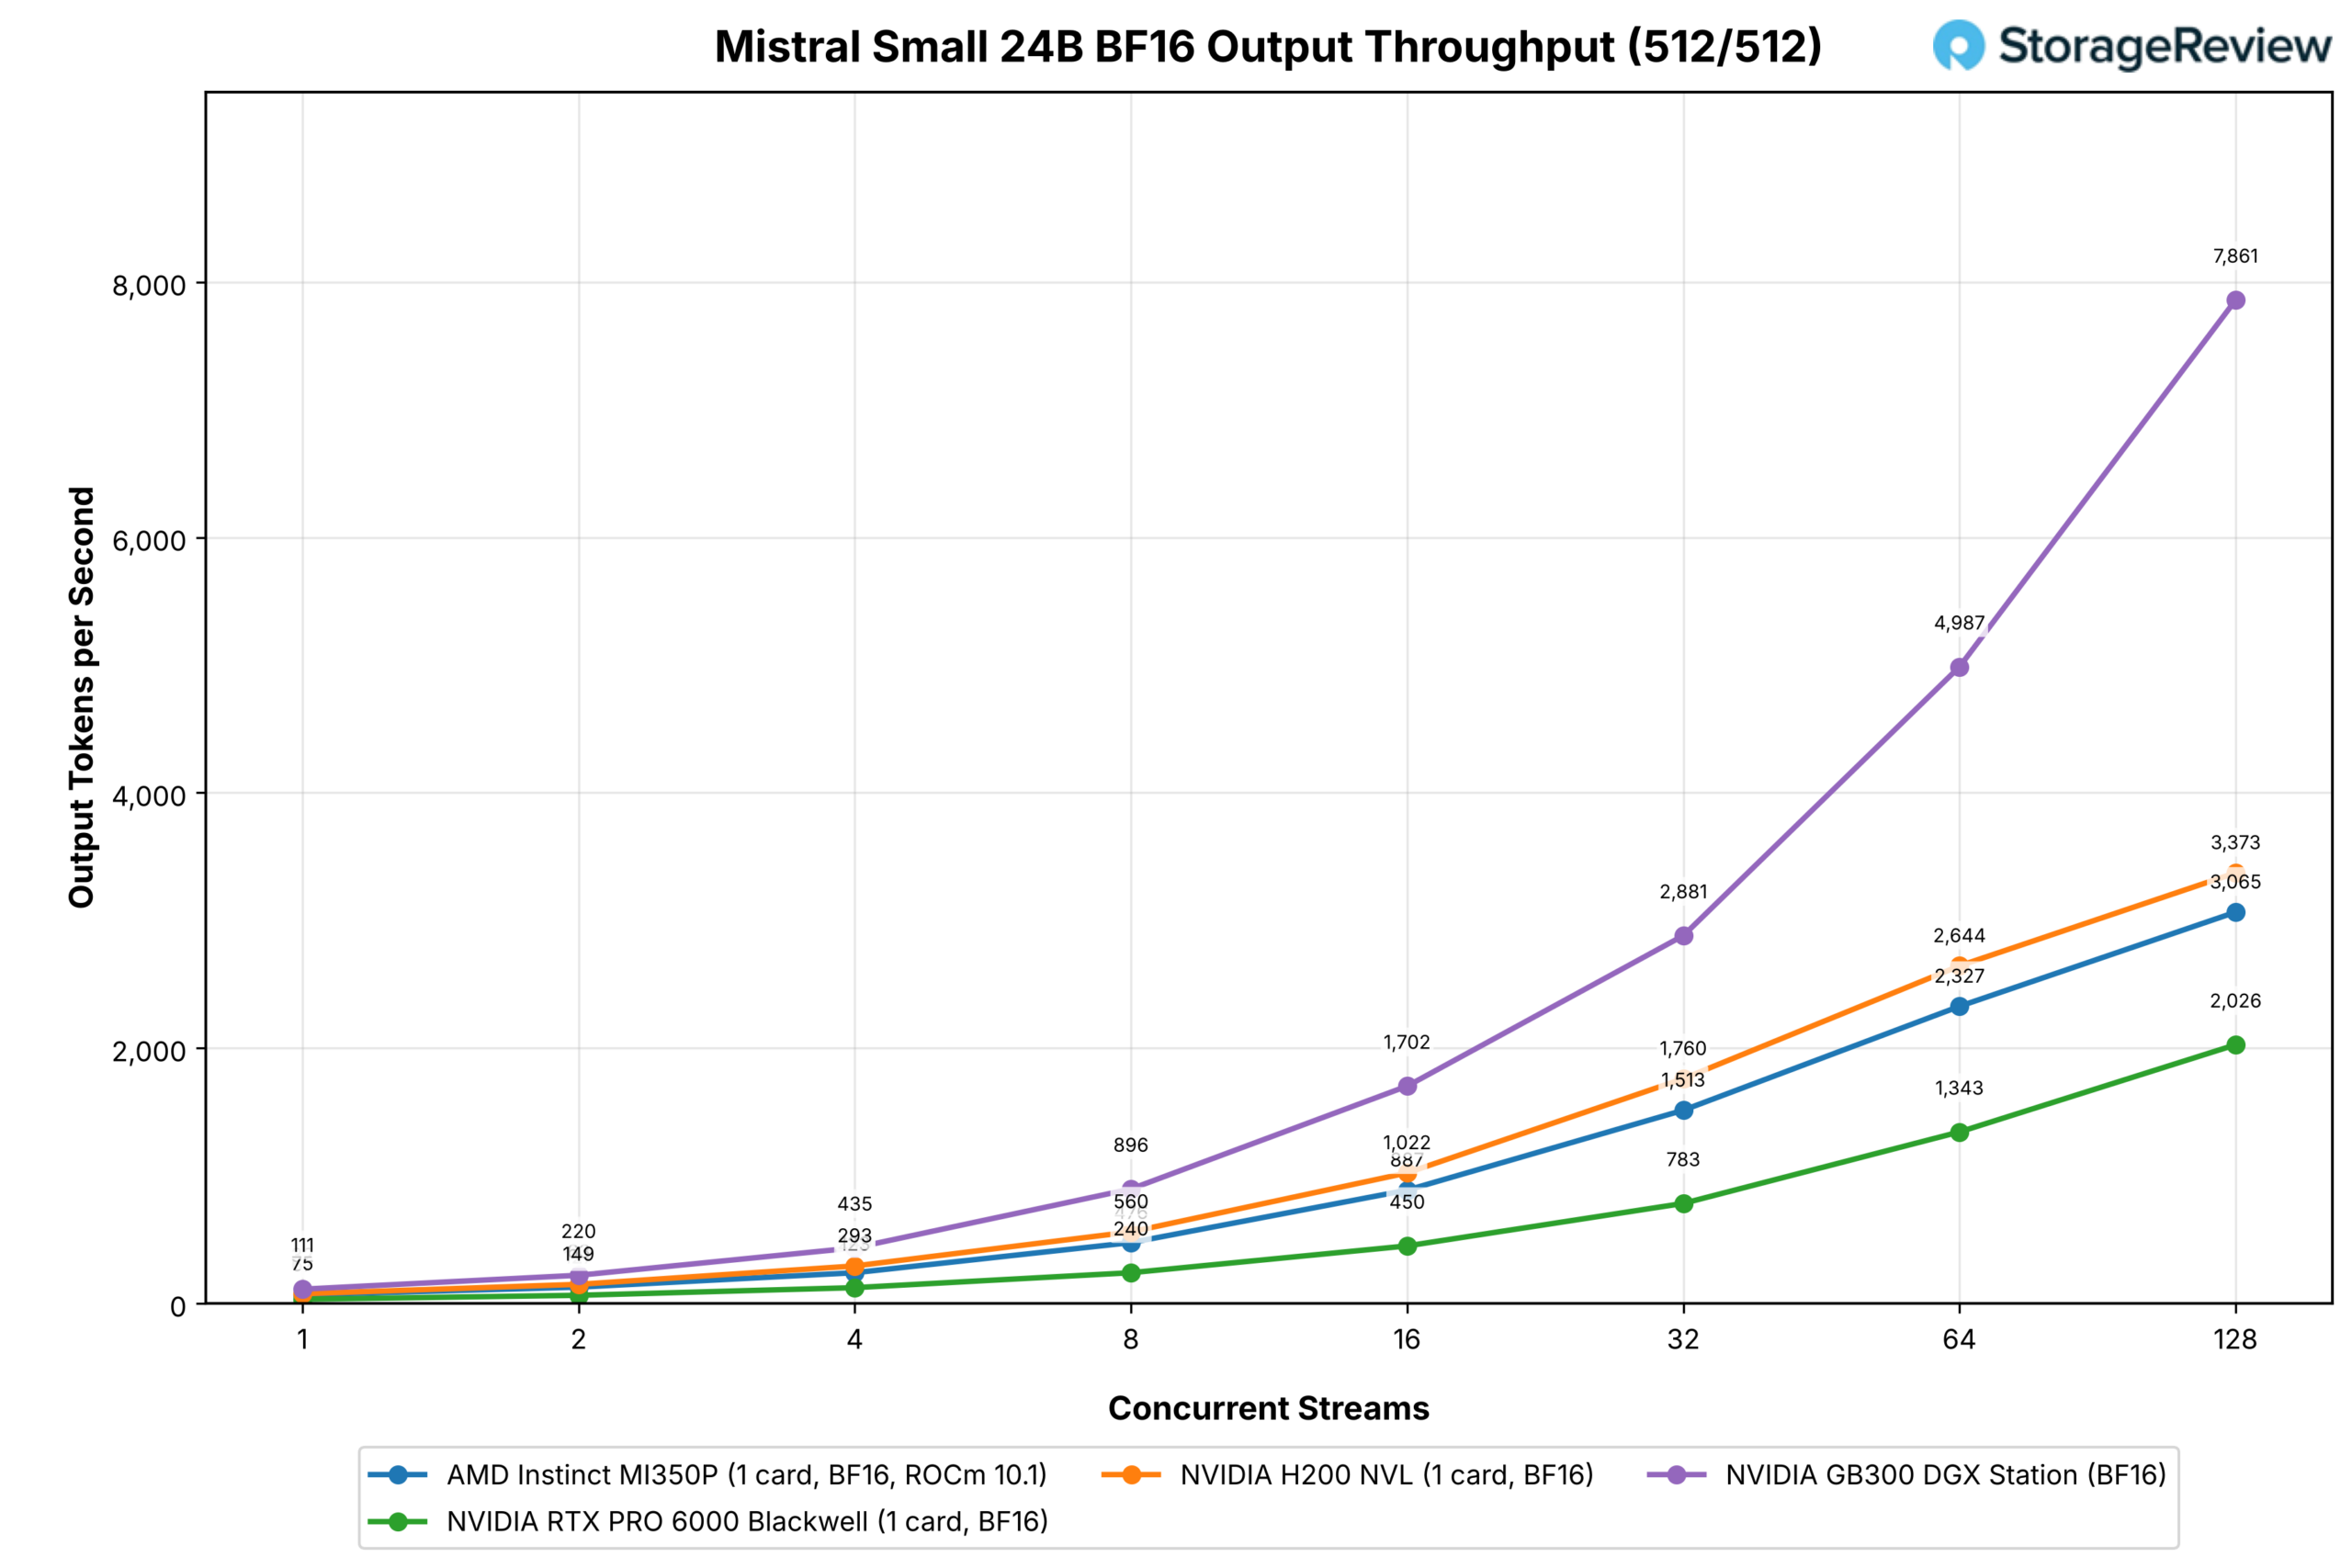
Mistral Small is het sterkste resultaat van de MI350P in vergelijking met de RTX PRO 6000: 4,458 tegen 3,242 op FP8 en 3,065 tegen 2,026 op BF16 bij 128 streams in de chat-workload. Bij één stream presteert de MI350P ongeveer twee keer zo goed als de NVIDIA-kaart (100 tegen 56 op FP8, 67 tegen 32 op BF16).
Het is ook het dichtste model waarin de MI350P de overhand heeft bij prompts met veel voorvulling, met 599 tegen 482 op FP8 bij 128 streams en 425 tegen 299 op BF16 bij 64, hoewel de H200 op dezelfde punten 799 en 632 behaalt.
Lama 3.1 8B
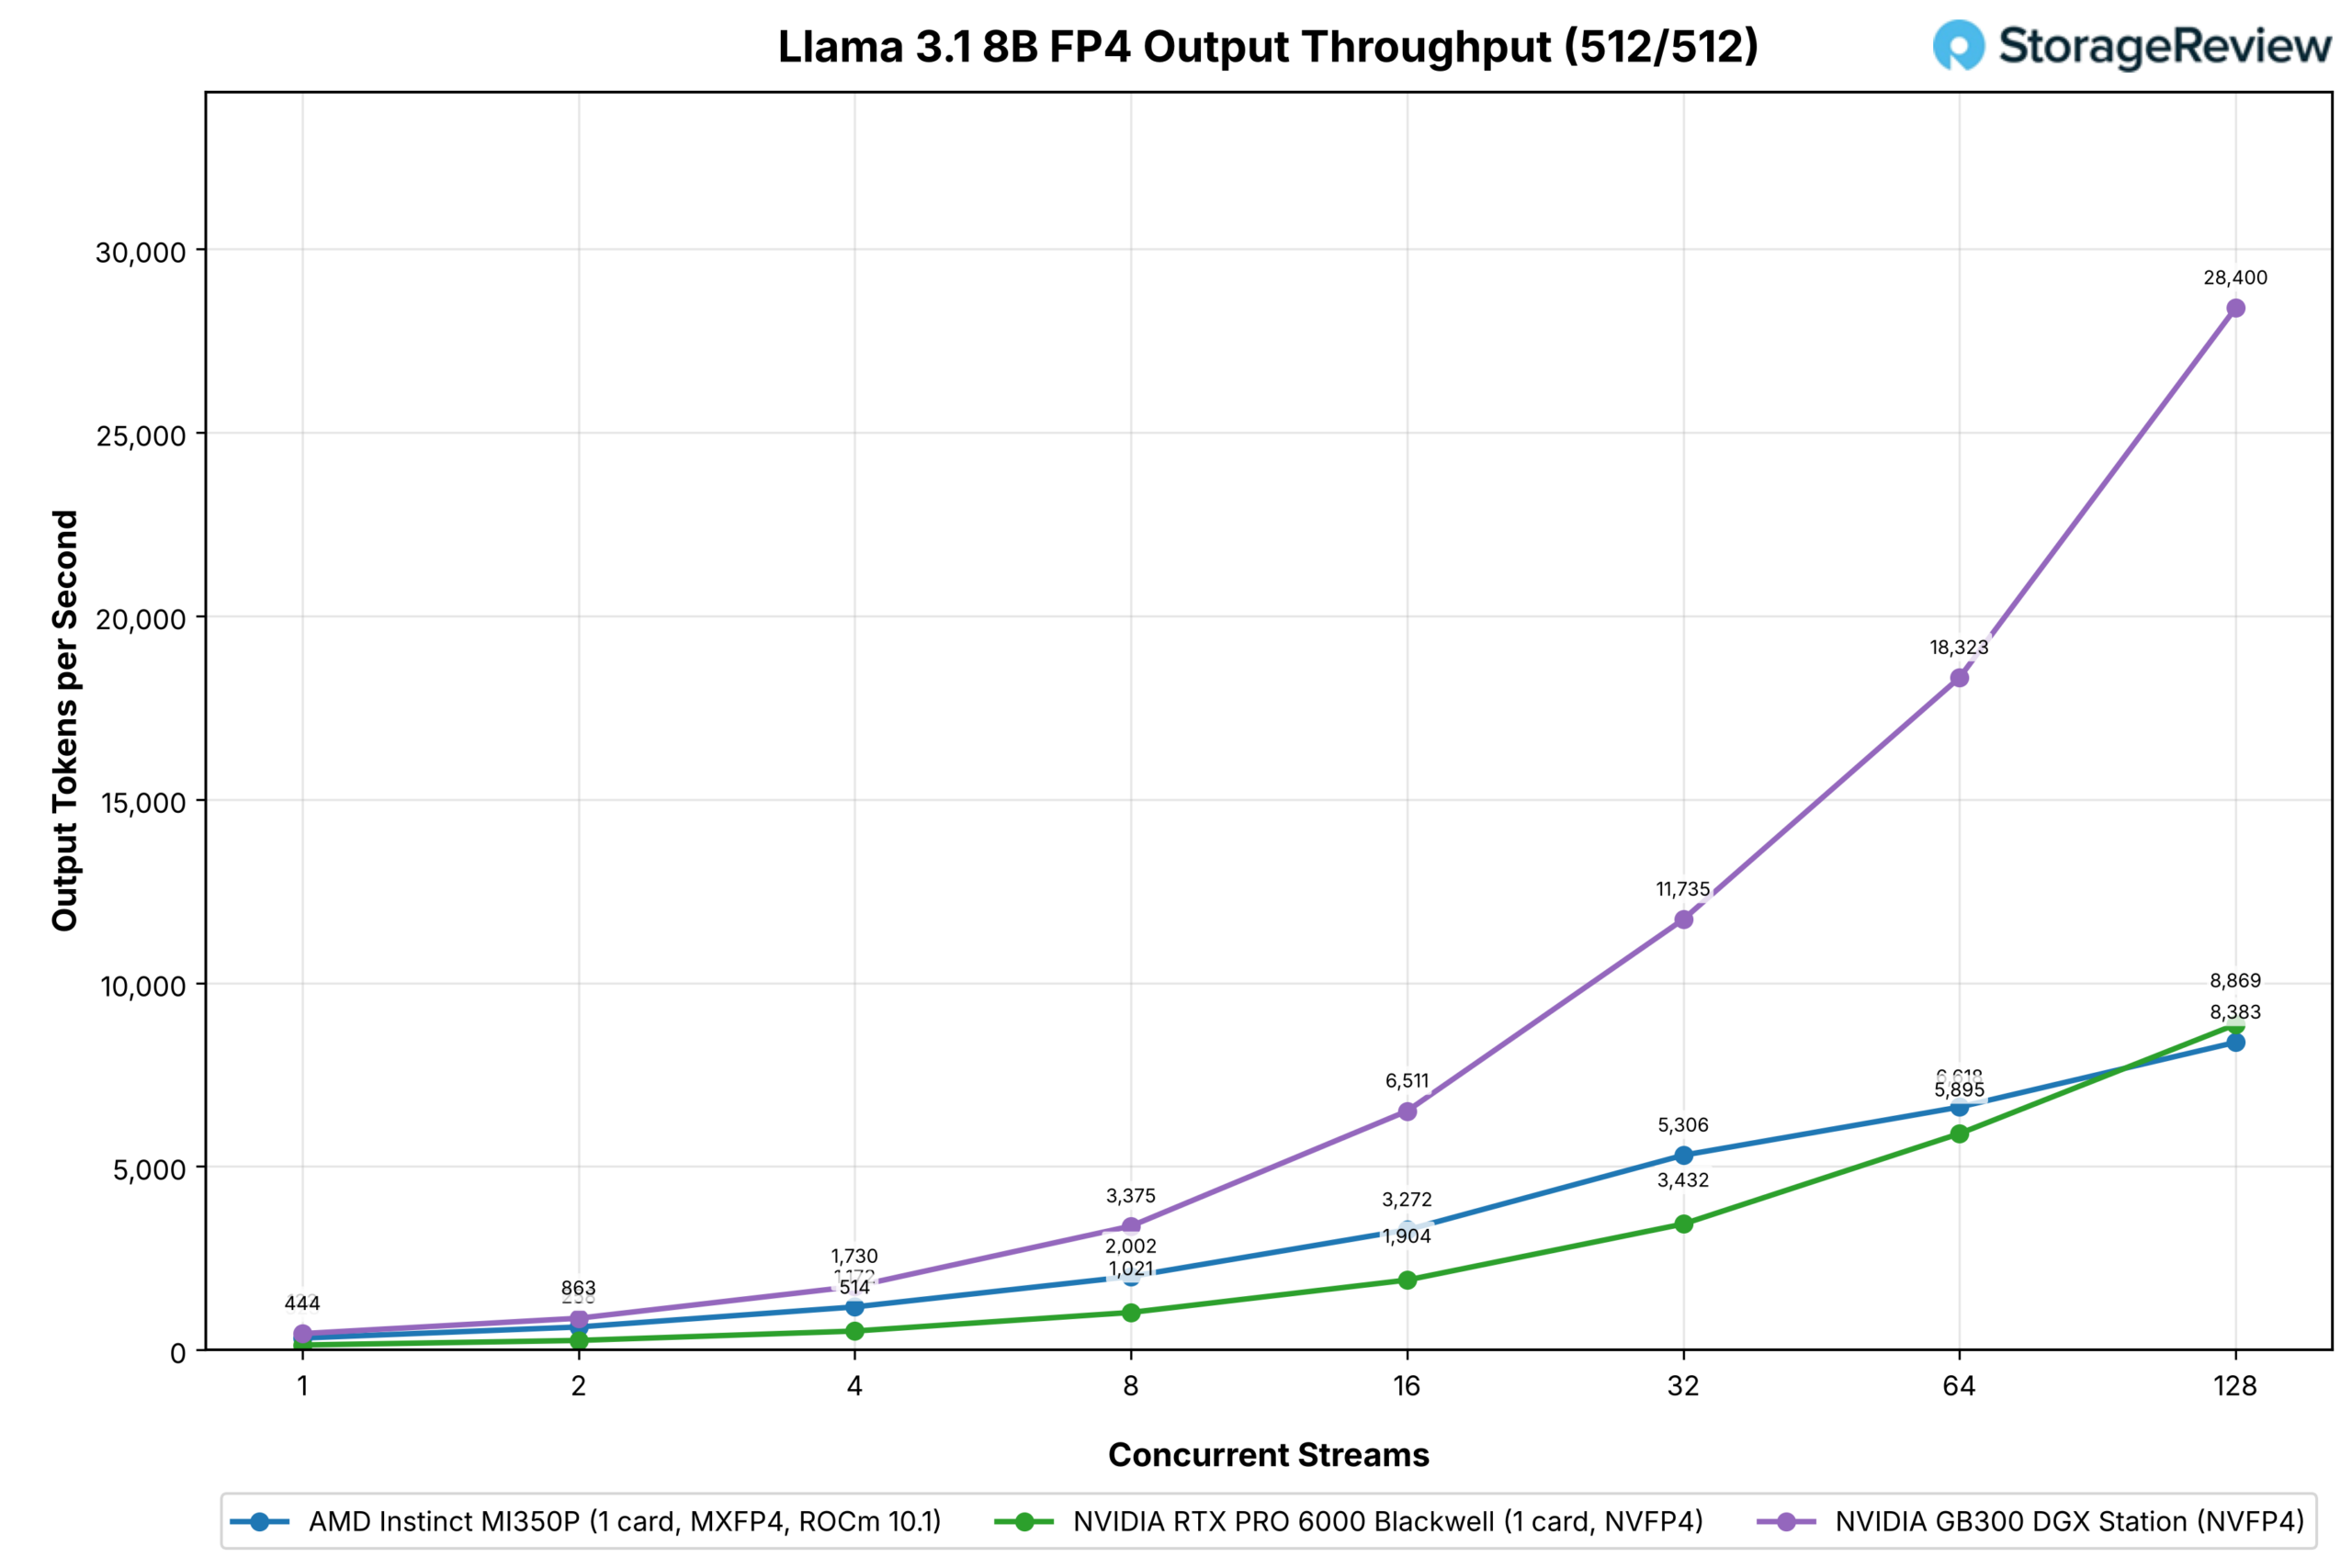
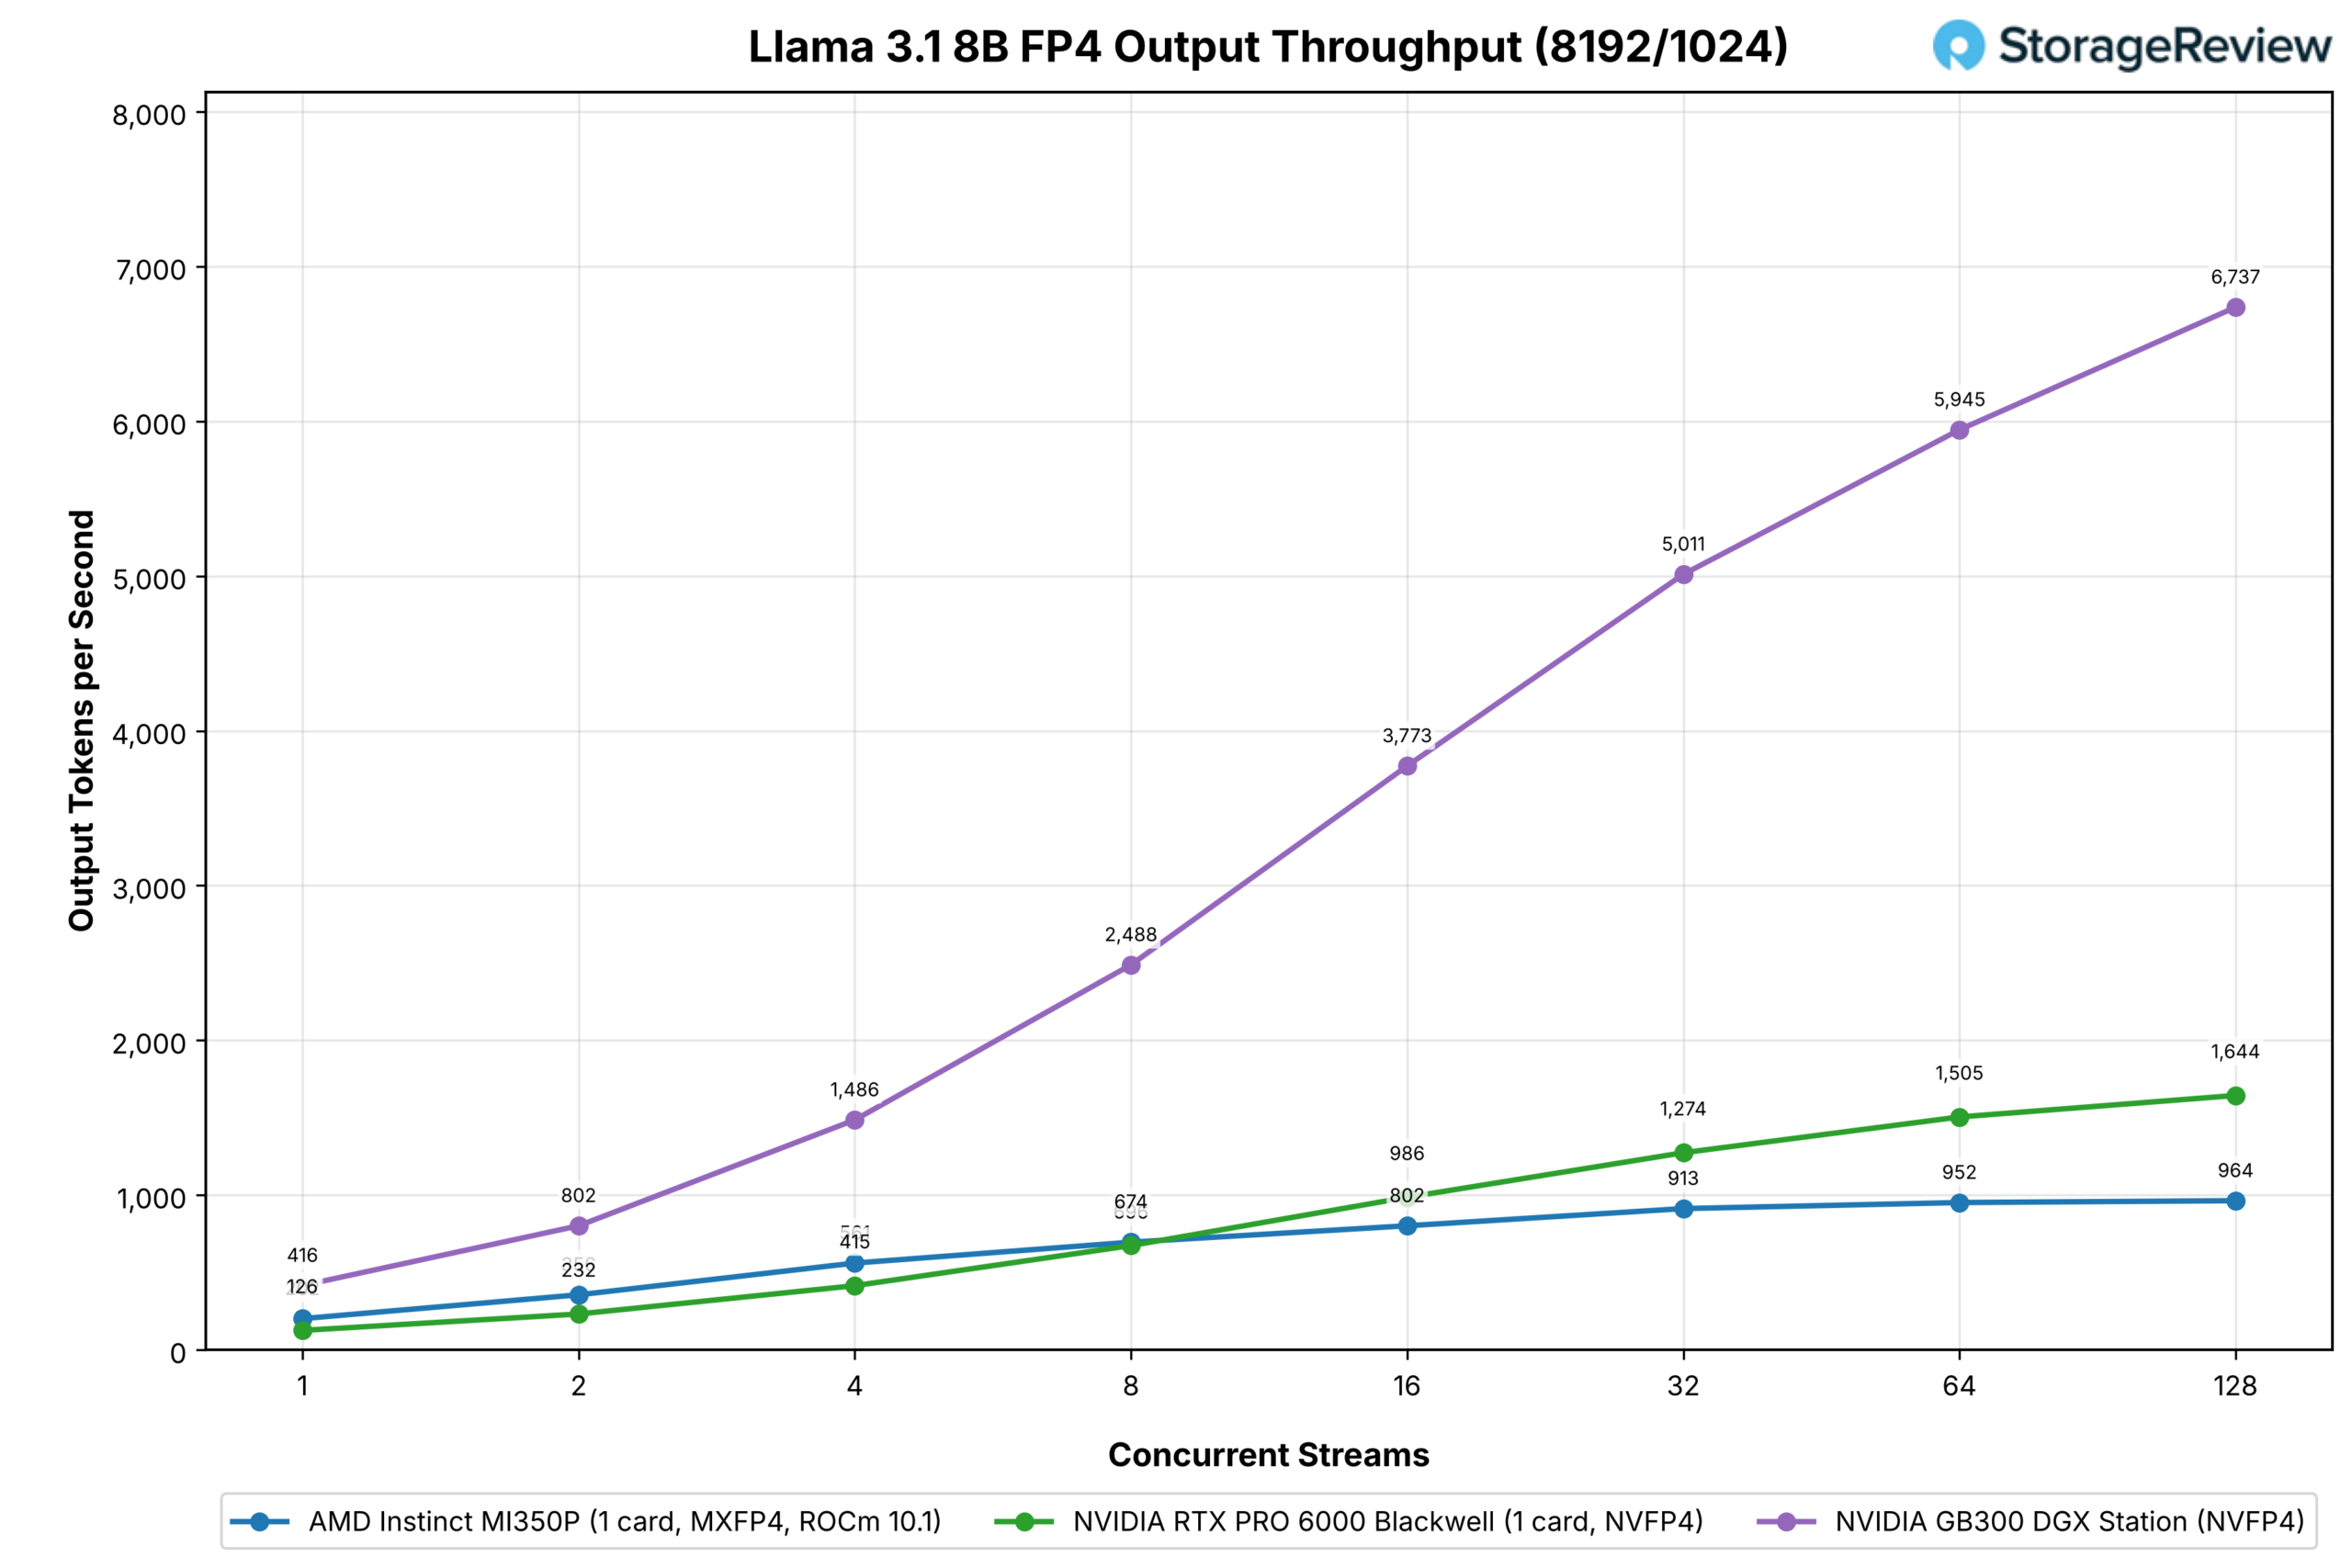
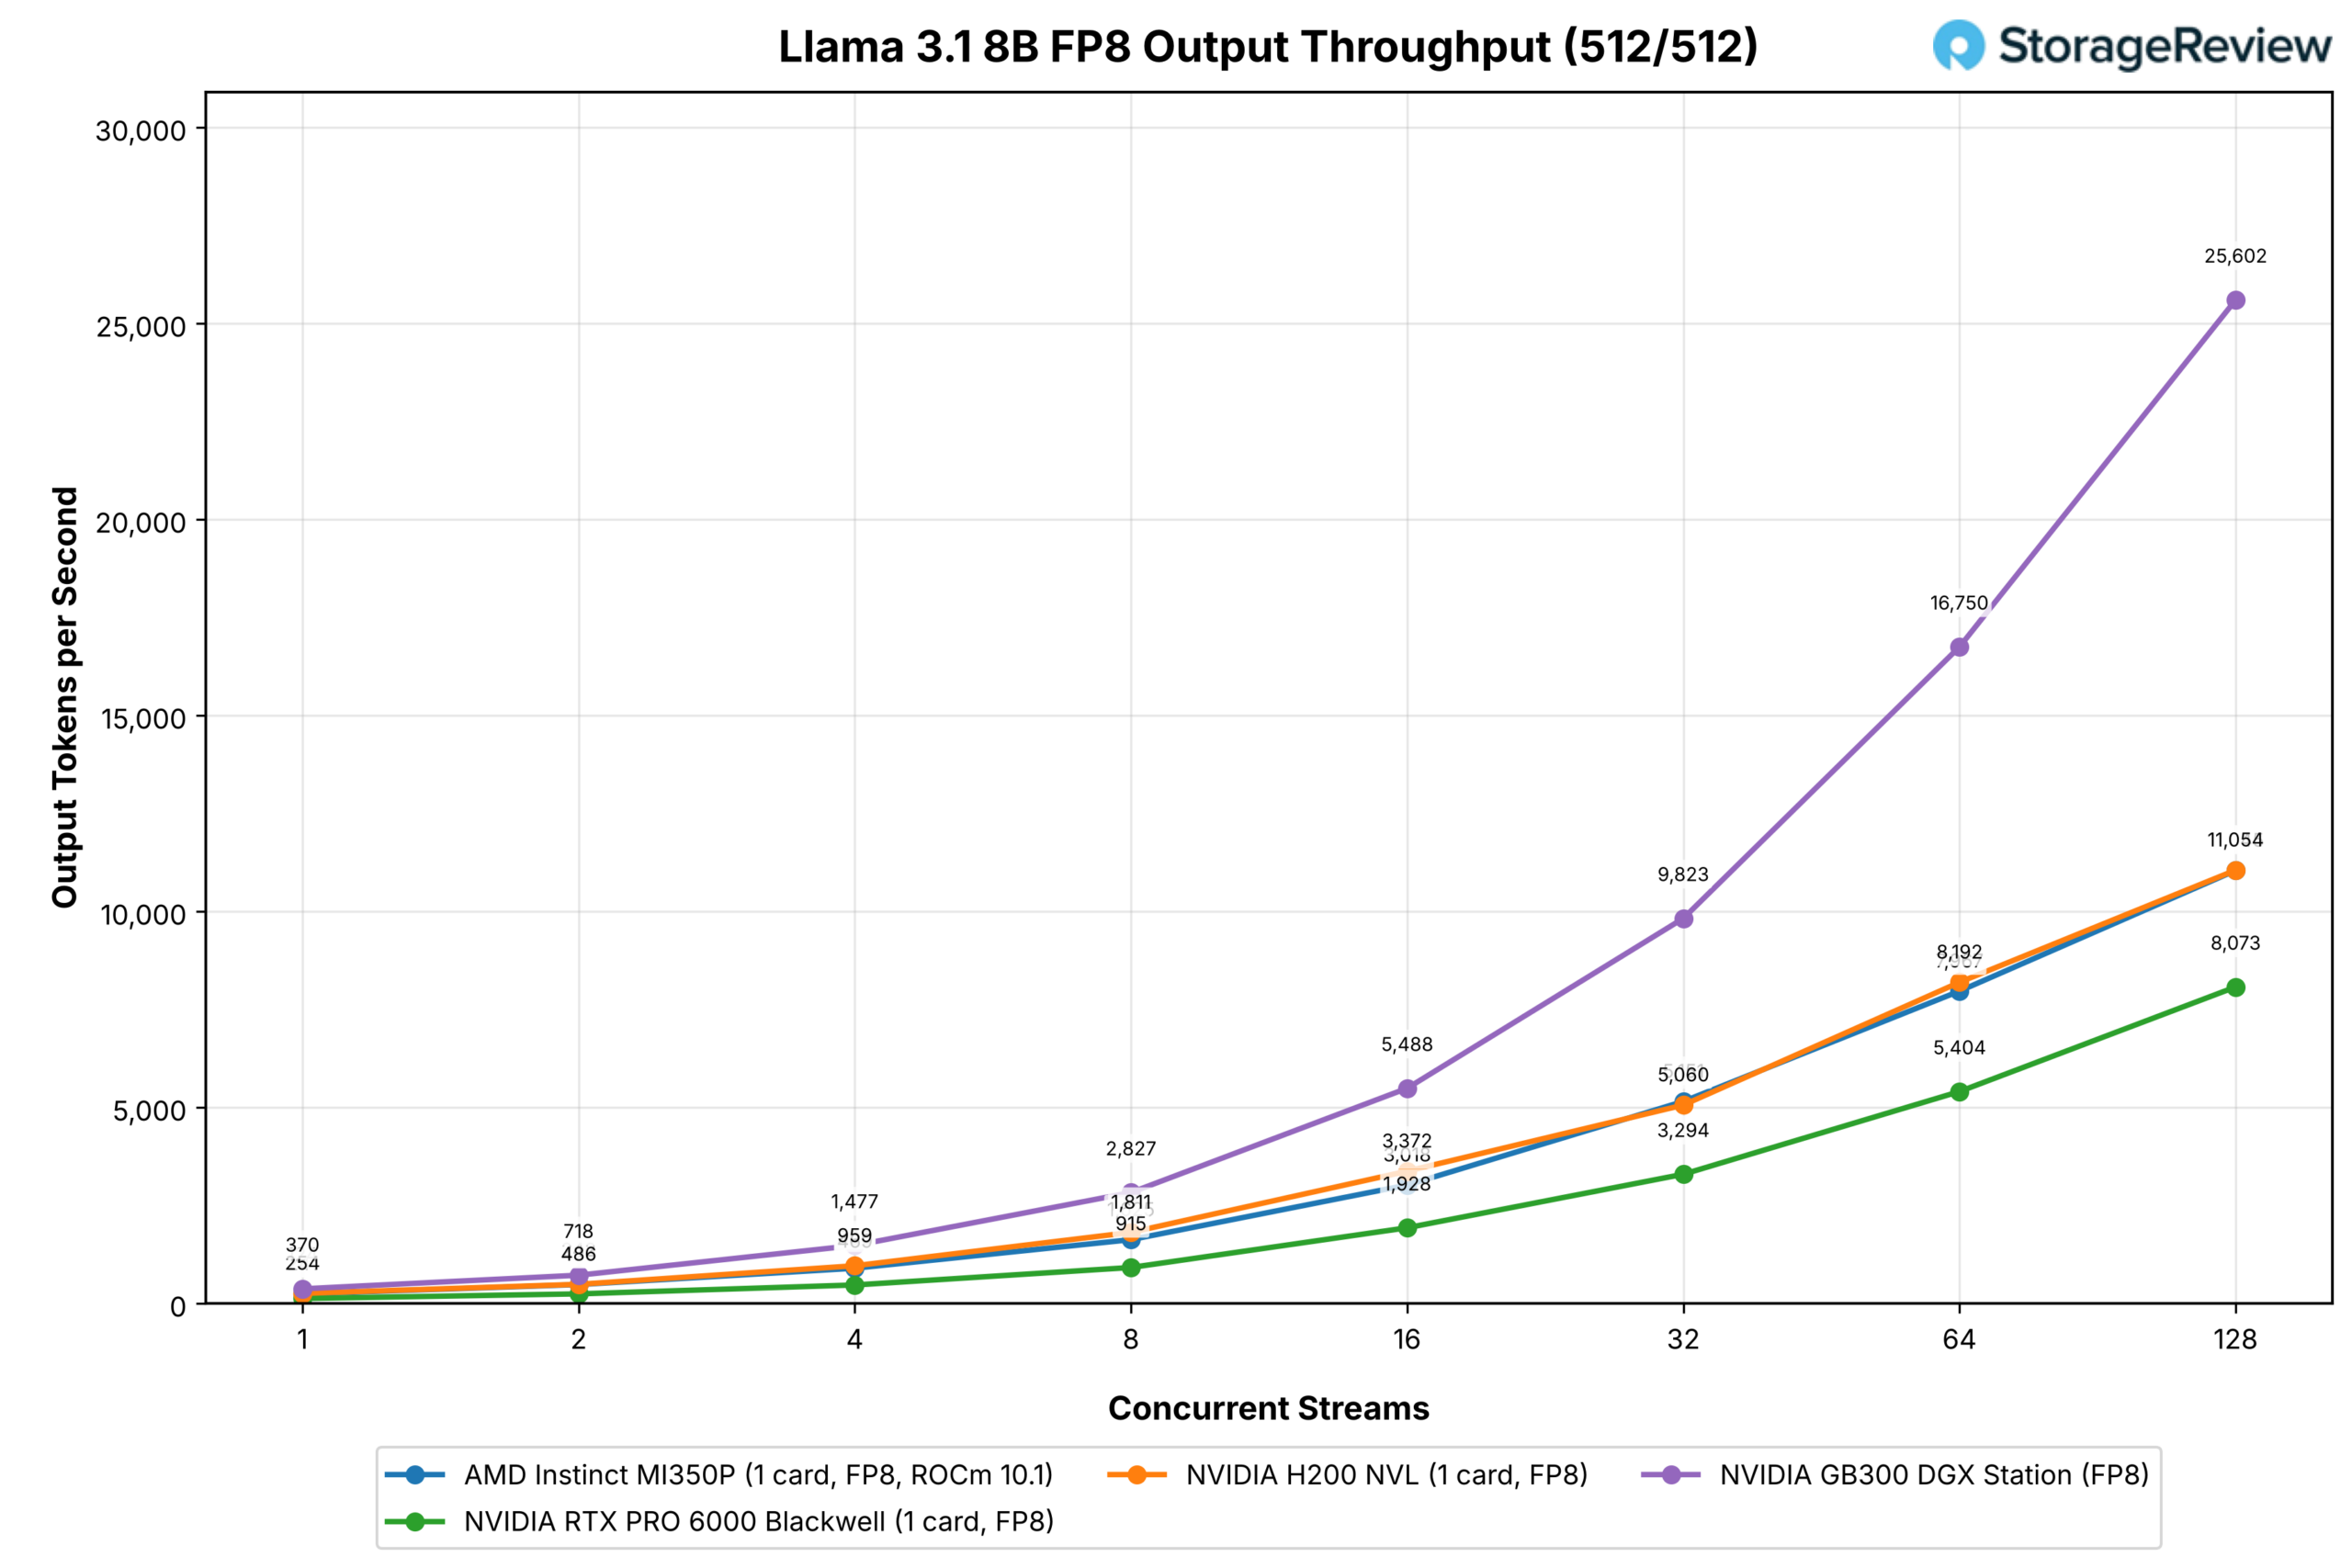
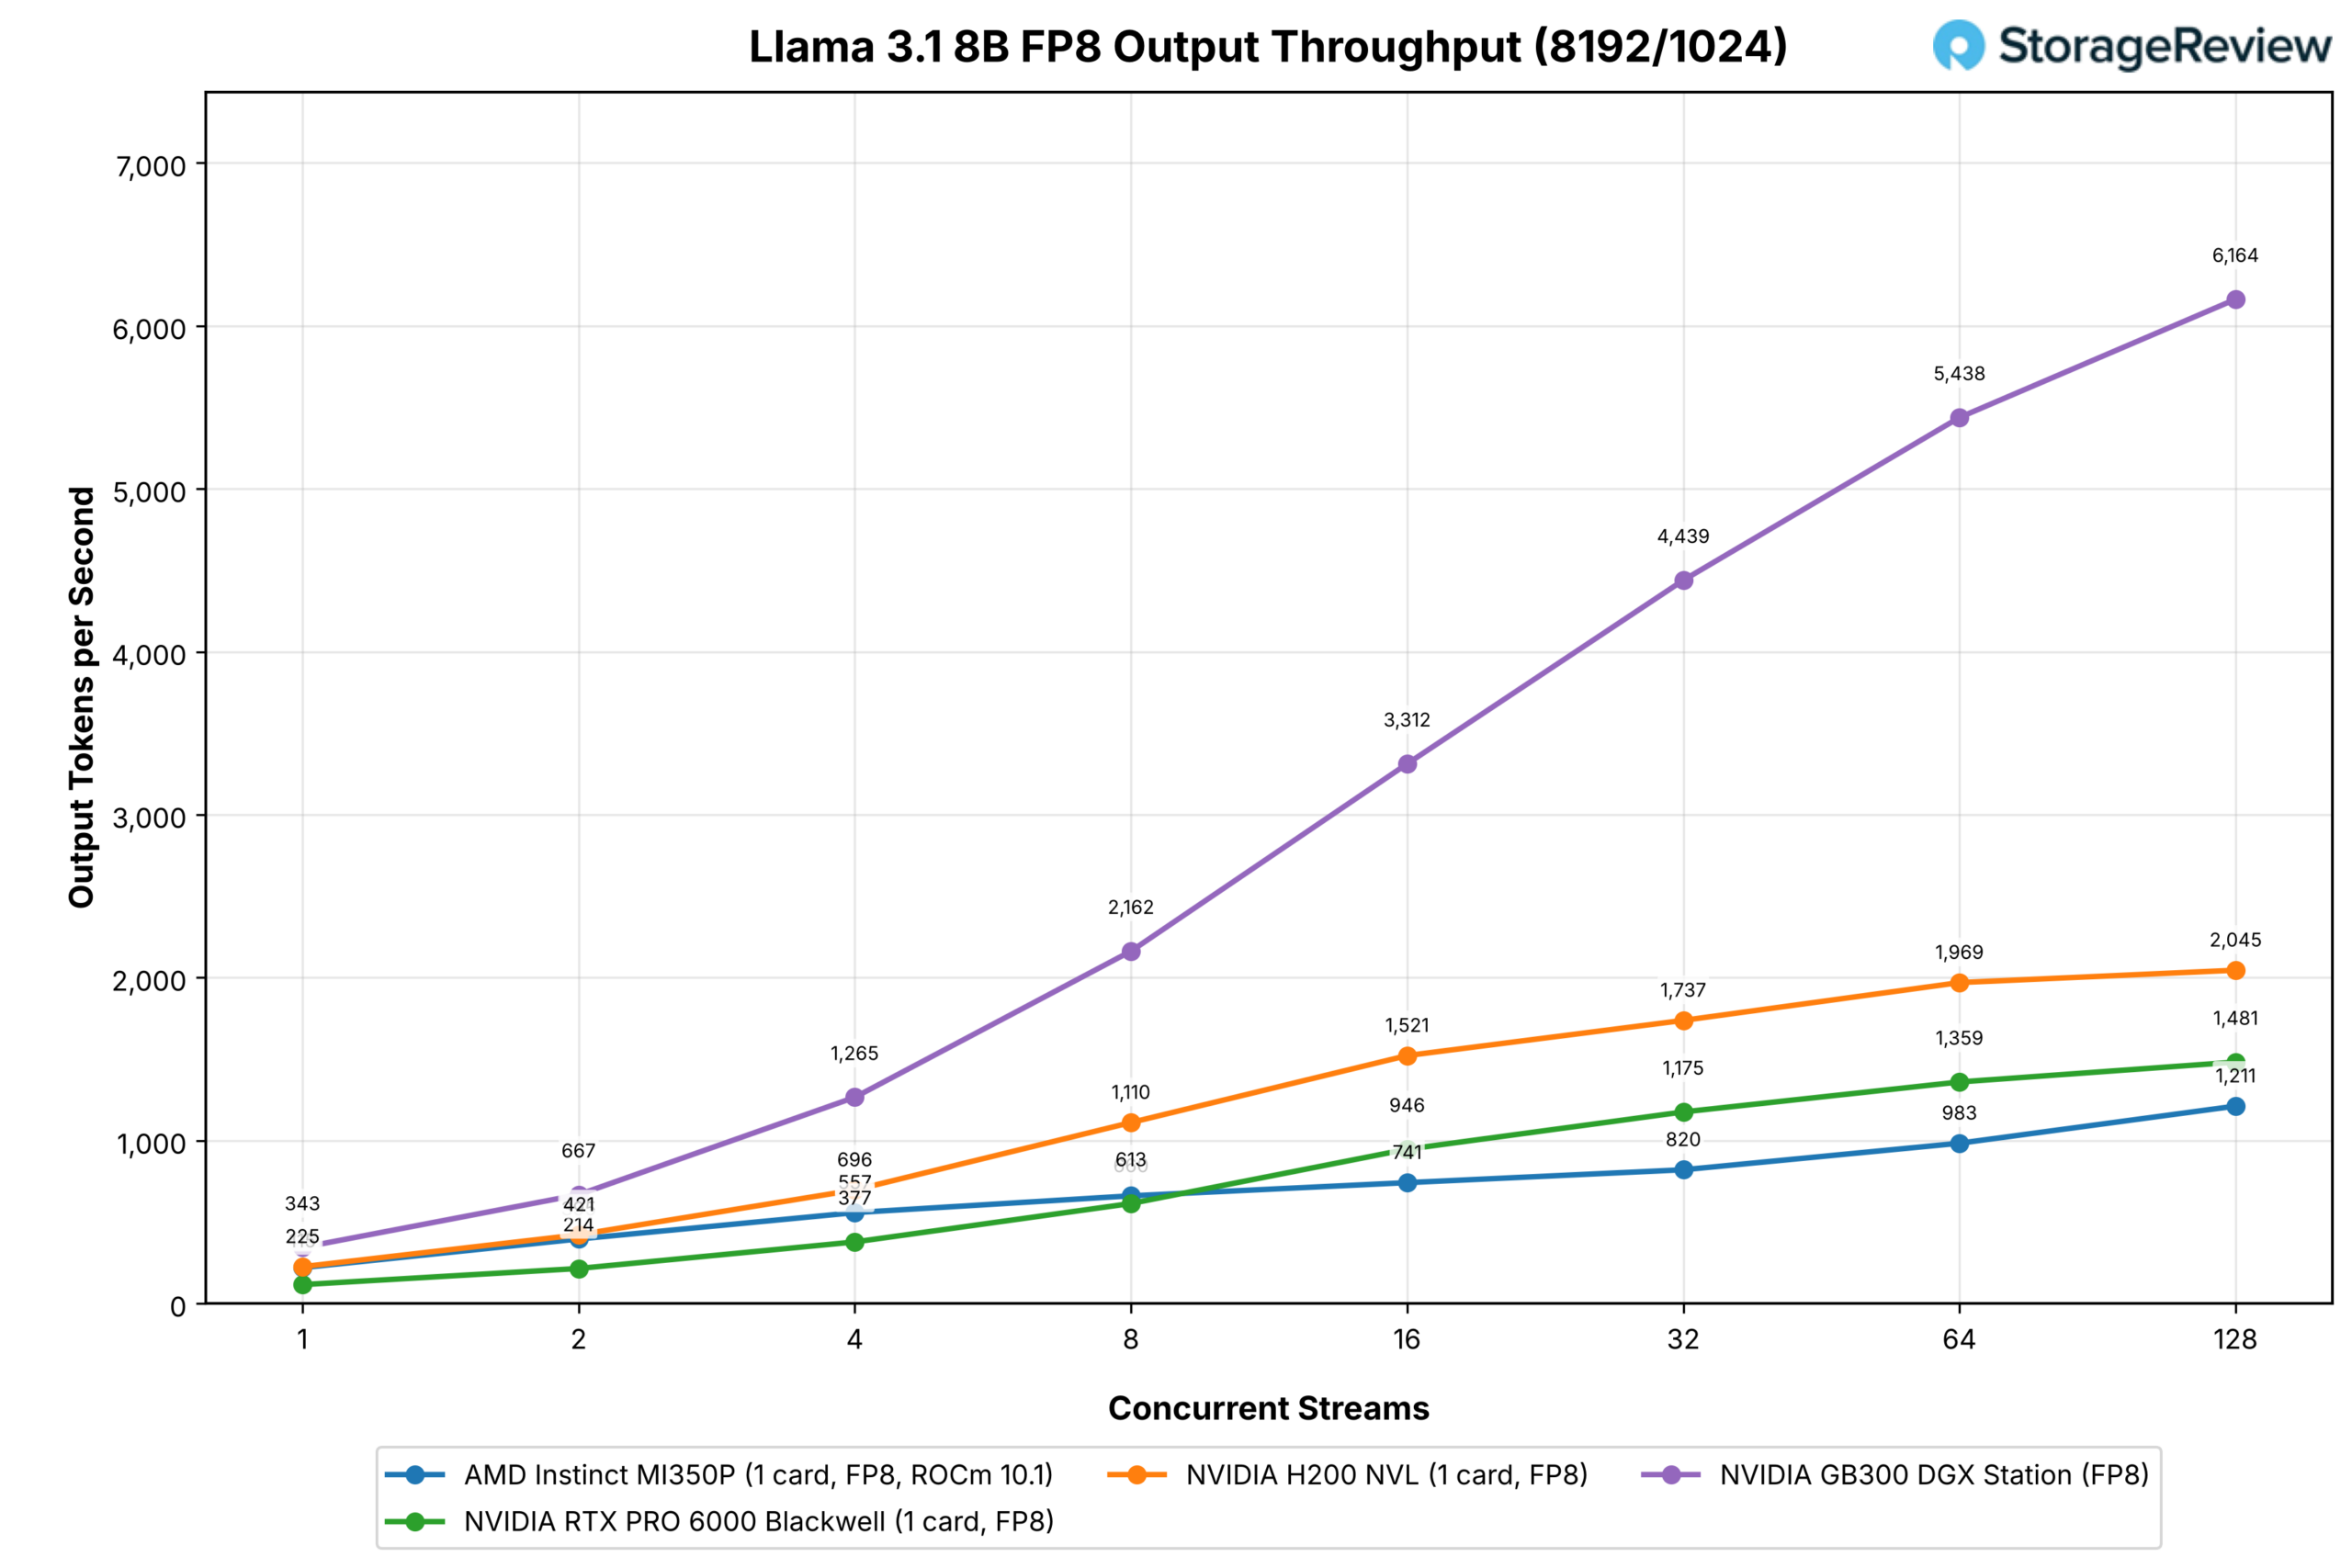
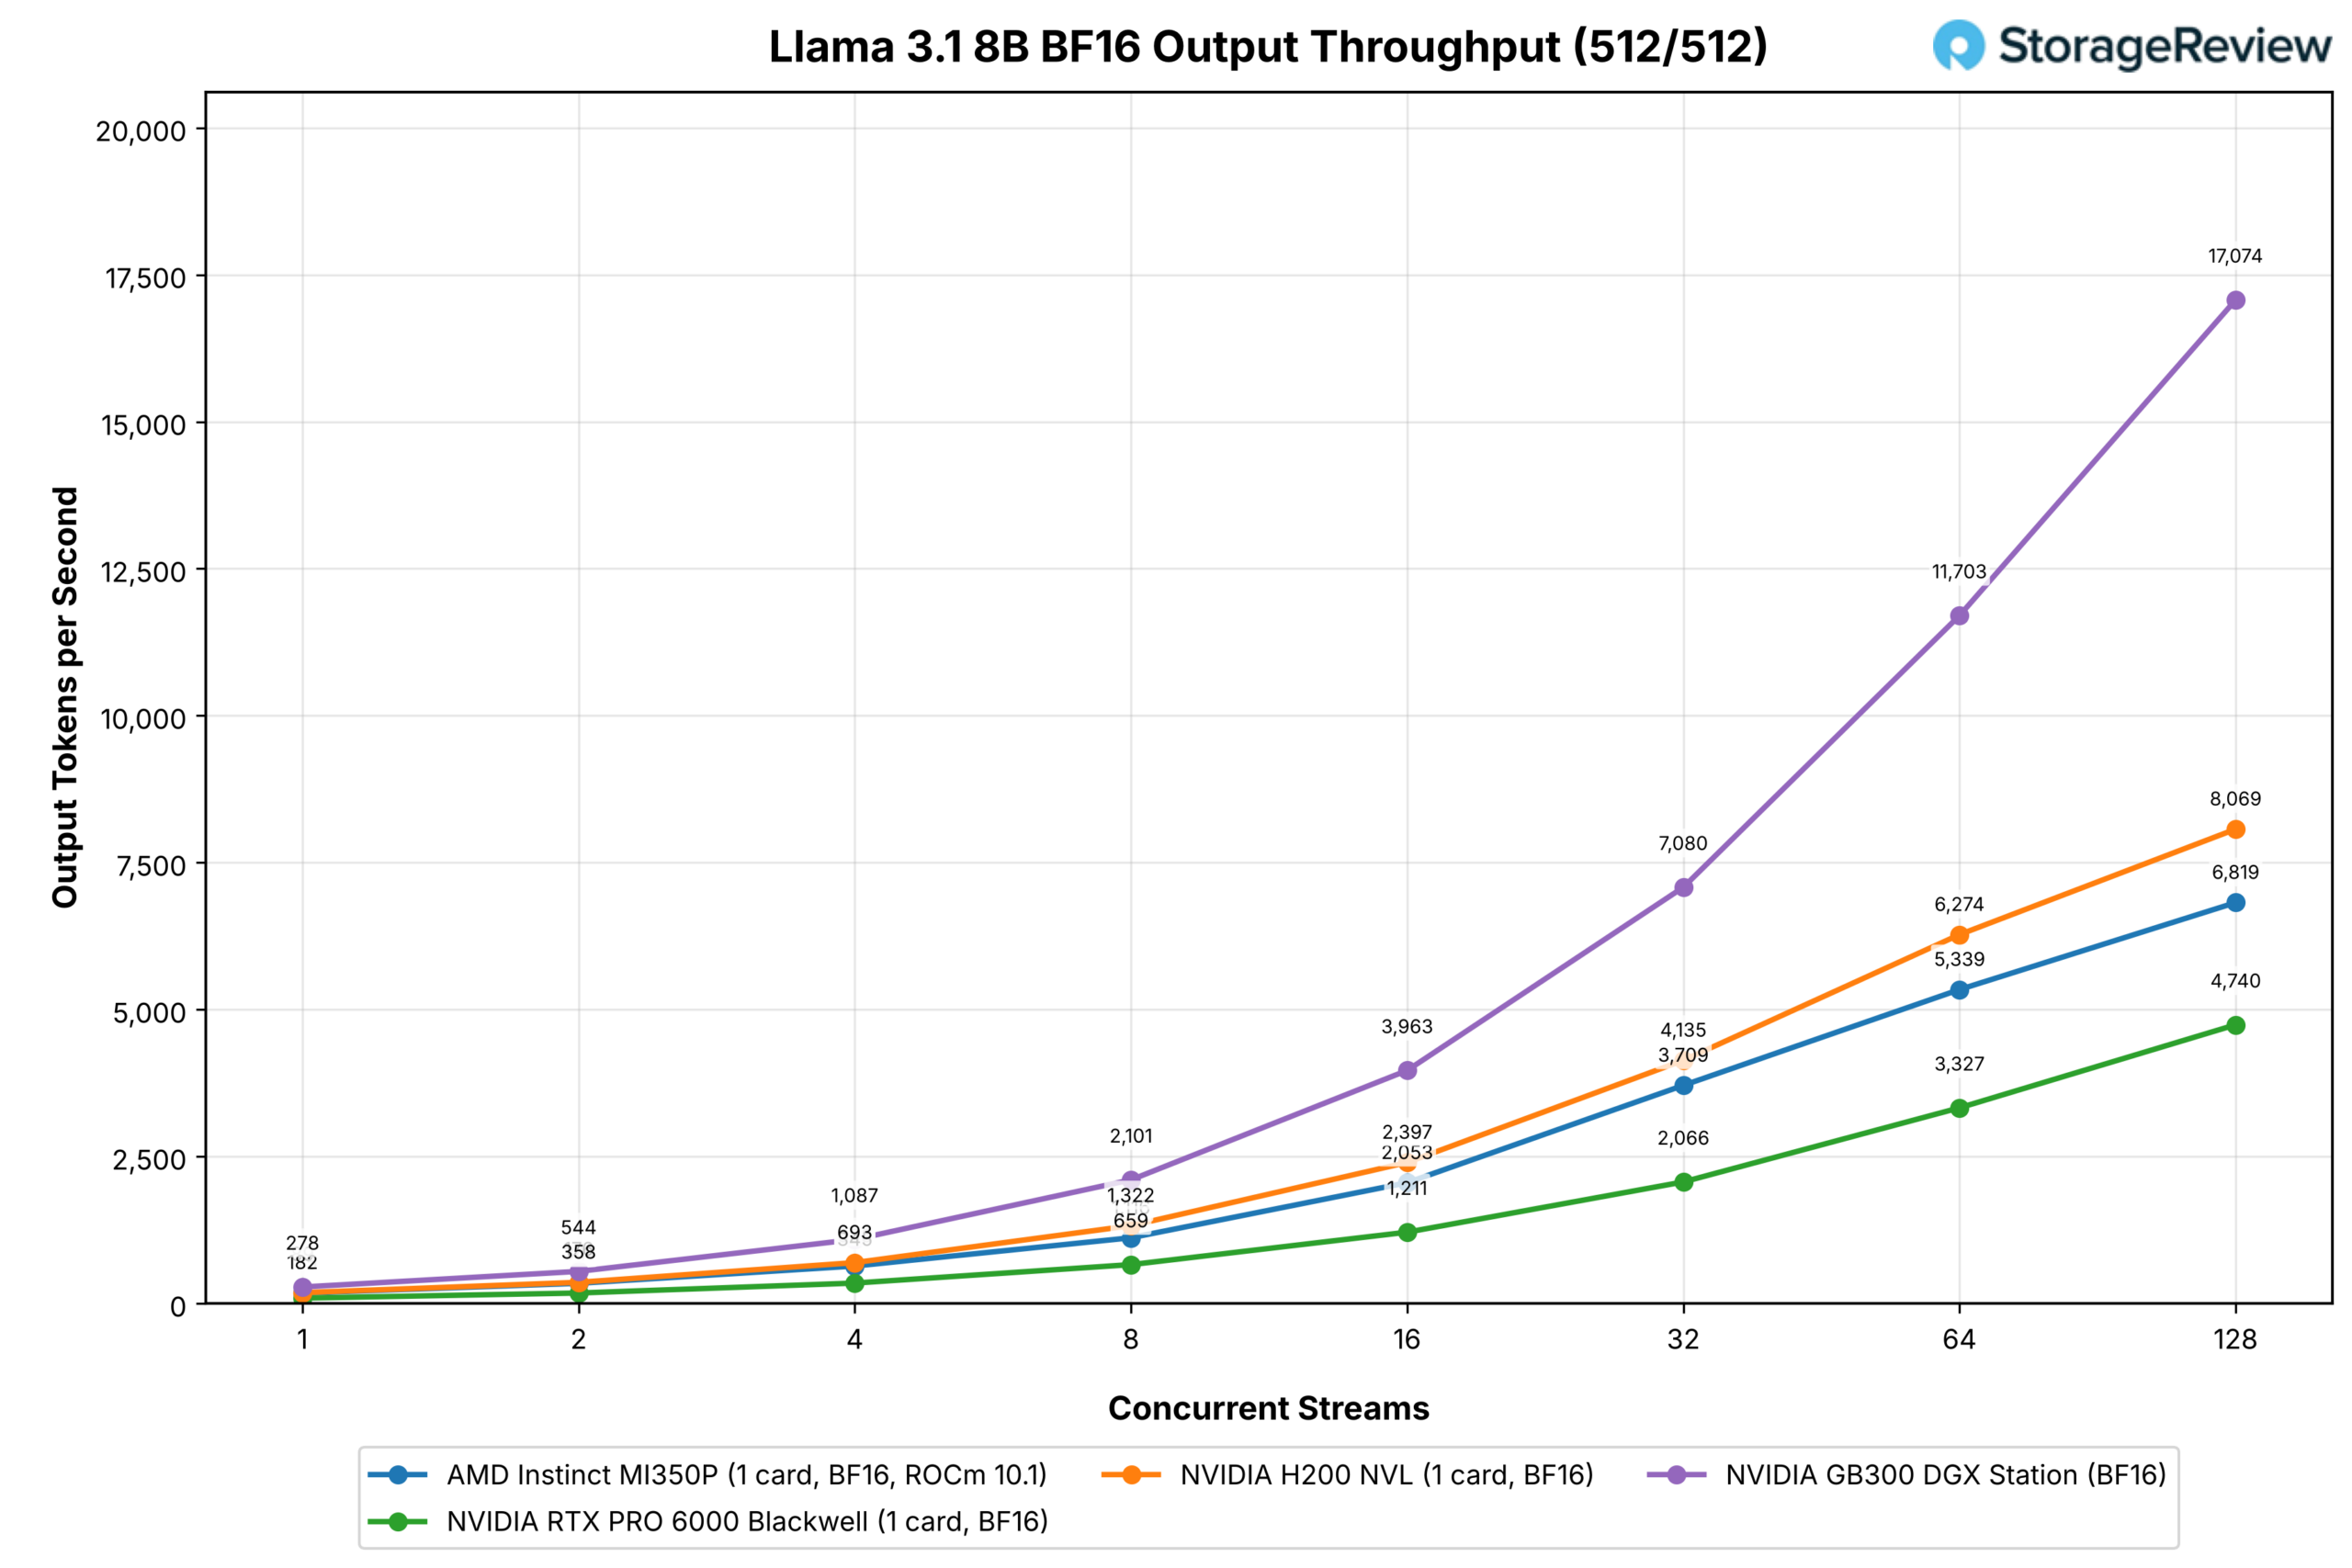
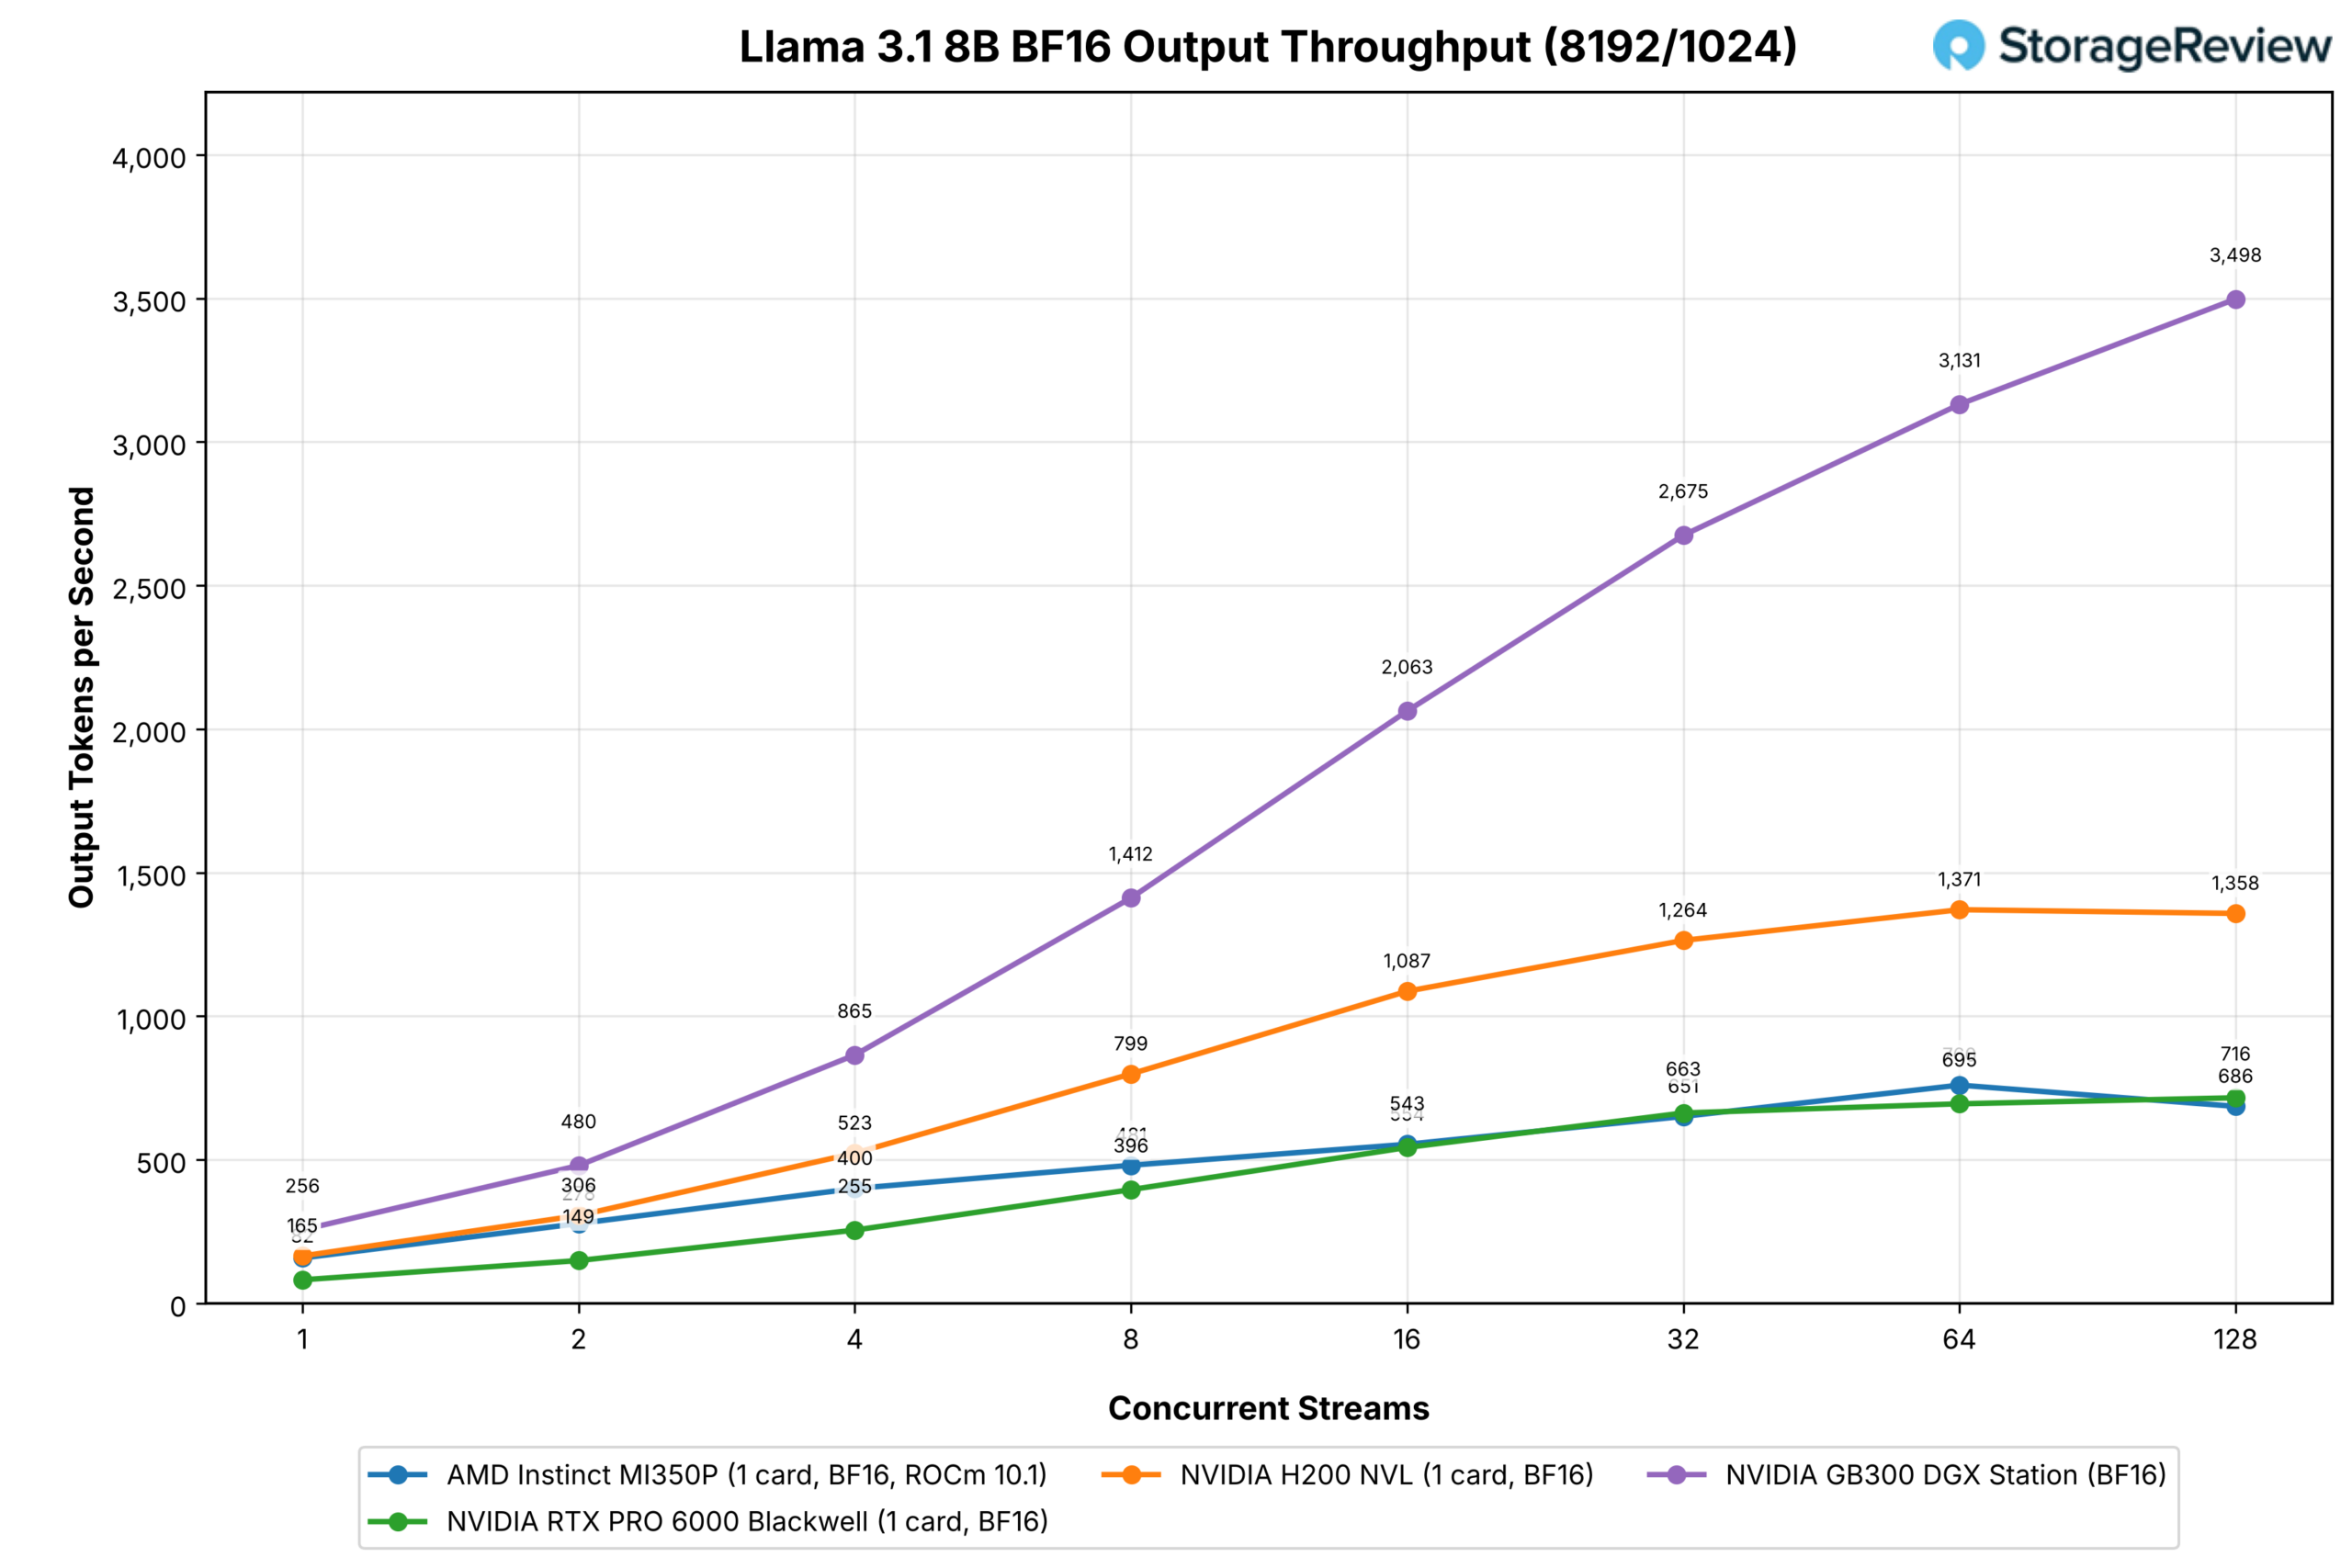
Llama 3.1 8B is hier om de continuïteit van onze eerdere GPU-verslaggeving te waarborgen. Bij 128 streams in de chat-workload levert de MI350P 11,045 outputtokens per seconde op FP8, tegenover 8,073 voor de RTX PRO 6000 en 11,054 voor de H200, een gelijkspel met de Hopper-kaart, en 6,819 op BF16 tegenover 4,740 en 8,069. AMD's MXFP4-build bereikt 8,383 bij 128 streams, 5 procent minder dan NVIDIA's NVFP4-build op de RTX PRO 6000 (8,869), na een voorsprong van 12 tot 143 procent bij elk lager aantal streams; bij één stream leest de MXFP4-run 323 tegen 133.
De tests met veel prefill draaien het resultaat om: de MI350P FP8 presteert 16 streams minder en eindigt op 1,211 streams, tegenover 1,481 voor de RTX PRO 6000 en 2,045 voor de H200, ondanks dat de MI350P bij aanvang 90 procent voorloopt op de RTX PRO 6000 met één stream, en de MXFP4-build 41 procent achterblijft op NVFP4 met 128 streams.
Conclusie
De MI350P is de eerste Instinct-kaart in vier jaar die in een standaard server past, en met een stroomverbruik van 450W in een 2U-behuizing presteert hij uitstekend als PCIe-accelerator: 144 GB HBM3E met 4 TB/s, 1,120 TFLOPS FP8 en 2,228 TFLOPS block-scaled FP4 in MAMF, tegenover 820 en 1,634 voor de RTX PRO 6000 Blackwell, en ongeveer 2.1 keer de bruikbare geheugenbandbreedte van de NVIDIA-kaart.

In vergelijking met de RTX PRO 6000 was de MI350P sneller bij prompts van chatformaat op alle FP8-, BF16- en GPT-OSS-modellen, met een verschil van 35 tot 65 procent bij 128 streams, waar de bandbreedte en capaciteit van HBM3E een 96GB GDDR7-kaart overtrof, en op beide GPT-OSS-modellen bij elk aantal streams en beide promptvormen de beste prestatie leverde.
De H200 NVL presteerde nog steeds beter in de intensieve FP8- en BF16-tests, met 4 tot 18 procent bij 128 streams met chatprompts en nog meer bij langere prompts, met 20 procent meer bandbreedte en zonder FP4-pad; in GPT-OSS eindigde de MI350P 50 en 78 procent voor op de Hopper-kaart. De grotere modellen zijn minder eenduidig, aangezien vier RTX PRO 6000's de MI350P-combinatie voorbijstreven in GLM-5.2 met 16 streams, met 384 GB tegenover 288 GB en meer gecombineerde bandbreedte en rekenkracht.
MiniMax-M3 zit er dichterbij: de drie configuraties blijven binnen 10 procent van elkaar bij acht streams met chatprompts, de RTX quad loopt voor met 16 procent, en het MI350P-paar leidt bij langere prompts met acht streams. Per kaart is de gemeten FP4-rate van de MI350P 36 procent hoger dan die van de RTX PRO 6000, dus het voordeel zit hem in het aantal kaarten. Deze resultaten met twee kaarten zijn gebaseerd op de ROCm 7.2.3-stack en zullen opnieuw worden getest met ROCm 10.1, samen met de 600W-test.
Een definitief oordeel over de MI350P kunnen we nog niet vellen zonder hem op volle kracht te testen bij 600W, wat we van plan zijn te doen in een PowerEdge XE7745; Dell ondersteunt acht MI350P's op 600W in die behuizing. We hebben vernomen dat AMD schat dat de extra 150W een prestatieverbetering van ongeveer 10 procent oplevert.
AMD heeft grote vooruitgang geboekt en de MI350/5X-serie laat zien hoe capabel de architectuur is. We gebruiken een MI300X-systeem in ons lab voor ontwikkeling en de snelheid van de softwarestack bleek uit het feit dat een groot deel van de suite probleemloos draaide op de standaard vLLM-architectuur.
Op basis van wat we in deze configuratie hebben gezien, is de MI350P bedoeld voor kopers die op zoek zijn naar een alternatief voor NVIDIA GPU's, bijvoorbeeld vanwege de levertijden, de prijs of om niet afhankelijk te zijn van één fabrikant. De ondersteuning van de MI350P door Dell in de PowerEdge-lijn zorgt voor voldoende siliciumdiversiteit in mainstream servers die aan deze behoefte voldoen.
Eerlijk gezegd is ons werk hier nog lang niet af. Hoewel veel kopers deze kaarten in 2U-servers zullen plaatsen, valt er meer prestatie te behalen in grotere chassis die ontworpen zijn voor kaarten van 600W. Hoe ze ook worden ingezet, dit is een geweldige eerste kennismaking met AMD's terugkeer naar de servermarkt voor insteekkaarten. Naarmate de software verder wordt ontwikkeld, heeft de MI350P, en wat daarop volgt, een veelbelovende toekomst. Voor kopers met modellen in de categorie 96GB tot 144GB is de MI350P momenteel een van de twee PCIe-kaarten die het systeem op één GPU houden, en de enige met meer dan 141GB.
Klassement: De AMD Instinct MI350P staat ook vermeld onder 'Ook getest' in ons klassement van de beste enterprise GPU's , met de resultaten van de test met twee kaarten onder 'Scale-Out-configuraties'.



 Amazon