

De ASUS ExpertCenter Pro ET900N G3 is het tweede GB300 DGX-station dat we hebben getest en het eerste dat we in ons lab hebben kunnen uitproberen; onze tests met de MSI XpertStation WS300 vonden op afstand plaats. Het maakt gebruik van dezelfde NVIDIA-chip die we in de MSI XpertStation WS300 hebben getest: een Grace Blackwell Ultra Desktop Superchip met 72 Grace-cores, een B300 GPU, 252 GB HBM3e, 496 GB LPDDR5X en een ConnectX-8 SuperNIC met twee 400GbE-poorten. ASUS heeft dit vaste kernplatform verpakt in een compacte towerbehuizing, speciaal ontworpen voor AI-toepassingen op het bureau, met een paar extra's die niet op de WS300 te vinden zijn: twee handgrepen aan de bovenkant, een speciale ventilator gericht op de ConnectX-8 optische modules en een 1,600W voeding met 80 PLUS Titanium-certificering.
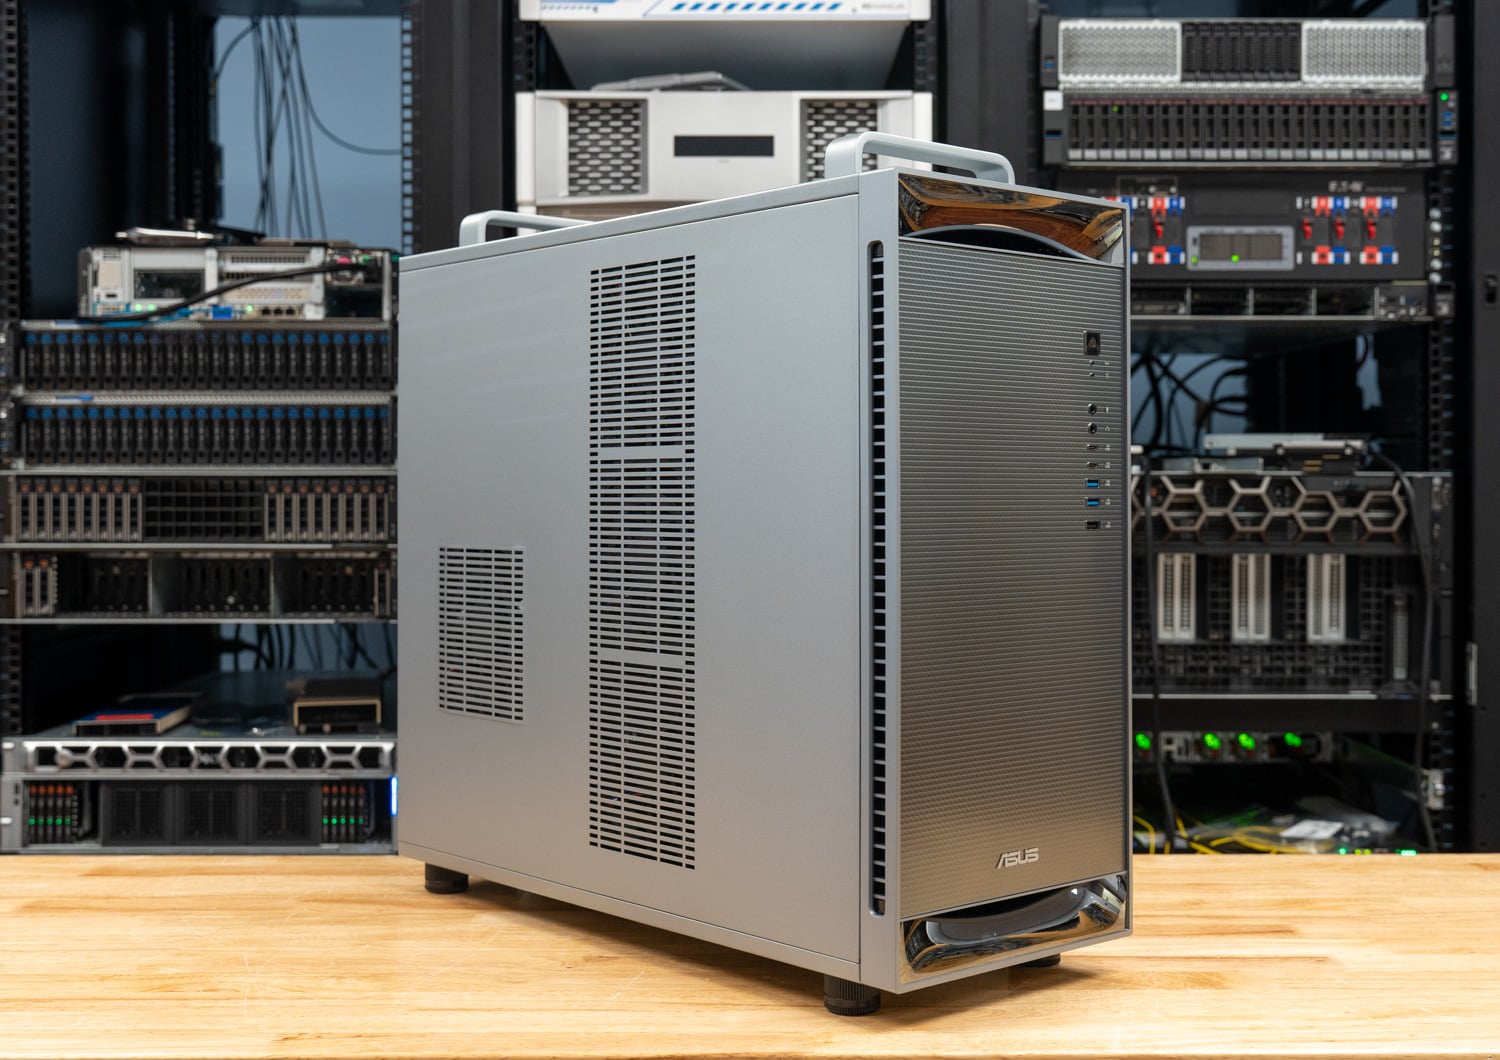
ASUS stuurde de ET900N G3 naar ons lab voor een testweek vol benchmarks, foto's en fysieke controles, met een RTX PRO 2000 geïnstalleerd. De review van de WS300 behandelt het platform zelf, de B300, Grace, NVLink-C2C, MIG en de functie van een DGX Station. Deze review gaat over wat ASUS rondom de Superchip heeft gebouwd en of de prestaties vergelijkbaar zijn met die van de eerste GB300-tower die we hebben getest.
Specificaties van de ASUS ExpertCenter Pro ET900N G3
| Specificaties | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Platformoverzicht | |
| Superchip | NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip |
| CPU | NVIDIA Grace, 72 Arm Neoverse V2-kernen |
| GPU | NVIDIA Blackwell Ultra (B300), tot 20 PFLOPS NVFP4 met sparse compressie |
| CPU-GPU-interconnect | NVLink-C2C, 900 GB/s bidirectioneel |
| Geheugen | |
| Coherente herinnering | 748GB |
| GPU-geheugen | 252 GB HBM3e, 7.1 TB/s |
| CPU-geheugen | 496 GB LPDDR5X, 396 GB/s, 4x SOCAMM |
| Opslag | |
| Opstartschijven | 2x M.2 2280 PCIe 5.0 x4 (Key M), gevuld met 2x 2TB NVMe in RAID 1 |
| Uitbreidingsschijven | 2x M.2 2280 (Key M), PCIe 6.0 x4 volgens ASUS, fabrieksmatig geopend |
| Netwerken | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Uitbreiding | |
| PCIe slots | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (x8 signalen) |
| Insteek-GPU | Maximaal één NVIDIA RTX PRO Blackwell-kaart; het testexemplaar werd geleverd met een RTX PRO 2000 Blackwell. |
| I / O | |
| Voorwiel | 2x USB 10Gbps Type-C 2x USB 10Gbps Type-A 1x USB 2.0 Hoofdtelefoon- en microfoonaansluitingen |
| Achterwiel | 4x USB 10Gbps Type-A 1x Micro-USB COM (BMC seriële console) 1x Mini DisplayPort (BMC) 3 audio-aansluitingen |
| Beheer en beveiliging | |
| BMC | ASPEED AST2600 met AMI MegaRAC-firmware, IPMI en Redfish |
| Security | Aan boord TPM 2.0 |
| Stroom en koeling | |
| Laboratoriumvoedingen | 1x 1,600W ATX, 80 PLUS Titanium |
| Koelen | Gesloten AIO-vloeistofkoeling (volgens ASUS) met koelplaten op de GB300, SOCAMM en ConnectX-8; radiatoren aan de voor- en bovenkant, chassisventilator aan de achterkant, aparte ventilator boven de QSFP112-modules. |
| Bedrijfstemperatuur | 10C naar 35C |
| Software en vormfactor | |
| Besturingssysteem | Ubuntu met NVIDIA AI-ontwikkeltools; ASUS zegt dat ondersteuning voor AI-ontwikkeling op basis van Windows gepland staat. |
| Afmetingen | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 inch), zoals vermeld door ASUS |
| Gewicht | 27 kg netto, 32 kg bruto |
Ontwerp en bouw
ASUS presenteert de ET900N G3 als een zakelijk werkstation, met een geborsteld zilveren chassis, een donker mesh-front, een verchroomde boven- en onderkant en een ASUS-logo onderaan de voorkant. De afmetingen zijn zoals het platform voorschrijft: 584 x 232 x 565 mm volgens de specificaties van ASUS, wat iets hoger en smaller is dan de WS300 met 529 mm hoog, 570 mm diep en 246 mm breed. Met 27 kg is het geen systeem dat je zomaar even verplaatst, en dat is waar de eerste ASUS-specifieke oplossing om de hoek komt kijken. Twee metalen handgrepen aan de bovenkant, één aan de voorkant en één aan de achterkant, stellen twee personen in staat om de tower op een bureau of in een trolley te tillen zonder de panelen vast te pakken. Ze lijken misschien wat vreemd op een kantoorcomputer, totdat je ooit een GB300-tower door een laboratorium hebt moeten dragen.
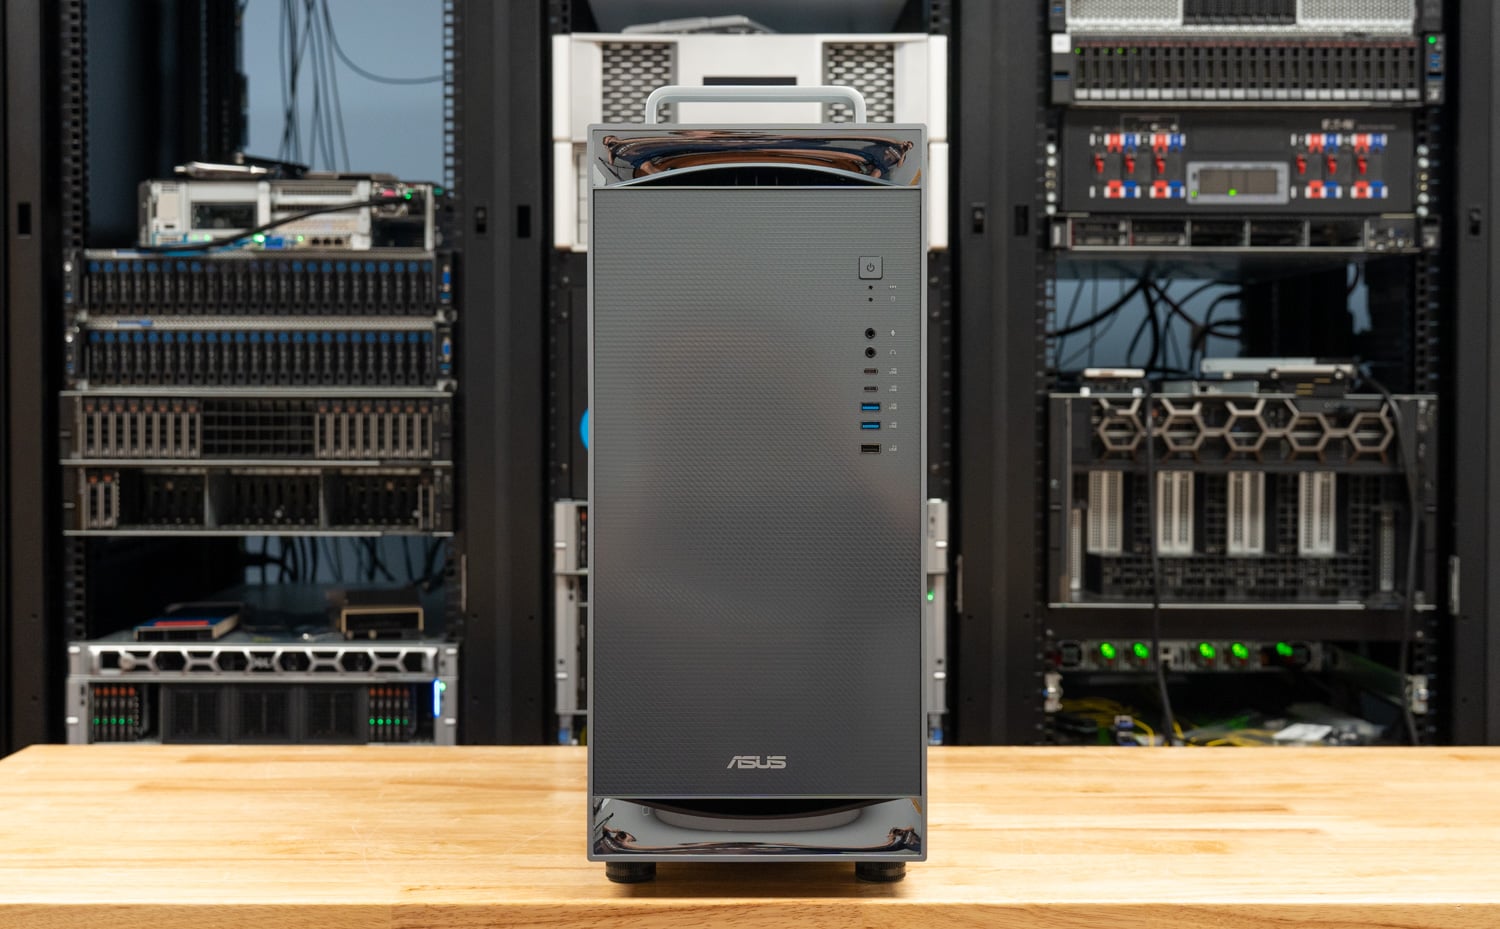
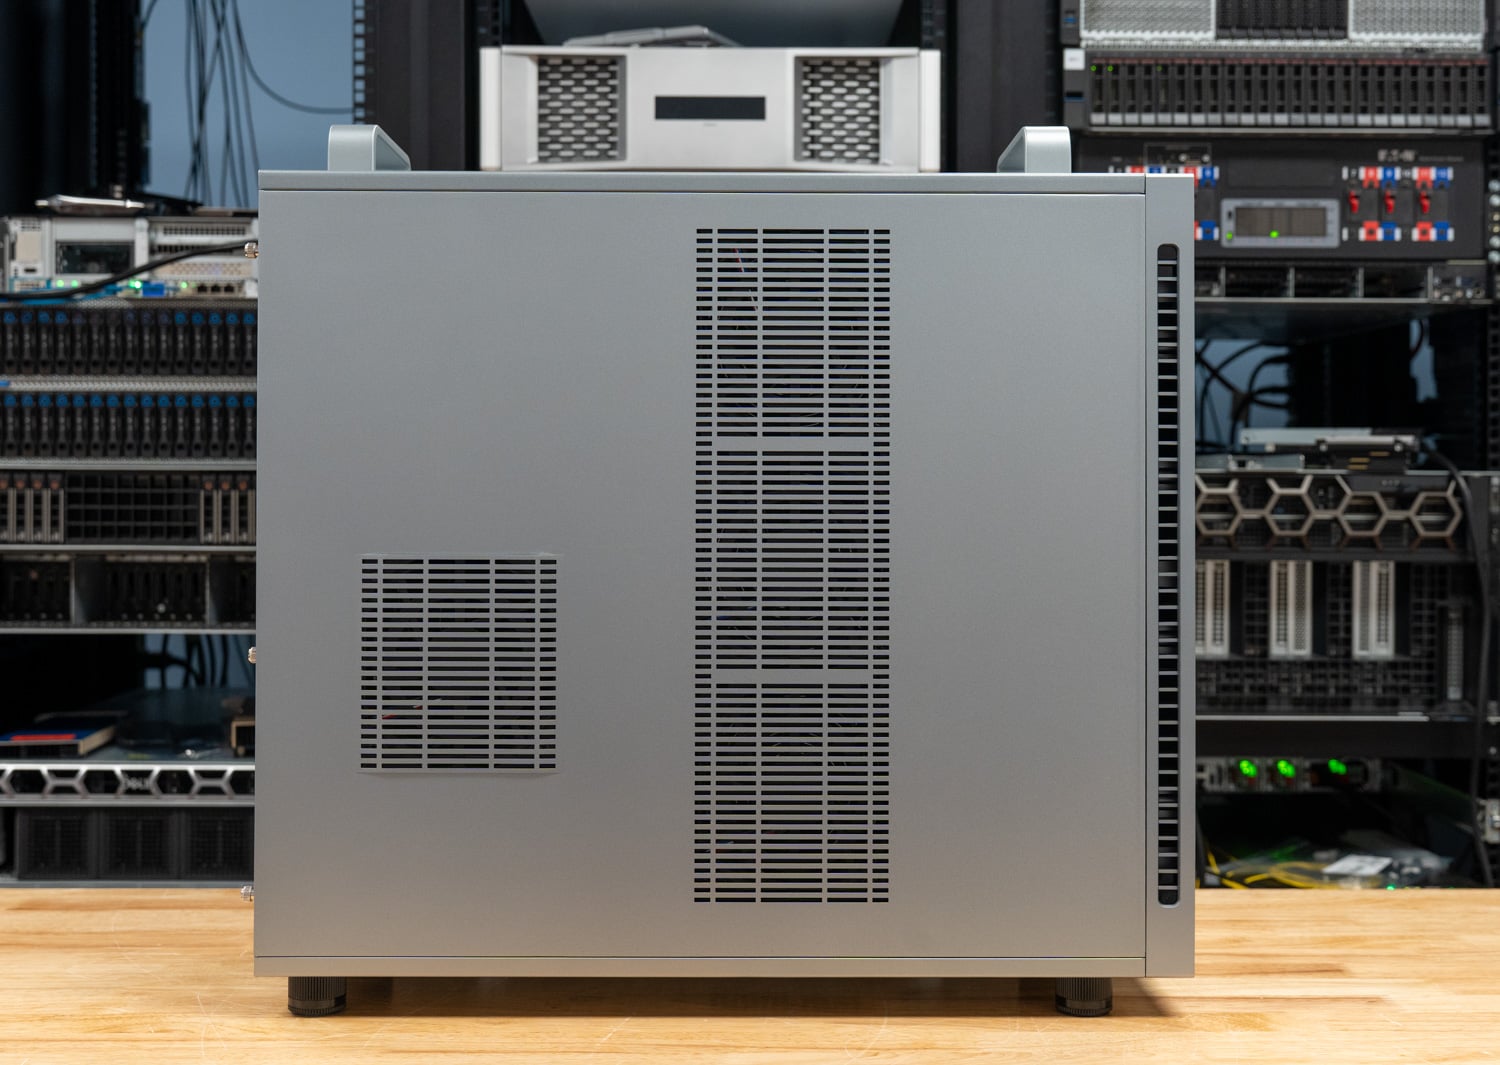
Het voorpaneel is voorzien van de aan/uit-knop, twee 10 Gbps USB Type-A-poorten, twee 10 Gbps USB Type-C-poorten, een USB 2.0-poort en aparte aansluitingen voor hoofdtelefoon en microfoon, allemaal verticaal gerangschikt rechtsboven in het gaas. Het zijpaneel is een grote geventileerde plaat, met een lange geperforeerde kolom aan de voorkant voor de luchtinlaat van de radiator en een kleiner vierkant rooster aan de achterkant dat aansluit op de systeemventilatoren. Er is geen venster en geen verlichting, wat aansluit bij de doelgroep.
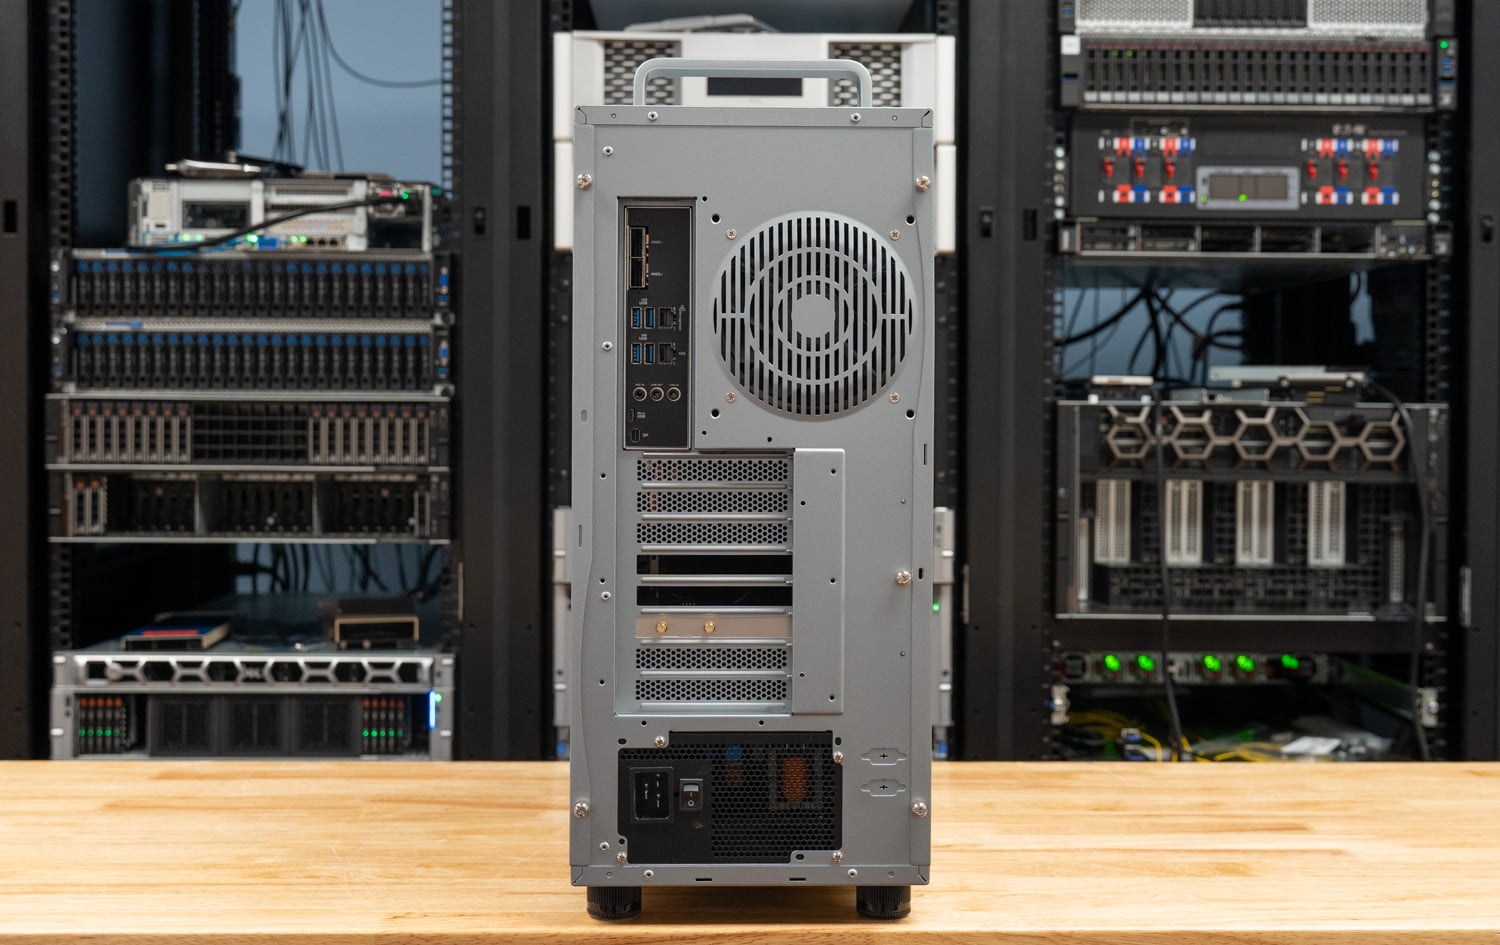
Aan de achterkant scheidt de lay-out de I/O-poorten van het werkstation van de serverhardware eronder. De bovenste cluster bevat de vier 10 Gbps USB Type-A-poorten, de 10 GbE- en 1 GbE RJ45-aansluitingen, de drie audio-aansluitingen, de Micro-USB-consolepoort van de BMC en de Mini DisplayPort die door de BMC wordt aangestuurd voor de configuratie. De twee QSFP112-behuizingen voor de ConnectX-8 bevinden zich bovenaan het I/O-paneel; ernaast zit een ventilator; de drie afdekkingen voor de uitbreidingsslots lopen in het midden; en de voeding met de C19-ingang bevindt zich onderaan. Net als bij de WS300 is de Mini DisplayPort een BMC-uitgang voor de eerste configuratie en het oplossen van problemen; wie een desktop op deze machine wil, heeft de RTX PRO-videokaart nodig.
Binnenin de ET900N G3
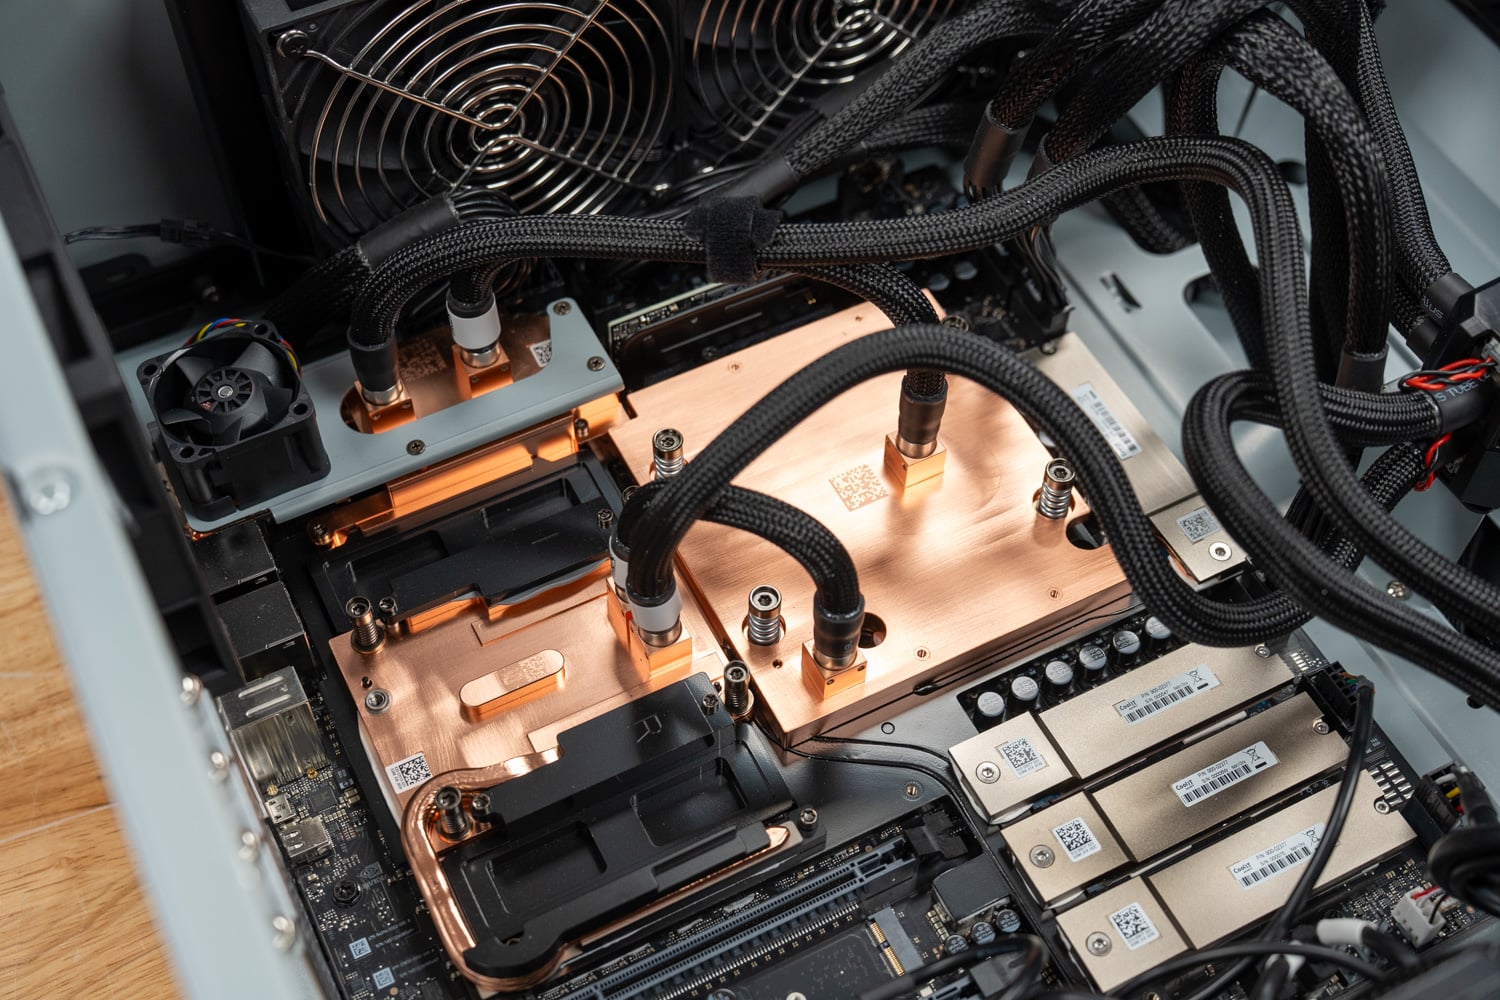
Zonder het zijpaneel lijkt de ET900N G3 een nauwe verwant van de WS300, wat te verwachten is aangezien beide hetzelfde NVIDIA-moederbord delen. De GB300 Superchip bevindt zich onder een koperen koelplaat aan de linkerkant van de behuizing, met de SOCAMM-modules onder hun eigen koperen platen ernaast en de ConnectX-8 onder een derde blok nabij de achterste I/O-aansluitingen. Gevlochten slangen lopen van de blokken naar een verdeelstuk op de dwarsbalk van de behuizing en vandaar naar de radiatoren. De drie PCIe-slots van volledige lengte bevinden zich onder de Superchip, de voeding bevindt zich in de linkerbenedenhoek en een metalen kap bedekt de kabelgeleiding aan de onderkant.
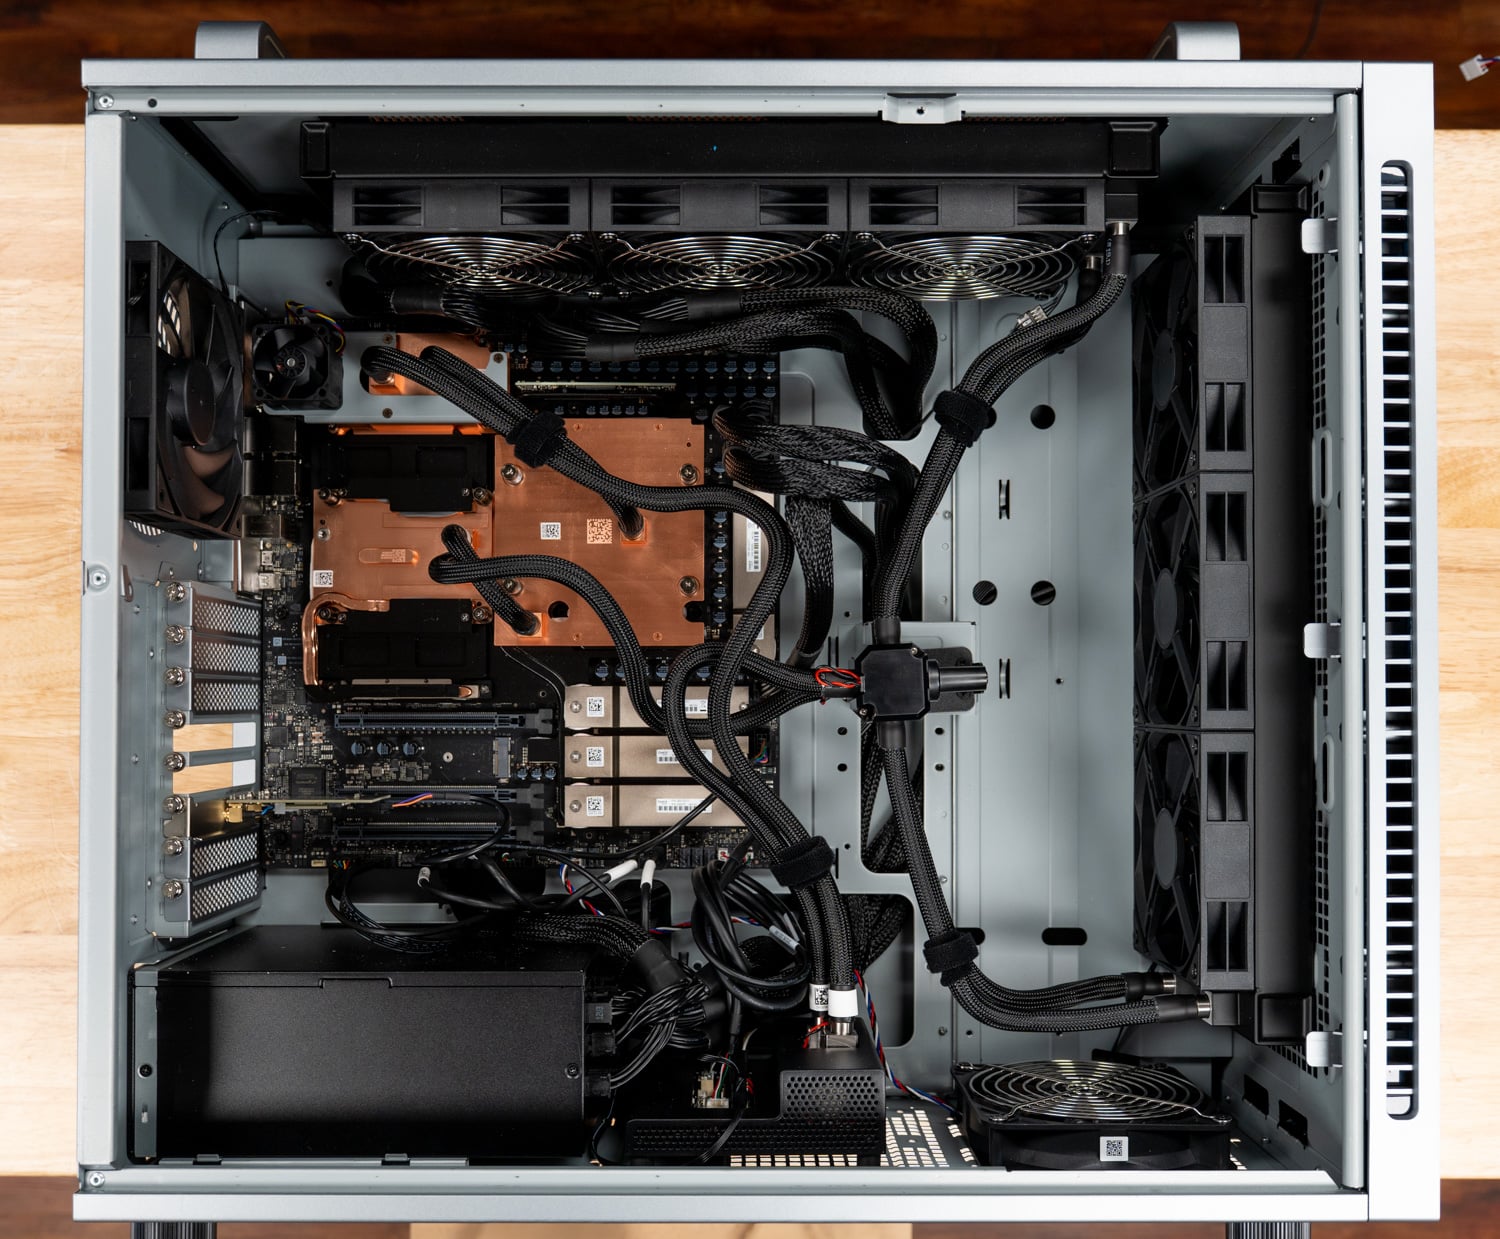
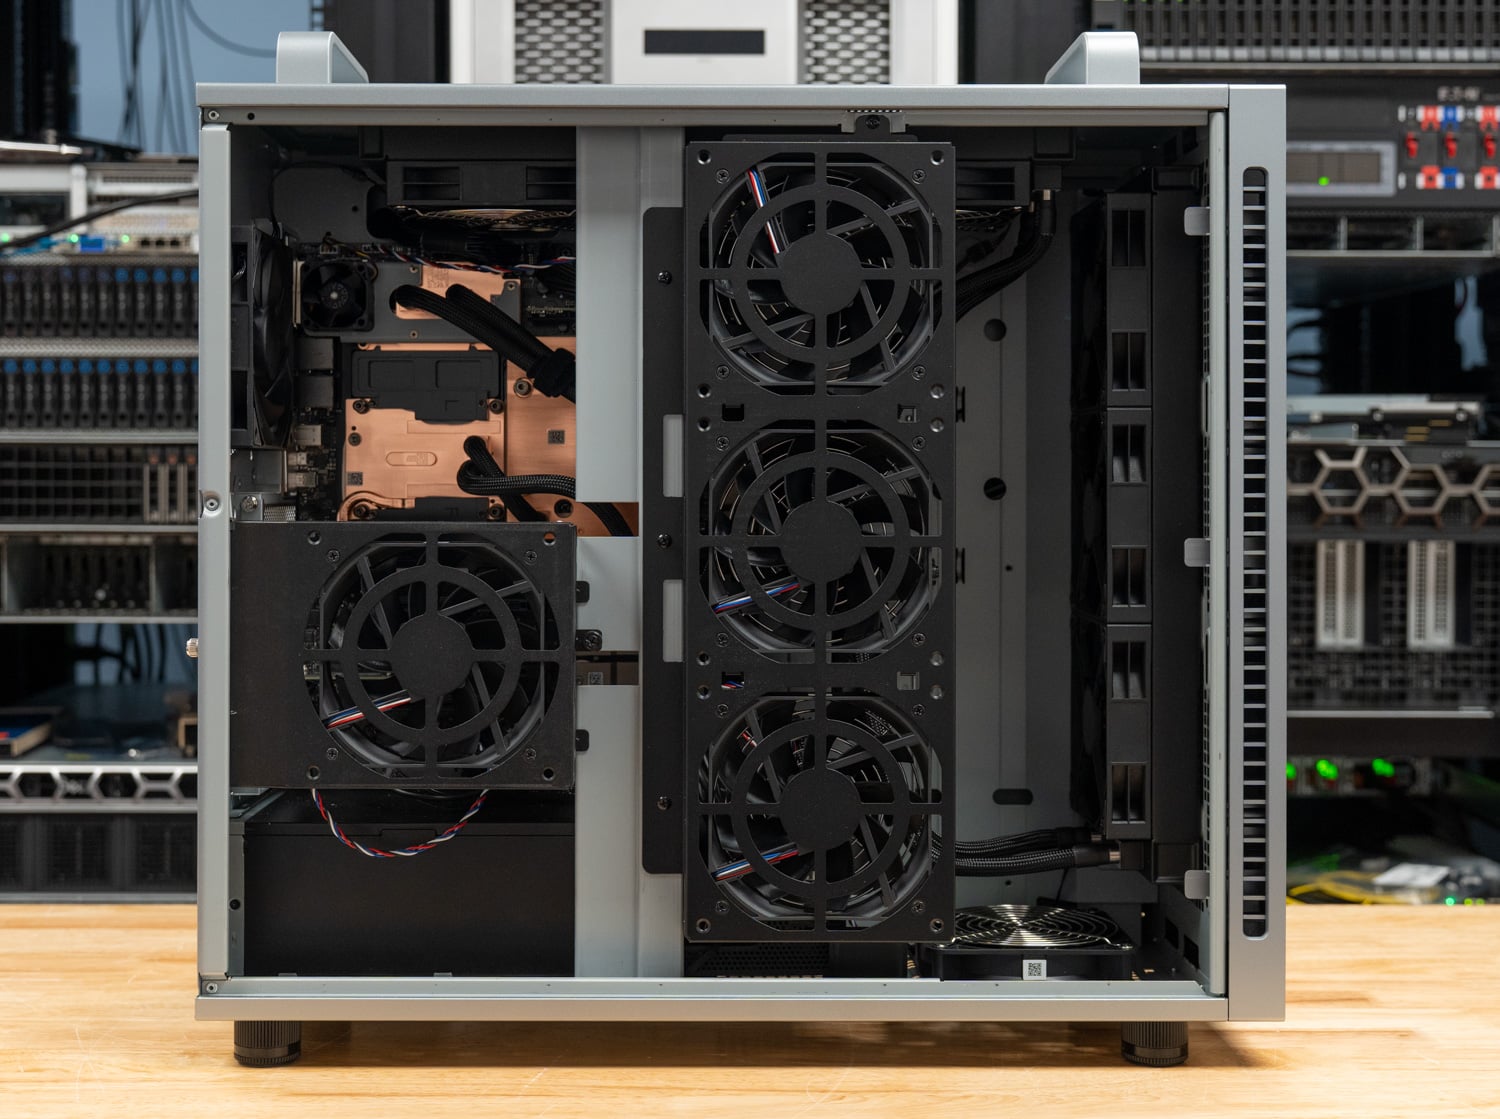
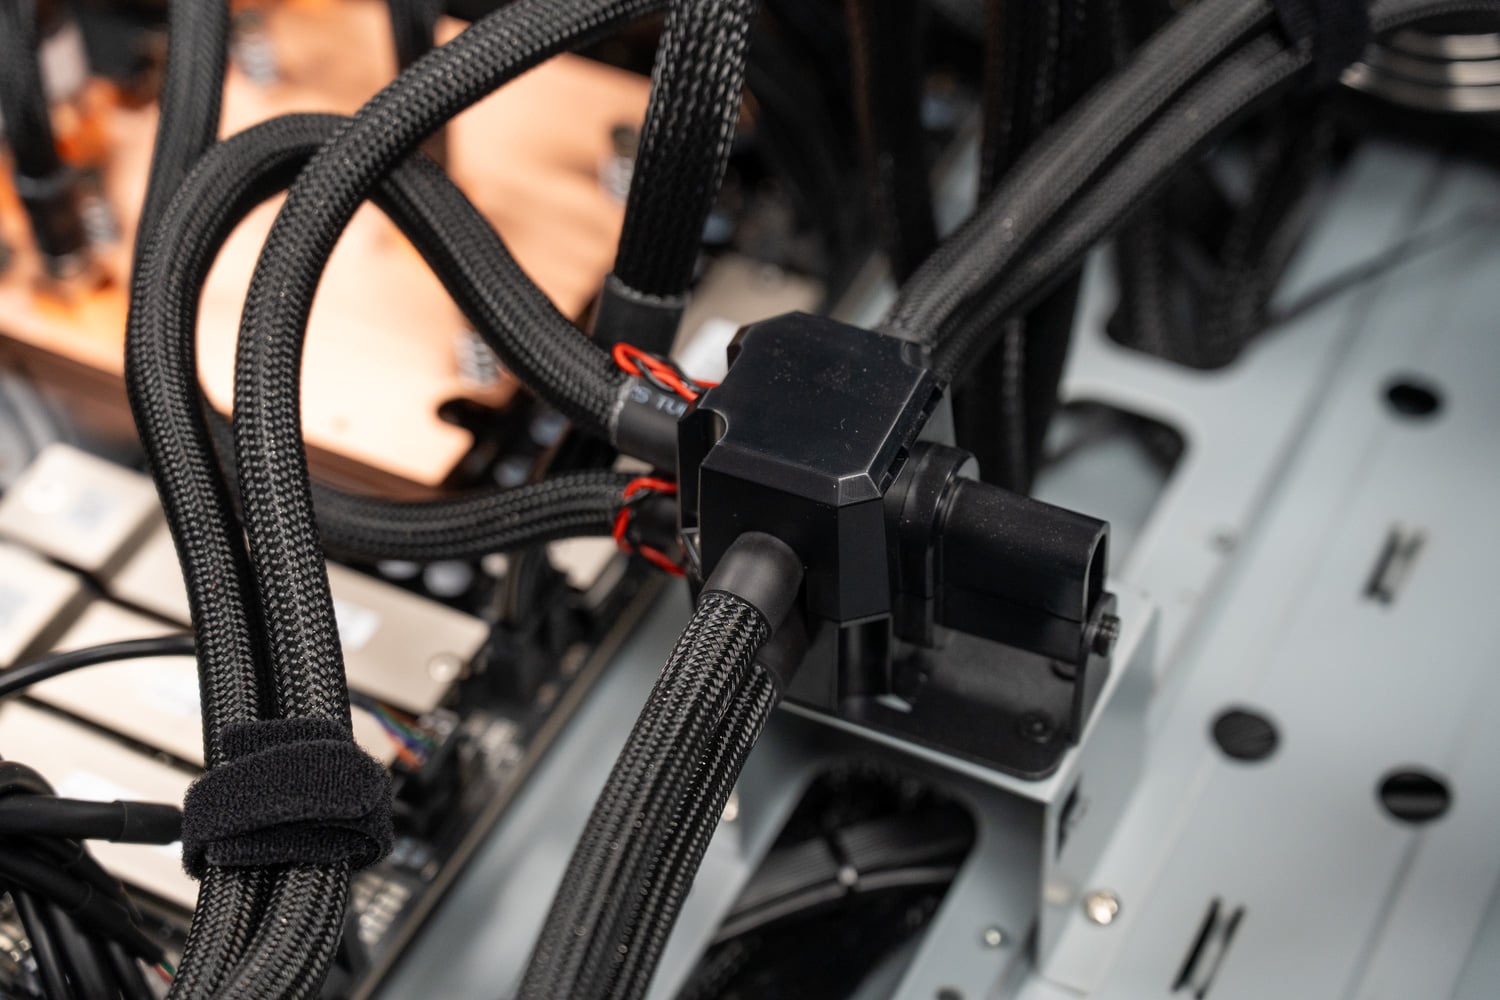
De interne indeling volgt hetzelfde patroon als de WS300: één radiator verticaal gemonteerd achter het voorste gaas en een tweede bovenaan, elk met een rij ventilatoren, plus een chassisventilator aan de achterkant. De koelvloeistofleidingen zijn omhuld en met klittenband aan de dwarsbalk bevestigd, en het verdeelstuk bundelt de leidingen van de vier koelplaten zodat er slechts twee leidingen naar elke radiator lopen.
De optische ventilator
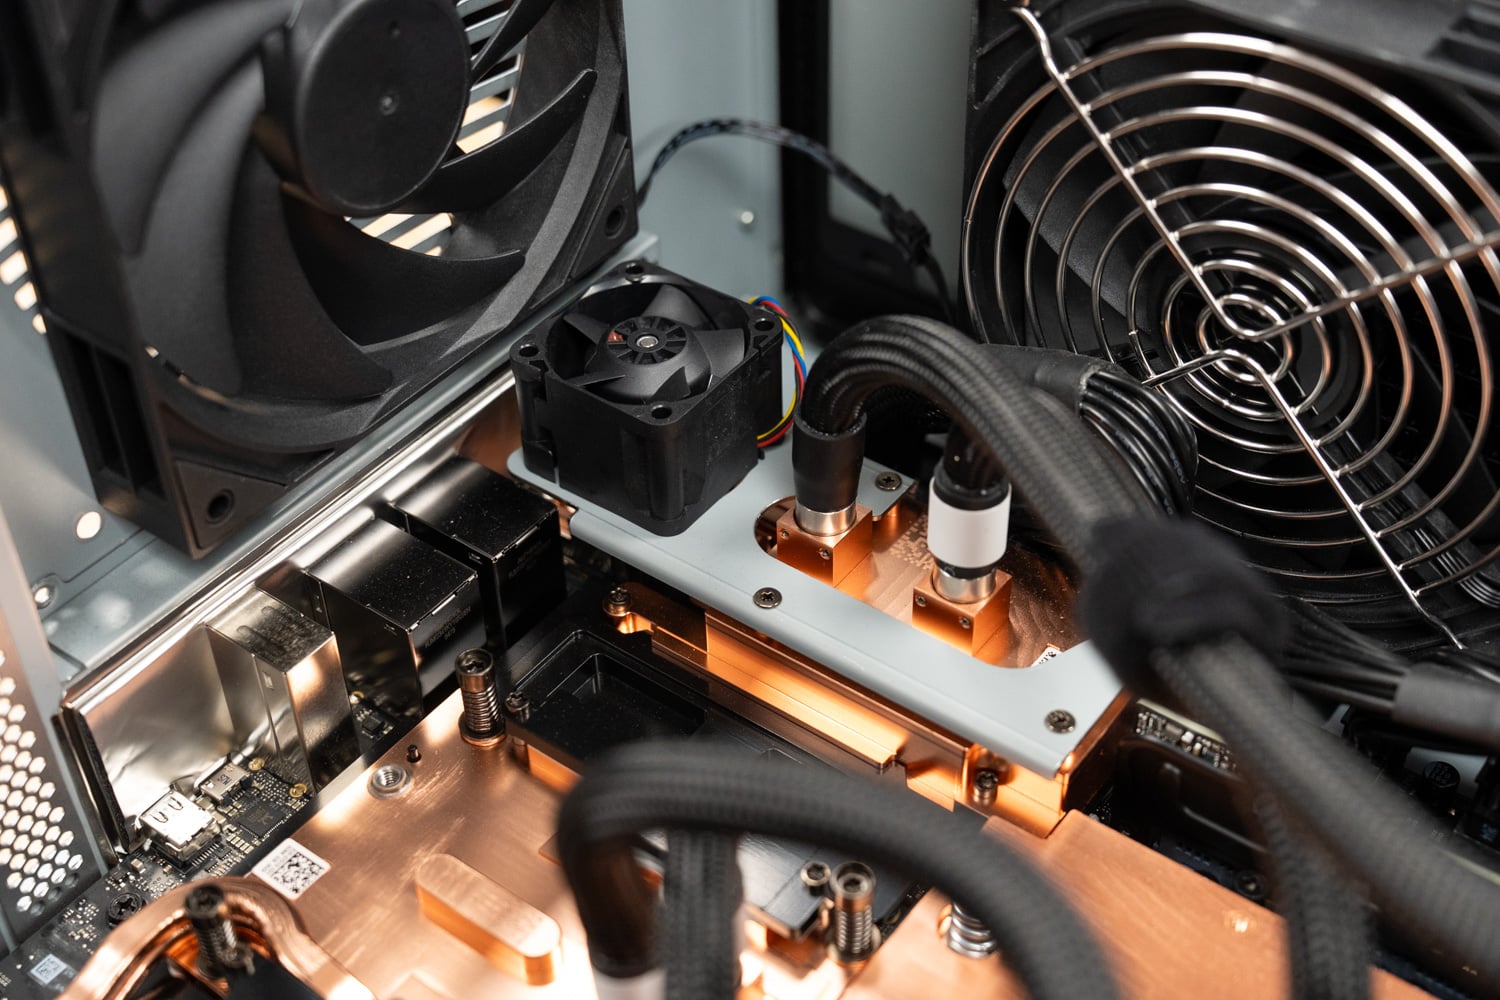
Het enige koelelement dat geen equivalent heeft in de WS300 is een kleine ventilator die op een beugel boven de ConnectX-8 koelplaat is gemonteerd en gericht is op de QSFP112-behuizingen. De vloeistofkoeling zorgt voor de koeling van de SuperNIC-chip zelf, maar 400G optische transceivers genereren hun eigen warmte en bevinden zich in metalen behuizingen die de koelplaat alleen via geleiding kan bereiken. Bij andere tests hebben we vastgesteld dat de ConnectX-8 warm wordt bij langdurige belasting en dat de optische componenten zelf ook heet kunnen worden. Een speciale luchtstroom over de behuizingen is daarom een prettig ontwerpkenmerk voor iedereen die van plan is de ET900N G3 urenlang via glasvezel te gebruiken. Met DAC's, zoals we die hebben gebruikt om een tweede GB300 Station aan te sluiten voor een diepgaande analyse van geclusterde inferentie die nog gaande is, heeft de ventilator minder werk te verrichten.
Opslag, uitbreiding en stroomvoorziening
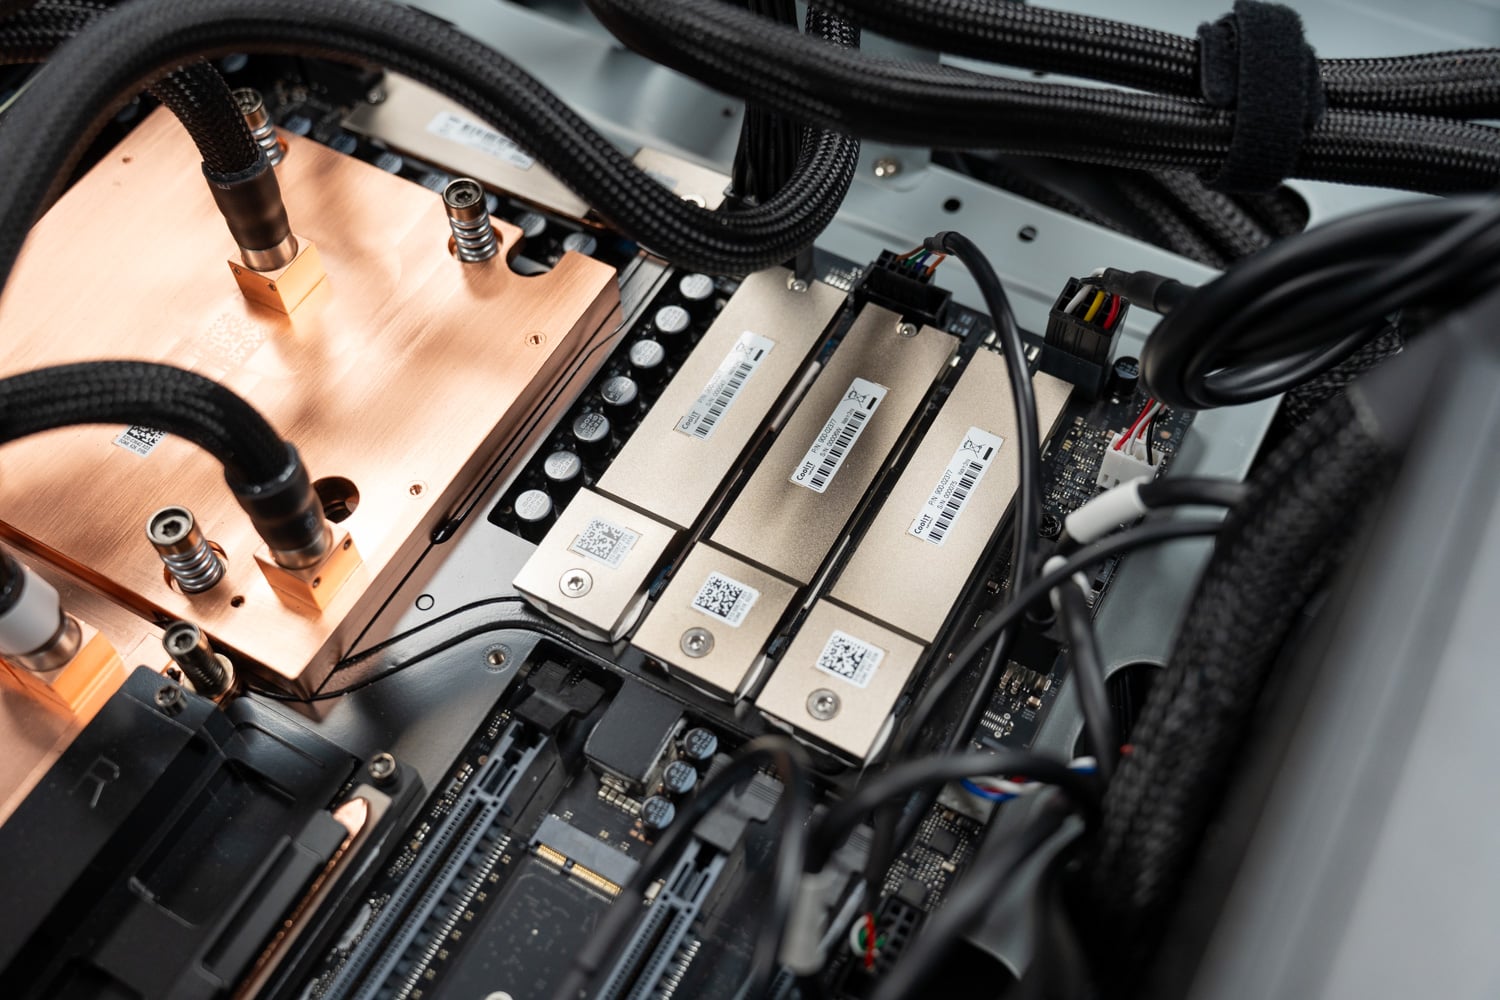
ASUS leverde de ET900N G3 met één 2TB NVMe-schijf voor het besturingssysteem en de NVIDIA-softwarestack, in de twee M.2 2280-slots die via PCIe 5.0 x4 met Grace zijn verbonden. Het tweede paar slots is aangesloten op de geïntegreerde PCIe-switch van de ConnectX-8 en werd leeg geleverd.
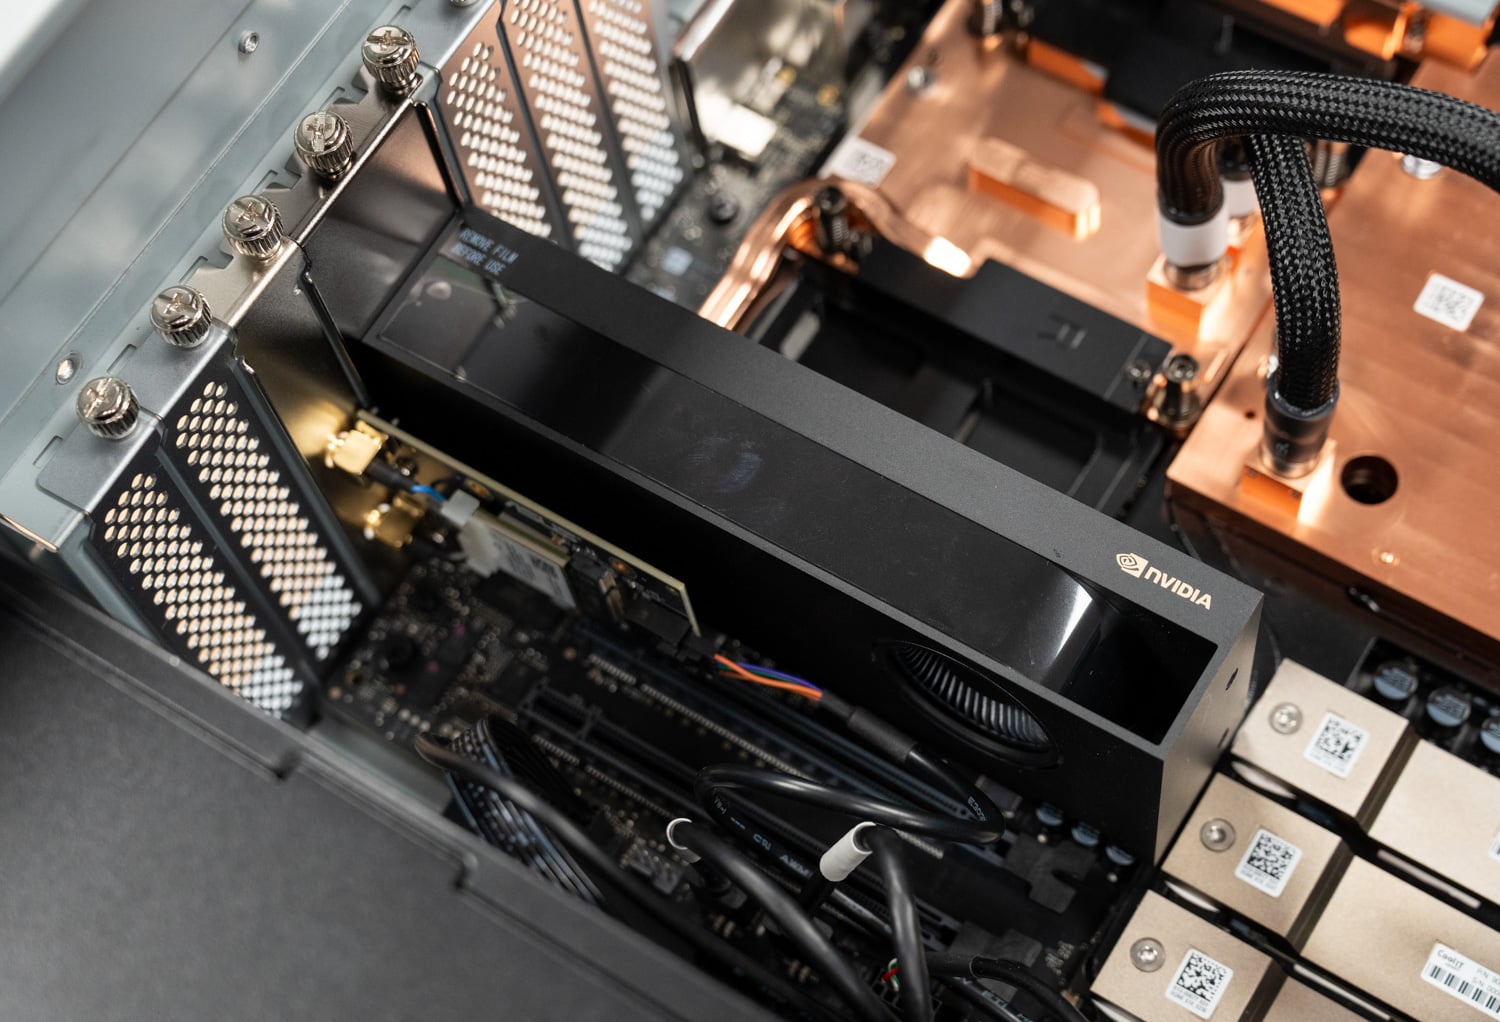
Ons testexemplaar werd geleverd met een NVIDIA RTX PRO 2000 Blackwell in het PCIe 5.0 x16-slot, een van de configuraties die ASUS vermeldt. De kaart levert beelduitvoer zonder noemenswaardig veel stroom van de GB300 te verbruiken, en ASUS geeft aan dat de behuizing plaats biedt aan maximaal één RTX PRO Blackwell-kaart. We hebben de RTX PRO 2000 verwijderd vóór de benchmarks, zodat de Superchip de volledige acceleratorcapaciteit had, dezelfde situatie die we ook voor de WS300 hebben gebruikt. We hebben in deze behuizing geen krachtige RTX PRO-kaart getest; die aanpak, en de gevolgen daarvan voor het gedeelde stroombudget, zullen we in een volgende review van de GB300 Station bespreken.
De voeding is een 1,600W ATX-unit die door ASUS is gecertificeerd als 80 PLUS Titanium, een stap hoger dan de Platinum-unit in de WS300. Titanium vereist een efficiëntie van 94% bij 50% belasting op een ingangsspanning van 115V, vergeleken met 92% voor Platinum. Het is de enige certificeringscategorie die een minimum van 10% belasting hanteert, waardoor de ET900N G3 enkele tientallen watts minder zou moeten verbruiken bij een volledige belasting van de GB300. Het stroomverbruik wordt nog steeds gedeeld: Grace, de B300, de pompen, ventilatoren, opslag en elke RTX PRO-kaart gebruiken dezelfde 1,600W. NVIDIA's vsloshd-service verschuift de beschikbare ruimte tussen de Superchip en een extra GPU naarmate het stroomverbruik verandert, zonder vaste limiet voor beide. De review van de WS300 beschrijft dit beleid en het is hier ongewijzigd. Een aparte 20A-stroomkring blijft vereist voor installaties in Noord-Amerika.
Connectiviteit
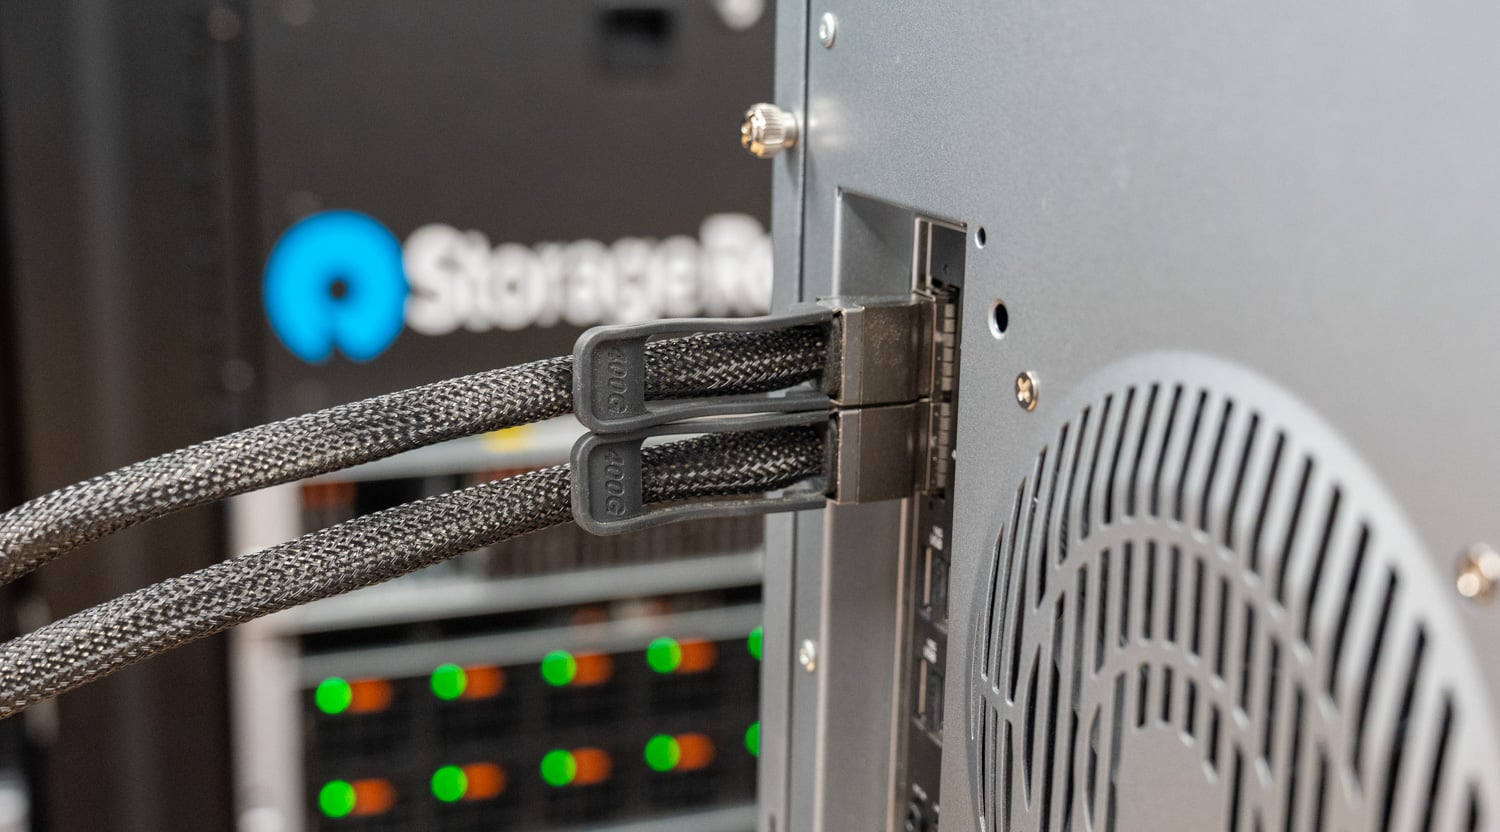
De twee QSFP112-poorten van de ConnectX-8 vormen de verbinding van de ET900N G3 met de rest van het systeem: opslag, een tweede DGX Station of een clusterfabric. Deze poorten worden al in het lab gebruikt, waarbij de ET900N G3 via 400G DAC's is verbonden met een tweede GB300 Station voor een diepgaand onderzoek naar clusterinferentie dat we later zullen publiceren. De 10GbE Marvell-poort verwerkt het reguliere hostverkeer en de Realtek 1GbE-poort is specifiek voor de BMC.
Testnotities
Alle resultaten in deze review zijn afkomstig van het exemplaar dat ASUS naar ons lab heeft verzonden, in de standaard geheugenconfiguratie met 252 GB HBM3e en 496 GB LPDDR5X. Het systeem draaide zonder een RTX PRO-kaart, waardoor de GB300 Superchip het volledige vermogen van de accelerator tot zijn beschikking had, wat overeenkomt met de omstandigheden van onze WS300-tests. De softwarestack, vLLM-configuratie, workloadprofielen en gelijktijdigheidsmetingen zijn hetzelfde als die we voor de WS300 hebben gebruikt, waardoor de twee towers direct met elkaar vergeleken kunnen worden. Deze review richt zich uitsluitend op de prestaties; we hebben het stroomverbruik of de temperatuur van dit exemplaar niet gemeten.
De workloads zijn dezelfde twee vLLM live-inferentieprofielen die we op elk lokaal AI-systeem uitvoeren: een gelijke workload met 512 input- en 512 output-tokens, en een workload met veel prefill met 8,192 input- en 1,024 output-tokens, waarbij één tot 128 gelijktijdige streams worden gebruikt. Voor de grootschalige modellen vergelijken we met een Dell PowerEdge XE7740 GPU-server met twee of vier RTX PRO 6000 -kaarten, het dichtstbijzijnde alternatief in één systeem voor deze controlepunten. Voor de kleinere modellen vergelijken we met een enkele RTX PRO 6000 in dezelfde XE7740, een enkele H200 NVL in een Dell PowerEdge R770 en een GB10 DGX Spark, vertegenwoordigd door de Acer Veriton GN100 , dezelfde Spark die we gebruikten in de WS300-review. De onderstaande ET900N G3-cijfers zijn de exacte waarden uit de runlogs; De vergelijkingscijfers worden afgelezen uit onze resultaatgrafieken.
Inferentieprestaties
Grensmodellen op de coherente geheugenpool
De GB300 is ontworpen om modellen te ondersteunen die zich aan weerszijden van de 252GB HBM3e-grens van de B300 bevinden. Daarom beginnen we met vier referentiepunten die deze grens overbruggen: DeepSeek V4 Flash en MiniMax M2.7 passen in HBM met gemak, MiniMax M3 past er maar net in en verplaatst een deel van zijn expertise naar Grace-geheugen, en GLM-5.2 verplaatst ongeveer de helft van zijn capaciteit. Aan de andere kant van elke grafiek staat het dichtstbijzijnde alternatief in één behuizing: RTX PRO 6000-kaarten samen in de PowerEdge XE7740, waarbij expertise naar hostgeheugen wordt verplaatst waar nodig.
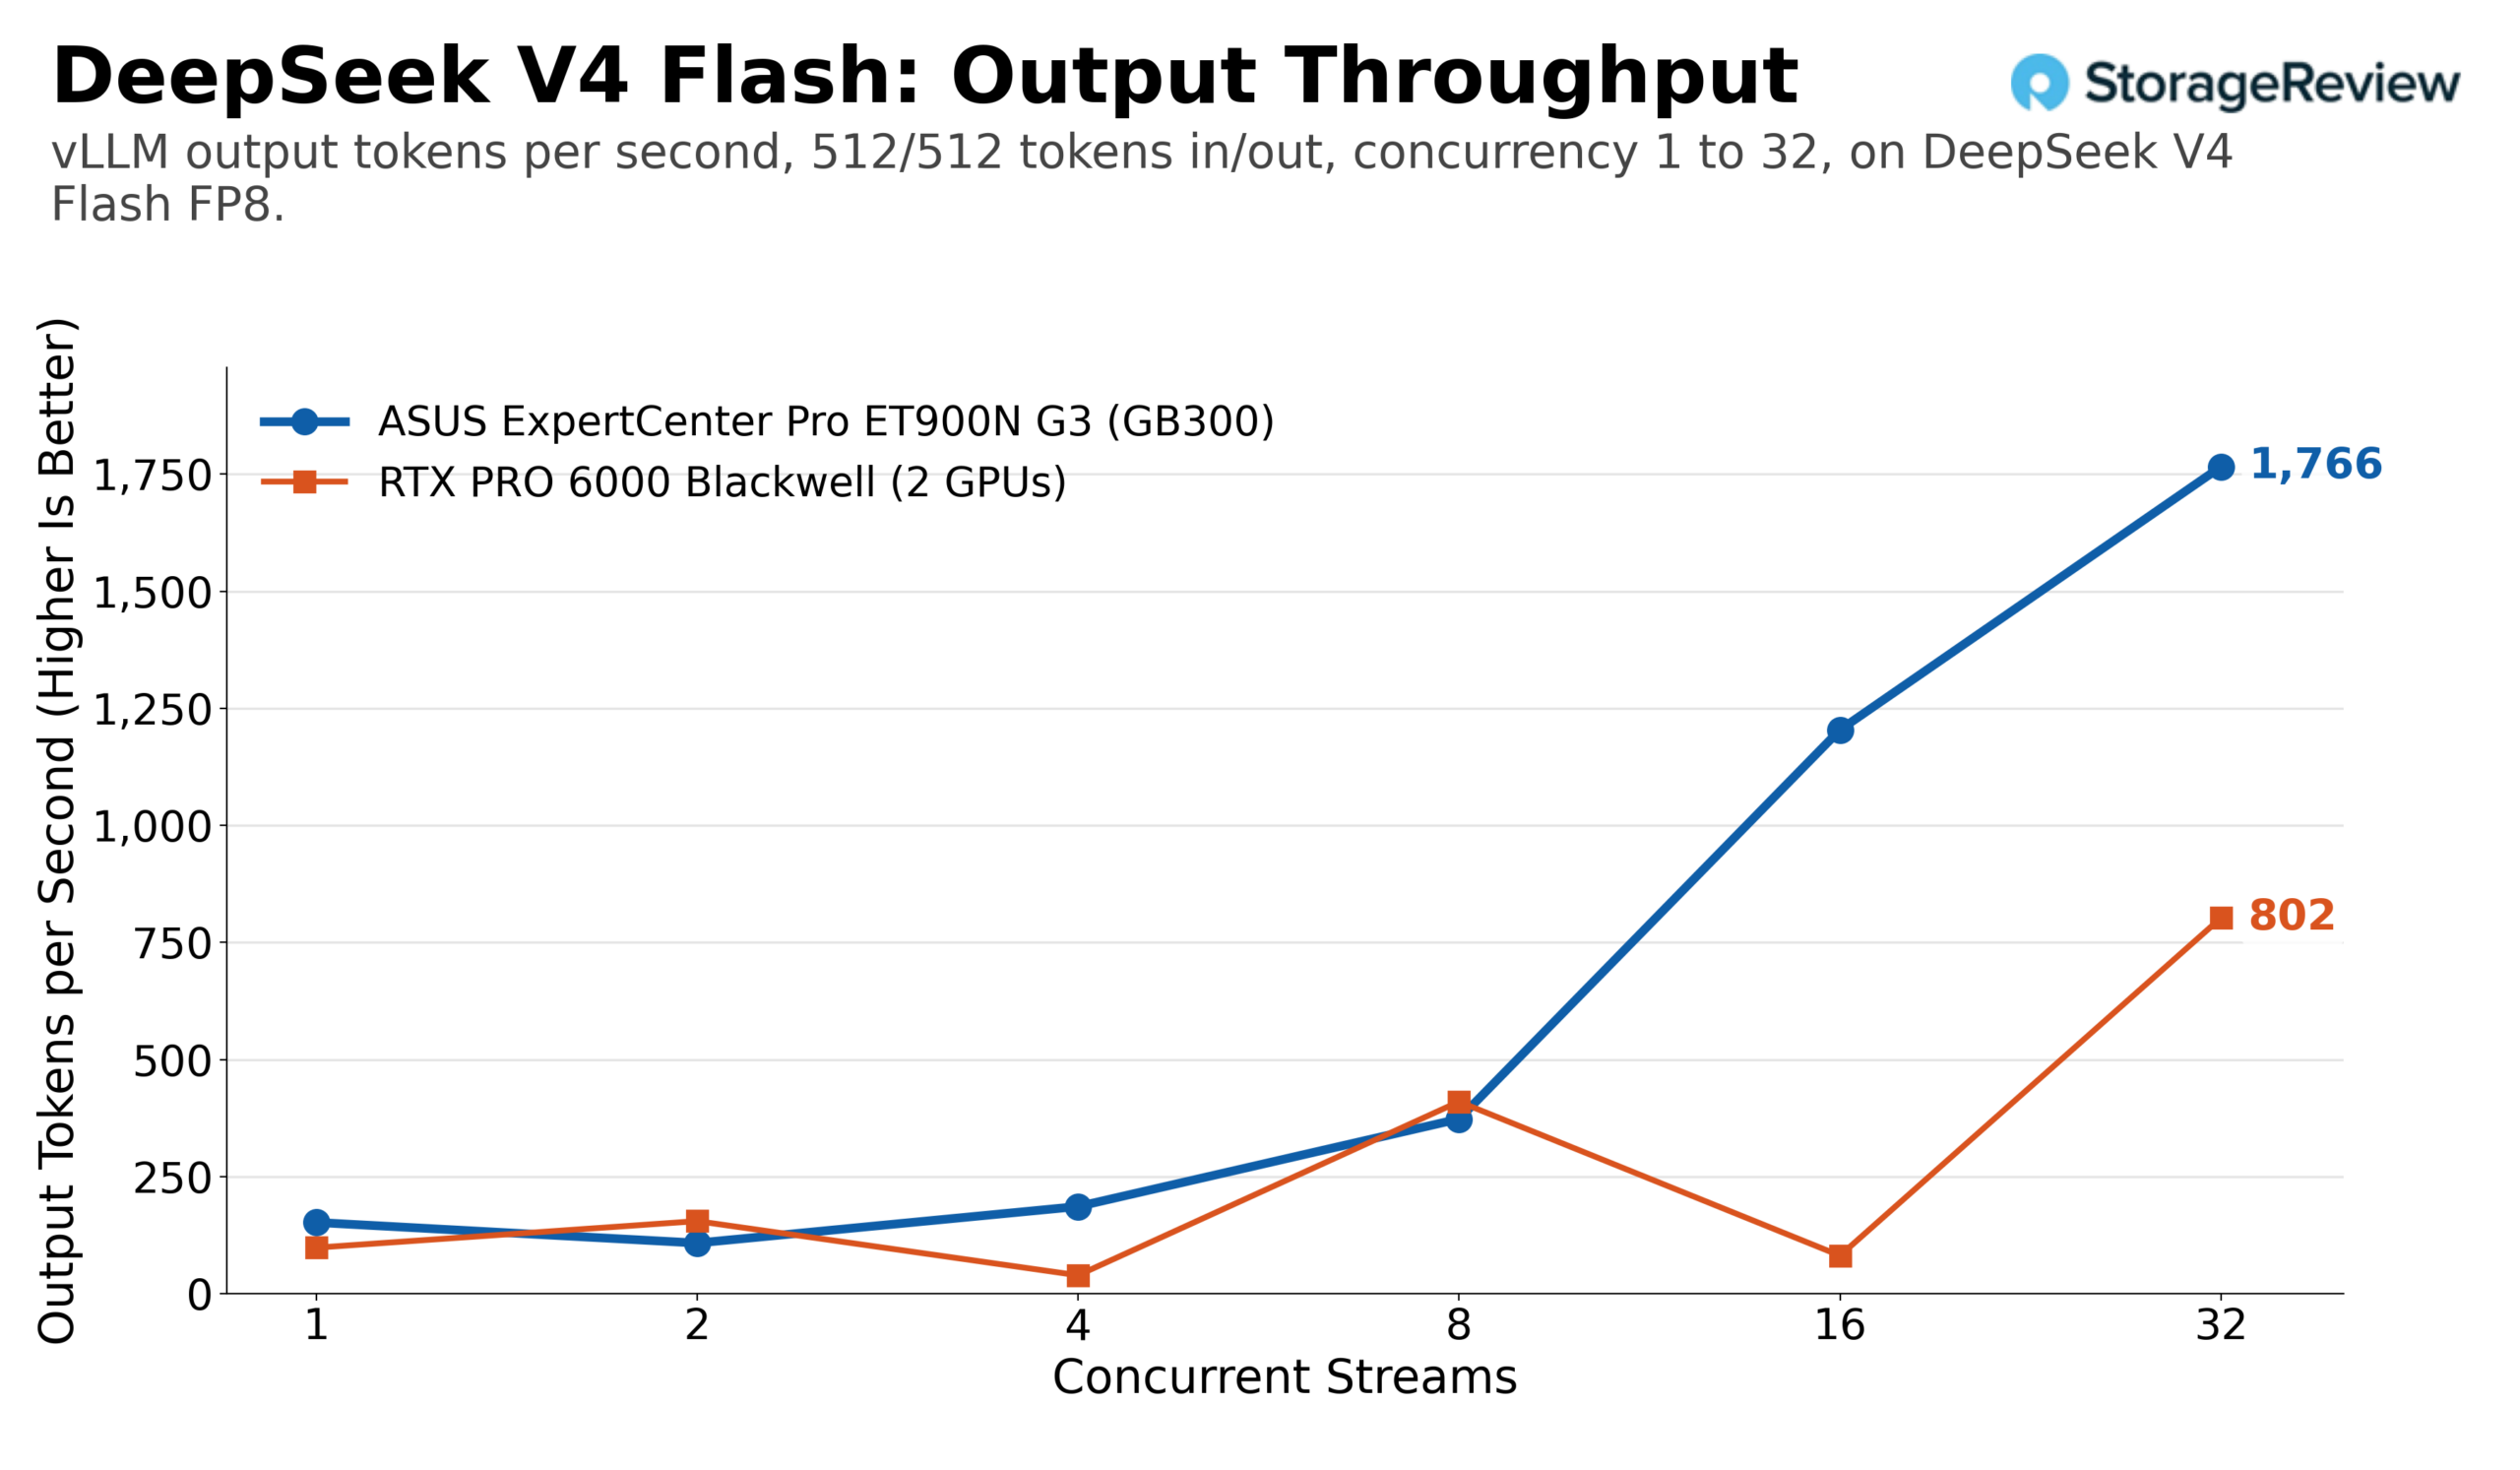
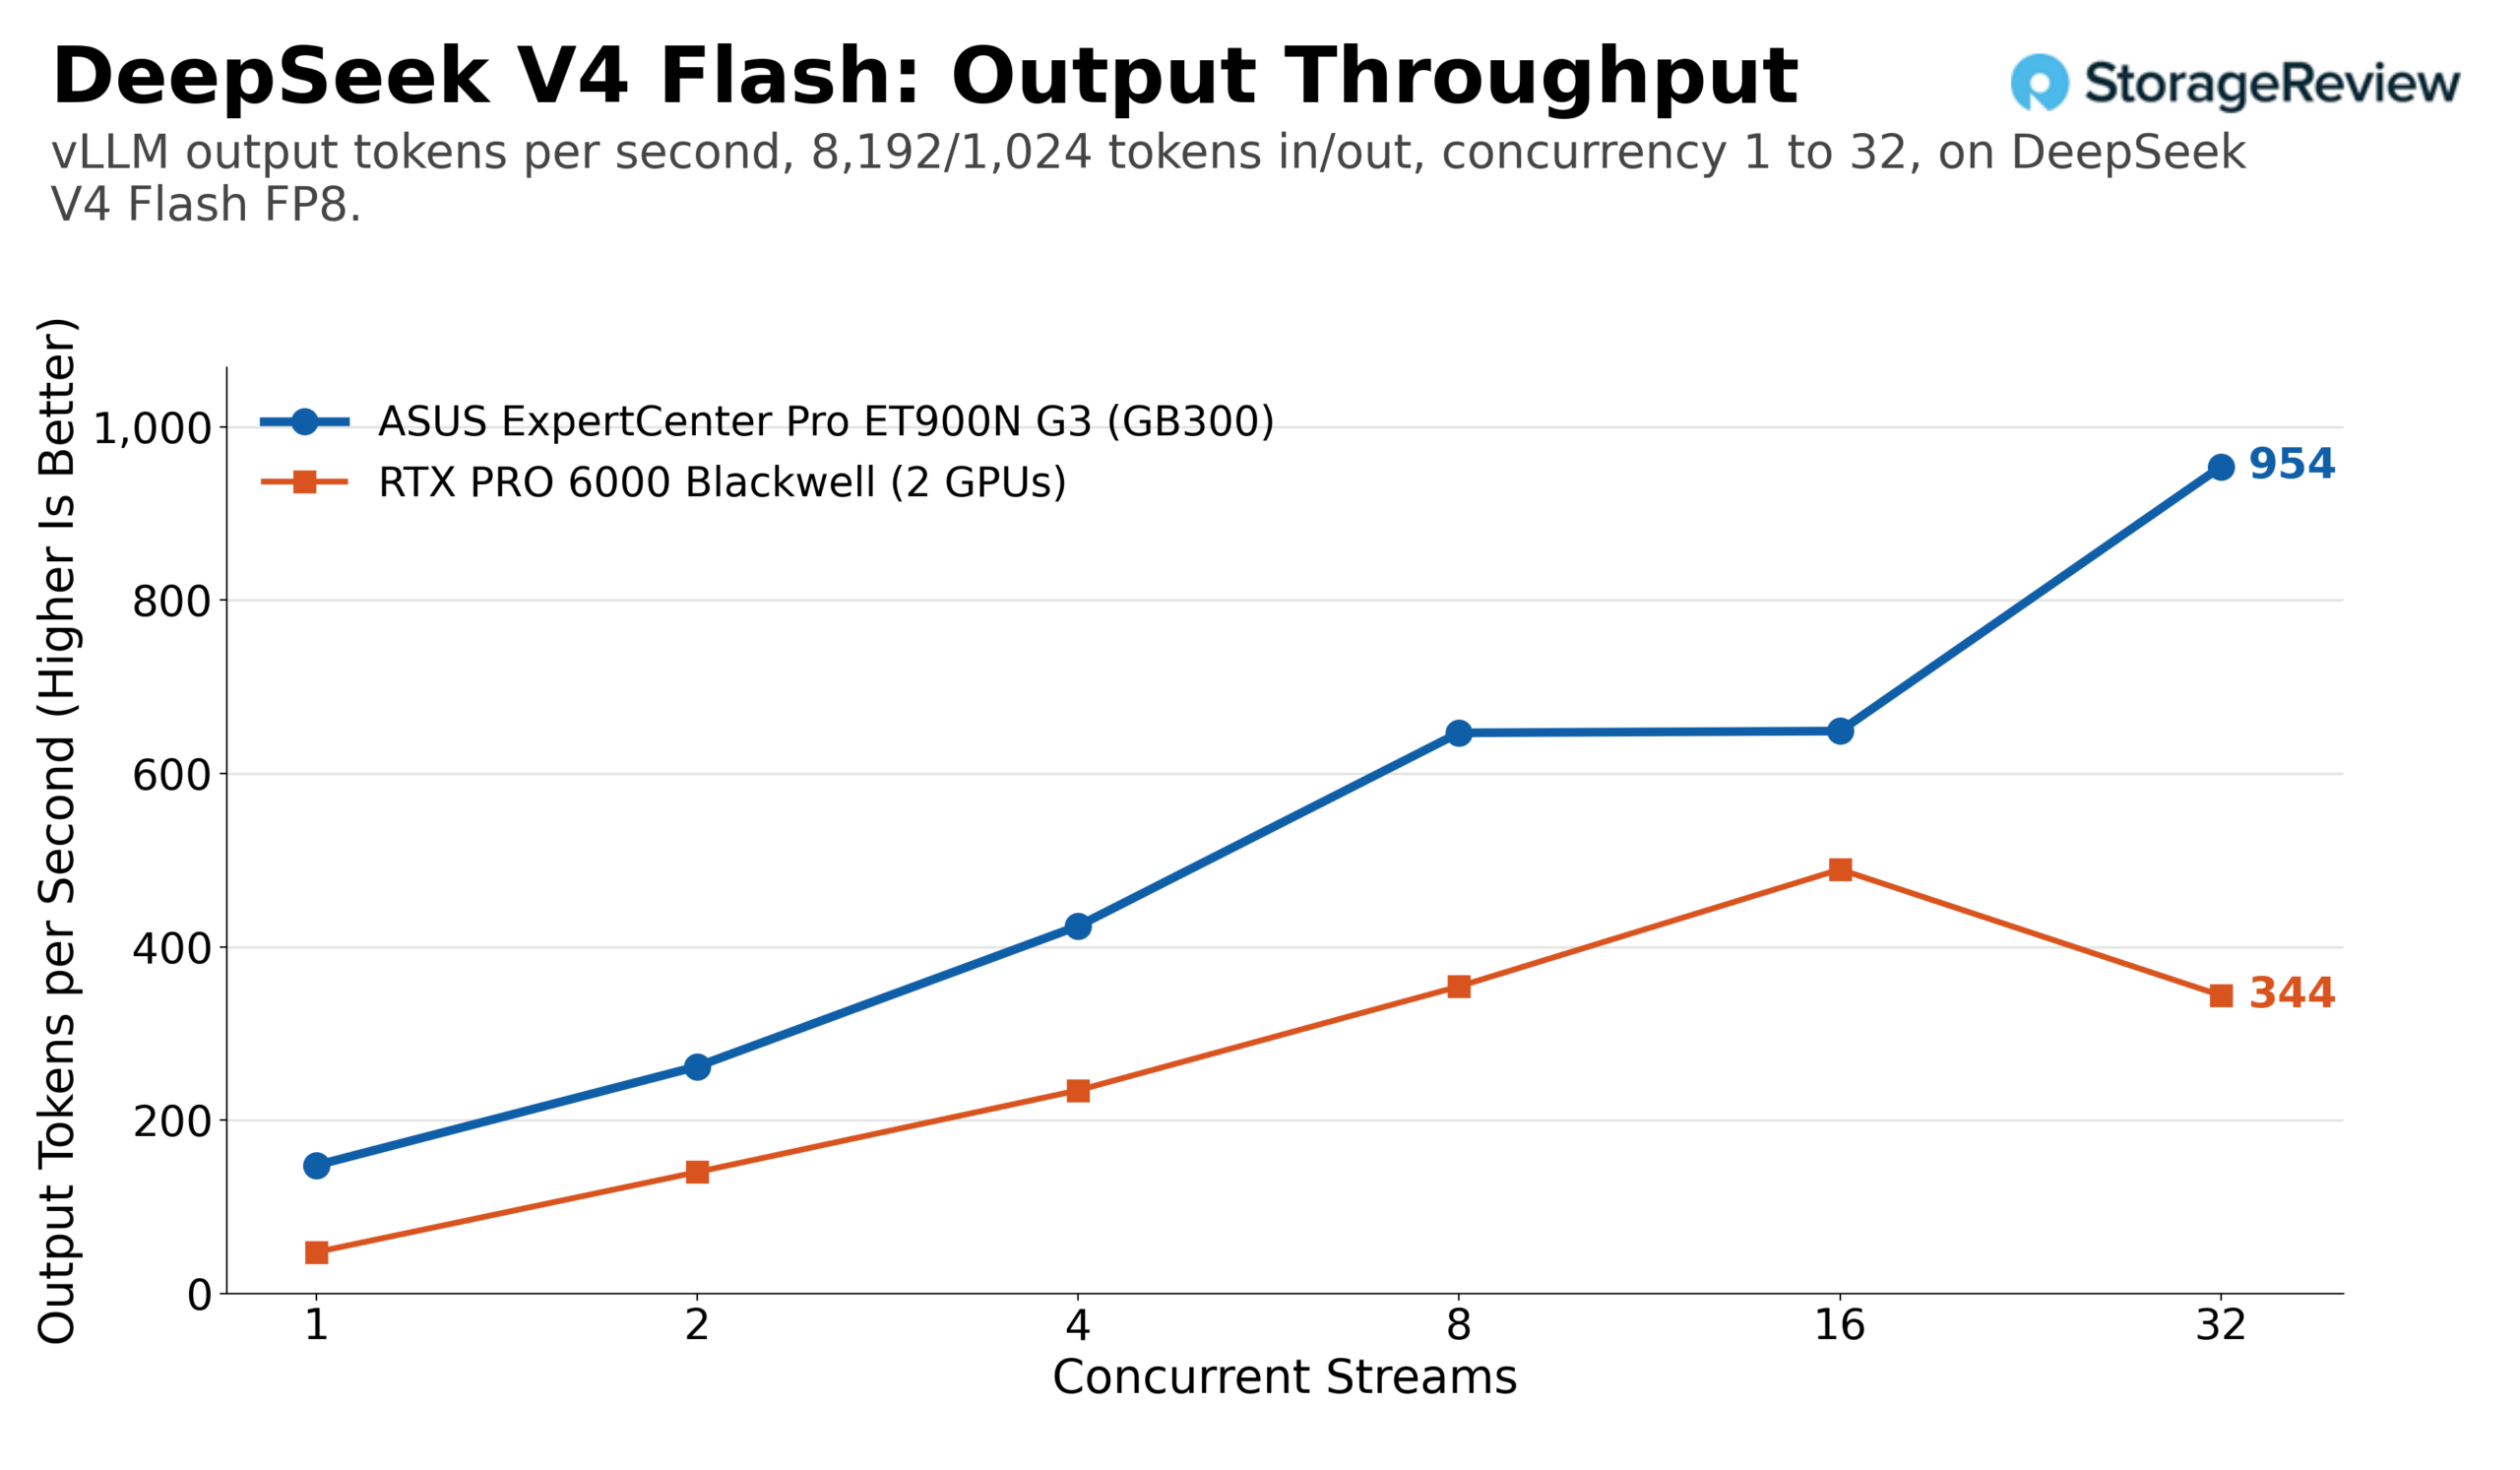
DeepSeek V4 Flash is een eenvoudig voorbeeld: een native FP8-checkpoint van ongeveer 20 GB dat de B300 moeiteloos verwerkt. De uitvoerdoorvoer bij dezelfde workload steeg van 152 tokens per seconde met 1 stream naar 1,766 met 32 streams, wat een totale tokendoorvoer van 3,532 opleverde. Bij het profiel met veel prefill-taken steeg de uitvoerdoorvoer van de ET900N G3 van 148 naar 954 tokens per seconde, met een totaal van 8,587 tokens. Twee RTX PRO 6000-kaarten bereikten een piek van bijna 800 tokens per seconde bij dezelfde workload en ongeveer 490 bij de lange prompts, met een onregelmatige curve bij lage gelijktijdigheid.
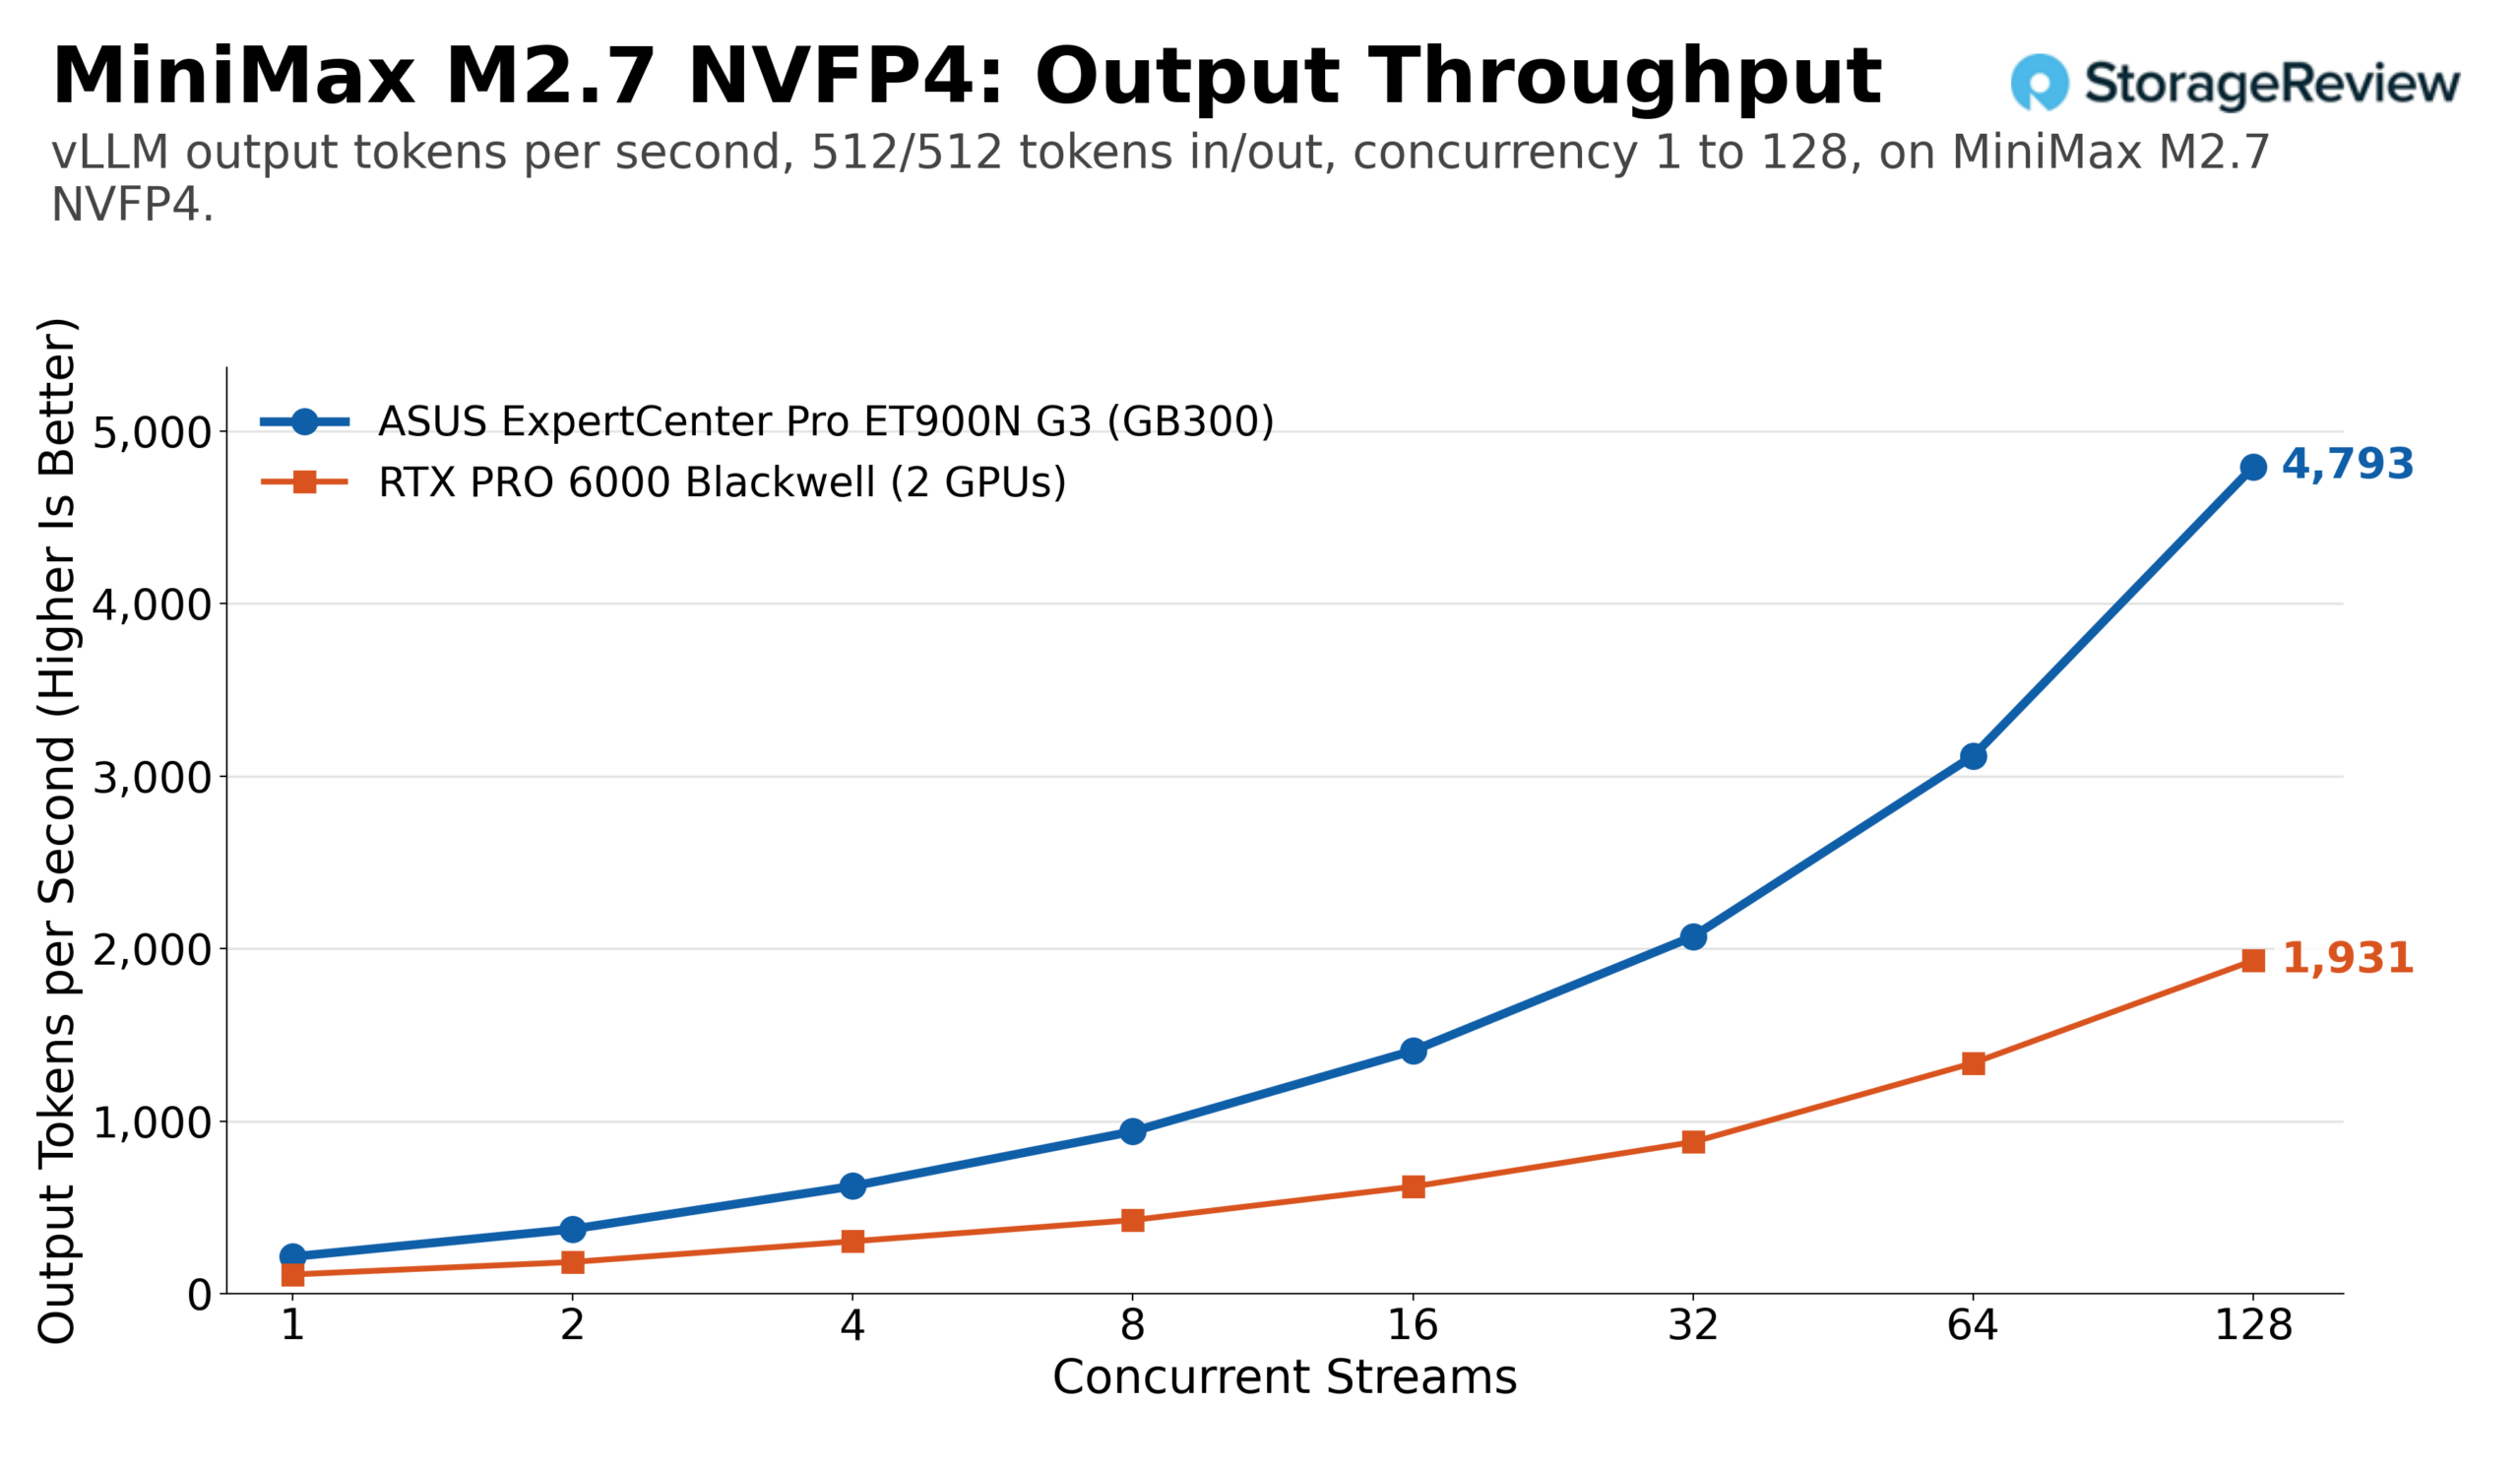
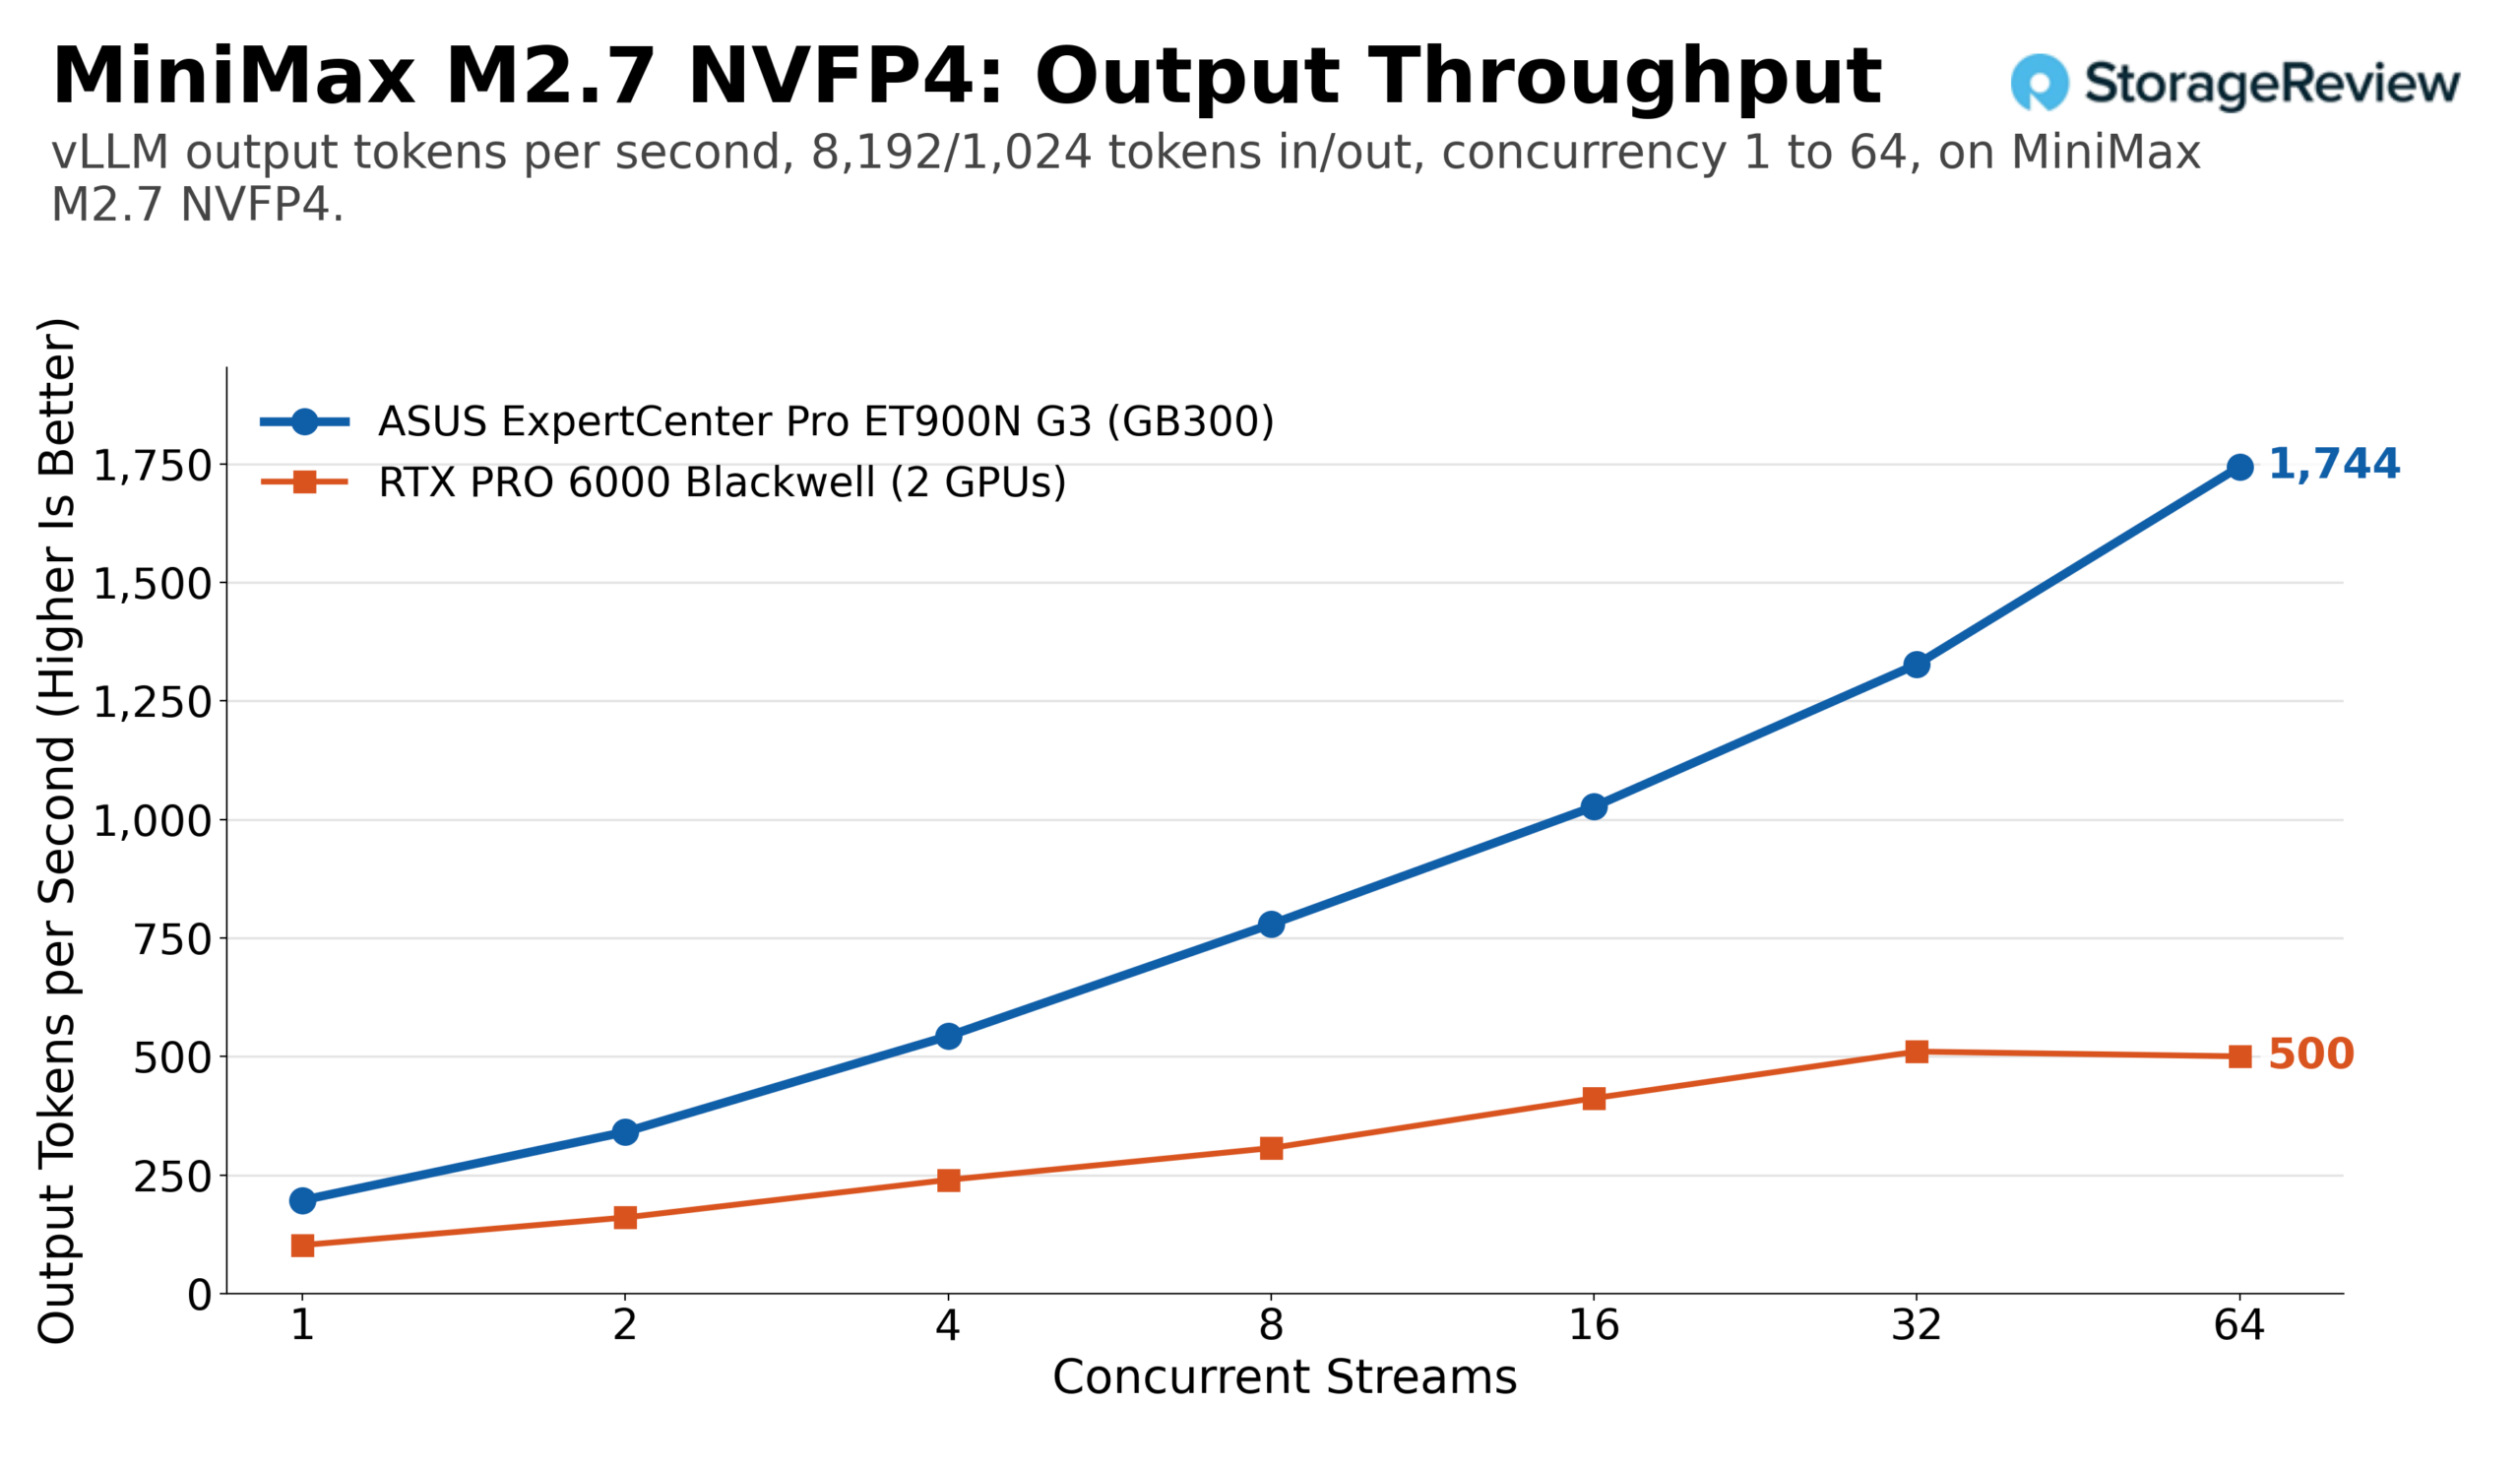
De MiniMax M2.7 in NVIDIA's NVFP4-kwantisering neemt ongeveer 125 GB HBM in beslag en schaalde het meest van de vier. Bij een gelijke werklast steeg het aantal uitvoertokens van 214 tokens per seconde op één stream naar 4,793 op 128 streams, en de totale doorvoer bereikte 9,586. De test met veel prefill-bewerkingen schaalde naar 1,744 uitvoertokens per seconde en 15,700 totale tokens per seconde bij 64 streams. Twee RTX PRO 6000-kaarten vertoonden een vergelijkbaar patroon, maar met minder dan de helft van de hoogte, met een maximum van ongeveer 1,930 uitvoertokens per seconde bij een gelijke werklast en ongeveer 510 bij de lange prompts.
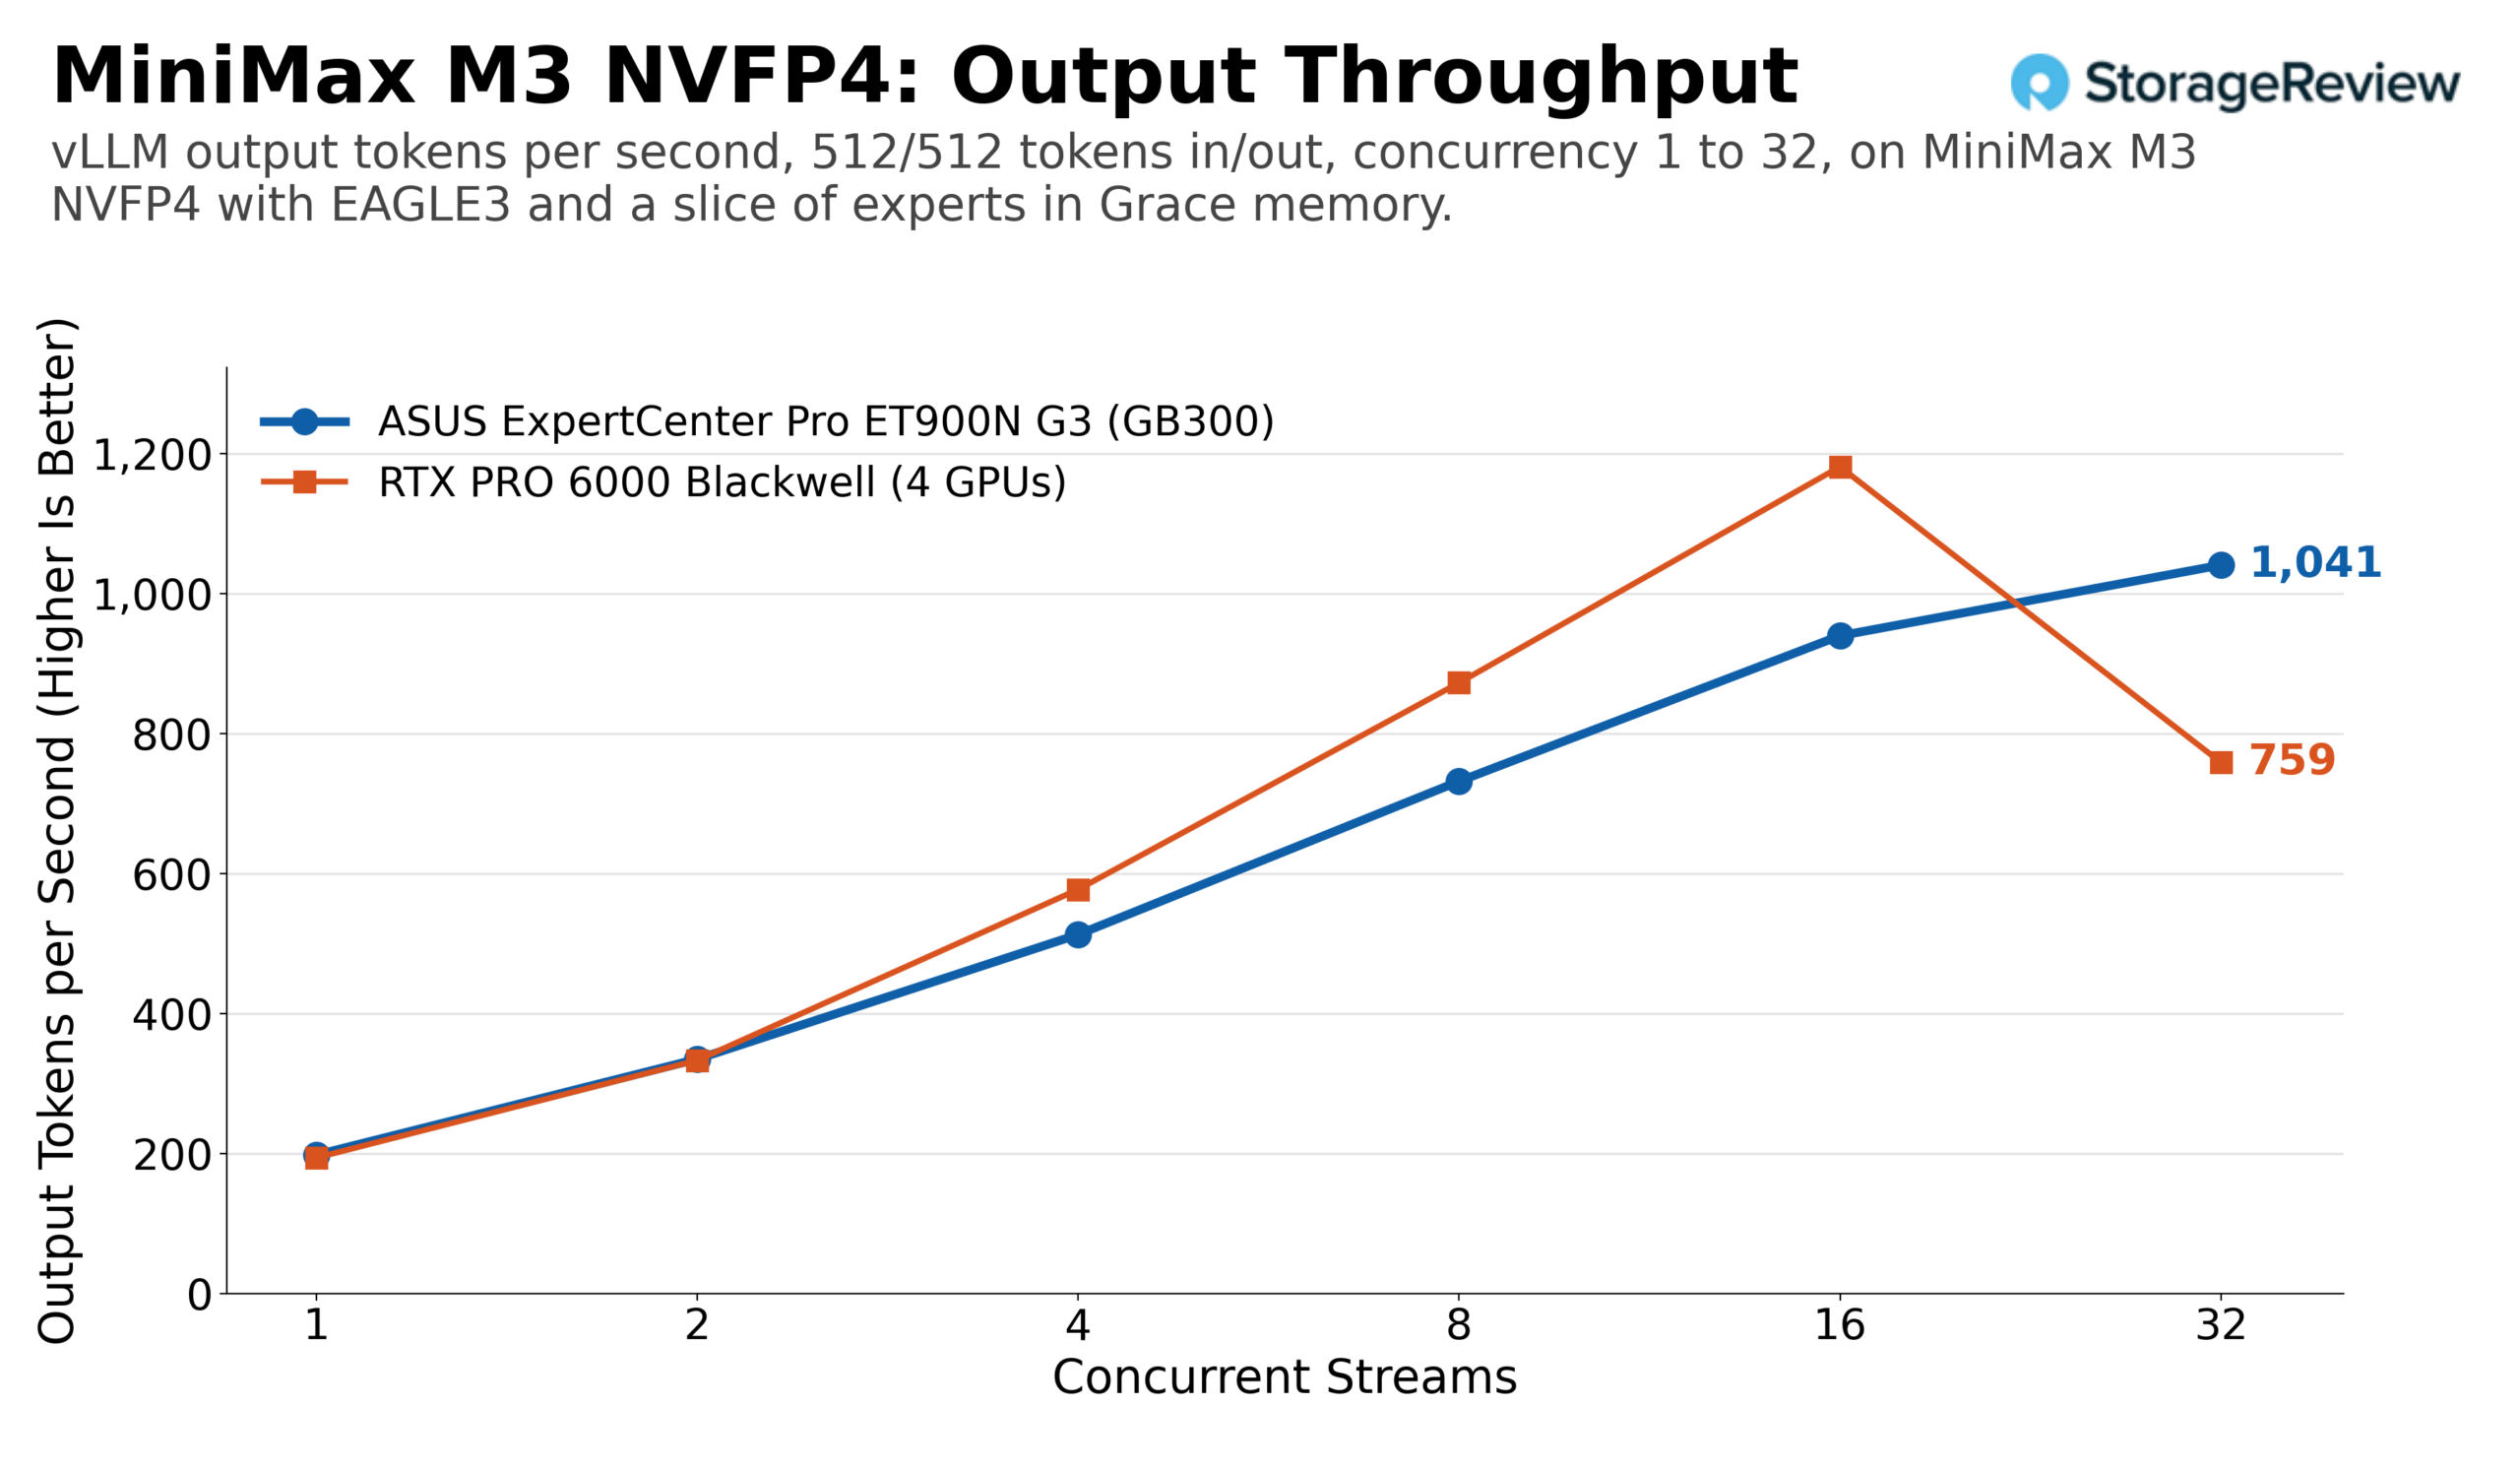
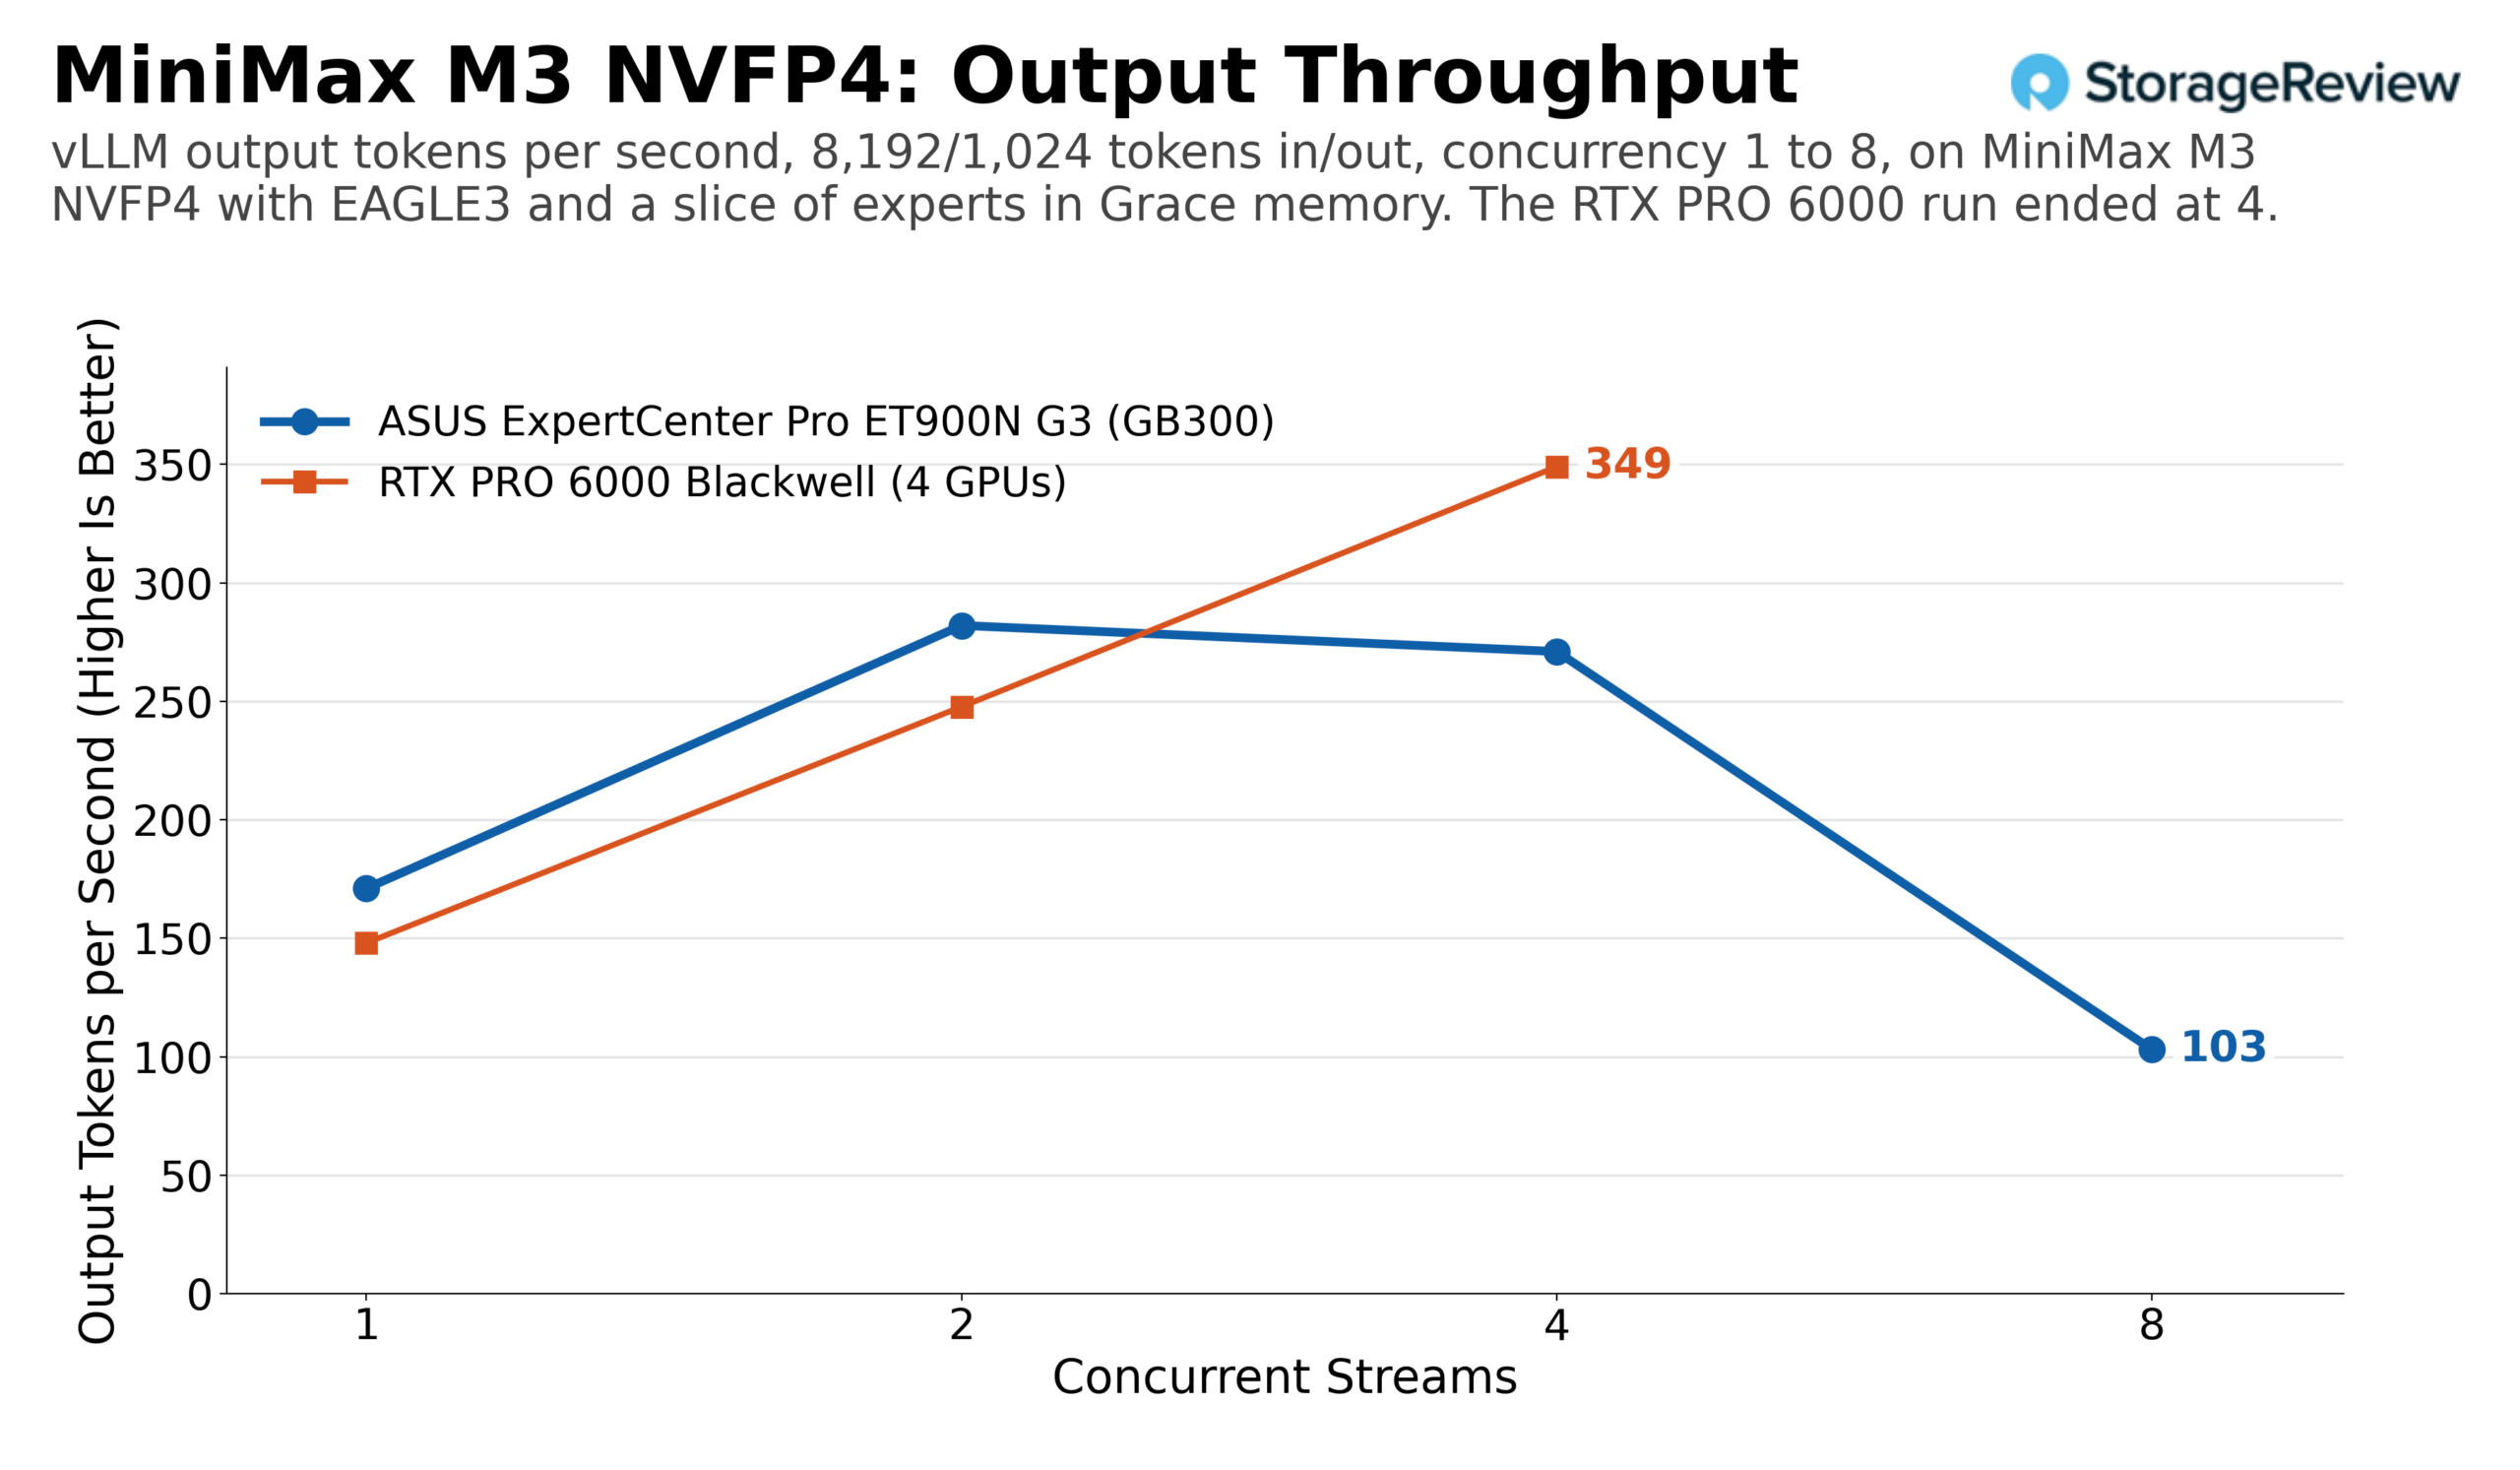
MiniMax M3 laat zien hoe het is om maar net in het geheugen te passen. Het NVFP4-checkpoint is kleiner dan 252 GB, maar de runtime en de KV-cache hebben ook ruimte nodig. Daarom bevindt een deel van de experts zich in het Grace-geheugen en loopt elke decodeerstap die hiermee te maken krijgt via NVLink-C2C. Met speculatieve decodering met EAGLE3 bereikte de ET900N G3 1,041 uitvoertokens per seconde bij 32 streams met dezelfde werklast. Het profiel met veel prefill piekte op 282 bij twee streams, bleef stabiel op 271 bij vier en daalde naar 103 bij acht, omdat de lange prompts de resterende cache verbruikten. Vier RTX PRO 6000-kaarten met dezelfde speculatieve decoder hielden gelijke tred tot en met acht streams en liepen vooruit bij 16 streams met ongeveer 1,180 uitvoertokens per seconde, waarna ze terugvielen naar ongeveer 760 bij 32 streams. Bij het profiel met veel prefill-bewerkingen verwerkte de box met vier kaarten ongeveer 349 uitvoertokens per seconde bij vier streams, tegenover 271 bij het Station. Een model dat precies op de HBM-grens zit, is de enige in deze reeks waar 384 GB VRAM verdeeld over vier kaarten concurreert met 252 GB HBM plus offload.
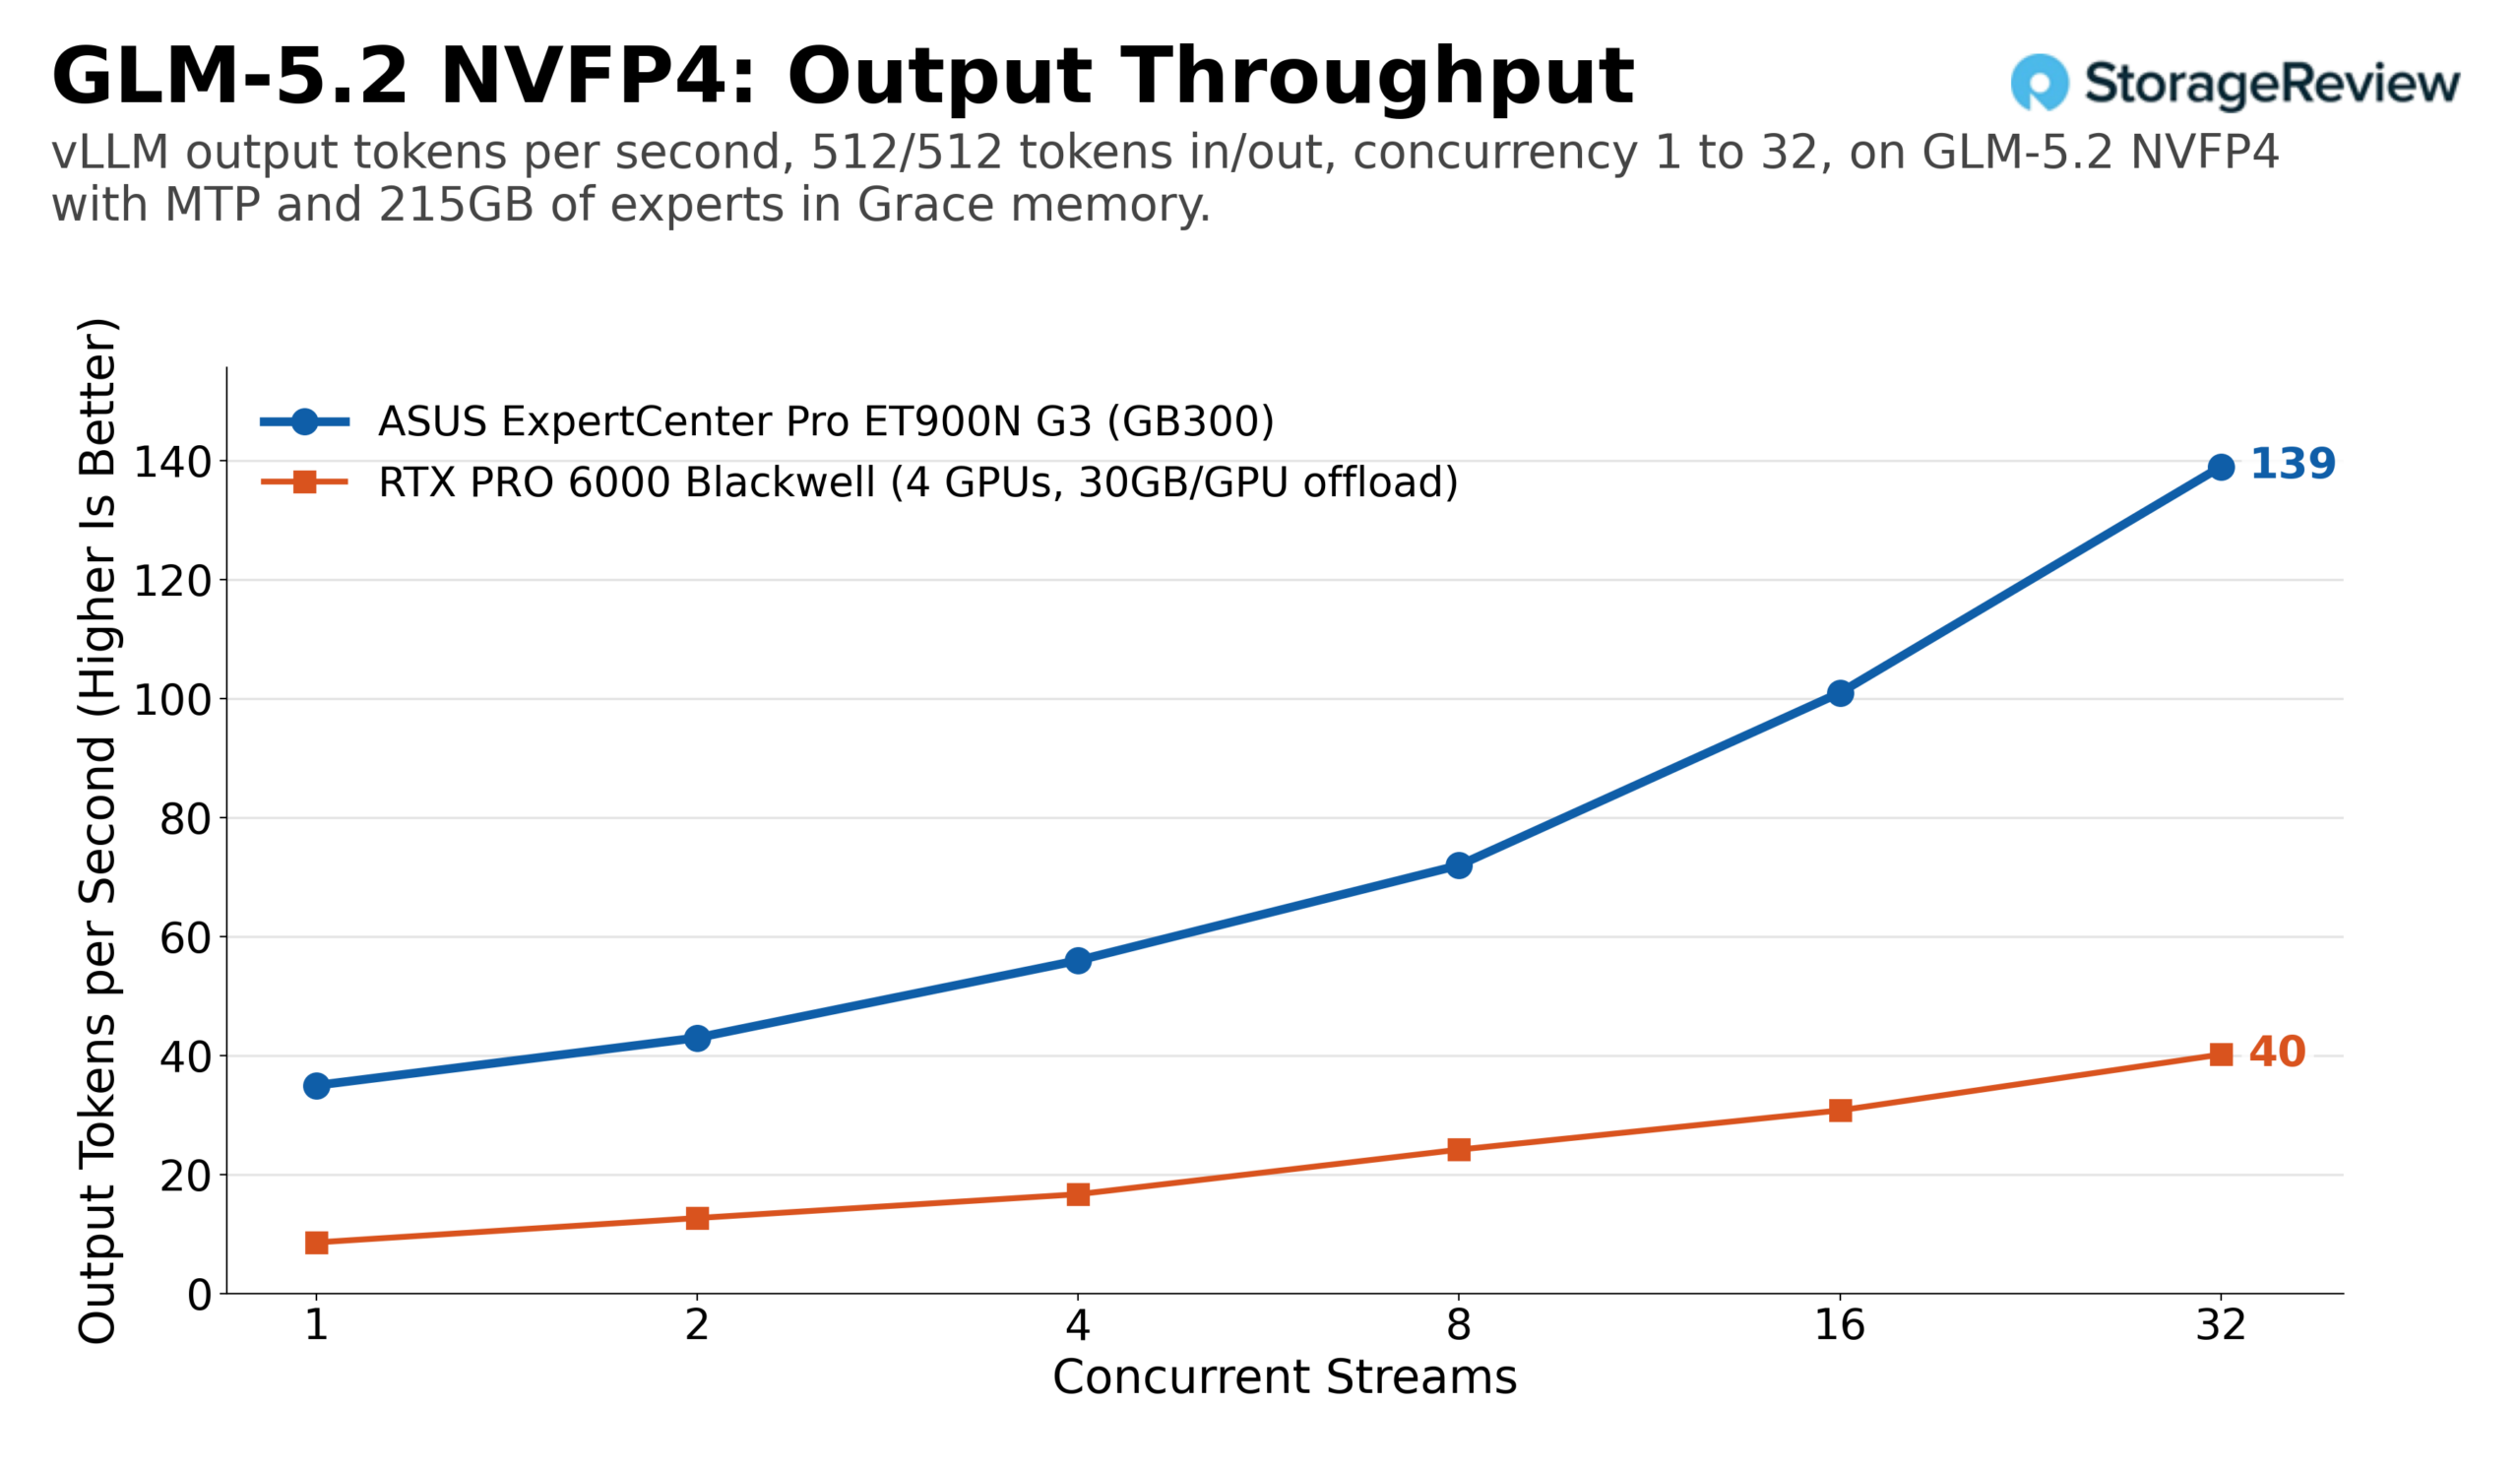
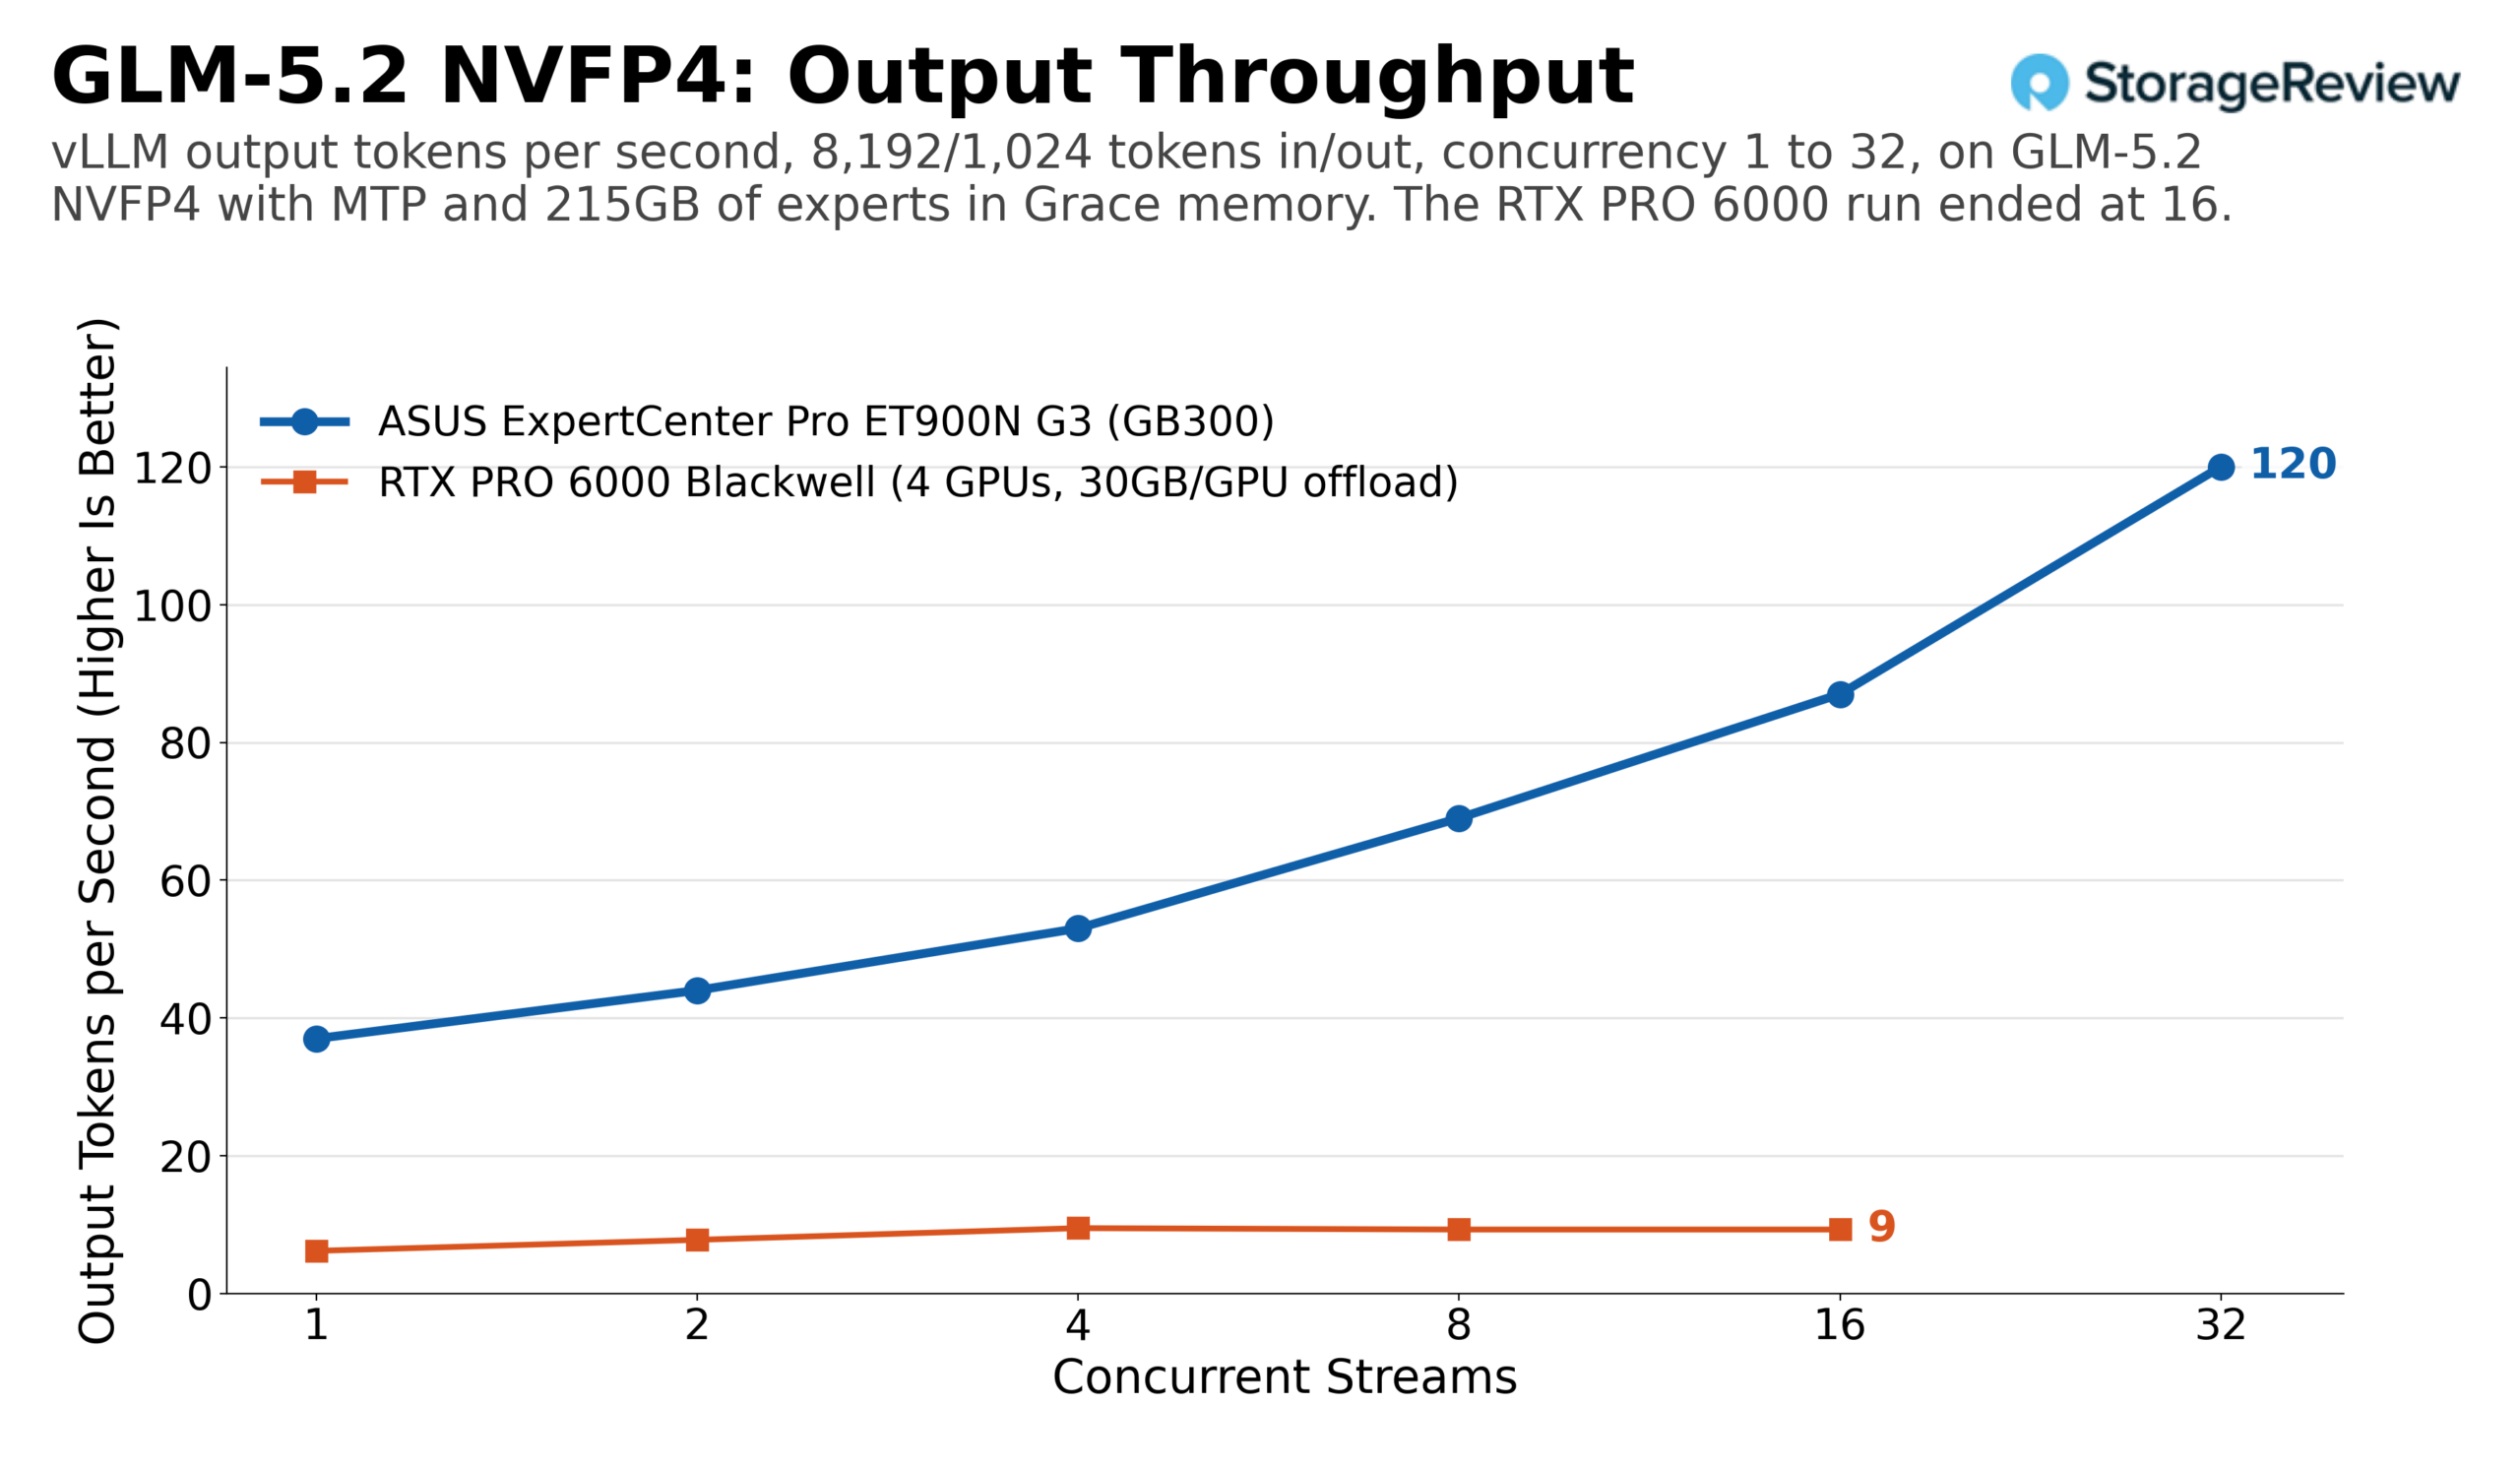
GLM-5.2 is het gebruiksscenario dat alleen mogelijk is met een coherente pool. Het NVFP4-checkpoint bewaart ongeveer 215 GB aan expertgewichten in het Grace-geheugen met MTP-speculatieve decodering, en de ET900N G3 verwerkte dit met 35 uitvoertokens per seconde voor één stream en 139 voor 32 streams bij een gelijke werkbelasting, met een totale doorvoer van 277. Op het profiel met veel prefill draaide de sweep tot 32 streams, waarbij 120 uitvoertokens per seconde en in totaal 1,079 tokens werden bereikt. Vier RTX PRO 6000-kaarten, die elk ongeveer 30 GB naar het hostgeheugen overzetten, haalden ongeveer 40 uitvoertokens per seconde bij 32 streams, wat afvlakte tot ongeveer 9 à 10 bij langere prompts vanaf vier streams. Geen van beide systemen zorgt ervoor dat een model met 433 GB snel aanvoelt, maar de 396 GB/s LPDDR5X en 900 GB/s NVLink-C2C-verbinding van de GB300 naar offloaded experts zorgt ervoor dat het systeem blijft schalen waar hostgeheugen via PCIe met vier kaarten stopt.
In vergelijking met de MSI WS300 liggen de resultaten van het grensmodel van de ET900N G3 op elk vergelijkingspunt binnen ongeveer 1%: 1,766 uitvoertokens per seconde op DeepSeek V4 Flash bij 32 streams op beide towers, 4,793 versus 4,801 op MiniMax M2.7 bij 128 streams, 1,041 op MiniMax M3 bij 32 streams op beide towers, en 139 op GLM-5.2 bij 32 streams op beide towers.
Gedeelde modellen met de RTX PRO 6000, H200 NVL en DGX Spark.
De tweede helft van de benchmarktests maakt gebruik van modellen die klein genoeg zijn voor elk systeem: GPT-OSS-20B en 120B in native MXFP4; Llama 3.1 8B in BF16 en FP8; Mistral Small 24B in BF16 en FP8; en Qwen3 Coder 30B in BF16 en FP8. Nieuw sinds de review van de WS300 is een enkele H200 NVL, NVIDIA's 141GB Hopper-kaart, die de vergelijking een datacenteraccelerator van een generatie ouder geeft.
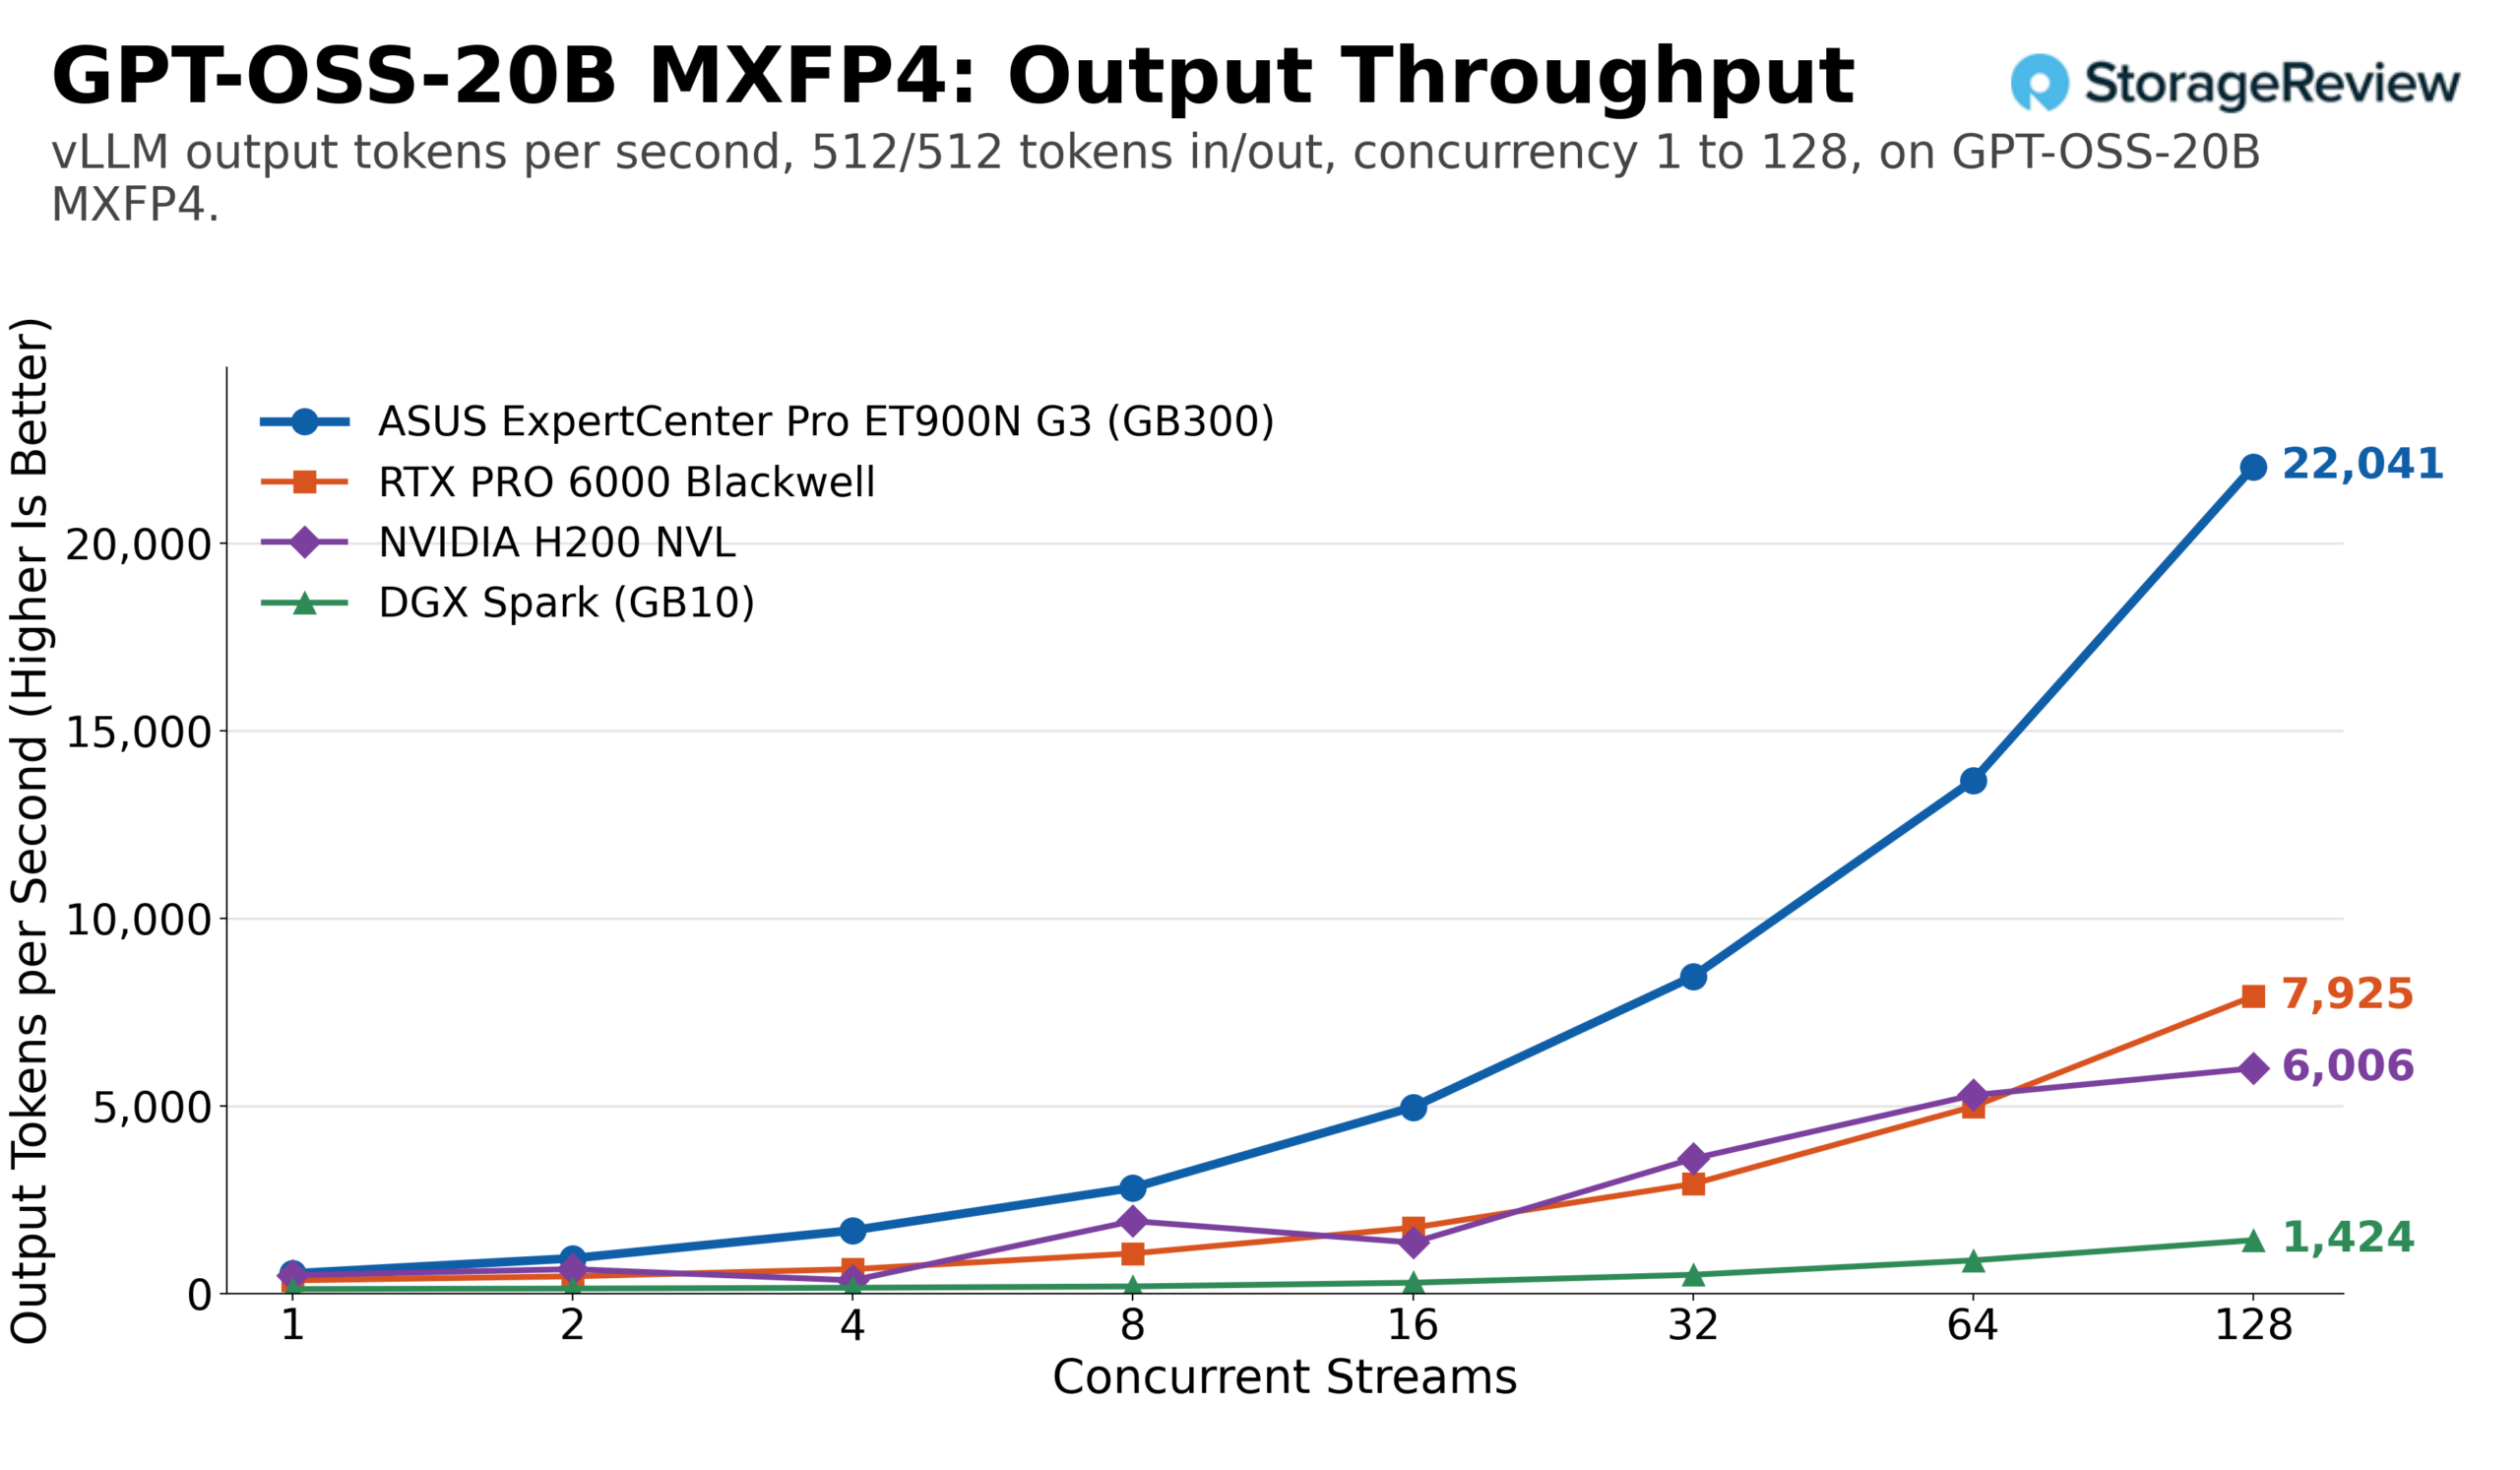
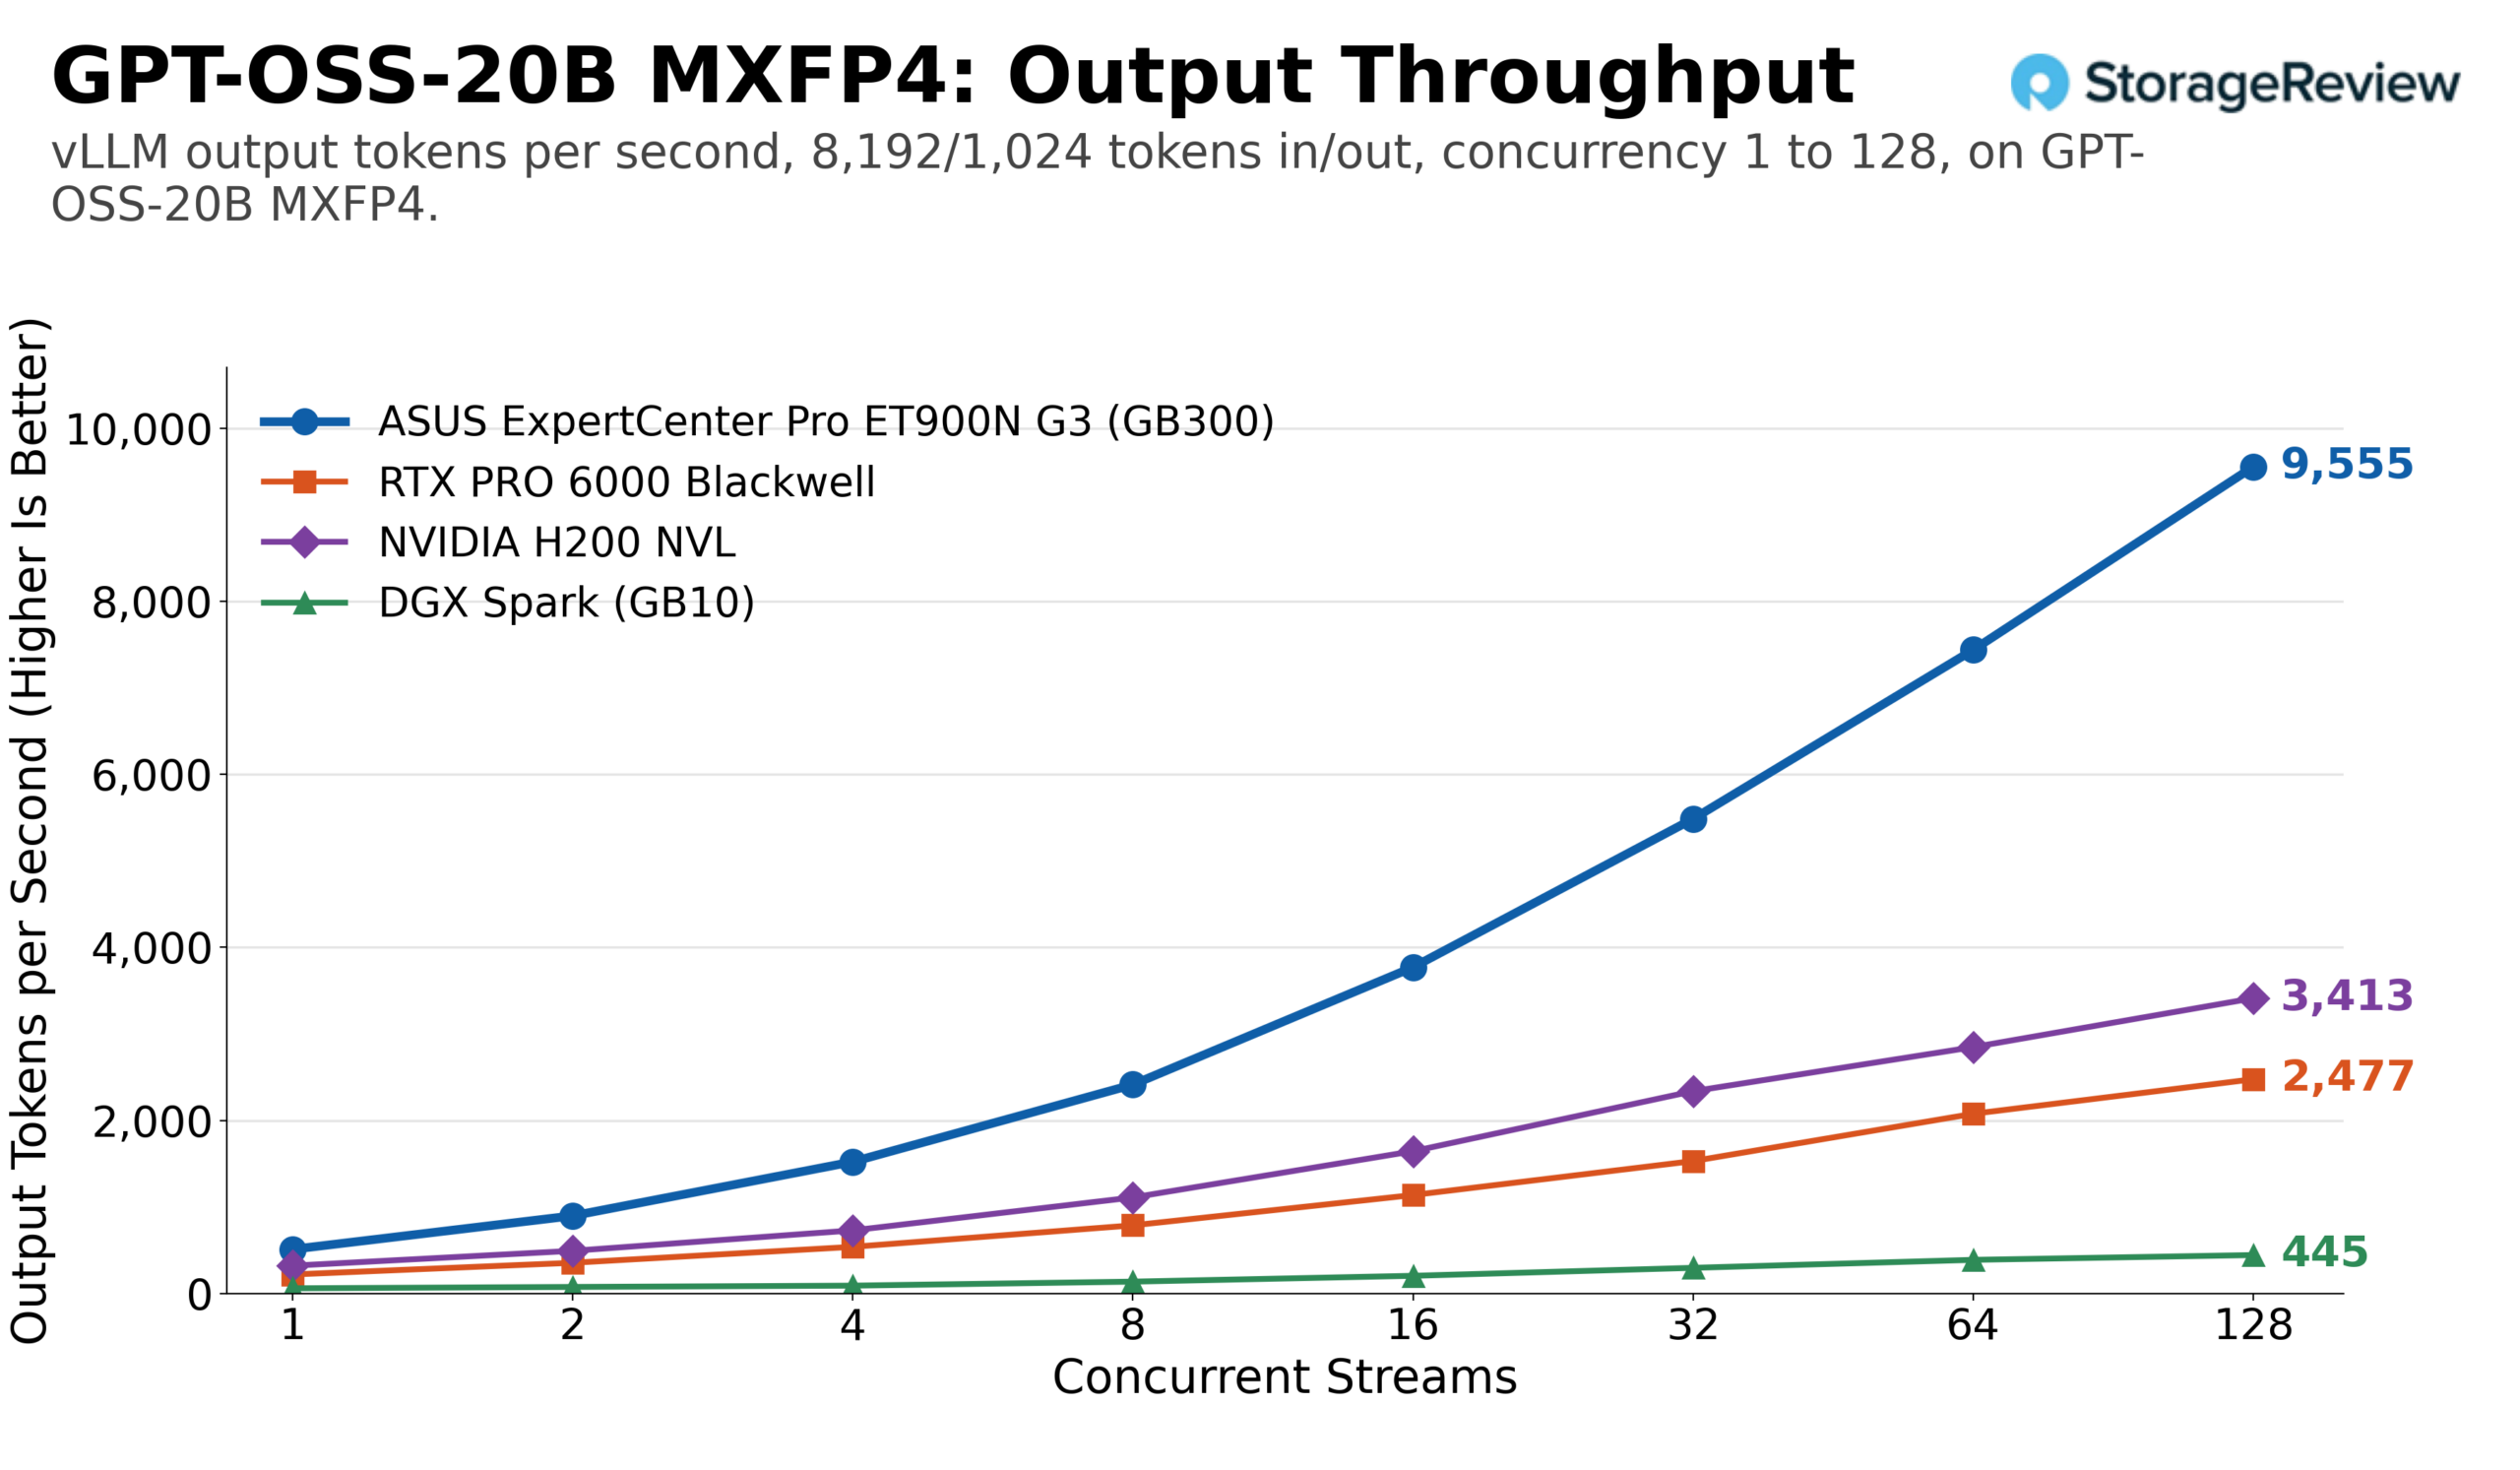
GPT-OSS-20B is de meest toegankelijke test van de reeks, een controlepunt dat elk systeem met gemak aankan. Bij een gelijke werkbelasting schaalde de ET900N G3 op naar 22,041 uitvoertokens per seconde bij 128 streams, ofwel 44,082 in totaal, tegenover ongeveer 7,920 voor de RTX PRO 6000, 6,010 voor de H200 NVL en 1,420 voor de DGX Spark. In de modus met één stream produceerde de Station 536 uitvoertokens per seconde, vergeleken met 354 voor de kaart, 489 voor de H200 en 120 voor de Spark. Het profiel met veel prefill vergrootte het verschil: 9,555 uitvoertokens per seconde en 85,994 in totaal bij 128 streams voor de Station, terwijl de RTX PRO 6000 op ongeveer 2,480 uitkwam, de H200 NVL op 3,410 en de Spark op 445.
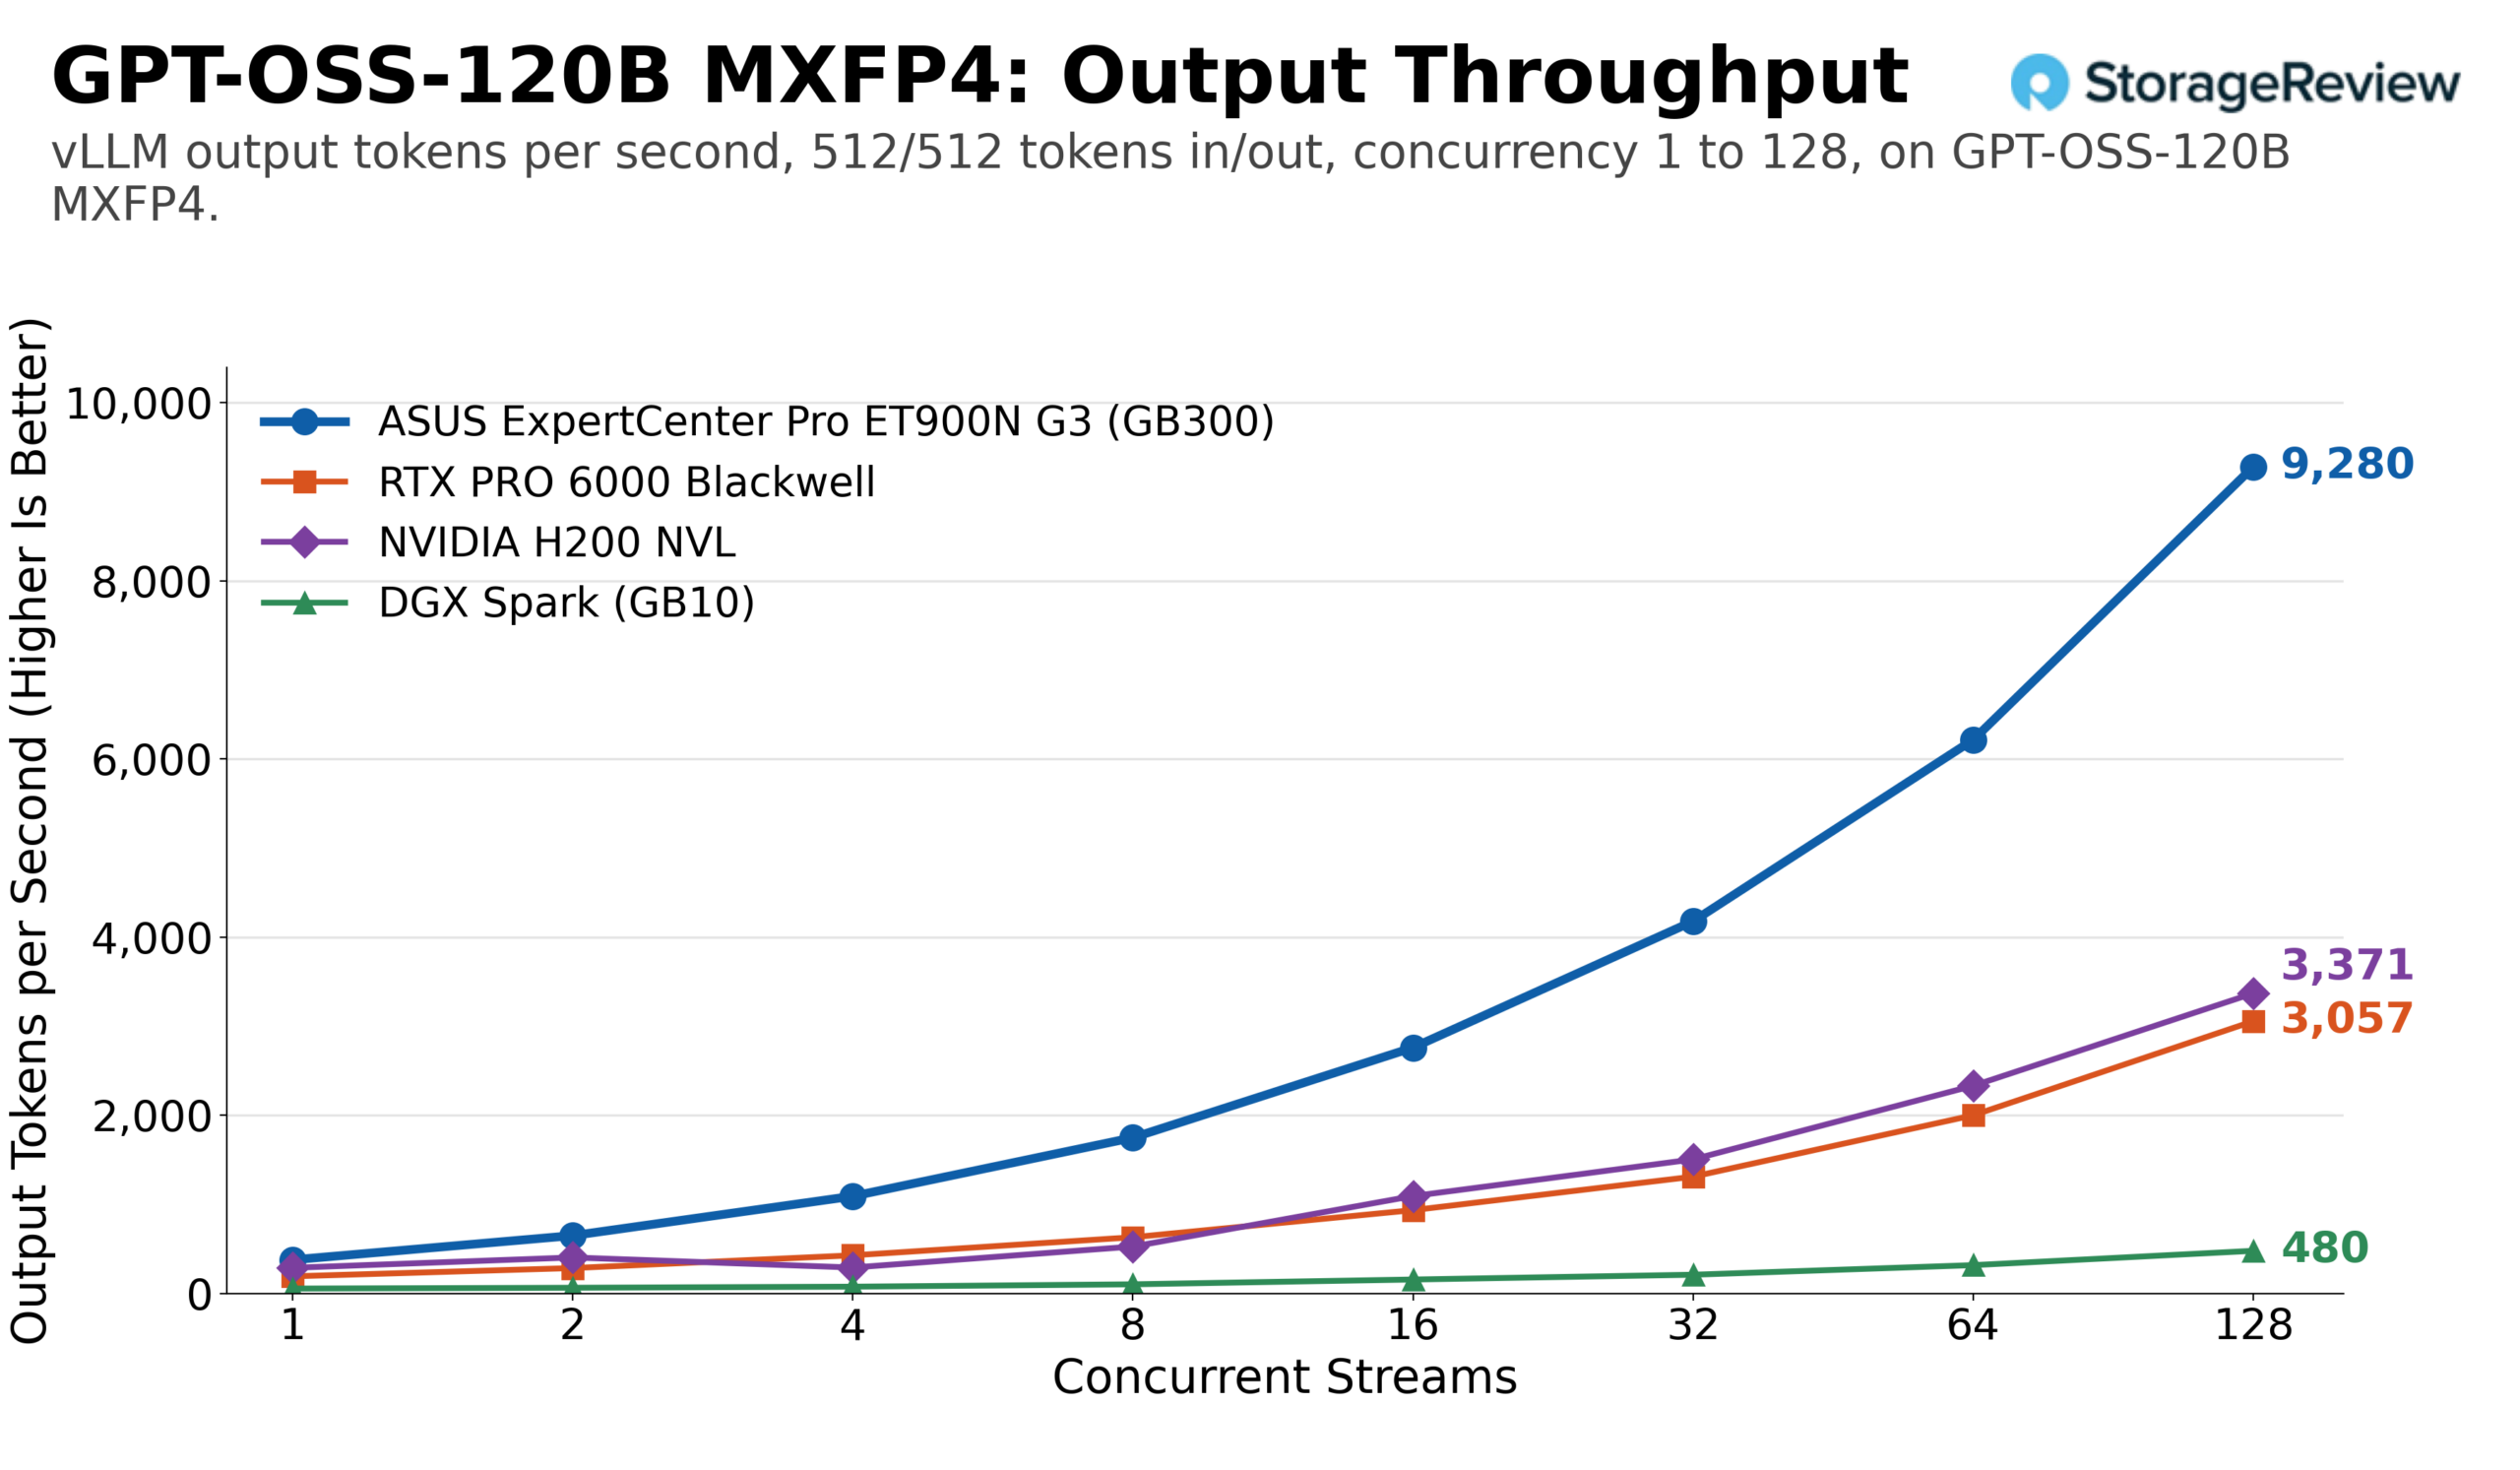
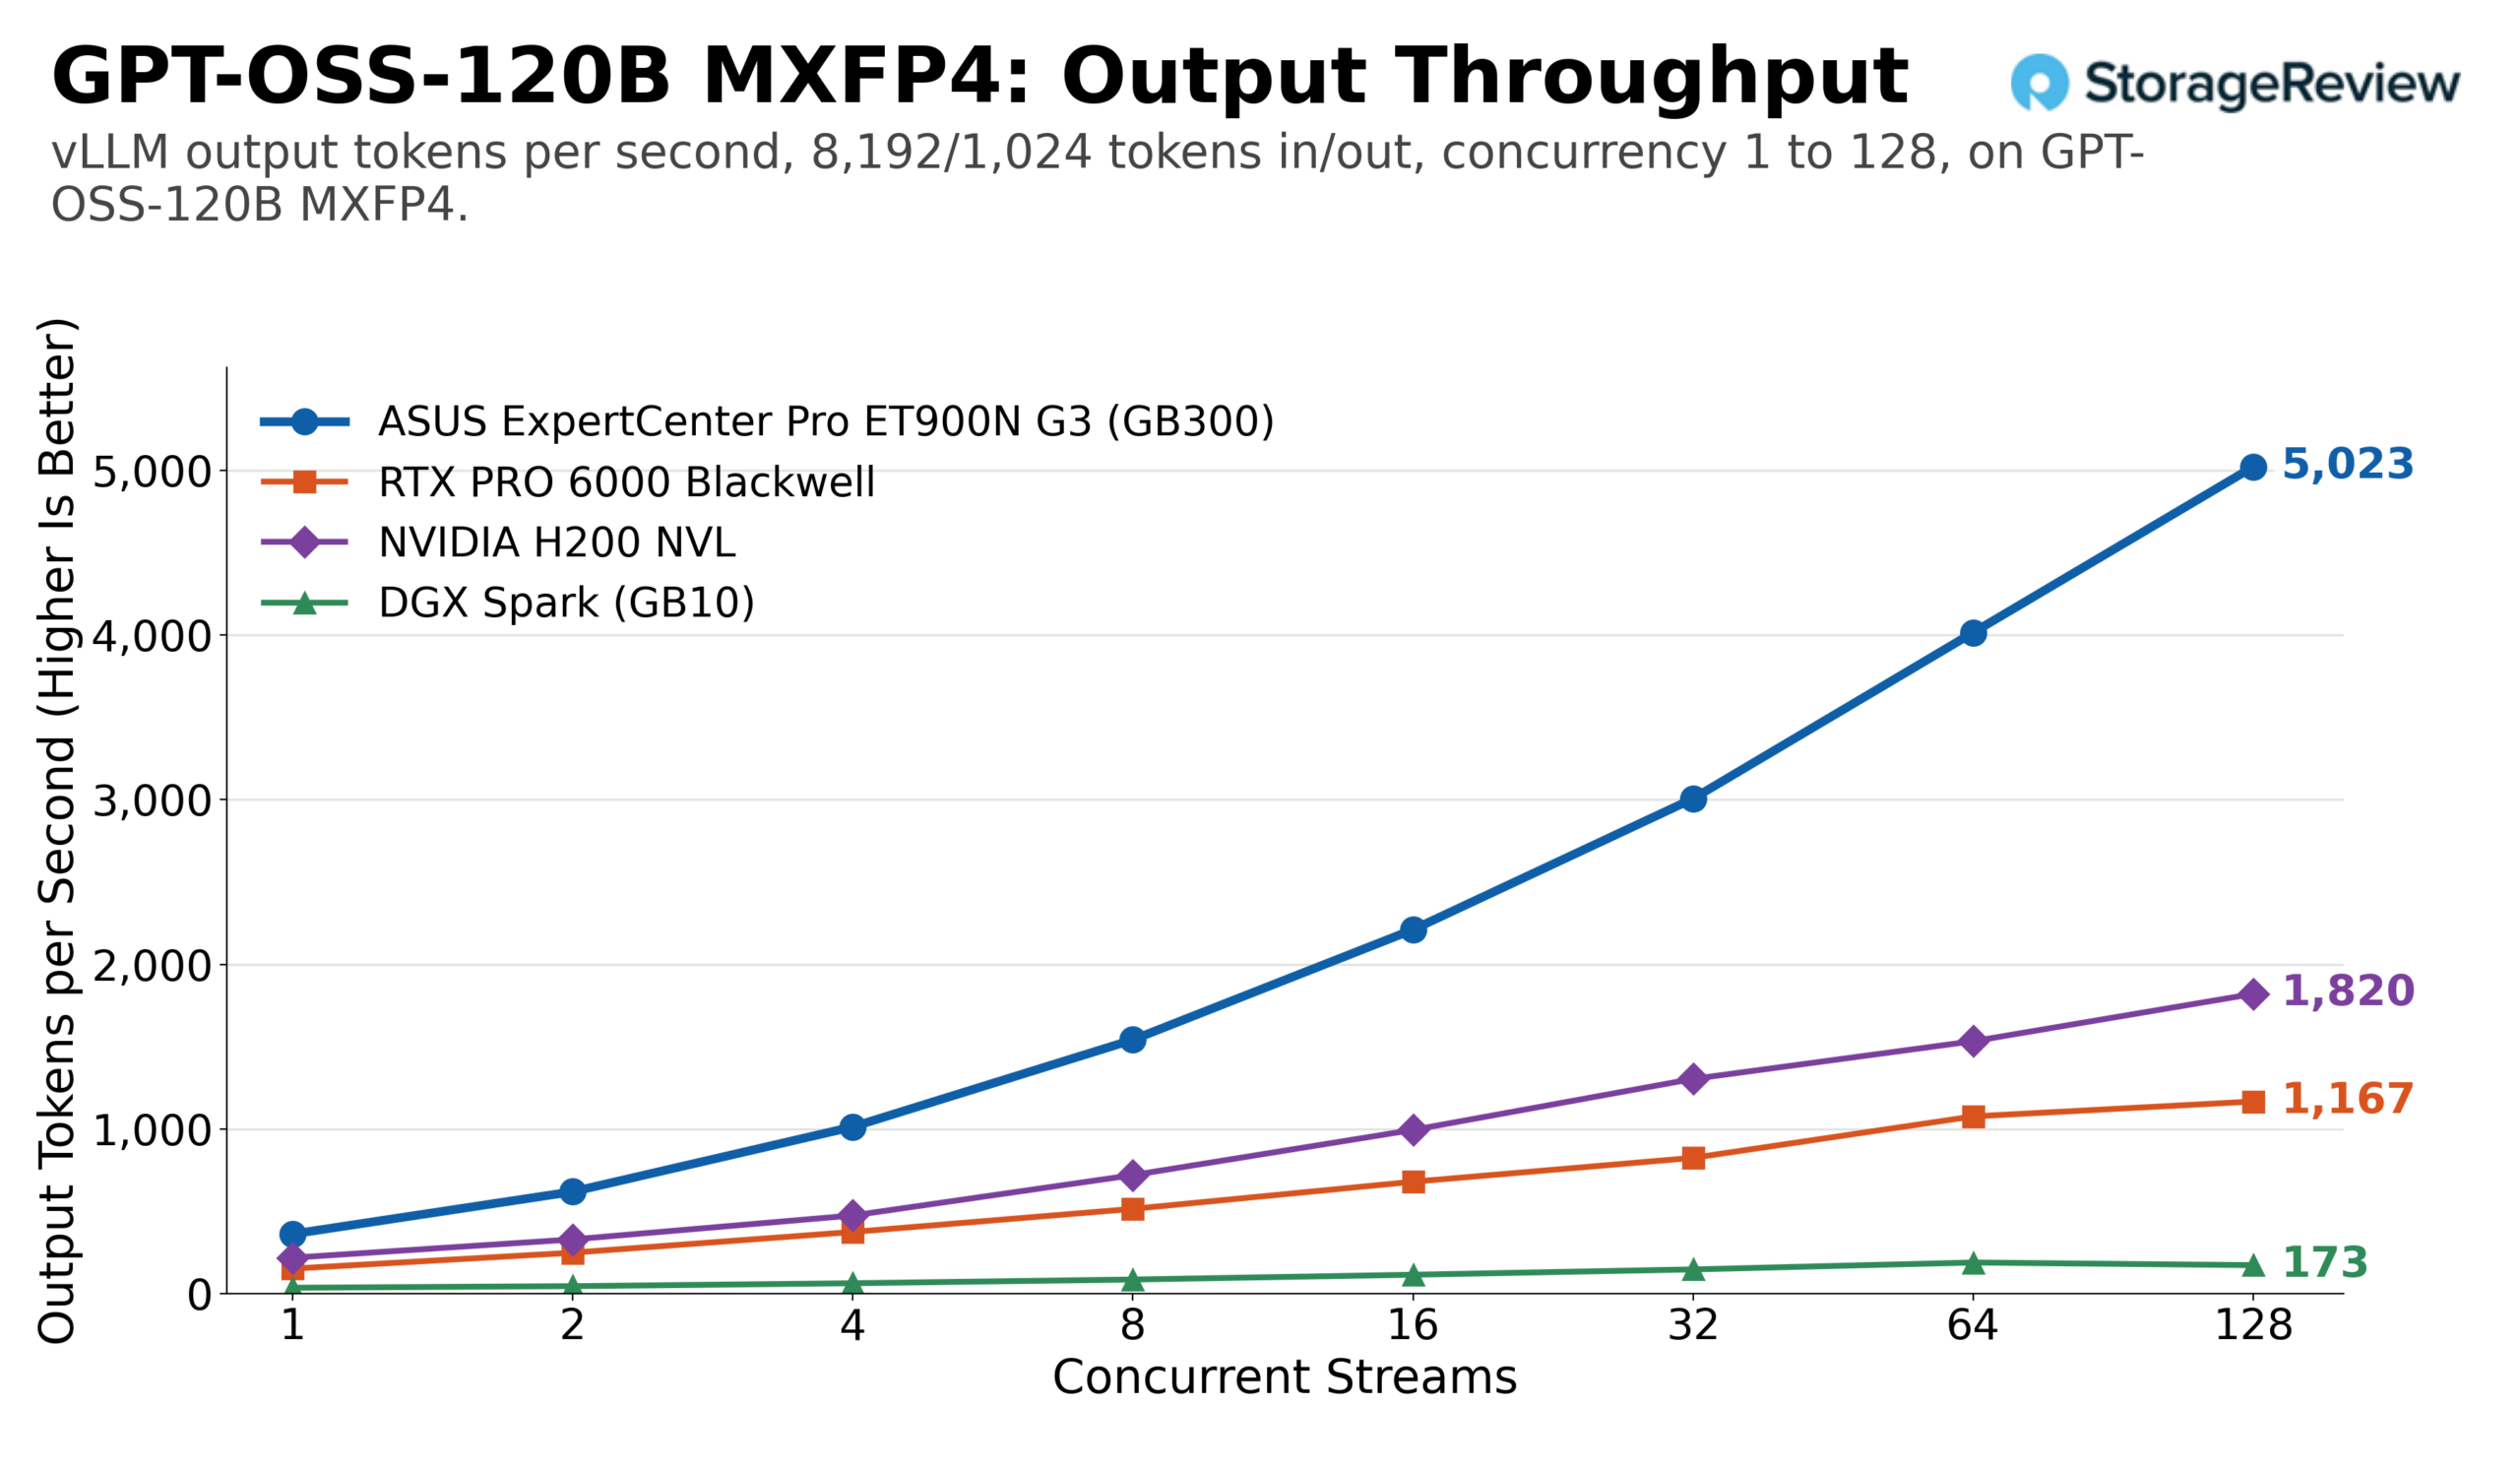
GPT-OSS-120B is waar het geheugen begint met het sorteren van het veld. De ET900N G3 bereikte 9,280 uitvoertokens per seconde bij dezelfde werklast met 128 streams, ongeveer drie keer zoveel als de RTX PRO 6000 met 3,060, 2.8 keer zoveel als de H200 NVL met 3,370 en meer dan 19 keer zoveel als de Spark met 480. Bij lange prompts raakten de kleinere systemen al snel door hun KV-cachecapaciteit heen: de RTX PRO 6000 bereikte een maximum van ongeveer 1,170 uitvoertokens per seconde en de H200 NVL bijna 1,820, terwijl de Station nog steeds aan het oplopen was met 128 streams en eindigde op 5,023, met een totale doorvoer van 45,205 tokens per seconde.
Llama 3.1 8B bij FP8 is het hoogste individuele getal in de set. De ET900N G3 verwerkte 25,602 outputtokens per seconde over 128 streams met dezelfde workload, in totaal 51,205, vergeleken met ongeveer 8,060 voor de RTX PRO 6000 en 11,040 voor de H200 NVL. De overstap van BF16 naar FP8 zorgde voor een prestatieverbetering van ongeveer 50% voor de Station (van 17,074 naar 25,602), terwijl de RTX PRO 6000 ongeveer 70% en de H200 NVL ongeveer 37% wonnen bij dezelfde verandering. Het profiel met veel prefill comprimeerde alles, met de Station op 6,164 outputtokens per seconde, de kaart op 1,480 en de H200 op 2,040.
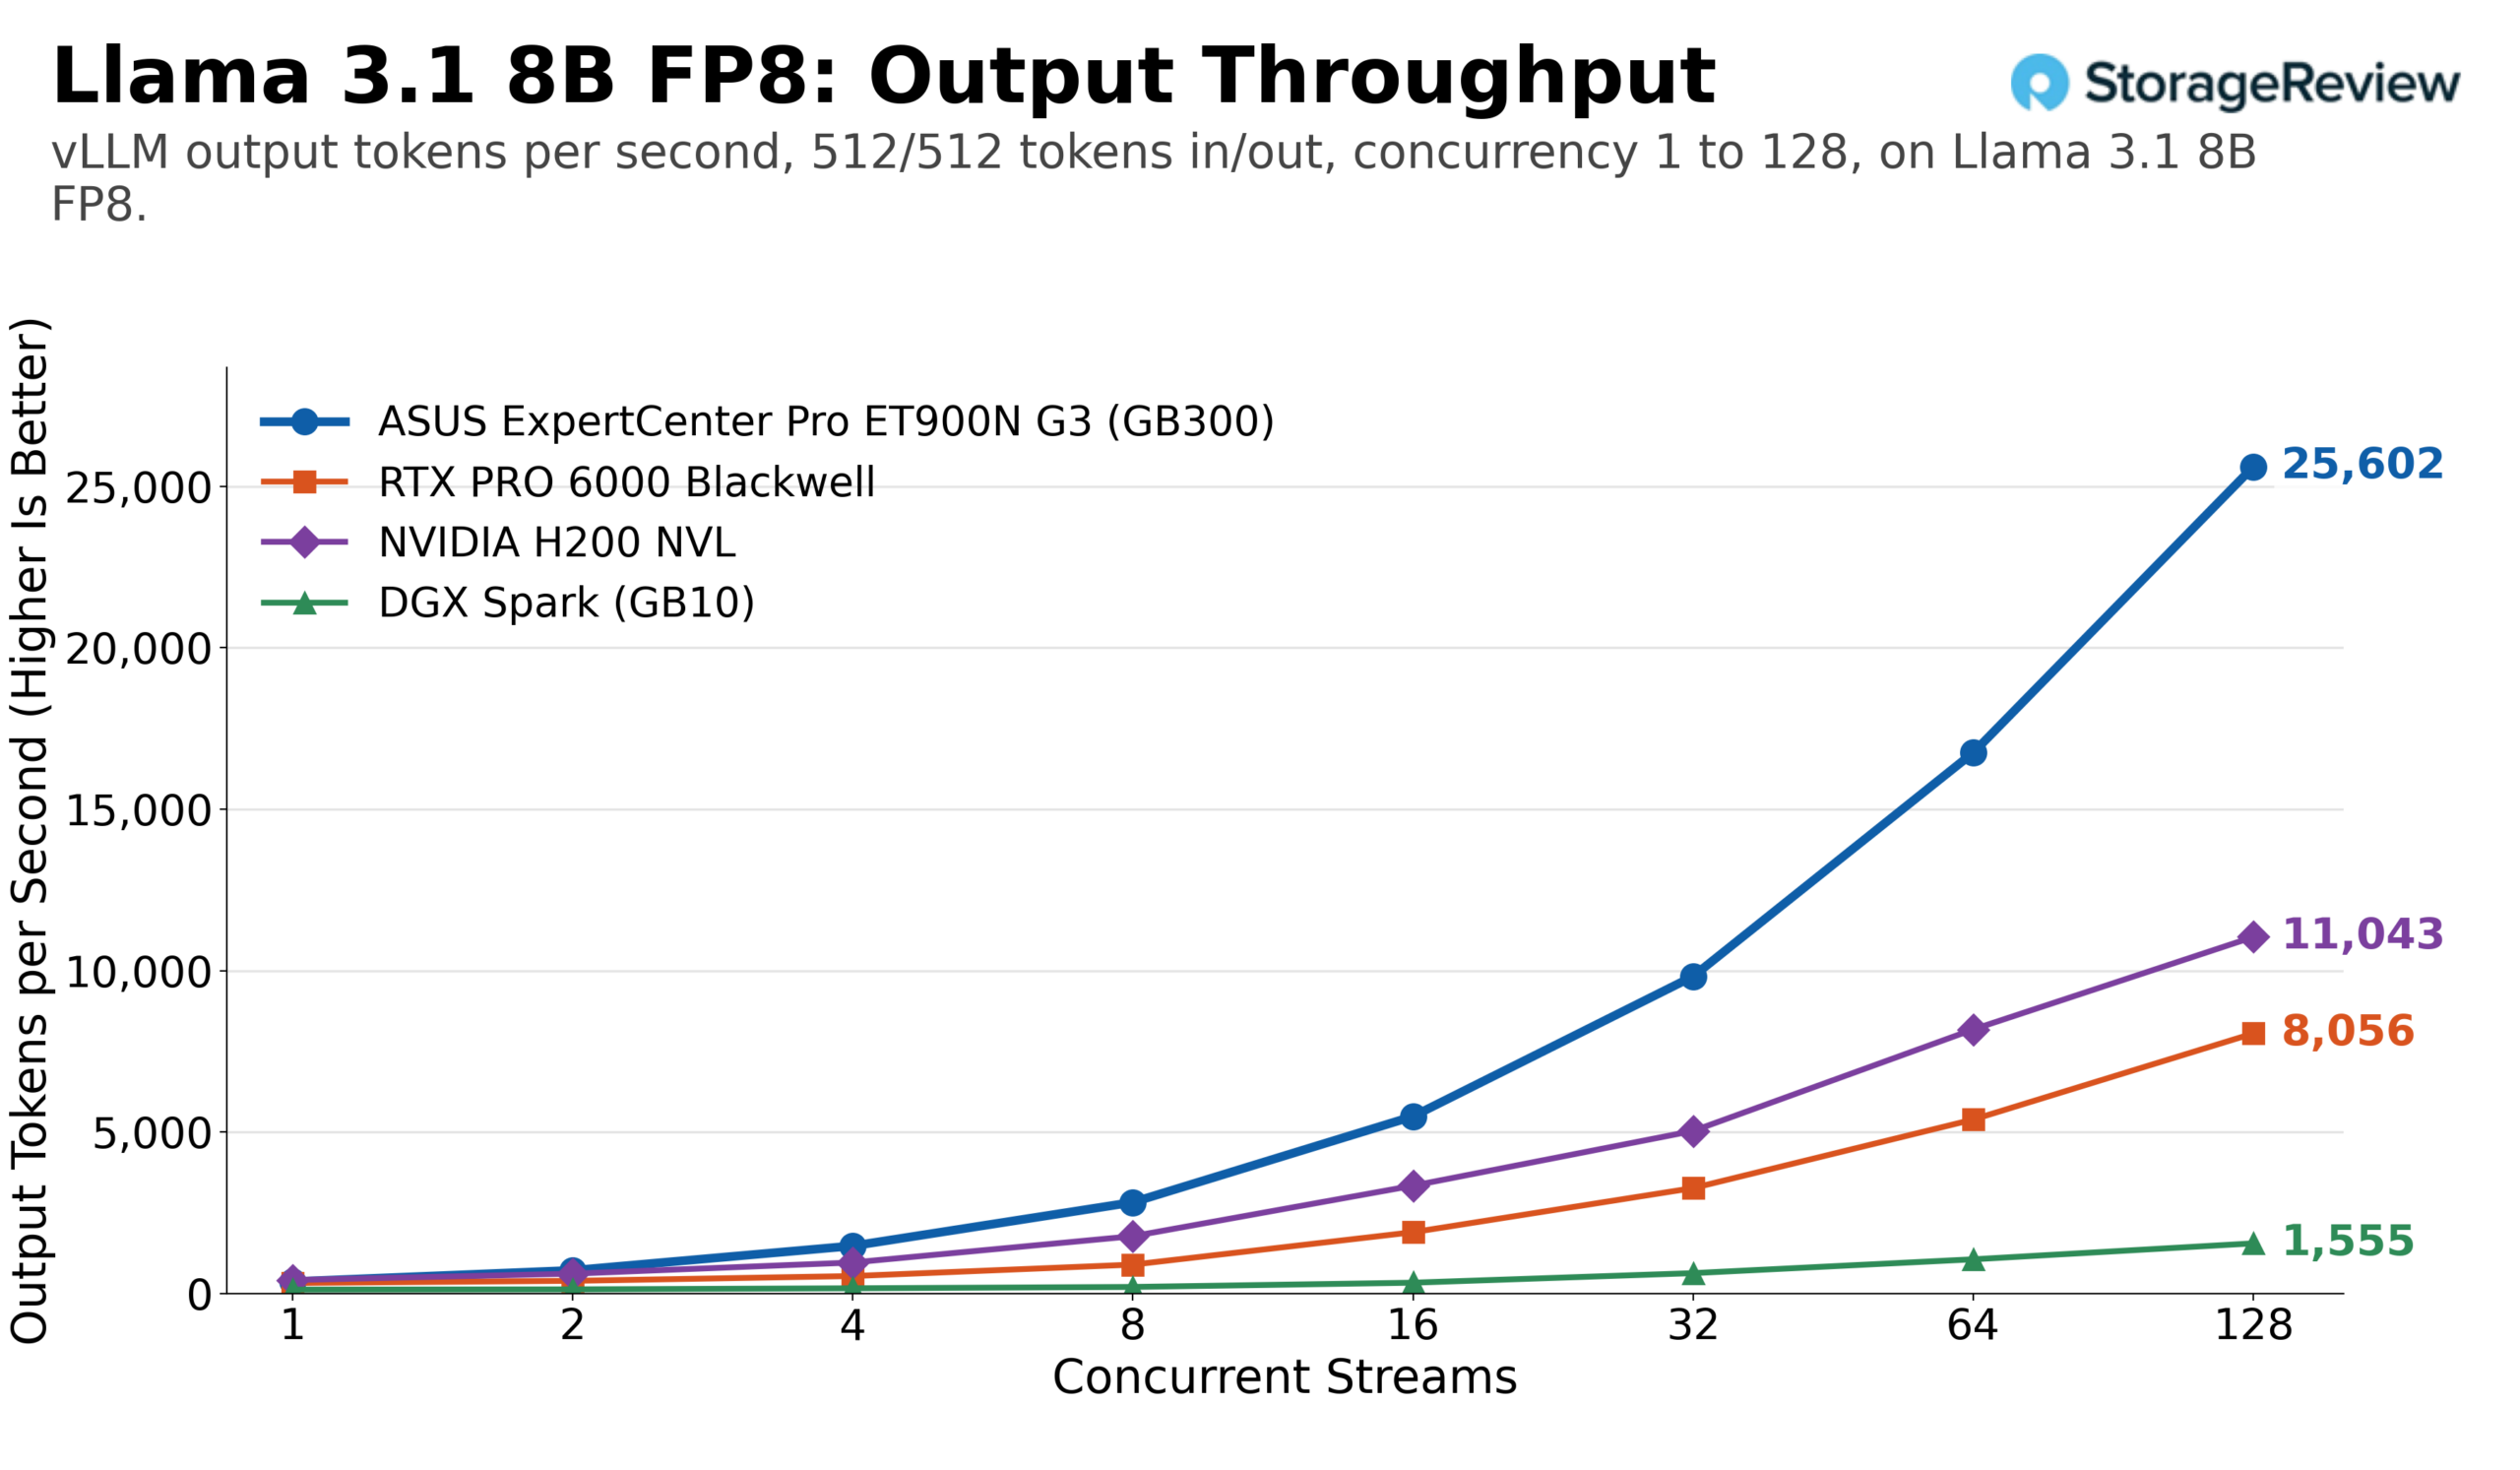
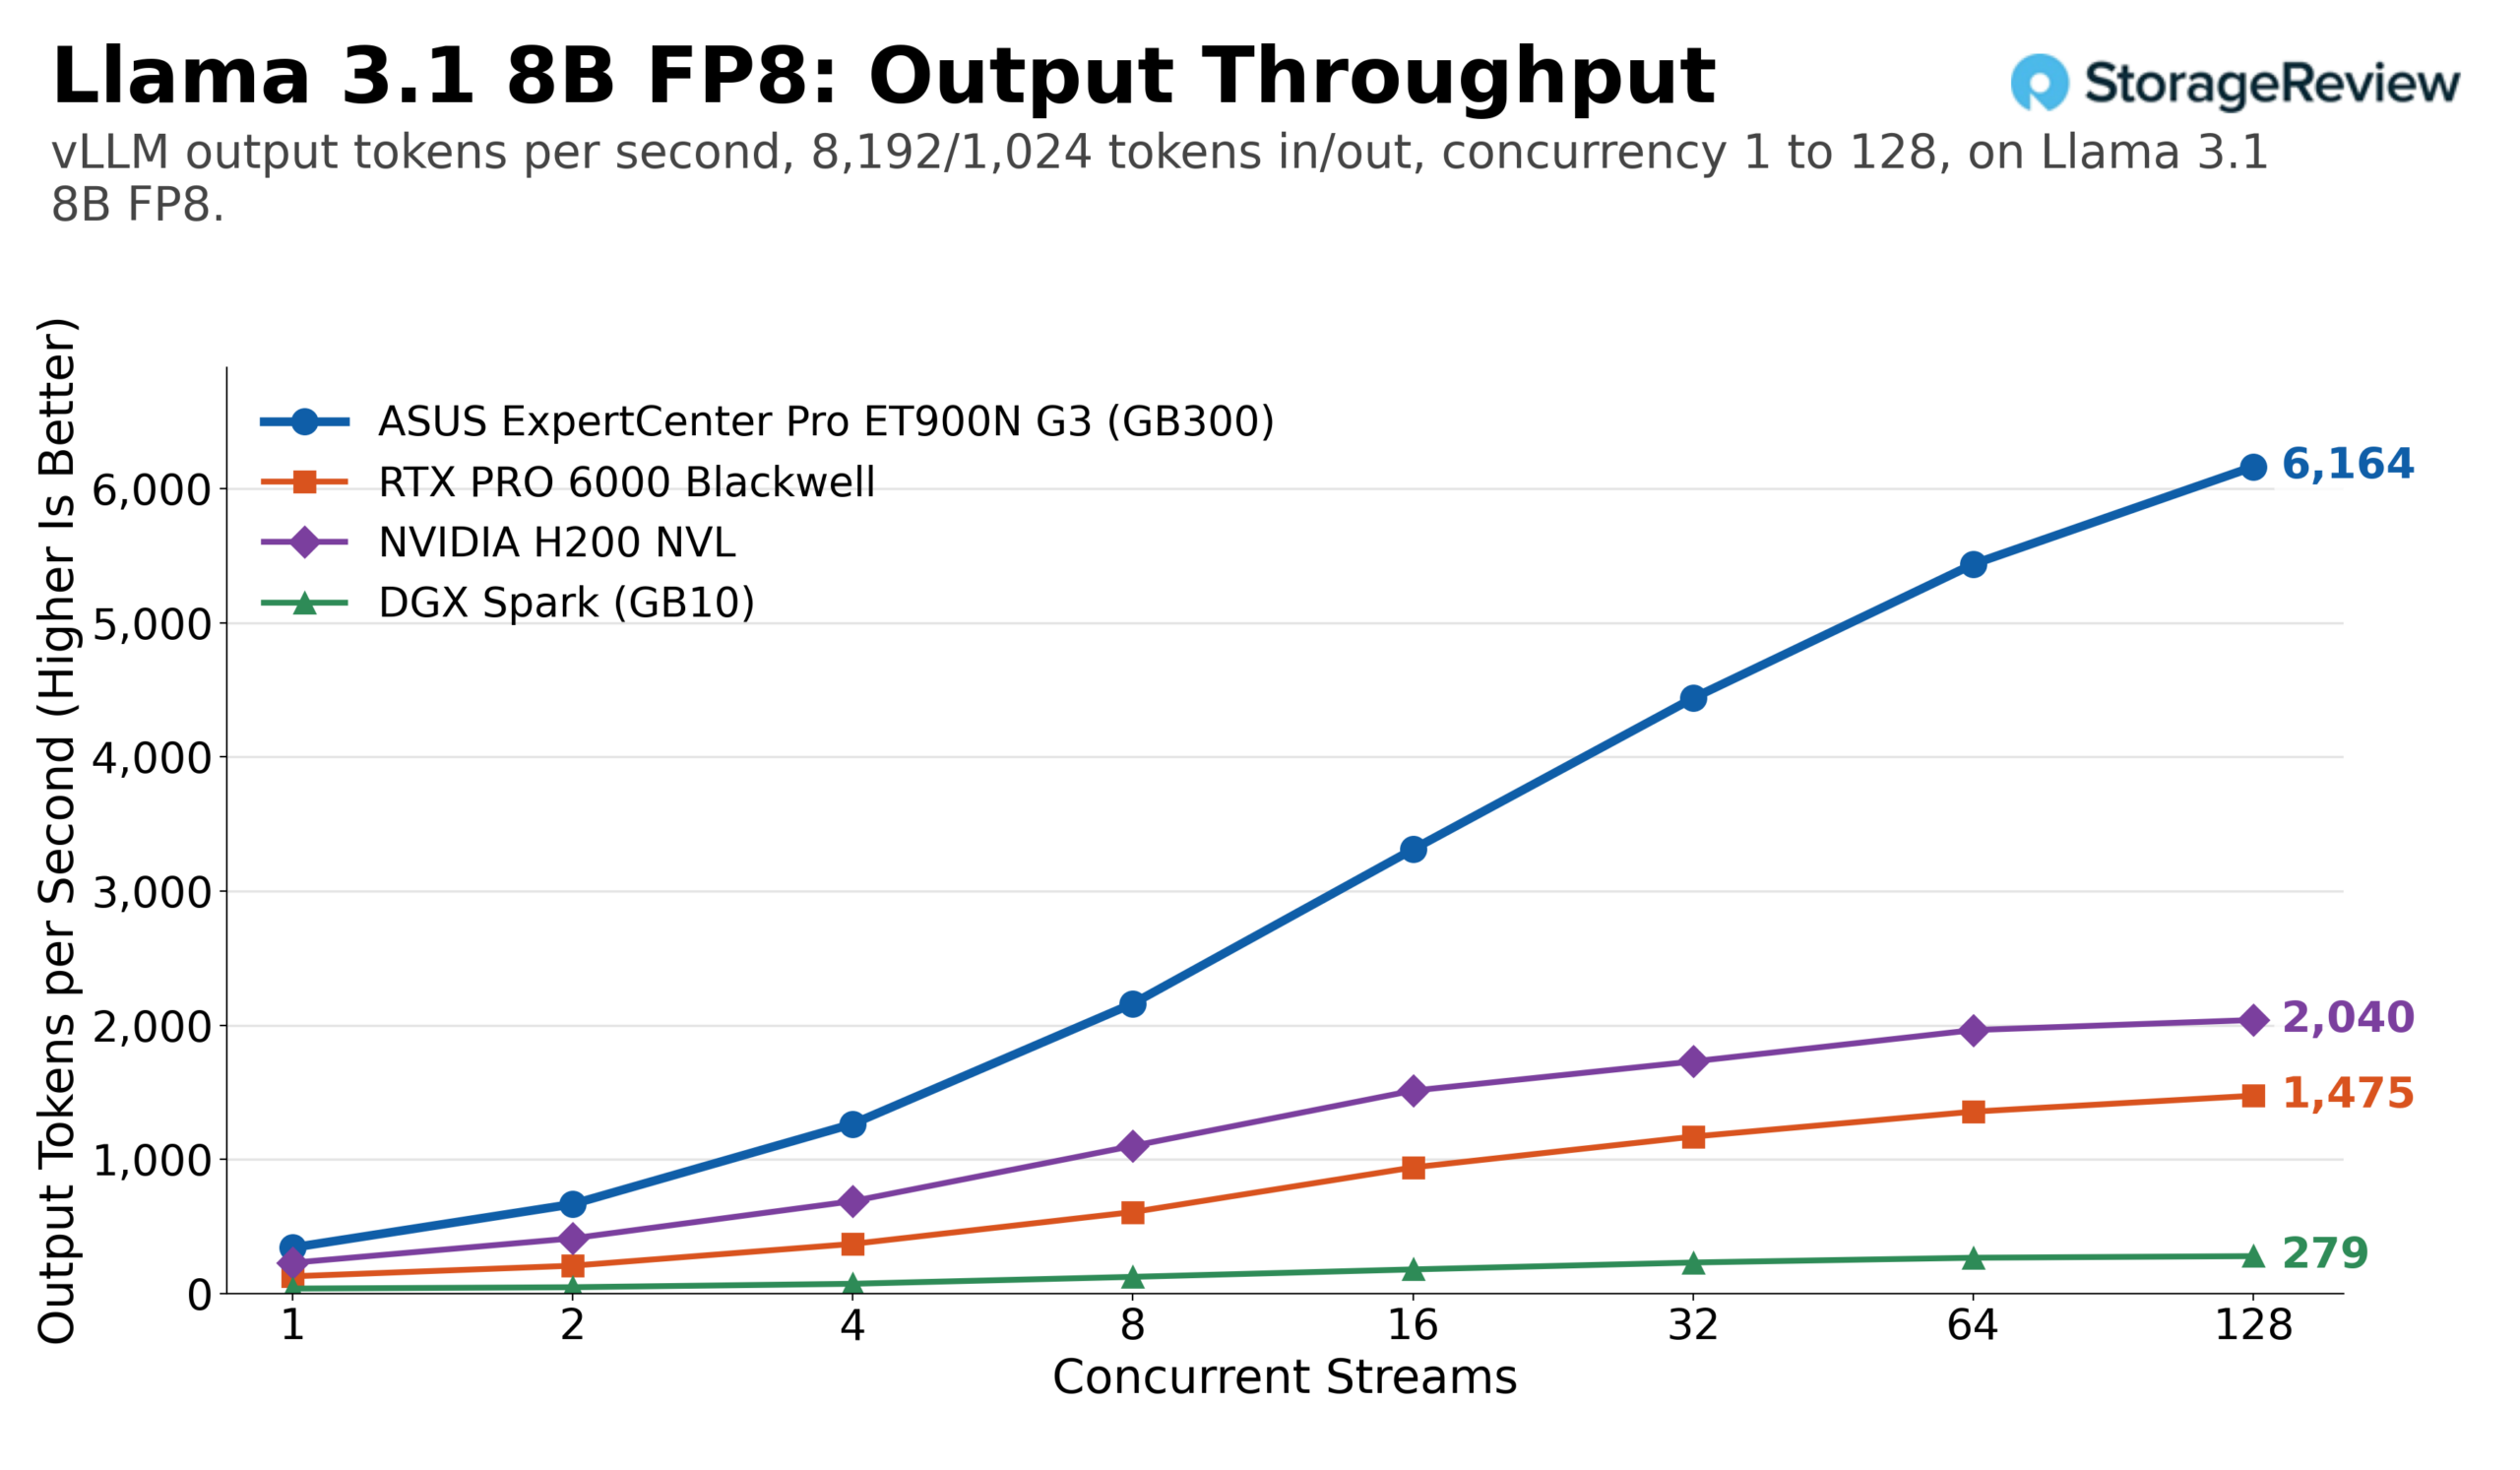
Mistral Small 24B produceerde bij FP8 de grootste prestatieverschillen. De ET900N G3 piekte op 11,075 uitvoertokens per seconde bij dezelfde werklast, 3.4 keer zoveel als de RTX PRO 6000 met 3,240, 2.4 keer zoveel als de H200 NVL met 4,610 en bijna 20 keer zoveel als de Spark met 559. Bij langere prompts piekte de RTX PRO 6000 op 32 streams en ongeveer 480 uitvoertokens per seconde voordat de prestaties terugvielen; de H200 NVL bereikte een maximum van ongeveer 854 en de Station haalde 2,302 bij 128 streams.


Qwen3 Coder 30B, een model met een mix van experts en een klein aantal actieve parameters, laat zien waar het verschil bij één stream kleiner wordt. Bij één stream en een gelijke werkbelasting leverde de RTX PRO 6000 ongeveer 232 uitvoertokens per seconde, tegenover 319 voor de Station en 308 voor de H200 NVL. Batchverwerking herstelt de volgorde: bij 128 streams bereikte de ET900N G3 12,439 uitvoertokens per seconde bij FP8, 3.1 keer zoveel als de kaart met 3,990 en 1.7 keer zoveel als de H200 NVL met 7,450. Op het profiel met veel prefill bereikte de Station 3,837 uitvoertokens per seconde, terwijl de RTX PRO 6000 piekte op ongeveer 880 bij 64 streams en de H200 NVL op ongeveer 1,820.


Bij de gedeelde modellen presteerde de ET900N G3 2.8 tot 3.4 keer beter dan een enkele RTX PRO 6000 en 1.7 tot 3.7 keer beter dan een H200 NVL bij volledige gelijktijdigheid. Het verschil met beide werd groter bij langere prompts, omdat de KV-cachecapaciteit opraakte. Ten opzichte van de WS300 lagen deze vier wederom binnen 1%: 22,041 versus 22,161 op GPT-OSS-20B, 9,280 versus 9,294 op GPT-OSS-120B, 11,075 versus 11,157 op Mistral Small FP8 en 12,439 versus 12,425 op Qwen3 Coder FP8. De volledige vergelijking van 14 modellen, inclusief de drie modellen met de grootste verschillen, vindt u in het volgende gedeelte.
Twee towers, één basisplaat: ASUS ET900N G3 versus MSI WS300
De ET900N G3 en de MSI XpertStation WS300 gebruiken hetzelfde NVIDIA GB300 DGX Station-moederbord in twee verschillende OEM-behuizingen. Beide kaarten zijn getest met dezelfde 14 modellen, dezelfde twee workloads en dezelfde gelijktijdigheidstest in dezelfde vLLM-build. De onderstaande grafiek vergelijkt de piekdoorvoer van de ET900N G3 over alle modellen met die van de WS300.
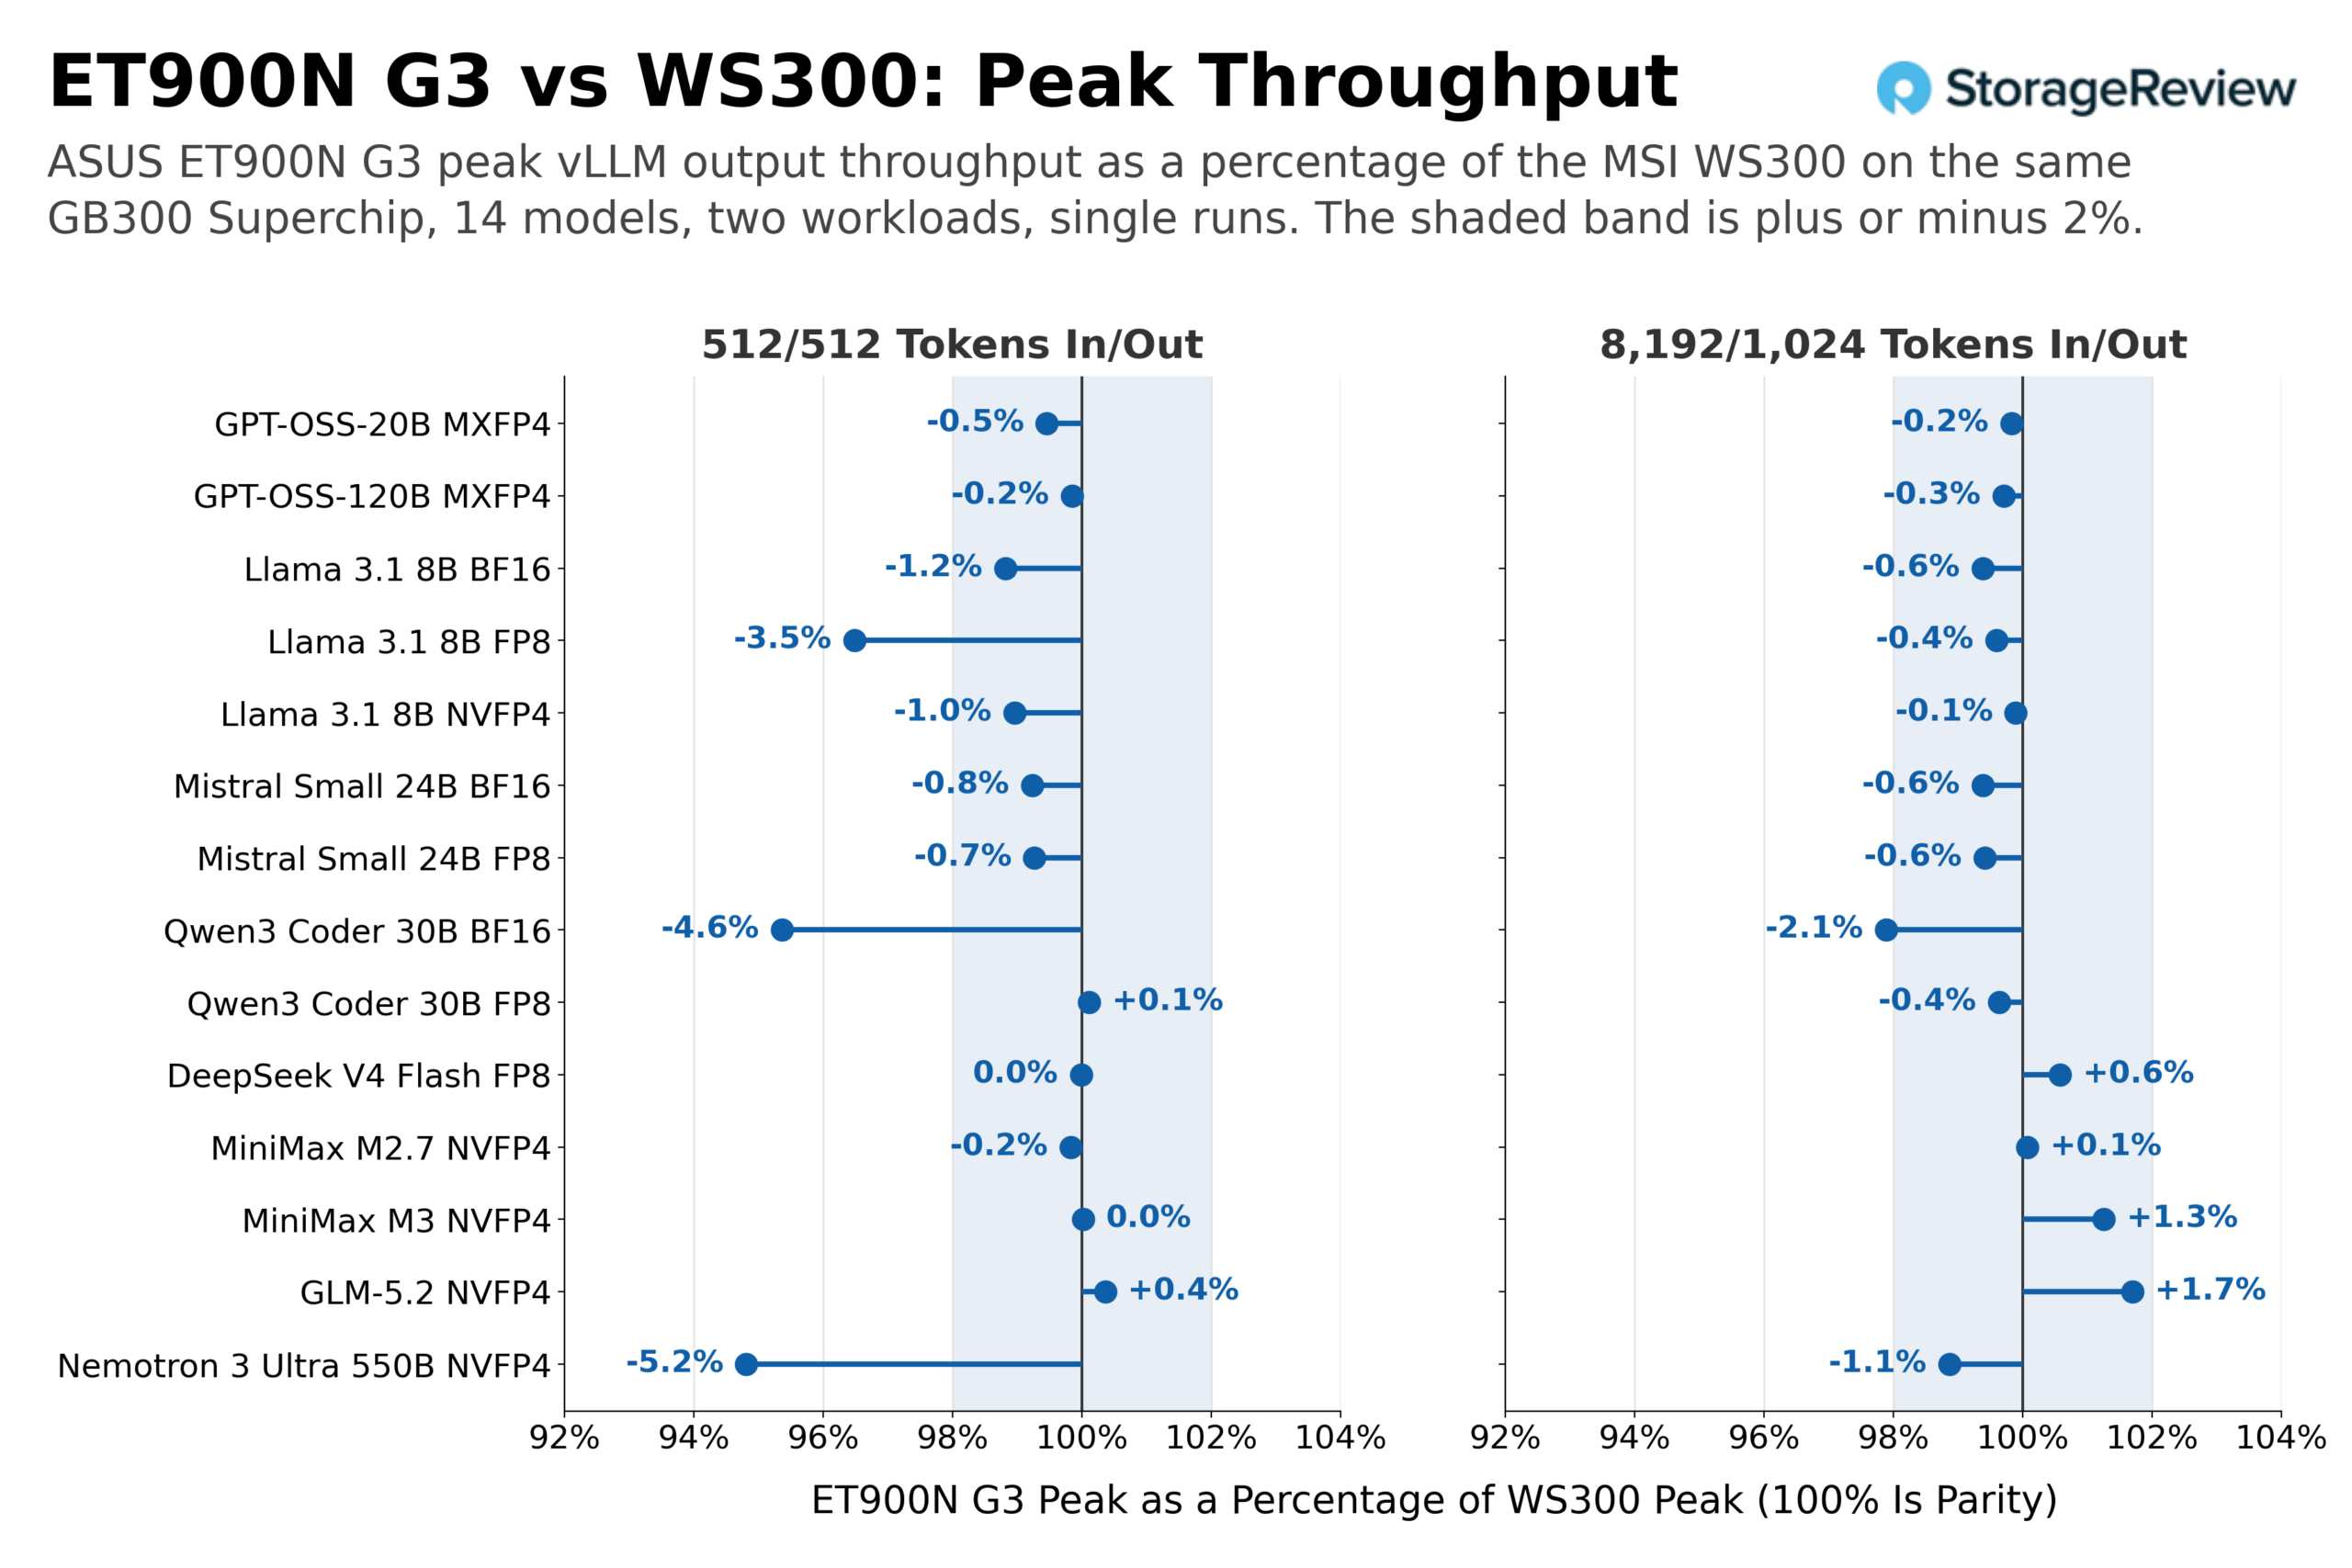
Van de 28 model-werkbelastingcombinaties liggen er 24 binnen 2% van elkaar, en de meeste daarvan zijn een fractie van een procent in het voordeel van de WS300. Vier combinaties vallen buiten die marge, waarvan drie bij dezelfde werkbelasting: Llama 3.1 8B FP8 met 3.5% minder dan de WS300 (25,602 versus 26,536 uitvoertokens per seconde), Qwen3 Coder 30B BF16 met 4.6% minder (10,000 versus 10,486) en Nemotron 3 Ultra 550B met 5.2% minder (159 versus 168), plus Qwen3 Coder 30B BF16 nogmaals met 2.1% minder bij de lange prompts. Elk cijfer hier is gebaseerd op één run op elke tower, dus een verschil van 2 tot 5% tussen drie van de veertien modellen kunnen we niet zomaar aan het chassis toeschrijven; We noteren alleen de gegevens en het verschil tussen de twee. De modellen die gebruikmaken van de coherente geheugenpool, MiniMax M3 en GLM-5.2, presteren gelijkwaardig of beter bij beide workloads; dat is volgens ons het resultaat dat het belangrijkst is voor het platform: het Grace-offloadpad presteert in de ASUS-behuizing hetzelfde als in de MSI-behuizing.
| Model | WS300 512/512 | ET900N G3 512/512 | Delta | WS300 8,192/1,024 | ET900N G3 8,192/1,024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Llama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Llama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Qwen3 Coder 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Qwen3 Coder 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, het dichtstbevolkte geval met de hoogste doorvoer in de reeks, en GLM-5.2, het offload-geval, laten de overlap zien zonder verhouding: in beide gevallen volgt de WS300 de ET900N G3 punt voor punt.
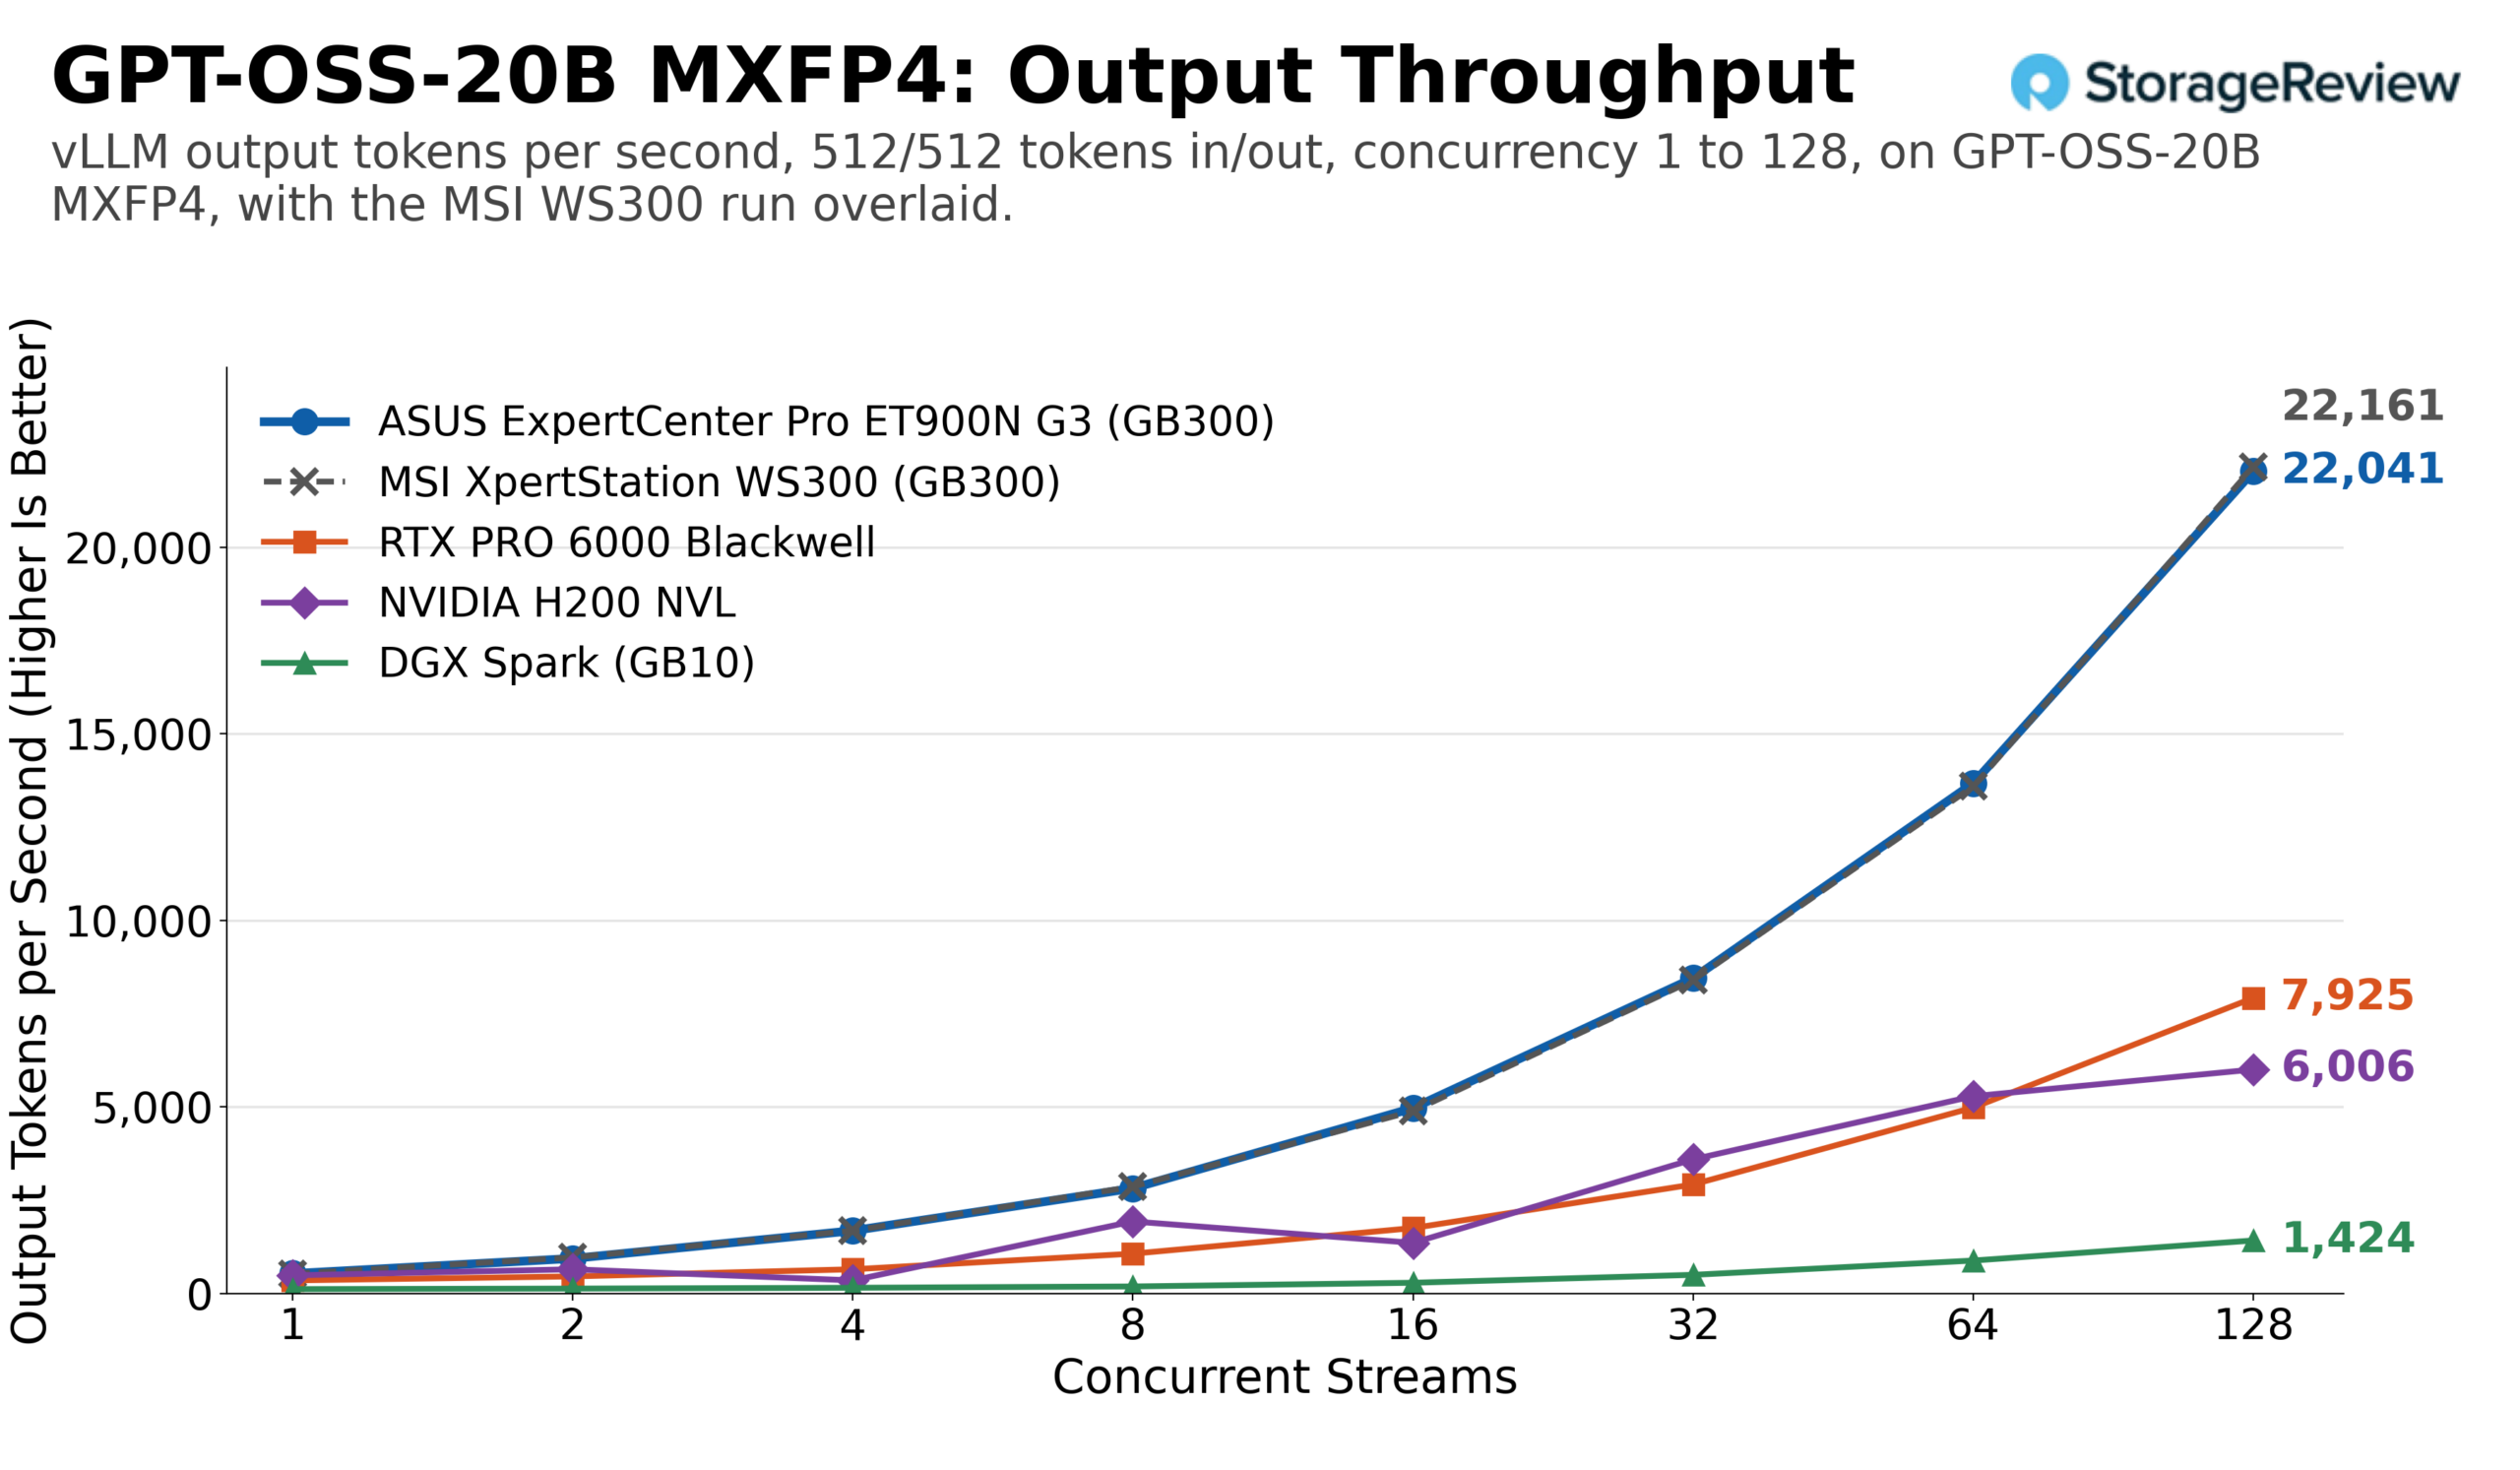
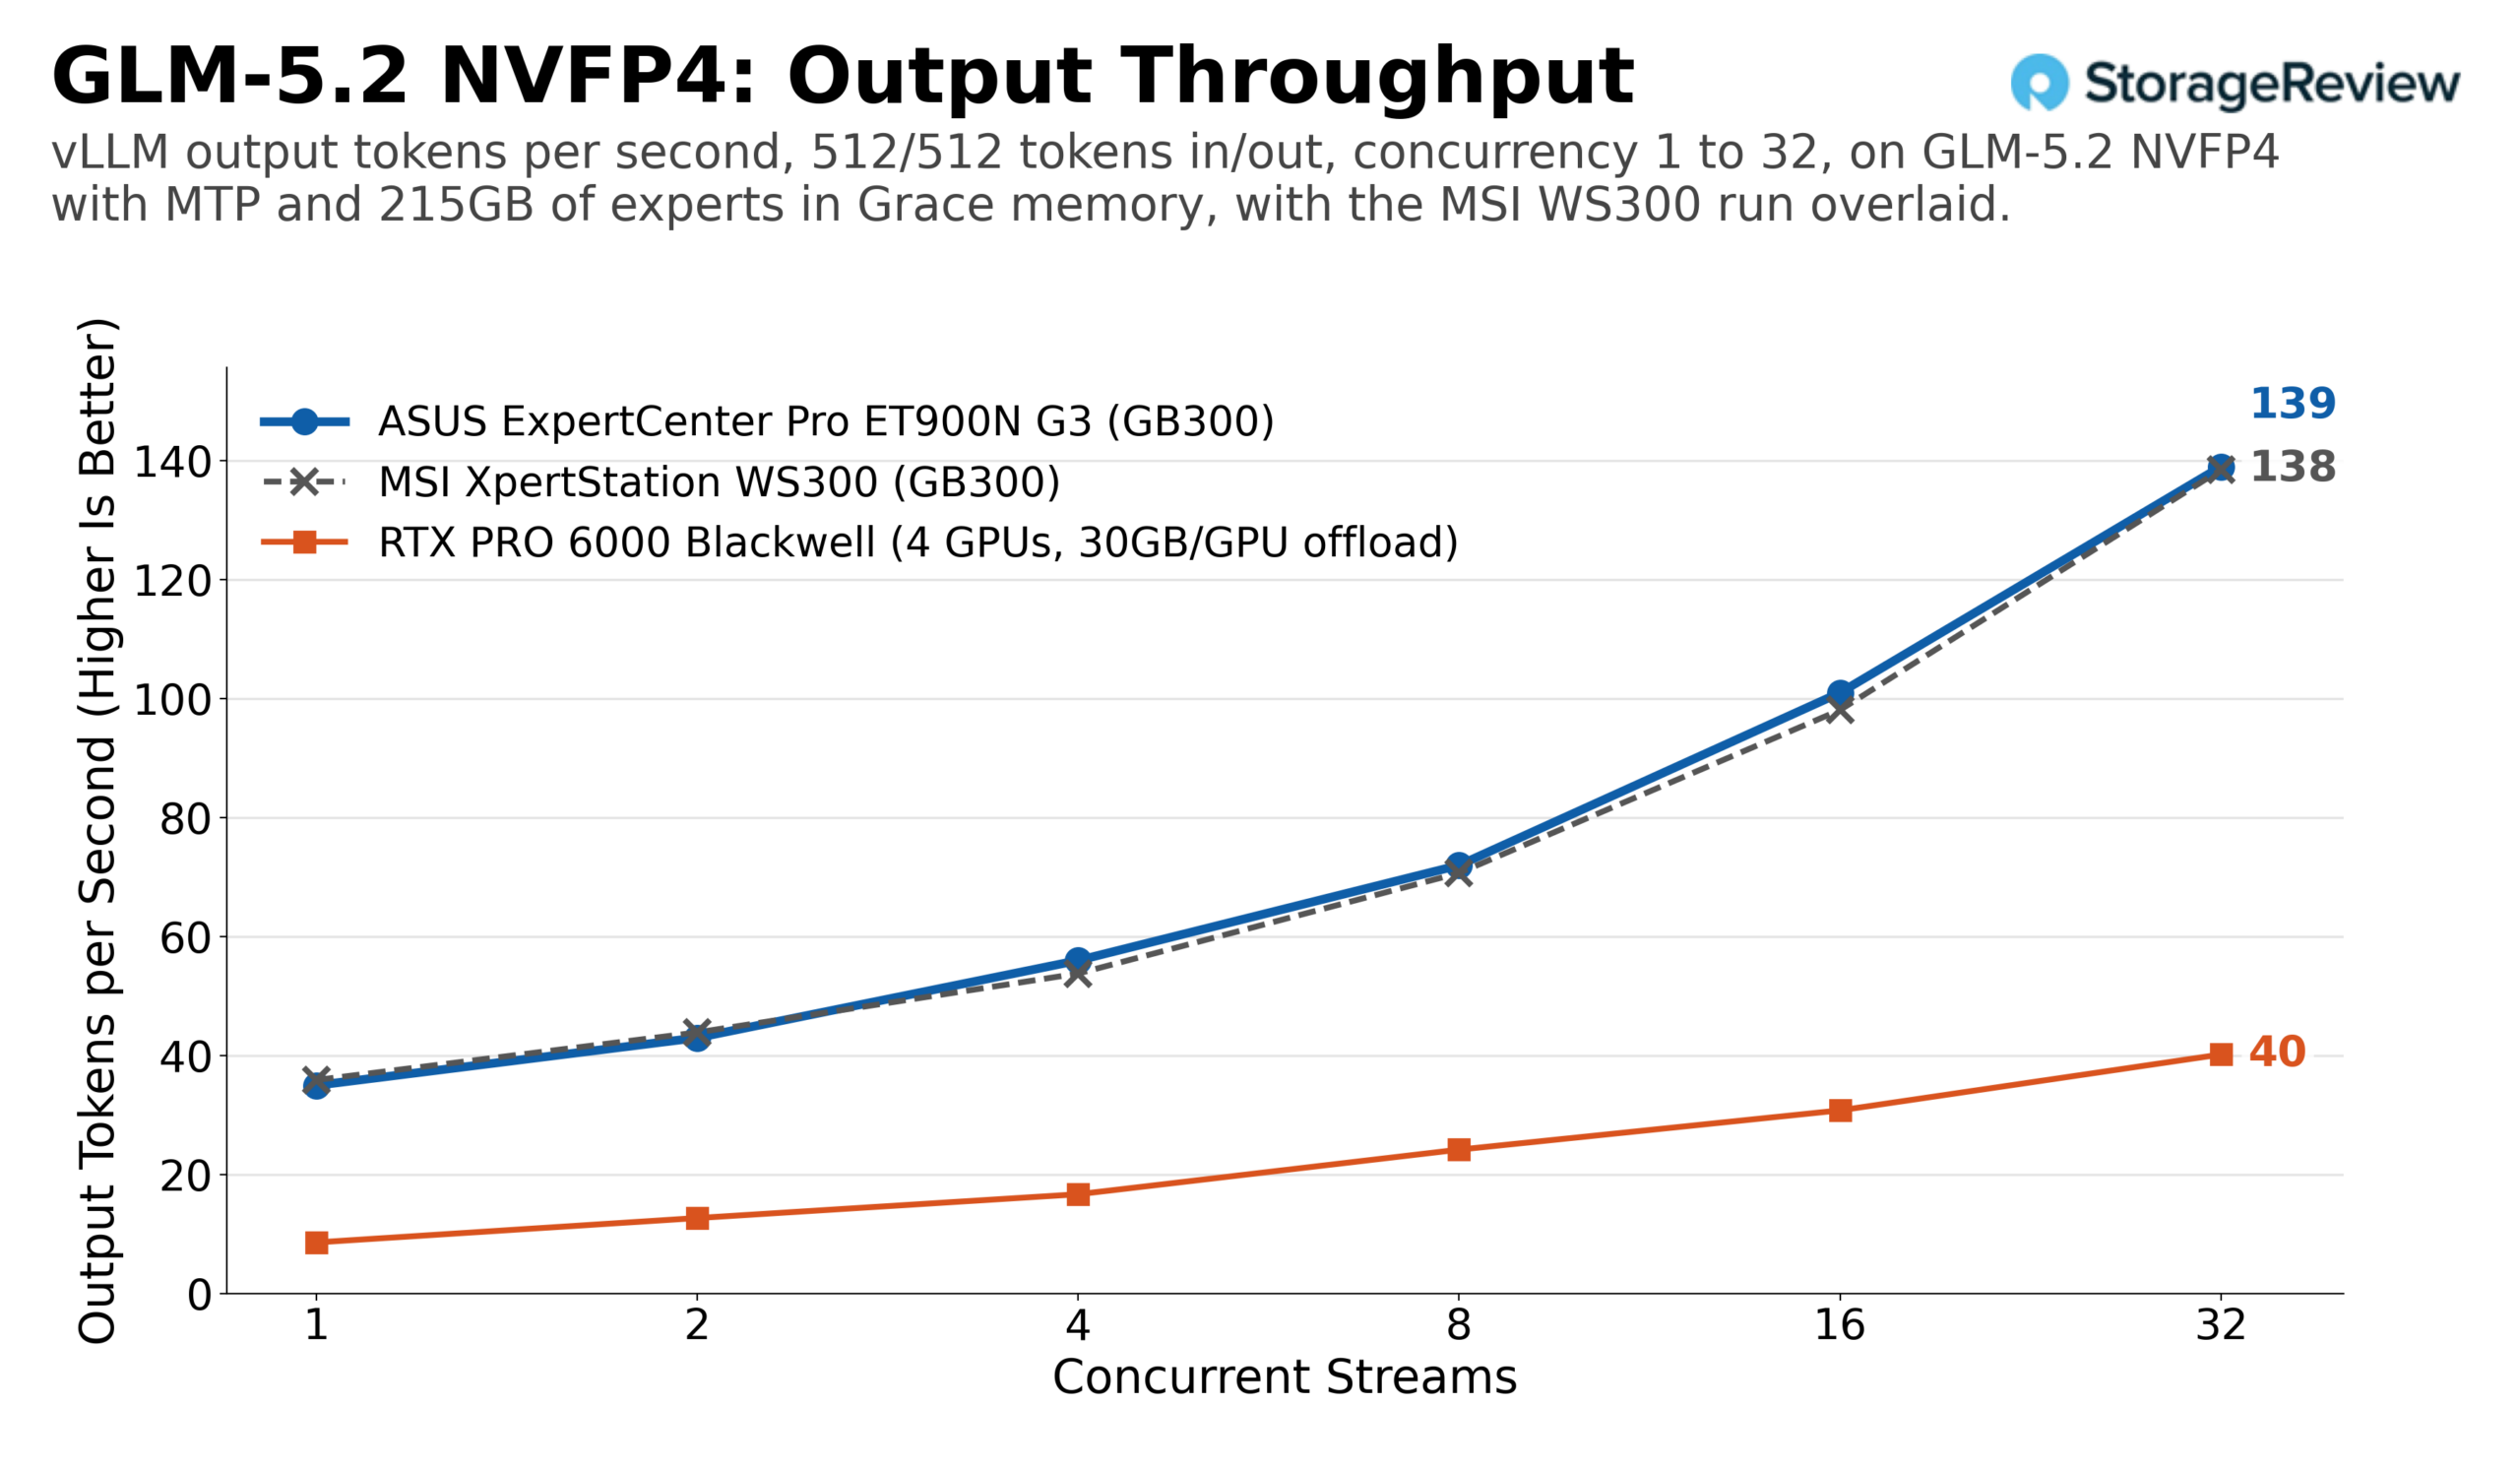
Dit is de vergelijking waarop we voortbouwen naarmate er meer GB300-torens in het lab binnenkomen. HP's ZGX is de volgende, en er zullen er nog meer volgen. Elk exemplaar ondergaat dezelfde test, dus eventuele verschillen tussen OEM-implementaties zullen hier zichtbaar zijn, in één grafiek per toren, terwijl de modelgrafieken de ruwe curves bevatten.
Conclusie
De ASUS ExpertCenter Pro ET900N G3 doet wat een tweede implementatie van een referentieplatform zou moeten doen: het bevestigt de eerste. Over 14 modellen en twee workloads lag de piek-vLLM-doorvoer binnen 2% van de MSI XpertStation WS300 in 24 van de 28 vergelijkingen, van 1,766 uitvoertokens per seconde op DeepSeek V4 Flash tot 22,041 op GPT-OSS-20B, met vier uitschieters van 2 tot 5% onder de norm. Bovendien verwerkte het GLM-5.2 met 215 GB aan experts in Grace-geheugen met snelheden die vier RTX PRO 6000-kaarten niet konden bereiken. De GB300 Superchip zet de limiet en ASUS heeft goed werk geleverd met de uitvoering.
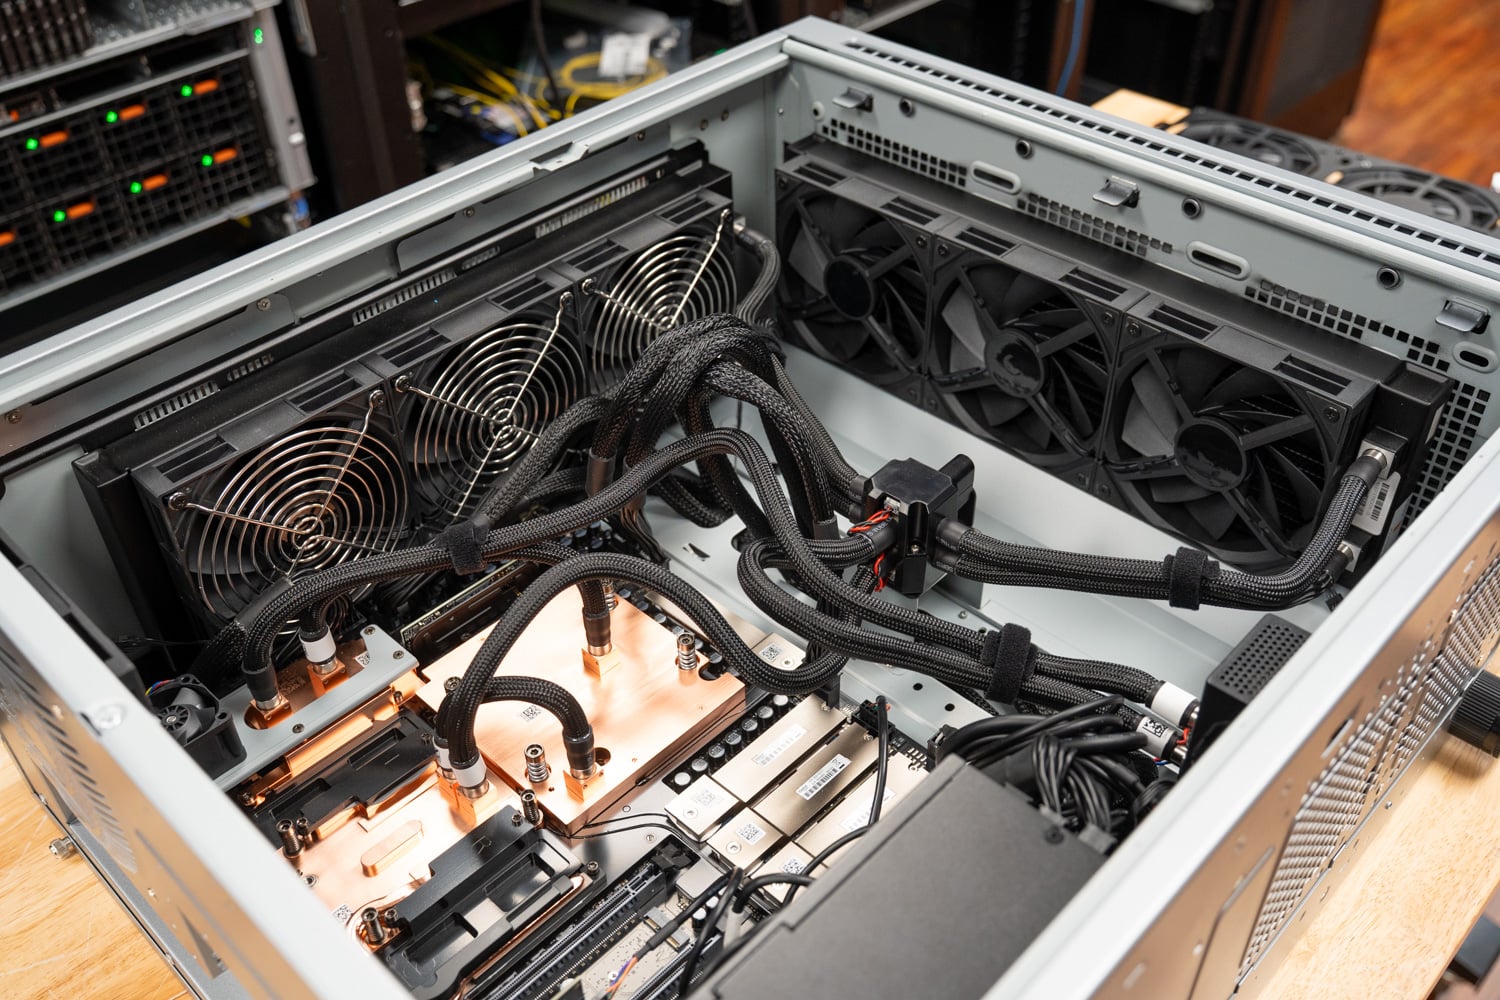
Wat ASUS toevoegt is praktisch: de handgrepen maken van een 27 kg zware tower een apparaat dat door twee personen verplaatst kan worden zonder de panelen vast te hoeven pakken, de ventilator boven de QSFP112-cages lost een potentieel probleem op voor gebruikers die urenlang 400G-videokaarten gebruiken, en de Titanium-voeding bespaart een paar watt aan stroom. De Arm-host, het 20A-circuit, de BMC-only display-uitgang en het gedeelde budget van 1,600W bij een grote videokaart zijn platformeigenschappen die voor beide towers gelden.
De GB300 DGX Station blijft het meest capabele apparaat dat we ooit op een bureau hebben geplaatst, en ASUS heeft met hun versie een goede optie gemaakt om hem aan te schaffen.
Op onze Beste desktops voor lokale AI leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon